PixVerse R2:扩展实时全能世界模型
PixVerse R1 提出并落地了首个实时视频世界模型,把视频生成从一次性交付固定片段,变成持续运行的世界。模型可以持续接收用户输入、实时更新世界状态,并流式输出与交互保持一致的同步音视频。R1 证明这一技术范式可以成立。
PixVerse R2 回答下一个问题:实时视频世界模型如何持续扩展。R2 聚焦两个目标。第一,构建能在长时域上持有统一状态的动态世界,把完整时空先验转化为只向前推进的世界演化。第二,持续把来自文本、参考、音频与动作的物理因果与交互信号内化进单一模型,使世界能在流式同步音视频的同时生成、接收控制并更新状态。
围绕这些目标,R2 把模型、数据、任务、控制信号与时间尺度的增长,转化为生成质量、长程一致性与多模态控制的提升。
整体框架
R2 把系统收敛为两层核心:Omni Causal AR 与 Real-Time Acceleration(实时加速)。Omni Causal AR 持续扩展高质量、多模态、长时域的世界生成。实时加速在严格的交互延迟预算下,尽可能无损地继承这些能力。路径很清晰:先抬高世界模型的能力上限,再把该能力加速到实时、可交互的工作区间。
更早的长视频与实时管线通常串联许多训练阶段:把双向模型转成 AR 模型,从任务特定的双向模型构建蒸馏教师,跑 DMD 蒸馏,再加 self-rollout DMD 以弥合训练-推理差距。每个阶段都要重新迁移能力、重新对齐目标、重新拟合数据分布。画质、运动、条件遵循与长时域稳定性可能在这些转移中被侵蚀。随着模型、数据与任务规模增长,多阶段管线会拆散优化目标,并抬高训练成本与系统复杂度。
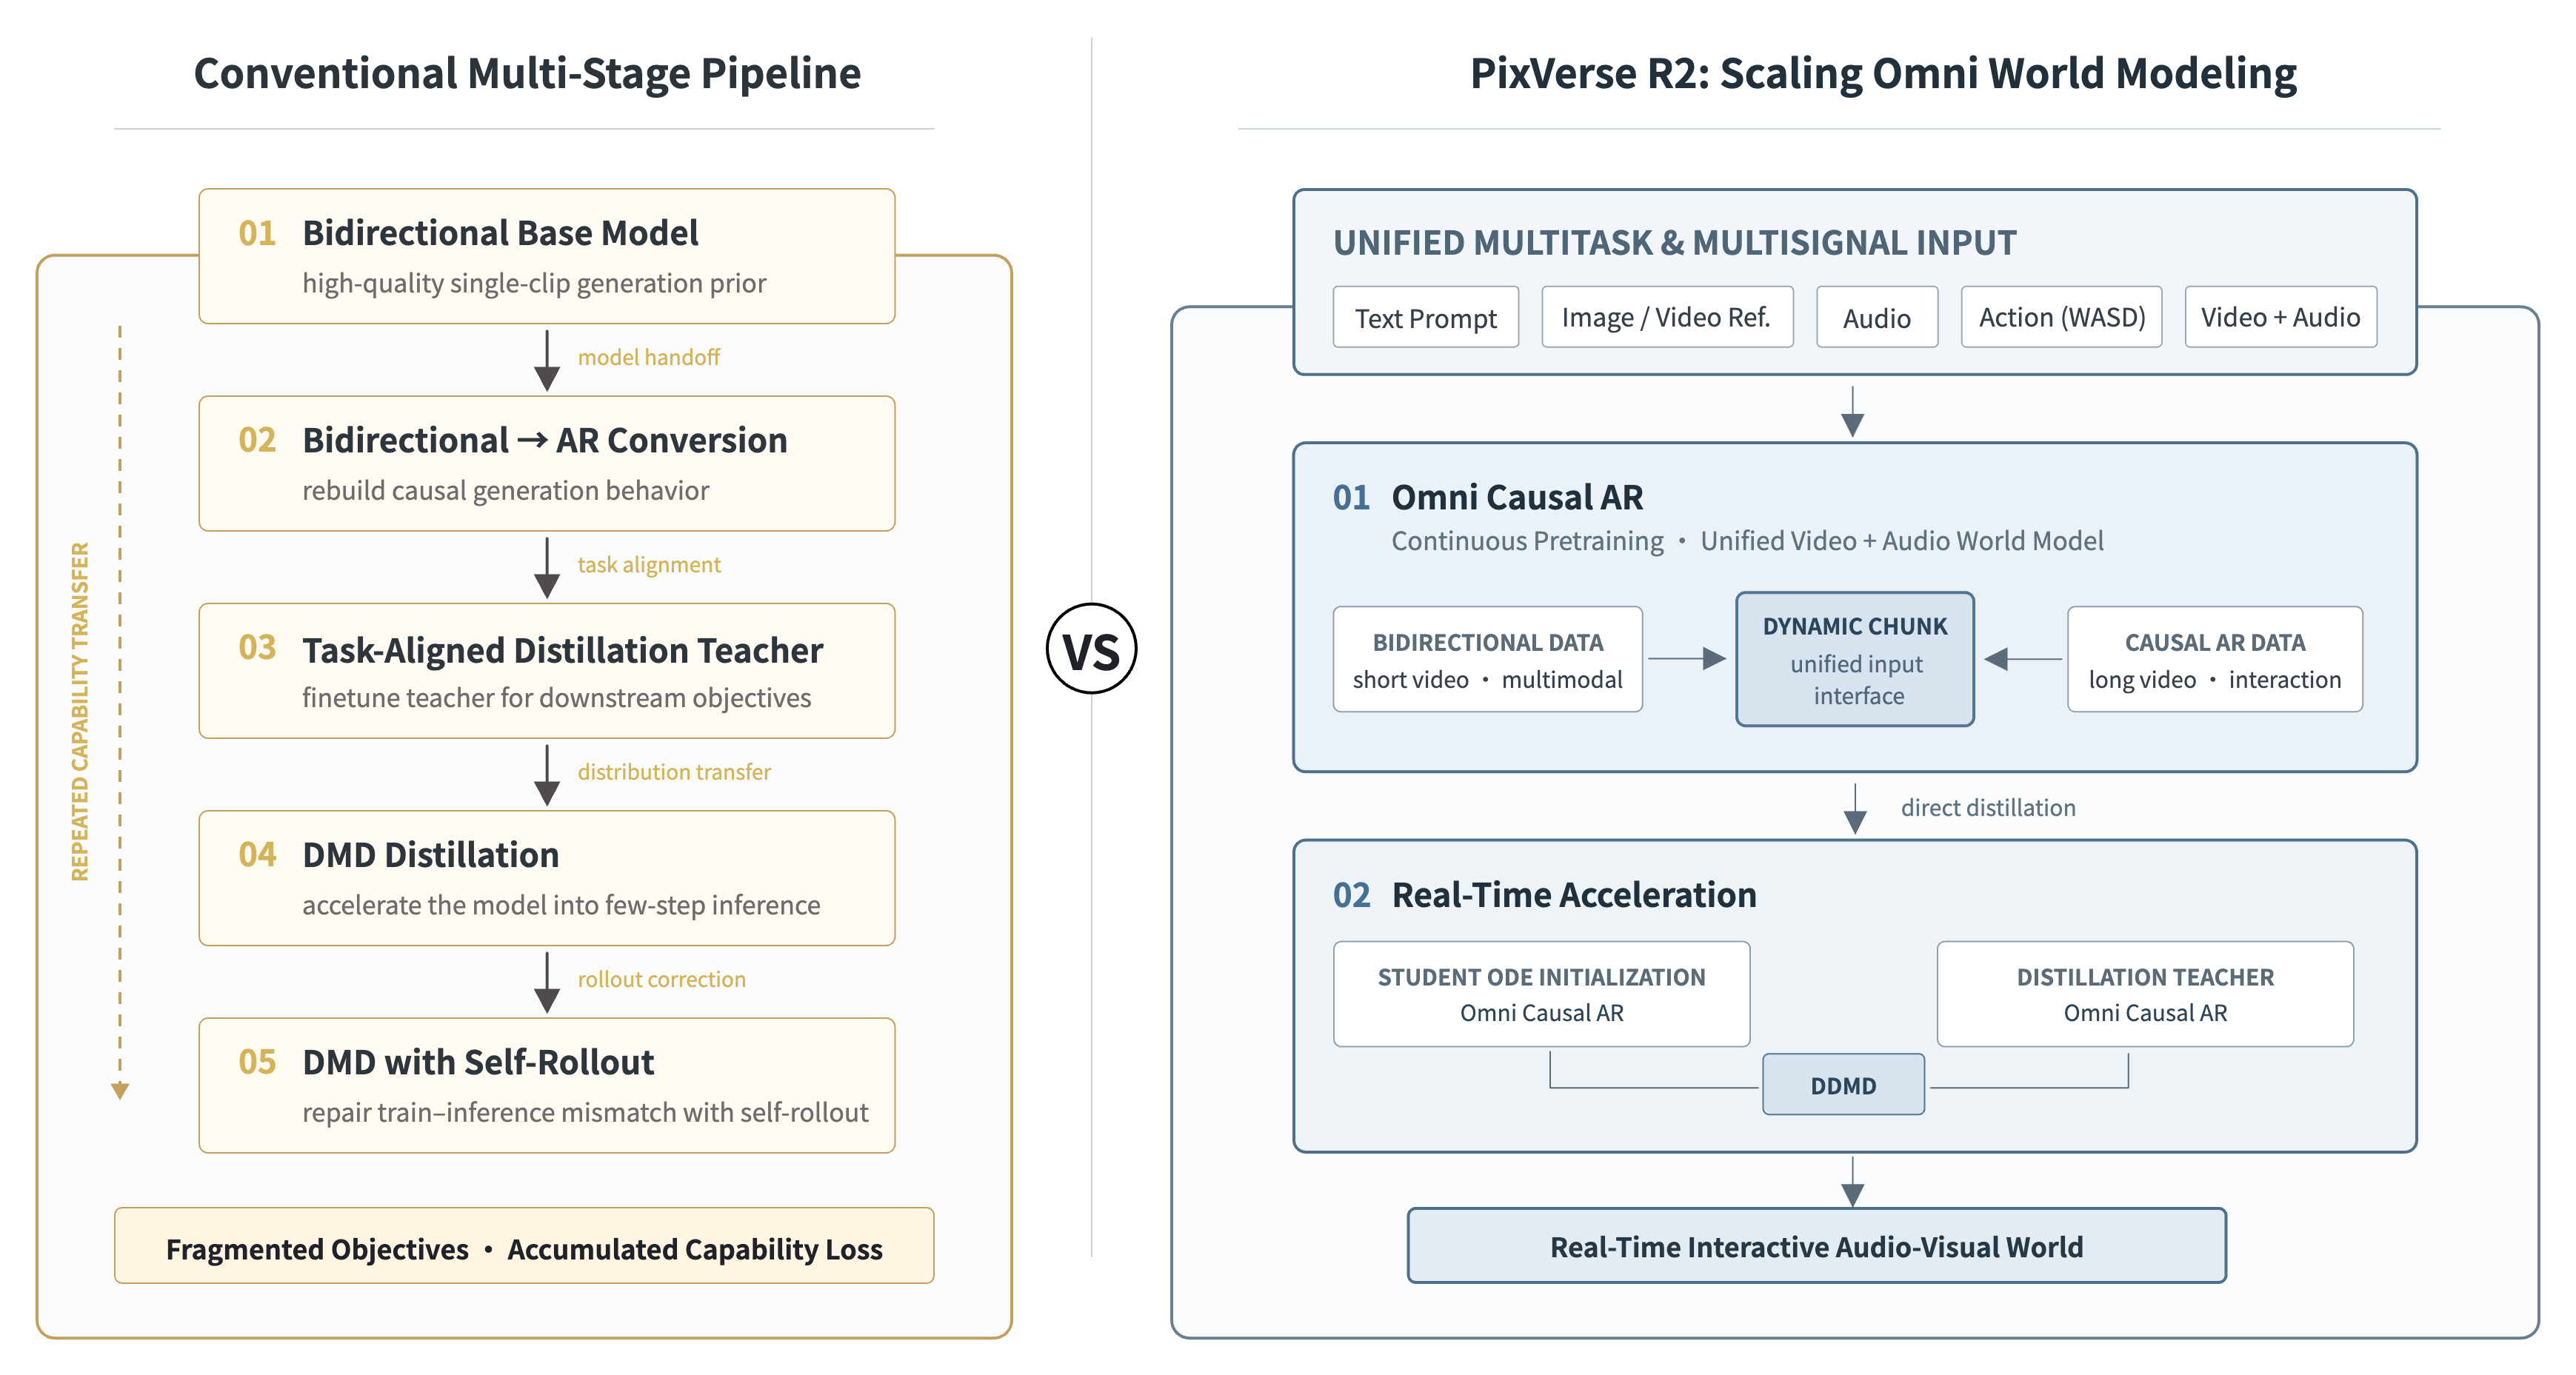
图 1. 传统多阶段管线对比 PixVerse R2 扩展世界建模。R2 把能力扩展与实时蒸馏收敛为 Omni Causal AR 与实时加速层,在同一框架中统一多任务、多信号与长视频建模。
PixVerse R2 提出实时世界模型的统一训练范式。它不再在许多模型与任务阶段之间反复迁移能力,而是把复杂管线收成两条可持续扩展的过程:持续预训练持有统一世界状态的 Omni Causal AR,再直接蒸馏成能实时生成、同时继承空间一致性与长时域建模的加速模型。
更少的阶段边界,减少来自独立教师、任务对齐与反复模型转移的能力损失。新数据、任务、控制信号与模型规模,可以更直接地转化为实时世界建模能力。
阶段 1:Omni Causal AR 的持续预训练。 R2 不再把双向生成先验与长视频 AR 当作两个断开的阶段。它在双向模型能力之上,持续训练统一的 Omni Causal AR。动态分块让不同数据形态共享时间表征:模型可以吸收双向预训练中的高质量短视频与多模态数据,也可以扩展到连续长视频与多轮交互轨迹。画质、视听表达、长时域生成与多信号控制可以在同一模型内扩展,而不必通过反复转换重新迁移。
阶段 2:从已扩展的 Omni Causal AR 蒸馏实时加速层。 持续预训练让 Omni Causal AR 同时具备高质量生成、稳定的长时域状态传递,以及真实因果 rollout。R2 随后用同一个 Omni Causal AR 同时做学生 ODE 初始化与蒸馏教师,使教师、学生与真实 AR 推理共享一致的因果建模基础。实时蒸馏变成「对已有世界模型做少步加速」,而不是「重新学习一个长时域世界」。
Omni Causal AR
R2 延续 R1 已验证的多模态输入、自回归生成与实时交互路径,再把这些能力集中到统一的 Omni Causal AR 训练路线。Omni Causal AR 把完整时空生成先验转化为只向前推进的世界状态传递。通过因果化与持续预训练,模型在保持画面、运动、音频与多模态语义能力的同时,学会仅凭历史预测下一个同步视听块。
当训练对象从独立短视频扩展到连续长视频与多轮交互轨迹时,模型逐步在历史世界状态、当前交互输入与未来世界演化之间建立长期因果。
模型联合接收文本提示词、多模态参考、动作信号(例如 WASD 或连续控制)与音频,并输出同步视频与音频。不同控制信号可以在运行中持续进入模型,并改变后续世界状态。R2 不只是响应一次性条件;它可以同时生成、接收控制并更新世界。
为了让因果生成在同一世界中长时运行,R2 应对四个问题:训练-推理分布差距、对噪声历史的鲁棒性、长期与近期记忆的协调,以及错误状态的校正。Hybrid Teacher / Diffusion Forcing 让模型同时适应干净与带噪历史。Multi-Timescale Memory 联合存储世界锚点、近期动态与物体状态。Error Bank 把失败状态带回训练。它们共同构成长期世界状态的训练循环,并减少画面、角色、运动、视听关系与控制响应随时间的漂移。
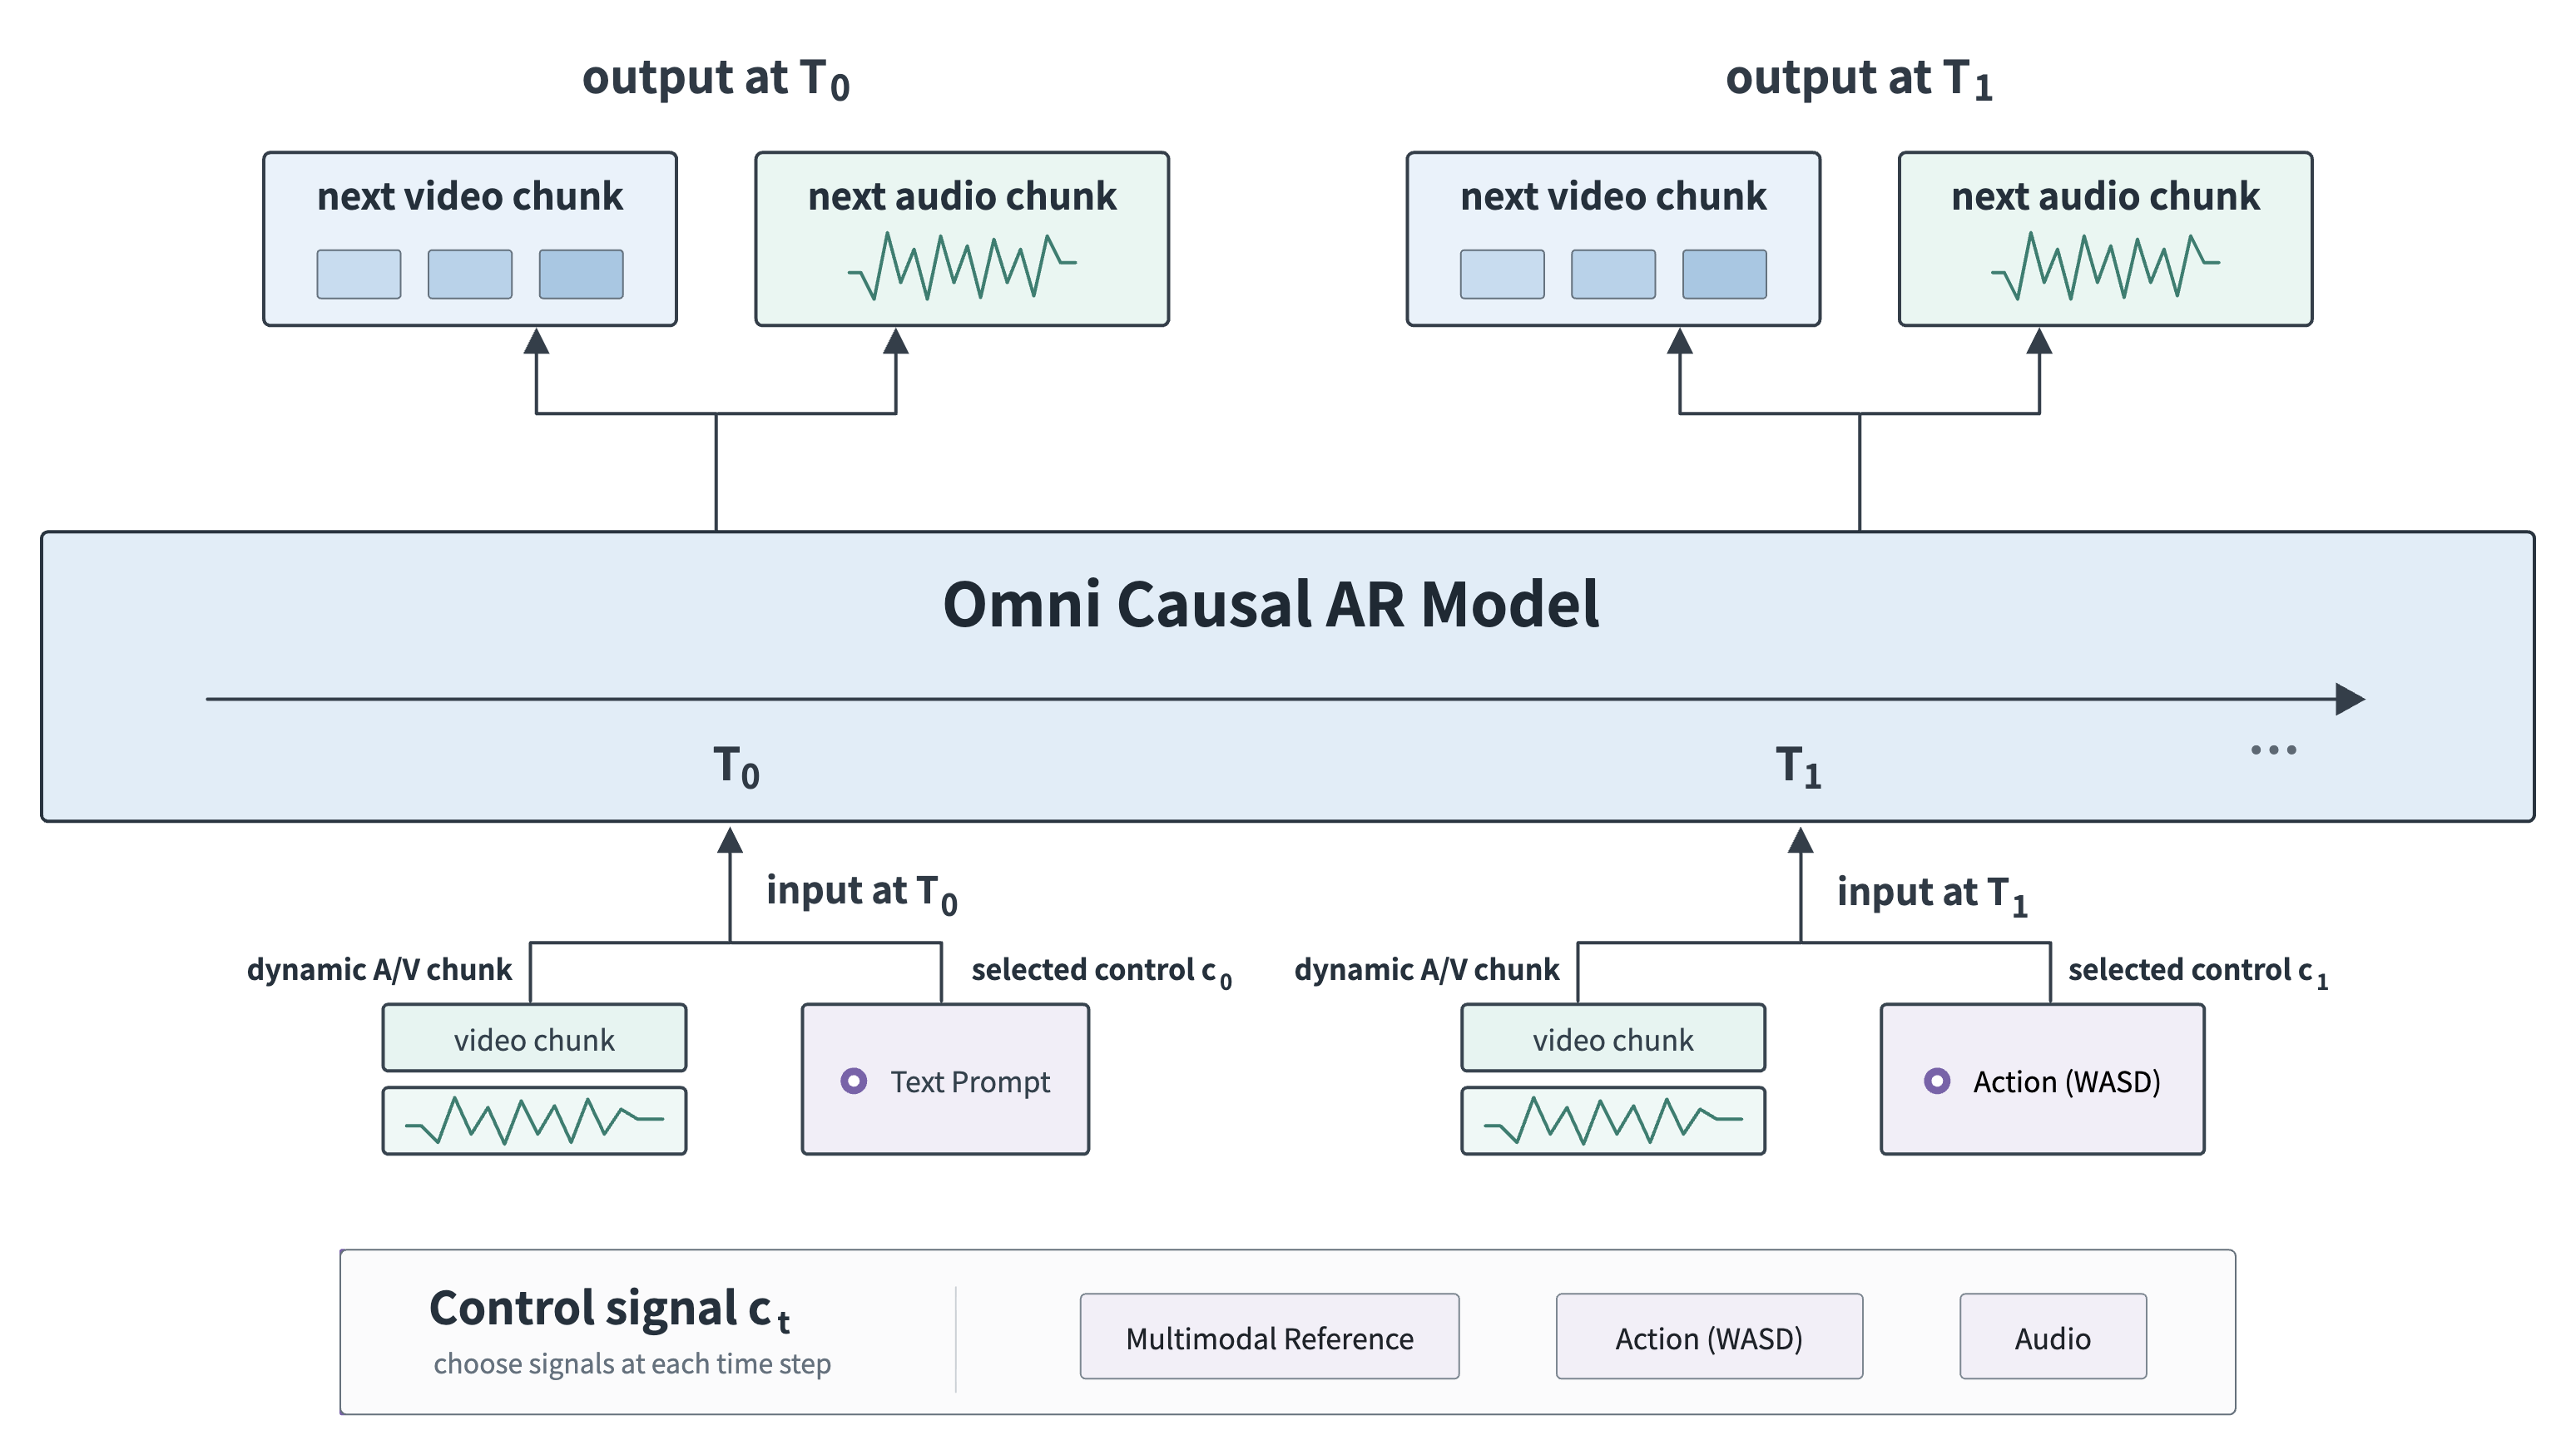
图 2. PixVerse R2 Omni Causal AR。模型可以在运行中持续接收不同控制信号。在每个交互时刻,活动信号与匹配粒度的动态视听块对齐,并驱动下一段视频与音频。
动态分块生成
不同控制信号生活在不同时间尺度上。提示词与参考通常描述完整语义或更长事件。动作(WASD)需要细粒度、即时的状态反馈。音频同时携带语义、节奏与时间同步。若把每种输入都强行塞进固定时长单元,模型往往必须在响应速度与表达完整性之间取舍。
Dynamic Chunk 是 R2 统一这些交互时间尺度的方式。R2 按当前控制信号的语义边界与时长自适应切分视听序列,并用最大分块尺寸约束计算与训练稳定性。短块提升动作与局部指令的响应精度。长块保住事件、运动与视听语义的完整结构。不同任务与控制信号可以共享同一因果生成接口,而不必切换模型结构。
Hybrid Teacher Forcing / Diffusion Forcing
长时域 AR 的核心张力在于:训练历史通常更干净,而真实运行时历史包含模型自身的噪声与局部错误。只在干净历史上训练可以提高单步质量上限,但会让模型对小偏差过于敏感。只在扰动历史上训练则可能伤害画质、运动与控制响应。
R2 在同一训练过程中混合干净历史与带噪历史。干净历史稳住世界演化的质量上限。带噪历史让模型提前适应部署时会看到的不完美状态。互补训练缩小训练-推理差距,使模型既能生成高质量的下一段世界,又能在历史已含小误差时继续向前滚动。
Causal Attention Mask 与 Relative Temporal RoPE 共同约束当前状态可读哪些历史,以及这些历史落在当前窗口的何处。Attention Mask 强制严格因果可见性。Temporal RoPE 不会随全局 block ID 无界增长;它按当前注意力窗口内的相对槽位重新索引。当滚动窗口向前移动时,真实时间继续前进,但 sink 记忆、近期历史与当前块仍被映射到稳定、有界的相对位置范围。
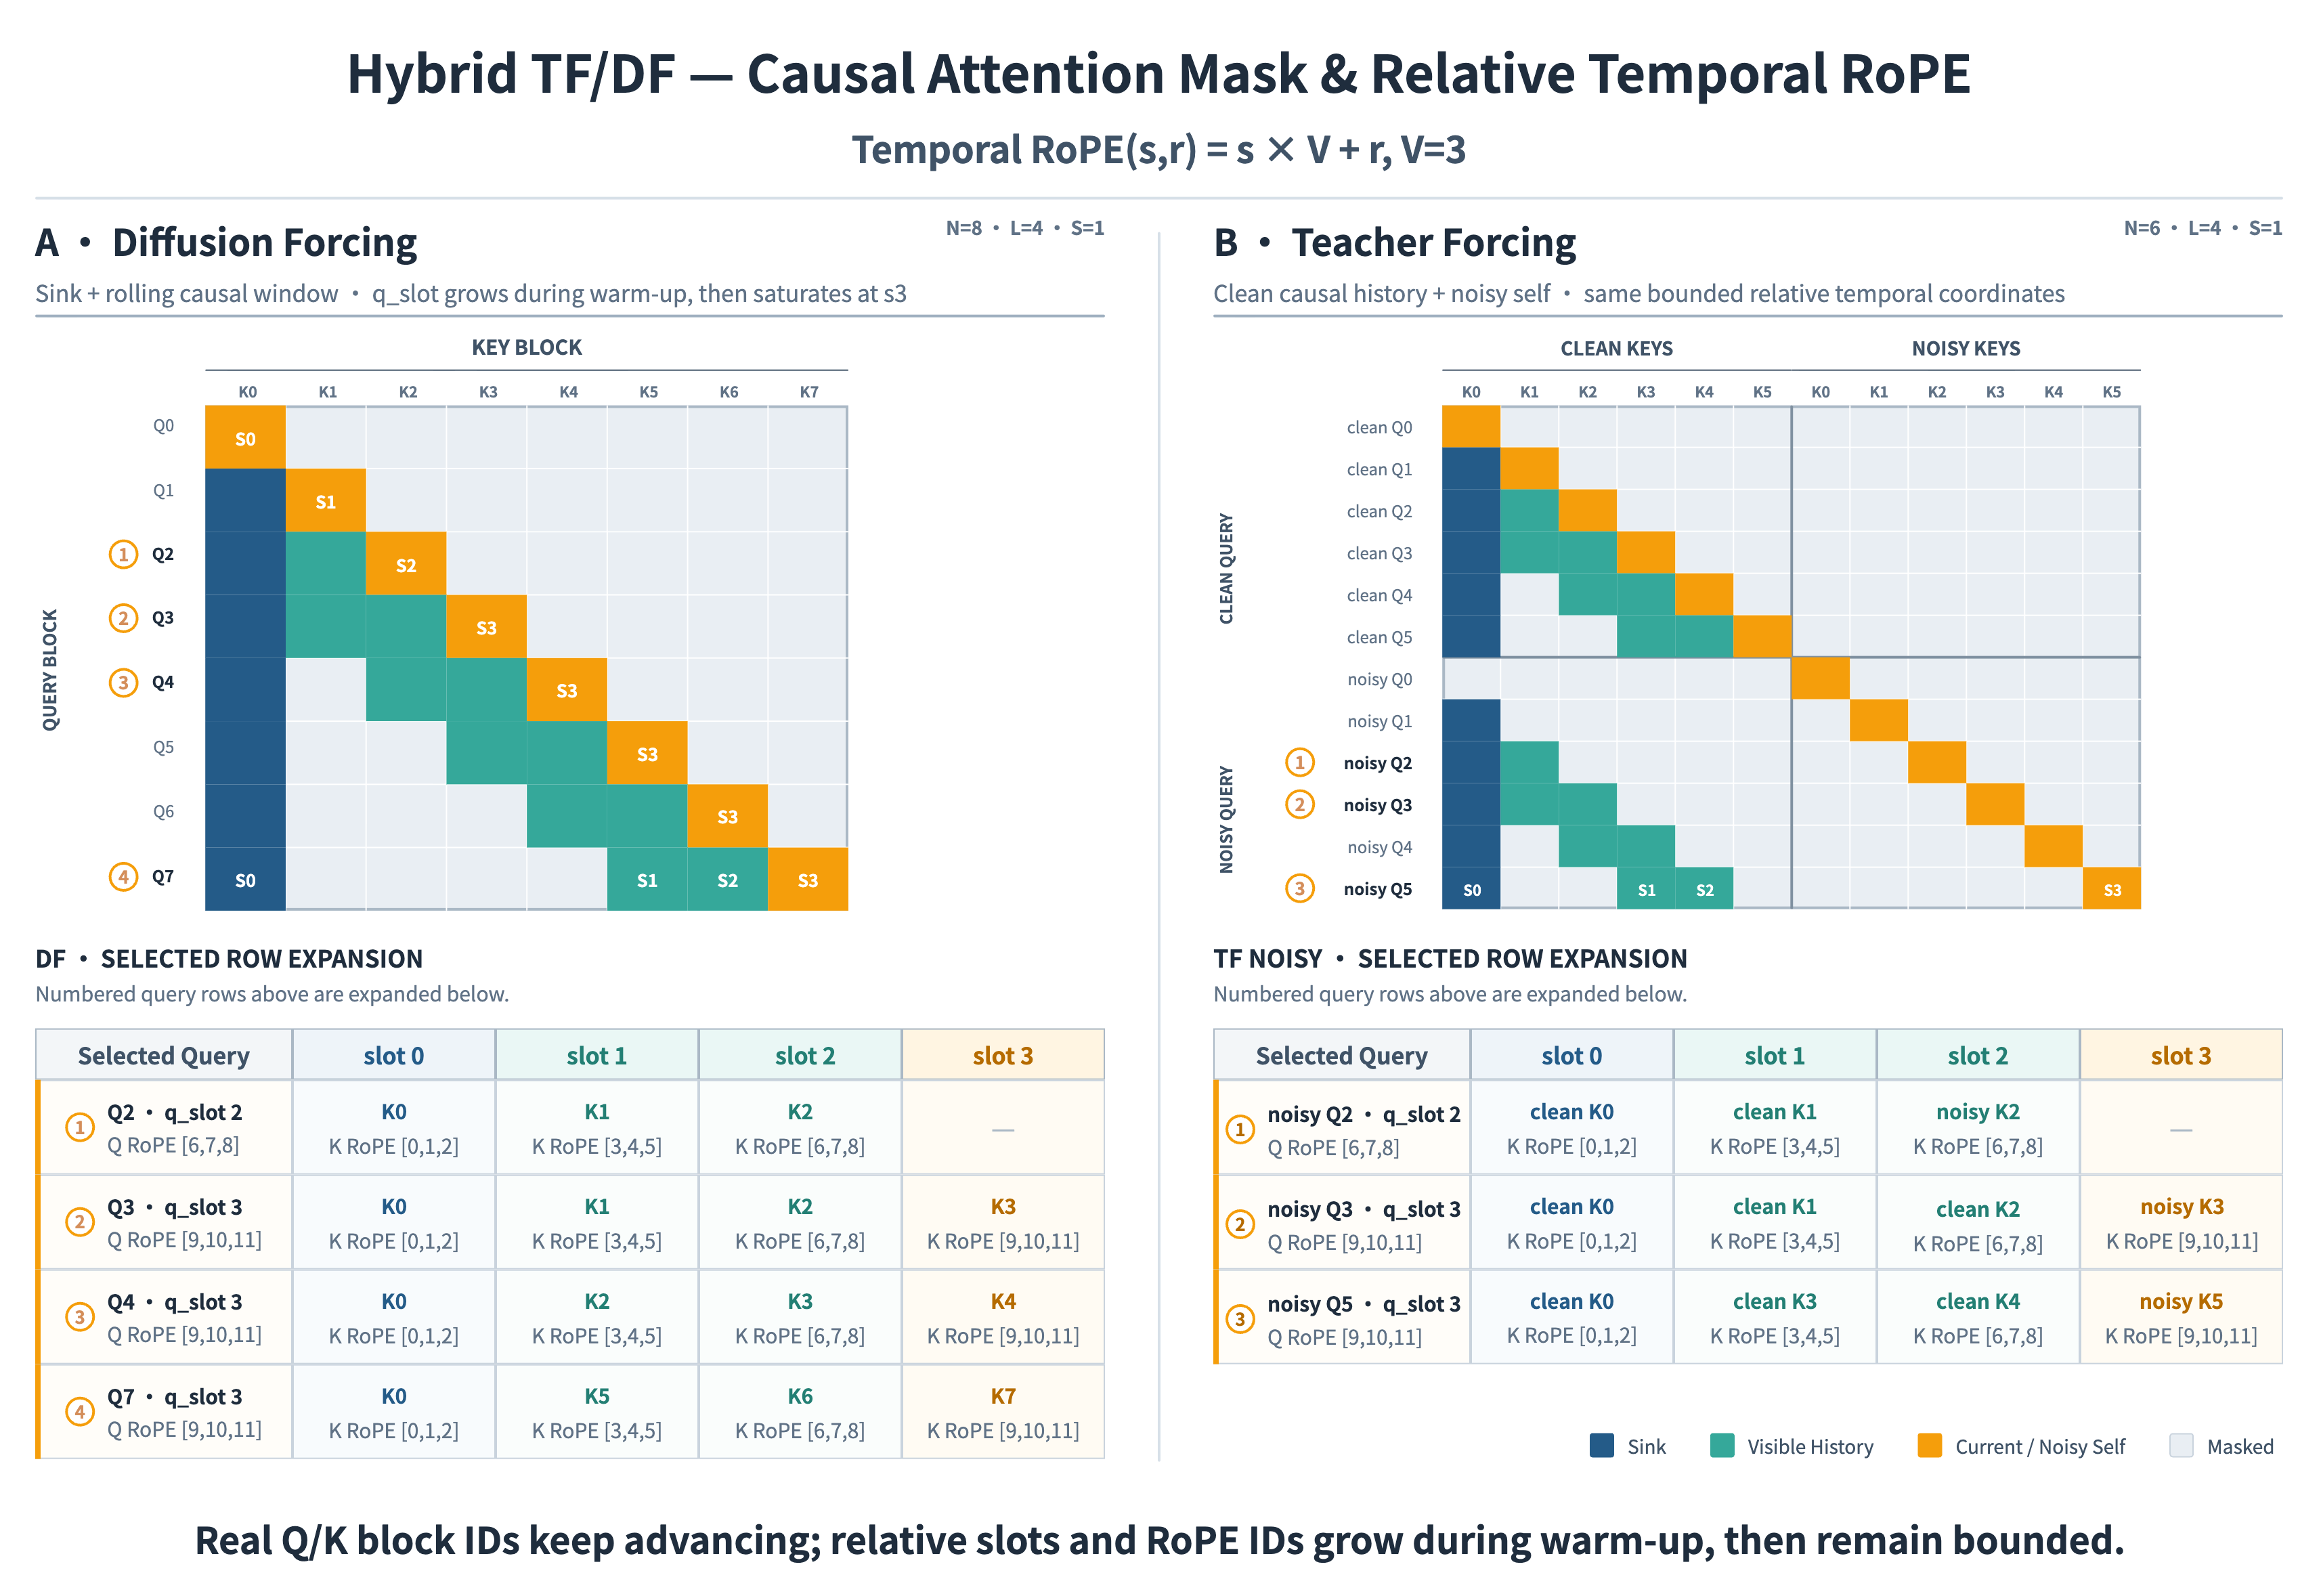
图 3. Hybrid Teacher / Diffusion Forcing 的统一因果注意力掩码与相对时间 RoPE。上图展示两种历史构造的因果可见性。下图把代表性查询映射到 Q/K 块、相对槽位与 RoPE ID,显示真实 block ID 持续前进,而窗口内时间坐标保持有界。
多时间尺度记忆
长期世界建模不能简单记住全部历史。无界历史会迅速抬高计算与内存成本;过度裁剪则会丢掉角色身份、场景设定与关键事件。R2 用 Sink Memory、Rolling History 与 Object KV Cache 构建多尺度记忆系统。
- Sink Memory 存储角色、场景、风格与世界规则等长期锚点。
- Rolling History 聚焦近期动作、姿态、镜头与环境变化,让局部状态能自然衔接。
- Object KV Cache 复用并压缩已计算的物体级历史表征,在有限预算内保留真正影响后续演化的状态。
三者共同给出长期身份稳定、短程运动连续与可控运行时成本,并减少角色漂移、场景跳变、跨块闪烁与动作断裂。
Error Bank
AR 世界模型中的严重漂移,往往始于写入历史并随后被继承的早期小误差。R2 构建 Error Bank,把代表性错误历史存为可复用样本,并在训练中按设定比率回放到正常历史。模型不再只学习如何从理想状态继续,也学习如何识别、吸收并修复已经漂移的历史。
在分阶段评估中,长期亮度漂移指标从 0.201 降至 0.129,约下降 35.8%。29 个长序列样本中有 20 个改善,全部 5 个明确应保持静止的样本都减少了错误运动。
实时加速
R2 的实时加速不是在少步模型里重新学习一个长时域世界。它加速的是已经能长时间稳定运行的世界模型。加速层从持续预训练的 Omni Causal AR 出发,并用它同时做学生 ODE 初始化与蒸馏教师,使教师、学生与真实 AR 推理共享一致的因果轨迹分布。
这一统一因果起点减少对 Self-Forcing 与 Rolling Forcing 类调参的依赖。实时加速可以聚焦少步速度真正引入的问题:带对抗正则的 DDMD 处理蒸馏中的条件对齐、生成分布与真实感;块稀疏注意力 压缩长上下文计算;金字塔 路径降低高分辨率生成成本。
带对抗正则的 DDMD
在超少步生成中,条件对齐、分布匹配与真实感并不是同一优化问题。R2 基于 DDMD,并进一步引入来自 DMD2 的对抗正则。三个训练信号在同一个学生中汇合:条件对齐强化控制,分布匹配保住教师分布,对抗正则锚定真实数据,使少量采样步既能保持准确的交互响应,也能保持可信世界。
块稀疏注意力
R2 在时空 token 序列上使用块稀疏注意力。模型把 Q、K、V 切成计算块,快速估计每个查询块最需要哪些键/值块,只保留得分最高的连接,并在这些选定块上运行精确 softmax 注意力。块级路由不是随机剪枝;它把计算集中在当前多模态控制、近期运动与关键世界状态之间的强依赖上。
通过在训练中让模型适应稀疏连接结构,R2 把注意力稀疏度提高到 90% 以上,同时在当前评估中保持画质、动作连续、条件遵循与长时域稳定性,没有明显下降。
金字塔超少步蒸馏
在高分辨率空间从头做全部世界建模,会把计算浪费在低分辨率已经能确定的全局结构上。R2 把生成组织为一到两个低分辨率阶段加一个高分辨率阶段。低分辨率阶段设定场景布局、主体运动与镜头结构。高分辨率阶段恢复纹理、边缘与局部细节。由粗到细的路径减少重复的高分辨率计算,同时保持更强的结构稳定性与细节。
结语与限制
PixVerse R1 提出并落地了首个实时视频世界模型,表明视频可以从离线固定内容,走向能实时交互并持续运行的动态世界。PixVerse R2 接着解决这一范式如何持续扩展:统一的 Omni Causal AR 承载增长的数据、任务、模态与时间尺度,实时加速把完整世界建模能力带入实时少步推理。
R2 不是单点能力升级。它是下一代实时世界模型的统一训练路径。R1 让实时视频世界模型成为现实。R2 把它们放进统一、可扩展、持续改进的阶段。
在严格的实时计算与交互延迟预算下,当前单次生成质量相对领先离线视频模型仍有提升空间,尤其是在复杂场景细节、运动自然度、物理一致性与长时运行稳定性上。这些差距更常反映 R2 当前的扩展阶段,而不是框架本身的上限。
抢先体验
2026 年 8 月 23 日,本报告将 PixVerse R2 描述为封闭测试。2026 年 9 月 22 日,PixVerse 宣布这些世界的精选集合已可在 world.pixverse.video 开放探索。详见 R2 发布公告。
该公告并不开放不受限制的 API。PixVerse 世界模型 R2 体验表单 仍是申请抢先体验与 API 权限的请求途径。
相关资源
- PixVerse R1 解析:实时 AI 视频世界模型
- PixVerse Game Engine 深度解析
- PixVerse 更新 R1:共享世界
- 实时 AI 视频生成指南
- PixVerse 完成 C 轮追加融资
2026 年 9 月 22 日公告中的世界已可在 world.pixverse.video 开放探索。API 权限仍须通过上方表单申请,也可以立即用 PixVerse V6 与 R1 开始创作。