PixVerse R2: Mở rộng các mô hình thế giới Omni thời gian thực
PixVerse R1 đã giới thiệu và đưa vào vận hành mô hình thế giới video thời gian thực đầu tiên, biến việc tạo video từ việc giao một clip cố định trong một lần thành một thế giới chạy liên tục. Mô hình có thể tiếp tục nhận đầu vào của người dùng, cập nhật trạng thái thế giới theo thời gian thực, và stream âm thanh cùng video đồng bộ, nhất quán với tương tác. R1 đã cho thấy mô hình kỹ thuật này có thể hoạt động.
PixVerse R2 trả lời câu hỏi tiếp theo: một mô hình thế giới video thời gian thực tiếp tục mở rộng như thế nào. R2 tập trung vào hai mục tiêu. Thứ nhất, nó xây một thế giới động có thể giữ một trạng thái thống nhất trên các tầm xa dài, chuyển các prior không–thời gian đầy đủ thành sự tiến hóa của thế giới chỉ đi về phía trước theo thời gian. Thứ hai, nó liên tục nội hóa tính nhân quả vật lý và các tín hiệu tương tác từ văn bản, tham chiếu, âm thanh và hành động vào một mô hình duy nhất, để thế giới có thể tạo sinh, nhận điều khiển và cập nhật trạng thái cùng lúc trong khi stream âm thanh và video đồng bộ.
Xoay quanh những mục tiêu đó, R2 biến sự tăng trưởng về mô hình, dữ liệu, tác vụ, tín hiệu điều khiển và thang thời gian thành mức tăng về chất lượng tạo sinh, tính nhất quán tầm xa và điều khiển đa phương thức.
Khung tổng thể
R2 thu hệ thống còn hai lớp lõi: Omni Causal AR và Tăng tốc thời gian thực. Omni Causal AR tiếp tục mở rộng việc tạo thế giới chất lượng cao, đa phương thức, tầm xa dài. Tăng tốc thời gian thực kế thừa các năng lực đó một cách ít mất mát nhất có thể dưới một ngân sách độ trễ tương tác chặt. Con đường rất rõ: nâng trần năng lực của mô hình thế giới, rồi tăng tốc năng lực đó vào một dải vận hành thời gian thực, tương tác.
Các pipeline video dài và thời gian thực trước đây thường xâu chuỗi nhiều giai đoạn huấn luyện: chuyển một mô hình hai chiều thành mô hình AR, xây một teacher chưng cất từ một mô hình hai chiều theo từng tác vụ, chạy chưng cất DMD, rồi thêm DMD self-rollout để khép khoảng cách huấn luyện–suy luận. Mỗi giai đoạn phải di chuyển lại năng lực, căn lại mục tiêu, và khớp lại phân phối dữ liệu. Chất lượng hình, chuyển động, tuân theo điều kiện và độ ổn định tầm xa có thể bị bào mòn trong những lần chuyển đó. Khi quy mô mô hình, dữ liệu và tác vụ tăng, pipeline nhiều giai đoạn tách mục tiêu tối ưu và đẩy cả chi phí huấn luyện lẫn độ phức tạp hệ thống.
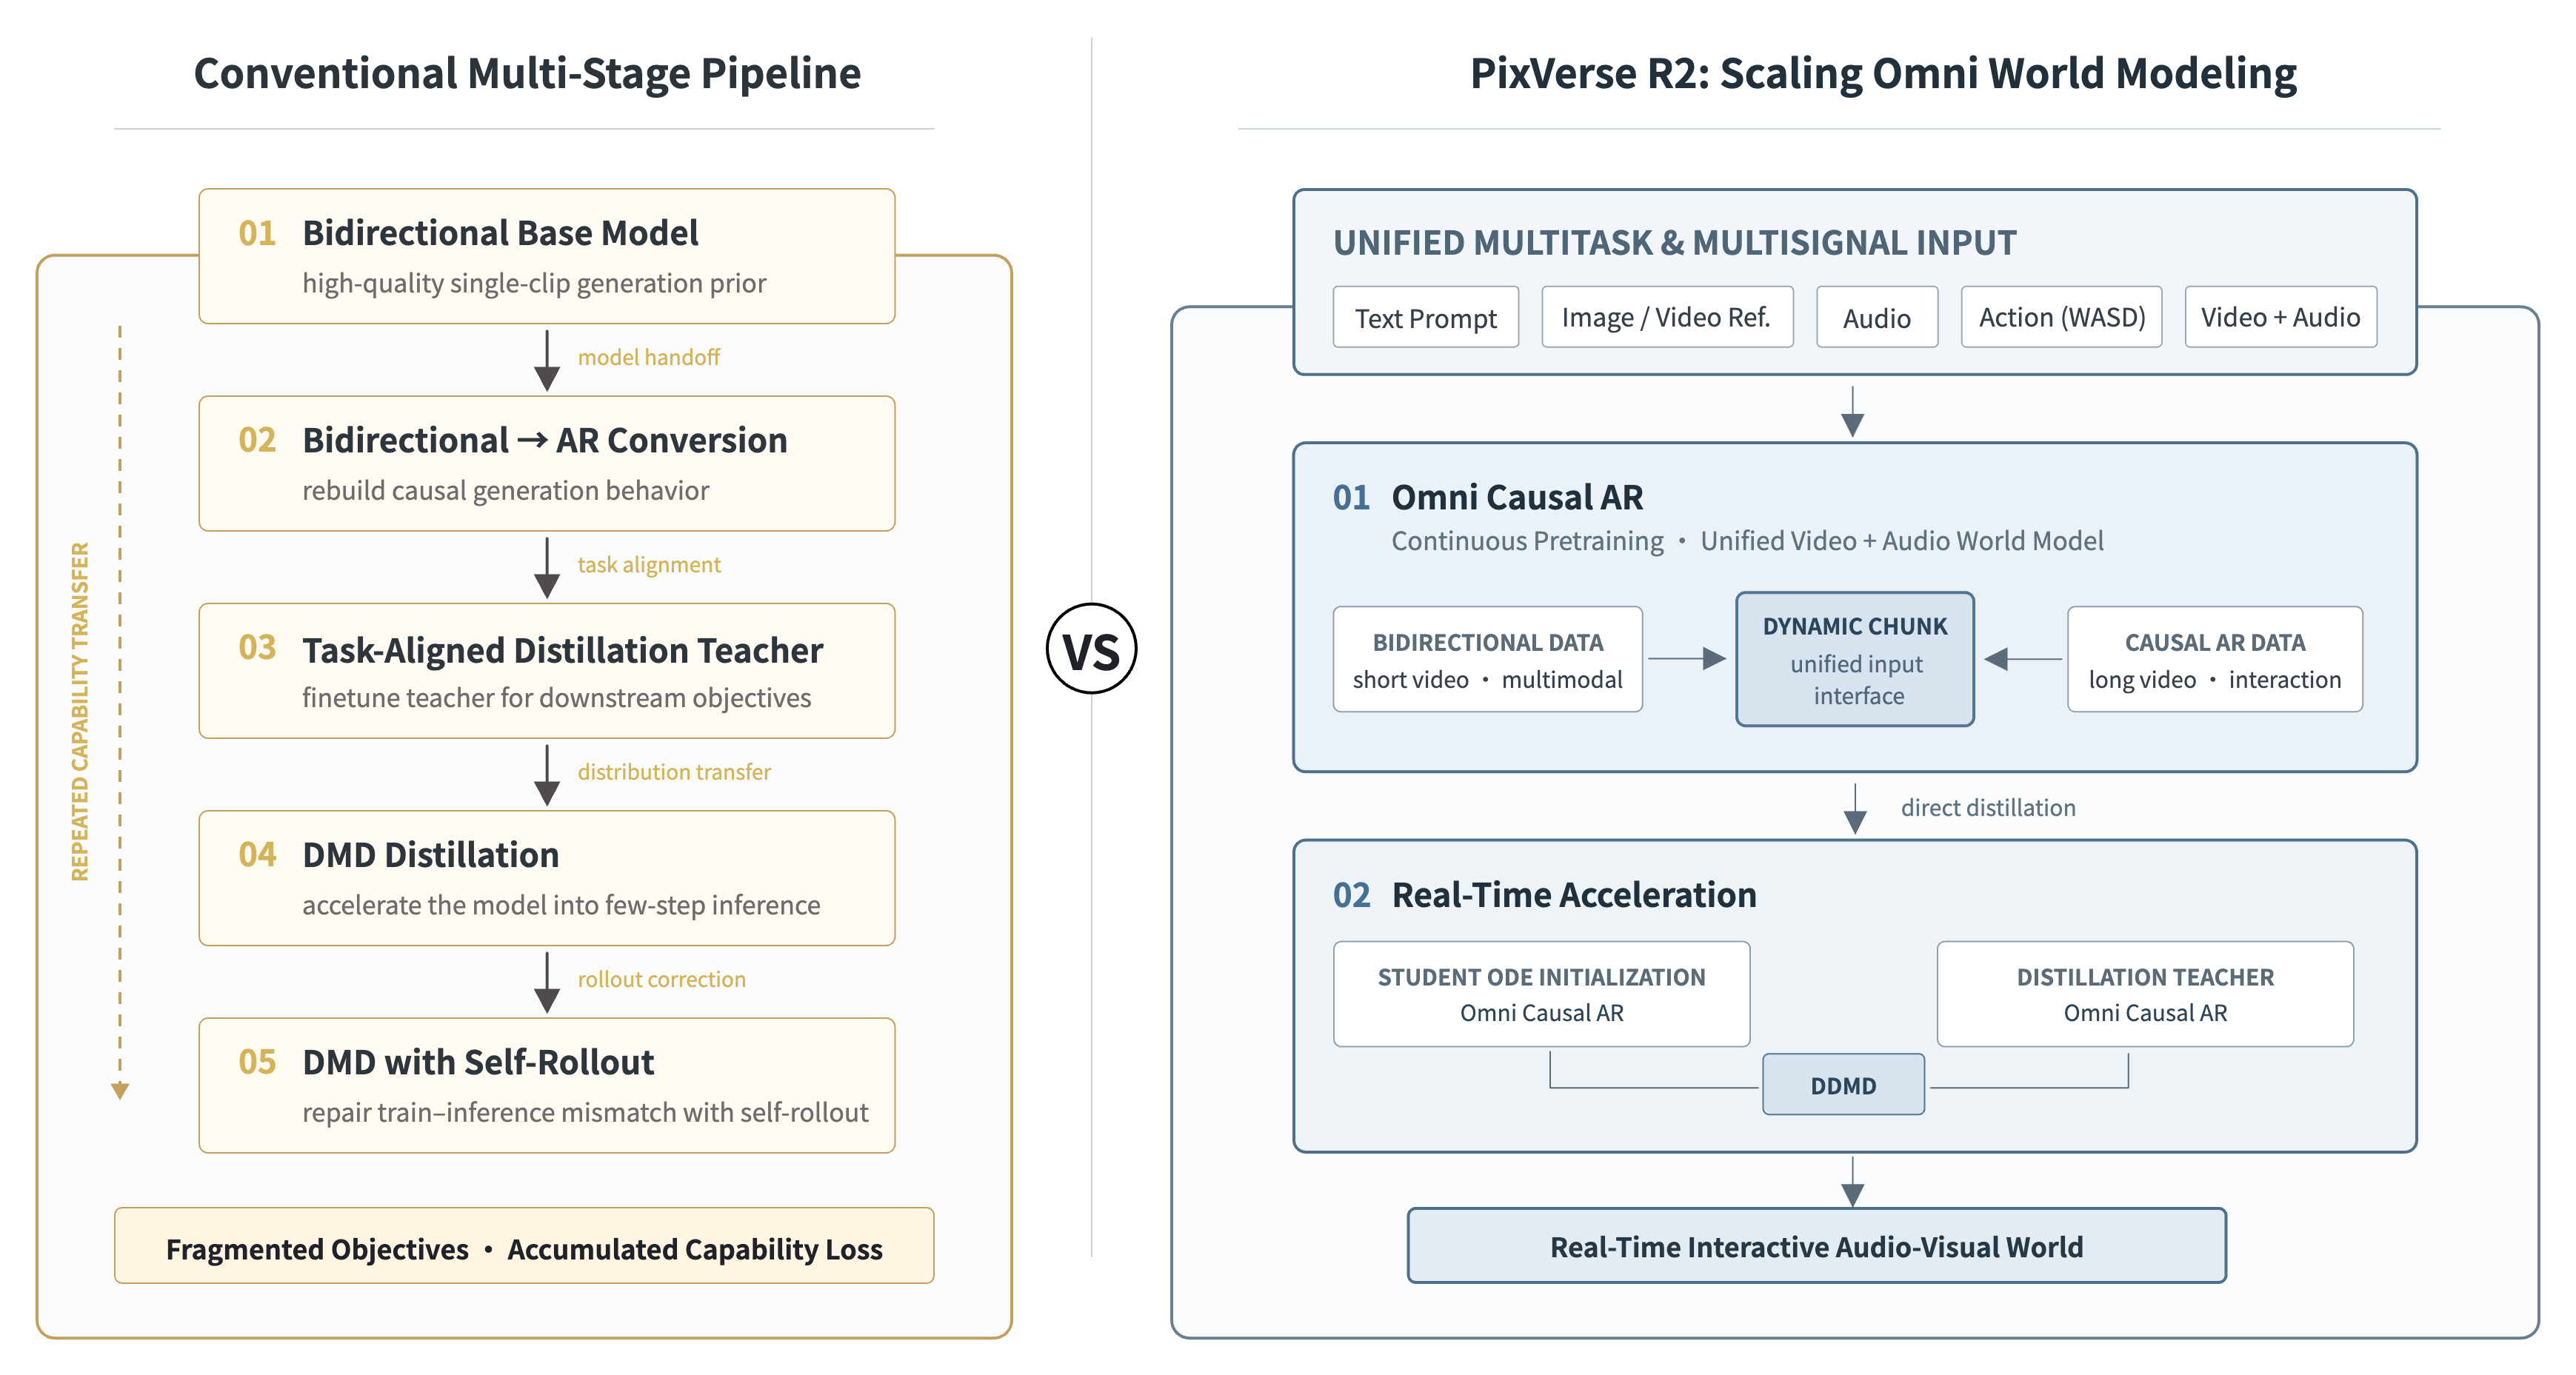
Hình 1. Pipeline nhiều giai đoạn cũ so với mô hình hóa thế giới mở rộng của PixVerse R2. R2 hội tụ việc mở rộng năng lực và chưng cất thời gian thực vào Omni Causal AR và một lớp tăng tốc thời gian thực, thống nhất mô hình hóa đa tác vụ, đa tín hiệu và video dài trong một khung.
PixVerse R2 đề xuất một mô hình huấn luyện thống nhất cho các mô hình thế giới thời gian thực. Thay vì liên tục di chuyển năng lực qua nhiều mô hình và giai đoạn tác vụ, nó rút pipeline phức tạp còn hai quá trình có thể tiếp tục mở rộng: liên tục pretrain một Omni Causal AR giữ trạng thái thế giới thống nhất, rồi chưng cất trực tiếp nó thành một mô hình được tăng tốc, có thể tạo sinh theo thời gian thực trong khi kế thừa tính nhất quán không gian và mô hình hóa tầm xa dài.
Ít ranh giới giai đoạn hơn sẽ giảm tổn thất năng lực đến từ các teacher độc lập, việc căn chỉnh tác vụ và các lần chuyển mô hình lặp lại. Dữ liệu, tác vụ, tín hiệu điều khiển và quy mô mô hình mới có thể chuyển trực tiếp hơn thành khả năng mô hình hóa thế giới thời gian thực.
Giai đoạn 1: pretrain liên tục Omni Causal AR. R2 không còn coi các prior tạo sinh hai chiều và AR video dài là hai giai đoạn tách rời. Nó liên tục huấn luyện một Omni Causal AR thống nhất trên nền năng lực của mô hình hai chiều. Các chunk động cho các dạng dữ liệu khác nhau một biểu diễn thời gian dùng chung: mô hình có thể hấp thụ video ngắn chất lượng cao và dữ liệu đa phương thức từ pretraining hai chiều, đồng thời mở rộng sang video dài liên tục và các quỹ đạo tương tác nhiều lượt. Chất lượng hình, biểu đạt nghe nhìn, tạo sinh tầm xa dài và điều khiển đa tín hiệu có thể mở rộng bên trong một mô hình, thay vì bị di chuyển lại qua các lần chuyển đổi lặp.
Giai đoạn 2: chưng cất một lớp tăng tốc thời gian thực từ Omni Causal AR đã được mở rộng. Pretrain liên tục mang lại cho Omni Causal AR đồng thời khả năng tạo sinh chất lượng cao, chuyển trạng thái tầm xa dài ổn định, và rollout nhân quả thực. R2 sau đó dùng cùng một Omni Causal AR cho cả khởi tạo ODE của student và teacher chưng cất, để teacher, student và suy luận AR thực chia sẻ một nền mô hình hóa nhân quả nhất quán. Chưng cất thời gian thực trở thành “tăng tốc vài bước của một mô hình thế giới đã có”, chứ không phải “học lại một thế giới tầm xa dài”.
Omni Causal AR
R2 tiếp tục con đường đầu vào đa phương thức, tạo sinh tự hồi quy và tương tác thời gian thực mà R1 đã xác nhận, rồi tập trung các năng lực đó vào một lộ trình huấn luyện Omni Causal AR thống nhất. Omni Causal AR chuyển các prior tạo sinh không–thời gian đầy đủ thành chuyển trạng thái thế giới chỉ đi về phía trước theo thời gian. Thông qua nhân quả hóa và pretrain liên tục, mô hình giữ khả năng hình ảnh, chuyển động, âm thanh và ngữ nghĩa đa phương thức trong khi học cách dự đoán chunk nghe nhìn đồng bộ tiếp theo chỉ từ lịch sử.
Khi các đối tượng huấn luyện mở từ các video ngắn độc lập sang video dài liên tục và các quỹ đạo tương tác nhiều lượt, mô hình dần xây dựng quan hệ nhân quả dài hạn giữa trạng thái thế giới lịch sử, đầu vào tương tác hiện tại và sự tiến hóa của thế giới trong tương lai.
Mô hình đồng thời nhận một prompt văn bản, các tham chiếu đa phương thức, tín hiệu hành động (ví dụ WASD hoặc điều khiển liên tục) và âm thanh, rồi xuất ra video và âm thanh được đồng bộ. Các tín hiệu điều khiển khác nhau có thể tiếp tục đi vào mô hình trong suốt một lần chạy và thay đổi trạng thái thế giới về sau. R2 không chỉ phản hồi một điều kiện một lần; nó có thể sinh nội dung, nhận điều khiển và cập nhật thế giới cùng lúc.
Để giữ việc sinh nhân quả bên trong cùng một thế giới qua một lần chạy dài, R2 xử lý bốn vấn đề: khoảng cách phân phối giữa huấn luyện và suy luận, độ bền trước lịch sử nhiễu, sự phối hợp giữa bộ nhớ dài hạn và bộ nhớ gần, cùng việc sửa các trạng thái lỗi. Hybrid Teacher / Diffusion Forcing cho phép mô hình thích ứng với cả lịch sử sạch và lịch sử nhiễu. Multi-Timescale Memory cùng lưu các mỏ neo thế giới, động lực gần đây và trạng thái đối tượng. Error Bank đưa các trạng thái thất bại trở lại quá trình huấn luyện. Cùng nhau, chúng tạo thành một vòng huấn luyện cho trạng thái thế giới dài hạn và giảm trôi về hình ảnh, nhân vật, chuyển động, quan hệ nghe–nhìn và phản hồi điều khiển theo thời gian.
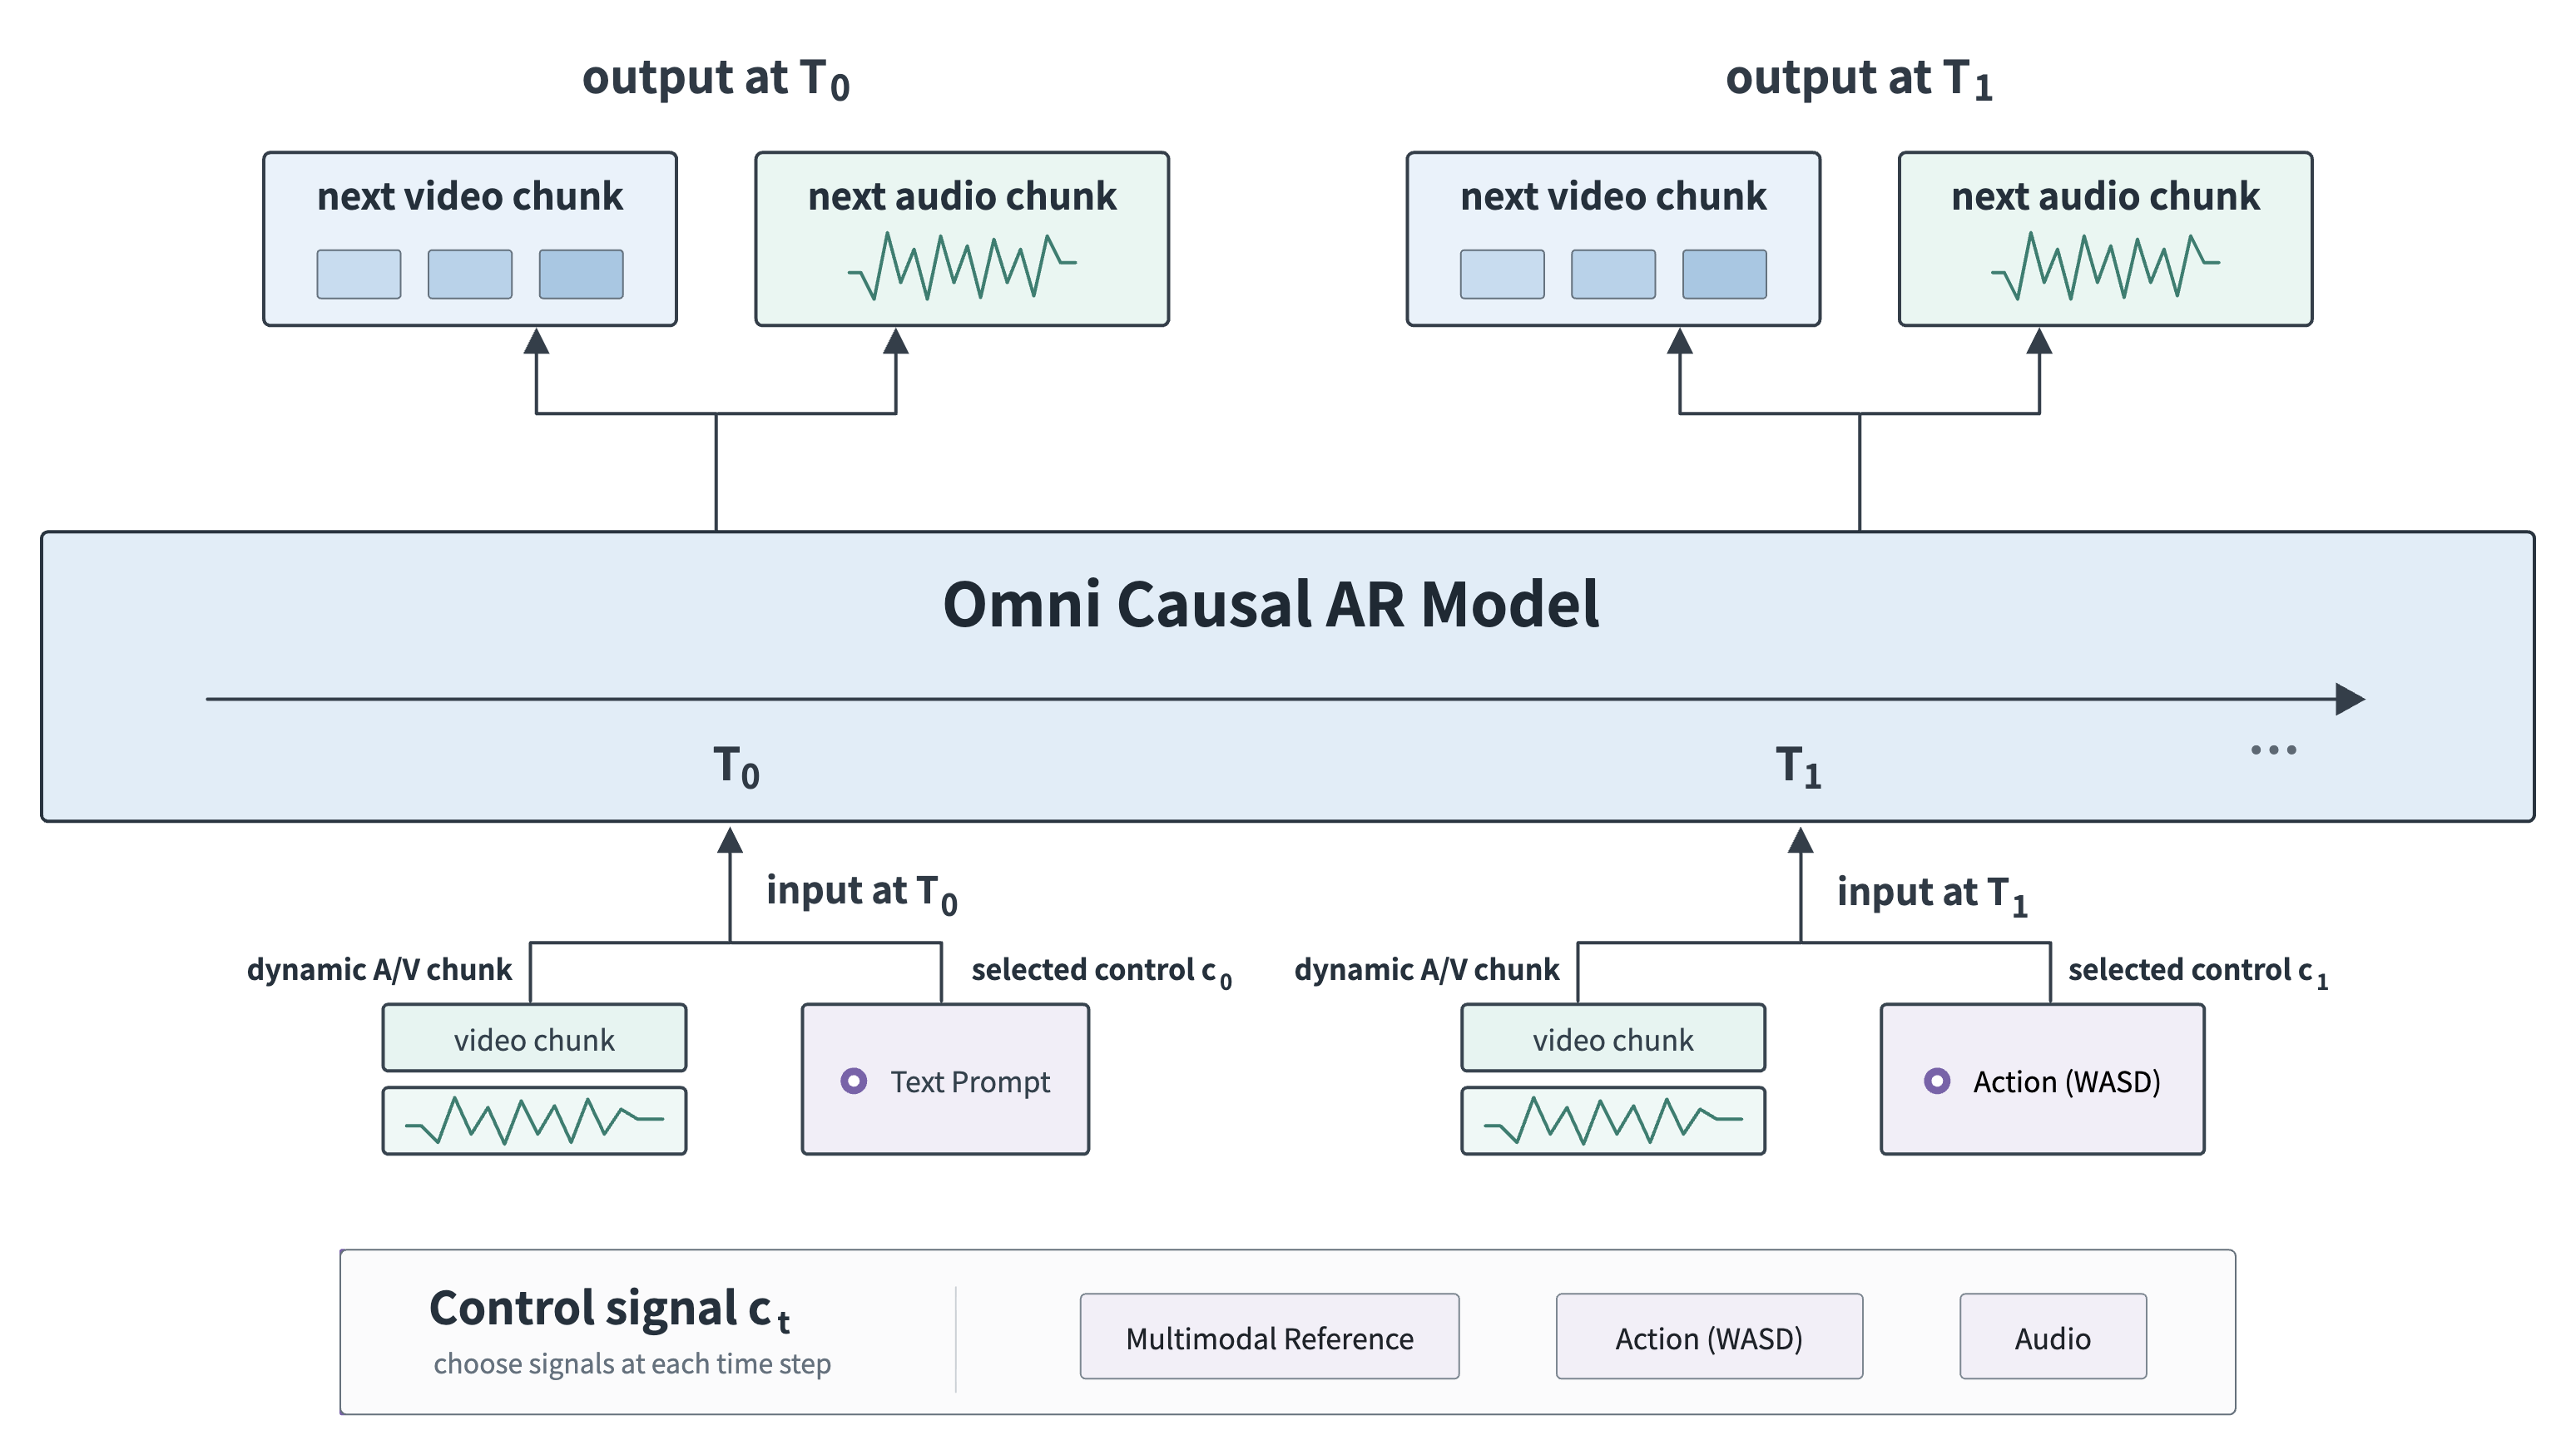
Hình 2. PixVerse R2 Omni Causal AR. Mô hình có thể tiếp tục nhận các tín hiệu điều khiển khác nhau trong một lần chạy. Tại mỗi thời điểm tương tác, tín hiệu đang hoạt động khớp với một đoạn nghe–nhìn động ở độ chi tiết tương ứng và điều khiển đoạn video cùng âm thanh tiếp theo.
Sinh chunk động
Các tín hiệu điều khiển khác nhau nằm trên những thang thời gian khác nhau. Prompt và tham chiếu thường mô tả ngữ nghĩa đầy đủ hoặc các sự kiện dài hơn. Hành động (WASD) cần phản hồi trạng thái tức thì, ở mức chi tiết cao. Âm thanh cùng lúc mang ngữ nghĩa, nhịp điệu và đồng bộ thời gian. Nếu mọi đầu vào đều bị ép vào một đơn vị thời gian có độ dài cố định, mô hình thường phải đánh đổi tốc độ phản hồi với sự trọn vẹn của cách diễn đạt.
Dynamic Chunk là cách R2 thống nhất những thang thời gian tương tác đó. R2 tách thích ứng các chuỗi nghe–nhìn theo ranh giới ngữ nghĩa và thời lượng của tín hiệu điều khiển hiện tại, với kích thước chunk tối đa nhằm giới hạn lượng tính toán và ổn định huấn luyện. Chunk ngắn cải thiện độ chính xác phản hồi cho hành động và chỉ dẫn cục bộ. Chunk dài giữ nguyên cấu trúc đầy đủ của sự kiện, chuyển động và ngữ nghĩa nghe–nhìn. Các tác vụ và tín hiệu điều khiển khác nhau có thể dùng chung một giao diện sinh nhân quả mà không cần đổi cấu trúc mô hình.
Hybrid Teacher Forcing / Diffusion Forcing
Mâu thuẫn cốt lõi của AR tầm xa là lịch sử lúc huấn luyện thường sạch hơn, trong khi lịch sử lúc chạy thực chứa nhiễu và lỗi cục bộ do chính mô hình tạo ra. Chỉ huấn luyện trên lịch sử sạch có thể nâng trần chất lượng từng bước, nhưng khiến mô hình quá nhạy với những lệch nhỏ. Chỉ huấn luyện trên lịch sử bị nhiễu có thể làm giảm chất lượng hình, chuyển động và phản hồi điều khiển.
R2 trộn lịch sử sạch và lịch sử nhiễu trong cùng một quá trình huấn luyện. Lịch sử sạch ổn định trần chất lượng của quá trình tiến hóa thế giới. Lịch sử nhiễu giúp mô hình thích ứng trước với những trạng thái chưa hoàn hảo mà nó sẽ gặp khi triển khai. Việc huấn luyện bổ trợ này thu hẹp khoảng cách giữa huấn luyện và suy luận, để mô hình vừa sinh được đoạn thế giới tiếp theo chất lượng cao, vừa tiếp tục lăn về phía trước khi lịch sử đã chứa một lỗi nhỏ.
Causal Attention Mask và Relative Temporal RoPE cùng ràng buộc lịch sử nào mà trạng thái hiện tại được đọc, và lịch sử đó nằm ở đâu trong cửa sổ hiện tại. Attention Mask áp đặt khả năng nhìn nhân quả nghiêm ngặt. Temporal RoPE không tăng không giới hạn theo ID khối toàn cục; nó được đánh chỉ mục lại theo vị trí tương đối bên trong cửa sổ attention hiện tại. Khi cửa sổ trượt tiến lên, thời gian thực vẫn tiếp tục trôi, nhưng sink memory, lịch sử gần và chunk hiện tại vẫn được ánh xạ vào một dải vị trí tương đối ổn định, có biên.
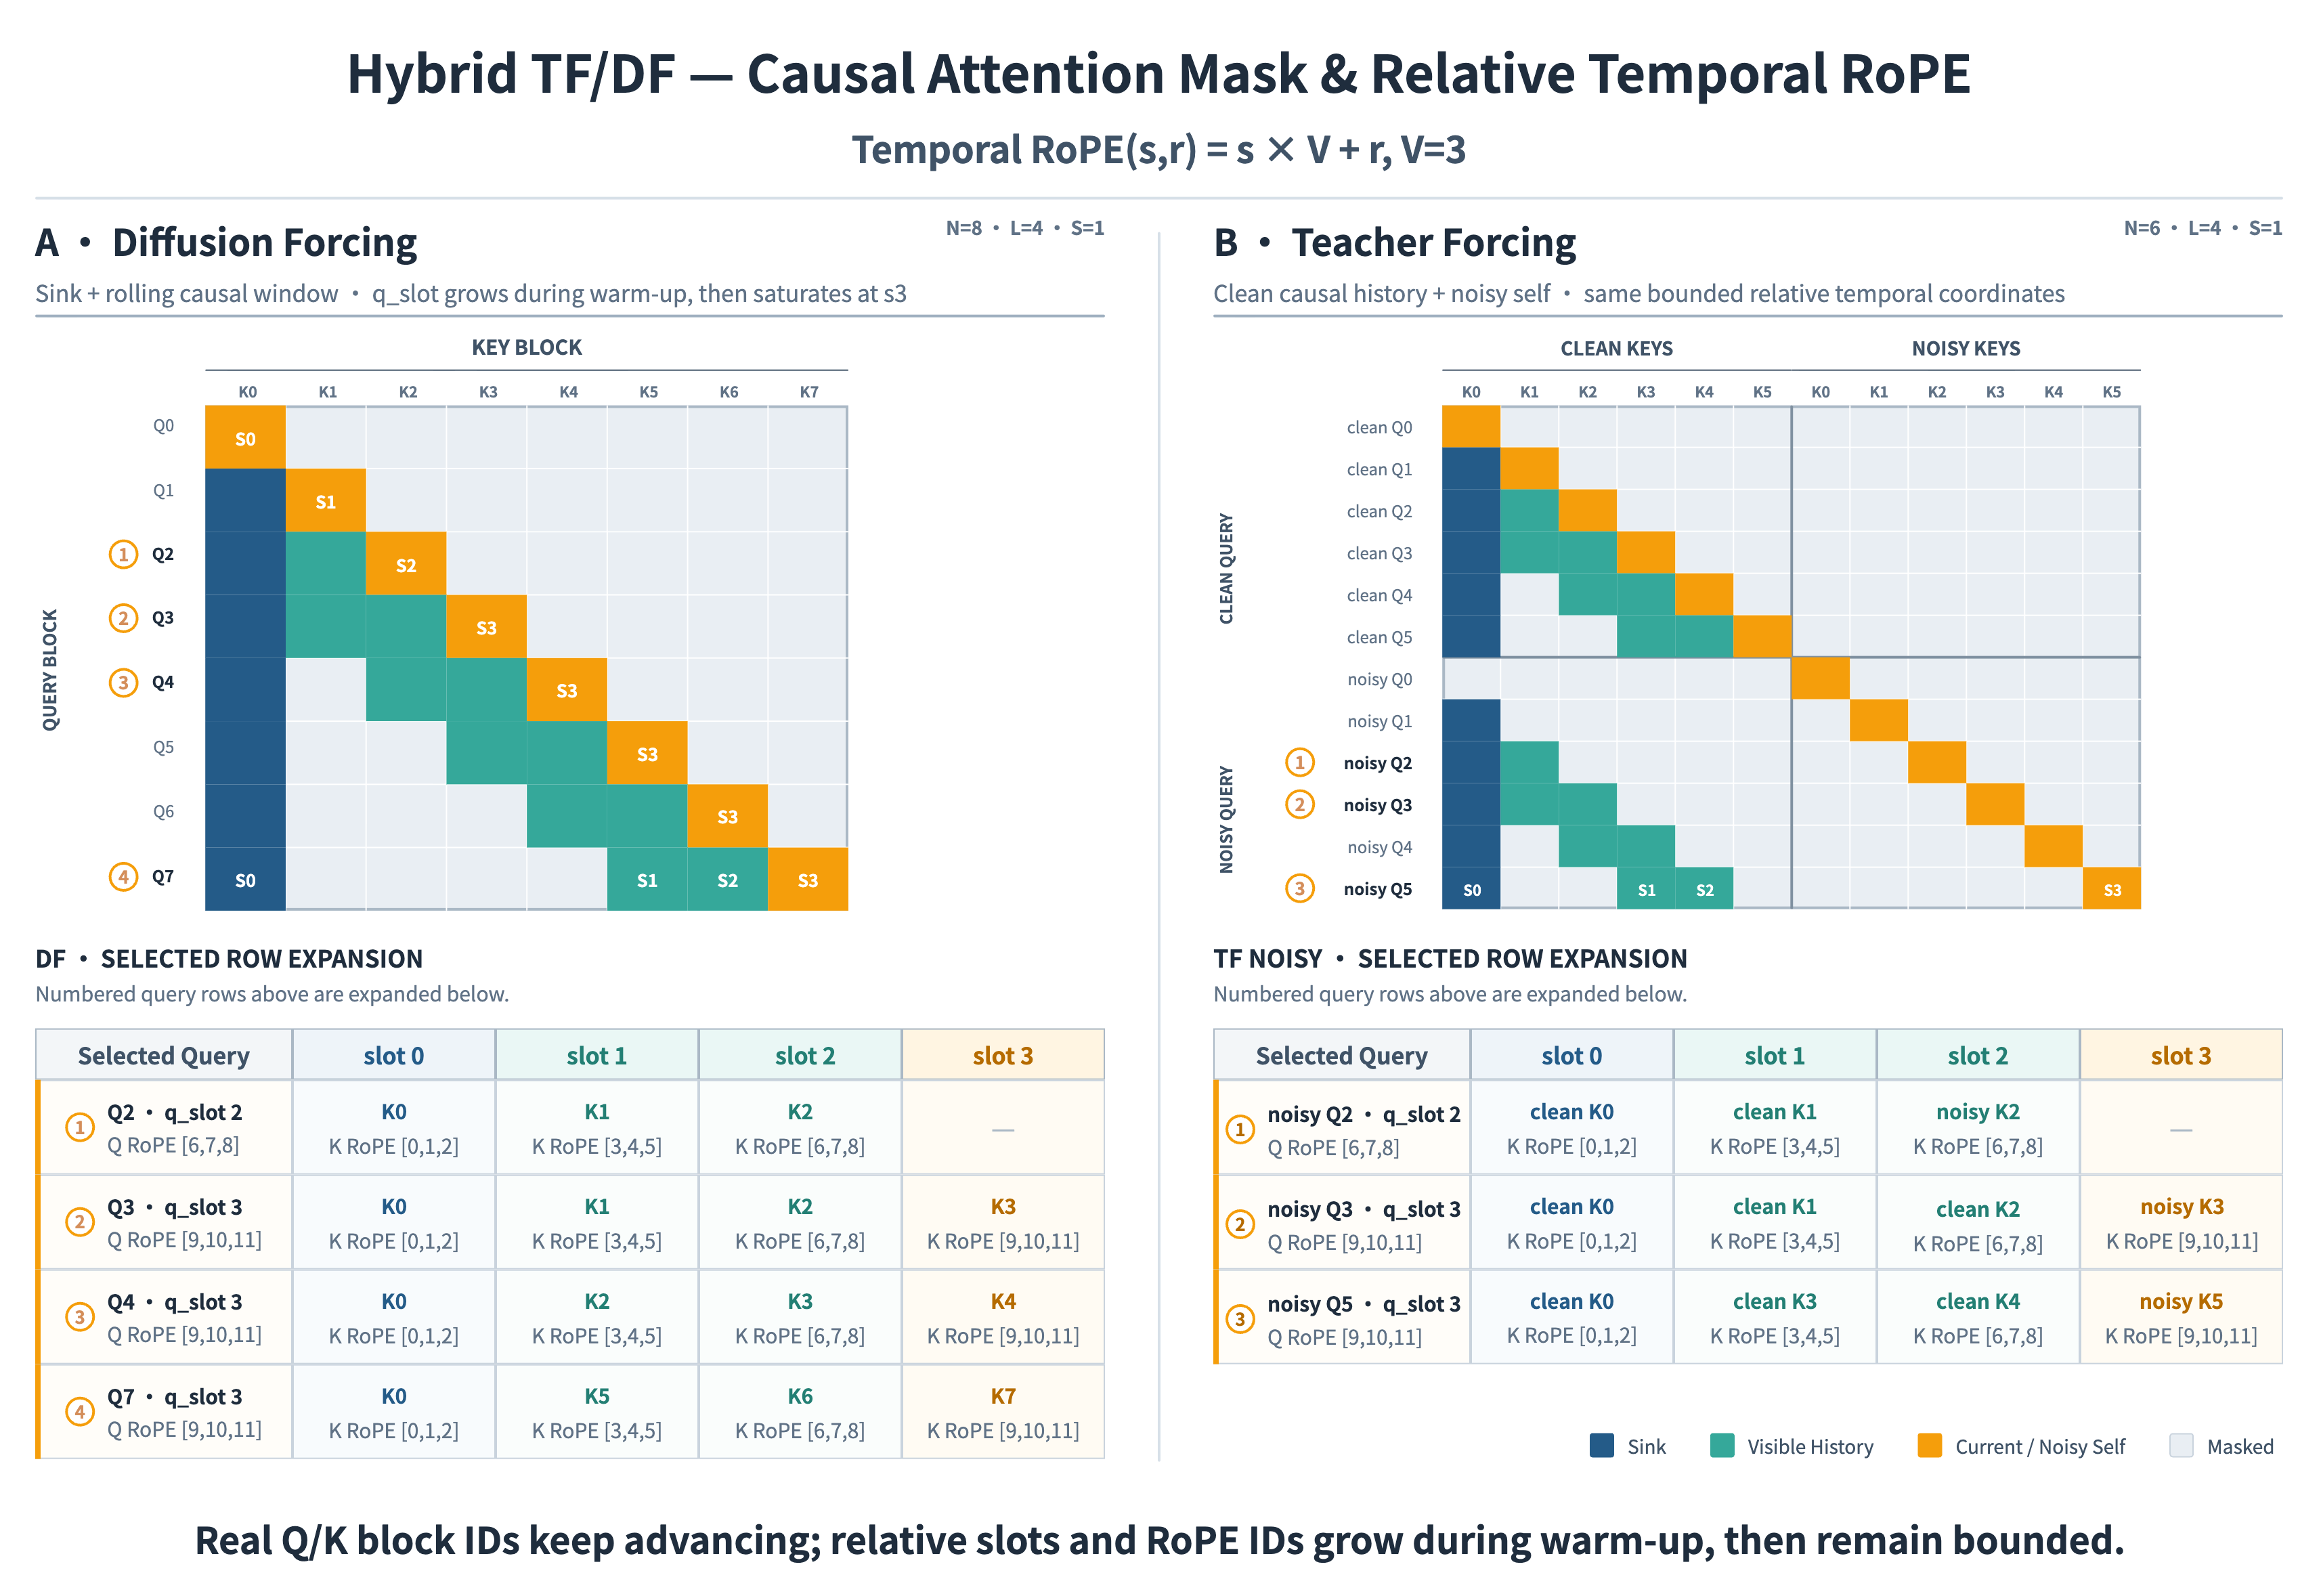
Hình 3. Mặt nạ attention nhân quả thống nhất và RoPE thời gian tương đối cho Hybrid Teacher / Diffusion Forcing. Phần trên cho thấy khả năng nhìn nhân quả của hai cách dựng lịch sử. Phần dưới ánh xạ các truy vấn đại diện tới các khối Q/K, vị trí tương đối và ID RoPE, cho thấy ID khối thực vẫn tiếp tục tăng trong khi tọa độ thời gian trong cửa sổ vẫn có biên.
Bộ nhớ đa thang thời gian
Mô hình hóa thế giới dài hạn không thể chỉ đơn giản ghi nhớ toàn bộ lịch sử. Lịch sử không giới hạn làm chi phí tính toán và bộ nhớ tăng nhanh; cắt quá mạnh sẽ làm mất nhận dạng nhân vật, bố cục cảnh và các sự kiện then chốt. R2 xây một hệ bộ nhớ đa tỷ lệ từ Sink Memory, Rolling History và Object KV Cache.
- Sink Memory lưu các mỏ neo dài hạn như nhân vật, cảnh, phong cách và quy tắc thế giới.
- Rolling History tập trung vào hành động, tư thế, camera và thay đổi môi trường gần đây để trạng thái cục bộ nối tiếp một cách tự nhiên.
- Object KV Cache tái sử dụng và nén các biểu diễn lịch sử cấp đối tượng đã tính sẵn, giữ lại những trạng thái thực sự ảnh hưởng đến sự tiến hóa sau này trong một ngân sách có hạn.
Ba thành phần này cùng mang lại sự ổn định danh tính dài hạn, tính liên tục chuyển động tầm ngắn và chi phí chạy có thể kiểm soát, đồng thời giảm trôi nhân vật, nhảy cảnh, nhấp nháy giữa các chunk và hành động bị đứt.
Error Bank
Độ trôi nghiêm trọng trong một mô hình thế giới AR thường bắt đầu từ một lỗi nhỏ sớm được ghi vào lịch sử rồi được kế thừa. R2 xây một Error Bank lưu các lịch sử lỗi tiêu biểu như mẫu tái sử dụng và phát lại chúng vào lịch sử bình thường với một tỷ lệ nhất định trong lúc huấn luyện. Mô hình không còn chỉ học cách tiếp tục từ một trạng thái lý tưởng; nó còn học cách nhận ra, hấp thụ và sửa lịch sử đã bị trôi.
Trong đánh giá theo giai đoạn, chỉ số trôi độ sáng dài hạn giảm từ 0.201 xuống 0.129, khoảng 35,8%. Trong 29 mẫu chuỗi dài, 20 mẫu được cải thiện, và cả 5 mẫu được yêu cầu rõ ràng phải đứng yên đều giảm chuyển động sai.
Tăng tốc thời gian thực
Lớp tăng tốc thời gian thực của R2 không học lại một thế giới tầm xa bên trong một mô hình vài bước. Nó tăng tốc một mô hình thế giới vốn đã có thể chạy ổn định trong thời gian dài. Lớp tăng tốc bắt đầu từ Omni Causal AR đã được tiền huấn luyện liên tục và dùng nó cho cả khởi tạo ODE của student lẫn teacher chưng cất, để teacher, student và suy luận AR thực cùng chia sẻ một phân phối quỹ đạo nhân quả nhất quán.
Điểm xuất phát nhân quả thống nhất đó giảm sự phụ thuộc vào kiểu tinh chỉnh Self-Forcing và Rolling Forcing. Tăng tốc thời gian thực có thể tập trung vào những vấn đề mà tốc độ vài bước thực sự gây ra: DDMD với regularization đối kháng xử lý căn chỉnh điều kiện, phân phối sinh và tính chân thực trong lúc chưng cất; block-sparse attention nén tính toán ngữ cảnh dài; và một đường pyramid hạ chi phí sinh ở độ phân giải cao.
DDMD với regularization đối kháng
Trong sinh nội dung cực ít bước, căn chỉnh điều kiện, khớp phân phối và tính chân thực không phải cùng một bài toán tối ưu. R2 dựa trên DDMD và tiếp tục đưa regularization đối kháng từ DMD2. Ba tín hiệu huấn luyện gặp nhau trong một student: căn chỉnh điều kiện tăng cường khả năng điều khiển, khớp phân phối giữ phân phối của teacher, và regularization đối kháng neo vào dữ liệu thực, để ít bước lấy mẫu vẫn giữ được cả phản hồi tương tác chính xác lẫn một thế giới đáng tin.
Block-sparse attention
R2 dùng block-sparse attention trên các chuỗi token không–thời gian. Mô hình chia Q, K và V thành các khối tính toán, nhanh chóng ước lượng khối key/value nào mà mỗi khối query cần nhất, chỉ giữ các kết nối có điểm cao nhất, rồi chạy softmax attention chính xác trên những khối đã chọn. Định tuyến cấp khối không phải cắt ngẫu nhiên; nó dồn tính toán vào các phụ thuộc mạnh giữa điều khiển đa phương thức hiện tại, chuyển động gần đây và trạng thái thế giới then chốt.
Bằng cách thích ứng mô hình với cấu trúc kết nối thưa trong lúc huấn luyện, R2 nâng độ thưa của attention lên trên 90%, đồng thời giữ chất lượng hình, tính liên tục hành động, mức độ bám điều kiện và sự ổn định tầm xa mà không có mức giảm rõ trong đánh giá hiện tại.
Chưng cất pyramid cực ít bước
Làm toàn bộ mô hình hóa thế giới từ đầu trong không gian độ phân giải cao sẽ lãng phí tính toán vào cấu trúc toàn cục mà độ phân giải thấp hơn đã xác định được. R2 tổ chức việc sinh thành một hoặc hai giai đoạn độ phân giải thấp cộng một giai đoạn độ phân giải cao. Các giai đoạn độ phân giải thấp thiết lập bố cục cảnh, chuyển động chủ thể và cấu trúc camera. Giai đoạn độ phân giải cao khôi phục kết cấu, cạnh và chi tiết cục bộ. Đường từ thô đến mịn cắt bớt tính toán độ phân giải cao lặp lại, đồng thời giữ sự ổn định cấu trúc và chi tiết tốt hơn.
Kết luận và giới hạn
PixVerse R1 đã đề xuất và phát hành mô hình thế giới video thời gian thực đầu tiên, cho thấy video có thể đi từ nội dung cố định ngoại tuyến sang một thế giới động có thể tương tác theo thời gian thực và tiếp tục chạy. PixVerse R2 sau đó giải quyết cách mô hình này tiếp tục mở rộng: một Omni Causal AR thống nhất mang dữ liệu, tác vụ, phương thức và thang thời gian ngày càng lớn, còn Real-Time Acceleration đưa đầy đủ năng lực mô hình hóa thế giới vào suy luận vài bước theo thời gian thực.
R2 không phải một nâng cấp năng lực đơn điểm. Đó là một lộ trình huấn luyện thống nhất cho thế hệ mô hình thế giới thời gian thực tiếp theo. R1 biến mô hình thế giới video thời gian thực thành hiện thực. R2 đưa chúng vào một giai đoạn thống nhất, có thể mở rộng và liên tục được cải thiện.
Trong một ngân sách tính toán thời gian thực và độ trễ tương tác chặt, chất lượng của một lần sinh hiện tại vẫn còn khoảng để cải thiện so với các mô hình video ngoại tuyến dẫn đầu, đặc biệt ở chi tiết cảnh phức tạp, độ tự nhiên của chuyển động, tính nhất quán vật lý và sự ổn định trên các lần chạy dài. Những khoảng cách đó thường phản ánh giai đoạn mở rộng hiện tại của R2 hơn là trần của chính khung này.
Truy cập sớm
Tính đến ngày 23 tháng 8 năm 2026, báo cáo này mô tả PixVerse R2 đang ở giai đoạn thử nghiệm kín. Ngày 22 tháng 9 năm 2026, PixVerse thông báo một bộ các thế giới này đã mở để khám phá tại world.pixverse.video. Xem thông báo ra mắt R2.
Thông báo đó không mở quyền truy cập API không hạn chế. Biểu mẫu trải nghiệm mô hình thế giới PixVerse R2 vẫn là đường yêu cầu cho trải nghiệm sớm và quyền truy cập API.
Tài nguyên liên quan
- Giải thích PixVerse R1: Mô hình thế giới video AI thời gian thực
- Đi sâu vào PixVerse Game Engine
- PixVerse cập nhật R1 với Shared Worlds
- Hướng dẫn sinh video AI thời gian thực
- PixVerse khép lại vòng mở rộng Series C
Các thế giới từ thông báo ngày 22 tháng 9 năm 2026 đã mở để khám phá tại world.pixverse.video. Quyền truy cập API vẫn được yêu cầu qua biểu mẫu ở trên. Bạn cũng có thể sáng tạo với PixVerse V6 và R1 ngay hôm nay.