PixVerse R2: Pag-scale ng Real-Time Omni World Models
Ipinakilala at inilabas ng PixVerse R1 ang unang real-time video world model, na ginawang ang pagbuo ng video mula sa one-shot na paghahatid ng isang fixed na clip tungo sa isang patuloy na tumatakbong mundo. Patuloy na makakatanggap ang modelo ng input ng user, maa-update ang world state nang real time, at mag-stream ng naka-synchronize na audio at video na nananatiling consistent sa interaction. Ipinakita ng R1 na maaaring gumana ang teknikal na paradigm na ito.
Sinusagot ng PixVerse R2 ang susunod na tanong: paano patuloy na nagsa-scale ang isang real-time video world model. Nakatuon ang R2 sa dalawang layunin. Una, bumubuo ito ng isang dynamic na mundong kayang humawak ng pinag-isang state sa mahahabang horizon, na ginagawang world evolution ang buong spatiotemporal prior na pasulong lamang sa panahon. Ikalawa, patuloy nitong ini-internalize ang physical causality at interaction signal mula sa text, reference, audio, at action sa isang modelong iisa, kaya ang mundo ay maaaring bumuo, tumanggap ng control, at mag-update ng state nang sabay habang nag-i-stream ng naka-synchronize na audio at video.
Sa paligid ng mga layuning iyon, ginagawang ng R2 ang paglago sa modelo, data, gawain, control signal, at time scale bilang mga kita sa kalidad ng pagbuo, long-range consistency, at multimodal control.
Pangkalahatang Framework
Pinapaliit ng R2 ang sistema sa dalawang pangunahing layer: Omni Causal AR at Real-Time Acceleration. Patuloy na pinalalawak ng Omni Causal AR ang mataas na kalidad, multimodal, at long-horizon na pagbuo ng mundo. Minamana ng Real-Time Acceleration ang mga kakayahang iyon nang pinaka-lossless na posible sa ilalim ng mahigpit na interaction-latency budget. Malinaw ang landas: itaas ang capability ceiling ng world model, pagkatapos ay pabilisin ang kakayahang iyon tungo sa isang real-time at interactive na operating range.
Ang mas lumang long-video at real-time pipeline ay karaniwang nagkakaugnay ng maraming yugto ng pagsasanay: gawing AR model ang isang bidirectional model, bumuo ng distillation teacher mula sa isang task-specific bidirectional model, magpatakbo ng DMD distillation, pagkatapos ay magdagdag ng self-rollout DMD upang isara ang train-inference gap. Ang bawat yugto ay kailangang muling ilipat ang kakayahan, muling ihanay ang mga layunin, at muling iangkop ang data distribution. Ang kalidad ng larawan, galaw, pagsunod sa kondisyon, at long-horizon stability ay maaaring humina sa mga paglilipat na iyon. Habang lumalaki ang scale ng modelo, data, at gawain, hinati ng multi-stage pipeline ang optimization target at itinaas ang parehong gastos sa pagsasanay at pagiging kumplikado ng sistema.
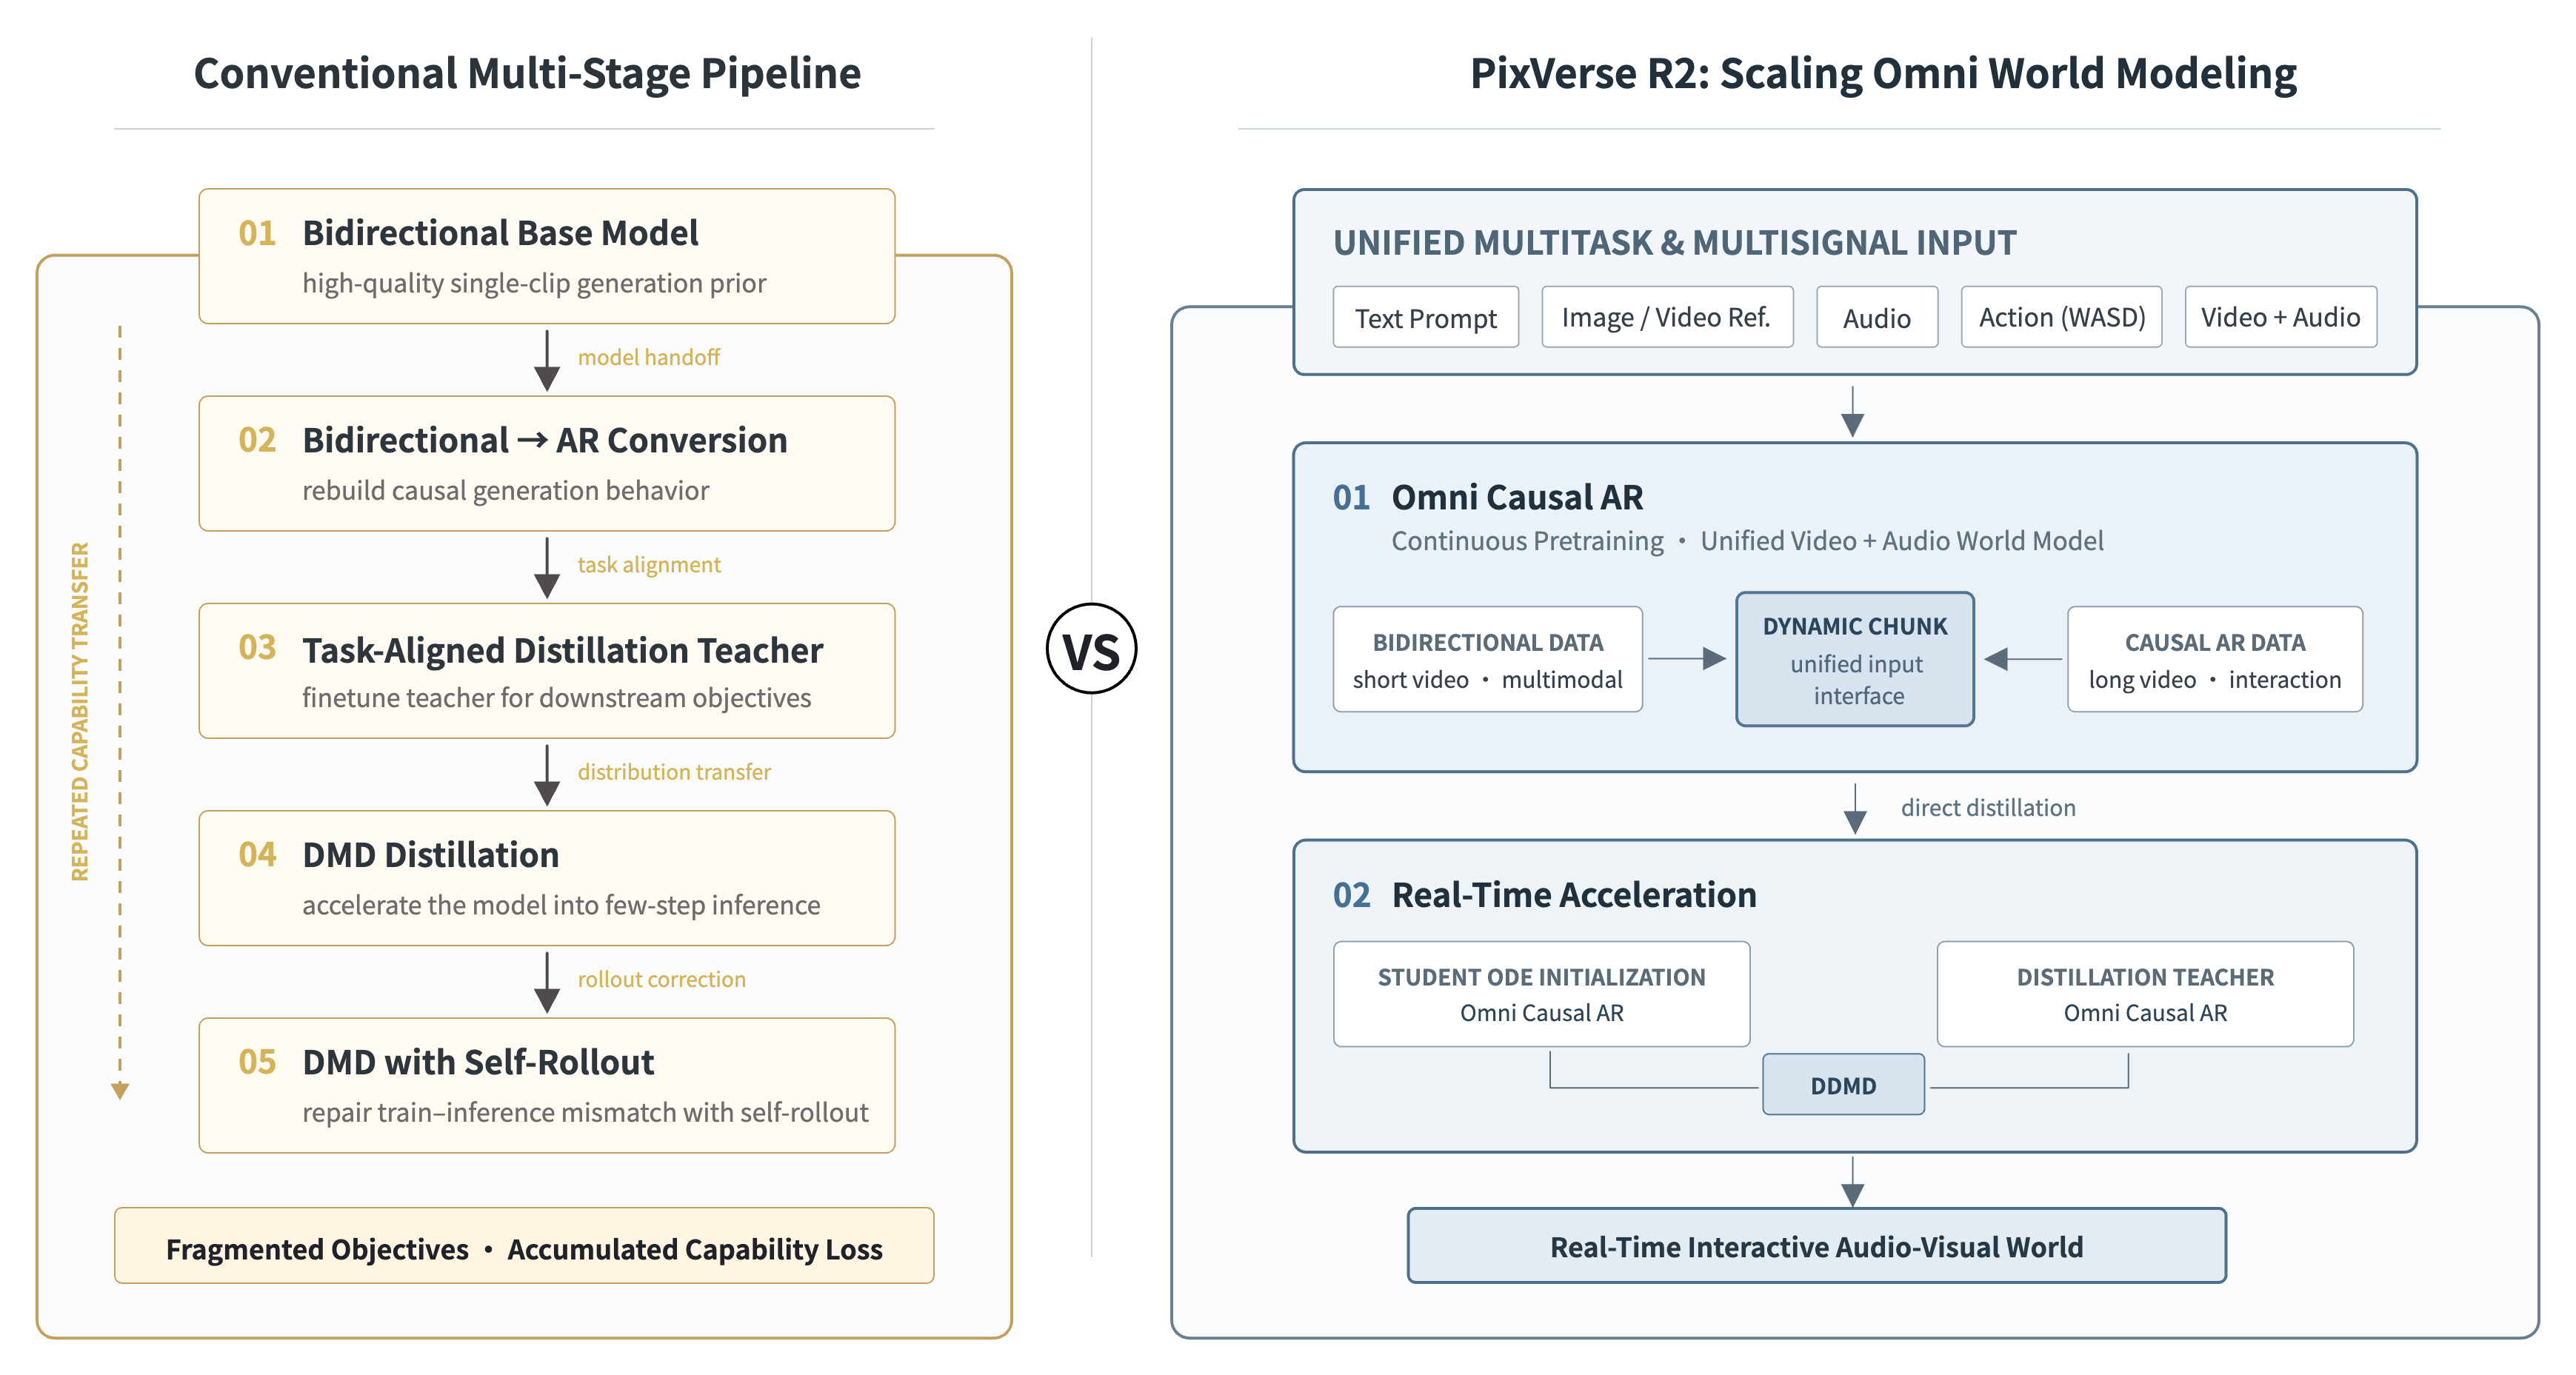
Figure 1. Legacy na multi-stage pipeline laban sa scaling world modeling ng PixVerse R2. Pinagtatagpo ng R2 ang pagpapalawak ng kakayahan at real-time distillation sa Omni Causal AR at isang real-time acceleration layer, na pinag-iisa ang multi-task, multi-signal, at long-video modeling sa isang framework.
Iminumungkahi ng PixVerse R2 ang isang pinag-isang training paradigm para sa real-time world models. Sa halip na paulit-ulit na ilipat ang kakayahan sa maraming modelo at yugto ng gawain, pinapaliit nito ang kumplikadong pipeline sa dalawang prosesong patuloy na makakapag-scale: patuloy na i-pretrain ang isang Omni Causal AR na humahawak ng pinag-isang world state, pagkatapos ay i-distill ito nang direkta sa isang accelerated na modelong kayang bumuo nang real time habang minamana ang spatial consistency at long-horizon modeling.
Ang mas kaunting hangganan ng yugto ay nagpapababa ng pagkawala ng kakayahan na nagmumula sa independiyenteng mga teacher, task alignment, at paulit-ulit na paglilipat ng modelo. Ang bagong data, gawain, control signal, at model scale ay maaaring mas direktang maging real-time world-modeling ability.
Yugto 1: continual pretraining ng Omni Causal AR. Hindi na tinatrato ng R2 ang bidirectional generation prior at long-video AR bilang dalawang hindi magkaugnay na yugto. Patuloy nitong sinasanay ang isang pinag-isang Omni Causal AR sa ibabaw ng kakayahan ng bidirectional model. Ang dynamic chunks ay nagbibigay sa iba’t ibang anyo ng data ng isang pinagsasaluhang temporal representation: maaaring saluhin ng modelo ang mataas na kalidad na maikling video at multimodal data mula sa bidirectional pretraining, at maaari itong lumawak tungo sa tuloy-tuloy na mahabang video at multi-turn interaction trajectory. Ang kalidad ng larawan, audiovisual expression, long-horizon generation, at multi-signal control ay maaaring mag-scale sa loob ng isang modelo sa halip na muling ilipat sa pamamagitan ng paulit-ulit na conversion.
Yugto 2: i-distill ang isang real-time acceleration layer mula sa na-scale na Omni Causal AR. Ang continual pretraining ay nagbibigay sa Omni Causal AR ng mataas na kalidad na pagbuo, matatag na long-horizon state transfer, at tunay na causal rollout nang sabay. Ginagamit pagkatapos ng R2 ang parehong Omni Causal AR para sa student ODE initialization at sa distillation teacher, kaya ang teacher, student, at tunay na AR inference ay may iisang consistent na causal modeling base. Ang real-time distillation ay nagiging “few-step acceleration ng isang umiiral na world model,” hindi “muling pag-aaral ng isang long-horizon na mundo.”
Omni Causal AR
Ipinagpapatuloy ng R2 ang multimodal input, autoregressive generation, at real-time interaction path na napatunayan na ng R1, pagkatapos ay itinuon ang mga kakayahang iyon sa isang pinag-isang ruta ng pagsasanay ng Omni Causal AR. Ginagawang ng Omni Causal AR ang buong spatiotemporal generation prior bilang world-state transfer na pasulong lamang sa panahon. Sa pamamagitan ng causalization at continual pretraining, pinananatili ng modelo ang kakayahan sa larawan, galaw, audio, at multimodal semantic habang natututong hulaan ang susunod na naka-synchronize na audiovisual chunk mula sa kasaysayan lamang.
Habang lumalawak ang mga training object mula sa independiyenteng maikling video tungo sa tuloy-tuloy na mahabang video at multi-turn interaction trajectory, unti-unting binubuo ng modelo ang pangmatagalang causality sa pagitan ng historical world state, kasalukuyang interaction input, at hinaharap na world evolution.
Sabay na tinatanggap ng modelo ang text prompt, multimodal na mga reference, action signal (halimbawa, WASD o continuous control), at audio, at naglalabas ito ng naka-synchronize na video at audio. Maaaring patuloy na pumasok ang iba’t ibang control signal sa modelo habang tumatakbo ito at baguhin ang susunod na world state. Hindi lang tumutugon ang R2 sa isang one-shot na kondisyon; kaya nitong bumuo, tumanggap ng control, at i-update ang mundo nang sabay.
Para mapanatili ang causal generation sa loob ng iisang mundo sa mahabang run, tinutugunan ng R2 ang apat na problema: train-inference distribution gap, robustness sa maingay na history, koordinasyon ng long-term at kamakailang memory, at pagwawasto ng error state. Hinahayaan ng Hybrid Teacher / Diffusion Forcing na umangkop ang modelo sa malinis at maingay na history. Sabay na iniimbak ng Multi-Timescale Memory ang world anchor, kamakailang dynamics, at object state. Ibinalik ng Error Bank ang mga nabigong state sa training. Sama-sama, bumubuo ang mga ito ng training loop para sa long-term world state at binabawasan ang drift sa larawan, karakter, galaw, audio-visual na ugnayan, at control response sa paglipas ng panahon.
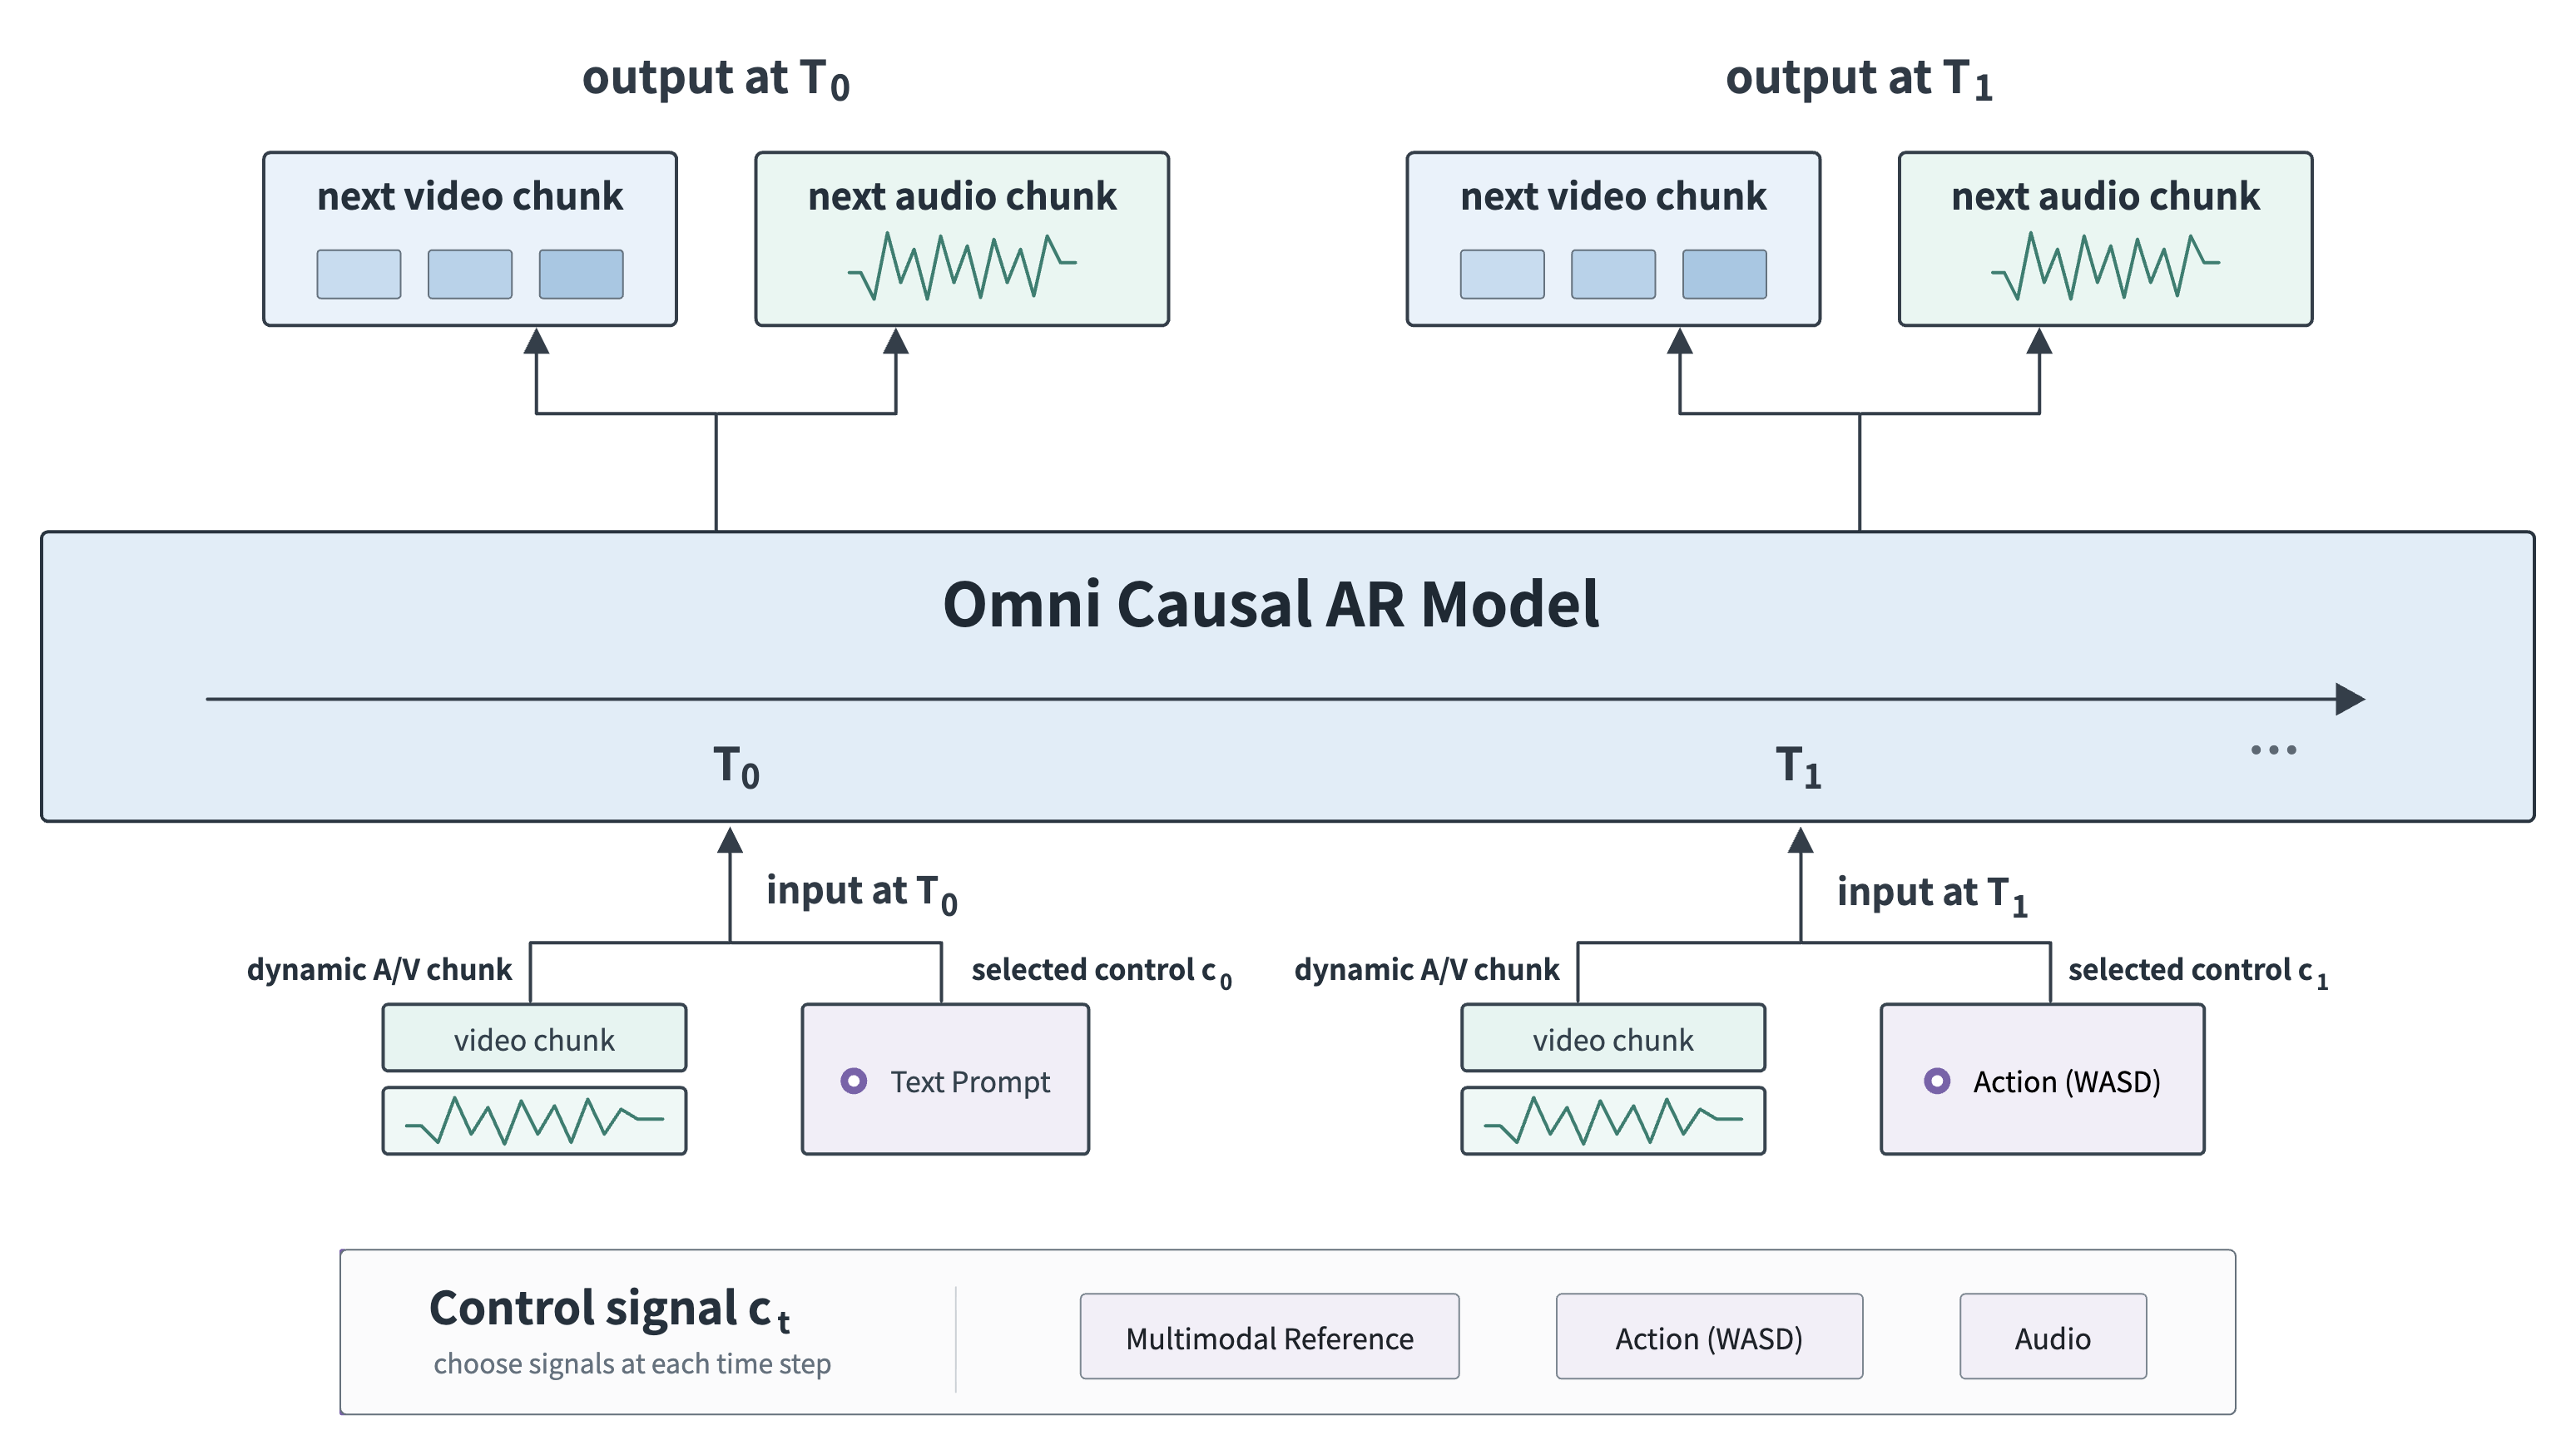
Figure 2. PixVerse R2 Omni Causal AR. Patuloy na makakatanggap ang modelo ng iba’t ibang control signal habang tumatakbo. Sa bawat sandali ng interaksyon, nakaayon ang aktibong signal sa isang dynamic na audiovisual chunk sa katugmang granularity at itinutulak nito ang susunod na segment ng video at audio.
Dynamic chunk generation
Nakatira ang iba’t ibang control signal sa magkakaibang timescale. Karaniwang inilalarawan ng mga prompt at reference ang buong semantics o mas mahahabang pangyayari. Kailangan ng action (WASD) ang pinong, agarang state feedback. Sabay na dala ng audio ang semantics, ritmo, at temporal sync. Kung pipilitin ang bawat input sa fixed-length na time unit, madalas na kailangang ipagpalit ng modelo ang bilis ng tugon sa pagkakumpleto ng ekspresyon.
Ang Dynamic Chunk ang paraan ng R2 para pag-isahin ang mga timescale ng interaksyon. Adaptive na hinahati ng R2 ang audiovisual sequence ayon sa semantic boundary at tagal ng kasalukuyang control signal, na may maximum chunk size na naglilimita sa compute at stability ng training. Pinapaganda ng maiikling chunk ang katumpakan ng tugon para sa action at lokal na instruction. Pinapanatili ng mahahabang chunk ang buong istruktura ng mga pangyayari, galaw, at audiovisual semantics. Maaaring magbahagi ang iba’t ibang task at control signal ng iisang causal generation interface nang hindi pinapalitan ang istruktura ng modelo.
Hybrid Teacher Forcing / Diffusion Forcing
Ang pangunahing tensyon sa long-horizon AR ay mas malinis kadalasan ang training history, samantalang ang tunay na runtime history ay naglalaman ng sariling ingay at lokal na error ng modelo. Ang pagsasanay lamang sa malinis na history ay maaaring magtaas ng ceiling ng kalidad sa isang hakbang ngunit gawing masyadong sensitibo ang modelo sa maliliit na paglihis. Ang pagsasanay lamang sa perturbed history ay maaaring makasakit sa kalidad ng larawan, galaw, at control response.
Hinahalo ng R2 ang malinis na history at maingay na history sa iisang proseso ng training. Pinapatatag ng malinis na history ang ceiling ng kalidad ng ebolusyon ng mundo. Hinahayaan ng maingay na history na umangkop nang maaga ang modelo sa hindi perpektong state na makikita nito sa deployment. Pinaliit ng komplementaryong training ang train-inference gap, kaya makabubuo ang modelo ng mataas na kalidad na susunod na world segment at patuloy na uunlad kahit may maliit nang error ang history.
Sabay na nililimitahan ng Causal Attention Mask at Relative Temporal RoPE kung aling history ang mababasa ng kasalukuyang state at kung saan nakapuwesto ang history na iyon sa kasalukuyang window. Ipinapatupad ng Attention Mask ang mahigpit na causal visibility. Hindi lumalaki nang walang hangganan ang Temporal RoPE kasama ng global block ID; muling ini-index ito ayon sa relative slot sa loob ng kasalukuyang attention window. Kapag umusad ang rolling window, patuloy na umuusad ang totoong oras, ngunit nananatiling nakamap ang sink memory, kamakailang history, at kasalukuyang chunk sa matatag at may hangganang relative position range.
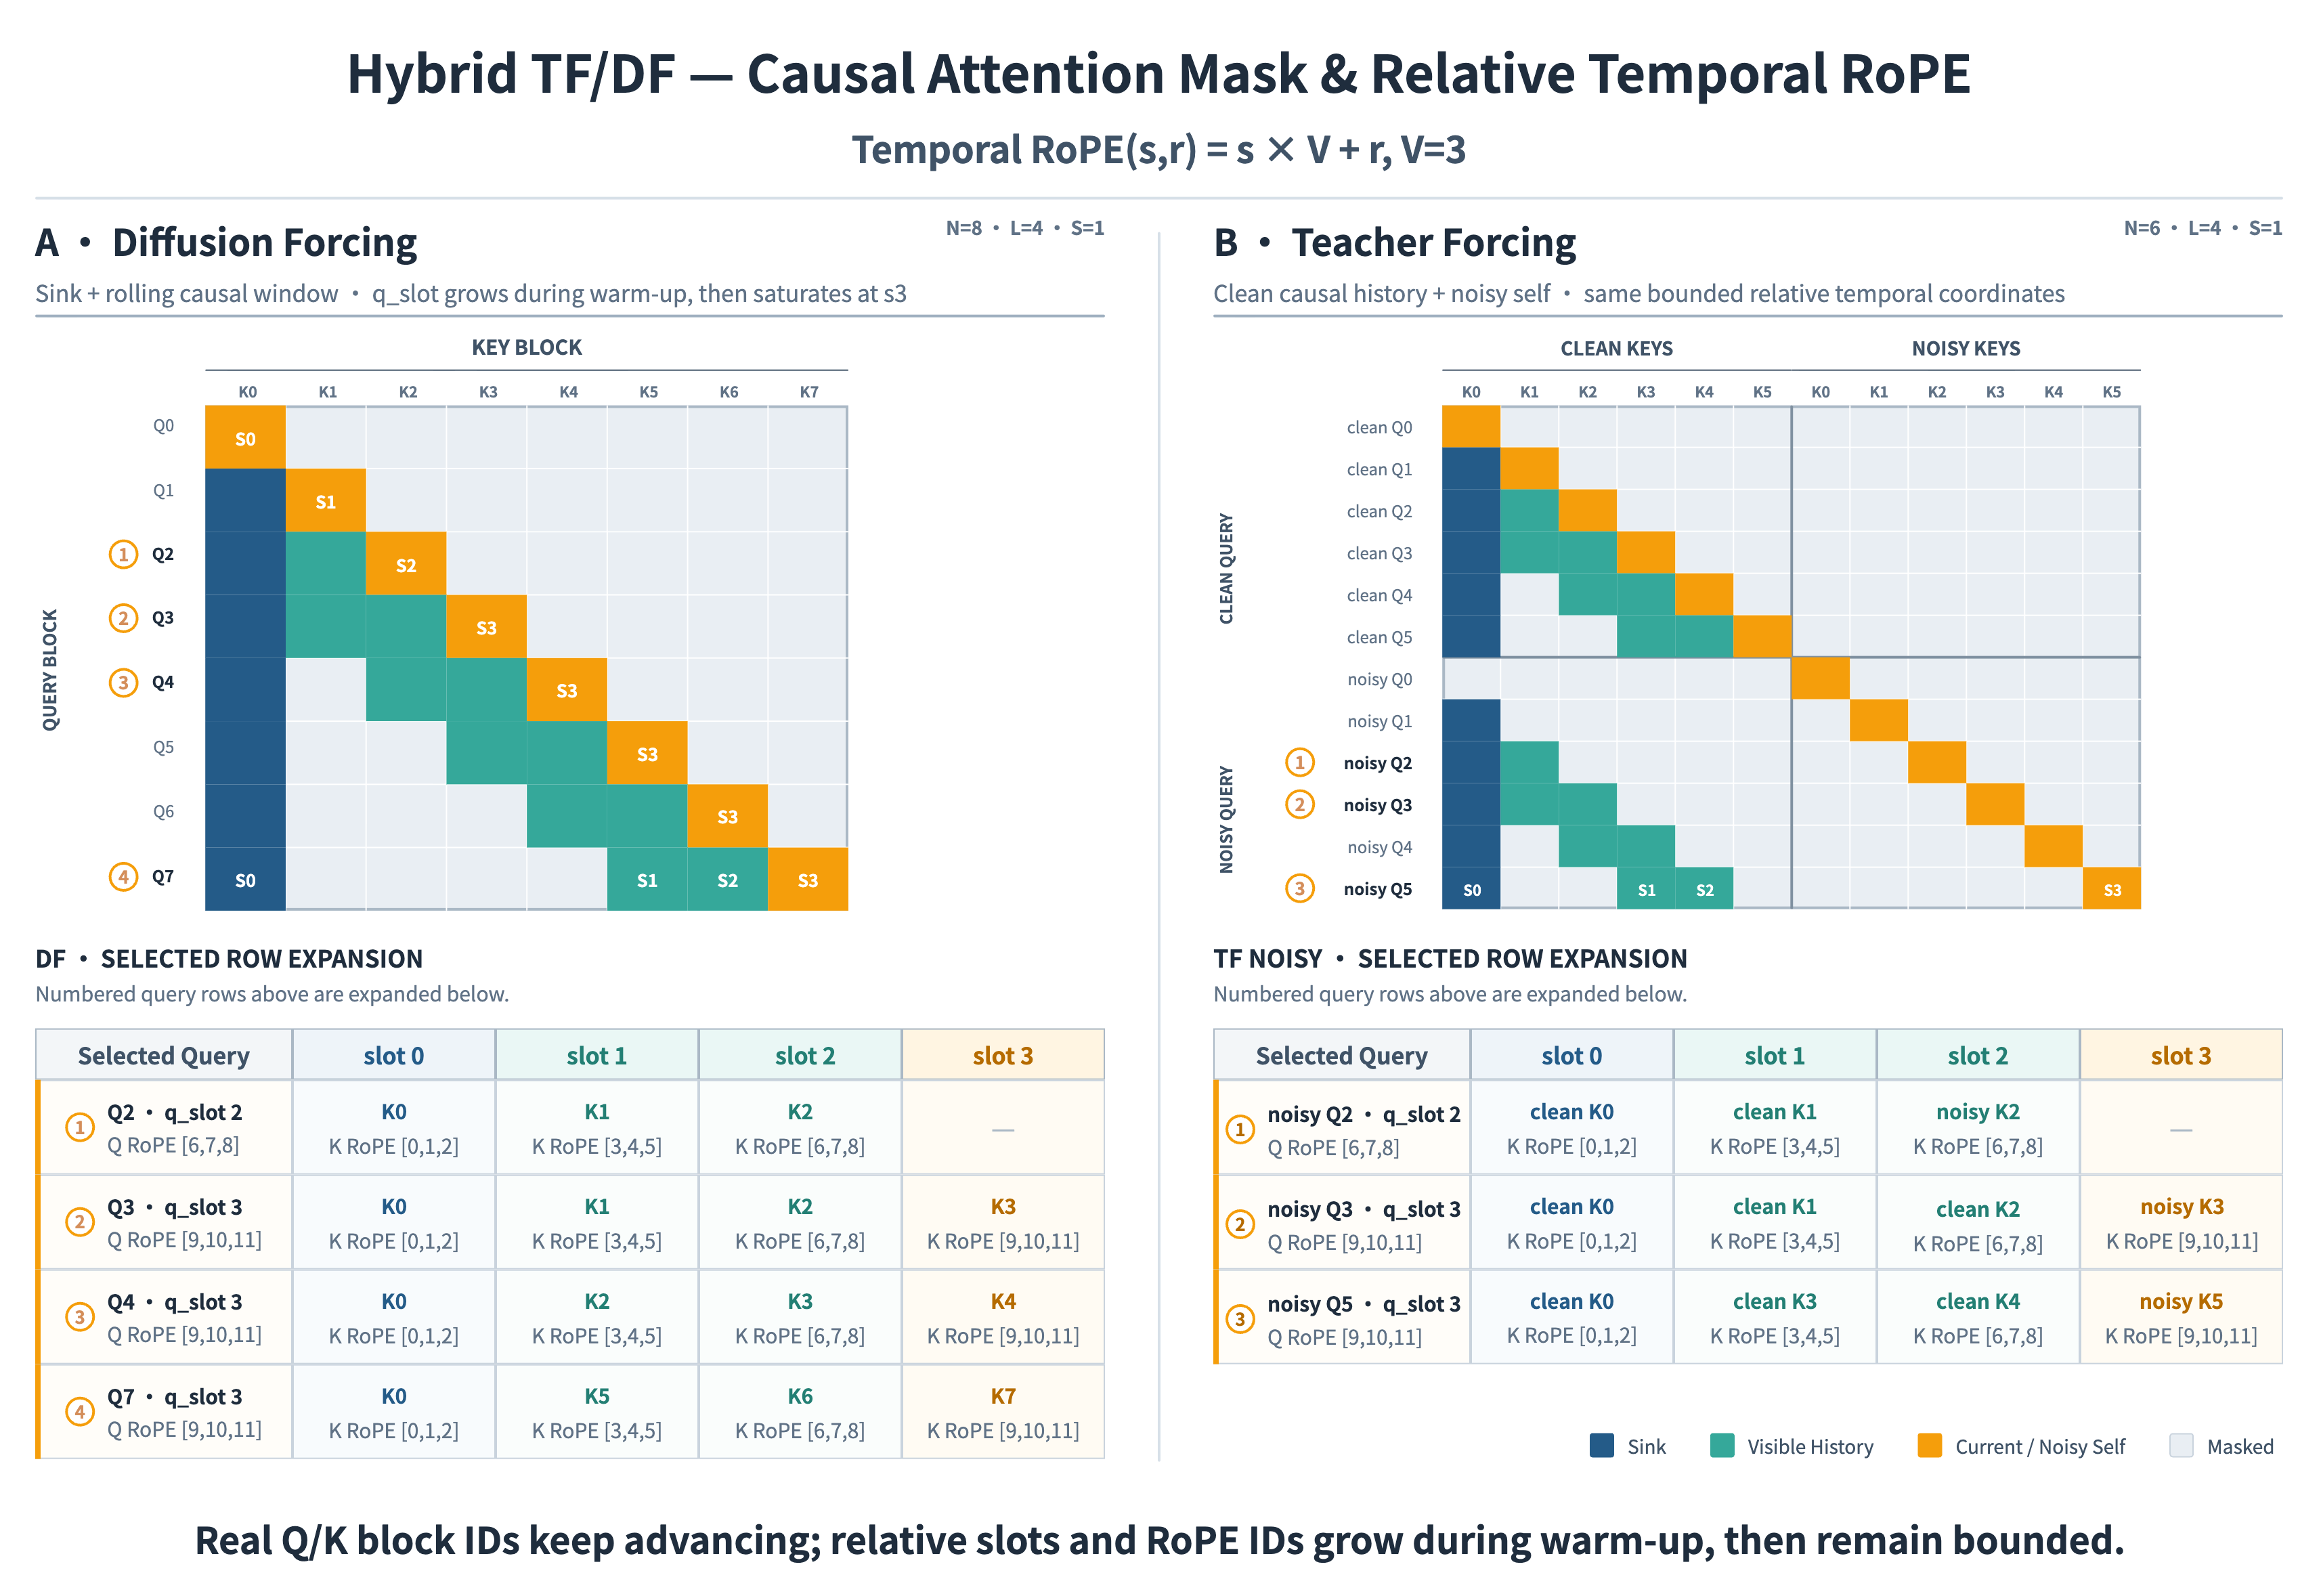
Figure 3. Pinag-isang causal attention mask at relative temporal RoPE para sa Hybrid Teacher / Diffusion Forcing. Ipinapakita sa itaas ang causal visibility para sa dalawang pagbuo ng history. Iniuugnay sa ibaba ang mga kinatawang query sa Q/K block, relative slot, at RoPE ID, na nagpapakitang patuloy na umuusad ang totoong block ID habang nananatiling may hangganan ang in-window time coordinate.
Multi-timescale memory
Hindi sapat na tandaan lang ang lahat ng history sa long-term world modeling. Mabilis na itinataas ng walang hangganang history ang gastos sa compute at memory; ang sobrang pagputol naman ay nagpapabagsak ng character identity, scene setup, at mahahalagang pangyayari. Bumubuo ang R2 ng multi-scale memory system mula sa Sink Memory, Rolling History, at Object KV Cache.
- Sink Memory ang nag-iimbak ng long-term na mga anchor tulad ng karakter, eksena, istilo, at world rule.
- Rolling History ang nakatuon sa kamakailang action, pose, camera, at pagbabago sa kapaligiran para natural na magkadugtong ang lokal na state.
- Object KV Cache ang muling gumagamit at nagko-compress ng naka-compute nang object-level history representation, na pinapanatili sa limitadong budget ang mga state na talagang nakaaapekto sa susunod na ebolusyon.
Sama-sama, ibinibigay ng tatlo ang long-term identity stability, short-range motion continuity, at kontroladong runtime cost, at binabawasan nila ang character drift, scene jump, cross-chunk flicker, at sirang action.
Error Bank
Madalas na nagsisimula ang malalang drift sa isang AR world model sa maliit na maagang error na naisulat sa history at pagkatapos ay namana. Bumubuo ang R2 ng Error Bank na nag-iimbak ng mga kinatawang error history bilang reusable sample at ni-replay ang mga ito sa normal na history sa itinakdang rate habang nagsasanay. Hindi na lang natututo ang modelo kung paano magpatuloy mula sa ideal na state; natututo rin itong kilalanin, tanggapin, at ayusin ang history na na-drift na.
Sa staged evaluation, bumaba ang long-term brightness-drift metric mula 0.201 hanggang 0.129, mga 35.8% na pagbaba. Sa 29 long-sequence sample, bumuti ang 20, at lahat ng 5 sample na hayagang dapat manatiling hindi gumagalaw ay nabawasan ang maling galaw.
Real-Time Acceleration
Hindi muling natututo ang real-time acceleration ng R2 ng long-horizon na mundo sa loob ng few-step na modelo. Pinapabilis nito ang world model na kayang tumakbo nang matatag sa mahabang panahon. Nagsisimula ang acceleration layer sa patuloy na pretrained na Omni Causal AR at ginagamit ito para sa student ODE initialization at distillation teacher, kaya nagbabahagi ang teacher, student, at tunay na AR inference ng consistent na causal trajectory distribution.
Binabawasan ng pinag-isang causal na panimulang punto na iyon ang pag-asa sa Self-Forcing at Rolling Forcing na istilo ng tuning. Maaaring tumuon ang real-time acceleration sa mga problemang talagang dala ng few-step na bilis: hinahawakan ng DDMD with adversarial regularization ang condition alignment, generation distribution, at realism habang nagdi-distill; kinokpress ng block-sparse attention ang long-context compute; at pinapababa ng pyramid path ang gastos ng high-resolution generation.
DDMD with adversarial regularization
Sa ultra-few-step generation, hindi iisang optimization problem ang condition alignment, distribution matching, at realism. Nakabatay ang R2 sa DDMD at higit pang ipinapasok ang adversarial regularization mula sa DMD2. Nagtatagpo ang tatlong training signal sa iisang student: pinapalakas ng condition alignment ang control, pinapanatili ng distribution matching ang distribution ng teacher, at inaangkla ng adversarial regularization ang totoong data, kaya kayang panatilihin ng kaunting sampling step ang tumpak na interaction response at kapani-paniwalang mundo.
Block-sparse attention
Gumagamit ang R2 ng block-sparse attention sa spatiotemporal token sequence. Hinahati ng modelo ang Q, K, at V sa compute block, mabilis na tinatantya kung aling key/value block ang pinakakailangan ng bawat query block, pinananatili lamang ang pinakamataas na markang koneksyon, at pinapatakbo ang exact softmax attention sa mga napiling block. Hindi random pruning ang block-level routing; itinuon nito ang compute sa malalakas na dependency sa kasalukuyang multimodal control, kamakailang galaw, at mahalagang world state.
Sa pag-angkop ng modelo sa sparse connection structure habang nagsasanay, itinataas ng R2 ang attention sparsity nang higit sa 90% habang pinapanatili ang kalidad ng larawan, action continuity, condition following, at long-horizon stability nang walang malinaw na pagbaba sa kasalukuyang evaluation.
Pyramid ultra-few-step distillation
Ang paggawa ng lahat ng world modeling mula sa simula sa high-resolution space ay nag-aaksaya ng compute sa global structure na kayang matukoy na ng mas mababang resolution. Inaayos ng R2 ang generation bilang isa o dalawang low-resolution stage kasama ang isang high-resolution stage. Itinatakda ng low-resolution stage ang scene layout, subject motion, at camera structure. Ibinabalik ng high-resolution stage ang texture, gilid, at lokal na detalye. Pinuputol ng coarse-to-fine path ang paulit-ulit na high-resolution compute habang pinapanatili ang mas matibay na structural stability at detalye.
Konklusyon at mga Limitasyon
Iminungkahi at inilunsad ng PixVerse R1 ang unang real-time video world model, na nagpapakitang maaaring lumipat ang video mula sa offline na nakapirming content tungo sa dynamic na mundo na kayang makipag-interaksyon nang real time at patuloy na tumakbo. Pagkatapos, nilulutas ng PixVerse R2 kung paano patuloy na nagsa-scale ang paradigmang iyon: dinadala ng pinag-isang Omni Causal AR ang lumalaking data, task, modality, at timescale, at dinadala ng Real-Time Acceleration ang buong kakayahan sa world modeling sa real-time few-step inference.
Hindi single-point capability upgrade ang R2. Isa itong pinag-isang training path para sa susunod na henerasyon ng real-time world model. Ginawang totoo ng R1 ang real-time video world model. Inilalagay sila ng R2 sa pinag-isa, nasusukat, at patuloy na bumubuting yugto.
Sa ilalim ng mahigpit na budget sa real-time compute at interaction latency, may puwang pa ring mapaganda ang kasalukuyang kalidad ng single generation kumpara sa nangungunang offline video model, lalo na sa detalyeng kumplikadong eksena, natural na galaw, physical consistency, at stability sa mahahabang run. Mas madalas na sumasalamin ang mga puwang na iyon sa kasalukuyang scaling stage ng R2 kaysa sa ceiling ng mismong framework.
Early Access
Noong Agosto 23, 2026, inilarawan ng ulat na ito ang PixVerse R2 bilang closed testing. Noong Setyembre 22, 2026, inanunsyo ng PixVerse na bukas nang galugarin ang isang koleksyon ng mga mundong ito sa world.pixverse.video. Tingnan ang anunsyo ng paglulunsad ng R2.
Hindi binubuksan ng anunsyong iyon ang walang restriksyong API access. Ang form ng karanasan sa PixVerse world model R2 ang nananatiling daan ng kahilingan para sa maagang karanasan at API access.
Mga Kaugnay na Resource
- PixVerse R1, Ipinaliwanag: Real-Time na AI Video World Model
- Masusing Pagsusuri sa PixVerse Game Engine
- Ina-update ng PixVerse ang R1 gamit ang Shared Worlds
- Gabay sa Real-Time na Pagbuo ng AI Video
- Isinara ng PixVerse ang Series C Extension
Bukas nang galugarin ang mga mundo mula sa anunsyo noong Setyembre 22, 2026 sa world.pixverse.video. Hinihiling pa rin ang API access sa pamamagitan ng form sa itaas. Maaari ka ring lumikha gamit ang PixVerse V6 at R1 ngayon.