PixVerse R2: escalado de modelos de mundo Omni en tiempo real
PixVerse R1 introdujo y lanzó el primer modelo de mundo de vídeo en tiempo real, convirtiendo la generación de vídeo de una entrega única de un clip fijo en un mundo que corre de forma continua. El modelo puede seguir recibiendo entrada del usuario, actualizar el estado del mundo en tiempo real y transmitir audio y vídeo sincronizados que se mantienen consistentes con la interacción. R1 mostró que este paradigma técnico puede funcionar.
PixVerse R2 responde a la siguiente pregunta: cómo un modelo de mundo de vídeo en tiempo real sigue escalando. R2 se centra en dos objetivos. Primero, construye un mundo dinámico que puede sostener un estado unificado a lo largo de horizontes largos, convirtiendo los priors espacio-temporales completos en una evolución del mundo que solo avanza en el tiempo. Segundo, internaliza de forma continua la causalidad física y las señales de interacción de texto, referencia, audio y acción en un solo modelo, de modo que el mundo puede generar, recibir control y actualizar el estado al mismo tiempo que transmite audio y vídeo sincronizados.
En torno a esos objetivos, R2 convierte el crecimiento del modelo, los datos, las tareas, las señales de control y la escala temporal en ganancias de calidad de generación, consistencia a largo alcance y control multimodal.
Marco general
R2 pliega el sistema en dos capas centrales: Omni Causal AR y Real-Time Acceleration. Omni Causal AR sigue expandiendo la generación de mundo de alta calidad, multimodal y de horizonte largo. Real-Time Acceleration hereda esas capacidades con la menor pérdida posible bajo un presupuesto estricto de latencia de interacción. El camino es claro: subir el techo de capacidad del modelo de mundo y luego acelerar esa capacidad hasta un rango operativo interactivo en tiempo real.
Las tuberías anteriores de vídeo largo y tiempo real solían encadenar muchas etapas de entrenamiento: convertir un modelo bidireccional en un modelo AR, construir un profesor de destilación a partir de un modelo bidireccional específico de tarea, ejecutar destilación DMD y luego añadir self-rollout DMD para cerrar la brecha entrenamiento-inferencia. Cada etapa tenía que volver a migrar capacidad, realinear objetivos y reajustar la distribución de datos. La calidad de imagen, el movimiento, el seguimiento de condición y la estabilidad de horizonte largo podían erosionarse durante esas transferencias. A medida que crecían el modelo, los datos y la escala de tareas, la tubería de varias etapas dividía el objetivo de optimización y subía tanto el coste de entrenamiento como la complejidad del sistema.
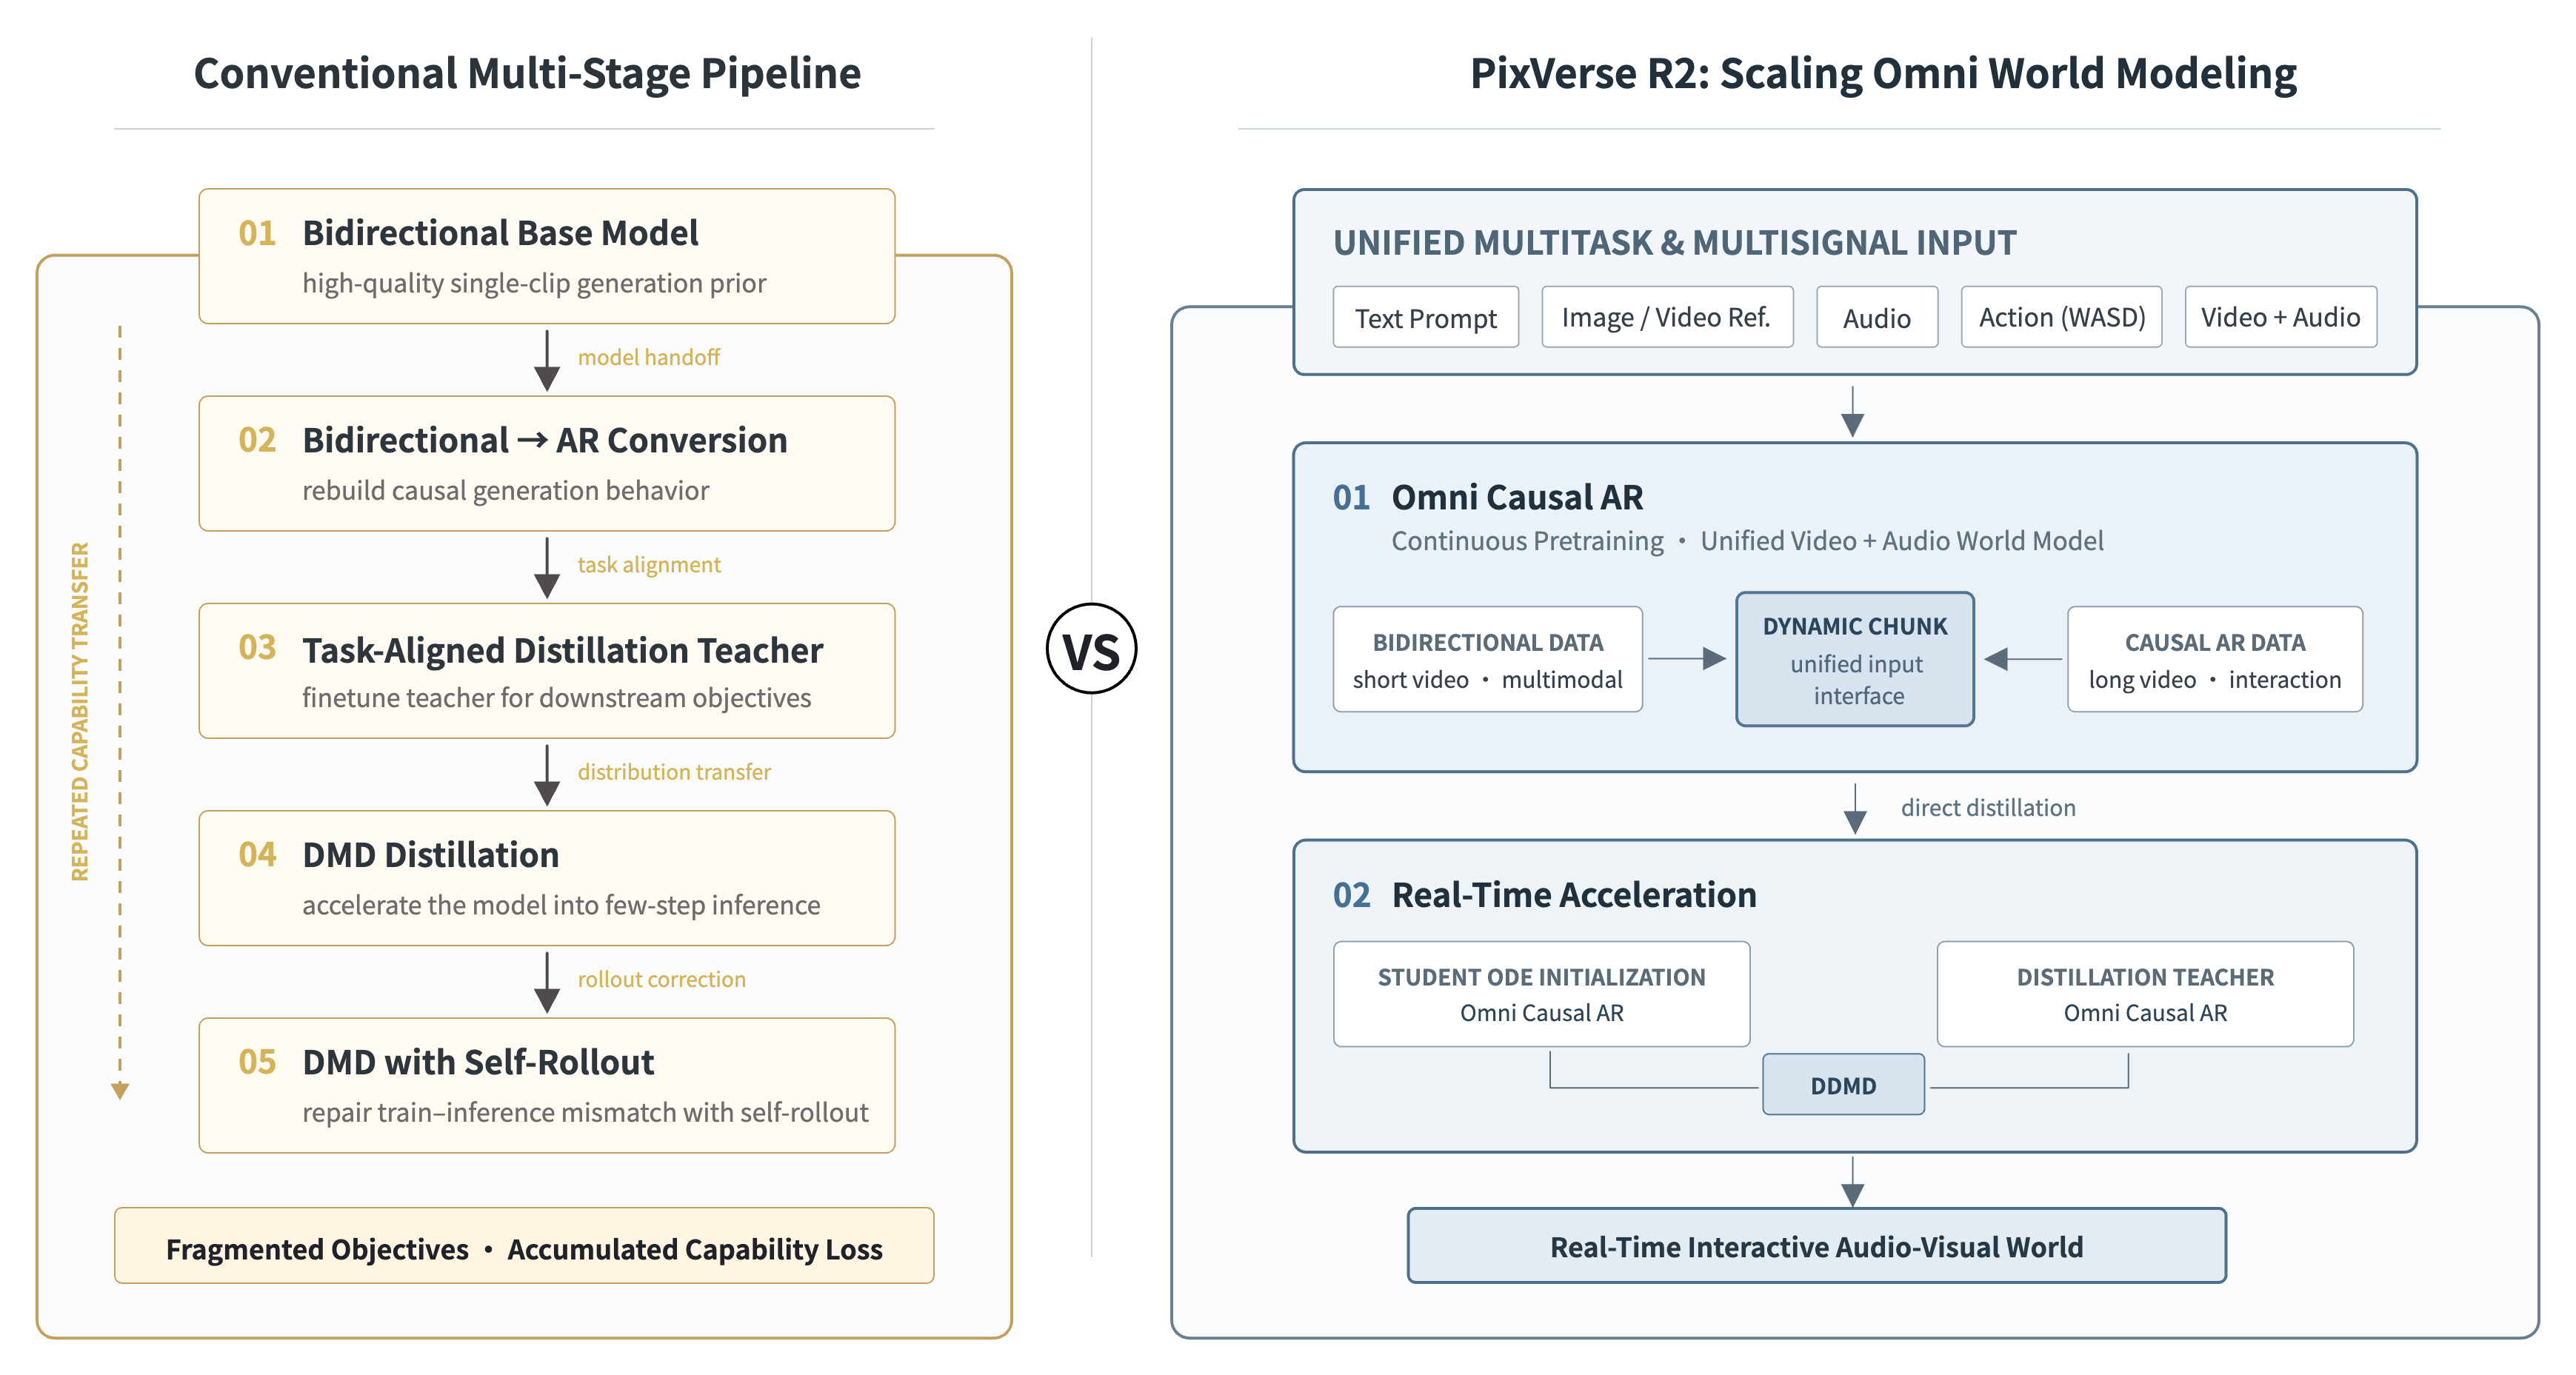
Figura 1. Tubería heredada de varias etapas frente al modelado de mundo a escala de PixVerse R2. R2 converge la expansión de capacidad y la destilación en tiempo real en Omni Causal AR y una capa de aceleración en tiempo real, unificando el modelado multitarea, multiseñal y de vídeo largo en un solo marco.
PixVerse R2 propone un paradigma de entrenamiento unificado para modelos de mundo en tiempo real. En lugar de migrar capacidad de forma repetida entre muchos modelos y etapas de tarea, reduce la tubería compleja a dos procesos que pueden seguir escalando: preentrenar de forma continua un Omni Causal AR que sostiene un estado de mundo unificado y destilarlo directamente a un modelo acelerado que puede generar en tiempo real heredando consistencia espacial y modelado de horizonte largo.
Menos fronteras de etapa reducen la pérdida de capacidad que viene de profesores independientes, alineación de tareas y transferencias repetidas de modelo. Los datos, las tareas, las señales de control y la escala de modelo nuevos pueden convertirse de forma más directa en capacidad de modelado de mundo en tiempo real.
Etapa 1: preentrenamiento continuo de Omni Causal AR. R2 ya no trata los priors de generación bidireccional y el AR de vídeo largo como dos etapas desconectadas. Entrena de forma continua un Omni Causal AR unificado sobre la capacidad del modelo bidireccional. Los chunks dinámicos dan a distintas formas de datos una representación temporal compartida: el modelo puede absorber vídeo corto de alta calidad y datos multimodales del preentrenamiento bidireccional, y puede expandirse a vídeo largo continuo y trayectorias de interacción de varios turnos. La calidad de imagen, la expresión audiovisual, la generación de horizonte largo y el control de varias señales pueden escalar dentro de un solo modelo en lugar de remigrarse mediante conversiones repetidas.
Etapa 2: destilar una capa de aceleración en tiempo real a partir del Omni Causal AR ya escalado. El preentrenamiento continuo da a Omni Causal AR generación de alta calidad, transferencia estable de estado de horizonte largo y rollout causal real al mismo tiempo. R2 usa entonces el mismo Omni Causal AR tanto para la inicialización ODE del estudiante como para el profesor de destilación, de modo que profesor, estudiante e inferencia AR real comparten una base de modelado causal consistente. La destilación en tiempo real se convierte en «aceleración de pocos pasos de un modelo de mundo existente», no en «reaprender un mundo de horizonte largo».
Omni Causal AR
R2 continúa la vía de entrada multimodal, generación autorregresiva e interacción en tiempo real que R1 ya validó, y luego concentra esas capacidades en una ruta de entrenamiento Omni Causal AR unificada. Omni Causal AR convierte los priors de generación espacio-temporal completos en transferencia de estado de mundo que solo avanza en el tiempo. Mediante causalización y preentrenamiento continuo, el modelo conserva capacidad de imagen, movimiento, audio y semántica multimodal mientras aprende a predecir el siguiente chunk audiovisual sincronizado solo a partir del historial.
A medida que los objetos de entrenamiento se expanden de vídeos cortos independientes a vídeos largos continuos y trayectorias de interacción de varios turnos, el modelo construye de forma gradual una causalidad a largo plazo entre el estado histórico del mundo, la entrada de interacción actual y la evolución futura del mundo.
El modelo recibe de forma conjunta un prompt de texto, referencias multimodales, señales de acción (por ejemplo WASD o control continuo) y audio, y emite vídeo y audio sincronizados. Distintas señales de control pueden seguir entrando en el modelo durante una ejecución y cambiar el estado posterior del mundo. R2 no solo responde a una condición de un solo disparo; puede generar, recibir control y actualizar el mundo al mismo tiempo.
Para mantener la generación causal dentro del mismo mundo durante una ejecución larga, R2 aborda cuatro problemas: la brecha de distribución entrenamiento-inferencia, la robustez al historial ruidoso, la coordinación de memoria a largo plazo y reciente, y la corrección de estados de error. Hybrid Teacher / Diffusion Forcing permite al modelo adaptarse tanto a historial limpio como ruidoso. Multi-Timescale Memory almacena de forma conjunta anclas de mundo, dinámica reciente y estado de objetos. Un Error Bank devuelve estados fallidos al entrenamiento. Juntos forman un bucle de entrenamiento para el estado de mundo a largo plazo y reducen la deriva de imagen, personaje, movimiento, relación audiovisual y respuesta de control a lo largo del tiempo.
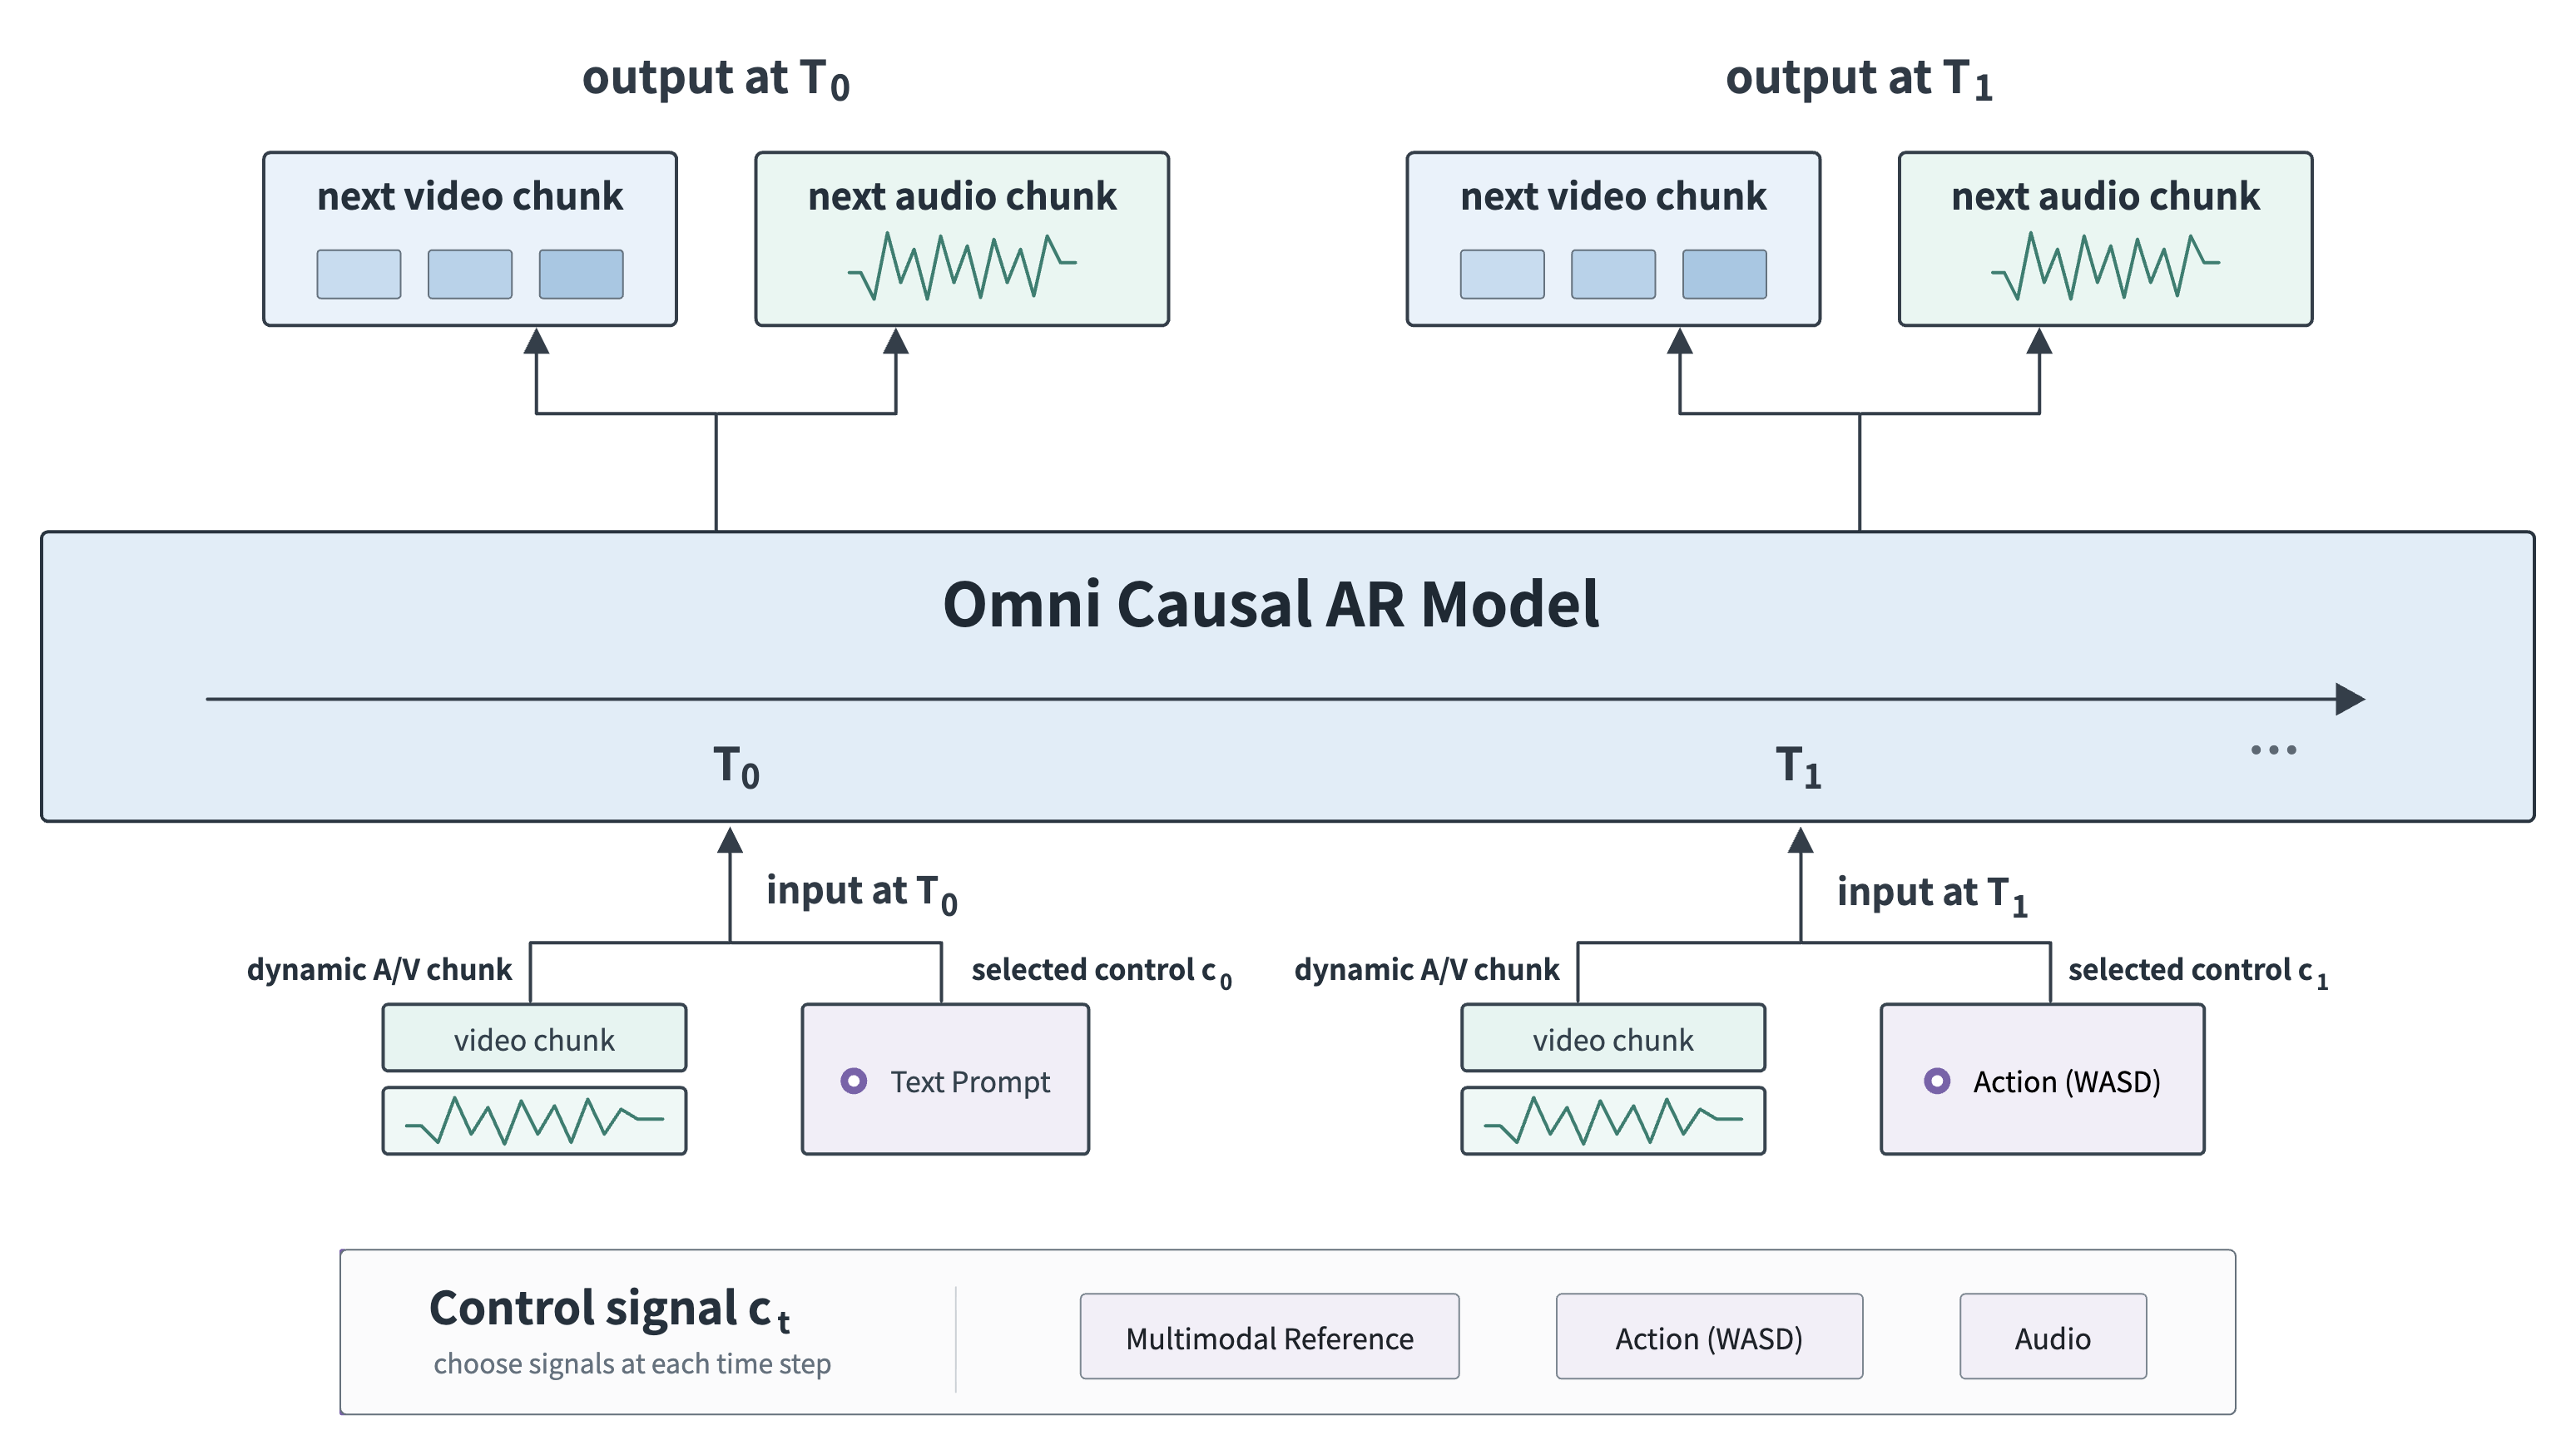
Figura 2. PixVerse R2 Omni Causal AR. El modelo puede seguir recibiendo distintas señales de control durante una ejecución. En cada momento de interacción, la señal activa se alinea con un chunk audiovisual dinámico de la granularidad correspondiente y impulsa el siguiente segmento de vídeo y audio.
Generación de chunks dinámicos
Las distintas señales de control viven en distintas escalas temporales. Los prompts y las referencias suelen describir semántica completa o eventos más largos. La acción (WASD) necesita retroalimentación de estado fina e inmediata. El audio lleva a la vez semántica, ritmo y sincronía temporal. Si cada entrada se fuerza a una unidad de tiempo de longitud fija, el modelo a menudo tiene que intercambiar velocidad de respuesta por completitud de expresión.
Dynamic Chunk es cómo R2 unifica esas escalas temporales de interacción. R2 divide de forma adaptativa las secuencias audiovisuales según el límite semántico y la duración de la señal de control actual, con un tamaño máximo de chunk que restringe el cómputo y la estabilidad del entrenamiento. Los chunks cortos mejoran la precisión de respuesta para acción e instrucciones locales. Los chunks largos conservan la estructura completa de eventos, movimiento y semántica audiovisual. Distintas tareas y señales de control pueden compartir una interfaz de generación causal sin cambiar la estructura del modelo.
Hybrid Teacher Forcing / Diffusion Forcing
La tensión central del AR de horizonte largo es que el historial de entrenamiento suele ser más limpio, mientras que el historial real en tiempo de ejecución contiene el ruido y los errores locales del propio modelo. Entrenar solo con historial limpio puede subir el techo de calidad de un solo paso, pero hace al modelo demasiado sensible a pequeñas desviaciones. Entrenar solo con historial perturbado puede dañar la calidad de imagen, el movimiento y la respuesta de control.
R2 mezcla historial limpio e historial ruidoso en un solo proceso de entrenamiento. El historial limpio estabiliza el techo de calidad de la evolución del mundo. El historial ruidoso deja que el modelo se adapte de antemano a estados imperfectos que verá en despliegue. El entrenamiento complementario reduce la brecha entrenamiento-inferencia, de modo que el modelo puede generar un siguiente segmento de mundo de alta calidad y seguir avanzando cuando el historial ya contiene un error pequeño.
Causal Attention Mask y Relative Temporal RoPE restringen de forma conjunta qué historial puede leer el estado actual y dónde se sitúa ese historial en la ventana actual. Attention Mask impone visibilidad causal estricta. Temporal RoPE no crece sin límite con un ID de bloque global; se reindexa por ranura relativa dentro de la ventana de atención actual. Cuando la ventana rodante avanza, el tiempo real sigue avanzando, pero la memoria sink, el historial reciente y el chunk actual permanecen mapeados a un rango de posición relativa estable y acotado.
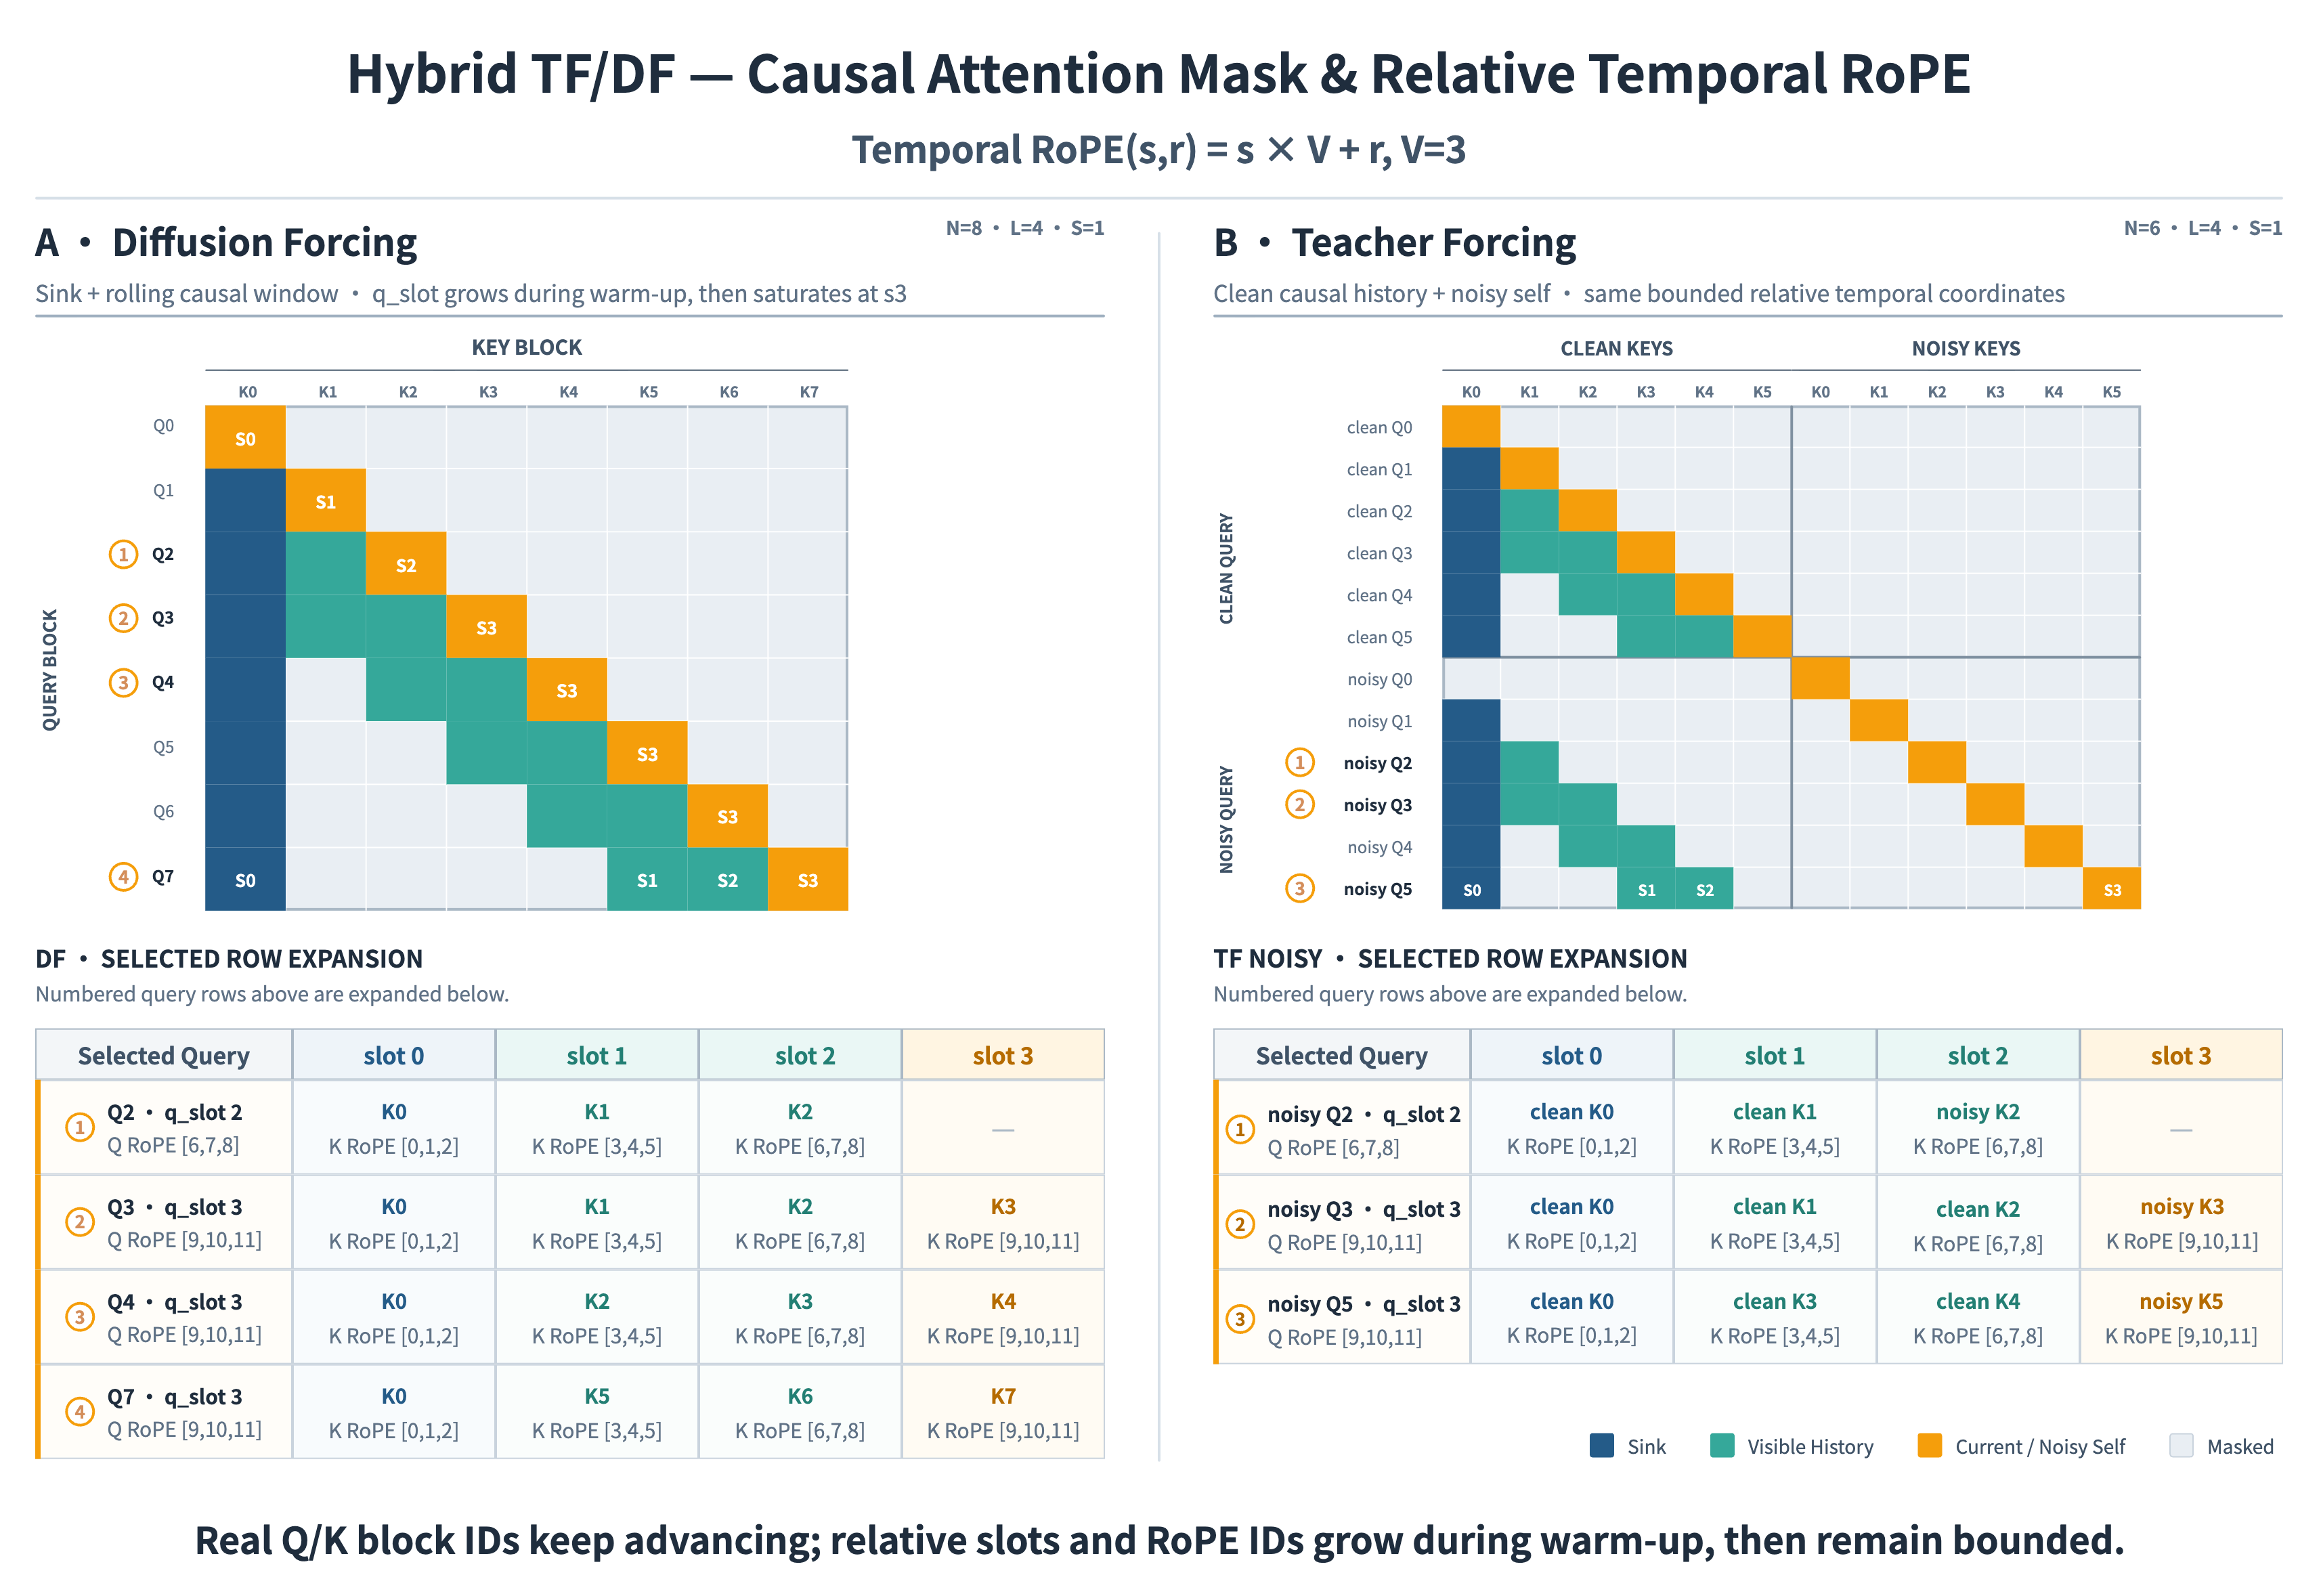
Figura 3. Máscara de atención causal unificada y RoPE temporal relativo para Hybrid Teacher / Diffusion Forcing. Arriba se muestra la visibilidad causal de las dos construcciones de historial. Abajo se mapean consultas representativas a bloques Q/K, ranuras relativas e IDs de RoPE, mostrando que los IDs de bloque reales siguen avanzando mientras las coordenadas temporales dentro de la ventana permanecen acotadas.
Memoria de varias escalas temporales
El modelado de mundo a largo plazo no puede limitarse a recordar todo el historial. Un historial no acotado sube con rapidez el coste de cómputo y memoria; recortar de más pierde identidad de personaje, ambientación de escena y eventos clave. R2 construye un sistema de memoria de varias escalas a partir de Sink Memory, Rolling History y un Object KV Cache.
- Sink Memory almacena anclas a largo plazo como personaje, escena, estilo y reglas del mundo.
- Rolling History se centra en la acción, la pose, la cámara y el cambio de entorno recientes para que el estado local pueda conectarse de forma natural.
- Object KV Cache reutiliza y comprime representaciones de historial a nivel de objeto ya calculadas, manteniendo dentro de un presupuesto limitado los estados que realmente afectan a la evolución posterior.
Los tres juntos dan estabilidad de identidad a largo plazo, continuidad de movimiento de corto alcance y un coste de ejecución controlable, y reducen la deriva de personaje, los saltos de escena, el parpadeo entre chunks y la acción rota.
Error Bank
La deriva grave en un modelo de mundo AR suele empezar con un error pequeño temprano escrito en el historial y luego heredado. R2 construye un Error Bank que almacena historiales de error representativos como muestras reutilizables y los reproduce en el historial normal a una tasa fijada durante el entrenamiento. El modelo ya no solo aprende cómo continuar desde un estado ideal; también aprende a reconocer, absorber y reparar historial que ya se ha desviado.
En evaluación por etapas, la métrica de deriva de brillo a largo plazo bajó de 0,201 a 0,129, una caída de alrededor del 35,8 %. De 29 muestras de secuencia larga, 20 mejoraron, y las 5 muestras que debían permanecer explícitamente quietas redujeron el movimiento erróneo.
Aceleración en tiempo real
La aceleración en tiempo real de R2 no reaprende un mundo de horizonte largo dentro de un modelo de pocos pasos. Acelera un modelo de mundo que ya puede correr de forma estable durante mucho tiempo. La capa de aceleración parte del Omni Causal AR preentrenado de forma continua y lo usa tanto para la inicialización ODE del estudiante como para el profesor de destilación, de modo que profesor, estudiante e inferencia AR real comparten una distribución de trayectoria causal consistente.
Ese punto de partida causal unificado reduce la dependencia de ajustes al estilo Self-Forcing y Rolling Forcing. La aceleración en tiempo real puede centrarse en los problemas que realmente introduce la velocidad de pocos pasos: DDMD con regularización adversaria trata la alineación de condición, la distribución de generación y el realismo durante la destilación; atención dispersa por bloques comprime el cómputo de contexto largo; y una vía piramidal baja el coste de la generación de alta resolución.
DDMD con regularización adversaria
En generación de poquísimos pasos, la alineación de condición, el emparejamiento de distribución y el realismo no son el mismo problema de optimización. R2 se basa en DDMD e introduce además regularización adversaria de DMD2. Tres señales de entrenamiento se encuentran en un solo estudiante: la alineación de condición refuerza el control, el emparejamiento de distribución conserva la distribución del profesor y la regularización adversaria ancla datos reales, de modo que pocos pasos de muestreo pueden conservar tanto una respuesta de interacción precisa como un mundo creíble.
Atención dispersa por bloques
R2 usa atención dispersa por bloques en secuencias de tokens espacio-temporales. El modelo divide Q, K y V en bloques de cómputo, estima con rapidez qué bloques de clave/valor necesita más cada bloque de consulta, conserva solo las conexiones de mayor puntuación y ejecuta atención softmax exacta en esos bloques seleccionados. El enrutado a nivel de bloque no es una poda aleatoria; concentra el cómputo en las dependencias fuertes entre el control multimodal actual, el movimiento reciente y el estado clave del mundo.
Al adaptar el modelo a la estructura de conexión dispersa durante el entrenamiento, R2 sube la dispersión de atención por encima del 90 % manteniendo calidad de imagen, continuidad de acción, seguimiento de condición y estabilidad de horizonte largo sin una caída clara en la evaluación actual.
Destilación piramidal de poquísimos pasos
Hacer todo el modelado de mundo desde cero en espacio de alta resolución desperdicia cómputo en estructura global que una resolución más baja ya puede determinar. R2 organiza la generación como una o dos etapas de baja resolución más una etapa de alta resolución. Las etapas de baja resolución fijan la disposición de escena, el movimiento del sujeto y la estructura de cámara. La etapa de alta resolución restaura textura, bordes y detalle local. La vía de grueso a fino recorta cómputo de alta resolución repetido manteniendo una estabilidad estructural y un detalle más fuertes.
Conclusión y límites
PixVerse R1 propuso y lanzó el primer modelo de mundo de vídeo en tiempo real, mostrando que el vídeo puede pasar de contenido fijo offline a un mundo dinámico que puede interactuar en tiempo real y seguir corriendo. PixVerse R2 resuelve entonces cómo ese paradigma sigue escalando: un Omni Causal AR unificado lleva datos, tareas, modalidades y escalas temporales en crecimiento, y Real-Time Acceleration lleva la capacidad completa de modelado de mundo a inferencia de pocos pasos en tiempo real.
R2 no es una mejora de capacidad de un solo punto. Es una vía de entrenamiento unificada para la siguiente generación de modelos de mundo en tiempo real. R1 hizo reales los modelos de mundo de vídeo en tiempo real. R2 los coloca en una etapa unificada, escalable y en mejora continua.
Bajo un presupuesto estricto de cómputo en tiempo real y latencia de interacción, la calidad actual de una sola generación aún tiene margen de mejora frente a los modelos de vídeo offline líderes, sobre todo en detalle de escena compleja, naturalidad de movimiento, consistencia física y estabilidad en ejecuciones largas. Esas brechas reflejan con más frecuencia la etapa de escalado actual de R2 que un techo del propio marco.
Acceso anticipado
El 23 de agosto de 2026, este informe describía PixVerse R2 como una prueba cerrada. El 22 de septiembre de 2026, PixVerse anunció que una colección de estos mundos está abierta para explorar en world.pixverse.video. Consulta el anuncio de lanzamiento de R2.
Ese anuncio no abre un acceso a la API sin restricciones. El formulario de experiencia del modelo de mundo R2 de PixVerse sigue siendo la vía de solicitud para la experiencia anticipada y el acceso a la API.
Recursos relacionados
- PixVerse R1 explicado: modelo de mundo de vídeo con IA en tiempo real
- PixVerse Game Engine a fondo
- PixVerse actualiza R1 con mundos compartidos
- Guía de generación de vídeo con IA en tiempo real
- PixVerse cierra la extensión de la Serie C
Los mundos del anuncio del 22 de septiembre de 2026 están abiertos para explorar en world.pixverse.video. El acceso a la API sigue solicitándose con el formulario de arriba. También puedes crear hoy con PixVerse V6 y R1.