PixVerse R2: масштабування омнімоделей світу реального часу
PixVerse R1 представила й випустила першу відеомодель світу реального часу, перетворивши генерацію відео з разової видачі фіксованого кліпу на світ, що працює безперервно. Модель може й далі отримувати введення користувача, оновлювати стан світу в реальному часі та стримити синхронізовані аудіо й відео, які залишаються узгодженими з взаємодією. R1 показала, що ця технічна парадигма може працювати.
PixVerse R2 відповідає на наступне питання: як відеомодель світу реального часу продовжує масштабуватися. R2 зосереджується на двох цілях. По-перше, вона будує динамічний світ, здатний утримувати уніфікований стан на довгих горизонтах, перетворюючи повні просторово-часові пріори на еволюцію світу, що рухається лише вперед у часі. По-друге, вона безперервно інтерналізує фізичну причинність і сигнали взаємодії з тексту, референсу, аудіо та дії в єдину модель, тож світ може генерувати, приймати керування й оновлювати стан одночасно, стримячи синхронізовані аудіо й відео.
Навколо цих цілей R2 перетворює зростання моделі, даних, задач, сигналів керування та часового масштабу на виграші в якості генерації, далекосяжній узгодженості та мультимодальному керуванні.
Загальний каркас
R2 згортає систему у два основні шари: Omni Causal AR і прискорення реального часу. Omni Causal AR продовжує розширювати високоякісну мультимодальну генерацію світу на довгому горизонті. Прискорення реального часу успадковує ці можливості якомога без втрат у межах суворого бюджету затримки взаємодії. Шлях зрозумілий: підняти стелю можливостей моделі світу, а потім прискорити цю можливість до робочого діапазону реального часу та інтерактивності.
Старіші конвеєри довгого відео та реального часу зазвичай зчіплювали багато етапів навчання: перетворення двонапрямної моделі на AR-модель, побудова вчителя дистиляції з двонапрямної моделі під конкретну задачу, запуск DMD-дистиляції, а потім додавання self-rollout DMD, щоб закрити розрив між навчанням і інференсом. На кожному етапі доводилося заново переносити можливості, переузгоджувати цілі та наново підганяти розподіл даних. Якість зображення, рух, дотримання умов і стабільність на довгому горизонті могли розмиватися під час цих перенесень. У міру зростання масштабу моделі, даних і задач багатоетапний конвеєр розщеплював ціль оптимізації та підвищував і вартість навчання, і складність системи.
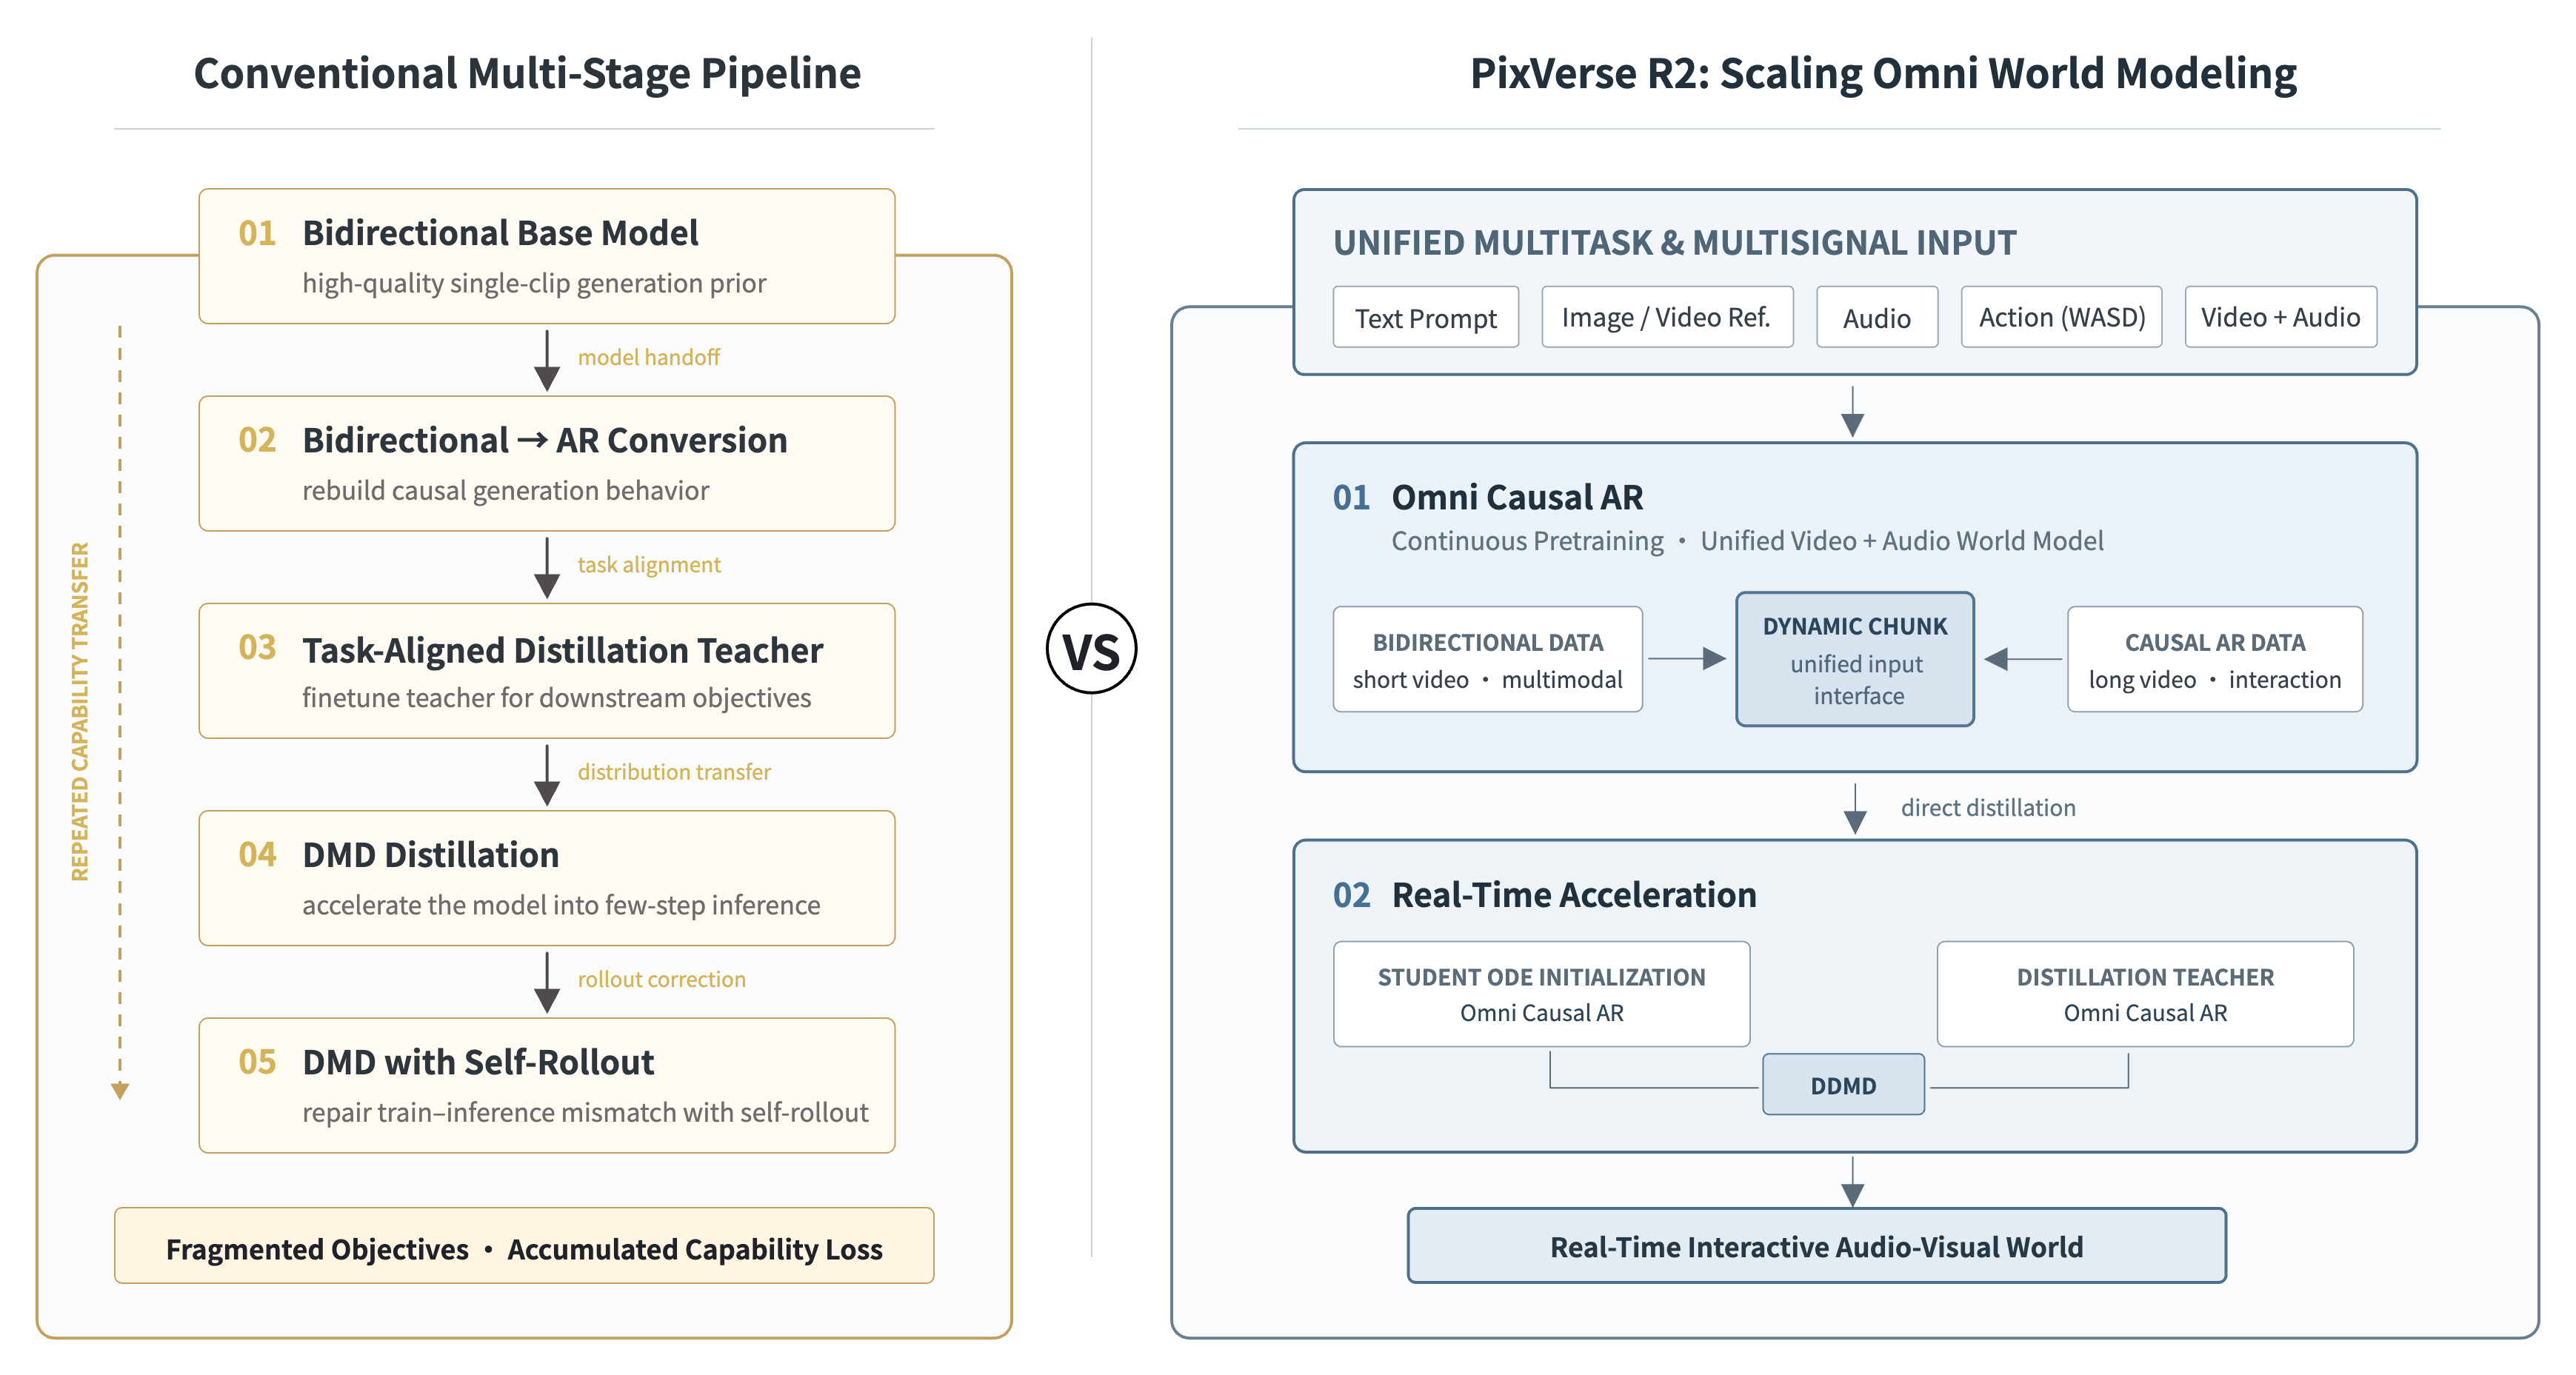
Рисунок 1. Застарілий багатоетапний конвеєр порівняно з масштабуванням моделювання світу PixVerse R2. R2 зводить розширення можливостей і дистиляцію реального часу в Omni Causal AR і шар прискорення реального часу, об’єднуючи багатозадачне, багатосигнальне моделювання та моделювання довгого відео в одному каркасі.
PixVerse R2 пропонує уніфіковану парадигму навчання для моделей світу реального часу. Замість повторного перенесення можливостей між багатьма моделями та етапами задач вона зводить складний конвеєр до двох процесів, які можуть і далі масштабуватися: безперервно донавчати Omni Causal AR, що утримує уніфікований стан світу, а потім безпосередньо дистилювати її в прискорену модель, здатну генерувати в реальному часі, успадковуючи просторову узгодженість і моделювання на довгому горизонті.
Менша кількість меж між етапами зменшує втрату можливостей, що виникає через незалежних учителів, узгодження задач і повторні перенесення моделей. Нові дані, задачі, сигнали керування та масштаб моделі можуть безпосередніше перетворюватися на здатність моделювати світ у реальному часі.
Етап 1: безперервне донавчання Omni Causal AR. R2 більше не розглядає двонапрямні пріори генерації та AR довгого відео як два роз’єднані етапи. Вона безперервно навчає уніфіковану Omni Causal AR поверх можливостей двонапрямної моделі. Динамічні чанки дають різним формам даних спільне часове представлення: модель може поглинати високоякісне коротке відео та мультимодальні дані з двонапрямного предонавчання й розширюватися на безперервне довге відео та траєкторії багатоходової взаємодії. Якість зображення, аудіовізуальна виразність, генерація на довгому горизонті та багатосигнальне керування можуть масштабуватися всередині однієї моделі замість повторного перенесення через багаторазові перетворення.
Етап 2: дистиляція шару прискорення реального часу з масштабованої Omni Causal AR. Безперервне донавчання одночасно дає Omni Causal AR високоякісну генерацію, стабільне перенесення стану на довгому горизонті та справжній причинний rollout. Далі R2 використовує ту саму Omni Causal AR і для ODE-ініціалізації учня, і як учителя дистиляції, тож учитель, учень і реальний AR-інференс поділяють узгоджену причинну базу моделювання. Дистиляція реального часу стає «прискоренням наявної моделі світу за кілька кроків», а не «повторним навчанням світу на довгому горизонті».
Omni Causal AR
R2 продовжує шлях мультимодального входу, авторегресійної генерації та взаємодії в реальному часі, який уже підтвердила R1, а потім зосереджує ці можливості в уніфікованому маршруті навчання Omni Causal AR. Omni Causal AR перетворює повні просторово-часові пріори генерації на перенесення стану світу, що рухається лише вперед у часі. Завдяки каузалізації та безперервному донавчанню модель зберігає здатність до зображення, руху, аудіо та мультимодальної семантики, навчаючись передбачати наступний синхронізований аудіовізуальний чанк лише з історії.
У міру того як об’єкти навчання розширюються від незалежних коротких відео до безперервних довгих відео та траєкторій багатоходової взаємодії, модель поступово будує довгострокову причинність між історичним станом світу, поточним входом взаємодії та майбутньою еволюцією світу.
Модель одночасно отримує текстовий промпт, мультимодальні референси, сигнали дій (наприклад, WASD або неперервне керування) та аудіо і видає синхронізовані відео й аудіо. Під час запуску в модель можуть і далі надходити різні сигнали керування й змінювати подальший стан світу. R2 не лише відповідає на одноразову умову; вона може одночасно генерувати, приймати керування й оновлювати світ.
Щоб каузальна генерація лишалася в тому самому світі протягом довгого запуску, R2 розв’язує чотири проблеми: розрив розподілів між навчанням і інференсом, стійкість до шумної історії, узгодження довгострокової та недавньої пам’яті, а також виправлення помилкових станів. Hybrid Teacher / Diffusion Forcing дає моделі змогу адаптуватися і до чистої, і до шумної історії. Multi-Timescale Memory спільно зберігає якорі світу, недавню динаміку та стан об’єктів. Error Bank повертає невдалі стани назад у навчання. Разом вони утворюють цикл навчання для довгострокового стану світу й з часом зменшують дрейф зображення, персонажа, руху, аудіовізуального зв’язку та реакції на керування.
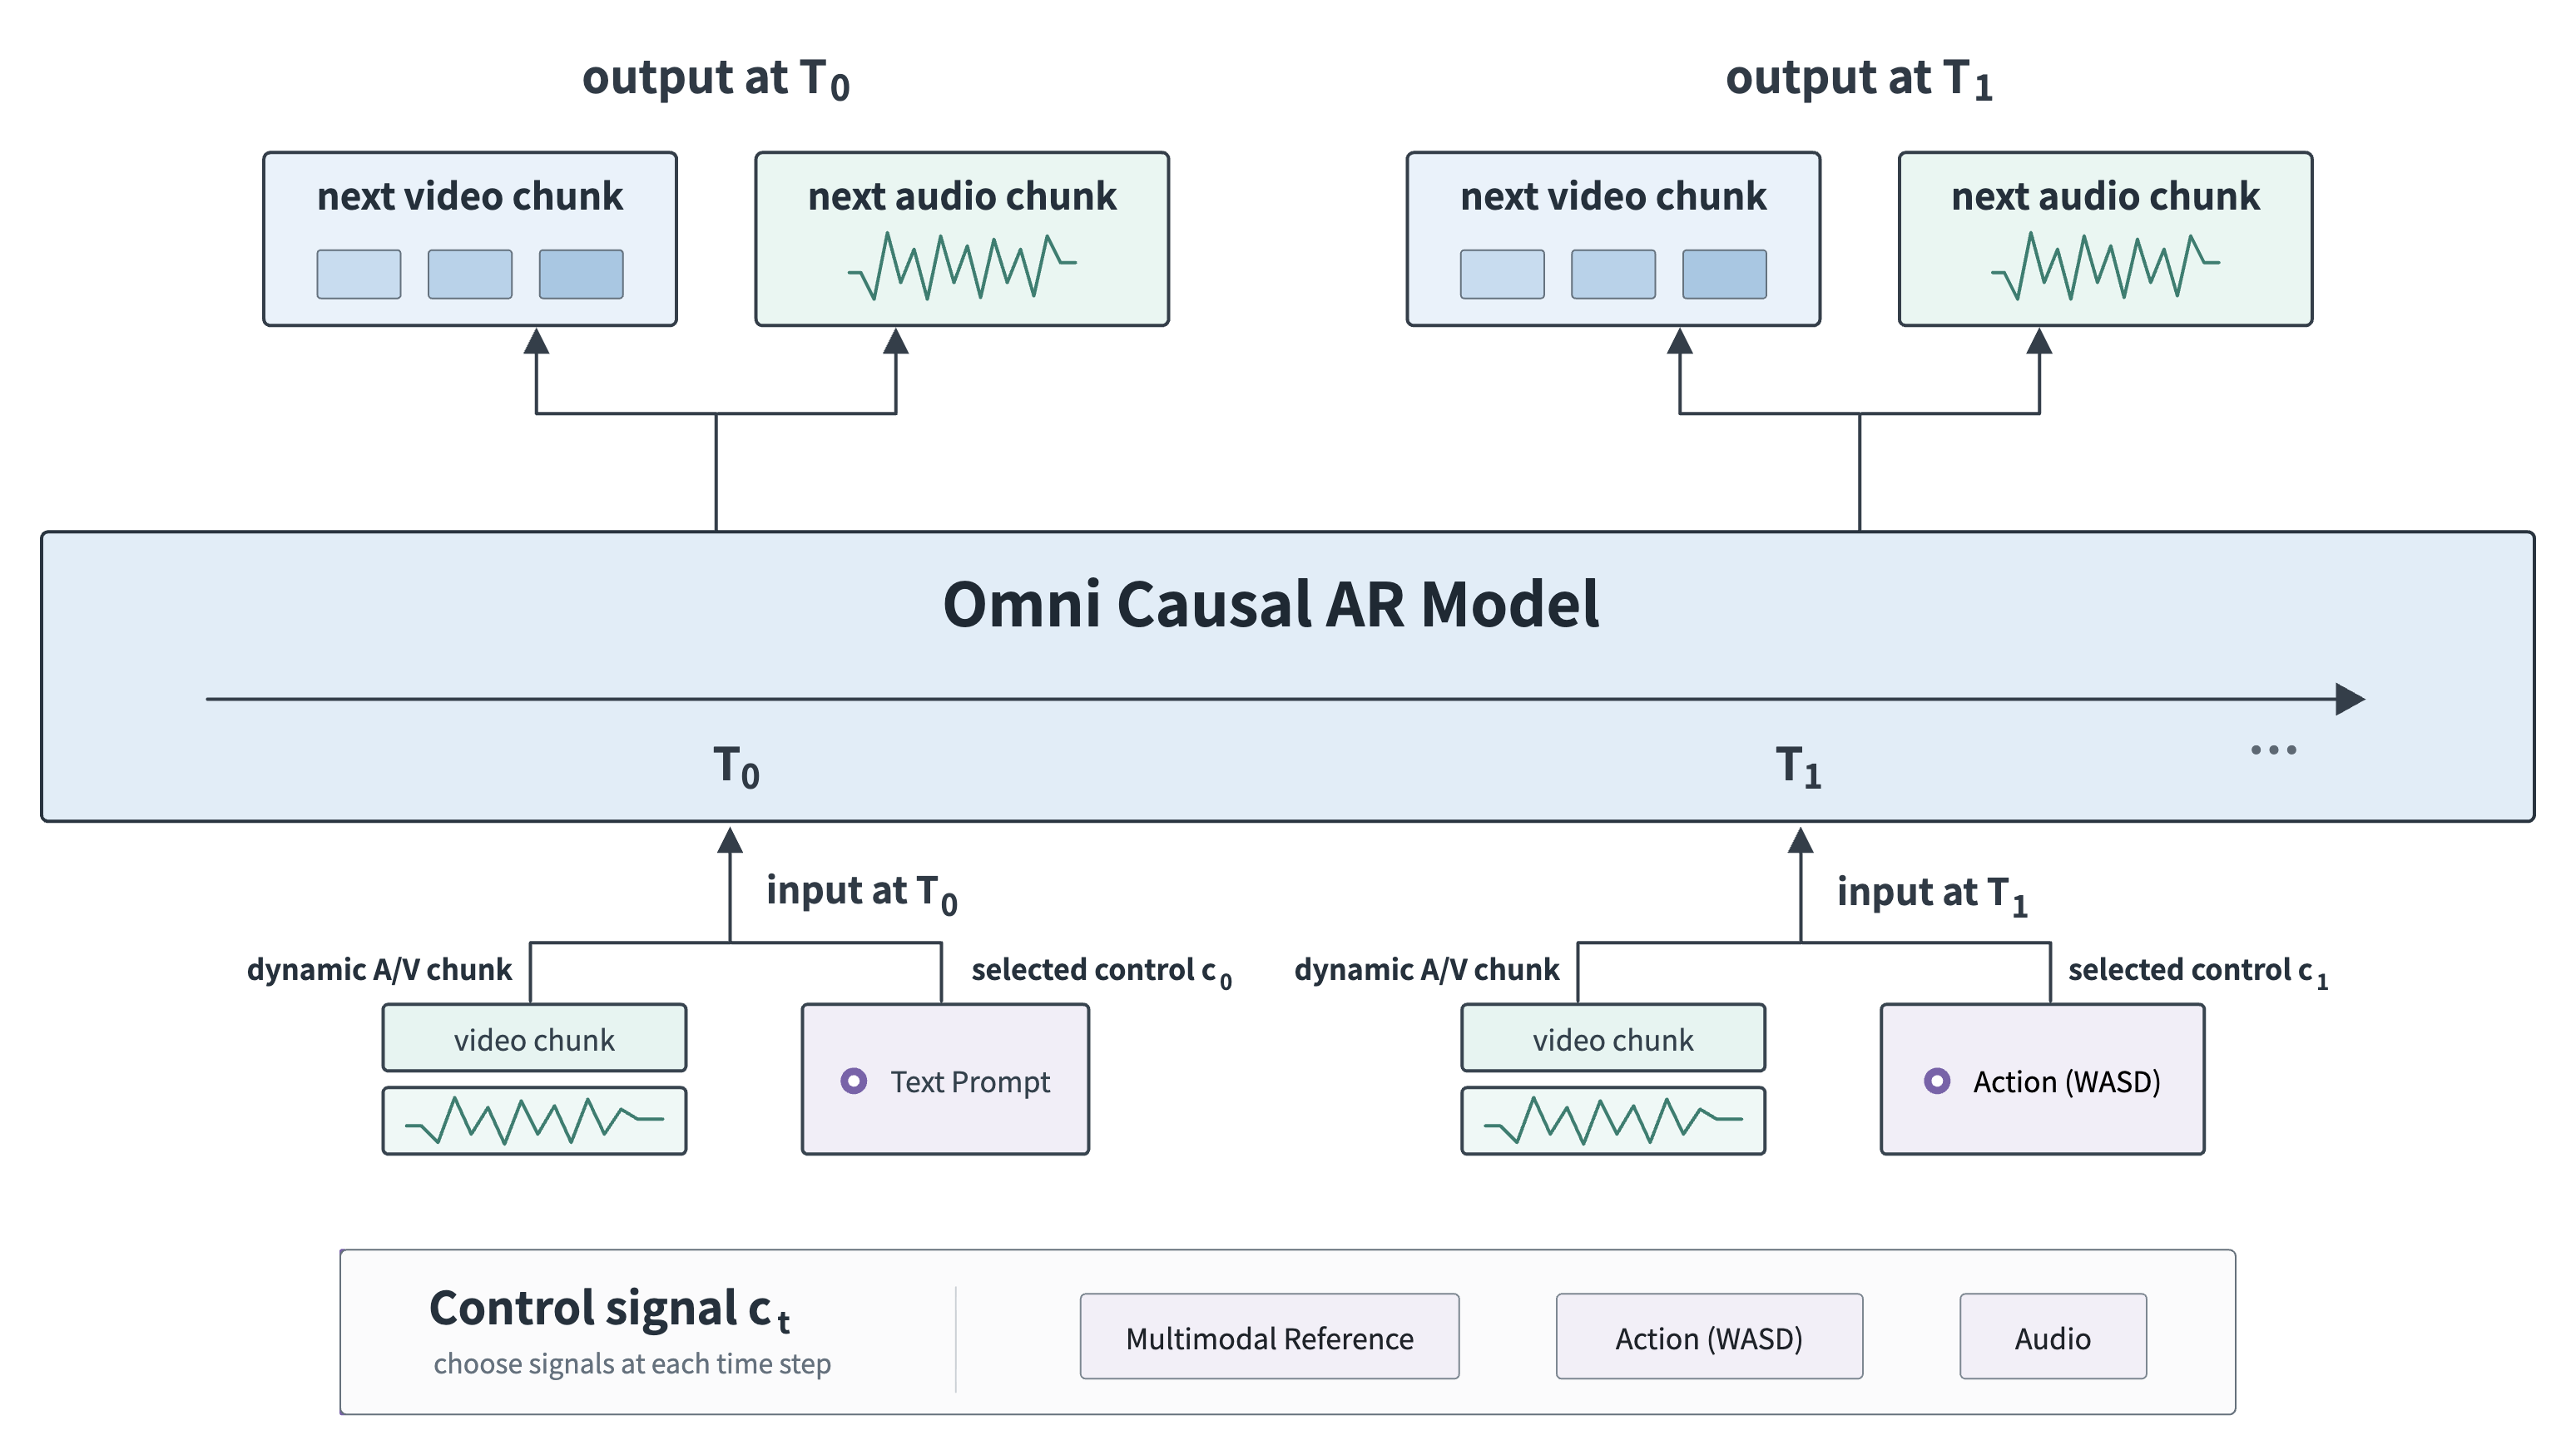
Рисунок 2. PixVerse R2 Omni Causal AR. Модель може й далі отримувати різні сигнали керування під час запуску. У кожен момент взаємодії активний сигнал узгоджується з динамічним аудіовізуальним чанком відповідної гранулярності й задає наступний сегмент відео та аудіо.
Динамічна генерація чанків
Різні сигнали керування живуть на різних часових масштабах. Промпти й референси зазвичай описують повну семантику або довші події. Дія (WASD) потребує дрібнозернистого, негайного зворотного зв’язку щодо стану. Аудіо одночасно несе семантику, ритм і часову синхронізацію. Якщо кожен вхід примусово вміщувати у фіксовану часову одиницю, моделі часто доводиться жертвувати швидкістю реакції заради повноти вираження.
Dynamic Chunk — це те, як R2 об’єднує ці часові масштаби взаємодії. R2 адаптивно розбиває аудіовізуальні послідовності за семантичною межею та тривалістю поточного сигналу керування, з максимальним розміром чанка, який обмежує обчислення й стабільність навчання. Короткі чанки підвищують точність реакції на дію та локальні інструкції. Довгі чанки зберігають повну структуру подій, руху й аудіовізуальної семантики. Різні завдання й сигнали керування можуть спільно використовувати один інтерфейс каузальної генерації без зміни структури моделі.
Hybrid Teacher Forcing / Diffusion Forcing
Головна напруга в довгогоризонтному AR полягає в тому, що історія під час навчання зазвичай чистіша, тоді як реальна історія під час виконання містить власний шум моделі та локальні помилки. Навчання лише на чистій історії може підняти стелю якості одного кроку, але зробити модель надто чутливою до малих відхилень. Навчання лише на збуреній історії може погіршити якість зображення, рух і реакцію на керування.
R2 змішує чисту й шумну історію в одному процесі навчання. Чиста історія стабілізує стелю якості еволюції світу. Шумна історія дає моделі заздалегідь адаптуватися до недосконалих станів, які вона побачить під час розгортання. Взаємодоповнювальне навчання звужує розрив між навчанням і інференсом, тож модель може згенерувати високоякісний наступний сегмент світу й продовжувати рух уперед, навіть якщо історія вже містить невелику помилку.
Causal Attention Mask і Relative Temporal RoPE спільно обмежують, яку історію може читати поточний стан і де ця історія розташована в поточному вікні. Attention Mask забезпечує сувору каузальну видимість. Temporal RoPE не зростає безмежно разом із глобальним ID блока; його переіндексовують за відносним слотом усередині поточного вікна уваги. Коли ковзне вікно рухається вперед, реальний час продовжує йти, але sink-пам’ять, недавня історія й поточний чанк лишаються відображеними на стабільний обмежений діапазон відносних позицій.
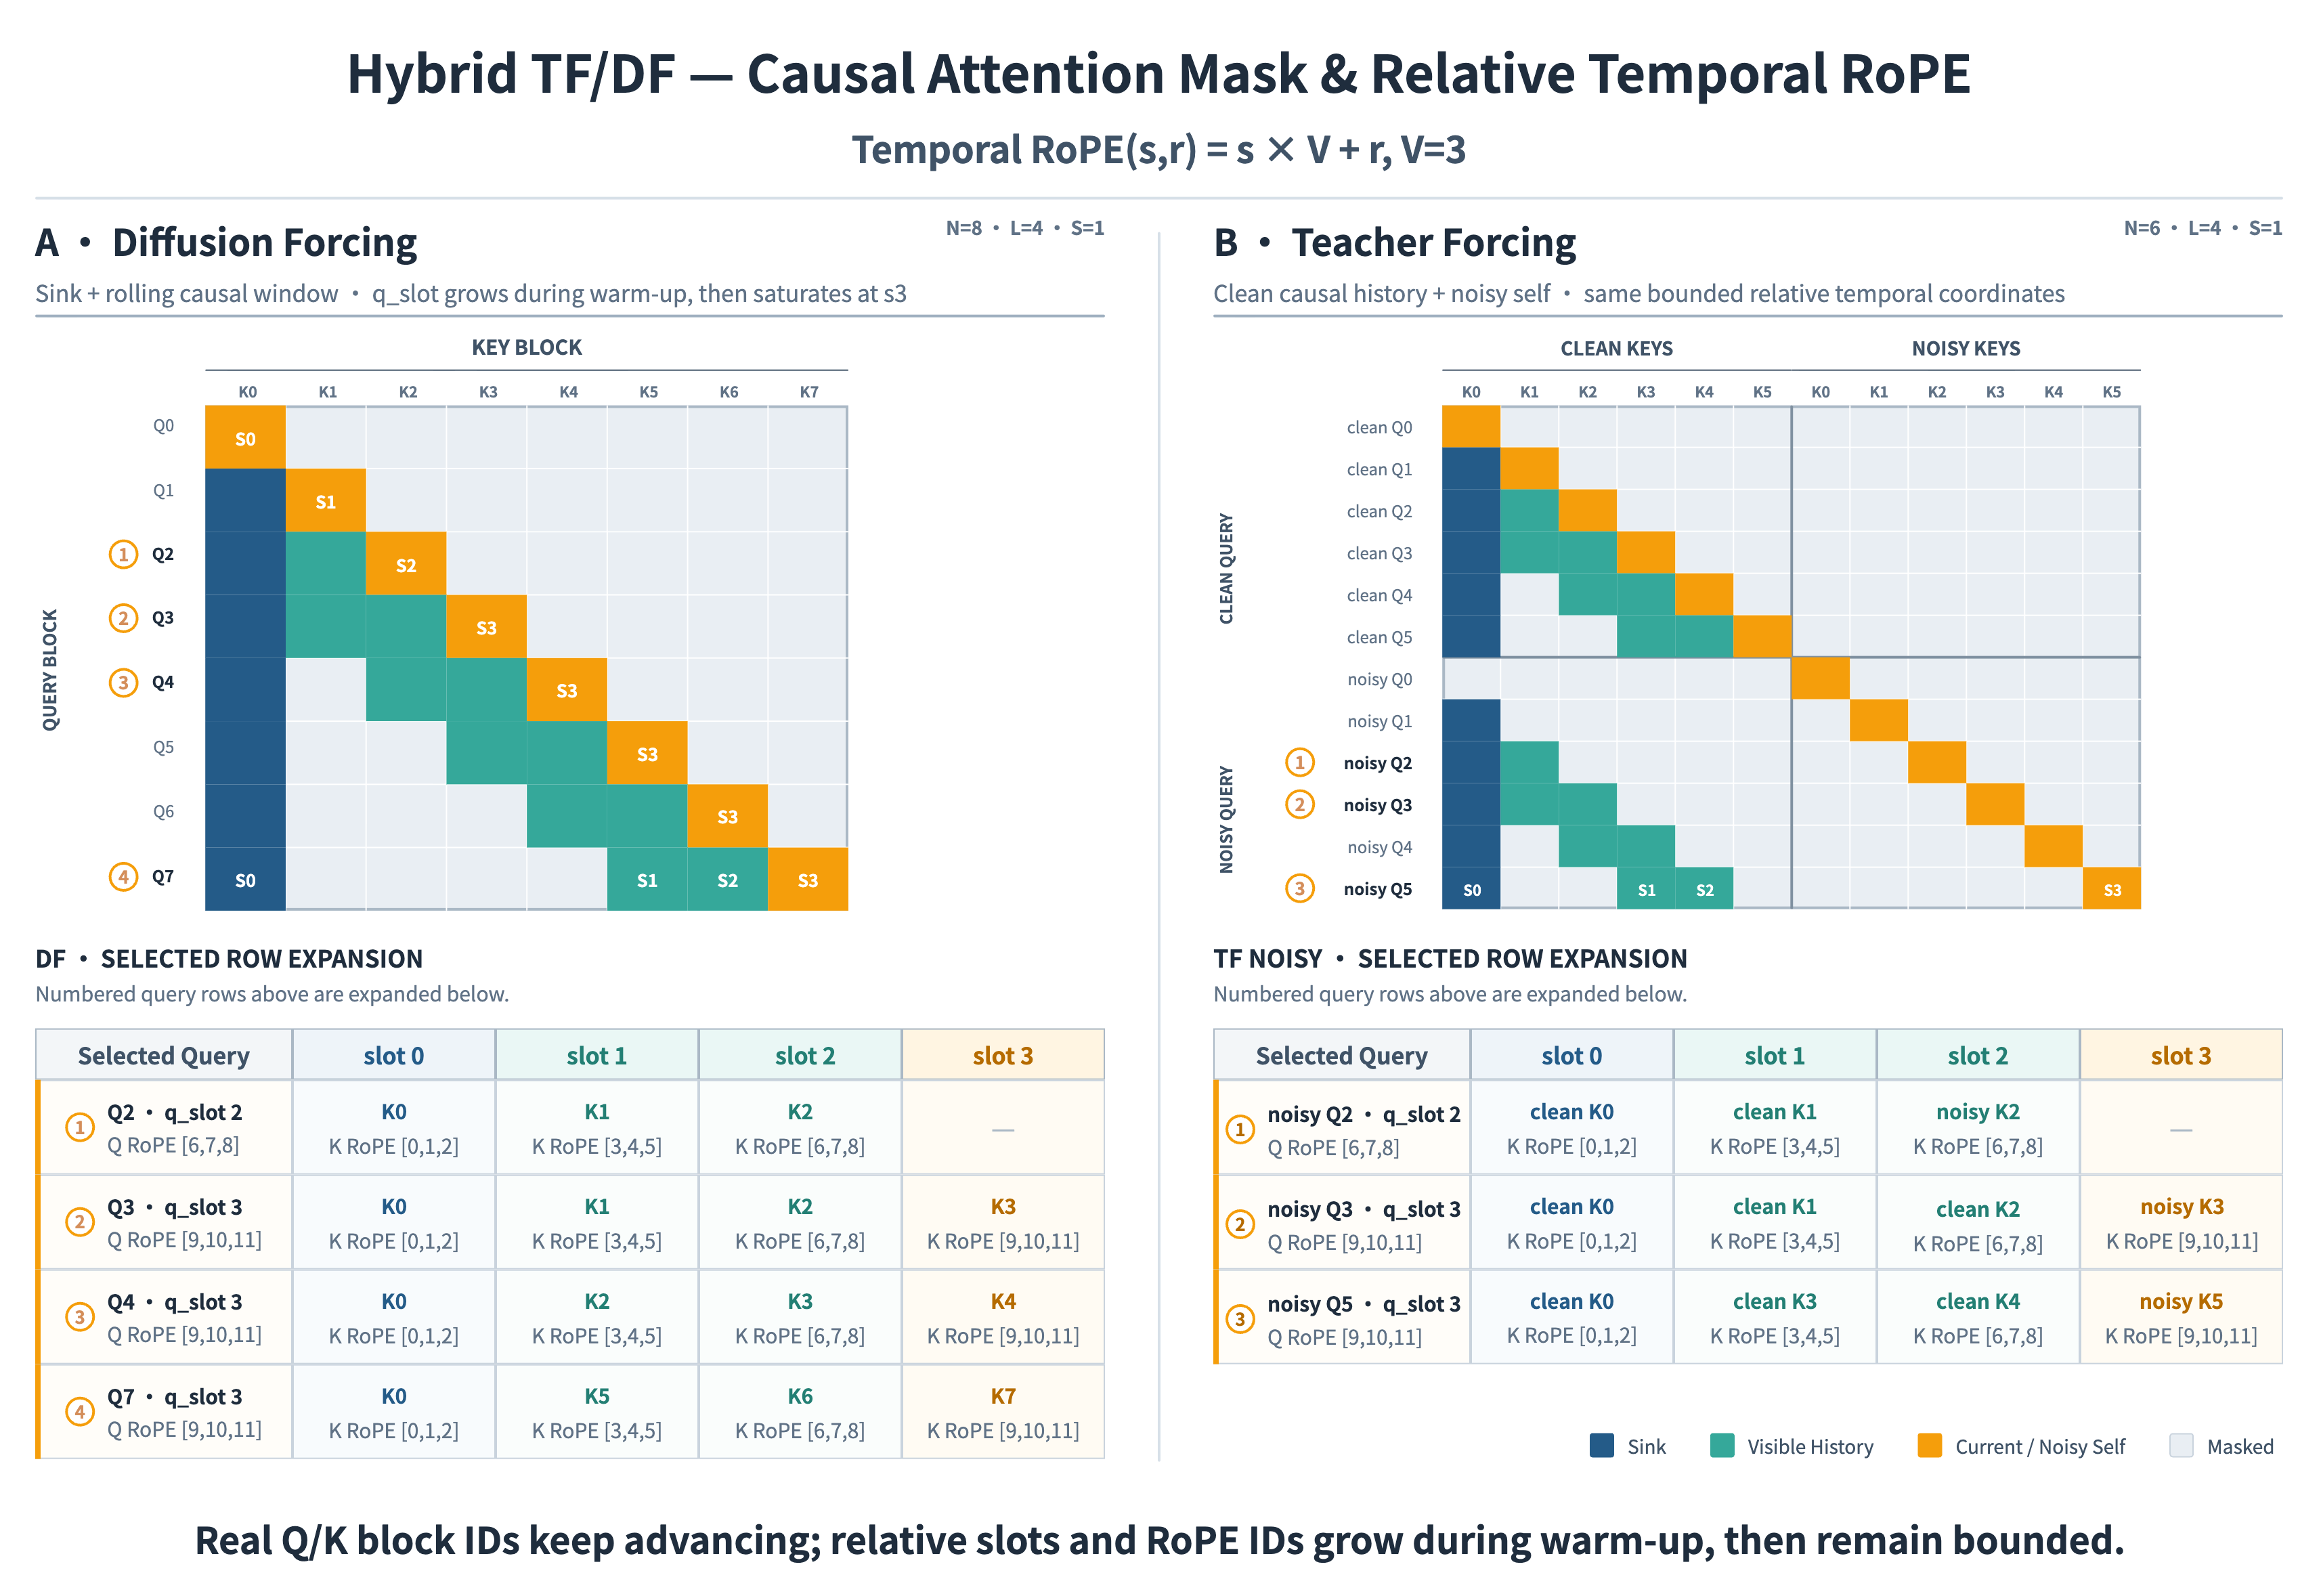
Рисунок 3. Єдина каузальна маска уваги й відносний часовий RoPE для Hybrid Teacher / Diffusion Forcing. Угорі показано каузальну видимість для двох побудов історії. Унизу репрезентативні запити зіставлено з блоками Q/K, відносними слотами й ID RoPE; видно, що реальні ID блоків і далі зростають, тоді як часові координати всередині вікна лишаються обмеженими.
Пам’ять на кількох часових масштабах
Довгострокове моделювання світу не може просто запам’ятовувати всю історію. Необмежена історія швидко підвищує вартість обчислень і пам’яті; надмірне обрізання втрачає ідентичність персонажа, постановку сцени й ключові події. R2 будує багатомасштабну систему пам’яті з Sink Memory, Rolling History та Object KV Cache.
- Sink Memory зберігає довгострокові якорі, як-от персонаж, сцена, стиль і правила світу.
- Rolling History зосереджується на недавній дії, позі, камері та змінах середовища, щоб локальний стан з’єднувався природно.
- Object KV Cache повторно використовує й стискає вже обчислені представлення історії на рівні об’єктів, утримуючи в обмеженому бюджеті ті стани, які справді впливають на подальшу еволюцію.
Утрьох вони дають довгострокову стабільність ідентичності, короткодіапазонну безперервність руху й контрольовану вартість виконання, а також зменшують дрейф персонажа, стрибки сцени, мерехтіння між чанками й зламану дію.
Error Bank
Серйозний дрейф в AR-моделі світу часто починається з невеликої ранньої помилки, записаної в історію, а потім успадкованої. R2 будує Error Bank, який зберігає репрезентативні історії помилок як повторно використовувані зразки й відтворює їх у звичайну історію із заданою частотою під час навчання. Модель більше не вчиться лише продовжувати з ідеального стану; вона також учиться розпізнавати, поглинати й виправляти історію, яка вже дрейфувала.
У поетапному оцінюванні метрика довгострокового дрейфу яскравості знизилася з 0.201 до 0.129, приблизно на 35.8%. Із 29 зразків довгих послідовностей 20 покращилися, а всі 5 зразків, які мали явно лишатися нерухомими, зменшили помилковий рух.
Прискорення в реальному часі
Прискорення R2 в реальному часі не перенавчає довгогоризонтний світ усередині few-step моделі. Воно прискорює модель світу, яка вже може стабільно працювати тривалий час. Шар прискорення починається з безперервно предобученої Omni Causal AR і використовує її і для ініціалізації студентської ODE, і як учителя дистиляції, тож учитель, студент і реальний AR-інференс поділяють узгоджений розподіл каузальної траєкторії.
Ця єдина каузальна відправна точка зменшує залежність від тюнінгу в стилі Self-Forcing і Rolling Forcing. Прискорення в реальному часі може зосередитися на проблемах, які справді вносить few-step швидкість: DDMD з адверсаріальною регуляризацією опрацьовує узгодження умов, розподіл генерації та реалістичність під час дистиляції; block-sparse attention стискає обчислення довгого контексту; а шлях pyramid знижує вартість генерації високої роздільності.
DDMD з адверсаріальною регуляризацією
В ультра-few-step генерації узгодження умов, узгодження розподілів і реалістичність — не одна й та сама задача оптимізації. R2 базується на DDMD і додатково вводить адверсаріальну регуляризацію з DMD2. Три навчальні сигнали сходяться в одному студентові: узгодження умов посилює керування, узгодження розподілів зберігає розподіл учителя, а адверсаріальна регуляризація якірить реальні дані, тож за кількох кроків семплінгу можна зберегти і точну реакцію на взаємодію, і правдоподібний світ.
Block-sparse attention
R2 застосовує block-sparse attention до просторово-часових послідовностей токенів. Модель розбиває Q, K і V на обчислювальні блоки, швидко оцінює, які блоки ключів/значень найбільше потрібні кожному блоку запитів, залишає лише зв’язки з найвищими оцінками й виконує точну softmax-увагу на цих вибраних блоках. Маршрутизація на рівні блоків — це не випадкове відсікання; вона зосереджує обчислення на сильних залежностях між поточним мультимодальним керуванням, недавнім рухом і ключовим станом світу.
Адаптуючи модель до розрідженої структури зв’язків під час навчання, R2 піднімає розрідженість уваги вище 90%, зберігаючи в поточному оцінюванні без помітного падіння якість зображення, безперервність дії, дотримання умов і довгогоризонтну стабільність.
Пірамідальна ультра-few-step дистиляція
Повне моделювання світу з нуля у просторі високої роздільності марнує обчислення на глобальну структуру, яку вже може визначити нижча роздільність. R2 організовує генерацію як один або два етапи низької роздільності плюс етап високої роздільності. Етапи низької роздільності задають компонування сцени, рух суб’єкта й структуру камери. Етап високої роздільності відновлює текстуру, контури й локальні деталі. Шлях від грубого до тонкого скорочує повторні обчислення у високій роздільності, зберігаючи сильнішу структурну стабільність і деталізацію.
Висновок і межі
PixVerse R1 запропонував і випустив першу відеомодель світу в реальному часі, показавши, що відео може перейти від офлайн-контенту з фіксованим змістом до динамічного світу, який взаємодіє в реальному часі й продовжує працювати. PixVerse R2 далі розв’язує, як ця парадигма масштабується: єдина Omni Causal AR несе зростальні дані, завдання, модальності й часові масштаби, а Real-Time Acceleration переносить повну здатність моделювати світ у few-step інференс у реальному часі.
R2 — це не точкове посилення однієї здатності. Це єдиний шлях навчання для наступного покоління моделей світу в реальному часі. R1 зробив відеомоделі світу в реальному часі реальними. R2 переводить їх на єдиний, масштабований етап постійного вдосконалення.
За суворого бюджету обчислень у реальному часі та затримки взаємодії якість однієї генерації й досі має простір для покращення порівняно з провідними офлайн-відеомоделями, особливо в деталях складних сцен, природності руху, фізичній узгодженості та стабільності на довгих запусках. Ці розриви частіше відображають поточний етап масштабування R2, ніж стелю самої архітектури.
Ранній доступ
Станом на 23 серпня 2026 року цей звіт описував PixVerse R2 як закрите тестування. 22 вересня 2026 року PixVerse оголосив, що добірку цих світів відкрито для дослідження на world.pixverse.video. Див. анонс запуску R2.
Цей анонс не відкриває необмежений доступ до API. Форма досвіду світової моделі PixVerse R2 лишається маршрутом запиту на ранній досвід і доступ до API.
Пов’язані матеріали
- PixVerse R1 пояснено: відеомодель світу ШІ в реальному часі
- Глибокий розбір ігрового рушія PixVerse
- PixVerse оновлює R1 спільними світами
- Посібник із генерації відео ШІ в реальному часі
- PixVerse закриває розширення раунду Series C
Світи з анонсу від 22 вересня 2026 року відкриті для дослідження на world.pixverse.video. Доступ до API й досі запитують через форму вище. Сьогодні також можна створювати з PixVerse V6 і R1.