PixVerse R2: การขยายเวิลด์โมเดล Omni แบบเรียลไทม์
PixVerse R1 แนะนำและส่งมอบเวิลด์โมเดลวิดีโอแบบเรียลไทม์ตัวแรก โดยเปลี่ยนการสร้างวิดีโอจากการส่งมอบคลิปความยาวคงที่แบบครั้งเดียว ให้เป็นโลกที่รันอย่างต่อเนื่อง โมเดลรับอินพุตของผู้ใช้ต่อไปได้ อัปเดตสถานะโลกแบบเรียลไทม์ และสตรีมเสียงกับวิดีโอที่ซิงค์กันซึ่งสอดคล้องกับการโต้ตอบ R1 แสดงให้เห็นว่ากระบวนทัศน์ทางเทคนิคนี้ใช้ได้จริง
PixVerse R2 ตอบคำถามถัดไป: เวิลด์โมเดลวิดีโอแบบเรียลไทม์จะขยายต่อไปอย่างไร R2 มุ่งสองเป้าหมาย แรก สร้างโลกไดนามิกที่ถือสถานะรวมได้ในระยะยาว โดยแปลงไพรเออร์เชิงปริภูมิ-เวลาเต็มรูปแบบให้เป็นวิวัฒนาการของโลกที่เดินหน้าในเวลาเท่านั้น สอง ซึมซับความเป็นเหตุเป็นผลทางกายภาพและสัญญาณการโต้ตอบจากข้อความ ข้อมูลอ้างอิง เสียง และการกระทำเข้าสู่โมเดลเดียวอย่างต่อเนื่อง เพื่อให้โลกสร้าง รับการควบคุม และอัปเดตสถานะได้ในเวลาเดียวกัน ขณะสตรีมเสียงและวิดีโอที่ซิงค์กัน
รอบเป้าหมายเหล่านั้น R2 เปลี่ยนการเติบโตของโมเดล ข้อมูล งาน สัญญาณควบคุม และสเกลเวลา ให้เป็นผลได้ด้านคุณภาพการสร้าง ความสอดคล้องระยะไกล และการควบคุมมัลติโมดัล
กรอบงานโดยรวม
R2 ยุบระบบให้เหลือสองชั้นแกน: Omni Causal AR และ การเร่งแบบเรียลไทม์ Omni Causal AR ขยายการสร้างโลกคุณภาพสูง มัลติโมดัล และระยะยาวต่อไป การเร่งแบบเรียลไทม์รับความสามารถเหล่านั้นมาโดยสูญเสียน้อยที่สุดเท่าที่จะทำได้ ภายใต้งบความหน่วงการโต้ตอบที่เข้มงวด เส้นทางชัดเจน: ยกระดับเพดานความสามารถของเวิลด์โมเดล แล้วเร่งความสามารถนั้นเข้าสู่ช่วงปฏิบัติการแบบเรียลไทม์และโต้ตอบได้
ไปป์ไลน์วิดีโอยาวและเรียลไทม์รุ่นก่อนมักต่อขั้นตอนการฝึกหลายขั้น: แปลงโมเดลสองทิศทางเป็นโมเดล AR สร้างครูกลั่นจากโมเดลสองทิศทางเฉพาะงาน รันการกลั่น DMD แล้วเพิ่ม self-rollout DMD เพื่อปิดช่องว่างระหว่างการฝึกกับการอนุมาน แต่ละขั้นต้องย้ายความสามารถใหม่ จัดวัตถุประสงค์ให้ตรงกันอีกครั้ง และฟิตการแจกแจงข้อมูลใหม่ คุณภาพภาพ การเคลื่อนไหว การตามเงื่อนไข และความเสถียรระยะยาวอาจเสื่อมระหว่างการถ่ายโอนเหล่านั้น เมื่อสเกลของโมเดล ข้อมูล และงานโตขึ้น ไปป์ไลน์หลายขั้นแยกเป้าหมายการปรับให้เหมาะสม และเพิ่มทั้งต้นทุนการฝึกและความซับซ้อนของระบบ
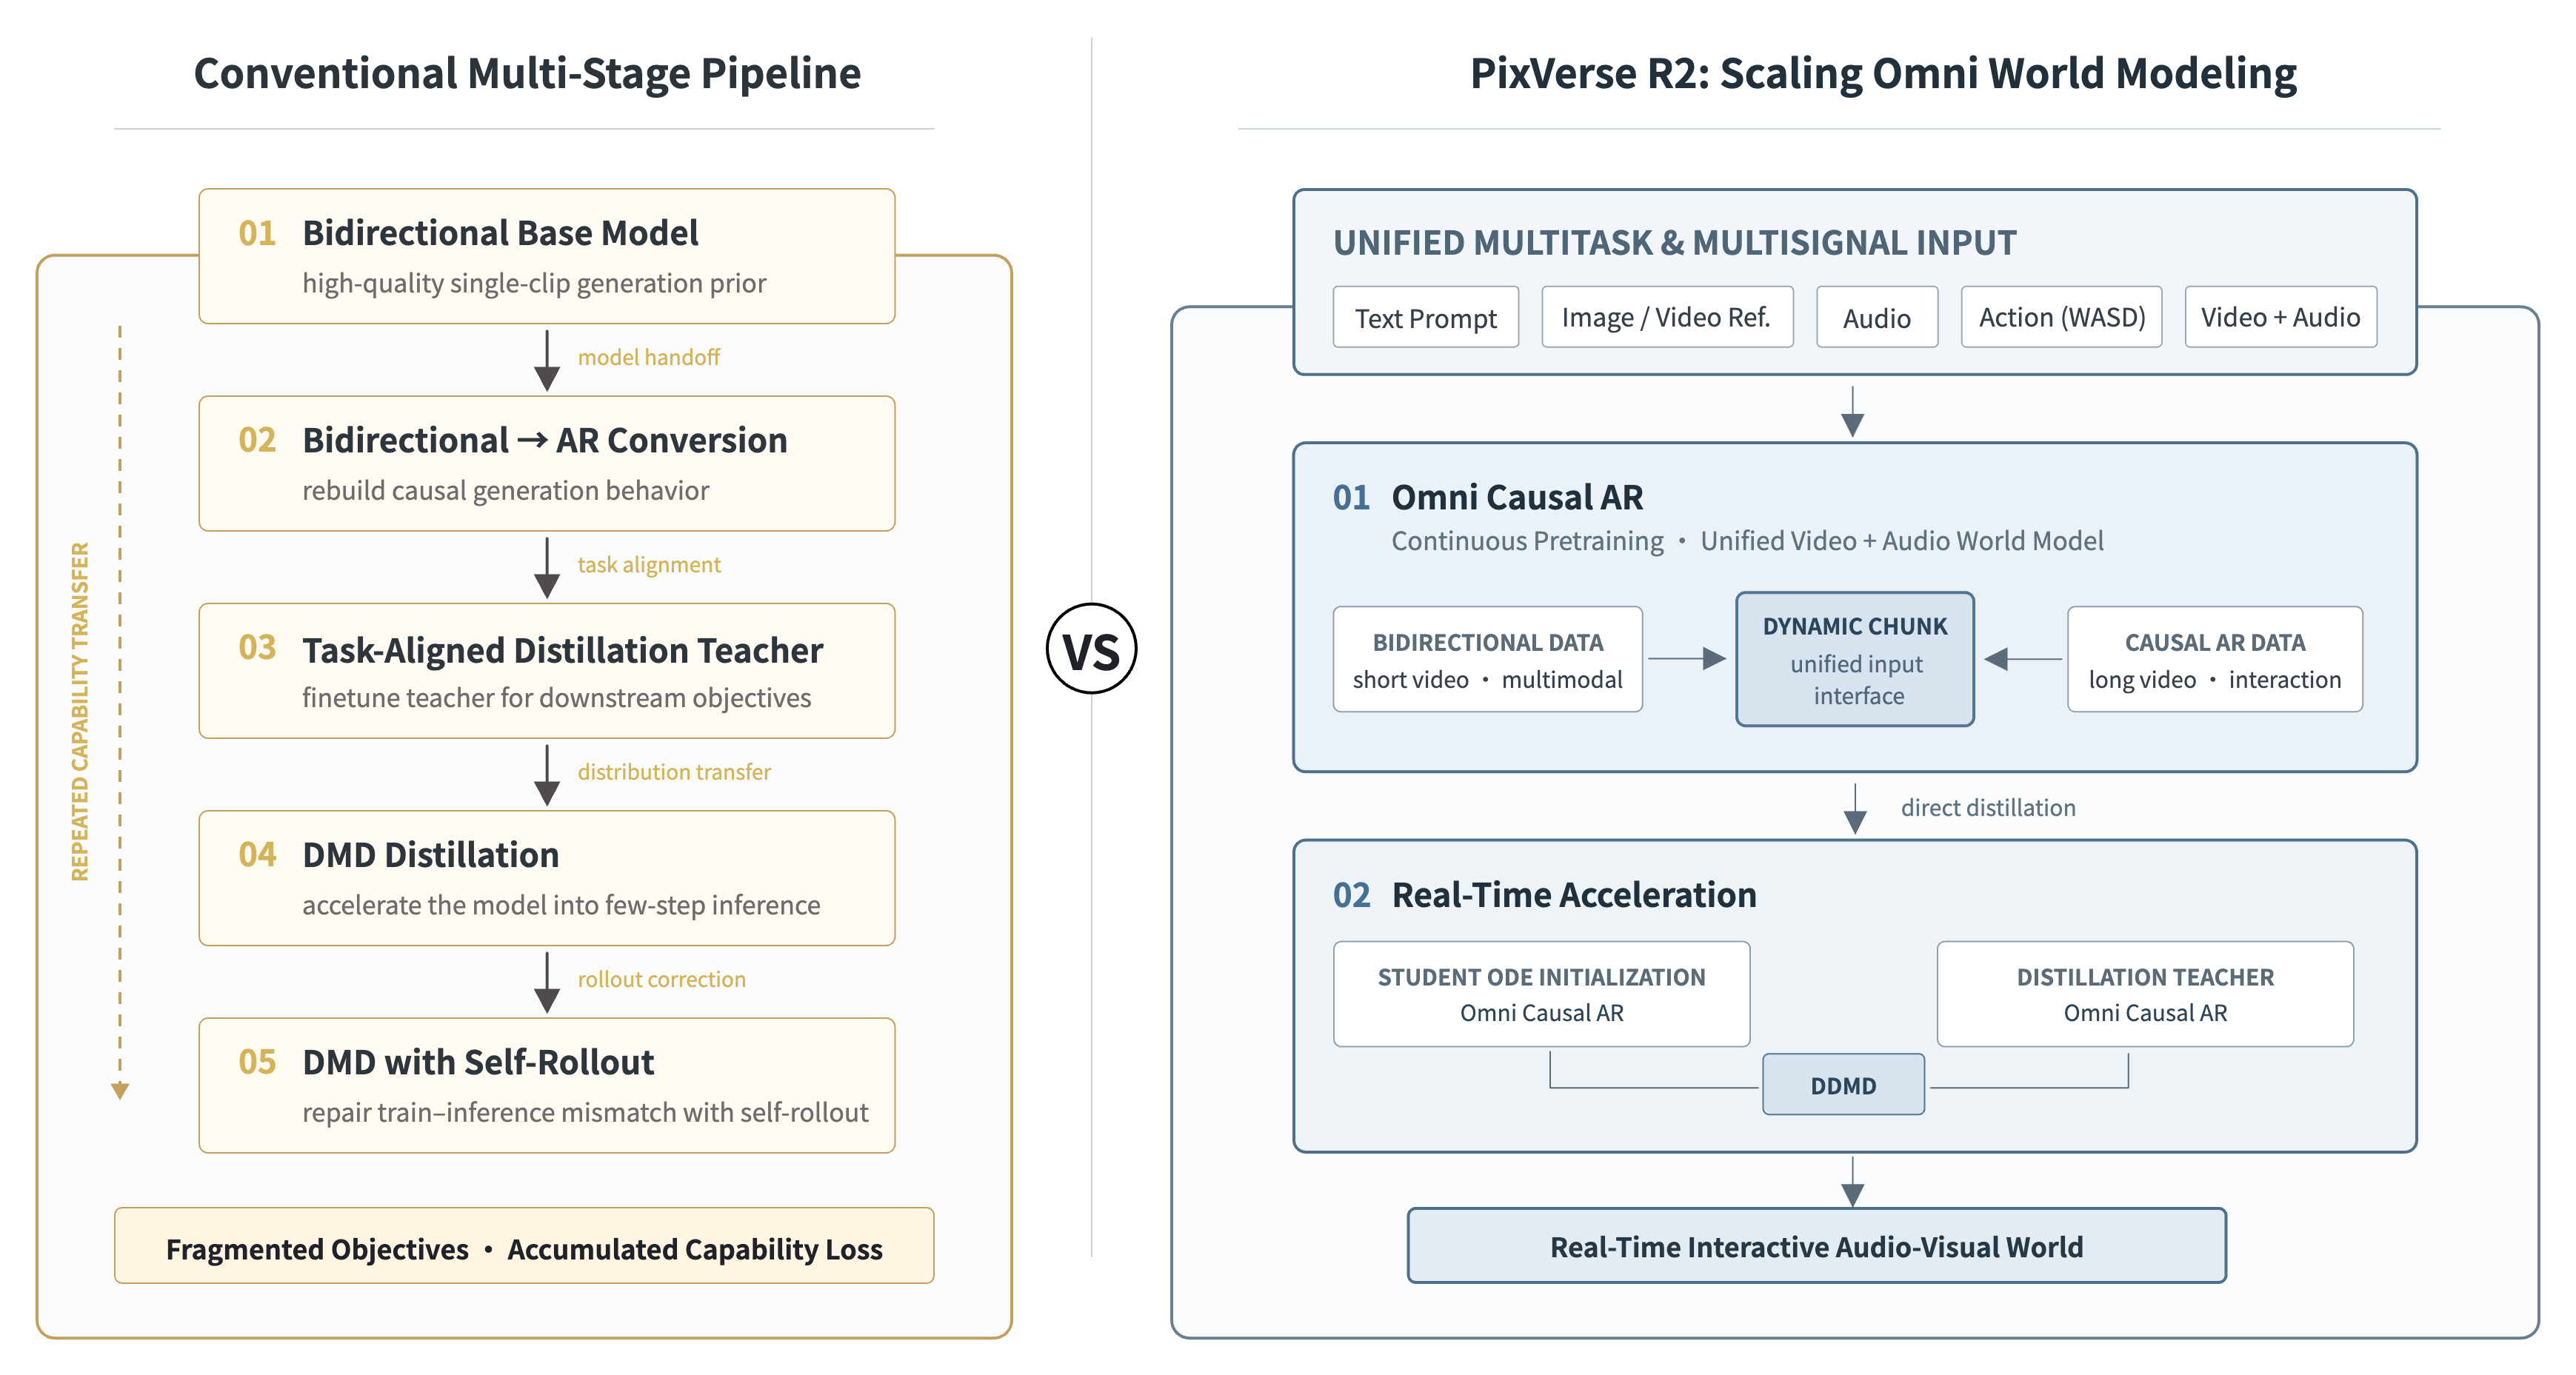
รูปที่ 1 ไปป์ไลน์หลายขั้นแบบเดิมเทียบกับการขยายการโมเดลโลกของ PixVerse R2 R2 รวมการขยายความสามารถและการกลั่นแบบเรียลไทม์เข้าสู่ Omni Causal AR และชั้นเร่งแบบเรียลไทม์ โดยรวมการโมเดลหลายงาน หลายสัญญาณ และวิดีโอยาวไว้ในเฟรมเวิร์กเดียว
PixVerse R2 เสนอกระบวนทัศน์การฝึกแบบรวมสำหรับเวิลด์โมเดลเรียลไทม์ แทนที่จะย้ายความสามารถซ้ำ ๆ ข้ามโมเดลและขั้นงานจำนวนมาก มันลดไปป์ไลน์ที่ซับซ้อนให้เหลือสองกระบวนการที่ขยายต่อไปได้: พรีเทรน Omni Causal AR ที่ถือสถานะโลกแบบรวมอย่างต่อเนื่อง แล้วกลั่นโดยตรงเป็นโมเดลที่เร่งแล้วซึ่งสร้างแบบเรียลไทม์ได้ ขณะรับความสอดคล้องเชิงพื้นที่และการโมเดลระยะยาวมาด้วย
ขอบเขตขั้นที่น้อยลงลดการสูญเสียความสามารถที่มาจากครูอิสระ การจัดแนวงาน และการถ่ายโอนโมเดลซ้ำ ๆ ข้อมูล งาน สัญญาณควบคุม และสเกลโมเดลใหม่สามารถแปลงเป็นความสามารถการโมเดลโลกแบบเรียลไทม์ได้ตรงกว่า
ขั้นที่ 1: การพรีเทรนต่อเนื่องของ Omni Causal AR R2 ไม่ถือว่าไพรเออร์การสร้างแบบสองทิศทางกับ AR วิดีโอยาวเป็นสองขั้นที่ขาดจากกันอีกต่อไป แต่ฝึก Omni Causal AR แบบรวมอย่างต่อเนื่องบนความสามารถของโมเดลสองทิศทาง ชังก์ไดนามิกให้รูปแบบข้อมูลที่ต่างกันมีการแทนค่าเชิงเวลาร่วมกัน: โมเดลดูดซับวิดีโอสั้นคุณภาพสูงและข้อมูลมัลติโมดัลจากการพรีเทรนแบบสองทิศทางได้ และขยายไปสู่วิดีโอยาวต่อเนื่องกับวิถีการโต้ตอบหลายเทิร์นได้ คุณภาพภาพ การแสดงออกด้านภาพและเสียง การสร้างระยะยาว และการควบคุมหลายสัญญาณสามารถขยายภายในโมเดลเดียว แทนที่จะถูกย้ายซ้ำผ่านการแปลงหลายครั้ง
ขั้นที่ 2: กลั่นชั้นเร่งแบบเรียลไทม์จาก Omni Causal AR ที่ขยายแล้ว การพรีเทรนต่อเนื่องให้ Omni Causal AR มีการสร้างคุณภาพสูง การถ่ายโอนสถานะระยะยาวที่เสถียร และการโรลเอาต์เชิงเหตุผลจริงในเวลาเดียวกัน จากนั้น R2 ใช้ Omni Causal AR เดียวกันทั้งสำหรับการเริ่มต้น ODE ของนักเรียนและครูกลั่น ดังนั้นครู นักเรียน และการอนุมาน AR จริงจึงใช้ฐานการโมเดลเชิงเหตุผลที่สอดคล้องกัน การกลั่นแบบเรียลไทม์จึงกลายเป็น “การเร่งไม่กี่ขั้นของเวิลด์โมเดลที่มีอยู่” ไม่ใช่ “การเรียนรู้โลกระยะยาวใหม่”
Omni Causal AR
R2 สานต่อเส้นทางอินพุตมัลติโมดัล การสร้างแบบออโตรีเกรสซีฟ และการโต้ตอบแบบเรียลไทม์ที่ R1 ได้พิสูจน์แล้ว แล้วรวบรวมความสามารถเหล่านั้นเข้าสู่เส้นทางการฝึก Omni Causal AR แบบรวม Omni Causal AR แปลงไพรเออร์การสร้างเชิงปริภูมิ-เวลาเต็มรูปแบบให้เป็นการถ่ายโอนสถานะโลกที่เดินหน้าในเวลาเท่านั้น ผ่านการทำให้เป็นเชิงเหตุผลและการพรีเทรนต่อเนื่อง โมเดลคงความสามารถด้านภาพ การเคลื่อนไหว เสียง และความหมายมัลติโมดัล ขณะเรียนรู้ที่จะทำนายชังก์ภาพและเสียงที่ซิงค์กันถัดไปจากประวัติเพียงอย่างเดียว
เมื่อวัตถุการฝึกขยายจากวิดีโอสั้นอิสระไปสู่วิดีโอยาวต่อเนื่องและวิถีการโต้ตอบหลายเทิร์น โมเดลค่อย ๆ สร้างความเป็นเหตุเป็นผลระยะยาวระหว่างสถานะโลกในอดีต อินพุตการโต้ตอบปัจจุบัน และวิวัฒนาการของโลกในอนาคต
โมเดลรับพรอมต์ข้อความ ภาพอ้างอิงหลายโหมด สัญญาณแอ็กชัน (เช่น WASD หรือการควบคุมต่อเนื่อง) และเสียงพร้อมกัน แล้วส่งออกวิดีโอกับเสียงที่ซิงก์กัน สัญญาณควบคุมที่ต่างกันเข้าโมเดลต่อได้ระหว่างรันและเปลี่ยนสถานะโลกในภายหลัง R2 ไม่ได้ตอบเพียงเงื่อนไขครั้งเดียว มันสร้าง รับการควบคุม และอัปเดตโลกได้ในเวลาเดียวกัน
เพื่อให้การสร้างแบบ causal อยู่ในโลกเดียวกันตลอดการรันยาว R2 จัดการสี่ปัญหา: ช่องว่างการกระจายระหว่างเทรนกับอินเฟอเรนซ์ ความทนทานต่อประวัติที่มีสัญญาณรบกวน การประสานหน่วยความจำระยะยาวกับล่าสุด และการแก้ไขสถานะข้อผิดพลาด Hybrid Teacher / Diffusion Forcing ให้โมเดลปรับได้ทั้งประวัติที่สะอาดและมีสัญญาณรบกวน Multi-Timescale Memory เก็บจุดยึดโลก พลวัตล่าสุด และสถานะวัตถุร่วมกัน Error Bank นำสถานะที่ล้มเหลวกลับเข้าการฝึก สิ่งเหล่านี้รวมกันเป็นลูปการฝึกสำหรับสถานะโลกระยะยาว และลดการลอยของภาพ ตัวละคร การเคลื่อนไหว ความสัมพันธ์ภาพ-เสียง และการตอบสนองการควบคุมเมื่อเวลาผ่านไป
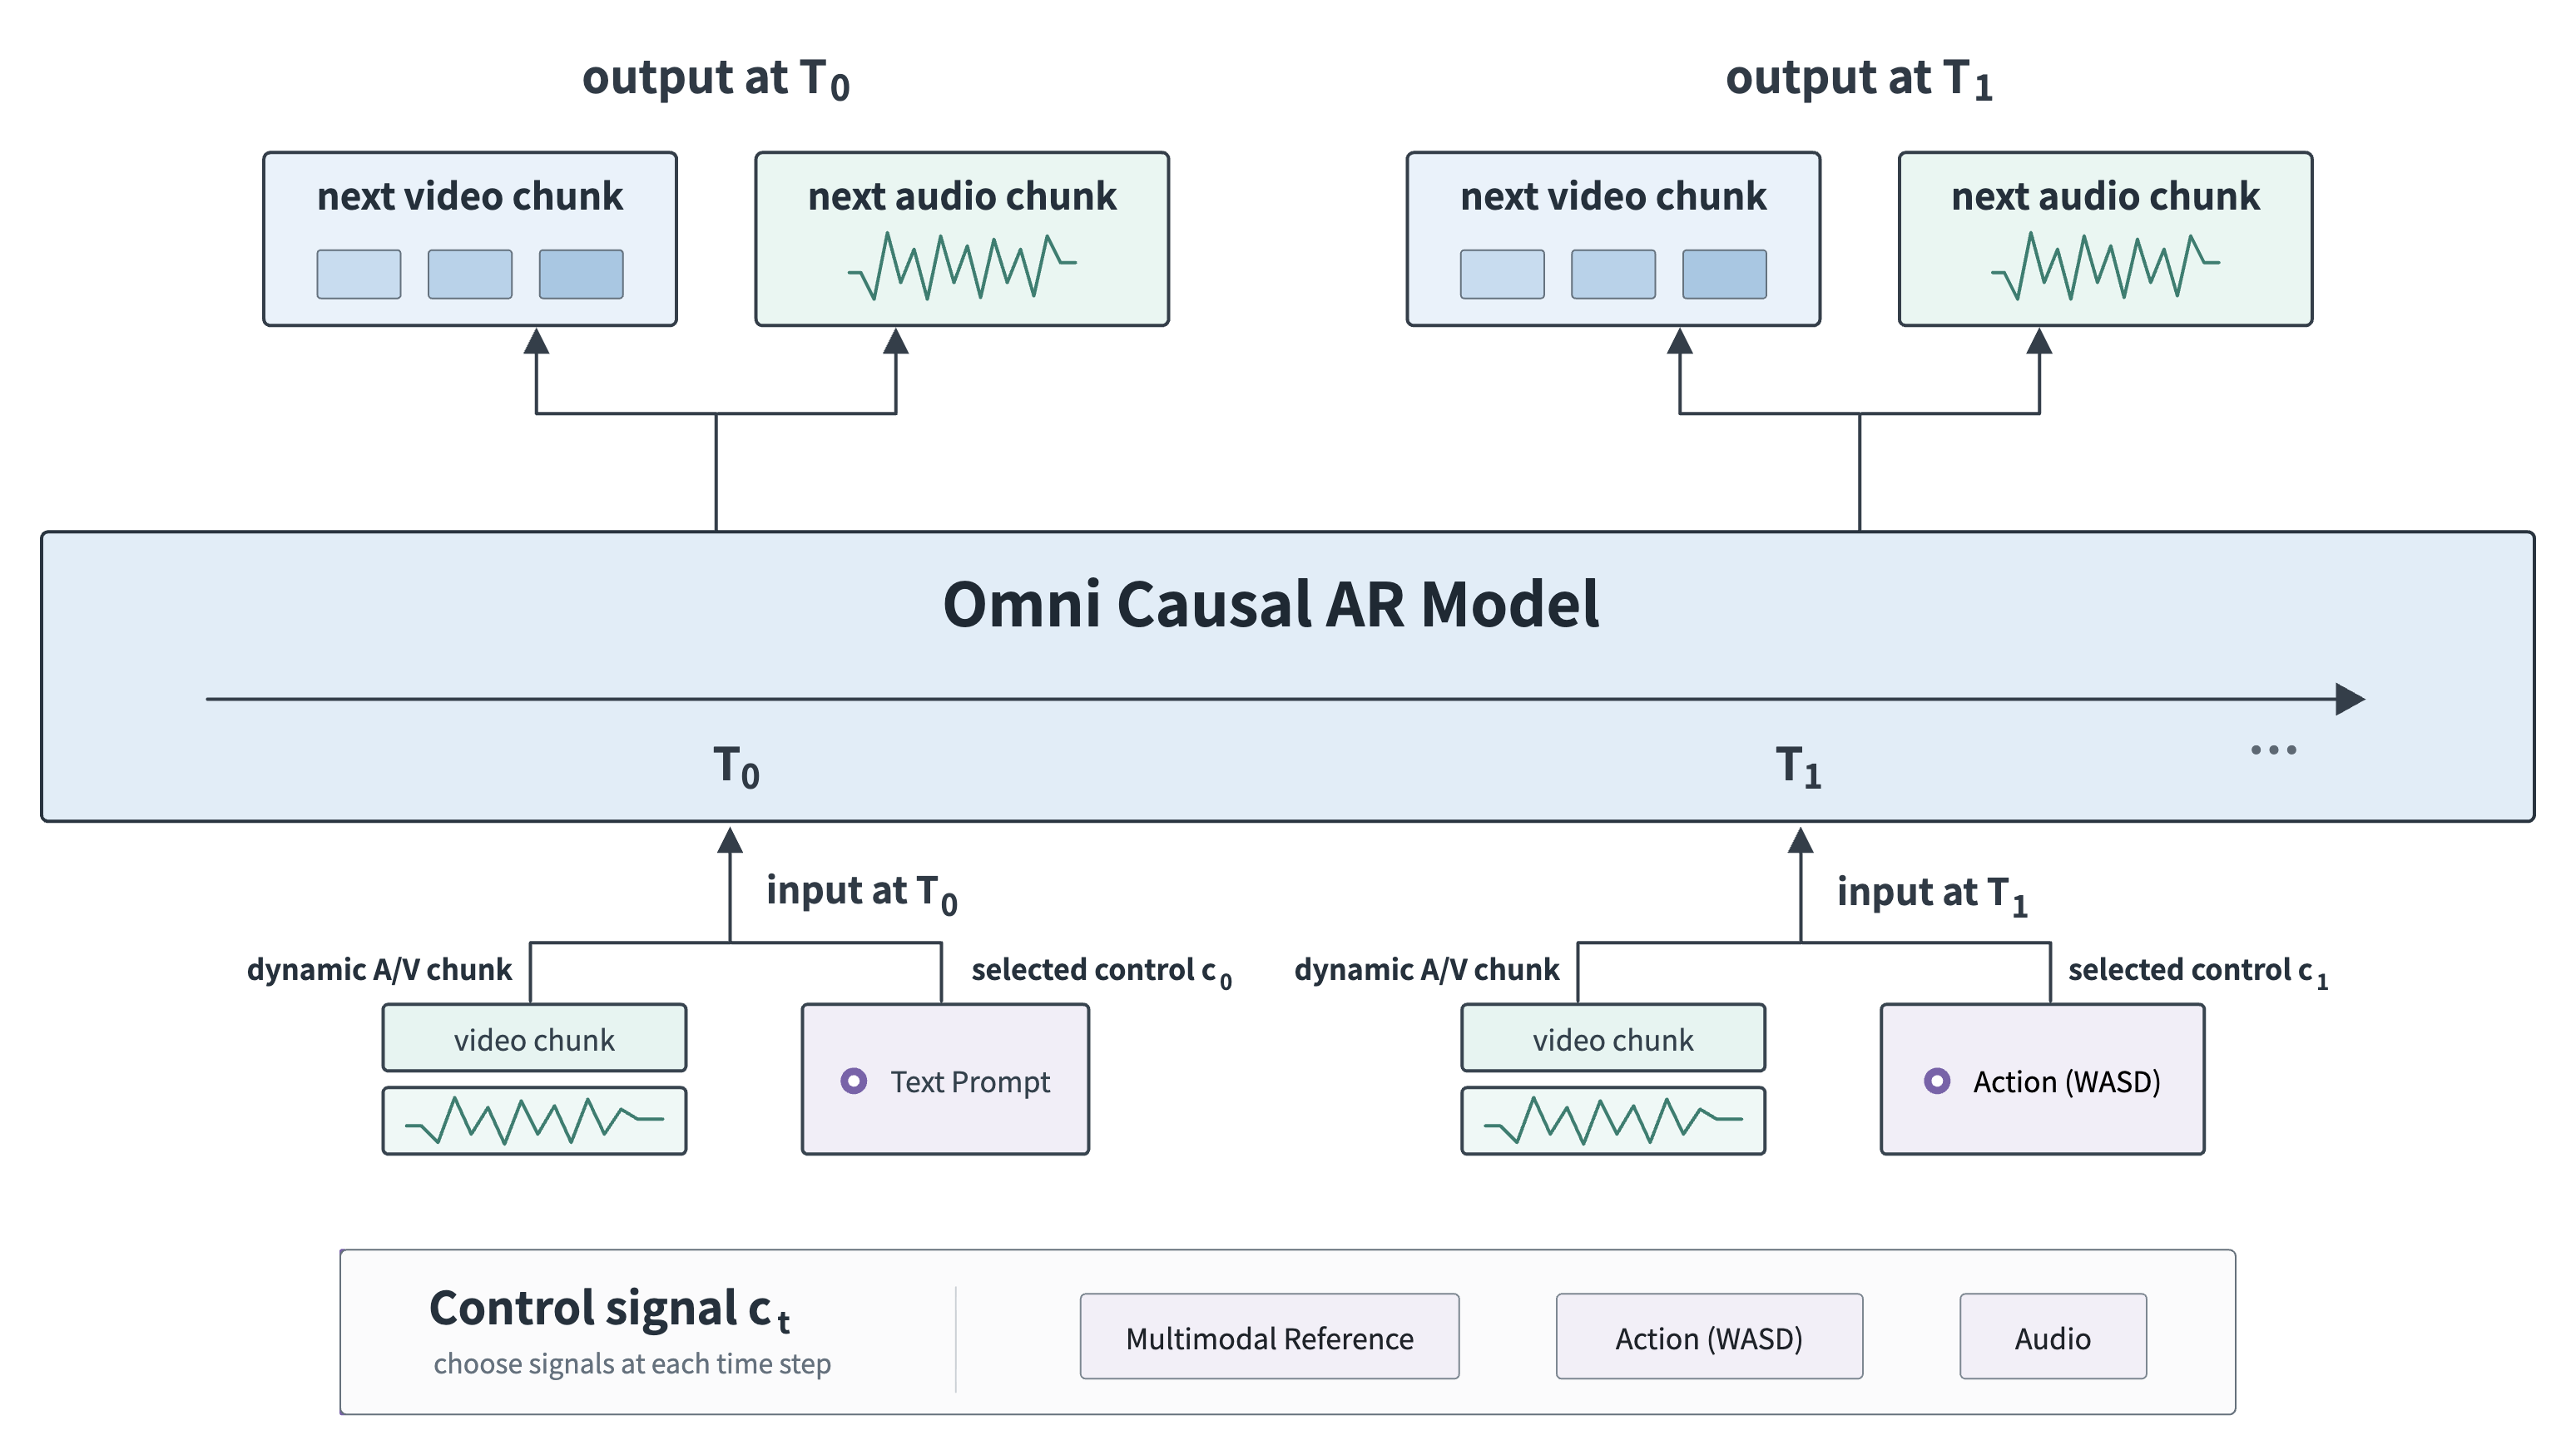
รูปที่ 2. PixVerse R2 Omni Causal AR โมเดลรับสัญญาณควบคุมที่ต่างกันต่อได้ระหว่างรัน ในแต่ละจังหวะปฏิสัมพันธ์ สัญญาณที่ทำงานอยู่จัดแนวกับชิ้นภาพเสียงแบบไดนามิกที่ความละเอียดตรงกัน และขับเคลื่อนส่วนวิดีโอกับเสียงถัดไป
การสร้างชิ้นแบบไดนามิก
สัญญาณควบคุมต่างกันอยู่บนไทม์สเกลต่างกัน พรอมต์และภาพอ้างอิงมักอธิบายความหมายเต็มหรือเหตุการณ์ที่ยาวกว่า แอ็กชัน (WASD) ต้องการฟีดแบ็กสถานะทันทีที่ละเอียด เสียงพาความหมาย จังหวะ และการซิงก์เวลาพร้อมกัน ถ้าบังคับทุกอินพุตเข้าหน่วยเวลาความยาวคงที่ โมเดลมักต้องแลกความเร็วในการตอบกับความครบของการแสดงออก
Dynamic Chunk คือวิธีที่ R2 รวมไทม์สเกลปฏิสัมพันธ์เหล่านั้น R2 แบ่งลำดับภาพเสียงตามขอบเขตความหมายและระยะเวลาของสัญญาณควบคุมปัจจุบันอย่างปรับตัวได้ โดยมีขนาดชิ้นสูงสุดที่จำกัดการคำนวณและความเสถียรของการฝึก ชิ้นสั้นเพิ่มความแม่นยำในการตอบสำหรับแอ็กชันและคำสั่งเฉพาะจุด ชิ้นยาวรักษาโครงสร้างเต็มของเหตุการณ์ การเคลื่อนไหว และความหมายภาพเสียง งานและสัญญาณควบคุมต่างกันใช้ส่วนติดต่อการสร้างแบบ causal เดียวกันได้โดยไม่สลับโครงสร้างโมเดล
Hybrid Teacher Forcing / Diffusion Forcing
ความตึงหลักใน AR ขอบฟ้ายาวคือประวัติตอนฝึกมักสะอาดกว่า ขณะที่ประวัติตอนรันจริงมีสัญญาณรบกวนและข้อผิดพลาดเฉพาะจุดของโมเดลเอง การฝึกเฉพาะประวัติสะอาดอาจยกเพดานคุณภาพทีละขั้น แต่ทำให้โมเดลไวต่อความเบี่ยงเล็กๆ มากเกินไป การฝึกเฉพาะประวัติที่ถูกรบกวนอาจทำลายคุณภาพภาพ การเคลื่อนไหว และการตอบสนองการควบคุม
R2 ผสมประวัติสะอาดกับประวัติที่มีสัญญาณรบกวนในกระบวนการฝึกเดียว ประวัติสะอาดทำให้เพดานคุณภาพของวิวัฒนาการโลกเสถียร ประวัติที่มีสัญญาณรบกวนให้โมเดลปรับล่วงหน้ากับสถานะไม่สมบูรณ์ที่เจอตอนใช้งานจริง การฝึกที่เสริมกันนี้ลดช่องว่างเทรน-อินเฟอเรนซ์ จึงสร้างส่วนโลกถัดไปคุณภาพสูงได้ และเดินหน้าต่อได้เมื่อประวัติมีข้อผิดพลาดเล็กอยู่แล้ว
Causal Attention Mask และ Relative Temporal RoPE ร่วมกันจำกัดว่าสถานะปัจจุบันอ่านประวัติใดได้ และประวัตินั้นอยู่ตรงไหนในหน้าต่างปัจจุบัน Attention Mask บังคับการมองเห็นแบบ causal อย่างเคร่งครัด Temporal RoPE ไม่โตไร้ขอบเขตตาม block ID ระดับโลก แต่ถูกจัดดัชนีใหม่ตามสล็อตสัมพัทธ์ในหน้าต่าง attention ปัจจุบัน เมื่อหน้าต่างเลื่อนไปข้างหน้า เวลาจริงเดินต่อ แต่ sink memory ประวัติล่าสุด และชิ้นปัจจุบันยังถูกแมปอยู่ในช่วงตำแหน่งสัมพัทธ์ที่เสถียรและมีขอบเขต
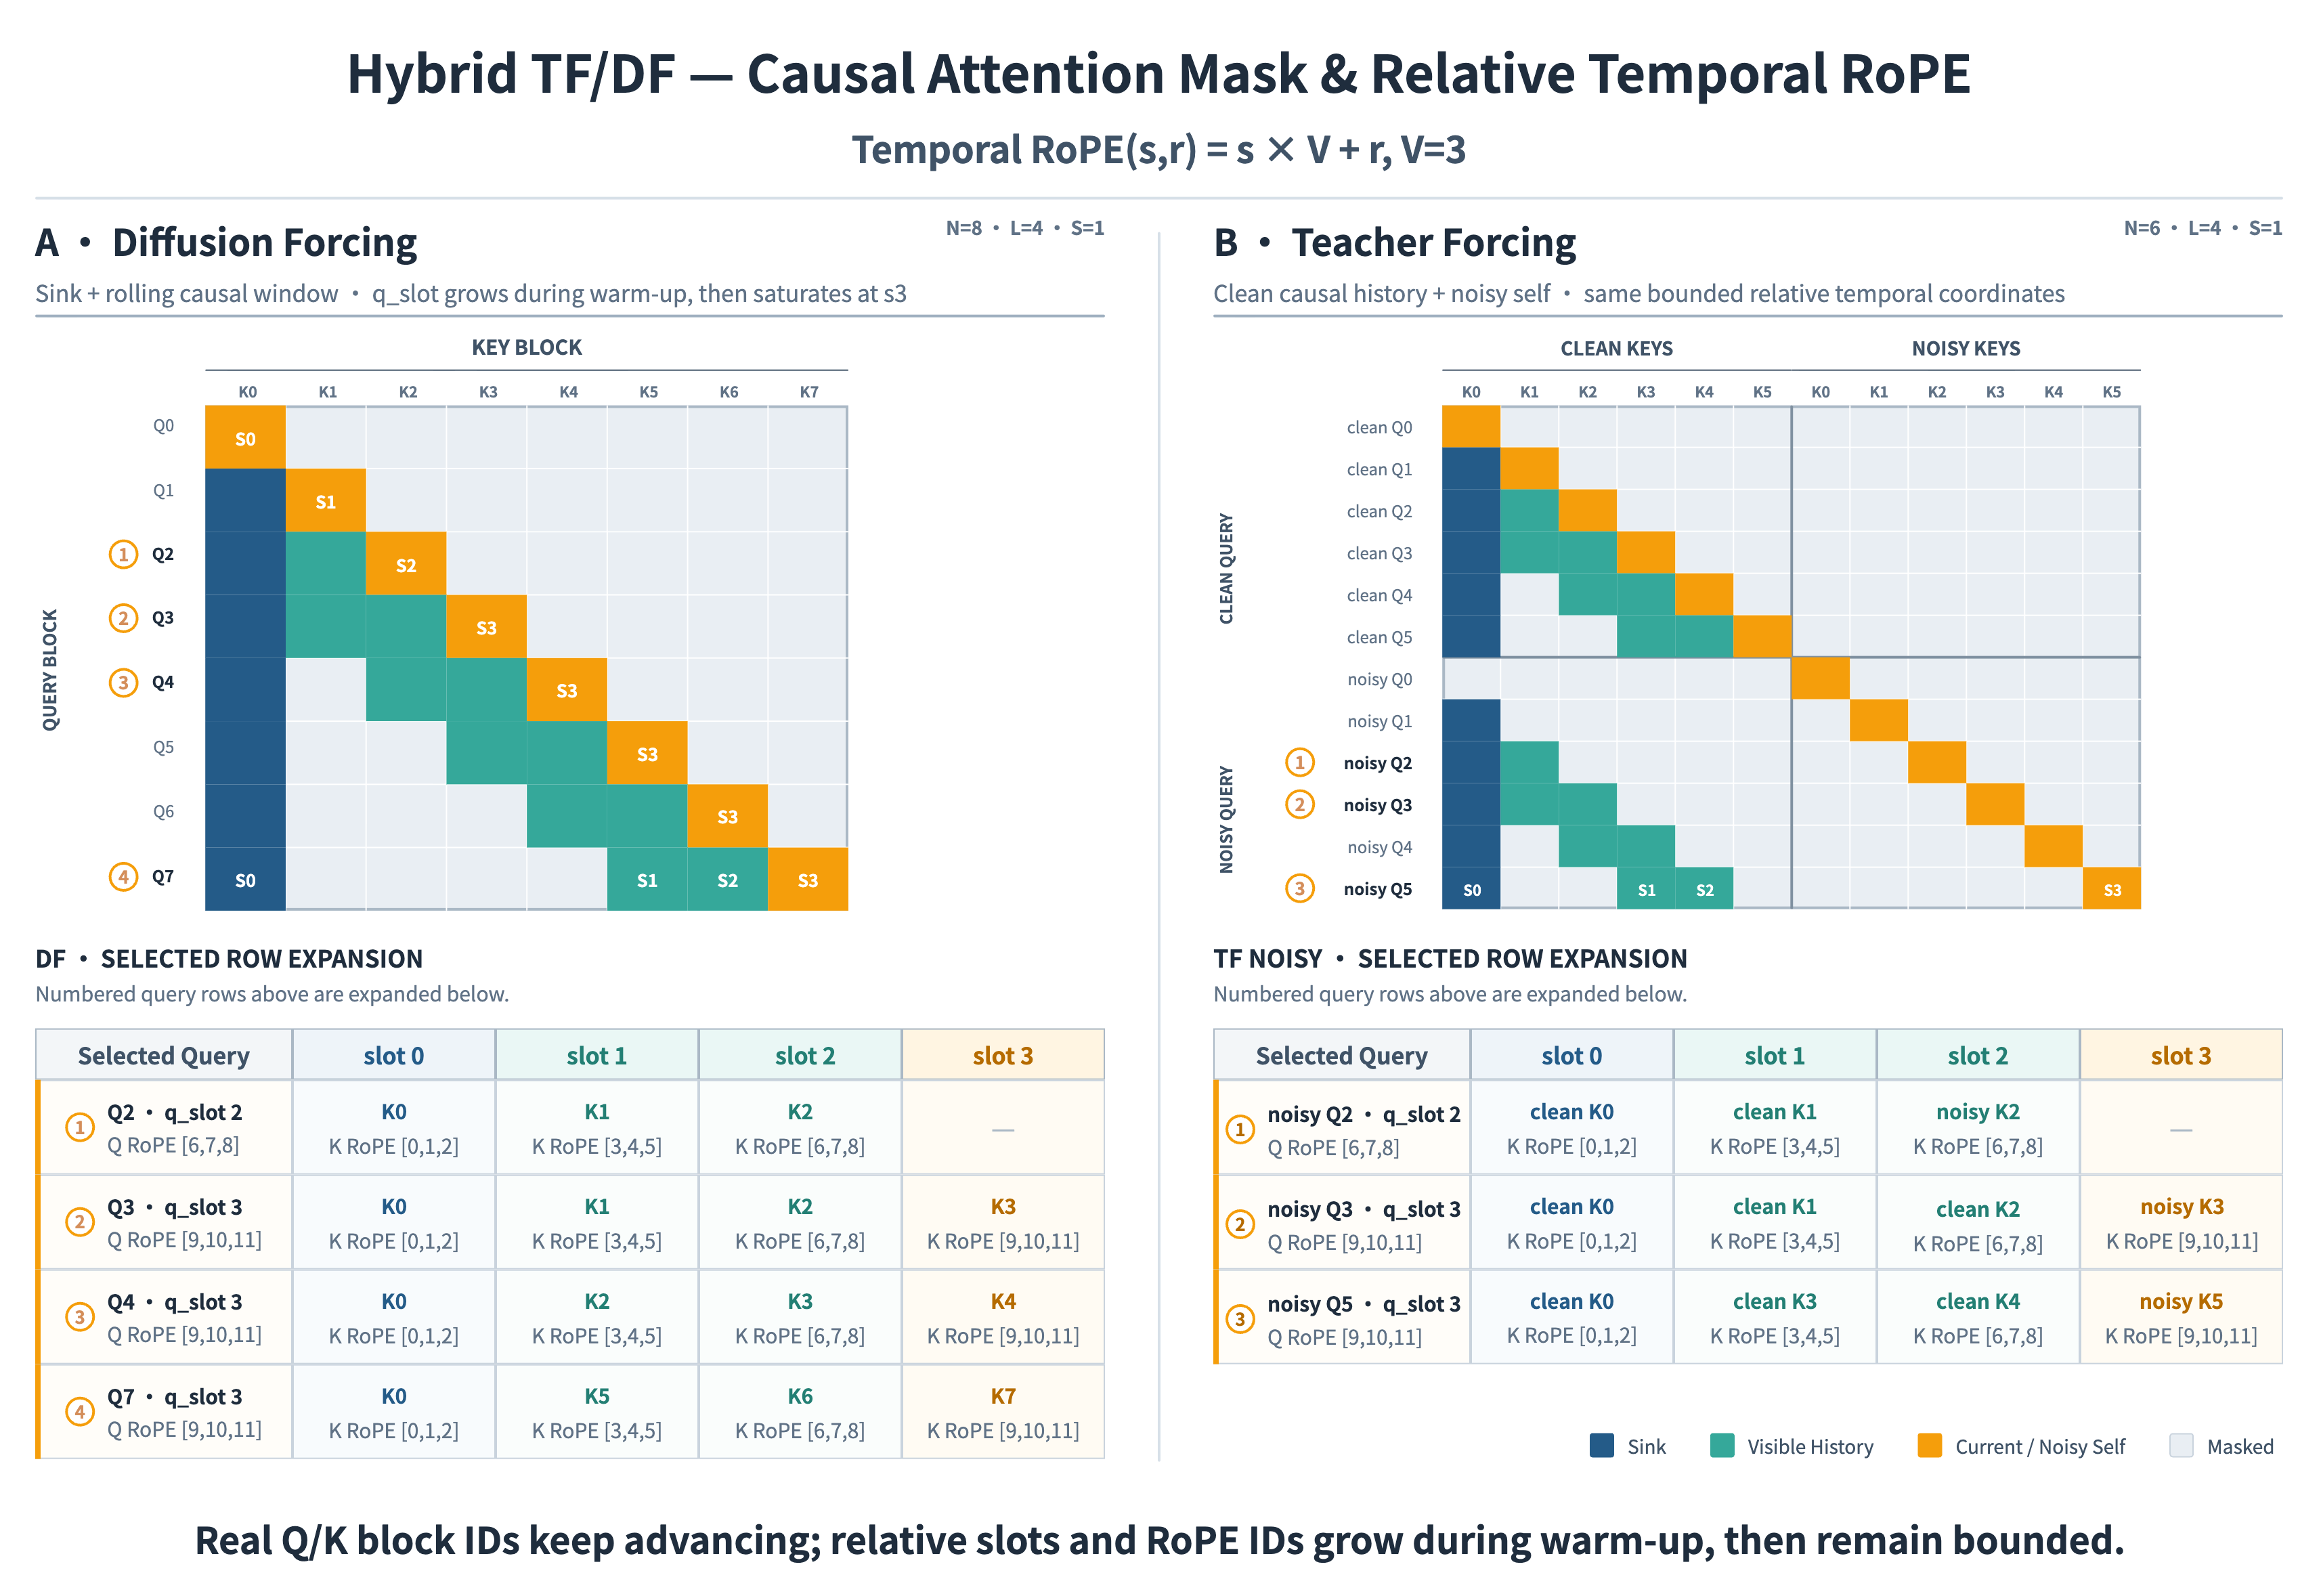
รูปที่ 3. มาสก์ attention แบบ causal แบบรวม และ relative temporal RoPE สำหรับ Hybrid Teacher / Diffusion Forcing ส่วนบนแสดงการมองเห็นแบบ causal ของโครงสร้างประวัติสองแบบ ส่วนล่างแมปคิวรีตัวแทนไปยังบล็อก Q/K สล็อตสัมพัทธ์ และ RoPE ID แสดงว่า block ID จริงเดินต่อ ในขณะที่พิกัดเวลาในหน้าต่างยังมีขอบเขต
หน่วยความจำหลายไทม์สเกล
การจำลองโลกระยะยาวจำประวัติทั้งหมดอย่างเดียวไม่ได้ ประวัติไร้ขอบเขตดันต้นทุนคำนวณและหน่วยความจำขึ้นเร็ว การครอปมากเกินไปทำให้เอกลักษณ์ตัวละคร การจัดฉาก และเหตุการณ์สำคัญหลุด R2 สร้างระบบหน่วยความจำหลายสเกลจาก Sink Memory, Rolling History และ Object KV Cache
- Sink Memory เก็บจุดยึดระยะยาว เช่น ตัวละคร ฉาก สไตล์ และกฎของโลก
- Rolling History โฟกัสที่แอ็กชัน ท่าทาง กล้อง และการเปลี่ยนแปลงสภาพแวดล้อมล่าสุด เพื่อให้สถานะเฉพาะจุดเชื่อมต่อกันอย่างเป็นธรรมชาติ
- Object KV Cache นำกลับมาใช้และบีบอัดตัวแทนประวัติระดับวัตถุที่คำนวณแล้ว โดยเก็บสถานะที่ส่งผลต่อวิวัฒนาการภายหลังจริงๆ ไว้ในงบจำกัด
ทั้งสามให้ความเสถียรของเอกลักษณ์ระยะยาว ความต่อเนื่องของการเคลื่อนไหวระยะสั้น และต้นทุนรันไทม์ที่ควบคุมได้ และลดการลอยของตัวละคร การกระโดดฉาก การกระพริบข้ามชิ้น และแอ็กชันที่ขาด
Error Bank
การลอยรุนแรงในโมเดลโลก AR มักเริ่มจากข้อผิดพลาดเล็กช่วงต้นที่ถูกเขียนลงประวัติแล้วถูกสืบทอด R2 สร้าง Error Bank ที่เก็บประวัติข้อผิดพลาดตัวแทนเป็นตัวอย่างที่ใช้ซ้ำได้ และเล่นกลับเข้าประวัติปกติในอัตราที่กำหนดระหว่างฝึก โมเดลไม่ได้เรียนเพียงวิธีเดินต่อจากสถานะอุดมคติ แต่ยังเรียนวิธีรู้ ดูดซับ และซ่อมประวัติที่ลอยไปแล้ว
ในการประเมินแบบเป็นขั้น เมตริกการลอยของความสว่างระยะยาวลดจาก 0.201 เป็น 0.129 ประมาณ 35.8% จากตัวอย่างลำดับยาว 29 รายการ มี 20 รายการดีขึ้น และตัวอย่างทั้ง 5 ที่ควรอยู่นิ่งอย่างชัดเจนลดการเคลื่อนไหวที่ผิดพลาด
การเร่งแบบเรียลไทม์
การเร่งแบบเรียลไทม์ของ R2 ไม่ได้เรียนโลกขอบฟ้ายาวใหม่ในโมเดลไม่กี่ขั้น มันเร่งโมเดลโลกที่รันได้อย่างเสถียรเป็นเวลานานอยู่แล้ว ชั้นเร่งเริ่มจาก Omni Causal AR ที่พรีเทรนต่อเนื่อง และใช้ทั้งสำหรับเริ่มต้น ODE ของนักเรียนและครูกลั่น ดังนั้นครู นักเรียน และการอินเฟอเรนซ์ AR จริงจึงใช้การกระจายวิถี causal ที่สอดคล้องกัน
จุดเริ่ม causal แบบรวมนั้นลดการพึ่งการจูนแนว Self-Forcing และ Rolling Forcing การเร่งแบบเรียลไทม์โฟกัสปัญหาที่ความเร็วไม่กี่ขั้นสร้างขึ้นจริง: DDMD with adversarial regularization จัดการการจัดแนวเงื่อนไข การกระจายการสร้าง และความสมจริงระหว่างกลั่น block-sparse attention บีบอัดการคำนวณบริบทยาว และเส้นทาง pyramid ลดต้นทุนการสร้างความละเอียดสูง
DDMD with adversarial regularization
ในการสร้างขั้นน้อยมาก การจัดแนวเงื่อนไข การจับคู่การกระจาย และความสมจริงไม่ใช่ปัญหาการหาค่าเหมาะเดียวกัน R2 อิง DDMD และเพิ่ม adversarial regularization จาก DMD2 สัญญาณฝึกสามอย่างมาบรรจบในนักเรียนตัวเดียว: การจัดแนวเงื่อนไขเสริมการควบคุม การจับคู่การกระจายรักษาการกระจายของครู และ adversarial regularization ยึดข้อมูลจริง ดังนั้นขั้นสุ่มน้อยยังรักษาทั้งการตอบสนองปฏิสัมพันธ์ที่แม่นยำและโลกที่น่าเชื่อ
Block-sparse attention
R2 ใช้ block-sparse attention บนลำดับโทเคนเชิงพื้นที่-เวลา โมเดลแบ่ง Q, K และ V เป็นบล็อกคำนวณ ประเมินอย่างรวดเร็วว่าบล็อก query แต่ละบล็อกต้องการบล็อก key/value ใดมากที่สุด เก็บเฉพาะการเชื่อมที่มีคะแนนสูงสุด แล้วทำ softmax attention แบบแม่นบนบล็อกที่เลือก การจัดเส้นทางระดับบล็อกไม่ใช่การตัดแบบสุ่ม แต่รวมการคำนวณไว้ที่ความสัมพันธ์ที่แข็งระหว่างการควบคุมหลายโหมดปัจจุบัน การเคลื่อนไหวล่าสุด และสถานะโลกสำคัญ
โดยปรับโมเดลให้เข้ากับโครงสร้างการเชื่อมแบบเบาบางระหว่างฝึก R2 ยกความเบาบางของ attention เกิน 90% โดยยังรักษาคุณภาพภาพ ความต่อเนื่องของแอ็กชัน การทำตามเงื่อนไข และความเสถียรขอบฟ้ายาว โดยไม่ลดลงชัดเจนในการประเมินปัจจุบัน
Pyramid ultra-few-step distillation
การจำลองโลกทั้งหมดจากศูนย์ในพื้นที่ความละเอียดสูงเสียการคำนวณกับโครงสร้างรวมที่ความละเอียดต่ำกำหนดได้อยู่แล้ว R2 จัดลำดับการสร้างเป็นหนึ่งหรือสองขั้นความละเอียดต่ำบวกขั้นความละเอียดสูง ขั้นความละเอียดต่ำกำหนดเลย์เอาต์ฉาก การเคลื่อนไหวของตัวแบบ และโครงสร้างกล้อง ขั้นความละเอียดสูงคืนพื้นผิว ขอบ และรายละเอียดเฉพาะจุด เส้นทางจากหยาบไปละเอียดตัดการคำนวณความละเอียดสูงที่ซ้ำ ขณะยังรักษาความเสถียรเชิงโครงสร้างและรายละเอียดที่แข็งกว่า
บทสรุปและข้อจำกัด
PixVerse R1 เสนอและส่งมอบโมเดลโลกวิดีโอแบบเรียลไทม์ตัวแรก แสดงว่าวิดีโอขยับจากคอนเทนต์ออฟไลน์ที่คงที่ได้สู่โลกไดนามิกที่โต้ตอบแบบเรียลไทม์และรันต่อได้ PixVerse R2 จึงแก้วิธีให้กระบวนทัศน์นั้นขยายต่อ: Omni Causal AR แบบรวมรองรับข้อมูล งาน โหมด และไทม์สเกลที่โตขึ้น และการเร่งแบบเรียลไทม์นำความสามารถจำลองโลกเต็มรูปแบบเข้าสู่การอินเฟอเรนซ์ไม่กี่ขั้นแบบเรียลไทม์
R2 ไม่ใช่การอัปเกรดความสามารถจุดเดียว แต่เป็นเส้นทางการฝึกแบบรวมสำหรับโมเดลโลกเรียลไทม์รุ่นถัดไป R1 ทำให้โมเดลโลกวิดีโอเรียลไทม์เป็นจริง R2 วางพวกมันไว้ในขั้นที่รวม เป็นสเกลได้ และปรับปรุงต่อเนื่อง
ภายใต้งบคำนวณเรียลไทม์และความหน่วงปฏิสัมพันธ์ที่เข้มงวด คุณภาพของการสร้างครั้งเดียวยังมีช่องให้ดีขึ้นเมื่อเทียบกับโมเดลวิดีโอออฟไลน์ชั้นนำ โดยเฉพาะรายละเอียดฉากซับซ้อน ความเป็นธรรมชาติของการเคลื่อนไหว ความสอดคล้องทางกายภาพ และความเสถียรในการรันยาว ช่องว่างเหล่านั้นสะท้อนขั้นการขยายปัจจุบันของ R2 บ่อยกว่าเพดานของเฟรมเวิร์กเอง
Early Access
ณ วันที่ 23 สิงหาคม 2026 รายงานนี้อธิบาย PixVerse R2 ว่าเป็นการทดสอบแบบปิด เมื่อวันที่ 22 กันยายน 2026 PixVerse ประกาศว่าชุดของโลกเหล่านี้เปิดให้สำรวจได้ที่ world.pixverse.video ดู ประกาศเปิดตัว R2
ประกาศนั้นไม่ได้เปิดการเข้าถึง API แบบไม่จำกัด แบบฟอร์มประสบการณ์โมเดลโลก PixVerse R2 ยังเป็นเส้นทางขอสำหรับประสบการณ์ช่วงต้นและการเข้าถึง API
แหล่งข้อมูลที่เกี่ยวข้อง
- อธิบาย PixVerse R1: โมเดลโลกวิดีโอ AI แบบเรียลไทม์
- เจาะลึก PixVerse Game Engine
- PixVerse อัปเดต R1 ด้วย Shared Worlds
- คู่มือการสร้างวิดีโอ AI แบบเรียลไทม์
- PixVerse ปิดรอบขยาย Series C
โลกจากประกาศวันที่ 22 กันยายน 2026 เปิดให้สำรวจที่ world.pixverse.video การเข้าถึง API ยังขอผ่านแบบฟอร์มด้านบน คุณยังสร้างด้วย PixVerse V6 และ R1 ได้วันนี้