PixVerse R2: Menskalakan Omni World Model Waktu Nyata
PixVerse R1 memperkenalkan dan merilis world model video waktu nyata pertama, mengubah generasi video dari pengiriman sekali jalan sebuah klip tetap menjadi dunia yang terus berjalan. Model ini dapat terus menerima masukan pengguna, memperbarui keadaan dunia secara waktu nyata, dan mengalirkan audio serta video yang tersinkronisasi dan tetap konsisten dengan interaksi. R1 menunjukkan bahwa paradigma teknis ini dapat bekerja.
PixVerse R2 menjawab pertanyaan berikutnya: bagaimana sebuah world model video waktu nyata terus diskalakan. R2 berfokus pada dua tujuan. Pertama, ia membangun dunia dinamis yang dapat menahan keadaan terpadu pada horizon yang panjang, mengubah prior spatiotemporal penuh menjadi evolusi dunia yang hanya bergerak maju dalam waktu. Kedua, ia secara berkelanjutan menginternalisasi kausalitas fisik dan sinyal interaksi dari teks, referensi, audio, dan aksi ke dalam satu model, sehingga dunia dapat menghasilkan, menerima kontrol, dan memperbarui keadaan secara bersamaan sambil mengalirkan audio dan video yang tersinkronisasi.
Di sekitar tujuan itu, R2 mengubah pertumbuhan model, data, tugas, sinyal kontrol, dan skala waktu menjadi peningkatan kualitas generasi, konsistensi jarak jauh, dan kontrol multimodal.
Kerangka Keseluruhan
R2 meruntuhkan sistem menjadi dua lapisan inti: Omni Causal AR dan Real-Time Acceleration. Omni Causal AR terus memperluas generasi dunia berkualitas tinggi, multimodal, dan berhorizon panjang. Real-Time Acceleration mewarisi kapabilitas itu selossless mungkin di bawah anggaran latensi interaksi yang ketat. Jalurnya jelas: naikkan batas kapabilitas world model, lalu percepat kapabilitas itu ke rentang operasi yang waktu nyata dan interaktif.
Alur video panjang dan waktu nyata yang lebih lama biasanya merangkai banyak tahap pelatihan: mengubah model bidirectional menjadi model AR, membangun teacher distilasi dari model bidirectional yang spesifik tugas, menjalankan distilasi DMD, lalu menambahkan self-rollout DMD untuk menutup celah train-inference. Setiap tahap harus memigrasikan ulang kapabilitas, menyelaraskan ulang objektif, dan menyesuaikan ulang distribusi data. Kualitas gambar, gerakan, kepatuhan kondisi, dan stabilitas horizon panjang dapat terkikis selama transfer itu. Seiring skala model, data, dan tugas tumbuh, alur multi-tahap memecah target optimasi dan menaikkan baik biaya pelatihan maupun kompleksitas sistem.
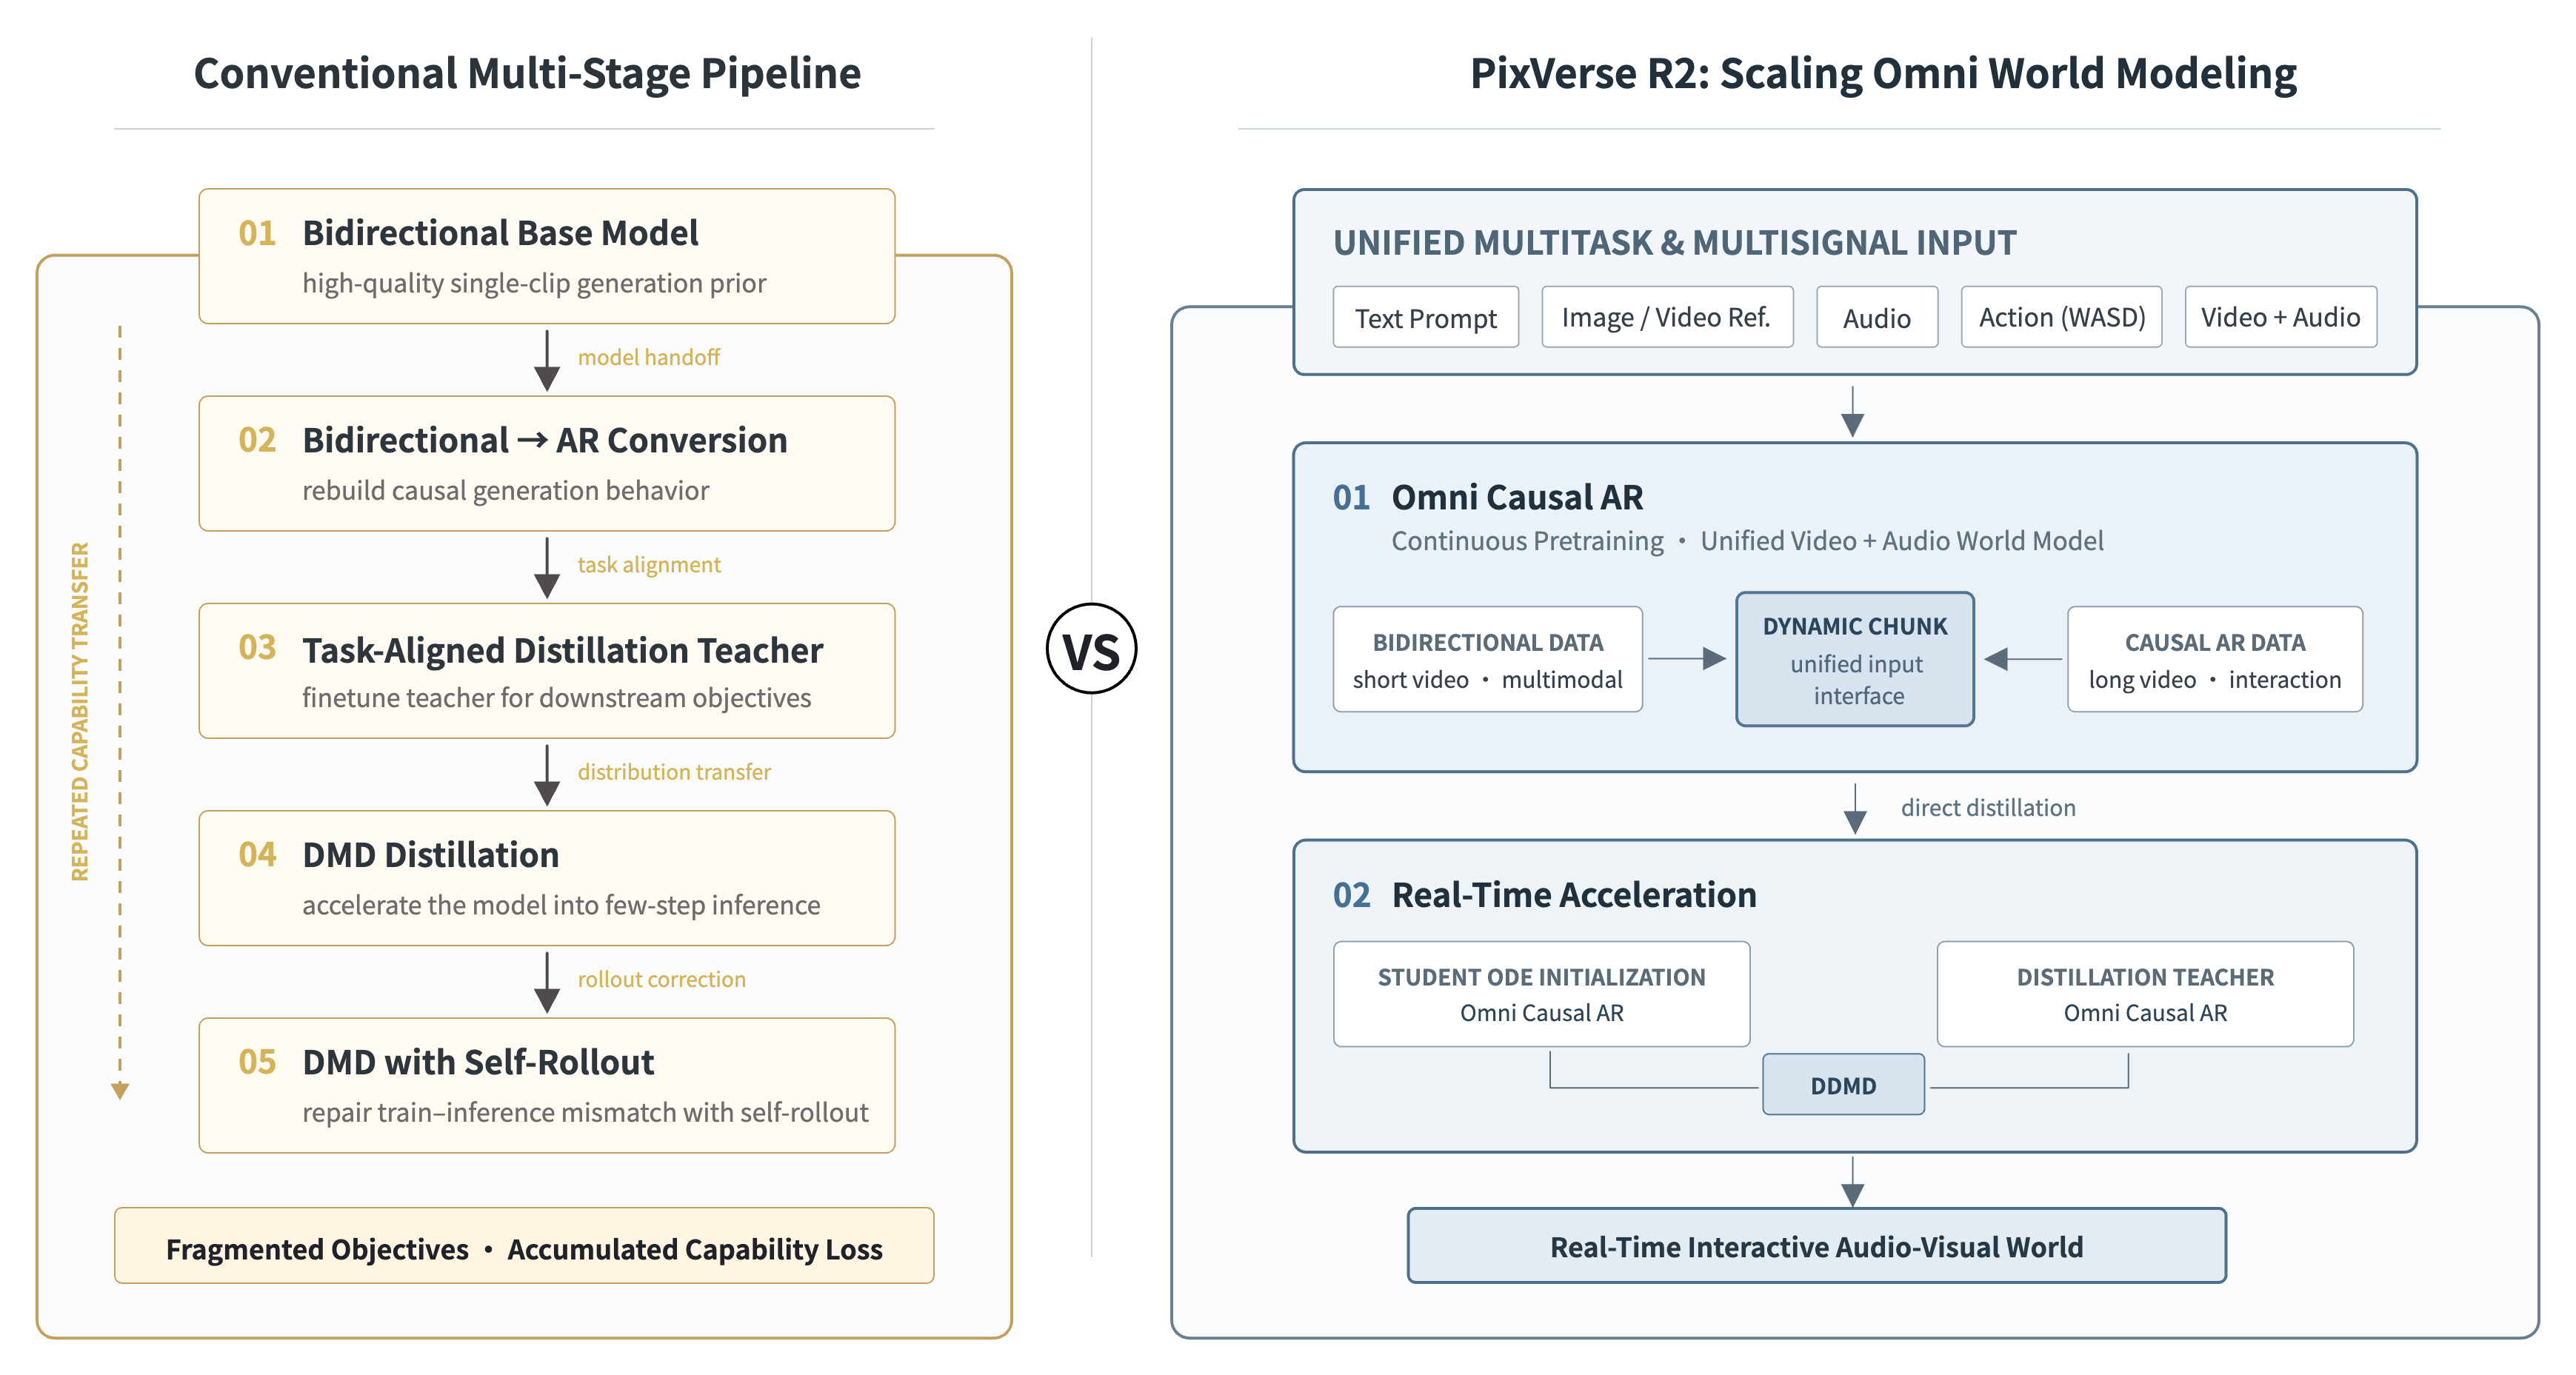
Gambar 1. Alur multi-tahap lama versus pemodelan dunia berskala PixVerse R2. R2 menyatukan perluasan kapabilitas dan distilasi waktu nyata ke dalam Omni Causal AR dan lapisan akselerasi waktu nyata, menyatukan pemodelan multi-tugas, multi-sinyal, dan video panjang dalam satu kerangka.
PixVerse R2 mengusulkan paradigma pelatihan terpadu untuk world model waktu nyata. Alih-alih berulang kali memigrasikan kapabilitas di banyak model dan tahap tugas, ia mereduksi alur yang kompleks menjadi dua proses yang dapat terus diskalakan: secara berkelanjutan melakukan pretraining pada Omni Causal AR yang menahan keadaan dunia terpadu, lalu mendistilasinya secara langsung menjadi model yang dipercepat yang dapat menghasilkan secara waktu nyata sambil mewarisi konsistensi spasial dan pemodelan horizon panjang.
Lebih sedikit batas tahap mengurangi kehilangan kapabilitas yang berasal dari teacher independen, penyelarasan tugas, dan transfer model yang berulang. Data, tugas, sinyal kontrol, dan skala model yang baru dapat dikonversi lebih langsung menjadi kemampuan pemodelan dunia waktu nyata.
Tahap 1: pretraining berkelanjutan Omni Causal AR. R2 tidak lagi memperlakukan prior generasi bidirectional dan AR video panjang sebagai dua tahap yang terputus. Ia secara berkelanjutan melatih Omni Causal AR terpadu di atas kapabilitas model bidirectional. Dynamic chunk memberi berbagai bentuk data representasi temporal bersama: model dapat menyerap video pendek berkualitas tinggi dan data multimodal dari pretraining bidirectional, serta dapat berkembang ke video panjang berkelanjutan dan lintasan interaksi multi-giliran. Kualitas gambar, ekspresi audiovisual, generasi horizon panjang, dan kontrol multi-sinyal dapat diskalakan di dalam satu model, alih-alih dimigrasikan ulang melalui konversi berulang.
Tahap 2: distilasi lapisan akselerasi waktu nyata dari Omni Causal AR yang telah diskalakan. Pretraining berkelanjutan memberi Omni Causal AR generasi berkualitas tinggi, transfer keadaan horizon panjang yang stabil, dan rollout kausal nyata secara bersamaan. R2 kemudian menggunakan Omni Causal AR yang sama baik untuk inisialisasi ODE student maupun teacher distilasi, sehingga teacher, student, dan inferensi AR nyata berbagi basis pemodelan kausal yang konsisten. Distilasi waktu nyata menjadi “akselerasi beberapa langkah dari world model yang sudah ada,” bukan “mempelajari ulang dunia berhorizon panjang.”
Omni Causal AR
R2 melanjutkan jalur masukan multimodal, generasi autoregresif, dan interaksi waktu nyata yang telah divalidasi R1, lalu memusatkan kapabilitas itu ke dalam rute pelatihan Omni Causal AR yang terpadu. Omni Causal AR mengubah prior generasi spatiotemporal penuh menjadi transfer keadaan dunia yang hanya bergerak maju dalam waktu. Melalui kausalisasi dan pretraining berkelanjutan, model mempertahankan kemampuan gambar, gerakan, audio, dan semantik multimodal sambil belajar memprediksi chunk audiovisual tersinkronisasi berikutnya hanya dari riwayat.
Seiring objek pelatihan berkembang dari video pendek yang independen menjadi video panjang berkelanjutan dan lintasan interaksi multi-giliran, model secara bertahap membangun kausalitas jangka panjang di antara keadaan dunia historis, masukan interaksi saat ini, dan evolusi dunia di masa depan.
Model secara bersama menerima prompt teks, referensi multimodal, sinyal aksi (misalnya WASD atau kontrol berkelanjutan), dan audio, lalu mengeluarkan video dan audio yang tersinkronisasi. Sinyal kontrol yang berbeda dapat terus masuk ke model selama sebuah proses berjalan dan mengubah keadaan dunia selanjutnya. R2 tidak hanya merespons kondisi sekali jalan; ia dapat menghasilkan, menerima kontrol, dan memperbarui dunia secara bersamaan.
Untuk menjaga generasi kausal di dalam dunia yang sama selama proses yang panjang, R2 menangani empat masalah: celah distribusi train-inference, ketahanan terhadap riwayat yang berisik, koordinasi memori jangka panjang dan memori terkini, serta koreksi keadaan kesalahan. Hybrid Teacher / Diffusion Forcing memungkinkan model beradaptasi terhadap riwayat yang bersih maupun berisik. Multi-Timescale Memory secara bersama menyimpan jangkar dunia, dinamika terkini, dan keadaan objek. Error Bank membawa keadaan yang gagal kembali ke pelatihan. Bersama-sama mereka membentuk loop pelatihan untuk keadaan dunia jangka panjang dan mengurangi drift pada gambar, karakter, gerakan, hubungan audio-visual, dan respons kontrol seiring waktu.
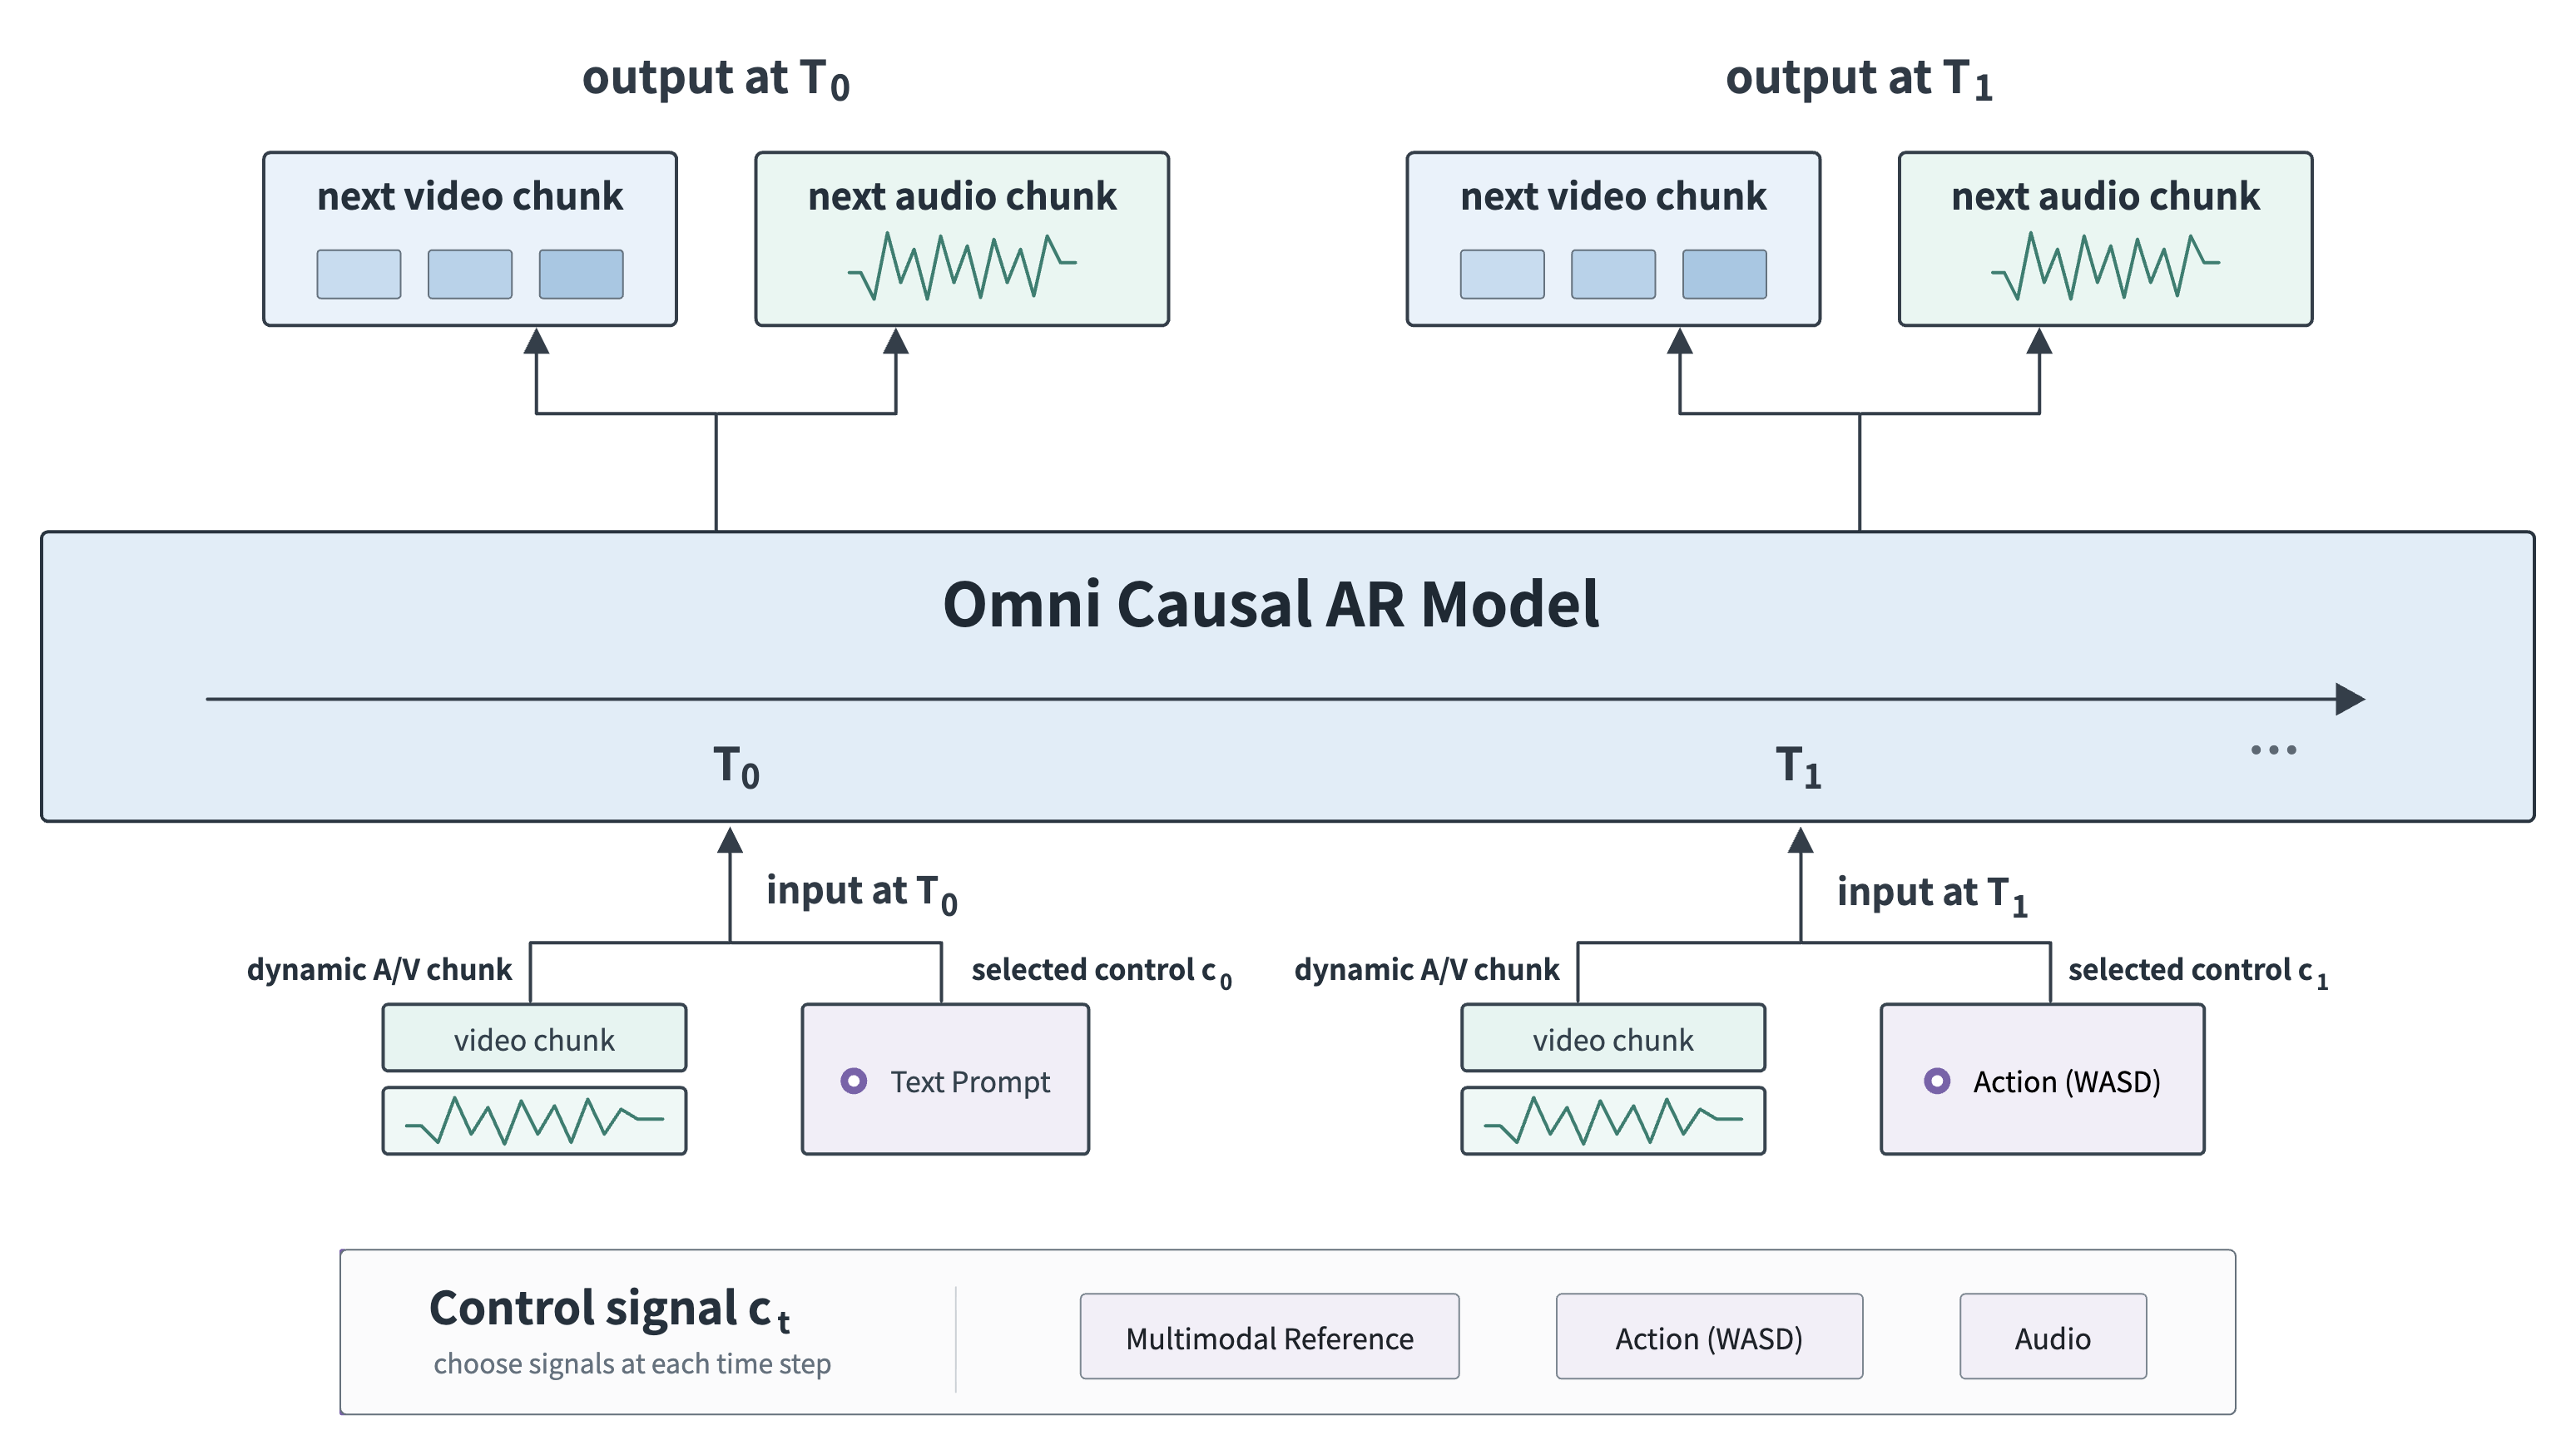
Gambar 2. Omni Causal AR PixVerse R2. Model dapat terus menerima sinyal kontrol yang berbeda selama sebuah proses berjalan. Pada setiap momen interaksi, sinyal yang aktif selaras dengan chunk audiovisual dinamis pada granularitas yang sesuai dan menggerakkan segmen video dan audio berikutnya.
Generasi dynamic chunk
Sinyal kontrol yang berbeda hidup pada skala waktu yang berbeda. Prompt dan referensi biasanya menggambarkan semantik penuh atau peristiwa yang lebih panjang. Aksi (WASD) membutuhkan umpan balik keadaan yang berbutir halus dan segera. Audio membawa semantik, ritme, dan sinkronisasi temporal sekaligus. Jika setiap masukan dipaksa ke dalam unit waktu berpanjang tetap, model sering harus menukar kecepatan respons dengan kelengkapan ekspresi.
Dynamic Chunk adalah cara R2 menyatukan skala waktu interaksi itu. R2 secara adaptif membagi urutan audiovisual menurut batas semantik dan durasi sinyal kontrol saat ini, dengan ukuran chunk maksimum yang membatasi komputasi dan stabilitas pelatihan. Chunk pendek meningkatkan presisi respons untuk aksi dan instruksi lokal. Chunk panjang mempertahankan struktur penuh peristiwa, gerakan, dan semantik audiovisual. Tugas dan sinyal kontrol yang berbeda dapat berbagi satu antarmuka generasi kausal tanpa mengganti struktur model.
Hybrid Teacher Forcing / Diffusion Forcing
Ketegangan inti dalam AR berhorizon panjang adalah bahwa riwayat pelatihan biasanya lebih bersih, sementara riwayat runtime nyata mengandung derau dan kesalahan lokal milik model itu sendiri. Melatih hanya pada riwayat bersih dapat menaikkan batas kualitas satu langkah, tetapi membuat model terlalu sensitif terhadap penyimpangan kecil. Melatih hanya pada riwayat yang terganggu dapat merugikan kualitas gambar, gerakan, dan respons kontrol.
R2 mencampurkan riwayat bersih dan riwayat berderau dalam satu proses pelatihan. Riwayat bersih menstabilkan batas atas kualitas evolusi dunia. Riwayat berderau memungkinkan model beradaptasi lebih awal terhadap keadaan yang tidak sempurna yang akan ditemuinya saat penerapan. Pelatihan yang saling melengkapi ini memperkecil celah antara pelatihan dan inferensi, sehingga model dapat menghasilkan segmen dunia berikutnya yang berkualitas tinggi dan terus bergulir maju ketika riwayat sudah mengandung kesalahan kecil.
Causal Attention Mask dan Relative Temporal RoPE bersama-sama membatasi riwayat mana yang dapat dibaca keadaan saat ini dan di mana riwayat itu berada di jendela saat ini. Attention Mask menegakkan visibilitas kausal yang ketat. Temporal RoPE tidak bertambah tanpa batas bersama ID blok global; ia diindeks ulang menurut slot relatif di dalam jendela atensi saat ini. Ketika jendela bergulir bergerak maju, waktu nyata terus berjalan, tetapi sink memory, riwayat terbaru, dan chunk saat ini tetap dipetakan ke rentang posisi relatif yang stabil dan terbatas.
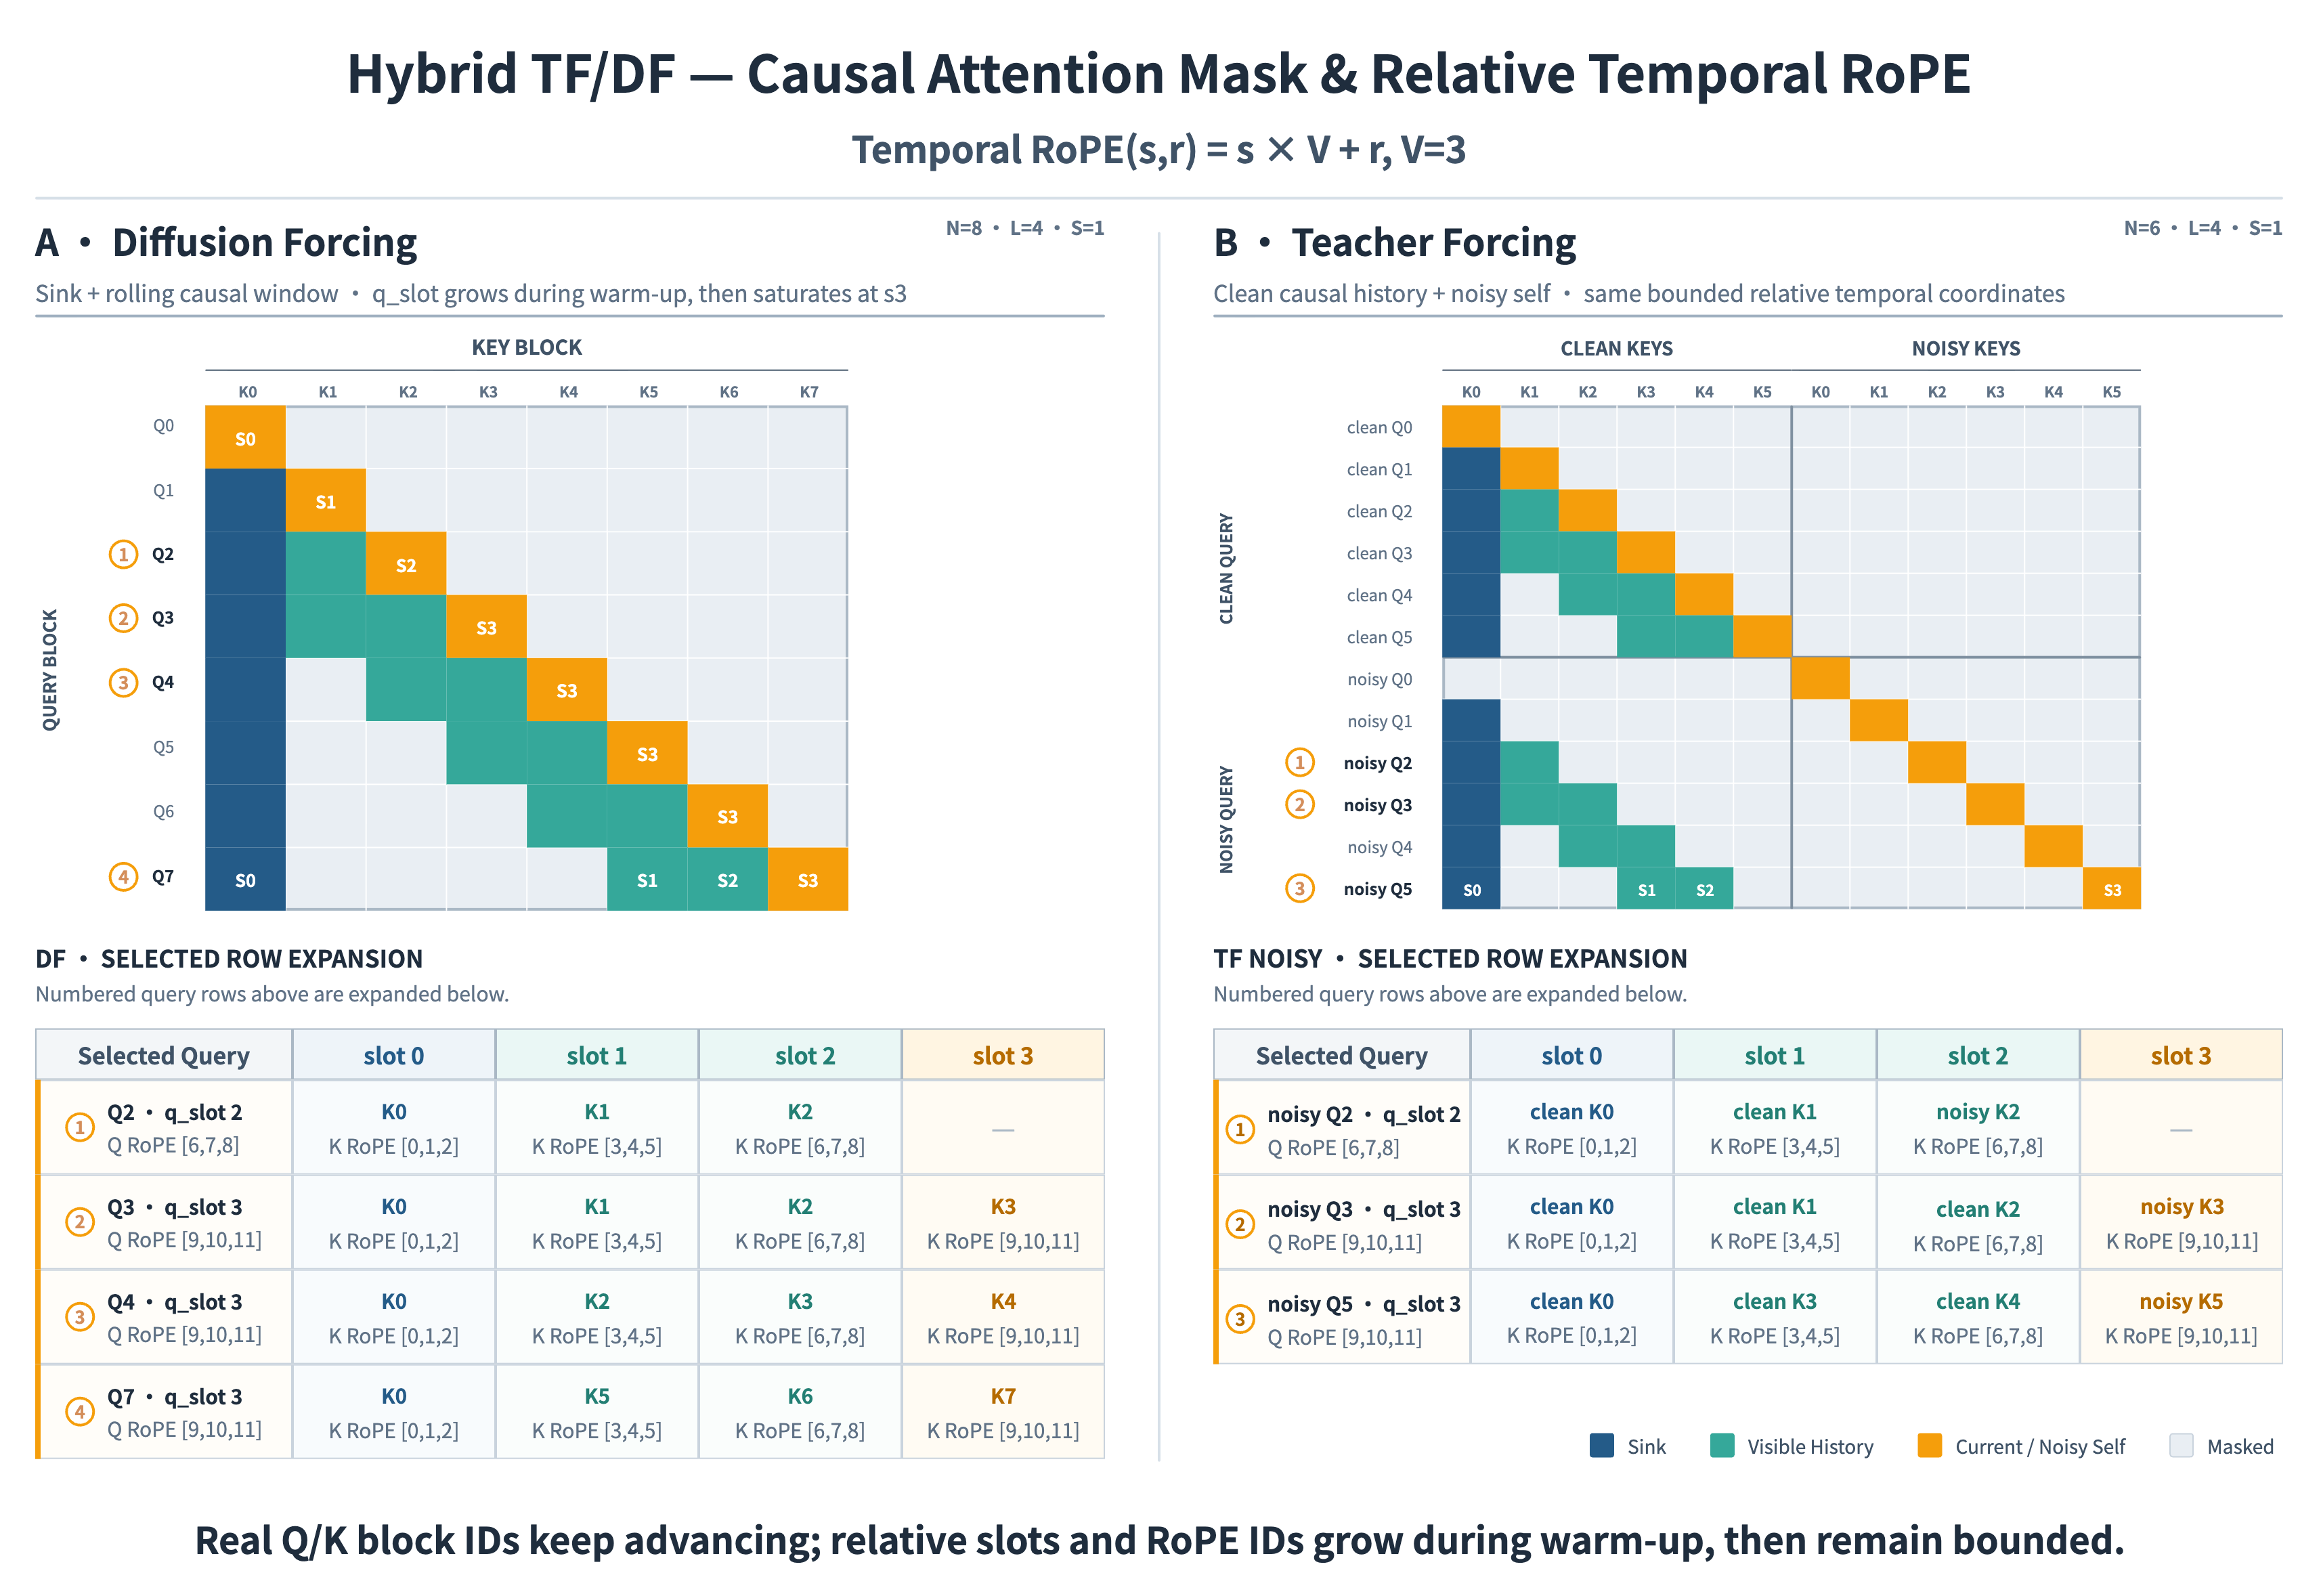
Gambar 3. Mask atensi kausal terpadu dan relative temporal RoPE untuk Hybrid Teacher / Diffusion Forcing. Bagian atas menunjukkan visibilitas kausal untuk dua konstruksi riwayat. Bagian bawah memetakan kueri representatif ke blok Q/K, slot relatif, dan ID RoPE, yang menunjukkan bahwa ID blok nyata terus maju sementara koordinat waktu di dalam jendela tetap terbatas.
Memori multi-skala waktu
Pemodelan dunia jangka panjang tidak bisa sekadar mengingat seluruh riwayat. Riwayat tanpa batas menaikkan biaya komputasi dan memori dengan cepat; pemotongan berlebih menghilangkan identitas karakter, penataan adegan, dan peristiwa kunci. R2 membangun sistem memori multi-skala dari Sink Memory, Rolling History, dan Object KV Cache.
- Sink Memory menyimpan jangkar jangka panjang seperti karakter, adegan, gaya, dan aturan dunia.
- Rolling History berfokus pada aksi, pose, kamera, dan perubahan lingkungan terbaru agar keadaan lokal dapat tersambung secara alami.
- Object KV Cache menggunakan kembali dan memampatkan representasi riwayat tingkat objek yang sudah dihitung, sehingga keadaan yang benar-benar memengaruhi evolusi berikutnya tetap berada dalam anggaran yang terbatas.
Ketiganya bersama-sama memberikan stabilitas identitas jangka panjang, kontinuitas gerak jarak pendek, dan biaya runtime yang dapat dikendalikan, serta mengurangi drift karakter, lompatan adegan, kedipan lintas-chunk, dan aksi yang patah.
Error Bank
Drift serius pada model dunia AR sering bermula dari kesalahan kecil di awal yang tertulis ke dalam riwayat lalu diwariskan. R2 membangun Error Bank yang menyimpan riwayat kesalahan representatif sebagai sampel yang dapat digunakan kembali dan memutarnya kembali ke dalam riwayat normal pada laju tertentu selama pelatihan. Model tidak lagi hanya belajar cara melanjutkan dari keadaan ideal; ia juga belajar cara mengenali, menyerap, dan memperbaiki riwayat yang sudah mengalami drift.
Dalam evaluasi bertahap, metrik drift kecerahan jangka panjang turun dari 0,201 menjadi 0,129, sekitar penurunan 35,8%. Dari 29 sampel urutan panjang, 20 membaik, dan kelima sampel yang secara eksplisit seharusnya tetap diam mengurangi gerak yang keliru.
Akselerasi Real-Time
Akselerasi real-time R2 tidak mempelajari ulang dunia berhorizon panjang di dalam model beberapa langkah. Ia mempercepat model dunia yang sudah dapat berjalan stabil dalam waktu lama. Lapisan akselerasi berangkat dari Omni Causal AR yang terus dilatih sebelumnya dan menggunakannya baik untuk inisialisasi ODE siswa maupun guru distilasi, sehingga guru, siswa, dan inferensi AR nyata berbagi distribusi trajektori kausal yang konsisten.
Titik awal kausal yang terpadu itu mengurangi ketergantungan pada penyetelan bergaya Self-Forcing dan Rolling Forcing. Akselerasi real-time dapat berfokus pada masalah yang benar-benar muncul dari kecepatan beberapa langkah: DDMD dengan regularisasi adversarial menangani penyelarasan kondisi, distribusi generasi, dan realisme selama distilasi; atensi block-sparse memampatkan komputasi konteks panjang; dan jalur piramida menurunkan biaya generasi resolusi tinggi.
DDMD dengan regularisasi adversarial
Dalam generasi ultra-sedikit-langkah, penyelarasan kondisi, pencocokan distribusi, dan realisme bukan masalah optimasi yang sama. R2 didasarkan pada DDMD dan selanjutnya memperkenalkan regularisasi adversarial dari DMD2. Tiga sinyal pelatihan bertemu dalam satu siswa: penyelarasan kondisi memperkuat kendali, pencocokan distribusi menjaga distribusi guru, dan regularisasi adversarial menambatkan data nyata, sehingga sedikit langkah sampling dapat mempertahankan respons interaksi yang akurat sekaligus dunia yang meyakinkan.
Atensi block-sparse
R2 menggunakan atensi block-sparse pada urutan token spatiotemporal. Model membagi Q, K, dan V menjadi blok komputasi, dengan cepat memperkirakan blok key/value mana yang paling dibutuhkan setiap blok kueri, hanya mempertahankan koneksi dengan skor tertinggi, lalu menjalankan atensi softmax eksak pada blok terpilih itu. Perutean tingkat blok bukan pemangkasan acak; ia memusatkan komputasi pada ketergantungan kuat di antara kendali multimodal saat ini, gerak terbaru, dan keadaan dunia yang kunci.
Dengan menyesuaikan model pada struktur koneksi sparse selama pelatihan, R2 menaikkan sparsitas atensi di atas 90% sambil menjaga kualitas gambar, kontinuitas aksi, kepatuhan terhadap kondisi, dan stabilitas horizon panjang tanpa penurunan yang jelas dalam evaluasi saat ini.
Distilasi piramida ultra-sedikit-langkah
Melakukan seluruh pemodelan dunia dari nol di ruang resolusi tinggi membuang komputasi pada struktur global yang sudah dapat ditentukan oleh resolusi lebih rendah. R2 menata generasi sebagai satu atau dua tahap resolusi rendah ditambah satu tahap resolusi tinggi. Tahap resolusi rendah menetapkan tata letak adegan, gerak subjek, dan struktur kamera. Tahap resolusi tinggi memulihkan tekstur, tepi, dan detail lokal. Jalur kasar-ke-halus memangkas komputasi resolusi tinggi yang berulang sambil menjaga stabilitas struktural dan detail yang lebih kuat.
Kesimpulan dan Batasan
PixVerse R1 mengusulkan dan merilis model dunia video real-time pertama, yang menunjukkan bahwa video dapat beralih dari konten offline yang tetap menjadi dunia dinamis yang dapat berinteraksi secara real time dan terus berjalan. PixVerse R2 kemudian menyelesaikan cara paradigma itu terus diskalakan: Omni Causal AR yang terpadu membawa data, tugas, modalitas, dan skala waktu yang terus bertambah, dan Akselerasi Real-Time membawa kemampuan pemodelan dunia penuh ke dalam inferensi beberapa langkah secara real time.
R2 bukan peningkatan kemampuan pada satu titik. Ia adalah jalur pelatihan terpadu untuk generasi berikutnya dari model dunia real-time. R1 menjadikan model dunia video real-time nyata. R2 menempatkannya pada tahap yang terpadu, dapat diskalakan, dan terus membaik.
Di bawah anggaran komputasi real-time dan latensi interaksi yang ketat, kualitas generasi tunggal saat ini masih memiliki ruang untuk membaik dibandingkan model video offline terdepan, terutama pada detail adegan kompleks, kealamian gerak, konsistensi fisik, dan stabilitas pada proses yang panjang. Kesenjangan itu lebih sering mencerminkan tahap penskalaan R2 saat ini daripada batas dari kerangka itu sendiri.
Akses Awal
Per 23 Agustus 2026, laporan ini menggambarkan PixVerse R2 sebagai pengujian tertutup. Pada 22 September 2026, PixVerse mengumumkan bahwa kumpulan dunia ini terbuka untuk dijelajahi di world.pixverse.video. Lihat pengumuman peluncuran R2.
Pengumuman itu tidak membuka akses API tanpa batas. Formulir pengalaman model dunia PixVerse R2 tetap menjadi jalur permintaan untuk pengalaman awal dan akses API.
Sumber Terkait
- PixVerse R1 Dijelaskan: Model Dunia Video AI Real-Time
- Ulasan Mendalam Mesin Game PixVerse
- PixVerse Memperbarui R1 dengan Dunia Bersama
- Panduan Generasi Video AI Real-Time
- PixVerse Menutup Perpanjangan Seri C
Dunia dari pengumuman 22 September 2026 terbuka untuk dijelajahi di world.pixverse.video. Akses API masih diminta melalui formulir di atas. Anda juga dapat berkarya dengan PixVerse V6 dan R1 hari ini.