PixVerse R2: Scalare modelli di mondo Omni in tempo reale
PixVerse R1 ha introdotto e reso operativo il primo modello di mondo video in tempo reale, trasformando la generazione video da una consegna isolata di un filmato statico a un universo dinamico in continua esecuzione. Il modello è in grado di ricevere input dall’utente senza soluzione di continuità, aggiornare lo stato del mondo all’istante e trasmettere un flusso audio-video sincronizzato e coerente con ogni interazione. R1 ha dimostrato la concreta fattibilità di questo paradigma tecnico.
PixVerse R2 risponde al passo successivo: come continuare a scalare un modello di mondo video in tempo reale. R2 si focalizza su due obiettivi primari. In primo luogo, edificare un mondo dinamico capace di conservare uno stato unificato su orizzonti prolungati, convertendo completi riferimenti spazio-temporali in un’evoluzione orientata rigorosamente in avanti nel tempo. In secondo luogo, interiorizzare in modo continuo la causalità fisica e i segnali di interazione provenienti da testo, riferimenti visivi, tracce audio e azioni in un unico modello coeso, consentendo al mondo di generare, recepire comandi e mutare stato simultaneamente mentre trasmette audio e video sincronizzati.
Intorno a tali traguardi, R2 traduce la crescita della scala dei modelli, dei dati, dei compiti e dei segnali di controllo in miglioramenti tangibili nella fedeltà visiva, nella continuità a lungo raggio e nella precisione del controllo multimodale.
Architettura complessiva
R2 sintetizza l’intero impianto in due livelli cardine: Omni Causal AR e Accelerazione in tempo reale. Omni Causal AR amplia in modo costante la generazione di mondi multimodali e duraturi ad alta fedeltà. L’Accelerazione in tempo reale eredita queste facoltà con minime perdite nel rispetto di un severo budget di latenza d’interazione. Il percorso è lineare: elevare il potenziale massimo del modello di mondo per poi accelerare tale potenza verso un regime d’uso interattivo e istantaneo.
I precedenti flussi per video estesi e in tempo reale concatenavano molteplici fasi di addestramento: conversione da modello bidirezionale a modello AR, allestimento di un docente di distillazione dedicato, distillazione DMD e aggiunta di DMD ad auto-rollout per attenuare la discrepanza tra addestramento e inferenza. A ogni passaggio occorreva ricalibrare capacità, riallineare le funzioni obiettivo e riadattare la distribuzione dei dati. Nitidezza grafica, fluidità dei movimenti, aderenza ai vincoli e stabilità prolungata potevano risentire di questi continui trasferimenti. Al crescere delle dimensioni dei modelli e dei dati, una pipeline articolata su troppi stadi frammentava il target di ottimizzazione, gonfiando costi computazionali e complessità ingegneristica.
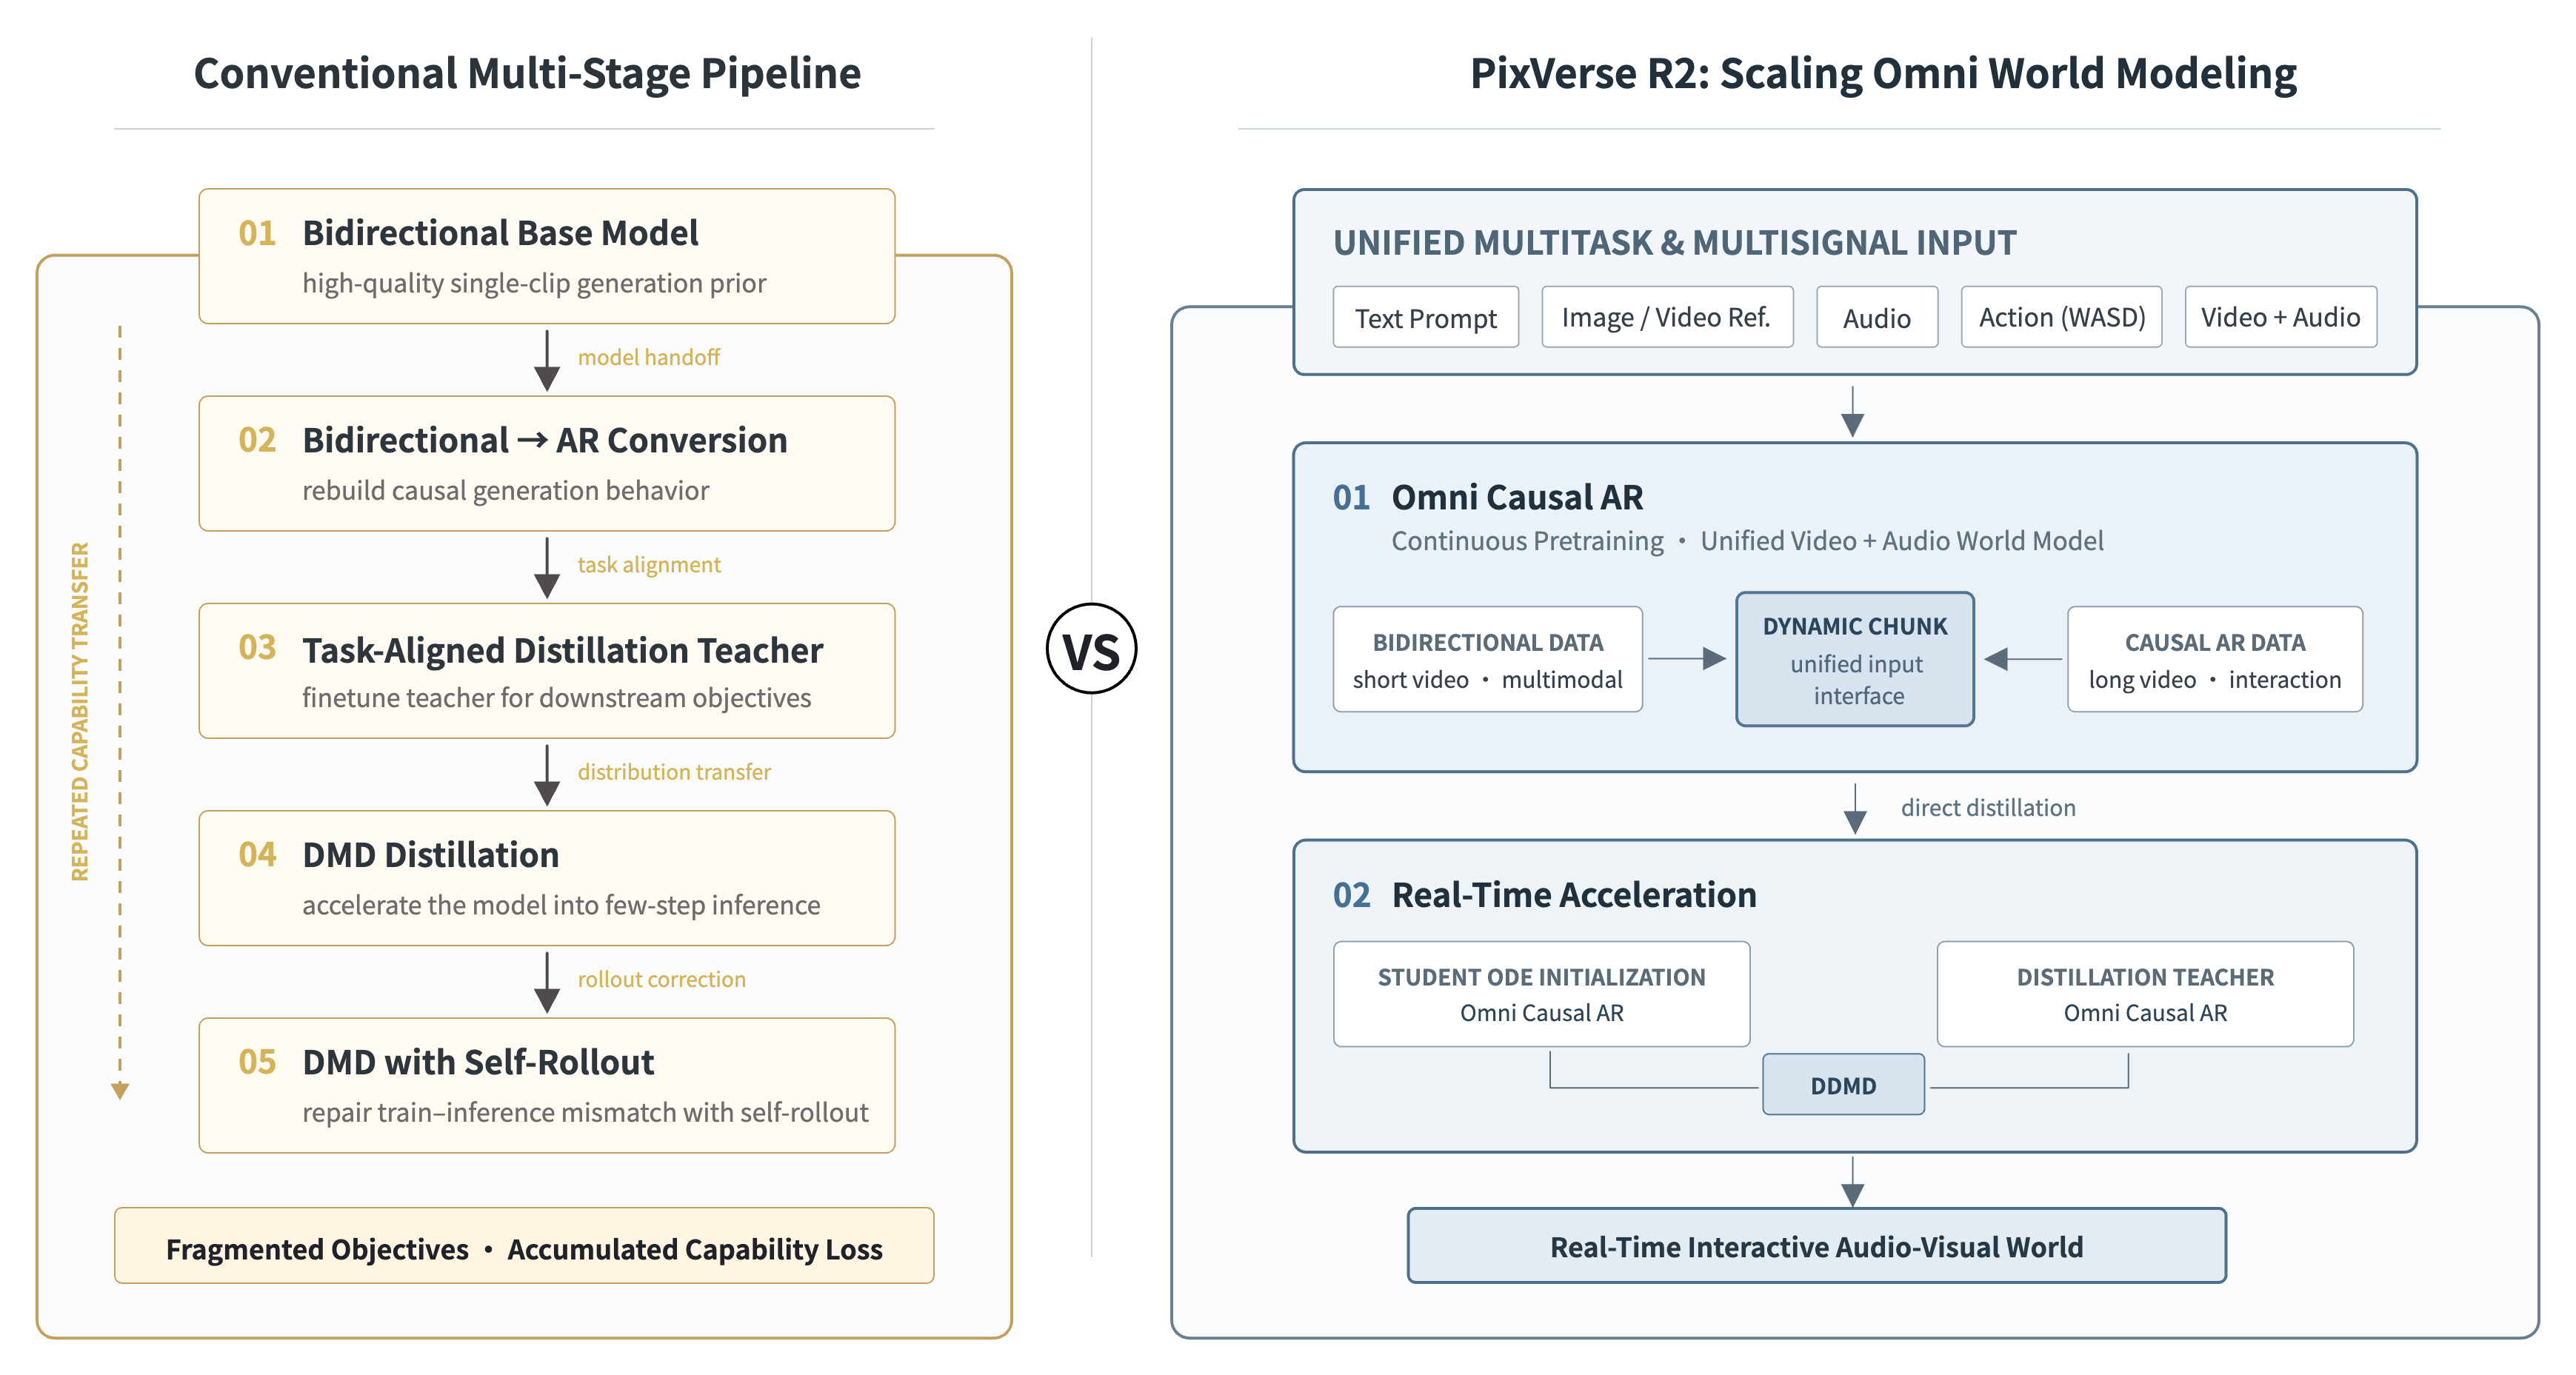
Figura 1. Pipeline multi-stadio tradizionale a confronto con la modellazione scalabile di PixVerse R2. R2 unifica l’espansione delle capacità e la distillazione real-time in Omni Causal AR e in un livello di accelerazione in tempo reale, condensando modellazione multi-task, multi-segnale e video estesi in un solo schema.
PixVerse R2 propone un paradigma di addestramento unificato per i modelli di mondo in tempo reale. Anziché far migrare ripetutamente le competenze attraverso innumerevoli modelli intermedi, il flusso si concentra in due processi altamente scalabili: pre-addestrare continuamente un Omni Causal AR che governa uno stato di mondo coeso, per poi distillarne direttamente una versione accelerata capace di operare in tempo reale preservando coerenza spaziale e tenuta temporale.
Ridurre le barriere tra le fasi mitiga il decadimento prestazionale provocato da docenti indipendenti e frequenti passaggi intermedi. L’acquisizione di nuovi dati, compiti, parametri e risorse di calcolo si trasforma direttamente in maggiore efficacia operativa nella generazione in tempo reale.
Fase 1: pre-addestramento continuo di Omni Causal AR. R2 non tratta più i modelli generativi bidirezionali e i modelli AR per video lunghi come momenti disgiunti. Addestra con continuità un modello unificato Omni Causal AR al di sopra delle capacità dei modelli bidirezionali. I blocchi dinamici (Dynamic Chunks) conferiscono a tipologie eterogenee di dati una base temporale condivisa: la rete apprende da brevi clip di alto livello e dati multimodali, estendendosi con naturalezza a sequenze prolungate e traiettorie interattive multi-turno. Qualità d’immagine, ricchezza sonora, generazione duratura e controllo da segnali multipli evolvono all’interno di un’unica matrice.
Fase 2: distillazione del livello di accelerazione real-time da Omni Causal AR. Il pre-addestramento continuo dota Omni Causal AR di eccellente fedeltà d’output, stabilità nel passaggio di stato ed effettiva dinamica causale. R2 impiega quindi questo medesimo Omni Causal AR sia per l’inizializzazione dell’ODE dello studente sia come docente di distillazione. In questo modo docente, studente e inferenza AR effettiva condividono la medesima traiettoria causale. La distillazione in tempo reale diventa un’accelerazione a pochi passi di un modello di mondo già strutturato, non la faticosa ripartenza da zero.
Omni Causal AR
R2 porta avanti la formula fondata su input multimodale, generazione autoregressiva e interattività in tempo reale convalidata da R1, accentrando queste doti in un canale formativo unificato Omni Causal AR. Questa componente converte la piena comprensione spazio-temporale in una transizione di stato che evolve rigorosamente in avanti nel tempo. Tramite causalizzazione e pre-addestramento costante, il modello conserva resa visiva, naturalezza cinetica, audio e intelligenza semantica, imparando a stimare il successivo blocco audiovisivo sincronizzato basandosi unicamente sul trascorso.
Man mano quegli elementi di addestramento passano da clip brevi a sequenze video estese e percorsi di scelta interattivi, il modello consolida nessi di causa-effetto tra lo stato pregresso del mondo, l’azione corrente e l’evoluzione futura dell’ambiente.
Il modello accoglie congiuntamente prompt testuali, riferimenti multimodali, segnali di comando (come i tasti WASD o controlli continui) e flussi audio, restituendo video e suoni perfettamente sincronizzati. Segnali di comando differenti possono intervenire senza sosta durante la sessione, modificando la traiettoria del mondo. R2 non si limita a eseguire un comando isolato: genera, riceve istruzioni e aggiorna lo spazio virtuale contemporaneamente.
Per preservare la generazione causale all’interno del medesimo contesto su sessioni lunghe, R2 supera quattro criticità: il disallineamento distributivo tra training e inferenza, la resilienza a contesti storici imperfetti, l’armonizzazione tra memoria recente e remota e il risanamento di stati alterati. L’impostazione Hybrid Teacher / Diffusion Forcing consente al modello di destreggiarsi sia con trascorsi ideali sia con dati rumorosi. La Multi-Timescale Memory custodisce riferimenti stabili, dinamiche recenti e parametri degli oggetti. L’Error Bank reinserisce gli stati anomali nel flusso di apprendimento. Insieme, formano un circuito solido per la conservazione dello stato, riducendo derive grafiche, incongruenze dei personaggi e sfasamenti tra suono e immagine.
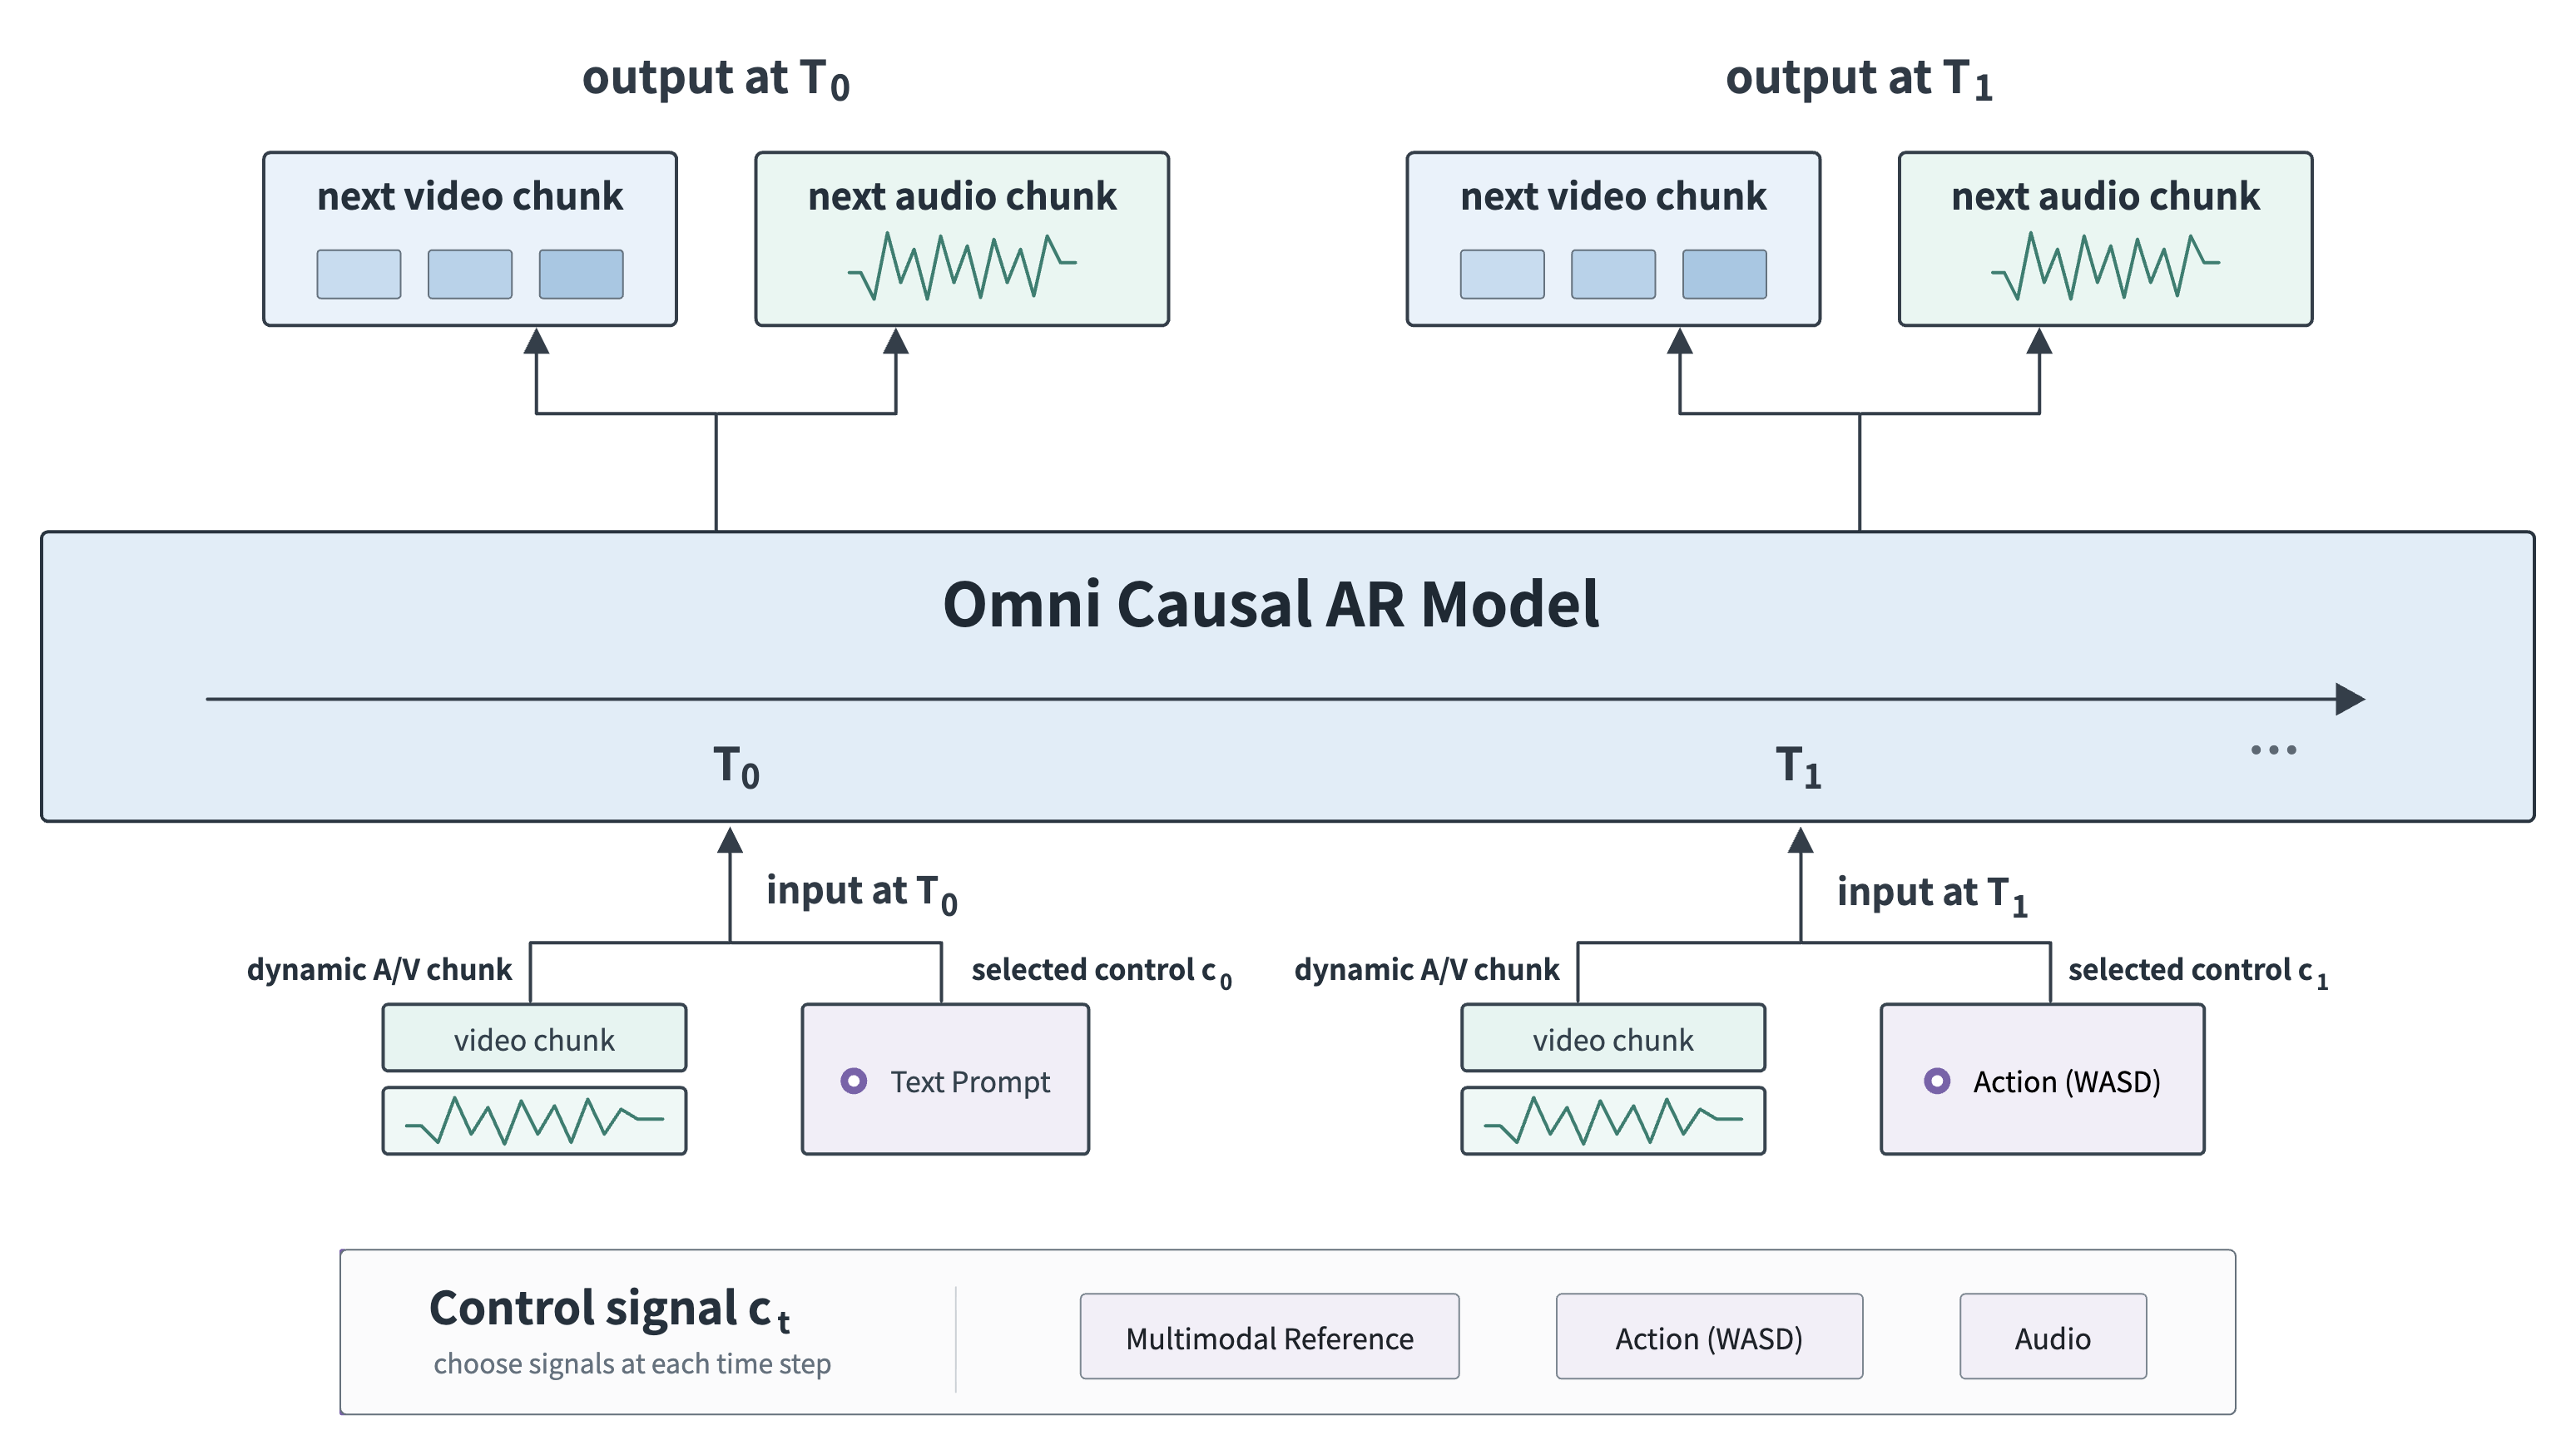
Figura 2. PixVerse R2 Omni Causal AR. Il modello può accogliere continuamente segnali di comando eterogenei durante la sessione. In ogni istante interattivo, l’istruzione attiva si allinea con un blocco audiovisivo dinamico della misura appropriata, guidando la sequenza successiva.
Generazione a blocchi dinamici (Dynamic Chunks)
Segnali di controllo differenti operano su orizzonti temporali disomogenei. Prompt e riferimenti racchiudono spesso concetti ampi o eventi prolungati. Le azioni fisiche (WASD) pretendono una retroazione immediata e capillare. L’audio reca con sé significato, cadenza e sincronia rigorosa. Qualora ogni dato in ingresso venisse costretto in un’unità temporale rigida, il sistema si troverebbe costretto a sacrificare la prontezza di risposta o la pienezza espressiva.
Il Dynamic Chunk costituisce la soluzione con cui R2 accorda queste differenti velocità. Il modello segmenta i flussi audiovisivi in modo adattivo, basandosi sui confini concettuali e sulla durata del segnale attivo, entro un limite massimo di blocco a tutela della stabilità dei calcoli. Blocchi brevi massimizzano la prontezza a comandi istantanei. Blocchi lunghi tutelano l’articolazione di eventi complessi e l’armonia acustica. Finalità differenti impiegano così la medesima interfaccia causale senza alterazioni all’architettura di base.
Hybrid Teacher Forcing / Diffusion Forcing
La tensione di fondo nell’apprendimento autoregressivo a lungo termine risiede nel fatto che le sequenze di addestramento sono immacolate, laddove il trascorso reale in produzione accumula imperfezioni e rumore generati dal modello stesso. Esercitare la rete unicamente su dati perfetti ne accresce la qualità nel singolo fotogramma ma la rende vulnerabile al minimo scostamento. Allenarla solo su contesti corrotti ne penalizza la pulizia visiva, il dinamismo e la docilità ai comandi.
R2 amalgama trascorsi puliti e contesti degradati in un unico processo formativo. La traccia pulita ancora il vertice qualitativo della scena. La traccia disturbata allena preventivamente il sistema ad affrontare gli imprevisti che incontrerà nell’utilizzo effettivo. Tale sinergia colma la distanza tra teoria e impiego pratico, consentendo alla rete di generare la porzione successiva con grande sicurezza anche se la memoria recente presenta lievi difetti.
La Causal Attention Mask e il Relative Temporal RoPE cooperano nel delimitare quali informazioni pregresse possano essere lette e la loro collocazione nella finestra attiva. La maschera impone una causalità rigorosa. Il RoPE temporale non cresce illimitatamente con l’indice globale del blocco, ma viene rimappato su posizioni relative all’interno della finestra di attenzione corrente. Man mano che la finestra scorre, il tempo reale avanza, ma la memoria fondante, la cronologia recente e il blocco in elaborazione rimangono ancorati a un intervallo relativo stabile.
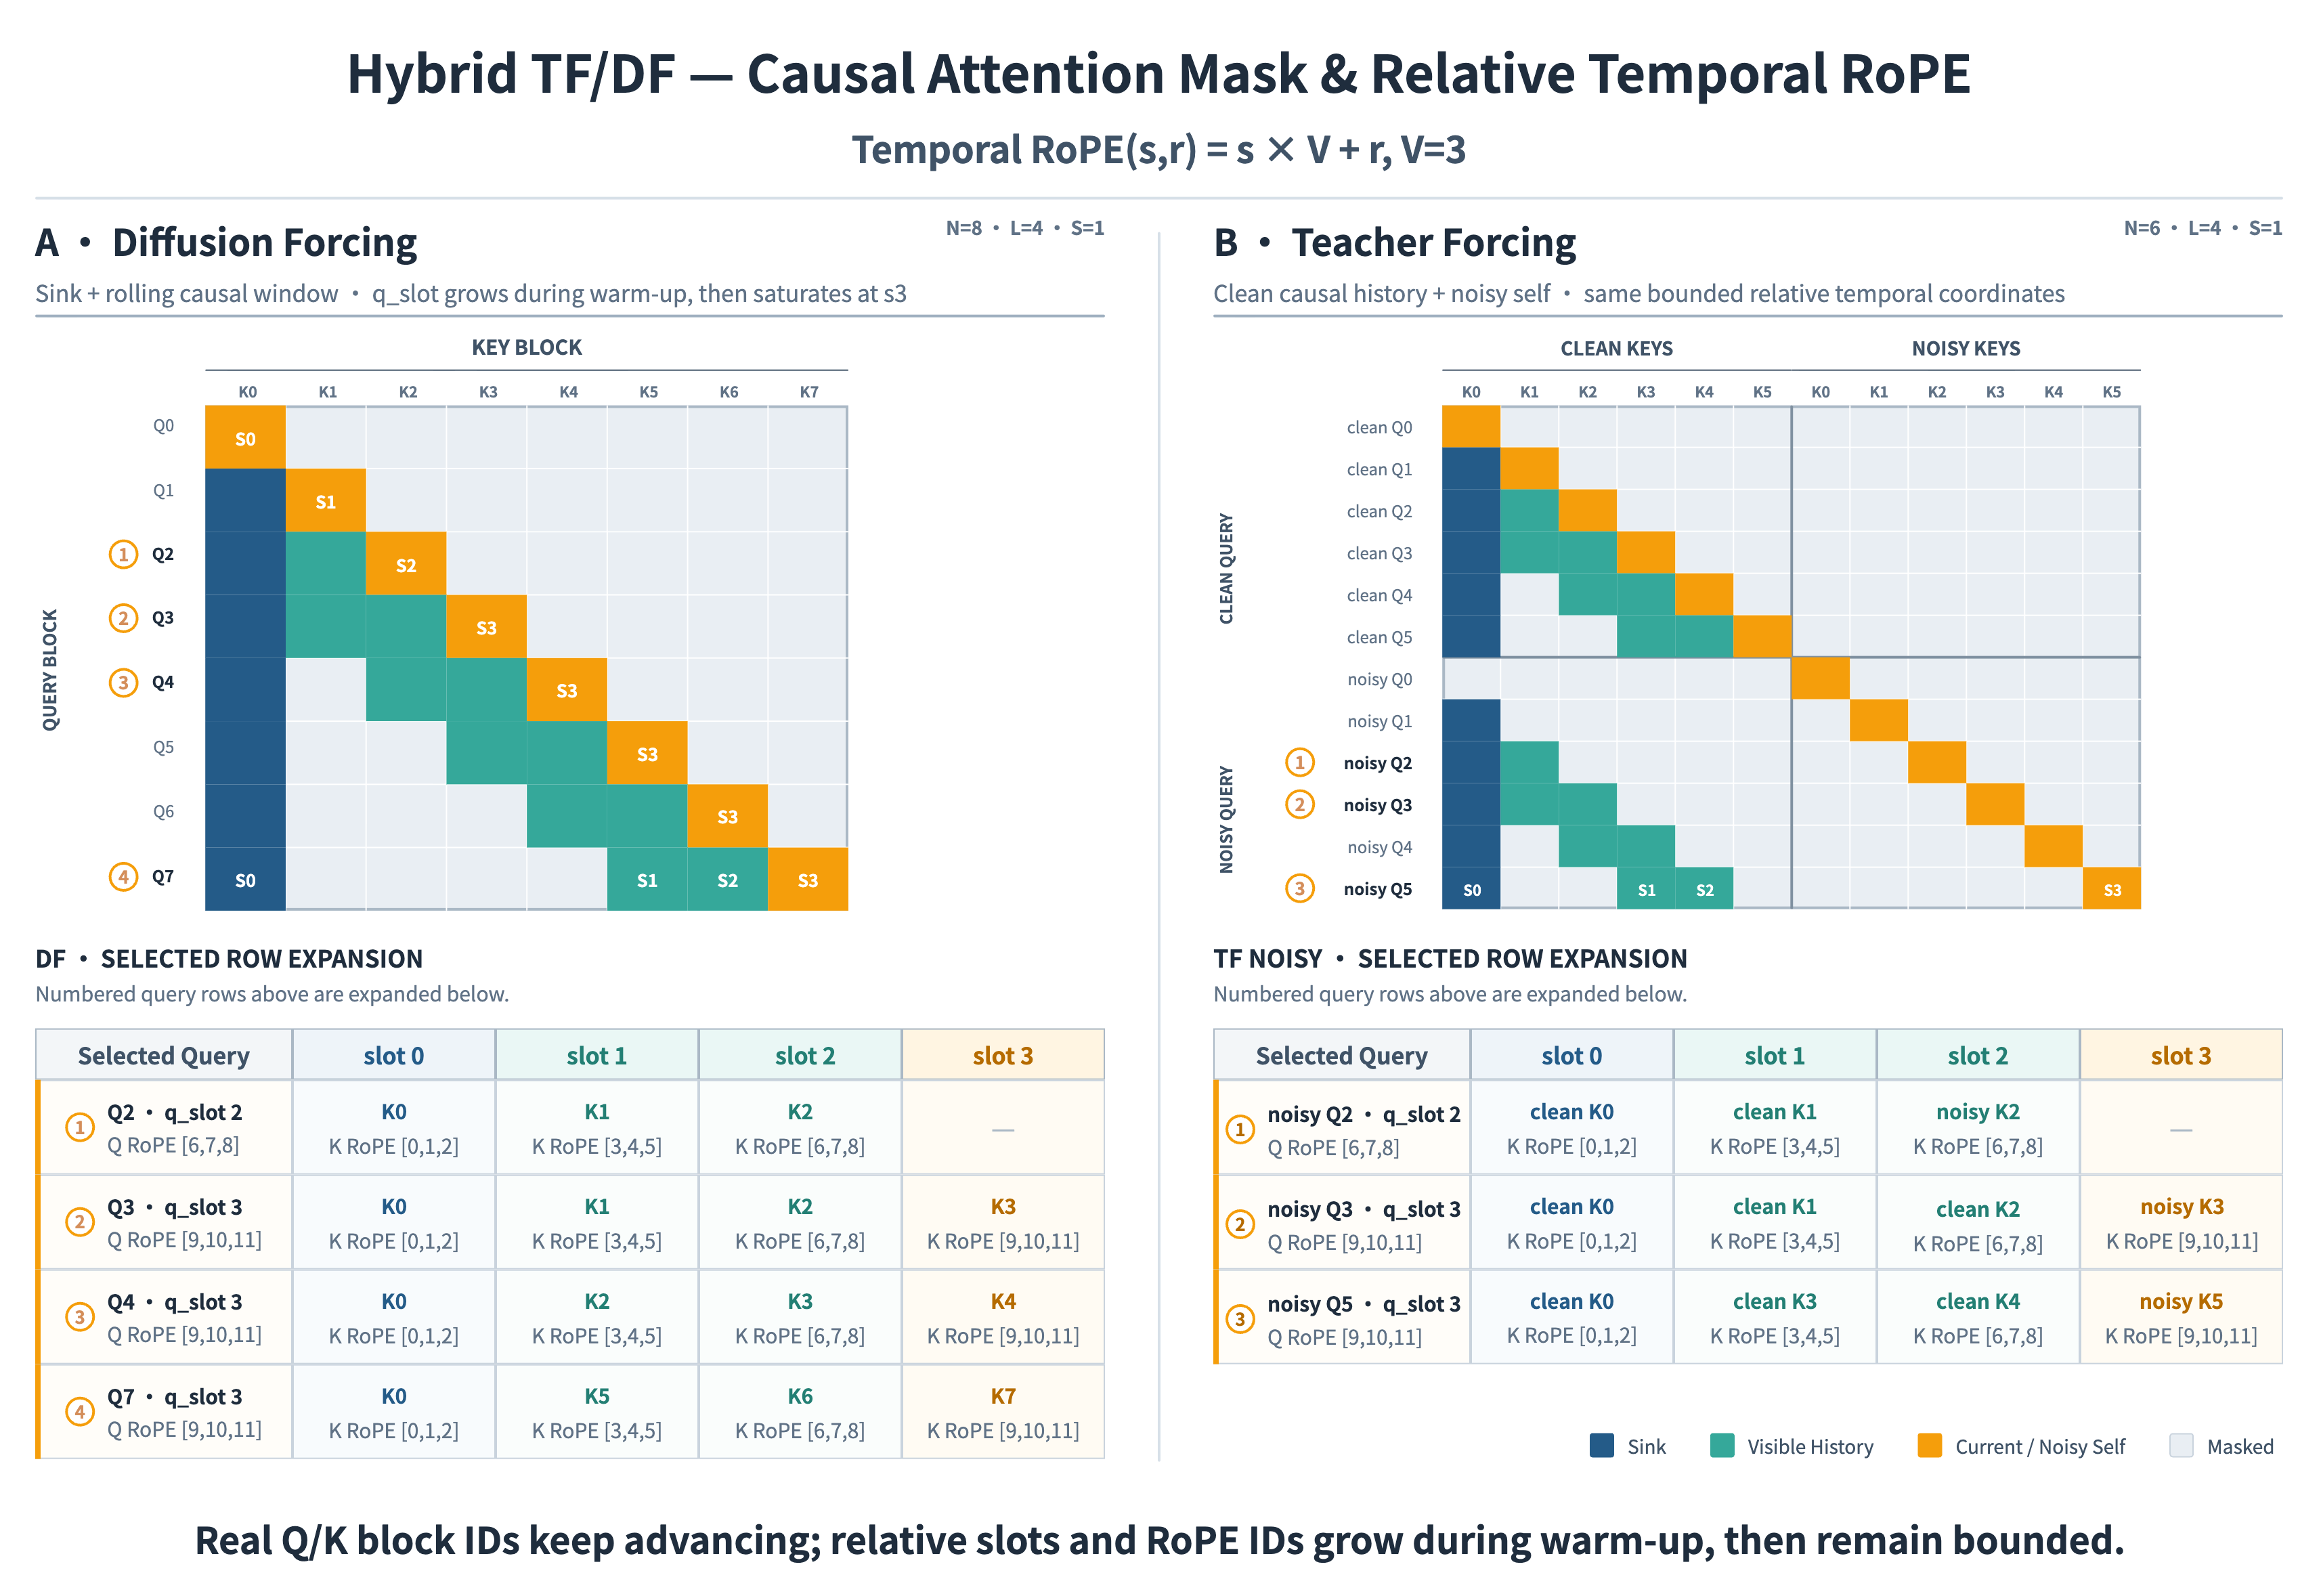
Figura 3. Maschera di attenzione causale unificata e RoPE temporale relativo per Hybrid Teacher / Diffusion Forcing. La sezione superiore mostra la visibilità causale nelle due configurazioni di cronologia. La sezione inferiore illustra la mappatura delle query sui blocchi Q/K, sugli slot relativi e sugli indici RoPE, evidenziando che i numeri di blocco reali crescono mentre le coordinate interne restano limitate.
Memoria a scale temporali multiple (Multi-timescale memory)
La modellazione del mondo su percorsi estesi non può risolversi nel conservare passivamente l’intero passato. Una cronologia sconfinata fa lievitare rapidamente i requisiti di memoria e calcolo; una potatura drastica cancella la fisionomia dei protagonisti, la conformazione dei luoghi e gli snodi narrativi. R2 implementa un sistema di memoria articolato su Sink Memory, Rolling History e Object KV Cache.
- Sink Memory: custodisce i cardini permanenti, quali aspetto dei personaggi, fisionomia dell’ambiente, canone stilistico e regole del mondo.
- Rolling History: memorizza le azioni prossime, le posture, i movimenti della camera e le variazioni di luce per raccordare con naturalezza i passaggi ravvicinati.
- Object KV Cache: comprime e ricicla le descrizioni analitiche degli elementi scenici già elaborate, trattenendo solo i dati che avranno effettivo impatto sullo sviluppo futuro con un dispendio misurato di risorse.
L’azione congiunta di questi tre livelli salvaguarda la coerenza delle figure, la fluidità delle movenze e la sostenibilità dei costi di calcolo, abbattendo alterazioni dei volti, salti d’inquadratura e sfarfallii.
Error Bank
Le derive gravi nei modelli di mondo autoregressivi scaturiscono di frequente da un microscopico difetto impresso nella cronologia ed enfatizzato nei fotogrammi successivi. R2 adotta una banca degli errori (Error Bank) che cataloga anomalie storiche rappresentative e le reimmette deliberatamente nell’addestramento secondo dosaggi definiti. La rete non impara soltanto a proseguire a partire da condizioni impeccabili, ma acquisisce l’abilità di riconoscere, neutralizzare e raddrizzare una sequenza che ha iniziato a deviare.
Nei test comparativi, il parametro di deriva della luminosità a lungo termine è calato da 0,201 a 0,129, con una contrazione pari al 35,8%. Su 29 sequenze prolungate esaminate, 20 hanno palesato marcati progressi, e in tutte e 5 le prove concepite per rimanere immobili sono stati azzerati i movimenti parassiti.
Accelerazione in tempo reale
L’accelerazione real-time di R2 non si prefigge di insegnare la fisica di un universo complesso a un modello a bassissimo numero di passi partendo da zero. Essa si limita a velocizzare un modello di mondo che già dimostra piena stabilità e tenuta nel tempo. Lo stadio di accelerazione muove dall’Omni Causal AR pre-addestrato, sfruttandolo sia per l’avvio dell’ODE sia come docente di distillazione, garantendo la condivisione della medesima traiettoria causale.
Questo punto di partenza concordato stempera la dipendenza da correttivi complessi quali Self-Forcing o Rolling Forcing. L’accelerazione può focalizzarsi sulle criticità insite nella sintesi in pochissimi passaggi: DDMD con regolarizzazione avversaria presidia l’obbedienza alle condizioni, l’aderenza distributiva e il realismo visivo; l’attenzione a blocchi sparsi (block-sparse attention) snellisce il carico computazionale sui contesti lunghi; e una struttura a piramide riduce l’onere computazionale alle risoluzioni più elevate.
DDMD con regolarizzazione avversaria
Nella sintesi a passaggi minimi, il rispetto dei comandi, l’equivalenza distributiva e la credibilità fotografica delineano finalità di ottimizzazione non coincidenti. R2 si fonda su DDMD introducendo la regolarizzazione avversaria mutuata da DMD2. Tre stimoli si compenetrano nello studente: il controllo sulle condizioni fortifica la guida, l’armonizzazione distributiva preserva l’abilità del docente e la regolarizzazione avversaria àncora l’output ai dati reali. Pochi passi di campionamento bastano così a garantire reattività immediata e un ambiente credibile.
Attenzione a blocchi sparsi (Block-sparse attention)
R2 fa leva sull’attenzione a blocchi sparsi per le sequenze di token spazio-temporali. Il modello scompone le matrici Q, K e V in blocchi operativi, valuta celermente quali blocchi di chiavi e valori siano essenziali per ciascuna query, trattiene solo i percorsi ad alta affinità ed esegue l’attenzione softmax puntuale su questi specifici raggruppamenti. Tale instradamento non costituisce un taglio arbitrario: focalizza la potenza di calcolo sulle connessioni dominanti tra controlli multimodali attivi, dinamiche prossime e assetti portanti del mondo.
Educando la rete a questa trama sparsa sin dalla fase formativa, R2 eleva la parsimonia dell’attenzione a oltre il 90%, custodendo nitidezza, continuità d’azione, fedeltà alle indicazioni e tenuta sul lungo termine senza flessioni sensibili nelle prove effettuate.
Distillazione piramidale a passaggi minimi
Elaborare l’intero ambiente fin dal principio nello spazio ad alta definizione disperde risorse preziose su volumi e geometrie complessive che una risoluzione più contenuta è già perfettamente in grado di impostare. R2 articola la generazione in uno o due stadi a risoluzione moderata seguiti da un passaggio ad alta definizione. I primi passaggi definiscono la composizione scenica, il percorso dei soggetti e i movimenti della camera. Il passaggio conclusivo rifinisce texture, contorni e dettagli minuti. Questa progressione dal macro al micro scongiura calcoli ridondanti consolidando al contempo la stabilità strutturale della scena.
Conclusioni e limiti attuali
PixVerse R1 ha ideato e lanciato il primo modello di mondo video operante in tempo reale, dimostrando che il video generato può superare lo status di file pre-renderizzato per farsi mondo dinamico, continuo e aperto all’interazione. PixVerse R2 scioglie il nodo della scalabilità di questo paradigma: un Omni Causal AR unificato sostiene volumi crescenti di dati, obiettivi, modalità e tempi, mentre l’Accelerazione in tempo reale traduce questo patrimonio in risposte istantanee a bassissimo numero di passi.
R2 non è un semplice ritocco a parametri circoscritti, ma un impianto di addestramento strutturato per la nuova generazione di modelli di mondo. Se R1 ha conferito concretezza ai modelli di mondo in tempo reale, R2 li traghetta in una fase unificata, scalabile e votata al perfezionamento continuo.
Sotto i vincoli rigorosi dell’elaborazione istantanea e della minima latenza d’interazione, la resa grafica di una singola generazione serba margini di crescita rispetto ai migliori modelli video offline, segnatamente nella precisione delle micro-texture, nella spontaneità cinetica, nella fedeltà alle leggi fisiche e nella stabilità su sequenze prolungate. Tali divari rispecchiano lo stadio evolutivo attuale di R2 più che un limite invalicabile della struttura stessa.
Accesso anticipato
Al 23 agosto 2026 questo rapporto descriveva PixVerse R2 come un test a numero chiuso. Il 22 settembre 2026 PixVerse ha annunciato che una raccolta di questi mondi è aperta all’esplorazione su world.pixverse.video. Vedi l’annuncio di lancio di R2.
Quell’annuncio non apre un accesso API senza restrizioni. Il modulo di richiesta per il modello di mondo PixVerse R2 resta il percorso di richiesta per l’accesso anticipato e le credenziali API.
Risorse correlate
- PixVerse R1 spiegato: Il modello di mondo video AI in tempo reale
- Analisi di PixVerse Game Engine
- PixVerse aggiorna R1 con i mondi condivisi
- Guida alla generazione video AI in tempo reale
- PixVerse conclude l’estensione del Series C
I mondi dell’annuncio del 22 settembre 2026 sono aperti all’esplorazione su world.pixverse.video. L’accesso API si richiede ancora tramite il modulo sopra. Si può anche creare oggi con PixVerse V6 e R1.