PixVerse R2: توسيع نماذج العالم الشاملة في الوقت الفعلي
قدّم PixVerse R1 وأطلق أول نموذج عالم فيديو في الوقت الفعلي، محوّلًا توليد الفيديو من تسليم لمرة واحدة لمقطع ثابت إلى عالم يعمل باستمرار. يستطيع النموذج مواصلة تلقي مدخلات المستخدم، وتحديث حالة العالم في الوقت الفعلي، وبث صوت وفيديو متزامنين يظلان متسقين مع التفاعل. وأظهر R1 أن هذا النموذج التقني يمكن أن ينجح.
يجيب PixVerse R2 عن السؤال التالي: كيف يواصل نموذج عالم فيديو في الوقت الفعلي التوسع. يركز R2 على هدفين. أولًا، يبني عالمًا ديناميكيًا يستطيع الاحتفاظ بحالة موحّدة عبر آفاق طويلة، محوّلًا المسبقات الزمكانية الكاملة إلى تطور للعالم يتحرك إلى الأمام في الزمن فقط. ثانيًا، يستبطن باستمرار السببية الفيزيائية وإشارات التفاعل من النص والمرجع والصوت والفعل في نموذج واحد، بحيث يستطيع العالم أن يولّد ويتلقى التحكم ويحدّث الحالة في الوقت نفسه أثناء بث صوت وفيديو متزامنين.
وحول هذين الهدفين، يحوّل R2 النمو في النموذج والبيانات والمهام وإشارات التحكم والمقياس الزمني إلى مكاسب في جودة التوليد والاتساق طويل المدى والتحكم متعدد الوسائط.
الإطار العام
يختزل R2 النظام إلى طبقتين أساسيتين: Omni Causal AR والتسريع في الوقت الفعلي. يواصل Omni Causal AR توسيع توليد عالم عالي الجودة ومتعدد الوسائط وذي أفق طويل. ويرث التسريع في الوقت الفعلي تلك القدرات بأقل فقد ممكن تحت ميزانية صارمة لزمن استجابة التفاعل. المسار واضح: ارفع سقف قدرة نموذج العالم، ثم سرّع تلك القدرة إلى نطاق تشغيل تفاعلي في الوقت الفعلي.
كانت خطوط الفيديو الطويل والوقت الفعلي الأقدم تربط عادة مراحل تدريب عديدة: تحويل نموذج ثنائي الاتجاه إلى نموذج انحدار ذاتي، وبناء معلّم تقطير من نموذج ثنائي الاتجاه خاص بمهمة، وتشغيل تقطير DMD، ثم إضافة DMD بالطرح الذاتي لسد فجوة التدريب–الاستدلال. وكان على كل مرحلة إعادة ترحيل القدرة وإعادة محاذاة الأهداف وإعادة ملاءمة توزيع البيانات. وكان يمكن أن تتآكل جودة الصورة والحركة واتباع الشرط واستقرار الأفق الطويل أثناء تلك التحويلات. ومع نمو مقياس النموذج والبيانات والمهام، قسّم خط المعالجة متعدد المراحل هدف التحسين ورفع تكلفة التدريب وتعقيد النظام معًا.
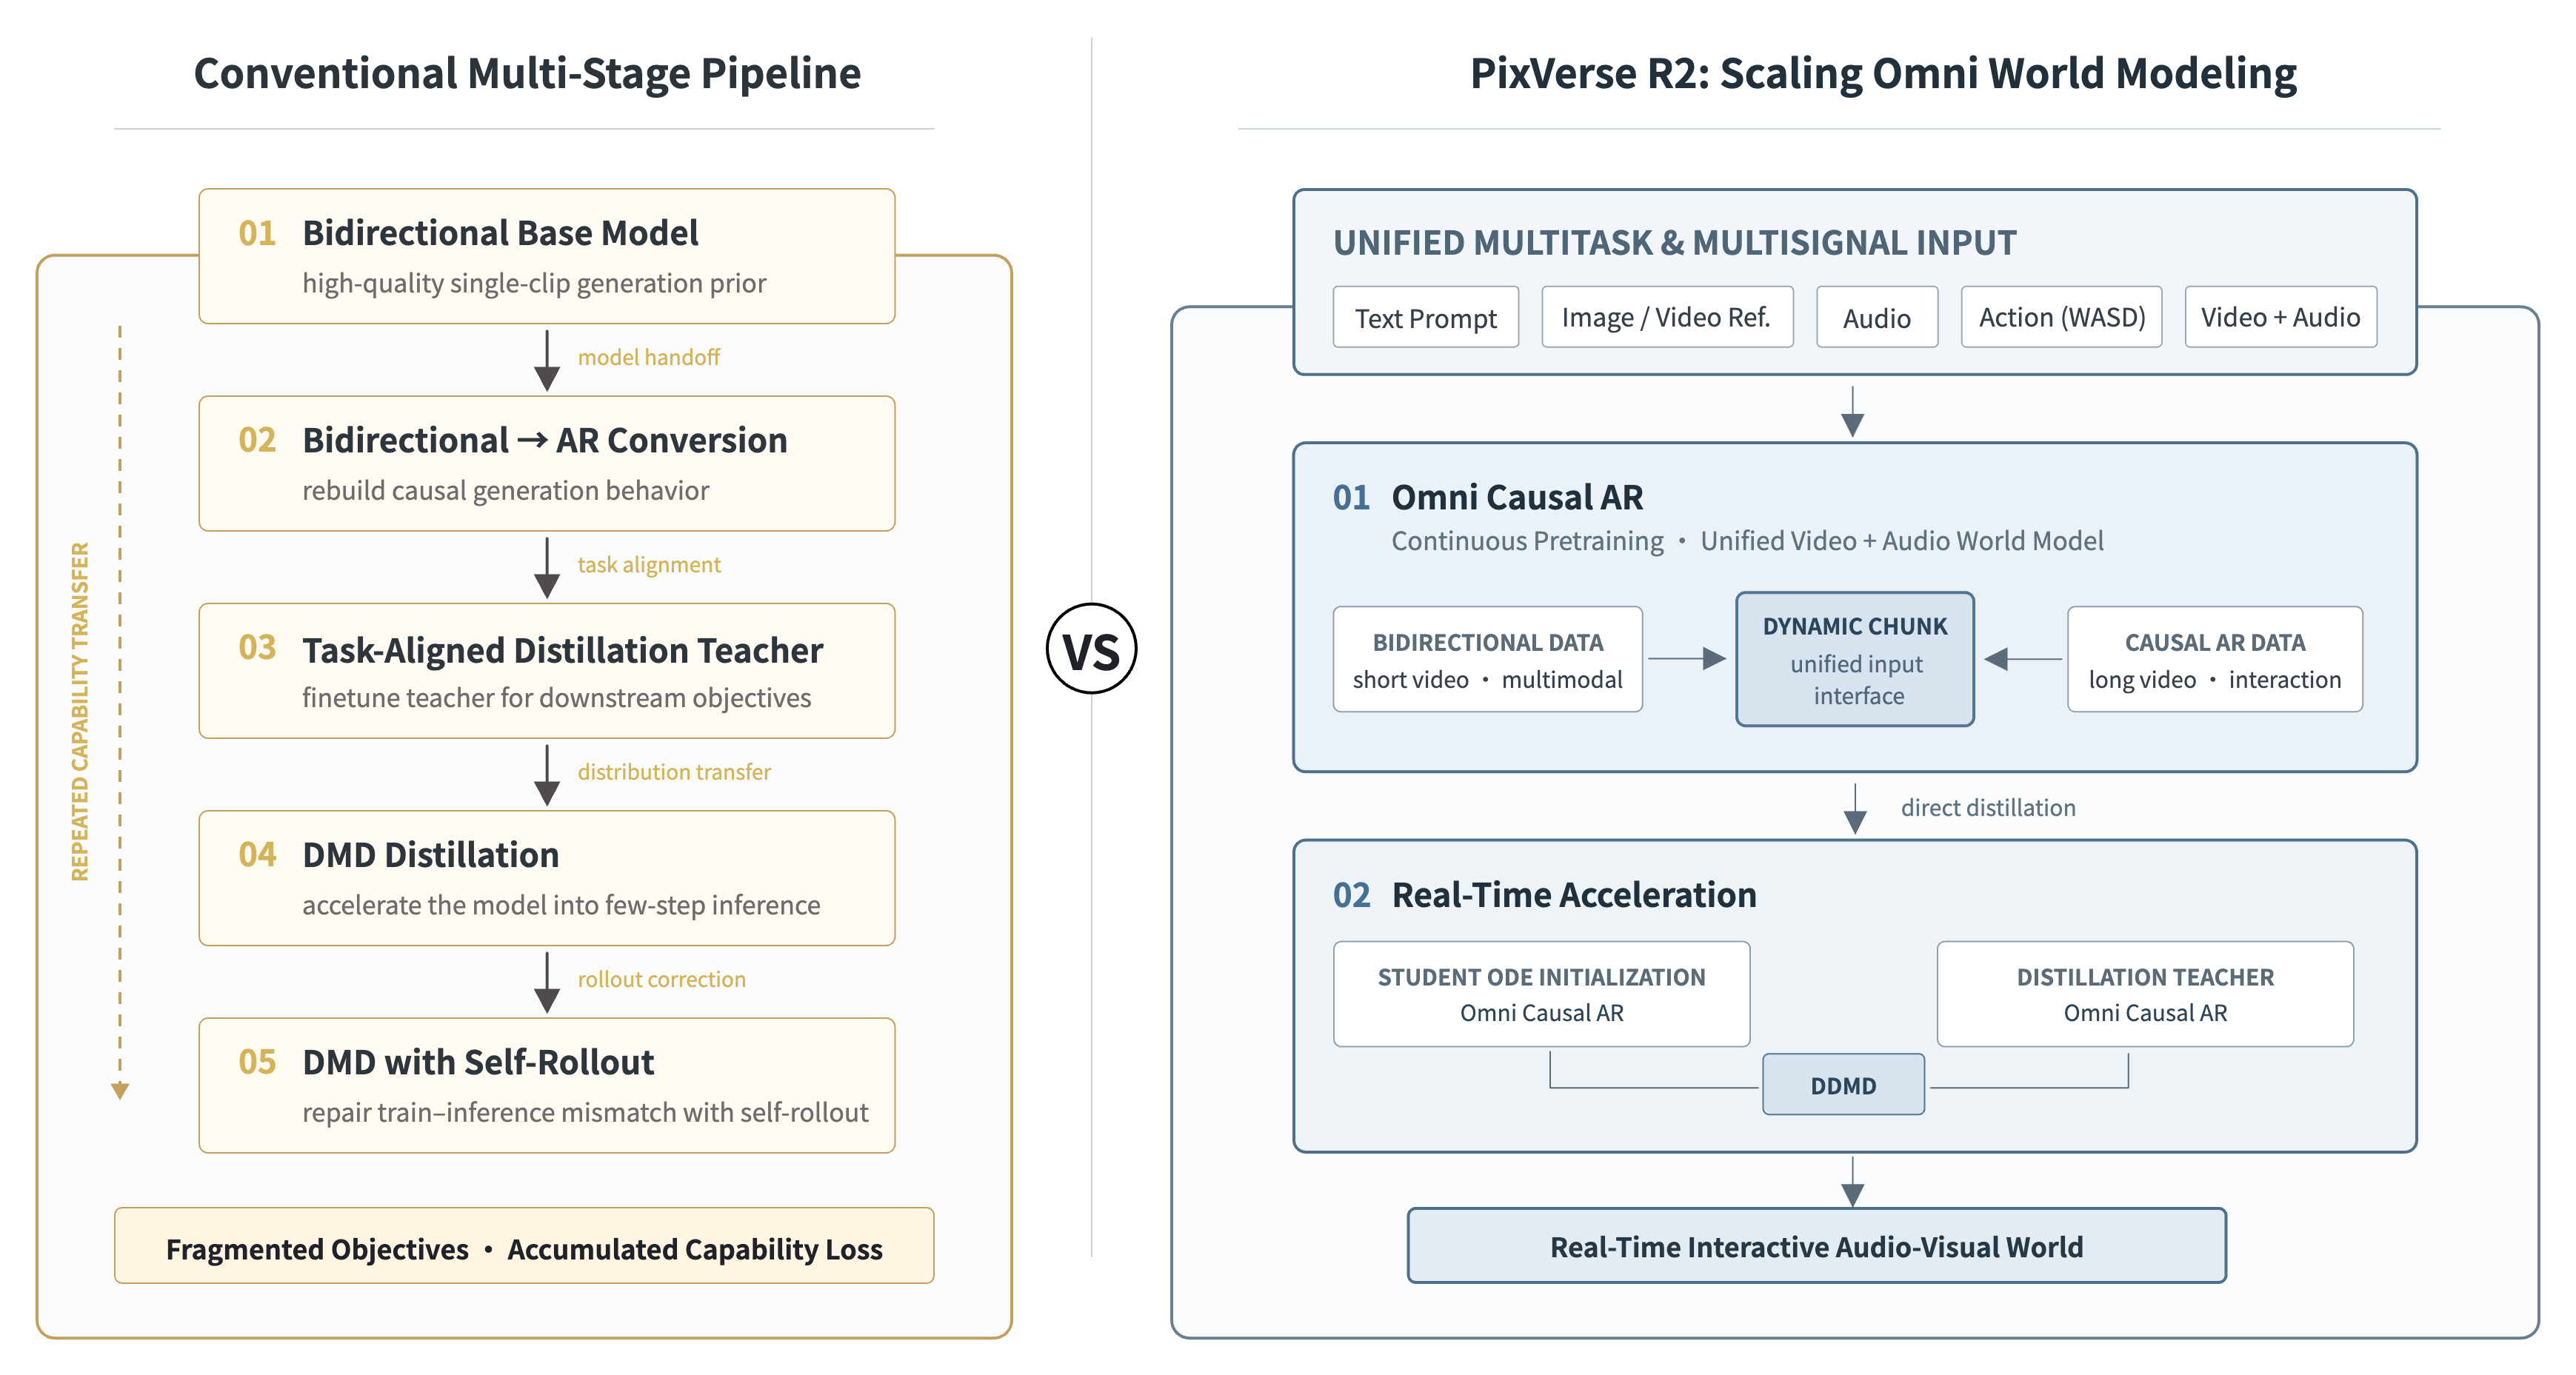
الشكل 1. خط المعالجة القديم متعدد المراحل مقابل توسيع نمذجة العالم في PixVerse R2. يقارب R2 توسيع القدرة وتقطير الوقت الفعلي في Omni Causal AR وطبقة تسريع في الوقت الفعلي، موحّدًا نمذجة المهام المتعددة والإشارات المتعددة والفيديو الطويل في إطار واحد.
يقترح PixVerse R2 نموذج تدريب موحّدًا لنماذج العالم في الوقت الفعلي. وبدل ترحيل القدرة مرارًا عبر نماذج ومراحل مهام كثيرة، يختزل خط المعالجة المعقد إلى عمليتين يمكنهما مواصلة التوسع: التدريب المسبق المستمر لـ Omni Causal AR يحتفظ بحالة عالم موحّدة، ثم تقطيره مباشرة إلى نموذج مسرَّع يستطيع التوليد في الوقت الفعلي مع وراثة الاتساق المكاني ونمذجة الأفق الطويل.
تقلل حدود المراحل الأقل فقد القدرة الناتج عن المعلمين المستقلين ومحاذاة المهام وعمليات نقل النموذج المتكررة. ويمكن أن تتحول البيانات والمهام وإشارات التحكم ومقياس النموذج الجديدة بشكل أكثر مباشرة إلى قدرة نمذجة العالم في الوقت الفعلي.
المرحلة 1: التدريب المسبق المستمر لـ Omni Causal AR. لم يعد R2 يعامل مسبقات التوليد ثنائي الاتجاه والانحدار الذاتي للفيديو الطويل كمرحلتين منفصلتين. فهو يدرّب باستمرار Omni Causal AR موحّدًا فوق قدرة النموذج ثنائي الاتجاه. تمنح القطع الديناميكية أشكال البيانات المختلفة تمثيلًا زمنيًا مشتركًا: يستطيع النموذج استيعاب فيديو قصير عالي الجودة وبيانات متعددة الوسائط من التدريب المسبق ثنائي الاتجاه، ويمكنه التوسع إلى فيديو طويل متصل ومسارات تفاعل متعددة الأدوار. ويمكن أن تتوسع جودة الصورة والتعبير السمعي البصري وتوليد الأفق الطويل والتحكم متعدد الإشارات داخل نموذج واحد بدل إعادة ترحيلها عبر تحويلات متكررة.
المرحلة 2: تقطير طبقة تسريع في الوقت الفعلي من Omni Causal AR الموسَّع. يمنح التدريب المسبق المستمر Omni Causal AR توليدًا عالي الجودة، ونقل حالة مستقرًا ذا أفق طويل، وطرحًا سببيًا حقيقيًا في الوقت نفسه. ثم يستخدم R2 Omni Causal AR نفسه لكل من تهيئة ODE للطالب ومعلّم التقطير، بحيث يتشارك المعلم والطالب واستدلال الانحدار الذاتي الحقيقي قاعدة نمذجة سببية متسقة. ويصبح تقطير الوقت الفعلي «تسريعًا بخطوات قليلة لنموذج عالم قائم»، لا «إعادة تعلم عالم ذي أفق طويل».
Omni Causal AR
يواصل R2 مسار المدخلات متعددة الوسائط والتوليد بالانحدار الذاتي والتفاعل في الوقت الفعلي الذي سبق أن أثبته R1، ثم يركّز تلك القدرات في مسار تدريب موحّد لـ Omni Causal AR. يحوّل Omni Causal AR مسبقات التوليد الزمكانية الكاملة إلى نقل لحالة العالم يتحرك إلى الأمام في الزمن فقط. وعبر السببنة والتدريب المسبق المستمر، يحتفظ النموذج بقدرة الصورة والحركة والصوت والدلالة متعددة الوسائط بينما يتعلم التنبؤ بالقطعة السمعية البصرية المتزامنة التالية من التاريخ وحده.
ومع توسع أهداف التدريب من فيديوهات قصيرة مستقلة إلى فيديوهات طويلة متصلة ومسارات تفاعل متعددة الأدوار، يبني النموذج تدريجيًا سببية طويلة الأمد بين حالة العالم التاريخية ومدخل التفاعل الحالي وتطور العالم المستقبلي.
يستقبل النموذج معًا موجّهًا نصيًا ومراجع متعددة الوسائط وإشارات تحكم (مثل WASD أو التحكم المستمر) والصوت، ويُخرج فيديو وصوتًا متزامنين. ويمكن أن تستمر إشارات التحكم المختلفة في الدخول إلى النموذج أثناء التشغيل وتغيّر حالة العالم لاحقًا. ولا يقتصر R2 على الاستجابة لشرط يُقدَّم مرة واحدة؛ فهو قادر على التوليد واستقبال التحكم وتحديث العالم في الوقت نفسه.
للحفاظ على التوليد السببي داخل العالم نفسه عبر تشغيل طويل، يعالج R2 أربع مشكلات: فجوة التوزيع بين التدريب والاستدلال، والمتانة تجاه التاريخ المشوش، وتنسيق الذاكرة طويلة الأمد والذاكرة الحديثة، وتصحيح حالات الخطأ. يتيح Hybrid Teacher / Diffusion Forcing للنموذج التكيّف مع التاريخ النظيف والمشوش معًا. وتخزّن Multi-Timescale Memory بشكل مشترك مراسي العالم والديناميكيات الحديثة وحالة الكائن. وتعيد Error Bank الحالات الفاشلة إلى التدريب. وتشكّل هذه العناصر معًا حلقة تدريب لحالة العالم طويلة الأمد وتقلّل الانجراف في الصورة والشخصية والحركة والعلاقة السمعية البصرية واستجابة التحكم بمرور الوقت.
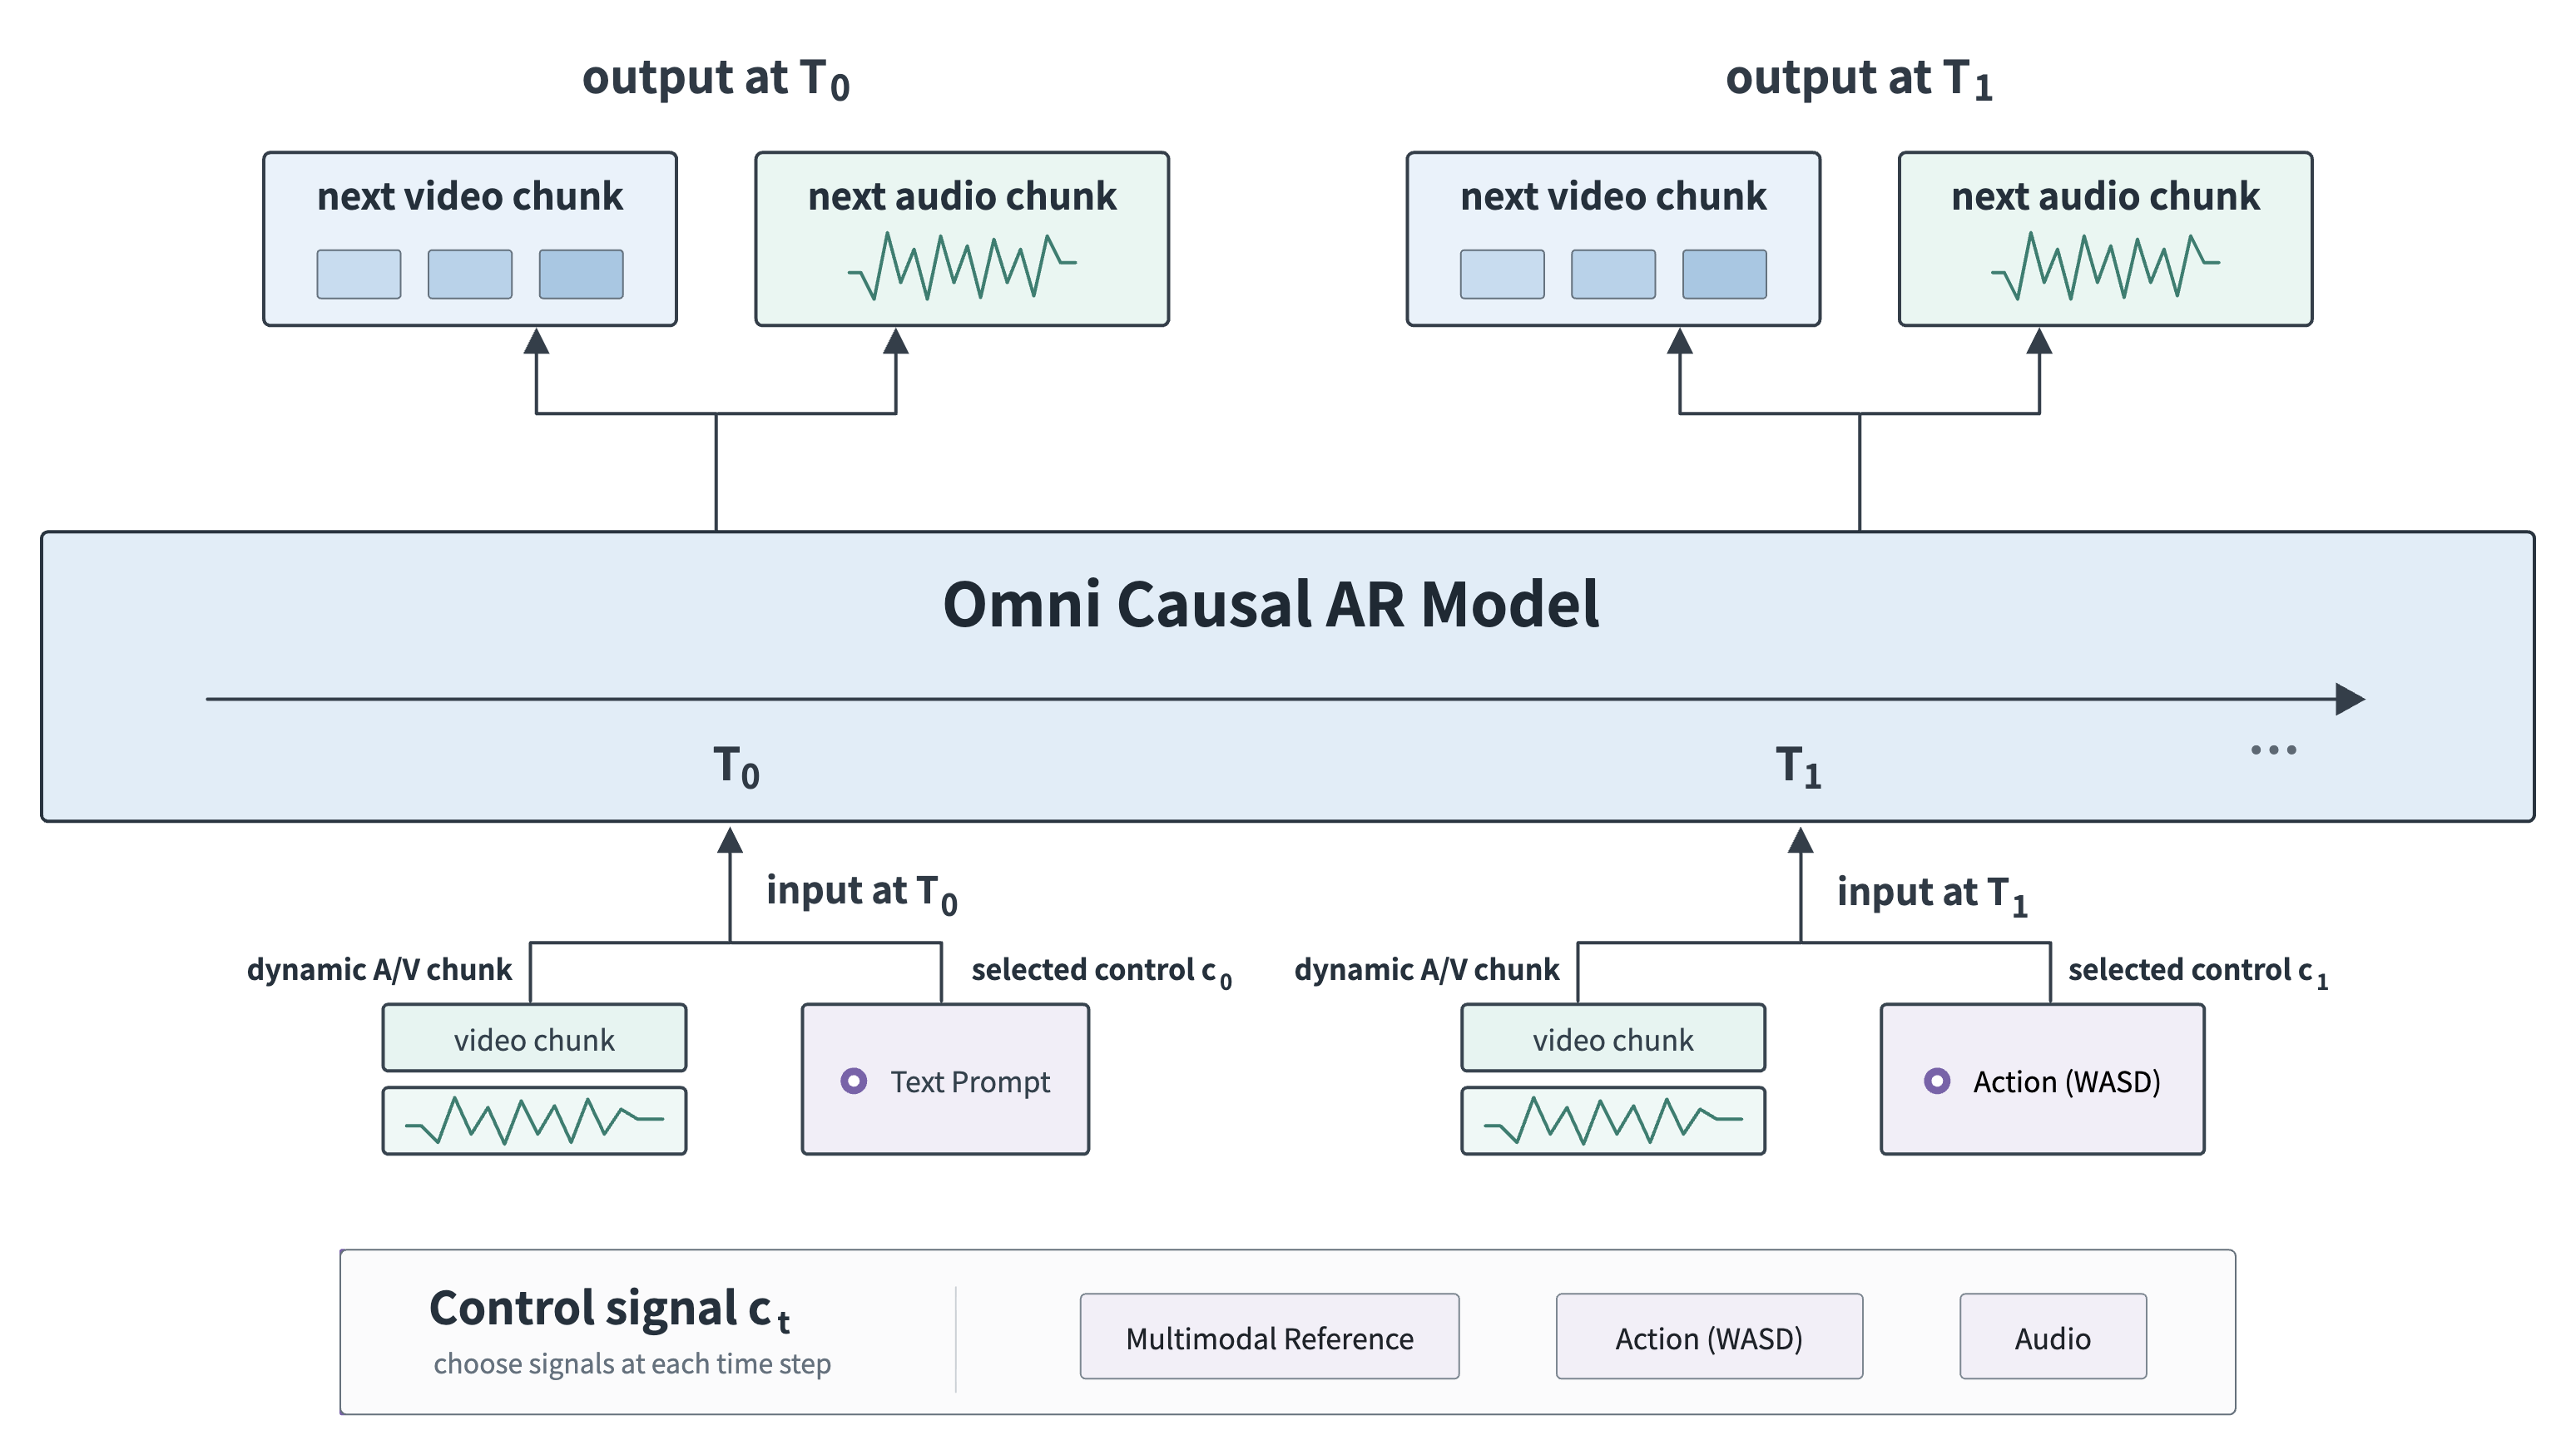
الشكل 2. PixVerse R2 Omni Causal AR. يمكن للنموذج أن يستمر في استقبال إشارات تحكم مختلفة أثناء التشغيل. وفي كل لحظة تفاعل، تتوافق الإشارة النشطة مع مقطع سمعي بصري ديناميكي عند الدقّة المطابقة وتقود مقطع الفيديو والصوت التالي.
توليد المقاطع الديناميكي
تعيش إشارات التحكم المختلفة على مقاييس زمنية مختلفة. وعادةً ما تصف الموجّهات والمراجع دلالات كاملة أو أحداثًا أطول. ويحتاج الفعل (WASD) إلى تغذية راجعة فورية ودقيقة للحالة. ويحمل الصوت الدلالات والإيقاع والمزامنة الزمنية في آن واحد. وإذا أُجبر كل مدخل على وحدة زمنية بطول ثابت، فغالبًا ما يضطر النموذج إلى المقايضة بين سرعة الاستجابة واكتمال التعبير.
Dynamic Chunk هي الطريقة التي يوحّد بها R2 مقاييس التفاعل الزمنية هذه. يقسّم R2 تسلسلات الصوت والفيديو تكيّفيًا وفق الحدود الدلالية ومدة إشارة التحكم الحالية، مع حد أقصى لحجم المقطع يقيّد الحوسبة واستقرار التدريب. وتحسّن المقاطع القصيرة دقة الاستجابة للأفعال والتعليمات المحلية. وتحافظ المقاطع الطويلة على البنية الكاملة للأحداث والحركة والدلالات السمعية البصرية. ويمكن أن تتشارك المهام وإشارات التحكم المختلفة واجهة توليد سببي واحدة من دون تبديل بنية النموذج.
Hybrid Teacher Forcing / Diffusion Forcing
التوتر الجوهري في التوليد التلقائي طويل الأفق هو أن تاريخ التدريب يكون عادةً أنظف، بينما يحتوي تاريخ التشغيل الفعلي على ضوضاء النموذج نفسه وأخطائه المحلية. والتدريب على التاريخ النظيف فقط قد يرفع سقف جودة الخطوة الواحدة، لكنه يجعل النموذج شديد الحساسية للانحرافات الصغيرة. والتدريب على التاريخ المضطرب فقط قد يضر بجودة الصورة والحركة واستجابة التحكم.
يمزج R2 التاريخ النظيف والتاريخ المشوش في عملية تدريب واحدة. ويثبّت التاريخ النظيف سقف جودة تطور العالم. ويتيح التاريخ المشوش للنموذج أن يتكيّف مسبقًا مع الحالات غير المثالية التي سيراها عند النشر. ويقلّص التدريب التكميلي فجوة التدريب والاستدلال، فيستطيع النموذج توليد مقطع عالم تالٍ عالي الجودة ومواصلة التقدم عندما يحتوي التاريخ أصلًا على خطأ صغير.
يقيّد Causal Attention Mask وRelative Temporal RoPE معًا أي تاريخ يمكن للحالة الحالية قراءته وأين يقع هذا التاريخ داخل النافذة الحالية. ويفرض Attention Mask رؤية سببية صارمة. ولا ينمو Temporal RoPE بلا حد مع معرّف كتلة عام؛ بل يُعاد فهرسته وفق الموضع النسبي داخل نافذة الانتباه الحالية. وعندما تتحرك النافذة المتدحرجة إلى الأمام، يستمر الزمن الحقيقي في التقدم، لكن ذاكرة المرسى والتاريخ الحديث والمقطع الحالي تبقى مُسقَطة على نطاق مواضع نسبية مستقر ومحدود.
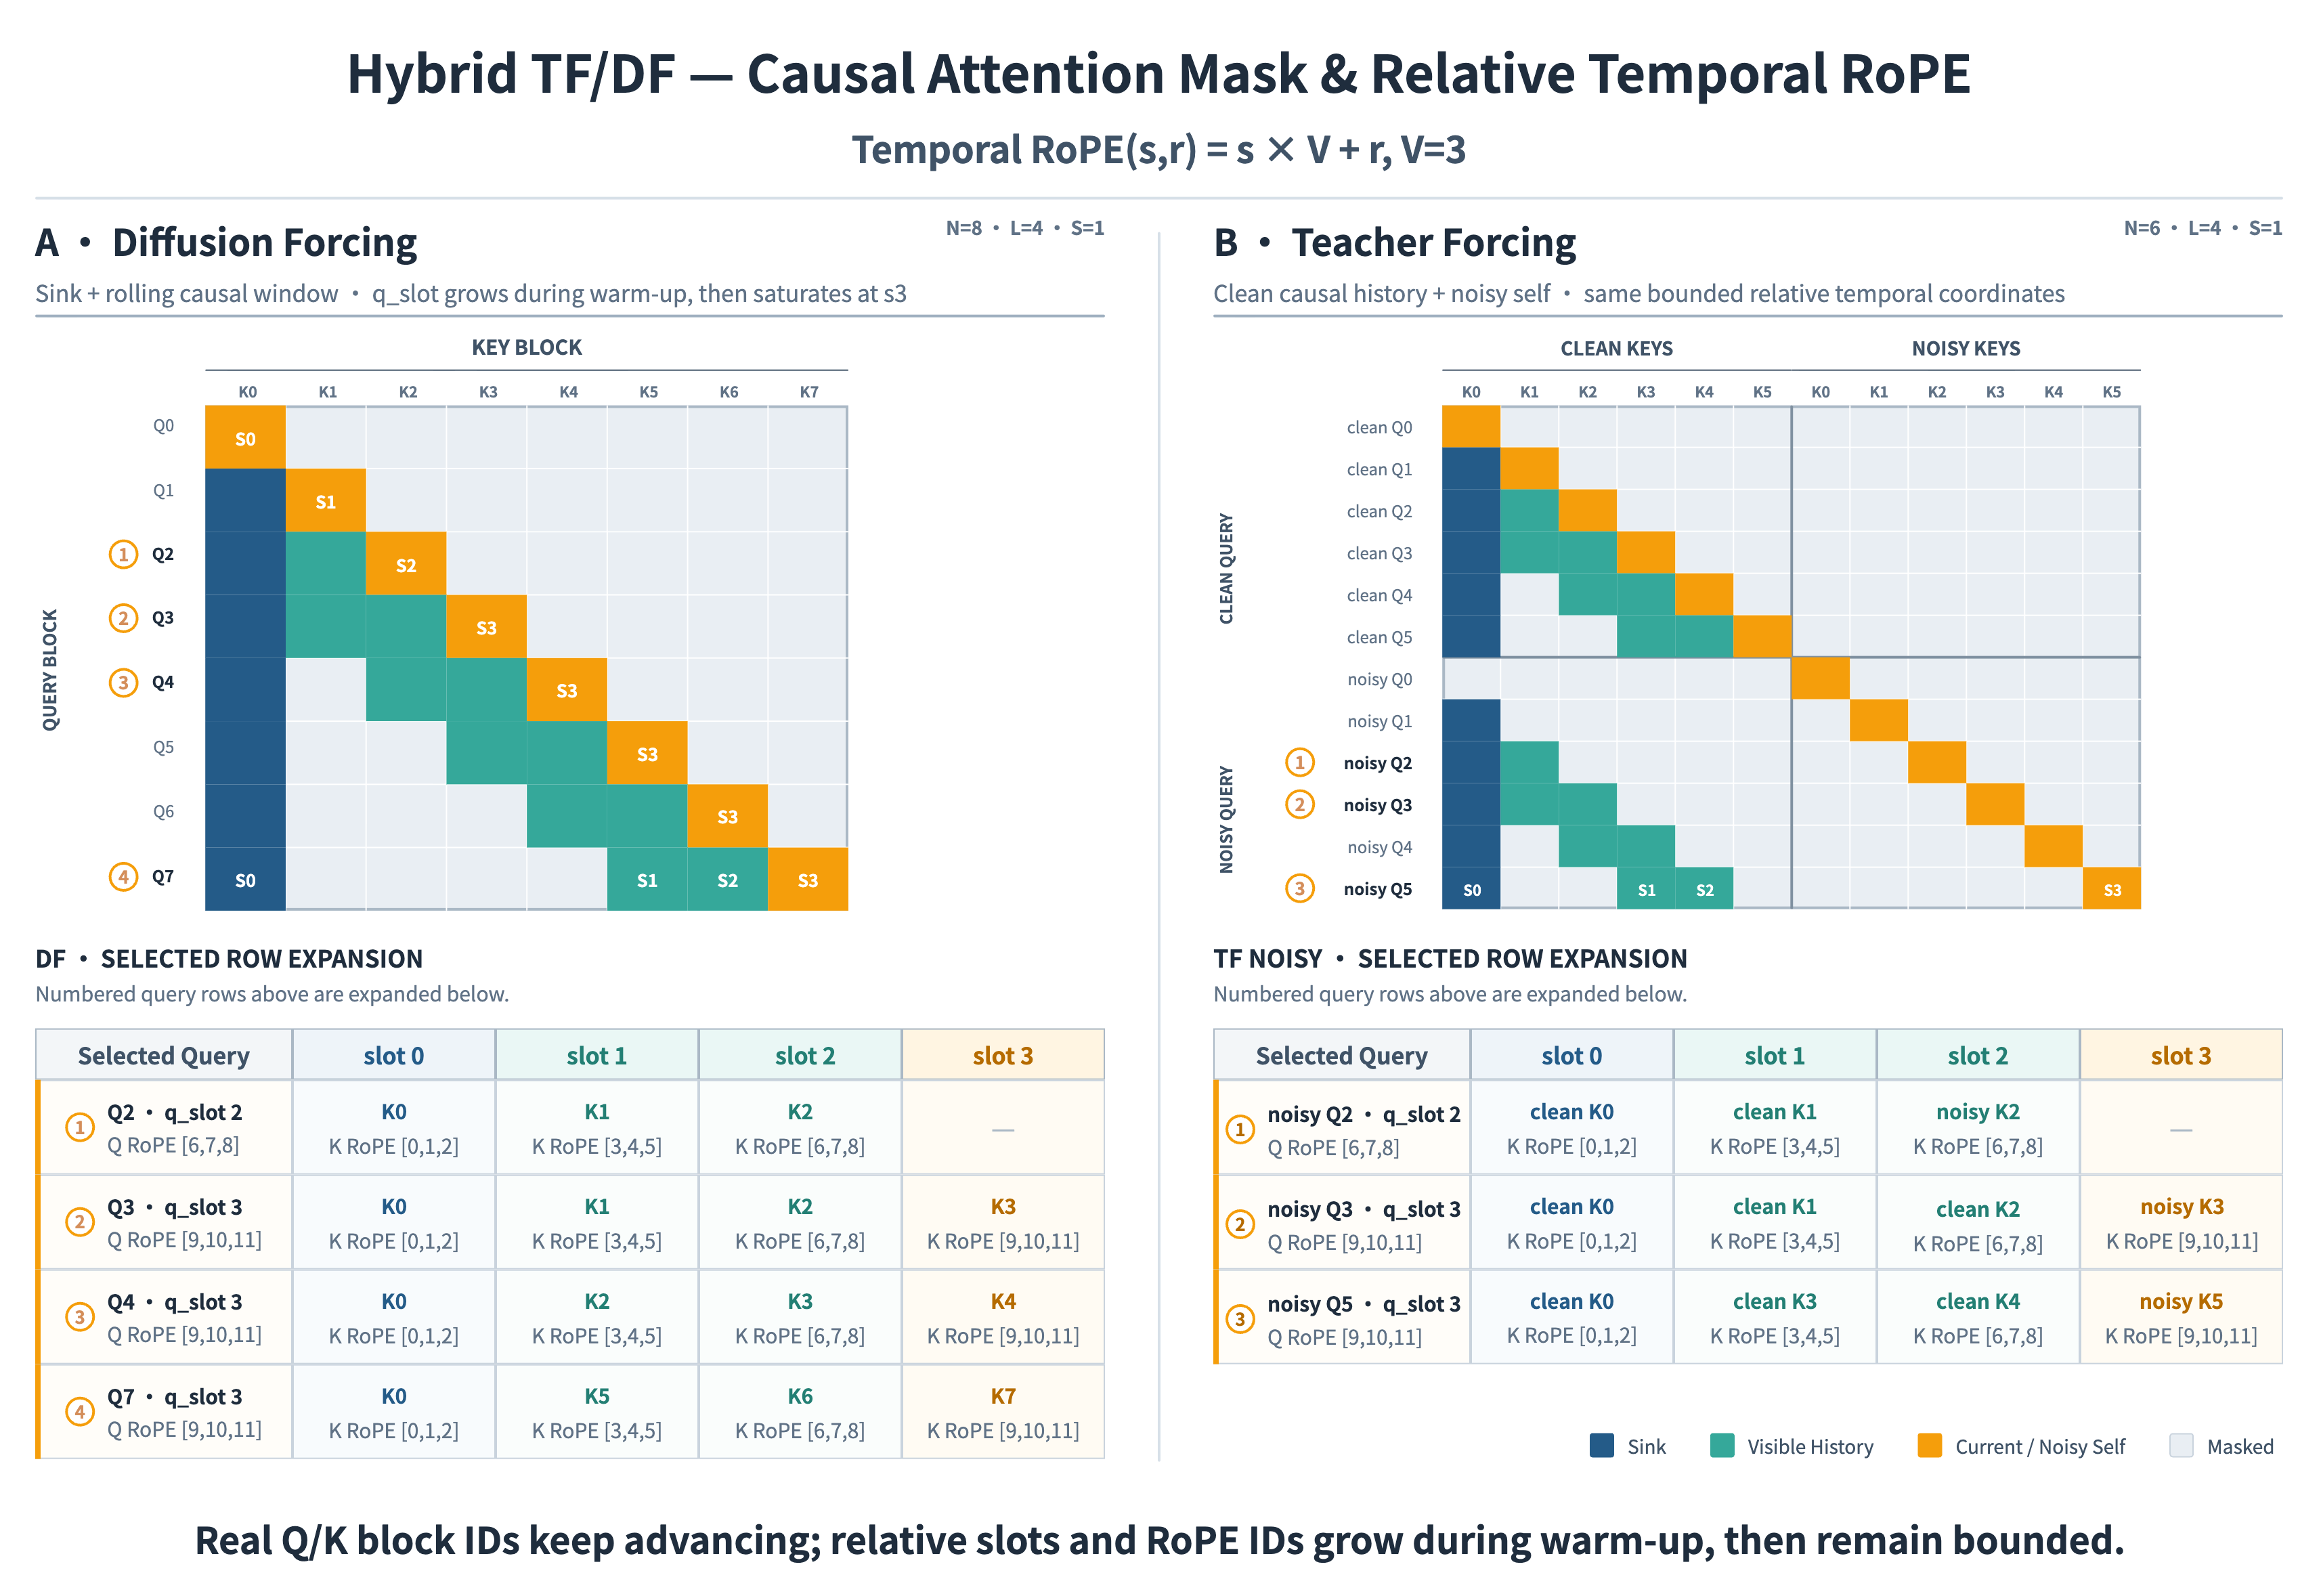
الشكل 3. قناع الانتباه السببي الموحّد وRelative temporal RoPE لـ Hybrid Teacher / Diffusion Forcing. يُظهر الجزء العلوي الرؤية السببية لبناءَي التاريخ. ويربط الجزء السفلي استعلامات تمثيلية بكتل Q/K والمواضع النسبية ومعرّفات RoPE، موضّحًا أن معرّفات الكتل الحقيقية تستمر في التقدم بينما تبقى إحداثيات الزمن داخل النافذة محدودة.
الذاكرة متعددة المقاييس الزمنية
لا يمكن لنمذجة العالم طويلة الأمد أن تتذكر التاريخ كله ببساطة. فالتاريخ غير المحدود يرفع تكلفة الحوسبة والذاكرة بسرعة، والاقتصاص المفرط يُسقط هوية الشخصية وإعداد المشهد والأحداث الأساسية. يبني R2 نظام ذاكرة متعدد المقاييس من Sink Memory وRolling History وObject KV Cache.
- تخزّن Sink Memory مراسي طويلة الأمد مثل الشخصية والمشهد والأسلوب وقواعد العالم.
- تركّز Rolling History على الفعل والوضعية والكاميرا وتغيّر البيئة حديثًا حتى تتصل الحالة المحلية بشكل طبيعي.
- تعيد Object KV Cache استخدام تمثيلات التاريخ على مستوى الكائن التي جرى حسابها مسبقًا وتضغطها، مع الإبقاء على الحالات التي تؤثر فعلًا في التطور اللاحق ضمن ميزانية محدودة.
وتمنح العناصر الثلاثة معًا استقرار الهوية على المدى الطويل واستمرارية الحركة قصيرة المدى وتكلفة تشغيل يمكن التحكم فيها، وتقلّل انجراف الشخصية وقفزات المشهد والوميض بين المقاطع وانكسار الفعل.
Error Bank
غالبًا ما يبدأ الانجراف الخطير في نموذج عالم توليدي تلقائي من خطأ مبكر صغير يُكتب في التاريخ ثم يُورَّث. يبني R2 بنك أخطاء يخزّن تواريخ أخطاء تمثيلية كعينات قابلة لإعادة الاستخدام ويعيد تشغيلها داخل التاريخ العادي بمعدل محدد أثناء التدريب. ولم يعد النموذج يتعلم فقط كيف يواصل من حالة مثالية؛ بل يتعلم أيضًا كيف يتعرّف التاريخ الذي انحرف أصلًا ويستوعبه ويصلحه.
في التقييم المرحلي، انخفض مقياس انجراف السطوع طويل الأمد من 0.201 إلى 0.129، أي بانخفاض يبلغ نحو 35.8%. ومن بين 29 عينة طويلة التسلسل، تحسّنت 20 عينة، وقلّلت العينات الخمس التي كان يُفترض أن تبقى ساكنة كلها الحركة الخاطئة.
التسريع في الوقت الفعلي
لا يعيد تسريع R2 في الوقت الفعلي تعلّم عالم طويل الأفق داخل نموذج قليل الخطوات. بل يسرّع نموذج عالم يستطيع أصلًا أن يعمل بثبات لمدة طويلة. تبدأ طبقة التسريع من Omni Causal AR المدرَّب باستمرار مسبقًا وتستخدمه لتهيئة ODE الخاصة بالطالب ولمعلّم التقطير، بحيث يتشارك المعلّم والطالب واستدلال التوليد التلقائي الفعلي توزيع مسار سببي متسق.
تقلّل نقطة البداية السببية الموحّدة هذه الاعتماد على ضبط بأسلوب Self-Forcing وRolling Forcing. ويمكن أن يركّز التسريع في الوقت الفعلي على المشكلات التي تُدخلها السرعة قليلة الخطوات فعلًا: يعالج DDMD مع التنظيم الخصومي محاذاة الشرط وتوزيع التوليد والواقعية أثناء التقطير؛ ويضغط الانتباه المتناثر على مستوى الكتل حوسبة السياق الطويل؛ ويخفّض مسار هرمي تكلفة التوليد عالي الدقة.
DDMD مع التنظيم الخصومي
في التوليد فائق قلة الخطوات، لا تُعدّ محاذاة الشرط ومطابقة التوزيع والواقعية مسألة تحسين واحدة. ويستند R2 إلى DDMD ويُدخل كذلك تنظيمًا خصوميًا من DMD2. وتلتقي ثلاث إشارات تدريب في طالب واحد: تقوّي محاذاة الشرط التحكم، وتحافظ مطابقة التوزيع على توزيع المعلّم، ويرسّخ التنظيم الخصومي البيانات الحقيقية، بحيث تستطيع خطوات أخذ العينات القليلة الإبقاء على استجابة تفاعل دقيقة وعالم قابل للتصديق معًا.
الانتباه المتناثر على مستوى الكتل
يستخدم R2 انتباهًا متناثرًا على مستوى الكتل في تسلسلات الرموز الزمكانية. ويقسّم النموذج Q وK وV إلى كتل حوسبة، ويقدّر بسرعة كتل المفاتيح/القيم التي تحتاج إليها كل كتلة استعلام أكثر من غيرها، ويُبقي فقط على الاتصالات الأعلى درجة، ويُجري انتباه softmax الدقيق على تلك الكتل المختارة. وتوجيه مستوى الكتلة ليس تقليمًا عشوائيًا؛ فهو يركّز الحوسبة على التبعيات القوية بين التحكم متعدد الوسائط الحالي والحركة الحديثة وحالة العالم الأساسية.
ومن خلال تكييف النموذج مع بنية الاتصال المتناثرة أثناء التدريب، يرفع R2 تناثر الانتباه إلى ما فوق 90% مع الحفاظ على جودة الصورة واستمرارية الفعل واتباع الشرط واستقرار الأفق الطويل من دون انخفاض واضح في التقييم الحالي.
التقطير الهرمي فائق قلة الخطوات
إن إجراء نمذجة العالم كلها من الصفر في فضاء عالي الدقة يُهدر الحوسبة على بنية عامة يمكن لدقة أقل أن تحددها أصلًا. ينظّم R2 التوليد كمرحلة أو مرحلتين منخفضتي الدقة بالإضافة إلى مرحلة عالية الدقة. وتحدّد المراحل منخفضة الدقة تخطيط المشهد وحركة الموضوع وبنية الكاميرا. وتستعيد المرحلة عالية الدقة النسيج والحواف والتفاصيل المحلية. ويقلّل المسار من الخشن إلى الدقيق تكرار الحوسبة عالية الدقة مع الحفاظ على استقرار بنيوي وتفاصيل أقوى.
الخلاصة والحدود
اقترح PixVerse R1 وأطلق أول نموذج عالم فيديو في الوقت الفعلي، مبيّنًا أن الفيديو يمكن أن ينتقل من محتوى ثابت غير متصل إلى عالم ديناميكي يستطيع التفاعل في الوقت الفعلي والاستمرار في العمل. ثم يحل PixVerse R2 كيفية استمرار هذا النموذج في التوسّع: يحمل Omni Causal AR الموحّد بيانات ومهام ووسائط ومقاييس زمنية متنامية، ويُدخل التسريع في الوقت الفعلي قدرة نمذجة العالم الكاملة إلى استدلال قليل الخطوات وفي الوقت الفعلي.
ليس R2 ترقية لقدرة في نقطة واحدة. إنه مسار تدريب موحّد للجيل التالي من نماذج العالم في الوقت الفعلي. جعل R1 نماذج عالم الفيديو في الوقت الفعلي حقيقة. ويضعها R2 في مرحلة موحّدة وقابلة للتوسّع وتتحسّن باستمرار.
في ظل ميزانية صارمة للحوسبة في الوقت الفعلي وكمون التفاعل، ما زال لجودة التوليد الواحد الحالية مجال للتحسّن مقارنة بنماذج الفيديو غير المتصلة الرائدة، خصوصًا في تفاصيل المشاهد المعقّدة وطبيعية الحركة والاتساق الفيزيائي والاستقرار عبر التشغيل الطويل. وتعكس هذه الفجوات في الغالب مرحلة التوسّع الحالية لـ R2 أكثر مما تعكس سقفًا للإطار نفسه.
الوصول المبكر
حتى 23 أغسطس 2026، وصف هذا التقرير PixVerse R2 بأنه في اختبار مغلق. وفي 22 سبتمبر 2026، أعلن PixVerse أن مجموعة من هذه العوالم مفتوحة للاستكشاف على world.pixverse.video. انظر إعلان إطلاق R2.
لا يفتح هذا الإعلان وصولًا غير مقيّد إلى واجهة API. ويبقى نموذج تجربة نموذج العالم PixVerse R2 مسار الطلب للتجربة المبكرة والوصول إلى API.
موارد ذات صلة
- شرح PixVerse R1: نموذج عالم فيديو بالذكاء الاصطناعي في الوقت الفعلي
- تعمّق في محرك ألعاب PixVerse
- يحدّث PixVerse نموذج R1 بعوالم مشتركة
- دليل توليد فيديو بالذكاء الاصطناعي في الوقت الفعلي
- يغلق PixVerse تمديد الجولة C
العوالم الواردة في إعلان 22 سبتمبر 2026 مفتوحة للاستكشاف على world.pixverse.video. وما زال الوصول إلى API يُطلب عبر النموذج أعلاه. ويمكنك أيضًا الإبداع باستخدام PixVerse V6 وR1 اليوم.