PixVerse R2: Escalando Modelos de Mundo Omni em Tempo Real
O PixVerse R1 introduziu e lançou o primeiro modelo de mundo de vídeo em tempo real, transformando a geração de vídeo de uma entrega estática de um clipe fixo em um mundo continuamente em execução. O modelo é capaz de receber comandos do usuário ininterruptamente, atualizar o estado do mundo em tempo real e transmitir áudio e vídeo sincronizados que mantêm consistência absoluta com a interação. O R1 provou a viabilidade prática desse paradigma técnico.
O PixVerse R2 responde à questão seguinte: como continuar escalando um modelo de mundo de vídeo em tempo real. O R2 foca em dois objetivos centrais. Primeiro, constrói um mundo dinâmico capaz de sustentar um estado unificado em horizontes longos, convertendo priors espaço-temporais completos em uma evolução de mundo estritamente causal. Segundo, internaliza continuamente causalidade física e sinais de interação a partir de texto, referências visuais, áudio e ações em um único modelo integrado, permitindo gerar, receber controle e atualizar o estado simultaneamente enquanto transmite áudio e vídeo sincronizados.
Com base nesses objetivos, o R2 converte o crescimento de modelos, dados, tarefas, sinais de controle e horizontes temporais em saltos de qualidade de geração, consistência de longo alcance e controle multimodal preciso.
Estrutura Geral
O R2 sintetiza o sistema em duas camadas essenciais: Omni Causal AR e Aceleração em Tempo Real. O Omni Causal AR expande continuamente a geração de mundos multimodais e de longo horizonte em alta fidelidade. A Aceleração em Tempo Real herda essas capacidades da forma mais fiel possível sob um orçamento rigoroso de latência de interação. O caminho é claro: elevar o teto de capacidades do modelo de mundo e, em seguida, acelerar essa capacidade para um regime operacional interativo em tempo real.
Pipelines anteriores de vídeo longo e tempo real costumavam encadear múltiplos estágios de treinamento: converter um modelo bidirecional em um modelo AR, construir um professor de destilação a partir de um modelo bidirecional específico para a tarefa, executar destilação DMD e adicionar DMD de autorrolagem para mitigar o desvio entre treino e inferência. Cada etapa exigia migrar capacidades, realinhar objetivos e reajustar distribuições de dados. Qualidade visual, movimento, fidelidade às condições e estabilidade de longo prazo podiam se deteriorar nessas transferências. Conforme o volume de dados e tarefas aumentava, o pipeline multiestágio fragmentava o objetivo de otimização e elevava os custos e a complexidade do sistema.
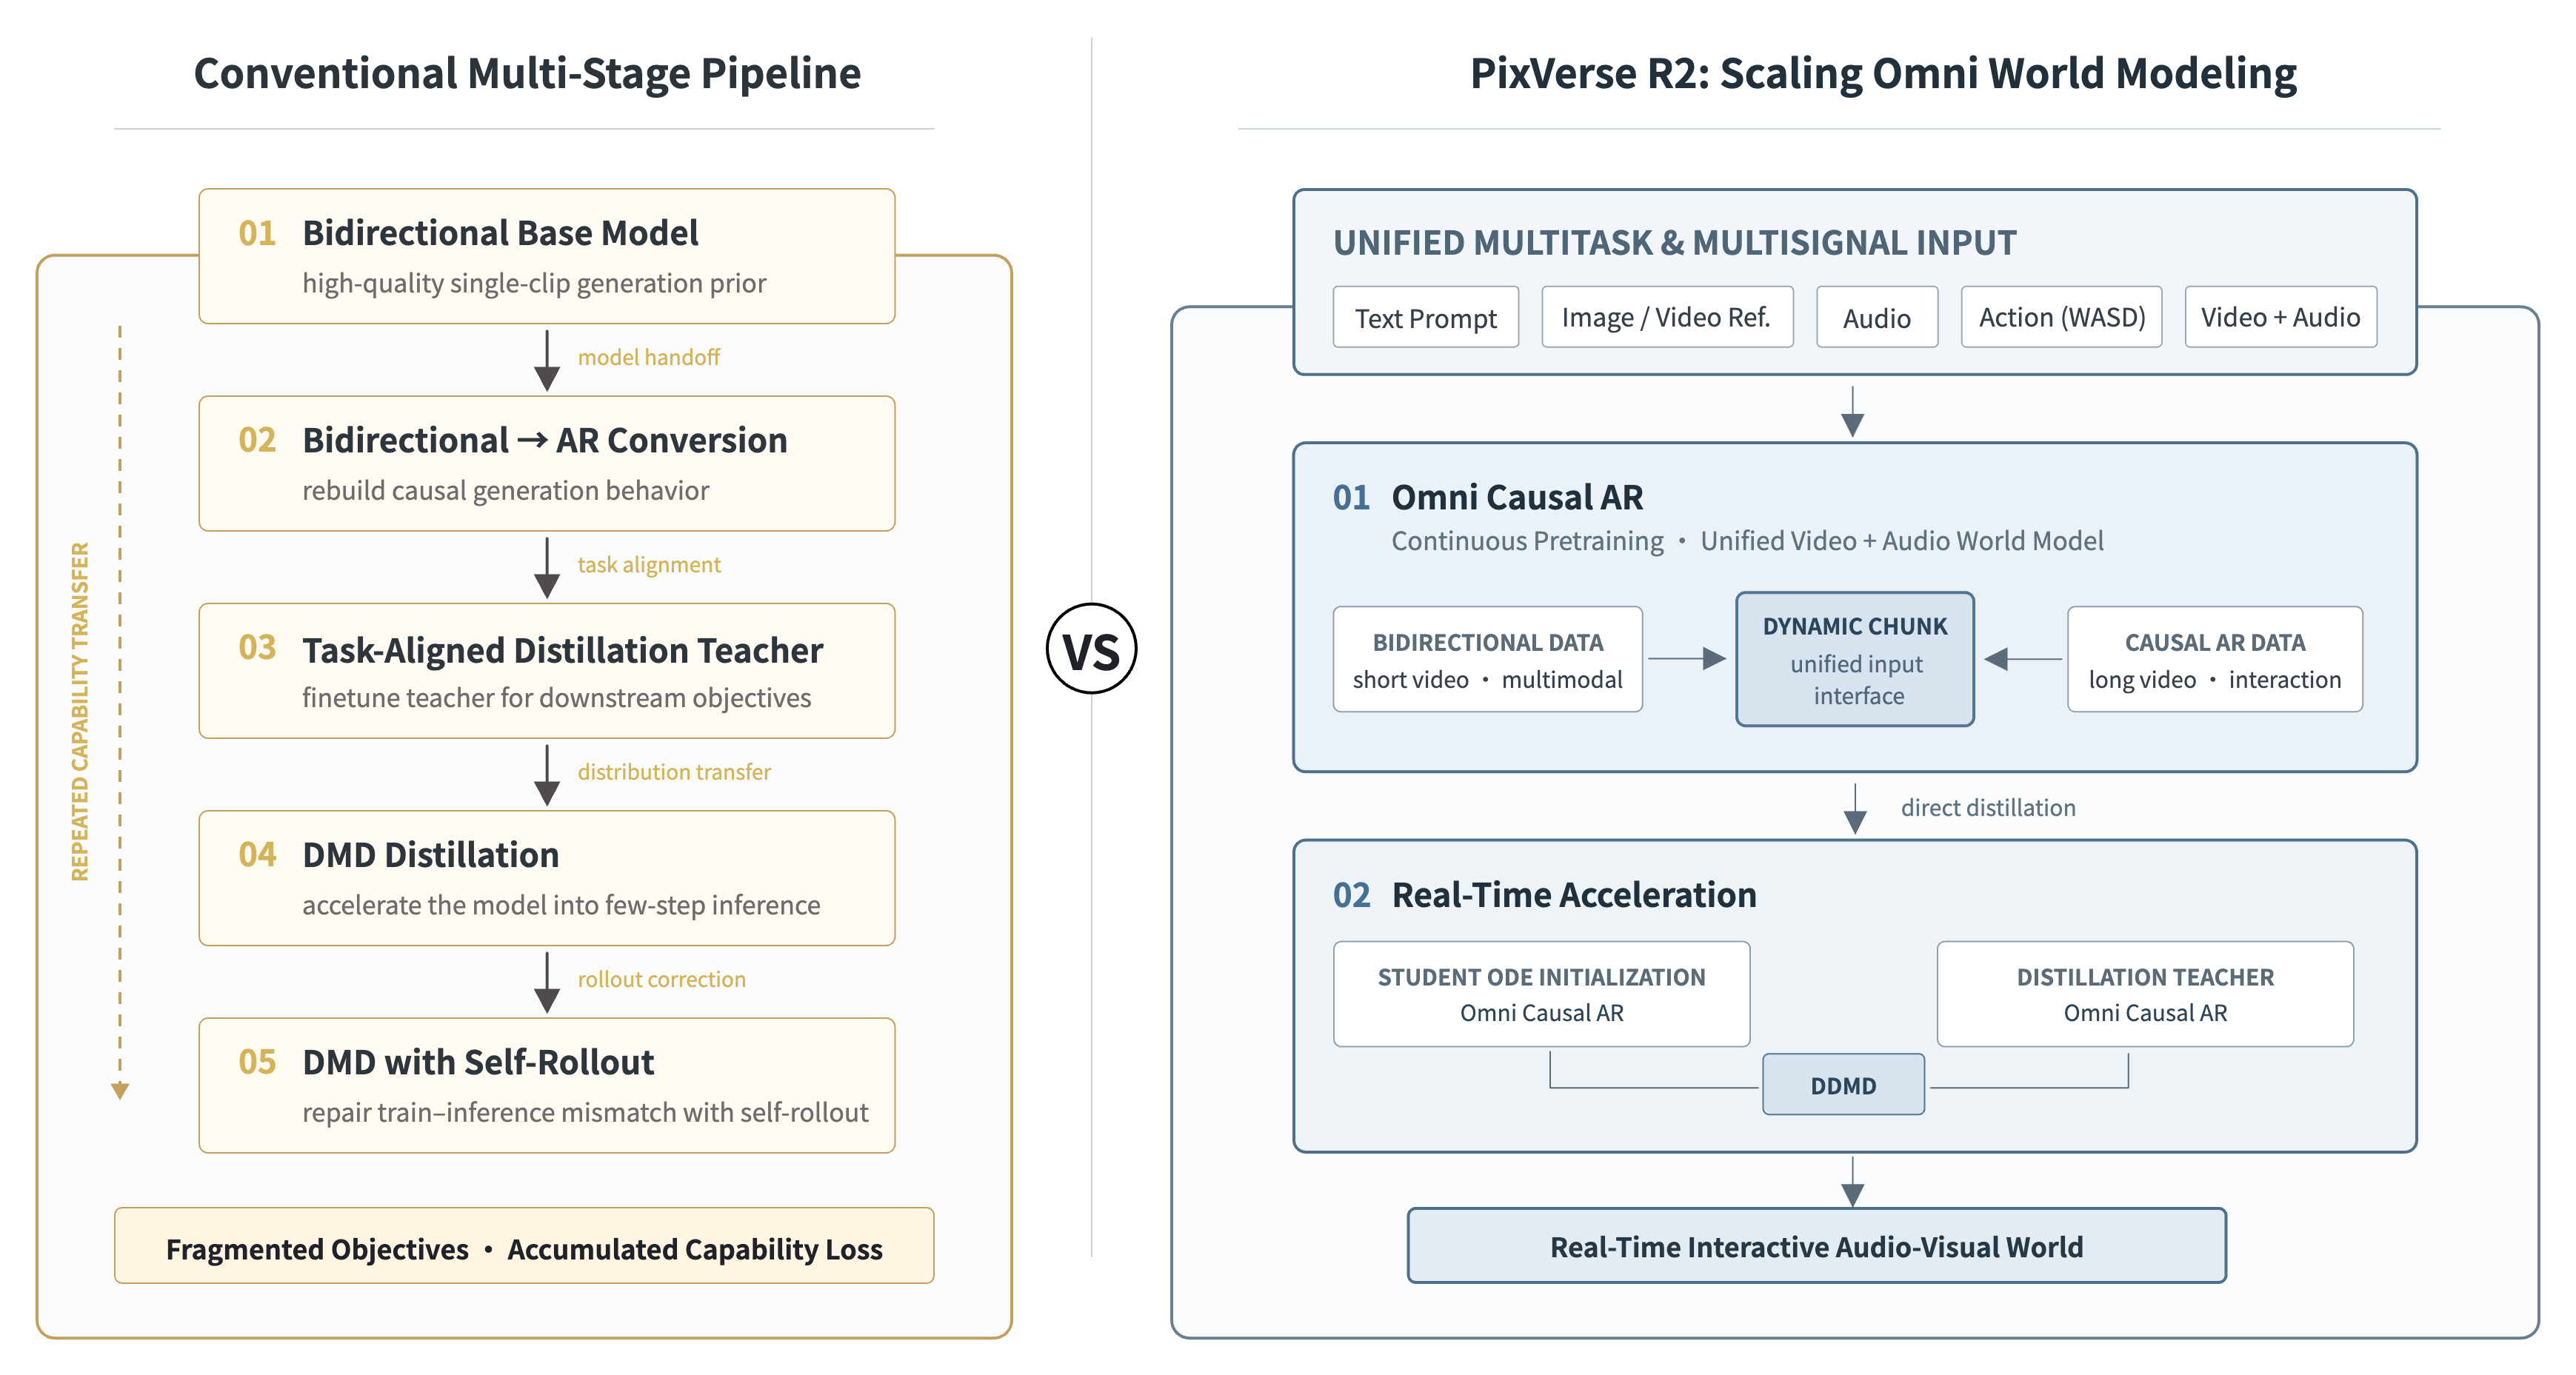
Figura 1. Pipeline tradicional multiestágio versus modelagem de mundo escalável do PixVerse R2. O R2 converge a expansão de capacidades e a destilação em tempo real no Omni Causal AR e em uma camada de aceleração em tempo real, unificando modelagem multitarefa, multissinal e de vídeo longo em um único framework.
O PixVerse R2 propõe um paradigma de treinamento unificado para modelos de mundo em tempo real. Em vez de migrar capacidades repetidamente através de múltiplos modelos e estágios, ele reduz o pipeline a dois processos escaláveis: pré-treinar continuamente um Omni Causal AR que sustenta um estado de mundo unificado e, a partir dele, destilar diretamente um modelo acelerado capaz de gerar em tempo real, preservando a coerência espacial e a modelagem de longo horizonte.
Menos barreiras entre etapas diminuem a perda de capacidades decorrente de professores independentes e transferências repetidas. Novos dados, tarefas, sinais de controle e escalas de parâmetros convertem-se diretamente em poder de modelagem de mundo em tempo real.
Estágio 1: pré-treinamento contínuo do Omni Causal AR. O R2 deixa de tratar priors bidirecionais e modelos AR de vídeo longo como fases desconectadas. Ele treina continuamente um Omni Causal AR unificado sobre a capacidade de modelos bidirecionais. Chunks dinâmicos conferem a diferentes formatos de dados uma representação temporal compartilhada: o modelo absorve vídeos curtos de alta qualidade e dados multimodais do pré-treinamento bidirecional, expandindo-se naturalmente para vídeos longos e trajetórias de interação contínuas. Qualidade de imagem, expressão audiovisual, geração de longo prazo e controle multissinal escalam dentro de um único modelo.
Estágio 2: destilação de uma camada de aceleração em tempo real a partir do Omni Causal AR. O pré-treinamento contínuo concede ao Omni Causal AR alta qualidade, transferência de estado estável e evolução verdadeiramente causal. O R2 utiliza esse mesmo Omni Causal AR tanto para a inicialização da EDO do modelo estudante quanto como professor de destilação. Assim, professor, estudante e inferência AR real compartilham a mesma base causal. A destilação em tempo real torna-se uma “aceleração em poucos passos de um modelo de mundo já existente”, e não o “reaprendizado de um mundo de longo horizonte”.
Omni Causal AR
O R2 dá continuidade ao caminho de entradas multimodais, geração autorregressiva e interação em tempo real validado pelo R1, concentrando tudo em uma rota unificada de treinamento Omni Causal AR. O Omni Causal AR converte priors espaço-temporais completos em transferência de estado de mundo puramente temporal. Por meio da causalização e do pré-treinamento contínuo, o modelo preserva qualidade de imagem, movimento, áudio e semântica multimodal enquanto aprende a prever o próximo bloco audiovisual sincronizado unicamente a partir do histórico anterior.
À medida que os objetos de treinamento evoluem de clipes isolados para vídeos contínuos de longa duração e trajetórias de interação com múltiplas etapas, o modelo consolida a causalidade temporal entre o estado histórico do mundo, os comandos atuais e a evolução futura do ambiente.
O modelo recebe conjuntamente prompts de texto, referências multimodais, comandos de ação (como teclas WASD ou controles analógicos contínuos) e áudio, gerando simultaneamente áudio e vídeo sincronizados. Diferentes sinais de controle podem intervir dinamicamente durante a execução e modular o estado futuro do mundo. O R2 não se limita a responder a um comando estático: ele gera, assimila controles e atualiza o mundo de forma simultânea.
Para manter a geração causal dentro do mesmo mundo durante longos períodos, o R2 resolve quatro desafios: o desvio de distribuição entre treino e inferência, a robustez a históricos com ruído, a coordenação de memórias recentes e de longo prazo e a autocorreção de estados imperfeitos. O método Hybrid Teacher / Diffusion Forcing permite que o modelo se adapte tanto a históricos perfeitos quanto ruidosos. O sistema Multi-Timescale Memory armazena âncoras globais, dinâmicas recentes e estados de objetos. O Error Bank reinjeta falhas no ciclo de aprendizado. Juntos, esses elementos formam um ciclo robusto de preservação do estado do mundo, mitigando desvios visuais, distorções de personagens, instabilidades de movimento e falhas de resposta aos comandos.
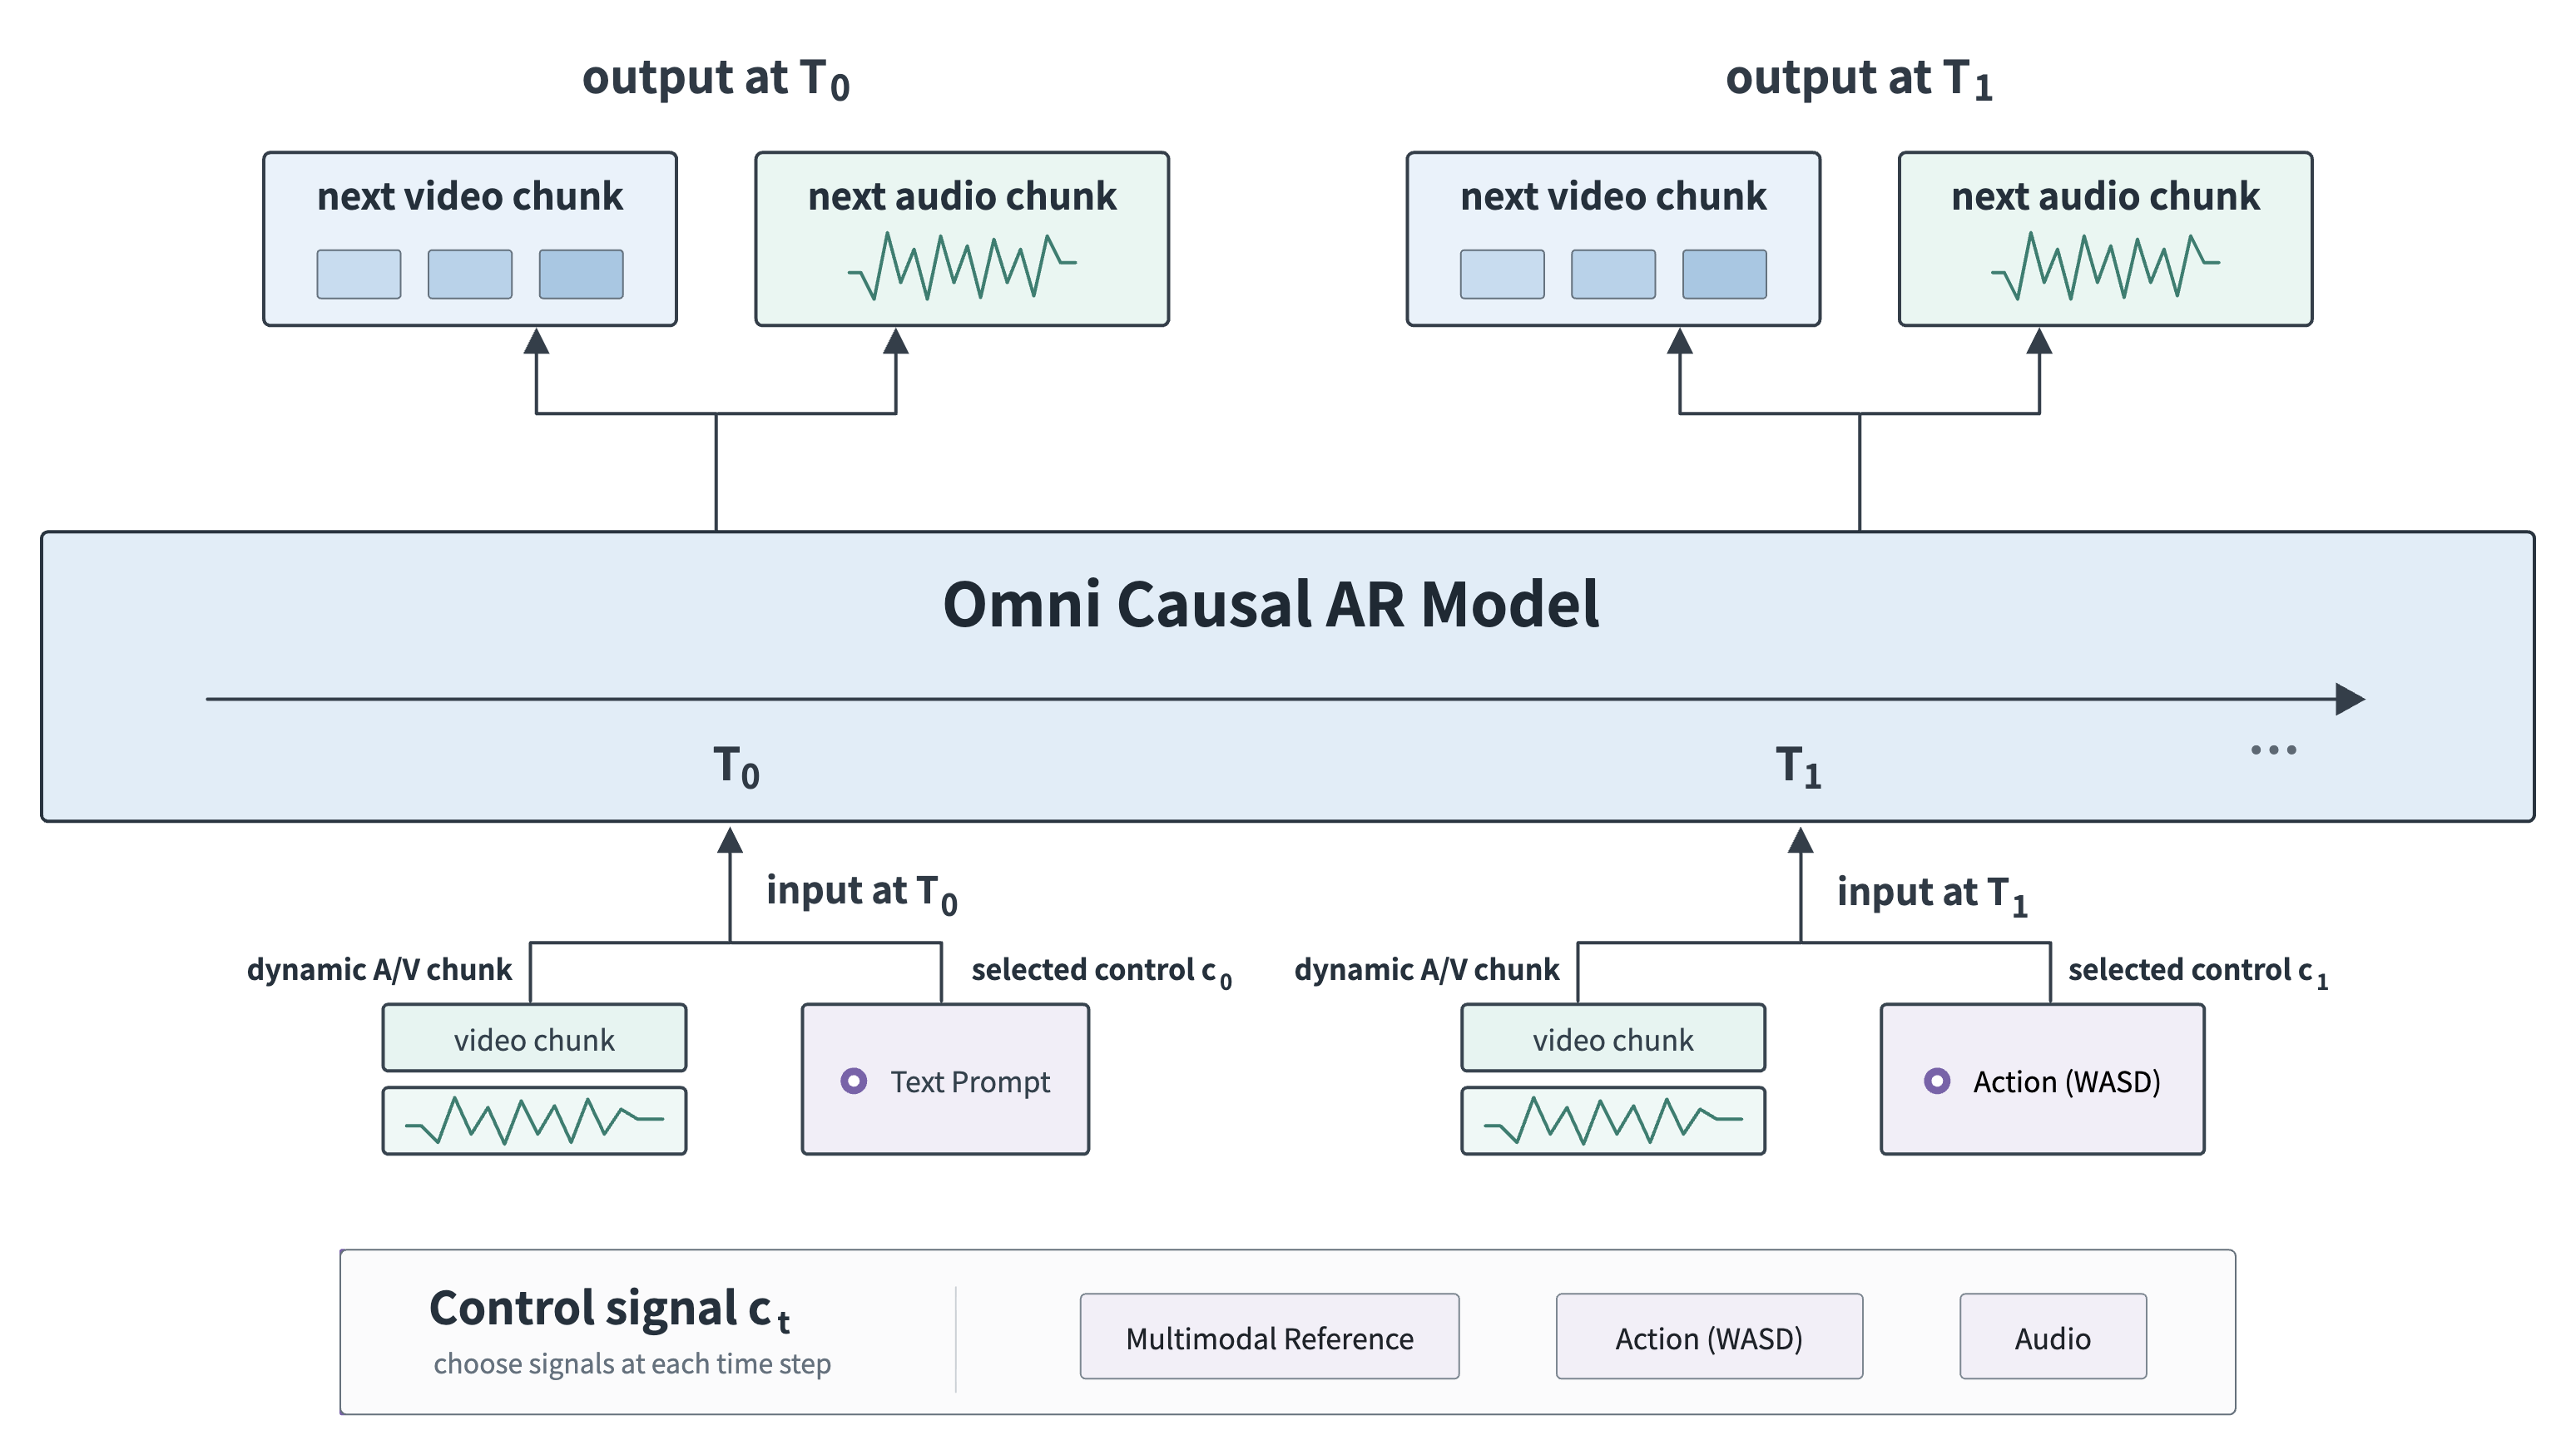
Figura 2. PixVerse R2 Omni Causal AR. O modelo pode receber continuamente diferentes sinais de controle ao longo da execução. Em cada instante de interação, o comando ativo alinha-se a um bloco audiovisual dinâmico na granularidade correspondente e orienta o segmento seguinte de vídeo e áudio.
Geração por blocos dinâmicos (Dynamic Chunks)
Diferentes sinais de controle operam em escalas temporais distintas. Prompts e referências costumam descrever eventos semânticos mais longos. Ações de controle (WASD) exigem retorno sensorial imediato e detalhado. O áudio transporta semântica, ritmo e sincronia temporal ao mesmo tempo. Caso todas as entradas fossem forçadas a uma duração fixa, o modelo teria de sacrificar velocidade de resposta em favor da integridade expressiva.
O Dynamic Chunk é o mecanismo pelo qual o R2 unifica essas escalas temporais. O modelo divide sequências audiovisuais de forma adaptativa, orientando-se pelos limites semânticos e pela duração do sinal de controle ativo, sob um tamanho máximo de bloco que garante estabilidade de treinamento. Chunks curtos elevam a agilidade de resposta para ações de comando imediatas. Chunks longos resguardam a coerência de eventos complexos, movimentos amplos e nuances sonoras. Tarefas diversas passam a compartilhar uma interface causal unificada sem alterações estruturais no modelo.
Hybrid Teacher Forcing / Diffusion Forcing
A tensão fundamental no aprendizado AR de longo horizonte decorre do fato de que os dados de treino são limpos, enquanto o histórico em tempo de execução acumula ruídos próprios do modelo e pequenas falhas locais. Treinar apenas com dados limpos maximiza o teto qualitativo de passos isolados, mas torna o sistema excessivamente frágil a pequenos desvios. Treinar unicamente com históricos degradados compromete a qualidade plástica, a dinâmica dos movimentos e a fidelidade aos comandos.
O R2 combina históricos puros e ruidosos em um único fluxo de treinamento. O histórico limpo ancora o teto de qualidade da evolução do mundo. O histórico com ruído condiciona o modelo a tolerar e contornar imperfeições que encontrará em ambiente de produção. Esse treinamento complementar reduz a distância entre treino e inferência, capacitando o sistema a gerar o próximo segmento com alta fidelidade mesmo quando o histórico recente contém imprecisões.
A Causal Attention Mask e o Relative Temporal RoPE regulam conjuntamente quais dados passados podem ser acessados e sua localização na janela ativa. A máscara de atenção garante visibilidade estritamente causal. O RoPE temporal não cresce infinitamente com o identificador global de blocos; ele é reindexado por slots relativos dentro da janela de atenção corrente. Conforme a janela avança, o tempo real progride continuamente, mas a memória de ancoragem, o histórico recente e o chunk atual permanecem mapeados em uma faixa estável de posições relativas.
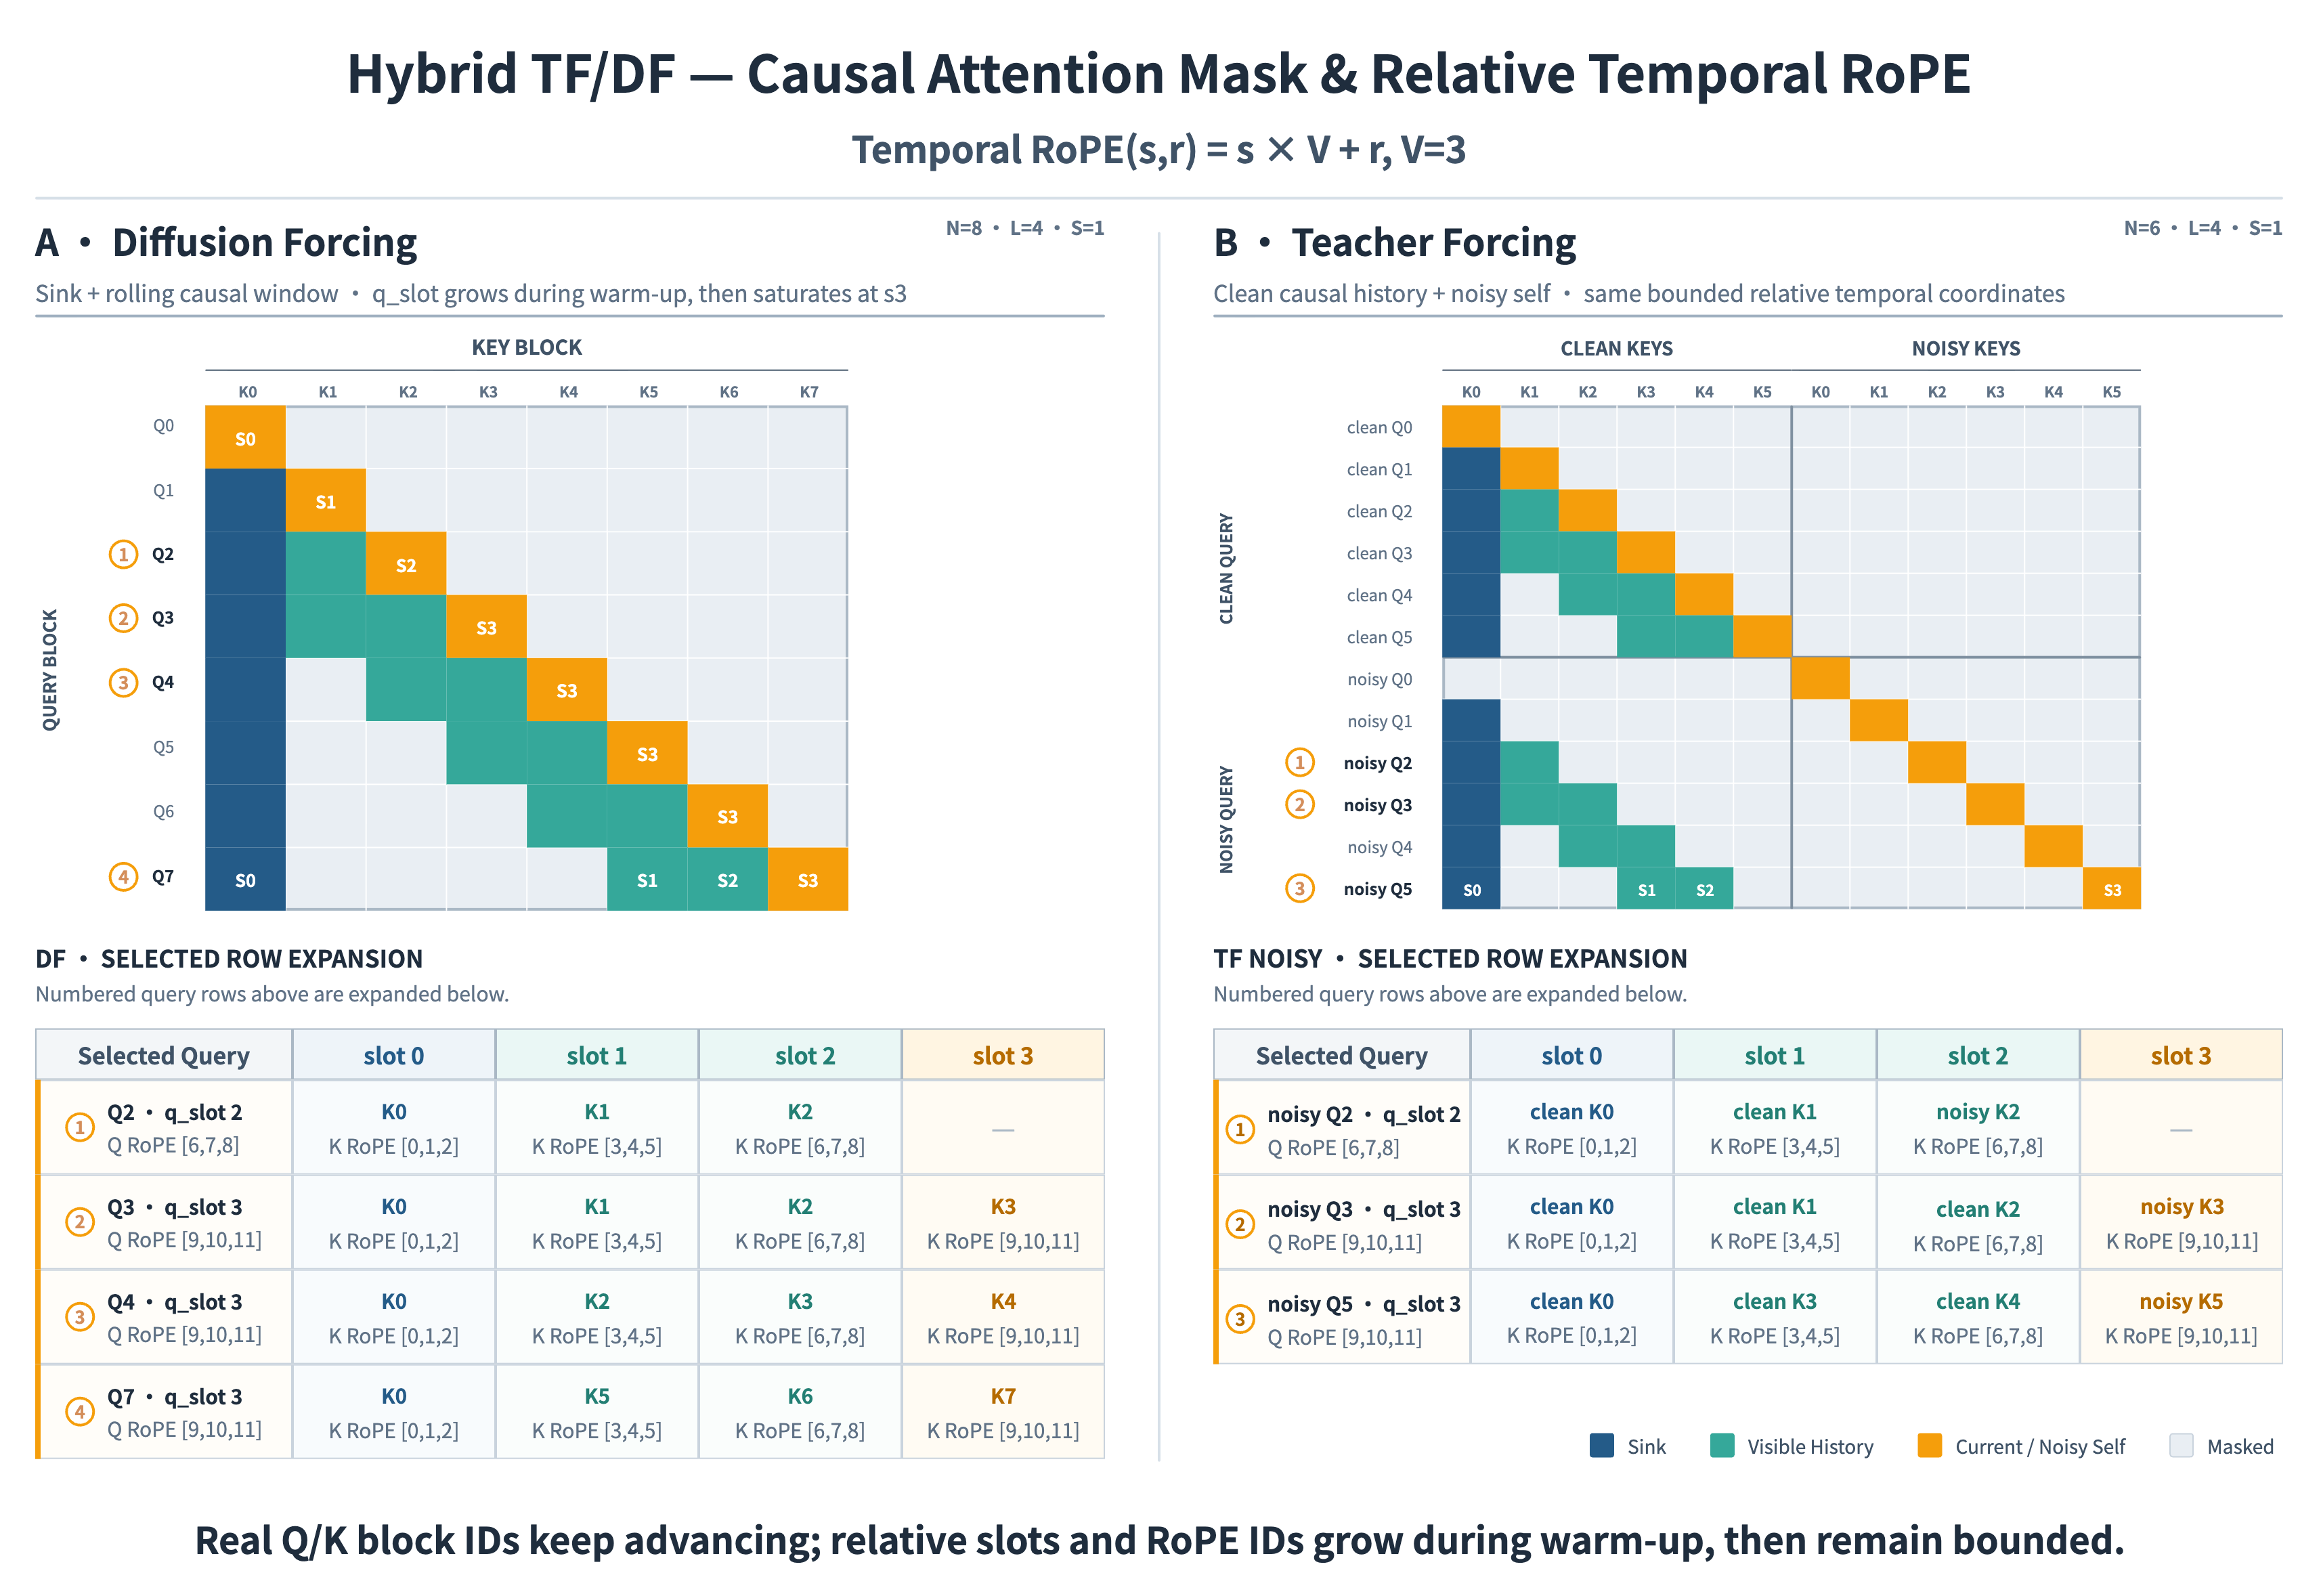
Figura 3. Máscara de atenção causal unificada e RoPE temporal relativo para Hybrid Teacher / Diffusion Forcing. A parte superior ilustra a visibilidade causal nas duas configurações de histórico. A parte inferior mapeia consultas representativas para blocos Q/K, slots relativos e IDs de RoPE, demonstrando que os índices de bloco reais progridem enquanto as coordenadas internas da janela permanecem delimitadas.
Memória multiescala (Multi-timescale memory)
Modelar mundos em longos períodos não pode significar armazenar todo o histórico indefinidamente. Reter dados sem limites sobrecarrega rapidamente a computação e a memória; podar dados em excesso elimina a identidade dos personagens, a ambientação e eventos fundamentais. O R2 implementa um sistema de memória em múltiplos níveis composto por Sink Memory, Rolling History e Object KV Cache.
- Sink Memory: preserva âncoras permanentes, como traços de personagens, cenários-chave, identidade estética e regras do mundo.
- Rolling History: foca em movimentos recentes, poses, ângulos de câmera e dinâmicas ambientais para que as transições locais ocorram com naturalidade.
- Object KV Cache: reaproveita e compacta representações pré-computadas no nível dos objetos, mantendo ativos apenas os estados que influenciarão a evolução posterior dentro de um orçamento rígido de recursos.
A combinação desses três mecanismos assegura estabilidade de identidade a longo prazo, fluidez nos movimentos imediatos e custo operacional controlado, reduzindo inconsistências em personagens, saltos de cenário e cintilações entre blocos.
Error Bank
Desvios graves em modelos autorregressivos de mundo frequentemente nascem de um erro sutil introduzido no histórico e subsequentemente amplificado. O R2 implementa um Error Bank que cataloga falhas representativas como amostras reutilizáveis e as reinsere deliberadamente no histórico durante o treino em taxas programadas. O modelo aprende não apenas a dar continuidade a estados ideais, mas também a identificar, absorver e corrigir um histórico que começou a se desviar.
Em avaliações graduais, a métrica de desvio de luminosidade a longo prazo caiu de 0,201 para 0,129, uma redução de aproximadamente 35,8%. De 29 amostras de sequências longas, 20 apresentaram melhorias notáveis, e todas as 5 amostras destinadas a manter imobilidade eliminaram artefatos indesejados de movimento.
Aceleração em Tempo Real
A aceleração em tempo real do R2 não tenta ensinar um mundo de longo alcance a partir do zero a um modelo de poucos passos. Ela acelera um modelo de mundo que já opera com estabilidade comprovada ao longo do tempo. A camada de aceleração tem como base o Omni Causal AR pré-treinado e o utiliza tanto para a inicialização da EDO quanto como professor de destilação, garantindo que professor, estudante e inferência real compartilhem uma trajetória causal unificada.
Esse ponto de partida unificado diminui a dependência de ajustes como Self-Forcing e Rolling Forcing. A aceleração em tempo real pode focar nos desafios que o regime de poucos passos efetivamente introduz: DDMD com regularização adversarial equilibra aderência a condições, distribuição de geração e realismo visual durante a destilação; atenção em blocos esparsos otimiza o processamento de contextos longos; e uma arquitetura em pirâmide barateia a geração em alta resolução.
DDMD com regularização adversarial
Na geração em pouquíssimos passos, alinhamento de condições, correspondência de distribuição e fotorrealismo configuram desafios de otimização distintos. O R2 baseia-se no DDMD e incorpora a regularização adversarial do DMD2. Três sinais convergem no modelo estudante: o alinhamento de condições aprimora o controle, a correspondência de distribuição retém a capacidade do professor e a regularização adversarial ancora os dados na realidade. Assim, poucos passos de amostragem bastam para assegurar respostas rápidas e um universo convincente.
Atenção em blocos esparsos (Block-sparse attention)
O R2 aplica atenção esparsa em blocos sobre sequências de tokens espaço-temporais. O modelo divide as matrizes Q, K e V em blocos de cálculo, estima prontamente quais blocos de chaves e valores são vitais para cada consulta, preserva somente os caminhos de maior relevância e processa a atenção softmax exata sobre esse subconjunto. Esse roteamento em nível de blocos não é uma poda aleatória: ele direciona o poder computacional para as fortes correlações entre os comandos multimodais atuais, os movimentos recentes e os estados centrais do mundo.
Adaptando o modelo a essa arquitetura esparsa durante o treino, o R2 atinge uma esparsidade de atenção superior a 90%, preservando fidelidade visual, fluidez de movimentos, obediência a comandos e estabilidade temporal sem perdas perceptíveis nas avaliações correntes.
Destilação piramidal em pouquíssimos passos
Construir toda a modelagem de mundo do zero no espaço de alta resolução desperdiça capacidade computacional com estruturas amplas que resoluções menores conseguem definir com facilidade. O R2 estrutura a geração em uma ou duas etapas de baixa resolução seguidas por uma etapa de alta resolução. As fases iniciais delimitam a composição da cena, os movimentos principais e a trajetória da câmera. A fase final reconstitui texturas, bordas e minúcias visuais. Essa transição do macro para o micro corta redundâncias computacionais e fortalece a solidez geométrica do ambiente.
Conclusões e Limitações
O PixVerse R1 concebeu e disponibilizou o primeiro modelo de mundo de vídeo em tempo real, provando que o vídeo gerado por IA pode transitar de um arquivo pré-renderizado para um universo dinâmico, interativo e contínuo. O PixVerse R2 soluciona a escala desse paradigma: um Omni Causal AR unificado abriga volumes crescentes de dados, tarefas, modalidades e tempos, enquanto a Aceleração em Tempo Real converte todo esse potencial em inferências de poucos passos em tempo real.
O R2 não representa uma melhoria isolada em parâmetros pontuais; é um roteiro unificado de treinamento para a próxima geração de modelos de mundo. O R1 tornou reais os modelos de mundo em tempo real; o R2 eleva-os a uma fase unificada, escalável e de aprimoramento ininterrupto.
Sob restrições severas de latência de interação e capacidade computacional instantânea, a qualidade de gerações isoladas ainda tem margem para amadurecer frente aos principais modelos de vídeo offline, sobretudo na riqueza de detalhes finos, na espontaneidade dos movimentos, na coerência física estrita e na estabilidade em trajetórias extremamente extensas. Tais desafios refletem o estágio atual de escala do R2, e não um limite intransponível de sua arquitetura.
Acesso Antecipado
Em 23 de agosto de 2026, este relatório descrevia o PixVerse R2 como um teste fechado. Em 22 de setembro de 2026, a PixVerse anunciou que uma coleção desses mundos está aberta para exploração em world.pixverse.video. Veja o anúncio de lançamento do R2.
Esse anúncio não abre acesso irrestrito à API. O formulário de experiência do modelo de mundo PixVerse R2 continua sendo a via de solicitação para a experiência antecipada e as credenciais de API.
Recursos Relacionados
- Entenda o PixVerse R1: Modelo de Mundo de Vídeo AI em Tempo Real
- Análise Aprofundada do PixVerse Game Engine
- PixVerse Atualiza R1 com Mundos Compartilhados
- Guia de Geração de Vídeo AI em Tempo Real
- PixVerse Conclui Extensão da Série C e Anuncia Expansão
Os mundos do anúncio de 22 de setembro de 2026 estão abertos para exploração em world.pixverse.video. O acesso à API continua sendo solicitado pelo formulário acima. Você também pode criar hoje com PixVerse V6 e R1.