PixVerse R2: Skalowanie modeli świata Omni w czasie rzeczywistym
PixVerse R1 wprowadził i wdrożył pierwszy w branży model świata wideo w czasie rzeczywistym, przekształcając generowanie wideo z jednorazowego renderowania statycznego klipu w nieprzerwanie działający, dynamiczny świat. Model ten potrafi na bieżąco przetwarzać sygnały od użytkownika, natychmiast aktualizować stan uniwersum i przesyłać zsynchronizowany strumień obrazu i dźwięku, w pełni spójny z podejmowanymi akcjami. Model R1 udowodnił, że ten paradygmat techniczny doskonale sprawdza się w praktyce.
PixVerse R2 odpowiada na kolejne fundamentalne pytanie: w jaki sposób efektywnie skalować model świata wideo w czasie rzeczywistym. R2 skupia się na dwóch głównych celach. Po pierwsze, tworzy dynamiczny świat zdolny do utrzymania spójnego stanu na długich horyzontach czasowych, przekształcając pełne wzorce czasoprzestrzenne w ewolucję środowiska biegnącą wyłącznie wprzód w czasie. Po drugie, integruje przyczynowość fizyczną i sygnały interakcji z tekstu, grafik referencyjnych, dźwięku i akcji gracza w ramach jednego, zunifikowanego modelu. Dzięki temu świat może równolegle generować klatki, przyjmować polecenia sterujące i aktualizować stan, nieustannie emitując zsynchronizowane audio i wideo.
Realizując te założenia, R2 przekształca wzrost skali modelu, zbiorów danych, zadań i sygnałów sterujących w bezpośredni skok jakości generowania, długofalową spójność oraz precyzję kontroli multimodalnej.
Ogólna struktura architektury
R2 upraszcza całą architekturę do dwóch kluczowych poziomów: Omni Causal AR oraz Akceleracji w czasie rzeczywistym. Omni Causal AR stale poszerza możliwości generowania wielomodalnych, trwałych światów o wysokiej wierności. Akceleracja w czasie rzeczywistym przejmuje te zdolności niemal bezstratnie, mieszcząc się w rygorystycznym budżecie opóźnień interakcji. Droga jest wytyczona jednoznacznie: podnieść maksymalny pułap możliwości modelu świata, a następnie zoptymalizować go do natychmiastowego, interaktywnego działania w czasie rzeczywistym.
Dotychczasowe potoki dla długich wideo w czasie rzeczywistym łączyły ze sobą wiele oddzielnych etapów uczenia: konwersję modelu dwukierunkowego na model AR, przygotowanie dedykowanego nauczyciela destylacji, wykonanie destylacji DMD oraz dodanie samorozwijalnego (self-rollout) DMD, by zniwelować rozbieżności między treningiem a inferencją. Na każdym kroku dochodziło do transferu parametrów, ponownego dopasowywania celów i rekonfiguracji rozkładów danych. Jakość detali, płynność ruchu, precyzja sterowania i stabilność długoterminowa mogły ulegać degradacji podczas tych kolejnych przejść. Wraz ze wzrostem skali danych i złożoności zadań wieloetapowy proces rozmywał cele optymalizacyjne, windując koszty obliczeniowe i komplikując infrastrukturę.
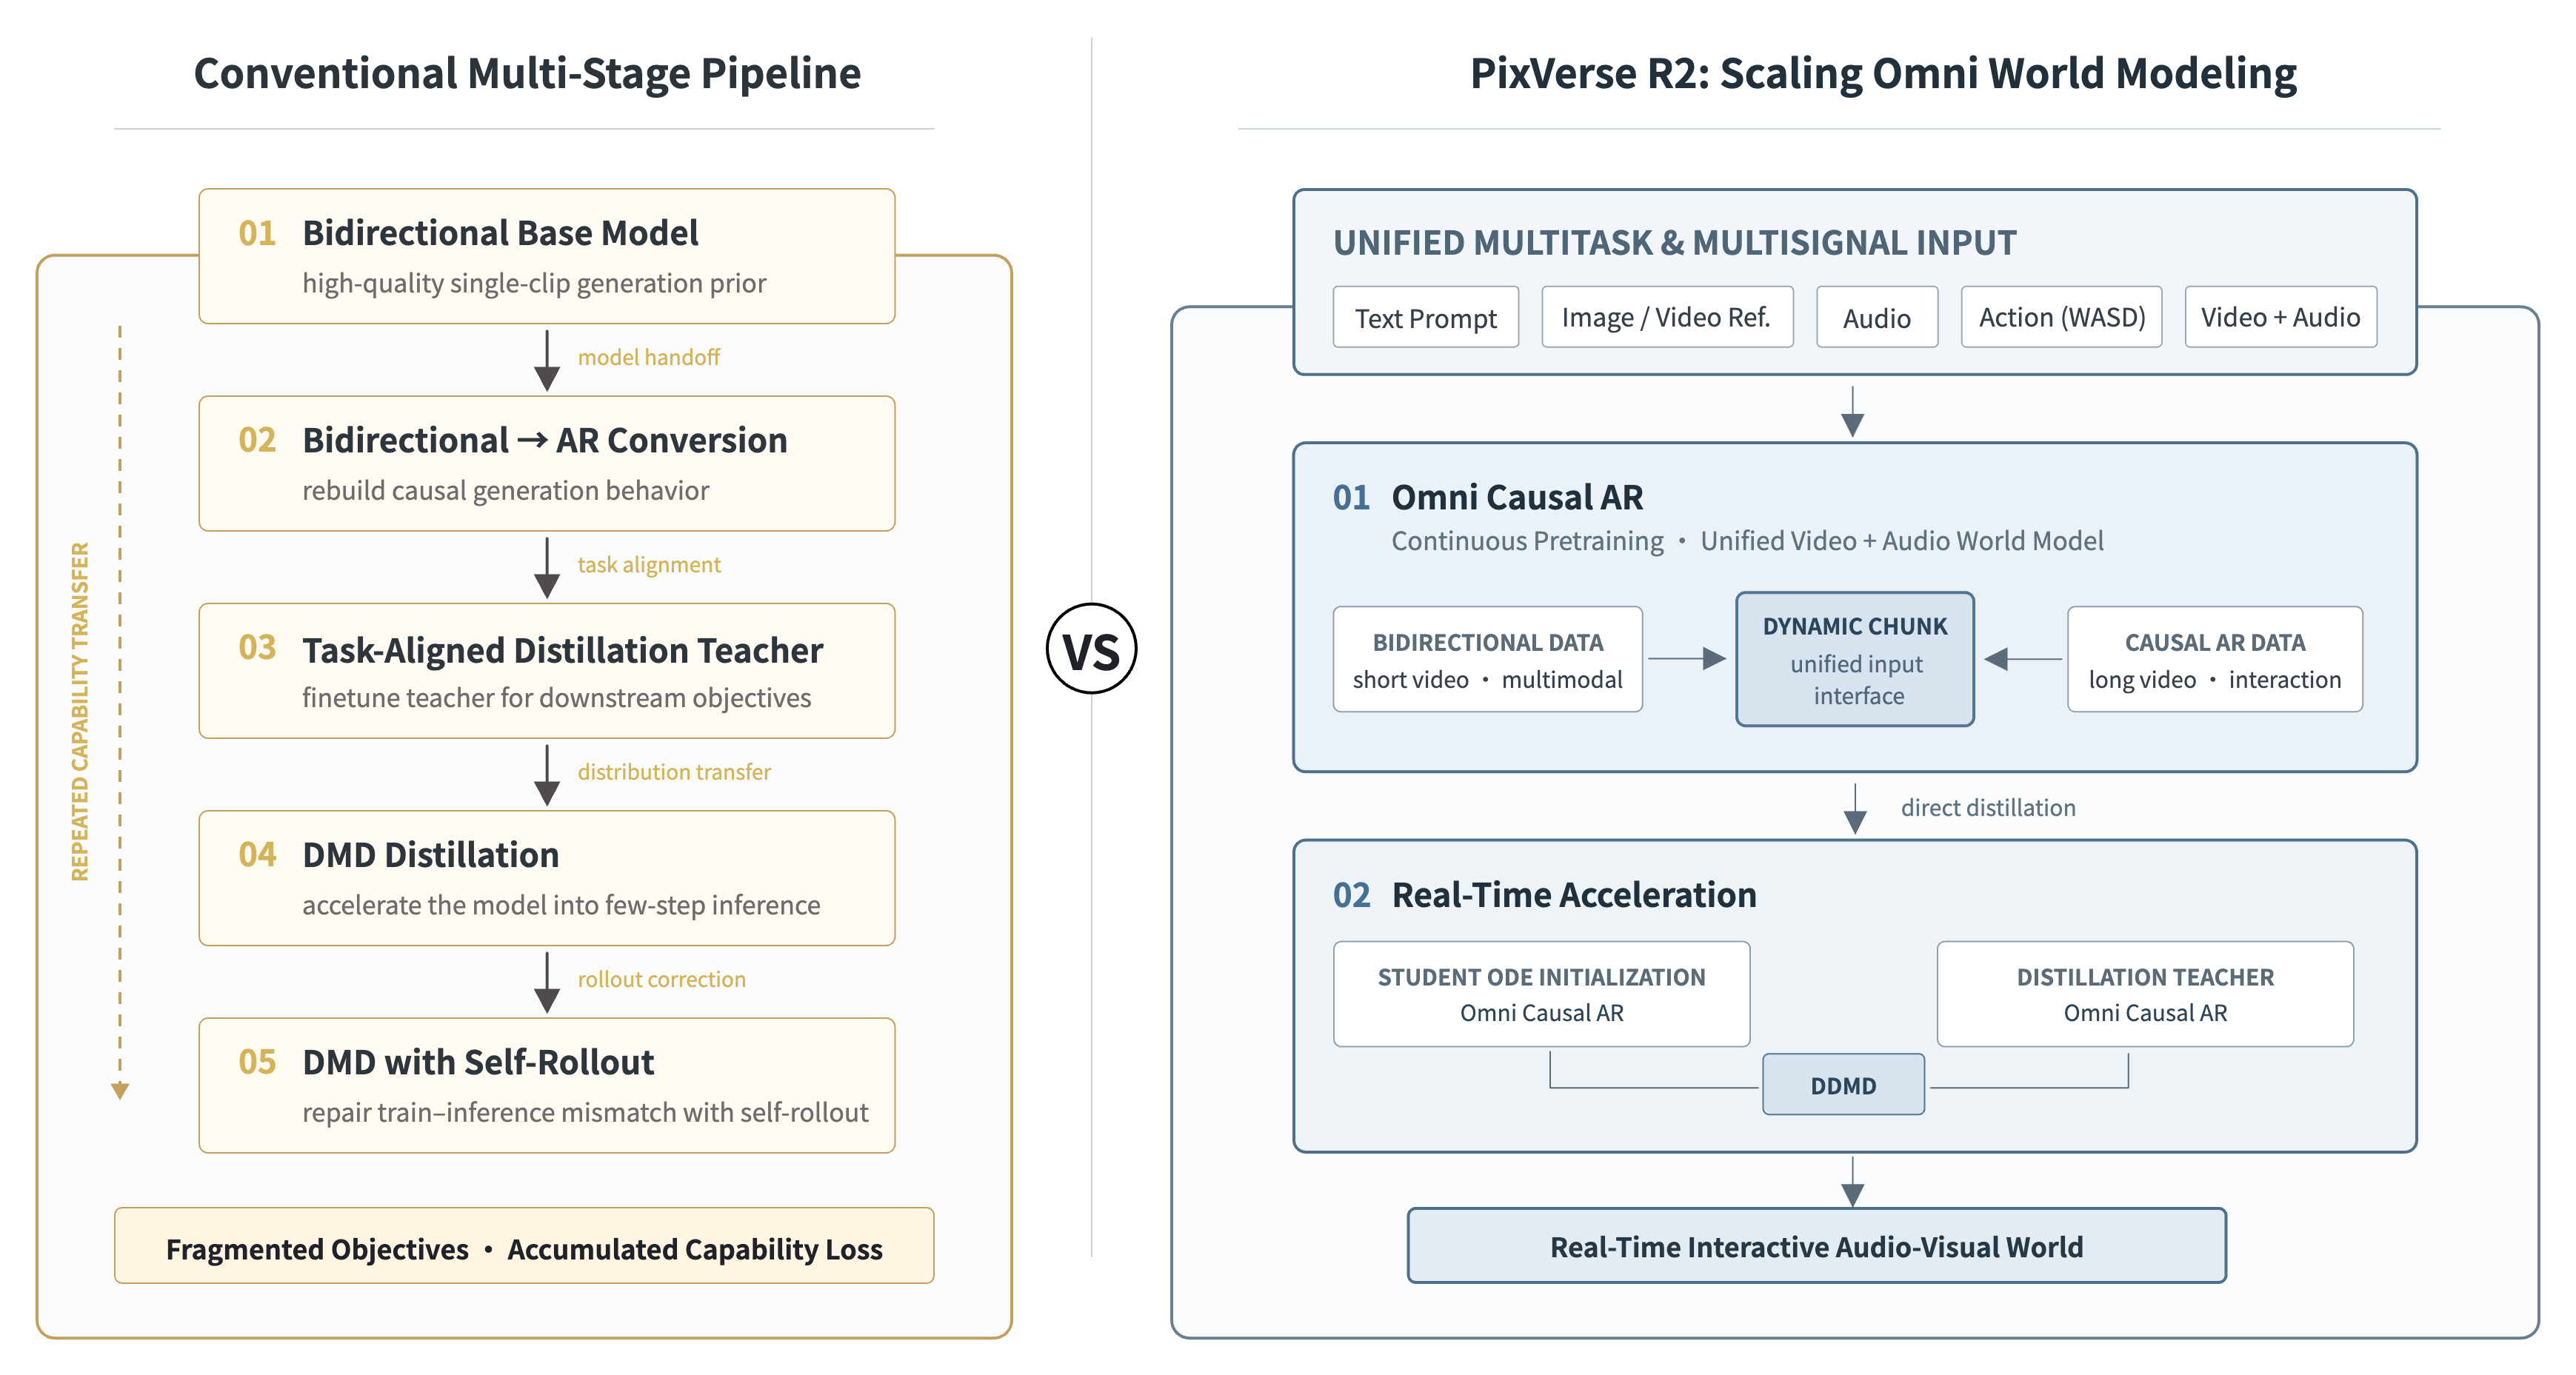
Rysunek 1. Porównanie tradycyjnego potoku wieloetapowego ze skalowalnym modelowaniem świata w PixVerse R2. R2 łączy rozwój możliwości i destylację czasu rzeczywistego w ramach Omni Causal AR oraz warstwy akceleracji, unifikując modelowanie wielozadaniowe, wielosygnałowe i generowanie długich wideo w jednej strukturze.
PixVerse R2 wprowadza spójny paradygmat treningowy dla modeli świata w czasie rzeczywistym. Zamiast mozolnego przenoszenia parametrów między wieloma modelami, złożony potok zredukowano do dwóch skalowalnych procesów: ciągłego pretreningu zunifikowanego Omni Causal AR, który utrzymuje spójny stan świata, oraz bezpośredniej destylacji do przyspieszonego modelu zdolnego do generowania w czasie rzeczywistym z zachowaniem geometrii i spójności długoterminowej.
Mniejsza liczba etapów ogranicza straty wynikające z korzystania z niezależnych nauczycieli i ciągłych konwersji modeli. Każdy nowy zestaw danych, sygnał sterujący czy zwiększenie parametrów sieci bezpośrednio przekłada się na wyższą sprawność modelu w czasie rzeczywistym.
Krok 1: Ciągły pretrening Omni Causal AR. R2 nie traktuje już dwukierunkowych modeli bazowych i długich modeli AR jako odrębnych faz. Nieustannie szkoli zunifikowany model Omni Causal AR w oparciu o bazę modeli dwukierunkowych. Dynamiczne bloki (Dynamic Chunks) nadają różnym formom danych wspólny wymiar czasowy: sieć przyswaja wysokiej jakości krótkie klipy i dane multimodalne, a następnie płynnie skaluje się do długich wideo i wieloetapowych sekwencji interakcji. Ostrość obrazu, bogactwo dźwięku, trwałość świata i obsługa wielu sygnałów rozwijają się w ramach jednego modelu.
Krok 2: Destylacja warstwy akceleracji czasu rzeczywistego ze skalowanego Omni Causal AR. Ciągły pretrening zapewnia Omni Causal AR doskonałą jakość, stabilny transfer stanów i autentyczną dynamikę przyczynową. R2 wykorzystuje dokładnie ten sam model Omni Causal AR zarówno do inicjalizacji równań ODE ucznia, jak i w roli nauczyciela destylacji. W ten sposób nauczyciel, uczeń i faktyczna inferencja AR współdzielą identyczny fundament przyczynowy. Destylacja staje się po prostu przyspieszeniem istniejącego modelu świata do kilku kroków obliczeniowych, eliminując konieczność ponownej nauki praw rządzących światem.
Omni Causal AR
R2 kontynuuje sprawdzoną w R1 ścieżkę multimodalnego wprowadzania danych, generowania autoregresyjnego i bezpośredniej interakcji, koncentrując te atuty w zunifikowanym procesie treningowym Omni Causal AR. Architektura ta przekłada czasoprzestrzenne wzorce na rozwój świata skierowany ściśle naprzód w czasie. Dzięki przyczynowości i ciągłemu pretreningowi model zachowuje jakość detali, dynamikę ruchu, wierność dźwięku i zrozumienie semantyki, ucząc się przewidywać kolejny zsynchronizowany blok audiowizualny wyłącznie na bazie dotychczasowej historii.
Gdy dane treningowe ewoluują z pojedynczych klipów w długie, nieprzerwane nagrania i złożone scenariusze interakcji, model wykształca trwałe poczucie przyczynowo-skutkowe łączące przeszły stan świata, aktualne polecenie gracza i przyszłą ewolucję otoczenia.
Model równocześnie przetwarza prompt tekstowy, referencje wizualne, komendy sterujące (np. klawisze WASD lub płynne sterowanie analogowe) oraz dźwięk, emitując zsynchronizowane wideo i audio. Rozmaite sygnały sterujące mogą nieprzerwanie wpływać do modelu w trakcie działania i modyfikować przyszły stan środowiska. R2 nie ogranicza się do jednorazowej reakcji na prompt: równolegle generuje obraz, rejestruje sterowanie i aktualizuje wirtualny świat.
Aby zagwarantować stabilność generowania w tym samym uniwersum przez długi czas, R2 eliminuje cztery kluczowe trudności: rozbieżność dystrybucji między treningiem a inferencją, odporność na zaszumioną historię, synchronizację pamięci krótko- i długoterminowej oraz korygowanie stanów błędnych. Podejście Hybrid Teacher / Diffusion Forcing pozwala modelowi radzić sobie zarówno z nieskazitelną, jak i zniekształconą historią. System Multi-Timescale Memory przechowuje stałe punkty odniesienia, bieżące ruchy i stany obiektów. Bank Błędów (Error Bank) wprowadza natomiast nieudane stany z powrotem do treningu. Razem tworzą one stabilny obieg podtrzymywania spójności świata, redukując zniekształcenia postaci, skoki scenerii i opóźnienia w reakcji na sterowanie.
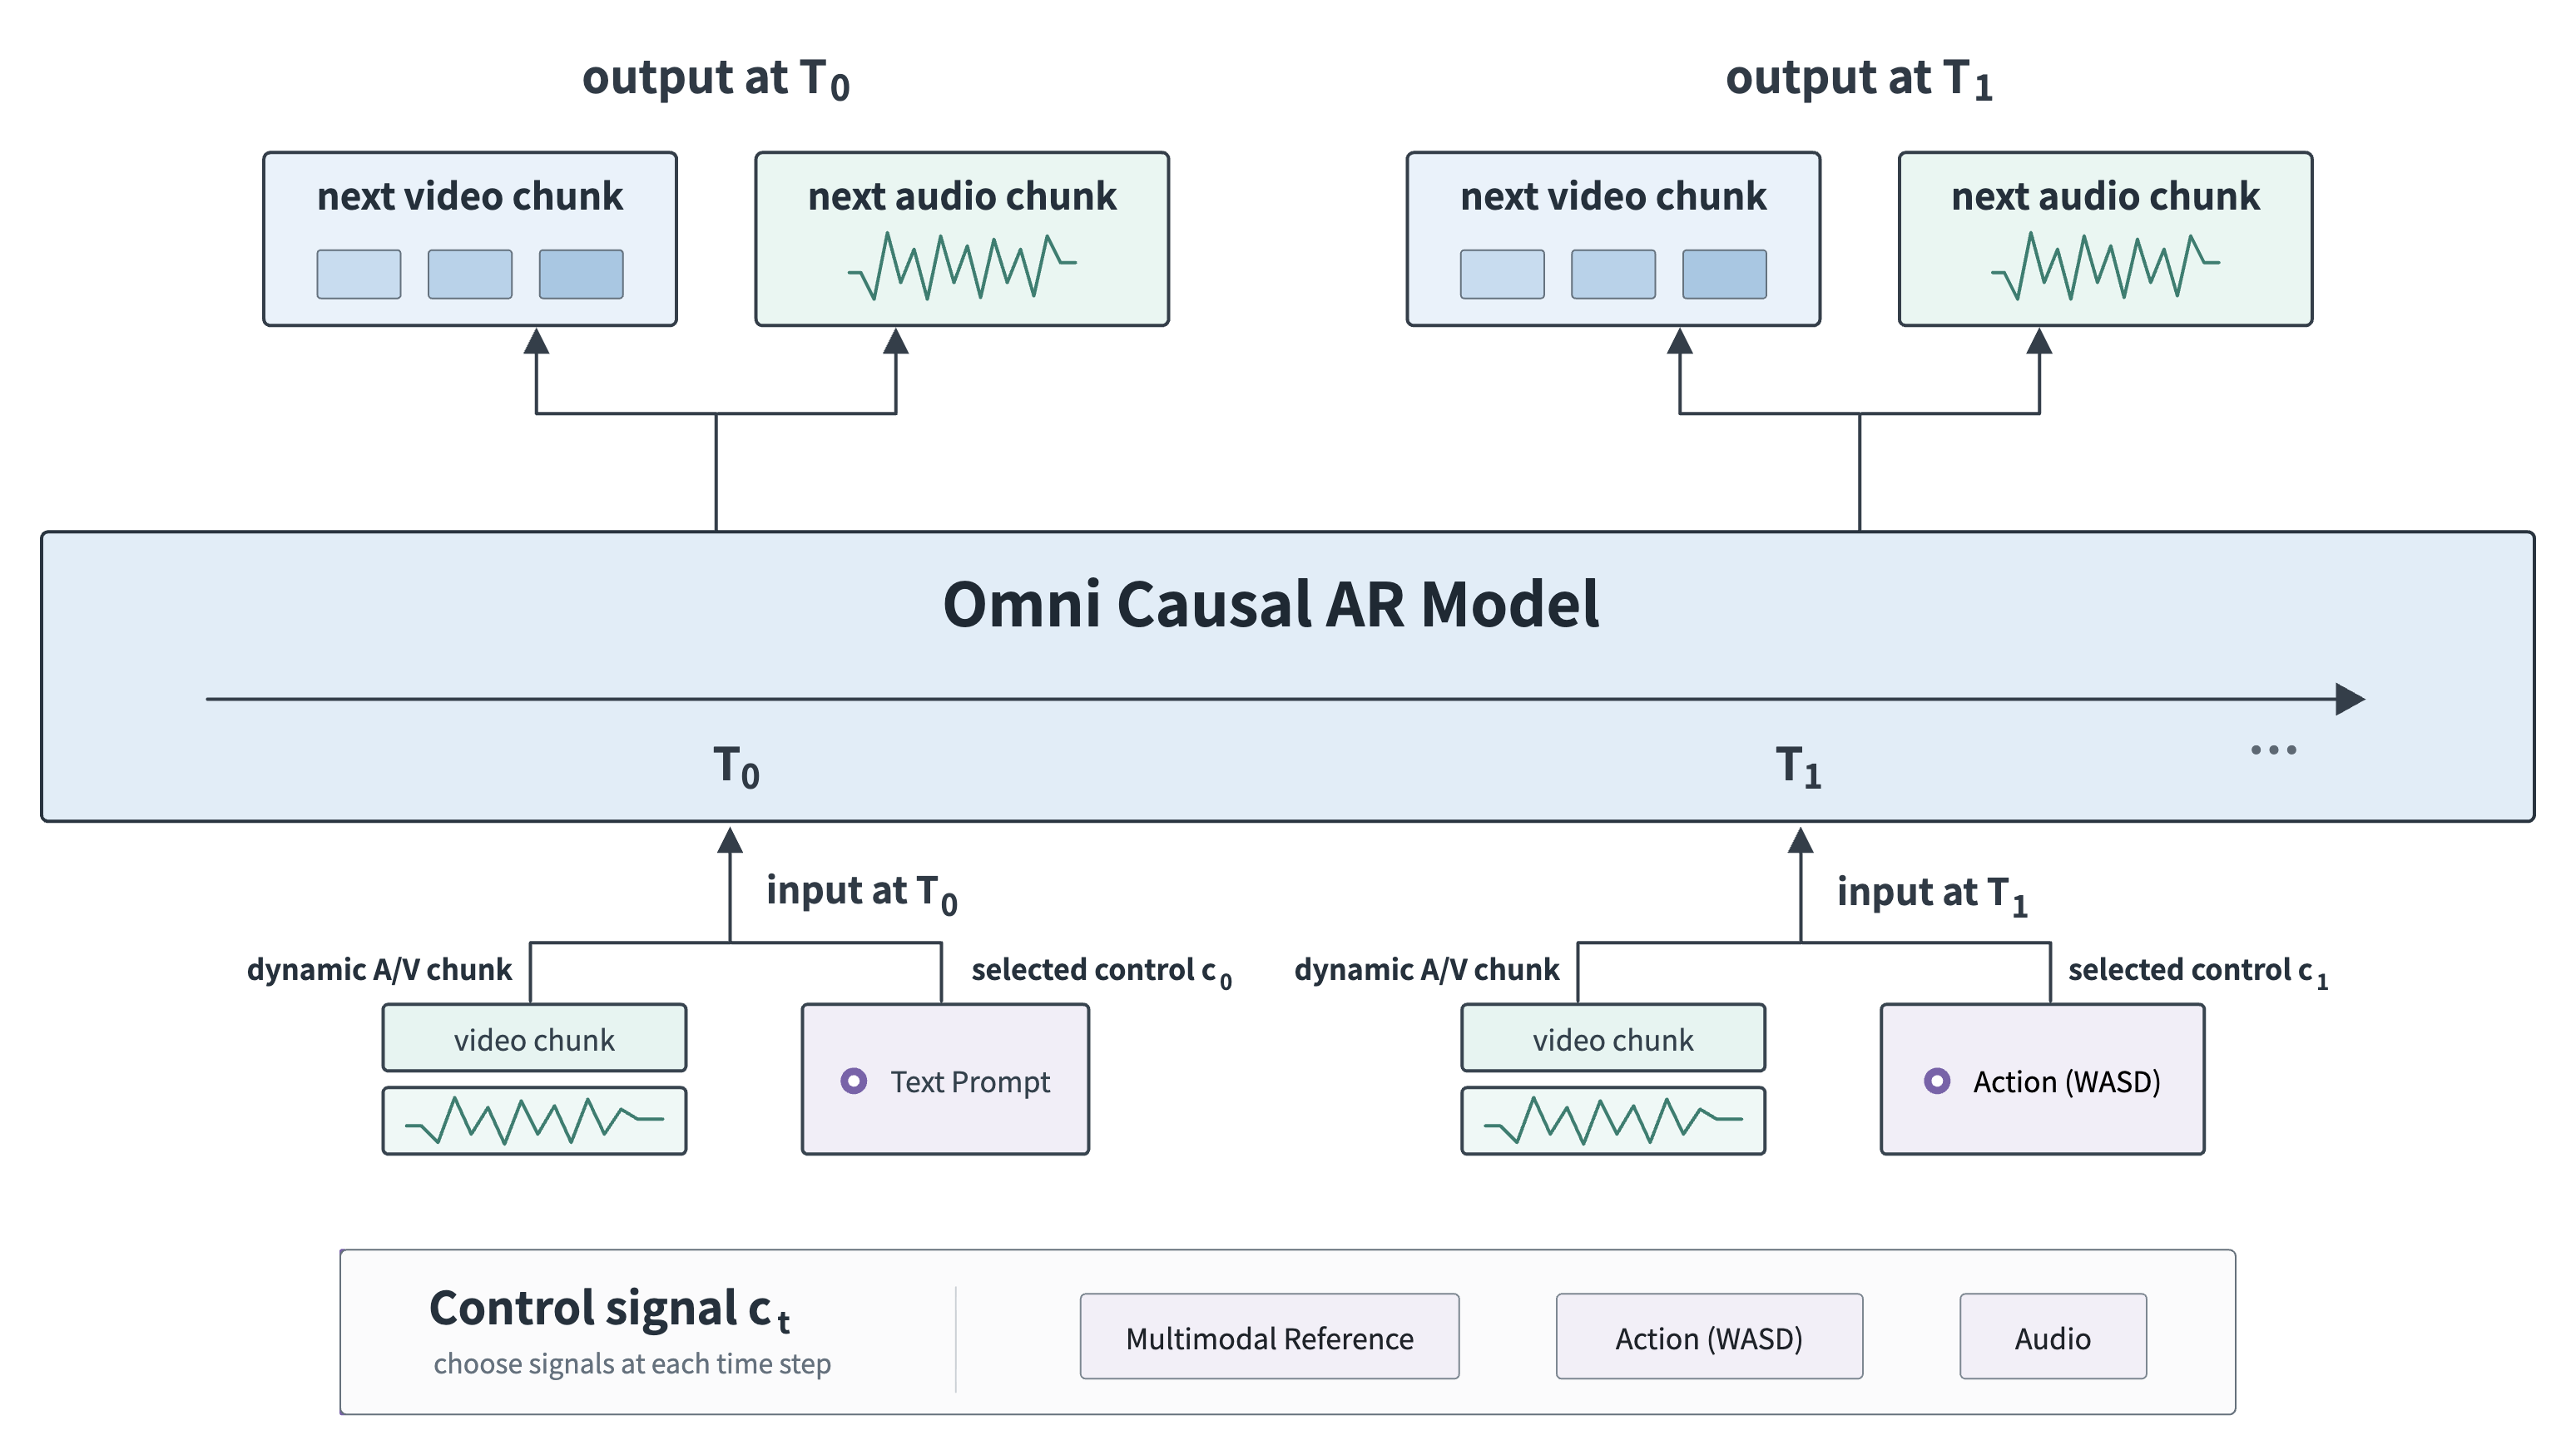
Rysunek 2. PixVerse R2 Omni Causal AR. Model może na bieżąco odbierać różnorodne sygnały sterujące w trakcie działania. W każdym momencie interakcji aktywna komenda zostaje dopasowana do dynamicznego bloku audiowizualnego o odpowiedniej ziarnistości, nadając kierunek kolejnemu segmentowi wideo i audio.
Generowanie w oparciu o dynamiczne bloki (Dynamic Chunks)
Różne sygnały sterujące operują w odmiennych skalach czasowych. Prompty i obrazy referencyjne opisują zazwyczaj całościowy kontekst lub dłuższe sceny. Działania użytkownika (WASD) wymagają natychmiastowej, precyzyjnej odpowiedzi. Ścieżka dźwiękowa niesie ze sobą treść, rytm i ścisłe ramy czasowe. Wymuszenie stałej długości jednostek czasu dla wszystkich wejść zmuszałoby system do kompromisów między czasem reakcji a bogactwem wyrazu.
Dynamic Chunk to mechanizm, dzięki któremu R2 unifikuje te zróżnicowane skale czasowe. Model adaptacyjnie dzieli strumienie audiowizualne na podstawie granic semantycznych i czasu trwania bieżącego sygnału sterującego, z zachowaniem maksymalnego limitu wielkości bloku w celu optymalizacji obliczeń. Krótkie bloki gwarantują błyskawiczną reakcję na polecenia ruchowe. Długie bloki zachowują złożoną strukturę wydarzeń, płynność gestów i ciągłość audio. Różnorodne zadania korzystają ze wspólnego interfejsu przyczynowego bez konieczności przebudowy sieci.
Hybrid Teacher Forcing / Diffusion Forcing
Główny problem w długoterminowym uczeniu AR polega na tym, że historia w zbiorach treningowych jest nieskazitelna, podczas gdy w rzeczywistej sesji zawiera szum i drobne artefakty generowane przez sam model. Trening wyłącznie na czystych danych podnosi jakość pojedynczego kroku, ale czyni model niezwykle wrażliwym na najmniejsze potknięcie. Trening wyłącznie na danych zaburzonych obniża wyrazistość obrazu, dynamikę i posłuszeństwo komendom.
R2 łączy idealne i zaburzone historie w jednym cyklu szkoleniowym. Czysta historia wyznacza najwyższy pułap jakościowy. Historia zaszumiona uczy model zawczasu neutralizować niedoskonałości, z którymi spotka się w środowisku produkcyjnym. Ten komplementarny trening zmniejsza lukę między teorią a praktyką, dzięki czemu model generuje kolejny fragment o nienagannej jakości nawet wtedy, gdy w pamięci podręcznej pojawił się drobny błąd.
Przyczynowa Maska Uwagi (Causal Attention Mask) oraz Względne Czasowe RoPE (Relative Temporal RoPE) wspólnie kontrolują dostęp do danych historycznych w oknie uwagi. Maska wymusza ścisłą przyczynowość czasową. Czasowe RoPE nie rozrasta się bez końca wraz z globalnym indeksem, lecz jest indeksowane względem aktywnego okna uwagi. W miarę przesuwania się okna czas rzeczywisty płynie naprzód, podczas gdy pamięć trwała, najnowsze klatki i bieżący blok pozostają zmapowane na stabilny, ograniczony zakres współrzędnych.
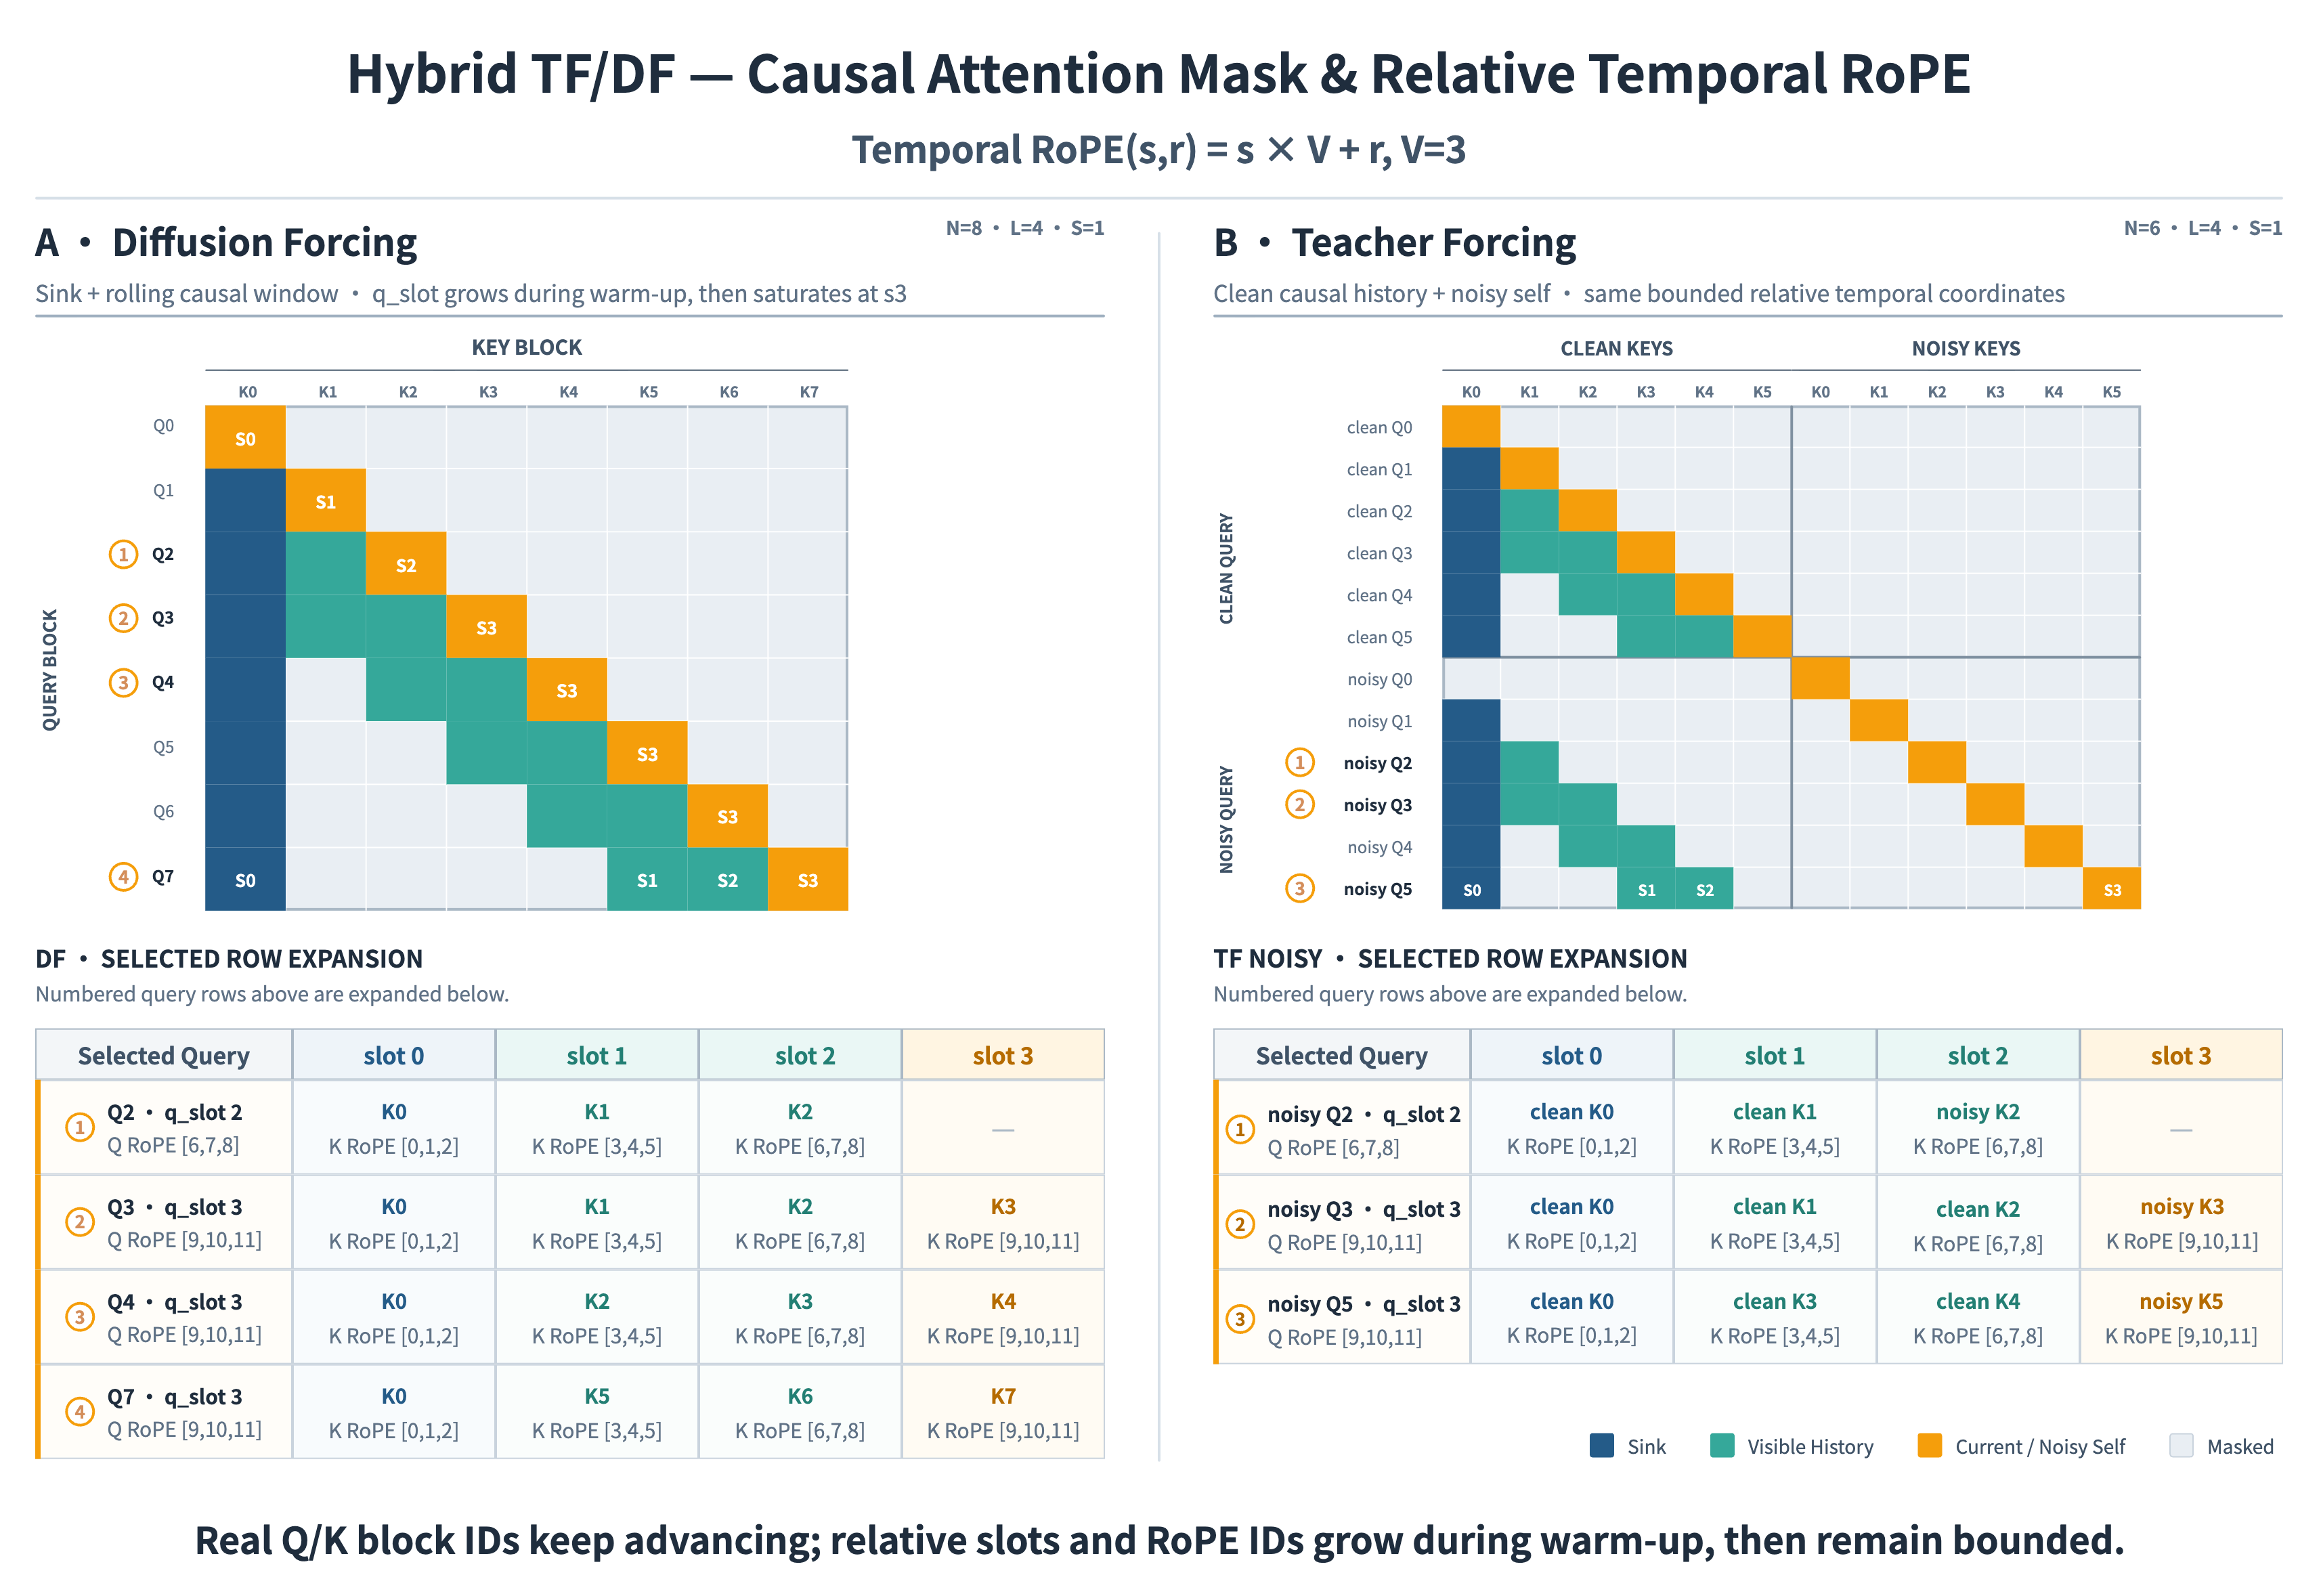
Rysunek 3. Zunifikowana przyczynowa maska uwagi i względne czasowe RoPE dla Hybrid Teacher / Diffusion Forcing. Górny schemat przedstawia widoczność przyczynową dla dwóch wariantów historii. Dolny odwzorowuje zapytania na bloki Q/K, względne sloty i identyfikatory RoPE, ukazując, że realne indeksy rosną, podczas gdy wewnętrzne współrzędne czasowe pozostają ograniczone.
Pamięć wieloskalowa (Multi-timescale memory)
Modelowanie świata w długich horyzontach czasowych nie może polegać na bezrefleksyjnym gromadzeniu wszystkich danych w pamięci podręcznej. Niekontrolowany rozrost historii błyskawicznie przeciąża zasoby sprzętowe; zbyt agresywne czyszczenie pamięci niszczy tożsamość postaci, układ lokacji i kluczowe wątki. R2 wykorzystuje trójstopniowy system pamięci złożony z Sink Memory, Rolling History oraz Object KV Cache.
- Sink Memory: przechowuje niezmienne filary świata (wygląd postaci, architekturę otoczenia, konwencję stylistyczną i prawa rządzące uniwersum).
- Rolling History: skupia się na niedawnych ruchach, pozach, pracy kamery i zmianach oświetlenia, dbając o płynne przejścia w najbliższych klatkach.
- Object KV Cache: optymalizuje i ponownie wykorzystuje obliczone wcześniej reprezentacje obiektów, zatrzymując w pamięci tylko te elementy, które mają realny wpływ na dalszą akcję.
Współpraca tych modułów gwarantuje niezmienność tożsamości postaci, ciągłość ruchu i kontrolę nad kosztami obliczeniowymi, eliminując migotanie klatek czy nagłe zmiany scenerii.
Bank Błędów (Error Bank)
Poważne anomalie w autoregresyjnych modelach świata biorą się zazwyczaj z niedostrzegalnego błędu, który utrwalił się w historii i został zwielokrotniony w kolejnych iteracjach. R2 tworzy Error Bank katalogujący typowe próbki błędów i w kontrolowanych proporcjach wprowadza je z powrotem do treningu. Model nie tylko uczy się kontynuować idealny stan, lecz zyskuje zdolność rozpoznawania, neutralizowania i naprawiania historii, która zaczęła zbaczać z właściwego toru.
W testach ewaluacyjnych wskaźnik długofalowego dryfu jasności obniżył się z 0,201 do 0,129 (spadek o 35,8%). Spośród 29 długich sekwencji testowych aż 20 wykazało wyraźną poprawę, a we wszystkich 5 próbkach statycznych całkowicie wyeliminowano niepożądany ruch własny kamery.
Akceleracja w czasie rzeczywistym
Akceleracja czasu rzeczywistego w R2 nie uczy kilkukrokowego modelu fizyki świata od podstaw. Przyspiesza ona model, który potrafi już stabilnie generować świat przez długi czas. Warstwa akceleracji bazuje na pretrenowanym Omni Causal AR, wykorzystując go zarówno do inicjalizacji ucznia, jak i w roli nauczyciela destylacji, dzięki czemu wszystkie komponenty dzielą tę samą trajektorię przyczynową.
Ten spójny punkt startowy zmniejsza zależność od skomplikowanych metod dostrajania w rodzaju Self-Forcing czy Rolling Forcing. Akceleracja może skupić się na rzeczywistych wyzwaniach generacji w małej liczbie kroków: DDMD z regularyzacją adwersarialną odpowiada za posłuszeństwo instrukcjom, zgodność rozkładów i realizm; uwaga blokowo-rzadka (block-sparse attention) redukuje koszt przetwarzania długiego kontekstu; a architektura piramidalna obniża narzut generowania obrazu w wysokiej rozdzielczości.
DDMD z regularyzacją adwersarialną
W generowaniu w bardzo małej liczbie kroków precyzja sterowania, zgodność rozkładu i fotorealizm stanowią odrębne zagadnienia optymalizacyjne. R2 opiera się na metodzie DDMD, wzbogacając ją o regularyzację adwersarialną z DMD2. Trzy wektory szkoleniowe spotykają się w modelu ucznia: kierowanie warunkowe wzmacnia sterowność, dopasowanie rozkładu chroni wiedzę nauczyciela, a regularyzacja adwersarialna kotwiczy wynik w autentycznych danych. W ten sposób zaledwie kilka kroków próbkowania wystarcza do zachowania pełnej responsywności i wiarygodności świata.
Uwaga blokowo-rzadka (Block-sparse attention)
R2 implementuje uwagę blokowo-rzadką dla sekwencji tokenów czasoprzestrzennych. Model dzieli macierze Q, K i V na bloki obliczeniowe, błyskawicznie szacuje najważniejsze powiązania dla każdego bloku zapytań, zachowuje jedynie kluczowe ścieżki i wykonuje dokładną uwagę softmax wyłącznie na wybranych blokach. Taki routing nie jest przypadkowym obcinaniem danych: skupia moc obliczeniową na silnych zależnościach między bieżącym sterowaniem multimodalnym, niedawnym ruchem a fundamentalnym stanem otoczenia.
Dzięki dostosowaniu sieci do rzadkiej struktury połączeń podczas treningu R2 osiąga rzadkość uwagi na poziomie ponad 90%, zachowując ostrość detali, płynność ruchu, reakcję na polecenia i stabilność czasową bez odczuwalnych strat jakościowych.
Piramidalna destylacja w skrajnie małej liczbie kroków
Generowanie całego kadru od zera w najwyższej rozdzielczości marnuje zasoby na zarysowywanie ogólnej geometrii, którą z łatwością definiuje się na niższych poziomach. R2 dzieli proces na jeden lub dwa etapy w niższej rozdzielczości oraz finałowy etap w wysokiej rozdzielczości. Wczesne fazy ustalają układ sceny, ruch postaci i kąt widzenia kamery. Faza końcowa odtwarza faktury, ostre krawędzie i mikrografię. Ta progresywna metoda eliminuje zbędne obliczenia, wzmacniając jednocześnie ogólną spójność konstrukcyjną sceny.
Podsumowanie i ograniczenia
PixVerse R1 zapoczątkował erę modeli świata wideo czasu rzeczywistego, dowodząc, że wideo AI może wyjść poza ramy statycznego pliku i stać się interaktywnym, nieprzerwanie działającym światem. PixVerse R2 rozwiązuje zagadnienie skalowania tego paradygmatu: zunifikowany Omni Causal AR radzi sobie z rosnącymi wolumenami danych, zadań i modalności, a Akceleracja w Czasie Rzeczywistym przekłada ten potencjał na błyskawiczną inferencję w kilku krokach.
R2 to nie jednostkowa aktualizacja parametrów, lecz zunifikowany fundament szkoleniowy dla kolejnej generacji modeli świata. R1 urzeczywistnił koncepcję modeli wideo w czasie rzeczywistym, natomiast R2 wprowadza je na poziom skalowalnego, stale doskonalącego się standardu.
W warunkach ścisłych limitów opóźnień interakcji i mocy obliczeniowej jakość pojedynczych generacji wciąż ma przestrzeń do rozwoju w porównaniu z wiodącymi modelami offline — zwłaszcza pod kątem złożonych mikrotekstur, absolutnego realizmu motorycznego i długofalowej stabilności w wielominutowych sekwencjach. Różnice te odzwierciedlają obecny etap skalowania R2, a nie nieprzekraczalną barierę samej architektury.
Wczesny dostęp (Early Access)
Na dzień 23 sierpnia 2026 ten raport opisywał PixVerse R2 jako zamknięte testy. 22 września 2026 PixVerse ogłosił, że zbiór tych światów jest otwarty do eksploracji na world.pixverse.video. Zobacz ogłoszenie premiery R2.
To ogłoszenie nie otwiera nieograniczonego dostępu do API. Formularz dostępu do modelu świata PixVerse R2 pozostaje ścieżką wniosku o wczesny dostęp i klucze API.
Powiązane materiały
- PixVerse R1: Model świata wideo AI w czasie rzeczywistym
- Analiza silnika PixVerse Game Engine
- PixVerse aktualizuje R1 o współdzielone światy
- Przewodnik po generowaniu wideo AI w czasie rzeczywistym
- PixVerse zamyka rundę Series C Extension
Światy z ogłoszenia z 22 września 2026 są otwarte do eksploracji na world.pixverse.video. Dostęp do API wciąż składa się przez formularz powyżej. Można też tworzyć dziś z PixVerse V6 i R1.