PixVerse R2:リアルタイムOmni世界モデルのスケーリング
PixVerse R1は、最初のリアルタイム動画世界モデルを提案し出荷し、動画生成を固定クリップの一発納品から、継続的に走る世界へ変えました。モデルはユーザー入力を受け続け、世界状態をリアルタイムで更新し、インタラクションと一貫した同期音声と動画をストリームできます。R1は、この技術パラダイムが成立することを示しました。
PixVerse R2 は次の問いに答えます。リアルタイム動画世界モデルがどうスケールし続けるかです。R2は2つの目標に焦点を当てます。第一に、長い地平にわたって統一状態を保てる動的世界を構築し、完全な時空間事前を、時間方向にだけ進む世界進化へ変換します。第二に、テキスト、参照、音声、アクションからの物理因果とインタラクション信号を単一モデルへ継続的に内在化させ、世界が生成し、制御を受け、状態を更新すると同時に、同期音声と動画をストリームできるようにします。
これらの目標の周りで、R2はモデル、データ、タスク、制御信号、時間スケールの成長を、生成品質、長距離一貫性、マルチモーダル制御の向上へ変えます。
全体フレームワーク
R2はシステムを2つのコア層へ畳みます。Omni Causal AR と Real-Time Acceleration です。Omni Causal ARは、高品質でマルチモーダルな長地平の世界生成を拡張し続けます。Real-Time Accelerationは、厳しいインタラクション遅延予算の下で、それらの能力をできるだけ無損失に継承します。経路は明確です。世界モデルの能力天井を上げ、その能力をリアルタイムで対話可能な動作範囲へ加速します。
従来の長尺動画とリアルタイムパイプラインは、多くの訓練段階を連鎖させることが普通でした。双方向モデルをARモデルへ変換し、タスク固有の双方向モデルから蒸留教師を作り、DMD蒸留を行い、訓練と推論のギャップを閉じるためにself-rollout DMDを足します。各段階で能力を再移行し、目的を再整列し、データ分布を再適合しなければなりませんでした。画質、動き、条件追従、長地平の安定性は、それらの転送中に侵食され得ます。モデル、データ、タスク規模が大きくなると、多段階パイプラインは最適化目標を分裂させ、訓練コストとシステム複雑さを上げます。
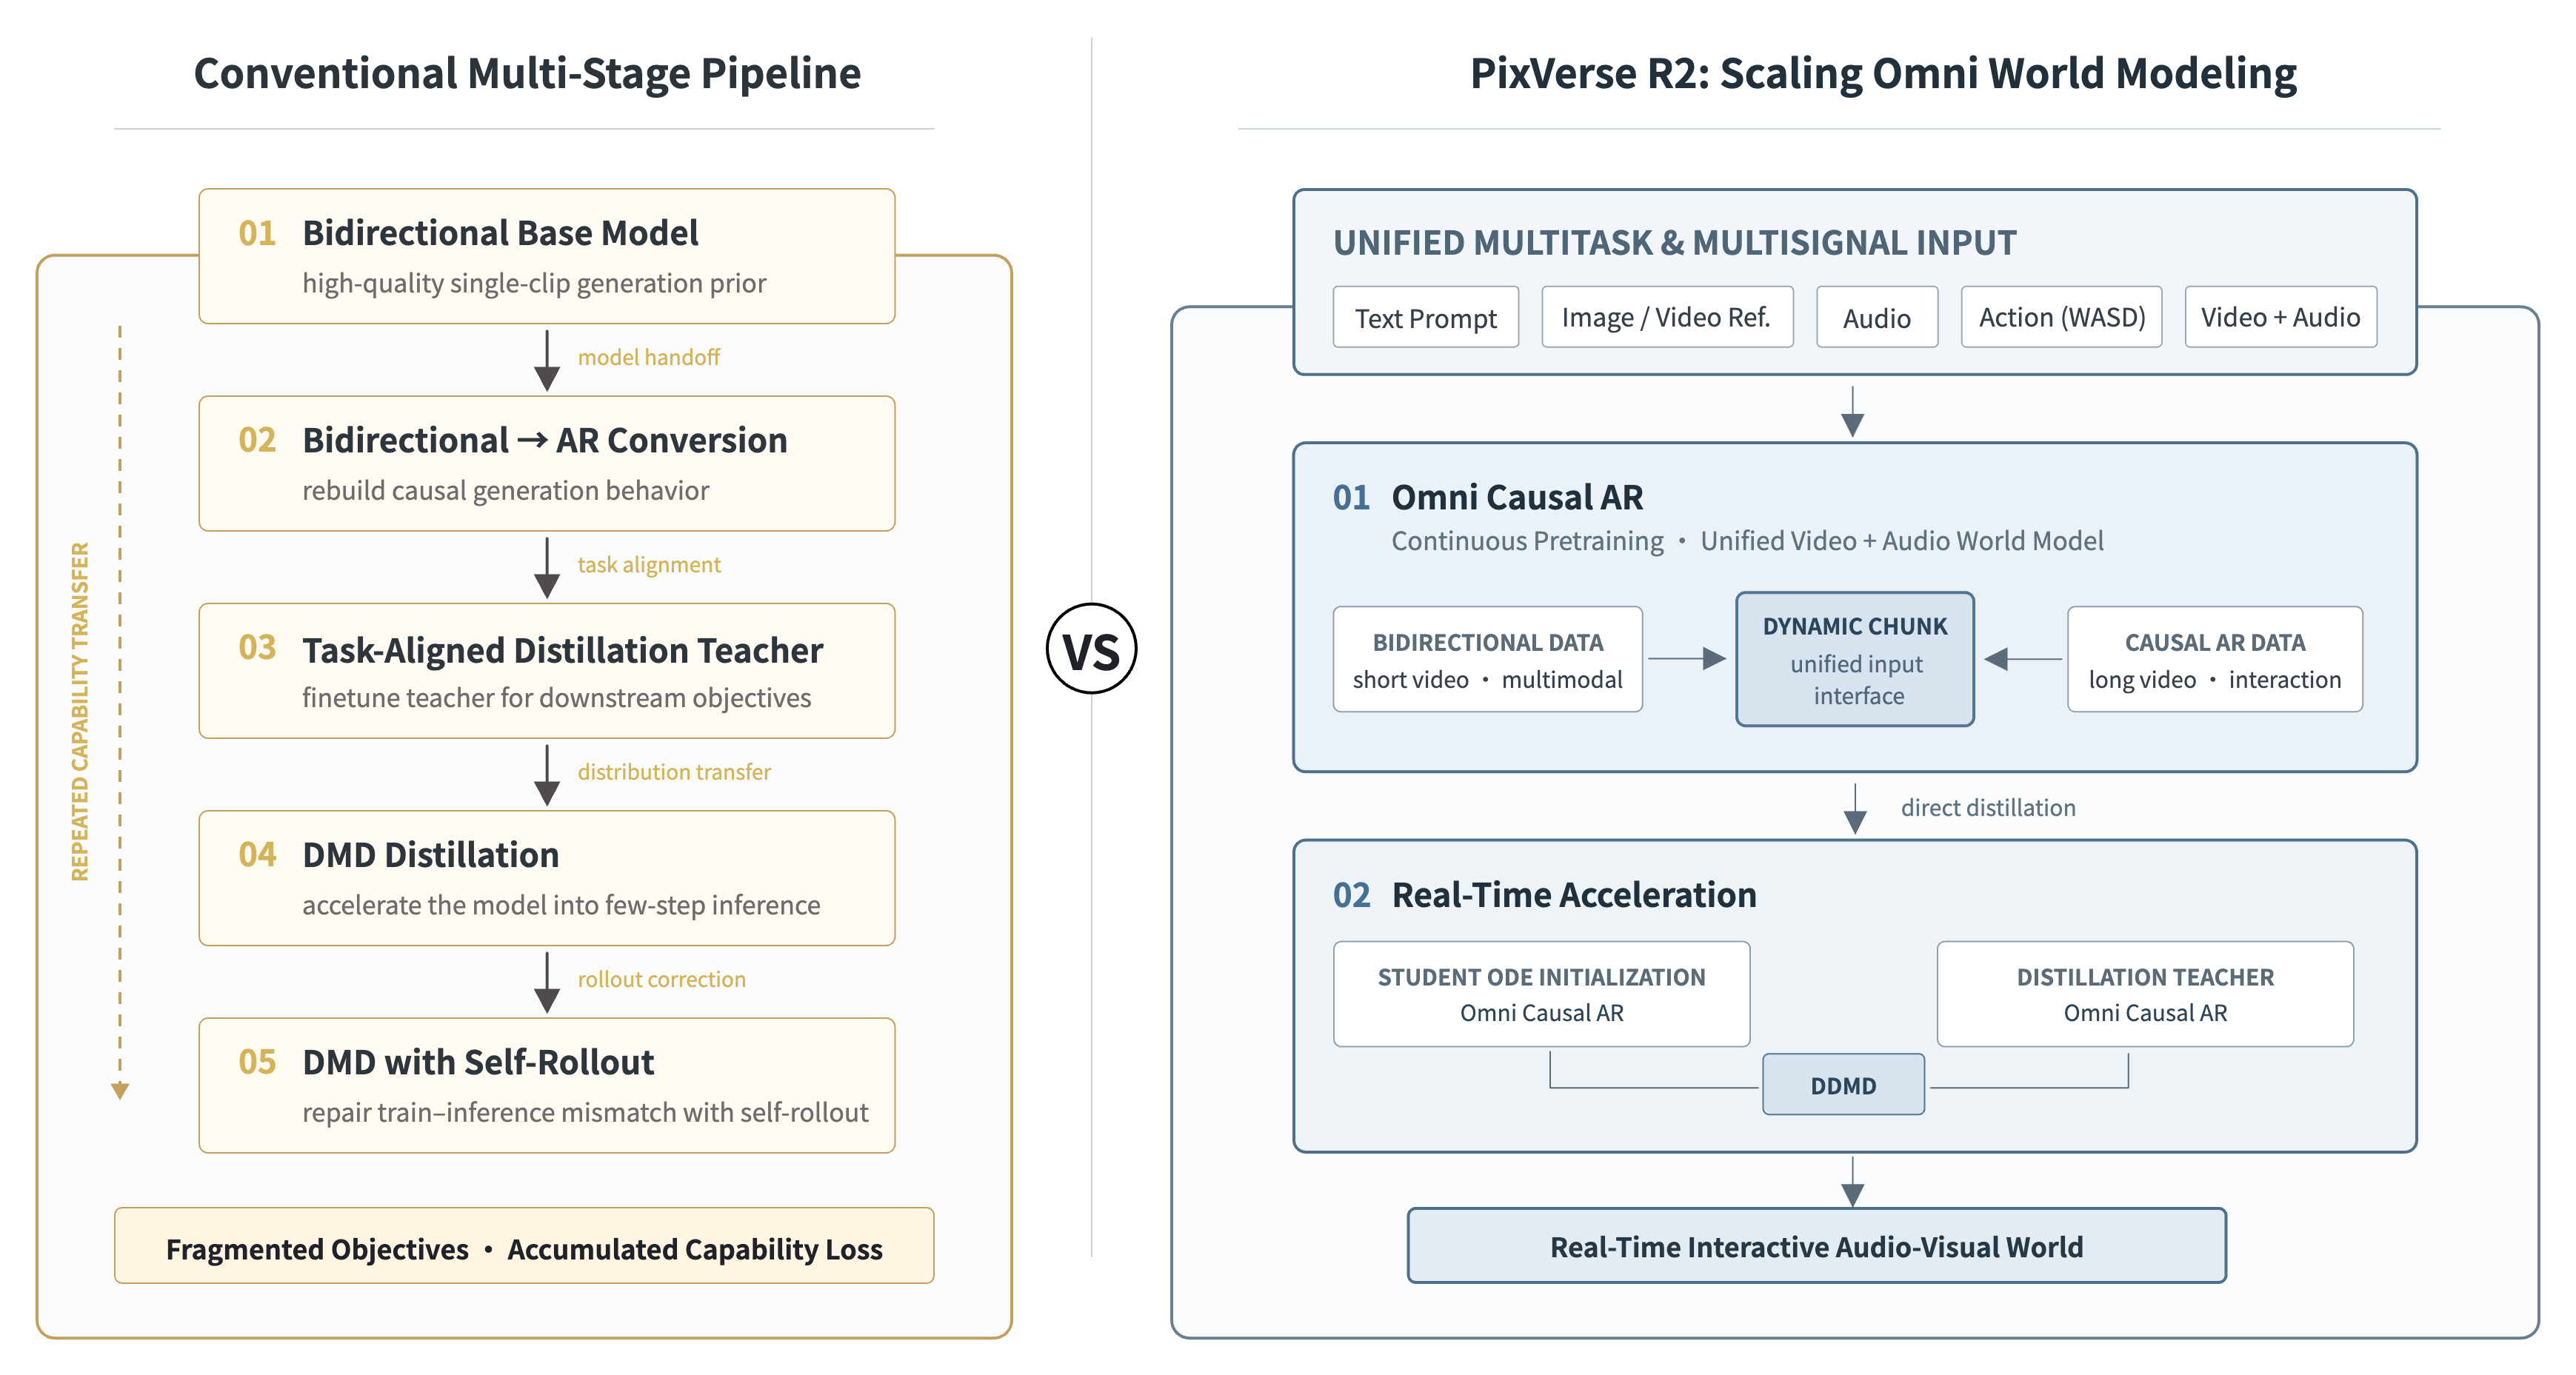
図1. 従来の多段階パイプラインとPixVerse R2のスケーリング世界モデリング。R2は能力拡張とリアルタイム蒸留をOmni Causal ARとリアルタイム加速層へ収束させ、マルチタスク、マルチ信号、長尺動画モデリングを一つの枠組みで統一します。
PixVerse R2は、リアルタイム世界モデル向けの統一訓練パラダイムを提案します。多くのモデルとタスク段階にわたって能力を繰り返し移行するのではなく、複雑なパイプラインを、スケールし続けられる2つの過程へ減らします。統一世界状態を持つOmni Causal ARを継続事前学習し、空間一貫性と長地平モデリングを継承したままリアルタイム生成できる加速モデルへ直接蒸留します。
段階境界が減ると、独立教師、タスク整列、繰り返しのモデル転送から来る能力損失が減ります。新しいデータ、タスク、制御信号、モデル規模は、より直接にリアルタイム世界モデリング能力へ変換できます。
段階1:Omni Causal ARの継続事前学習。 R2は双方向生成事前と長尺動画ARを、つながっていない2段階としては扱いません。双方向モデル能力の上で、統一Omni Causal ARを継続訓練します。動的チャンクが異なるデータ形態に共有の時間表現を与えます。モデルは双方向事前学習からの高品質短尺動画とマルチモーダルデータを吸収でき、連続長尺動画と多ターンのインタラクション軌跡へ拡張できます。画質、視聴覚表現、長地平生成、マルチ信号制御は、繰り返し変換で再移行するのではなく、一つのモデル内でスケールできます。
段階2:スケールしたOmni Causal ARからリアルタイム加速層を蒸留。 継続事前学習は、Omni Causal ARに高品質生成、安定した長地平状態転送、本物の因果ロールアウトを同時に与えます。R2はその同じOmni Causal ARを学生ODE初期化と蒸留教師の両方に使うため、教師、学生、実際のAR推論が一致した因果モデリング基盤を共有します。リアルタイム蒸留は「長地平世界の再学習」ではなく、「既存世界モデルの少数ステップ加速」になります。
Omni Causal AR
R2は、R1がすでに検証したマルチモーダル入力、自己回帰生成、リアルタイムインタラクション経路を続け、それらの能力を統一Omni Causal AR訓練ルートへ集中させます。Omni Causal ARは、完全な時空間生成事前を、時間方向にだけ進む世界状態転送へ変換します。因果化と継続事前学習により、モデルは画、動き、音声、マルチモーダル意味能力を保ちつつ、履歴だけから次の同期視聴覚チャンクを予測することを学びます。
訓練対象が独立した短尺動画から連続長尺動画と多ターンのインタラクション軌跡へ広がると、モデルは歴史的世界状態、現在のインタラクション入力、将来の世界進化のあいだに長期因果を徐々に築きます。
モデルはテキストプロンプト、マルチモーダル参照、アクション信号(WASDや連続制御など)、音声を共同で受け、同期した動画と音声を出力します。異なる制御信号は実行中に入り続け、後の世界状態を変えられます。R2は一発条件への応答だけでなく、生成し、制御を受け、世界を同時に更新できます。
因果生成を同じ世界の中で長く走らせるため、R2は4つの問題に取り組みます。訓練と推論の分布ギャップ、ノイズのある履歴への頑健性、長期記憶と直近記憶の協調、誤り状態の補正です。Hybrid Teacher / Diffusion Forcingは、モデルがきれいな履歴とノイズのある履歴の両方に適応できるようにします。Multi-Timescale Memoryは世界アンカー、直近ダイナミクス、物体状態を共同保存します。Error Bankは失敗状態を訓練へ戻します。合わせて長期世界状態の訓練ループを形成し、画、キャラクター、動き、視聴覚関係、制御応答の時間的ドリフトを減らします。
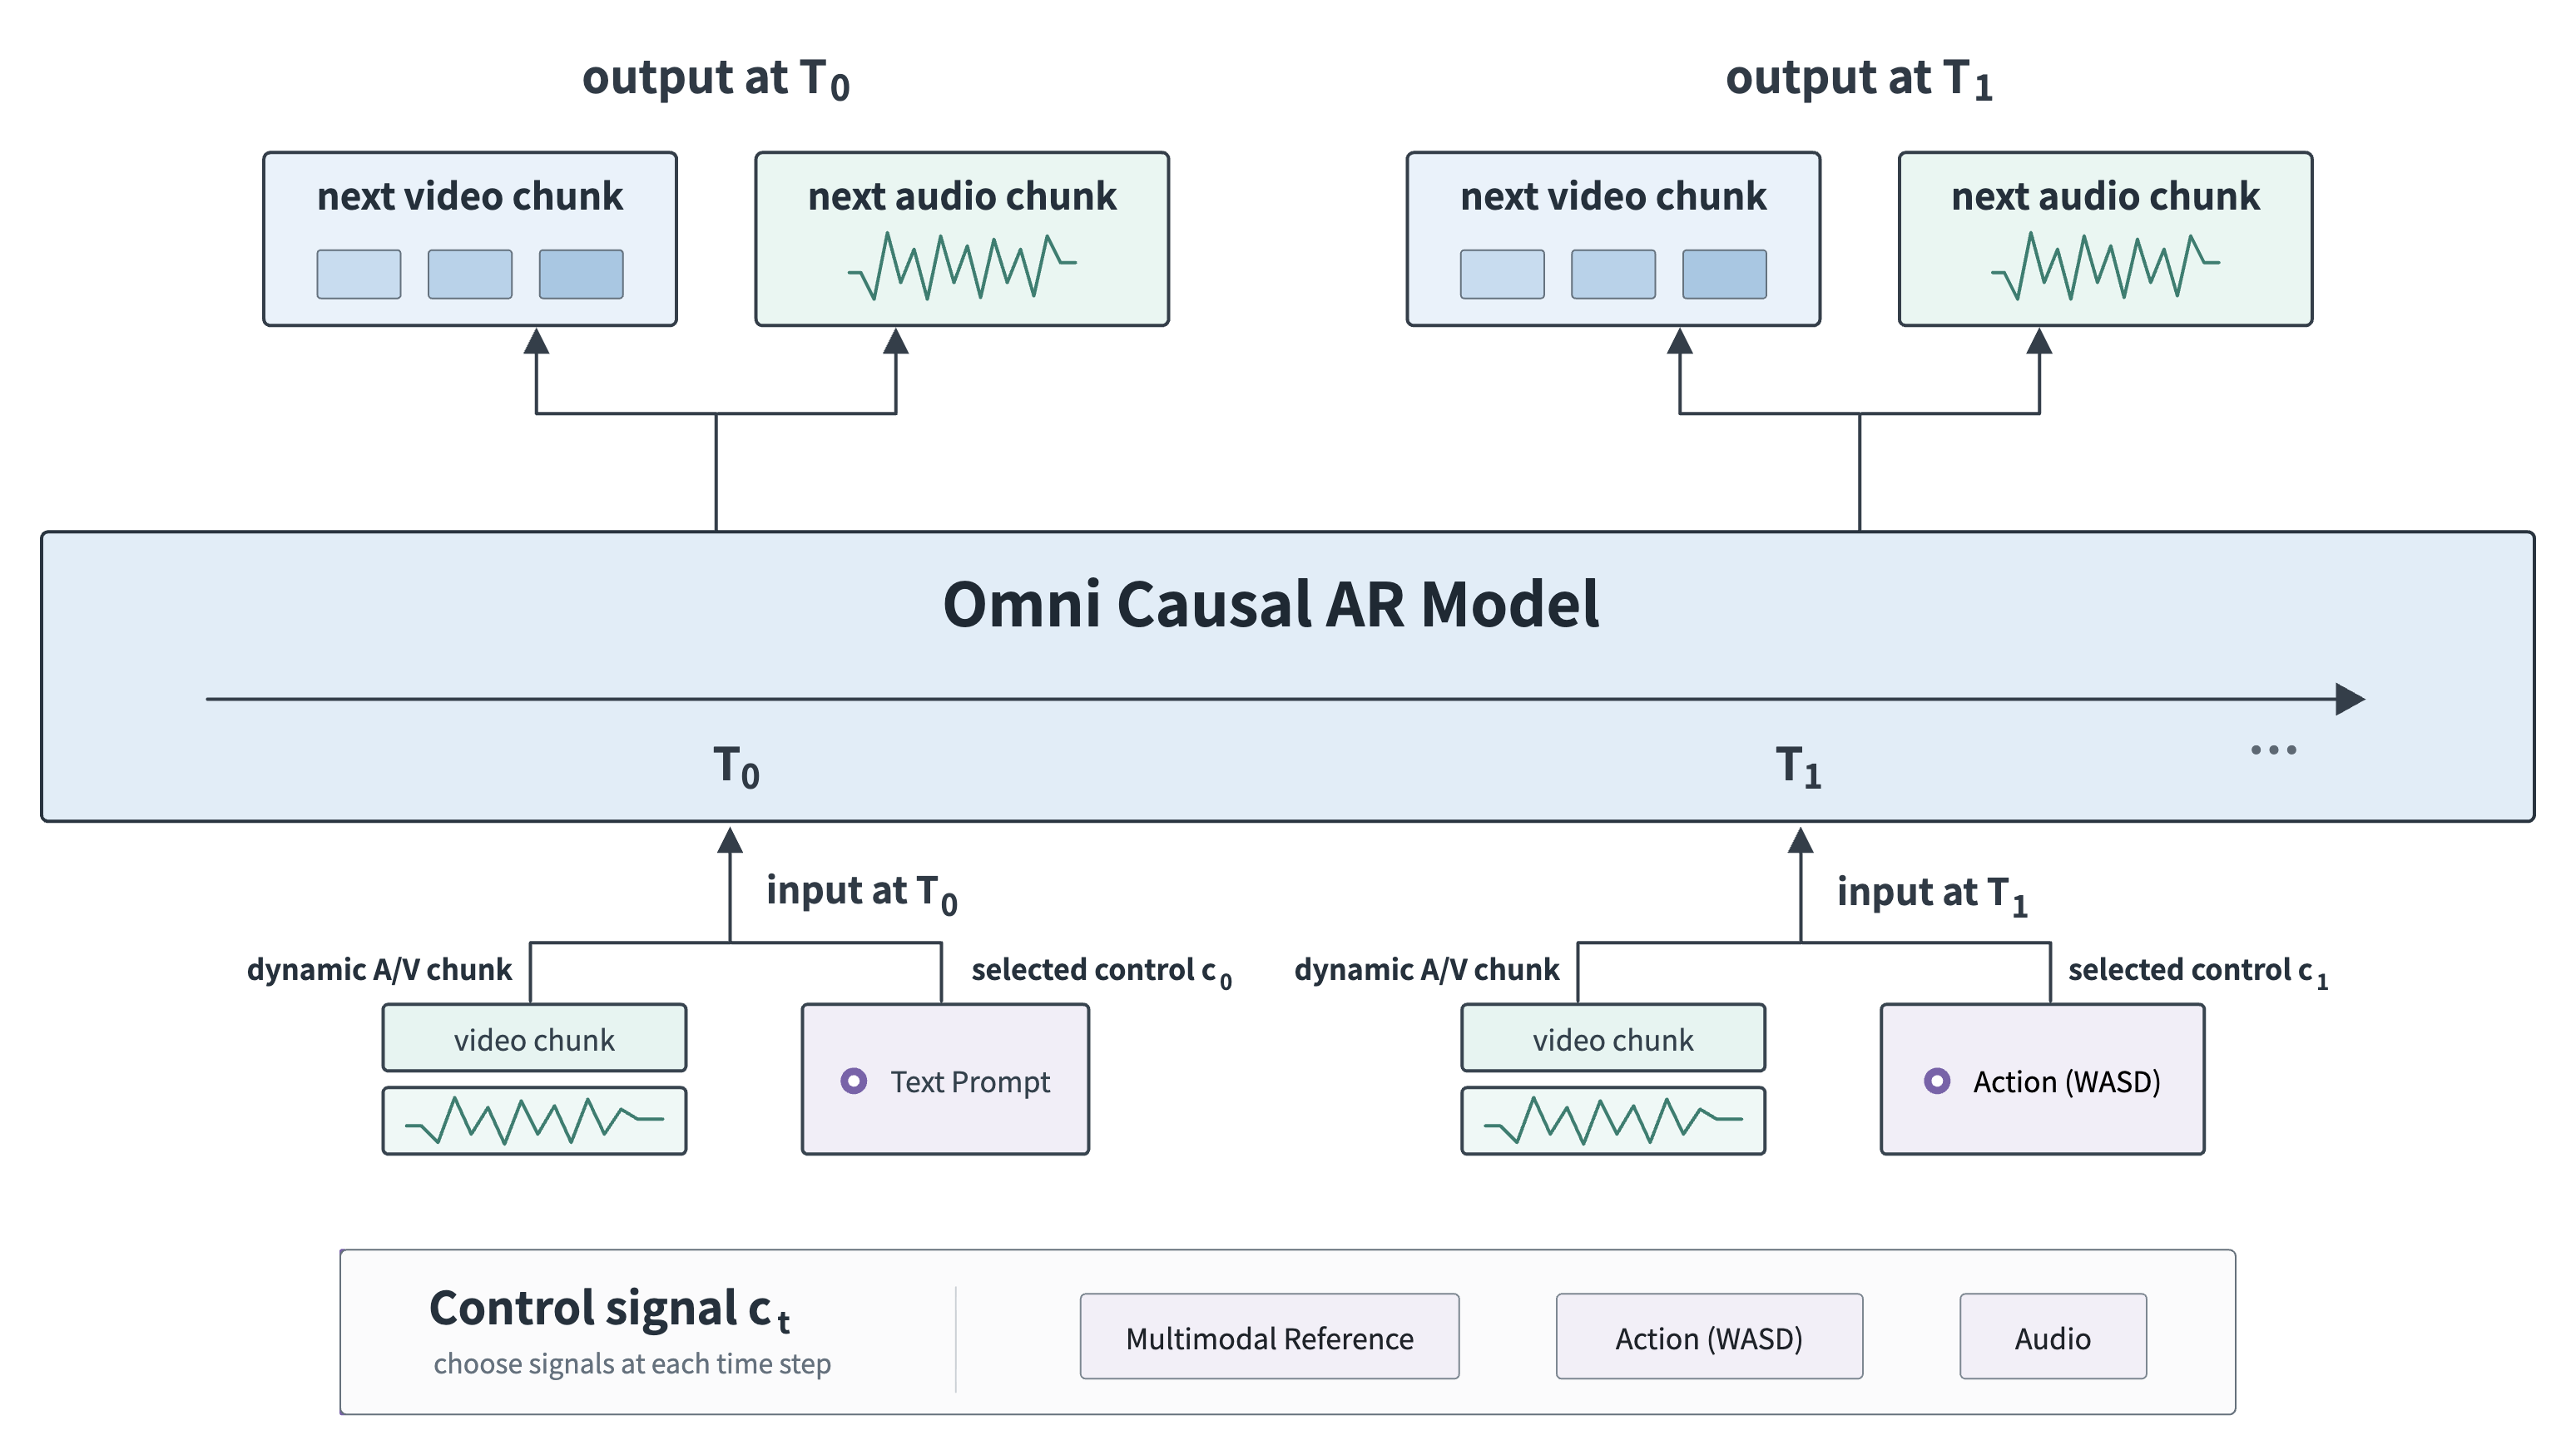
図2. PixVerse R2 Omni Causal AR。モデルは実行中に異なる制御信号を受け続けられます。各インタラクション時点で、アクティブ信号は一致する粒度の動的視聴覚チャンクと整列し、次の動画と音声セグメントを駆動します。
動的チャンク生成
異なる制御信号は異なる時間スケールに住みます。プロンプトと参照は通常、完全な意味やより長い出来事を記述します。アクション(WASD)は細粒度で即時の状態フィードバックを必要とします。音声は意味、リズム、時間同期を一度に運びます。すべての入力を固定長の時間単位へ押し込むと、モデルは応答速度と表現の完全性をしばしばトレードオフしなければなりません。
Dynamic Chunkは、R2がそれらのインタラクション時間スケールを統一する方法です。R2は現在の制御信号の意味境界と持続時間で視聴覚系列を適応的に分割し、最大チャンクサイズで計算と訓練安定性を制約します。短いチャンクはアクションと局所指示の応答精度を上げます。長いチャンクは出来事、動き、視聴覚意味の完全構造を保ちます。異なるタスクと制御信号は、モデル構造を切り替えずに一つの因果生成インターフェースを共有できます。
Hybrid Teacher Forcing / Diffusion Forcing
長地平ARの中核の緊張は、訓練履歴が通常よりきれいである一方、実際の実行時履歴はモデル自身のノイズと局所誤りを含むことです。きれいな履歴だけで訓練すると単ステップの品質天井は上がりますが、小さなずれに過敏になります。摂動履歴だけで訓練すると、画質、動き、制御応答を損なうことがあります。
R2は一つの訓練過程できれいな履歴とノイズのある履歴を混ぜます。きれいな履歴は世界進化の品質天井を安定させます。ノイズのある履歴は、配備で見る不完全な状態へモデルを事前に適応させます。相補的な訓練が訓練と推論のギャップを縮め、モデルは高品質な次の世界セグメントを生成でき、履歴にすでに小さな誤りがあっても前方へロールできます。
Causal Attention MaskとRelative Temporal RoPEは、現在状態がどの履歴を読めるか、その履歴が現在ウィンドウのどこにあるかを共同で制約します。Attention Maskは厳密な因果可視性を強制します。Temporal RoPEはグローバルblock IDとともに無界に伸びず、現在のアテンションウィンドウ内の相対スロットで再インデックスされます。ローリングウィンドウが前方へ動くと、実時間は進み続けますが、sinkメモリ、直近履歴、現在チャンクは安定した有界の相対位置範囲へ写像されたままです。
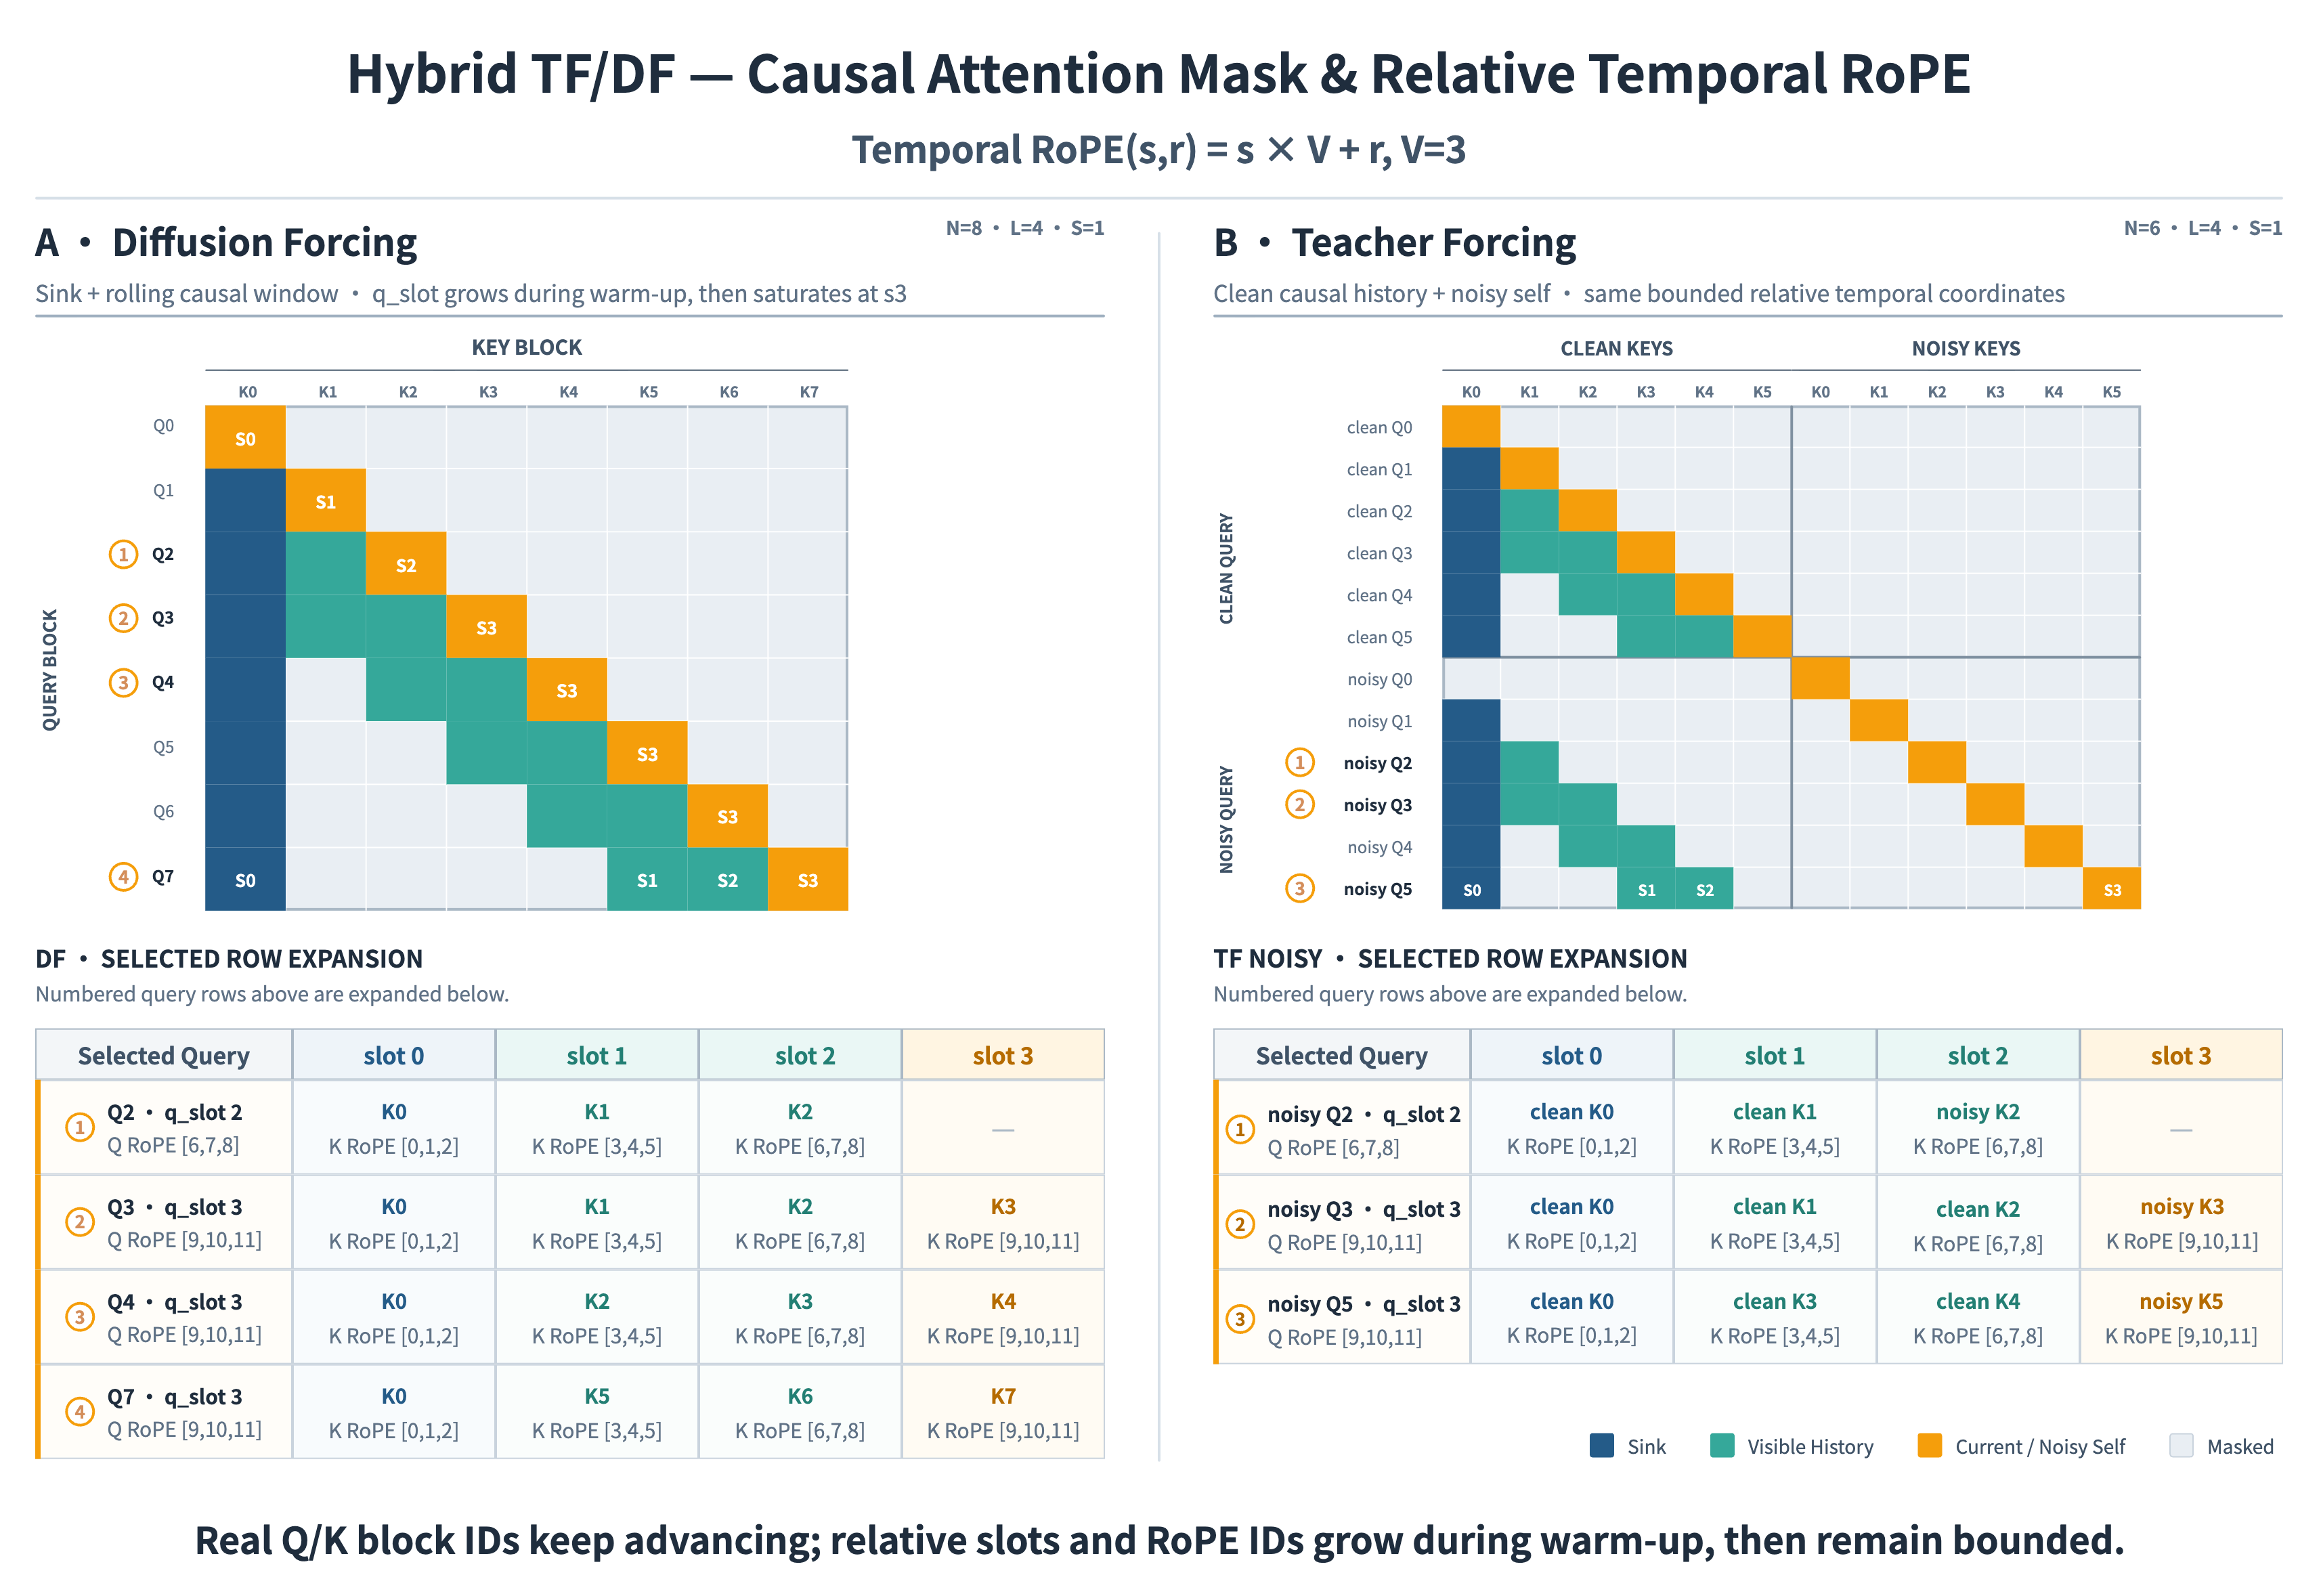
図3. Hybrid Teacher / Diffusion Forcing向けの統一因果アテンションマスクと相対時間RoPE。上は2つの履歴構成の因果可視性を示します。下は代表クエリをQ/Kブロック、相対スロット、RoPE IDへ写像し、実block IDは進み続け、ウィンドウ内時間座標は有界に保たれることを示します。
マルチタイムスケールメモリ
長期世界モデリングは、すべての履歴を単純に覚えることではありません。無界の履歴は計算とメモリコストを急速に上げ、切りすぎるとキャラクターアイデンティティ、シーン設定、重要イベントを落とします。R2はSink Memory、Rolling History、Object KV Cacheから多尺度メモリシステムを構築します。
- Sink Memory はキャラクター、シーン、スタイル、世界規則などの長期アンカーを保存します。
- Rolling History は直近のアクション、ポーズ、カメラ、環境変化に焦点を当て、局所状態が自然につながるようします。
- Object KV Cache はすでに計算した物体レベル履歴表現を再利用・圧縮し、後の進化に実際に影響する状態を限られた予算内に保ちます。
三者は長期アイデンティティの安定、短距離の動き連続、制御可能な実行時コストを与え、キャラクタードリフト、シーンジャンプ、チャンク間フリッカー、折れたアクションを減らします。
Error Bank
AR世界モデルの深刻なドリフトは、履歴に書き込まれて継承される初期の小さな誤りから始まることが多いです。R2はError Bankを構築し、代表的な誤り履歴を再利用可能なサンプルとして保存し、訓練中に設定比率で通常履歴へ再生します。モデルは理想状態から続ける方法だけでなく、すでにずれた履歴を認識し、吸収し、修復する方法も学びます。
段階評価では、長期輝度ドリフト指標が 0.201から0.129 へ下がり、約 35.8% の低下でした。29の長系列サンプルのうち20が改善し、静止すべきと明示された5サンプルすべてで誤った動きが減りました。
リアルタイム加速
R2のリアルタイム加速は、少数ステップモデルの中で長地平世界を再学習しません。すでに長く安定して走れる世界モデルを加速します。加速層は継続事前学習したOmni Causal ARから始まり、学生ODE初期化と蒸留教師の両方にそれを使うため、教師、学生、実際のAR推論が一致した因果軌跡分布を共有します。
この統一因果出発点は、Self-ForcingやRolling Forcing型の調整への依存を減らします。リアルタイム加速は、少数ステップ速度が実際に持ち込む問題に集中できます。敵対的正則化付きDDMD は蒸留中の条件整列、生成分布、リアリズムを扱い、ブロックスパースアテンション は長文脈計算を圧縮し、ピラミッド 経路は高解像度生成のコストを下げます。
敵対的正則化付きDDMD
超少数ステップ生成では、条件整列、分布マッチング、リアリズムは同じ最適化問題ではありません。R2は DDMD を基に、DMD2 からの敵対的正則化をさらに導入します。3つの訓練信号が一つの学生で出会います。条件整列が制御を強め、分布マッチングが教師分布を保ち、敵対的正則化が実データをアンカーするため、少ないサンプリングステップでも正確なインタラクション応答と信じられる世界を保てます。
ブロックスパースアテンション
R2は時空間トークン系列にブロックスパースアテンションを使います。モデルはQ、K、Vを計算ブロックへ分割し、各クエリブロックが最も必要とするキー/値ブロックを素早く推定し、最高スコアの接続だけを残し、選ばれたブロックで正確なsoftmaxアテンションを実行します。ブロックレベルルーティングはランダム剪定ではありません。現在のマルチモーダル制御、直近の動き、重要な世界状態のあいだの強い依存へ計算を集中させます。
訓練中にモデルをスパース接続構造へ適応させることで、R2はアテンションスパース性を 90% 超へ上げつつ、現在の評価では画質、アクション連続、条件追従、長地平安定性を明確に落とさずに保ちます。
ピラミッド超少数ステップ蒸留
高解像度空間で世界モデリングを一から行うと、低解像度ですでに決まる大域構造に計算を浪費します。R2は生成を1〜2の低解像度段階と1つの高解像度段階として組織します。低解像度段階はシーン配置、被写体の動き、カメラ構造を決めます。高解像度段階はテクスチャ、エッジ、局所ディテールを復元します。粗いものから細かいものへの経路は、繰り返す高解像度計算を減らしつつ、より強い構造安定とディテールを保ちます。
まとめと制限
PixVerse R1は最初のリアルタイム動画世界モデルを提案し出荷し、動画がオフラインの固定コンテンツから、リアルタイムで対話し続けられる動的世界へ移れることを示しました。PixVerse R2はそのパラダイムがどうスケールし続けるかを解きます。統一Omni Causal ARが成長するデータ、タスク、モダリティ、時間スケールを運び、Real-Time Accelerationが完全な世界モデリング能力をリアルタイム少数ステップ推論へ持ち込みます。
R2は単点の能力アップグレードではありません。次世代リアルタイム世界モデル向けの統一訓練経路です。R1はリアルタイム動画世界モデルを現実にしました。R2はそれらを統一され、スケール可能で、継続的に改善する段階へ置きます。
厳しいリアルタイム計算とインタラクション遅延予算の下では、現在の単回生成品質は、特に複雑なシーンディテール、動きの自然さ、物理一貫性、長時間実行の安定性で、先行するオフライン動画モデルに対してまだ改善余地があります。これらのギャップは、枠組みそのものの天井というより、R2の現在のスケーリング段階を反映することが多いです。
アーリーアクセス
2026年8月23日時点で、本レポートは PixVerse R2 をクローズドテストとして記していました。2026年9月22日、PixVerse はこれらの世界のコレクションを world.pixverse.video で探索できると発表しました。R2公開のお知らせを参照してください。
この発表は、制限のない API アクセスを開放するものではありません。PixVerse世界モデルR2体験フォーム は、先行体験と API アクセスを申請する経路のままです。
関連リソース
- PixVerse R1解説:リアルタイムAI動画世界モデル
- PixVerse Game Engine徹底解説
- PixVerseがR1をShared Worldsで更新
- リアルタイムAI動画生成ガイド
- PixVerseがSeries Cエクステンションをクローズ
2026年9月22日の発表にある世界は world.pixverse.video で探索できます。API アクセスは引き続き上記フォームから申請します。今日から PixVerse V6とR1 で作成することもできます。