PixVerse R2:擴充即時全能世界模型
PixVerse R1 提出並落地了首個即時影片世界模型,把影片生成從一次性交付固定片段,變成持續執行的世界。模型可以持續接收使用者輸入、即時更新世界狀態,並流式輸出與互動保持一致的同步音影片。R1 證明這一技術範式可以成立。
PixVerse R2 回答下一個問題:即時影片世界模型如何持續擴充。R2 聚焦兩個目標。第一,構建能在長時域上持有統一狀態的動態世界,把完整時空先驗轉化為只向前推進的世界演化。第二,持續把來自文本、參考、音訊與動作的物理因果與互動訊號內化進單一模型,使世界能在流式同步音影片的同時生成、接收控制並更新狀態。
圍繞這些目標,R2 把模型、資料、任務、控制訊號與時間尺度的增長,轉化為生成品質、長程一致性與多模態控制的提升。
整體框架
R2 把系統收斂為兩層核心:Omni Causal AR 與 Real-Time Acceleration(即時加速)。Omni Causal AR 持續擴充高質量、多模態、長時域的世界生成。即時加速在嚴格的互動延遲預算下,儘可能無損地繼承這些能力。路徑很清晰:先抬高世界模型的能力上限,再把該能力加速到即時、可互動的工作區間。
更早的長影片與即時管線通常串聯許多訓練階段:把雙向模型轉成 AR 模型,從任務特定的雙向模型構建蒸餾教師,跑 DMD 蒸餾,再加 self-rollout DMD 以彌合訓練-推理差距。每個階段都要重新遷移能力、重新對齊目標、重新擬合數據分佈。畫質、運動、條件遵循與長時域穩定性可能在這些轉移中被侵蝕。隨著模型、資料與任務規模增長,多階段管線會拆散最佳化目標,並抬高訓練成本與系統複雜度。
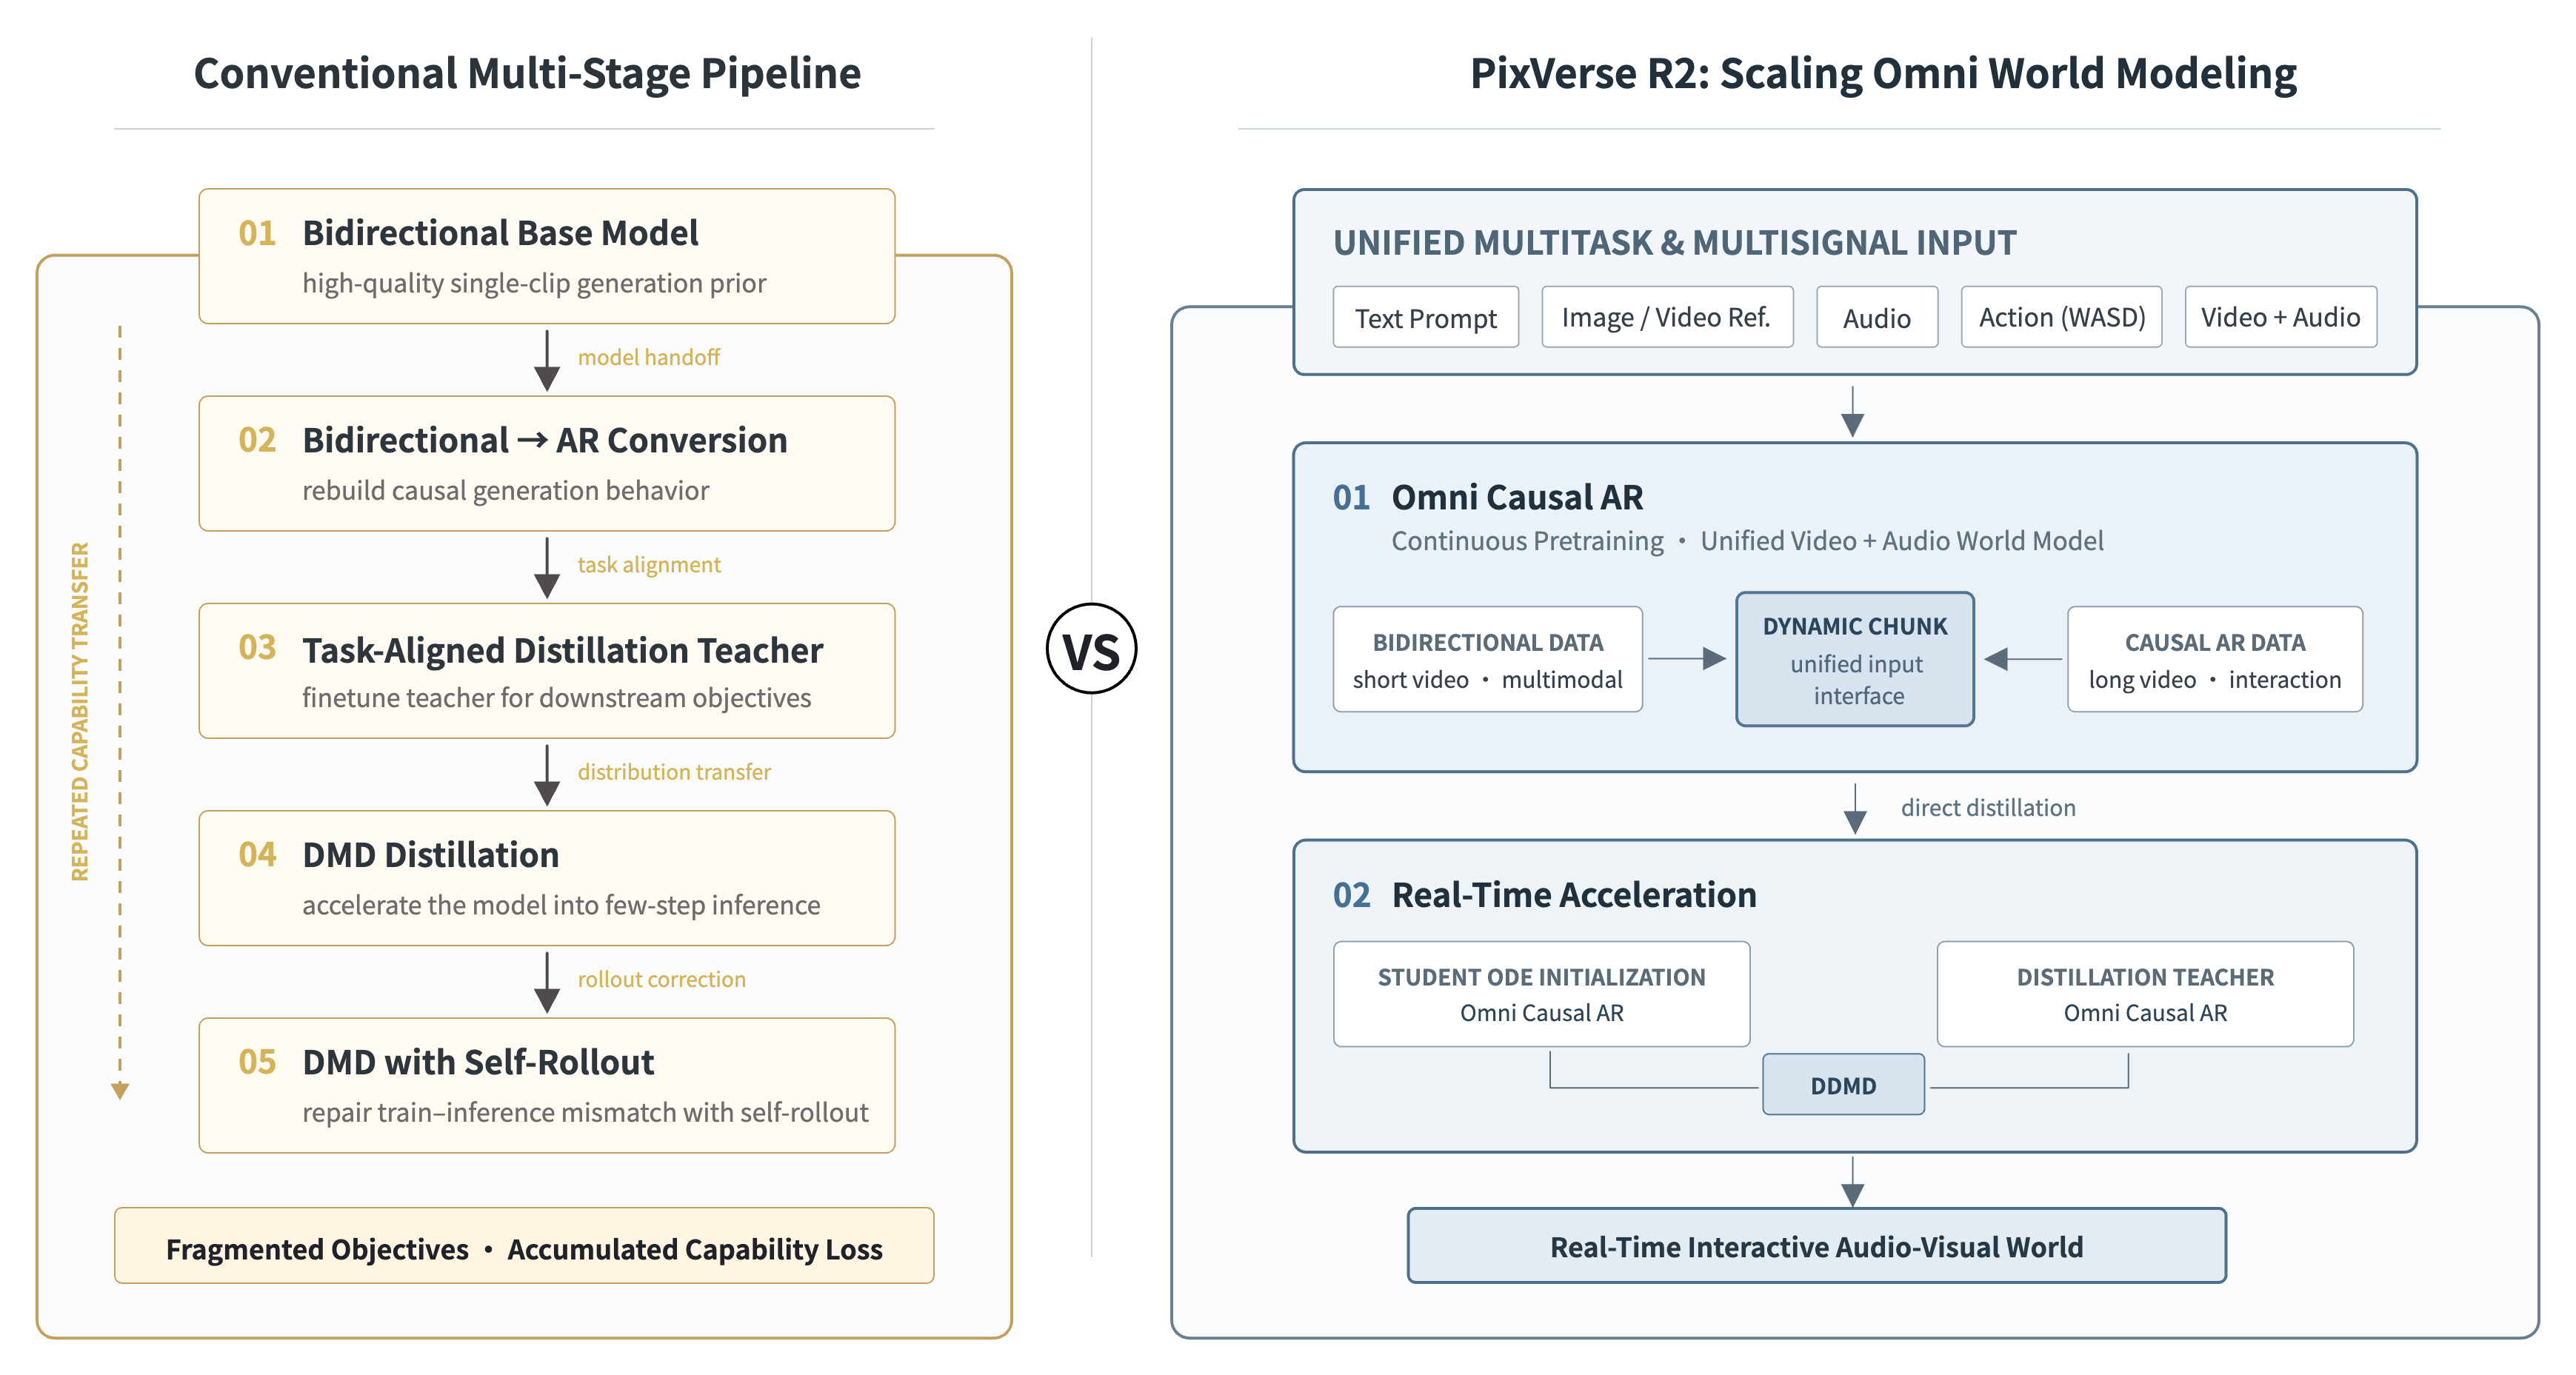
圖 1. 傳統多階段管線對比 PixVerse R2 擴充世界建模。R2 把能力擴充與即時蒸餾收斂為 Omni Causal AR 與即時加速層,在同一框架中統一多工、多訊號與長影片建模。
PixVerse R2 提出即時世界模型的統一訓練範式。它不再在許多模型與任務階段之間反覆遷移能力,而是把複雜管線收成兩條可持續擴充的過程:持續預訓練持有統一世界狀態的 Omni Causal AR,再直接蒸餾成能即時生成、同時繼承空間一致性與長時域建模的加速模型。
更少的階段邊界,減少來自獨立教師、任務對齊與反覆模型轉移的能力損失。新資料、任務、控制訊號與模型規模,可以更直接地轉化為即時世界建模能力。
階段 1:Omni Causal AR 的持續預訓練。 R2 不再把雙向生成先驗與長影片 AR 當作兩個斷開的階段。它在雙向模型能力之上,持續訓練統一的 Omni Causal AR。動態分塊讓不同資料形態共享時間表徵:模型可以吸收雙向預訓練中的高質量短影片與多模態資料,也可以擴充到連續長影片與多輪互動軌跡。畫質、視聽表達、長時域生成與多訊號控制可以在同一模型內擴充,而不必通過反覆轉換重新遷移。
階段 2:從已擴充的 Omni Causal AR 蒸餾即時加速層。 持續預訓練讓 Omni Causal AR 同時具備高質量生成、穩定的長時域狀態傳遞,以及真實因果 rollout。R2 隨後用同一個 Omni Causal AR 同時做學生 ODE 初始化與蒸餾教師,使教師、學生與真實 AR 推理共享一致的因果建模基礎。即時蒸餾變成「對已有世界模型做少步加速」,而不是「重新學習一個長時域世界」。
Omni Causal AR
R2 延續 R1 已驗證的多模態輸入、自迴歸生成與即時互動路徑,再把這些能力集中到統一的 Omni Causal AR 訓練路線。Omni Causal AR 把完整時空生成先驗轉化為只向前推進的世界狀態傳遞。通過因果化與持續預訓練,模型在保持畫面、運動、音訊與多模態語義能力的同時,學會僅憑歷史預測下一個同步視聽塊。
當訓練物件從獨立短影片擴充到連續長影片與多輪互動軌跡時,模型逐步在歷史世界狀態、當前互動輸入與未來世界演化之間建立長期因果。
模型聯合接收文本提示詞、多模態參考、動作訊號(例如 WASD 或連續控制)與音訊,並輸出同步影片與音訊。不同控制訊號可以在執行中持續進入模型,並改變後續世界狀態。R2 不只是響應一次性條件;它可以同時生成、接收控制並更新世界。
為了讓因果生成在同一世界中長時執行,R2 應對四個問題:訓練-推理分佈差距、對噪聲歷史的魯棒性、長期與近期記憶的協調,以及錯誤狀態的校正。Hybrid Teacher / Diffusion Forcing 讓模型同時適應乾淨與帶噪歷史。Multi-Timescale Memory 聯合儲存世界錨點、近期動態與物體狀態。Error Bank 把失敗狀態帶回訓練。它們共同構成長期世界狀態的訓練迴圈,並減少畫面、角色、運動、視聽關係與控制響應隨時間的漂移。
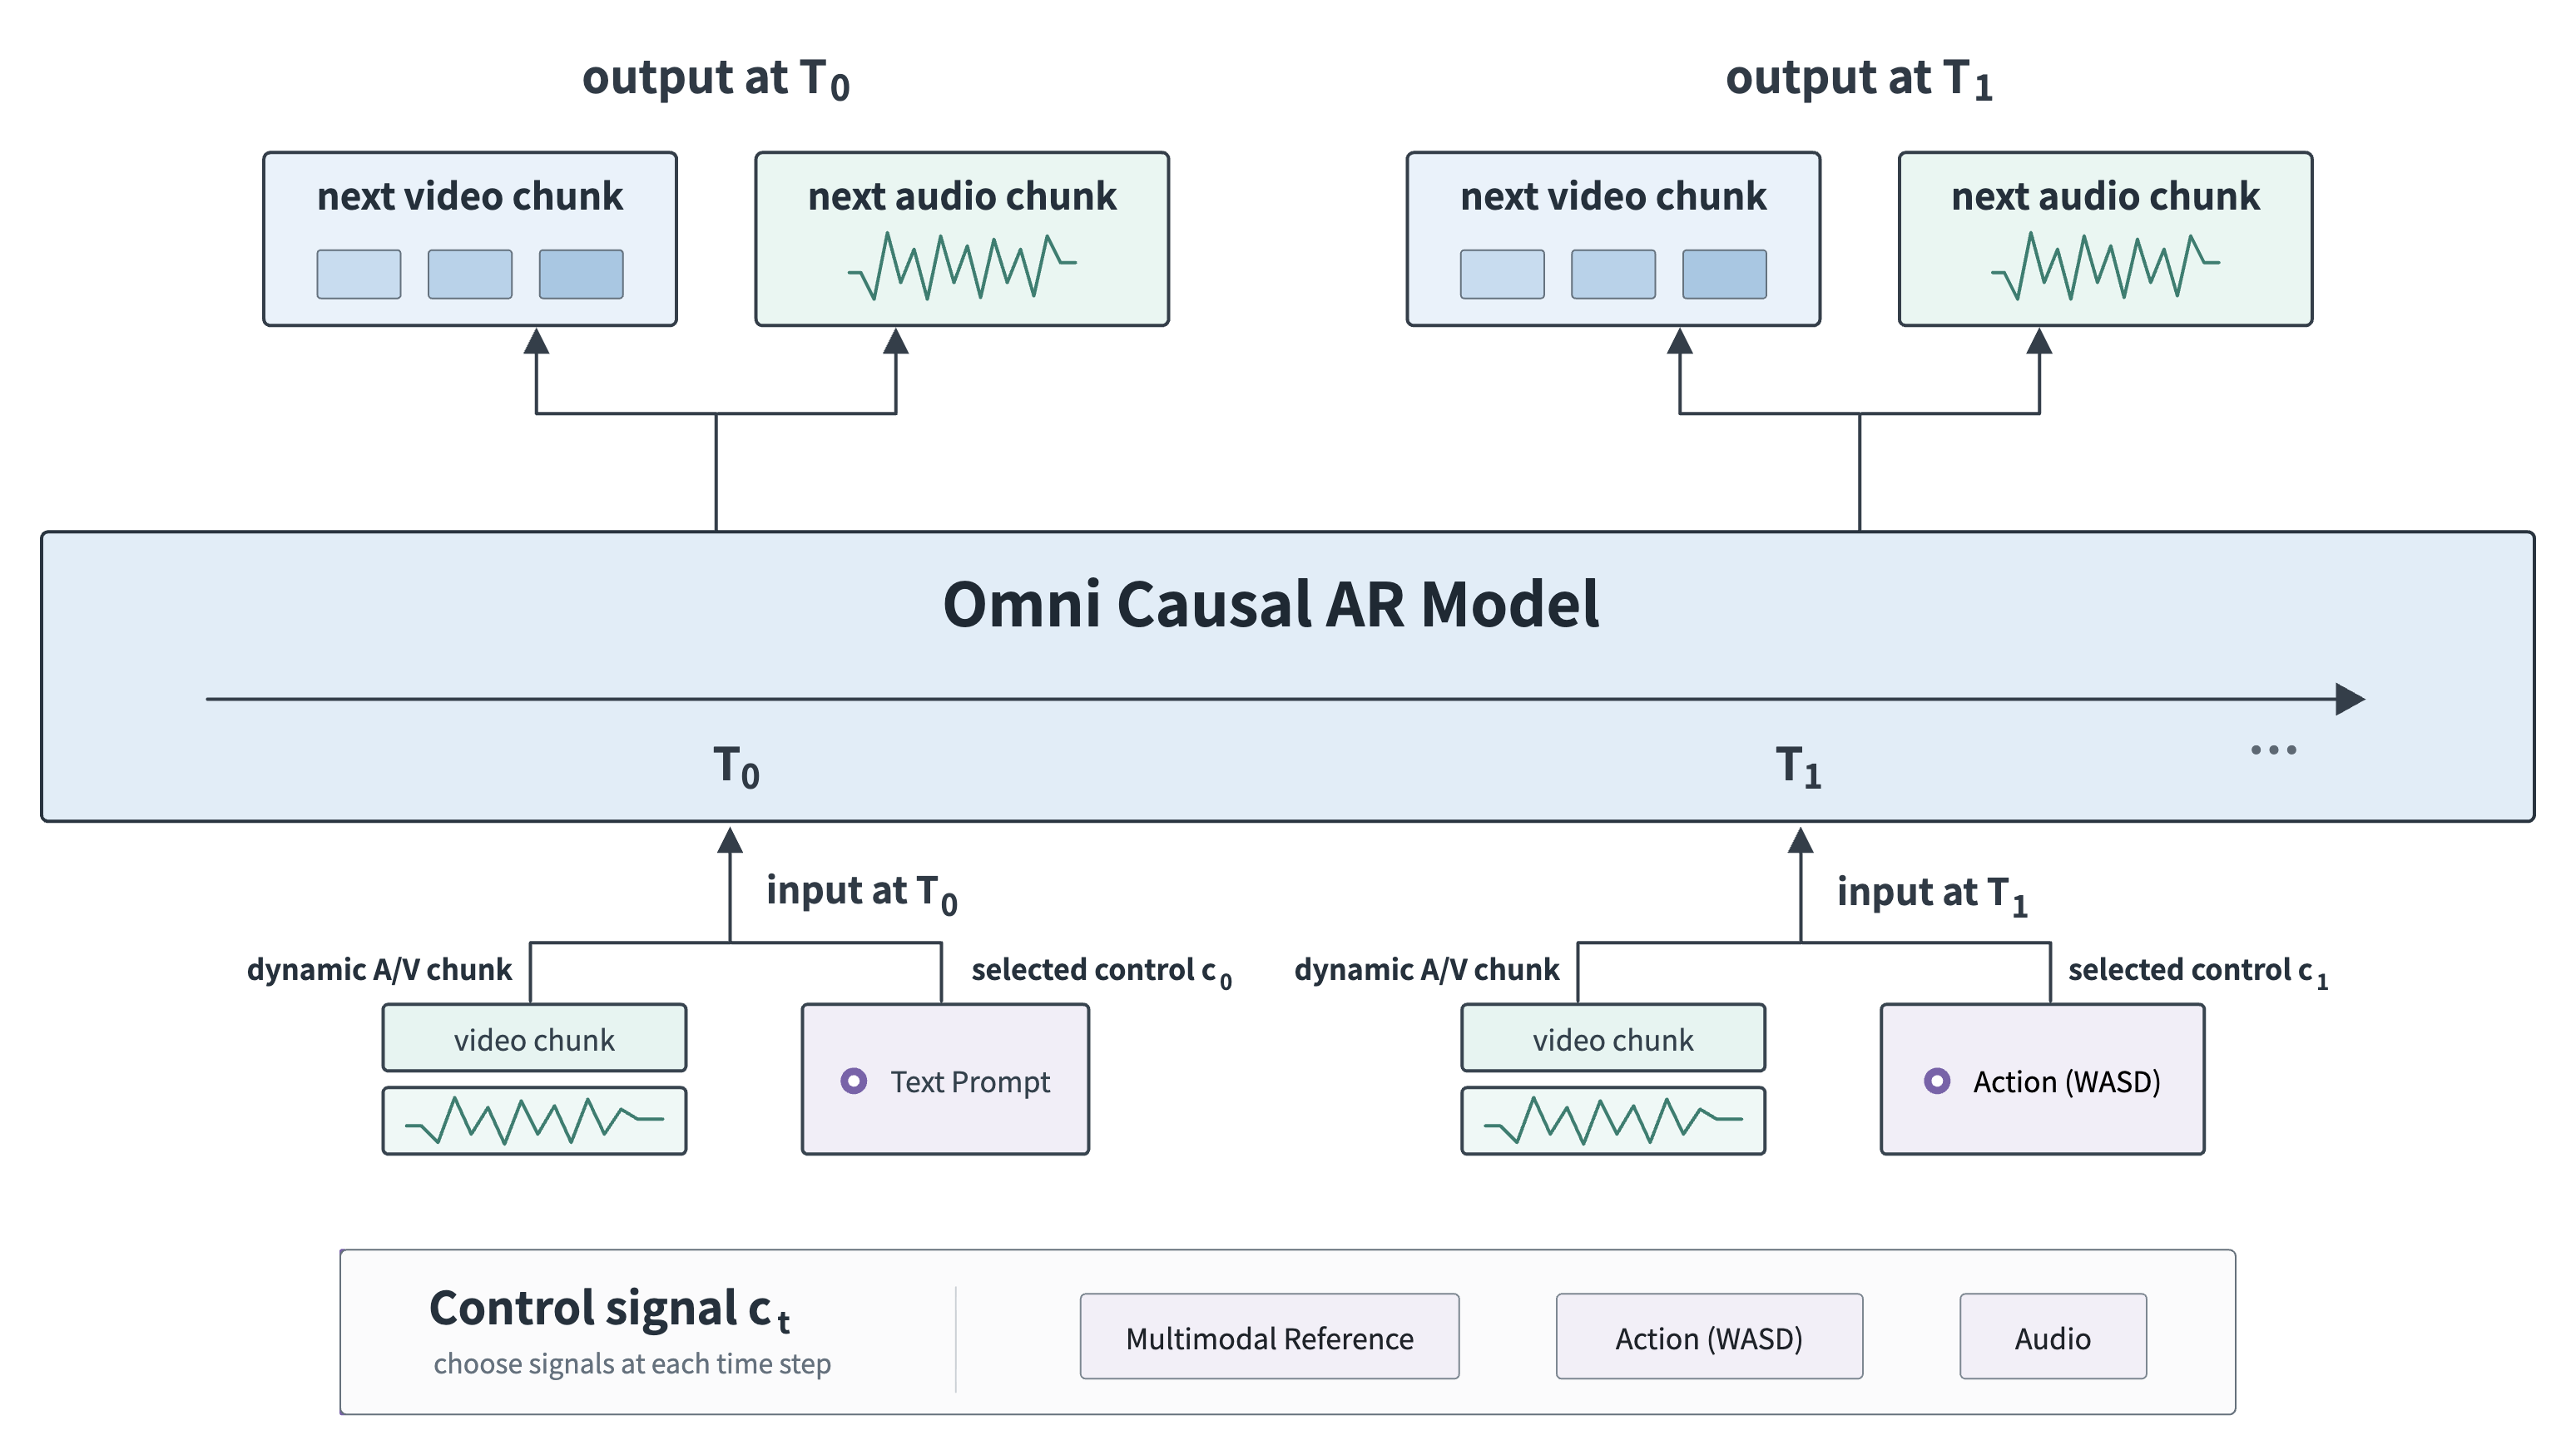
圖 2. PixVerse R2 Omni Causal AR。模型可以在執行中持續接收不同控制訊號。在每個互動時刻,活動訊號與匹配粒度的動態視聽塊對齊,並驅動下一段影片與音訊。
動態分塊生成
不同控制訊號生活在不同時間尺度上。提示詞與參考通常描述完整語義或更長事件。動作(WASD)需要細粒度、即時的狀態反饋。音訊同時攜帶語義、節奏與時間同步。若把每種輸入都強行塞進固定時長單元,模型往往必須在響應速度與表達完整性之間取捨。
Dynamic Chunk 是 R2 統一這些互動時間尺度的方式。R2 按當前控制訊號的語義邊界與時長自適應切分視聽序列,並用最大分塊尺寸約束計算與訓練穩定性。短塊提升動作與區域性指令的響應精度。長塊保住事件、運動與視聽語義的完整結構。不同任務與控制訊號可以共享同一因果生成介面,而不必切換模型結構。
Hybrid Teacher Forcing / Diffusion Forcing
長時域 AR 的核心張力在於:訓練歷史通常更乾淨,而真實執行時歷史包含模型自身的噪聲與區域性錯誤。只在乾淨歷史上訓練可以提高單步質量上限,但會讓模型對小偏差過於敏感。只在擾動歷史上訓練則可能傷害畫質、運動與控制響應。
R2 在同一訓練過程中混合乾淨歷史與帶噪歷史。乾淨歷史穩住世界演化的質量上限。帶噪歷史讓模型提前適應部署時會看到的不完美狀態。互補訓練縮小訓練-推理差距,使模型既能生成高質量的下一段世界,又能在歷史已含小誤差時繼續向前滾動。
Causal Attention Mask 與 Relative Temporal RoPE 共同約束當前狀態可讀哪些歷史,以及這些歷史落在當前視窗的何處。Attention Mask 強制嚴格因果可見性。Temporal RoPE 不會隨全域性 block ID 無界增長;它按當前注意力視窗內的相對槽位重新索引。當滾動視窗向前移動時,真即時間繼續前進,但 sink 記憶、近期歷史與當前塊仍被對映到穩定、有界的相對位置範圍。
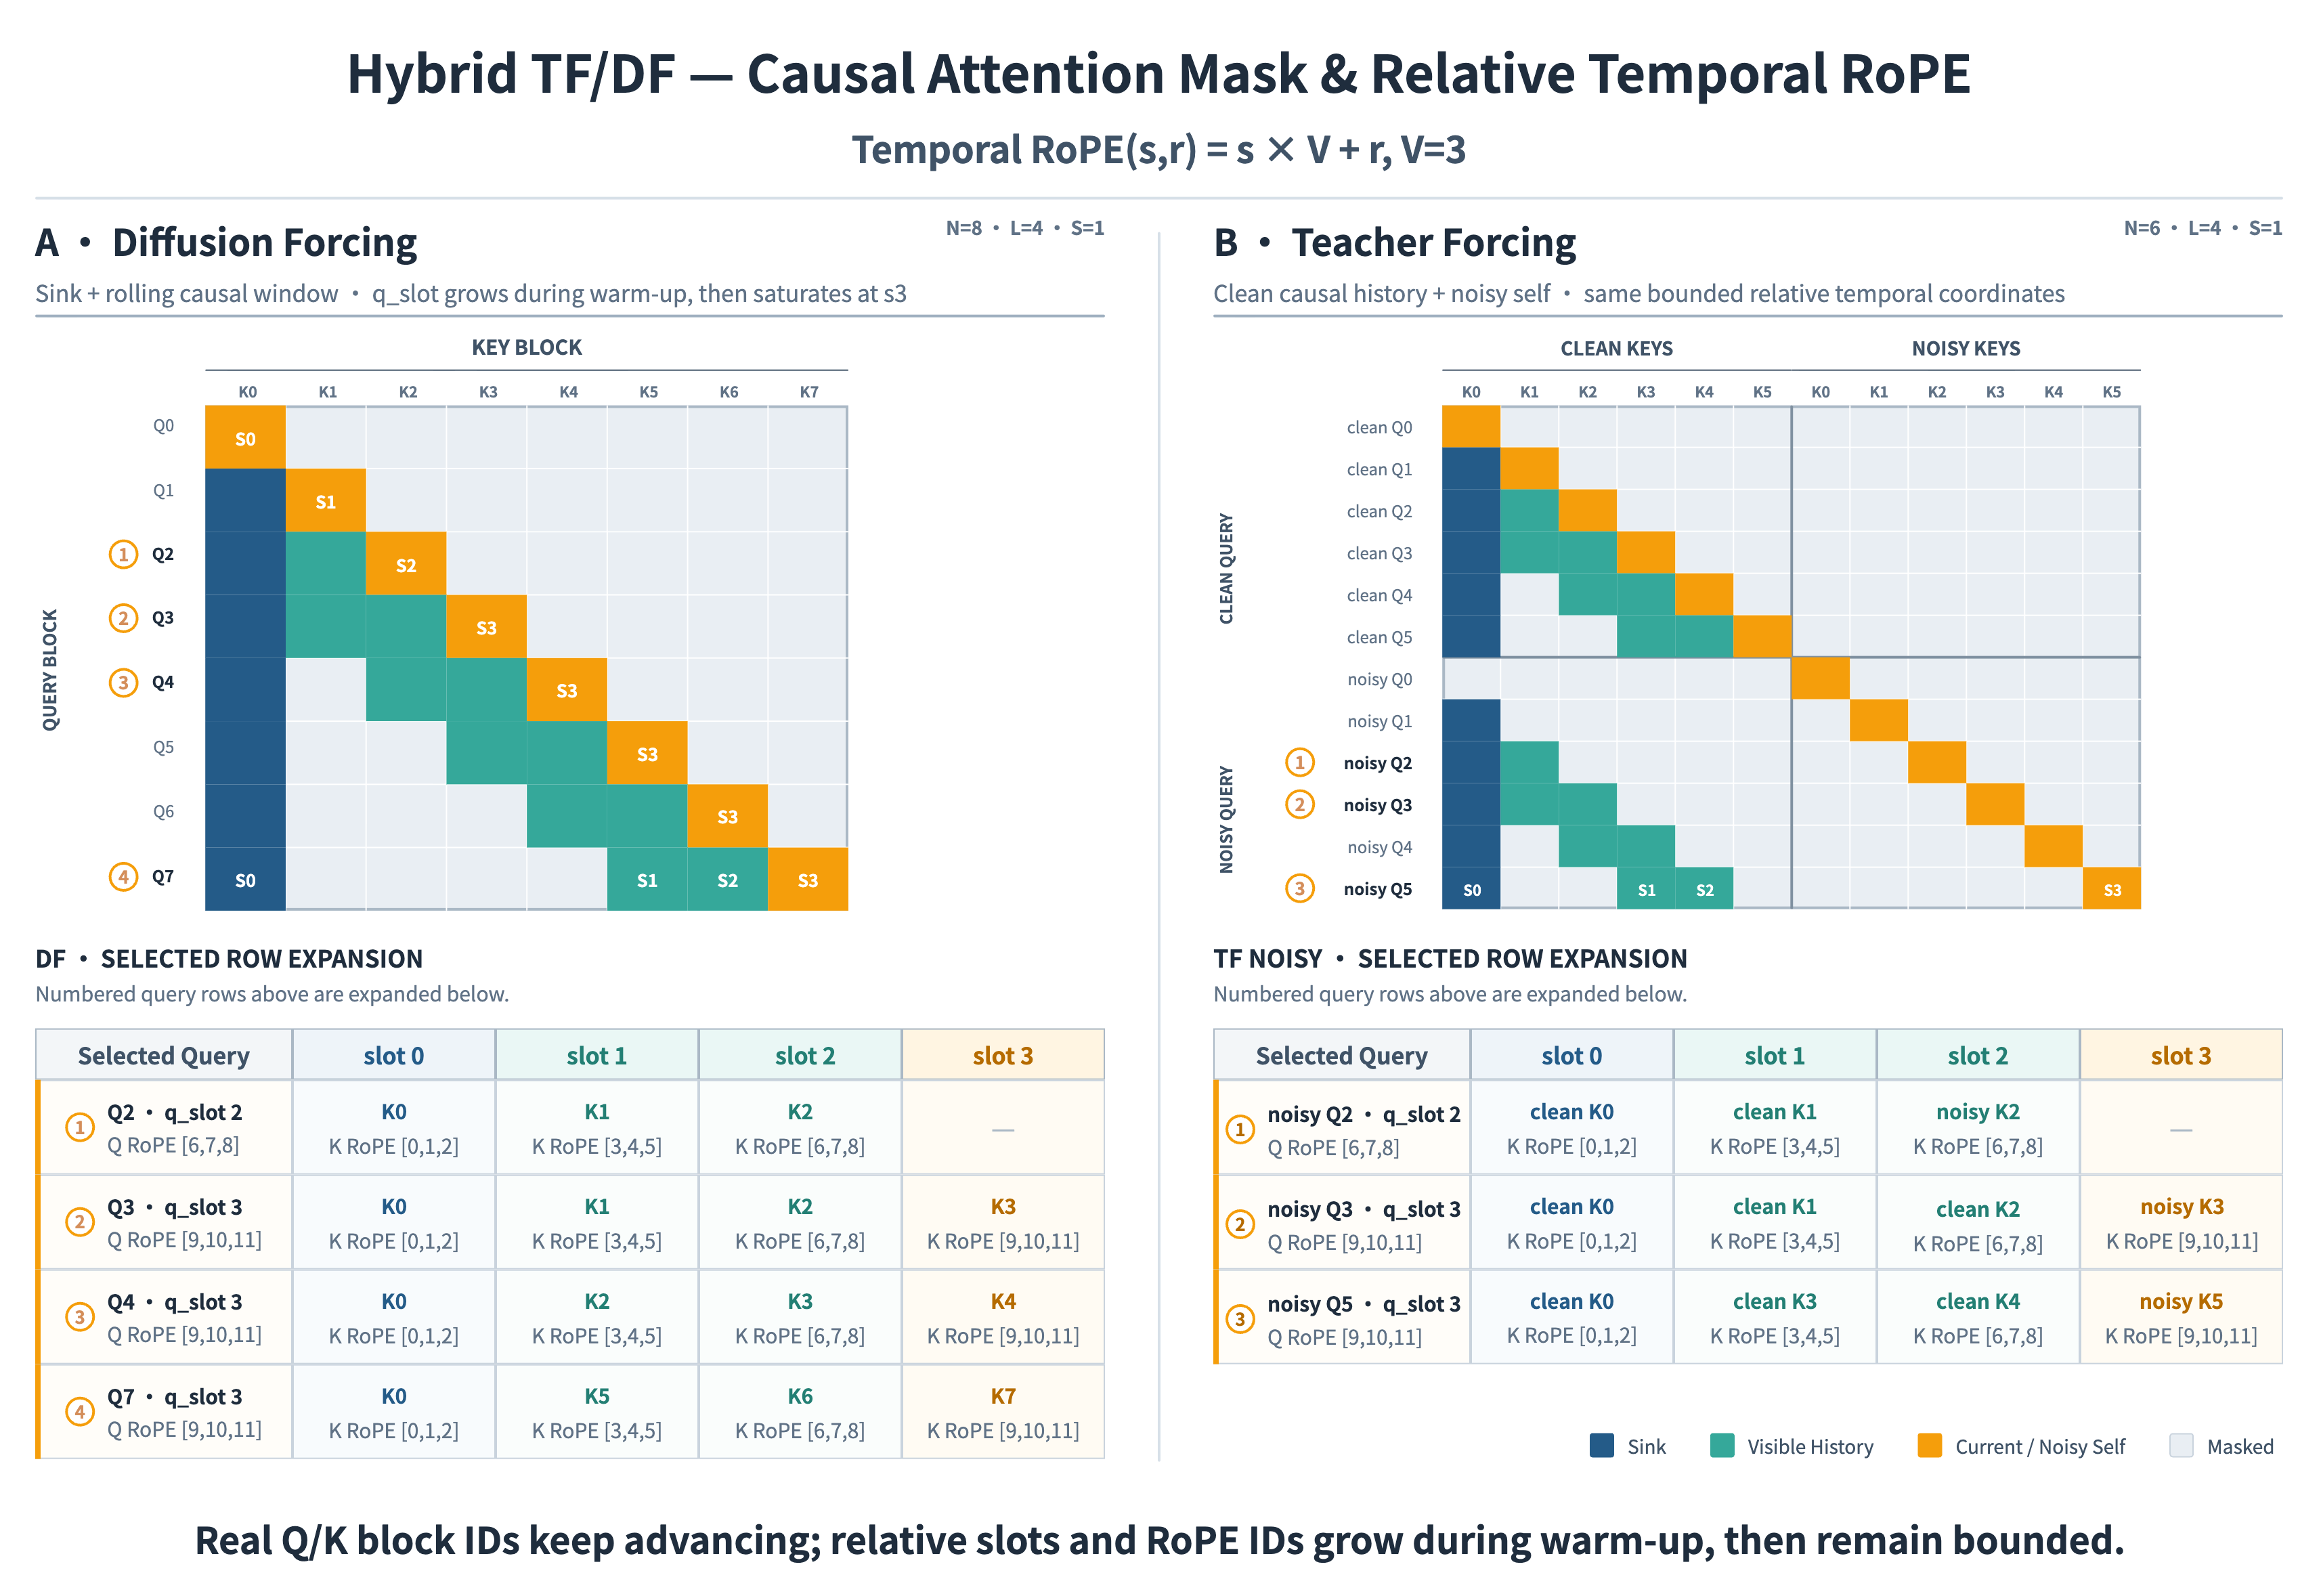
圖 3. Hybrid Teacher / Diffusion Forcing 的統一因果注意力掩碼與相對時間 RoPE。上圖展示兩種歷史構造的因果可見性。下圖把代表性查詢對映到 Q/K 塊、相對槽位與 RoPE ID,顯示真實 block ID 持續前進,而視窗內時間座標保持有界。
多時間尺度記憶
長期世界建模不能簡單記住全部歷史。無界歷史會迅速抬高計算與記憶體成本;過度裁剪則會丟掉角色身份、場景設定與關鍵事件。R2 用 Sink Memory、Rolling History 與 Object KV Cache 構建多尺度記憶系統。
- Sink Memory 儲存角色、場景、風格與世界規則等長期錨點。
- Rolling History 聚焦近期動作、姿態、鏡頭與環境變化,讓區域性狀態能自然銜接。
- Object KV Cache 複用並壓縮已計算的物體級歷史表徵,在有限預算內保留真正影響後續演化的狀態。
三者共同給出長期身份穩定、短程運動連續與可控執行時成本,並減少角色漂移、場景跳變、跨塊閃爍與動作斷裂。
Error Bank
AR 世界模型中的嚴重漂移,往往始於寫入歷史並隨後被繼承的早期小誤差。R2 構建 Error Bank,把代表性錯誤歷史存為可複用樣本,並在訓練中按設定比率回放到正常歷史。模型不再只學習如何從理想狀態繼續,也學習如何識別、吸收並修復已經漂移的歷史。
在分階段評估中,長期亮度漂移指標從 0.201 降至 0.129,約下降 35.8%。29 個長序列樣本中有 20 個改善,全部 5 個明確應保持靜止的樣本都減少了錯誤運動。
即時加速
R2 的即時加速不是在少步模型裡重新學習一個長時域世界。它加速的是已經能長時間穩定執行的世界模型。加速層從持續預訓練的 Omni Causal AR 出發,並用它同時做學生 ODE 初始化與蒸餾教師,使教師、學生與真實 AR 推理共享一致的因果軌跡分佈。
這一統一因果起點減少對 Self-Forcing 與 Rolling Forcing 類調參的依賴。即時加速可以聚焦少步速度真正引入的問題:帶對抗正則的 DDMD 處理蒸餾中的條件對齊、生成分佈與真實感;塊稀疏注意力 壓縮長上下文計算;金字塔 路徑降低高解析度生成成本。
帶對抗正則的 DDMD
在超少步生成中,條件對齊、分佈匹配與真實感並不是同一最佳化問題。R2 基於 DDMD,並進一步引入來自 DMD2 的對抗正則。三個訓練訊號在同一個學生中匯合:條件對齊強化控制,分佈匹配保住教師分佈,對抗正則錨定真實資料,使少量取樣步既能保持準確的互動響應,也能保持可信世界。
塊稀疏注意力
R2 在時空 token 序列上使用塊稀疏注意力。模型把 Q、K、V 切成計算塊,快速估計每個查詢塊最需要哪些鍵/值塊,只保留得分最高的連線,並在這些選定塊上執行精確 softmax 注意力。塊級路由不是隨機剪枝;它把計算集中在當前多模態控制、近期運動與關鍵世界狀態之間的強依賴上。
通過在訓練中讓模型適應稀疏連線結構,R2 把注意力稀疏度提高到 90% 以上,同時在當前評估中保持畫質、動作連續、條件遵循與長時域穩定性,沒有明顯下降。
金字塔超少步蒸餾
在高解析度空間從頭做全部世界建模,會把計算浪費在低解析度已經能確定的全域性結構上。R2 把生成組織為一到兩個低解析度階段加一個高解析度階段。低解析度階段設定場景佈局、主體運動與鏡頭結構。高解析度階段恢復紋理、邊緣與區域性細節。由粗到細的路徑減少重複的高解析度計算,同時保持更強的結構穩定性與細節。
結語與限制
PixVerse R1 提出並落地了首個即時影片世界模型,表明影片可以從離線固定內容,走向能即時互動並持續執行的動態世界。PixVerse R2 接著解決這一範式如何持續擴充:統一的 Omni Causal AR 承載增長的資料、任務、模態與時間尺度,即時加速把完整世界建模能力帶入即時少步推理。
R2 不是單點能力升級。它是下一代即時世界模型的統一訓練路徑。R1 讓即時影片世界模型成為現實。R2 把它們放進統一、可擴充、持續改進的階段。
在嚴格的即時計算與互動延遲預算下,當前單次生成品質相對領先離線影片模型仍有提升空間,尤其是在複雜場景細節、運動自然度、物理一致性與長時執行穩定性上。這些差距更常反映 R2 當前的擴充階段,而不是框架本身的上限。
搶先體驗
2026 年 8 月 23 日,本報告將 PixVerse R2 描述為封閉測試。2026 年 9 月 22 日,PixVerse 宣佈這些世界的精選集合已可在 world.pixverse.video 開放探索。詳見 R2 釋出公告。
該公告並不開放不受限制的 API。PixVerse 世界模型 R2 體驗表單 仍是申請搶先體驗與 API 權限的請求途徑。
相關資源
- PixVerse R1 解析:即時 AI 影片世界模型
- PixVerse Game Engine 深度解析
- PixVerse 更新 R1:共享世界
- 即時 AI 影片生成指南
- PixVerse 完成 C 輪追加融資
2026 年 9 月 22 日公告中的世界已可在 world.pixverse.video 開放探索。API 權限仍須通過上方表單申請,也可以立即用 PixVerse V6 與 R1 開始創作。