PixVerse R2 : Le passage à l'échelle des modèles de monde Omni en temps réel
PixVerse R1 a inauguré et déployé le premier modèle de monde vidéo en temps réel, transformant la génération vidéo : d’un rendu figé et ponctuel d’un clip, elle est devenue un univers dynamique en perpétuelle exécution. Le modèle peut recevoir en continu les actions de l’utilisateur, actualiser l’état du monde en temps réel et diffuser un flux audiovisuel parfaitement synchronisé et cohérent avec chaque interaction. R1 a démontré la viabilité pratique de cette approche.
PixVerse R2 franchit l’étape suivante : comment faire évoluer à grande échelle un modèle de monde vidéo en temps réel. R2 poursuit deux objectifs majeurs. Premièrement, construire un monde dynamique capable de maintenir un état unifié sur de longues durées, convertissant des a priori spatio-temporels complets en une évolution du monde strictement orientée vers l’avenir. Deuxièmement, intégrer de manière continue la causalité physique et les signaux d’interaction (texte, références visuelles, audio et commandes d’action) au sein d’un modèle unique, de sorte que l’univers puisse générer des images, intégrer des commandes et mettre à jour son état simultanément tout en diffusant un flux audio et vidéo synchronisé.
Autour de ces axes, R2 transforme la montée en puissance du modèle, des données, des tâches, des signaux de contrôle et des échelles temporelles en gains directs de qualité de génération, de cohérence sur le long terme et de maîtrise multimodale.
Architecture globale
R2 simplifie le système en deux couches fondamentales : Omni Causal AR et l’Accélération Temps Réel. Omni Causal AR étend en continu la génération de mondes multimodaux et pérennes en haute fidélité. L’Accélération Temps Réel hérite de ces facultés de façon quasi intégrale, dans le respect d’un budget strict de latence d’interaction. La démarche est claire : repousser le plafond des capacités du modèle de monde, puis adapter cette puissance à un environnement d’exécution interactif en temps réel.
Les anciens pipelines de vidéos longues en temps réel enchaînaient généralement de multiples phases d’entraînement : conversion d’un modèle bidirectionnel en modèle autorégressif (AR), construction d’un modèle enseignant de distillation dédié à chaque tâche, distillation DMD, puis ajout d’un mécanisme d’auto-déroulement DMD pour combler l’écart entre apprentissage et inférence. Chaque étape exigeait de retransférer les compétences, de réaligner les objectifs et de réadapter la distribution des données. La qualité d’image, le dynamisme, le respect des consignes et la stabilité à long terme pouvaient s’éroder lors de ces transitions successives. À mesure que les modèles et les données grandissaient, ce découpage fragmentait l’optimisation et alourdissait les coûts d’entraînement et la complexité globale.
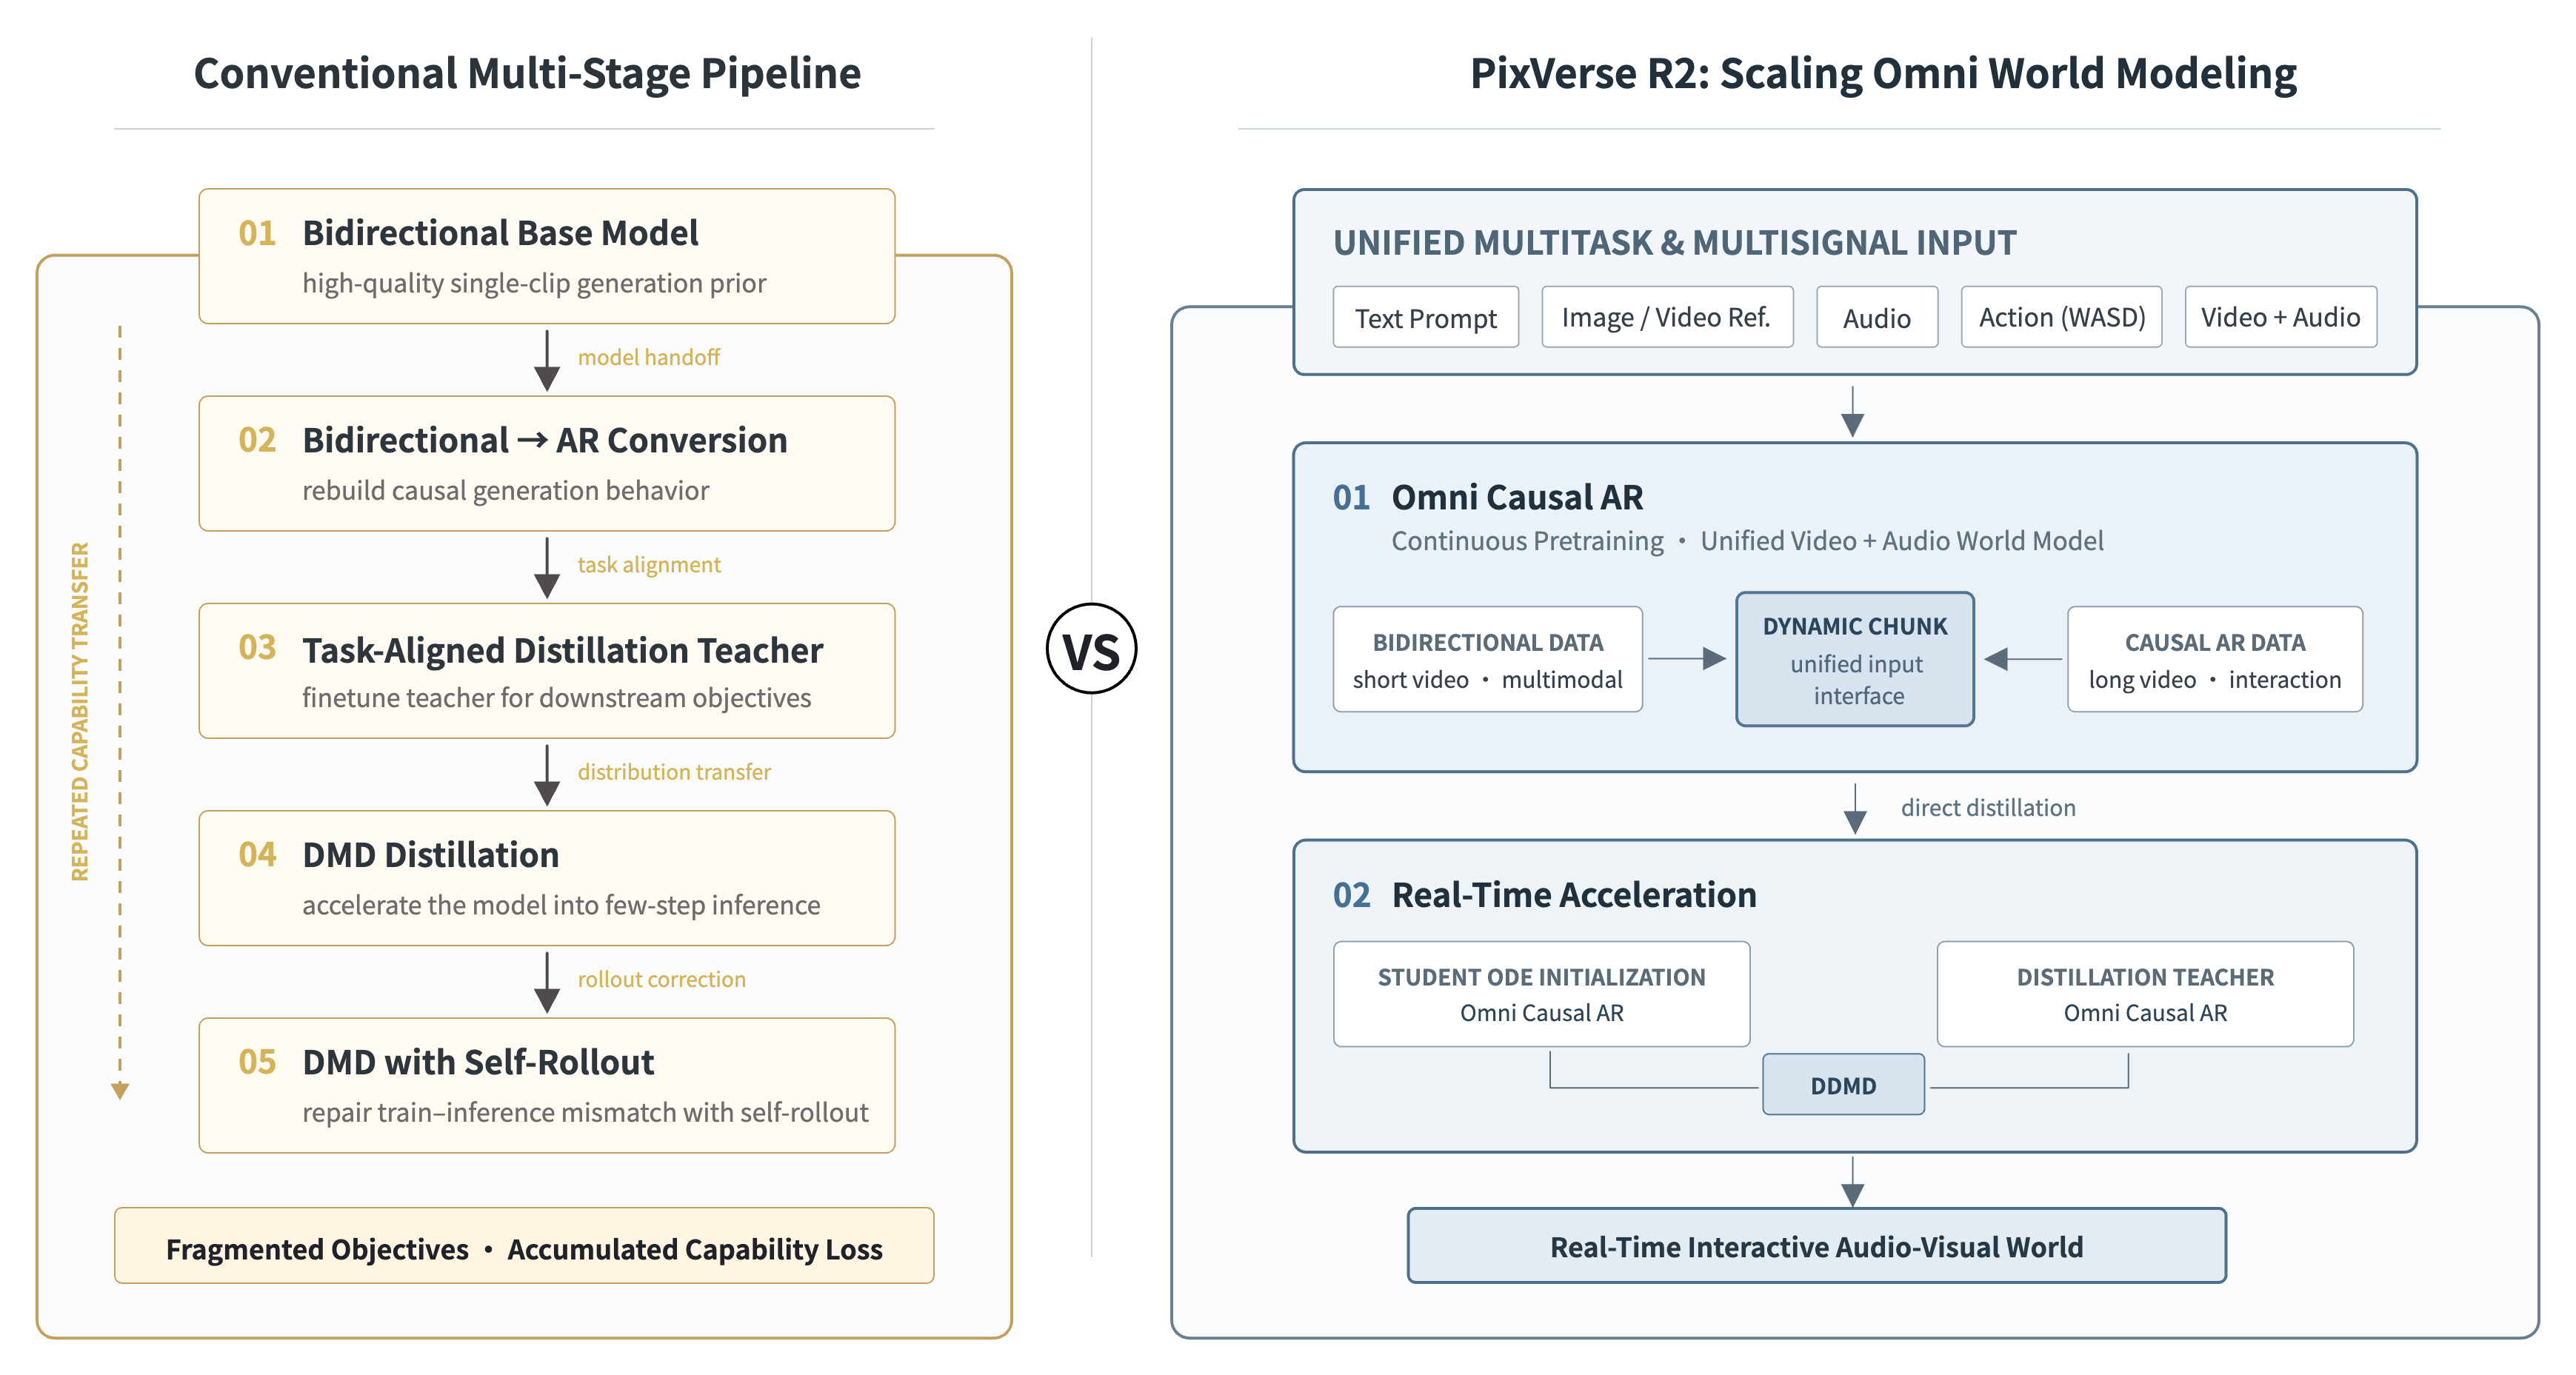
Figure 1. Pipeline multi-étapes traditionnel versus passage à l’échelle du modèle de monde PixVerse R2. R2 réunit le développement des capacités et la distillation temps réel au sein d’Omni Causal AR et d’une couche d’accélération temps réel, unifiant la modélisation multitâche, multisignal et vidéo longue dans un cadre unique.
PixVerse R2 inaugure un paradigme d’entraînement unifié pour les modèles de monde en temps réel. Au lieu de transférer péniblement les capacités d’un modèle à un autre, il condense le pipeline en deux processus évolutifs : pré-entraîner en continu un modèle Omni Causal AR maintenant un état de monde cohérent, puis le distiller directement dans un modèle accéléré capable d’opérer en temps réel tout en héritant de la cohérence spatiale et de la stabilité temporelle.
Réduire les frontières entre étapes limite les pertes de performance liées à la multiplication des modèles intermédiaires. Les nouvelles données, tâches, commandes et montées en échelle se traduisent directement en gains opérationnels pour la modélisation en direct.
Étape 1 : pré-entraînement continu d’Omni Causal AR. R2 ne considère plus les modèles bidirectionnels et les modèles AR pour vidéos longues comme deux étapes disjointes. Il entraîne en continu un modèle unifié Omni Causal AR par-dessus les capacités des modèles bidirectionnels. Le découpage en segments dynamiques (Dynamic Chunks) confère aux différentes formes de données une base temporelle commune : le modèle assimile des vidéos courtes de haute qualité et des données multimodales issues de l’apprentissage bidirectionnel, tout en s’étendant à des vidéos longues et à des trajectoires d’interactions interactives. Rendu visuel, expression sonore, maintien à long terme et contrôle multisignal progressent au cœur d’un modèle unique.
Étape 2 : distillation d’une couche d’accélération temps réel depuis Omni Causal AR. Le pré-entraînement continu dote Omni Causal AR d’une grande finesse de génération, d’une transmission d’état robuste et d’un déroulement strictement causal. R2 emploie alors ce même modèle Omni Causal AR à la fois pour l’initialisation de l’EDO du modèle élève et comme enseignant de distillation. Enseignant, élève et inférence AR partagent ainsi un socle causal parfaitement harmonisé. La distillation temps réel devient une simple accélération en quelques étapes d’un modèle de monde déjà opérationnel, et non le réapprentissage complet d’un univers pérenne.
Omni Causal AR
R2 poursuit dans la voie des entrées multimodales, de la génération autorégressive et de l’interaction en direct initiée par R1, en concentrant ces acquis dans la méthode Omni Causal AR. Ce composant convertit des a priori spatio-temporels complets en une progression causale du monde. Grâce à la causalisation et au pré-entraînement continu, le modèle préserve la qualité d’image, le mouvement, le son et la compréhension sémantique tout en apprenant à prédire le bloc audiovisuel synchronisé suivant à partir du seul historique passé.
À mesure que les données d’entraînement passent de courts clips indépendants à de longues séquences continues et des parcours d’interactions à choix multiples, le modèle tisse des liens de causalité pérennes entre l’état passé du monde, l’action présente et l’évolution future du décor.
Le modèle reçoit conjointement une consigne textuelle, des références multimodales, des actions utilisateur (par exemple les touches WASD ou un contrôle continu) et une piste audio, pour produire simultanément un flux vidéo et audio synchronisé. Différents signaux de contrôle peuvent intervenir à tout instant pendant la session et infléchir l’évolution de l’univers. R2 ne se contente pas de répondre à une commande ponctuelle : il génère, intègre les ordres et fait évoluer le monde de front.
Pour garantir une génération causale stable dans un univers pérenne, R2 surmonte quatre difficultés majeures : le fossé de distribution entre entraînement et inférence, la tolérance aux imperfections de l’historique, la coordination entre mémoires récente et lointaine, et la rectification des états dégradés. L’association Hybrid Teacher / Diffusion Forcing permet au modèle de s’accommoder d’historiques parfaits comme de contextes bruités. Le système Multi-Timescale Memory conserve les points d’ancrage essentiels, les dynamiques récentes et l’état des objets. La banque d’erreurs (Error Bank) réinjecte quant à elle les dérives rencontrées dans l’entraînement. Ensemble, ces mécanismes assurent une stabilité remarquable du monde, prévenant les déformations visuelles, les ruptures de ton et les retards de réaction aux commandes.
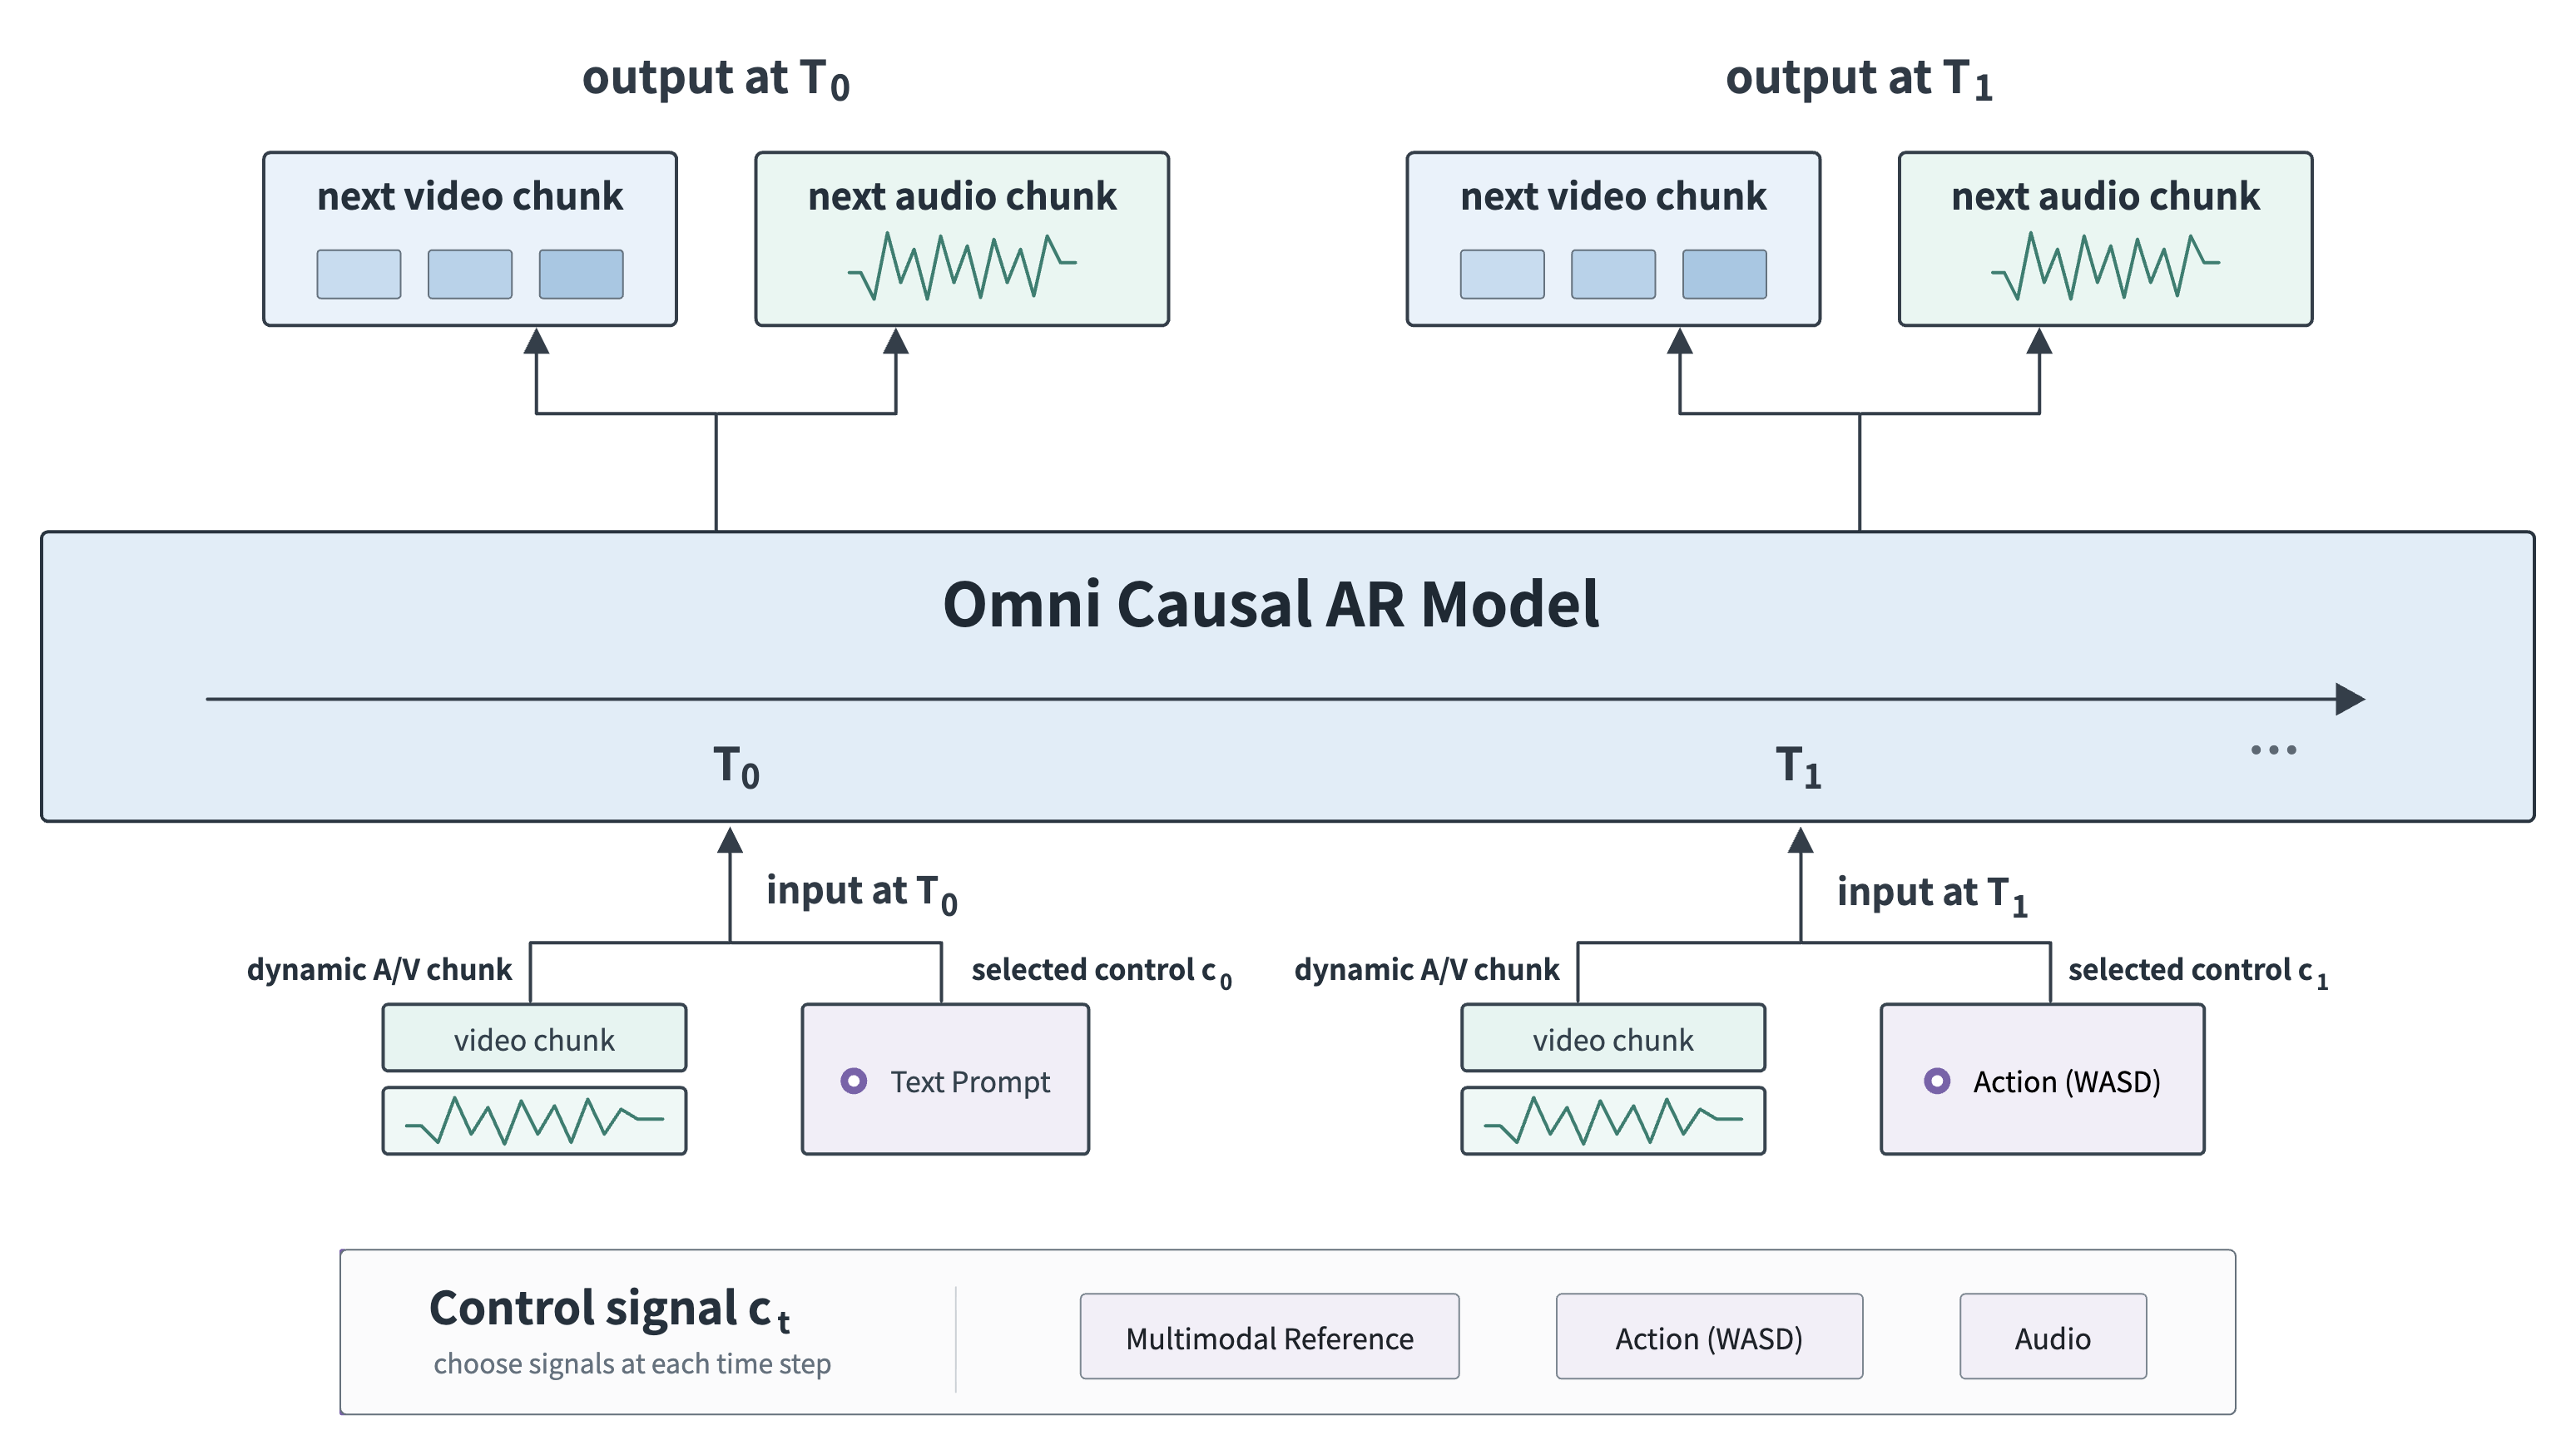
Figure 2. PixVerse R2 Omni Causal AR. Le modèle peut recevoir en continu divers signaux de contrôle durant son exécution. À chaque moment d’interaction, la commande active s’articule avec un bloc audiovisuel dynamique à la granularité adaptée pour guider le segment visuel et sonore suivant.
Génération par blocs dynamiques (Dynamic Chunks)
Les différents signaux d’interaction s’inscrivent dans des temporalités dissemblables. Les prompts et références traduisent souvent une sémantique d’ensemble ou des scènes étendues. Les commandes motrices (WASD) exigent un retour immédiat et chirurgical. Le son rassemble à la fois message, pulsation et synchronisme précis. Si chaque donnée d’entrée était contrainte dans un créneau de temps uniforme, le système devrait nécessairement sacrifier la vivacité de réaction ou la richesse d’expression.
Le Dynamic Chunk permet à R2 de concilier ces rythmes hétérogènes. Le modèle découpe les flux audiovisuels de manière adaptative en tenant compte du sens et de la durée du signal de contrôle actif, sous le contrôle d’une taille maximale de bloc préservant la stabilité du calcul. Les segments courts maximisent la réactivité aux sollicitations directes. Les segments longs préservent la structure des événements complexes et la continuité sonore. Les différents usages partagent une même interface causale sans exiger de modification architecturale.
Hybrid Teacher Forcing / Diffusion Forcing
Le dilemme classique de l’apprentissage autorégressif à long terme tient au décalage entre des données d’entraînement rigoureusement propres et un historique réel en cours d’exécution altéré par le bruit et les approximations du modèle. N’entraîner le modèle que sur des données parfaites élève la qualité ponctuelle mais le rend hypersensible au moindre écart. Ne l’entraîner que sur des données corrompues dégrade la netteté, l’animation et l’obéissance aux commandes.
R2 associe données pures et contextes dégradés au sein d’une seule boucle d’apprentissage. L’historique propre stabilise le niveau d’excellence visuelle. L’historique altéré habitue le modèle à corriger de lui-même les petites incohérences qu’il croisera inévitablement en situation réelle. Cet apprentissage croisé réduit l’écart entre conception et utilisation, permettant au système d’engendrer la suite des événements avec brio, même lorsque le passé immédiat comporte une légère imperfection.
Le masque d’attention causale (Causal Attention Mask) et l’encodage RoPE temporel relatif (Relative Temporal RoPE) régulent la visibilité des données antérieures au sein de la fenêtre de traitement. Le masque impose une stricte visibilité causale. Le RoPE temporel ne grandit pas sans limite au fil du temps : il est réindexé de façon relative à l’intérieur de la fenêtre active. Lorsque celle-ci avance, le temps réel progresse, mais la mémoire d’ancrage, le passé récent et le segment en cours demeurent indexés sur un intervalle relatif parfaitement maîtrisé.
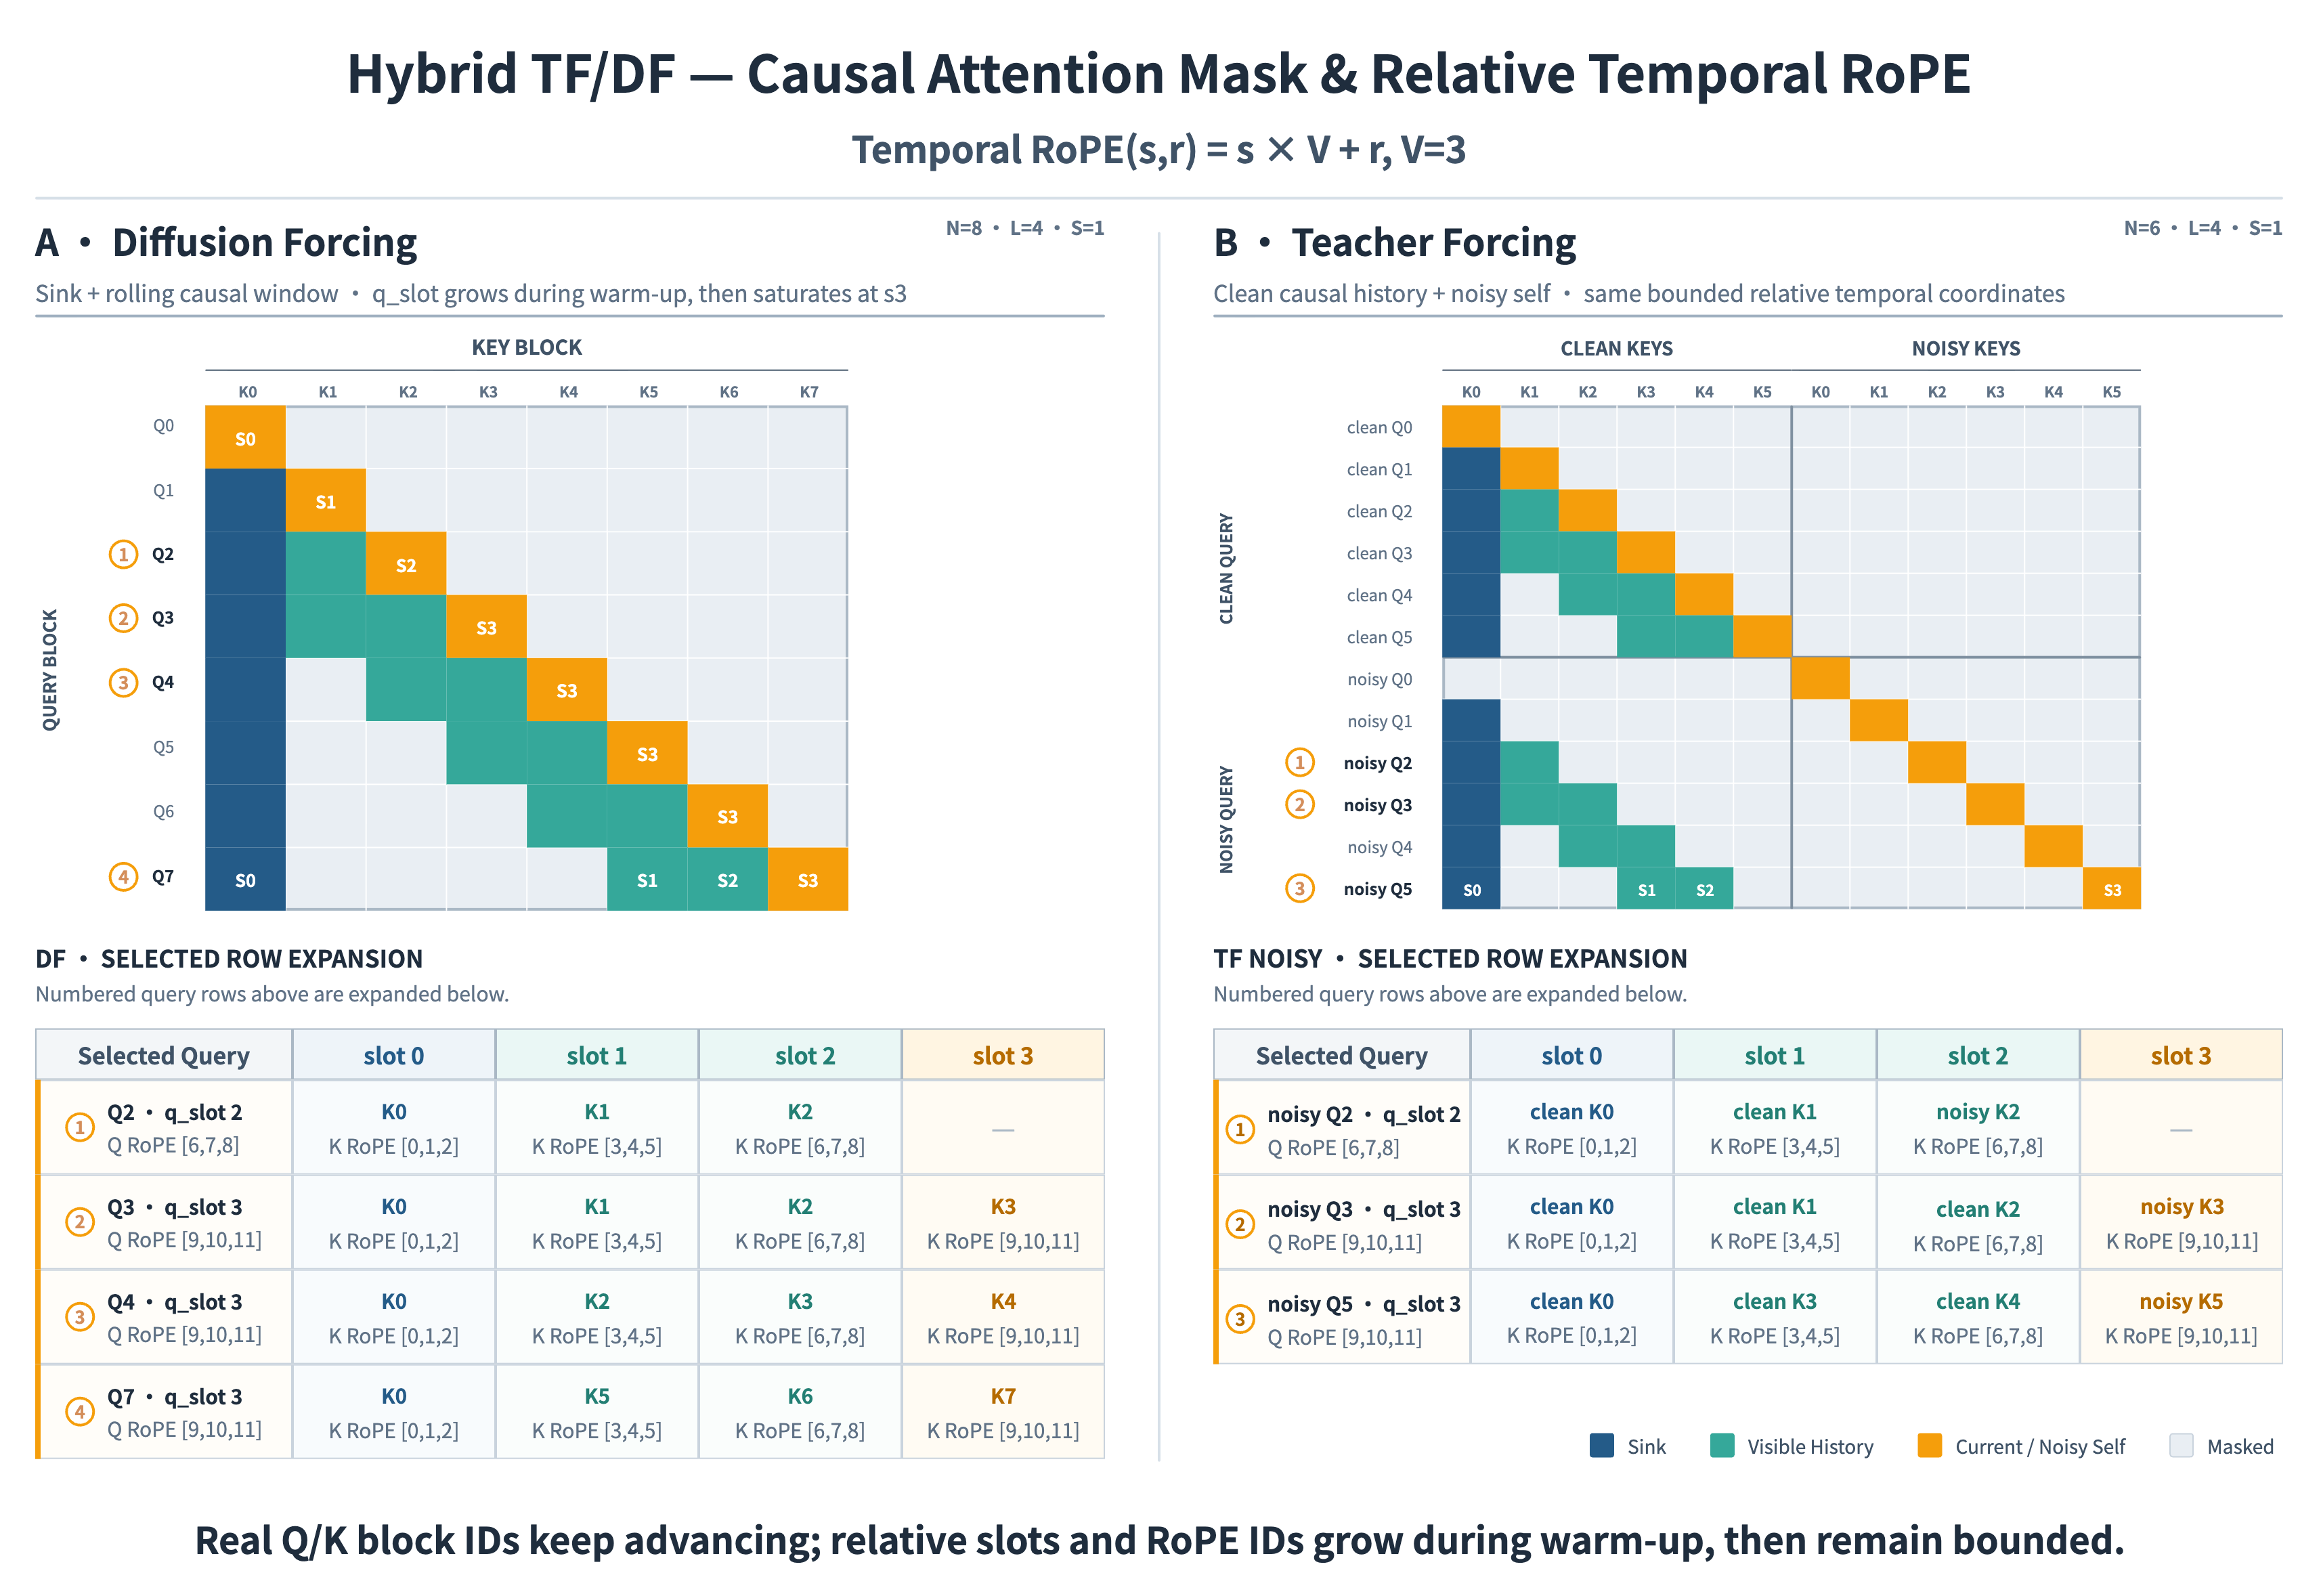
Figure 3. Masque d’attention causale unifié et RoPE temporel relatif pour Hybrid Teacher / Diffusion Forcing. La partie supérieure montre la visibilité causale pour les deux types d’historiques. La partie inférieure illustre la projection des requêtes vers les blocs Q/K, les fenêtres relatives et les identifiants RoPE, confirmant que les indices réels avancent alors que les repères internes restent contenus.
Mémoire à échelles temporelles multiples (Multi-timescale memory)
Modéliser un univers sur le long terme ne saurait consister à garder l’intégralité du passé en mémoire vive. Conserver un historique sans fin ferait exploser l’empreinte mémoire et la puissance requise ; rogner trop brutalement effacerait l’identité des personnages, le cadre de scène et les péripéties clés. R2 structure son système mémoriel en trois niveaux : Sink Memory, Rolling History et Object KV Cache.
- Sink Memory : préserve les fondations pérennes comme les caractéristiques des personnages, le décor initial, la signature visuelle et les règles de l’univers.
- Rolling History : retient les mouvements récents, la gestuelle, les mouvements d’appareil et les changements d’ambiance immédiats pour garantir des enchaînements fluides.
- Object KV Cache : compresse et réutilise les représentations d’objets déjà calculées, ne conservant que les éléments ayant une incidence directe sur la suite des événements, dans une enveloppe de calcul strictement délimitée.
Cette triade garantit la constance des identités, la fluidité des actions et une maîtrise stricte des coûts de fonctionnement, réduisant drastiquement les disparitions de personnages, les sautes de décor et les sautillements d’image.
Error Bank
Les décrochages sévères dans un modèle de monde autorégressif prennent souvent racine dans un infime artefact enregistré dans l’historique et amplifié au fil des images. R2 met en place une banque d’erreurs (Error Bank) qui catalogue les historiques altérés typiques et les réinjecte méthodiquement dans l’entraînement selon un dosage précis. Le modèle ne s’exerce plus seulement à poursuivre une situation idéale : il apprend à détecter une anomalie naissante, à l’assimiler et à réparer le cours des événements.
Lors de nos évaluations, la dérive de luminosité à long terme a diminué de 0,201 à 0,129, soit une baisse de 35,8 %. Sur 29 séquences longues de test, 20 ont montré un progrès manifeste, et les 5 séquences censées demeurer immobiles ont vu leurs mouvements parasites disparaître.
Accélération temps réel
L’accélération temps réel de R2 n’essaie pas d’inculquer la cohérence d’un univers pérenne à un modèle d’échantillonnage rapide en partant de zéro. Elle accélère un modèle de monde qui maîtrise déjà parfaitement la continuité temporelle. La couche d’accélération part d’Omni Causal AR pré-entraîné et s’en sert à la fois pour initialiser l’EDO et comme enseignant de distillation, garantissant un chemin causal commun entre tous les composants.
Cette origine causale commune atténue la dépendance aux phases d’ajustement complexes comme Self-Forcing et Rolling Forcing. L’accélération en temps réel peut se concentrer sur les problématiques propres à l’inférence en très peu d’étapes : DDMD avec régularisation antagoniste pour concilier respect des consignes, conformité de distribution et réalisme ; attention parcellaire par blocs (block-sparse attention) pour comprimer les contextes étendus ; et une structure en pyramide pour alléger le coût de la très haute résolution.
DDMD avec régularisation antagoniste
En génération ultra-rapide (très peu de pas), le respect des consignes, la conformité aux distributions de référence et le photoréalisme relèvent d’objectifs d’optimisation distincts. R2 prend appui sur DDMD en y associant la régularisation antagoniste de DMD2. Trois vecteurs se rencontrent chez l’élève : le guidage renforce la fidélité aux commandes, l’appariement de distribution préserve les qualités de l’enseignant et la régularisation ancre les résultats dans le réel. Quelques étapes de calcul suffisent ainsi à préserver un comportement interactif précis et un monde crédible.
Attention parcellaire par blocs (Block-sparse attention)
R2 applique une attention parcellaire organisée en blocs sur les séquences de jetons spatio-temporels. Le modèle segmente les matrices Q, K et V en blocs de calcul, identifie promptement les blocs de clés et valeurs indispensables à chaque requête, ne retient que les chemins d’interaction dominants et opère une attention softmax exacte sur ces seuls blocs. Cet aiguillage structuré ne relève pas d’un élagage au hasard : il concentre l’effort de calcul sur les corrélations puissantes entre commandes multimodales en cours, cinétique immédiate et repères cruciaux du décor.
En habituant le réseau à cette trame parcellaire dès l’entraînement, R2 porte la parcimonie de l’attention au-delà de 90 % tout en maintenant la netteté visuelle, la continuité gestuelle, la docilité aux instructions et la stabilité à long terme sans perte décelable lors de nos tests.
Distillation pyramidale en ultra-faible nombre de pas
Calculer l’ensemble de la scène d’emblée en très haute définition mobilise inutilement des ressources pour agencer des formes globales qu’une définition intermédiaire peut poser aisément. R2 échelonne la génération en une ou deux phases en résolution modérée, suivies d’une passe en haute résolution. Les premières cadrent l’organisation des lieux, le déplacement des sujets et la trajectoire de l’appareil. La passe finale restaure les textures, le piqué et les détails locaux. Cette démarche progressive supprime les redondances de calcul lourd tout en apportant une solidité structurelle accrue à l’ensemble.
Conclusion et limites
PixVerse R1 a conçu et livré le premier modèle de monde vidéo interactif en direct, prouvant qu’une vidéo IA peut s’émanciper du simple fichier préenregistré pour devenir un univers réactif et ininterrompu. PixVerse R2 relève le défi du passage à l’échelle : un modèle unifié Omni Causal AR accueille un volume grandissant de données, d’objectifs, de modalités et de durées, tandis que l’Accélération Temps Réel transpose cette richesse dans des inférences instantanées en quelques pas de calcul.
R2 ne se résume pas à une amélioration ponctuelle de performances : il inaugure un cadre d’entraînement standardisé pour la prochaine génération de modèles de monde. Si R1 a concrétisé l’existence de ces univers en temps réel, R2 les fait entrer dans une phase unifiée, évolutive et vouée à un perfectionnement continu.
Sous la contrainte stricte d’un temps de calcul instantané et d’une latence minimale, la qualité visuelle brute d’une génération ponctuelle conserve encore une marge de progression par rapport aux modèles vidéo hors ligne les plus avancés, en particulier dans la finesse des textures complexes, le naturel des mouvements, la rigueur physique et la parfaite stabilité sur de très longues séquences. Ces écarts témoignent du stade actuel de montée en charge de R2 bien plus que d’une limite inhérente à son architecture.
Accès anticipé
Au 23 août 2026, ce rapport décrivait PixVerse R2 comme un test fermé. Le 22 septembre 2026, PixVerse a annoncé qu’une collection de ces mondes est ouverte à l’exploration sur world.pixverse.video. Voir l’annonce de lancement de R2.
Cette annonce n’ouvre pas un accès API sans restriction. Le formulaire d’accès au modèle de monde PixVerse R2 reste la voie de demande pour l’accès prioritaire et les clés d’API.
Ressources connexes
- Comprendre PixVerse R1 : Modèle de monde vidéo IA en temps réel
- Au cœur du moteur de jeu PixVerse
- PixVerse enrichit R1 avec les mondes partagés
- Guide de la génération vidéo IA en temps réel
- PixVerse boucle son extension de Série C
Les mondes de l’annonce du 22 septembre 2026 sont ouverts à l’exploration sur world.pixverse.video. L’accès API se demande toujours via le formulaire ci-dessus. Vous pouvez aussi créer dès aujourd’hui avec PixVerse V6 et R1.