PixVerse R2: 실시간 Omni 월드 모델 스케일링
PixVerse R1은 첫 실시간 비디오 월드 모델을 제안하고 출시하여, 비디오 생성을 고정 클립의 일회 전달에서 계속 실행되는 세계로 바꿨습니다. 모델은 사용자 입력을 계속 받고, 세계 상태를 실시간으로 갱신하며, 상호작용과 일관된 동기 오디오와 비디오를 스트리밍할 수 있습니다. R1은 이 기술 패러다임이 작동할 수 있음을 보여 주었습니다.
PixVerse R2는 다음 질문에 답합니다. 실시간 비디오 월드 모델이 어떻게 계속 스케일하는가입니다. R2는 두 목표에 초점을 둡니다. 첫째, 긴 지평에 걸쳐 통일 상태를 유지할 수 있는 동적 세계를 구축하고, 완전한 시공간 사전을 시간 방향으로만 나아가는 세계 진화로 변환합니다. 둘째, 텍스트, 참조, 오디오, 액션에서 오는 물리 인과와 상호작용 신호를 단일 모델에 지속적으로 내재화하여, 세계가 생성하고, 제어를 받고, 상태를 갱신하는 동시에 동기 오디오와 비디오를 스트리밍하게 합니다.
이 목표를 중심으로 R2는 모델, 데이터, 작업, 제어 신호, 시간 척도의 성장을 생성 품질, 장거리 일관성, 멀티모달 제어의 이득으로 바꿉니다.
전체 프레임워크
R2는 시스템을 두 핵심 층으로 접습니다. Omni Causal AR과 Real-Time Acceleration입니다. Omni Causal AR은 고품질, 멀티모달, 장지평 세계 생성을 계속 확장합니다. Real-Time Acceleration은 엄격한 상호작용 지연 예산 아래 그 능력을 가능한 한 손실 없이 상속합니다. 경로는 분명합니다. 월드 모델의 능력 천장을 올린 뒤, 그 능력을 실시간 인터랙티브 동작 범위로 가속합니다.
이전의 장편 비디오와 실시간 파이프라인은 보통 많은 훈련 단계를 사슬로 이었습니다. 양방향 모델을 AR 모델로 변환하고, 작업 특화 양방향 모델에서 증류 교사를 만들고, DMD 증류를 한 뒤, 훈련-추론 격차를 닫기 위해 self-rollout DMD를 더합니다. 각 단계는 능력을 다시 이전하고, 목표를 다시 정렬하고, 데이터 분포를 다시 맞춰야 했습니다. 화질, 움직임, 조건 추종, 장지평 안정성은 그 이전 중에 침식될 수 있습니다. 모델, 데이터, 작업 규모가 커지면 다단계 파이프라인은 최적화 목표를 쪼개고 훈련 비용과 시스템 복잡도를 올립니다.
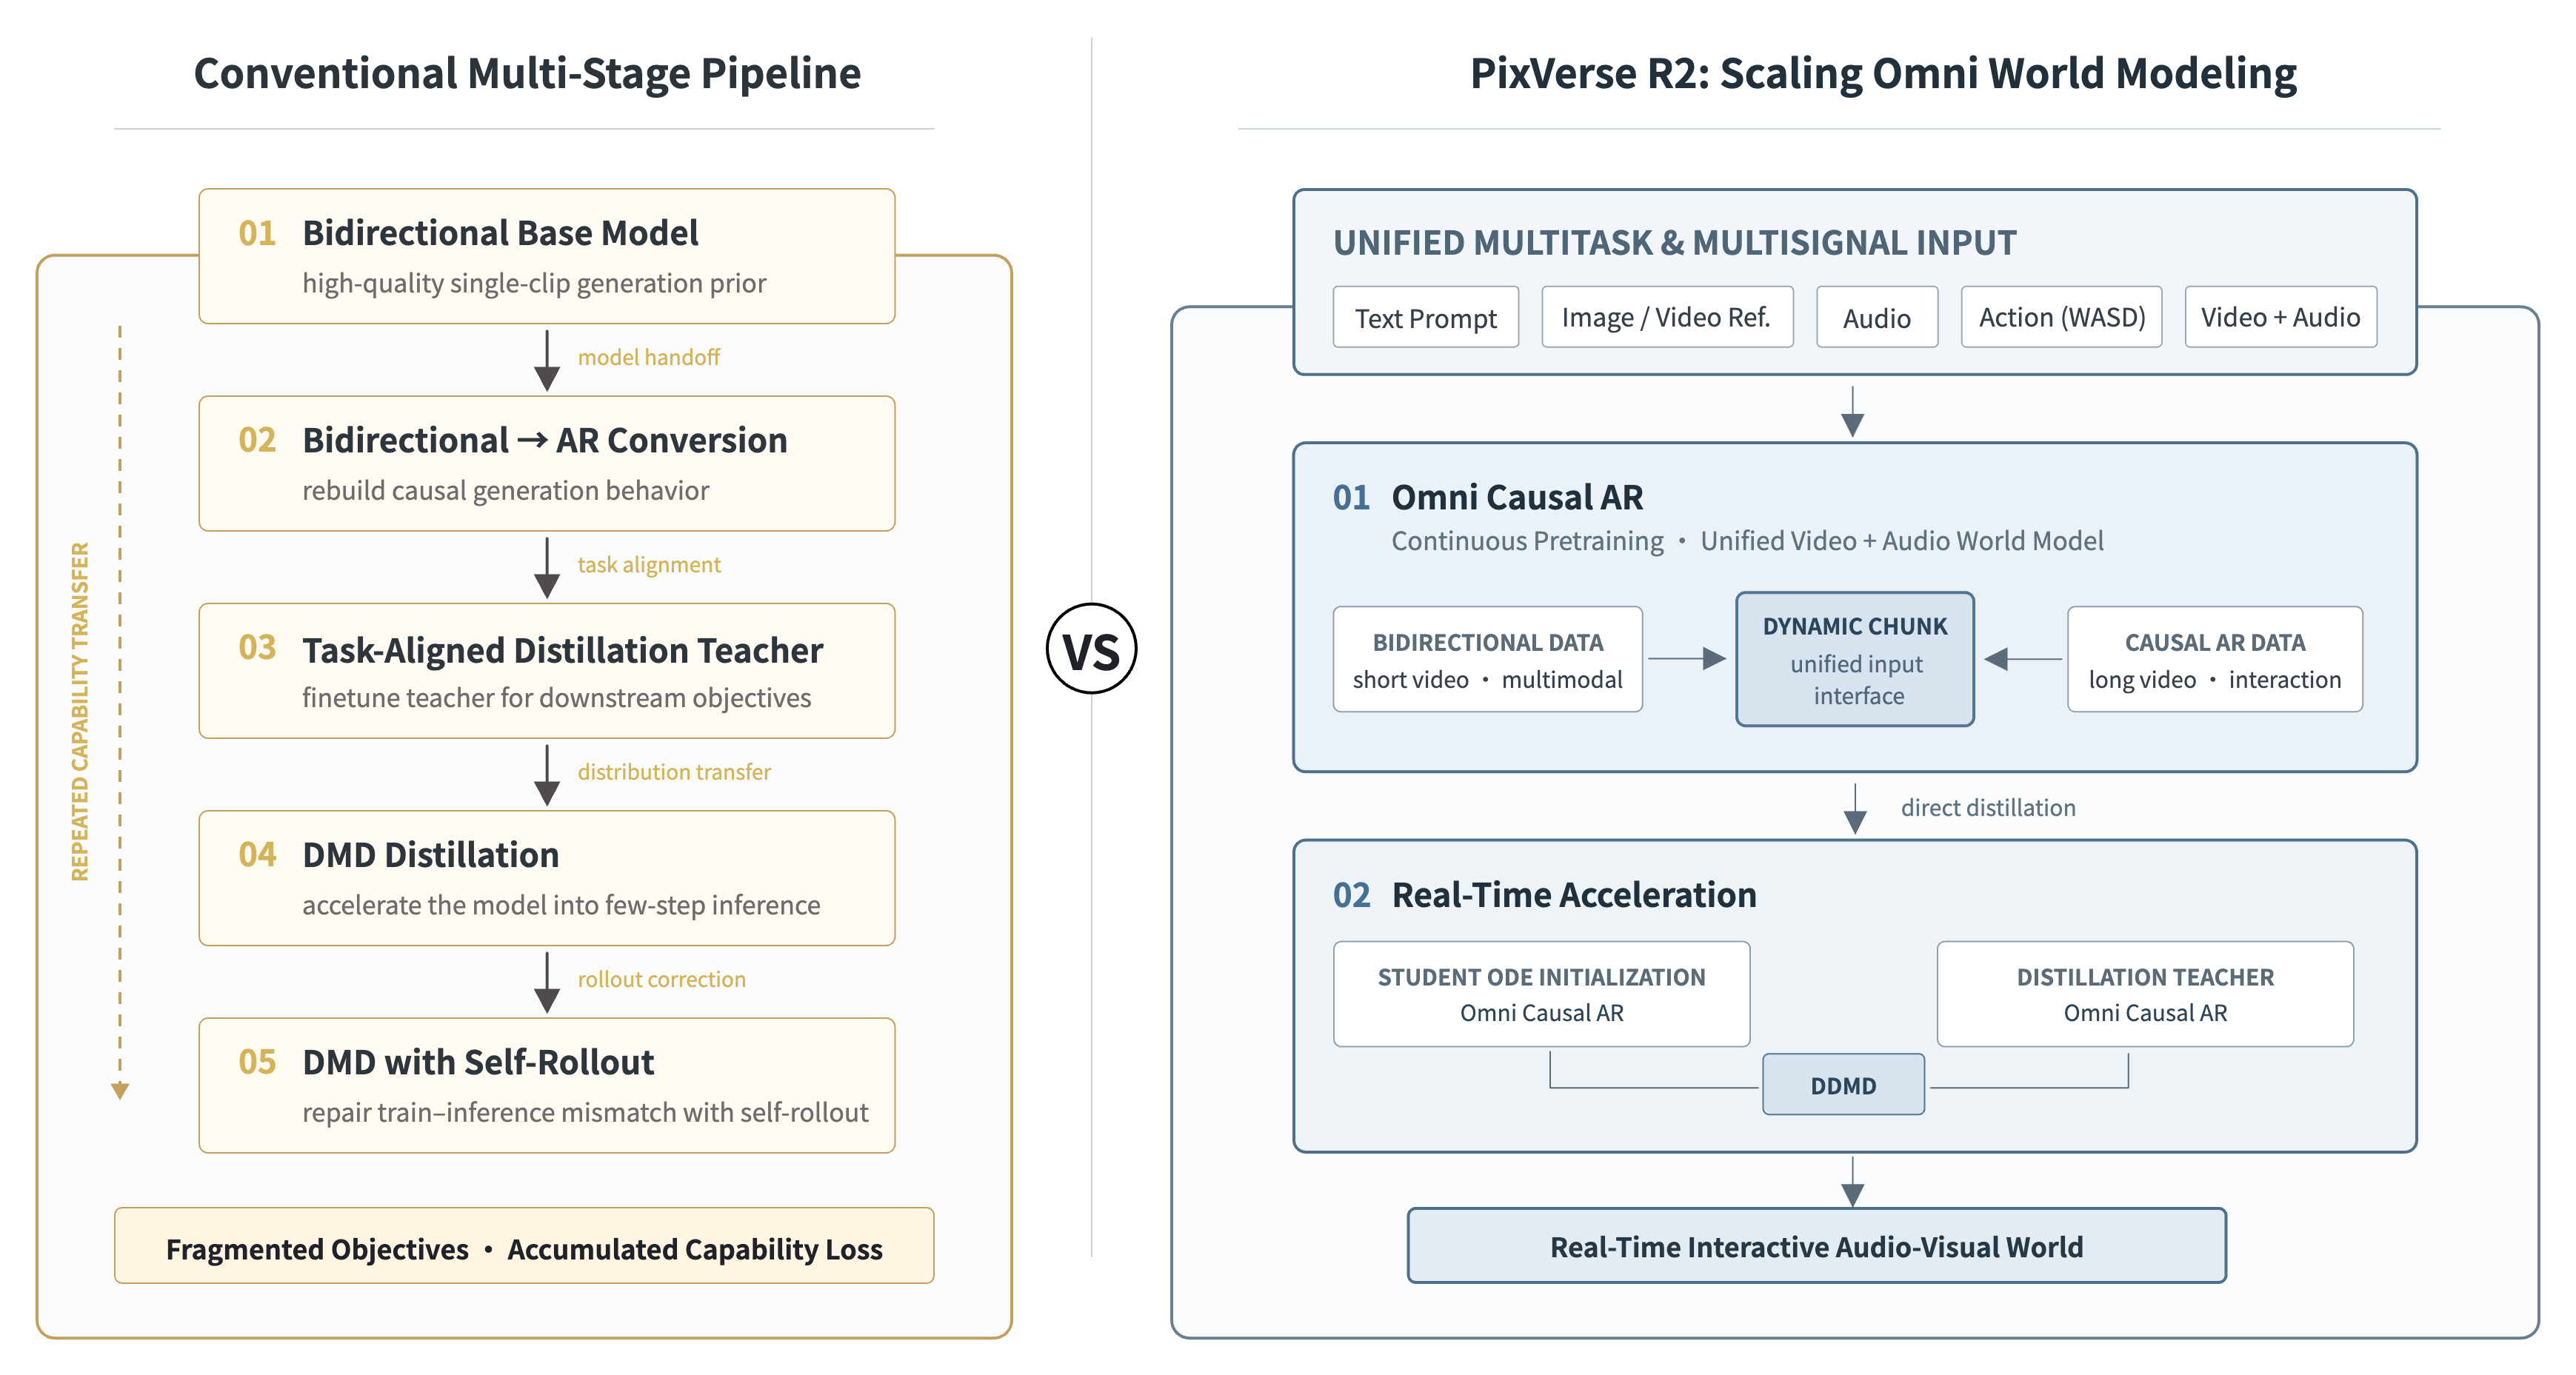
그림 1. 기존 다단계 파이프라인과 PixVerse R2 스케일링 월드 모델링. R2는 능력 확장과 실시간 증류를 Omni Causal AR과 실시간 가속 층으로 수렴시켜, 다중 작업, 다중 신호, 장편 비디오 모델링을 하나의 프레임워크에서 통일합니다.
PixVerse R2는 실시간 월드 모델을 위한 통일 훈련 패러다임을 제안합니다. 많은 모델과 작업 단계에 걸쳐 능력을 반복 이전하는 대신, 복잡한 파이프라인을 계속 스케일할 수 있는 두 과정으로 줄입니다. 통일 세계 상태를 가진 Omni Causal AR을 지속 사전학습한 뒤, 공간 일관성과 장지평 모델링을 상속하면서 실시간 생성할 수 있는 가속 모델로 직접 증류합니다.
단계 경계가 줄어들면 독립 교사, 작업 정렬, 반복 모델 이전에서 오는 능력 손실이 줄어듭니다. 새 데이터, 작업, 제어 신호, 모델 규모는 더 직접적으로 실시간 월드 모델링 능력으로 변환될 수 있습니다.
1단계: Omni Causal AR의 지속 사전학습. R2는 더 이상 양방향 생성 사전과 장편 비디오 AR을 끊어진 두 단계로 다루지 않습니다. 양방향 모델 능력 위에서 통일 Omni Causal AR을 지속 훈련합니다. 동적 청크가 다른 데이터 형태에 공유 시간 표현을 줍니다. 모델은 양방향 사전학습의 고품질 짧은 비디오와 멀티모달 데이터를 흡수할 수 있고, 연속 장편 비디오와 다중 턴 상호작용 궤적으로 확장할 수 있습니다. 화질, 시청각 표현, 장지평 생성, 다중 신호 제어는 반복 변환으로 다시 이전되는 대신 한 모델 안에서 스케일할 수 있습니다.
2단계: 스케일된 Omni Causal AR에서 실시간 가속 층 증류. 지속 사전학습은 Omni Causal AR에 고품질 생성, 안정된 장지평 상태 전달, 실제 인과 롤아웃을 동시에 줍니다. R2는 그 같은 Omni Causal AR을 학생 ODE 초기화와 증류 교사 모두에 쓰므로, 교사, 학생, 실제 AR 추론이 일관된 인과 모델링 기반을 공유합니다. 실시간 증류는 “장지평 세계를 다시 배우는 것”이 아니라 “기존 월드 모델의 소수 스텝 가속”이 됩니다.
Omni Causal AR
R2는 R1이 이미 검증한 멀티모달 입력, 자기회귀 생성, 실시간 상호작용 경로를 이어 가며, 그 능력을 통일 Omni Causal AR 훈련 경로로 집중합니다. Omni Causal AR은 완전한 시공간 생성 사전을 시간 방향으로만 나아가는 세계 상태 전달로 변환합니다. 인과화와 지속 사전학습을 통해 모델은 화면, 움직임, 오디오, 멀티모달 의미 능력을 유지하면서, 이력만으로 다음 동기 시청각 청크를 예측하는 법을 배웁니다.
훈련 대상이 독립 짧은 비디오에서 연속 장편 비디오와 다중 턴 상호작용 궤적으로 확장되면, 모델은 역사적 세계 상태, 현재 상호작용 입력, 미래 세계 진화 사이에 장기 인과를 점진적으로 구축합니다.
모델은 텍스트 프롬프트, 멀티모달 참조, 액션 신호(예: WASD 또는 연속 제어), 오디오를 공동으로 받고 동기 비디오와 오디오를 출력합니다. 다른 제어 신호는 실행 중에 계속 들어와 이후 세계 상태를 바꿀 수 있습니다. R2는 일회 조건에 응답하는 것만이 아니라, 생성하고, 제어를 받고, 세계를 동시에 갱신할 수 있습니다.
인과 생성을 같은 세계 안에서 오래 달리게 하기 위해 R2는 네 문제를 다룹니다. 훈련-추론 분포 격차, 노이즈 이력에 대한 강건성, 장기 기억과 최근 기억의 조율, 오류 상태의 교정입니다. Hybrid Teacher / Diffusion Forcing은 모델이 깨끗한 이력과 노이즈 이력 모두에 적응하게 합니다. Multi-Timescale Memory는 세계 앵커, 최근 역학, 오브젝트 상태를 공동 저장합니다. Error Bank는 실패한 상태를 훈련으로 되돌립니다. 함께 장기 세계 상태의 훈련 루프를 형성하고, 화면, 캐릭터, 움직임, 시청각 관계, 제어 응답의 시간적 드리프트를 줄입니다.
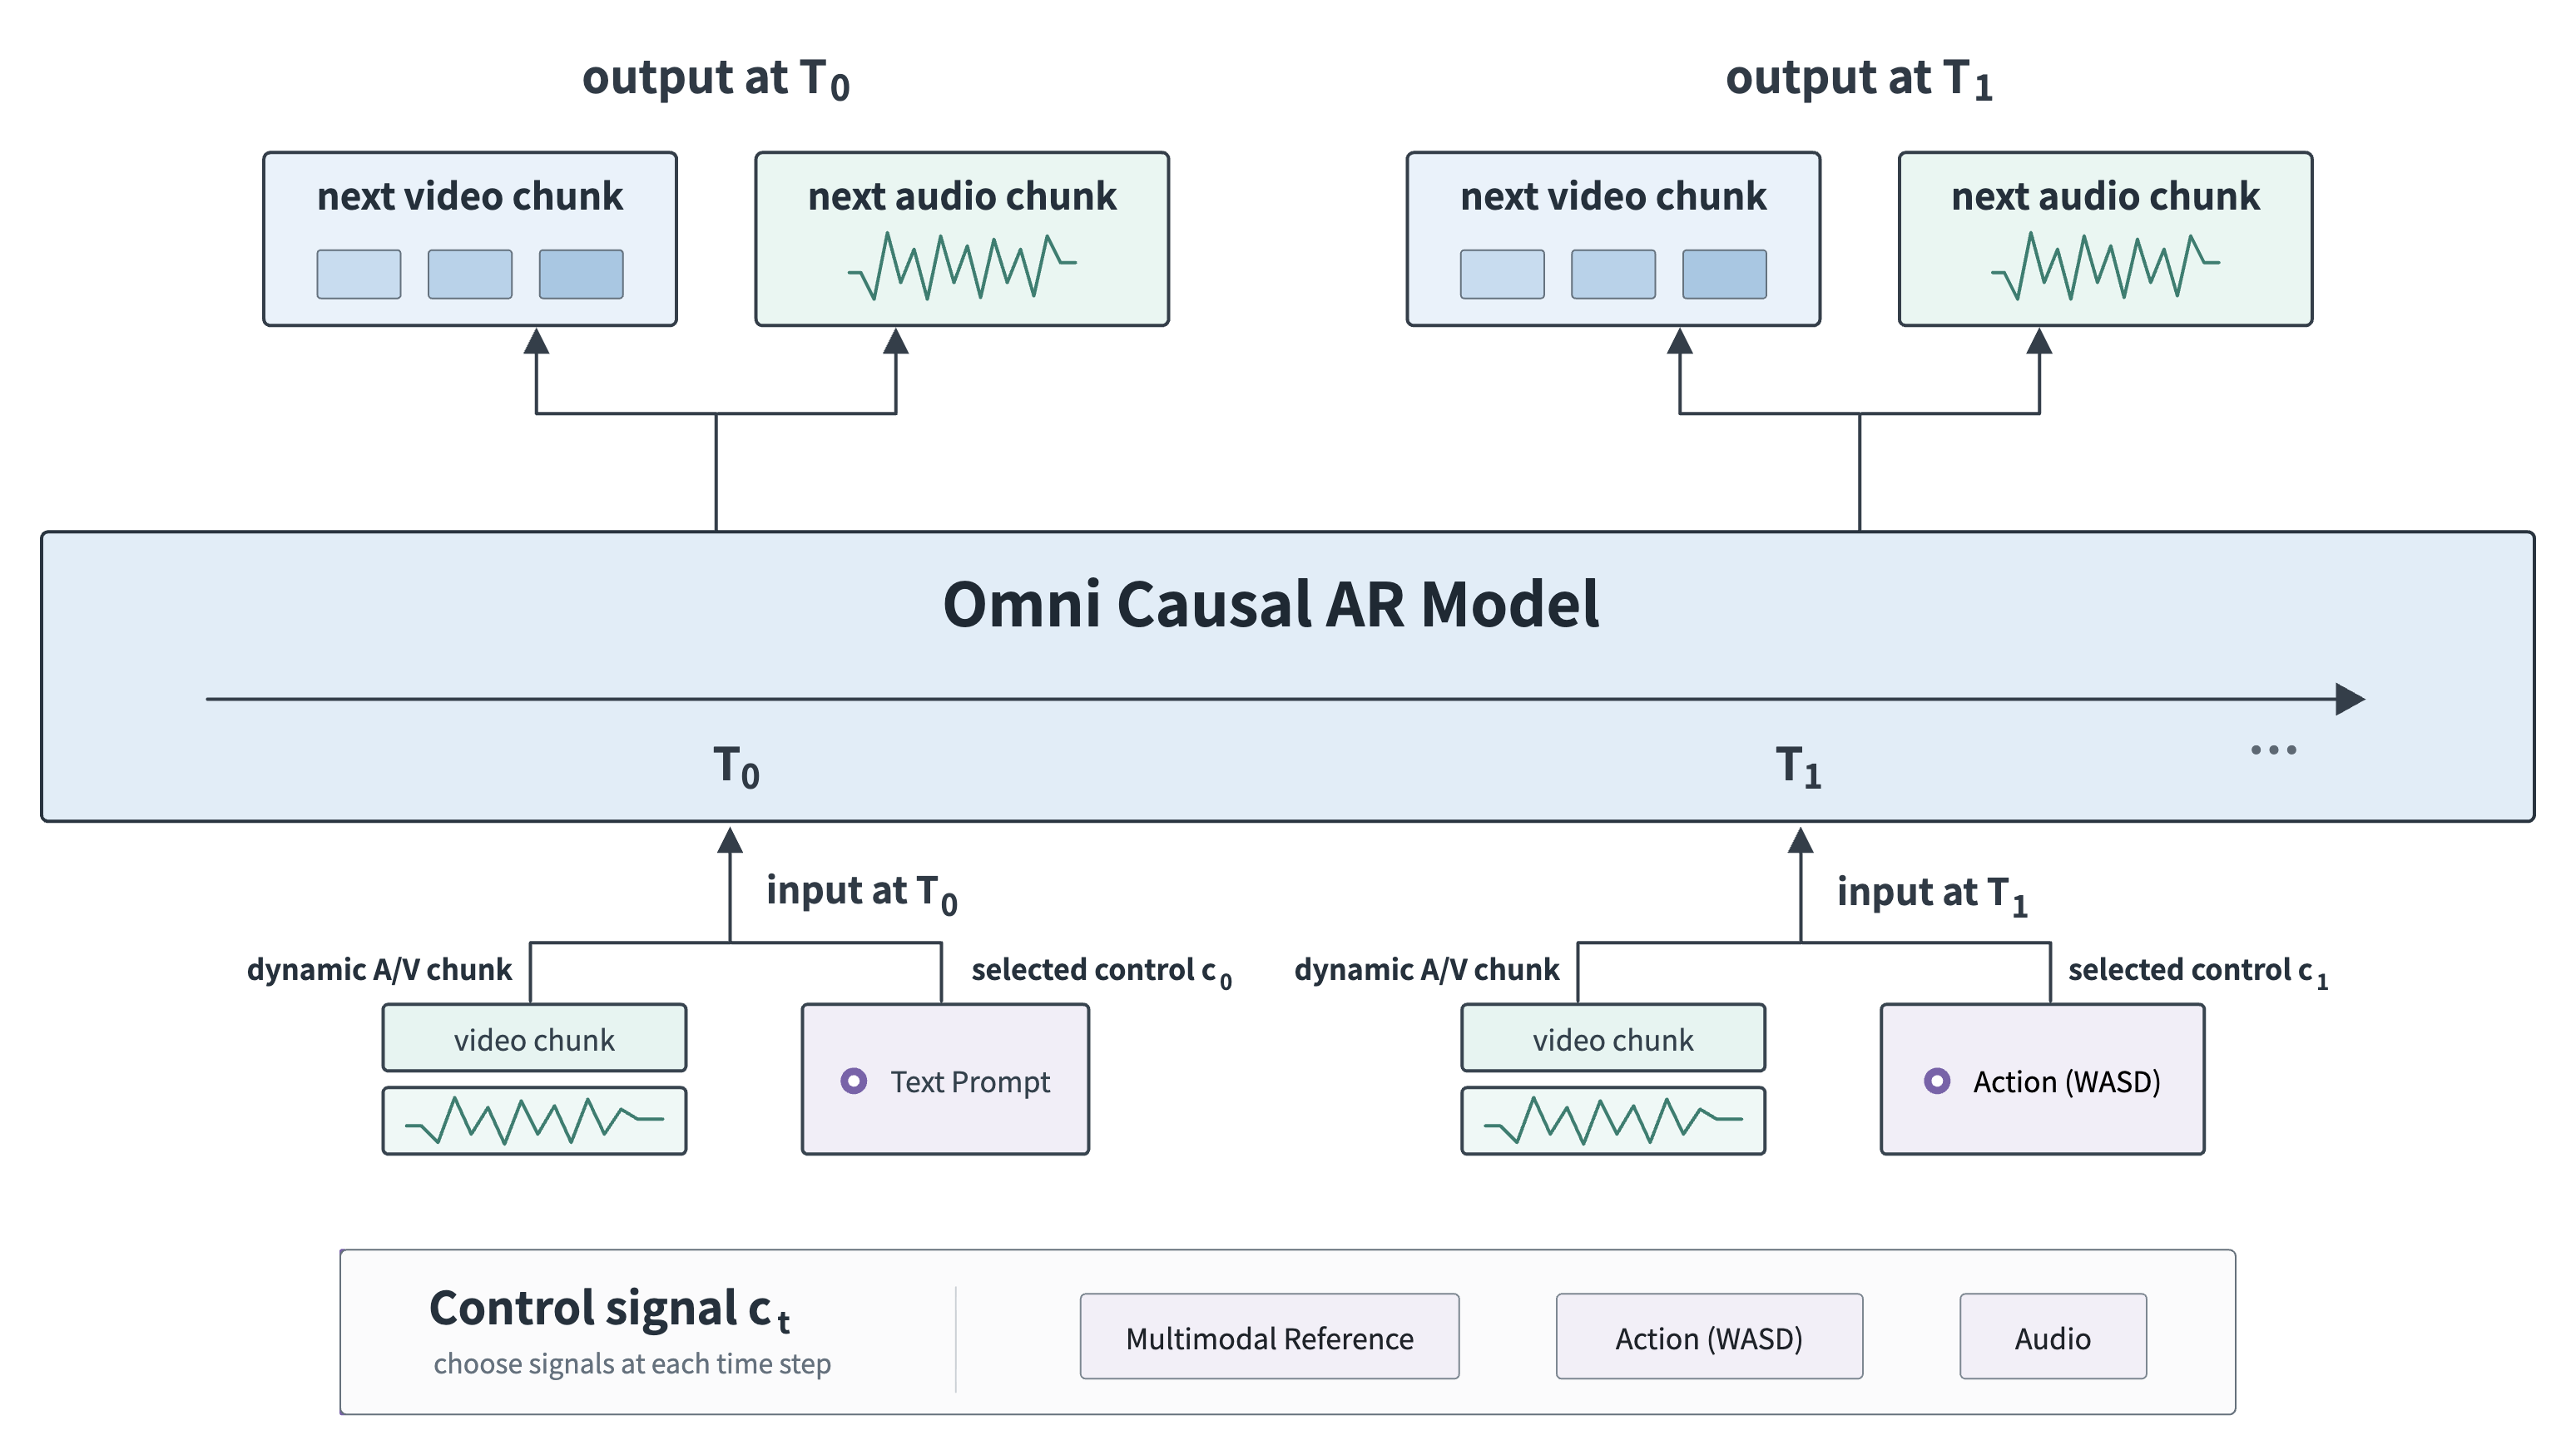
그림 2. PixVerse R2 Omni Causal AR. 모델은 실행 중에 다른 제어 신호를 계속 받을 수 있습니다. 각 상호작용 시점에 활성 신호는 맞는 입도의 동적 시청각 청크와 정렬되어 다음 비디오와 오디오 세그먼트를 구동합니다.
동적 청크 생성
다른 제어 신호는 다른 시간 척도에 삽니다. 프롬프트와 참조는 보통 전체 의미나 더 긴 사건을 설명합니다. 액션(WASD)은 세밀하고 즉각적인 상태 피드백이 필요합니다. 오디오는 의미, 리듬, 시간 동기화를 한꺼번에 나릅니다. 모든 입력을 고정 길이 시간 단위로 강제하면, 모델은 종종 응답 속도와 표현의 완전성 사이에서 타협해야 합니다.
Dynamic Chunk는 R2가 그 상호작용 시간 척도를 통일하는 방식입니다. R2는 현재 제어 신호의 의미 경계와 지속 시간으로 시청각 시퀀스를 적응적으로 나누고, 최대 청크 크기로 계산과 훈련 안정성을 제약합니다. 짧은 청크는 액션과 국소 지시의 응답 정밀도를 높입니다. 긴 청크는 사건, 움직임, 시청각 의미의 전체 구조를 지킵니다. 다른 작업과 제어 신호는 모델 구조를 바꾸지 않고 하나의 인과 생성 인터페이스를 공유할 수 있습니다.
Hybrid Teacher Forcing / Diffusion Forcing
장지평 AR의 핵심 긴장은, 훈련 이력이 보통 더 깨끗한 반면 실제 런타임 이력은 모델 자신의 노이즈와 국소 오류를 포함한다는 점입니다. 깨끗한 이력만으로 훈련하면 단일 스텝 품질 천장은 올라가지만 작은 편차에 너무 민감해질 수 있습니다. 섭동 이력만으로 훈련하면 화질, 움직임, 제어 응답이 손상될 수 있습니다.
R2는 한 훈련 과정에서 깨끗한 이력과 노이즈 이력을 섞습니다. 깨끗한 이력은 세계 진화의 품질 천장을 안정시킵니다. 노이즈 이력은 배포에서 보게 될 불완전한 상태에 모델을 미리 적응시킵니다. 상보적 훈련이 훈련-추론 격차를 줄여, 모델이 고품질의 다음 세계 세그먼트를 생성하고, 이력에 이미 작은 오류가 있어도 앞으로 롤할 수 있게 합니다.
Causal Attention Mask와 Relative Temporal RoPE는 현재 상태가 어떤 이력을 읽을 수 있는지, 그 이력이 현재 창의 어디에 있는지를 공동으로 제약합니다. Attention Mask는 엄격한 인과 가시성을 강제합니다. Temporal RoPE는 전역 block ID와 함께 무한히 자라지 않고, 현재 어텐션 창 안의 상대 슬롯으로 다시 인덱싱됩니다. 롤링 창이 앞으로 움직이면 실제 시간은 계속 나아가지만, sink 메모리, 최근 이력, 현재 청크는 안정되고 유계인 상대 위치 범위에 매핑된 채로 남습니다.
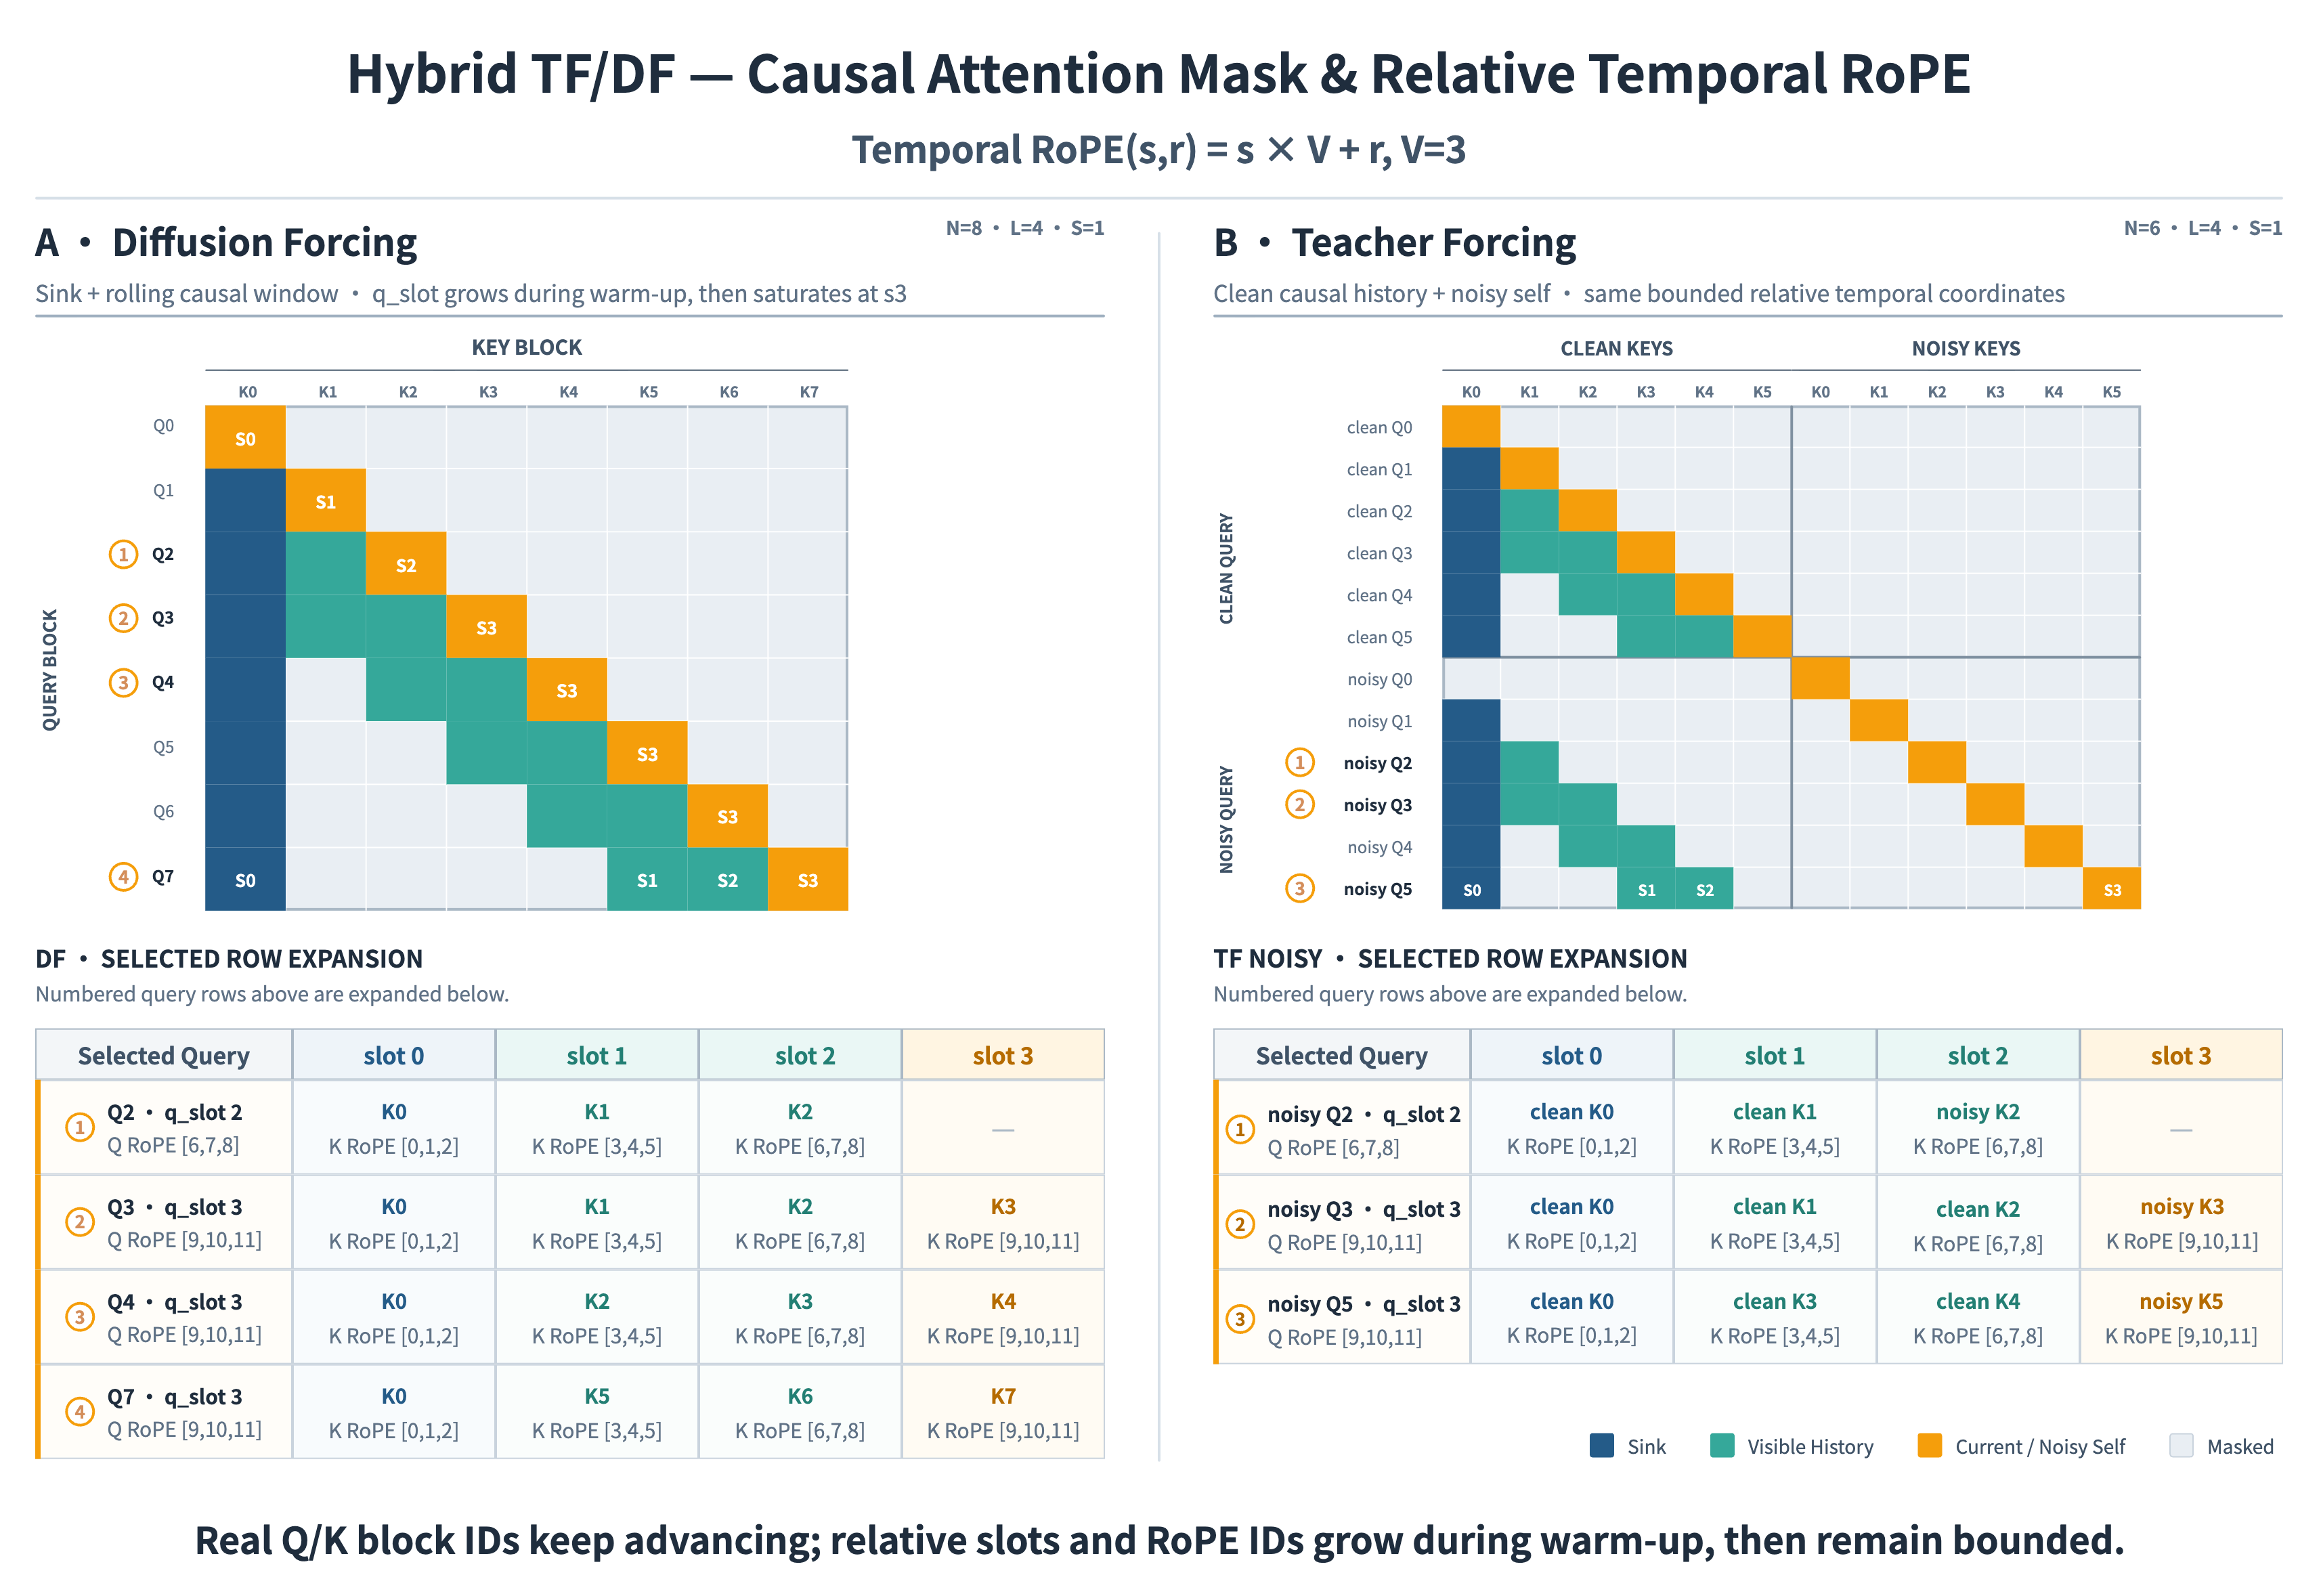
그림 3. Hybrid Teacher / Diffusion Forcing을 위한 통일 인과 어텐션 마스크와 상대 시간 RoPE. 위는 두 이력 구성의 인과 가시성을 보여 줍니다. 아래는 대표 쿼리를 Q/K 블록, 상대 슬롯, RoPE ID에 매핑하여, 실제 block ID는 계속 나아가고 창 안 시간 좌표는 유계로 남는 것을 보여 줍니다.
다중 시간 척도 메모리
장기 월드 모델링은 모든 이력을 단순히 기억하는 것이 아닙니다. 무한 이력은 계산과 메모리 비용을 빠르게 올리고, 과도한 잘라내기는 캐릭터 정체성, 장면 설정, 핵심 사건을 떨어뜨립니다. R2는 Sink Memory, Rolling History, Object KV Cache로 다중 척도 메모리 시스템을 구축합니다.
- Sink Memory는 캐릭터, 장면, 스타일, 세계 규칙과 같은 장기 앵커를 저장합니다.
- Rolling History는 최근 액션, 포즈, 카메라, 환경 변화에 초점을 두어 국소 상태가 자연스럽게 이어지게 합니다.
- Object KV Cache는 이미 계산된 오브젝트 수준 이력 표현을 재사용·압축하여, 이후 진화에 실제로 영향을 주는 상태를 제한된 예산 안에 유지합니다.
셋은 함께 장기 정체성 안정, 단거리 움직임 연속, 제어 가능한 런타임 비용을 주고, 캐릭터 드리프트, 장면 점프, 청크 간 깜빡임, 끊긴 액션을 줄입니다.
Error Bank
AR 월드 모델의 심각한 드리프트는 종종 이력에 쓰인 뒤 상속되는 초기 작은 오류에서 시작합니다. R2는 Error Bank를 구축하여 대표 오류 이력을 재사용 가능한 샘플로 저장하고, 훈련 중 설정된 비율로 정상 이력에 재생합니다. 모델은 이상 상태에서 이어가는 법만이 아니라, 이미 흔들린 이력을 인식하고, 흡수하고, 복구하는 법도 배웁니다.
단계 평가에서 장기 밝기 드리프트 지표는 0.201에서 0.129로 떨어져 약 35.8% 감소했습니다. 29개 장시퀀스 샘플 중 20개가 개선되었고, 정지해야 한다고 명시된 5개 샘플 모두에서 잘못된 움직임이 줄었습니다.
실시간 가속
R2의 실시간 가속은 소수 스텝 모델 안에서 장지평 세계를 다시 배우지 않습니다. 이미 오래 안정적으로 달릴 수 있는 월드 모델을 가속합니다. 가속 층은 지속 사전학습된 Omni Causal AR에서 시작하여 학생 ODE 초기화와 증류 교사 모두에 그것을 쓰므로, 교사, 학생, 실제 AR 추론이 일관된 인과 궤적 분포를 공유합니다.
이 통일 인과 출발점은 Self-Forcing과 Rolling Forcing 스타일 튜닝에 대한 의존을 줄입니다. 실시간 가속은 소수 스텝 속도가 실제로 가져오는 문제에 집중할 수 있습니다. 적대 정규화가 있는 DDMD는 증류 중 조건 정렬, 생성 분포, 사실감을 다루고, 블록 희소 어텐션은 긴 맥락 계산을 압축하며, 피라미드 경로는 고해상도 생성 비용을 낮춥니다.
적대 정규화가 있는 DDMD
초소수 스텝 생성에서 조건 정렬, 분포 매칭, 사실감은 같은 최적화 문제가 아닙니다. R2는 DDMD를 기반으로 DMD2의 적대 정규화를 더 도입합니다. 세 훈련 신호가 한 학생에서 만납니다. 조건 정렬이 제어를 강화하고, 분포 매칭이 교사 분포를 유지하며, 적대 정규화가 실제 데이터를 앵커하므로, 적은 샘플링 스텝으로도 정확한 상호작용 응답과 믿을 수 있는 세계를 유지할 수 있습니다.
블록 희소 어텐션
R2는 시공간 토큰 시퀀스에 블록 희소 어텐션을 사용합니다. 모델은 Q, K, V를 계산 블록으로 나누고, 각 쿼리 블록이 가장 필요로 하는 키/값 블록을 빠르게 추정하며, 점수가 가장 높은 연결만 남기고, 선택된 블록에서 정확한 softmax 어텐션을 실행합니다. 블록 수준 라우팅은 무작위 가지치기가 아닙니다. 현재 멀티모달 제어, 최근 움직임, 핵심 세계 상태 사이의 강한 의존에 계산을 집중합니다.
훈련 중 모델을 희소 연결 구조에 적응시킴으로써 R2는 어텐션 희소성을 90% 이상으로 올리면서, 현재 평가에서 화질, 액션 연속, 조건 추종, 장지평 안정성을 뚜렷이 떨어뜨리지 않고 유지합니다.
피라미드 초소수 스텝 증류
고해상도 공간에서 월드 모델링을 처음부터 하면, 낮은 해상도에서 이미 결정할 수 있는 전역 구조에 계산을 낭비합니다. R2는 생성을 하나 또는 두 개의 저해상도 단계와 하나의 고해상도 단계로 조직합니다. 저해상도 단계는 장면 배치, 피사체 움직임, 카메라 구조를 정합니다. 고해상도 단계는 텍스처, 가장자리, 국소 디테일을 복원합니다. 거친 것에서 세밀한 것으로의 경로는 반복되는 고해상도 계산을 줄이면서 더 강한 구조 안정성과 디테일을 유지합니다.
결론과 한계
PixVerse R1은 첫 실시간 비디오 월드 모델을 제안하고 출시하여, 비디오가 오프라인 고정 콘텐츠에서 실시간으로 상호작용하며 계속 실행되는 동적 세계로 이동할 수 있음을 보여 주었습니다. PixVerse R2는 그 패러다임이 어떻게 계속 스케일하는지를 풉니다. 통일 Omni Causal AR이 성장하는 데이터, 작업, 모달리티, 시간 척도를 나르고, Real-Time Acceleration이 완전한 월드 모델링 능력을 실시간 소수 스텝 추론으로 가져옵니다.
R2는 단일 지점 능력 업그레이드가 아닙니다. 차세대 실시간 월드 모델을 위한 통일 훈련 경로입니다. R1은 실시간 비디오 월드 모델을 현실로 만들었습니다. R2는 그것을 통일되고, 스케일 가능하며, 지속적으로 개선되는 단계에 둡니다.
엄격한 실시간 계산과 상호작용 지연 예산 아래, 현재 단일 생성 품질은 특히 복잡한 장면 디테일, 움직임 자연스러움, 물리 일관성, 장시간 실행 안정성에서 선도 오프라인 비디오 모델 대비 아직 개선 여지가 있습니다. 그 격차는 프레임워크 자체의 천장보다 R2의 현재 스케일링 단계를 더 자주 반영합니다.
얼리 액세스
2026년 8월 23일 기준으로 이 보고서는 PixVerse R2를 비공개 테스트로 설명했습니다. 2026년 9월 22일 PixVerse는 이 세계들의 모음을 world.pixverse.video에서 탐색할 수 있다고 발표했습니다. R2 출시 공지를 보세요.
이 발표는 제한 없는 API 액세스를 열지 않습니다. PixVerse 월드 모델 R2 체험 양식은 선행 체험과 API 액세스를 신청하는 경로로 남아 있습니다.
관련 자료
- PixVerse R1 해설: 실시간 AI 비디오 월드 모델
- PixVerse Game Engine 심층 분석
- PixVerse, Shared Worlds로 R1 업데이트
- 실시간 AI 비디오 생성 가이드
- PixVerse, Series C 연장 라운드 마감
2026년 9월 22일 공지의 세계는 world.pixverse.video에서 탐색할 수 있습니다. API 액세스는 여전히 위 양식으로 신청합니다. 오늘 PixVerse V6와 R1으로 만들 수도 있습니다.