PixVerse R2: Skalierung von Echtzeit-Omni-Weltmodellen
PixVerse R1 führte das erste Echtzeit-Videoweltmodell ein und wandelte die Videogenerierung von der einmaligen Ausgabe eines statischen Clips in eine kontinuierlich laufende Welt um. Das Modell kann fortlaufend Benutzereingaben empfangen, den Weltzustand in Echtzeit aktualisieren und synchronisierte Bild- und Tondaten streamen, die jederzeit mit der Interaktion übereinstimmen. R1 hat bewiesen, dass dieses technische Paradigma in der Praxis funktioniert.
PixVerse R2 beantwortet die nächste zentrale Frage: wie ein Echtzeit-Videoweltmodell kontinuierlich skaliert werden kann. R2 verfolgt zwei Kernziele: Erstens den Aufbau einer dynamischen Welt, die einen einheitlichen Zustand über lange Zeithorizonte aufrechterhalten kann, indem umfassende raum-zeitliche Priors in eine rein zeitlich vorwärtsgerichtete Weltentwicklung überführt werden. Zweitens die kontinuierliche Verinnerlichung physikalischer Kausalität und von Interaktionssignalen aus Text, Bildreferenzen, Audio und Steuerungsbefehlen in einem einzigen Modell, sodass die Welt synchron Bild und Ton streamen, Steuerungsbefehle verarbeiten und ihren Zustand parallel aktualisieren kann.
Entlang dieser Ziele wandelt R2 das Wachstum von Modellgröße, Daten, Aufgaben, Steuersignalen und Zeithorizonten in deutliche Fortschritte bei Generierungsqualität, Langzeitkonsistenz und multimodaler Kontrolle um.
Gesamter Aufbau
R2 verdichtet das System auf zwei zentrale Schichten: Omni Causal AR und Echtzeit-Beschleunigung. Omni Causal AR erweitert kontinuierlich die Erzeugung qualitativ hochwertiger, multimodaler Welten über lange Zeithorizonte. Die Echtzeit-Beschleunigung übernimmt diese Fähigkeiten möglichst verlustfrei unter Einhaltung eines strengen Latenzbudgets für Interaktionen. Der Weg ist klar vorgegeben: Das Leistungsvermögen des Weltmodells auf ein neues Höchstniveau heben und diese Leistung anschließend in einen interaktiven Echtzeit-Betriebsbereich beschleunigen.
Bisherige Pipelines für Langvideos und Echtzeit verknüpften meist mehrere aufeinanderfolgende Trainingsschritte: Konvertierung eines bidirektionalen Modells in ein AR-Modell, Erstellung eines Destillations-Lehrers aus einem aufgabenspezifischen bidirektionalen Modell, DMD-Destillation und anschließendes Self-Rollout-DMD zur Schließung der Lücke zwischen Training und Inferenz. In jeder Phase mussten Fähigkeiten übertragen, Optimierungsziele neu ausgerichtet und Datenverteilungen angepasst werden. Bildqualität, Bewegung, Regelbefolgung und Langzeitstabilität litten häufig unter diesen Übertragungsverlusten. Mit wachsendem Datenvolumen und steigenden Modellanforderungen führte die Mehrstufen-Pipeline zu einer Fragmentierung des Trainingsziels und steigerte sowohl Kosten als auch Systemkomplexität.
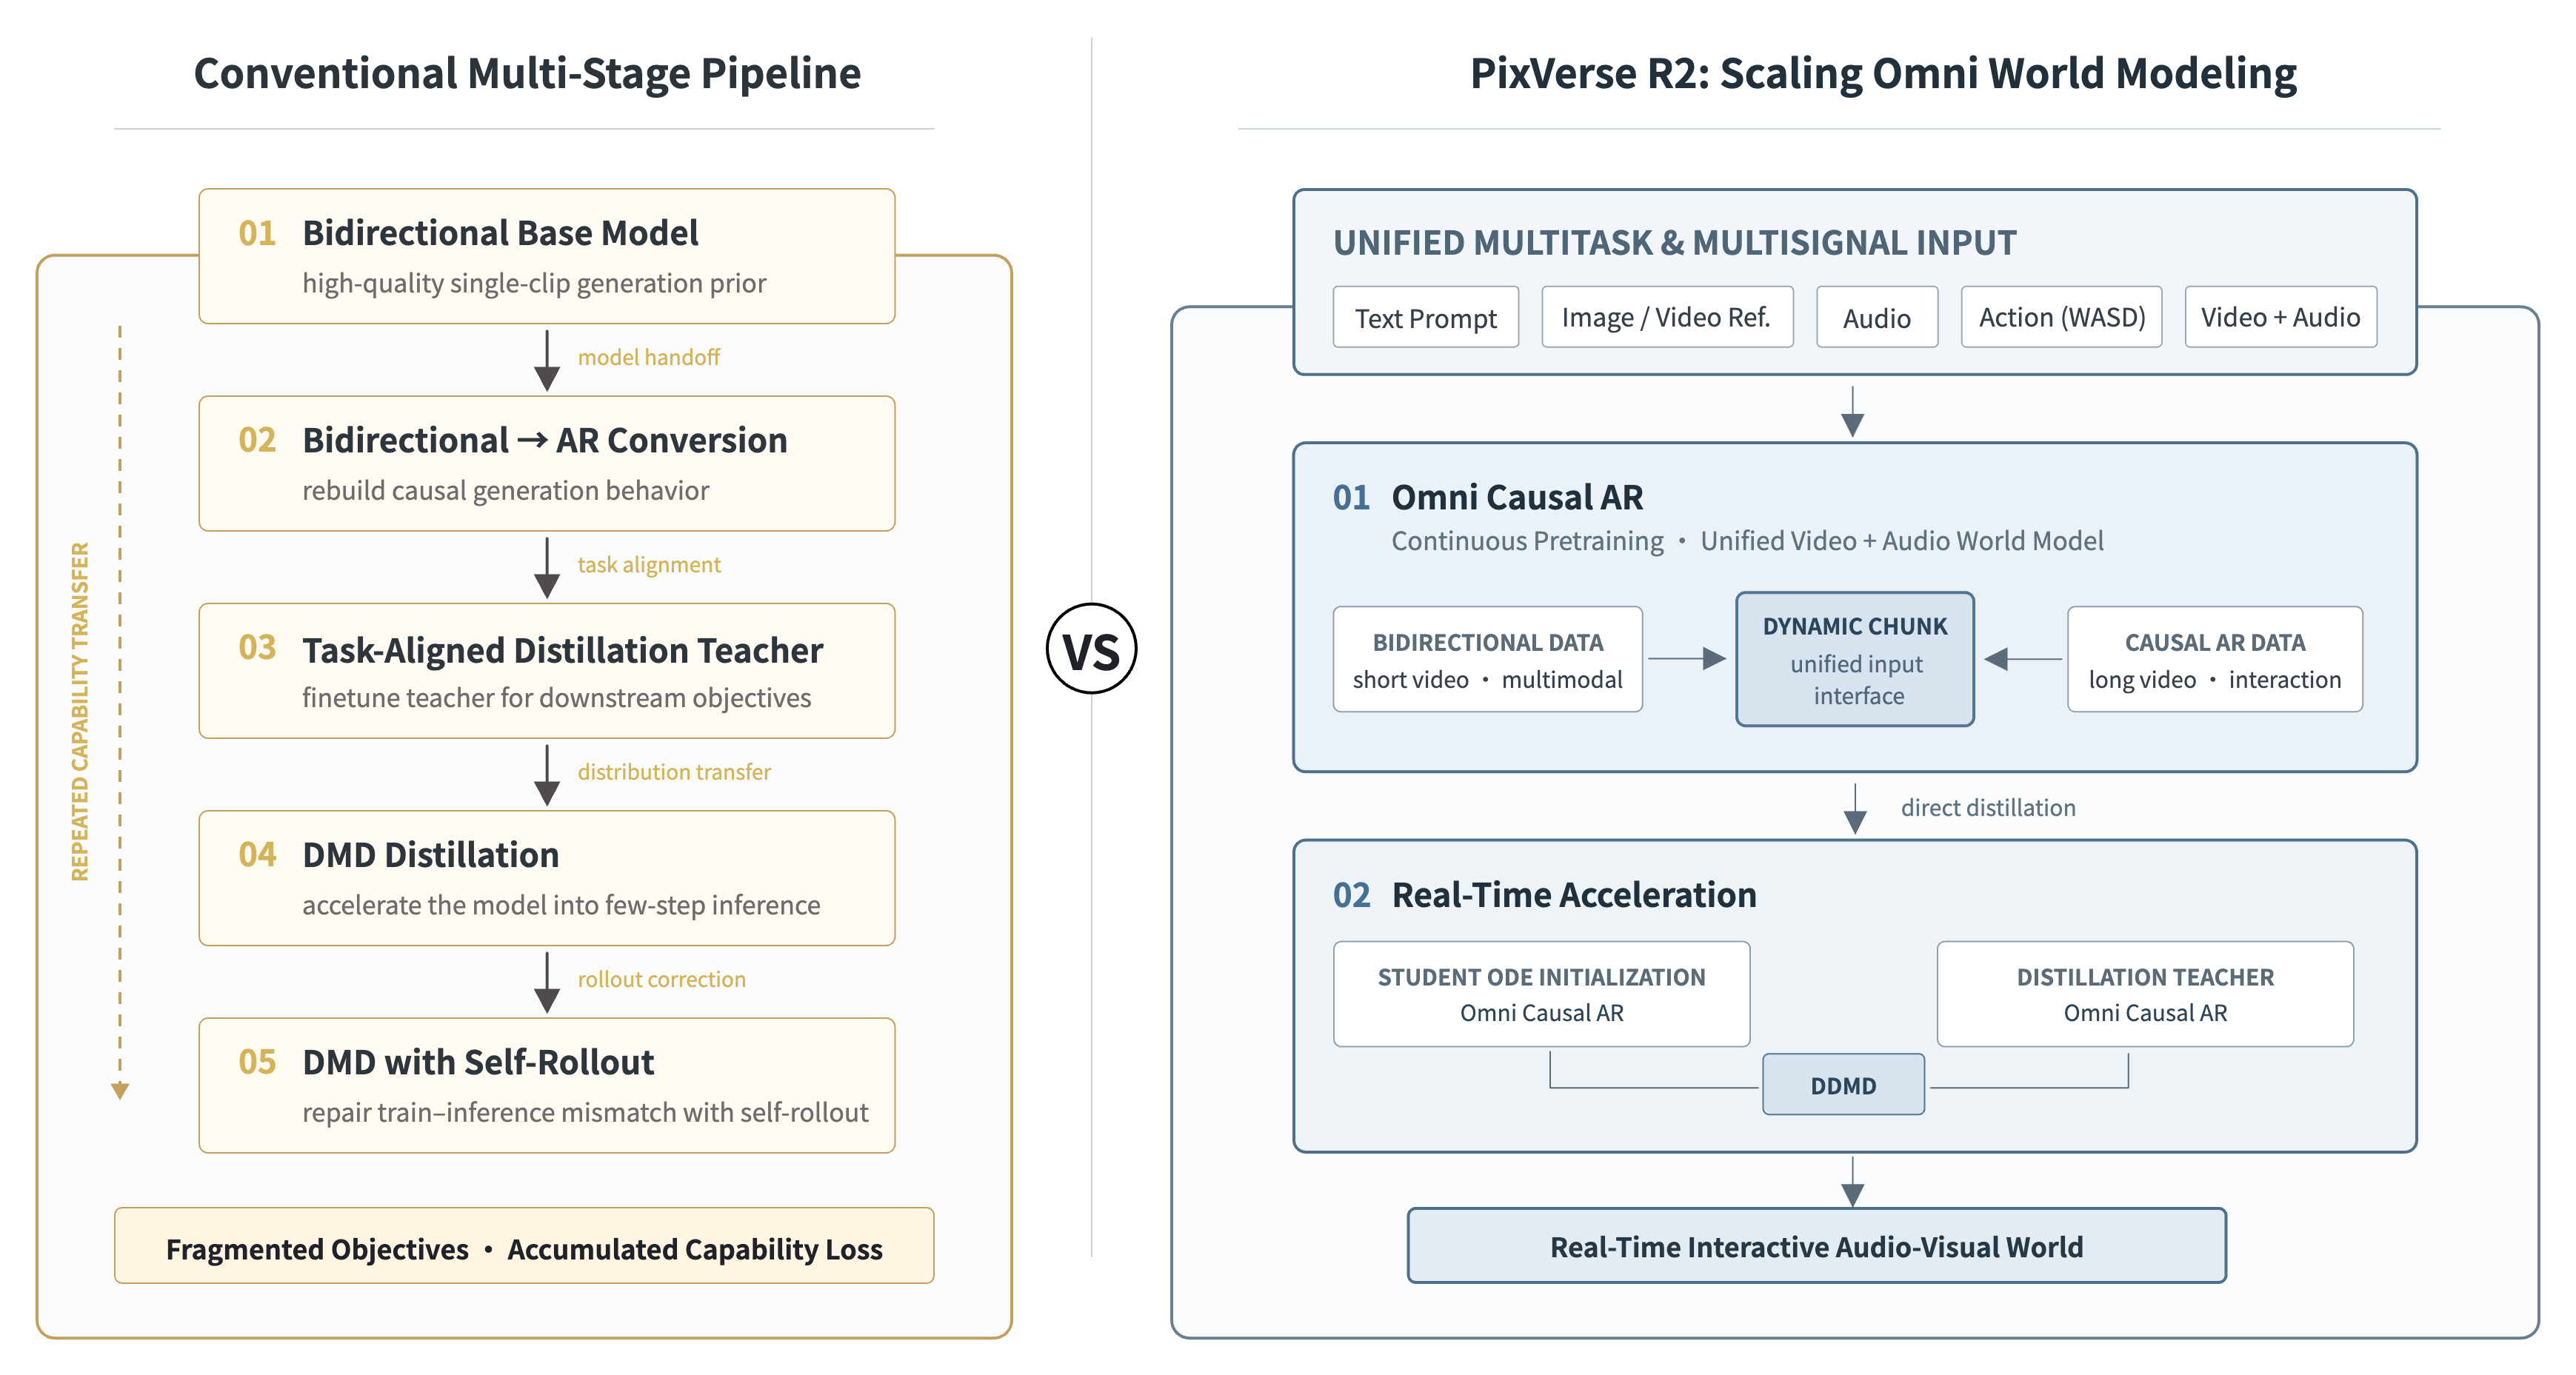
Abbildung 1. Traditionelle Mehrstufen-Pipeline versus skalierbare Weltmodellierung in PixVerse R2. R2 führt Fähigkeitserweiterung und Echtzeit-Destillation in Omni Causal AR und einer Echtzeit-Beschleunigungsschicht zusammen und vereinheitlicht Multi-Task-, Multi-Signal- und Langvideo-Modellierung in einem einzigen Rahmenwerk.
PixVerse R2 führt ein einheitliches Trainingsparadigma für Echtzeit-Weltmodelle ein. Anstatt Fähigkeiten wiederholt über viele Zwischenmodelle zu migrieren, reduziert es den Ablauf auf zwei skalierbare Prozesse: das kontinuierliche Vortraining eines Omni Causal AR, das einen einheitlichen Weltzustand verwaltet, und dessen direkte Destillation in ein beschleunigtes Modell, das in Echtzeit generieren kann und dabei räumliche Konsistenz sowie Langzeitstabilität übernimmt.
Weniger Schnittstellen zwischen einzelnen Stufen minimieren den Qualitätsverlust, der bisher durch unabhängige Lehrermodelle und wiederholte Modelltransfers entstand. Neue Daten, Aufgaben, Steuerungssignale und Modellparameter schlagen sich direkter in der Echtzeit-Modellierungsleistung nieder.
Stufe 1: Kontinuierliches Vortraining von Omni Causal AR. R2 trennt bidirektionale Priors und autoregressive Langvideomodelle nicht länger voneinander. Es trainiert kontinuierlich ein vereinheitlichtes Omni Causal AR auf Basis der Fähigkeiten bidirektionaler Modelle. Dynamische Chunks (Dynamic Chunks) geben unterschiedlichen Datenformaten eine gemeinsame zeitliche Repräsentation: Das Modell absorbiert hochwertige Kurzvideos und multimodale Daten aus dem bidirektionalen Vortraining und skaliert nahtlos zu zusammenhängenden Langvideos und interaktiven Interaktionsverläufen. Bildqualität, audiovisuelle Ausdruckskraft, Langzeitgenerierung und Steuerung über mehrere Signalquellen wachsen in einem einzigen Modell.
Stufe 2: Destillation einer Echtzeit-Beschleunigungsschicht aus Omni Causal AR. Das kontinuierliche Vortraining verleiht Omni Causal AR hohe Ausgabequalität, stabilen Langzeitzustandstransfer und ein echtes kausales Rollout. R2 nutzt dieselbe Omni Causal AR-Architektur sowohl für die Initialisierung der Schüler-ODE als auch als Destillations-Lehrer. Dadurch teilen sich Lehrer, Schüler und die reale AR-Inferenz eine konsistente kausale Basis. Die Echtzeit-Destillation wird so zu einer Beschleunigung eines bereits existierenden Weltmodells auf wenige Rechenschritte und erfordert kein erneutes Erlernen der Weltkonsistenz.
Omni Causal AR
R2 setzt den von R1 erprobten Weg multimodaler Eingaben, autoregressiver Generierung und direkter Interaktion fort und bündelt diese Fähigkeiten in einem einheitlichen Omni Causal AR-Trainingspfad. Omni Causal AR transformiert raum-zeitliche Priors in einen Weltzustandstransfer, der sich strikt vorwärts in der Zeit bewegt. Durch Kausalisierung und fortlaufendes Vortraining bewahrt das Modell Bildqualität, Bewegungsdynamik, Audio und multimodale Semantik, während es lernt, das nächste synchrone audiovisuelle Segment allein aus der bisherigen Historie vorherzusagen.
Mit dem Übergang von isolierten Kurzclips zu kontinuierlichen Langvideos und mehrstufigen Interaktionspfaden baut das Modell eine langfristige Kausalität zwischen vergangenem Weltzustand, aktuellem Steuerungsbefehl und zukünftiger Weltentwicklung auf.
Das Modell verarbeitet Textprompts, multimodale Referenzen, Aktionssignale (wie WASD-Tasten oder analoge Befehle) und Audiodaten gemeinsam und liefert lippensynchrones Video und Audio. Verschiedene Steuersignale können während des Betriebs dynamisch eingespeist werden und spätere Weltzustände beeinflussen. R2 reagiert nicht nur auf eine einmalige Vorgabe: Es generiert Inhalte, verarbeitet Befehle und aktualisiert die Spielwelt zeitgleich.
Um eine kausale Generierung innerhalb derselben Welt über lange Zeiträume stabil zu halten, löst R2 vier fundamentale Probleme: die Verteilungsdiskrepanz zwischen Training und Inferenz, die Robustheit gegenüber unvollständigen Verläufen, die Abstimmung zwischen Langzeit- und Kurzzeitgedächtnis sowie die Korrektur fehlerhafter Zustände. Hybrid Teacher / Diffusion Forcing ermöglicht es dem Modell, sowohl mit idealen als auch mit gestörten Verläufen umzugehen. Das Multi-Timescale Memory speichert globale Anker, kurzfristige Bewegungen und Objektzustände. Eine Fehlerdatenbank (Error Bank) bringt aufgetretene Abweichungen zurück ins Training. Gemeinsam bilden sie eine geschlossene Regelschleife für den langfristigen Weltzustand und minimieren Drift bei Darstellung, Figuren, Bewegungsabläufen und Steuerungsreaktionen.
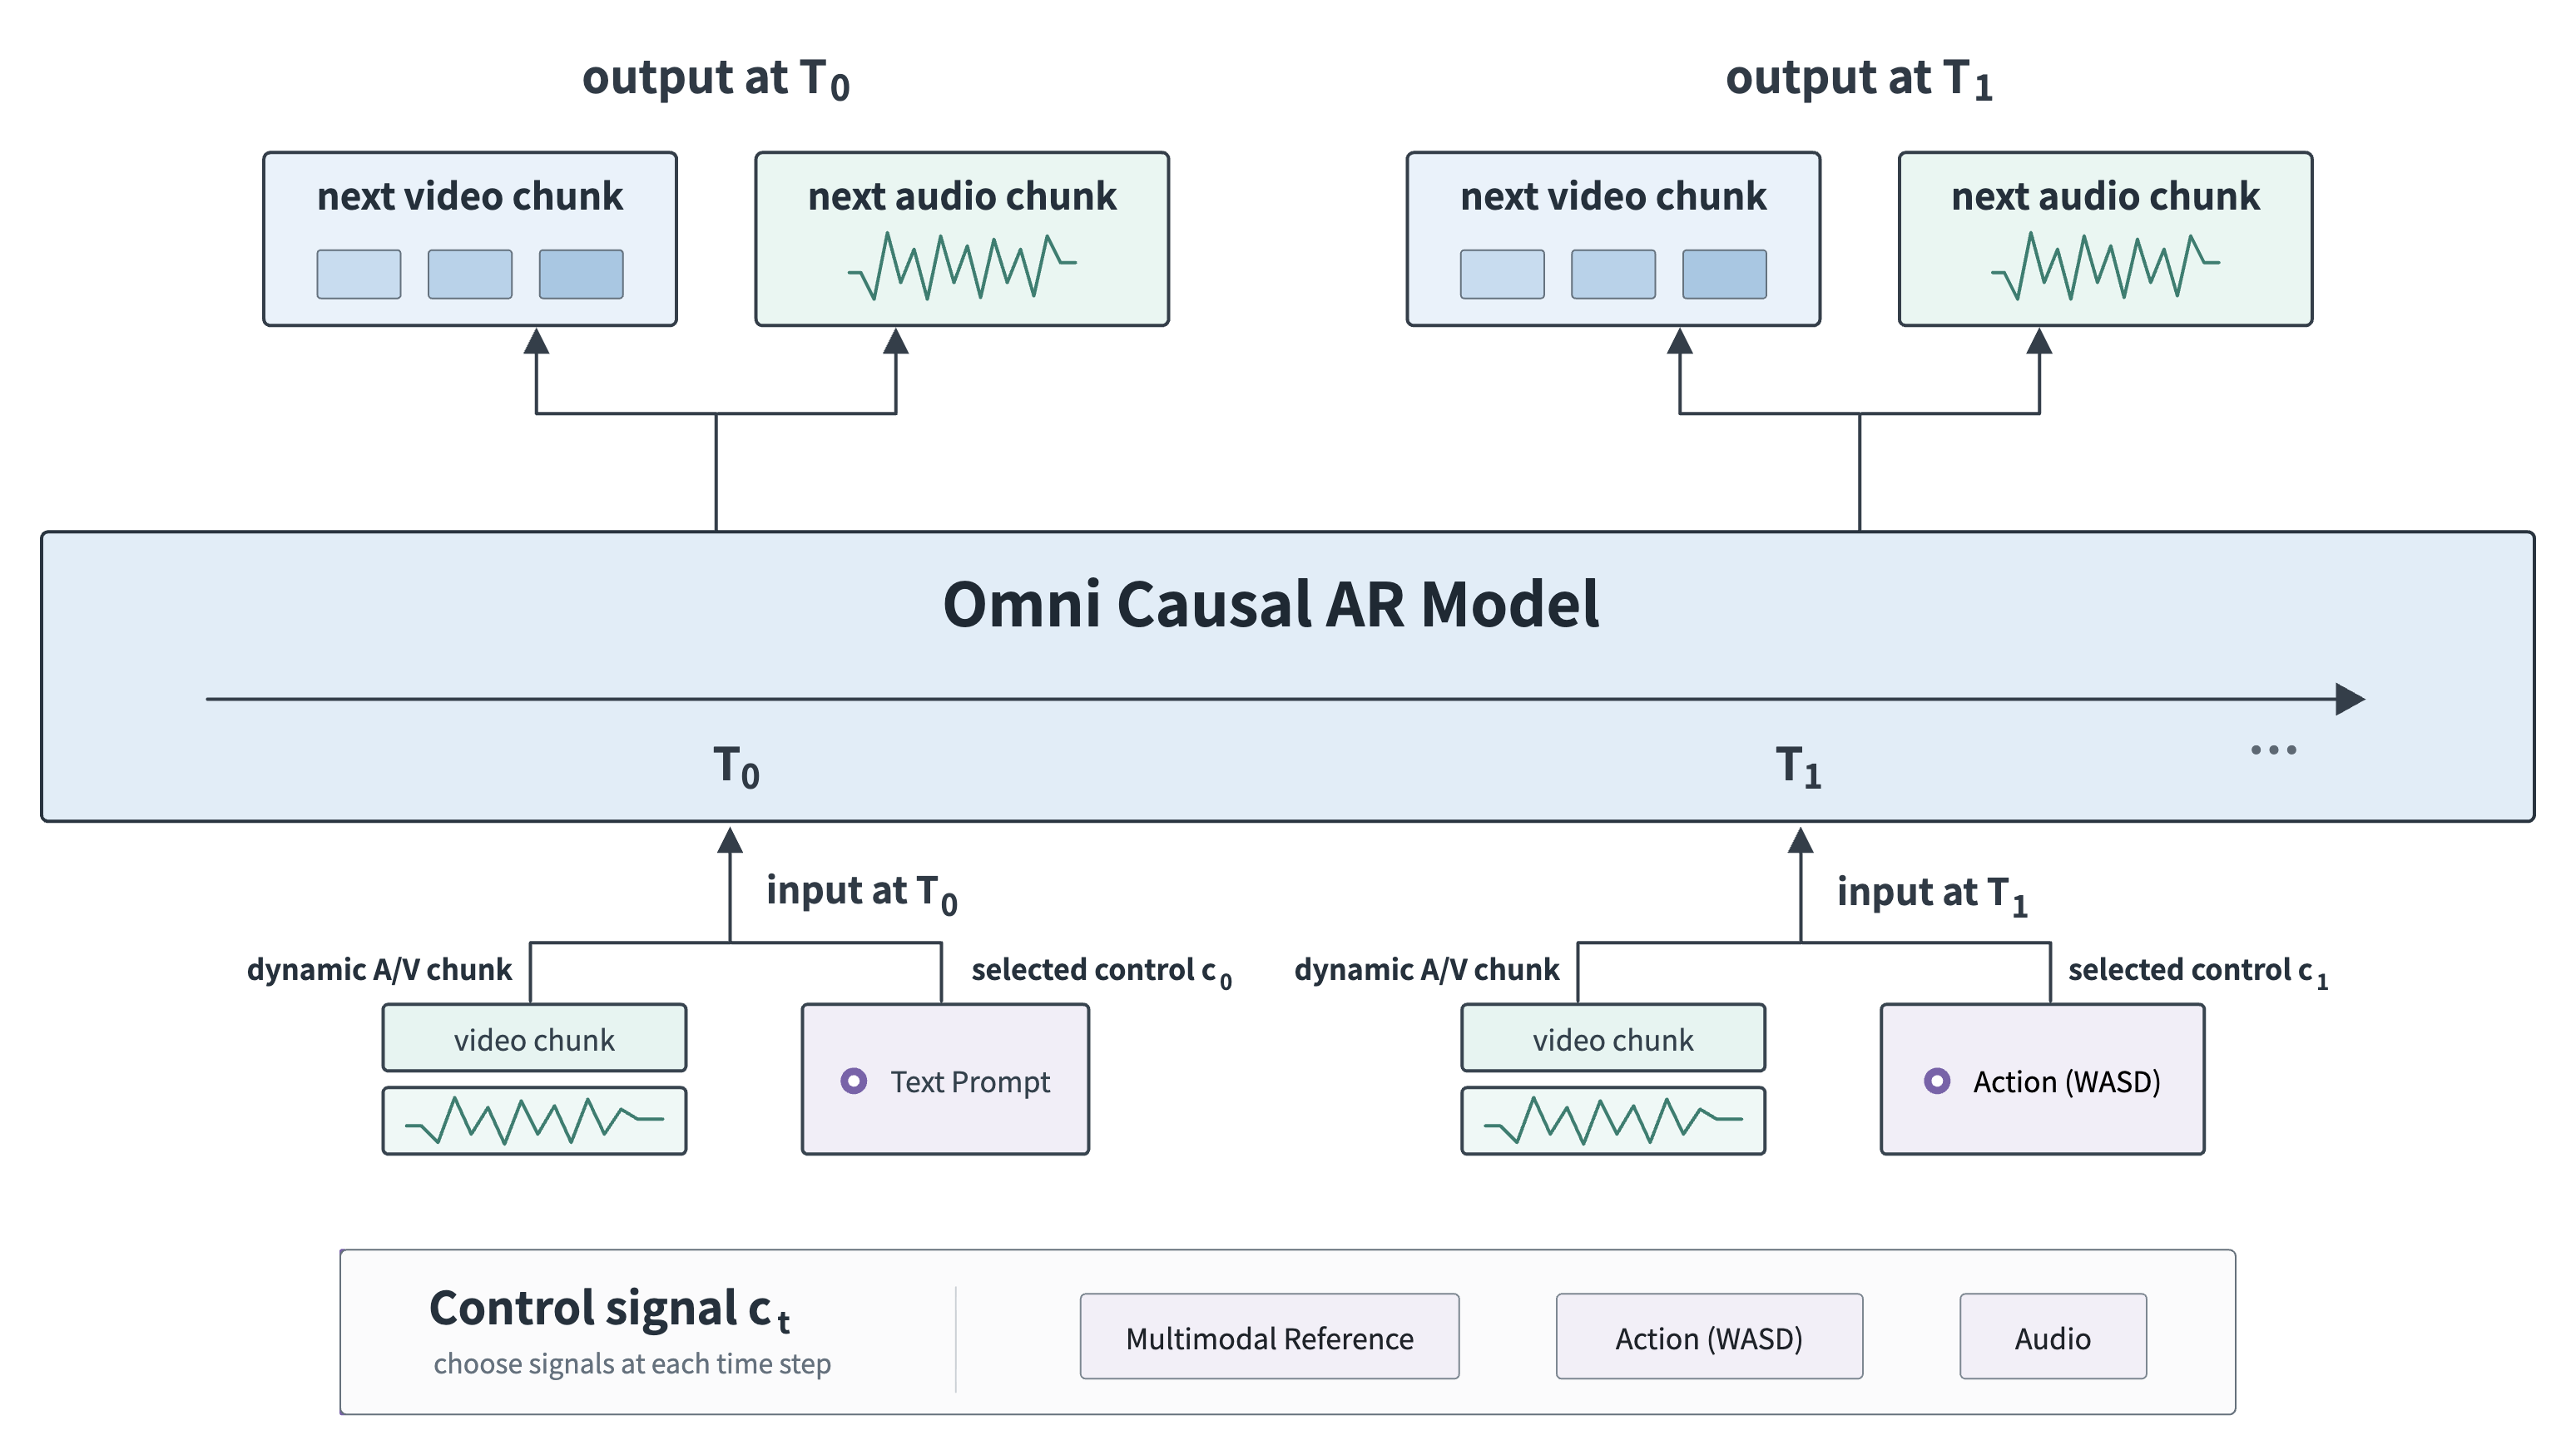
Abbildung 2. PixVerse R2 Omni Causal AR. Das Modell kann während des Betriebs kontinuierlich Steuersignale aufnehmen. Bei jeder Interaktion synchronisiert sich das aktive Signal mit einem dynamischen audiovisuellen Chunk in passender Granularität und steuert das folgende Video- und Audiosegment.
Generierung mit dynamischen Chunks
Unterschiedliche Steuerungssignale bewegen sich auf verschiedenen Zeitskalen. Prompts und Referenzen beschreiben typischerweise vollständige Szenen oder längere Handlungsbögen. Aktionen (WASD) verlangen sofortiges, feingranulares Zustandsfeedback. Audio vereint Inhalt, Rhythmus und zeitliche Synchronität in einem Signal. Würde jede Eingabe in ein starres Zeitraster gezwungen, müsste das Modell Reaktionsgeschwindigkeit gegen Ausdrucksreichtum abwägen.
Dynamic Chunk ist die Methode, mit der R2 diese unterschiedlichen Zeitskalen harmonisiert. R2 unterteilt audiovisuelle Sequenzen adaptiv anhand der inhaltlichen Grenzen und der Dauer des aktuellen Steuersignals, begrenzt durch eine maximale Chunk-Größe zur Sicherung von Stabilität und Rechenaufwand. Kurze Chunks erhöhen die Reaktionspräzision auf direkte Steuerbefehle. Lange Chunks bewahren die komplexe Struktur von Ereignissen, Bewegungen und Audioinhalten. Unterschiedliche Aufgaben teilen sich so dieselbe kausale Schnittstelle, ohne dass das Modell umkonfiguriert werden muss.
Hybrid Teacher Forcing / Diffusion Forcing
Der zentrale Konflikt beim autoregressiven Lernen über lange Zeithorizonte liegt darin, dass Trainingsdaten makellos sind, während reale Verläufe zur Laufzeit unvermeidlich Rauschen und kleine Eigenfehler des Modells anhäufen. Ein ausschließliches Training mit fehlerfreien Daten steigert zwar die isolierte Bildqualität, macht das Modell jedoch extrem anfällig für minimale Abweichungen. Ein Training nur auf fehlerhaften Daten beeinträchtigt hingegen Schärfe, Bewegung und Steuerungsfolgsamkeit.
R2 kombiniert fehlerfreie und fehlerbehaftete Verläufe in einem einheitlichen Trainingsprozess. Der saubere Verlauf sichert das Qualitätsmaximum der Weltentwicklung. Der unvollständige Verlauf gewöhnt das Modell frühzeitig an reale Einsatzbedingungen. Dieses komplementäre Training schließt die Lücke zwischen Training und Praxis, sodass das System auch bei kleineren Vorfehlern im Verlauf ein stabiles, hochwertiges Folge-Segment berechnen kann.
Causal Attention Mask und Relative Temporal RoPE steuern gemeinsam, welche vergangenen Zustände abrufbar sind und wie sie im aktuellen Aufmerksamkeitsfenster verortet werden. Die Aufmerksamkeitsmaske erzwingt strikte Kausalität. Das zeitliche RoPE wächst nicht unbegrenzt mit einer globalen Block-ID, sondern wird über relative Positionen im aktiven Fenster indexiert. Wenn das Fenster weiterrückt, schreitet die reale Zeit fort, während Ankerspeicher, jüngste Historie und der aktuelle Chunk innerhalb eines klar definierten relativen Koordinatenbereichs verbleiben.
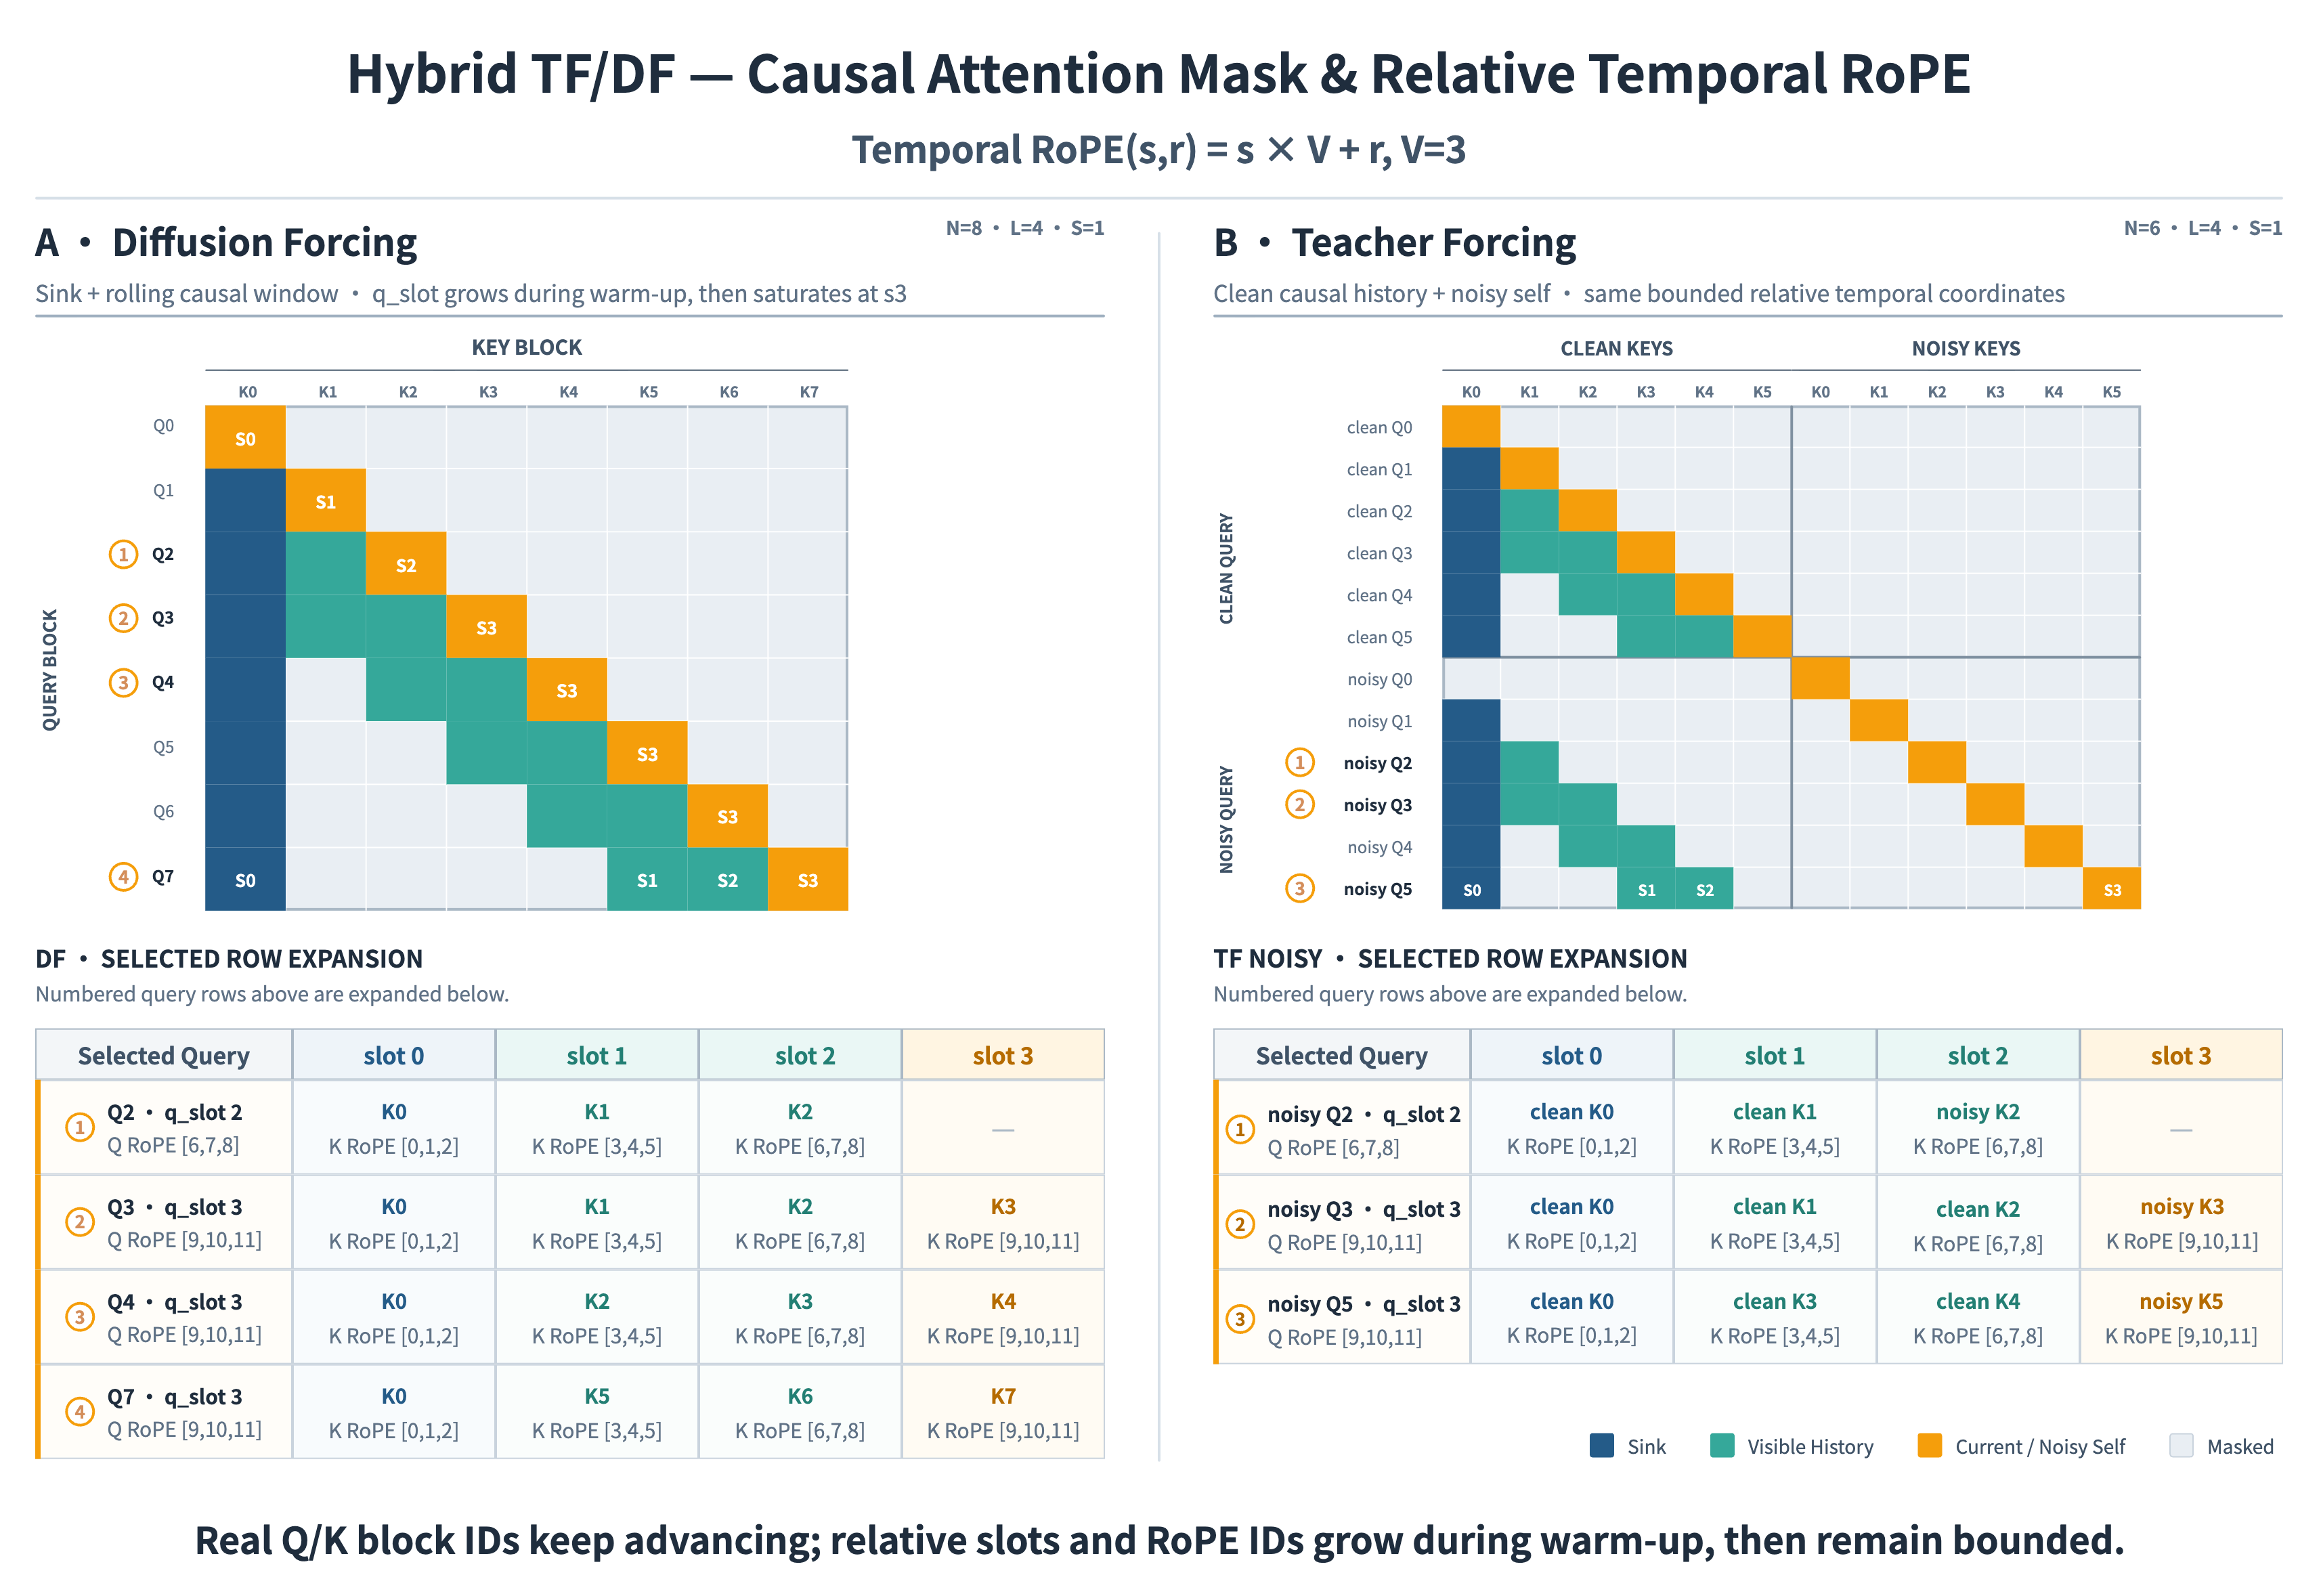
Abbildung 3. Einheitliche kausale Aufmerksamkeitsmaske und relatives temporales RoPE für Hybrid Teacher / Diffusion Forcing. Oben ist die kausale Sichtbarkeit für beide Verlaufskonfigurationen dargestellt. Unten werden Abfragen auf Q/K-Blöcke, relative Positionen und RoPE-IDs projiziert, was verdeutlicht, dass reale Block-IDs fortschreiten, während interne Zeitkoordinaten beschränkt bleiben.
Mehrstufiges Gedächtnissystem (Multi-timescale memory)
Langfristige Weltmodellierung kann nicht bedeuten, die gesamte Historie lückenlos im Speicher zu halten. Ein unbegrenztes Mitziehen aller Daten treibt Rechenaufwand und Speicherbedarf rasch in die Höhe; ein zu radikales Abschneiden zerstört Figurenidentität, Szenenaufbau und Kernereignisse. R2 setzt auf ein dreistufiges Speichersystem aus Sink Memory, Rolling History und einem Object KV Cache.
- Sink Memory: Speichert dauerhafte Anker wie Charakterzüge, Schauplätze, Stilmerkmale und Grundregeln der Welt.
- Rolling History: Konzentriert sich auf jüngste Aktionen, Posen, Kamerabewegungen und Umgebungsveränderungen für nahtlose Übergänge.
- Object KV Cache: Komprimiert und nutzt bereits berechnete Objektrepräsentationen, sodass nur jene Zustände im Speicher verbleiben, die für die weitere Entwicklung relevant sind.
Das Zusammenspiel dieser drei Stufen gewährleistet langfristige Wiedererkennbarkeit, unmittelbare Bewegungskontinuität und beherrschbare Betriebskosten bei minimaler Charakter- oder Szenendrift.
Fehlerdatenbank (Error Bank)
Starke Abweichungen in autoregressiven Weltmodellen entstehen häufig aus winzigen Anfangsfehlern, die in die Historie einfließen und sich schrittweise aufschaukeln. R2 nutzt eine Error Bank, die typische fehlerhafte Verläufe sammelt und diese im Training gezielt mit festen Raten wieder einspielt. Das Modell lernt dadurch nicht nur, von Idealzuständen auszugehen, sondern auch bereits leicht abgedriftete Situationen zu erkennen, auszugleichen und zu korrigieren.
In standardisierten Tests sank der langfristige Helligkeitsdrift-Wert von 0,201 auf 0,129 – ein Rückgang um rund 35,8 %. Von 29 untersuchten Langsequenzen verbesserten sich 20 deutlich, und alle 5 Sequenzen mit beabsichtigter Bewegungslosigkeit reduzierten fehlerhafte Eigenbewegungen spürbar.
Echtzeit-Beschleunigung
Die Echtzeit-Beschleunigung von R2 versucht nicht, einem Wenig-Schritt-Modell mühsam eine neue Weltkonsistenz anzutrainieren. Sie beschleunigt ein Weltmodell, das bereits nachweislich über lange Zeiträume stabil funktioniert. Die Beschleunigungsschicht baut direkt auf dem vortrainierten Omni Causal AR auf und nutzt dieses sowohl für die Initialisierung als auch als Destillations-Lehrer, wodurch alle Komponenten denselben kausalen Verlauf teilen.
Diese gemeinsame kausale Basis reduziert den Bedarf an aufwendigen Feinabstimmungen wie Self-Forcing oder Rolling Forcing. Die Beschleunigung kann sich ganz auf die eigentlichen Herausforderungen der Wenig-Schritt-Generierung konzentrieren: DDMD mit adversarieller Regularisierung sorgt für Befolgung von Vorgaben, Verteilungstreue und Realismus; block-sparse Attention reduziert den Berechnungsaufwand bei langen Kontexten; und eine Pyramiden-Struktur senkt die Kosten hochauflösender Bildausgaben.
DDMD mit adversarieller Regularisierung
Bei der Generierung in extrem wenigen Schritten stellen Bedingungstreue, Verteilungsabgleich und visueller Realismus unterschiedliche Optimierungsziele dar. R2 baut auf DDMD auf und ergänzt es um die adversarielle Regularisierung aus DMD2. Drei Trainingssignale wirken im Schüler zusammen: Das Befolgen von Bedingungen stärkt die Steuerung, der Verteilungsabgleich wahrt das Wissen des Lehrers und die adversarielle Regularisierung verankert das Ergebnis in realen Daten. So genügen wenige Rechenschritte für präzise Steuerungsreaktionen und eine überzeugende Bildwelt.
Block-sparse Attention
R2 setzt auf block-sparse Attention bei raum-zeitlichen Token-Sequenzen. Das Modell unterteilt Q-, K- und V-Matrizen in Berechnungsblöcke, schätzt zügig ab, welche Schlüssel- und Werteblöcke für jeden Abfrageblock wesentlich sind, behält nur die relevantesten Verbindungen bei und führt auf diesen ausgewählten Blöcken exakte Softmax-Attention aus. Dieses strukturierte Routing konzentriert die Rechenleistung gezielt auf die starken Wechselwirkungen zwischen Steuerungseingabe, jüngster Dynamik und wesentlichem Weltzustand.
Durch die Anpassung des Netzes an diese spärliche Verbindungsstruktur während des Trainings steigert R2 die Aufmerksamkeits-Sparsity auf über 90 %, ohne dass Bildschärfe, Bewegungskontinuität oder Steuerungspräzision in den Tests messbar abfallen.
Pyramidale Destillation in extrem wenigen Schritten
Die vollständige Weltberechnung von Beginn an im hochauflösenden Raum durchzuführen, bindet unnötig Ressourcen an globale Bildstrukturen, die bereits in niedrigerer Auflösung festgelegt werden können. R2 gliedert die Generierung in ein bis zwei Phasen niedrigerer Auflösung gefolgt von einer finalen Hochauflösungsphase. Die ersten Stufen definieren Komposition, Bewegungsabläufe und Kamerapfade. Die finale Stufe arbeitet Details, Kanten und Texturen heraus. Dieser Ansatz spart erhebliche Rechenkapazitäten ein und festigt gleichzeitig die globale Strukturstabilität.
Fazit und Grenzen
PixVerse R1 stellte das erste praxistaugliche Echtzeit-Videoweltmodell vor und bewies, dass KI-Video von vorgerenderten Konserven zu interaktiven, fortlaufenden Erlebniswelten übergehen kann. PixVerse R2 löst die Frage der Skalierung: Ein vereinheitlichtes Omni Causal AR nimmt wachsende Datenmengen, Modalitäten und Zeithorizonte auf, während die Echtzeit-Beschleunigung dieses Potenzial in reaktionsschnelle Inferenz mit wenigen Schritten überführt.
R2 ist keine punktuelle Optimierung einzelner Parameter, sondern ein durchgängiges Trainingskonzept für die nächste Generation von Weltmodellen. R1 hat Echtzeit-Videoweltmodelle Wirklichkeit werden lassen; R2 überführt sie in eine skalierbare, kontinuierlich lernende Entwicklungsstufe.
Unter den strikten Vorgaben sofortiger Interaktion und minimaler Latenz hat die Bildqualität einzelner Szenen gegenüber führenden Offline-Videomodellen noch Entwicklungspotenzial – insbesondere bei feinteiligen Texturen, absoluter Bewegungsnatürlichkeit und perfekter Langzeitstabilität. Diese Unterschiede spiegeln den aktuellen Entwicklungsstand von R2 wider und stellen keine grundsätzliche Grenze der Architektur dar.
Vorabzugang (Early Access)
Stand 23. August 2026 beschrieb dieser Bericht PixVerse R2 als geschlossene Testphase. Am 22. September 2026 kündigte PixVerse an, dass eine Sammlung dieser Welten unter world.pixverse.video offen erkundet werden kann. Siehe die R2-Startankündigung.
Diese Ankündigung öffnet keinen uneingeschränkten API-Zugang. Das PixVerse Weltmodell R2 Anmeldeformular bleibt der Antragsweg für den Vorabzugang und API-Schlüssel.
Weiterführende Ressourcen
- PixVerse R1 erklärt: Echtzeit-KI-Videoweltmodell
- PixVerse Game Engine im Detail
- PixVerse erweitert R1 um geteilte Welten
- Leitfaden zur Echtzeit-KI-Videogenerierung
- PixVerse schließt Serie-C-Erweiterung ab
Welten aus der Ankündigung vom 22. September 2026 sind unter world.pixverse.video offen zu erkunden. Der API-Zugang wird weiterhin über das Formular oben beantragt. Sie können auch heute mit PixVerse V6 und R1 eigene Projekte erstellen.