PixVerse R2: Масштабирование Omni-моделей мира реального времени
PixVerse R1 представил и внедрил первую в индустрии модель мира видео в реальном времени, превратив генерацию видео из создания статичного клипа в непрерывно функционирующий интерактивный мир. Модель способна принимать пользовательские команды на лету, мгновенно обновлять состояние окружения и транслировать синхронизированный аудиовизуальный поток, полностью согласованный с действиями игрока. Модель R1 доказала практическую реализуемость этой парадигмы.
PixVerse R2 отвечает на следующий фундаментальный вопрос: как масштабировать модель мира видео в реальном времени. R2 сфокусирован на двух ключевых целях. Во-первых, создать динамический мир, способный сохранять целостное состояние на длительных временных отрезках, преобразуя пространственно-временные априорные знания в строго направленную вперед эволюцию среды. Во-вторых, непрерывно интегрировать законы физической причинности и сигналы управления (текст, референсы, аудио и действия) в единую модель, чтобы среда могла одновременно генерировать кадры, принимать команды и обновлять состояние при непрерывной трансляции синхронного звука и видео.
Благодаря этим целям R2 преобразует рост масштаба моделей, обучающих данных, задач и управляющих сигналов в повышение качества картинки, долговременную стабильность и высокую точность мультимодального контроля.
Общая структура архитектуры
R2 объединяет систему в два фундаментальных уровня: Omni Causal AR и Ускорение в реальном времени. Omni Causal AR отвечает за постоянное расширение возможностей качественной мультимодальной генерации мира на длинных дистанциях. Уровень ускорения в реальном времени наследует эти возможности практически без потерь в рамках жесткого бюджета задержки отклика. Логика прозрачна: поднять потолок возможностей базовой модели мира, а затем перенести этот потенциал в интерактивный режим реального времени.
Прежние пайплайны для генерации длинных видео в реальном времени состояли из длинной цепочки этапов обучения: конвертация двунаправленной модели в авторегрессионную (AR), создание учителя дистилляции из специализированной модели, дистилляция по методу DMD и добавление DMD с саморазвертыванием для сглаживания разрыва между обучением и инференсом. На каждом этапе приходилось заново переносить возможности, перенастраивать функции потерь и подгонять распределения данных. Качество изображения, динамика движений, следование инструкциям и стабильность страдали от постоянных потерь при переносе. По мере роста объема данных и задач многоэтапный подход дробил цель оптимизации, взвинчивая вычислительные затраты и сложность инфраструктуры.
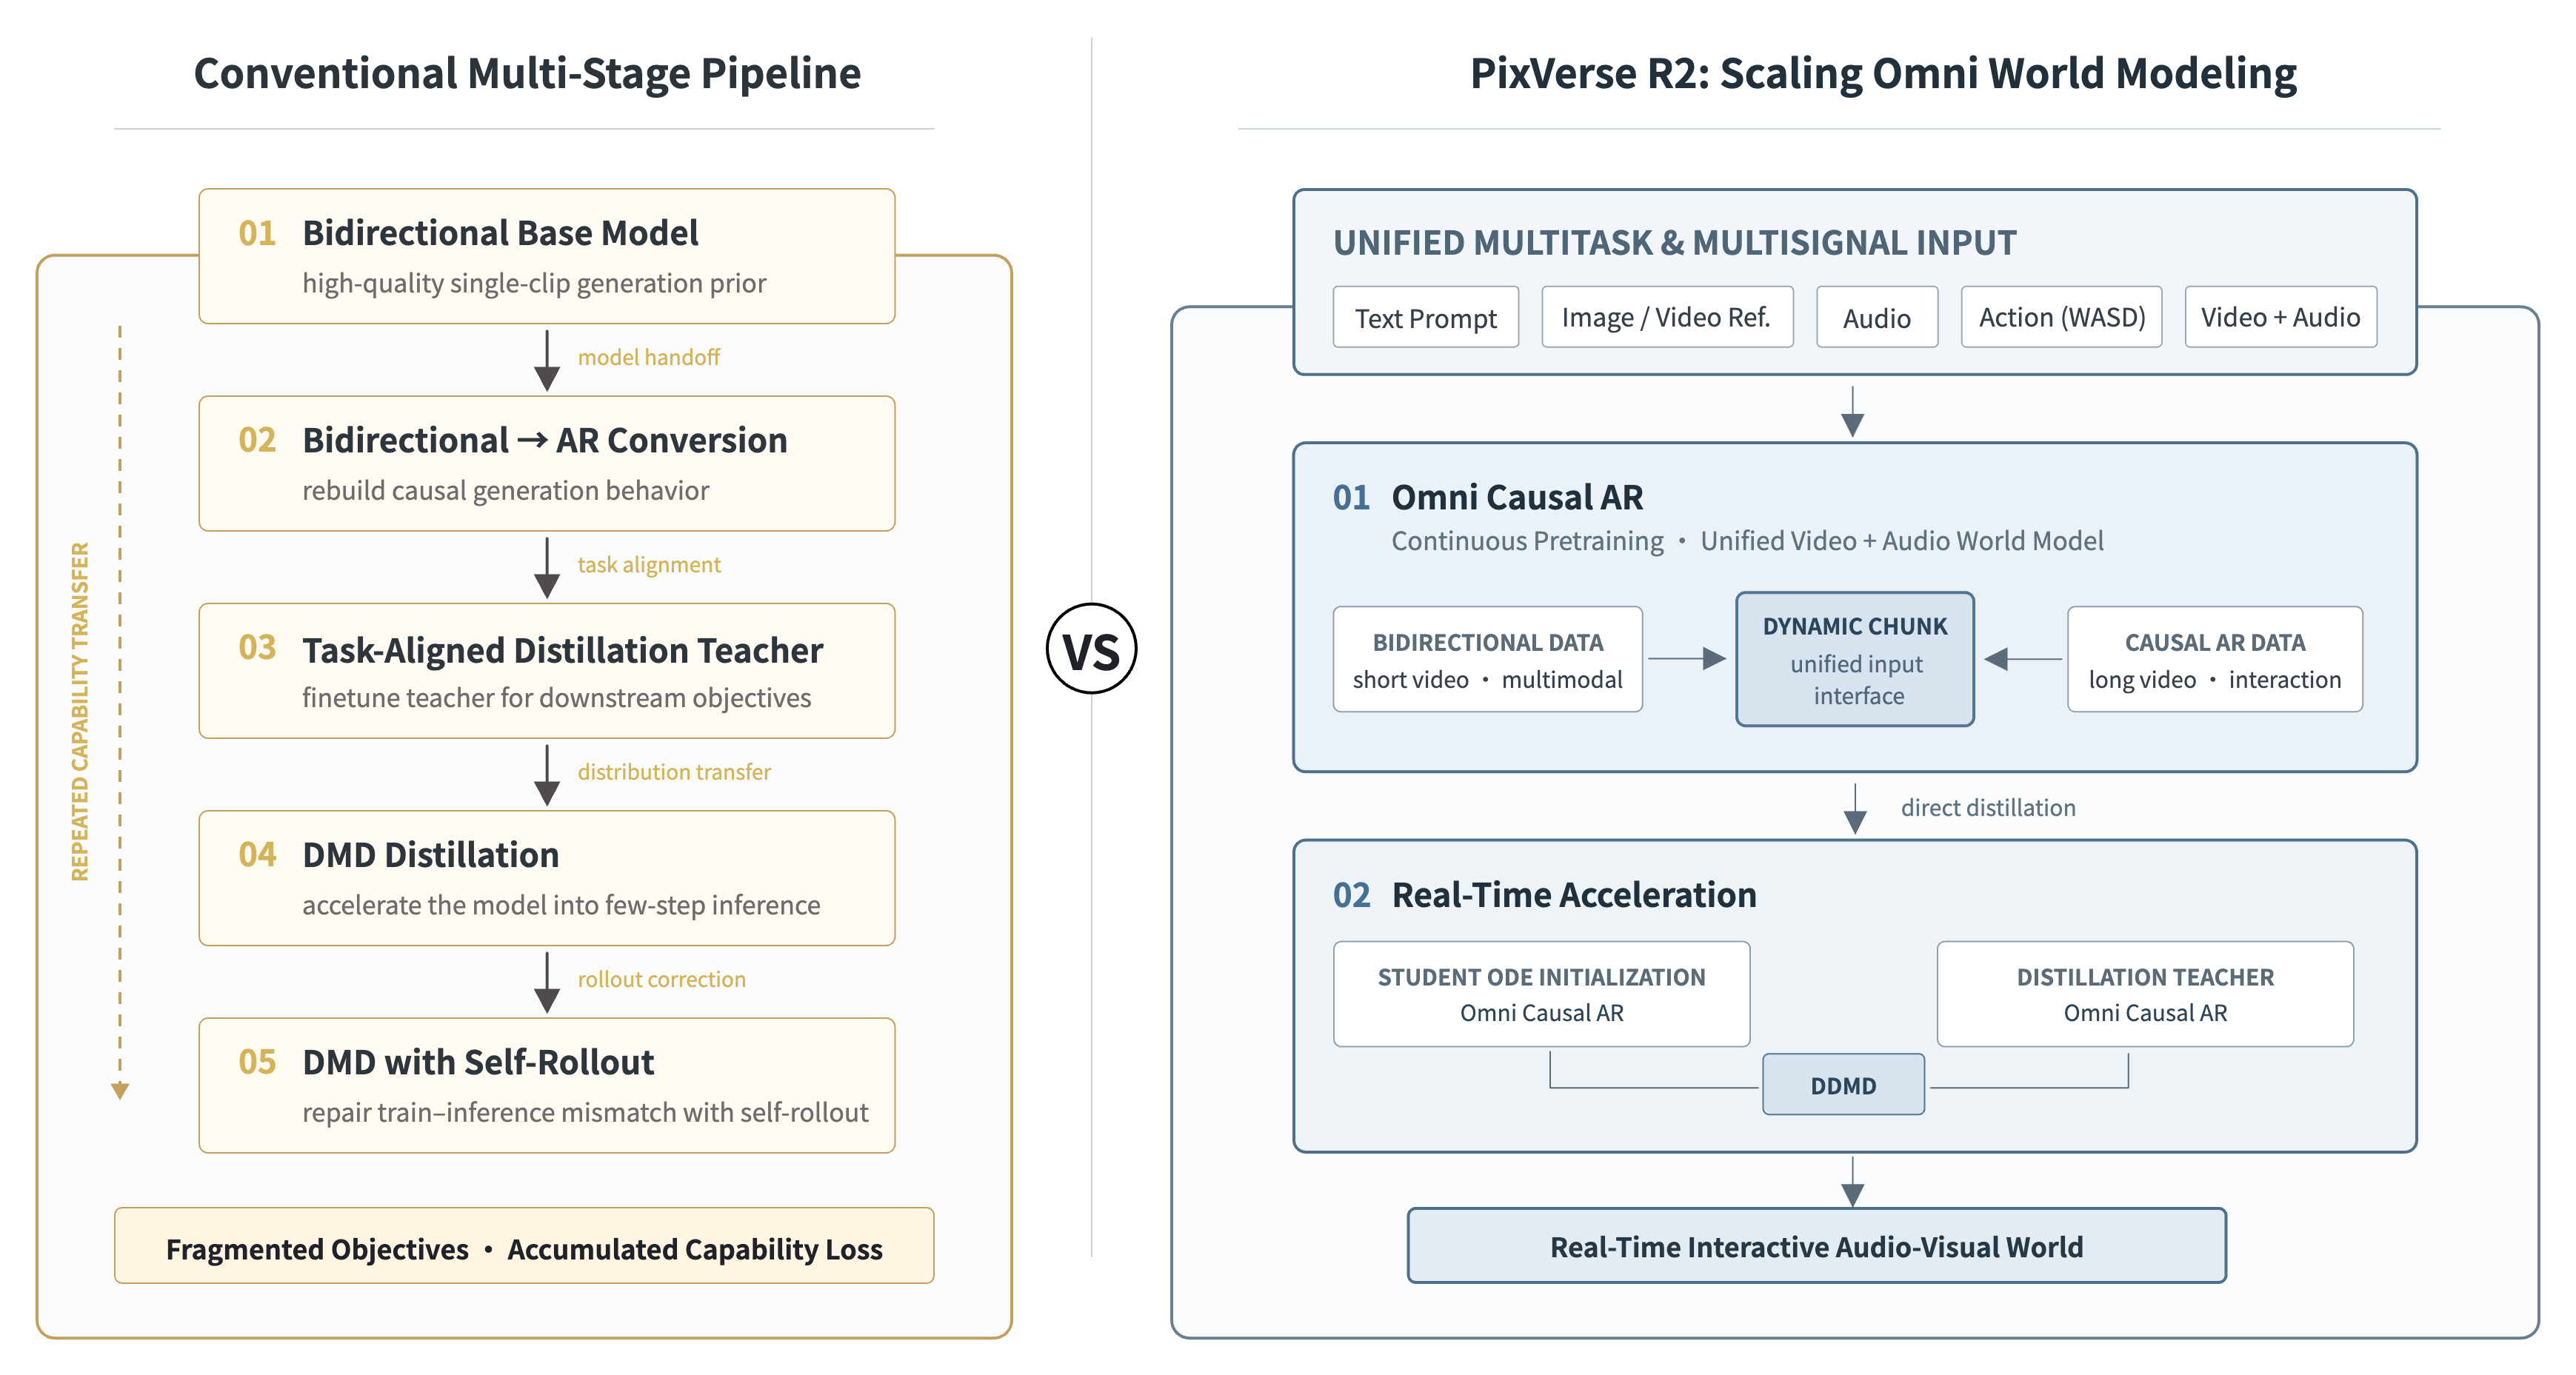
Рисунок 1. Традиционный многоэтапный конвейер в сравнении с масштабируемой моделью мира PixVerse R2. R2 объединяет расширение функционала и дистилляцию в единую систему Omni Causal AR и уровень ускорения реального времени, унифицируя многозадачное, многосигнальное моделирование длинных видео.
PixVerse R2 предлагает единую парадигму обучения моделей мира реального времени. Вместо череды взаимных миграций между моделями архитектура сведена к двум непрерывно масштабируемым процессам: постоянное предобучение Omni Causal AR, удерживающего единое состояние мира, и его прямая дистилляция в ускоренную модель, способную работать в реальном времени с сохранением пространственной и временной когерентности.
Устранение лишних этапов минимизирует деградацию качества, неизбежную при использовании разрозненных учителей и многократных переносов весов. Любые новые массивы данных, сигналы управления и вычислительные ресурсы напрямую трансформируются в усиление способностей моделирования окружения.
Этап 1: Непрерывное предобучение Omni Causal AR. R2 больше не рассматривает двунаправленные генеративные модели и авторегрессионные длинные видео как изолированные стадии. Модель Omni Causal AR непрерывно обучается поверх возможностей двунаправленных моделей. Динамические блоки (Dynamic Chunks) обеспечивают разнородным данным общее временное представление: модель впитывает высококачественные короткие ролики и мультимодальные выборки, плавно масштабируясь на длинные видеоряды и непрерывные интерактивные траектории. Качество визуала, звуковая выразительность, длительность генерации и управление различными сигналами растут внутри единой сети.
Этап 2: Дистилляция уровня ускорения реального времени из масштабированной Omni Causal AR. Непрерывное предобучение наделяет Omni Causal AR кинематографическим качеством, устойчивой передачей состояния и подлинной причинной динамикой. R2 задействует эту же модель Omni Causal AR как для инициализации ОДУ ученика, так и в качестве учителя дистилляции. Благодаря этому учитель, ученик и реальный AR-инференс опираются на согласованную траекторию причинности. Дистилляция сводится к ускорению генерации готовой модели мира за малое число шагов, исключая необходимость заново обучать модель пониманию законов мира.
Omni Causal AR
R2 развивает принципы мультимодального ввода, авторегрессии и интерактивности, заложенные в R1, сводя их в единую методику обучения Omni Causal AR. Архитектура Omni Causal AR трансформирует пространственно-временные закономерности в развитие мира, направленное строго вперед во времени. Посредством причинной адаптации и сквозного предобучения модель сохраняет качество картинки, естественность движений, чистоту звука и семантическое понимание, обучаясь предсказывать следующий блок аудио и видео исключительно на базе предшествующей истории.
По мере расширения спектра обучающих сценариев от изолированных видеофрагментов до многоминутных роликов и разветвленных интерактивных сессий модель выстраивает глубокие причинно-следственные связи между прошлым состоянием вселенной, текущей командой игрока и будущим развитием окружения.
Модель одновременно принимает текстовое описание, визуальные референсы, управляющие воздействия (например, WASD или аналоговый ввод) и звук, выдавая синхронный видео- и аудиопоток. Управляющие команды могут непрерывно поступать во время сессии, непосредственно меняя траекторию развития мира. R2 не просто исполняет разовый запрос: модель одновременно генерирует окружение, считывает управление и обновляет мир.
Для устойчивой причинной генерации на длительных дистанциях R2 решает четыре фундаментальные проблемы: несовпадение распределений при обучении и инференсе, устойчивость к зашумленной истории, баланс долговременной и оперативной памяти и исправление накапливающихся ошибок. Комплекс Hybrid Teacher / Diffusion Forcing приучает модель корректно работать как с чистой, так и с искаженной предысторией. Модуль Multi-Timescale Memory хранит глобальные якоря, недавние действия и состояния отдельных объектов. Банк ошибок (Error Bank) целенаправленно возвращает сбойные состояния в цикл обучения. Вместе они формируют устойчивый контур поддержания состояния мира, исключая визуальный дрифт, искажение внешности персонажей, рывки анимации и запаздывание реакции на команды.
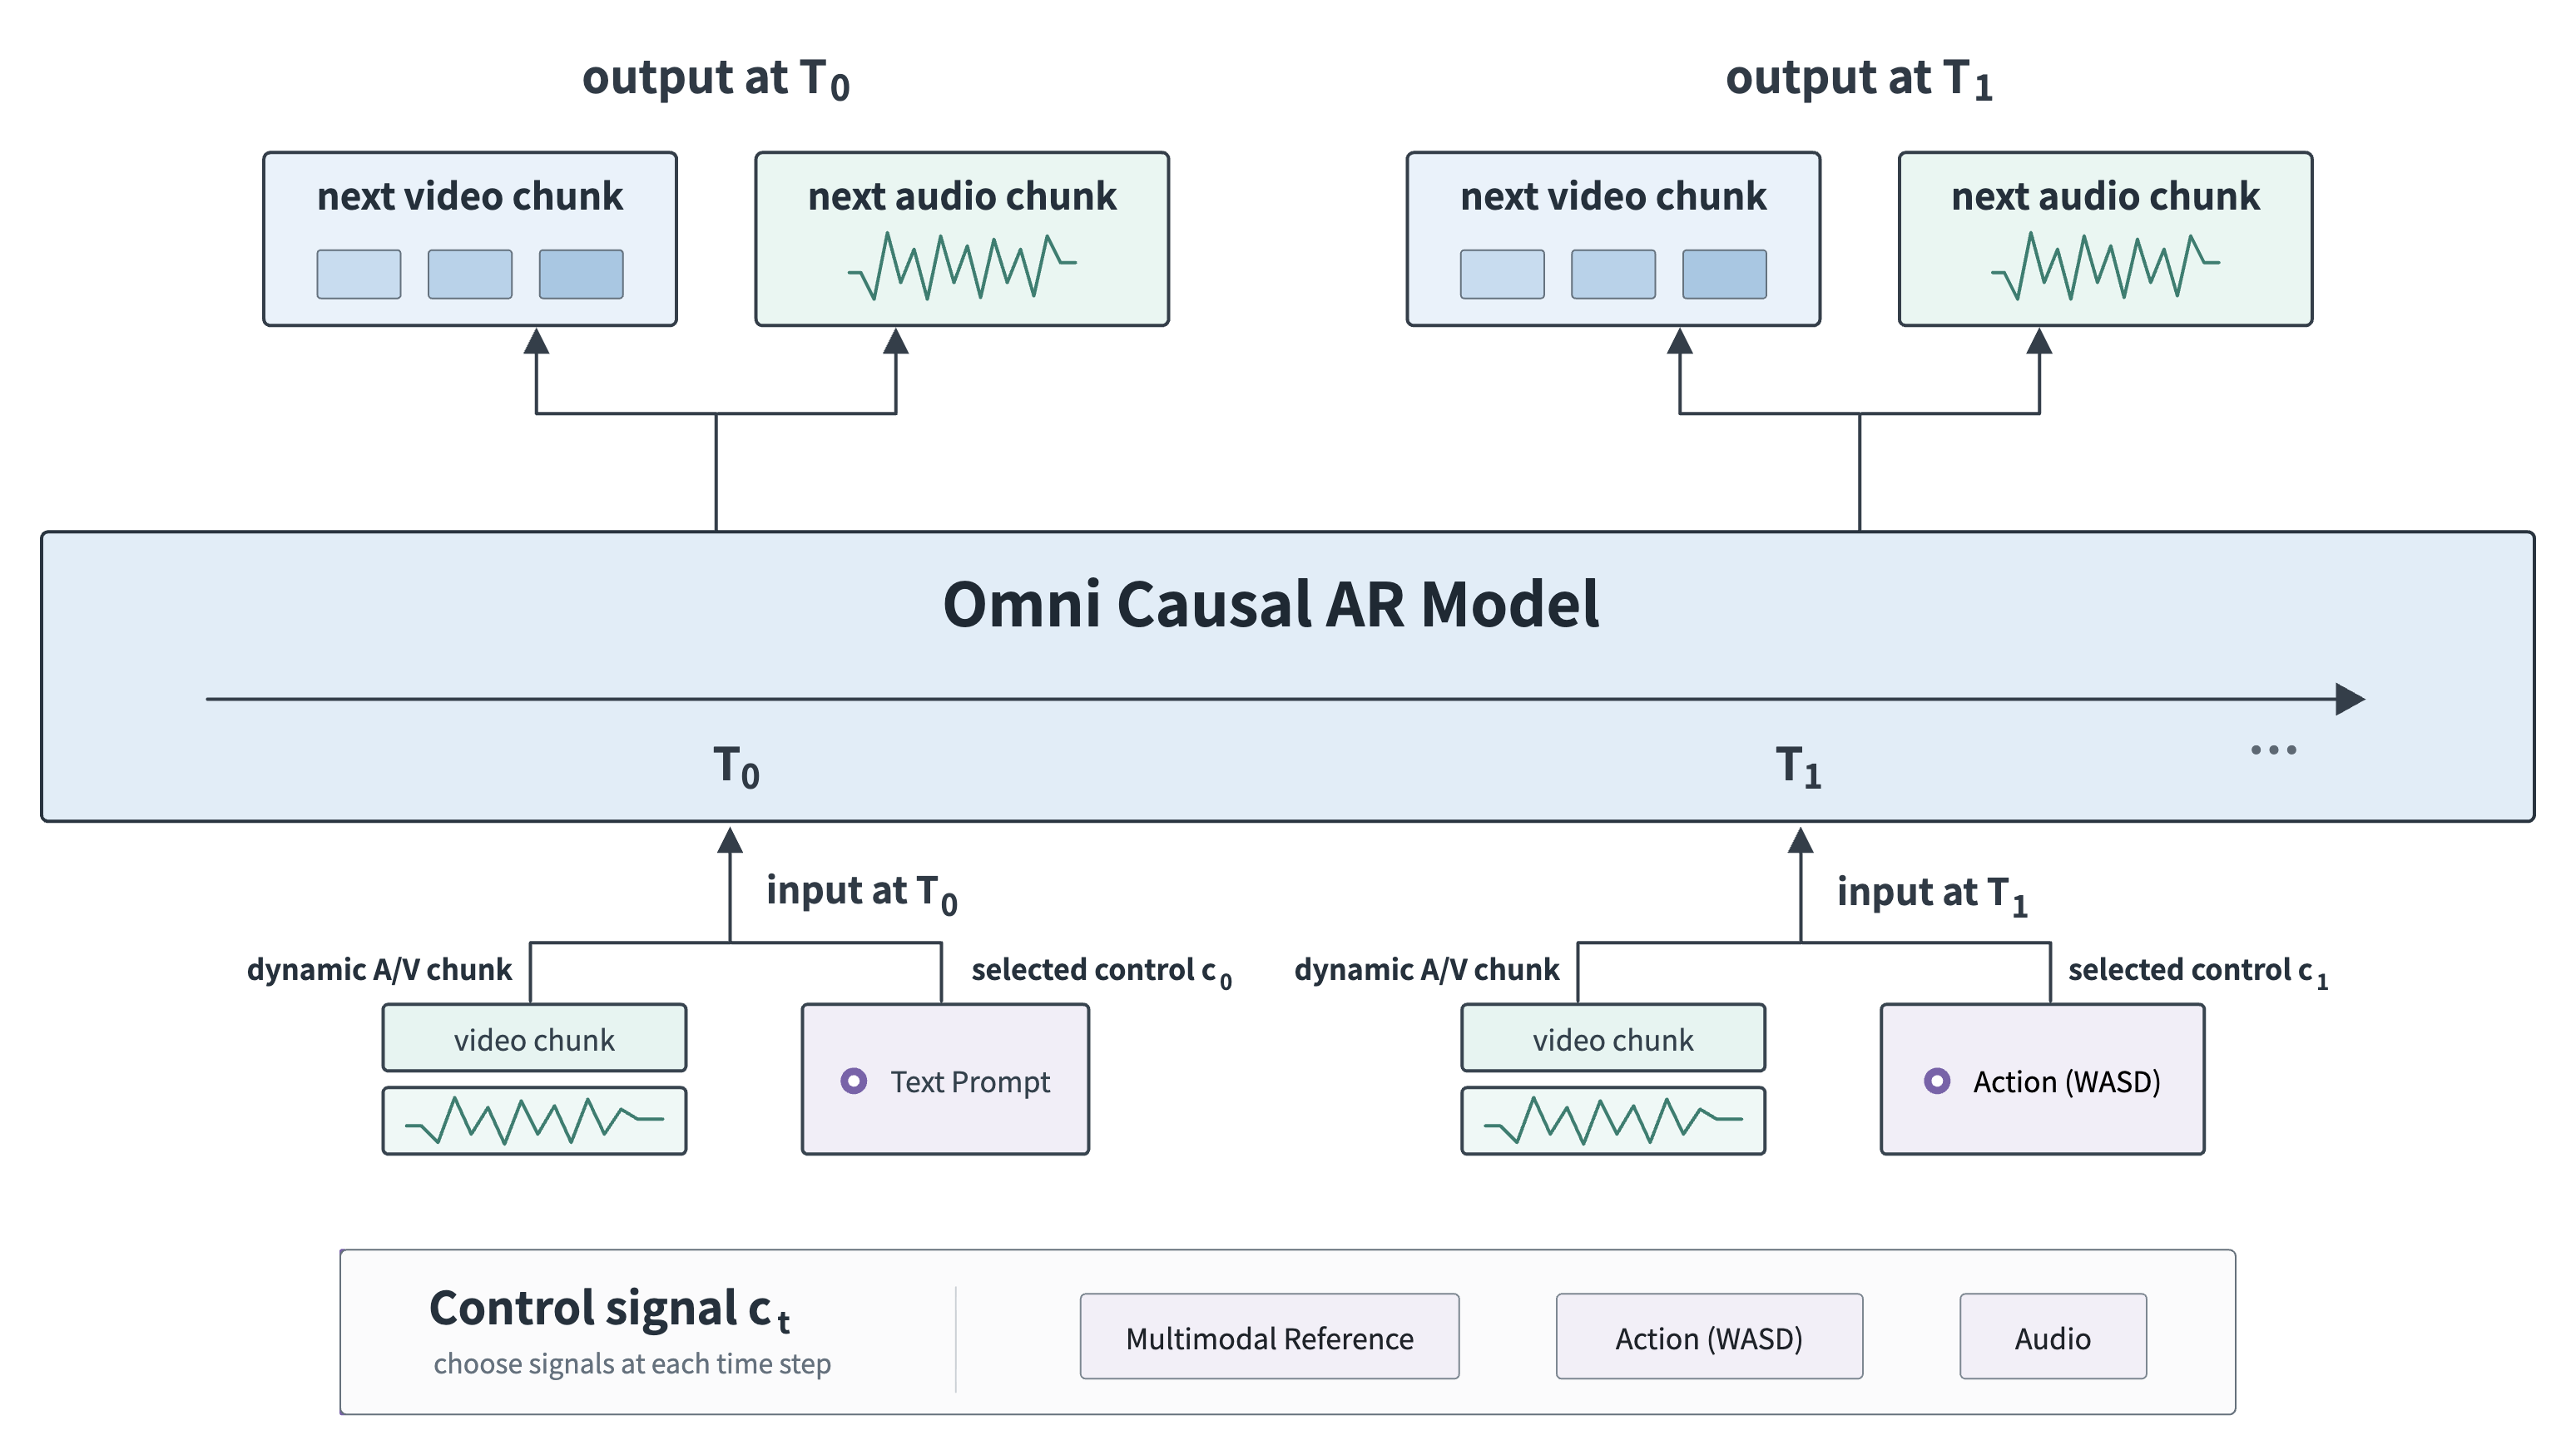
Рисунок 2. PixVerse R2 Omni Causal AR. Модель непрерывно принимает разнородные управляющие сигналы в ходе работы. В каждый момент взаимодействия активная команда сопоставляется с динамическим блоком соответствующего масштаба и направляет генерацию следующего видео- и аудиосегмента.
Генерация динамическими блоками (Dynamic Chunks)
Разные типы управления действуют на разных временных масштабах. Текстовые промпты и референсы описывают общие сцены или протяженные события. Управляющие нажатия (WASD) требуют мгновенного отклика с точностью до долей секунды. Аудио несет в себе смысл, ритм и жесткую временную сетку. Попытка втиснуть все типы сигналов в жесткие фиксированные временные рамки неизбежно заставила бы систему выбирать между скоростью реакции и богатством выразительности.
Механизм Dynamic Chunk в R2 гармонизирует эти несовпадающие масштабы. Модель адаптивно дробит аудиовизуальный ряд в зависимости от смысловых границ и продолжительности текущего сигнала управления с учетом лимита максимального размера блока для стабильности расчетов. Короткие блоки гарантируют отзывчивость при непосредственном управлении. Длинные блоки сберегают целостность сложных событий, размашистых движений и звукового полотна. Разноплановые задачи функционируют через общий причинный интерфейс без изменения структуры модели.
Hybrid Teacher Forcing / Diffusion Forcing
Главная дилемма при авторегрессионном обучении длинных видео состоит в том, что история на этапе тренировки идеальна, тогда как реальная история при инференсе неизбежно зашумлена собственными погрешностями модели. Обучение только на идеальных данных максимизирует разовое качество, но делает систему уязвимой к малейшим отклонениям. Обучение только на зашумленных данных портит резкость, плавность движений и управляемость.
R2 объединяет чистую и зашумленную историю в общем цикле обучения. Чистая история фиксирует эталонную планку качества генерации. Зашумленная история заранее учит сеть адаптироваться к неидеальным состояниям реальной среды. Этот синергетический подход нивелирует разрыв между обучением и инференсом, позволяя модели уверенно генерировать следующий отрезок даже тогда, когда недавние кадры содержат мелкие дефекты.
Маска причинного внимания (Causal Attention Mask) и относительное временное позиционное кодирование (Relative Temporal RoPE) строго регулируют доступность истории и ее размещение в рабочем окне. Маска гарантирует строгую причинную направленность. Временное RoPE не возрастает бесконечно вместе с глобальным номером блока, а индексируется относительно активного окна внимания. По мере смещения окна реальное время продвигается вперед, но ключевая память, недавняя предыстория и текущий блок остаются привязаны к стабильным ограниченным координатам.
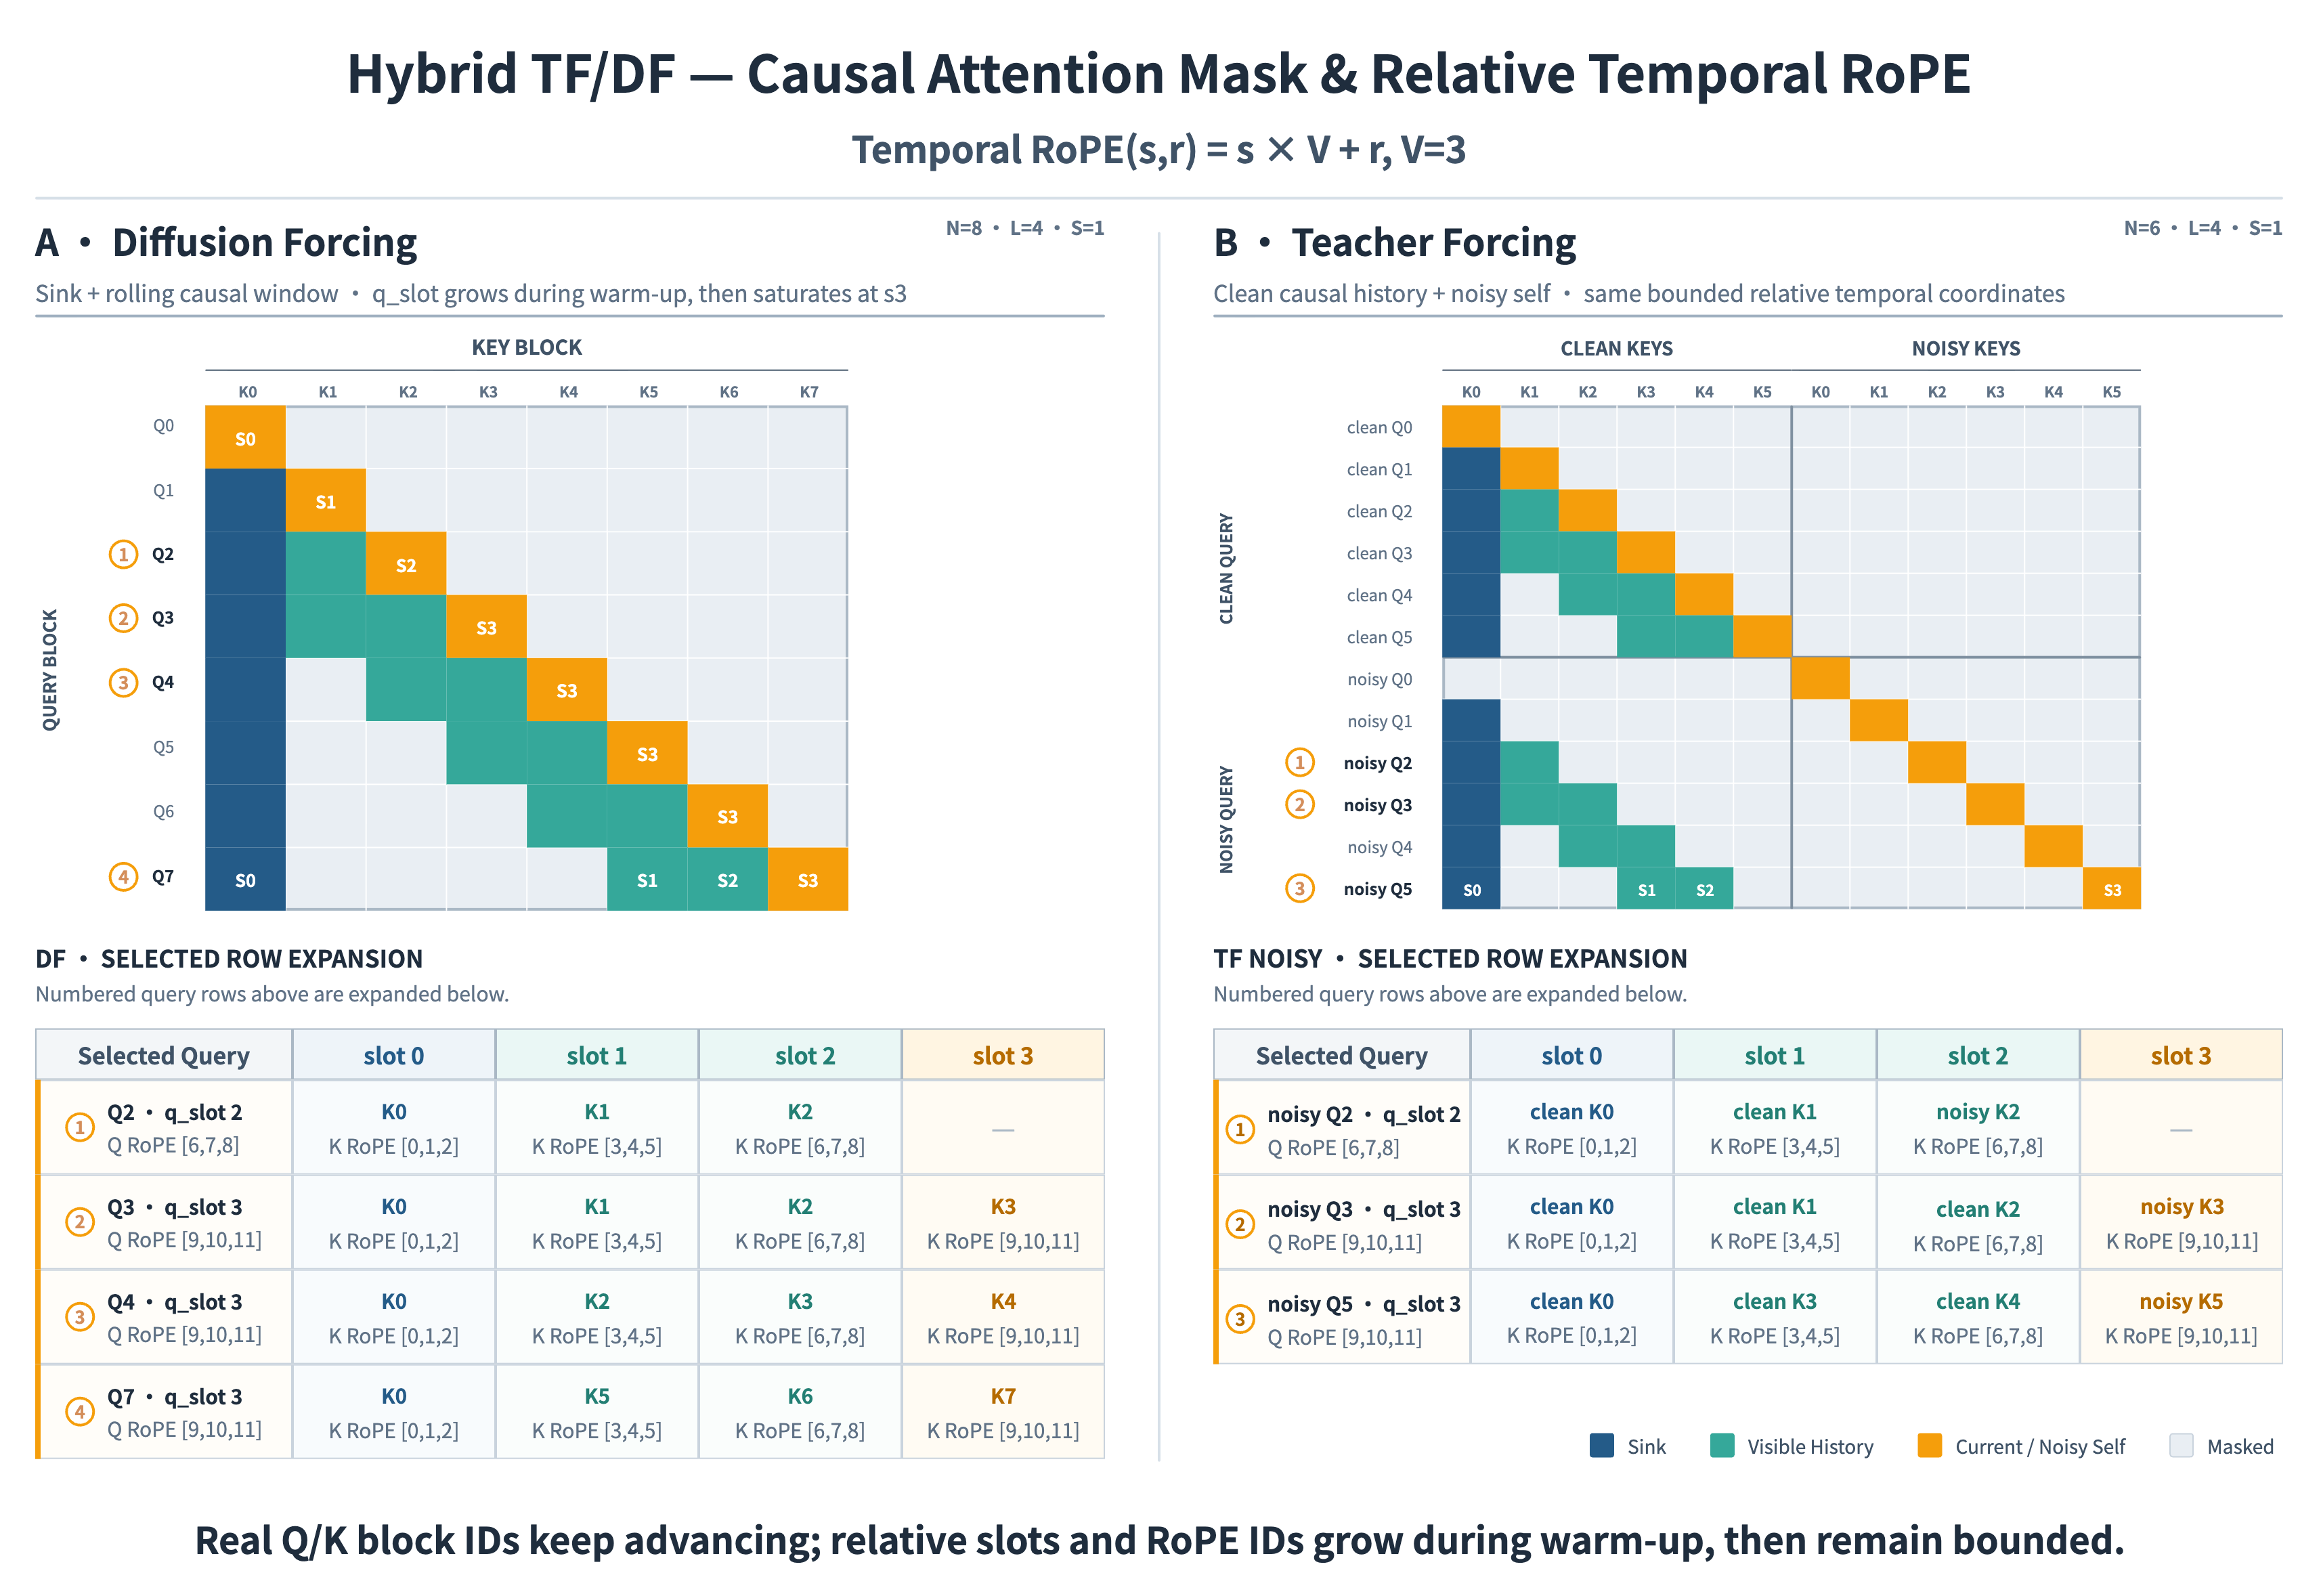
Рисунок 3. Единая причинная маска внимания и относительное временное кодирование RoPE для Hybrid Teacher / Diffusion Forcing. Сверху показана причинная видимость для двух вариантов истории. Снизу отображено сопоставление запросов с блоками Q/K, относительными слотами и индексами RoPE: реальные индексы непрерывно растут, тогда как внутренние координаты остаются компактными.
Многомасштабная память (Multi-timescale memory)
Моделирование мира на длинных дистанциях не может строиться на сохранении всего объема прошлых данных. Бесконечное накопление истории приводит к перегрузке видеопамяти и процессора; чрезмерная обрезка стирает облик персонажей, ключевые локации и поворотные события. R2 использует трехуровневую систему памяти, объединяющую Sink Memory, Rolling History и Object KV Cache.
- Sink Memory: хранит фундаментальные опорные константы (внешность персонажей, архитектуру локаций, визуальную стилистику и правила мира).
- Rolling History: отслеживает недавние действия, позы, движение камеры и изменения света, обеспечивая плавность локальных переходов.
- Object KV Cache: оптимизирует и повторно задействует ранее вычисленные представления отдельных объектов, удерживая в памяти только влияющие на эволюцию сцены сущности.
Совместная работа трех компонентов гарантирует постоянство образов, непрерывность движений и строгий контроль над вычислительными ресурсами, устраняя скачки окружения и мерцания между кадрами.
Банк ошибок (Error Bank)
Катастрофический дрифт в авторегрессионных моделях мира обычно берет начало в незаметной ошибке, зафиксированной в истории и многократно усиленной последующими шагами. R2 включает специализированный Error Bank, собирающий характерные образцы ошибок и дозированно возвращающий их в обучающий поток. Модель перестает быть «тепличной»: она учится распознавать возникшую деградацию, компенсировать ее и выравнивать ход генерации обратно к стабильному состоянию.
В ходе сравнительных тестов показатель долговременного дрифта яркости снизился с 0,201 до 0,129 (улучшение на 35,8%). Из 29 контрольных длинных сцен 20 показали существенный прирост качества, а во всех 5 тестовых статичных сценах исчезли паразитные спонтанные движения.
Ускорение в реальном времени
Ускорение реального времени в R2 не пытается обучить малошаговую модель устойчивому представлению о мире с нуля. Оно разгоняет модель мира, которая уже доказала свою способность стабильно генерировать сцены на длинной дистанции. Модуль ускорения берет за основу предобученную Omni Causal AR и применяет ее как для инициализации ОДУ, так и в качестве учителя дистилляции, обеспечивая единство причинных траекторий.
Такая согласованная отправная точка избавляет от необходимости в громоздких надстройках вроде Self-Forcing или Rolling Forcing. Ускорение концентрируется на задачах малошаговой генерации: DDMD с состязательной регуляризацией обеспечивает точное следование условиям, согласованность распределений и реализм; блочно-разреженное внимание (block-sparse attention) снижает затраты на длинный контекст; а пирамидальная структура удешевляет генерацию в высоком разрешении.
DDMD с состязательной регуляризацией
В сверхмалошаговой генерации следование командам, совпадение распределений и фотореализм представляют собой нетождественные цели оптимизации. R2 берет за основу метод DDMD и интегрирует состязательную регуляризацию из DMD2. Три обучающих сигнала сходятся в модели-ученике: ориентация на условия усиливает контроль, согласование распределений сохраняет глубину учителя, а состязательная регуляризация гарантирует правдоподобие текстур. Благодаря этому малое число шагов сэмплирования обеспечивает и мгновенный отклик, и естественность окружения.
Блочно-разреженное внимание (Block-sparse attention)
R2 применяет блочно-разреженное внимание к пространственно-временным последовательностям токенов. Модель делит матрицы Q, K и V на расчетные блоки, быстро определяет наиболее критичные пары блоков для каждого запроса, оставляет только приоритетные маршруты и вычисляет точный softmax исключительно по выбранным блокам. Блочная маршрутизация не является случайным прореживанием: она целенаправленно концентрирует ресурсы на прочных связях между текущим сигналом управления, недавним движением и опорными состояниями мира.
Благодаря адаптации к разреженной топологии внимания при обучении R2 доводит разреженность более чем до 90%, не теряя в четкости картинки, плавности физики, точности реакций и общей стабильности на длинных сценах.
Пирамидальная малошаговая дистилляция
Генерация всего пространства кадра сразу в максимальном разрешении нерационально расходует ресурсы на прорисовку глобальной геометрии, которую можно надежно определить в базовом масштабе. R2 структурирует инференс в один-два этапа пониженного разрешения с финальным переходом в высокое разрешение. Начальные стадии фиксируют композицию, кинематику объектов и ракурс камеры. Финальная стадия восстанавливает текстуры, четкость граней и локальные детали. Такой подход исключает дублирующие расчеты и гарантирует структурную монолитность сцены.
Итоги и текущие ограничения
PixVerse R1 открыл эру интерактивных моделей мира видео в реальном времени, доказав, что генеративное видео способно перерасти формат замкнутого видеофайла и превратиться в живой интерактивный мир. PixVerse R2 предлагает масштабируемое развитие этой концепции: единая архитектура Omni Causal AR аккумулирует растущие объемы данных, задач и модальностей, а модуль ускорения в реальном времени переносит эту мощь в мгновенный инференс за минимальное количество шагов.
R2 — это не точечное улучшение характеристик, а целостный подход к обучению моделей мира нового поколения. Если R1 сделал модели мира реального времени осязаемой реальностью, то R2 выводит их на стадию масштабируемого, непрерывно совершенствующегося стандарта.
В условиях жестких ограничений времени отклика и мгновенного расчета качество отдельных сгенерированных сцен все еще может уступать флагманским оффлайн-моделям видео, особенно в сложных микротекстурах, абсолютной физической естественности и долгосрочной устойчивости многоминутных сессий. Эти различия отражают текущую фазу масштабирования R2 и не являются фундаментальным барьером разработанной архитектуры.
Ранний доступ
По состоянию на 23 августа 2026 года этот отчет описывал PixVerse R2 как закрытое тестирование. 22 сентября 2026 года PixVerse объявил, что коллекция этих миров открыта для изучения на world.pixverse.video. См. анонс запуска R2.
Этот анонс не открывает неограниченный доступ к API. Форма заявки на доступ к модели мира PixVerse R2 остается маршрутом запроса раннего доступа и ключей API.
Полезные материалы
- Все о PixVerse R1: Модель мира видео ИИ в реальном времени
- Архитектура игрового движка PixVerse Game Engine
- PixVerse обновляет R1: Общие интерактивные миры
- Руководство по генерации ИИ-видео в реальном времени
- PixVerse привлекает расширение раунда Series C
Миры из анонса от 22 сентября 2026 года открыты для изучения на world.pixverse.video. Доступ к API по-прежнему запрашивается через форму выше. Создавать можно и сегодня на базе PixVerse V6 и R1.