GPT Image 2 深度测评:2026年提示词指南与实战案例
OpenAI 于 2026 年 4 月 21 日发布了 GPT Image 2,作为 GPT Image 1.5 的继任者,如今已成为 ChatGPT 内图像生成的核心模型。我们在发布首周进行了测试,并在 6 月底用更丰富的提示词集合、OpenAI 官方的提示词指南以及公开的 API 定价再次回顾了它,看看这个模型在最初的热度褪去后表现究竟如何。
核心要点:
- GPT Image 2 原生支持 2K 分辨率输出,可选 4K 放大,在拉丁文、中文、日文、韩文和阿拉伯文等多种文字下的文本渲染准确率超过 95%。
- 这个模型更适合被当作设计助手,而非单纯的图片生成器:它在有明确成功标准的任务上表现出色——精确的文案、固定的版式、可重复的分镜结构——但在开放式的“让它更美”这类提示词上表现就没那么稳定。
- 品牌 Logo 还原、极小号法律条款文字和专有字体仍是薄弱环节,仍需人工复核。
- OpenAI 的 API 按 token 对 GPT Image 2 计费,涵盖图片输入、缓存图片输入、图片输出、文本输入和缓存文本输入——这与部分竞品采用的按图计费模式不同。
- PixVerse 已将 GPT Image 2 纳入其文生图产品线,与 Nano Banana 2 和 Seedream 并列,生成的图片可以直接进入图生视频流程,无需离开工作区。
GPT Image 2 是什么?核心功能与局限
GPT Image 2 是 OpenAI 的第二代图像模型,在 ChatGPT 和 API 中全面取代了 GPT Image 1.5。它与 Midjourney、DALL-E 3 和 Stable Diffusion 展开竞争,但将自身定位押注在两点上:图片内文字的精准还原,以及能够解读提示词意图而非仅仅匹配关键词的推理层。
核心功能一览
| 功能 | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| 原生分辨率 | 2K(支持 4K 放大) | 1K | 2K(需加 —hd 参数) |
| 文本渲染准确率 | 95%+(多语言) | 约 70%(仅拉丁文) | 约 80%(仅拉丁文) |
| 推理能力集成 | 支持——可解读多层指令 | 不支持 | 不支持 |
| 宽高比范围 | 3:1 至 1:3 | 1:1、16:9 | 1:1 至 3:2 |
| 角色一致性 | 连续图片间达到像素级 | 有限 | 中等(需 —cref 参数) |
| 自然语言编辑 | 支持——用文字描述区域进行编辑 | 不支持 | 不支持 |
| 定价 | API 按 token 计费;ChatGPT 按套餐分级 | 相同 | 每月 10-30 美元订阅制 |
文本渲染是最受关注的功能,这也是有道理的。早期的图像模型把文字当作纹理来处理——你要求生成一句海报标题,得到的往往是字形状的噪点。GPT Image 2 能够以真正的一致性处理多行英文标题、中文字符和混合语言排版;在我们的测试中,大约每 20 次生成里有 19 次能一次性得到完全可读的结果。
推理能力集成意味着模型不只是对你的措辞做模式匹配。让它“生成一张展示明天旧金山天气对应活动的信息图”,它会去获取天气预报、挑选相关活动,并围绕这些数据构建版式——这比 Midjourney 或 Stable Diffusion 处理提示词的方式更进一步。
自然语言编辑让你可以通过描述改动而非手动蒙版来修改图片。“把咖啡杯移到桌子左侧”或“把天空改成日落”,这两种指令都能作为针对性的编辑生效,而无需重新生成整个场景。
用户怎么说
发布以来的反馈总体积极,同时也伴随着一组一致的抱怨。在 X 和 Reddit 上流传的人像测试结果已经接近工作室级摄影水准,测试长文案排版(传单、菜单、招牌)的海报设计师们反馈,文字准确度终于能经得起真实使用的考验。多位设计师提到,对于基础营销素材,他们可以跳过 Photoshop 精修步骤,因为模型自身对构图的把握已经足够独立做出版式决策。
最受好评的是提示词遵循度:要求场景中出现 15 个具体元素,GPT Image 2 往往能全部囊括,而老一代模型随着提示词变长,常常开始遗漏细节。
负面反馈方面,品牌还原度依然不稳定。一次被广泛传播的 ZDNet 实测显示,模型未能准确还原 ZDNET 的 Logo,其他用户也反馈了针对特定品牌标识的类似问题。模型在概念层面理解“什么是 Logo”,但并不能可靠地还原精确的矢量形状或专有字体。
已知局限
- 品牌 Logo 还原并不可靠——生成后建议在 Photoshop 或 Figma 中合成精确的 Logo,而不是直接用提示词生成。
- 生成速度落后于 FLUX 或 Nano Banana 2 等更轻量的模型,在 ChatGPT Plus 上通常需要 30-60 秒,而其他平台不到 10 秒。
- 免费额度限制较紧,免费版 ChatGPT 用户大约每天只能生成两张图。Plus 订阅用户在 ChatGPT 内可无限生成,但 API 费用会随用量增长。
- 风格控制比 Midjourney 更粗粒度。你无法以同样的精度调节胶片质感、镜头类型或颗粒感,模型自身的美学偏好也需要刻意的提示词技巧才能覆盖。
- 内容政策比开源替代方案更严格,一些在 Stable Diffusion 或本地模型上能顺利运行的提示词,在这里会被拒绝。
这些局限并不妨碍它投入生产使用,但在你把整条流程完全绑定到单一模型之前,值得提前了解。
如何写出真正有效的 GPT Image 2 提示词
我们第二轮测试中最明显的转变是:最好的 GPT Image 2 提示词不只是描述一张图片——它们描述的是这张图片必须完成的任务。一条社媒广告的提示词,应该和产品切图、信息图、UI 界面或者视频首帧的提示词写法不同。
一个可靠的任务简述结构如下:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
先说明任务类型,再谈风格
先点明输出类型——海报、产品广告、App 界面、角色设定图、图表、编辑还是视频首帧——这样模型才知道自己会被以什么标准来评判。
较弱的写法:A cool futuristic speaker, cinematic, high detail.
更好的写法:Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
第二种写法告诉模型,它是被以版式和实用性来评判的,而不仅仅是美感。
把文字当作锁定的资产来对待
把所有必须出现的文案放进引号里,并明确说明它应该以什么方式呈现——除非你想让模型自己编词,否则不要笼统地要求“一句标语”。
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
对于更长的文案,在提示词中把每一行文字明确拆开列出。如果某个单词生成后出现拼写错误,就用更短的文案、更大的字号,并加上更严格的“仅渲染指定文字”指令重新生成。
给模型一台“相机”和一份版式
直接说明镜头距离、角度、主体位置、留白和宽高比——GPT Image 2 在构图指令上遵循度很高,但前提是你把它们讲清楚。
- 特写适合产品质感、手部、面部、材质、标签。
- 远景适合环境场景、故事画面、城市海报、适合转视频的画面。
- 俯拍适合美食、桌面场景、平铺展示、包装套装。
- 左三分之一 / 右三分之一适合需要平衡文字和产品的广告版式。
- 整齐网格适合 UI 效果图、角色设定图、图表、信息图。
用三句话写编辑类提示词
最有效的编辑类提示词会把“改动内容”、“必须保持不变的内容”以及把两者衔接起来的物理真实感分开描述:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
这种“改动、保留、匹配”的结构,效果始终优于笼统的“让它看起来更好”这类要求。
如果静态图要转成视频,加一条运动提示
如果一张图片之后可能会用于 PixVerse 的图生视频流程,请提前在提示词里加入景深和运动就绪的要求:前景、中景、背景,一个干净的主体轮廓,以及一个可以合理运动的可见元素——灰尘、织物、头发、雨水、反光或一段镜头推进路径。
不要这样写:An astronaut in a desert.
而要这样写:A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
我们如何测试 GPT Image 2
在两轮测试中,我们让模型分别处理人像、文字密集型海报、产品风格构图、角色设定图、UI 效果图以及实验性叙事场景。我们的目标不是跑一个基准分数,而是判断设计师、营销人员或创作者能否只需轻微修改就能直接交付这些产出,而不必从头重做。
| 测试领域 | 我们检查的内容 |
|---|---|
| 人像与电影感静帧 | 光线控制、皮肤质感、反射、氛围、场景一致性 |
| 海报与排版设计 | 标题拼写、多行文字、层级关系、留白、类品牌级的精致度 |
| 角色与概念设定图 | 多视角一致性、服装细节、色板统一性、标签准确度 |
| UI 与社媒效果图 | 版式真实感、小字号文字、图标间距、信息流网格、截图可信度 |
| 实验性提示词 | 幽默感、叙事推理、物体摆放、小号说明文字的准确度 |
这一规律在两轮测试中都成立:GPT Image 2 更青睐精确的任务简述,而不是关键词堆砌。当提示词明确了任务并定义了成功标准——精确文字、固定版式、可重复的分镜结构——模型往往能保持结构完整。如果提示词只描述了一种模糊的氛围,结果可能依然好看,但更难在不修改的情况下直接复用。
GPT Image 2 应用案例与提示词示例
我们围绕以下场景对五种不同能力进行了压力测试:光线控制、精确文字排版、多元素构图、角色一致性和 UI 排版。以下每一条提示词都可以直接复制并按需调整。
电影感人像摄影
这一项考察模型对光线、氛围和克制构图的把握——这正是区分作品集级图片与普通 AI 生成图的关键。
提示词:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
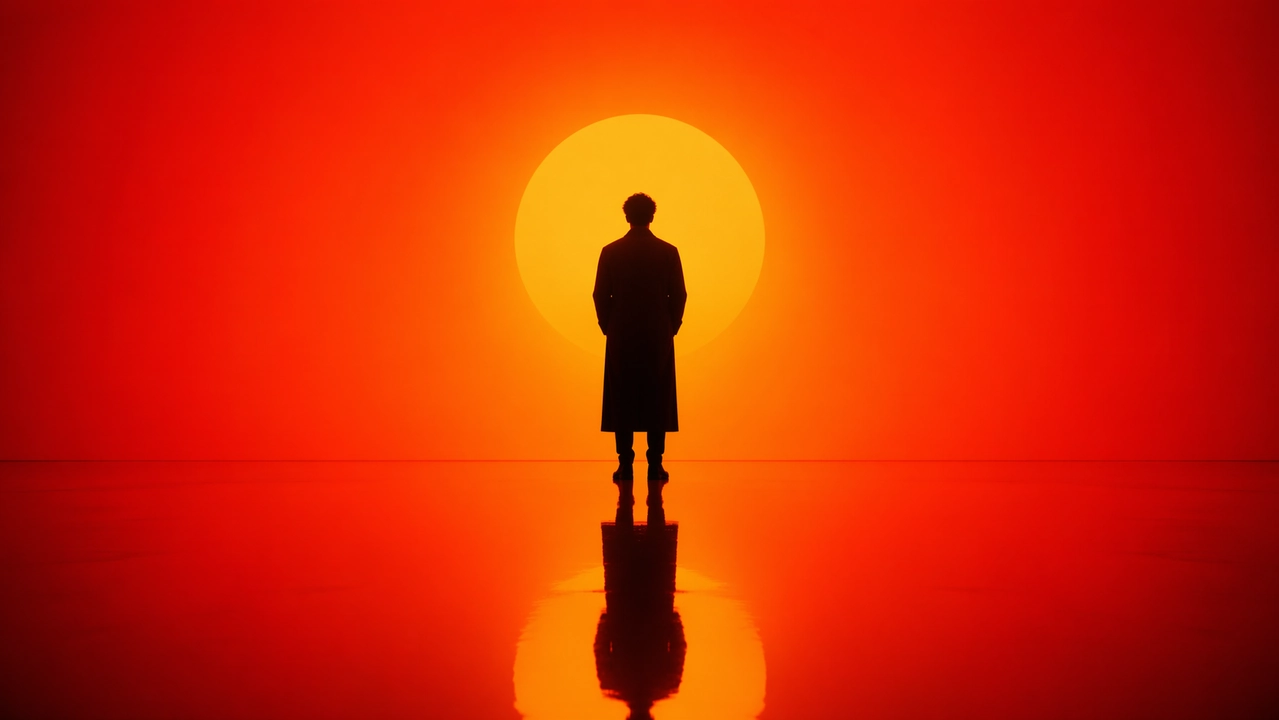
**需要关注的地方:**轮廓边缘是否干净无光晕瑕疵,地面反射是否透视准确,渐变是否平滑(而非出现色带断层),以及姿态是否有真实的重量感,而不是显得僵硬或悬浮。
城市海报与插画设计
这是对清晰排版和密集多元素构图的最严苛压力测试——超过十个不同的视觉元素沿 S 形曲线排布,且英文文字必须在渲染后保持完整无误。
提示词:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
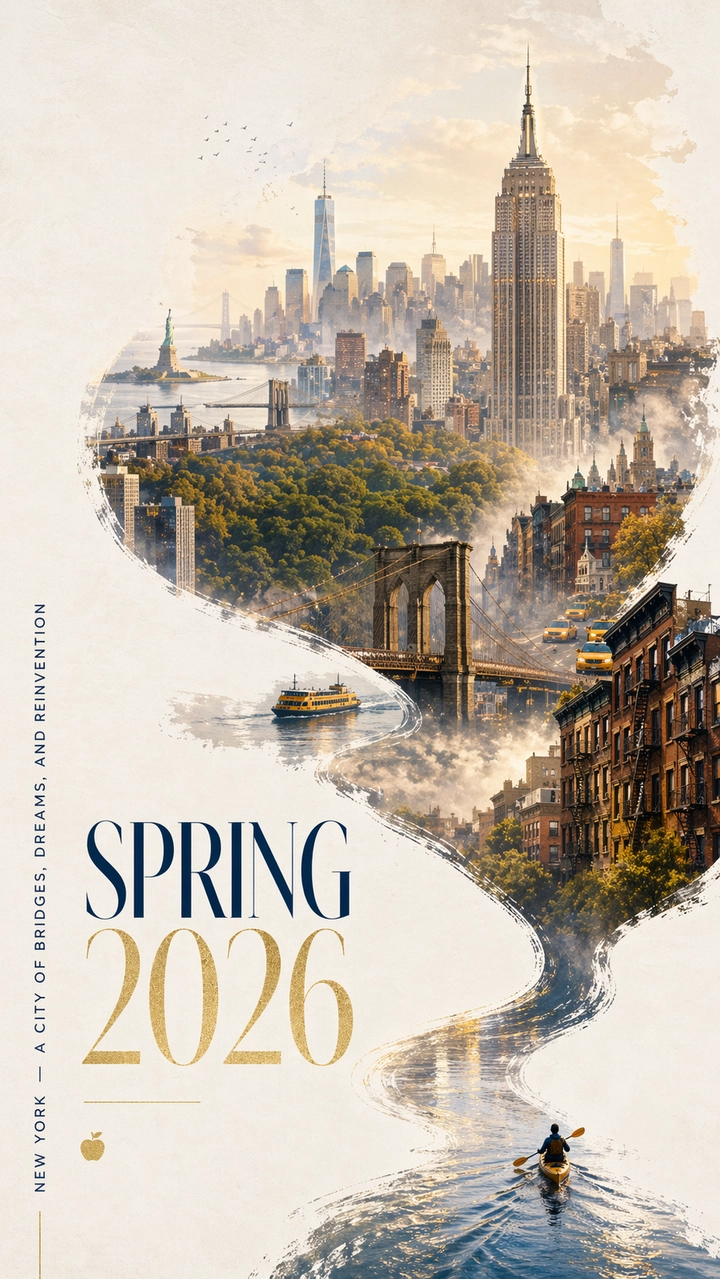
**需要关注的地方:**标题和标语中的每个字母是否清晰可读且拼写正确,S 形曲线是否从划艇自然过渡到天际线,地标建筑是否能被识别出来而不是变成泛泛的高楼,以及留白是否给人刻意为之的感觉而非单纯的空洞。
角色设计与设定图
游戏开发者和概念设计师需要在一次生成中获得多视角的一致性。这一项考察模型能否在正面、侧面和背面视图之间稳定保持角色设计。
提示词:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
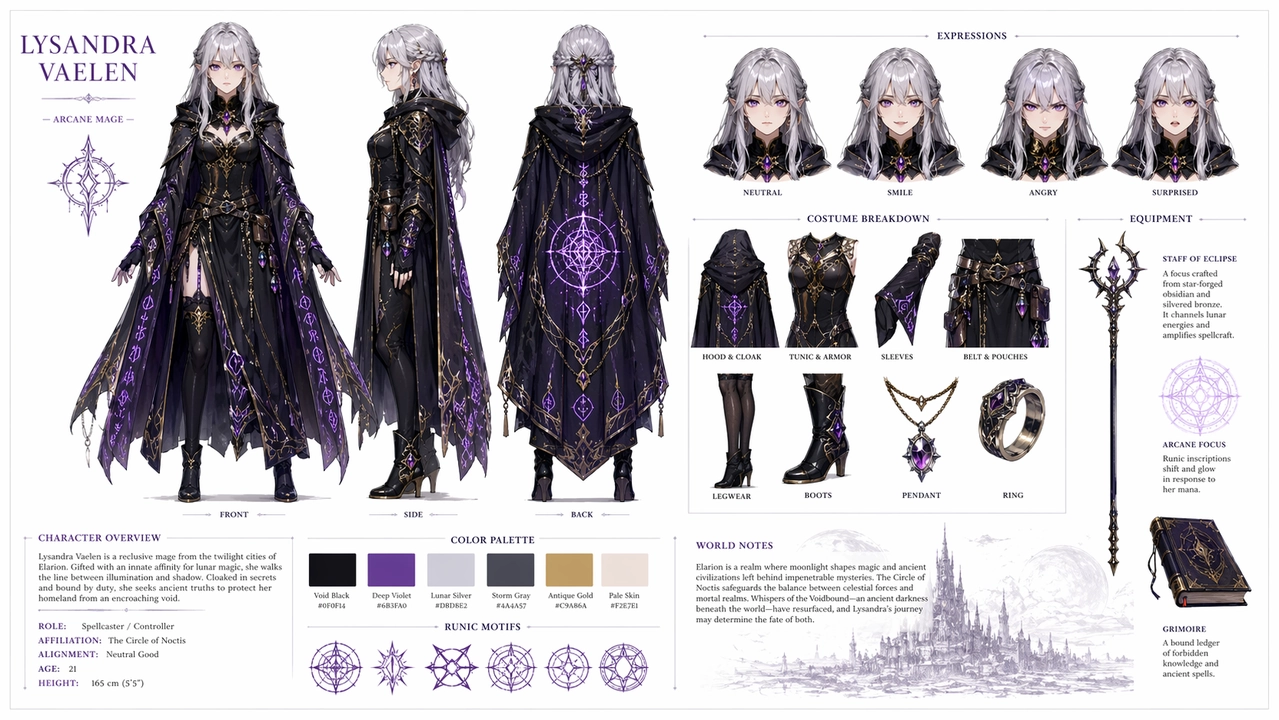
**需要关注的地方:**面部、发型和服装在三个视角中是否保持一致;表情变化是否只改变了面部,而没有影响发型或服装;色板是否真正对应画面中实际使用的颜色;以及文字标注是否拼写正确。如果侧面或背面视图出现偏差,可以用更强的“保留”语句重复身份锚点后重新生成。
UI 与社媒效果图
这一项同时考验三种能力:像素级精确的 UI 排版、混合语言文字渲染,以及创意概念的融合——这类内容往往也更容易在社交平台上获得良好表现。
提示词:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
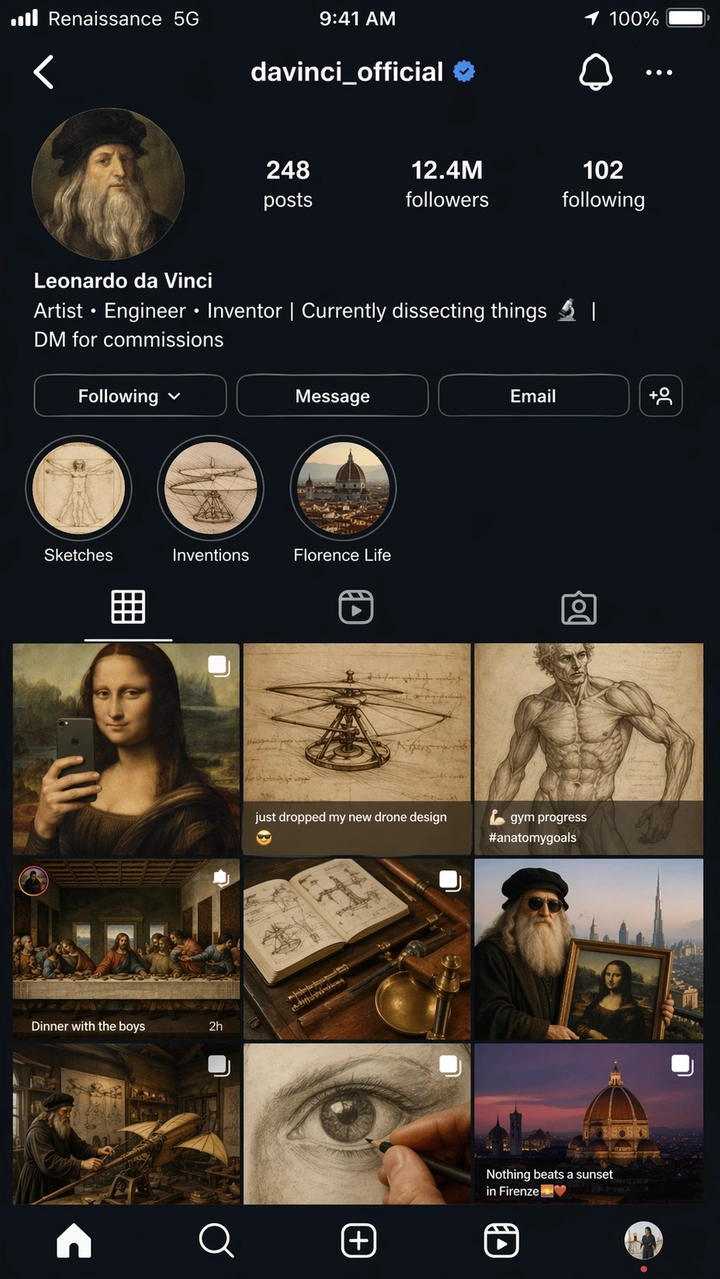
**需要关注的地方:**Instagram 的界面元素——网格间距、个人主页排版、故事圆圈、底部标签栏——是否读起来像一张真实的 iOS 截图,而不是风格化的近似效果。所有文字都应清晰可读,其中“Renaissance 5G”运营商标签是一个刻意设置的准确度检验点。应把任何 UI 效果图输出当作概念参考,而非可直接投产的界面;小号标签和图标对齐通常还需要一轮清理。
创意与实验性艺术
带有内在叙事幽默感的短提示词,用来考察模型是否能自行填补创意空白,而不是完全依赖详尽的指令。
提示词:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
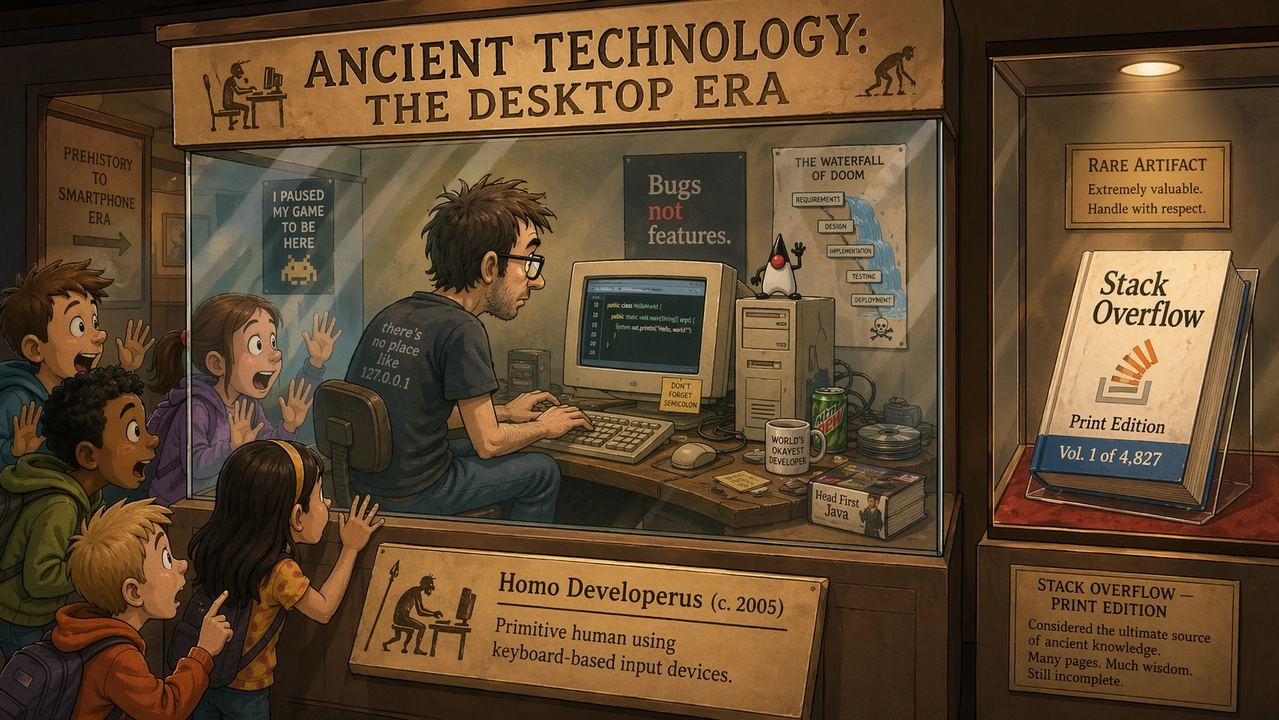
**需要关注的地方:**幽默感应通过视觉细节来传达,而不仅仅依靠说明文字。展牌和书名必须保持清晰可读且拼写正确——这对小字号的多行文字来说是相当严苛的考验——而且卡通风格应在整个场景中保持统一,而不是局部出现写实感的割裂。
各应用场景的测试结果
最出色的结果始终来自那些具有明确产出标准的提示词——即可以通过拼写、版式、物体保留度或分镜顺序来判定的标准。而只描述模糊氛围的提示词,结果的稳定性会差很多。
| 应用场景 | 表现良好的方面 | 仍需人工复核的方面 |
|---|---|---|
| 文本渲染 | 大标题、短标签、海报标题以及简单的 UI 标签,在精确引用文案时都能保持准确。 | 极小号的法律条款文字、密集段落和风格化字体仍可能出现偏差——保持文案简短并逐字检查。 |
| 产品图片 | 简洁的广告版式、留白充足的宣传构图以及以产品为核心的画面表现良好。 | 真实的标签、Logo 和受监管的宣传语,仍需人工复核,或从经审核的素材中合成。 |
| UI 效果图 | 当提示词点明真实界面元素时,手机界面、仪表盘和类 App 层级看起来相当可信。 | 应把输出当作概念效果图;小号标签和图标对齐通常仍需清理。 |
| 角色一致性 | 角色设定图、表情变化和色板作为创意参考表现良好。 | 面部和服装细节在不同视角间可能出现偏差;需重复身份锚点,必要时重新生成。 |
| 编辑与合成 | “改动、保留、匹配”结构的表现优于笼统的编辑请求。 | 选区边界和透明背景输出仍需质检。 |
GPT Image 2 提示词常见错误
- **要求精确文字却不给出具体文案。**如果文字很重要,就把它逐字写出来,并说明它应该出现在什么位置。
- **在单条提示词里塞入所有可能的细节。**先从核心场景开始,再逐一调整变量进行优化。
- **在编辑时忘记声明不变量。**明确说明必须保持不变的内容:身份特征、背景、姿态、光线、产品形状、标签文字、镜头角度。
- 在功能性任务上依赖装饰性的形容词。“漂亮”并不能让一个标签变得可读——应使用“清晰的标签文字”或“远距离可辨识”这类表述。
- **忽略宽高比。**一张出色的方形图片,也可能无法作为竖版广告或视频缩略图使用。
- **把 Logo 当作普通文字处理。**GPT Image 2 可以设计 Logo 概念,但精确的品牌标识应从经审核的素材中合成,而不是直接用提示词生成。
GPT Image 2 API 与定价说明
OpenAI 的 API 定价页面对 GPT Image 2 采用按 token 计费,而非统一的按图定价:
| 项目 | 标价 |
|---|---|
| 图片输入 | 8.00 美元 / 100 万 token |
| 缓存图片输入 | 2.00 美元 / 100 万 token |
| 图片输出 | 30.00 美元 / 100 万 token |
| 文本输入 | 5.00 美元 / 100 万 token |
| 缓存文本输入 | 1.25 美元 / 100 万 token |
单张图片的实际成本取决于提示词长度、参考图片、输出尺寸、是否命中缓存以及质量设置。ChatGPT 套餐配额与 API 计费是两条独立的轨道——Plus 订阅并不能直接换算成 API 额度,如果两者都在使用,建议分开做预算。
对于高频次的工作流来说,真正重要的数字是经过重试后每张被采纳素材的成本,而不是单次尝试的标价。如果一次生成需要三次重新生成才能把拼写或版式做对,那它其实并不便宜。
| 工作流 | 实用的提示词建议 |
|---|---|
| 文字密集型海报或图表 | 每张图使用更少的文字,精确引用文案,明确指定层级关系。 |
| 产品照片 | 锁定产品形状、标签、颜色、材质和镜头角度;在每一轮编辑中重复保留清单。 |
| UI 效果图 | 把界面描述成一个已上线的产品界面——导航、卡片、按钮、状态——而不是概念艺术图。 |
| 多参考图编辑 | 为每张输入图片标注其角色:主体、风格、背景或材质参考。 |
| 批量生成 | 追踪每张被采纳图片的成本,而不是每次尝试的成本。 |
如果你想看看 GPT Image 2 在相同提示词下与一个以写实风格见长的对手相比表现如何,我们的《GPT Image 2 对比 Nano Banana 2》评测进行了六轮正面对比,并附有完整的 API 和平台定价明细。
从图片到视频:在 PixVerse 完成你的完整创作流程
生成一张出色的图片只是第一步。把它变成动态画面,才是大多数工作流容易卡壳的地方——你在 GPT Image 2 中完成了一张人像或产品海报,接下来却要打开另一个工具,重新上传文件,还得祈祷视频模型不会把你精心构图的画面弄变形。PixVerse 正是要消除这种衔接上的摩擦。
GPT Image 2 已上线 PixVerse
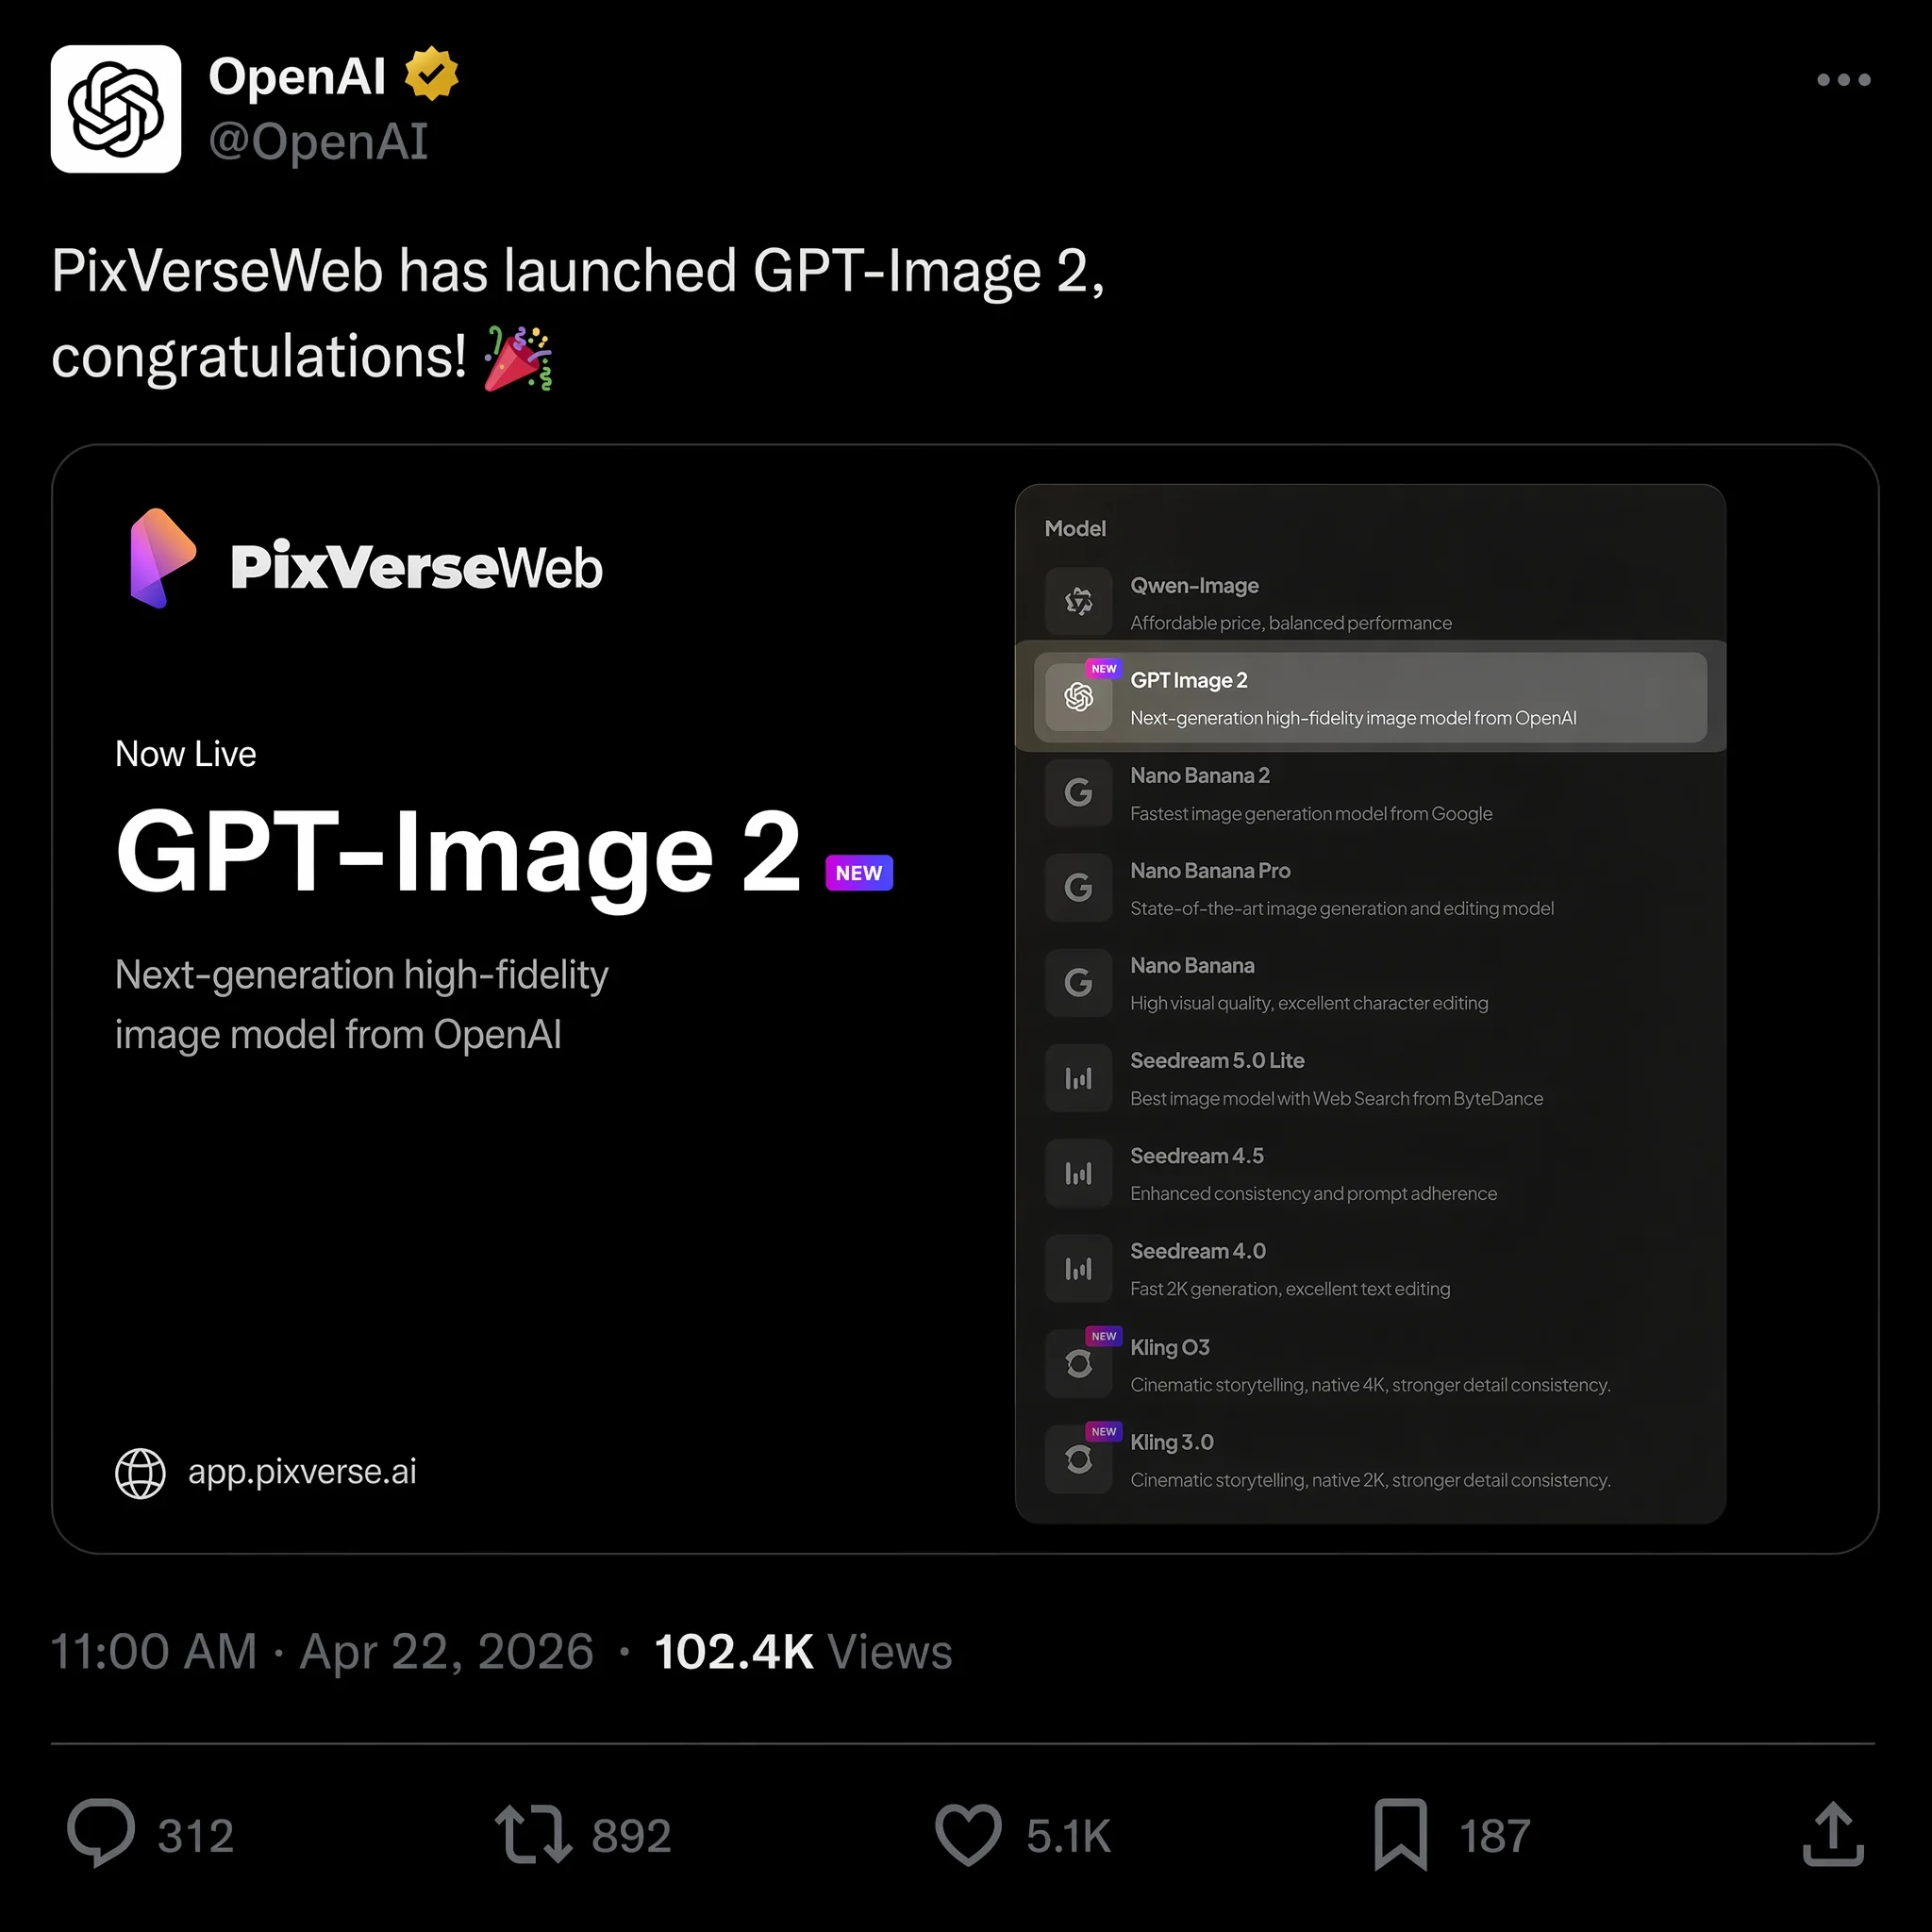
2026 年 4 月 22 日,PixVerse 将 GPT Image 2 加入文生图选项,与 Nano Banana 2、Seedream 和 HappyHorse 1.0 共同组成模型阵容。你可以在同一个工作区内用 GPT Image 2 生成图片并将其转换为视频,全程无需下载、重新上传或切换标签页。
这一点之所以重要有一个具体原因:当图片直接进入同一平台上的图生视频流程时,视频模型可以直接读取全分辨率的源文件及其元数据。整个过程不会因为压缩或格式转换而产生质量损失,这意味着最终成片的动态效果更干净,瑕疵更少。
如果一张静态图注定要变成一段视频片段,就从一开始在提示词中加入运动就绪的要求——要求前景、中景、背景的景深层次,一个干净的主体轮廓,以及一个可以合理运动的物理元素(灰尘、蒸汽、织物、变化中的光源)。在为静态图添加动画之前,先把它当作一份完成的设计文件来审阅:先检查拼写、产品几何形状和 UI 对齐情况,因为视频模型不会自动修正拼错的标题或变形的标签。然后再单独写一条更短的运动提示词,只描述应该运动的部分以及必须锁定不变的部分,而不是把整份图片简述再重复一遍。
为什么创作者正在转向一体化平台
如果你在 2026 年 3 月之前一直用 OpenAI 的 Sora 做视频生成,你应该已经体会到把整套工作流押注在单一工具上的风险。OpenAI 在 3 月 24 日关闭了 Sora 应用和 API,理由是成本难以为继,并计划转向机器人领域,数千名创作者的视频生产流程一夜之间中断。完整的事件经过以及哪些工具填补了这一空缺,请参见我们的《Sora 替代方案指南》。
PixVerse 采取了不同的思路:让你能在完整的创作流程中使用多个模型,而不是把你锁定在单一工具里:
- 文生图支持 GPT Image 2、Nano Banana 2、Seedream 等多个模型——按任务需要挑选合适的模型
- 图生视频将你生成的图片转换为动态画面,具备角色一致性和运镜控制能力
- 文生视频可直接根据文字提示生成片段,使用 PixVerse V6 或电影感更强的 C1 模型
- 原生音频生成能自动为你的视频同步音效和对白
实际带来的好处是:你可以从一个文字概念一路走到带有同步音频的成片,全程无需离开一个工作区,这为每个项目省下大量文件管理的时间。如果你更喜欢通过命令行来编写生成脚本,PixVerse CLI 指南介绍了如何将图片和视频生成都自动化。
PixVerse 还为新用户提供每日 30-60 个免费额度,让你可以在正式付费之前,先测试从图片生成到视频输出的完整流程。
常见问题
GPT Image 2 是免费使用的吗?
免费版 ChatGPT 用户大约每天可以用 GPT Image 2 生成两张图片。ChatGPT Plus 订阅用户(每月 20 美元)可无限生成,且处理速度更快。API 访问按 token 计费,涵盖图片输入、图片输出和文本输入,因此成本会随提示词长度和输出尺寸变化,而不是固定的按图收费。
GPT Image 2 支持什么分辨率?
GPT Image 2 原生支持 2K 分辨率生成,通过 API 可选 4K 放大。宽高比范围从 3:1 到 1:3,因此方形、竖版和超宽格式都可以直接生成。
GPT Image 2 能准确渲染图片中的文字吗?
可以——这是它最突出的能力之一。在我们的测试中,英文、中文、日文、韩文和阿拉伯文的文字准确率在首次生成时就超过了 95%。多行标题、海报标题和 UI 文字标签都能被可靠处理,不过在低分辨率下的极小号文字偶尔仍会出错。
GPT Image 2 与 Midjourney、Nano Banana 2 相比如何?
Midjourney V8 拥有更强的艺术风格控制能力,以及更成熟的美学精修社区。Nano Banana 2 在写实感、电影级光线和快速迭代方面更胜一筹。GPT Image 2 的优势在于文字渲染、结构化排版和自然语言编辑。对于带文字的海报设计和营销素材,GPT Image 2 目前占优;如果是纯粹的艺术探索或写实主视觉,另外两款模型值得直接对比——参见我们的《对比 Nano Banana 2》正面测评。
Sora 关闭后,视频领域有哪些最佳替代方案?
OpenAI 在 2026 年 3 月关闭 Sora 之后,排在前列的替代方案包括:适合角色一致性多镜头视频的 PixVerse V6、擅长电影级运镜控制的 Runway Gen-4,以及适合动作场面的 Kling v3.0。PixVerse 是唯一一个把文生图、图生视频和文生视频与原生音频结合在一起的平台,并且每天都能获得免费额度使用。完整对比详见我们的《Sora 替代方案指南》。
我能把 GPT Image 2 生成的图片转换成视频吗?
可以。由于 GPT Image 2 已在 PixVerse 上线,你可以在应用内生成图片,并在同一工作区中通过图生视频流程将其转换为视频,无需任何文件传输。你也可以上传在其他地方生成的 GPT Image 2 文件,并通过同一流程处理。