Review van GPT Image 2: promptgids en toepassingen in 2026
OpenAI bracht GPT Image 2 uit op 21 april 2026 — de opvolger van GPT Image 1.5 en het model dat nu beeldgeneratie in ChatGPT aandrijft. We testten het tijdens de lanceringsweek en kwamen er eind juni opnieuw op terug met een bredere set prompts, OpenAI’s eigen promptgids en de gepubliceerde API-prijzen, om te zien hoe het model standhoudt zodra de eerste hype is geluwd.
Belangrijkste punten:
- GPT Image 2 genereert beelden op native 2K-resolutie met optionele 4K-opschaling, en de nauwkeurigheid van tekstweergave ligt boven de 95% voor Latijnse, Chinese, Japanse, Koreaanse en Arabische schriften.
- Het model werkt het best als ontwerpassistent en minder als fotogenerator: het blinkt uit in opdrachten met een duidelijke succesnorm — exacte tekst, een vastgelegde lay-out, een herhaalbare paneelstructuur — en wordt minder voorspelbaar bij open prompts in de trant van “maak het mooi”.
- Het reproduceren van merklogo’s, kleine juridische tekst en propriëtaire lettertypen blijven zwakke punten die nog handmatige controle nodig hebben.
- De API van OpenAI factureert GPT Image 2 per token over beeldingang, gecachete beeldingang, beelduitvoer, tekstingang en gecachete tekstingang — een ander prijsmodel dan de tarieven per beeld die sommige concurrenten gebruiken.
- PixVerse neemt GPT Image 2 op in zijn text-to-image-aanbod naast Nano Banana 2 en Seedream, zodat een gegenereerd beeld direct een image-to-video-pipeline in kan zonder de werkruimte te verlaten.
Wat is GPT Image 2? Belangrijkste functies en beperkingen
GPT Image 2 is het beeldmodel van de tweede generatie van OpenAI en vervangt GPT Image 1.5 in ChatGPT en de API. Het concurreert met Midjourney, DALL-E 3 en Stable Diffusion, maar zet zijn identiteit in op twee dingen: nauwkeurige tekst in beelden, en een redeneerlaag die de bedoeling van een prompt interpreteert in plaats van alleen de trefwoorden te matchen.
Kernfuncties in één oogopslag
| Functie | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Native resolutie | 2K (met 4K-opschaling) | 1K | 2K (met —hd-vlag) |
| Nauwkeurigheid tekstweergave | 95%+ meertalig | ~70% (alleen Latijn) | ~80% (alleen Latijn) |
| Integratie van redeneren | Ja — interpreteert gelaagde instructies | Nee | Nee |
| Bereik beeldverhouding | 3:1 tot 1:3 | 1:1, 16:9 | 1:1 tot 3:2 |
| Consistentie van personages | Op pixelniveau over opeenvolgende beelden | Beperkt | Matig (—cref-vlag) |
| Bewerken in natuurlijke taal | Ja — bewerk gebieden door ze te beschrijven | Nee | Nee |
| Prijs | Op tokens via API; ChatGPT-abonnementen | Hetzelfde | Abonnement van $10–30/maand |
Tekstweergave is de functie die de meeste aandacht krijgt, en terecht. Oudere beeldmodellen behandelden tekst als textuur — vroeg je om een posterkop, dan kreeg je ruis in de vorm van letters. GPT Image 2 verwerkt Engelse koppen over meerdere regels, Chinese tekens en lay-outs in meerdere talen met echte consistentie; in onze tests kwamen ongeveer 19 van de 20 generaties bij de eerste poging volledig leesbaar terug.
Integratie van redeneren betekent dat het model meer doet dan je formulering op patronen matchen. Vraag het om “een infographic te genereren met activiteiten voor het weer van morgen in San Francisco”, en het haalt de voorspelling op, kiest relevante activiteiten en bouwt een lay-out rond die gegevens — een stap verder dan hoe Midjourney of Stable Diffusion een prompt verwerken.
Bewerken in natuurlijke taal laat je een beeld herzien door de wijziging te beschrijven in plaats van handmatig te maskeren. “Zet het koffiekopje aan de linkerkant van de tafel” of “verander de lucht in zonsondergang” worden allebei toegepast als gerichte bewerkingen, zonder de hele scène opnieuw te genereren.
Wat gebruikers zeggen
De feedback sinds de lancering is grotendeels positief, met een consistente reeks klachten. Portrettests die circuleren op X en Reddit lijken dicht bij studiofotografie, en posterontwerpers die lange lay-outs testen — flyers, menu’s, bewegwijzering — melden dat de tekstnauwkeurigheid het in echt gebruik eindelijk volhoudt. Verschillende ontwerpers merkten op dat ze een Photoshop-ronde voor basis-marketingassets konden overslaan, omdat het eigen compositiegevoel van het model sterk genoeg is om lay-outbeslissingen zelfstandig te nemen.
De sterkste lof gaat over het opvolgen van prompts: vraag om 15 specifieke elementen in een scène en GPT Image 2 neemt ze meestal allemaal op, terwijl oudere modellen details begonnen te laten vallen naarmate prompts langer werden.
Aan de negatieve kant is merkgetrouwheid nog inconsistent. Een veel gedeelde praktijktest van ZDNet liet zien dat het model het ZDNET-logo niet nauwkeurig reproduceerde, en andere gebruikers meldden hetzelfde bij specifieke merkkensels. Het model begrijpt conceptueel wat een logo is, maar reproduceert exacte vectorvormen of propriëtaire lettertypen niet betrouwbaar.
Bekende beperkingen
- Reproductie van merklogo’s is onbetrouwbaar — zet exacte logo’s na het genereren samen in Photoshop of Figma in plaats van er rechtstreeks om te vragen.
- Generatiesnelheid blijft achter bij lichtere modellen zoals FLUX of Nano Banana 2, met doorgaans 30–60 seconden op ChatGPT Plus tegenover minder dan 10 seconden elders.
- Limieten in de gratis versie zijn krap — ongeveer twee afbeeldingen per dag voor gratis ChatGPT-gebruikers. Plus-abonnees krijgen onbeperkte ChatGPT-generaties, maar API-kosten schalen mee met het volume.
- Stijlcontrole is grover dan bij Midjourney. Je kunt filmstock, lenstype of korrel niet met dezelfde precisie instellen, en de eigen esthetische voorkeur van het model vraagt bewust promptwerk om te overschrijven.
- Contentbeleid is strenger dan bij open-sourcealternatieven, dus sommige prompts die prima werken op Stable Diffusion of lokale modellen worden hier geweigerd.
Geen van deze punten sluit productiegebruik uit, maar ze zijn het weten waard voordat je een pipeline exclusief rond één model bouwt.
Prompts voor GPT Image 2 schrijven die echt werken
De duidelijkste verschuiving in onze tweede testronde: de beste prompts voor GPT Image 2 beschrijven niet alleen een beeld — ze beschrijven de taak die het beeld moet vervullen. Een prompt voor een social advertentie moet anders lezen dan een productuitsnede, een infographic, een UI-scherm of een eerste frame bedoeld voor video.
Een betrouwbaar patroon om de briefing te structureren:
Maak [type afbeelding] voor [toepassing]. Hoofdonderwerp: [specifiek onderwerp en zichtbare details]. Exacte tekst, indien van toepassing: “[tekst die moet verschijnen]”. Compositie: [kadrering, lay-out, negatieve ruimte, plaatsing van het onderwerp]. Stijl en belichting: [visuele taal, medium, sfeer, lichtrichting]. Beperkingen: [wat niet mag veranderen, geen extra woorden, geen watermerk]. Uitvoerformaat: [beeldverhouding, transparante achtergrond, videoklaar frame].
Noem de taak vóór de stijl
Begin met het uitvoertype — poster, productadvertentie, app-scherm, character sheet, diagram, bewerking of eerste videoframe — zodat het model weet aan welke standaard het wordt beoordeeld.
Zwak: Een coole futuristische speaker, cinematografisch, veel detail.
Beter: Maak een premium productadvertentie voor een matzwarte draadloze speaker. De afbeelding moet werken als een 16:9-campagnebanner, met het product rechts, een korte kop links, schone negatieve ruimte en scherpe productranden.
De tweede versie maakt het model duidelijk dat het wordt beoordeeld op lay-out en bruikbaarheid, en niet alleen op esthetiek.
Behandel tekst als een vergrendeld asset
Zet vereiste copy tussen aanhalingstekens en zeg precies hoe die moet worden weergegeven — vraag niet om “een slogan” tenzij je wilt dat het model zelf woorden verzint.
Kop: “SOUND YOU CAN FEEL”. Geef de kop letterlijk weer. Geen extra woorden, geen dubbele tekst, geen nep-logo. Vet wit schreefloos lettertype, linkerkant van de compositie, van een afstand leesbaar.
Splits bij langere copy elke regel expliciet in de prompt. Komt een woord verkeerd gespeld terug, regenereer dan met kortere copy, groter lettertype en een strengere instructie “alleen exacte tekst”.
Geef het model een camera en een lay-out
Benoem camera-afstand, hoek, plaatsing van het onderwerp, negatieve ruimte en beeldverhouding rechtstreeks — GPT Image 2 volgt compositie-aanwijzingen goed, maar alleen als ze expliciet zijn uitgeschreven.
- Close-up voor producttextuur, handen, gezichten, materialen, labels.
- Wijd shot voor omgevingen, verhaalscènes, stadsposters, videoklare frames.
- Bovenaanzicht voor eten, bureauscènes, flat-lays, verpakkingssets.
- Linker derde / rechter derde voor advertentielay-outs die tekst en product in balans brengen.
- Strak raster voor UI-mockups, character sheets, diagrammen, infographics.
Schrijf bewerkingen in drie zinnen
De sterkste bewerkingsprompts scheiden de wijziging van wat onaangeroerd moet blijven en van het fysieke realisme dat ze verbindt:
Vervang de geparkeerde auto door een vintage fiets. Behoud het huis, het hek, de oprit, de beplanting, de lichtrichting, de camerahoek en het tijdstip van de dag exact. Stem de schaal van de fiets, de contactschaduw en het perspectief af op de bestaande scène.
Die structuur “wijzigen, behouden, afstemmen” presteert consequent beter dan een vage vraag als “maak dit mooier”.
Voeg een bewegingscue toe als het stilstaande beeld video wordt
Als een afbeelding later een PixVerse image-to-video-pipeline kan voeden, vraag dan vooraf om diepte en bewegingsgereedheid: voorgrond, middengrond, achtergrond, een schoon silhouet van het onderwerp en één zichtbare cue die kan bewegen — stofdeeltjes, textiel, haar, regen, een reflectie of een camerapad naar voren.
In plaats van: Een astronaut in een woestijn.
Gebruik: Een cinematografisch eerste frame voor een image-to-video-clip: een eenzame astronaut aan de rand van een gloeiende woestijnkrater bij zonsopgang, cape en stof klaar om in de wind te bewegen, sterk silhouet op de voorgrond, duidelijke dieptelagen en warm licht aan de horizon.
Hoe we GPT Image 2 hebben getest
In beide testrondes lieten we het model portretten, tekstzware posters, productachtige composities, character sheets, UI-mockups en experimentele narratieve scènes genereren. Het doel was geen benchmarkscore — het was of een designer, marketeer of creator de output kon opleveren met lichte bewerkingen in plaats van het asset helemaal opnieuw op te bouwen.
| Testgebied | Wat we controleerden |
|---|---|
| Portretten en cinematografische stills | Lichtregie, huidtextuur, reflecties, sfeer, scèneconsistentie |
| Poster- en typografielay-outs | Spelling van koppen, tekst over meerdere regels, hiërarchie, negatieve ruimte, merkachtige afwerking |
| Character- en conceptsheets | Consistentie over meerdere aanzichten, kostuumdetail, paletafstemming, nauwkeurigheid van labels |
| UI- en social mockups | Realisme van de lay-out, kleine tekst, pictogramafstand, feedrasters, geloofwaardigheid van screenshots |
| Experimentele prompts | Humor, narratief redeneren, plaatsing van objecten, nauwkeurigheid van kleine bijschriften |
Het patroon hield stand in beide rondes: GPT Image 2 beloont een precieze briefing meer dan een keten van trefwoorden. Wanneer een prompt de taak benoemt en succes definieert — exacte tekst, een vergrendelde lay-out, een herhaalbare paneelstructuur — neigt het model ernaar de structuur te behouden. Wanneer een prompt alleen om een vage sfeer vraagt, kan het resultaat er nog steeds gepolijst uitzien, maar is het moeilijker te hergebruiken zonder bewerkingen.
Toepassingen van GPT Image 2 met promptvoorbeelden
We hebben vijf verschillende capaciteiten in deze scenario’s zwaar getest: lichtregie, exacte typografie, compositie met meerdere elementen, karakterconsistentie en UI-lay-out. Elke prompt hieronder is klaar om te kopiëren en aan te passen.
Cinematografische portretfotografie
Dit toetst het begrip van het model van belichting, sfeer en ingetogen compositie — de basis die een portfolio-klaar beeld onderscheidt van een generieke AI-render.
Prompt:
Genereer een cinematografisch portret van een eenzame figuur in een intense omgeving met een verloop van oranje naar rood. Sterke silhouetbelichting van achteren, diep schaduwcontrast, een glanzende reflecterende vloer die de figuur spiegelt. Symmetrische compositie, minimale set, geen rommel op de achtergrond. De sfeer is beschouwend en krachtig, als een still uit een sciencefictionfilm. Beeldverhouding 16:9.
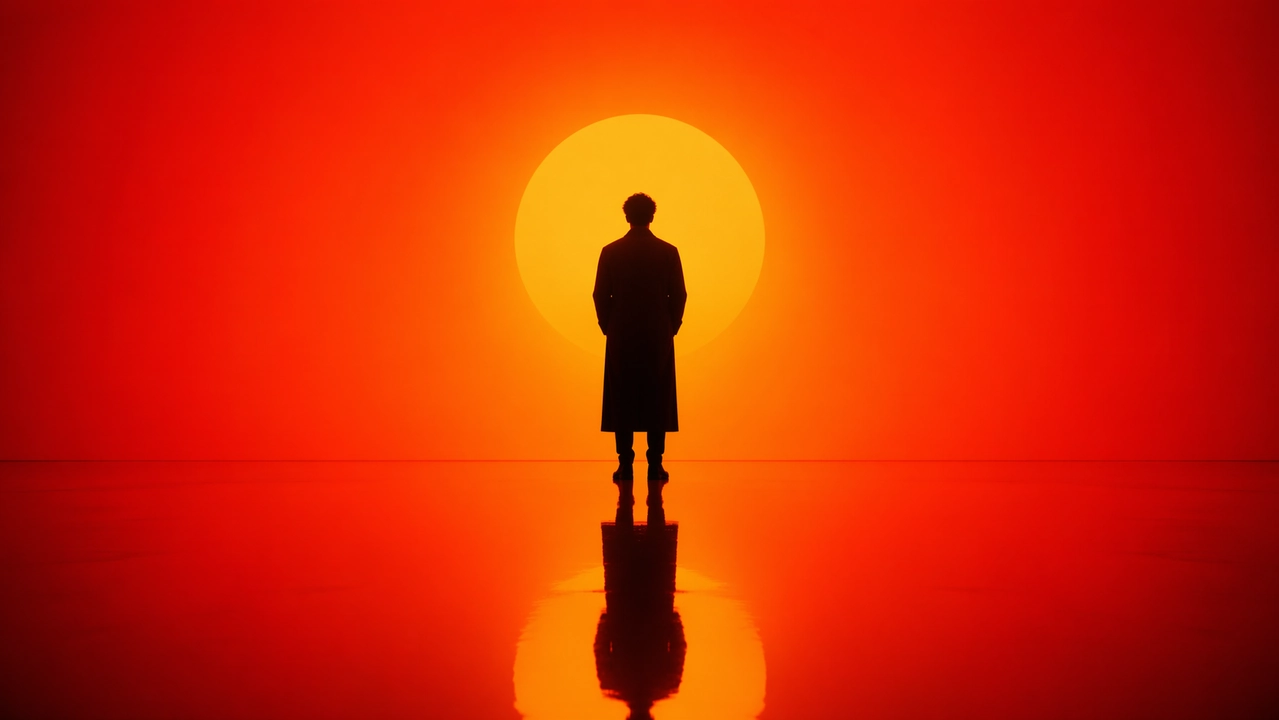
Waar je op let: schone silhouetranden zonder halo-artefacten, een nauwkeurige vloerreflectie met correct perspectief, een vloeiend (niet gebandeerd) verloop, en een pose die echt gewicht draagt in plaats van stijf of zwevend te ogen.
Stadsposter en illustratieontwerp
De zwaarste stresstest voor leesbare typografie in combinatie met een dichte compositie van meerdere elementen — meer dan tien afzonderlijke visuele elementen langs een S-curve, met Engelse tekst die de render intact moet overleven.
Prompt:
Een opvallende stadsposter Spring 2026 voor New York met een gedurfd eigentijds ontwerp en een elegante feestelijke sfeer. Schone gebroken witte getextureerde achtergrond met royale negatieve ruimte. Een miniatuurkajaker peddelt over een smalle strook reflecterend water in de rechterbenedenhoek. Het kielzog veegt omhoog in een dynamische kalligrafische curve en verandert geleidelijk in de Hudson River en daarna in een droomachtig, met de hand geschilderd panorama van Manhattan. Binnen de vloeiende, rivierachtige compositie: het Empire State Building, de Brooklyn Bridge, het bladerdak van Central Park, One World Trade Center, brownstone-daken, gele taxi’s, havenveren en het Vrijheidsbeeld op zachte afstand. Zachte ochtendmist, gouden lentelicht, subtiele accenten in marineblauw en goud. Elegante typografie linksonder luidt “SPRING 2026” met een verticale slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Tekst moet scherp en mooi gecomponeerd zijn. Geen extra woorden. Premium grafisch ontwerp, beeldverhouding 9:16.
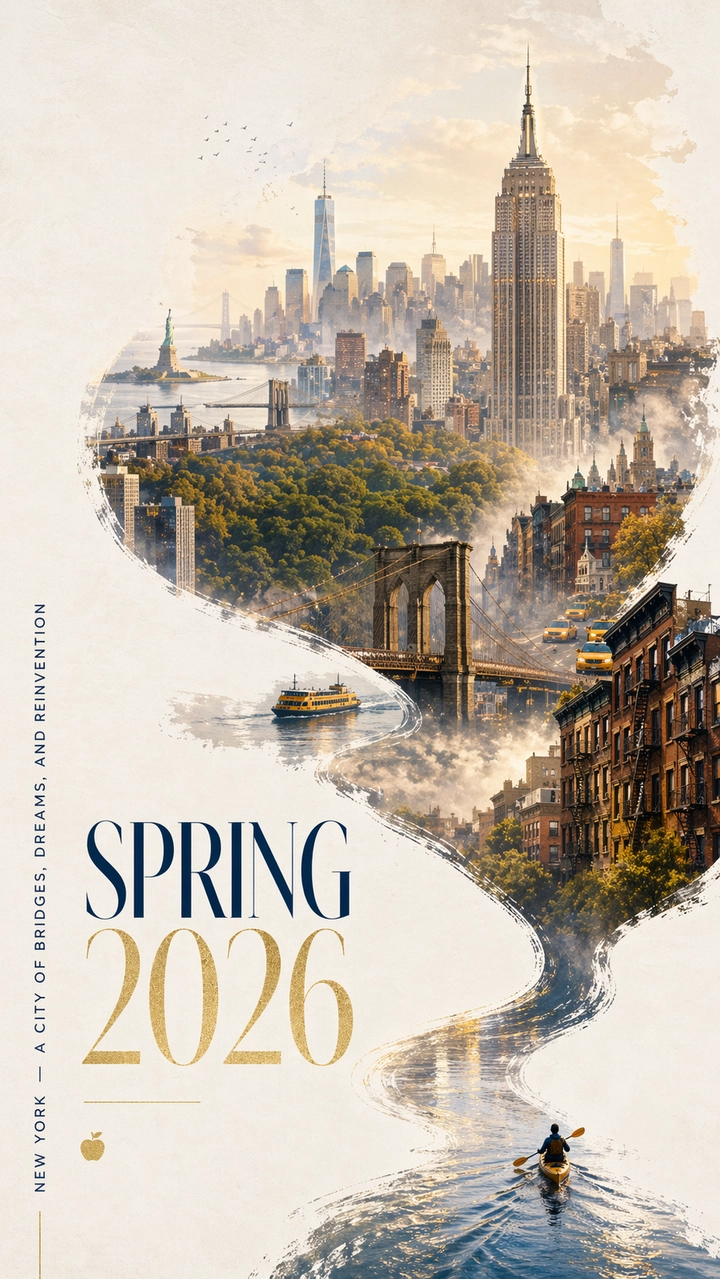
Waar je op let: elke letter in de titel en de slogan moet leesbaar en correct gespeld zijn, de S-curve moet natuurlijk lopen van kajaker naar skyline, landmarkgebouwen moeten herkenbaar ogen in plaats van generieke torens, en de negatieve ruimte moet bewust aanvoelen in plaats van leeg.
Karakterontwerp en referentiesheet
Game-ontwikkelaars en concept artists hebben consistentie over meerdere aanzichten nodig uit één generatie. Dit toetst of het model het ontwerp van een personage stabiel houdt in vooraanzicht, zijaanzicht en achteraanzicht.
Prompt:
Maak een professionele karakterreferentiesheet voor een origineel fantasy-RPG-personage: een jonge vrouwelijke magiër met zilver haar en violette ogen, in een sierlijke donkere mantel met gloeiende runenpatronen. Neem op een schone witte achtergrond op: een turnaround in drie aanzichten met voor, zijkant en achterkant; variaties in gezichtsuitdrukking met neutraal, glimlachend, boos en verrast; gedetailleerde uitsplitsingen van kostuum- en uitrustingsstukken; een rij kleurpaletstalen; en korte worldbuilding-notities in schone typografie. Georganiseerde rasterlay-out, concept-artstijl, hoge resolutie. Beeldverhouding 16:9.
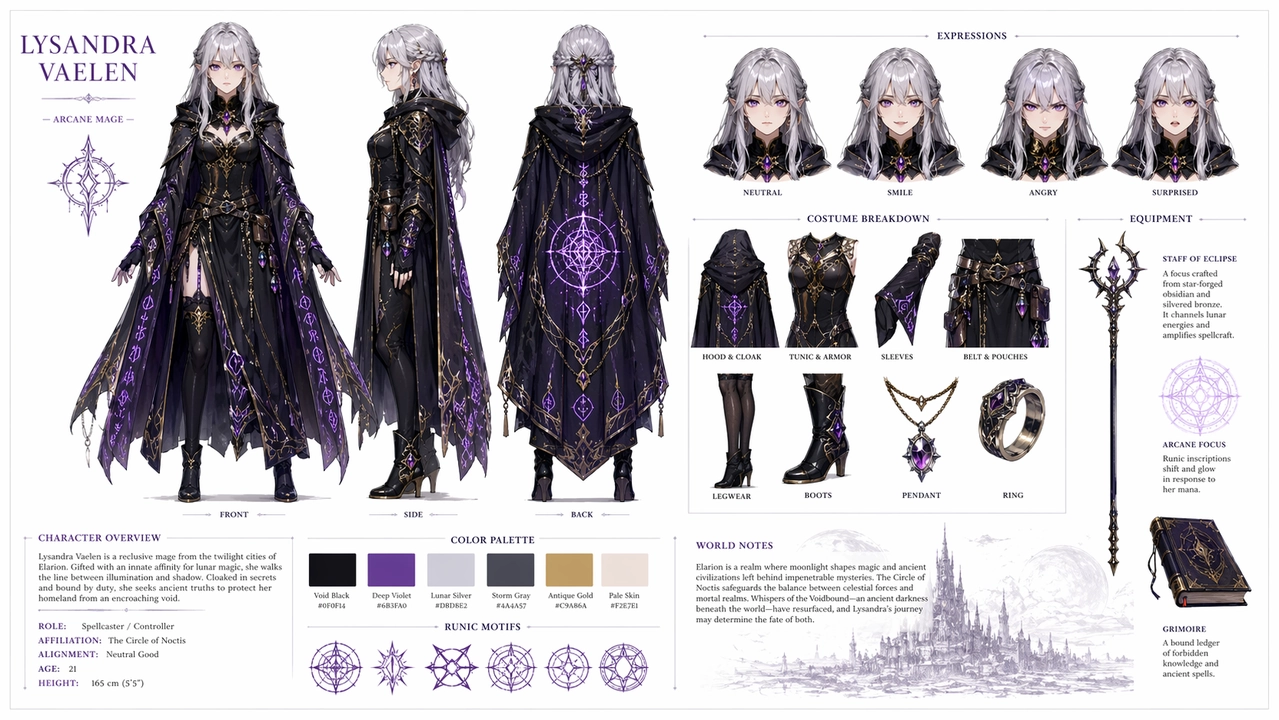
Waar je op let: gezicht, haar en outfit moeten in alle drie de aanzichten consistent blijven; expressievariaties mogen alleen het gezicht veranderen, niet het kapsel of de kleding; het paletstaal moet echt overeenkomen met de kleuren in de kunst; en tekstlabels moeten correct gespeld zijn. Wijkt een zij- of achteraanzicht af, regenereer dan met sterkere “behouden”-taal die de identiteitsankers herhaalt.
UI- en socialmediamockup
Dit duwt drie dingen tegelijk: pixelnauwkeurige UI-lay-out, weergave van tekst in meerdere talen en creatieve conceptfusie — het soort content dat ook goed presteert op social platforms.
Prompt:
Een hyperrealistische iPhone-screenshot van een fictieve Instagram-profielpagina voor Leonardo da Vinci, gebruikersnaam @davinci_official, alsof hij in 2026 een moderne influencer is. De profielfoto is een renaissance-zelfportret in een ronde crop. De bio luidt: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Het raster toont 9 posts: de Mona Lisa opnieuw gekaderd als een mirror selfie, een helicopterschets met het bijschrift “just dropped my new drone design”, een anatomiestudie gepost als een gym-voortgangsfoto, Het Laatste Avondmaal geënsceneerd als een groepsfoto van een etentje, en andere creatieve anachronistische mashups. Aantal volgers: 12,4 mln. Story-highlights gelabeld Sketches, Inventions en Florence Life. Volledige iOS-statusbalk met providertekst “Renaissance 5G”, batterijpictogram en huidige tijd. Overal dark mode-UI. Fotorealistische screenshotkwaliteit, beeldverhouding 9:16.
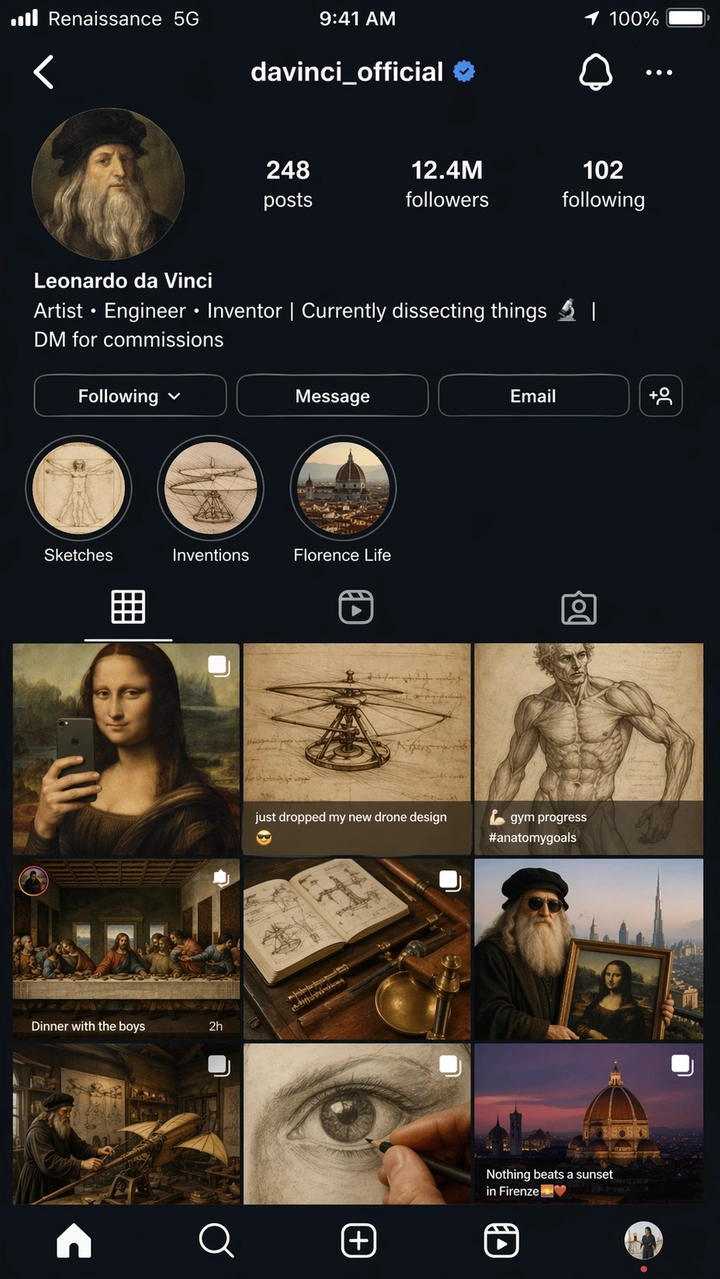
Waar je op let: de Instagram-UI-elementen — rasterafstand, profiellay-out, story-cirkels, tabbalk — moeten lezen als een echte iOS-screenshot en niet als een gestileerde benadering. Alle tekst moet leesbaar zijn, en het providerlabel “Renaissance 5G” is een bewuste nauwkeurigheidscheck. Behandel elke UI-mockupoutput als conceptreferentie en niet als productierijpe UI; kleine labels en pictogramuitlijning hebben meestal een opschoonronde nodig.
Creatieve en experimentele kunst
Korte prompts met ingebouwde narratieve humor toetsen of het model creatieve gaten zelf invult in plaats van te leunen op uitputtende instructies.
Prompt:
In een museumexpositie getiteld “Ancient Technology: The Desktop Era” demonstreert een programmeur in een glazen vitrine live coderen op een CRT-monitor, terwijl verbaasde schoolkinderen hun gezicht tegen het glas drukken. Het expositiebordje luidt: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Een tweede vitrine in de buurt toont een fysiek boek met het label “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D-cartoonillustratiestijl, warme museumverlichting, humoristische en nostalgische toon. Beeldverhouding 16:9.
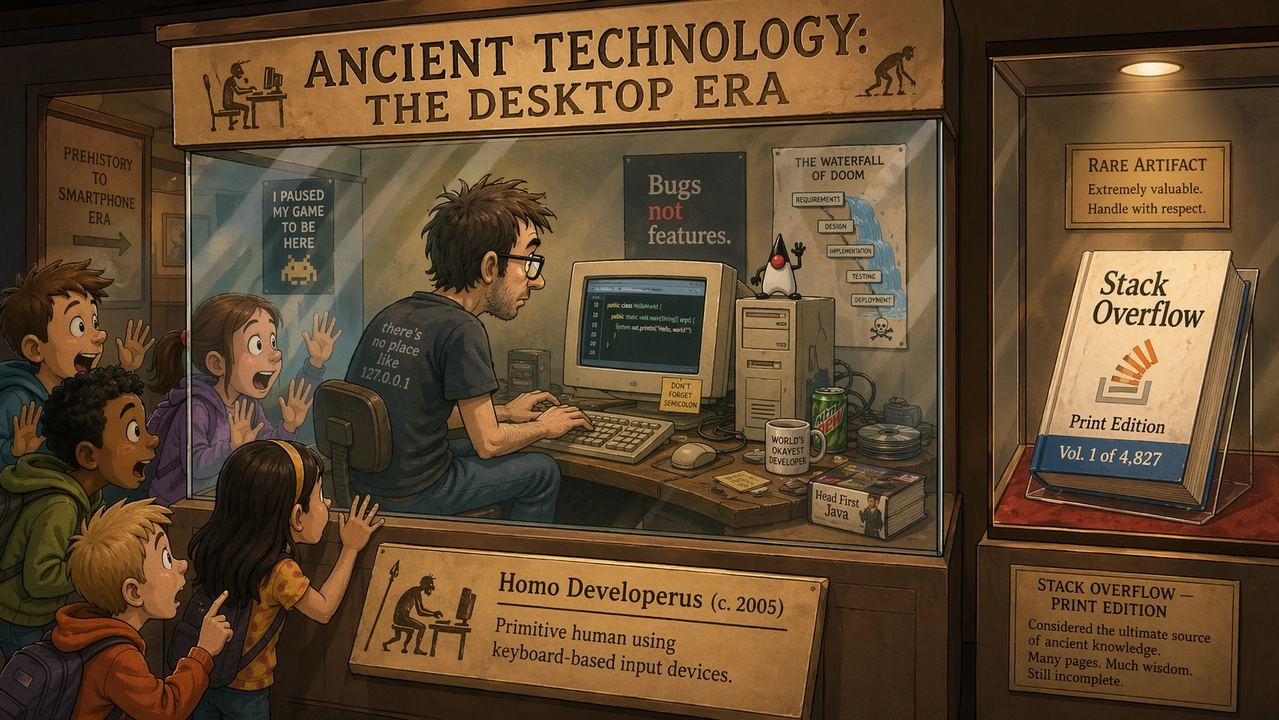
Waar je op let: de humor moet landen via visuele details, en niet alleen via de bijschrifttekst. Het bordje en de boektitel moeten leesbaar en correct gespeld blijven — een echt zware test voor tekst over meerdere regels op klein formaat — en de cartoonstijl moet over de hele scène samenhangend aanvoelen in plaats van hier en daar fotorealistisch.
Testresultaten per toepassing
De sterkste resultaten kwamen consequent van prompts met een duidelijke productiestandaard — iets dat te beoordelen is op spelling, lay-out, behoud van objecten of paneelvolgorde. Vage prompts die alleen een sfeer vroegen, leverden wisselendere resultaten op.
| Toepassing | Wat goed werkte | Wat nog review nodig heeft |
|---|---|---|
| Tekstweergave | Grote koppen, korte labels, postertitels en eenvoudige UI-labels bleven nauwkeurig wanneer de exacte copy tussen aanhalingstekens stond. | Piepkleine juridische copy, dichte alinea’s en gestileerde lettertypen kunnen nog afwijken — houd copy kort en controleer elke letter. |
| Productbeelden | Schone advertentielay-outs, negatieve ruimte voor campagnes en composities met het product voorop werden goed gerenderd. | Echte labels, logo’s en gereguleerde claims hebben nog handmatige review of compositing vanuit goedgekeurde assets nodig. |
| UI-mockups | Mobiele schermen, dashboards en app-achtige hiërarchie oogden aannemelijk wanneer de prompt echte interface-elementen noemde. | Behandel output als conceptmockups — kleine labels en pictogramuitlijning hebben meestal opschoning nodig. |
| Karakterconsistentie | Character sheets, expressierijen en paletstalen werkten goed als creatieve referenties. | Gezichten en kostuumdetails kunnen tussen aanzichten afwijken; herhaal identiteitsankers en regenereer indien nodig. |
| Bewerken en compositing | Het patroon “wijzigen, behouden, afstemmen” presteerde beter dan brede bewerkingsverzoeken. | Selectiegrenzen en uitvoer met transparante achtergrond hebben nog QA nodig. |
Veelgemaakte promptfouten bij GPT Image 2
- Nauwkeurige tekst vragen zonder de exacte copy te geven. Als tekst ertoe doet, schrijf die dan letterlijk uit en zeg waar die hoort.
- Eén prompt overladen met elk mogelijk detail. Begin met de kernscène en verfijn daarna één variabele tegelijk.
- Invarianten bij bewerkingen vergeten te noemen. Schrijf uit wat ongewijzigd moet blijven: identiteit, achtergrond, pose, belichting, productvorm, labeltekst, camerahoek.
- Leunen op decoratieve kwaliteitswoorden voor functionele taken. “Mooi” maakt een label niet leesbaar — gebruik taal als “scherpe labeltekst” of “van een afstand leesbaar”.
- De beeldverhouding overslaan. Een sterk vierkant beeld kan nog steeds falen als verticale advertentie of videominiatuur.
- Logo’s behandelen als gewone tekst. GPT Image 2 kan logoconcepten ontwerpen, maar exacte merktekens moeten worden samengesteld uit goedgekeurde assets in plaats van rechtstreeks te worden gevraagd.
GPT Image 2 API en prijzen
De API-prijspagina van OpenAI vermeldt GPT Image 2 op tokenbasis en niet als een vast tarief per afbeelding:
| Item | Vermelde prijs |
|---|---|
| Beeldinvoer | $8.00 / 1 mln. tokens |
| Gecachte beeldinvoer | $2.00 / 1 mln. tokens |
| Beelduitvoer | $30.00 / 1 mln. tokens |
| Tekstinvoer | $5.00 / 1 mln. tokens |
| Gecachte tekstinvoer | $1.25 / 1 mln. tokens |
De werkelijke kosten per afbeelding hangen af van promptlengte, referentiebeelden, uitvoerformaat, caching en kwaliteitsinstelling. Quota van ChatGPT-abonnementen lopen los van API-facturering — een Plus-abonnement vertaalt zich niet rechtstreeks naar API-tegoed, dus budgetteer beide apart als je ze allebei gebruikt.
Voor workflows met hoog volume is het getal dat telt de kosten per geaccepteerd asset na nieuwe pogingen, niet de catalogusprijs van één poging. Een goedkopere generatie is niet echt goedkoper als er drie regeneraties nodig zijn om spelling of lay-out goed te krijgen.
| Workflow | Praktisch promptadvies |
|---|---|
| Tekstzware posters of diagrammen | Gebruik minder woorden per afbeelding, citeer de exacte copy en specificeer de hiërarchie expliciet. |
| Productfoto’s | Vergrendel productvorm, label, kleur, materiaal en camerahoek; herhaal de behoudlijst bij elke bewerkingsronde. |
| UI-mockups | Beschrijf het scherm als een opgeleverde interface — navigatie, kaarten, knoppen, states — en niet als concept art. |
| Bewerkingen met meerdere referenties | Label elk invoerbeeld op rol: onderwerp, stijl, achtergrond, outfit of materiaalreferentie. |
| Batchgeneratie | Volg de kosten per geaccepteerde afbeelding, niet de kosten per poging. |
Wil je zien hoe GPT Image 2 zich verhoudt tot een alternatief dat fotorealisme vooropstelt bij identieke prompts, dan draait onze vergelijking GPT Image 2 vs. Nano Banana 2 zes directe rondes met volledige prijsuitsplitsingen voor API en platform.
Van beeld naar video: maak je creatieve workflow compleet op PixVerse
Een sterk beeld genereren is één stap. Het in beweging zetten is waar de meeste workflows stuklopen — je maakt een portret of een productposter af in GPT Image 2 en moet daarna een aparte tool openen, het bestand opnieuw uploaden en hopen dat het videomodel je zorgvuldig gecomponeerde beeld niet vervormt. Die overdrachtswrijving is precies wat PixVerse wegneemt.
GPT Image 2 is live op PixVerse
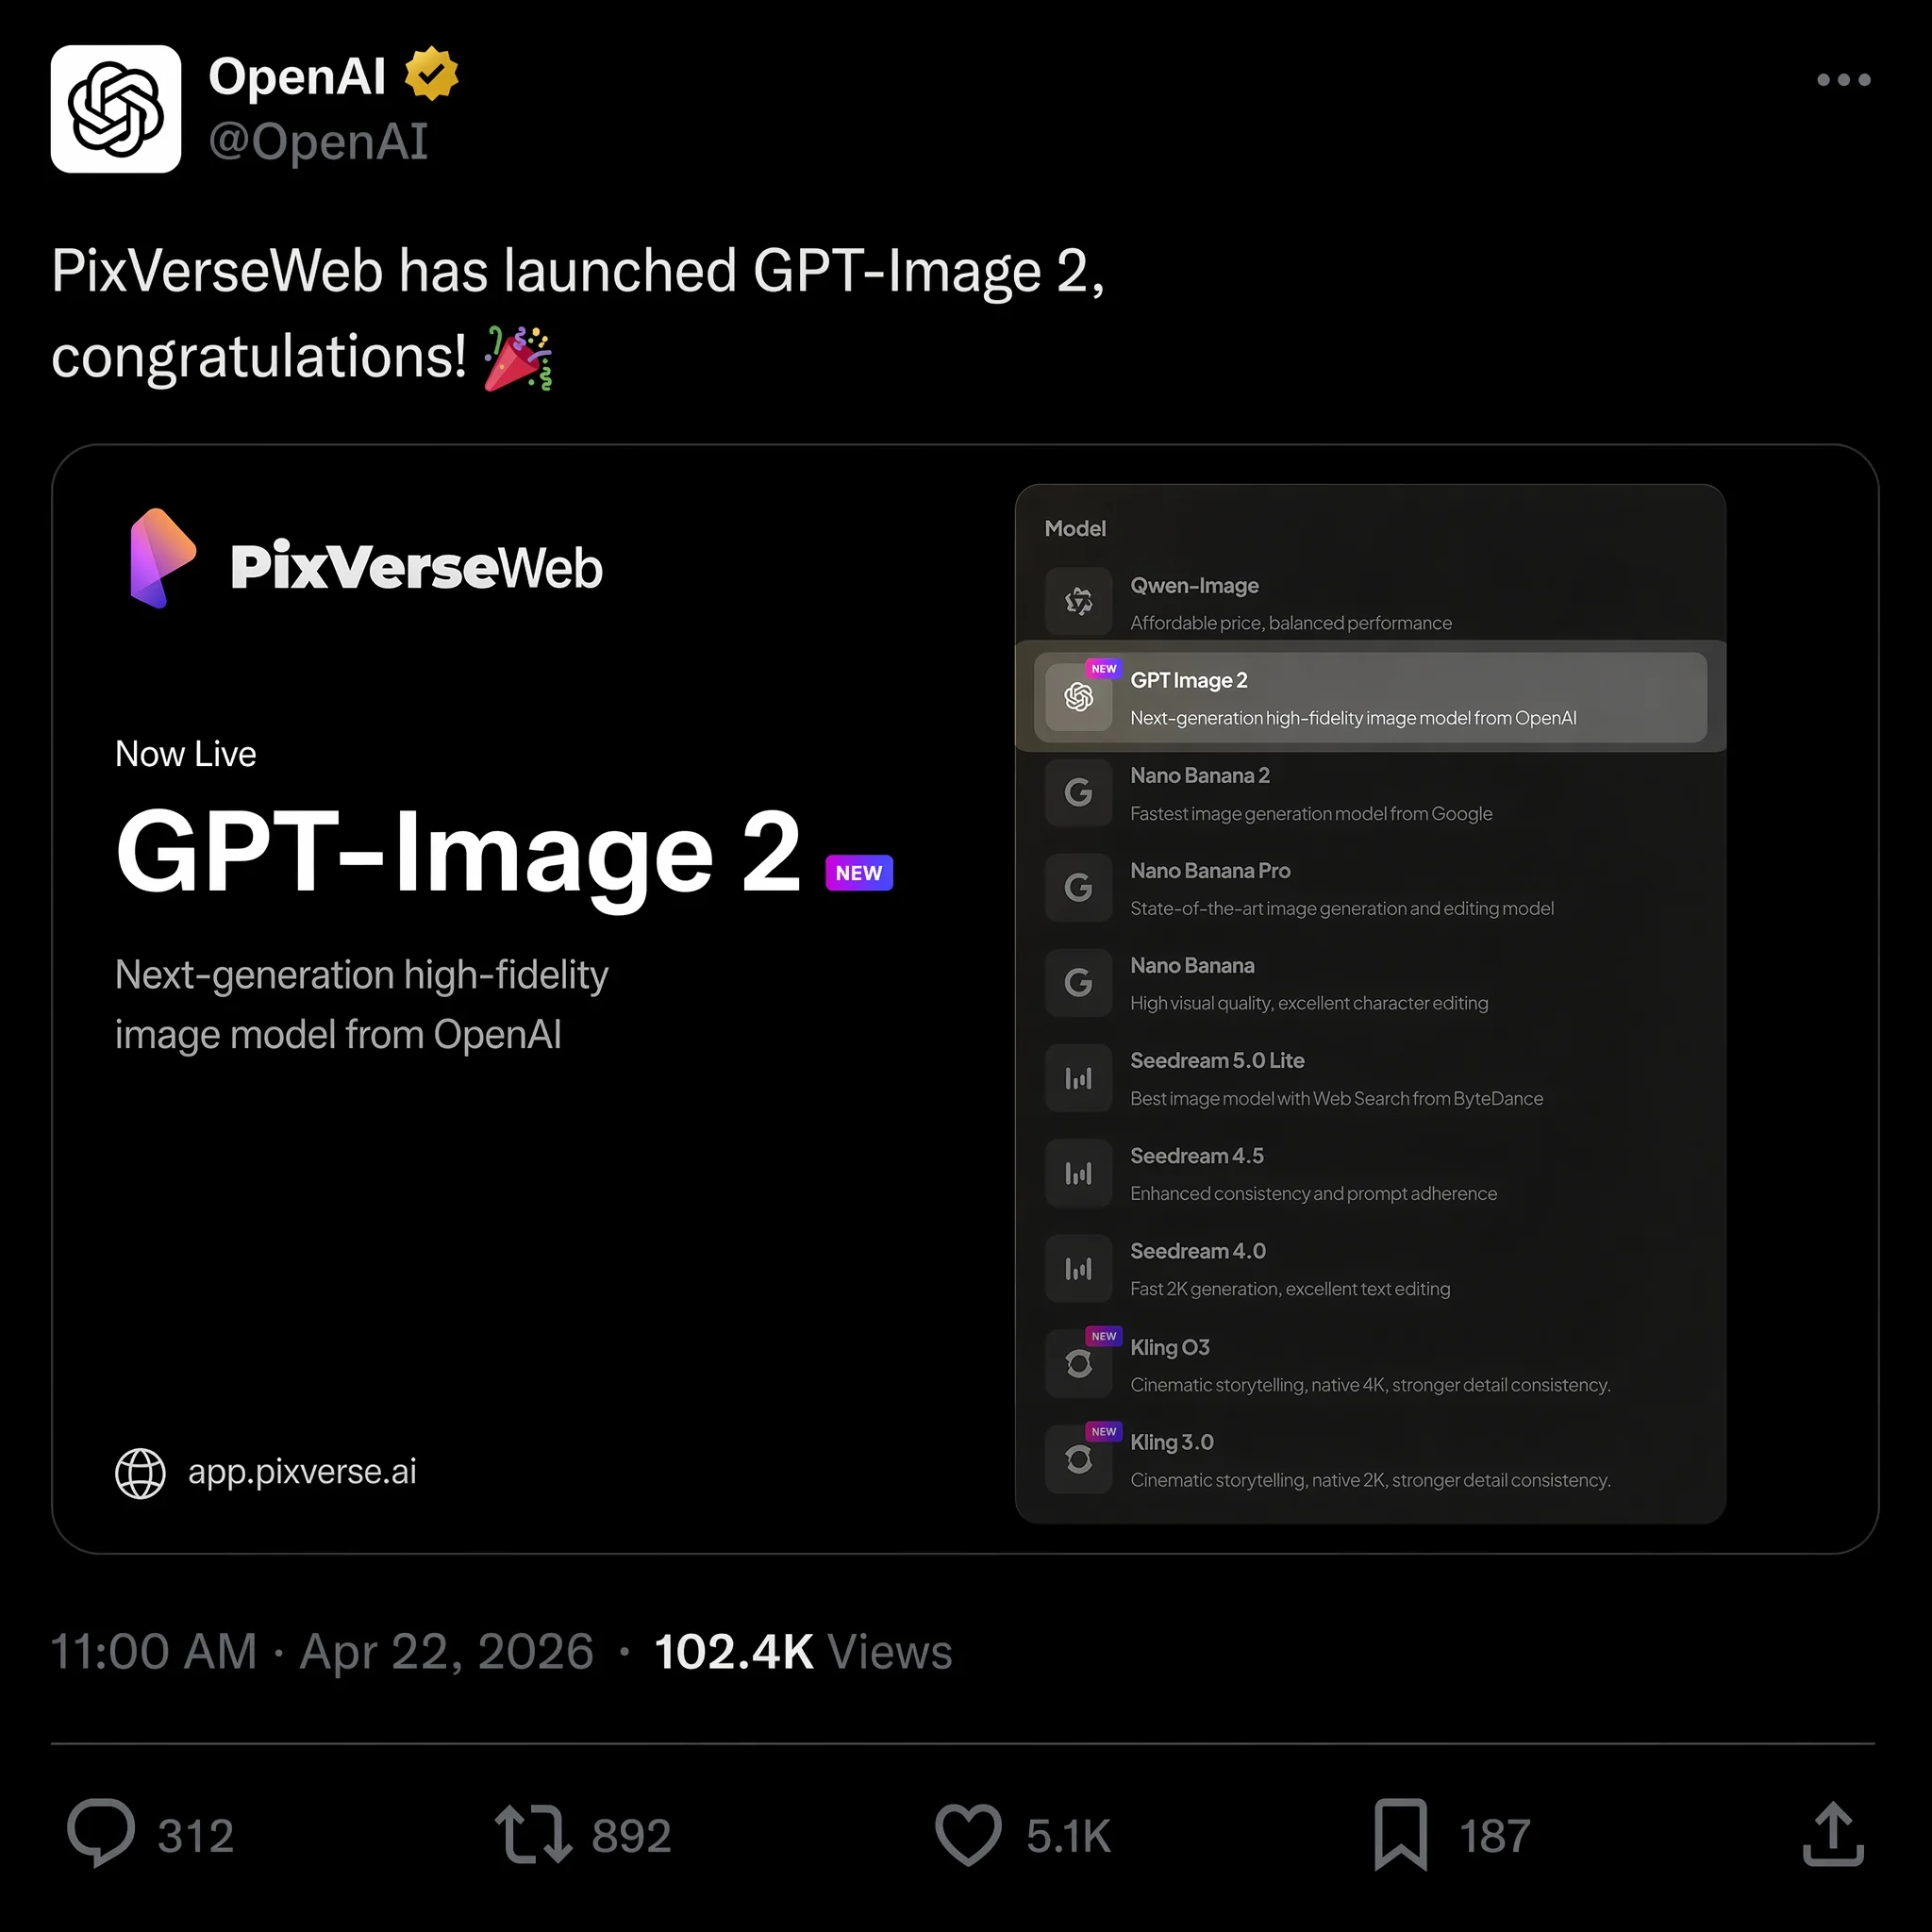
Op 22 april 2026 voegde PixVerse GPT Image 2 toe als text-to-image-optie, naast Nano Banana 2, Seedream en HappyHorse 1.0 in het modellenaanbod. Je kunt een beeld genereren met GPT Image 2 en het in dezelfde workspace omzetten naar video, zonder downloaden, opnieuw uploaden of van tab wisselen.
Dat telt om een concrete reden: wanneer het beeld rechtstreeks een image-to-video-pipeline op hetzelfde platform voedt, werkt het videomodel vanuit het bronbestand op volledige resolutie en de bijbehorende metadata. Er is onderweg geen kwaliteitsverlies door compressie of formaatconversie, wat schonere beweging en minder artefacten in de uiteindelijke clip betekent.
Als een still een clip moet worden, vraag dan vanaf het begin om bewegingsgereedheid — vraag om diepte in voorgrond, middengrond en achtergrond, een schoon silhouet van het onderwerp en één fysiek element dat aannemelijk kan bewegen (stofdeeltjes, stoom, textiel, een verschuivende lichtbron). Beoordeel de still als een afgerond ontwerpbestand voordat je die animeert: controleer eerst spelling, productgeometrie en UI-uitlijning, want een videomodel herstelt een verkeerd gespelde kop of een vervormd label niet vanzelf. Schrijf daarna een aparte, kortere bewegingsprompt die alleen beschrijft wat moet bewegen en wat vergrendeld moet blijven, in plaats van de volledige beeldbriefing te herhalen.
Waarom creators overstappen naar een alles-in-éénplatform
Gebruikte je vóór maart 2026 OpenAI’s Sora voor videogeneratie, dan ken je het risico van een workflow rond één tool al. OpenAI sloot de Sora-app en API op 24 maart, met als reden onhoudbare kosten en een draai richting robotica, en duizenden creators verloren van de ene op de andere dag hun videopipeline. Zie onze gids over Sora-alternatieven voor een volledig overzicht van wat er gebeurde en welke tools het gat vulden.
PixVerse kiest een andere aanpak door je toegang te geven tot meerdere modellen over de volledige creatieve pipeline, in plaats van je vast te zetten op één model:
- Text-to-image met GPT Image 2, Nano Banana 2, Seedream en meer — kies het model dat bij de taak past
- Image-to-video dat je gegenereerde beelden omzet in beweging met karakterconsistentie en camerabesturing
- Text-to-video voor clips die rechtstreeks uit een geschreven prompt worden gegenereerd met PixVerse V6 of het cinematografische C1-model
- Native audiogeneratie die geluidseffecten en dialoog automatisch op je video synchroniseert
Het praktische voordeel: je gaat van een geschreven concept naar een afgewerkte video met gesynchroniseerde audio zonder één workspace te verlaten, wat uren bestandsbeheer uit elk project haalt. Werk je liever vanaf de opdrachtregel, dan behandelt de PixVerse CLI-gids het automatiseren van zowel beeld- als videogeneratie.
PixVerse biedt nieuwe gebruikers ook 30–60 gratis credits per dag, zodat je de volledige pipeline — van beeldgeneratie tot video-uitvoer — kunt testen voordat je een betaald abonnement neemt.
Veelgestelde vragen
Is GPT Image 2 gratis te gebruiken?
Gratis ChatGPT-gebruikers kunnen met GPT Image 2 ongeveer twee afbeeldingen per dag genereren. ChatGPT Plus-abonnees ($20 per maand) krijgen onbeperkte generaties met snellere verwerking. API-toegang wordt per token gefactureerd over beeldinvoer, beelduitvoer en tekstinvoer, dus de kosten schalen mee met promptlengte en uitvoerformaat in plaats van een vast tarief per afbeelding.
Welke resolutie ondersteunt GPT Image 2?
GPT Image 2 genereert beelden op native 2K-resolutie, met een optionele 4K-opschaling via de API. Beeldverhoudingen lopen van 3:1 tot 1:3, dus vierkant, verticaal en ultrabreed zijn allemaal rechtstreeks beschikbaar.
Kan GPT Image 2 tekst in afbeeldingen nauwkeurig weergeven?
Ja — dit is een van de sterkste functies. In onze tests lag de tekstnauwkeurigheid voor Engels, Chinees, Japans, Koreaans en Arabisch boven 95% bij de eerste generatiepoging. Koppen over meerdere regels, postertitels en UI-tekstlabels worden allemaal betrouwbaar afgehandeld, al kan zeer kleine tekst bij lage resoluties nog af en toe misgaan.
Hoe verhoudt GPT Image 2 zich tot Midjourney en Nano Banana 2?
Midjourney V8 heeft sterkere artistieke stijlregie en een meer gevestigde community voor esthetische verfijning. Nano Banana 2 is de sterkere keuze voor fotorealisme, cinematografische belichting en snelle iteratie. GPT Image 2 heeft de voorsprong bij tekstweergave, gestructureerde lay-outs en bewerken in natuurlijke taal. Voor posterontwerp en marketingmateriaal met tekst wint GPT Image 2 op dit moment; voor puur artistieke verkenning of fotorealistische hero-shots zijn de andere twee het directe vergelijken waard — zie onze directe test tegen Nano Banana 2.
Wat zijn de beste alternatieven voor Sora voor video na de sluiting?
Nadat OpenAI Sora in maart 2026 sloot, behoren tot de topalternatieven PixVerse V6 voor video met meerdere shots en consistente personages, Runway Gen-4 voor cinematografische camerabesturing en Kling v3.0 voor actiesequenties. PixVerse is het enige platform dat text-to-image, image-to-video en text-to-video combineert met native audio, allemaal beschikbaar met dagelijkse gratis credits. Zie onze volledige gids over Sora-alternatieven voor een gedetailleerde vergelijking.
Kan ik output van GPT Image 2 omzetten naar video?
Ja. Met GPT Image 2 beschikbaar in PixVerse kun je het beeld in de app genereren en omzetten naar video via de image-to-video-pipeline in dezelfde workspace, zonder bestandsoverdrachten. Je kunt ook een elders gemaakt GPT Image 2-bestand uploaden en door dezelfde pipeline halen.