Análisis de GPT Image 2: Guía de Prompts y Casos de Uso en 2026
OpenAI lanzó GPT Image 2 el 21 de abril de 2026, sucesor de GPT Image 1.5 y el modelo que ahora impulsa la generación de imágenes en ChatGPT. Lo probamos durante la semana de lanzamiento y volvimos a él a finales de junio con un conjunto más amplio de prompts, la propia guía de prompting de OpenAI y sus precios de API publicados, para ver cómo se sostiene el modelo una vez que se calma el entusiasmo inicial.
Puntos Clave:
- GPT Image 2 genera imágenes a resolución nativa de 2K con upscaling opcional a 4K, y la precisión del renderizado de texto supera el 95% en escrituras latina, china, japonesa, coreana y árabe.
- El modelo se aprovecha mejor como un asistente de diseño que como un generador de fotos: destaca en tareas con un estándar de éxito claro (texto exacto, un layout fijo, una estructura de paneles repetible) y se vuelve menos predecible en prompts abiertos del tipo “hazlo bonito”.
- La reproducción de logotipos de marca, el texto legal diminuto y las tipografías propietarias siguen siendo puntos débiles que todavía requieren revisión manual.
- La API de OpenAI cobra GPT Image 2 por token, según entrada de imagen, entrada de imagen en caché, salida de imagen, entrada de texto y entrada de texto en caché, un modelo de precios distinto al de niveles por imagen que usan algunos competidores.
- PixVerse incluye GPT Image 2 en su catálogo de texto a imagen junto a Nano Banana 2 y Seedream, de modo que una imagen generada puede pasar directamente a un flujo de imagen a video sin salir del espacio de trabajo.
Qué Es GPT Image 2: Funciones Clave y Limitaciones
GPT Image 2 es el modelo de imágenes de segunda generación de OpenAI, que reemplaza a GPT Image 1.5 tanto en ChatGPT como en la API. Compite con Midjourney, DALL-E 3 y Stable Diffusion, pero construye su identidad sobre dos pilares: texto preciso dentro de las imágenes y una capa de razonamiento que interpreta la intención de un prompt en lugar de solo emparejar sus palabras clave.
Funciones Principales de un Vistazo
| Función | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Resolución nativa | 2K (con upscale a 4K) | 1K | 2K (con la opción —hd) |
| Precisión del renderizado de texto | 95%+ multilingüe | ~70% (solo latino) | ~80% (solo latino) |
| Integración de razonamiento | Sí, interpreta instrucciones en capas | No | No |
| Rango de relación de aspecto | 3:1 a 1:3 | 1:1, 16:9 | 1:1 a 3:2 |
| Consistencia de personajes | A nivel de píxel en imágenes secuenciales | Limitada | Moderada (opción —cref) |
| Edición en lenguaje natural | Sí, edita regiones describiéndolas | No | No |
| Precios | Basado en tokens vía API; niveles de plan de ChatGPT | Igual | Suscripción de $10–30/mes |
El renderizado de texto es la función que recibe más atención, y con razón. Los modelos de imágenes más antiguos trataban el texto como textura: pedías el titular de un póster y obtenías ruido con forma de letras. GPT Image 2 maneja titulares en inglés de varias líneas, caracteres chinos y layouts multilingües con verdadera consistencia; en nuestras pruebas, aproximadamente 19 de cada 20 generaciones resultaron completamente legibles al primer intento.
La integración de razonamiento significa que el modelo hace más que emparejar patrones con tu redacción. Pídele “generar una infografía que muestre actividades para el clima de mañana en San Francisco”, y extraerá el pronóstico, elegirá actividades relevantes y construirá un layout alrededor de esos datos, un paso más allá de cómo Midjourney o Stable Diffusion procesan un prompt.
La edición en lenguaje natural te permite revisar una imagen describiendo el cambio en lugar de enmascararlo manualmente. Tanto “mueve la taza de café al lado izquierdo de la mesa” como “cambia el cielo a un atardecer” se aplican como ediciones puntuales sin regenerar toda la escena.
Qué Dicen los Usuarios
Los comentarios desde el lanzamiento han sido en su mayoría positivos, con un conjunto consistente de quejas. Las pruebas de retratos que circulan en X y Reddit se ven cercanas a la fotografía de estudio, y los diseñadores de pósters que prueban layouts extensos (folletos, menús, señalización) reportan que la precisión del texto por fin se sostiene en uso real. Varios diseñadores notaron que podían saltarse un paso en Photoshop para materiales de marketing básicos porque el propio sentido de composición del modelo es lo bastante fuerte como para tomar decisiones de layout sin asistencia.
El elogio más fuerte se centra en la adherencia al prompt: pide 15 elementos específicos en una escena y GPT Image 2 tiende a incluirlos todos, mientras que los modelos más antiguos empezaban a perder detalles a medida que los prompts se alargaban.
En el lado negativo, la fidelidad de marca sigue siendo inconsistente. Una prueba práctica de ZDNet, ampliamente compartida, mostró al modelo fallando en reproducir con precisión el logotipo de ZDNET, y otros usuarios han reportado lo mismo con marcas específicas. El modelo entiende conceptualmente qué es un logotipo, pero no reproduce de forma confiable formas vectoriales exactas ni tipografías propietarias.
Limitaciones Conocidas
- La reproducción de logotipos de marca no es confiable: compón logotipos exactos en Photoshop o Figma después de la generación en lugar de pedirlos directamente en el prompt.
- La velocidad de generación va por detrás de modelos más ligeros como FLUX o Nano Banana 2, con 30–60 segundos típicos en ChatGPT Plus frente a menos de 10 segundos en otros lugares.
- Los límites de la capa gratuita son estrictos: aproximadamente dos imágenes al día para usuarios gratuitos de ChatGPT. Los suscriptores de Plus obtienen generaciones ilimitadas en ChatGPT, pero los costos de la API escalan con el volumen.
- El control de estilo es más tosco que el de Midjourney. No puedes ajustar el tipo de película, el tipo de lente ni el grano con la misma precisión, y el propio sesgo estético del modelo requiere trabajo deliberado de prompting para anularlo.
- La política de contenido es más estricta que las alternativas de código abierto, así que algunos prompts que funcionan bien en Stable Diffusion o modelos locales serán rechazados aquí.
Nada de esto descarta el uso en producción, pero vale la pena conocerlo antes de construir un flujo de trabajo alrededor de un solo modelo en exclusiva.
Cómo Escribir Prompts de GPT Image 2 Que Realmente Funcionan
El cambio más claro en nuestra segunda ronda de pruebas: los mejores prompts de GPT Image 2 no solo describen una imagen, describen el trabajo que la imagen tiene que cumplir. Un prompt para un anuncio social debería leerse de forma distinta a uno para un recorte de producto, una infografía, una pantalla de UI o un primer fotograma pensado para video.
Un patrón confiable para estructurar el brief:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Nombra el trabajo antes que el estilo
Comienza con el tipo de salida (póster, anuncio de producto, pantalla de app, hoja de personaje, diagrama, edición o primer fotograma de video) para que el modelo sepa contra qué estándar se le está evaluando.
Débil: A cool futuristic speaker, cinematic, high detail.
Mejor: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
La segunda versión le indica al modelo que se le está juzgando por el layout y la usabilidad, no solo por la estética.
Trata el texto como un activo cerrado
Coloca cualquier texto requerido entre comillas y especifica exactamente cómo debe renderizarse; no pidas “un eslogan” a menos que quieras que el modelo invente palabras por ti.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Para textos más largos, divide cada línea explícitamente en el prompt. Si una palabra vuelve mal escrita, regenera con texto más corto, tipografía más grande y una instrucción más estricta de “solo texto exacto”.
Dale al modelo una cámara y un layout
Indica directamente la distancia de cámara, el ángulo, la ubicación del sujeto, el espacio negativo y la relación de aspecto: GPT Image 2 sigue bien las indicaciones de composición, pero solo cuando están explicitadas.
- Primer plano para textura de producto, manos, rostros, materiales, etiquetas.
- Plano general para entornos, escenas narrativas, pósters de ciudad, fotogramas listos para video.
- Vista cenital para comida, escenas de escritorio, flat-lays, kits de empaque.
- Tercio izquierdo / tercio derecho para layouts de anuncios que equilibran texto y producto.
- Cuadrícula limpia para mockups de UI, hojas de personaje, diagramas, infografías.
Escribe las ediciones en tres frases
Los prompts de edición más sólidos separan el cambio de lo que debe permanecer intacto y del realismo físico que los une:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Esa estructura de “cambiar, preservar, ajustar” supera de forma consistente a una solicitud vaga de “haz que esto se vea mejor”.
Añade una indicación de movimiento si la imagen fija se convertirá en video
Si una imagen podría alimentar más adelante un flujo de imagen a video de PixVerse, indica desde el inicio la profundidad y la disposición al movimiento: primer plano, plano medio, fondo, una silueta de sujeto limpia y una señal visible que pudiera moverse (polvo, tela, cabello, lluvia, reflejo o una trayectoria de avance de cámara).
En lugar de: An astronaut in a desert.
Usa: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Cómo Probamos GPT Image 2
A lo largo de ambas rondas de pruebas, pusimos al modelo a prueba con retratos, pósters cargados de texto, composiciones de estilo producto, hojas de personaje, mockups de UI y escenas narrativas experimentales. El objetivo no era una puntuación de referencia, sino determinar si un diseñador, especialista en marketing o creador podría entregar el resultado con ediciones ligeras en lugar de reconstruir el activo desde cero.
| Área de prueba | Qué evaluamos |
|---|---|
| Retratos y tomas cinematográficas | Control de iluminación, textura de piel, reflejos, atmósfera, consistencia de escena |
| Layouts de póster y tipografía | Ortografía del titular, texto multilínea, jerarquía, espacio negativo, acabado tipo marca |
| Hojas de personaje y concepto | Consistencia multivista, detalle de vestuario, alineación de paleta, precisión de etiquetas |
| Mockups de UI y redes sociales | Realismo de layout, texto pequeño, espaciado de íconos, cuadrículas de feed, credibilidad de captura de pantalla |
| Prompts experimentales | Humor, razonamiento narrativo, colocación de objetos, precisión de subtítulos pequeños |
El patrón se mantuvo en ambas rondas: GPT Image 2 recompensa un brief preciso más que una cadena de palabras clave. Cuando un prompt nombra el trabajo y define el éxito (texto exacto, un layout fijo, una estructura de paneles repetible), el modelo tiende a preservar la estructura. Cuando un prompt solo pide un ambiente vago, el resultado aún puede lucir pulido, pero es más difícil de reutilizar sin ediciones.
Casos de Uso de GPT Image 2 con Ejemplos de Prompts
Sometimos a prueba de estrés cinco capacidades distintas en estos escenarios: control de iluminación, tipografía de texto exacto, composición multielemento, consistencia de personajes y layout de UI. Cada prompt a continuación está listo para copiar y adaptar.
Fotografía de Retrato Cinematográfico
Esto evalúa la comprensión del modelo sobre iluminación, atmósfera y composición contenida, los fundamentos que separan una imagen lista para portafolio de un render genérico de IA.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
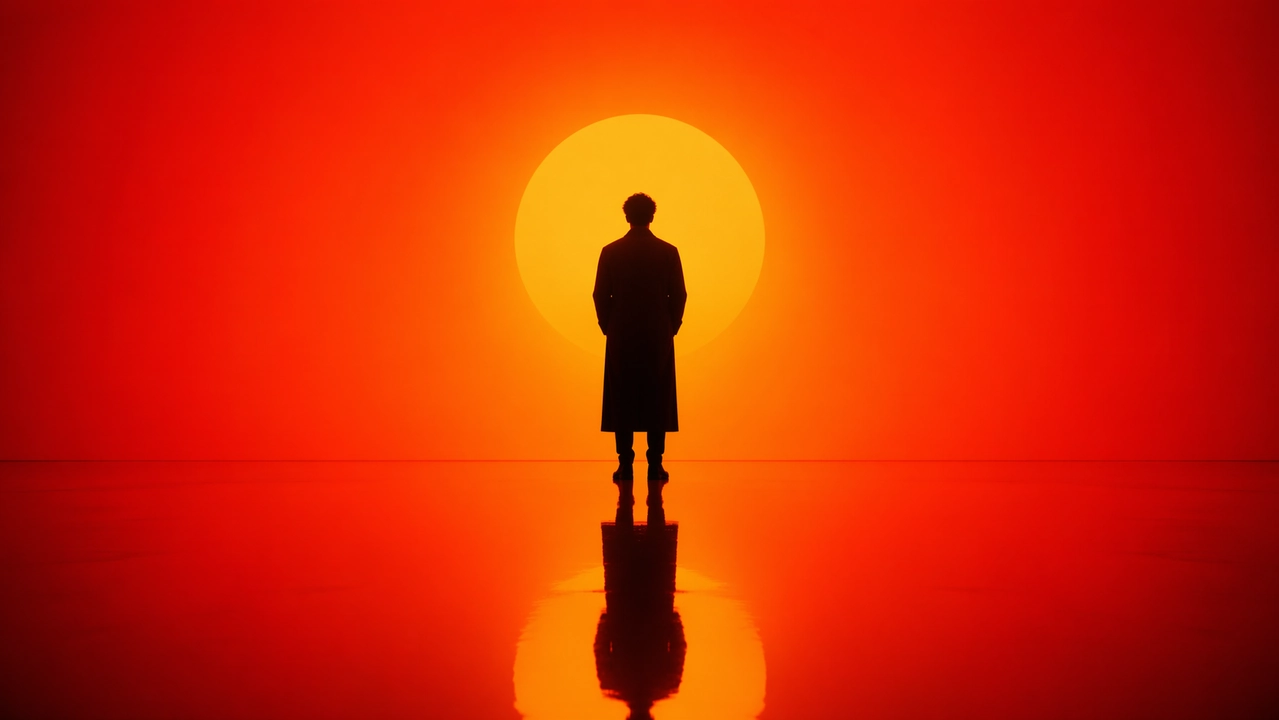
Qué buscar: bordes de silueta limpios sin artefactos de halo, un reflejo de suelo preciso con perspectiva correcta, un degradado suave (no en bandas) y una pose que transmita peso real en lugar de verse rígida o flotante.
Diseño de Póster e Ilustración de Ciudad
La prueba de estrés más difícil para tipografía legible combinada con una composición densa y multielemento: más de diez elementos visuales distintos dispuestos a lo largo de una curva en S, con texto en inglés que tiene que sobrevivir intacto al renderizado.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
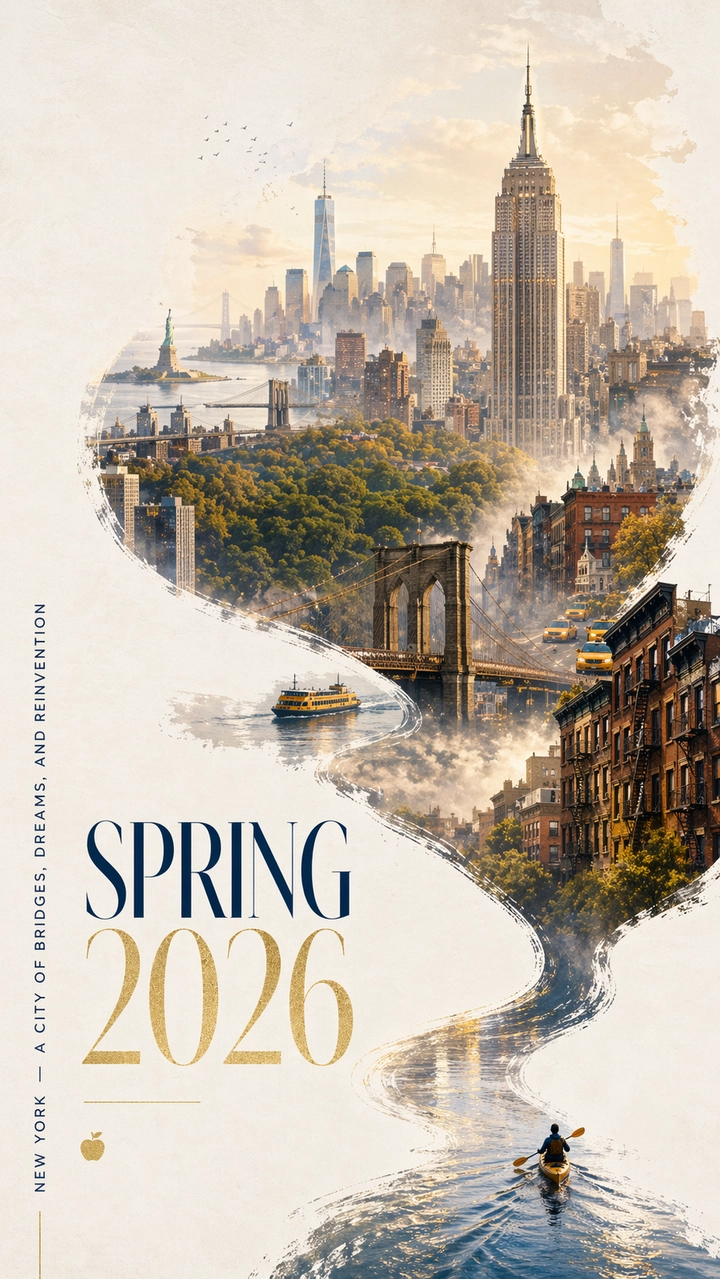
Qué buscar: cada letra del título y del eslogan debe ser legible y estar bien escrita, la curva en S debe fluir naturalmente desde el kayakista hasta el horizonte, los edificios emblemáticos deben leerse como reconocibles en lugar de torres genéricas, y el espacio negativo debe sentirse intencional en lugar de vacío.
Diseño de Personaje y Hoja de Referencia
Los desarrolladores de videojuegos y artistas conceptuales necesitan consistencia multivista a partir de una sola generación. Esto evalúa si el modelo puede mantener el diseño de un personaje estable en las vistas frontal, lateral y trasera.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
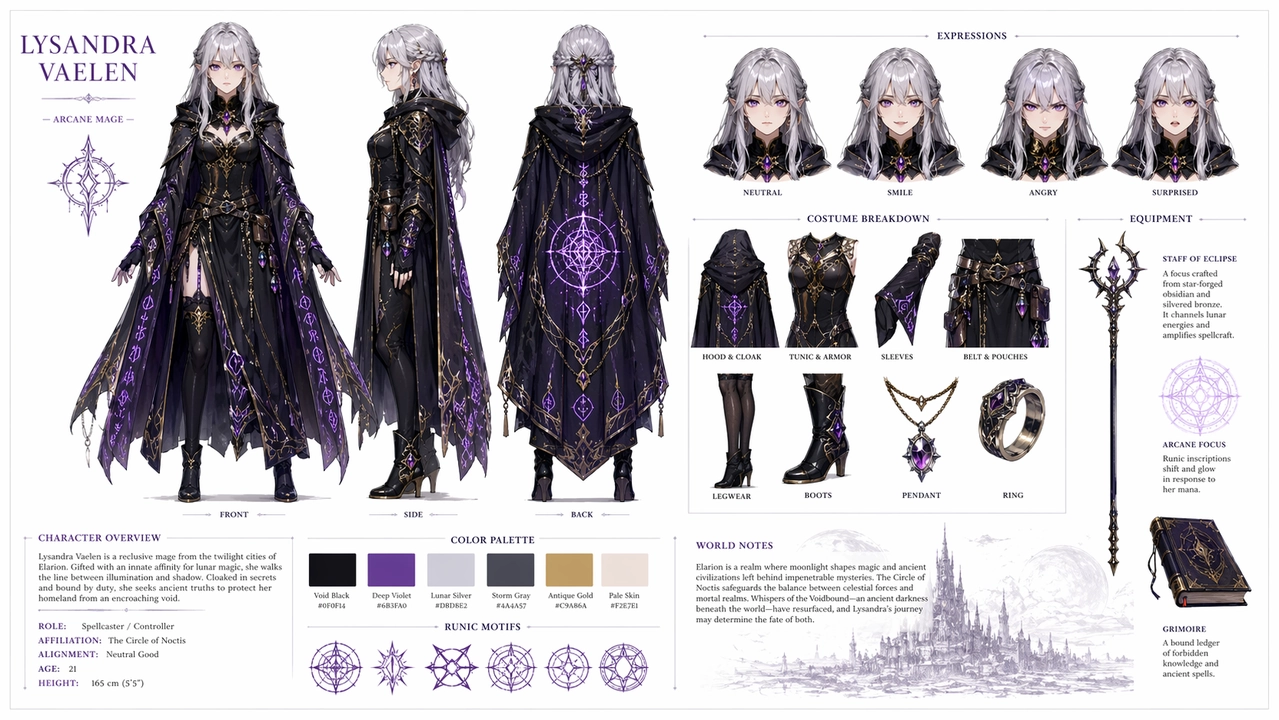
Qué buscar: el rostro, el cabello y el atuendo deben mantenerse consistentes en las tres vistas; las variaciones de expresión solo deben cambiar el rostro, no el peinado ni la ropa; la muestra de paleta debe coincidir realmente con los colores usados en el arte; y las etiquetas de texto deben estar bien escritas. Si una vista lateral o trasera se desvía, regenera con un lenguaje de “preservar” más fuerte que repita los anclajes de identidad.
Mockup de UI y Redes Sociales
Esto pone a prueba tres cosas a la vez: layout de UI con precisión de píxel, renderizado de texto en varios idiomas y fusión creativa de conceptos, el tipo de contenido que también suele funcionar bien en plataformas sociales.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
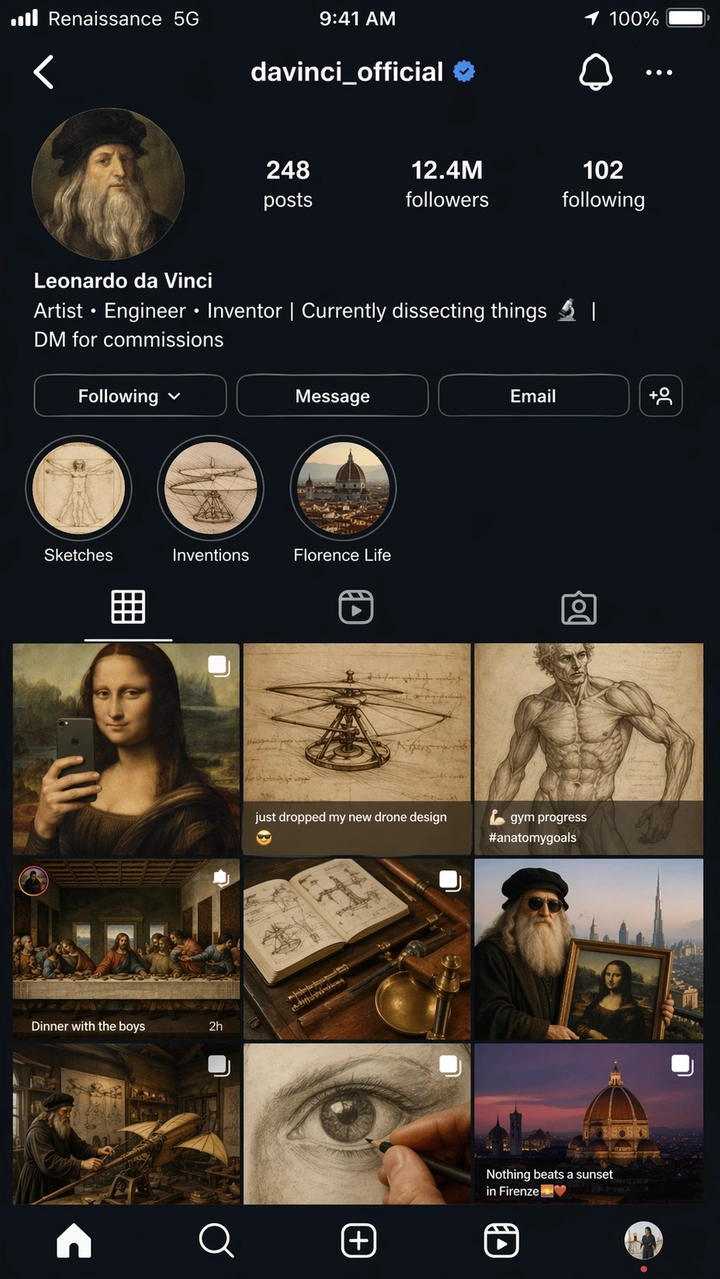
Qué buscar: los elementos de UI de Instagram (espaciado de cuadrícula, layout de perfil, círculos de historias, barra de pestañas) deben leerse como una captura de pantalla real de iOS en lugar de una aproximación estilizada. Todo el texto debe ser legible, y la etiqueta de operadora “Renaissance 5G” es una comprobación de precisión deliberada. Trata cualquier salida de mockup de UI como una referencia conceptual en lugar de una UI lista para producción; las etiquetas pequeñas y la alineación de íconos suelen necesitar un paso de limpieza.
Arte Creativo y Experimental
Prompts cortos con humor narrativo incorporado ponen a prueba si el modelo llena los vacíos creativos por su cuenta en lugar de depender de instrucciones exhaustivas.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
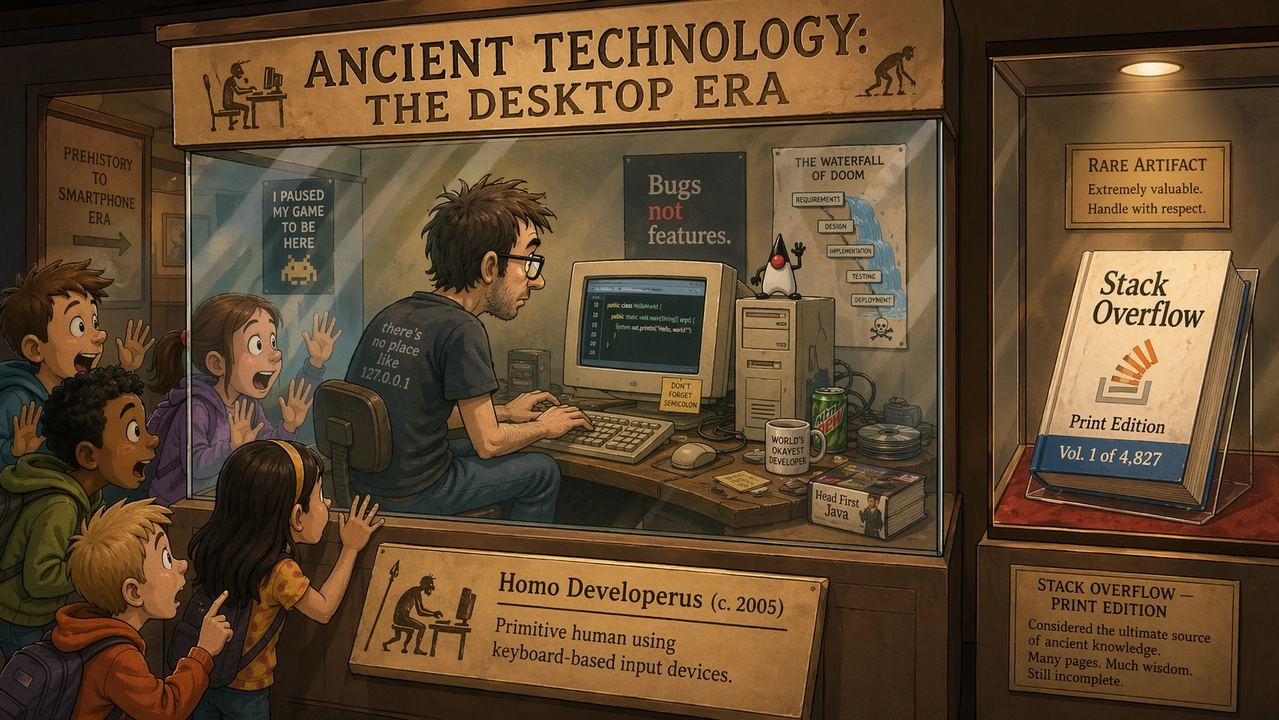
Qué buscar: el humor debe funcionar a través de los detalles visuales, no solo del texto del subtítulo. El cartel y el título del libro necesitan permanecer legibles y bien escritos, una prueba genuinamente difícil para texto multilínea en tamaños pequeños, y el estilo de caricatura debe sentirse cohesivo en toda la escena en lugar de fotorrealista en algunas partes.
Resultados de Pruebas por Caso de Uso
Los resultados más sólidos provinieron consistentemente de prompts con un estándar de producción evidente: algo evaluable por ortografía, layout, preservación de objetos u orden de paneles. Los prompts vagos, solo de ambiente, produjeron resultados más variables.
| Caso de uso | Qué funcionó bien | Qué todavía necesita revisión |
|---|---|---|
| Renderizado de texto | Titulares grandes, etiquetas cortas, títulos de póster y etiquetas simples de UI se mantuvieron precisos cuando el texto exacto estaba entre comillas. | El texto legal diminuto, los párrafos densos y las tipografías estilizadas todavía pueden desviarse; mantén el texto corto y revisa cada letra. |
| Imágenes de producto | Los layouts de anuncios limpios, el espacio negativo de campaña y las composiciones centradas en el producto se renderizaron bien. | Las etiquetas reales, los logotipos y las afirmaciones reguladas todavía necesitan revisión manual o composición a partir de activos aprobados. |
| Mockups de UI | Las pantallas móviles, los paneles y la jerarquía tipo app se vieron plausibles cuando el prompt nombraba elementos de interfaz reales. | Trata los resultados como mockups conceptuales; las etiquetas pequeñas y la alineación de íconos suelen necesitar limpieza. |
| Consistencia de personajes | Las hojas de personaje, las filas de expresiones y las muestras de paleta funcionaron bien como referencias creativas. | Los rostros y los detalles del vestuario pueden desviarse entre vistas; repite los anclajes de identidad y regenera si es necesario. |
| Edición y composición | El patrón “cambiar, preservar, ajustar” superó a las solicitudes de edición amplias. | Los límites de selección y la salida con fondo transparente todavía necesitan control de calidad. |
Errores Comunes al Escribir Prompts para GPT Image 2
- Pedir texto preciso sin proporcionar el texto exacto. Si el texto importa, escríbelo textualmente e indica dónde debe ir.
- Sobrecargar un solo prompt con todos los detalles posibles. Empieza con la escena principal y luego refina una variable a la vez.
- Olvidar indicar los invariantes durante las ediciones. Especifica qué debe permanecer sin cambios: identidad, fondo, pose, iluminación, forma del producto, texto de etiqueta, ángulo de cámara.
- Apoyarse en palabras de calidad decorativas para tareas funcionales. “Hermoso” no hace que una etiqueta sea legible; usa un lenguaje como “texto de etiqueta nítido” o “legible desde la distancia” en su lugar.
- Omitir la relación de aspecto. Una imagen cuadrada sólida puede seguir fallando como anuncio vertical o miniatura de video.
- Tratar los logotipos como texto ordinario. GPT Image 2 puede diseñar conceptos de logotipo, pero las marcas de marca exactas deben componerse a partir de activos aprobados en lugar de solicitarse directamente en el prompt.
Notas de Precios y API de GPT Image 2
La página de precios de la API de OpenAI enumera GPT Image 2 sobre una base de tokens en lugar de una tarifa plana por imagen:
| Elemento | Precio publicado |
|---|---|
| Entrada de imagen | $8.00 / 1M tokens |
| Entrada de imagen en caché | $2.00 / 1M tokens |
| Salida de imagen | $30.00 / 1M tokens |
| Entrada de texto | $5.00 / 1M tokens |
| Entrada de texto en caché | $1.25 / 1M tokens |
El costo real por imagen depende de la longitud del prompt, las imágenes de referencia, el tamaño de salida, el almacenamiento en caché y la configuración de calidad. Las cuotas del plan de ChatGPT son una vía separada de la facturación de la API; una suscripción Plus no se traduce directamente en crédito de API, así que presupuesta ambas por separado si estás usando las dos.
Para flujos de trabajo de alto volumen, el número que importa es el costo por activo aceptado después de reintentos, no el precio de lista de un solo intento. Una generación más barata no es en realidad más barata si necesita tres regeneraciones para corregir la ortografía o el layout.
| Flujo de trabajo | Consejo práctico de prompting |
|---|---|
| Pósters o diagramas cargados de texto | Usa menos palabras por imagen, cita el texto exacto, especifica la jerarquía explícitamente. |
| Fotos de producto | Fija la forma del producto, la etiqueta, el color, el material y el ángulo de cámara; repite la lista de preservación en cada pasada de edición. |
| Mockups de UI | Describe la pantalla como una interfaz ya publicada (navegación, tarjetas, botones, estados), no como arte conceptual. |
| Ediciones con múltiples referencias | Etiqueta cada imagen de entrada por rol: sujeto, estilo, fondo o referencia de material. |
| Generación por lotes | Rastrea el costo por imagen aceptada, no el costo por intento. |
Si quieres ver cómo se compara GPT Image 2 con una alternativa centrada en el fotorrealismo usando prompts idénticos, nuestra comparación de GPT Image 2 frente a Nano Banana 2 recorre seis rondas cara a cara con desgloses completos de precios de API y plataforma.
De la Imagen al Video: Completa Tu Flujo Creativo en PixVerse
Generar una imagen sólida es un paso. Convertirla en movimiento es donde la mayoría de los flujos de trabajo se rompen: terminas un retrato o un póster de producto en GPT Image 2, y luego tienes que abrir una herramienta separada, volver a subir el archivo y esperar que el modelo de video no distorsione tu imagen cuidadosamente compuesta. Esa fricción de traspaso es exactamente lo que PixVerse elimina.
GPT Image 2 Ya Está Disponible en PixVerse
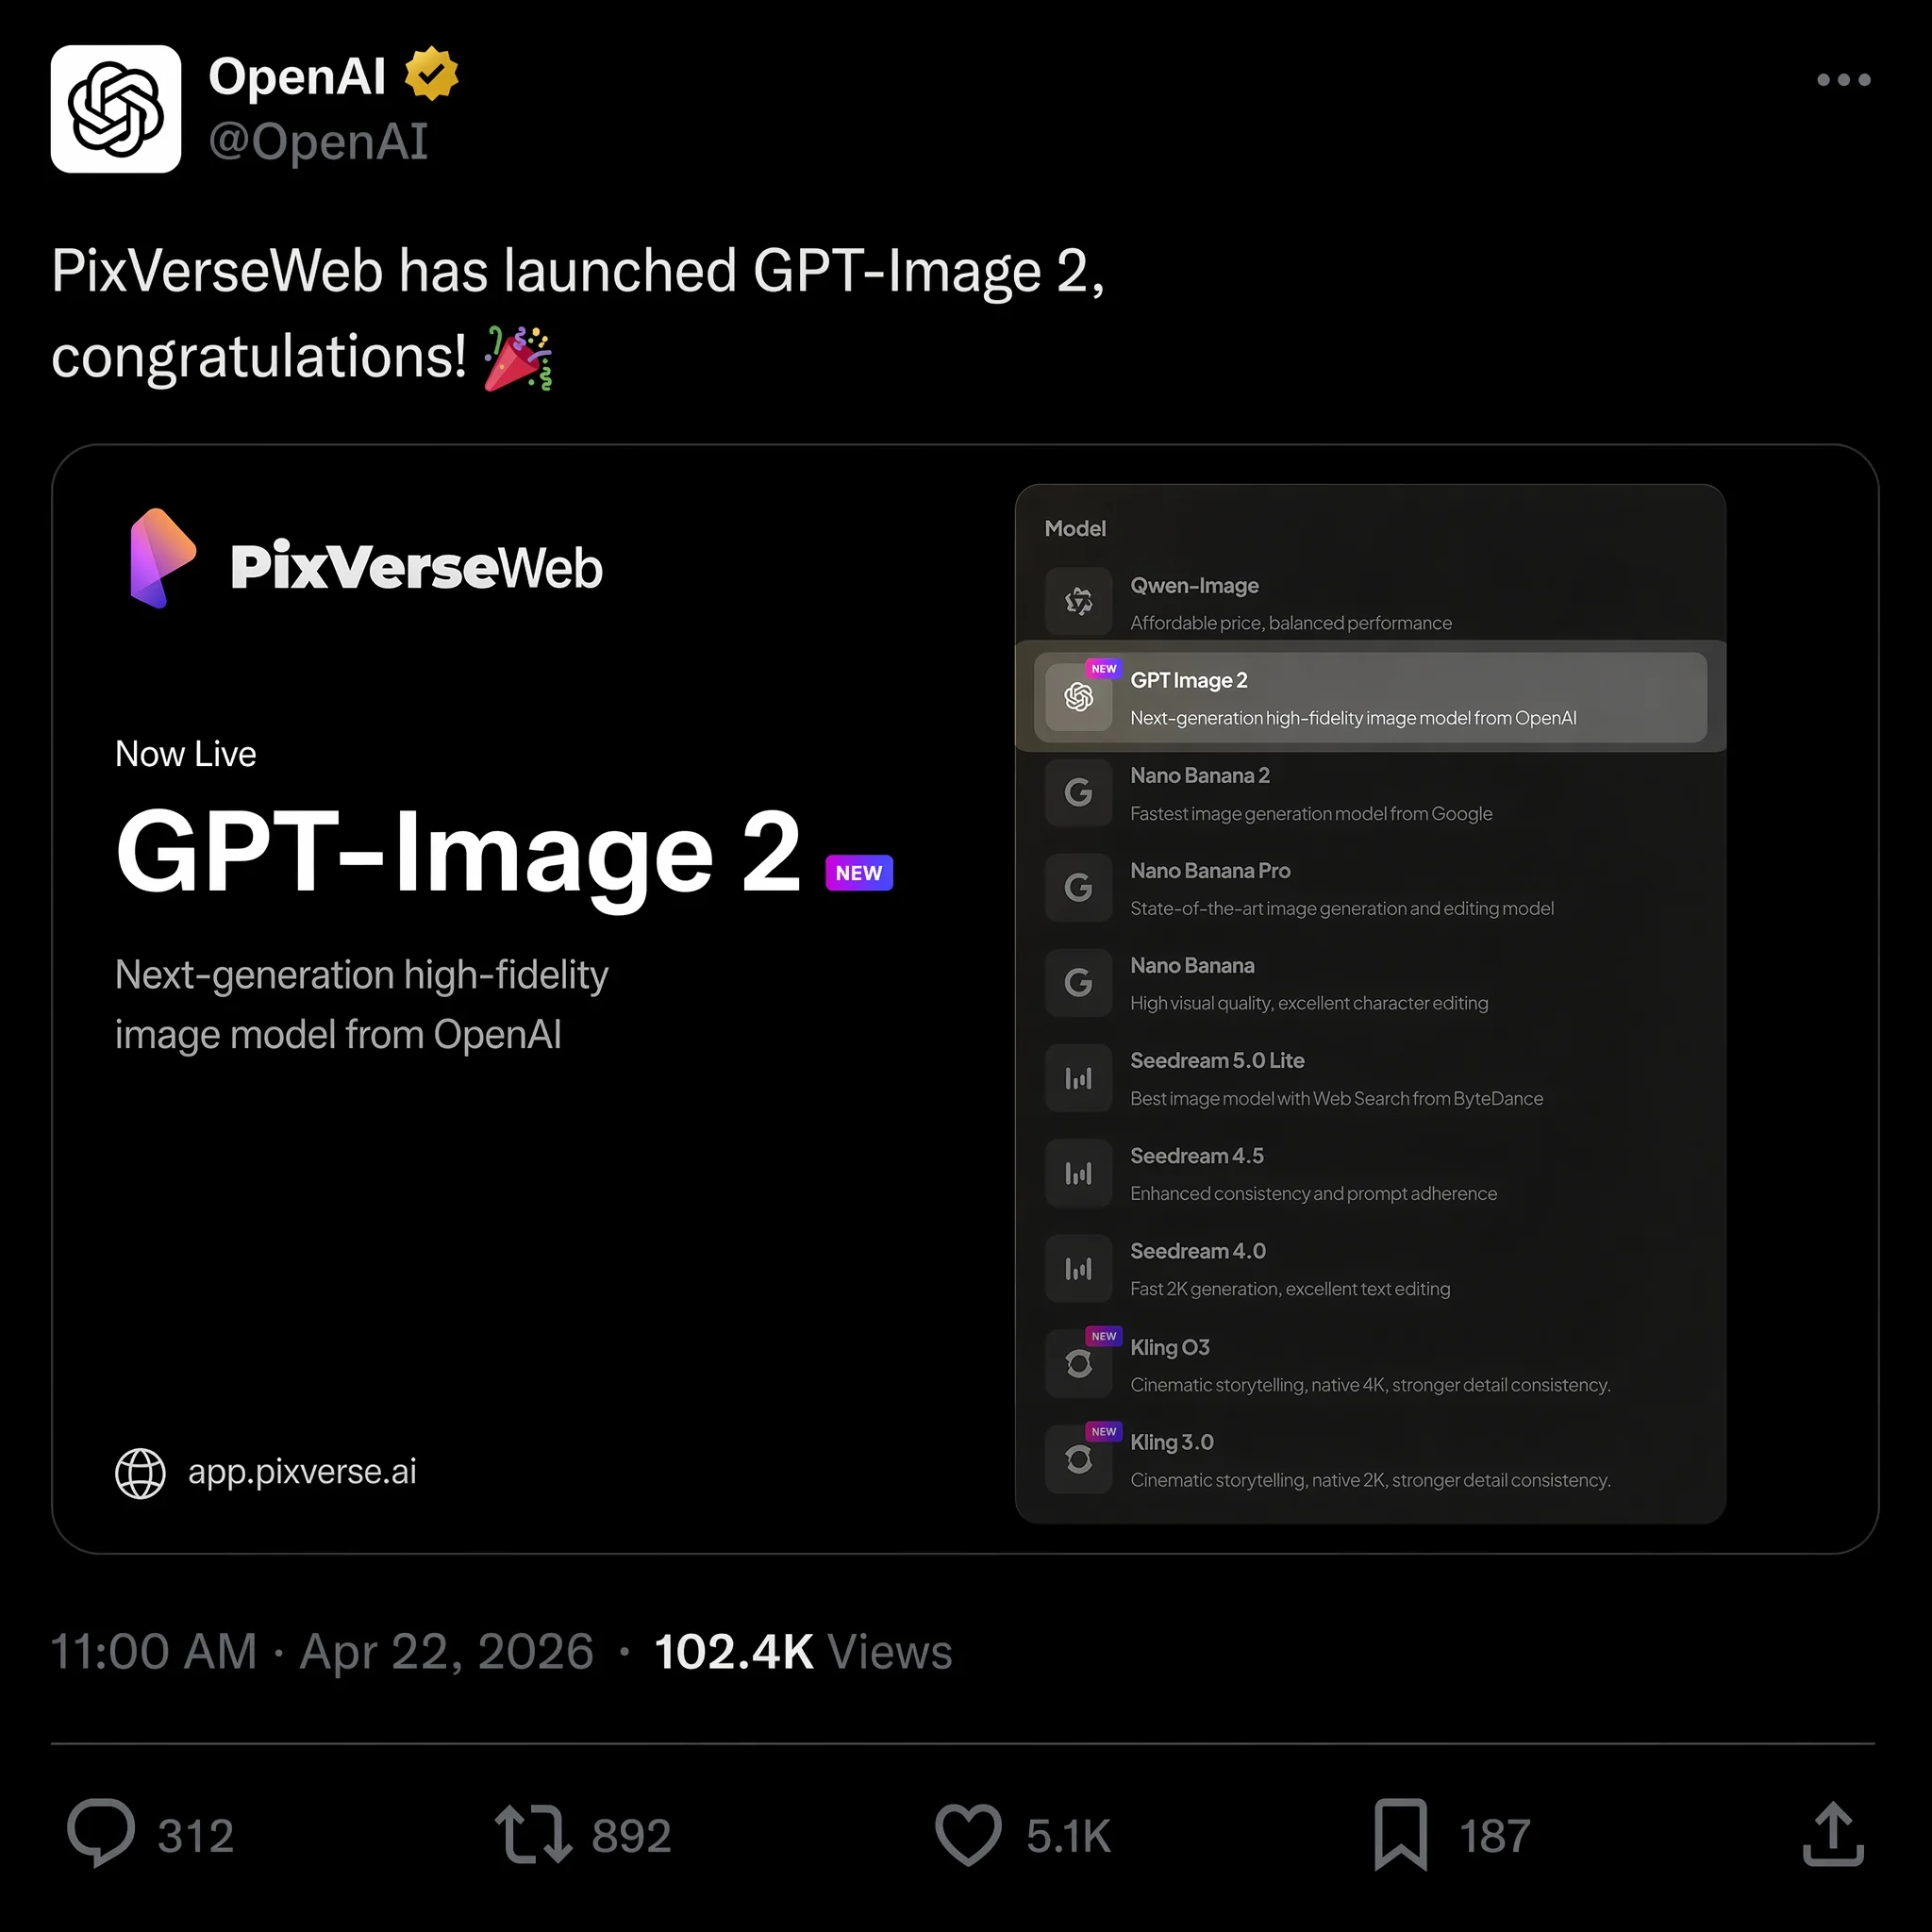
El 22 de abril de 2026, PixVerse añadió GPT Image 2 como opción de texto a imagen, uniéndose a Nano Banana 2, Seedream y HappyHorse 1.0 en el catálogo de modelos. Puedes generar una imagen con GPT Image 2 y convertirla en video en el mismo espacio de trabajo, sin descargas, resubidas ni cambios de pestaña de por medio.
Eso importa por una razón concreta: cuando la imagen alimenta directamente un flujo de imagen a video en la misma plataforma, el modelo de video trabaja directamente a partir del archivo fuente de resolución completa y sus metadatos. No hay pérdida de calidad por compresión ni conversión de formato en el camino, lo que se traduce en un movimiento más limpio y menos artefactos en el clip final.
Si una imagen fija está destinada a convertirse en un clip, indica desde el inicio la disposición al movimiento: pide profundidad de primer plano, plano medio y fondo, una silueta de sujeto limpia y un elemento físico que pueda moverse de forma plausible (polvo, vapor, tela, una fuente de luz cambiante). Revisa la imagen fija como un archivo de diseño terminado antes de animarla: comprueba primero la ortografía, la geometría del producto y la alineación de la UI, ya que un modelo de video no corregirá por sí solo un titular mal escrito o una etiqueta distorsionada. Luego escribe un prompt de movimiento separado y más corto que describa solo lo que debe moverse y lo que debe permanecer fijo, en lugar de repetir el brief completo de la imagen.
Por Qué los Creadores Están Migrando a una Plataforma Todo en Uno
Si usabas Sora de OpenAI para la generación de video antes de marzo de 2026, ya conoces el riesgo de construir un flujo de trabajo alrededor de una sola herramienta. OpenAI cerró la app y la API de Sora el 24 de marzo, citando costos insostenibles y un giro hacia la robótica, y miles de creadores perdieron su flujo de video de la noche a la mañana. Consulta nuestra guía de alternativas a Sora para un desglose completo de lo que ocurrió y qué herramientas llenaron el vacío.
PixVerse adopta un enfoque diferente al darte acceso a múltiples modelos a lo largo de todo el pipeline creativo en lugar de encerrarte en uno solo:
- Texto a imagen con GPT Image 2, Nano Banana 2, Seedream y más: elige el modelo que se ajuste al trabajo
- Imagen a video que convierte tus imágenes generadas en movimiento con consistencia de personajes y control de cámara
- Texto a video para clips generados directamente a partir de un prompt escrito usando PixVerse V6 o el cinematográfico modelo C1
- Generación de audio nativa que sincroniza efectos de sonido y diálogo con tu video automáticamente
El beneficio práctico: puedes pasar de un concepto escrito a un video terminado con audio sincronizado sin salir de un solo espacio de trabajo, lo que elimina horas de gestión de archivos de cada proyecto. Si prefieres programar la generación desde la línea de comandos, la guía de PixVerse CLI explica cómo automatizar tanto la generación de imágenes como de video.
PixVerse también ofrece entre 30 y 60 créditos gratuitos diarios para nuevos usuarios, así que puedes probar todo el pipeline (desde la generación de imágenes hasta la salida de video) antes de comprometerte con un plan de pago.
Preguntas Frecuentes
¿Es gratuito usar GPT Image 2?
Los usuarios gratuitos de ChatGPT pueden generar aproximadamente dos imágenes al día con GPT Image 2. Los suscriptores de ChatGPT Plus ($20/mes) obtienen generaciones ilimitadas con procesamiento más rápido. El acceso a la API se factura por token según entrada de imagen, salida de imagen y entrada de texto, por lo que el costo escala con la longitud del prompt y el tamaño de salida en lugar de una tarifa plana por imagen.
¿Qué resolución admite GPT Image 2?
GPT Image 2 genera imágenes a resolución nativa de 2K, con un upscale opcional a 4K a través de la API. Las relaciones de aspecto van de 3:1 a 1:3, por lo que los formatos cuadrado, vertical y ultra ancho están todos disponibles directamente.
¿Puede GPT Image 2 renderizar texto en imágenes con precisión?
Sí, esta es una de sus funciones más fuertes. En nuestras pruebas, la precisión del texto en inglés, chino, japonés, coreano y árabe superó el 95% en el primer intento de generación. Los titulares multilínea, los títulos de póster y las etiquetas de texto de UI se manejan todos de forma confiable, aunque el texto muy pequeño en resoluciones bajas todavía puede fallar ocasionalmente.
¿Cómo se compara GPT Image 2 con Midjourney y Nano Banana 2?
Midjourney V8 tiene controles de estilo artístico más sólidos y una comunidad más establecida para el refinamiento estético. Nano Banana 2 es la mejor opción para el fotorrealismo, la iluminación cinematográfica y la iteración rápida. GPT Image 2 tiene ventaja en el renderizado de texto, los layouts estructurados y la edición en lenguaje natural. Para el diseño de pósters y materiales de marketing con texto, GPT Image 2 gana actualmente; para la exploración puramente artística o las tomas fotorrealistas destacadas, vale la pena comparar directamente los otros dos: consulta nuestra prueba cara a cara contra Nano Banana 2.
¿Cuáles son las mejores alternativas a Sora para video tras el cierre?
Después de que OpenAI cerrara Sora en marzo de 2026, las principales alternativas incluyen PixVerse V6 para video multiplano con consistencia de personajes, Runway Gen-4 para control de cámara cinematográfico y Kling v3.0 para secuencias de acción. PixVerse es la única plataforma que combina texto a imagen, imagen a video y texto a video con audio nativo, todo accesible con créditos gratuitos diarios. Consulta nuestra guía completa de alternativas a Sora para una comparación detallada.
¿Puedo convertir las salidas de GPT Image 2 en video?
Sí. Con GPT Image 2 disponible en PixVerse, puedes generar la imagen dentro de la app y convertirla en video usando el pipeline de imagen a video en el mismo espacio de trabajo, sin necesidad de transferencias de archivos. También puedes subir un archivo de GPT Image 2 creado en otro lugar y ejecutarlo a través del mismo pipeline.