Ulasan GPT Image 2: Panduan Prompt dan Kes Penggunaan pada 2026
OpenAI mengeluarkan GPT Image 2 pada 21 April 2026 — pengganti GPT Image 1.5 dan model yang kini menguasakan penjanaan imej merentas ChatGPT. Kami mengujinya semasa minggu pelancaran dan kembali kepadanya pada akhir Jun dengan set prompt yang lebih luas, panduan prompt OpenAI sendiri, dan harga API yang diterbitkan untuk melihat bagaimana model bertahan setelah gembar-gembur awal reda.
Pengambilan Utama:
- GPT Image 2 menjana imej pada resolusi 2K asli dengan peningkatan skala 4K pilihan, dan ketepatan pemaparan teks melebihi 95% merentas skrip Latin, Cina, Jepun, Korea, dan Arab.
- Model paling baik dianggap sebagai pembantu reka bentuk dan bukannya penjana foto: ia cemerlang pada tugasan dengan standard kejayaan yang jelas — salinan tepat, susun atur dikunci, struktur panel yang boleh diulang — dan kurang boleh diramal pada prompt terbuka “jadikan cantik”.
- Pembiakan logo jenama, salinan undang-undang kecil, dan fon proprietari kekal titik lemah yang masih memerlukan semakan manual.
- API OpenAI mengebil GPT Image 2 mengikut token merentas input imej, input imej cache, output imej, input teks, dan input teks cache — model harga berbeza daripada peringkat per imej yang digunakan sesetengah pesaing.
- PixVerse merangkumi GPT Image 2 dalam barisan teks-ke-imej bersama Nano Banana 2 dan Seedream, jadi imej yang dijana boleh terus masuk ke saluran paip imej-ke-video tanpa meninggalkan ruang kerja.
Apakah GPT Image 2? Ciri Utama dan Had
GPT Image 2 ialah model imej generasi kedua OpenAI, menggantikan GPT Image 1.5 merentas ChatGPT dan API. Ia bersaing dengan Midjourney, DALL-E 3, dan Stable Diffusion, tetapi meletakkan identitinya pada dua perkara: teks tepat di dalam imej, dan lapisan penaakulan yang mentafsir niat prompt dan bukan sekadar memadankan kata kuncinya.
Ciri Teras Sekilas Pandang
| Ciri | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Resolusi asli | 2K (dengan peningkatan 4K) | 1K | 2K (dengan bendera —hd) |
| Ketepatan pemaparan teks | 95%+ berbilang bahasa | ~70% (Latin sahaja) | ~80% (Latin sahaja) |
| Integrasi penaakulan | Ya — mentafsir arahan berlapis | Tidak | Tidak |
| Julat nisbah aspek | 3:1 hingga 1:3 | 1:1, 16:9 | 1:1 hingga 3:2 |
| Konsistensi watak | Tahap piksel merentas imej berurutan | Terhad | Sederhana (bendera —cref) |
| Penyuntingan bahasa semula jadi | Ya — sunting kawasan dengan menerangkannya | Tidak | Tidak |
| Harga | Berasaskan token melalui API; peringkat pelan ChatGPT | Sama | Langganan $10–30/bln |
Pemaparan teks ialah ciri yang paling mendapat perhatian, dan atas alasan yang baik. Model imej lama menganggap teks sebagai tekstur — minta tajuk poster dan anda mendapat hingar berbentuk huruf. GPT Image 2 mengendalikan tajuk Inggeris berbilang baris, aksara Cina, dan susun atur bahasa campuran dengan konsistensi sebenar; dalam ujian kami, kira-kira 19 daripada 20 penjanaan kembali boleh dibaca sepenuhnya pada percubaan pertama.
Integrasi penaakulan bermaksud model melakukan lebih daripada memadankan corak perkataan anda. Minta ia “jana infografik yang menunjukkan aktiviti untuk cuaca esok di San Francisco,” dan ia akan mengambil ramalan, memilih aktiviti relevan, dan membina susun atur di sekitar data itu — satu langkah melangkaui cara Midjourney atau Stable Diffusion memproses prompt.
Penyuntingan bahasa semula jadi membolehkan anda menyemak semula imej dengan menerangkan perubahan dan bukannya menutupnya secara manual. “Alihkan cawan kopi ke sebelah kiri meja” atau “ubah langit kepada matahari terbenam” kedua-duanya digunakan sebagai suntingan tersasar tanpa menjana semula seluruh adegan.
Apa Kata Pengguna
Maklum balas sejak pelancaran sebahagian besarnya positif, dengan set aduan yang konsisten. Ujian potret yang beredar di X dan Reddit kelihatan hampir seperti fotografi studio, dan pereka poster yang menguji susun atur bentuk panjang — risalah, menu, papan tanda — melaporkan ketepatan teks akhirnya bertahan dalam penggunaan sebenar. Beberapa pereka menyatakan mereka boleh melangkau laluan Photoshop untuk aset pemasaran asas kerana deria komposisi model sendiri cukup kuat untuk membuat keputusan susun atur tanpa bantuan.
Pujian terkuat tertumpu pada pematuhan prompt: minta 15 elemen khusus dalam adegan dan GPT Image 2 cenderung memasukkan kesemuanya, manakala model lama mula menggugurkan butiran apabila prompt semakin panjang.
Pada sisi negatif, kesetiaan jenama masih tidak konsisten. Ujian langsung ZDNet yang dikongsi secara meluas menunjukkan model gagal menghasilkan semula logo ZDNET dengan tepat, dan pengguna lain melaporkan perkara sama dengan tanda jenama tertentu. Model memahami apa itu logo secara konsep, tetapi ia tidak menghasilkan semula bentuk vektor tepat atau muka taip proprietari dengan boleh dipercayai.
Had yang Diketahui
- Penghasilan semula logo jenama kurang boleh diharap — gabungkan logo yang tepat dalam Photoshop atau Figma selepas penjanaan, daripada memintanya secara langsung dalam prompt.
- Kelajuan penjanaan ketinggalan berbanding model yang lebih ringan seperti FLUX atau Nano Banana 2, dengan masa biasa 30–60 saat pada ChatGPT Plus berbanding kurang daripada 10 saat di tempat lain.
- Had kadar peringkat percuma ketat — kira-kira dua imej sehari untuk pengguna ChatGPT percuma. Pelanggan Plus mendapat penjanaan ChatGPT tanpa had, tetapi kos API meningkat mengikut volum.
- Kawalan gaya lebih kasar berbanding Midjourney. Anda tidak boleh menala stok filem, jenis lensa, atau grain dengan ketepatan yang sama, dan bias estetik model itu sendiri memerlukan kerja prompt yang sengaja untuk diatasi.
- Dasar kandungan lebih ketat berbanding alternatif sumber terbuka, jadi sesetengah prompt yang berfungsi dengan baik pada Stable Diffusion atau model tempatan akan ditolak di sini.
Tiada satu pun perkara ini mengetepikan penggunaan untuk produksi, tetapi ia wajar diketahui sebelum anda membina saluran paip di sekitar satu model secara eksklusif.
Cara Menulis Prompt GPT Image 2 yang Benar-benar Berfungsi
Anjakan paling jelas dalam pusingan ujian kedua kami: prompt GPT Image 2 yang terbaik bukan sekadar menggambarkan gambar — ia menggambarkan tugas yang perlu dilakukan oleh gambar itu. Prompt iklan sosial seharusnya dibaca secara berbeza daripada potongan produk, infografik, skrin UI, atau bingkai pertama yang dimaksudkan untuk video.
Corak yang boleh diharap untuk menstruktur brief:
Cipta [jenis imej] untuk [kes penggunaan]. Subjek utama: [subjek khusus dan butiran yang kelihatan]. Teks tepat, jika ada: “[salinan yang mesti muncul]”. Komposisi: [pembingkaian, susun atur, ruang negatif, penempatan subjek]. Gaya dan pencahayaan: [bahasa visual, medium, mood, arah cahaya]. Kekangan: [apa yang tidak boleh berubah, tiada perkataan tambahan, tiada tera air]. Format output: [nisbah aspek, latar belakang telus, bingkai sedia video].
Namakan tugas sebelum gaya
Mulakan dengan jenis output — poster, iklan produk, skrin apl, helaian watak, rajah, suntingan, atau bingkai pertama video — supaya model tahu standard yang digunakan untuk menilainya.
Lemah: Pembesar suara futuristik yang hebat, sinematik, perincian tinggi.
Lebih baik: Cipta iklan produk premium untuk pembesar suara wayarles hitam matte. Imej itu harus berfungsi sebagai sepanduk kempen 16:9, dengan produk di sebelah kanan, tajuk pendek di sebelah kiri, ruang negatif yang bersih, dan tepi produk yang tajam.
Versi kedua memberitahu model bahawa ia dinilai berdasarkan susun atur dan kebolehgunaan, bukan sekadar estetika.
Anggap teks sebagai aset yang dikunci
Letakkan sebarang salinan yang diperlukan dalam tanda petikan dan nyatakan dengan tepat cara ia harus dipaparkan — jangan minta “slogan” melainkan anda mahu model mencipta perkataan untuk anda.
Tajuk: “SOUND YOU CAN FEEL”. Paparkan tajuk itu secara verbatim. Tiada perkataan tambahan, tiada teks pendua, tiada logo palsu. Jenis sans-serif putih tebal, di sebelah kiri komposisi, boleh dibaca dari jauh.
Untuk salinan yang lebih panjang, pecahkan setiap baris secara eksplisit dalam prompt. Jika sesuatu perkataan kembali dieja salah, jana semula dengan salinan yang lebih pendek, jenis yang lebih besar, dan arahan “teks tepat sahaja” yang lebih ketat.
Beri model kamera dan susun atur
Nyatakan jarak kamera, sudut, penempatan subjek, ruang negatif, dan nisbah aspek secara langsung — GPT Image 2 mengikuti petunjuk komposisi dengan baik, tetapi hanya apabila ia dinyatakan dengan jelas.
- Close-up untuk tekstur produk, tangan, wajah, bahan, label.
- Syot lebar untuk persekitaran, adegan cerita, poster bandar, bingkai sedia video.
- Pandangan dari atas untuk makanan, adegan meja, flat-lay, kit pembungkusan.
- Sepertiga kiri / sepertiga kanan untuk susun atur iklan yang mengimbangi teks dan produk.
- Grid bersih untuk mockup UI, helaian watak, rajah, infografik.
Tulis suntingan dalam tiga ayat
Prompt suntingan yang paling kuat memisahkan perubahan daripada apa yang mesti kekal tidak disentuh dan daripada realisme fizikal yang mengikat semuanya:
Gantikan kereta yang diletakkan dengan basikal vintaj. Kekalkan rumah, pagar, laluan masuk, landskap, arah pencahayaan, sudut kamera, dan waktu hari dengan tepat. Padankan skala basikal, bayang sentuhan, dan perspektif dengan adegan sedia ada.
Struktur “ubah, kekalkan, padankan” itu secara konsisten mengatasi permintaan samar “jadikan ini kelihatan lebih baik”.
Tambah petunjuk gerakan jika gambar pegun akan menjadi video
Jika sesuatu imej mungkin kemudian dimasukkan ke saluran paip imej-ke-video PixVerse, minta kedalaman dan kesediaan gerakan dari awal: latar depan, latar tengah, latar belakang, siluet subjek yang bersih, dan satu petunjuk yang boleh bergerak — habuk, fabrik, rambut, hujan, pantulan, atau laluan tolakan kamera.
Daripada: Seorang angkasawan di padang pasir.
Gunakan: Bingkai pertama sinematik untuk klip imej-ke-video: seorang angkasawan bersendirian berdiri di tepi kawah padang pasir yang bercahaya pada waktu subuh, jubah dan habuk sedia bergerak ditiup angin, siluet latar depan yang kuat, lapisan kedalaman yang jelas, dan cahaya ufuk yang hangat.
Cara Kami Menguji GPT Image 2
Sepanjang kedua-dua pusingan ujian, kami menjalankan model melalui potret, poster padat teks, komposisi gaya produk, helaian watak, mockup UI, dan adegan naratif eksperimen. Matlamatnya bukan skor penanda aras — ia sama ada pereka, pemasar, atau pencipta boleh menghantar output dengan suntingan ringan dan bukannya membina semula aset dari awal.
| Kawasan ujian | Apa yang kami semak |
|---|---|
| Potret dan gambar pegun sinematik | Kawalan pencahayaan, tekstur kulit, pantulan, mood, ketekalan adegan |
| Susun atur poster dan tipografi | Ejaan tajuk, teks berbilang baris, hierarki, ruang negatif, kemasan seakan jenama |
| Helaian watak dan konsep | Ketekalan pelbagai pandangan, perincian kostum, penjajaran palet, ketepatan label |
| Mockup UI dan sosial | Realisme susun atur, teks kecil, jarak ikon, grid suapan, kebolehpercayaan tangkapan skrin |
| Prompt eksperimen | Humor, penaakulan naratif, penempatan objek, ketepatan kapsyen kecil |
Corak itu kekal merentas kedua-dua pusingan: GPT Image 2 memberi ganjaran kepada brief yang tepat lebih daripada rantaian kata kunci. Apabila prompt menamakan tugas dan mentakrifkan kejayaan — teks tepat, susun atur yang dikunci, struktur panel yang boleh diulang — model cenderung mengekalkan struktur. Apabila prompt hanya meminta mood yang samar, hasilnya masih boleh kelihatan kemas, tetapi lebih sukar digunakan semula tanpa suntingan.
Kes Penggunaan GPT Image 2 dengan Contoh Prompt
Kami menguji tekanan lima keupayaan berbeza merentas senario ini: kawalan pencahayaan, tipografi teks tepat, komposisi berbilang elemen, ketekalan watak, dan susun atur UI. Setiap prompt di bawah sedia untuk disalin dan disesuaikan.
Fotografi Potret Sinematik
Ini menyemak kefahaman model tentang pencahayaan, atmosfera, dan komposisi yang terkawal — asas yang membezakan imej sedia portfolio daripada render AI generik.
Prompt:
Jana potret sinematik seorang figura bersendirian yang berdiri dalam persekitaran kecerunan jingga ke merah yang kuat. Pencahayaan siluet yang kuat dari belakang, kontras bayang yang dalam, lantai berkilat reflektif yang memantulkan figura. Komposisi simetri, reka bentuk set yang minimum, tiada kekusutan latar belakang. Moodnya kontemplatif dan berkuasa, seperti gambar pegun daripada filem fiksyen sains. Nisbah aspek 16:9.
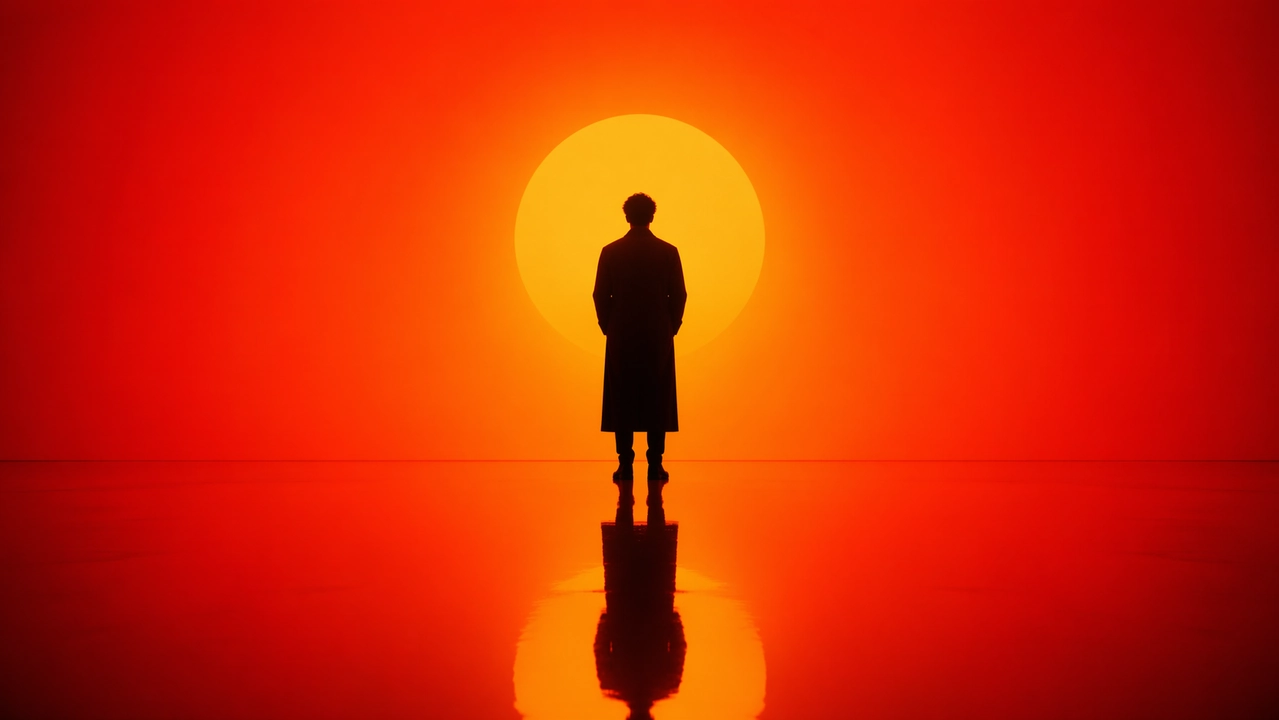
Apa yang perlu diperhatikan: tepi siluet yang bersih tanpa artifak halo, pantulan lantai yang tepat dengan perspektif yang betul, kecerunan yang licin (bukan berjalur), dan pose yang membawa berat nyata dan bukannya kelihatan kaku atau terapung.
Reka Bentuk Poster Bandar dan Ilustrasi
Ujian tekanan yang paling sukar untuk tipografi yang boleh dibaca dipadankan dengan komposisi padat berbilang elemen — lebih daripada sepuluh elemen visual yang berbeza disusun sepanjang lengkung-S, dengan teks bahasa Inggeris yang mesti kekal utuh selepas render.
Prompt:
Poster bandar New York Spring 2026 yang menarik dengan reka bentuk kontemporari yang berani dan mood perayaan yang elegan. Latar belakang bertekstur putih pudar yang bersih dengan ruang negatif yang luas. Seorang pendayung kayak miniatur mendayung merentasi pita air reflektif yang sempit di sudut kanan bawah. Olakan air menyapu ke atas dalam lengkung kaligrafi yang dinamik, beransur-ansur berubah menjadi Sungai Hudson dan kemudian menjadi panorama Manhattan yang dilukis tangan dan seakan mimpi. Di dalam komposisi berbentuk sungai yang mengalir: Empire State Building, Brooklyn Bridge, kanopi Central Park, One World Trade Center, bumbung brownstone, teksi kuning, feri pelabuhan, dan Patung Liberty di kejauhan yang lembut. Kabus pagi yang lembut, cahaya musim bunga keemasan, aksen halus dalam navy dan emas. Tipografi elegan di kiri bawah berbunyi “SPRING 2026” dengan slogan menegak “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Teks mesti tajam dan digubah dengan indah. Tiada perkataan tambahan. Reka bentuk grafik premium, nisbah aspek 9:16.
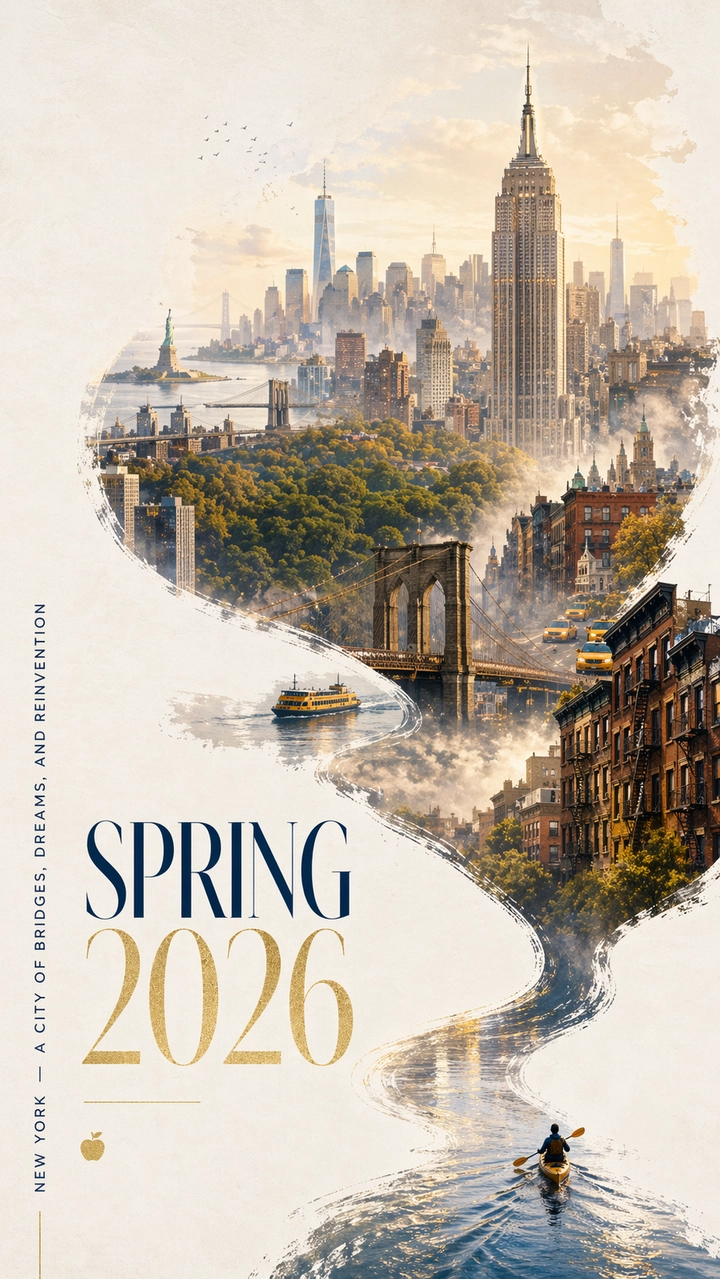
Apa yang perlu diperhatikan: setiap huruf dalam tajuk dan slogan harus boleh dibaca dan dieja dengan betul, lengkung-S harus mengalir secara semula jadi daripada pendayung kayak ke garis langit, bangunan mercu tanda harus dikenali dan bukannya menara generik, dan ruang negatif harus terasa disengajakan dan bukannya kosong.
Reka Bentuk Watak dan Helaian Rujukan
Pembangun permainan dan artis konsep memerlukan ketekalan pelbagai pandangan daripada satu penjanaan. Ini menyemak sama ada model dapat mengekalkan reka bentuk watak dengan stabil merentas pandangan depan, sisi, dan belakang.
Prompt:
Cipta helaian rujukan watak profesional untuk watak RPG fantasi asli: seorang ahli sihir wanita muda dengan rambut perak dan mata ungu, memakai jubah gelap berhias dengan corak rune yang bercahaya. Sertakan pada latar belakang putih yang bersih: pusingan tiga pandangan yang menunjukkan depan, sisi, dan belakang; variasi ekspresi wajah yang menunjukkan neutral, senyum, marah, dan terkejut; pecahan terperinci kepingan kostum dan peralatan; satu baris swatch palet warna; dan nota pembinaan dunia yang ringkas dalam tipografi yang bersih. Susun atur grid yang teratur, gaya seni konsep, resolusi tinggi. Nisbah aspek 16:9.
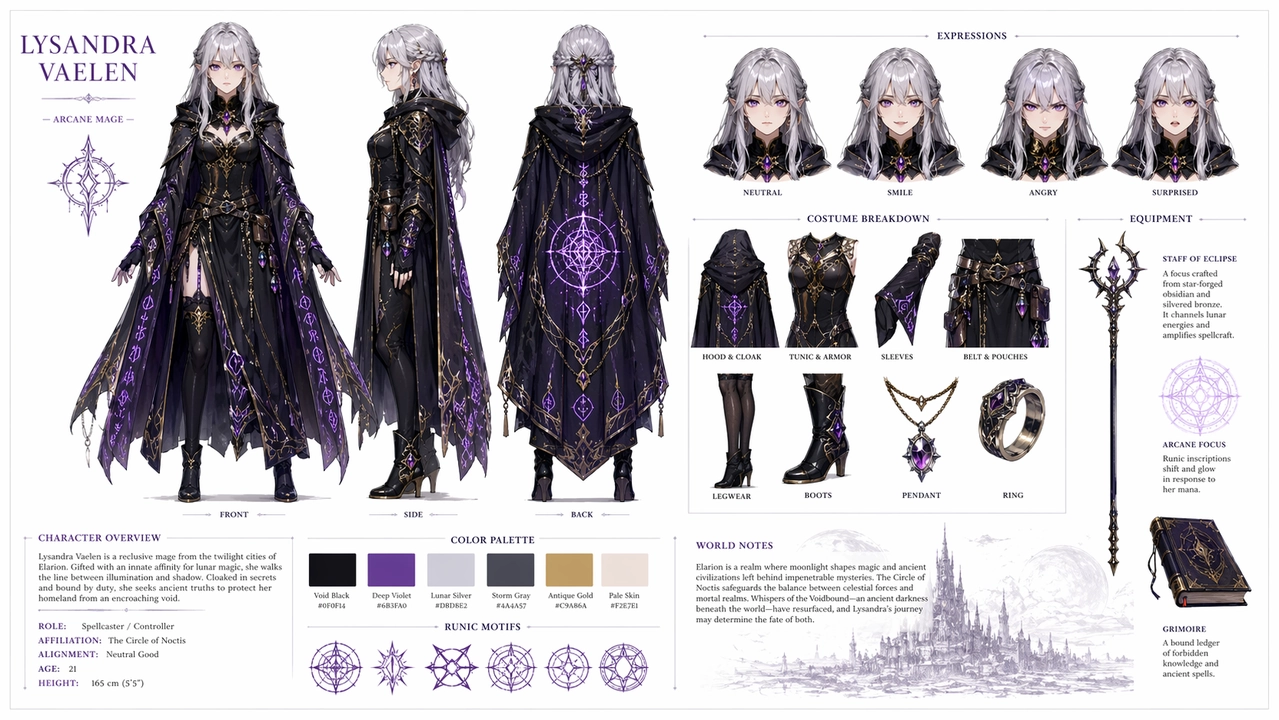
Apa yang perlu diperhatikan: wajah, rambut, dan pakaian harus kekal konsisten merentas ketiga-tiga pandangan; variasi ekspresi hanya boleh mengubah wajah, bukan gaya rambut atau pakaian; swatch palet harus benar-benar sepadan dengan warna yang digunakan dalam karya seni; dan label teks harus dieja dengan betul. Jika pandangan sisi atau belakang menyimpang, jana semula dengan bahasa “kekalkan” yang lebih kuat dan ulangi sauh identiti.
Mockup UI dan Media Sosial
Ini menolak tiga perkara serentak: susun atur UI yang tepat pada tahap piksel, pemaparan teks berbilang bahasa, dan gabungan konsep kreatif — jenis kandungan yang juga cenderung berprestasi baik di platform sosial.
Prompt:
Tangkapan skrin iPhone yang hiperrealistik bagi halaman profil Instagram rekaan untuk Leonardo da Vinci, nama pengguna @davinci_official, seolah-olah beliau seorang influencer moden pada 2026. Foto profil ialah potret diri Renaissance dalam potongan bulat. Bio berbunyi: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Grid menunjukkan 9 siaran: Mona Lisa yang dibingkai semula sebagai swafoto cermin, lakaran helikopter dengan kapsyen “just dropped my new drone design”, kajian anatomi yang disiarkan sebagai foto kemajuan gim, The Last Supper yang dipentaskan sebagai syot kumpulan majlis makan malam, dan gabungan anakronistik kreatif yang lain. Bilangan pengikut: 12.4M. Sorotan cerita berlabel Sketches, Inventions, dan Florence Life. Bar status iOS yang lengkap dengan teks pembawa yang berbunyi “Renaissance 5G”, ikon bateri, dan masa semasa. UI mod gelap sepenuhnya. Kualiti tangkapan skrin fotorealistik, nisbah aspek 9:16.
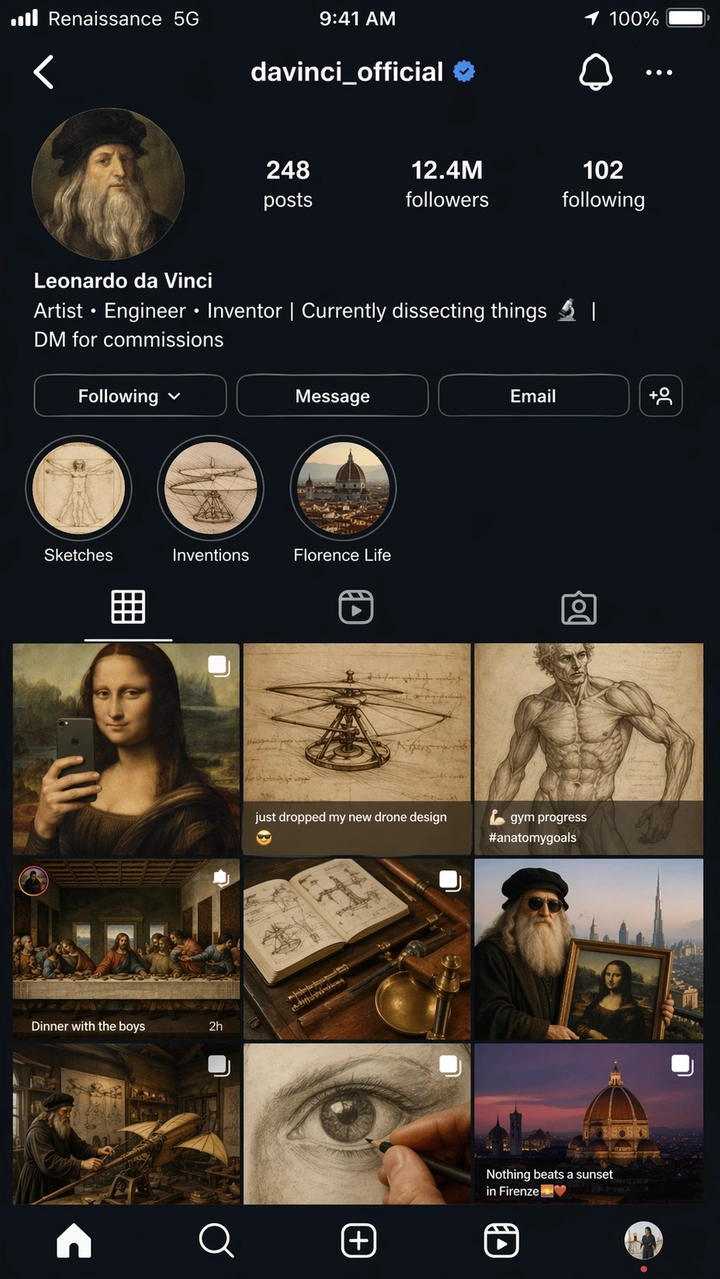
Apa yang perlu diperhatikan: elemen UI Instagram — jarak grid, susun atur profil, bulatan cerita, bar tab — harus dibaca sebagai tangkapan skrin iOS yang sebenar dan bukannya anggaran yang digayakan. Semua teks harus boleh dibaca, dan label pembawa “Renaissance 5G” ialah semakan ketepatan yang disengajakan. Anggap sebarang output mockup UI sebagai rujukan konsep dan bukannya UI yang sedia untuk produksi; label kecil dan penjajaran ikon biasanya memerlukan pusingan pembersihan.
Seni Kreatif dan Eksperimen
Prompt pendek dengan humor naratif terbina dalam menguji sama ada model mengisi jurang kreatif sendiri dan bukannya bergantung pada arahan yang menyeluruh.
Prompt:
Di dalam pameran muzium bertajuk “Ancient Technology: The Desktop Era”, seorang pengatur cara dalam bekas pameran kaca sedang mendemonstrasikan pengekodan secara langsung pada monitor CRT sementara kanak-kanak sekolah yang kagum menekan wajah mereka pada kaca. Plak pameran berbunyi: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Bekas pameran kedua berdekatan menunjukkan buku fizikal berlabel “Stack Overflow — Print Edition, Vol. 1 of 4,827”. Gaya ilustrasi kartun 2D, pencahayaan muzium yang hangat, nada humor dan nostalgia. Nisbah aspek 16:9.
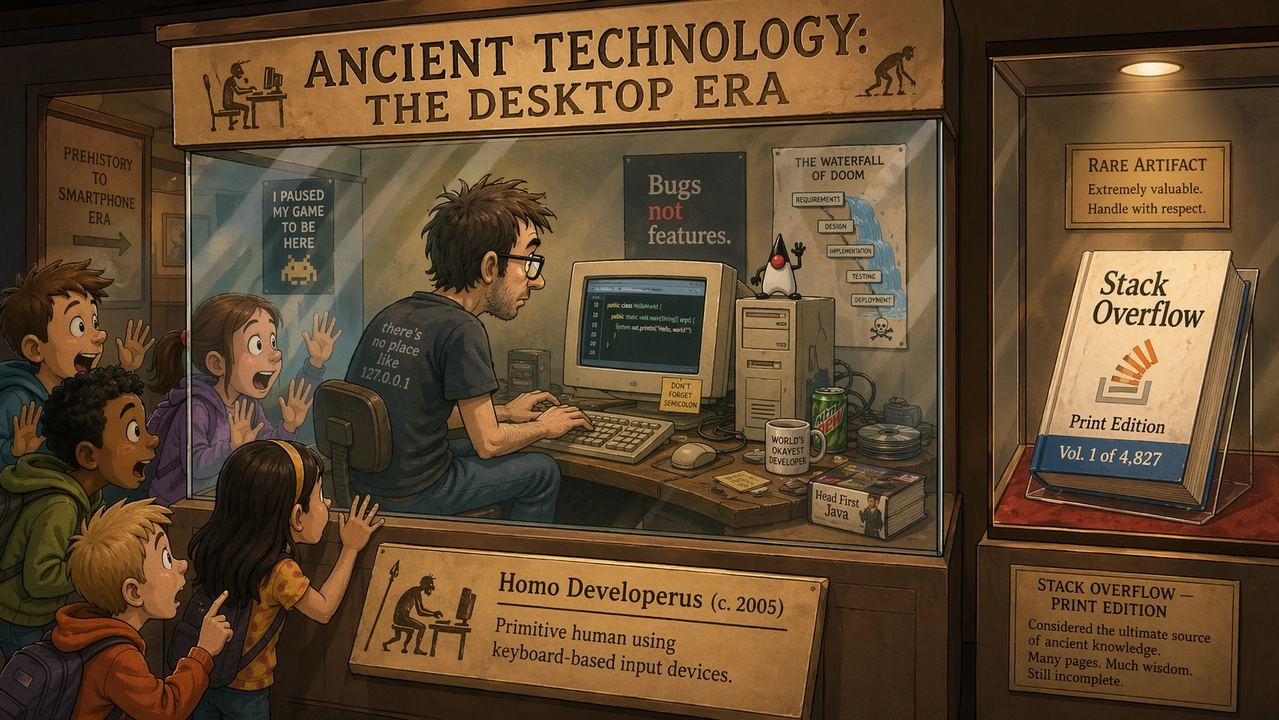
Apa yang perlu diperhatikan: humor itu harus sampai melalui butiran visual, bukan sekadar teks kapsyen. Plak dan tajuk buku perlu kekal boleh dibaca dan dieja dengan betul — ujian yang benar-benar sukar untuk teks berbilang baris pada saiz kecil — dan gaya kartun harus terasa padu merentas seluruh adegan dan bukannya fotorealistik secara bertompok-tompok.
Keputusan Ujian mengikut Kes Penggunaan
Keputusan paling kuat secara konsisten datang daripada prompt dengan standard produksi yang jelas — sesuatu yang boleh dinilai melalui ejaan, susun atur, pemeliharaan objek, atau susunan panel. Prompt yang hanya berupa mood samar menghasilkan keputusan yang lebih berubah-ubah.
| Kes penggunaan | Apa yang berfungsi dengan baik | Apa yang masih perlu disemak |
|---|---|---|
| Pemaparan teks | Tajuk besar, label pendek, tajuk poster, dan label UI ringkas kekal tepat apabila salinan tepat dipetik. | Salinan undang-undang yang sangat kecil, perenggan padat, dan fon bergaya masih boleh menyimpang — pastikan salinan pendek dan semak setiap huruf. |
| Imej produk | Susun atur iklan yang bersih, ruang negatif kempen, dan komposisi yang mengutamakan produk dipaparkan dengan baik. | Label sebenar, logo, dan dakwaan terkawal masih memerlukan semakan manual atau penggabungan daripada aset yang diluluskan. |
| Mockup UI | Skrin mudah alih, papan pemuka, dan hierarki seakan apl kelihatan munasabah apabila prompt menamakan elemen antara muka sebenar. | Anggap output sebagai mockup konsep — label kecil dan penjajaran ikon biasanya memerlukan pembersihan. |
| Ketekalan watak | Helaian watak, baris ekspresi, dan swatch palet berfungsi dengan baik sebagai rujukan kreatif. | Wajah dan perincian kostum boleh menyimpang merentas pandangan; ulangi sauh identiti dan jana semula jika perlu. |
| Suntingan dan penggabungan | Corak “ubah, kekalkan, padankan” mengatasi permintaan suntingan yang luas. | Sempadan pemilihan dan output latar belakang telus masih memerlukan QA. |
Kesilapan Prompt GPT Image 2 yang Biasa
- Meminta teks yang tepat tanpa memberikan salinan tepat. Jika teks penting, tulis ia sepenuhnya secara verbatim dan nyatakan tempat ia berada.
- Membebankan satu prompt dengan setiap butiran yang mungkin. Mulakan dengan adegan teras, kemudian halusi satu pemboleh ubah pada satu masa.
- Lupa menyatakan invarian semasa suntingan. Nyatakan dengan jelas apa yang mesti kekal tidak berubah: identiti, latar belakang, pose, pencahayaan, bentuk produk, teks label, sudut kamera.
- Bergantung pada perkataan kualiti yang bersifat hiasan untuk tugas berfungsi. “Cantik” tidak menjadikan label boleh dibaca — gunakan bahasa seperti “teks label yang tajam” atau “boleh dibaca dari jauh”.
- Melangkau nisbah aspek. Imej segi empat sama yang kuat masih boleh gagal sebagai iklan menegak atau lakaran kecil video.
- Menganggap logo seperti teks biasa. GPT Image 2 boleh mereka konsep logo, tetapi tanda jenama yang tepat harus digabungkan daripada aset yang diluluskan dan bukannya diminta secara langsung.
Nota API dan Harga GPT Image 2
Halaman harga API OpenAI menyenaraikan GPT Image 2 berasaskan token dan bukannya kadar rata setiap imej:
| Item | Harga tersenarai |
|---|---|
| Input imej | $8.00 / 1M token |
| Input imej cache | $2.00 / 1M token |
| Output imej | $30.00 / 1M token |
| Input teks | $5.00 / 1M token |
| Input teks cache | $1.25 / 1M token |
Kos sebenar setiap imej bergantung pada panjang prompt, imej rujukan, saiz output, cache, dan tetapan kualiti. Kuota pelan ChatGPT ialah landasan yang berasingan daripada pengebilan API — langganan Plus tidak bertukar secara langsung menjadi kredit API, jadi bajetkan kedua-duanya secara berasingan jika anda menggunakan kedua-duanya.
Untuk aliran kerja volum tinggi, nombor yang penting ialah kos setiap aset yang diterima selepas percubaan semula, bukan harga senarai satu percubaan. Penjanaan yang lebih murah sebenarnya tidak lebih murah jika ia memerlukan tiga penjanaan semula untuk mendapatkan ejaan atau susun atur yang betul.
| Aliran kerja | Nasihat prompt yang praktikal |
|---|---|
| Poster atau rajah padat teks | Gunakan lebih sedikit perkataan setiap imej, petik salinan tepat, nyatakan hierarki secara eksplisit. |
| Foto produk | Kunci bentuk produk, label, warna, bahan, dan sudut kamera; ulangi senarai kekalkan pada setiap pusingan suntingan. |
| Mockup UI | Huraikan skrin sebagai antara muka yang sudah dilancarkan — navigasi, kad, butang, keadaan — bukan sebagai seni konsep. |
| Suntingan berbilang rujukan | Labelkan setiap imej input mengikut peranan: subjek, gaya, latar belakang, pakaian, atau rujukan bahan. |
| Penjanaan berkelompok | Jejak kos setiap imej yang diterima, bukan kos setiap percubaan. |
Jika anda ingin melihat bagaimana GPT Image 2 dibandingkan dengan alternatif yang mengutamakan fotorealisme pada prompt yang sama, perbandingan GPT Image 2 lwn. Nano Banana 2 kami menjalankan enam pusingan berdepan dengan pecahan penuh harga API dan platform.
Dari Imej ke Video: Lengkapkan Aliran Kerja Kreatif Anda di PixVerse
Menjana imej yang kuat ialah satu langkah. Menukarnya menjadi gerakan ialah tempat kebanyakan aliran kerja tersekat — anda menyelesaikan potret atau poster produk dalam GPT Image 2, kemudian terpaksa membuka alat yang berasingan, memuat naik semula fail, dan berharap model video tidak merosakkan imej yang digubah dengan teliti. Geseran penyerahan itulah yang dihapuskan oleh PixVerse.
GPT Image 2 Kini Tersedia di PixVerse
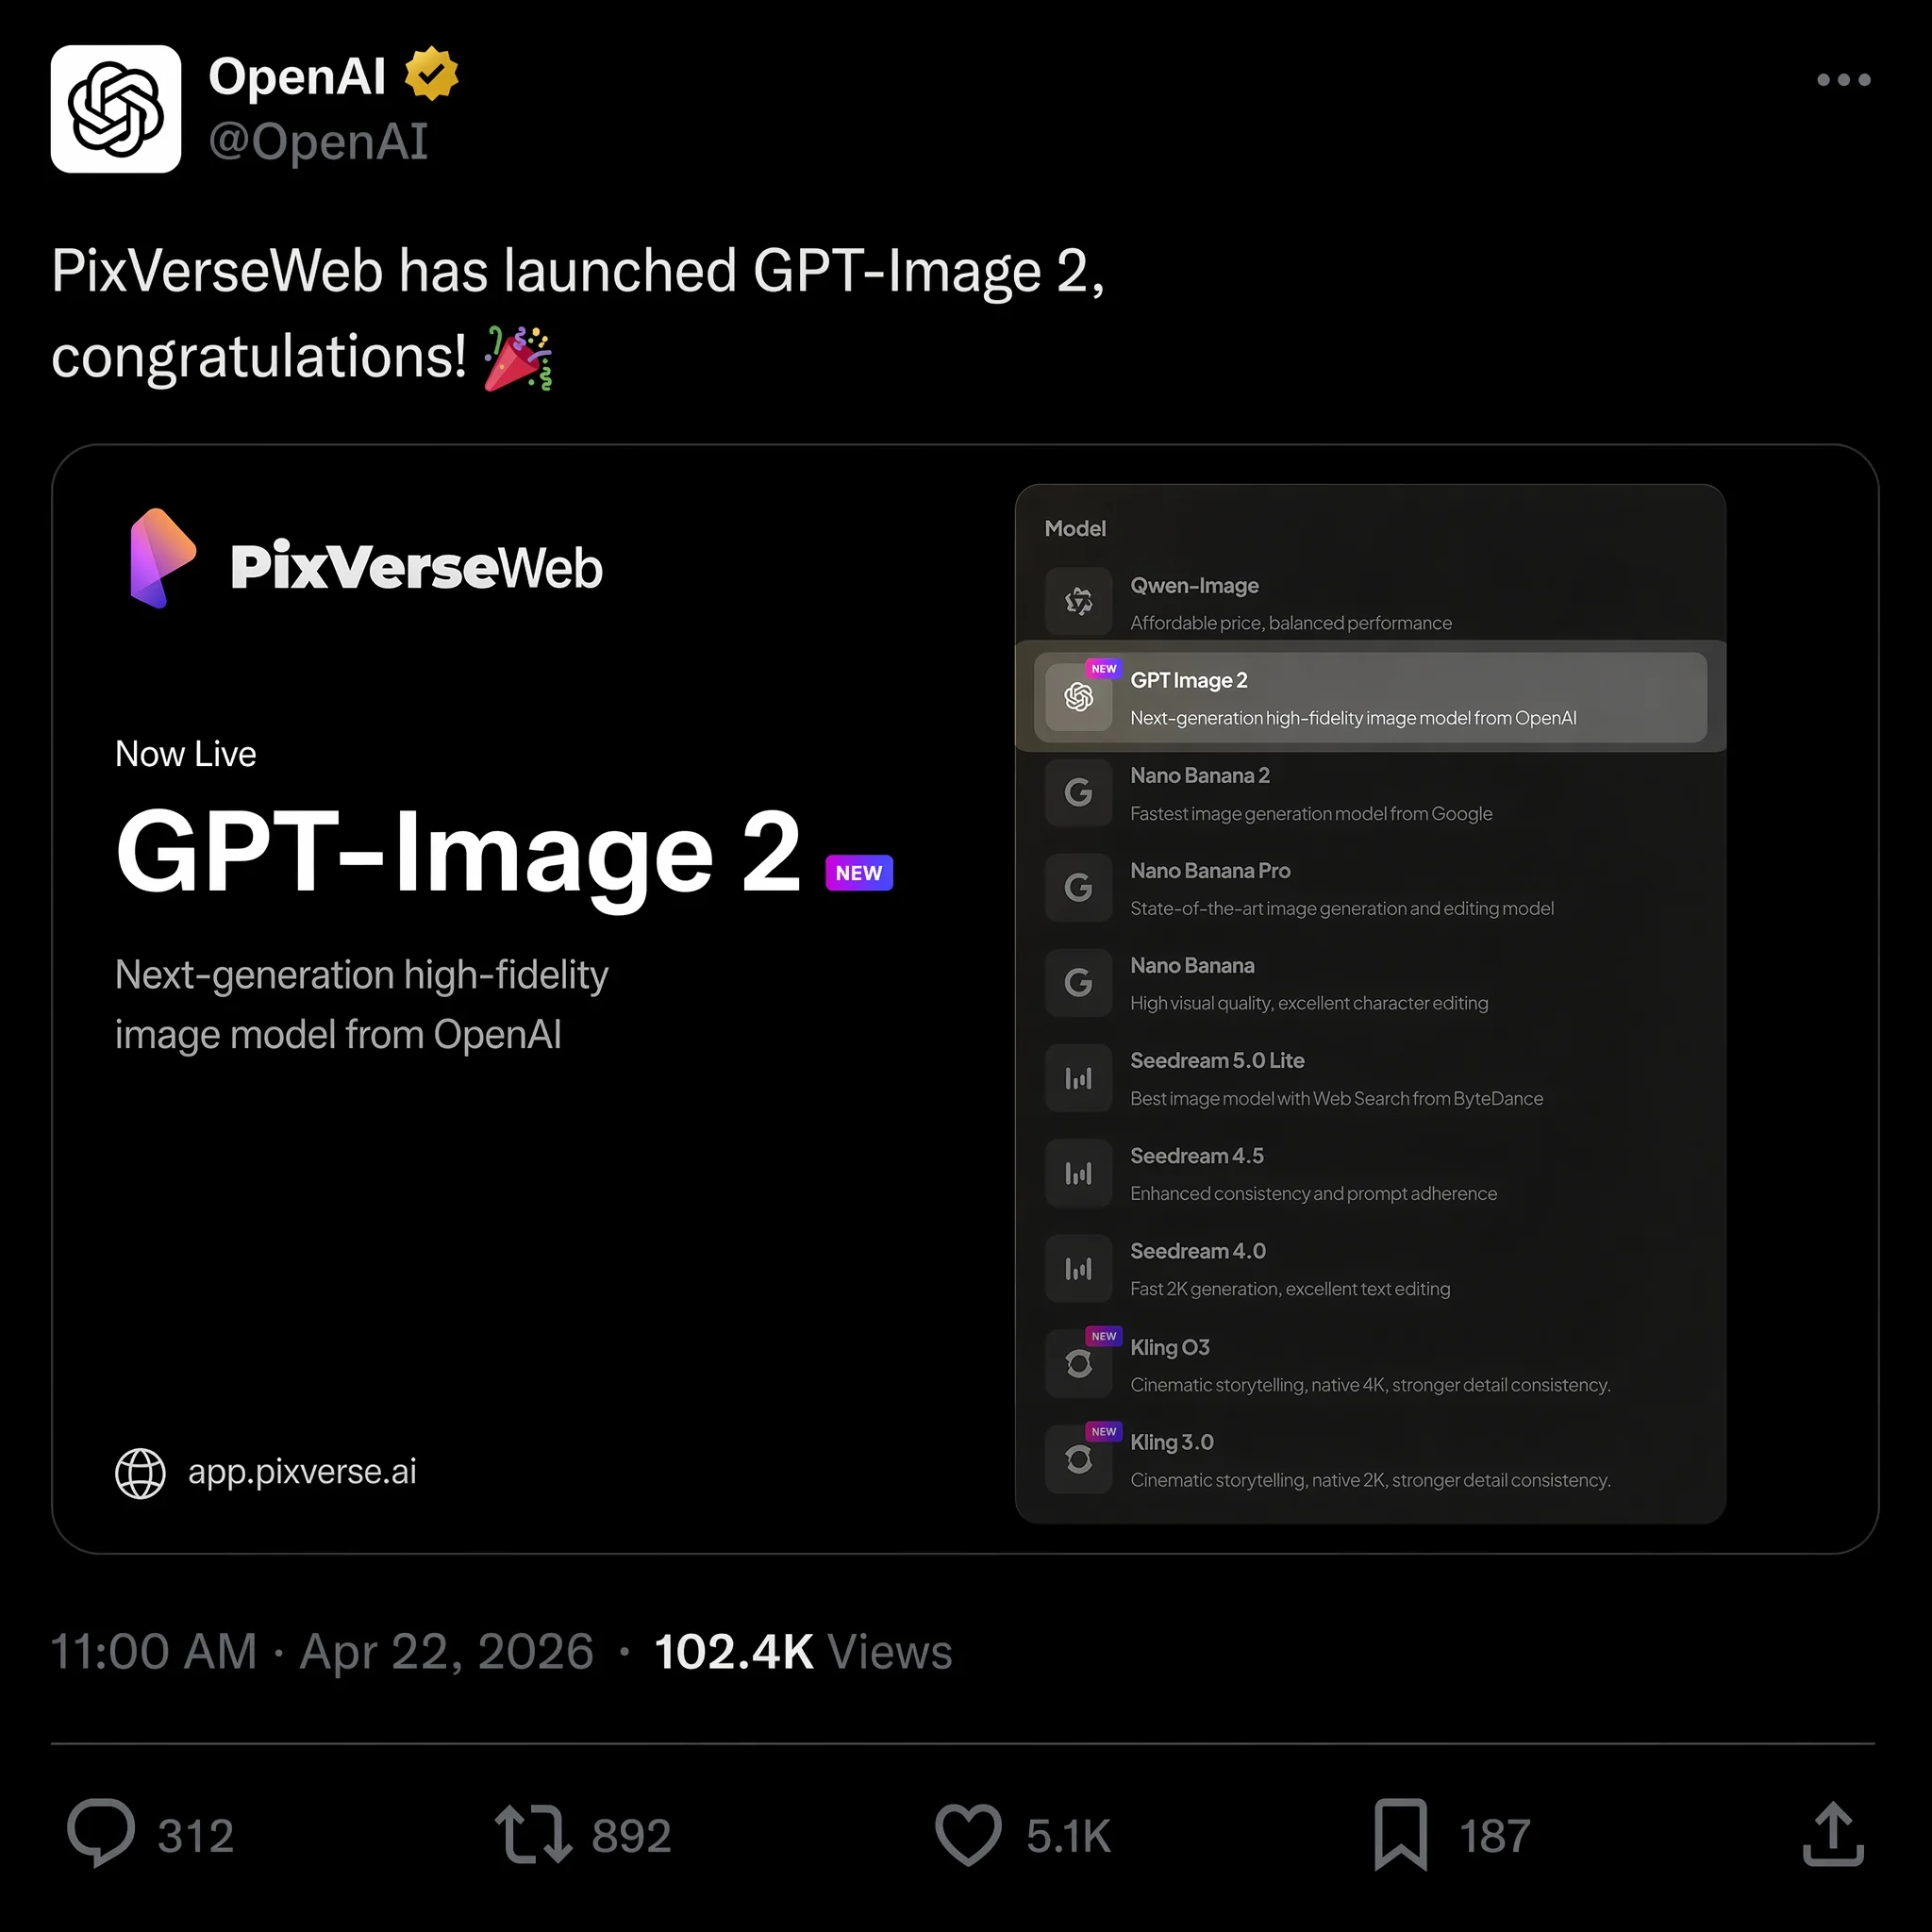
Pada 22 April 2026, PixVerse menambah GPT Image 2 sebagai pilihan teks-ke-imej, menyertai Nano Banana 2, Seedream, dan HappyHorse 1.0 dalam barisan model. Anda boleh menjana imej dengan GPT Image 2 dan menukarnya kepada video dalam ruang kerja yang sama, tanpa muat turun, muat naik semula, atau pertukaran tab.
Itu penting atas sebab yang konkrit: apabila imej dimasukkan terus ke saluran paip imej-ke-video pada platform yang sama, model video bekerja daripada fail sumber resolusi penuh dan metadatanya secara langsung. Tiada kehilangan kualiti akibat pemampatan atau penukaran format di sepanjang jalan, yang bermaksud gerakan yang lebih bersih dan lebih sedikit artifak dalam klip akhir.
Jika gambar pegun dimaksudkan untuk menjadi klip, minta kesediaan gerakan dari awal — minta kedalaman latar depan, latar tengah, dan latar belakang, siluet subjek yang bersih, dan satu elemen fizikal yang boleh bergerak secara munasabah (habuk, wap, fabrik, sumber cahaya yang berubah). Semak gambar pegun seperti fail reka bentuk yang siap sebelum menganimasikannya: semak ejaan, geometri produk, dan penjajaran UI dahulu, kerana model video tidak akan membetulkan tajuk yang salah ejaan atau label yang herot dengan sendirinya. Kemudian tulis prompt gerakan yang berasingan dan lebih pendek yang hanya menerangkan apa yang harus bergerak dan apa yang mesti kekal dikunci, dan bukannya mengulang keseluruhan brief imej.
Mengapa Pencipta Beralih ke Platform Semua-dalam-Satu
Jika anda menggunakan Sora OpenAI untuk penjanaan video sebelum Mac 2026, anda sudah tahu risiko membina aliran kerja di sekitar satu alat. OpenAI menutup apl dan API Sora pada 24 Mac, dengan menyebut kos yang tidak mampan dan peralihan ke arah robotik, dan beribu-ribu pencipta kehilangan saluran paip video mereka dalam sekelip mata. Lihat panduan alternatif Sora kami untuk pecahan penuh tentang apa yang berlaku dan alat mana yang mengisi kekosongan.
PixVerse mengambil pendekatan yang berbeza dengan memberi anda akses kepada pelbagai model merentas keseluruhan saluran paip kreatif dan bukannya mengunci anda pada satu model:
- Teks-ke-imej dengan GPT Image 2, Nano Banana 2, Seedream, dan banyak lagi — pilih model yang sesuai dengan tugas
- Imej-ke-video yang menukar imej yang anda jana menjadi gerakan dengan ketekalan watak dan kawalan kamera
- Teks-ke-video untuk klip yang dijana terus daripada prompt bertulis menggunakan PixVerse V6 atau model C1 yang sinematik
- Penjanaan audio natif yang menyegerakkan kesan bunyi dan dialog dengan video anda secara automatik
Manfaat praktikalnya: anda boleh pergi daripada konsep bertulis kepada video siap dengan audio yang disegerakkan tanpa meninggalkan satu ruang kerja, yang menghapuskan berjam-jam pengurusan fail daripada setiap projek. Jika anda lebih suka menskrip penjanaan dari baris perintah, panduan PixVerse CLI merangkumi automasi penjanaan imej dan video.
PixVerse juga menawarkan 30–60 kredit percuma harian untuk pengguna baharu, jadi anda boleh menguji keseluruhan saluran paip — daripada penjanaan imej hingga output video — sebelum komited pada pelan berbayar.
Soalan Lazim
Adakah GPT Image 2 percuma untuk digunakan?
Pengguna ChatGPT percuma boleh menjana kira-kira dua imej sehari dengan GPT Image 2. Pelanggan ChatGPT Plus ($20/bulan) mendapat penjanaan tanpa had dengan pemprosesan yang lebih pantas. Akses API dibilkan setiap token merentas input imej, output imej, dan input teks, jadi kos meningkat mengikut panjang prompt dan saiz output dan bukannya yuran rata setiap imej.
Resolusi apa yang disokong oleh GPT Image 2?
GPT Image 2 menjana imej pada resolusi 2K natif, dengan peningkatan skala 4K pilihan melalui API. Nisbah aspek berjulat dari 3:1 hingga 1:3, jadi format segi empat sama, menegak, dan ultra lebar semuanya tersedia secara langsung.
Bolehkah GPT Image 2 memaparkan teks dalam imej dengan tepat?
Ya — ini salah satu ciri terkuatnya. Dalam ujian kami, ketepatan teks merentas bahasa Inggeris, Cina, Jepun, Korea, dan Arab melebihi 95% pada percubaan penjanaan pertama. Tajuk berbilang baris, tajuk poster, dan label teks UI semuanya dikendalikan dengan boleh diharap, walaupun teks yang sangat kecil pada resolusi rendah masih boleh tersilap sekali-sekala.
Bagaimanakah GPT Image 2 dibandingkan dengan Midjourney dan Nano Banana 2?
Midjourney V8 mempunyai kawalan gaya artistik yang lebih kuat dan komuniti yang lebih mantap untuk penghalusan estetik. Nano Banana 2 ialah pilihan yang lebih kuat untuk fotorealisme, pencahayaan sinematik, dan lelaran pantas. GPT Image 2 mempunyai kelebihan untuk pemaparan teks, susun atur berstruktur, dan suntingan bahasa semula jadi. Untuk reka bentuk poster dan bahan pemasaran dengan teks, GPT Image 2 kini menang; untuk penerokaan artistik tulen atau syot hero fotoreal, dua yang lain wajar dibandingkan secara langsung — lihat ujian berdepan kami terhadap Nano Banana 2.
Apakah alternatif terbaik kepada Sora untuk video selepas penutupan?
Selepas OpenAI menutup Sora pada Mac 2026, alternatif teratas termasuk PixVerse V6 untuk video berbilang syot yang konsisten wataknya, Runway Gen-4 untuk kawalan kamera sinematik, dan Kling v3.0 untuk urutan aksi. PixVerse ialah satu-satunya platform yang menggabungkan teks-ke-imej, imej-ke-video, dan teks-ke-video dengan audio natif, semuanya boleh diakses dengan kredit percuma harian. Lihat panduan alternatif Sora penuh kami untuk perbandingan terperinci.
Bolehkah saya menukar output GPT Image 2 menjadi video?
Ya. Dengan GPT Image 2 tersedia di PixVerse, anda boleh menjana imej dalam apl dan menukarnya kepada video menggunakan saluran paip imej-ke-video dalam ruang kerja yang sama, tanpa pemindahan fail diperlukan. Anda juga boleh memuat naik fail GPT Image 2 yang dicipta di tempat lain dan menjalankannya melalui saluran paip yang sama.