GPT Image 2 İncelemesi: 2026'da Prompt Rehberi ve Kullanım Senaryoları
OpenAI, GPT Image 2’yi 21 Nisan 2026’da yayınladı — GPT Image 1.5’in halefi ve şu anda ChatGPT genelinde görsel oluşturmayı güçlendiren model. Modeli lansman haftasında test ettik ve Haziran sonunda daha geniş bir prompt seti, OpenAI’nin kendi prompt yazma rehberi ve yayınlanmış API fiyatlandırmasıyla tekrar ele aldık; amacımız ilk heyecan dindikten sonra modelin ne kadar tuttuğunu görmekti.
Öne Çıkanlar:
- GPT Image 2, isteğe bağlı 4K yükseltme ile birlikte yerel 2K çözünürlükte görsel üretiyor ve metin işleme doğruluğu Latin, Çince, Japonca, Korece ve Arapça yazı sistemlerinde %95’in üzerinde.
- Model, bir fotoğraf üreticisinden çok bir tasarım asistanı olarak ele alınmalı: net bir başarı standardı olan işlerde — birebir metin, sabit bir yerleşim, tekrarlanabilir bir panel yapısı — parlıyor, ama açık uçlu “bunu güzel yap” tarzı promptlarda daha az öngörülebilir hale geliyor.
- Marka logosu üretimi, küçük yasal metinler ve özel yazı tipleri hâlâ zayıf noktalar ve manuel inceleme gerektiriyor.
- OpenAI’nin API’si GPT Image 2’yi görsel girişi, önbelleğe alınmış görsel girişi, görsel çıktısı, metin girişi ve önbelleğe alınmış metin girişi üzerinden token bazında faturalandırıyor — bu, bazı rakiplerin kullandığı görsel başına katman fiyatlandırmasından farklı bir model.
- PixVerse, GPT Image 2’yi Nano Banana 2 ve Seedream’in yanında metinden görsele model yelpazesine dahil ediyor; böylece oluşturulan bir görsel çalışma alanından çıkmadan doğrudan görselden videoya iş akışına aktarılabiliyor.
GPT Image 2 Nedir? Temel Özellikler ve Sınırlamalar
GPT Image 2, OpenAI’nin ikinci nesil görsel modelidir ve ChatGPT ile API genelinde GPT Image 1.5’in yerini almıştır. Midjourney, DALL-E 3 ve Stable Diffusion ile rekabet ediyor, ancak kimliğini iki şeye dayandırıyor: görsellerin içinde doğru metin ve bir promptun amacını sadece anahtar kelimeleri eşleştirmek yerine yorumlayan bir akıl yürütme katmanı.
Temel Özelliklere Genel Bakış
| Özellik | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Yerel çözünürlük | 2K (4K yükseltme ile) | 1K | 2K (—hd bayrağıyla) |
| Metin işleme doğruluğu | %95+ çok dilli | ~%70 (yalnızca Latin) | ~%80 (yalnızca Latin) |
| Akıl yürütme entegrasyonu | Evet — katmanlı talimatları yorumlar | Hayır | Hayır |
| En-boy oranı aralığı | 3:1 ile 1:3 arası | 1:1, 16:9 | 1:1 ile 3:2 arası |
| Karakter tutarlılığı | Ardışık görsellerde piksel düzeyinde | Sınırlı | Orta (—cref bayrağı) |
| Doğal dilde düzenleme | Evet — bölgeleri tanımlayarak düzenleme | Hayır | Hayır |
| Fiyatlandırma | API üzerinden token bazlı; ChatGPT plan katmanları | Aynı | 10-30 $/ay abonelik |
Metin işleme, en çok dikkat çeken özellik ve haklı bir nedenle. Eski görsel modelleri metni doku gibi işlerdi — bir poster başlığı isteyin, harf şeklinde gürültü alırdınız. GPT Image 2, çok satırlı İngilizce başlıkları, Çince karakterleri ve karışık dilli yerleşimleri gerçek bir tutarlılıkla ele alıyor; testlerimizde, üretimlerin yaklaşık 20’de 19’u ilk denemede tamamen okunaklı çıktı.
Akıl yürütme entegrasyonu, modelin ifadenizle sadece kalıp eşleştirmesinden fazlasını yaptığı anlamına geliyor. “San Francisco’da yarınki hava durumuna göre aktiviteleri gösteren bir infografik oluştur” diye isteyin, model tahmini alacak, ilgili aktiviteleri seçecek ve bu veriler etrafında bir yerleşim oluşturacaktır — bu, Midjourney veya Stable Diffusion’ın bir promptu işleme biçiminin ötesinde bir adım.
Doğal dilde düzenleme, bir görseli manuel olarak maskeleme yerine değişikliği tarif ederek revize etmenizi sağlıyor. “Kahve fincanını masanın sol tarafına taşı” veya “gökyüzünü gün batımına çevir” gibi talimatlar, sahneyi baştan oluşturmadan hedefli düzenlemeler olarak uygulanıyor.
Kullanıcılar Ne Diyor?
Lansmandan bu yana gelen geri bildirimler büyük ölçüde olumlu, ancak tutarlı bir dizi şikayet de var. X ve Reddit’te dolaşan portre testleri stüdyo fotoğrafçılığına oldukça yakın görünüyor ve uzun format yerleşimleri — broşürler, menüler, tabelalar — test eden poster tasarımcıları, metin doğruluğunun gerçek kullanımda nihayet tutunduğunu bildiriyor. Birkaç tasarımcı, modelin kendi kompozisyon anlayışının yerleşim kararlarını yardımsız verecek kadar güçlü olması nedeniyle temel pazarlama varlıkları için bir Photoshop aşamasını atlayabildiklerini belirtti.
En güçlü övgü, prompt uyumu konusunda yoğunlaşıyor: bir sahnede 15 spesifik öğe isteyin, GPT Image 2 genellikle hepsini dahil etme eğiliminde; oysa eski modeller promptlar uzadıkça detayları düşürmeye başlardı.
Olumsuz tarafta, marka doğruluğu hâlâ tutarsız. Yaygın olarak paylaşılan bir ZDNet uygulamalı testi, modelin ZDNET logosunu doğru şekilde yeniden üretmekte başarısız olduğunu gösterdi ve diğer kullanıcılar da belirli marka işaretleriyle aynı sorunu bildirdi. Model bir logonun kavramsal olarak ne olduğunu anlıyor, ancak tam vektör şekillerini veya özel yazı tiplerini güvenilir bir şekilde yeniden üretmiyor.
Bilinen Sınırlamalar
- Marka logosu üretimi güvenilir değil — bunları doğrudan promptlamak yerine, üretim sonrası Photoshop veya Figma’da tam logoları birleştirin.
- Üretim hızı, FLUX veya Nano Banana 2 gibi daha hafif modellerin gerisinde kalıyor; ChatGPT Plus’ta tipik olarak 30-60 saniye sürerken diğer yerlerde 10 saniyenin altında.
- Ücretsiz katman hız limitleri sıkı — ücretsiz ChatGPT kullanıcıları için günde yaklaşık iki görsel. Plus aboneleri sınırsız ChatGPT üretimi alıyor, ancak API maliyetleri hacimle ölçekleniyor.
- Stil kontrolü, Midjourney’ninkinden daha kaba. Film tipi, lens türü veya grain’i aynı hassasiyetle ayarlayamıyorsunuz ve modelin kendi estetik önyargısını aşmak özenli prompt çalışması gerektiriyor.
- İçerik politikası, açık kaynaklı alternatiflerden daha sıkı; bu nedenle Stable Diffusion veya yerel modellerde sorunsuz çalışan bazı promptlar burada reddedilecektir.
Bunların hiçbiri üretim kullanımını dışlamıyor, ancak tek bir model etrafında bir iş akışı kurmadan önce bilinmesi gereken şeyler.
Gerçekten İşe Yarayan GPT Image 2 Promptları Nasıl Yazılır?
İkinci test turumuzdaki en net değişim şuydu: en iyi GPT Image 2 promptları sadece bir görseli tarif etmez — görselin yapması gereken işi tarif eder. Bir sosyal reklam promptu, bir ürün kesimi, bir infografik, bir UI ekranı veya video için ilk kare olacak bir görselden farklı okunmalıdır.
Brifi yapılandırmak için güvenilir bir kalıp:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Stilden önce işi adlandırın
Çıktı türünü — poster, ürün reklamı, uygulama ekranı, karakter sayfası, diyagram, düzenleme veya video ilk karesi — en başa koyun, böylece model hangi standarda göre değerlendirileceğini bilir.
Zayıf: A cool futuristic speaker, cinematic, high detail.
Daha iyi: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
İkinci versiyon, modele sadece estetik açıdan değil, yerleşim ve kullanılabilirlik açısından değerlendirildiğini söylüyor.
Metni sabit bir varlık gibi ele alın
Gerekli metni tırnak içine koyun ve tam olarak nasıl işlenmesi gerektiğini söyleyin — modelin sizin için kelime uydurmasını istemiyorsanız “bir slogan” istemeyin.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Daha uzun metinler için, her satırı promptta açıkça ayırın. Bir kelime yanlış yazılırsa, daha kısa metin, daha büyük yazı tipi ve daha katı bir “sadece tam metin” talimatıyla yeniden oluşturun.
Modele bir kamera ve yerleşim verin
Kamera mesafesini, açısını, konu yerleşimini, negatif alanı ve en-boy oranını doğrudan belirtin — GPT Image 2, kompozisyon ipuçlarını iyi takip ediyor, ama sadece açıkça belirtildiğinde.
- Ürün dokusu, eller, yüzler, malzemeler, etiketler için yakın çekim.
- Ortamlar, hikaye sahneleri, şehir posterleri, video için hazır kareler için geniş çekim.
- Yemek, masa sahneleri, düz yerleşimler, ambalaj setleri için yukarıdan çekim.
- Metin ve ürünü dengeleyen reklam yerleşimleri için sol üçte bir / sağ üçte bir.
- UI mockup’ları, karakter sayfaları, diyagramlar, infografikler için temiz ızgara.
Düzenlemeleri üç cümlede yazın
En güçlü düzenleme promptları, değişikliği dokunulmaması gerekenden ve bu ikisini birbirine bağlayan fiziksel gerçekçilikten ayırır:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Bu “değiştir, koru, eşleştir” yapısı, belirsiz bir “bunu daha güzel yap” isteğinden tutarlı bir şekilde daha iyi performans gösteriyor.
Görsel videoya dönüşecekse bir hareket ipucu ekleyin
Bir görsel daha sonra bir PixVerse görselden videoya iş akışını besleyecekse, en baştan derinlik ve harekete hazır olma durumu için prompt yazın: ön plan, orta plan, arka plan, temiz bir konu silueti ve hareket edebilecek görünür bir ipucu — toz, kumaş, saç, yağmur, yansıma veya bir kamera itme yolu.
Bunun yerine: An astronaut in a desert.
Şunu kullanın: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
GPT Image 2’yi Nasıl Test Ettik
Her iki test turunda da modeli portreler, metin ağırlıklı posterler, ürün tarzı kompozisyonlar, karakter sayfaları, UI mockup’ları ve deneysel anlatı sahneleri üzerinden çalıştırdık. Amaç bir benchmark puanı değildi — bir tasarımcının, pazarlamacının veya içerik üreticisinin çıktıyı varlığı sıfırdan yeniden oluşturmak yerine hafif düzenlemelerle gönderip gönderemeyeceğiydi.
| Test alanı | Neyi kontrol ettik |
|---|---|
| Portreler ve sinematik sabit görüntüler | Işık kontrolü, cilt dokusu, yansımalar, ruh hali, sahne tutarlılığı |
| Poster ve tipografi yerleşimleri | Başlık yazımı, çok satırlı metin, hiyerarşi, negatif alan, marka benzeri cila |
| Karakter ve konsept sayfaları | Çoklu görünüm tutarlılığı, kostüm detayı, palet uyumu, etiket doğruluğu |
| UI ve sosyal medya mockup’ları | Yerleşim gerçekçiliği, küçük metin, ikon aralığı, feed ızgaraları, ekran görüntüsü inandırıcılığı |
| Deneysel promptlar | Mizah, anlatı akıl yürütmesi, nesne yerleşimi, küçük altyazı doğruluğu |
Kalıp her iki turda da sabit kaldı: GPT Image 2, bir anahtar kelime zincirinden çok net bir brifi ödüllendiriyor. Bir prompt işi adlandırdığında ve başarıyı tanımladığında — tam metin, sabit bir yerleşim, tekrarlanabilir bir panel yapısı — model yapıyı korumaya eğilimli oluyor. Bir prompt sadece belirsiz bir ruh hali istediğinde, sonuç yine de cilalı görünebilir, ancak düzenlemeler olmadan yeniden kullanmak daha zor.
Prompt Örnekleriyle GPT Image 2 Kullanım Senaryoları
Bu senaryolar genelinde beş farklı yeteneği stres testine tabi tuttuk: ışık kontrolü, tam metinli tipografi, çok öğeli kompozisyon, karakter tutarlılığı ve UI yerleşimi. Aşağıdaki her prompt kopyalanıp uyarlanmaya hazır.
Sinematik Portre Fotoğrafçılığı
Bu, modelin ışık, atmosfer ve ölçülü kompozisyon konusundaki kavrayışını kontrol ediyor — portfolyoya hazır bir görseli genel bir AI render’ından ayıran temeller.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
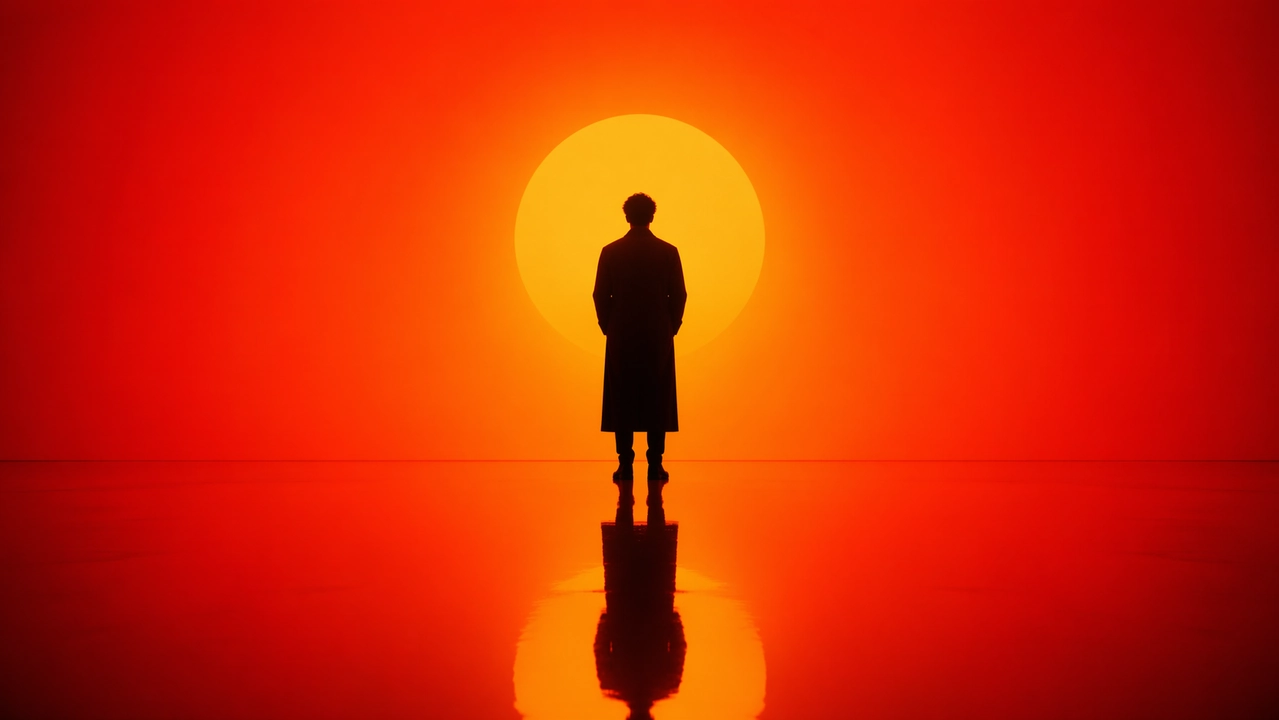
Nelere dikkat edilmeli: hale efekti olmayan temiz silüet kenarları, doğru perspektifle gerçekçi zemin yansıması, pürüzsüz (bantlanmamış) bir gradyan ve durağan veya havada süzülüyormuş gibi görünmek yerine gerçek bir ağırlık taşıyan bir poz.
Şehir Posteri ve İllüstrasyon Tasarımı
Yoğun, çok öğeli bir kompozisyonla eşleştirilmiş okunaklı tipografi için en zorlu stres testi — bir S-eğrisi boyunca düzenlenmiş on beşten fazla farklı görsel öğe ve render’dan sağlam çıkması gereken İngilizce metin.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
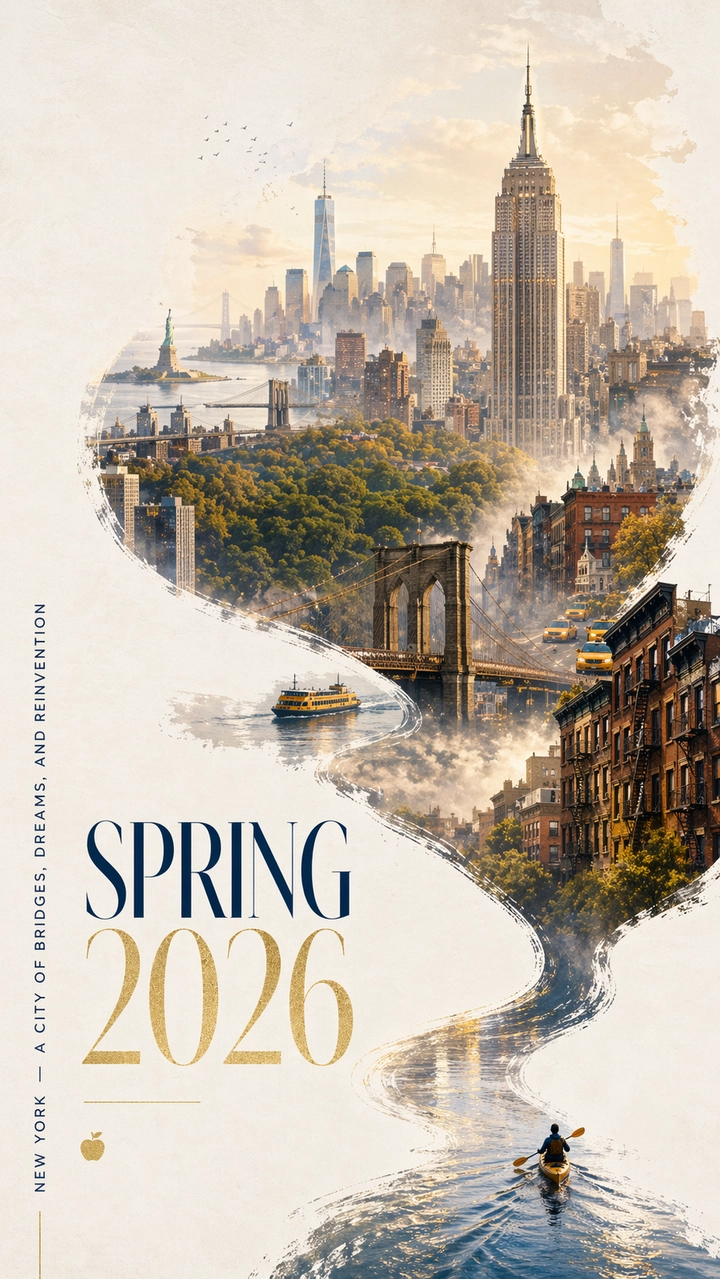
Nelere dikkat edilmeli: başlık ve slogandaki her harf okunaklı ve doğru yazılmış olmalı, S-eğrisi kayıkçıdan siluete doğru doğal akmalı, simge yapılar jenerik kuleler yerine tanınabilir görünmeli ve negatif alan boş değil kasıtlı hissettirmeli.
Karakter Tasarımı ve Referans Sayfası
Oyun geliştiricileri ve konsept sanatçıları tek bir üretimden çoklu görünüm tutarlılığına ihtiyaç duyar. Bu, modelin bir karakterin tasarımını ön, yan ve arka görünümler boyunca sabit tutup tutamadığını kontrol ediyor.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
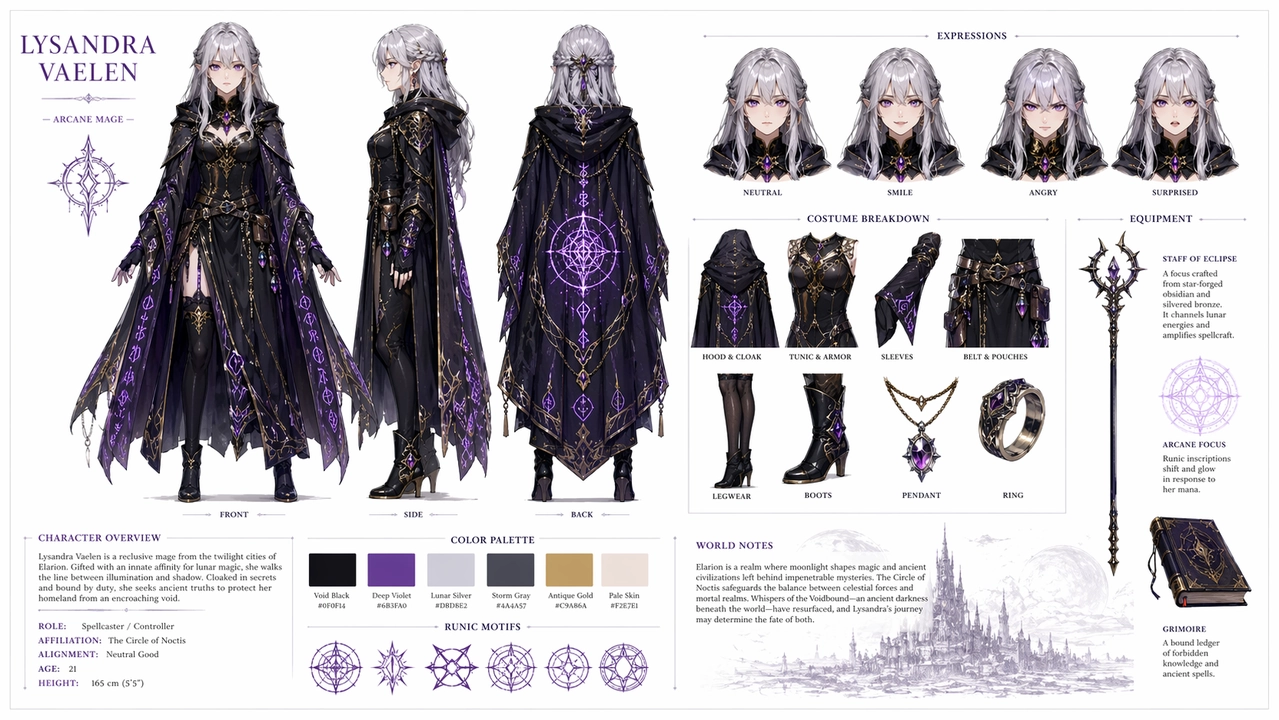
Nelere dikkat edilmeli: yüz, saç ve kıyafet üç görünümde de tutarlı kalmalı; ifade varyasyonları sadece yüzü değiştirmeli, saç stilini veya kıyafeti değil; palet örneği sanatta kullanılan renklerle gerçekten eşleşmeli; ve metin etiketleri doğru yazılmış olmalı. Bir yan veya arka görünüm kayarsa, kimlik çıpalarını tekrarlayan daha güçlü bir “koru” dili ile yeniden oluşturun.
UI ve Sosyal Medya Mockup’ı
Bu, aynı anda üç şeyi zorluyor: piksel doğruluğunda UI yerleşimi, karışık dilli metin işleme ve sosyal platformlarda da iyi performans gösterme eğiliminde olan türden yaratıcı konsept birleşimi.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
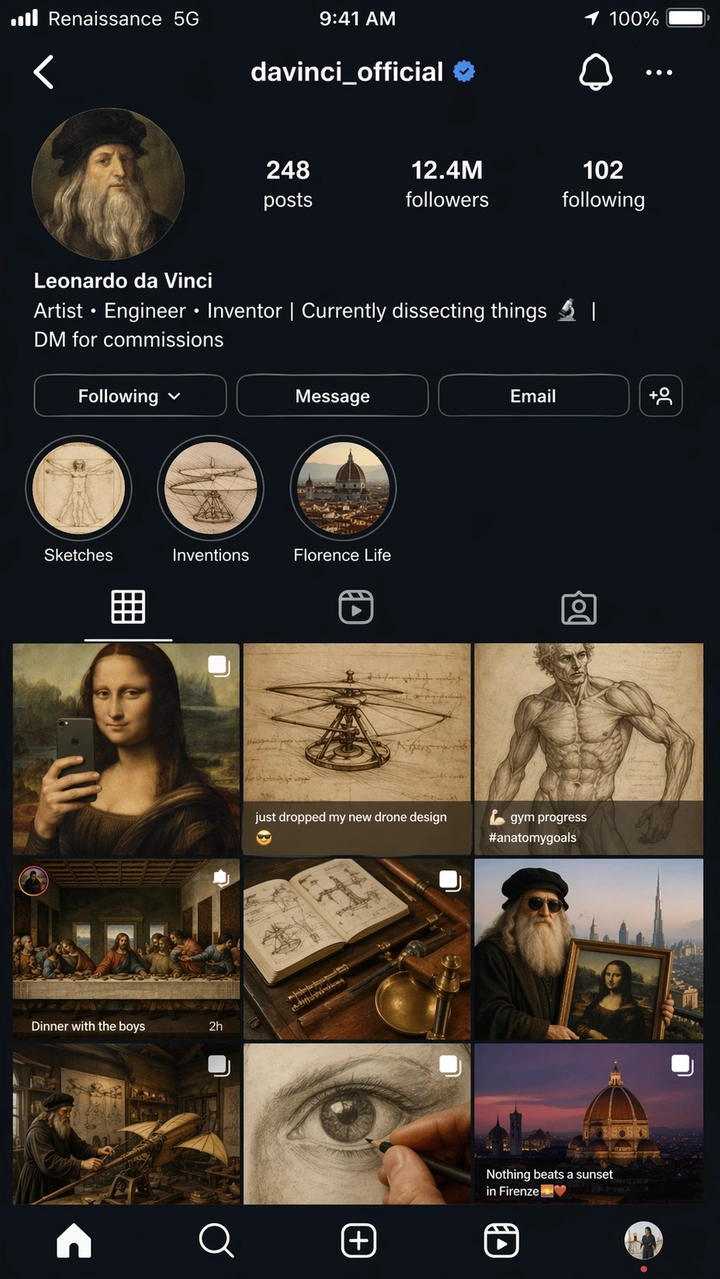
Nelere dikkat edilmeli: Instagram UI öğeleri — ızgara aralığı, profil yerleşimi, hikaye çemberleri, sekme çubuğu — stilize bir yaklaşımdan çok gerçek bir iOS ekran görüntüsü gibi okunmalı. Tüm metin okunabilir olmalı ve “Renaissance 5G” operatör etiketi kasıtlı bir doğruluk kontrolü. Herhangi bir UI mockup çıktısını üretime hazır UI yerine bir konsept referansı olarak ele alın; küçük etiketler ve ikon hizalaması genellikle bir temizlik geçişi gerektirir.
Yaratıcı ve Deneysel Sanat
Yerleşik anlatı mizahı içeren kısa promptlar, modelin ayrıntılı talimatlara güvenmek yerine yaratıcı boşlukları kendi başına doldurup dolduramadığını test ediyor.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
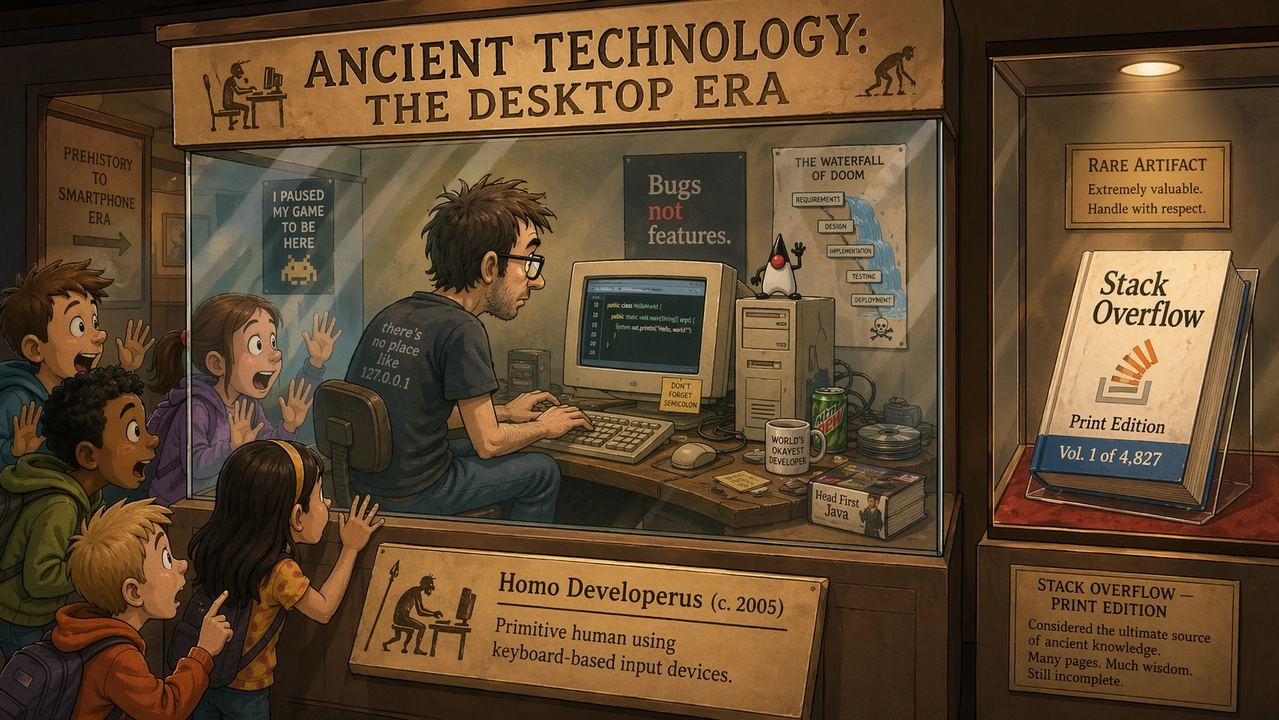
Nelere dikkat edilmeli: mizah sadece altyazı metninden değil, görsel detaylardan geçmeli. Levha ve kitap başlığı okunaklı ve doğru yazılmış kalmalı — küçük boyutlarda çok satırlı metin için gerçekten zor bir test — ve karikatür stili sahnenin bazı kısımlarında fotogerçekçi olmak yerine bütün sahne boyunca tutarlı hissettirmeli.
Kullanım Senaryosuna Göre Test Sonuçları
En güçlü sonuçlar tutarlı bir şekilde açık bir üretim standardına sahip promptlardan geldi — yazım, yerleşim, nesne korunması veya panel sırasıyla değerlendirilebilen bir şey. Sadece belirsiz ruh hali içeren promptlar daha değişken sonuçlar üretti.
| Kullanım senaryosu | Neler iyi çalıştı | Neler hâlâ incelemeye ihtiyaç duyuyor |
|---|---|---|
| Metin işleme | Büyük başlıklar, kısa etiketler, poster başlıkları ve basit UI etiketleri, tam metin alıntılandığında doğru kaldı. | Küçük yasal metinler, yoğun paragraflar ve stilize yazı tipleri hâlâ kayabiliyor — metni kısa tutun ve her harfi kontrol edin. |
| Ürün görselleri | Temiz reklam yerleşimleri, kampanya negatif alanı ve ürün öncelikli kompozisyonlar iyi render edildi. | Gerçek etiketler, logolar ve düzenlenmiş iddialar hâlâ manuel inceleme veya onaylı varlıklardan birleştirme gerektiriyor. |
| UI mockup’ları | Mobil ekranlar, panolar ve uygulama benzeri hiyerarşi, prompt gerçek arayüz öğelerini adlandırdığında inandırıcı görünüyordu. | Çıktıları konsept mockup’ları olarak ele alın — küçük etiketler ve ikon hizalaması genellikle temizlik gerektirir. |
| Karakter tutarlılığı | Karakter sayfaları, ifade sıraları ve palet örnekleri yaratıcı referanslar olarak iyi çalıştı. | Yüzler ve kostüm detayları görünümler arasında kayabilir; kimlik çıpalarını tekrarlayın ve gerekirse yeniden oluşturun. |
| Düzenleme ve birleştirme | “Değiştir, koru, eşleştir” kalıbı geniş düzenleme isteklerinden daha iyi performans gösterdi. | Seçim sınırları ve şeffaf arka plan çıktısı hâlâ kalite kontrolü gerektiriyor. |
Yaygın GPT Image 2 Prompt Hataları
- Tam metni sağlamadan doğru metin istemek. Metin önemliyse, tam olarak yazın ve nereye ait olduğunu belirtin.
- Tek bir promptu her olası detayla aşırı yüklemek. Temel sahneyle başlayın, ardından bir seferde bir değişkeni iyileştirin.
- Düzenlemeler sırasında değişmezleri belirtmeyi unutmak. Neyin değişmeden kalması gerektiğini açıkça belirtin: kimlik, arka plan, poz, ışıklandırma, ürün şekli, etiket metni, kamera açısı.
- İşlevsel işler için dekoratif kalite kelimelerine güvenmek. “Güzel” bir etiketi okunaklı yapmaz — bunun yerine “keskin etiket metni” veya “uzaktan okunabilir” gibi bir dil kullanın.
- En-boy oranını belirtmeyi atlamak. Güçlü bir kare görsel, dikey bir reklam veya video küçük resmi olarak yine de başarısız olabilir.
- Logoları sıradan metin gibi ele almak. GPT Image 2 logo konseptleri tasarlayabilir, ancak tam marka işaretleri doğrudan promptlanmak yerine onaylı varlıklardan birleştirilmelidir.
GPT Image 2 API ve Fiyatlandırma Notları
OpenAI’nin API fiyatlandırma sayfası, GPT Image 2’yi sabit bir görsel başına oran yerine token bazında listeliyor:
| Kalem | Listelenen fiyat |
|---|---|
| Görsel girişi | 8,00 $ / 1M token |
| Önbelleğe alınmış görsel girişi | 2,00 $ / 1M token |
| Görsel çıktısı | 30,00 $ / 1M token |
| Metin girişi | 5,00 $ / 1M token |
| Önbelleğe alınmış metin girişi | 1,25 $ / 1M token |
Görsel başına gerçek maliyet, prompt uzunluğuna, referans görsellere, çıktı boyutuna, önbelleğe almaya ve kalite ayarına bağlıdır. ChatGPT plan kotaları, API faturalandırmasından ayrı bir izleme yoludur — bir Plus aboneliği doğrudan API kredisine dönüşmez, bu yüzden ikisini de kullanıyorsanız bütçenizi ayrı ayrı planlayın.
Yüksek hacimli iş akışları için önemli olan sayı, tek bir denemenin liste fiyatı değil, yeniden denemelerden sonra kabul edilen varlık başına maliyettir. Yazımı veya yerleşimi doğru yapmak için üç yeniden üretime ihtiyaç duyuyorsa, daha ucuz bir üretim aslında daha ucuz değildir.
| İş akışı | Pratik prompt tavsiyesi |
|---|---|
| Metin ağırlıklı posterler veya diyagramlar | Görsel başına daha az kelime kullanın, tam metni alıntılayın, hiyerarşiyi açıkça belirtin. |
| Ürün fotoğrafları | Ürün şeklini, etiketi, rengi, malzemeyi ve kamera açısını sabitleyin; her düzenleme geçişinde koruma listesini tekrarlayın. |
| UI mockup’ları | Ekranı konsept sanatı olarak değil, gönderilmiş bir arayüz olarak tarif edin — navigasyon, kartlar, düğmeler, durumlar. |
| Çoklu referans düzenlemeleri | Her giriş görselini role göre etiketleyin: konu, stil, arka plan veya malzeme referansı. |
| Toplu üretim | Deneme başına maliyet değil, kabul edilen görsel başına maliyeti takip edin. |
GPT Image 2’nin fotogerçekçilik öncelikli bir alternatife karşı aynı promptlarda nasıl durduğunu görmek isterseniz, GPT Image 2 ile Nano Banana 2 karşılaştırmamız tam API ve platform fiyatlandırma dökümleriyle altı kafa kafaya tur çalıştırıyor.
Görselden Videoya: Yaratıcı İş Akışınızı PixVerse’de Tamamlayın
Güçlü bir görsel oluşturmak bir adımdır. Onu harekete dönüştürmek çoğu iş akışının bozulduğu yerdir — GPT Image 2’de bir portre veya ürün posteri bitirirsiniz, sonra ayrı bir araç açmanız, dosyayı yeniden yüklemeniz ve video modelinin özenle oluşturduğunuz görseli çarpıtmamasını ummanız gerekir. Bu aktarım sürtünmesi, PixVerse’in tam olarak ortadan kaldırdığı şeydir.
GPT Image 2 Artık PixVerse’de
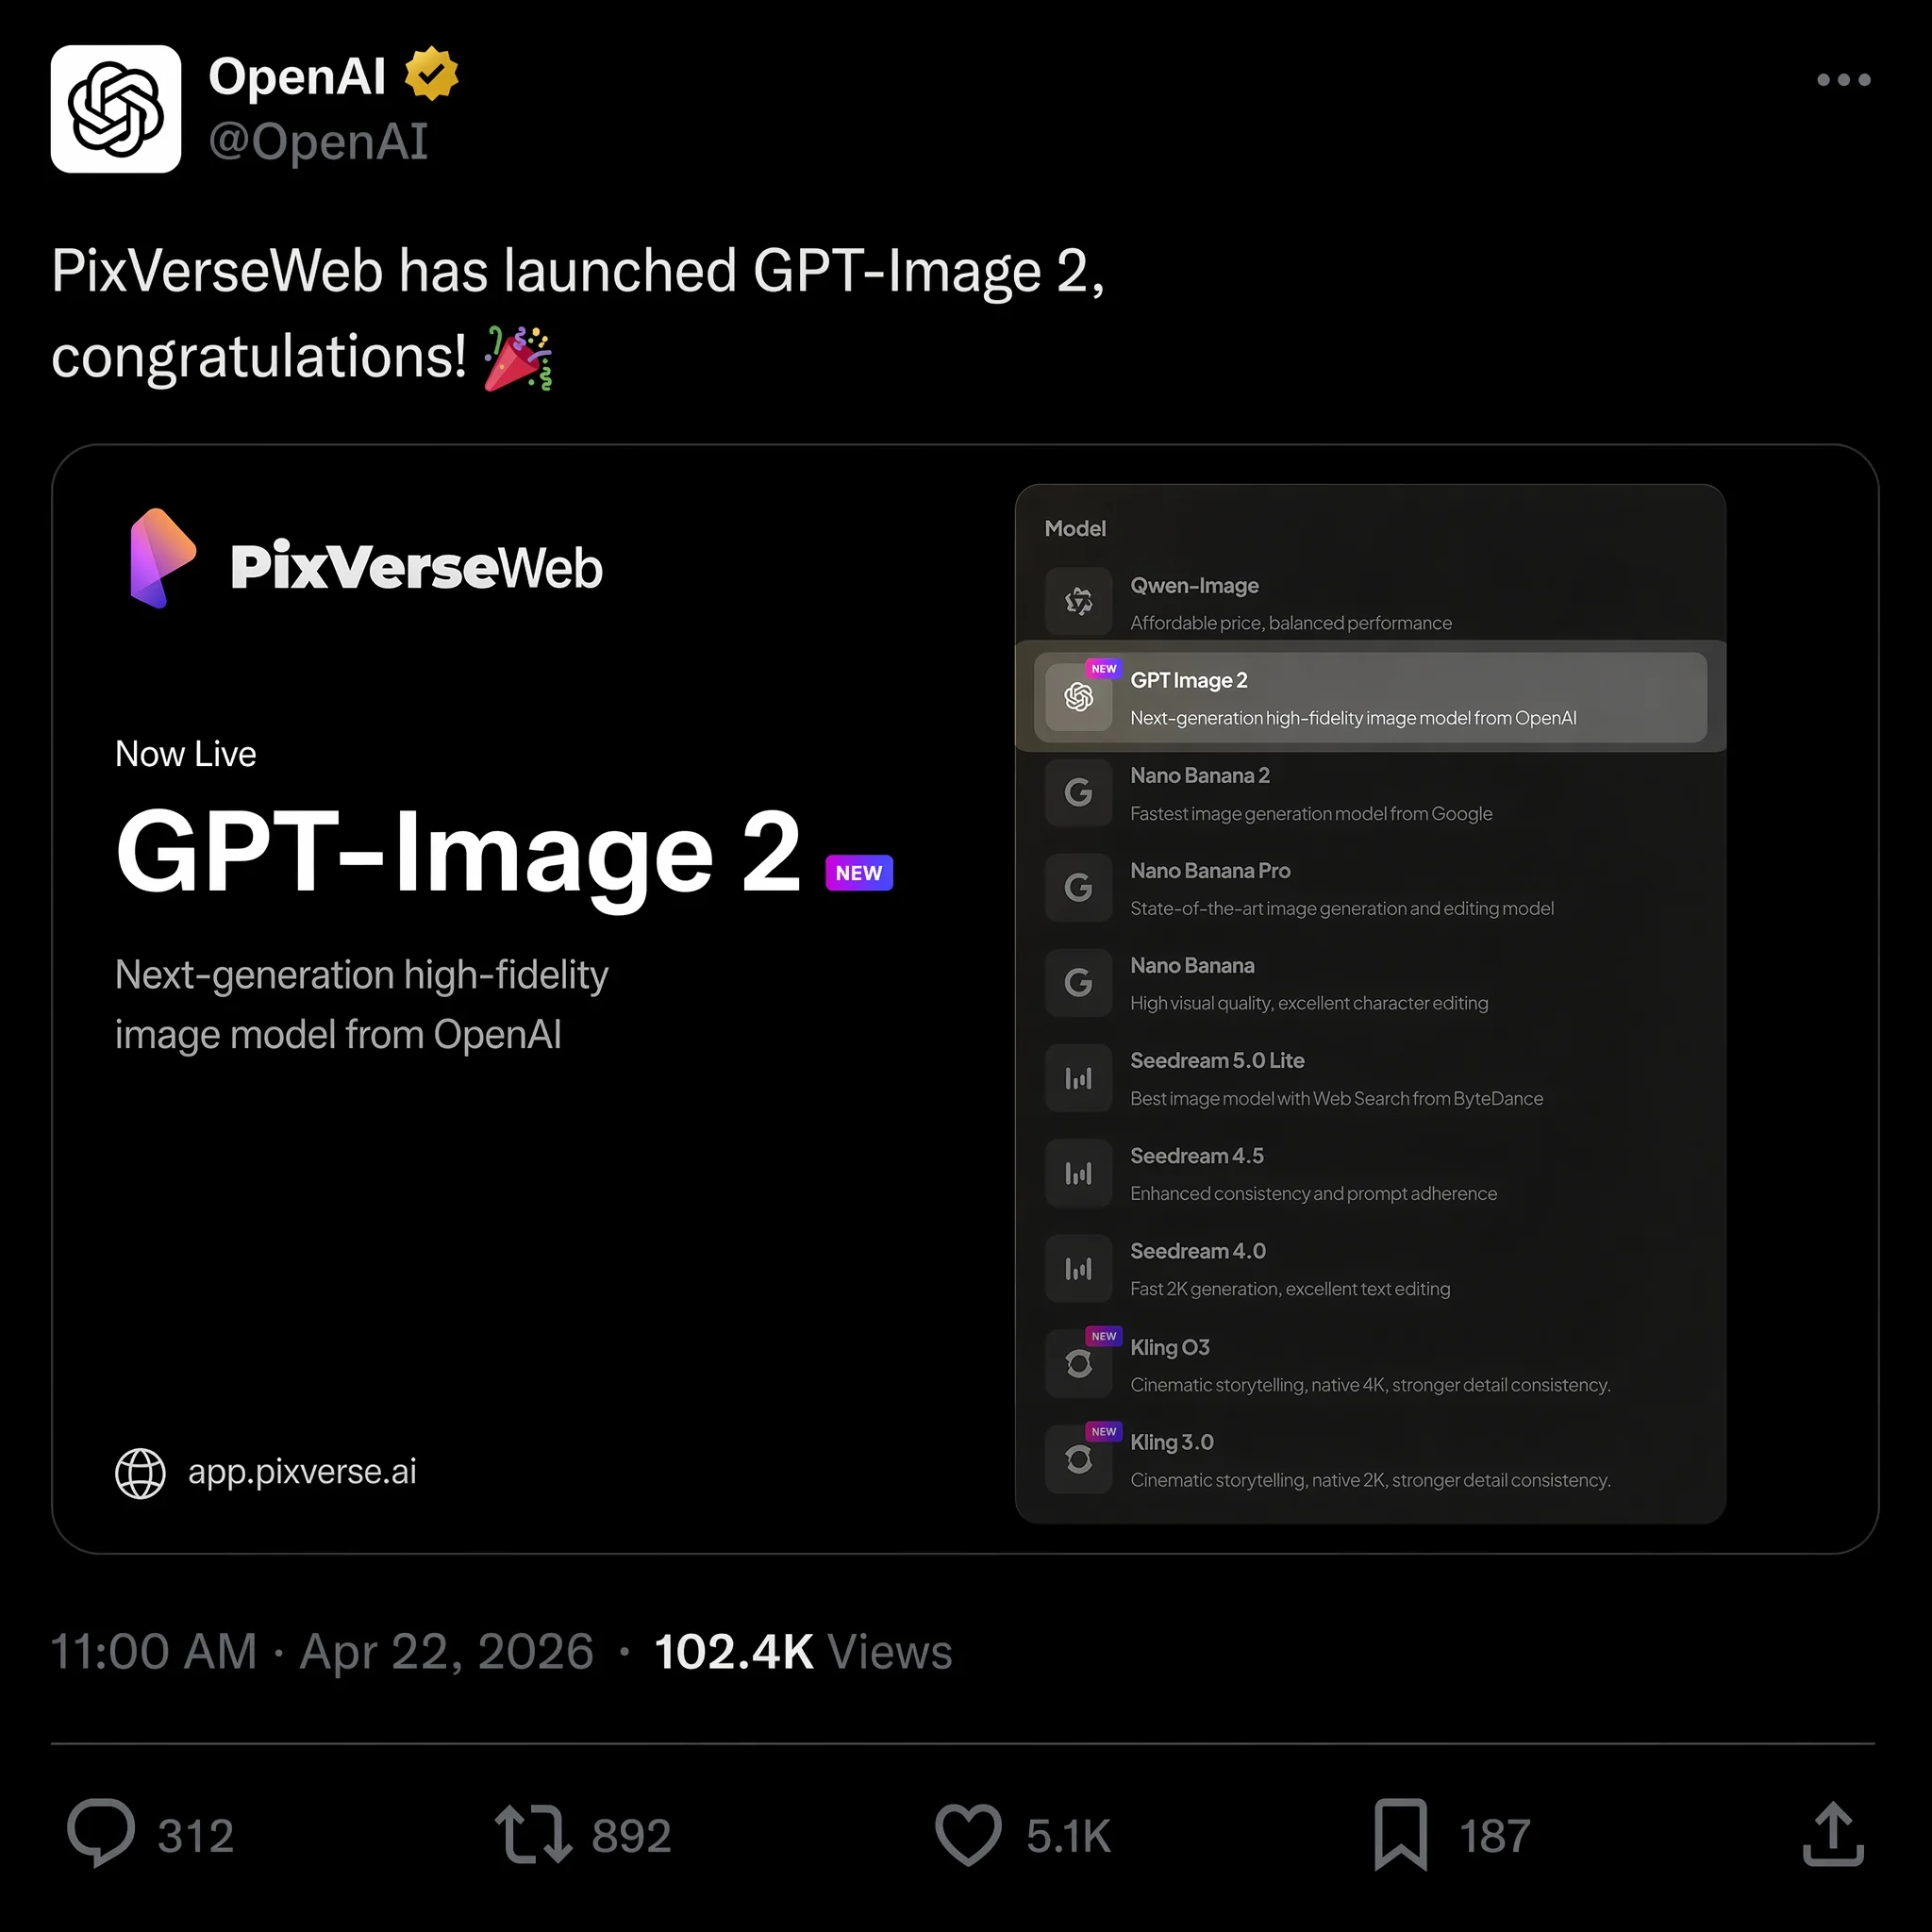
22 Nisan 2026’da PixVerse, GPT Image 2’yi metinden görsele bir seçenek olarak ekledi ve model yelpazesinde Nano Banana 2, Seedream ve HappyHorse 1.0 ile birleşti. GPT Image 2 ile bir görsel oluşturabilir ve indirme, yeniden yükleme veya sekme değiştirme olmadan aynı çalışma alanında videoya dönüştürebilirsiniz.
Bu somut bir nedenden dolayı önemli: görsel doğrudan aynı platformda görselden videoya bir iş akışını beslediğinde, video modeli tam çözünürlüklü kaynak dosya ve meta verileriyle doğrudan çalışır. Bu süreçte sıkıştırma veya format dönüşümünden kaynaklanan kalite kaybı olmaz, bu da nihai klipte daha temiz hareket ve daha az bozulma anlamına gelir.
Sabit bir görselin bir klibe dönüşmesi amaçlanıyorsa, en başından harekete hazır olma durumu için prompt yazın — ön plan, orta plan ve arka plan derinliği, temiz bir konu silüeti ve makul şekilde hareket edebilecek bir fiziksel öğe (toz, buhar, kumaş, değişen bir ışık kaynağı) isteyin. Animasyona başlamadan önce sabit görseli bitmiş bir tasarım dosyası gibi inceleyin: önce yazımı, ürün geometrisini ve UI hizalamasını kontrol edin, çünkü bir video modeli yanlış yazılmış bir başlığı veya çarpık bir etiketi kendi başına düzeltmez. Ardından, tüm görsel brifini tekrarlamak yerine sadece nelerin hareket etmesi gerektiğini ve nelerin sabit kalması gerektiğini tarif eden ayrı, daha kısa bir hareket promptu yazın.
İçerik Üreticileri Neden Hepsi Bir Arada Platforma Geçiyor
Mart 2026’dan önce video üretimi için OpenAI’nin Sora’sını kullanıyorsanız, tek bir araç etrafında bir iş akışı kurmanın riskini zaten biliyorsunuzdur. OpenAI, sürdürülemez maliyetleri ve robotiğe yönelik bir dönüşü gerekçe göstererek 24 Mart’ta Sora uygulamasını ve API’sini kapattı ve binlerce içerik üreticisi bir gecede video iş akışını kaybetti. Neler olduğuna ve hangi araçların bu boşluğu doldurduğuna dair eksiksiz bir döküm için Sora alternatifleri rehberimize bakın.
PixVerse, sizi tek bir araca kilitlemek yerine tüm yaratıcı iş akışında birden fazla modele erişim sağlayarak farklı bir yaklaşım benimsiyor:
- GPT Image 2, Nano Banana 2, Seedream ve daha fazlasıyla metinden görsele — işe uyan modeli seçin
- Oluşturduğunuz görselleri karakter tutarlılığı ve kamera kontrolüyle harekete dönüştüren görselden videoya
- PixVerse V6 veya sinematik C1 modeli kullanılarak yazılı bir promptdan doğrudan oluşturulan klipler için metinden videoya
- Ses efektlerini ve diyaloğu videonuzla otomatik olarak senkronize eden yerel ses üretimi
Pratik fayda: yazılı bir konseptten senkronize sesli tamamlanmış bir videoya, tek bir çalışma alanından çıkmadan gidebilirsiniz; bu, her projeden saatlerce dosya yönetimini ortadan kaldırır. Üretimi komut satırından yazmayı tercih ederseniz, PixVerse CLI rehberi hem görsel hem de video üretimini otomatikleştirmeyi kapsıyor.
PixVerse ayrıca yeni kullanıcılar için günlük 30-60 ücretsiz kredi sunuyor, böylece ücretli bir plana geçmeden önce görsel üretiminden video çıktısına kadar tüm iş akışını test edebilirsiniz.
Sıkça Sorulan Sorular
GPT Image 2 kullanımı ücretsiz mi?
Ücretsiz ChatGPT kullanıcıları GPT Image 2 ile günde yaklaşık iki görsel oluşturabilir. ChatGPT Plus abonelerinin (20 $/ay) daha hızlı işleme ile sınırsız üretimi vardır. API erişimi, görsel girişi, görsel çıktısı ve metin girişi üzerinden token başına faturalandırılır, bu nedenle maliyet sabit görsel başına ücret yerine prompt uzunluğu ve çıktı boyutuyla ölçeklenir.
GPT Image 2 hangi çözünürlüğü destekliyor?
GPT Image 2, yerel 2K çözünürlükte görsel oluşturur; API üzerinden isteğe bağlı bir 4K yükseltme mevcuttur. En-boy oranları 3:1 ile 1:3 arasında değişir, bu nedenle kare, dikey ve ultra geniş formatların hepsi doğrudan kullanılabilir.
GPT Image 2 görsellerdeki metni doğru şekilde render edebiliyor mu?
Evet — bu en güçlü özelliklerinden biri. Testlerimizde, İngilizce, Çince, Japonca, Korece ve Arapça genelinde metin doğruluğu ilk üretim denemesinde %95’i aştı. Çok satırlı başlıklar, poster başlıkları ve UI metin etiketlerinin hepsi güvenilir bir şekilde işleniyor, ancak düşük çözünürlüklerdeki çok küçük metinler hâlâ ara sıra hatalı çıkabiliyor.
GPT Image 2, Midjourney ve Nano Banana 2 ile nasıl karşılaştırılıyor?
Midjourney V8’in daha güçlü sanatsal stil kontrolleri ve estetik iyileştirme için daha köklü bir topluluğu var. Nano Banana 2, fotogerçekçilik, sinematik ışıklandırma ve hızlı yineleme için daha güçlü bir seçim. GPT Image 2, metin işleme, yapılandırılmış yerleşimler ve doğal dilde düzenleme konusunda avantaja sahip. Metinli poster tasarımı ve pazarlama materyalleri için GPT Image 2 şu anda kazanıyor; saf sanatsal keşif veya fotogerçekçi hero görseller için diğer ikisini doğrudan karşılaştırmaya değer — Nano Banana 2’ye karşı kafa kafaya testimize bakın.
Kapanıştan sonra video için Sora’ya en iyi alternatifler nelerdir?
OpenAI, Mart 2026’da Sora’yı kapattıktan sonra, en iyi alternatifler arasında karakter tutarlı çoklu çekim video için PixVerse V6, sinematik kamera kontrolü için Runway Gen-4 ve aksiyon sahneleri için Kling v3.0 bulunuyor. PixVerse, metinden görsele, görselden videoya ve metinden videoya modellerini yerel sesle birleştiren, günlük ücretsiz kredilerle erişilebilen tek platform. Ayrıntılı bir karşılaştırma için tam Sora alternatifleri rehberimize bakın.
GPT Image 2 çıktılarını videoya dönüştürebilir miyim?
Evet. PixVerse’de kullanılabilir olan GPT Image 2 ile görseli uygulama içinde oluşturabilir ve dosya aktarımı gerektirmeden aynı çalışma alanındaki görselden videoya iş akışını kullanarak videoya dönüştürebilirsiniz. Ayrıca başka bir yerde oluşturulmuş bir GPT Image 2 dosyasını yükleyip aynı iş akışından geçirebilirsiniz.