Recensione di GPT Image 2: guida ai prompt e casi d'uso nel 2026
OpenAI ha rilasciato GPT Image 2 il 21 aprile 2026 — il successore di GPT Image 1.5 e il modello che oggi alimenta la generazione di immagini in ChatGPT. Lo abbiamo testato durante la settimana di lancio e vi siamo tornati a fine giugno con un set più ampio di prompt, la guida al prompting pubblicata da OpenAI e i prezzi ufficiali dell’API, per capire come si comporta il modello una volta esaurito l’entusiasmo iniziale.
Punti chiave:
- GPT Image 2 genera immagini a risoluzione nativa 2K con upscaling opzionale a 4K, e l’accuratezza nel rendering del testo supera il 95% su scritture latine, cinesi, giapponesi, coreane e arabe.
- Il modello va trattato più come un assistente di design che come un generatore di foto: eccelle nei compiti con uno standard di successo chiaro — testo esatto, layout bloccato, struttura a pannelli ripetibile — mentre diventa meno prevedibile con prompt aperti del tipo “rendilo bello”.
- La riproduzione dei loghi di marca, il testo legale minuscolo e i font proprietari restano punti deboli che richiedono ancora una revisione manuale.
- L’API di OpenAI addebita GPT Image 2 a token, distinguendo tra input immagine, input immagine in cache, output immagine, input testo e input testo in cache — un modello di prezzo diverso rispetto ai livelli per immagine usati da alcuni concorrenti.
- PixVerse include GPT Image 2 nella sua lineup text-to-image insieme a Nano Banana 2 e Seedream, così un’immagine generata può passare direttamente in una pipeline image-to-video senza uscire dallo spazio di lavoro.
Cos’è GPT Image 2? Funzionalità chiave e limitazioni
GPT Image 2 è il modello immagine di seconda generazione di OpenAI, che sostituisce GPT Image 1.5 su ChatGPT e sull’API. Compete con Midjourney, DALL-E 3 e Stable Diffusion, ma punta la propria identità su due elementi: testo accurato all’interno delle immagini e un livello di ragionamento che interpreta l’intento del prompt invece di limitarsi ad abbinarne le parole chiave.
Funzionalità principali in breve
| Funzionalità | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Risoluzione nativa | 2K (con upscale a 4K) | 1K | 2K (con flag —hd) |
| Accuratezza rendering testo | 95%+ multilingue | ~70% (solo latino) | ~80% (solo latino) |
| Integrazione del ragionamento | Sì — interpreta istruzioni stratificate | No | No |
| Range aspect ratio | Da 3:1 a 1:3 | 1:1, 16:9 | Da 1:1 a 3:2 |
| Coerenza del personaggio | A livello di pixel tra immagini in sequenza | Limitata | Moderata (flag —cref) |
| Editing in linguaggio naturale | Sì — modifica le aree descrivendole | No | No |
| Prezzo | Basato su token via API; livelli di piano ChatGPT | Uguale | Abbonamento $10–30/mese |
Il rendering del testo è la funzionalità che attira più attenzione, e a ragione. I modelli immagine più datati trattavano il testo come una texture — chiedevate il titolo di un poster e ottenevate rumore a forma di lettere. GPT Image 2 gestisce titoli in inglese su più righe, caratteri cinesi e layout multilingue con una coerenza reale; nei nostri test, circa 19 generazioni su 20 sono risultate completamente leggibili al primo tentativo.
L’integrazione del ragionamento significa che il modello fa più che un semplice pattern-matching sulla vostra formulazione. Chiedetegli di “generare un’infografica che mostri le attività per il meteo di domani a San Francisco” e recupererà le previsioni, sceglierà attività pertinenti e costruirà un layout attorno a quei dati — un passo oltre il modo in cui Midjourney o Stable Diffusion elaborano un prompt.
L’editing in linguaggio naturale consente di rivedere un’immagine descrivendo la modifica invece di mascherarla manualmente. “Sposta la tazza di caffè sul lato sinistro del tavolo” oppure “cambia il cielo con un tramonto” vengono applicate come modifiche mirate senza rigenerare l’intera scena.
Cosa dicono gli utenti
Il feedback dal lancio è stato in gran parte positivo, con un insieme coerente di lamentele. I test di ritratti che circolano su X e Reddit sembrano vicini alla fotografia da studio, e i designer di poster che testano layout lunghi — volantini, menu, cartellonistica — riferiscono che l’accuratezza del testo finalmente regge nell’uso reale. Diversi designer hanno notato di poter saltare un passaggio in Photoshop per gli asset di marketing di base, perché il senso di composizione del modello è abbastanza forte da prendere decisioni di layout senza assistenza.
L’elogio più forte riguarda l’aderenza al prompt: chiedete 15 elementi specifici in una scena e GPT Image 2 tende a includerli tutti, mentre i modelli più vecchi iniziavano a perdere dettagli man mano che i prompt si allungavano.
Sul lato negativo, la fedeltà al brand resta incostante. Un test pratico ampiamente condiviso da ZDNet ha mostrato il modello fallire nel riprodurre accuratamente il logo ZDNET, e altri utenti hanno segnalato lo stesso problema con marchi specifici. Il modello capisce concettualmente cosa sia un logo, ma non riproduce in modo affidabile forme vettoriali esatte o caratteri tipografici proprietari.
Limitazioni note
- La riproduzione dei loghi di marca non è affidabile — componete i loghi esatti in Photoshop o Figma dopo la generazione invece di chiederli direttamente nel prompt.
- La velocità di generazione è inferiore a quella di modelli più leggeri come FLUX o Nano Banana 2, con 30–60 secondi tipici su ChatGPT Plus contro meno di 10 secondi altrove.
- I limiti di frequenza del piano gratuito sono stretti — circa due immagini al giorno per gli utenti gratuiti di ChatGPT. Gli abbonati Plus ottengono generazioni illimitate su ChatGPT, ma i costi API scalano con il volume.
- Il controllo dello stile è più grossolano rispetto a Midjourney. Non è possibile regolare con la stessa precisione il tipo di pellicola, l’obiettivo o la grana, e il bias estetico del modello richiede un lavoro deliberato sul prompt per essere superato.
- La policy sui contenuti è più severa rispetto alle alternative open-source, quindi alcuni prompt che funzionano bene su Stable Diffusion o su modelli locali qui verranno rifiutati.
Nessuno di questi punti esclude l’uso in produzione, ma vale la pena conoscerli prima di costruire una pipeline basata esclusivamente su un unico modello.
Come scrivere prompt per GPT Image 2 che funzionano davvero
Il cambiamento più chiaro nel nostro secondo round di test: i migliori prompt per GPT Image 2 non descrivono solo un’immagine — descrivono il compito che l’immagine deve svolgere. Un prompt per un’inserzione social dovrebbe leggersi in modo diverso da uno per un ritaglio prodotto, un’infografica, una schermata UI o un primo fotogramma destinato al video.
Uno schema affidabile per strutturare il brief:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Indicate il compito prima dello stile
Iniziate con il tipo di output — poster, inserzione prodotto, schermata app, scheda personaggio, diagramma, modifica o primo fotogramma per video — così il modello sa contro quale standard verrà giudicato.
Weak: A cool futuristic speaker, cinematic, high detail.
Better: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
La seconda versione dice al modello che verrà giudicato su layout e usabilità, non solo sull’estetica.
Trattate il testo come un asset bloccato
Mettete tra virgolette qualsiasi testo richiesto e specificate esattamente come deve essere reso — non chiedete “uno slogan” a meno che non vogliate che il modello inventi le parole al posto vostro.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Per testi più lunghi, dividete esplicitamente ogni riga nel prompt. Se una parola torna scritta male, rigenerate con un testo più corto, un carattere più grande e un’istruzione più rigida del tipo “solo testo esatto”.
Date al modello una macchina fotografica e un layout
Indicate direttamente la distanza della camera, l’angolazione, il posizionamento del soggetto, lo spazio negativo e l’aspect ratio — GPT Image 2 segue bene gli indizi di composizione, ma solo quando sono esplicitati.
- Primo piano per texture di prodotto, mani, volti, materiali, etichette.
- Campo lungo per ambienti, scene narrative, poster cittadini, fotogrammi pronti per il video.
- Dall’alto per cibo, scene da scrivania, flat-lay, kit di packaging.
- Terzo sinistro / terzo destro per layout pubblicitari che bilanciano testo e prodotto.
- Griglia pulita per mockup UI, schede personaggio, diagrammi, infografiche.
Scrivete le modifiche in tre frasi
I prompt di modifica più efficaci separano il cambiamento da ciò che deve restare intatto e dal realismo fisico che li tiene insieme:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Questa struttura “cambia, preserva, adatta” supera costantemente una vaga richiesta di “rendilo più bello”.
Aggiungete un indizio di movimento se il fermo immagine diventerà video
Se un’immagine potrebbe in seguito alimentare una pipeline image-to-video di PixVerse, chiedete fin dall’inizio profondità e prontezza al movimento: primo piano, piano intermedio, sfondo, una silhouette del soggetto pulita e un elemento visibile che potrebbe muoversi — polvere, tessuto, capelli, pioggia, riflesso o un percorso di spostamento della camera.
Instead of: An astronaut in a desert.
Use: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Come abbiamo testato GPT Image 2
In entrambi i round di test, abbiamo messo alla prova il modello su ritratti, poster con molto testo, composizioni in stile prodotto, schede personaggio, mockup UI e scene narrative sperimentali. L’obiettivo non era un punteggio da benchmark, ma capire se un designer, un marketer o un creator potesse pubblicare l’output con lievi modifiche invece di ricostruire l’asset da zero.
| Area di test | Cosa abbiamo verificato |
|---|---|
| Ritratti e fermi immagine cinematografici | Controllo dell’illuminazione, texture della pelle, riflessi, atmosfera, coerenza della scena |
| Layout di poster e tipografia | Ortografia del titolo, testo su più righe, gerarchia, spazio negativo, rifinitura simile a un brand |
| Schede personaggio e concept | Coerenza multi-vista, dettaglio dei costumi, allineamento della palette, accuratezza delle etichette |
| Mockup UI e social | Realismo del layout, testo piccolo, spaziatura delle icone, griglie feed, credibilità dello screenshot |
| Prompt sperimentali | Umorismo, ragionamento narrativo, posizionamento degli oggetti, accuratezza di didascalie piccole |
Il pattern si è confermato in entrambi i round: GPT Image 2 premia un brief preciso più di una catena di parole chiave. Quando un prompt indica il compito e definisce il successo — testo esatto, layout bloccato, struttura a pannelli ripetibile — il modello tende a preservare la struttura. Quando un prompt chiede solo un’atmosfera vaga, il risultato può comunque apparire curato, ma è più difficile da riutilizzare senza modifiche.
Casi d’uso di GPT Image 2 con esempi di prompt
Abbiamo messo sotto stress cinque capacità distinte in questi scenari: controllo dell’illuminazione, tipografia con testo esatto, composizione multi-elemento, coerenza del personaggio e layout UI. Ogni prompt qui sotto è pronto da copiare e adattare.
Fotografia ritratto cinematografica
Questo test verifica la comprensione del modello di illuminazione, atmosfera e composizione controllata — i fondamentali che distinguono un’immagine pronta per il portfolio da un render AI generico.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
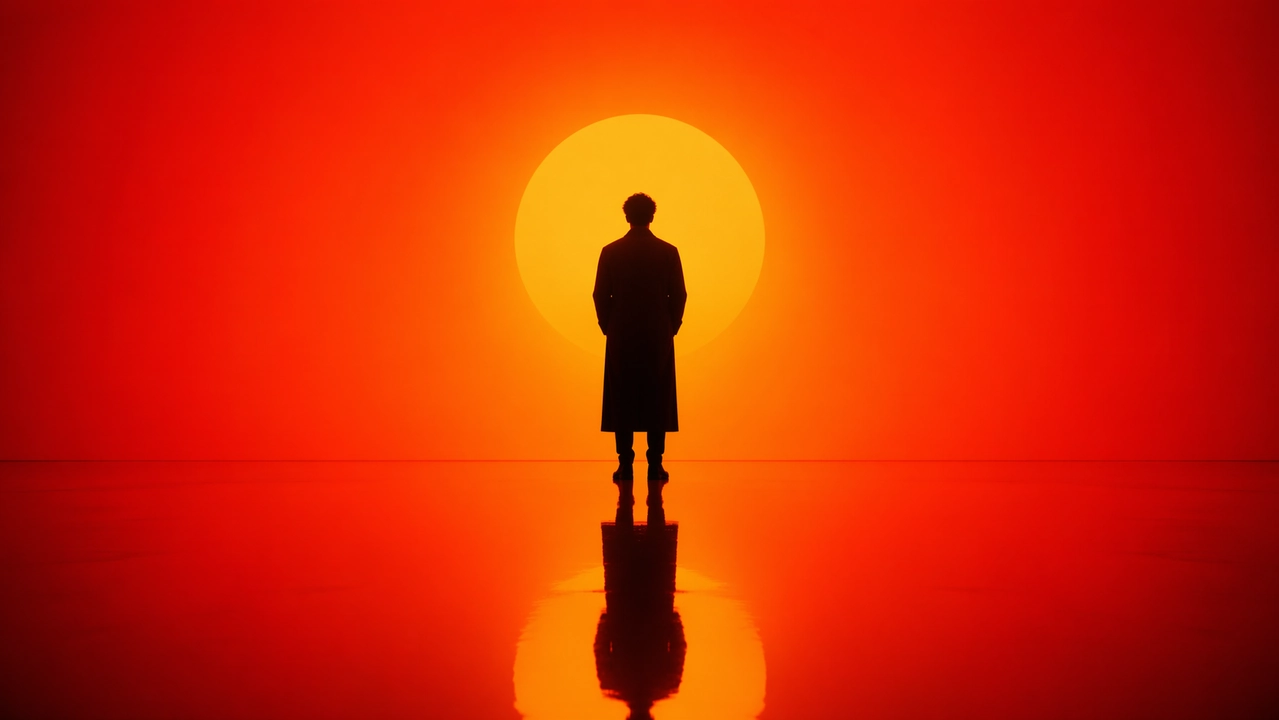
Cosa cercare: bordi puliti della silhouette senza artefatti a forma di alone, un riflesso sul pavimento accurato con prospettiva corretta, un gradiente uniforme (senza bande) e una posa che trasmetta un peso reale invece di apparire rigida o fluttuante.
Design di poster cittadino e illustrazione
Il test di stress più difficile per una tipografia leggibile abbinata a una composizione densa e multi-elemento — oltre dieci elementi visivi distinti disposti lungo una curva a S, con testo in inglese che deve sopravvivere intatto al render.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
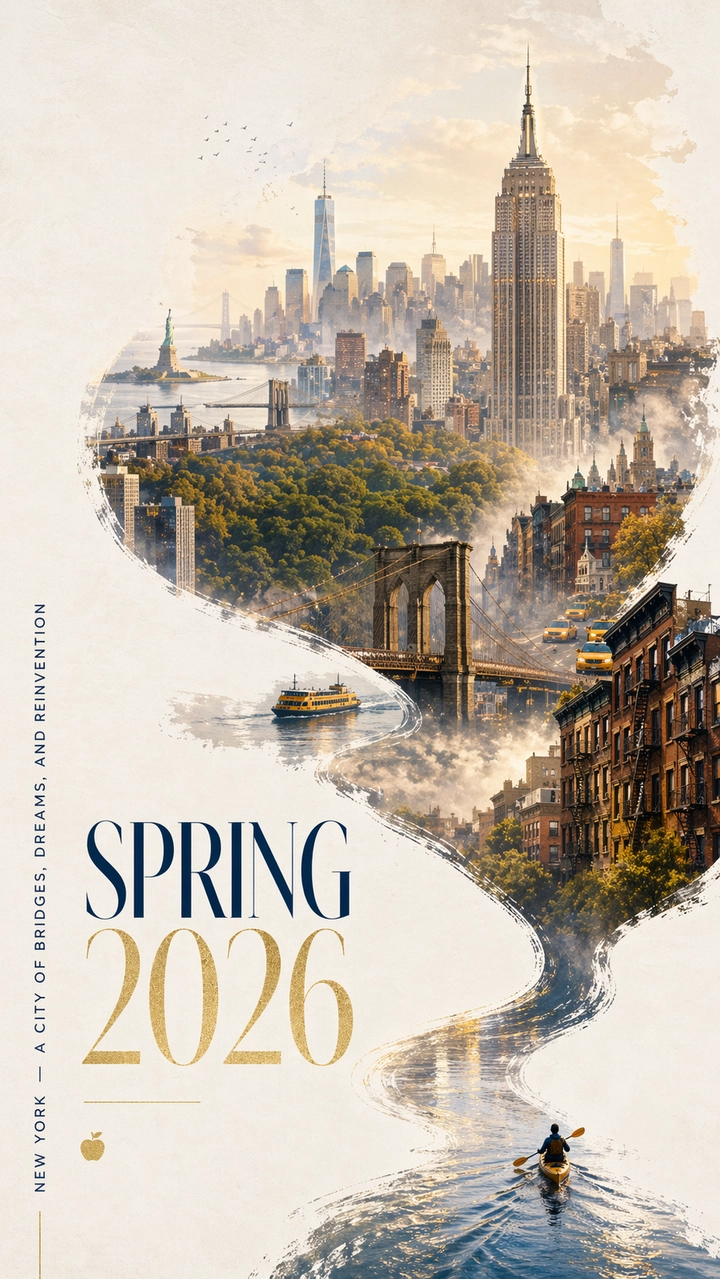
Cosa cercare: ogni lettera del titolo e dello slogan deve essere leggibile e ortograficamente corretta, la curva a S deve fluire naturalmente dal kayak allo skyline, gli edifici simbolo devono risultare riconoscibili e non torri generiche, e lo spazio negativo deve sembrare intenzionale e non semplicemente vuoto.
Design di personaggio e scheda di riferimento
Sviluppatori di giochi e concept artist hanno bisogno di coerenza multi-vista da un’unica generazione. Questo test verifica se il modello riesce a mantenere stabile il design di un personaggio tra vista frontale, laterale e posteriore.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
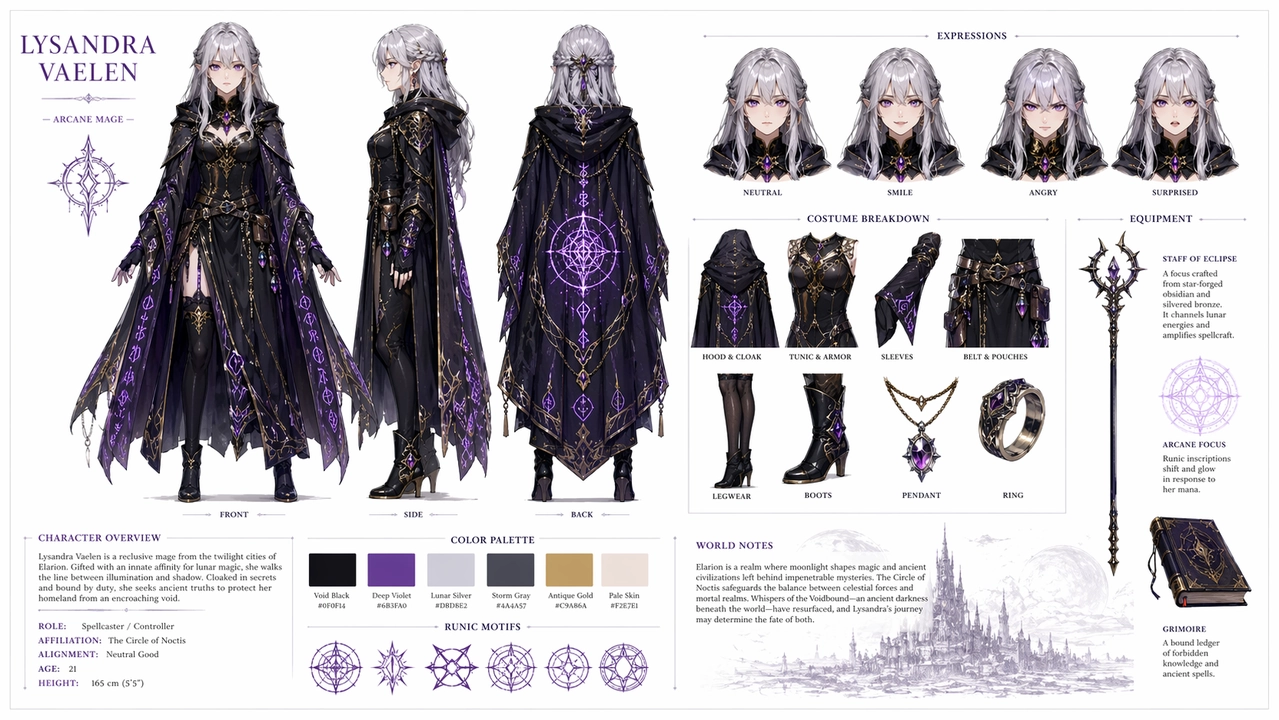
Cosa cercare: volto, capelli e abito devono restare coerenti in tutte e tre le viste; le variazioni di espressione devono cambiare solo il viso, non l’acconciatura o l’abbigliamento; la palette dei campioni deve corrispondere davvero ai colori usati nell’illustrazione; e le etichette di testo devono essere scritte correttamente. Se una vista laterale o posteriore devia, rigenerate rafforzando il linguaggio di “preservazione” ripetendo gli ancoraggi di identità.
Mockup UI e social media
Questo test mette alla prova tre cose insieme: layout UI accurato al pixel, rendering di testo multilingue e fusione creativa di concetti — il tipo di contenuto che tende anche a funzionare bene sulle piattaforme social.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
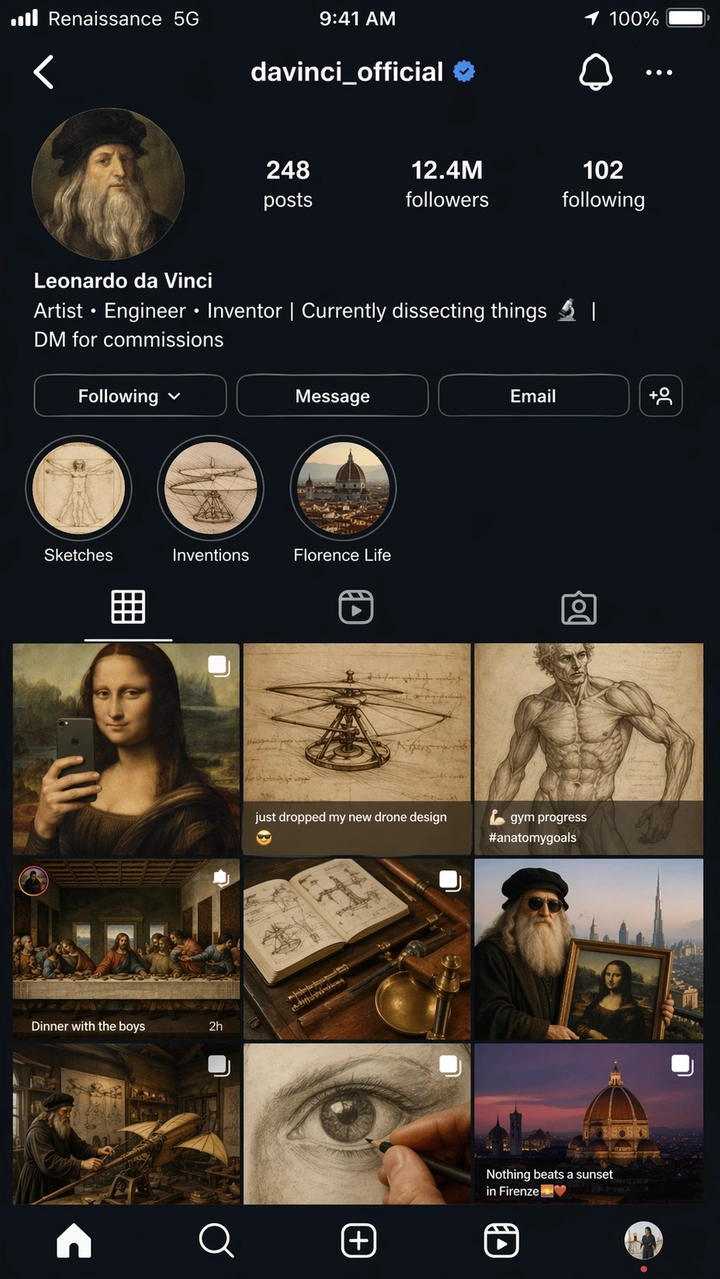
Cosa cercare: gli elementi dell’interfaccia Instagram — spaziatura della griglia, layout del profilo, cerchi delle storie, barra delle schede — devono leggersi come un vero screenshot iOS e non come un’approssimazione stilizzata. Tutto il testo deve essere leggibile, e l’etichetta operatore “Renaissance 5G” è un controllo di accuratezza deliberato. Trattate qualsiasi output di mockup UI come un riferimento concettuale piuttosto che come UI pronta per la produzione; le piccole etichette e l’allineamento delle icone di solito richiedono un passaggio di rifinitura.
Arte creativa e sperimentale
Prompt brevi con umorismo narrativo integrato verificano se il modello colma da solo le lacune creative invece di affidarsi a istruzioni esaustive.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
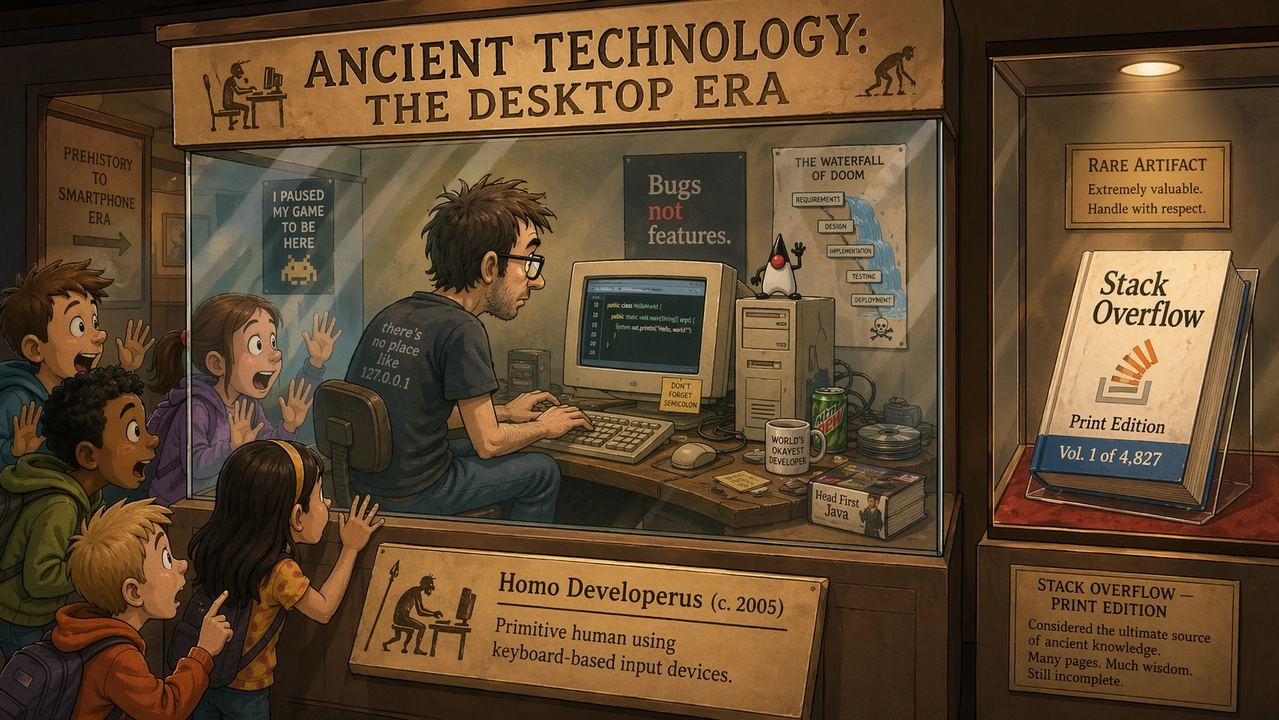
Cosa cercare: l’umorismo deve arrivare attraverso i dettagli visivi, non solo dal testo della didascalia. Il cartello e il titolo del libro devono restare leggibili e ortograficamente corretti — un test davvero difficile per un testo su più righe a dimensioni ridotte — e lo stile a cartone animato deve risultare coerente in tutta la scena, senza tratti fotorealistici a chiazze.
Risultati dei test per caso d’uso
I risultati più forti sono arrivati costantemente da prompt con uno standard di produzione evidente — qualcosa di giudicabile in base a ortografia, layout, preservazione degli oggetti o ordine dei pannelli. I prompt vaghi basati solo sull’atmosfera hanno prodotto risultati più variabili.
| Caso d’uso | Cosa ha funzionato bene | Cosa richiede ancora revisione |
|---|---|---|
| Rendering del testo | Titoli grandi, etichette brevi, titoli di poster ed etichette UI semplici sono rimasti accurati quando il testo esatto era tra virgolette. | Il testo legale minuscolo, i paragrafi densi e i font stilizzati possono ancora deviare — mantenete il testo breve e controllate ogni lettera. |
| Immagini di prodotto | Layout pubblicitari puliti, spazio negativo per campagne e composizioni incentrate sul prodotto hanno reso bene. | Etichette reali, loghi e affermazioni regolamentate richiedono ancora una revisione manuale o una composizione da asset approvati. |
| Mockup UI | Schermate mobili, dashboard e gerarchie in stile app apparivano plausibili quando il prompt indicava elementi di interfaccia reali. | Trattate gli output come mockup concettuali — le piccole etichette e l’allineamento delle icone di solito richiedono una rifinitura. |
| Coerenza del personaggio | Schede personaggio, righe di espressioni e campioni di palette hanno funzionato bene come riferimenti creativi. | Volti e dettagli dei costumi possono deviare tra le viste; ripetete gli ancoraggi di identità e rigenerate se necessario. |
| Editing e composizione | Il pattern “cambia, preserva, adatta” ha superato le richieste di modifica generiche. | I confini di selezione e l’output con sfondo trasparente richiedono ancora un controllo qualità. |
Errori comuni nel prompting di GPT Image 2
- Chiedere testo accurato senza fornire il testo esatto. Se il testo conta, scrivetelo per intero e indicate dove deve trovarsi.
- Sovraccaricare un singolo prompt con ogni dettaglio possibile. Iniziate con la scena principale, poi affinate una variabile alla volta.
- Dimenticare di specificare gli invarianti durante le modifiche. Precisate cosa deve restare invariato: identità, sfondo, posa, illuminazione, forma del prodotto, testo dell’etichetta, angolazione della camera.
- Affidarsi a parole decorative di qualità per compiti funzionali. “Bello” non rende leggibile un’etichetta — usate invece un linguaggio come “testo dell’etichetta nitido” o “leggibile a distanza”.
- Saltare l’aspect ratio. Un’immagine quadrata efficace può comunque fallire come inserzione verticale o miniatura video.
- Trattare i loghi come testo ordinario. GPT Image 2 può progettare concetti di logo, ma i marchi esatti dovrebbero essere composti da asset approvati invece di essere richiesti direttamente nel prompt.
Note su API e prezzi di GPT Image 2
La pagina dei prezzi API di OpenAI elenca GPT Image 2 su base token piuttosto che con una tariffa fissa per immagine:
| Voce | Prezzo indicato |
|---|---|
| Input immagine | $8,00 / 1M token |
| Input immagine in cache | $2,00 / 1M token |
| Output immagine | $30,00 / 1M token |
| Input testo | $5,00 / 1M token |
| Input testo in cache | $1,25 / 1M token |
Il costo effettivo per immagine dipende dalla lunghezza del prompt, dalle immagini di riferimento, dalla dimensione dell’output, dalla cache e dall’impostazione di qualità. Le quote dei piani ChatGPT costituiscono un binario separato rispetto alla fatturazione API — un abbonamento Plus non si traduce direttamente in credito API, quindi pianificate i due budget separatamente se usate entrambi.
Per i workflow ad alto volume, il numero che conta è il costo per asset accettato dopo i tentativi ripetuti, non il prezzo di listino di un singolo tentativo. Una generazione più economica non è realmente più economica se richiede tre rigenerazioni per correggere ortografia o layout.
| Workflow | Consiglio pratico di prompting |
|---|---|
| Poster o diagrammi con molto testo | Usate meno parole per immagine, citate il testo esatto tra virgolette, specificate esplicitamente la gerarchia. |
| Foto di prodotto | Bloccate forma del prodotto, etichetta, colore, materiale e angolazione della camera; ripetete l’elenco da preservare a ogni passaggio di modifica. |
| Mockup UI | Descrivete la schermata come un’interfaccia già rilasciata — navigazione, card, pulsanti, stati — non come concept art. |
| Modifiche multi-riferimento | Etichettate ogni immagine di input in base al ruolo: soggetto, stile, sfondo o riferimento materiale. |
| Generazione in batch | Tracciate il costo per immagine accettata, non il costo per tentativo. |
Se volete vedere come GPT Image 2 si confronta con un’alternativa orientata al fotorealismo su prompt identici, il nostro confronto tra GPT Image 2 e Nano Banana 2 esegue sei round testa a testa con un’analisi completa dei prezzi di API e piattaforma.
Dall’immagine al video: completate il vostro workflow creativo su PixVerse
Generare un’immagine efficace è un passo. Trasformarla in movimento è dove la maggior parte dei workflow si interrompe — finite un ritratto o un poster prodotto in GPT Image 2, poi dovete aprire uno strumento separato, ricaricare il file e sperare che il modello video non deformi la vostra immagine accuratamente composta. Questo attrito nel passaggio è esattamente ciò che PixVerse elimina.
GPT Image 2 è disponibile su PixVerse
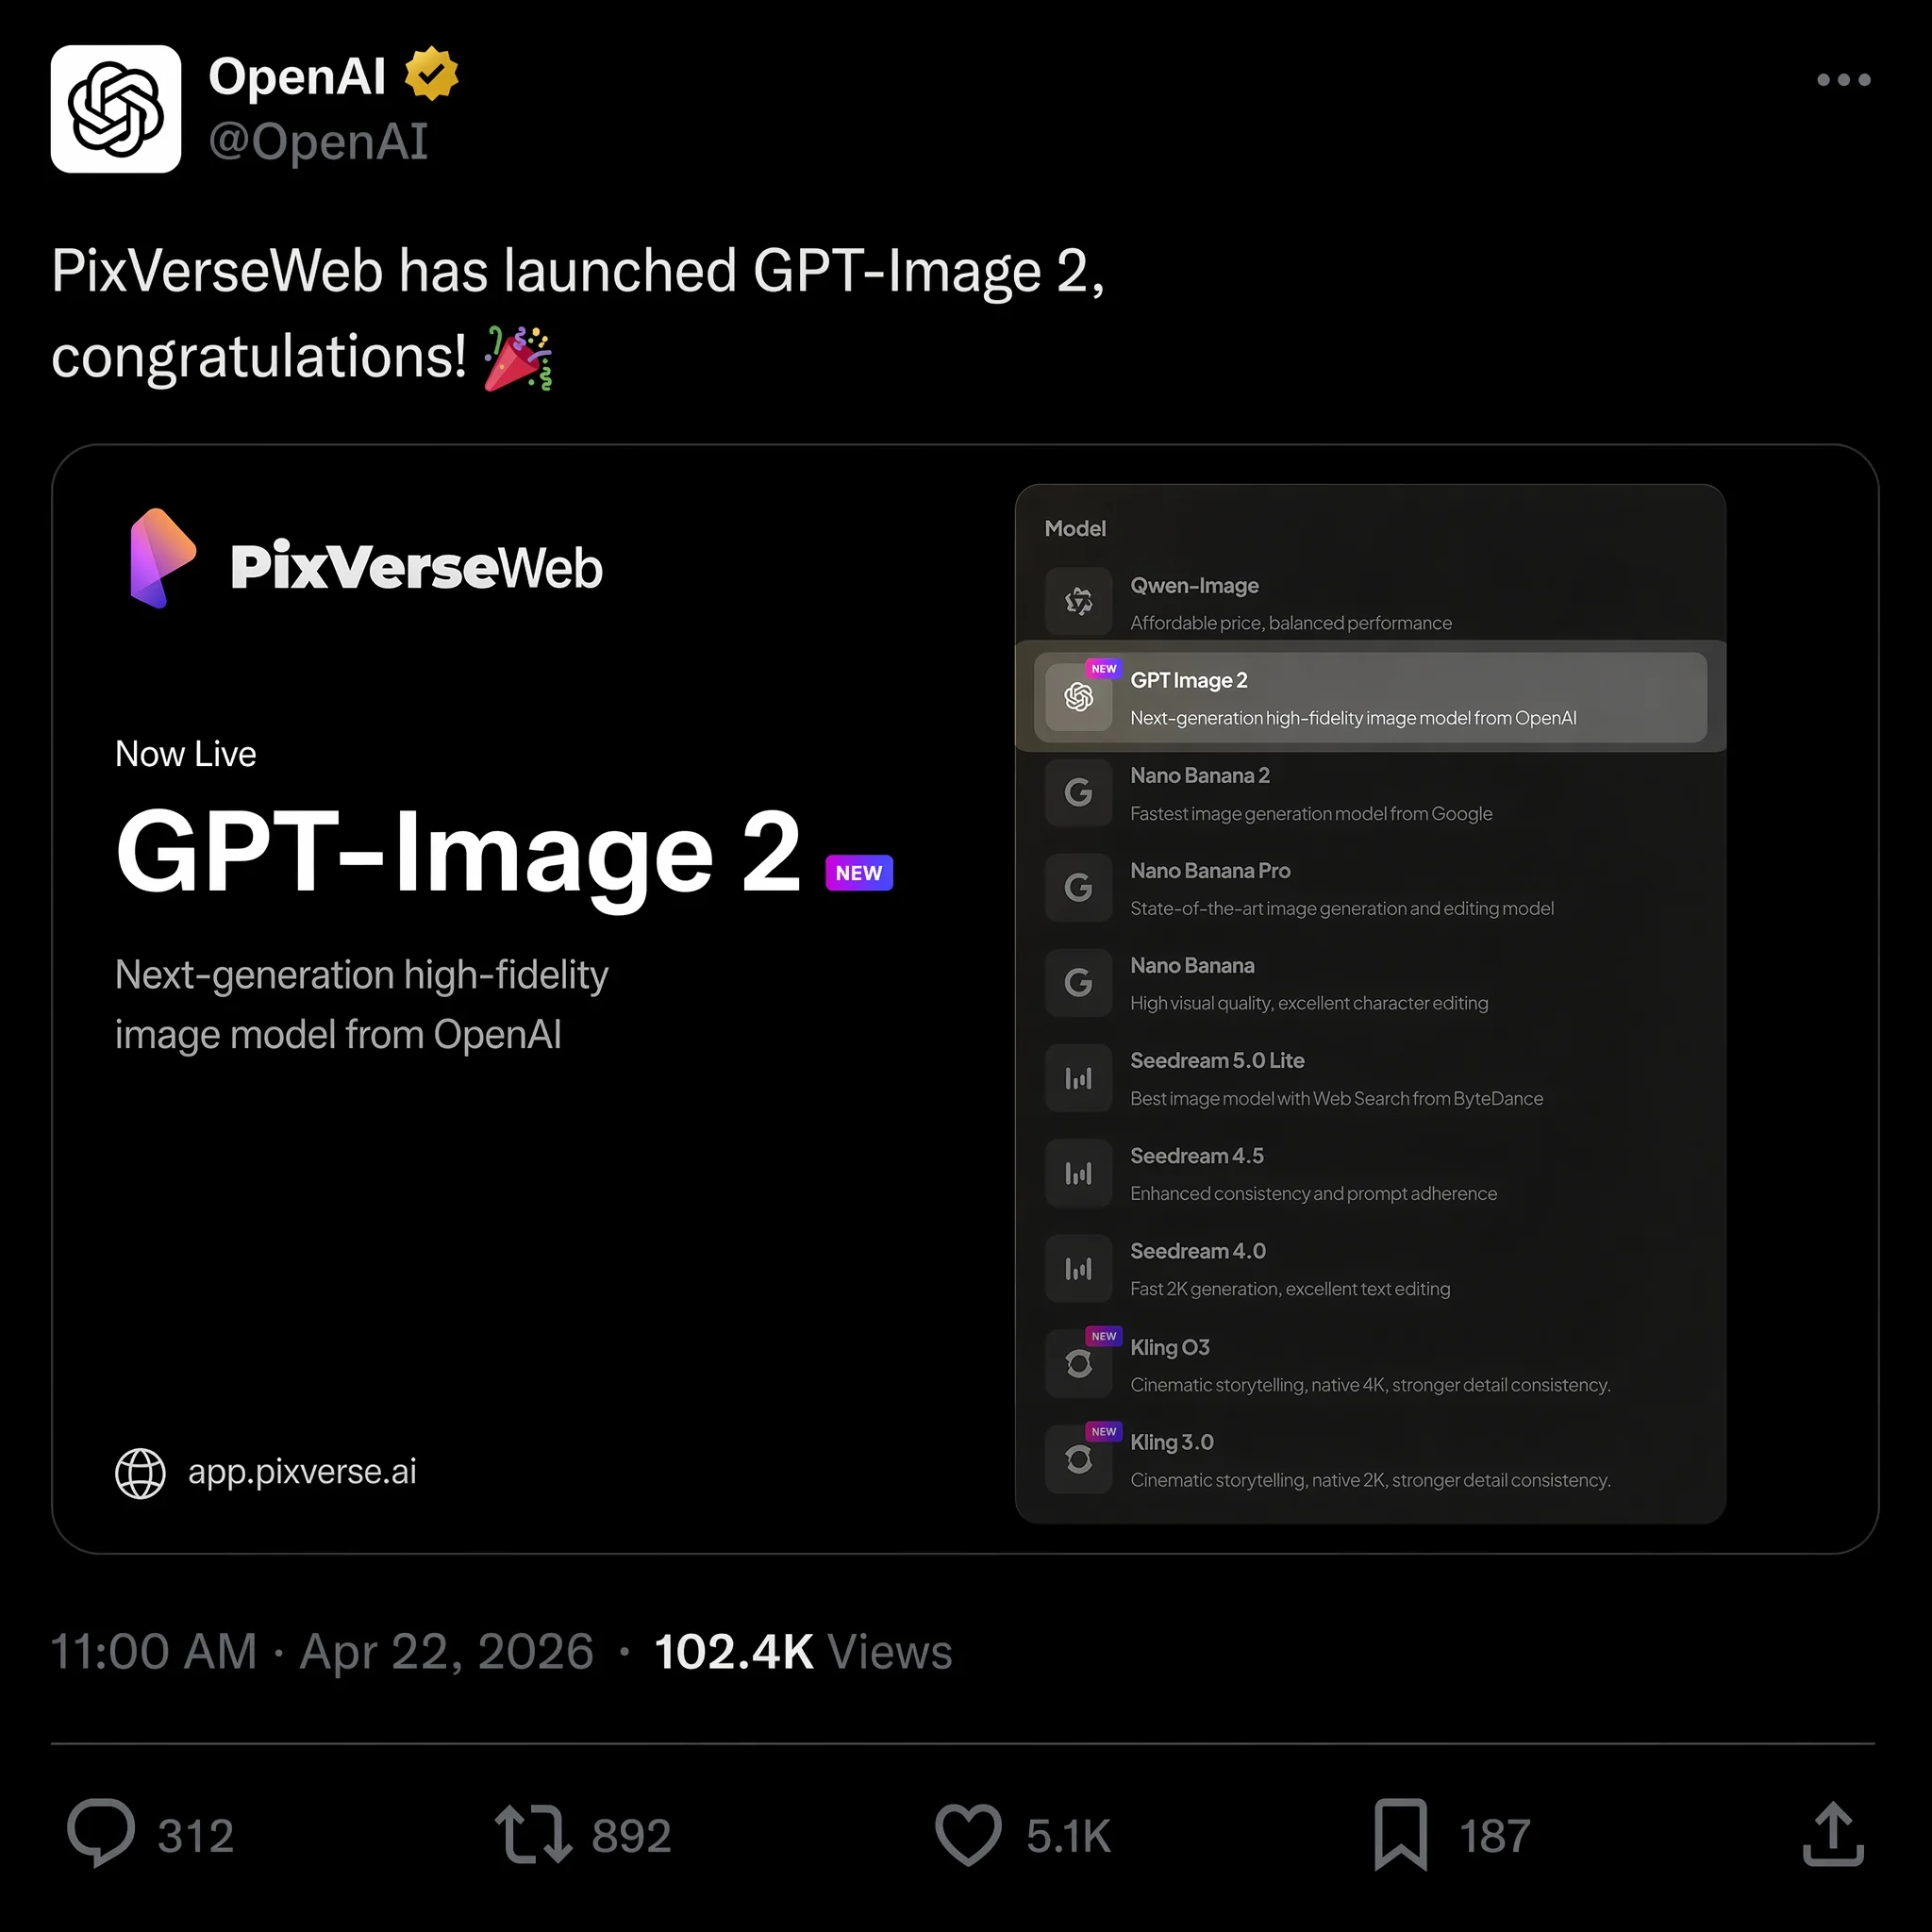
Il 22 aprile 2026, PixVerse ha aggiunto GPT Image 2 come opzione text-to-image, unendosi a Nano Banana 2, Seedream e HappyHorse 1.0 nella lineup di modelli. Potete generare un’immagine con GPT Image 2 e convertirla in video nello stesso spazio di lavoro, senza download, ricaricamenti o cambi di scheda.
Questo conta per una ragione concreta: quando l’immagine alimenta direttamente una pipeline image-to-video sulla stessa piattaforma, il modello video lavora a partire dal file sorgente a piena risoluzione e dai suoi metadati direttamente. Non c’è perdita di qualità dovuta a compressione o conversione di formato lungo il percorso, il che significa movimento più pulito e meno artefatti nella clip finale.
Se un fermo immagine è destinato a diventare una clip, chiedete fin dall’inizio la prontezza al movimento — richiedete profondità in primo piano, piano intermedio e sfondo, una silhouette del soggetto pulita e un elemento fisico che possa plausibilmente muoversi (polvere, vapore, tessuto, una fonte di luce che cambia). Rivedete il fermo immagine come un file di design finito prima di animarlo: controllate prima ortografia, geometria del prodotto e allineamento UI, poiché un modello video non correggerà da solo un titolo scritto male o un’etichetta deformata. Poi scrivete un prompt di movimento separato e più breve che descriva solo ciò che deve muoversi e ciò che deve restare bloccato, invece di ripetere l’intero brief dell’immagine.
Perché i creator stanno passando a una piattaforma all-in-one
Se usavate Sora di OpenAI per la generazione video prima di marzo 2026, conoscete già il rischio di costruire un workflow attorno a un singolo strumento. OpenAI ha chiuso l’app e l’API di Sora il 24 marzo, citando costi insostenibili e un pivot verso la robotica, e migliaia di creator hanno perso la propria pipeline video da un giorno all’altro. Consultate la nostra guida alle alternative a Sora per un resoconto completo di cosa è successo e quali strumenti hanno colmato il vuoto.
PixVerse adotta un approccio diverso, offrendo l’accesso a più modelli lungo l’intera pipeline creativa invece di vincolarvi a uno solo:
- Text-to-image con GPT Image 2, Nano Banana 2, Seedream e altri — scegliete il modello adatto al compito
- Image-to-video che converte le immagini generate in movimento con coerenza del personaggio e controllo della camera
- Text-to-video per clip generate direttamente da un prompt scritto usando PixVerse V6 o il modello cinematografico C1
- Generazione audio nativa che sincronizza automaticamente effetti sonori e dialoghi con il video
Il vantaggio pratico: potete passare da un concetto scritto a un video finito con audio sincronizzato senza uscire da un unico spazio di lavoro, il che elimina ore di gestione dei file da ogni progetto. Se preferite scriptare la generazione da riga di comando, la guida alla PixVerse CLI illustra come automatizzare sia la generazione di immagini che quella video.
PixVerse offre inoltre 30–60 crediti gratuiti giornalieri per i nuovi utenti, così potete testare l’intera pipeline — dalla generazione dell’immagine all’output video — prima di impegnarvi in un piano a pagamento.
Domande frequenti
GPT Image 2 è gratuito da usare?
Gli utenti gratuiti di ChatGPT possono generare circa due immagini al giorno con GPT Image 2. Gli abbonati ChatGPT Plus ($20/mese) ottengono generazioni illimitate con elaborazione più veloce. L’accesso API viene fatturato a token su input immagine, output immagine e input testo, quindi il costo scala con la lunghezza del prompt e la dimensione dell’output piuttosto che con una tariffa fissa per immagine.
Quale risoluzione supporta GPT Image 2?
GPT Image 2 genera immagini a risoluzione nativa 2K, con un upscale opzionale a 4K tramite API. Gli aspect ratio spaziano da 3:1 a 1:3, quindi i formati quadrati, verticali e ultra-larghi sono tutti disponibili direttamente.
GPT Image 2 può rendere il testo nelle immagini in modo accurato?
Sì — è una delle sue funzionalità più forti. Nei nostri test, l’accuratezza del testo in inglese, cinese, giapponese, coreano e arabo ha superato il 95% al primo tentativo di generazione. Titoli su più righe, titoli di poster ed etichette di testo UI vengono gestiti in modo affidabile, anche se il testo molto piccolo a basse risoluzioni può ancora sbagliare occasionalmente.
Come si confronta GPT Image 2 con Midjourney e Nano Banana 2?
Midjourney V8 ha controlli di stile artistico più forti e una comunità più consolidata per la rifinitura estetica. Nano Banana 2 è la scelta più forte per fotorealismo, illuminazione cinematografica e iterazione rapida. GPT Image 2 ha il vantaggio nel rendering del testo, nei layout strutturati e nell’editing in linguaggio naturale. Per il design di poster e materiali di marketing con testo, GPT Image 2 al momento vince; per la pura esplorazione artistica o gli scatti eroe fotorealistici, vale la pena confrontare gli altri due direttamente — vedete il nostro confronto testa a testa con Nano Banana 2.
Quali sono le migliori alternative a Sora per il video dopo la chiusura?
Dopo che OpenAI ha chiuso Sora a marzo 2026, le principali alternative includono PixVerse V6 per video multi-scena con personaggi coerenti, Runway Gen-4 per il controllo cinematografico della camera e Kling v3.0 per le sequenze d’azione. PixVerse è l’unica piattaforma che combina text-to-image, image-to-video e text-to-video con audio nativo, tutto accessibile con crediti gratuiti giornalieri. Consultate la nostra guida completa alle alternative a Sora per un confronto dettagliato.
Posso trasformare gli output di GPT Image 2 in video?
Sì. Con GPT Image 2 disponibile in PixVerse, potete generare l’immagine nell’app e convertirla in video usando la pipeline image-to-video nello stesso spazio di lavoro, senza bisogno di trasferimenti di file. Potete anche caricare un file GPT Image 2 creato altrove e farlo passare attraverso la stessa pipeline.