GPT Image 2 im Test: Prompt-Leitfaden und Anwendungsfälle 2026
OpenAI veröffentlichte GPT Image 2 am 21. April 2026 — den Nachfolger von GPT Image 1.5 und das Modell, das inzwischen die Bildgenerierung in ChatGPT antreibt. Wir haben es in der Launch-Woche getestet und Ende Juni mit einem breiteren Satz an Prompts, OpenAIs eigenem Prompting-Leitfaden und der veröffentlichten API-Preisliste erneut geprüft, um zu sehen, wie sich das Modell hält, sobald der anfängliche Hype abgeklungen ist.
Die wichtigsten Erkenntnisse:
- GPT Image 2 erzeugt Bilder in nativer 2K-Auflösung mit optionalem 4K-Upscaling, und die Textgenauigkeit liegt bei über 95 % über lateinische, chinesische, japanische, koreanische und arabische Schriftzeichen hinweg.
- Das Modell wird am besten als Design-Assistent behandelt, nicht als Foto-Generator: Es glänzt bei Aufgaben mit einem klaren Erfolgsmaßstab — exakter Text, ein festgelegtes Layout, eine wiederholbare Panel-Struktur — und wird bei offenen “mach es schön”-Prompts unberechenbarer.
- Die Reproduktion von Markenlogos, winziger Rechtstext und proprietäre Schriftarten bleiben Schwachpunkte, die weiterhin manuelle Nachbearbeitung erfordern.
- OpenAIs API berechnet GPT Image 2 tokenbasiert über Bild-Input, gecachten Bild-Input, Bild-Output, Text-Input und gecachten Text-Input — ein anderes Preismodell als die Preis-pro-Bild-Stufen, die manche Wettbewerber verwenden.
- PixVerse hat GPT Image 2 neben Nano Banana 2 und Seedream in seine Text-zu-Bild-Palette aufgenommen, sodass ein generiertes Bild direkt in eine Bild-zu-Video-Pipeline übergehen kann, ohne den Arbeitsbereich zu verlassen.
Was ist GPT Image 2? Kernfunktionen und Grenzen
GPT Image 2 ist OpenAIs Bildmodell der zweiten Generation und ersetzt GPT Image 1.5 sowohl in ChatGPT als auch in der API. Es konkurriert mit Midjourney, DALL-E 3 und Stable Diffusion, setzt seine Identität aber auf zwei Dinge: präzisen Text in Bildern und eine Reasoning-Ebene, die die Absicht eines Prompts interpretiert, statt nur dessen Schlüsselwörter abzugleichen.
Kernfunktionen im Überblick
| Funktion | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Native Auflösung | 2K (mit 4K-Upscale) | 1K | 2K (mit —hd-Flag) |
| Textgenauigkeit | 95%+ mehrsprachig | ~70% (nur Latein) | ~80% (nur Latein) |
| Reasoning-Integration | Ja — interpretiert mehrschichtige Anweisungen | Nein | Nein |
| Seitenverhältnis-Bereich | 3:1 bis 1:3 | 1:1, 16:9 | 1:1 bis 3:2 |
| Charakterkonsistenz | Pixelgenau über sequenzielle Bilder | Begrenzt | Moderat (—cref-Flag) |
| Bearbeitung in natürlicher Sprache | Ja — Regionen durch Beschreibung bearbeiten | Nein | Nein |
| Preisgestaltung | Tokenbasiert über API; ChatGPT-Plan-Stufen | Gleich | 10–30 $/Monat Abo |
Textrendering ist die Funktion, die die meiste Aufmerksamkeit erhält, und das aus gutem Grund. Ältere Bildmodelle behandelten Text als Textur — bei einer Poster-Headline kam meist buchstabenförmiges Rauschen heraus. GPT Image 2 handhabt mehrzeilige englische Headlines, chinesische Schriftzeichen und mehrsprachige Layouts mit echter Konsistenz; in unseren Tests kamen rund 19 von 20 Generierungen beim ersten Versuch vollständig lesbar heraus.
Reasoning-Integration bedeutet, dass das Modell mehr tut, als nur Ihre Formulierung nach Mustern abzugleichen. Bitten Sie es, “eine Infografik mit Aktivitäten für das morgige Wetter in San Francisco zu erstellen”, und es zieht die Vorhersage heran, wählt passende Aktivitäten aus und baut ein Layout um diese Daten herum — ein Schritt weiter, als Midjourney oder Stable Diffusion einen Prompt verarbeiten.
Bearbeitung in natürlicher Sprache erlaubt es, ein Bild durch Beschreibung der Änderung zu überarbeiten, statt es manuell zu maskieren. “Verschiebe die Kaffeetasse auf die linke Seite des Tisches” oder “ändere den Himmel zu Sonnenuntergang” wenden sich beide als gezielte Bearbeitungen an, ohne die gesamte Szene neu zu generieren.
Was Nutzer sagen
Das Feedback seit dem Launch ist überwiegend positiv, mit einem konstanten Satz an Beschwerden. Porträttests, die auf X und Reddit kursieren, wirken nah an Studiofotografie, und Posterdesigner, die langformatige Layouts testen — Flyer, Speisekarten, Beschilderung — berichten, dass die Textgenauigkeit im echten Einsatz endlich standhält. Mehrere Designer merkten an, dass sie einen Photoshop-Durchgang für einfache Marketing-Assets überspringen konnten, weil das eigene Kompositionsgefühl des Modells stark genug ist, um Layoutentscheidungen unassistiert zu treffen.
Das stärkste Lob konzentriert sich auf die Prompt-Treue: Fragen Sie nach 15 spezifischen Elementen in einer Szene, und GPT Image 2 neigt dazu, alle einzubeziehen, während ältere Modelle bei längeren Prompts anfingen, Details fallen zu lassen.
Auf der negativen Seite bleibt die Markentreue weiterhin inkonsistent. Ein weit geteilter Praxistest von ZDNet zeigte, dass das Modell das ZDNET-Logo nicht akkurat reproduzieren konnte, und andere Nutzer haben Ähnliches bei bestimmten Markenzeichen berichtet. Das Modell versteht konzeptionell, was ein Logo ist, reproduziert aber nicht zuverlässig exakte Vektorformen oder proprietäre Schriftarten.
Bekannte Einschränkungen
- Markenlogo-Reproduktion ist unzuverlässig — komponieren Sie exakte Logos nach der Generierung in Photoshop oder Figma, statt direkt danach zu prompten.
- Generierungsgeschwindigkeit hinkt leichteren Modellen wie FLUX oder Nano Banana 2 hinterher, mit typischerweise 30–60 Sekunden auf ChatGPT Plus gegenüber unter 10 Sekunden anderswo.
- Rate-Limits im kostenlosen Tarif sind eng gesetzt — etwa zwei Bilder pro Tag für kostenlose ChatGPT-Nutzer. Plus-Abonnenten erhalten unbegrenzte ChatGPT-Generierungen, aber die API-Kosten skalieren mit dem Volumen.
- Stilkontrolle ist gröber als bei Midjourney. Sie können Filmmaterial, Objektivtyp oder Korn nicht mit der gleichen Präzision einstellen, und die eigene ästhetische Neigung des Modells erfordert gezielte Prompt-Arbeit, um sie zu überschreiben.
- Inhaltsrichtlinien sind strenger als bei Open-Source-Alternativen, sodass manche Prompts, die bei Stable Diffusion oder lokalen Modellen problemlos funktionieren, hier abgelehnt werden.
Keiner dieser Punkte schließt den Produktiveinsatz aus, aber sie sind es wert, bekannt zu sein, bevor Sie eine Pipeline exklusiv um ein einzelnes Modell herum aufbauen.
Wie man GPT Image 2 Prompts schreibt, die wirklich funktionieren
Die deutlichste Verschiebung in unserer zweiten Testrunde: Die besten GPT Image 2 Prompts beschreiben nicht nur ein Bild — sie beschreiben die Aufgabe, die das Bild erfüllen muss. Ein Prompt für eine Social-Ad sollte anders klingen als ein Produkt-Cutout, eine Infografik, ein UI-Screen oder ein erster Frame für ein Video.
Ein zuverlässiges Muster zur Strukturierung des Briefings:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Nennen Sie die Aufgabe vor dem Stil
Führen Sie mit dem Output-Typ — Poster, Produktanzeige, App-Screen, Charakterblatt, Diagramm, Bearbeitung oder erster Video-Frame — damit das Modell weiß, an welchem Maßstab es gemessen wird.
Weak: A cool futuristic speaker, cinematic, high detail.
Better: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
Die zweite Version teilt dem Modell mit, dass es an Layout und Nutzbarkeit gemessen wird, nicht nur an der Ästhetik.
Behandeln Sie Text wie ein festgelegtes Asset
Setzen Sie erforderlichen Text in Anführungszeichen und geben Sie genau an, wie er gerendert werden soll — bitten Sie nicht um “einen Slogan”, es sei denn, Sie möchten, dass das Modell Wörter für Sie erfindet.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Bei längerem Text teilen Sie jede Zeile explizit im Prompt auf. Falls ein Wort falsch geschrieben zurückkommt, regenerieren Sie mit kürzerem Text, größerer Schrift und einer strengeren “nur exakter Text”-Anweisung.
Geben Sie dem Modell eine Kamera und ein Layout
Geben Sie Kameraabstand, Winkel, Motivplatzierung, Freiraum und Seitenverhältnis direkt an — GPT Image 2 folgt Kompositionshinweisen gut, aber nur wenn sie ausbuchstabiert sind.
- Nahaufnahme für Produkttextur, Hände, Gesichter, Materialien, Etiketten.
- Weitwinkel für Umgebungen, Erzählszenen, Stadtposter, videofertige Frames.
- Draufsicht für Essen, Schreibtischszenen, Flat-Lays, Verpackungssets.
- Linkes/rechtes Drittel für Anzeigenlayouts, die Text und Produkt ausbalancieren.
- Sauberes Raster für UI-Mockups, Charakterblätter, Diagramme, Infografiken.
Schreiben Sie Bearbeitungen in drei Sätzen
Die stärksten Bearbeitungs-Prompts trennen die Änderung von dem, was unangetastet bleiben muss, und von dem physikalischen Realismus, der beides zusammenhält:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Diese “ändern, bewahren, anpassen”-Struktur übertrifft konsistent eine vage “mach das schöner”-Anfrage.
Fügen Sie einen Bewegungshinweis hinzu, wenn das Standbild zu Video werden soll
Wenn ein Bild später eine PixVerse Bild-zu-Video-Pipeline speisen könnte, prompten Sie von Anfang an für Tiefe und Bewegungsbereitschaft: Vordergrund, Mittelgrund, Hintergrund, eine klare Motiv-Silhouette und einen sichtbaren Hinweis, der sich bewegen könnte — Staub, Stoff, Haare, Regen, Reflexion oder ein Kamerafahrt-Pfad.
Instead of: An astronaut in a desert.
Use: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Wie wir GPT Image 2 getestet haben
Über beide Testrunden hinweg haben wir das Modell durch Porträts, textlastige Poster, produktartige Kompositionen, Charakterblätter, UI-Mockups und experimentelle Erzählszenen laufen lassen. Das Ziel war kein Benchmark-Score — es ging darum, ob ein Designer, Vermarkter oder Kreativer den Output mit leichten Anpassungen ausliefern könnte, statt das Asset von Grund auf neu zu bauen.
| Testbereich | Was wir geprüft haben |
|---|---|
| Porträts und filmische Standbilder | Lichtkontrolle, Hauttextur, Reflexionen, Stimmung, Szenenkonsistenz |
| Poster- und Typografie-Layouts | Headline-Rechtschreibung, mehrzeiliger Text, Hierarchie, Freiraum, markenähnlicher Feinschliff |
| Charakter- und Konzeptblätter | Konsistenz über mehrere Ansichten, Kostümdetails, Paletten-Abgleich, Beschriftungsgenauigkeit |
| UI- und Social-Mockups | Layout-Realismus, kleiner Text, Icon-Abstände, Feed-Raster, Screenshot-Glaubwürdigkeit |
| Experimentelle Prompts | Humor, narratives Reasoning, Objektplatzierung, Genauigkeit kleiner Bildunterschriften |
Das Muster hielt sich über beide Runden hinweg: GPT Image 2 belohnt ein präzises Briefing mehr als eine Kette von Schlüsselwörtern. Wenn ein Prompt die Aufgabe benennt und Erfolg definiert — exakter Text, ein festgelegtes Layout, eine wiederholbare Panel-Struktur —, neigt das Modell dazu, die Struktur zu bewahren. Wenn ein Prompt nur nach einer vagen Stimmung fragt, kann das Ergebnis trotzdem gepflegt aussehen, ist aber schwerer ohne Nachbearbeitung wiederzuverwenden.
GPT Image 2 Anwendungsfälle mit Prompt-Beispielen
Wir haben fünf unterschiedliche Fähigkeiten in diesen Szenarien einem Stresstest unterzogen: Lichtkontrolle, exakte Text-Typografie, Komposition mit mehreren Elementen, Charakterkonsistenz und UI-Layout. Jeder Prompt unten ist bereit zum Kopieren und Anpassen.
Filmische Porträtfotografie
Dies prüft das Verständnis des Modells für Licht, Atmosphäre und zurückhaltende Komposition — die Grundlagen, die ein portfoliofertiges Bild von einem generischen KI-Render unterscheiden.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
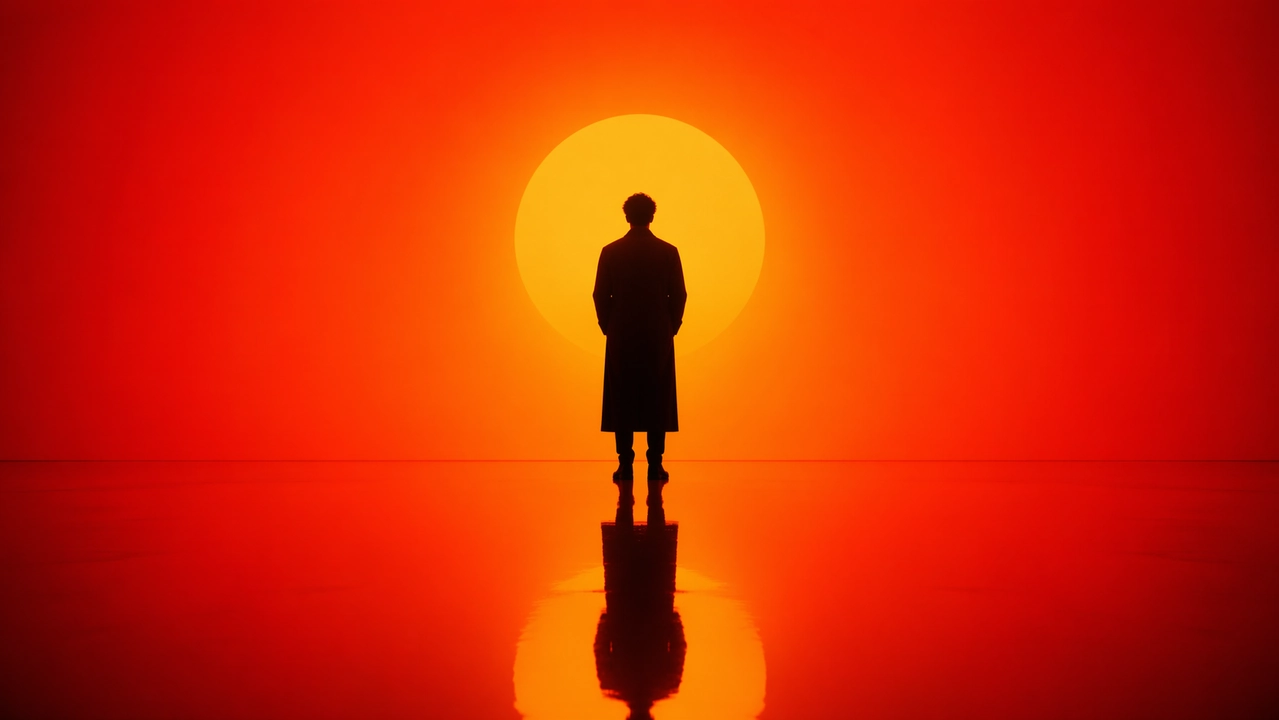
Worauf zu achten ist: saubere Silhouettenkanten ohne Halo-Artefakte, eine akkurate Bodenreflexion mit korrekter Perspektive, ein glatter (nicht gebänderter) Verlauf und eine Pose, die echtes Gewicht trägt, statt steif oder schwebend zu wirken.
Stadtposter- und Illustrationsdesign
Der härteste Stresstest für lesbare Typografie gepaart mit einer dichten, mehrelementigen Komposition — mehr als zehn eigenständige visuelle Elemente entlang einer S-Kurve angeordnet, mit englischem Text, der das Rendering unversehrt überstehen muss.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
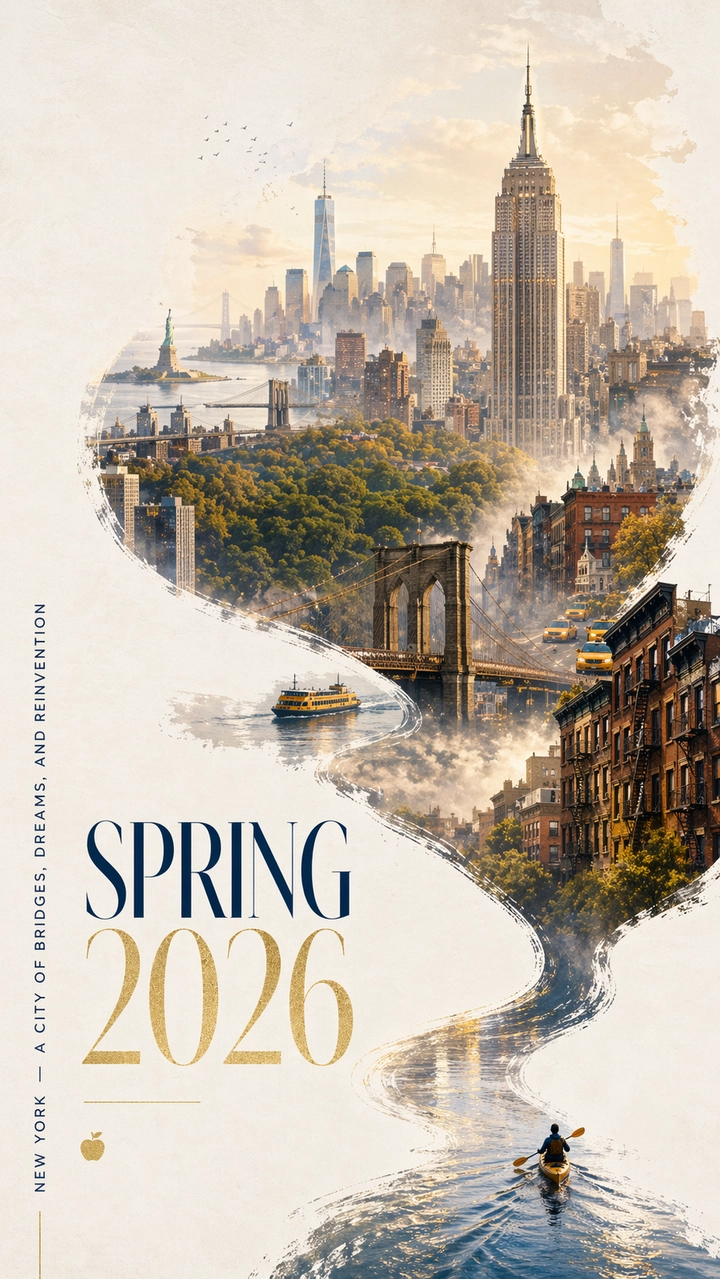
Worauf zu achten ist: Jeder Buchstabe im Titel und Slogan sollte lesbar und korrekt geschrieben sein, die S-Kurve sollte natürlich vom Kajakfahrer zur Skyline fließen, Wahrzeichen-Gebäude sollten als erkennbar und nicht als generische Türme wirken, und der Freiraum sollte beabsichtigt statt leer wirken.
Charakterdesign und Referenzblatt
Spieleentwickler und Konzeptkünstler benötigen Konsistenz über mehrere Ansichten aus einer einzigen Generierung. Dies prüft, ob das Modell das Design eines Charakters über Front-, Seiten- und Rückansicht stabil halten kann.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
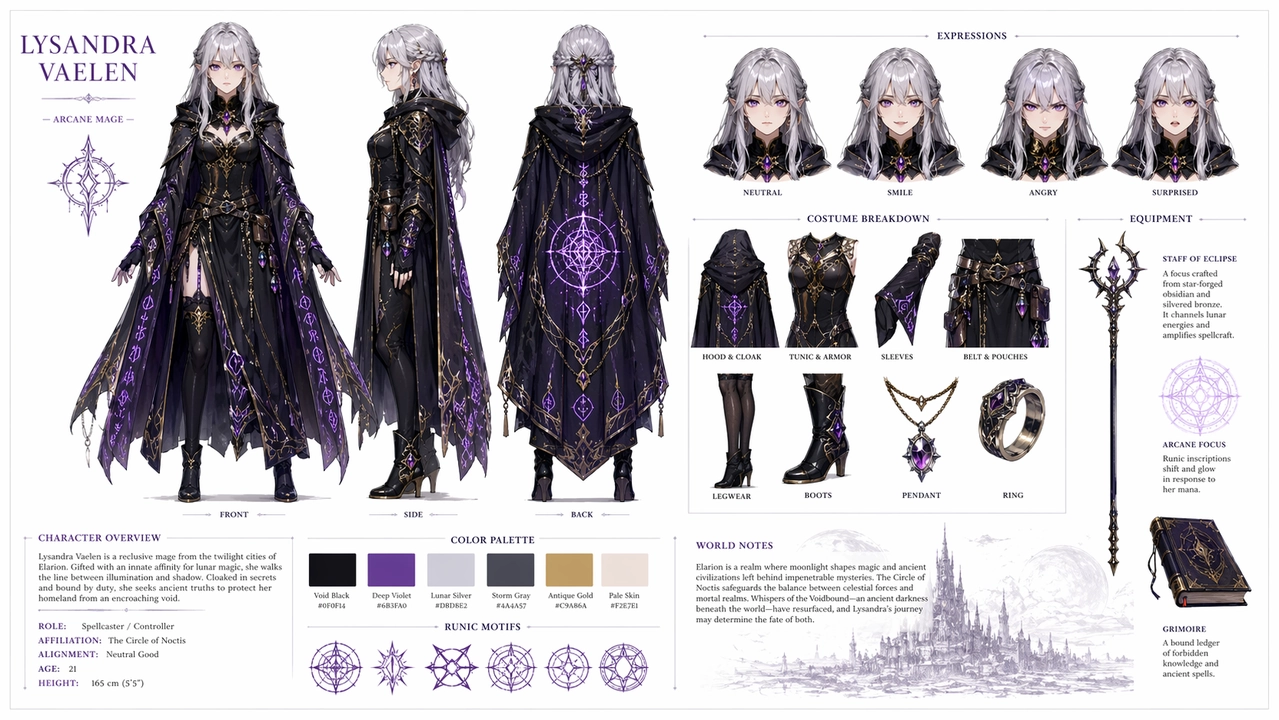
Worauf zu achten ist: Gesicht, Haare und Outfit sollten über alle drei Ansichten konsistent bleiben; Ausdrucksvariationen sollten nur das Gesicht verändern, nicht die Frisur oder Kleidung; die Farbpalette sollte tatsächlich zu den in der Kunst verwendeten Farben passen; und Textbeschriftungen sollten korrekt geschrieben sein. Falls eine Seiten- oder Rückansicht abweicht, regenerieren Sie mit stärkerer “bewahren”-Sprache, die die Identitätsanker wiederholt.
UI- und Social-Media-Mockup
Dies fordert drei Dinge gleichzeitig: pixelgenaues UI-Layout, mehrsprachiges Textrendering und kreative Konzeptfusion — genau die Art von Inhalt, die sich auf Social-Plattformen tendenziell auch gut performen lässt.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
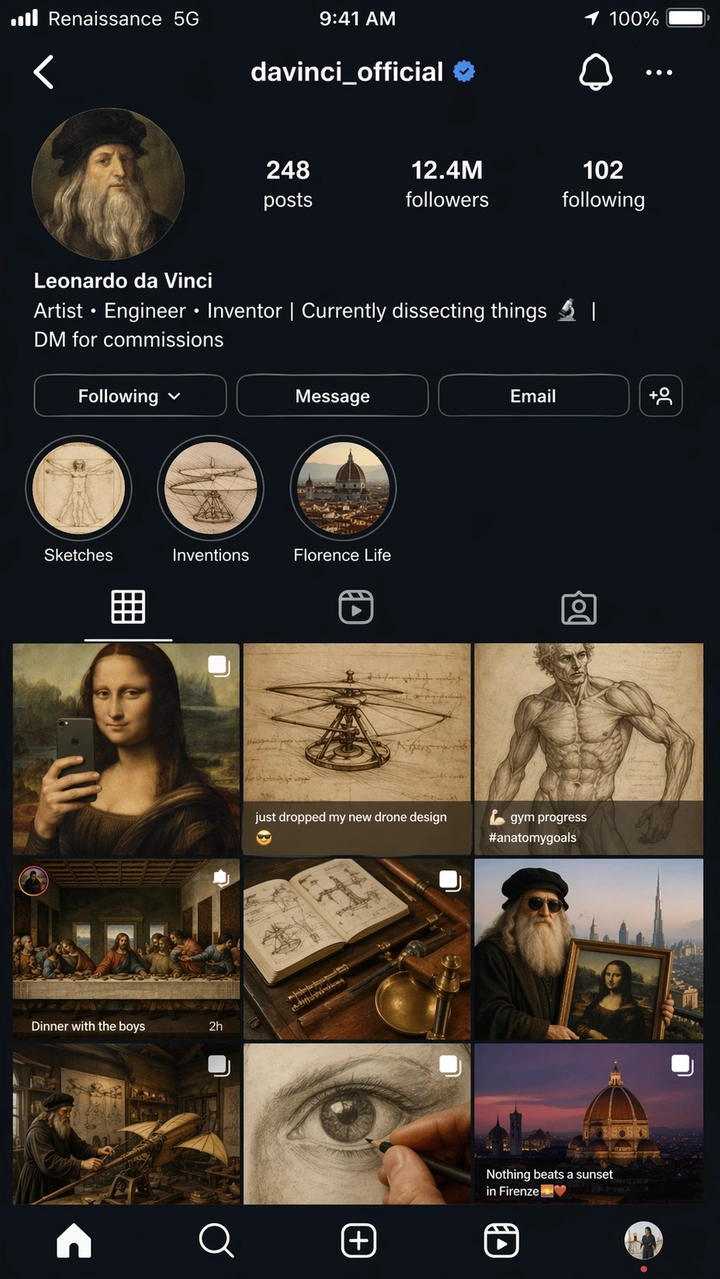
Worauf zu achten ist: die Instagram-UI-Elemente — Rasterabstände, Profillayout, Story-Kreise, Tab-Leiste — sollten wie ein echter iOS-Screenshot wirken statt eine stilisierte Annäherung. Aller Text sollte lesbar sein, und das Label “Renaissance 5G” ist ein bewusster Genauigkeitstest. Behandeln Sie jeden UI-Mockup-Output als Konzeptreferenz statt als produktionsfertiges UI; kleine Beschriftungen und Icon-Ausrichtung benötigen meist eine Nachbearbeitung.
Kreative und experimentelle Kunst
Kurze Prompts mit eingebautem narrativem Humor prüfen, ob das Modell kreative Lücken selbstständig füllt, statt sich auf erschöpfende Anweisungen zu verlassen.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
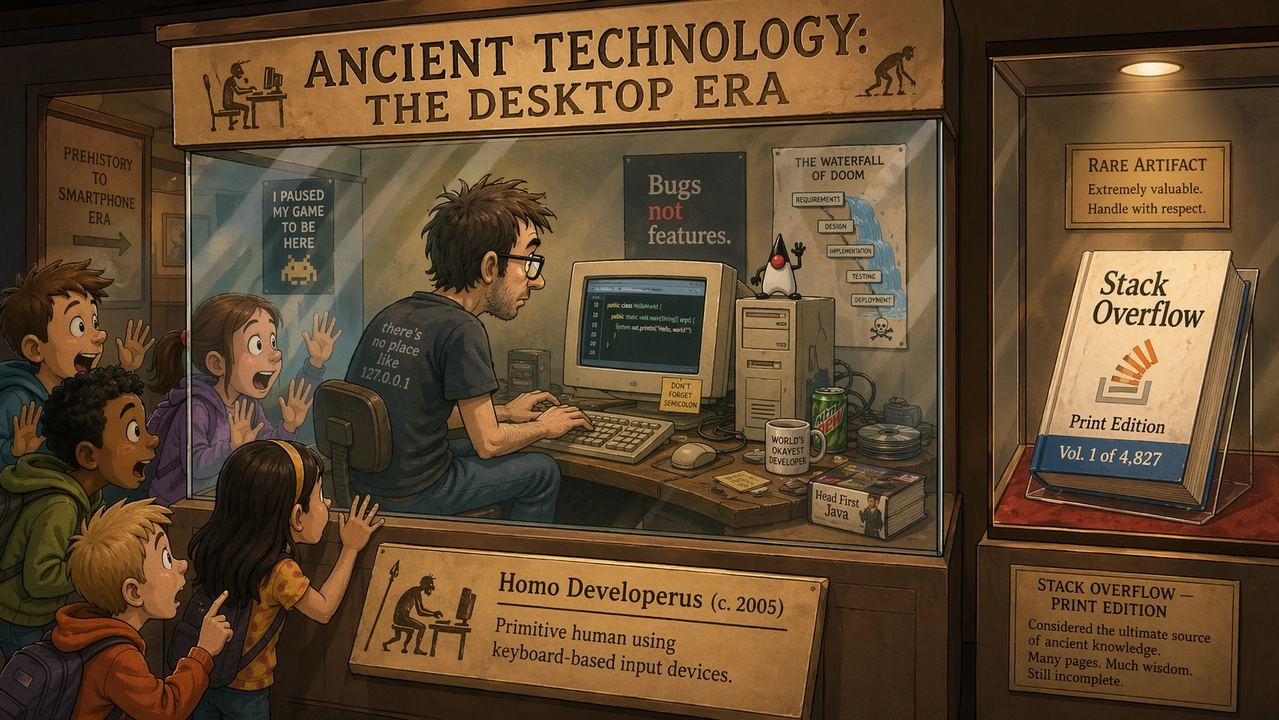
Worauf zu achten ist: der Humor sollte durch visuelle Details wirken, nicht nur durch den Beschreibungstext. Das Schild und der Buchtitel müssen lesbar und korrekt geschrieben bleiben — ein wirklich harter Test für mehrzeiligen Text in kleiner Größe — und der Cartoon-Stil sollte über die gesamte Szene hinweg kohärent wirken statt in Teilen fotorealistisch.
Testergebnisse nach Anwendungsfall
Die stärksten Ergebnisse kamen konsistent aus Prompts mit einem offensichtlichen Produktionsmaßstab — etwas, das anhand von Rechtschreibung, Layout, Objekterhaltung oder Panel-Reihenfolge beurteilbar ist. Vage, nur stimmungsbasierte Prompts erzeugten variablere Ergebnisse.
| Anwendungsfall | Was gut funktionierte | Was noch überprüft werden muss |
|---|---|---|
| Textrendering | Große Headlines, kurze Labels, Postertitel und einfache UI-Labels blieben akkurat, wenn der exakte Text zitiert wurde. | Winziger Rechtstext, dichte Absätze und stilisierte Schriften können immer noch abweichen — halten Sie Text kurz und prüfen Sie jeden Buchstaben. |
| Produktbilder | Saubere Anzeigenlayouts, Kampagnen-Freiraum und produktorientierte Kompositionen wurden gut gerendert. | Echte Etiketten, Logos und regulierte Aussagen benötigen weiterhin manuelle Prüfung oder Zusammensetzung aus freigegebenen Assets. |
| UI-Mockups | Mobile Bildschirme, Dashboards und app-ähnliche Hierarchien wirkten plausibel, wenn der Prompt echte Interface-Elemente benannte. | Behandeln Sie Outputs als Konzept-Mockups — kleine Labels und Icon-Ausrichtung benötigen meist Nachbearbeitung. |
| Charakterkonsistenz | Charakterblätter, Ausdrucksreihen und Farbpaletten funktionierten gut als kreative Referenzen. | Gesichter und Kostümdetails können über Ansichten hinweg abweichen; wiederholen Sie Identitätsanker und regenerieren Sie bei Bedarf. |
| Bearbeitung und Compositing | Das “ändern, bewahren, anpassen”-Muster übertraf breite Bearbeitungsanfragen. | Auswahlgrenzen und transparenter Hintergrund-Output benötigen weiterhin QA. |
Häufige Fehler beim Prompten von GPT Image 2
- Nach akkuratem Text fragen, ohne exakten Text bereitzustellen. Wenn Text wichtig ist, schreiben Sie ihn wortwörtlich aus und geben Sie an, wo er hingehört.
- Einen einzelnen Prompt mit jedem möglichen Detail überladen. Beginnen Sie mit der Kernszene und verfeinern Sie dann eine Variable nach der anderen.
- Vergessen, Invarianten bei Bearbeitungen anzugeben. Buchstabieren Sie aus, was unverändert bleiben muss: Identität, Hintergrund, Pose, Beleuchtung, Produktform, Etikettentext, Kamerawinkel.
- Sich bei funktionalen Aufgaben auf dekorative Qualitätswörter verlassen. “Schön” macht ein Etikett nicht lesbar — verwenden Sie stattdessen Formulierungen wie “scharfer Etikettentext” oder “aus der Distanz lesbar”.
- Das Seitenverhältnis auslassen. Ein starkes quadratisches Bild kann als vertikale Anzeige oder Video-Thumbnail trotzdem scheitern.
- Logos wie gewöhnlichen Text behandeln. GPT Image 2 kann Logo-Konzepte entwerfen, aber exakte Markenzeichen sollten aus freigegebenen Assets zusammengesetzt statt direkt geprompted werden.
GPT Image 2 API- und Preishinweise
OpenAIs API-Preisseite listet GPT Image 2 auf Token-Basis statt zu einem pauschalen Preis pro Bild:
| Posten | Gelisteter Preis |
|---|---|
| Bild-Input | 8,00 $ / 1 Mio. Token |
| Gecachter Bild-Input | 2,00 $ / 1 Mio. Token |
| Bild-Output | 30,00 $ / 1 Mio. Token |
| Text-Input | 5,00 $ / 1 Mio. Token |
| Gecachter Text-Input | 1,25 $ / 1 Mio. Token |
Die tatsächlichen Kosten pro Bild hängen von Prompt-Länge, Referenzbildern, Output-Größe, Caching und Qualitätseinstellung ab. ChatGPT-Plan-Kontingente sind eine separate Rechnungsspur von der API-Abrechnung — ein Plus-Abo übersetzt sich nicht direkt in API-Guthaben, budgetieren Sie also beide unabhängig voneinander, wenn Sie beide nutzen.
Für Workflows mit hohem Volumen zählt die Kennzahl Kosten pro akzeptiertem Asset nach Wiederholungen, nicht der Listenpreis eines einzelnen Versuchs. Eine günstigere Generierung ist nicht wirklich günstiger, wenn sie drei Regenerationen braucht, um Rechtschreibung oder Layout richtig hinzubekommen.
| Workflow | Praktischer Prompting-Tipp |
|---|---|
| Textlastige Poster oder Diagramme | Verwenden Sie weniger Wörter pro Bild, zitieren Sie exakten Text, geben Sie die Hierarchie explizit an. |
| Produktfotos | Legen Sie Produktform, Etikett, Farbe, Material und Kamerawinkel fest; wiederholen Sie die Bewahren-Liste bei jedem Bearbeitungsdurchgang. |
| UI-Mockups | Beschreiben Sie den Bildschirm als ausgeliefertes Interface — Navigation, Karten, Buttons, Zustände — nicht als Konzeptkunst. |
| Bearbeitungen mit mehreren Referenzen | Beschriften Sie jedes Eingabebild nach Rolle: Motiv, Stil, Hintergrund, Outfit oder Materialreferenz. |
| Batch-Generierung | Verfolgen Sie die Kosten pro akzeptiertem Bild, nicht die Kosten pro Versuch. |
Wenn Sie sehen möchten, wie sich GPT Image 2 gegenüber einer auf Fotorealismus ausgerichteten Alternative bei identischen Prompts schlägt, durchläuft unser GPT Image 2 vs. Nano Banana 2 Vergleich sechs direkte Vergleichsrunden mit vollständigen API- und Plattform-Preisaufschlüsselungen.
Vom Bild zum Video: Vervollständigen Sie Ihren kreativen Workflow auf PixVerse
Ein starkes Bild zu generieren ist ein Schritt. Es in Bewegung zu verwandeln ist der Punkt, an dem die meisten Workflows scheitern — Sie vollenden ein Porträt oder ein Produktposter in GPT Image 2 und müssen dann ein separates Tool öffnen, die Datei erneut hochladen und hoffen, dass das Video-Modell Ihr sorgfältig komponiertes Bild nicht verzerrt. Genau diese Übergabe-Reibung entfernt PixVerse.
GPT Image 2 ist live auf PixVerse
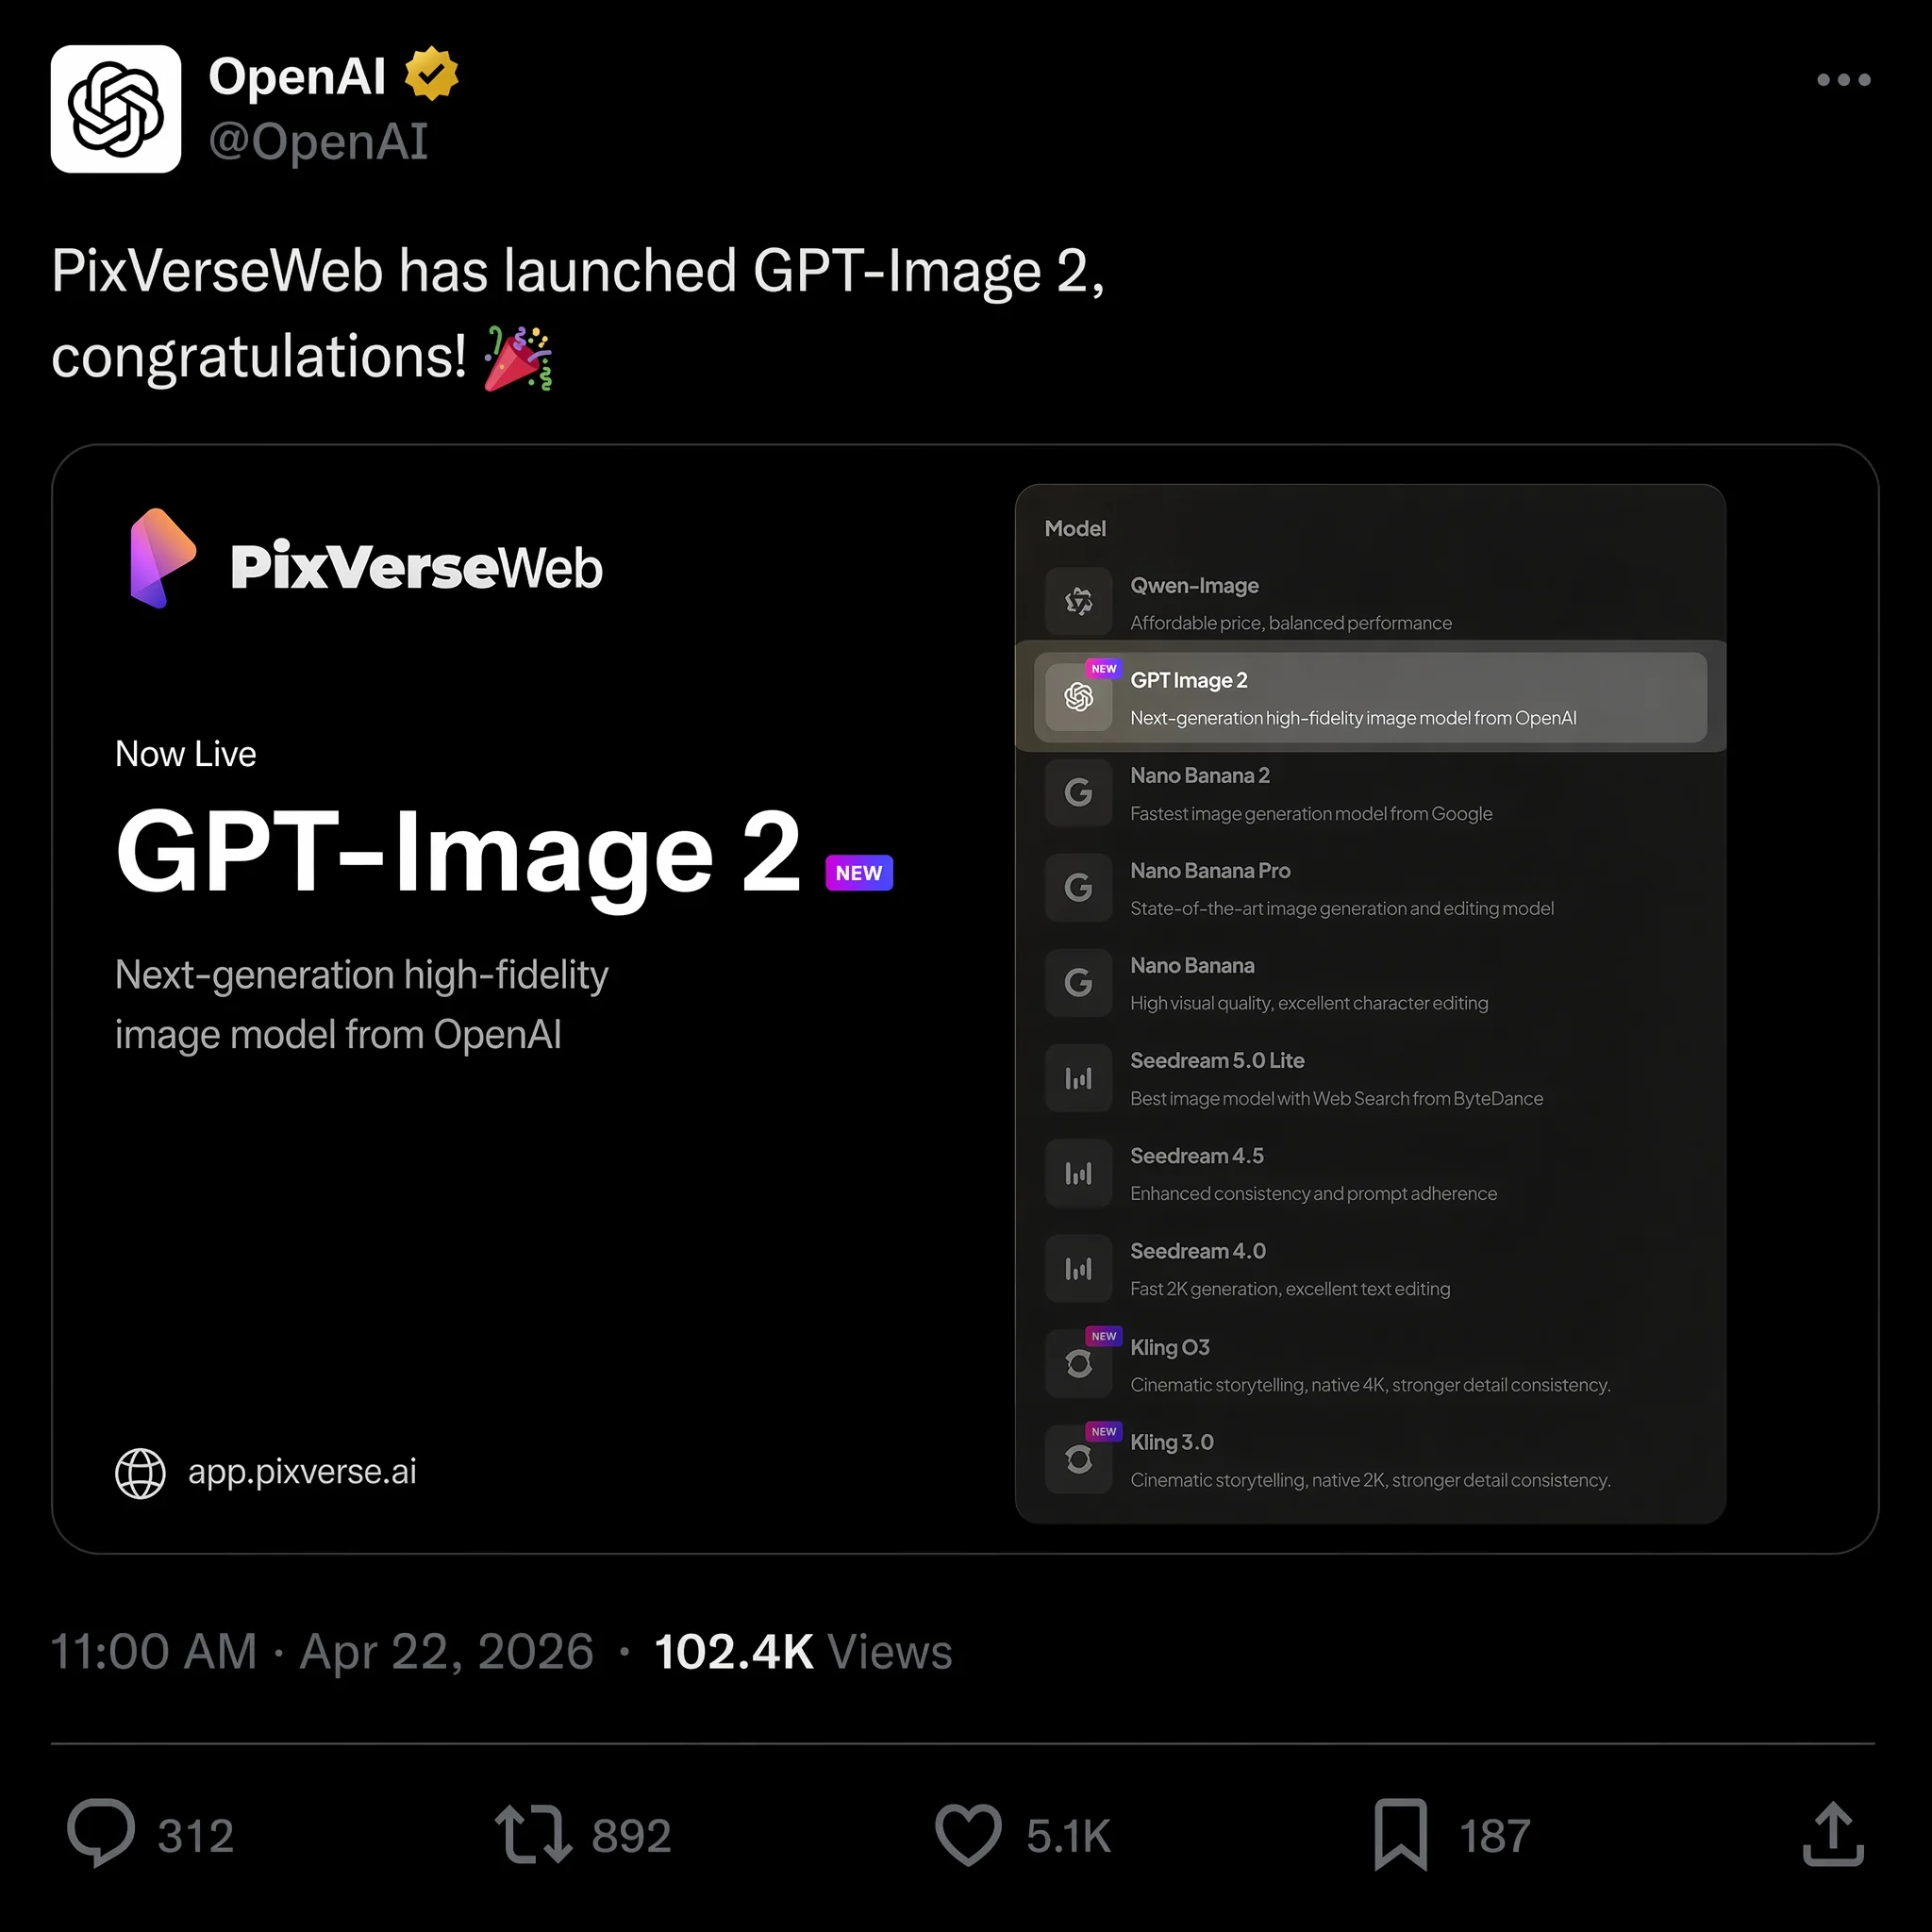
Am 22. April 2026 fügte PixVerse GPT Image 2 als Text-zu-Bild-Option hinzu und ergänzte damit Nano Banana 2, Seedream und HappyHorse 1.0 in der Modellpalette. Sie können ein Bild mit GPT Image 2 generieren und es im selben Arbeitsbereich in Video umwandeln, ohne herunterzuladen, erneut hochzuladen oder zwischen Tabs zu wechseln.
Das ist aus einem konkreten Grund wichtig: Wenn das Bild direkt in eine Bild-zu-Video-Pipeline auf derselben Plattform einfließt, arbeitet das Video-Modell direkt mit der Quelldatei in voller Auflösung und deren Metadaten. Auf dem Weg dorthin gibt es keinen Qualitätsverlust durch Komprimierung oder Formatumwandlung, was sauberere Bewegung und weniger Artefakte im finalen Clip bedeutet.
Wenn ein Standbild zu einem Clip werden soll, prompten Sie von Anfang an für Bewegungsbereitschaft — bitten Sie um Vordergrund-, Mittelgrund- und Hintergrundtiefe, eine klare Motiv-Silhouette und ein physisches Element, das sich plausibel bewegen kann (Staub, Dampf, Stoff, eine sich verändernde Lichtquelle). Überprüfen Sie das Standbild wie eine fertige Design-Datei, bevor Sie es animieren: Prüfen Sie zuerst Rechtschreibung, Produktgeometrie und UI-Ausrichtung, da ein Video-Modell eine falsch geschriebene Headline oder ein verzerrtes Etikett nicht von selbst korrigiert. Schreiben Sie dann einen separaten, kürzeren Bewegungs-Prompt, der nur beschreibt, was sich bewegen soll und was festgelegt bleiben muss, statt das gesamte Bild-Briefing zu wiederholen.
Warum Kreative zu einer All-in-One-Plattform wechseln
Wenn Sie vor März 2026 OpenAIs Sora für die Videogenerierung verwendet haben, kennen Sie bereits das Risiko, einen Workflow um ein einzelnes Tool herum aufzubauen. OpenAI schaltete die Sora-App und -API am 24. März ab, unter Berufung auf nicht tragfähige Kosten und einen Schwenk in Richtung Robotik, und Tausende von Kreativen verloren ihre Video-Pipeline über Nacht. Sehen Sie unseren Leitfaden zu Sora-Alternativen für eine vollständige Aufschlüsselung dessen, was passiert ist und welche Tools die Lücke gefüllt haben.
PixVerse verfolgt einen anderen Ansatz, indem es Ihnen Zugang zu mehreren Modellen über die gesamte kreative Pipeline hinweg gibt, statt Sie an eines zu binden:
- Text-zu-Bild mit GPT Image 2, Nano Banana 2, Seedream und mehr — wählen Sie das Modell, das zur Aufgabe passt
- Bild-zu-Video, das Ihre generierten Bilder mit Charakterkonsistenz und Kamerakontrolle in Bewegung umwandelt
- Text-zu-Video für Clips, die direkt aus einem geschriebenen Prompt generiert werden, mit PixVerse V6 oder dem filmischen C1-Modell
- Native Audiogenerierung, die Soundeffekte und Dialoge automatisch mit Ihrem Video synchronisiert
Der praktische Vorteil: Sie können von einem geschriebenen Konzept zu einem fertigen Video mit synchronisiertem Audio gelangen, ohne einen Arbeitsbereich zu verlassen, was Stunden an Dateiverwaltung aus jedem Projekt entfernt. Wenn Sie die Generierung lieber von der Kommandozeile aus skripten möchten, deckt der PixVerse CLI Leitfaden die Automatisierung von sowohl Bild- als auch Videogenerierung ab.
PixVerse bietet neuen Nutzern außerdem 30–60 kostenlose Credits pro Tag, sodass Sie die gesamte Pipeline — von der Bildgenerierung bis zum Video-Output — testen können, bevor Sie sich für einen bezahlten Plan entscheiden.
Häufig gestellte Fragen
Ist GPT Image 2 kostenlos nutzbar?
Kostenlose ChatGPT-Nutzer können mit GPT Image 2 etwa zwei Bilder pro Tag generieren. ChatGPT Plus-Abonnenten (20 $/Monat) erhalten unbegrenzte Generierungen mit schnellerer Verarbeitung. Der API-Zugang wird pro Token über Bild-Input, Bild-Output und Text-Input abgerechnet, sodass die Kosten mit Prompt-Länge und Output-Größe skalieren statt mit einer pauschalen Gebühr pro Bild.
Welche Auflösung unterstützt GPT Image 2?
GPT Image 2 generiert Bilder in nativer 2K-Auflösung, mit einem optionalen 4K-Upscale über die API. Seitenverhältnisse reichen von 3:1 bis 1:3, sodass quadratische, vertikale und extrem breite Formate alle direkt verfügbar sind.
Kann GPT Image 2 Text in Bildern akkurat rendern?
Ja — das ist eine seiner stärksten Funktionen. In unseren Tests überstieg die Textgenauigkeit über Englisch, Chinesisch, Japanisch, Koreanisch und Arabisch beim ersten Generierungsversuch 95 %. Mehrzeilige Headlines, Postertitel und UI-Textlabels werden alle zuverlässig gehandhabt, obwohl sehr kleiner Text bei niedrigen Auflösungen gelegentlich noch danebengehen kann.
Wie schneidet GPT Image 2 im Vergleich zu Midjourney und Nano Banana 2 ab?
Midjourney V8 verfügt über stärkere künstlerische Stilkontrollen und eine etabliertere Community für ästhetische Verfeinerung. Nano Banana 2 ist die stärkere Wahl für Fotorealismus, filmische Beleuchtung und schnelle Iteration. GPT Image 2 hat die Nase vorn bei Textrendering, strukturierten Layouts und Bearbeitung in natürlicher Sprache. Für Posterdesign und Marketingmaterialien mit Text gewinnt GPT Image 2 derzeit; für rein künstlerische Erkundung oder fotorealistische Hero-Shots lohnt es sich, die anderen beiden direkt zu vergleichen — siehe unseren direkten Vergleichstest mit Nano Banana 2.
Was sind die besten Alternativen zu Sora für Video nach der Abschaltung?
Nachdem OpenAI Sora im März 2026 abgeschaltet hat, gehören zu den besten Alternativen PixVerse V6 für charakterkonsistentes Multi-Shot-Video, Runway Gen-4 für filmische Kamerakontrolle und Kling v3.0 für Actionsequenzen. PixVerse ist die einzige Plattform, die Text-zu-Bild, Bild-zu-Video und Text-zu-Video mit nativem Audio kombiniert, alles zugänglich mit täglichen kostenlosen Credits. Sehen Sie unseren vollständigen Leitfaden zu Sora-Alternativen für einen detaillierten Vergleich.
Kann ich GPT Image 2 Outputs in Video umwandeln?
Ja. Mit GPT Image 2 verfügbar in PixVerse können Sie das Bild in der App generieren und es mit der Bild-zu-Video-Pipeline im selben Arbeitsbereich in Video umwandeln, ohne dass Dateiübertragungen erforderlich sind. Sie können auch eine anderswo erstellte GPT Image 2 Datei hochladen und sie durch dieselbe Pipeline laufen lassen.