GPT Image 2: recenzja, przewodnik po promptach i zastosowania w 2026
OpenAI wydało GPT Image 2 21 kwietnia 2026 roku — następcę GPT Image 1.5 i model, który od tego momentu napędza generowanie obrazów w ChatGPT. Przetestowaliśmy go w tygodniu premiery, a pod koniec czerwca wróciliśmy do niego ponownie z szerszym zestawem promptów, oficjalnym przewodnikiem promptowania od OpenAI oraz opublikowanym cennikiem API, by sprawdzić, jak model wypada, gdy początkowy szum opadnie.
Najważniejsze wnioski:
- GPT Image 2 generuje obrazy w natywnej rozdzielczości 2K z opcjonalnym podbiciem do 4K, a dokładność renderowania tekstu przekracza 95% w alfabecie łacińskim, chińskim, japońskim, koreańskim i arabskim.
- Model najlepiej traktować jako asystenta projektowego, a nie generator zdjęć: świetnie radzi sobie z zadaniami mającymi jasny standard sukcesu — dokładny tekst, ustalony układ, powtarzalna struktura paneli — a staje się mniej przewidywalny przy otwartych promptach typu „zrób to ładnie”.
- Odtwarzanie logo marek, drobny tekst prawny i autorskie fonty to wciąż słabe punkty wymagające ręcznej weryfikacji.
- API OpenAI rozlicza GPT Image 2 na podstawie tokenów w podziale na wejście obrazu, buforowane wejście obrazu, wyjście obrazu, wejście tekstu i buforowane wejście tekstu — inny model cenowy niż płaskie stawki za obraz stosowane przez część konkurencji.
- PixVerse udostępnia GPT Image 2 w swojej ofercie tekst-na-obraz obok Nano Banana 2 i Seedream, dzięki czemu wygenerowany obraz może od razu trafić do potoku obraz-na-wideo bez opuszczania przestrzeni roboczej.
Czym jest GPT Image 2? Kluczowe funkcje i ograniczenia
GPT Image 2 to model obrazu drugiej generacji od OpenAI, zastępujący GPT Image 1.5 zarówno w ChatGPT, jak i w API. Konkuruje z Midjourney, DALL-E 3 i Stable Diffusion, ale buduje swoją tożsamość na dwóch filarach: dokładnym tekście wewnątrz obrazów oraz warstwie rozumowania, która interpretuje intencję promptu, a nie tylko dopasowuje słowa kluczowe.
Kluczowe funkcje w skrócie
| Funkcja | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Natywna rozdzielczość | 2K (z podbiciem do 4K) | 1K | 2K (z flagą —hd) |
| Dokładność renderowania tekstu | 95%+ wielojęzyczne | ~70% (tylko łacińskie) | ~80% (tylko łacińskie) |
| Integracja rozumowania | Tak — interpretuje wielowarstwowe instrukcje | Nie | Nie |
| Zakres proporcji obrazu | 3:1 do 1:3 | 1:1, 16:9 | 1:1 do 3:2 |
| Spójność postaci | Na poziomie pikseli w sekwencji obrazów | Ograniczona | Umiarkowana (flaga —cref) |
| Edycja w języku naturalnym | Tak — edycja obszarów przez ich opisanie | Nie | Nie |
| Cennik | Oparty na tokenach w API; poziomy planu ChatGPT | Ten sam | Subskrypcja 10–30 USD/mies. |
Renderowanie tekstu to funkcja, która zbiera najwięcej uwagi, i nie bez powodu. Starsze modele obrazu traktowały tekst jak teksturę — poproszony o nagłówek na plakat model zwracał szum w kształcie liter. GPT Image 2 obsługuje wielowierszowe angielskie nagłówki, chińskie znaki i mieszane układy językowe z prawdziwą spójnością; w naszych testach mniej więcej 19 na 20 generacji było w pełni czytelnych za pierwszym razem.
Integracja rozumowania oznacza, że model robi więcej niż dopasowywanie wzorców do słów. Poproszony o „wygeneruj infografikę pokazującą aktywności na jutrzejszą pogodę w San Francisco”, pobierze prognozę, wybierze pasujące aktywności i zbuduje wokół tych danych układ graficzny — krok dalej niż to, jak Midjourney czy Stable Diffusion przetwarzają prompt.
Edycja w języku naturalnym pozwala poprawić obraz, opisując zmianę, zamiast ręcznie maskować obszar. Zarówno „przesuń kubek z kawą na lewą stronę stołu”, jak i „zmień niebo na zachód słońca” są stosowane jako celowane edycje bez ponownego generowania całej sceny.
Co mówią użytkownicy
Opinie od momentu premiery są w większości pozytywne, choć pojawia się spójny zestaw zastrzeżeń. Testy portretowe krążące na X i Reddicie wyglądają blisko fotografii studyjnej, a projektanci plakatów testujący długie układy — ulotki, menu, oznakowanie — zgłaszają, że dokładność tekstu wreszcie sprawdza się w realnym użyciu. Kilku projektantów zauważyło, że mogli pominąć przejście przez Photoshopa dla podstawowych materiałów marketingowych, bo własne wyczucie kompozycji modelu jest na tyle silne, by samodzielnie podejmować decyzje o układzie.
Najmocniejsze pochwały dotyczą trzymania się promptu: poproś o 15 konkretnych elementów w scenie, a GPT Image 2 zwykle uwzględni je wszystkie, podczas gdy starsze modele zaczynały gubić szczegóły wraz z wydłużaniem się promptu.
Po stronie negatywów wierność odtwarzania marek wciąż bywa niekonsekwentna. Szeroko udostępniany test praktyczny ZDNet pokazał, że model nie odtworzył poprawnie logo ZDNET, a inni użytkownicy zgłaszali podobne problemy z konkretnymi znakami marek. Model rozumie, czym koncepcyjnie jest logo, ale nie odtwarza niezawodnie dokładnych kształtów wektorowych ani autorskich krojów pisma.
Znane ograniczenia
- Odtwarzanie logo marek jest niepewne — po wygenerowaniu skomponuj dokładne logo w Photoshopie lub Figmie, zamiast promptować o nie bezpośrednio.
- Szybkość generowania ustępuje lżejszym modelom, takim jak FLUX czy Nano Banana 2 — typowo 30–60 sekund w ChatGPT Plus wobec poniżej 10 sekund gdzie indziej.
- Limity na darmowym poziomie są ciasne — mniej więcej dwa obrazy dziennie dla darmowych użytkowników ChatGPT. Subskrybenci Plus mają nielimitowane generowanie w ChatGPT, ale koszty API rosną wraz z wolumenem.
- Kontrola stylu jest mniej precyzyjna niż w Midjourney. Nie da się z taką samą dokładnością ustawić typu taśmy filmowej, rodzaju obiektywu czy ziarna, a własne uprzedzenie estetyczne modelu wymaga świadomej pracy nad promptem, by je przełamać.
- Polityka treści jest surowsza niż w rozwiązaniach open source, więc część promptów działających bez problemu w Stable Diffusion lub modelach lokalnych zostanie tu odrzucona.
Żadne z tych ograniczeń nie wyklucza użycia produkcyjnego, ale warto je znać, zanim zbudujesz cały potok wokół jednego modelu.
Jak pisać prompty do GPT Image 2, które naprawdę działają
Najwyraźniejsza zmiana w naszej drugiej rundzie testów: najlepsze prompty do GPT Image 2 nie opisują po prostu obrazka — opisują zadanie, które ten obrazek ma spełnić. Prompt do reklamy społecznościowej powinien wyglądać inaczej niż prompt do wycinka produktowego, infografiki, ekranu UI czy pierwszej klatki przeznaczonej pod wideo.
Niezawodny wzorzec do konstruowania briefu:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Najpierw nazwij zadanie, potem styl
Zacznij od typu produktu wyjściowego — plakat, reklama produktu, ekran aplikacji, karta postaci, diagram, edycja czy pierwsza klatka wideo — tak by model wiedział, według jakiego standardu będzie oceniany.
Słabo: A cool futuristic speaker, cinematic, high detail.
Lepiej: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
Druga wersja mówi modelowi, że będzie oceniany na podstawie układu i użyteczności, a nie tylko estetyki.
Traktuj tekst jak zablokowany zasób
Umieść wymaganą treść w cudzysłowie i dokładnie określ, jak ma zostać wyrenderowana — nie proś o „hasło reklamowe”, chyba że chcesz, by model sam wymyślił za ciebie słowa.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Dla dłuższej treści rozbij każdą linię w prompcie osobno. Jeśli słowo wróci błędnie zapisane, wygeneruj ponownie z krótszym tekstem, większą czcionką i bardziej surową instrukcją „tylko dokładny tekst”.
Daj modelowi kamerę i układ
Bezpośrednio określ odległość kamery, kąt, umiejscowienie obiektu, przestrzeń negatywną i proporcje obrazu — GPT Image 2 dobrze podąża za wskazówkami kompozycyjnymi, ale tylko wtedy, gdy są jasno wypisane.
- Zbliżenie do faktury produktu, dłoni, twarzy, materiałów, etykiet.
- Szeroki plan do otoczenia, scen fabularnych, plakatów miejskich, klatek pod wideo.
- Z góry do zdjęć jedzenia, scen na biurku, flat-lay’ów, zestawów opakowań.
- Lewa/prawa jedna trzecia do układów reklamowych balansujących tekst i produkt.
- Czysta siatka do makiet UI, kart postaci, diagramów, infografik.
Pisz edycje w trzech zdaniach
Najsilniejsze prompty edycyjne oddzielają zmianę od tego, co musi pozostać nietknięte, oraz od fizycznego realizmu, który je spina:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Ta struktura „zmień, zachowaj, dopasuj” konsekwentnie przewyższa niejasną prośbę typu „spraw, by to wyglądało lepiej”.
Dodaj wskazówkę ruchu, jeśli klatka ma stać się wideo
Jeśli obraz może później zasilić potok obraz-na-wideo w PixVerse, promptuj z góry pod kątem głębi i gotowości do ruchu: pierwszy plan, plan środkowy, tło, czysta sylwetka głównego obiektu oraz jeden widoczny element, który mógłby się poruszyć — pył, tkanina, włosy, deszcz, odbicie lub tor najazdu kamery.
Zamiast: An astronaut in a desert.
Użyj: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Jak testowaliśmy GPT Image 2
W obu rundach testów przepuściliśmy model przez portrety, plakaty z dużą ilością tekstu, kompozycje w stylu produktowym, karty postaci, makiety UI i eksperymentalne sceny narracyjne. Celem nie był wynik w benchmarku — chodziło o to, czy projektant, marketer lub twórca mógłby wykorzystać wynik po drobnych poprawkach zamiast budować zasób od zera.
| Obszar testów | Co sprawdzaliśmy |
|---|---|
| Portrety i kadry filmowe | Kontrola oświetlenia, faktura skóry, odbicia, nastrój, spójność sceny |
| Plakaty i układy typograficzne | Poprawność nagłówka, tekst wielowierszowy, hierarchia, przestrzeń negatywna, wykończenie zbliżone do brandingu |
| Karty postaci i koncepcji | Spójność wielu ujęć, szczegóły kostiumu, zgodność palety, dokładność etykiet |
| Makiety UI i mediów społecznościowych | Realizm układu, drobny tekst, odstępy między ikonami, siatki feedu, wiarygodność zrzutu ekranu |
| Prompty eksperymentalne | Humor, rozumowanie narracyjne, umiejscowienie obiektów, dokładność drobnych podpisów |
Wzorzec utrzymał się w obu rundach: GPT Image 2 nagradza precyzyjny brief bardziej niż łańcuch słów kluczowych. Gdy prompt nazywa zadanie i definiuje sukces — dokładny tekst, ustalony układ, powtarzalna struktura paneli — model zwykle zachowuje strukturę. Gdy prompt prosi jedynie o niejasny nastrój, wynik nadal może wyglądać dopracowanie, ale trudniej go ponownie wykorzystać bez poprawek.
Zastosowania GPT Image 2 z przykładami promptów
Poddaliśmy stress-testowi pięć odrębnych możliwości w tych scenariuszach: kontrolę oświetlenia, typografię z dokładnym tekstem, kompozycję wieloelementową, spójność postaci i układ UI. Każdy prompt poniżej jest gotowy do skopiowania i dostosowania.
Filmowa fotografia portretowa
Sprawdza to zrozumienie przez model oświetlenia, atmosfery i powściągliwej kompozycji — fundamenty, które odróżniają obraz gotowy do portfolio od generycznego renderu AI.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
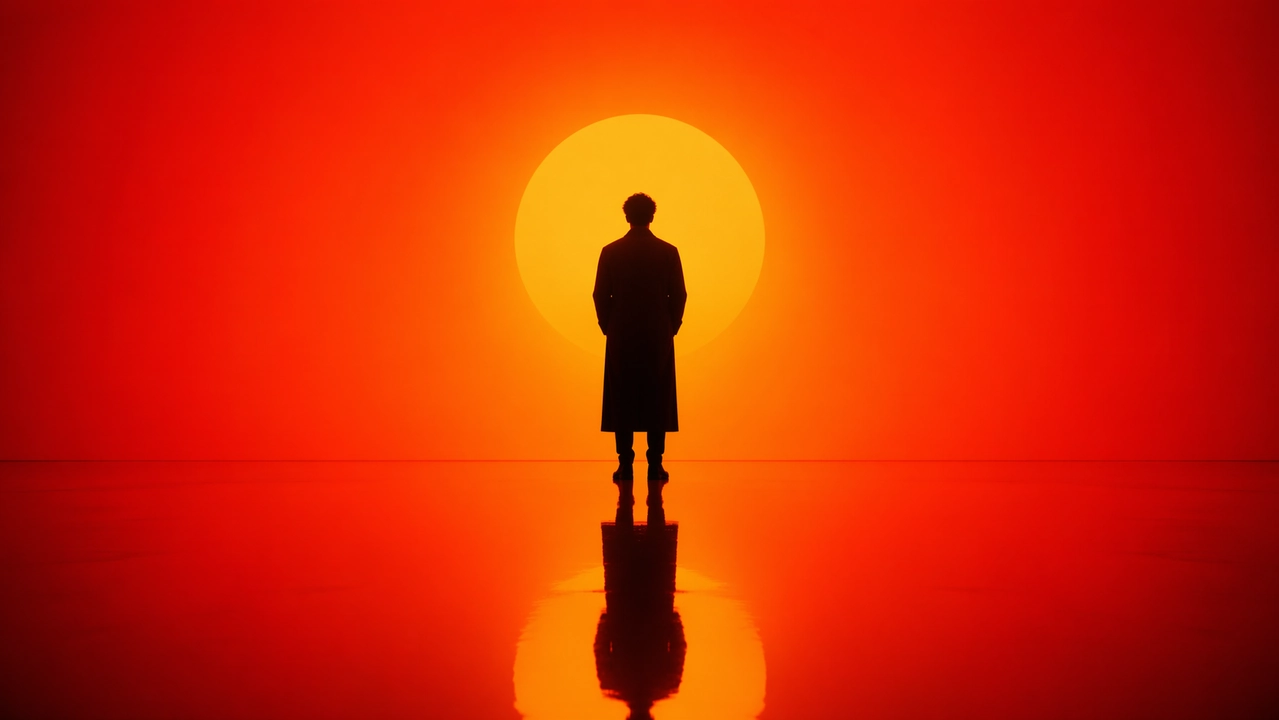
Na co zwrócić uwagę: czyste krawędzie sylwetki bez artefaktów w formie halo, dokładne odbicie na podłodze z poprawną perspektywą, płynny (nie pasmowy) gradient oraz poza, która niesie realny ciężar, zamiast wyglądać sztywno lub jakby unosiła się w powietrzu.
Projekt plakatu miejskiego i ilustracji
Najtrudniejszy stress-test dla czytelnej typografii połączonej z gęstą, wieloelementową kompozycją — ponad dziesięć odrębnych elementów wizualnych ułożonych wzdłuż krzywej S, z angielskim tekstem, który musi przetrwać render nienaruszony.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
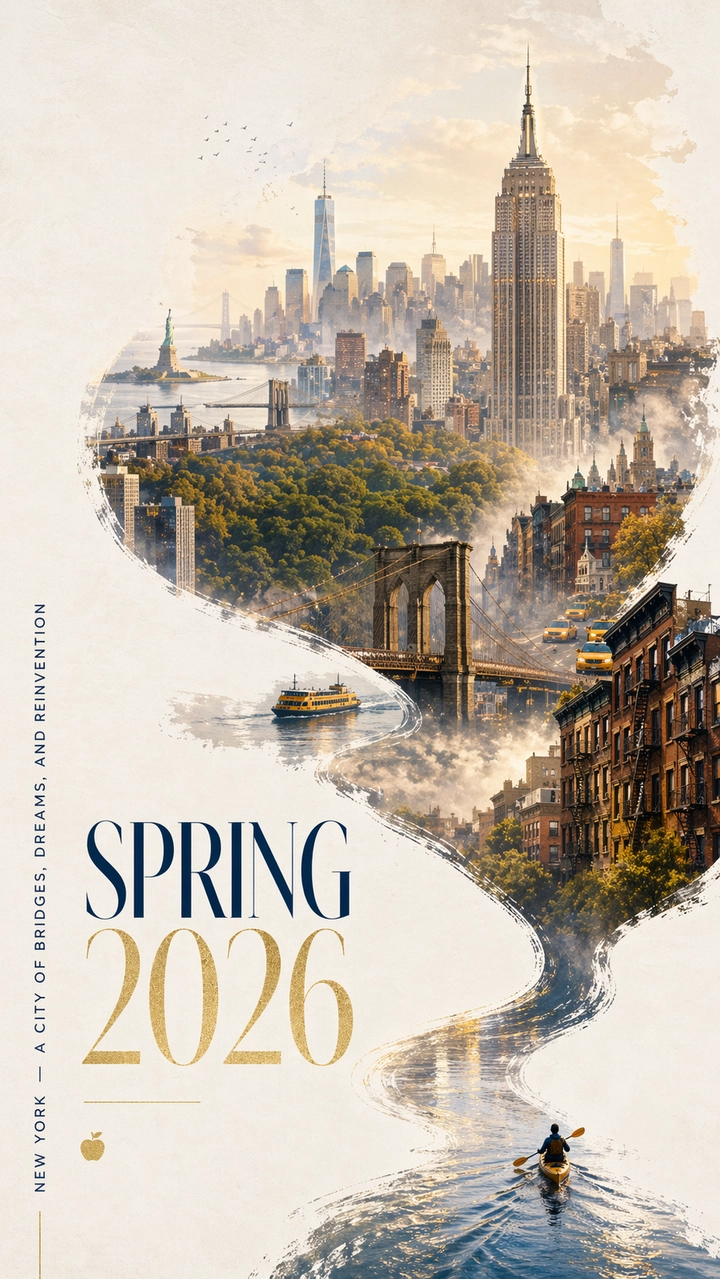
Na co zwrócić uwagę: każda litera w tytule i haśle powinna być czytelna i poprawnie zapisana, krzywa S powinna płynnie prowadzić od kajakarza do panoramy miasta, budynki-symbole powinny być rozpoznawalne, a nie wyglądać jak generyczne wieżowce, a przestrzeń negatywna powinna sprawiać wrażenie celowej, nie pustej.
Projekt postaci i arkusz referencyjny
Twórcy gier i artyści koncepcyjni potrzebują spójności wielu ujęć z jednej generacji. Sprawdza to, czy model potrafi utrzymać stały projekt postaci w widoku z przodu, z boku i z tyłu.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
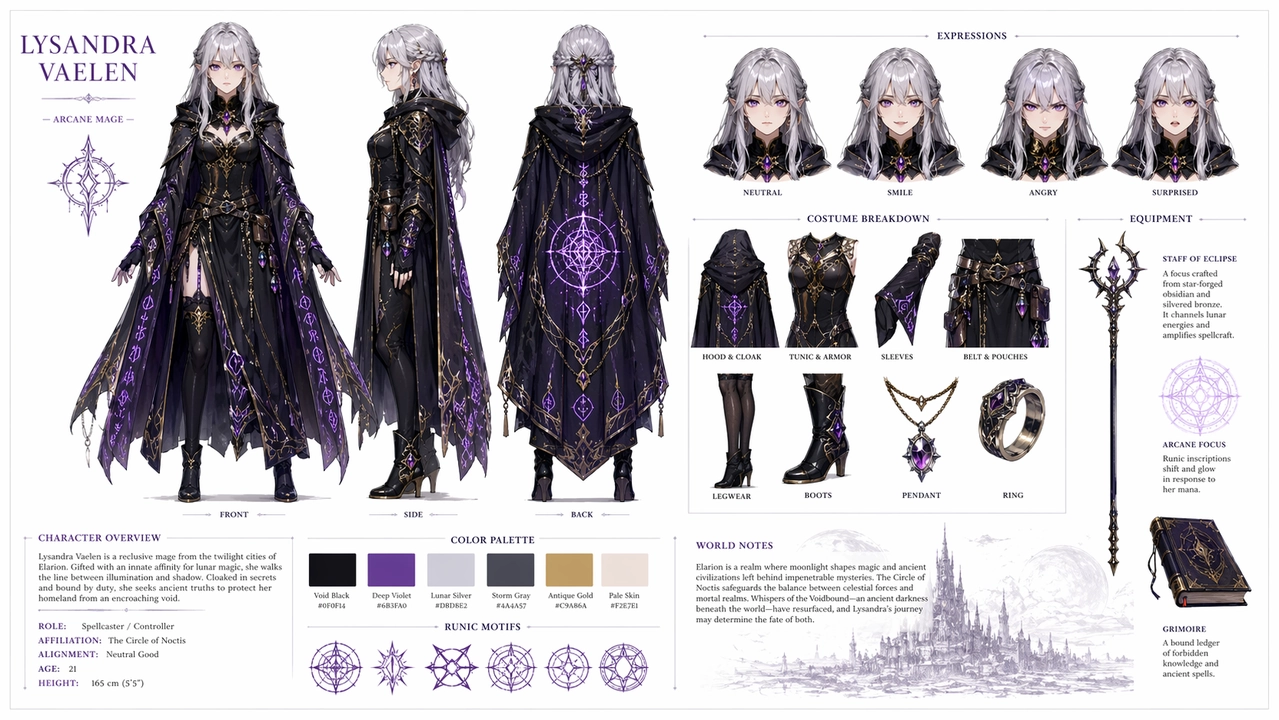
Na co zwrócić uwagę: twarz, włosy i strój powinny pozostać spójne we wszystkich trzech ujęciach; warianty mimiki powinny zmieniać wyłącznie twarz, nie fryzurę ani ubranie; próbki palety kolorów powinny faktycznie odpowiadać kolorom użytym w grafice, a etykiety tekstowe powinny być poprawnie zapisane. Jeśli widok z boku lub z tyłu odbiega od reszty, wygeneruj ponownie z mocniejszym językiem „zachowaj”, powtarzającym kotwice tożsamości.
Makieta UI i mediów społecznościowych
To pcha jednocześnie trzy rzeczy: układ UI z dokładnością co do piksela, renderowanie tekstu w mieszanych językach oraz kreatywną fuzję koncepcji — treść, która zwykle dobrze sprawdza się też na platformach społecznościowych.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
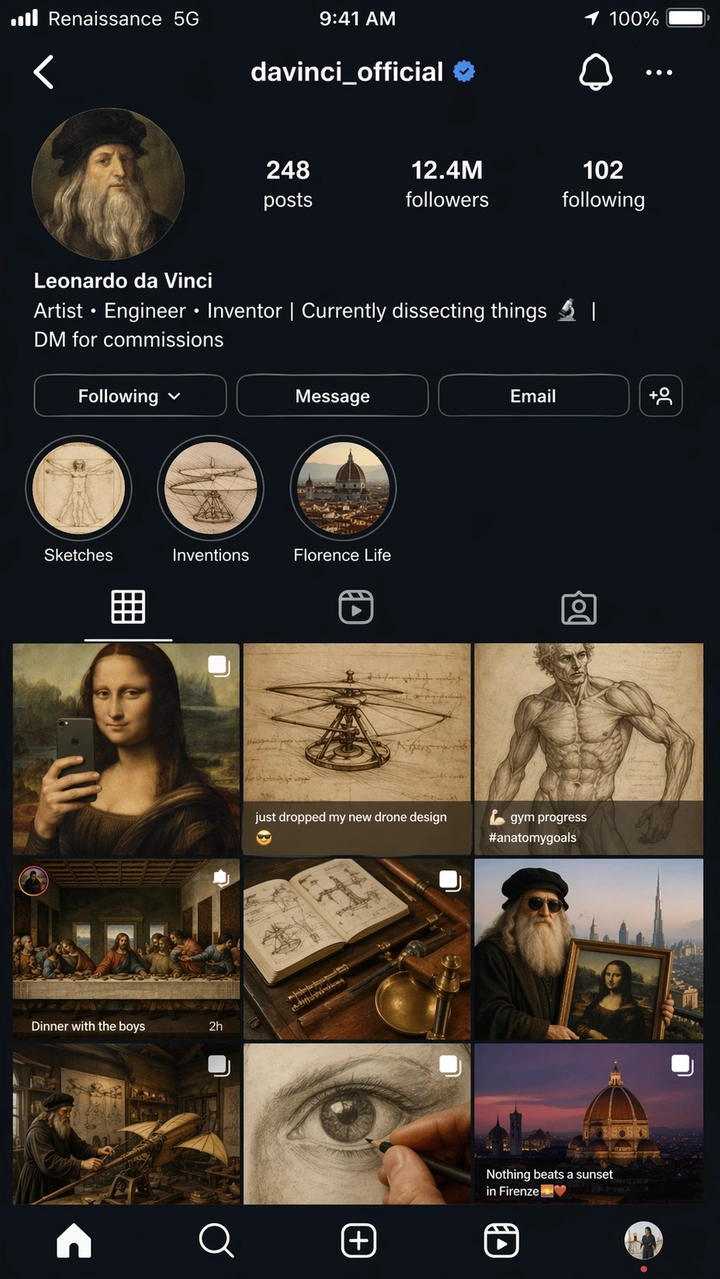
Na co zwrócić uwagę: elementy interfejsu Instagrama — odstępy w siatce, układ profilu, kółka relacji, pasek zakładek — powinny wyglądać jak rzeczywisty zrzut ekranu iOS, a nie stylizowane przybliżenie. Cały tekst powinien być czytelny, a etykieta operatora „Renaissance 5G” to celowy test dokładności. Każdy wynik makiety UI traktuj jako referencję koncepcyjną, a nie gotowy do produkcji interfejs; drobne etykiety i wyrównanie ikon zwykle wymagają dodatkowego czyszczenia.
Sztuka kreatywna i eksperymentalna
Krótkie prompty z wbudowanym humorem narracyjnym sprawdzają, czy model samodzielnie wypełnia luki kreatywne, zamiast polegać na wyczerpujących instrukcjach.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
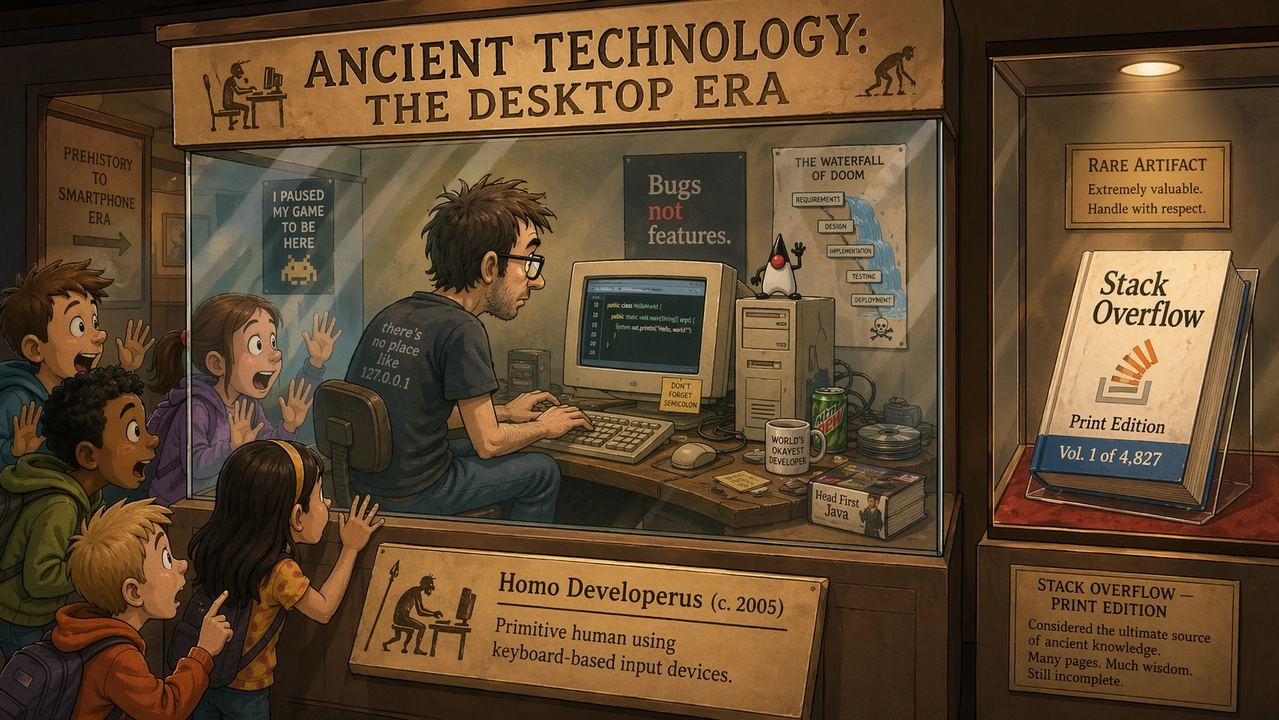
Na co zwrócić uwagę: humor powinien działać poprzez szczegóły wizualne, a nie tylko tekst podpisu. Tabliczka i tytuł książki muszą pozostać czytelne i poprawnie zapisane — naprawdę trudny test dla wielowierszowego tekstu w małym rozmiarze — a styl kreskówkowy powinien być spójny w całej scenie, zamiast fotorealistyczny fragmentami.
Wyniki testów według zastosowania
Najlepsze wyniki konsekwentnie dawały prompty z oczywistym standardem produkcyjnym — czymś, co można ocenić przez pisownię, układ, zachowanie obiektu lub kolejność paneli. Niejasne prompty skupione tylko na nastroju dawały bardziej zmienne rezultaty.
| Zastosowanie | Co działało dobrze | Co nadal wymaga weryfikacji |
|---|---|---|
| Renderowanie tekstu | Duże nagłówki, krótkie etykiety, tytuły plakatów i proste etykiety UI pozostawały dokładne, gdy dokładna treść była zacytowana. | Drobny tekst prawny, gęste akapity i stylizowane fonty wciąż mogą się rozjeżdżać — trzymaj tekst krótko i sprawdzaj każdą literę. |
| Obrazy produktowe | Czyste układy reklamowe, przestrzeń negatywna kampanii i kompozycje z produktem na pierwszym planie renderowały się dobrze. | Prawdziwe etykiety, logo i regulowane oświadczenia wciąż wymagają ręcznej weryfikacji lub kompozycji z zatwierdzonych zasobów. |
| Makiety UI | Ekrany mobilne, panele i hierarchia w stylu aplikacji wyglądały wiarygodnie, gdy prompt nazywał rzeczywiste elementy interfejsu. | Traktuj wyniki jako makiety koncepcyjne — drobne etykiety i wyrównanie ikon zwykle wymagają czyszczenia. |
| Spójność postaci | Karty postaci, rzędy mimiki i próbki palety dobrze sprawdzały się jako referencje kreatywne. | Twarze i szczegóły kostiumu mogą się rozjeżdżać między ujęciami; powtarzaj kotwice tożsamości i generuj ponownie w razie potrzeby. |
| Edycja i kompozycja | Wzorzec „zmień, zachowaj, dopasuj” przewyższał szerokie prośby o edycję. | Granice zaznaczenia i wyjście z przezroczystym tłem wciąż wymagają kontroli jakości. |
Częste błędy przy promptowaniu GPT Image 2
- Proszenie o dokładny tekst bez podania dokładnej treści. Jeśli tekst ma znaczenie, zapisz go dosłownie i wskaż, gdzie ma się znaleźć.
- Przeładowanie jednego promptu każdym możliwym szczegółem. Zacznij od głównej sceny, potem dopracowuj jedną zmienną naraz.
- Zapominanie o określeniu niezmienników podczas edycji. Wypisz, co musi pozostać niezmienione: tożsamość, tło, poza, oświetlenie, kształt produktu, tekst etykiety, kąt kamery.
- Poleganie na dekoracyjnych słowach jakościowych dla zadań funkcjonalnych. „Piękne” nie sprawi, że etykieta stanie się czytelna — używaj sformułowań takich jak „ostry tekst etykiety” czy „czytelne z odległości”.
- Pomijanie proporcji obrazu. Mocny kwadratowy obraz wciąż może zawieść jako pionowa reklama czy miniatura wideo.
- Traktowanie logo jak zwykłego tekstu. GPT Image 2 potrafi projektować koncepcje logo, ale dokładne znaki marek powinny być komponowane z zatwierdzonych zasobów, a nie promptowane bezpośrednio.
Uwagi o API i cenniku GPT Image 2
Strona cennika API OpenAI wymienia GPT Image 2 na podstawie tokenów, a nie płaskiej stawki za obraz:
| Pozycja | Podana cena |
|---|---|
| Wejście obrazu | 8,00 USD / 1M tokenów |
| Buforowane wejście obrazu | 2,00 USD / 1M tokenów |
| Wyjście obrazu | 30,00 USD / 1M tokenów |
| Wejście tekstu | 5,00 USD / 1M tokenów |
| Buforowane wejście tekstu | 1,25 USD / 1M tokenów |
Faktyczny koszt na obraz zależy od długości promptu, obrazów referencyjnych, rozmiaru wyjściowego, buforowania i ustawienia jakości. Limity planu ChatGPT to osobny tor rozliczeniowy od API — subskrypcja Plus nie przekłada się bezpośrednio na środki API, więc jeśli korzystasz z obu, budżetuj je niezależnie.
Przy przepływach o dużym wolumenie liczy się koszt na zaakceptowany zasób po powtórzeniach, a nie cena z cennika za pojedynczą próbę. Tańsza generacja nie jest w rzeczywistości tańsza, jeśli potrzebuje trzech powtórzeń, by poprawnie oddać pisownię lub układ.
| Przepływ pracy | Praktyczna rada dotycząca promptowania |
|---|---|
| Plakaty lub diagramy z dużą ilością tekstu | Używaj mniejszej liczby słów na obraz, cytuj dokładną treść, jawnie określaj hierarchię. |
| Zdjęcia produktowe | Zablokuj kształt produktu, etykietę, kolor, materiał i kąt kamery; powtarzaj listę „zachowaj” przy każdej edycji. |
| Makiety UI | Opisuj ekran jako gotowy do wdrożenia interfejs — nawigację, karty, przyciski, stany — a nie jako grafikę koncepcyjną. |
| Edycje z wieloma referencjami | Oznacz każdy obraz wejściowy według roli: obiekt, styl, tło, strój lub referencja materiału. |
| Generowanie wsadowe | Śledź koszt na zaakceptowany obraz, a nie koszt na próbę. |
Jeśli chcesz zobaczyć, jak GPT Image 2 wypada na tle alternatywy skupionej na fotorealizmie przy identycznych promptach, nasze porównanie GPT Image 2 z Nano Banana 2 przeprowadza sześć rund pojedynków z pełnym zestawieniem cen API i platformy.
Od obrazu do wideo: dokończ swój przepływ kreatywny w PixVerse
Wygenerowanie mocnego obrazu to jeden krok. Zamiana go w ruch to miejsce, gdzie większość przepływów pracy się załamuje — kończysz portret lub plakat produktowy w GPT Image 2, a potem musisz otworzyć osobne narzędzie, ponownie wgrać plik i liczyć, że model wideo nie zniekształci twojej starannie skomponowanej kompozycji. Właśnie to tarcie w przekazywaniu plików eliminuje PixVerse.
GPT Image 2 jest już dostępny w PixVerse
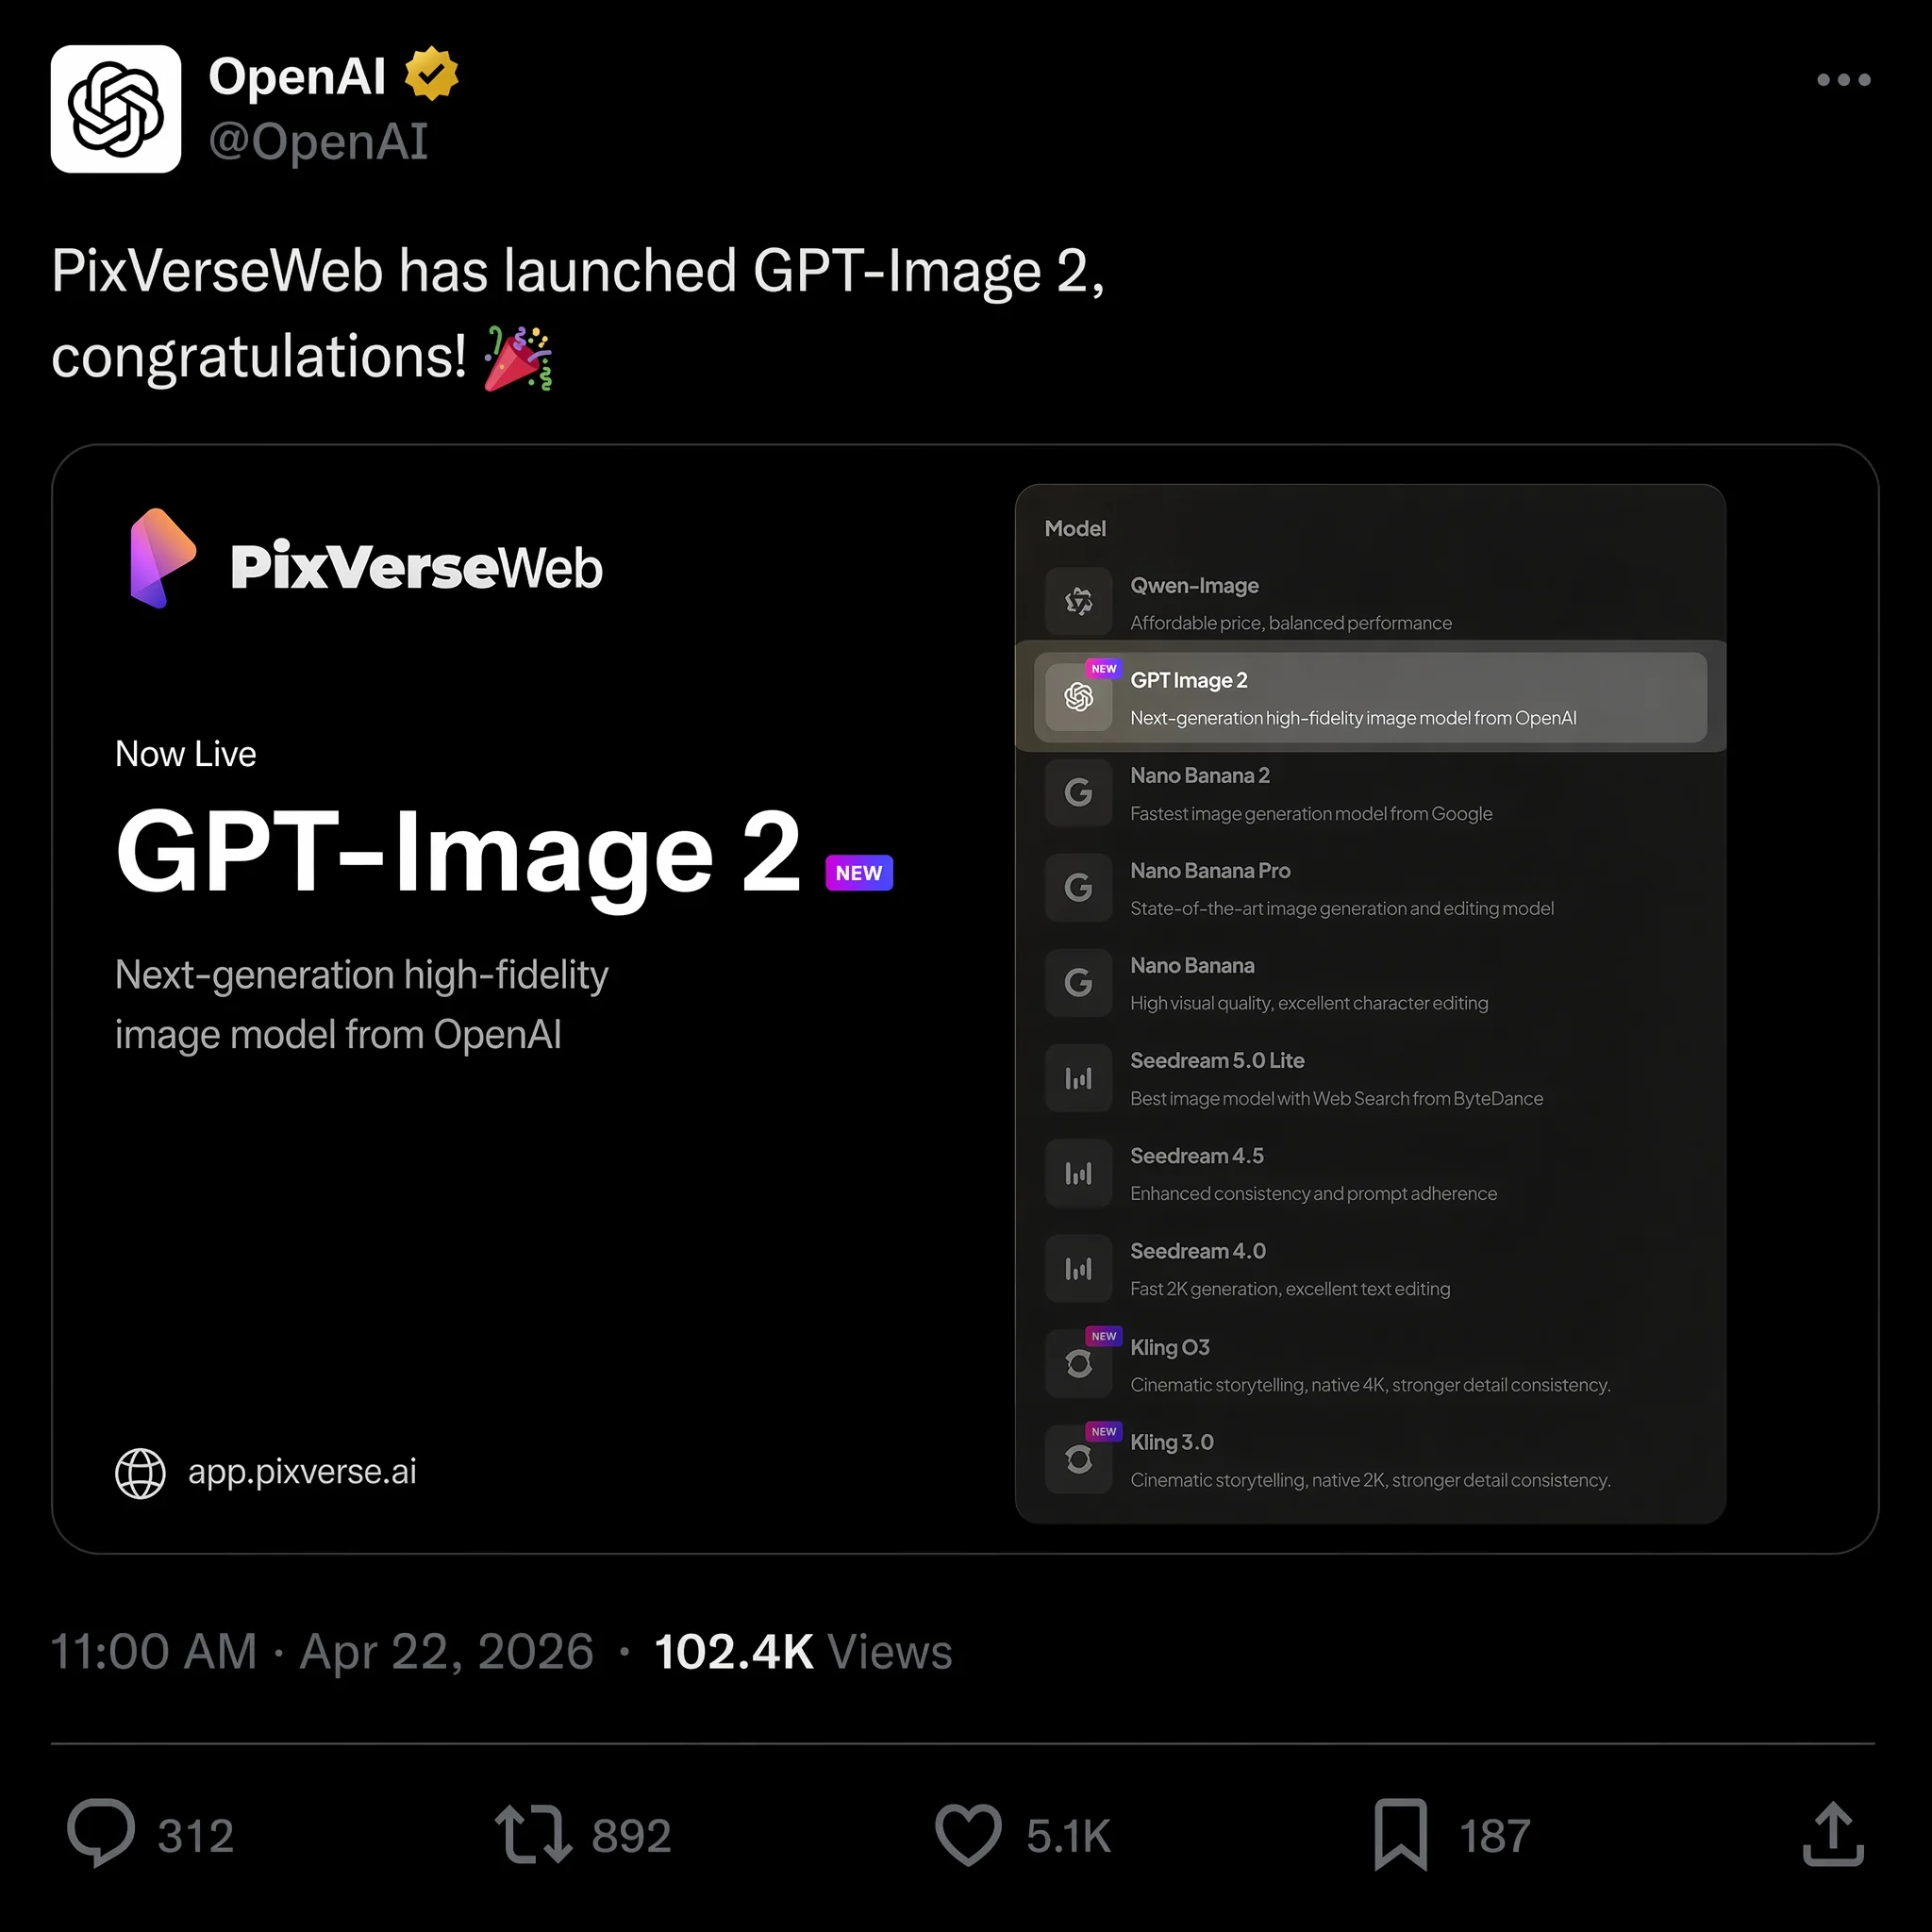
22 kwietnia 2026 roku PixVerse dodał GPT Image 2 jako opcję tekst-na-obraz, dołączając do Nano Banana 2, Seedream i HappyHorse 1.0 w ofercie modeli. Możesz wygenerować obraz za pomocą GPT Image 2 i przekonwertować go na wideo w tej samej przestrzeni roboczej, bez pobierania, ponownego wgrywania czy przełączania się między kartami.
Ma to znaczenie z konkretnego powodu: gdy obraz trafia bezpośrednio do potoku obraz-na-wideo w tej samej platformie, model wideo pracuje bezpośrednio na źródłowym pliku w pełnej rozdzielczości wraz z jego metadanymi. Nie ma po drodze utraty jakości spowodowanej kompresją czy konwersją formatu, co oznacza czystszy ruch i mniej artefaktów w finalnym klipie.
Jeśli obraz ma stać się klipem, promptuj pod kątem gotowości do ruchu od samego początku — poproś o głębię pierwszego planu, planu środkowego i tła, czystą sylwetkę głównego obiektu oraz jeden fizyczny element, który może się wiarygodnie poruszyć (pył, para, tkanina, zmieniające się źródło światła). Przeglądaj obraz jak gotowy plik projektowy przed animacją: sprawdź najpierw pisownię, geometrię produktu i wyrównanie UI, ponieważ model wideo sam nie naprawi błędnie zapisanego nagłówka ani zniekształconej etykiety. Następnie napisz osobny, krótszy prompt ruchu, opisujący tylko to, co powinno się poruszać i co musi pozostać zablokowane, zamiast powtarzać cały brief obrazu.
Dlaczego twórcy przechodzą na platformę all-in-one
Jeśli korzystałeś z Sora od OpenAI do generowania wideo przed marcem 2026 roku, znasz już ryzyko budowania przepływu pracy wokół jednego narzędzia. OpenAI zamknęło aplikację i API Sora 24 marca, powołując się na niezrównoważone koszty i zwrot w stronę robotyki, a tysiące twórców z dnia na dzień straciło swój potok wideo. Zobacz nasz przewodnik po alternatywach dla Sora, by poznać pełny przebieg wydarzeń i to, jakie narzędzia wypełniły lukę.
PixVerse przyjmuje inne podejście, dając dostęp do wielu modeli w całym potoku kreatywnym, zamiast zamykać cię w jednym:
- Tekst-na-obraz z GPT Image 2, Nano Banana 2, Seedream i innymi — wybierz model dopasowany do zadania
- Obraz-na-wideo, który zamienia wygenerowane obrazy w ruch z spójnością postaci i kontrolą kamery
- Tekst-na-wideo dla klipów generowanych bezpośrednio z pisanego promptu za pomocą PixVerse V6 lub filmowego modelu C1
- Natywne generowanie audio, które automatycznie synchronizuje efekty dźwiękowe i dialogi z wideo
Praktyczna korzyść: możesz przejść od pisanej koncepcji do gotowego wideo z zsynchronizowanym dźwiękiem bez opuszczania jednej przestrzeni roboczej, co eliminuje godziny zarządzania plikami w każdym projekcie. Jeśli wolisz skryptować generowanie z poziomu wiersza poleceń, przewodnik po PixVerse CLI obejmuje automatyzację generowania zarówno obrazów, jak i wideo.
PixVerse oferuje też 30–60 darmowych kredytów dziennie dla nowych użytkowników, dzięki czemu możesz przetestować cały potok — od generowania obrazu po wyjście wideo — zanim zdecydujesz się na płatny plan.
Najczęściej zadawane pytania
Czy GPT Image 2 jest darmowy w użyciu?
Darmowi użytkownicy ChatGPT mogą wygenerować mniej więcej dwa obrazy dziennie za pomocą GPT Image 2. Subskrybenci ChatGPT Plus (20 USD/miesiąc) otrzymują nielimitowane generowanie z szybszym przetwarzaniem. Dostęp do API jest rozliczany za token w podziale na wejście obrazu, wyjście obrazu i wejście tekstu, więc koszt rośnie wraz z długością promptu i rozmiarem wyjściowym, a nie jako płaska opłata za obraz.
Jaką rozdzielczość obsługuje GPT Image 2?
GPT Image 2 generuje obrazy w natywnej rozdzielczości 2K, z opcjonalnym podbiciem do 4K przez API. Proporcje obrazu wahają się od 3:1 do 1:3, więc formaty kwadratowe, pionowe i ultraszerokie są dostępne bezpośrednio.
Czy GPT Image 2 potrafi dokładnie renderować tekst w obrazach?
Tak — to jedna z jego najmocniejszych funkcji. W naszych testach dokładność tekstu w języku angielskim, chińskim, japońskim, koreańskim i arabskim przekraczała 95% już przy pierwszej próbie generowania. Wielowierszowe nagłówki, tytuły plakatów i etykiety tekstowe UI są obsługiwane niezawodnie, choć bardzo drobny tekst w niskich rozdzielczościach wciąż może okazjonalnie zawieść.
Jak GPT Image 2 wypada w porównaniu z Midjourney i Nano Banana 2?
Midjourney V8 ma silniejszą kontrolę stylu artystycznego i bardziej ugruntowaną społeczność do dopracowywania estetyki. Nano Banana 2 to lepszy wybór do fotorealizmu, filmowego oświetlenia i szybkiej iteracji. GPT Image 2 ma przewagę w renderowaniu tekstu, uporządkowanych układach i edycji w języku naturalnym. Do projektowania plakatów i materiałów marketingowych z tekstem GPT Image 2 wygrywa obecnie; do czystej eksploracji artystycznej lub fotorealistycznych ujęć bohaterskich warto porównać pozostałe dwa bezpośrednio — zobacz nasz pojedynek z Nano Banana 2.
Jakie są najlepsze alternatywy dla Sora do wideo po zamknięciu?
Po zamknięciu Sora przez OpenAI w marcu 2026 roku najlepsze alternatywy obejmują PixVerse V6 dla spójnego charakterystycznie wideo z wieloma ujęciami, Runway Gen-4 dla filmowej kontroli kamery i Kling v3.0 dla sekwencji akcji. PixVerse to jedyna platforma łącząca tekst-na-obraz, obraz-na-wideo i tekst-na-wideo z natywnym audio, dostępna z codziennymi darmowymi kredytami. Zobacz nasz pełny przewodnik po alternatywach dla Sora po szczegółowe porównanie.
Czy mogę zamienić wyniki GPT Image 2 w wideo?
Tak. Dzięki dostępności GPT Image 2 w PixVerse możesz wygenerować obraz w aplikacji i przekonwertować go na wideo za pomocą potoku obraz-na-wideo w tej samej przestrzeni roboczej, bez konieczności przesyłania plików. Możesz też wgrać plik GPT Image 2 utworzony gdzie indziej i przepuścić go przez ten sam potok.