Огляд GPT Image 2: посібник із промптів і сценарії використання у 2026 році
OpenAI випустила GPT Image 2 21 квітня 2026 року — наступника GPT Image 1.5 і модель, яка тепер забезпечує генерацію зображень у ChatGPT. Ми тестували її протягом тижня запуску і повернулися до неї знову наприкінці червня з ширшим набором промптів, власним посібником із промптингу OpenAI і опублікованими цінами API, щоб побачити, як модель тримається, коли початковий галас стихає.
Головне:
- GPT Image 2 генерує зображення в нативній роздільності 2K з необов’язковим апскейлом до 4K, а точність відтворення тексту перевищує 95% для латинської, китайської, японської, корейської та арабської писемностей.
- Модель найкраще сприймати як помічника з дизайну, а не генератор фото: вона сильна в завданнях із чітким критерієм успіху — точний текст, зафіксований макет, повторювана структура панелей — і стає менш передбачуваною на відкритих промптах на кшталт «зроби красиво».
- Відтворення фірмових логотипів, дрібний юридичний текст і власницькі шрифти лишаються слабкими місцями, які досі потребують ручної перевірки.
- API OpenAI тарифікує GPT Image 2 за токенами: вхід зображення, кешований вхід зображення, вихід зображення, вхід тексту та кешований вхід тексту — інша модель ціноутворення, ніж позображувальні рівні, які використовують деякі конкуренти.
- PixVerse включає GPT Image 2 у лінійку text-to-image разом із Nano Banana 2 і Seedream, тож згенероване зображення може одразу піти в конвеєр image-to-video, не залишаючи робочий простір.
Що таке GPT Image 2? Ключові можливості та обмеження
GPT Image 2 — модель зображень другого покоління від OpenAI, яка замінює GPT Image 1.5 у ChatGPT і API. Вона конкурує з Midjourney, DALL-E 3 і Stable Diffusion, але будує свою ідентичність на двох речах: точному тексті всередині зображень і шарі міркування, який тлумачить намір промпта, а не лише зіставляє ключові слова.
Основні можливості коротко
| Можливість | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Нативна роздільність | 2K (з апскейлом до 4K) | 1K | 2K (з прапорцем —hd) |
| Точність відтворення тексту | 95%+ багатомовно | ~70% (лише латиниця) | ~80% (лише латиниця) |
| Інтеграція міркування | Так — тлумачить багаторівневі інструкції | Ні | Ні |
| Діапазон співвідношення сторін | від 3:1 до 1:3 | 1:1, 16:9 | від 1:1 до 3:2 |
| Узгодженість персонажа | На рівні пікселів між послідовними зображеннями | Обмежена | Помірна (прапорець —cref) |
| Редагування природною мовою | Так — правте області, описуючи їх | Ні | Ні |
| Ціноутворення | За токенами через API; рівні планів ChatGPT | Те саме | Підписка $10–30/міс |
Відтворення тексту — можливість, яка привертає найбільше уваги, і недарма. Старіші моделі зображень трактували текст як текстуру: попросіть заголовок постера — і отримаєте шум у формі літер. GPT Image 2 обробляє багаторядкові англійські заголовки, китайські ієрогліфи та багатомовні макети зі справжньою узгодженістю; у наших тестах приблизно 19 із 20 генерацій поверталися повністю читабельними з першої спроби.
Інтеграція міркування означає, що модель робить більше, ніж зіставляє ваші формулювання зі шаблоном. Попросіть її «згенерувати інфографіку з активностями на завтрашню погоду в Сан-Франциско», і вона візьме прогноз, підбере доречні активності та побудує макет навколо цих даних — крок далі за те, як Midjourney чи Stable Diffusion обробляють промпт.
Редагування природною мовою дає змогу змінити зображення, описавши зміну, замість ручного маскування. «Пересунь чашку кави на лівий бік столу» або «зміни небо на захід сонця» застосовуються як цільові правки без перегенерації всієї сцени.
Що кажуть користувачі
Відгуки від запуску здебільшого позитивні, з усталеним набором скарг. Тести портретів, що циркулюють в X і Reddit, виглядають близько до студійної фотографії, а дизайнери постерів, які тестують довгі макети — флаєри, меню, вивіски, — повідомляють, що точність тексту нарешті витримує реальне використання. Кілька дизайнерів зазначили, що можуть пропустити прохід у Photoshop для базових маркетингових матеріалів, бо власне відчуття композиції моделі достатньо сильне, щоб ухвалювати рішення щодо макета без допомоги.
Найсильніша похвала стосується дотримання промпта: попросіть 15 конкретних елементів у сцені, і GPT Image 2 зазвичай включає їх усі, тоді як старіші моделі починали втрачати деталі, щойно промпти ставали довшими.
З негативного боку, відповідність бренду досі нестабільна. Широко поширений практичний тест ZDNet показав, що модель не змогла точно відтворити логотип ZDNET, і інші користувачі повідомляли про те саме з конкретними фірмовими знаками. Модель концептуально розуміє, чим є логотип, але ненадійно відтворює точні векторні форми чи власницькі гарнітури.
Відомі обмеження
- Відтворення логотипів брендів ненадійне — точні логотипи краще зібрати в Photoshop або Figma після генерації, а не просити їх напряму в промпті.
- Швидкість генерації поступається легшим моделям на кшталт FLUX або Nano Banana 2: на ChatGPT Plus типово потрібно 30–60 секунд, тоді як в інших сервісах — менше ніж 10 секунд.
- Ліміти безкоштовного рівня жорсткі — приблизно два зображення на день для безкоштовних користувачів ChatGPT. Підписники Plus отримують необмежені генерації в ChatGPT, але вартість API зростає разом із обсягом.
- Контроль стилю грубший, ніж у Midjourney. Не можна так само точно задати тип плівки, об’єктив чи зерно, а власне естетичне упередження моделі доводиться свідомо перекривати промптом.
- Політика контенту суворіша, ніж у open-source альтернатив, тож деякі промпти, які добре працюють у Stable Diffusion або на локальних моделях, тут будуть відхилені.
Жодне з цього не виключає продакшен-використання, але про це варто знати, перш ніж будувати пайплайн виключно навколо однієї моделі.
Як писати промпти для GPT Image 2, які справді працюють
Найчіткіший зсув у нашому другому раунді тестування: найкращі промпти для GPT Image 2 не просто описують картинку — вони описують завдання, яке ця картинка має виконати. Промпт для соцреклами має звучати інакше, ніж промпт для вирізки товару, інфографіки, екрана інтерфейсу чи першого кадру для відео.
Надійний шаблон структурування брифу:
Створи [тип зображення] для [сценарію використання]. Головний об’єкт: [конкретний об’єкт і видимі деталі]. Точний текст, якщо є: “[текст, який має з’явитися]”. Композиція: [кадрування, макет, негативний простір, розміщення об’єкта]. Стиль і освітлення: [візуальна мова, медіум, настрій, напрямок світла]. Обмеження: [що не можна змінювати, без зайвих слів, без водяного знака]. Формат виводу: [співвідношення сторін, прозорий фон, кадр, готовий до відео].
Спочатку назвіть завдання, а вже потім стиль
Починайте з типу результату — постер, реклама товару, екран застосунку, аркуш персонажа, схема, редагування або перший кадр відео — щоб модель знала, за яким стандартом її оцінюватимуть.
Слабко: Крута футуристична колонка, кінематографічно, висока деталізація.
Краще: Створи преміальну рекламу товару для матової чорної бездротової колонки. Зображення має працювати як банер кампанії 16:9: товар праворуч, короткий заголовок ліворуч, чистий негативний простір і чіткі краї продукту.
Друга версія повідомляє моделі, що її оцінюють за макетом і придатністю до використання, а не лише за естетикою.
Ставтеся до тексту як до заблокованого активу
Будь-який обов’язковий текст беріть у лапки й точно описуйте, як його треба відтворити — не просіть «слоган», якщо не хочете, щоб модель вигадувала слова за вас.
Заголовок: “SOUND YOU CAN FEEL”. Відтвори заголовок дослівно. Без зайвих слів, без дубльованого тексту, без фальшивого логотипа. Жирний білий шрифт без засічок, ліва частина композиції, читабельний здалеку.
Для довшого тексту явно розбивайте кожен рядок у промпті. Якщо слово повертається з помилкою, згенеруйте знову з коротшим текстом, більшим кеглем і суворішою інструкцією «лише точний текст».
Задайте моделі камеру й макет
Прямо вкажіть відстань камери, ракурс, розміщення об’єкта, негативний простір і співвідношення сторін — GPT Image 2 добре дотримується композиційних підказок, але лише коли їх прописано явно.
- Крупний план — для текстури товару, рук, облич, матеріалів, етикеток.
- Загальний план — для середовищ, сюжетних сцен, міських постерів, кадрів, готових до відео.
- Вид зверху — для їжі, сцен на столі, флетлеїв, наборів пакування.
- Ліва третина / права третина — для рекламних макетів, що балансують текст і товар.
- Чиста сітка — для UI-макетів, аркушів персонажів, схем, інфографіки.
Пишіть правки трьома реченнями
Найсильніші промпти для редагування відокремлюють зміну від того, що має лишитися недоторканим, і від фізичної реалістичності, яка їх пов’язує:
Заміни припаркований автомобіль на вінтажний велосипед. Збережи будинок, паркан, під’їзд, озеленення, напрямок світла, ракурс камери й час доби точно як є. Узгодь масштаб велосипеда, контактну тінь і перспективу з наявною сценою.
Структура «зміни, збережи, узгодь» стабільно перевершує розпливчасте прохання «зроби це кращим».
Додайте підказку руху, якщо кадр стане відео
Якщо зображення згодом може піти в пайплайн PixVerse image-to-video, одразу просіть глибину й готовність до руху: передній план, середній план, задній план, чистий силует об’єкта й одну видиму деталь, яка може рухатися — пил, тканину, волосся, дощ, відблиск або траєкторію наїзду камери.
Замість: Астронавт у пустелі.
Використовуйте: Кінематографічний перший кадр для кліпу image-to-video: самотній астронавт стоїть на краю сяючого пустельного кратера на світанку, плащ і пил готові рухатися на вітрі, сильний силует на передньому плані, чіткі шари глибини й тепле світло горизонту.
Як ми тестували GPT Image 2
В обох раундах тестування ми проганяли модель через портрети, постери з великою кількістю тексту, композиції в стилі товару, аркуші персонажів, UI-макети й експериментальні наративні сцени. Мета була не в балі бенчмарку — а в тому, чи зможе дизайнер, маркетолог або автор віддати результат у роботу з легкими правками, а не збирати актив з нуля.
| Зона тесту | Що ми перевіряли |
|---|---|
| Портрети й кінематографічні кадри | Контроль освітлення, текстура шкіри, відблиски, настрій, узгодженість сцени |
| Постери й типографічні макети | Правопис заголовків, багаторядковий текст, ієрархія, негативний простір, брендовий рівень оздоблення |
| Аркуші персонажів і концептів | Узгодженість кількох ракурсів, деталі костюма, збіг палітри, точність підписів |
| UI та соцмакети | Реалістичність макета, дрібний текст, інтервали іконок, сітки стрічки, правдоподібність скриншота |
| Експериментальні промпти | Гумор, наративне міркування, розміщення об’єктів, точність дрібних підписів |
Закономірність трималася в обох раундах: GPT Image 2 краще винагороджує точний бриф, ніж ланцюжок ключових слів. Коли промпт називає завдання й визначає успіх — точний текст, зафіксований макет, повторювану структуру панелей — модель схильна зберігати структуру. Коли промпт просить лише розмитий настрій, результат усе одно може виглядати відшліфовано, але його важче використати повторно без правок.
Сценарії використання GPT Image 2 з прикладами промптів
Ми навантажувально перевірили п’ять різних можливостей у цих сценаріях: контроль освітлення, типографіку з точним текстом, композицію з багатьох елементів, узгодженість персонажа й макет UI. Кожен промпт нижче можна скопіювати й адаптувати.
Кінематографічна портретна фотографія
Це перевіряє, наскільки модель розуміє освітлення, атмосферу й стриману композицію — основи, які відрізняють зображення, готове до портфоліо, від типового AI-рендера.
Промпт:
Згенеруй кінематографічний портрет самотньої фігури, що стоїть у середовищі з інтенсивним градієнтом від помаранчевого до червоного. Сильне силуетне світло ззаду, глибокий контраст тіней, глянцева підлога, що віддзеркалює фігуру. Симетрична композиція, мінімальний дизайн декорацій, без візуального шуму на тлі. Настрій споглядальний і потужний, ніби кадр із науково-фантастичного фільму. Співвідношення сторін 16:9.
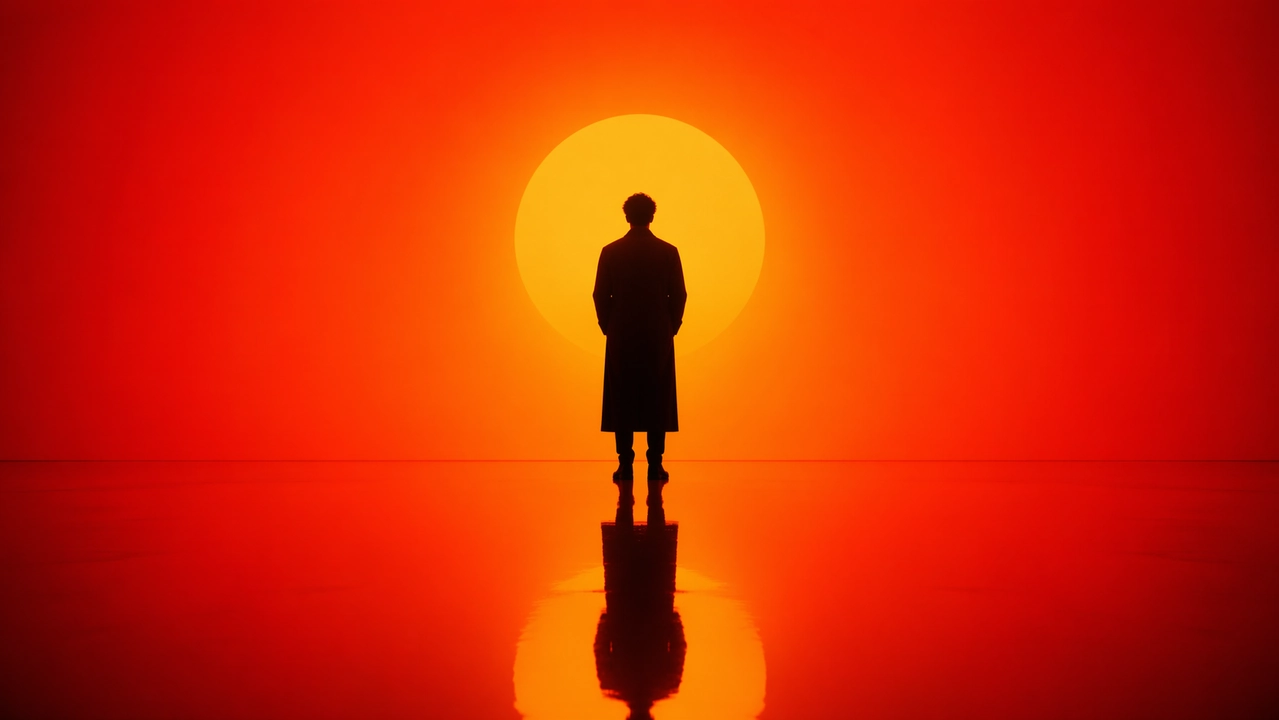
На що звернути увагу: чисті краї силуету без ореолів, точне віддзеркалення на підлозі з правильною перспективою, плавний (не смугастий) градієнт і поза, яка має реальну вагу, а не виглядає задерев’янілою чи такою, що зависла в повітрі.
Міський постер і дизайн ілюстрації
Найжорсткіший стрес-тест для читабельної типографіки в парі зі щільною багатоелементною композицією — понад десять окремих візуальних елементів уздовж S-подібної кривої, з англійським текстом, який має пережити рендер неушкодженим.
Промпт:
Вражаючий міський постер Spring 2026 для Нью-Йорка зі сміливим сучасним дизайном і елегантним святковим настроєм. Чисте текстурне тло кольору слонової кістки з щедрим негативним простором. Мініатюрний каякер веслує вузькою стрічкою відбивної води в нижньому правому куті. Слід на воді здіймається вгору динамічною каліграфічною кривою, поступово перетворюючись на річку Гудзон, а потім на сновидну написану вручну панораму Мангеттена. Усередині композиції у формі річки: Empire State Building, Brooklyn Bridge, крона Central Park, One World Trade Center, дахи браунстоунів, жовті таксі, поромні судна в гавані та Статуя Свободи в м’якій далині. М’який ранковий туман, золоте весняне світло, стримані акценти темно-синього й золотого. Елегантна типографіка внизу ліворуч читається “SPRING 2026” з вертикальним слоганом “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Текст має бути різким і красиво скомпонованим. Без зайвих слів. Преміальний графічний дизайн, співвідношення сторін 9:16.
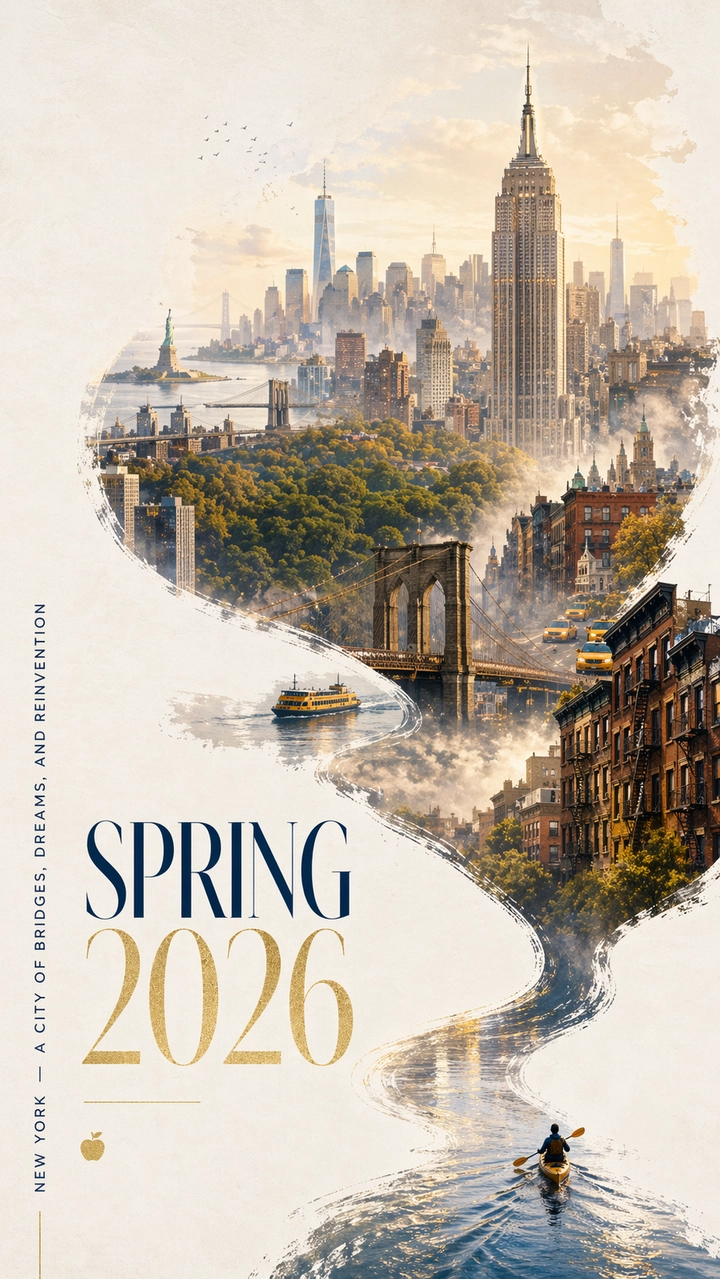
На що звернути увагу: кожна літера в назві й слогані має бути читабельною і правильно написаною, S-крива має природно текти від каякера до силуету міста, знакові будівлі мають читатися як упізнавані, а не як типові вежі, а негативний простір має здаватися навмисним, а не порожнім.
Дизайн персонажа й референсний аркуш
Розробникам ігор і концепт-художникам потрібна узгодженість кількох ракурсів з однієї генерації. Це перевіряє, чи може модель утримати дизайн персонажа стабільним у вигляді спереду, збоку й ззаду.
Промпт:
Створи професійний референсний аркуш персонажа для оригінального фентезійного RPG-персонажа: молода жінка-маг зі срібним волоссям і фіолетовими очима, в ошатному темному плащі зі світними рунічними візерунками. На чистому білому тлі включи: розворот у трьох ракурсах — спереду, збоку й ззаду; варіації виразу обличчя — нейтральний, усміхнений, злий і здивований; детальні розкладки елементів костюма й спорядження; ряд зразків кольорової палітри; і короткі нотатки з побудови світу чистою типографікою. Організований сітковий макет, стиль концепт-арту, висока роздільність. Співвідношення сторін 16:9.
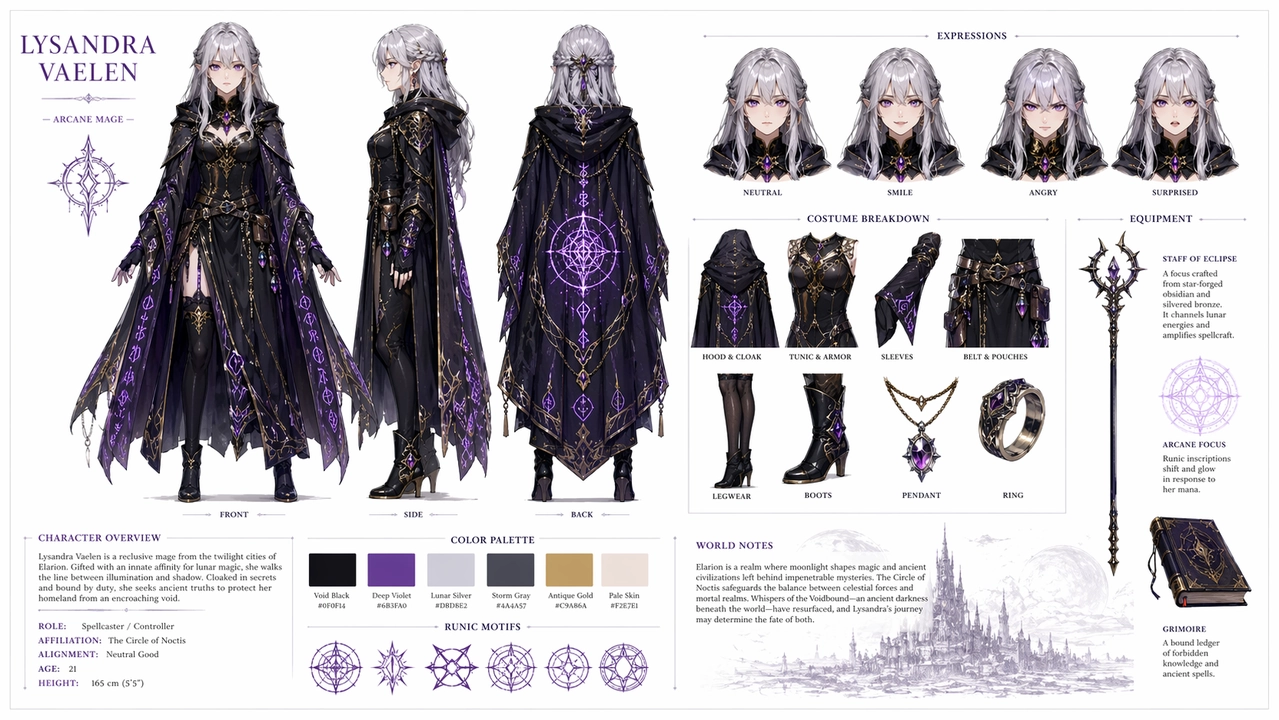
На що звернути увагу: обличчя, волосся й одяг мають лишатися узгодженими в усіх трьох ракурсах; варіації виразу мають змінювати лише обличчя, а не зачіску чи одяг; зразок палітри має справді збігатися з кольорами в малюнку; текстові підписи мають бути написані правильно. Якщо вид збоку або ззаду «пливе», згенеруйте знову з сильнішою мовою «збережи», повторюючи якірні ознаки ідентичності.
Макет UI та соцмереж
Це одночасно навантажує три речі: піксельно точний макет UI, рендеринг тексту різними мовами й творче злиття концептів — контент такого типу також зазвичай добре працює на соцплатформах.
Промпт:
Гіперреалістичний скриншот iPhone вигаданої сторінки профілю Instagram Леонардо да Вінчі, ім’я користувача @davinci_official, ніби він сучасний інфлюенсер у 2026 році. Фото профілю — ренесансний автопортрет у круглому кропі. Біо читається: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Сітка показує 9 дописів: Мона Ліза, переосмислена як селфі в дзеркалі, ескіз гелікоптера з підписом “just dropped my new drone design”, анатомічне дослідження, опубліковане як фото прогресу в залі, Таємна вечеря, поставлена як групове фото з вечері, та інші творчі анахронічні мешапи. Кількість підписників: 12.4M. Акценти історій підписані Sketches, Inventions і Florence Life. Повна панель стану iOS із текстом оператора “Renaissance 5G”, іконкою батареї й поточним часом. UI в темному режимі повсюдно. Фотореалістична якість скриншота, співвідношення сторін 9:16.
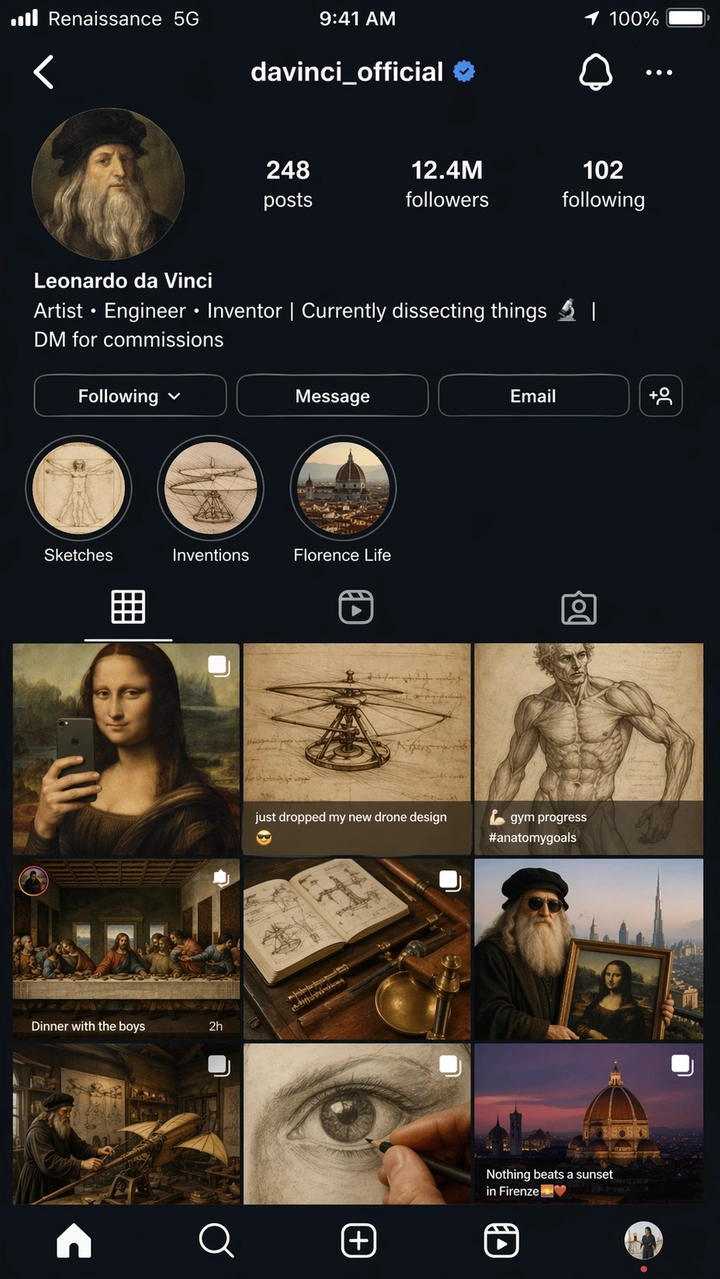
На що звернути увагу: елементи інтерфейсу Instagram — інтервали сітки, макет профілю, кола історій, панель вкладок — мають читатися як справжній скриншот iOS, а не стилізоване наближення. Увесь текст має бути читабельним, а підпис оператора “Renaissance 5G” — це навмисна перевірка точності. Будь-який вивід UI-макета вважайте концепт-референсом, а не готовим до продакшену UI; дрібні підписи й вирівнювання іконок зазвичай потребують проходу прибирання.
Творче й експериментальне мистецтво
Короткі промпти з вбудованим наративним гумором перевіряють, чи модель сама заповнює творчі прогалини, а не покладається на вичерпні інструкції.
Промпт:
Усередині музейної експозиції під назвою “Ancient Technology: The Desktop Era” програміст у скляній вітрині наживо демонструє кодування на CRT-моніторі, поки захоплені школярі притискають обличчя до скла. Табличка експоната читається: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Поруч друга вітрина показує фізичну книгу з підписом “Stack Overflow — Print Edition, Vol. 1 of 4,827”. Стиль 2D-мультфільмної ілюстрації, тепле музейне освітлення, гумористичний і ностальгійний тон. Співвідношення сторін 16:9.
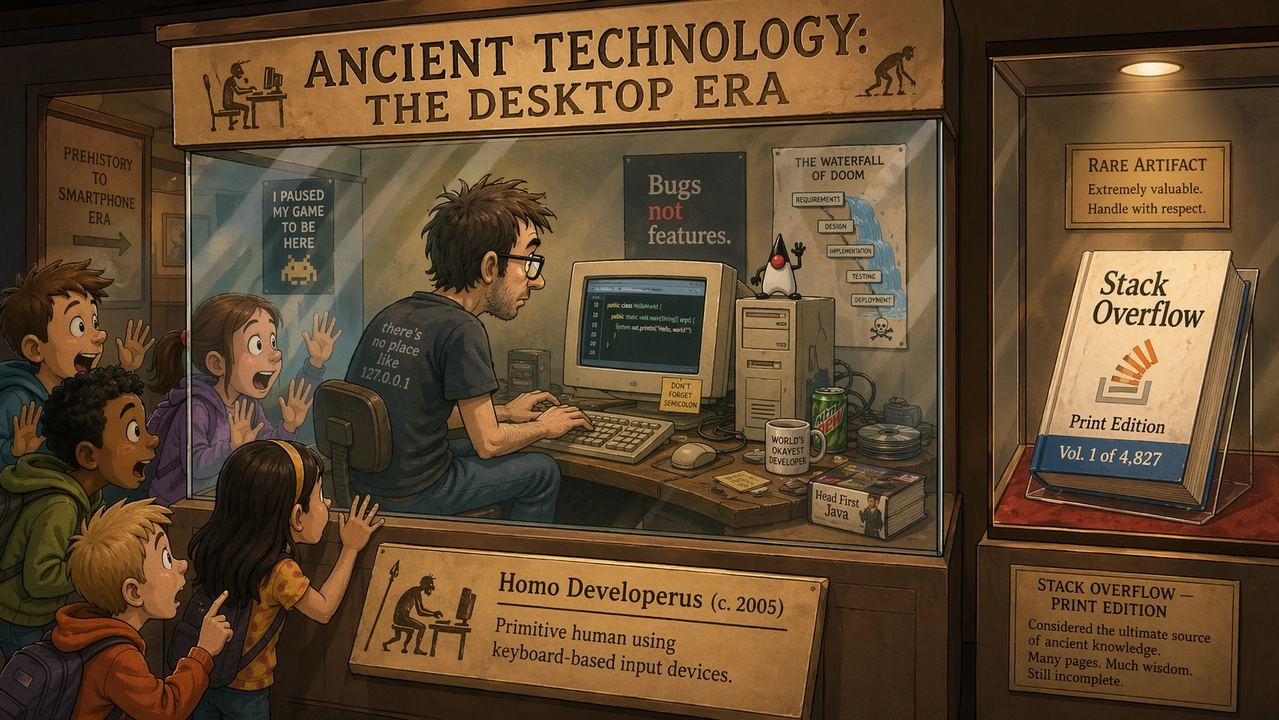
На що звернути увагу: гумор має спрацьовувати через візуальні деталі, а не лише через текст підпису. Табличка й назва книги мають лишатися читабельними й правильно написаними — це справді складний тест для багаторядкового тексту малого розміру — а мультфільмний стиль має відчуватися цілісним на всій сцені, а не фотореалістичним клаптями.
Результати тестів за сценаріями використання
Найсильніші результати стабільно давали промпти з очевидним продакшен-стандартом — тим, що можна оцінити за правописом, макетом, збереженням об’єктів або порядком панелей. Промпти лише з розмитим настроєм давали більш мінливі результати.
| Сценарій використання | Що спрацювало добре | Що все ще потребує перевірки |
|---|---|---|
| Рендеринг тексту | Великі заголовки, короткі підписи, назви постерів і прості підписи UI лишалися точними, коли точний текст було взято в лапки. | Дрібний юридичний текст, щільні абзаци й стилізовані шрифти все ще можуть «плисти» — тримайте текст коротким і перевіряйте кожну літеру. |
| Зображення товарів | Чисті рекламні макети, негативний простір кампанії й композиції з товаром на першому плані відтворювалися добре. | Справжні етикетки, логотипи й регульовані твердження все ще потребують ручної перевірки або композитингу з затверджених активів. |
| UI-макети | Мобільні екрани, дашборди й ієрархія, схожа на застосунок, виглядали правдоподібно, коли промпт називав реальні елементи інтерфейсу. | Вважайте результати концепт-макетами — дрібні підписи й вирівнювання іконок зазвичай потребують прибирання. |
| Узгодженість персонажа | Аркуші персонажів, ряди виразів і зразки палітри добре працювали як творчі референси. | Обличчя й деталі костюма можуть розходитися між ракурсами; повторюйте якірні ознаки ідентичності й за потреби генеруйте знову. |
| Редагування й композитинг | Шаблон «зміни, збережи, узгодь» перевершив широкі запити на правку. | Межі виділення й вивід із прозорим фоном усе ще потребують QA. |
Типові помилки в промптах для GPT Image 2
- Просити точний текст, не надавши точного формулювання. Якщо текст важливий, випишіть його дослівно й скажіть, де він має стояти.
- Перевантажувати один промпт усіма можливими деталями. Почніть із ядра сцени, потім уточнюйте по одній змінній за раз.
- Забувати вказувати інваріанти під час правок. Пропишіть, що має лишитися незмінним: ідентичність, тло, поза, освітлення, форма товару, текст етикетки, ракурс камери.
- Спиратися на декоративні слова якості для функціональних завдань. «Гарний» не робить етикетку читабельною — натомість використовуйте формулювання на кшталт «різкий текст етикетки» або «читабельний здалеку».
- Пропускати співвідношення сторін. Сильне квадратне зображення все одно може провалитися як вертикальна реклама чи прев’ю відео.
- Ставитися до логотипів як до звичайного тексту. GPT Image 2 може розробити концепти логотипів, але точні знаки бренду треба компонувати із затверджених активів, а не просити напряму в промпті.
Нотатки про API та ціни GPT Image 2
Сторінка цін API OpenAI подає GPT Image 2 на основі токенів, а не фіксованої ставки за зображення:
| Позиція | Зазначена ціна |
|---|---|
| Вхід зображення | $8.00 / 1M токенів |
| Кешований вхід зображення | $2.00 / 1M токенів |
| Вихід зображення | $30.00 / 1M токенів |
| Вхід тексту | $5.00 / 1M токенів |
| Кешований вхід тексту | $1.25 / 1M токенів |
Фактична вартість одного зображення залежить від довжини промпта, референсних зображень, розміру виводу, кешування й налаштування якості. Квоти тарифів ChatGPT — це окремий трек від білінгу API: підписка Plus не перетворюється напряму на кредит API, тож бюджетуйте їх незалежно, якщо користуєтеся обома.
Для робочих процесів із великим обсягом важлива цифра — вартість за прийнятий актив після повторних спроб, а не прайс однієї спроби. Дешевша генерація насправді не дешевша, якщо для правильного правопису чи макета потрібні три перегенерації.
| Робочий процес | Практична порада щодо промптів |
|---|---|
| Постери чи схеми з великою кількістю тексту | Менше слів на зображення, точний текст у лапках, ієрархію вказуйте явно. |
| Фото товарів | Зафіксуйте форму товару, етикетку, колір, матеріал і ракурс камери; повторюйте список «зберегти» на кожному проході правки. |
| UI-макети | Описуйте екран як відвантажений інтерфейс — навігація, картки, кнопки, стани — а не як концепт-арт. |
| Правки з кількома референсами | Позначте кожне вхідне зображення за роллю: об’єкт, стиль, тло, одяг або референс матеріалу. |
| Пакетна генерація | Рахуйте вартість за прийняте зображення, а не за спробу. |
Якщо хочете побачити, як GPT Image 2 виглядає проти альтернативи з пріоритетом фотореалізму на однакових промптах, наше порівняння GPT Image 2 та Nano Banana 2 проводить шість очних раундів із повним розбором цін API і платформи.
Від зображення до відео: завершіть творчий процес на PixVerse
Сильне зображення — це один крок. Перетворити його на рух — саме там більшість робочих процесів ламається: ви завершуєте портрет або товарний постер у GPT Image 2, а потім мусите відкрити окремий інструмент, повторно завантажити файл і сподіватися, що відеомодель не спотворить ретельно скомпоноване зображення. Саме це тертя передачі PixVerse прибирає.
GPT Image 2 уже доступний на PixVerse
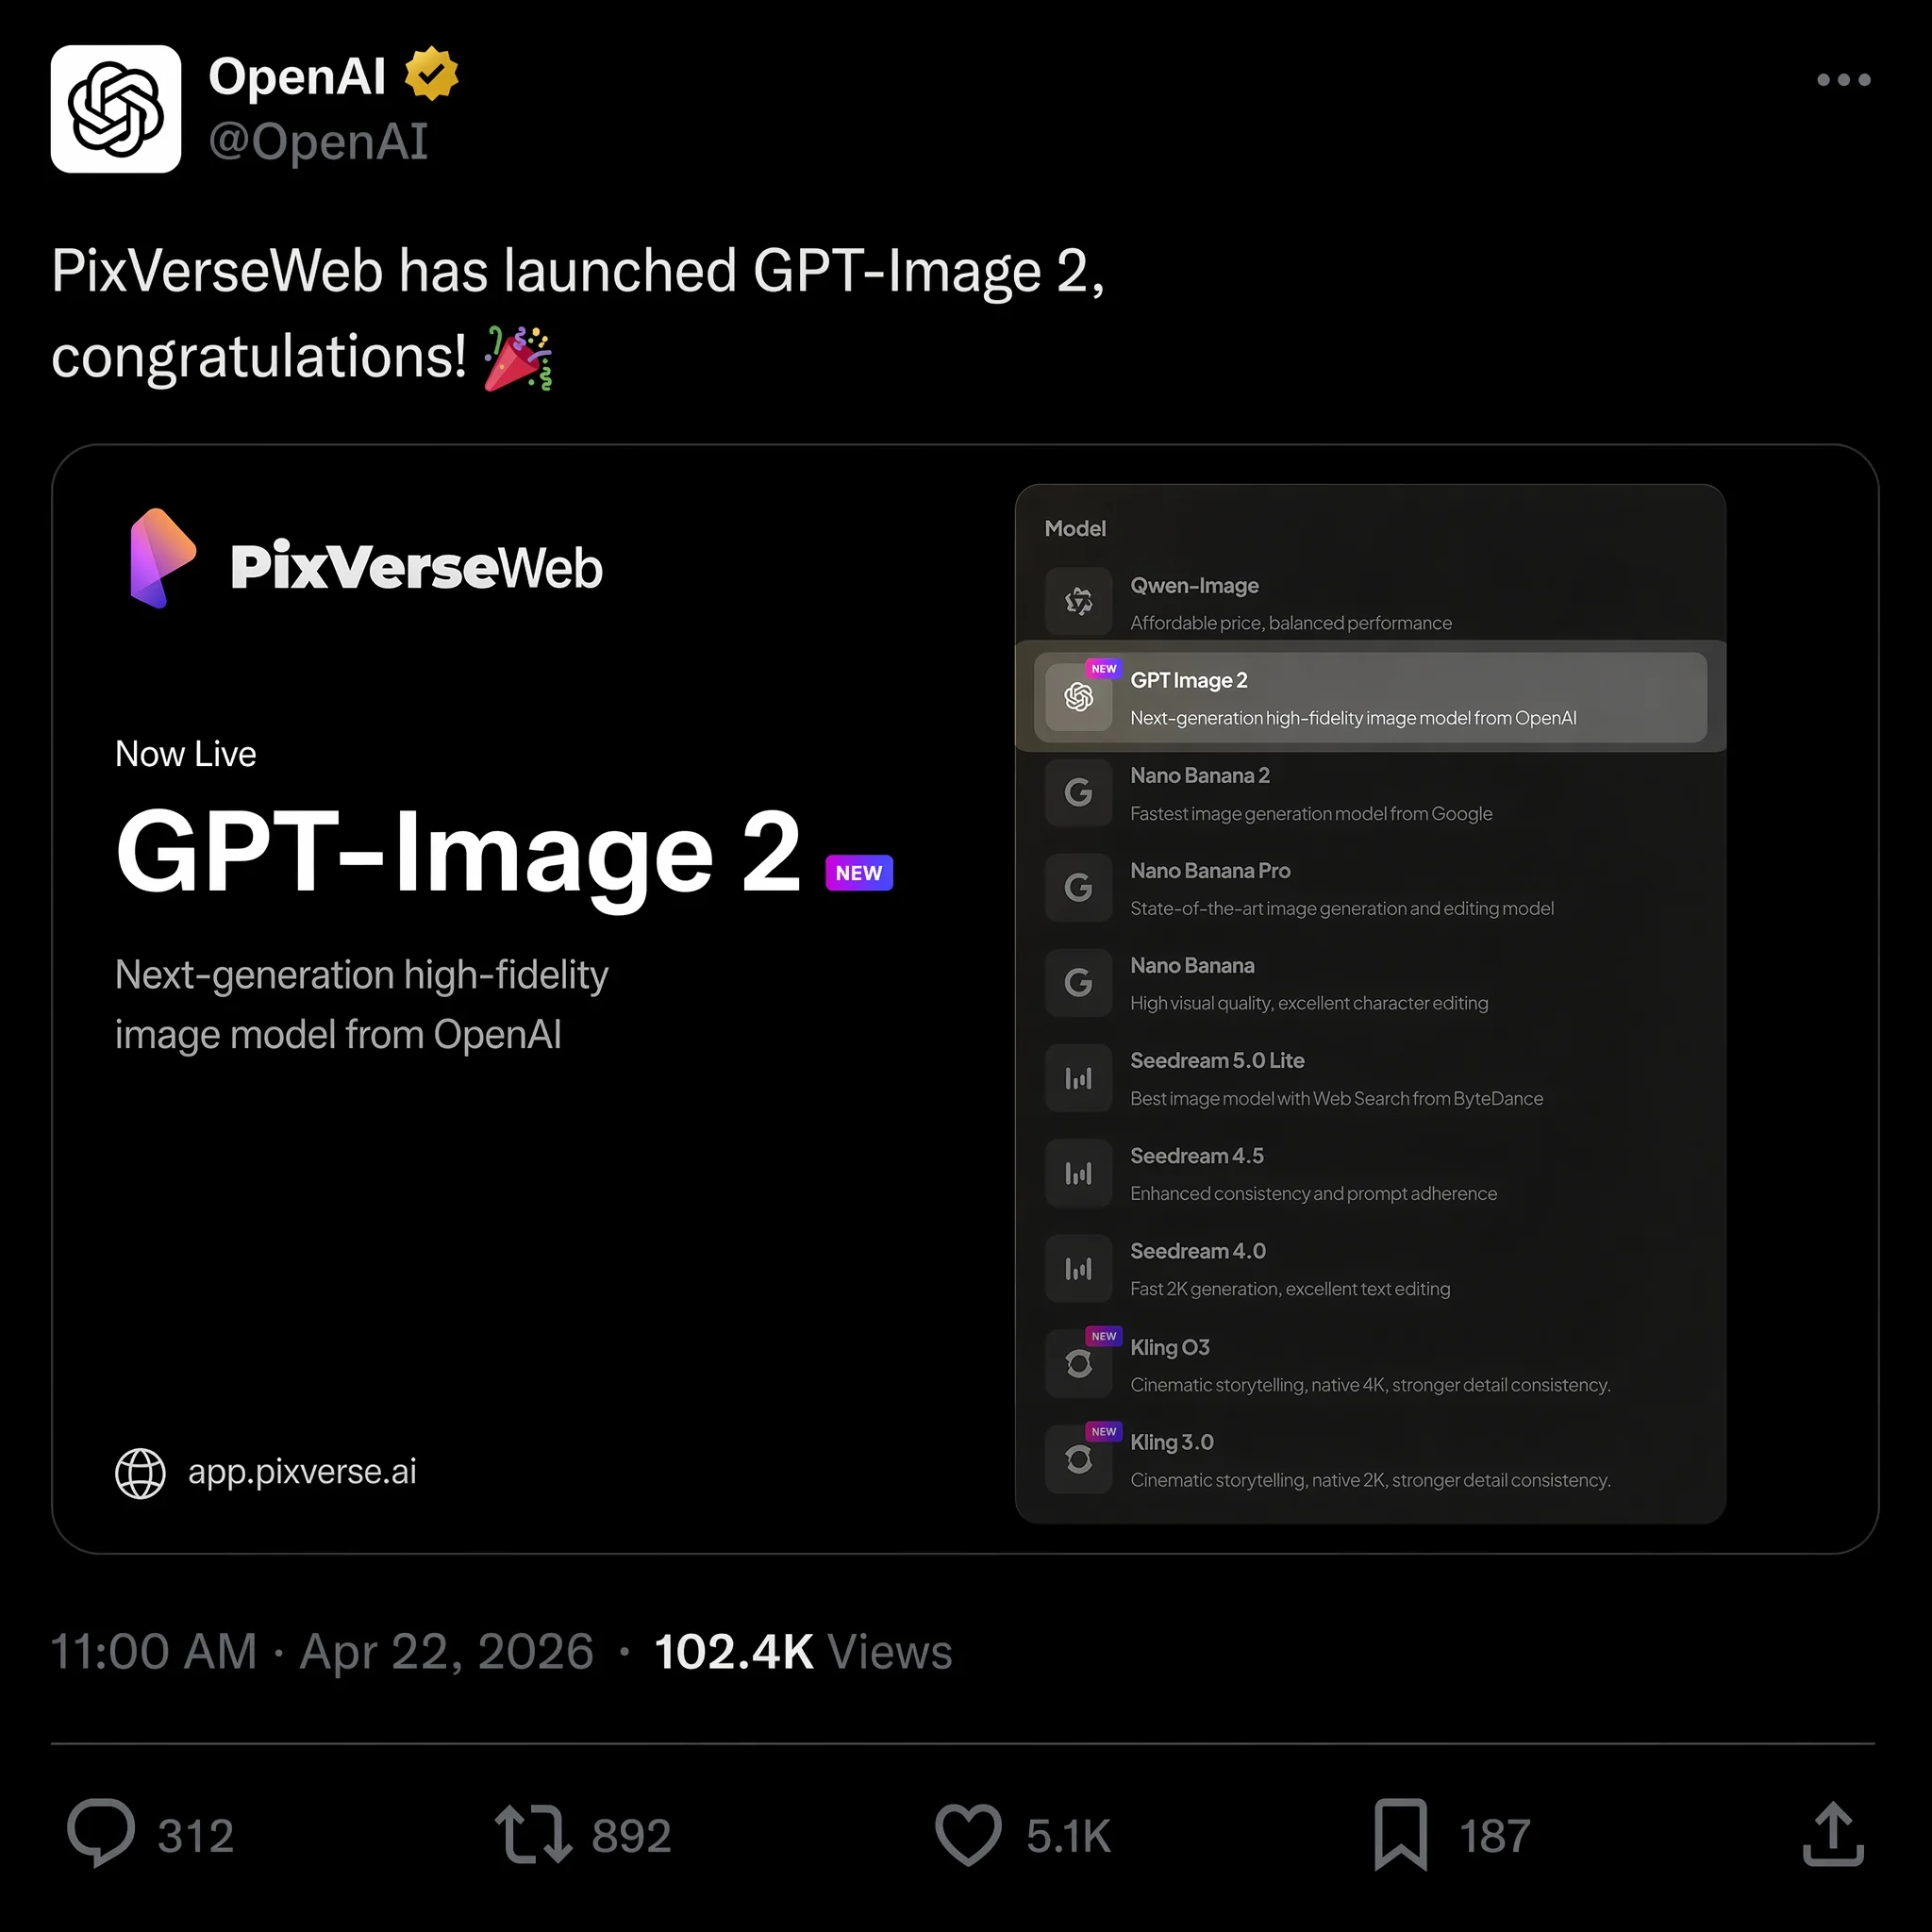
22 квітня 2026 року PixVerse додав GPT Image 2 як опцію text-to-image поряд із Nano Banana 2, Seedream і HappyHorse 1.0 у лінійці моделей. Ви можете згенерувати зображення за допомогою GPT Image 2 і перетворити його на відео в тому самому робочому просторі — без завантаження, повторного завантаження чи перемикання вкладок.
Це важливо з конкретної причини: коли зображення одразу йде в пайплайн image-to-video на тій самій платформі, відеомодель працює безпосередньо з вихідним файлом повної роздільності та його метаданими. Уздовж шляху немає втрати якості через стиснення чи конвертацію формату, а отже — чистіший рух і менше артефактів у фінальному кліпі.
Якщо кадр має стати кліпом, із самого початку просіть готовність до руху — передній, середній і задній плани глибини, чистий силует об’єкта й один фізичний елемент, який правдоподібно може рухатися (пил, пара, тканина, джерело світла, що зміщується). Переглядайте кадр як готовий файл дизайну перед анімацією: спочатку перевірте правопис, геометрію товару й вирівнювання UI, бо відеомодель сама не виправить заголовок з помилкою чи викривлену етикетку. Потім напишіть окремий, коротший промпт руху, який описує лише те, що має рухатися, і те, що має лишитися заблокованим, а не повторює весь бриф зображення.
Чому автори переходять на платформу «все в одному»
Якщо до березня 2026 року ви користувалися Sora від OpenAI для генерації відео, ви вже знаєте ризик побудови робочого процесу навколо одного інструмента. OpenAI закрила застосунок і API Sora 24 березня, пославшись на нестійкі витрати й поворот до робототехніки, і тисячі авторів за ніч втратили свій відеопайплайн. Дивіться наш гід альтернативами Sora — повний розбір того, що сталося і які інструменти закрили прогалину.
PixVerse обирає інший підхід: дає доступ до кількох моделей уздовж усього творчого пайплайна, а не замикає вас в одній:
- Text-to-image з GPT Image 2, Nano Banana 2, Seedream та іншими — обирайте модель під завдання
- Image-to-video, що перетворює згенеровані зображення на рух із узгодженістю персонажа і контролем камери
- Text-to-video для кліпів, згенерованих безпосередньо з письмового промпта за допомогою PixVerse V6 або кінематографічної моделі C1
- Нативна генерація аудіо, що автоматично синхронізує звукові ефекти й діалоги з вашим відео
Практична вигода: можна пройти від письмового концепту до готового відео із синхронізованим аудіо, не залишаючи одного робочого простору, і це прибирає години роботи з файлами з кожного проєкту. Якщо вам зручніше скриптувати генерацію з командного рядка, гід PixVerse CLI описує автоматизацію і зображень, і відео.
PixVerse також дає новим користувачам 30–60 безкоштовних кредитів щодня, тож ви можете протестувати весь пайплайн — від генерації зображення до відеовиводу — перш ніж переходити на платний тариф.
Часті запитання
Чи можна користуватися GPT Image 2 безкоштовно?
Безкоштовні користувачі ChatGPT можуть генерувати приблизно два зображення на день за допомогою GPT Image 2. Підписники ChatGPT Plus ($20/місяць) отримують необмежені генерації зі швидшою обробкою. Доступ до API тарифікується за токени — вхід зображення, вихід зображення й вхід тексту, — тож вартість масштабується з довжиною промпта й розміром виводу, а не фіксованою платою за зображення.
Яку роздільність підтримує GPT Image 2?
GPT Image 2 генерує зображення в нативній роздільності 2K, з опційним апскейлом до 4K через API. Співвідношення сторін — від 3:1 до 1:3, тож квадратні, вертикальні й ультраширокі формати доступні безпосередньо.
Чи може GPT Image 2 точно відтворювати текст на зображеннях?
Так — це одна з його найсильніших можливостей. У нашому тестуванні точність тексту англійською, китайською, японською, корейською й арабською перевищила 95% уже з першої спроби генерації. Багаторядкові заголовки, назви постерів і текстові підписи UI обробляються надійно, хоча дуже дрібний текст на низькій роздільності все ще іноді може спрацьовувати з помилкою.
Як GPT Image 2 порівнюється з Midjourney і Nano Banana 2?
Midjourney V8 має сильніший контроль художнього стилю й більш усталену спільноту для естетичного доведення. Nano Banana 2 — сильніший вибір для фотореалізму, кінематографічного світла й швидких ітерацій. GPT Image 2 має перевагу в рендерингу тексту, структурованих макетах і редагуванні природною мовою. Для дизайну постерів і маркетингових матеріалів із текстом GPT Image 2 зараз виграє; для чистої художньої розвідки чи фотореалістичних hero-кадрів два інші варто порівнювати напряму — дивіться наш очний тест проти Nano Banana 2.
Які найкращі альтернативи Sora для відео після закриття?
Після того як OpenAI закрила Sora в березні 2026 року, топ-альтернативи включають PixVerse V6 для багатокадрового відео з узгодженим персонажем, Runway Gen-4 для кінематографічного контролю камери і Kling v3.0 для екшен-сцен. PixVerse — єдина платформа, що поєднує text-to-image, image-to-video і text-to-video з нативним аудіо, і все це доступне з щоденними безкоштовними кредитами. Дивіться наш повний гід альтернативами Sora для детального порівняння.
Чи можу я перетворити результати GPT Image 2 на відео?
Так. Оскільки GPT Image 2 доступний у PixVerse, ви можете згенерувати зображення в застосунку й перетворити його на відео через пайплайн image-to-video в тому самому робочому просторі, без передачі файлів. Ви також можете завантажити файл GPT Image 2, створений деінде, і прогнати його через той самий пайплайн.