Đánh giá GPT Image 2: Hướng dẫn prompt và tình huống sử dụng năm 2026
OpenAI phát hành GPT Image 2 vào ngày 21 tháng 4 năm 2026 — thế hệ kế tiếp của GPT Image 1.5 và model hiện đang chạy tạo ảnh trên khắp ChatGPT. Chúng tôi đã thử trong tuần ra mắt và quay lại vào cuối tháng 6 với một bộ prompt rộng hơn, hướng dẫn viết prompt của chính OpenAI, và bảng giá API đã công bố, để xem model trụ thế nào khi cơn hype ban đầu lắng xuống.
Điểm chính:
- GPT Image 2 tạo ảnh ở độ phân giải 2K gốc, có thể upscale 4K tùy chọn, và độ chính xác render chữ trên 95% với chữ Latin, tiếng Trung, tiếng Nhật, tiếng Hàn và tiếng Ả Rập.
- Model nên được coi là trợ lý thiết kế hơn là máy tạo ảnh: nó xuất sắc ở các việc có tiêu chuẩn thành công rõ — chữ chính xác, bố cục bị khóa, cấu trúc panel lặp lại được — và kém dự đoán hơn với các prompt mở kiểu “làm cho đẹp”.
- Tái tạo logo thương hiệu, chữ pháp lý rất nhỏ và font độc quyền vẫn là điểm yếu, cần rà soát thủ công.
- API của OpenAI tính phí GPT Image 2 theo token trên đầu vào ảnh, đầu vào ảnh được cache, đầu ra ảnh, đầu vào chữ và đầu vào chữ được cache — một mô hình giá khác với các bậc giá theo ảnh mà một số đối thủ dùng.
- PixVerse đưa GPT Image 2 vào dải text-to-image cùng Nano Banana 2 và Seedream, nên ảnh đã tạo có thể đi thẳng vào pipeline image-to-video mà không rời workspace.
GPT Image 2 là gì? Tính năng chính và giới hạn
GPT Image 2 là model ảnh thế hệ thứ hai của OpenAI, thay GPT Image 1.5 trên ChatGPT và API. Nó cạnh tranh với Midjourney, DALL-E 3 và Stable Diffusion, nhưng đặt bản sắc vào hai thứ: chữ chính xác bên trong ảnh, và một lớp suy luận diễn giải ý định của prompt thay vì chỉ khớp từ khóa.
Các tính năng cốt lõi trong một cái nhìn
| Tính năng | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Độ phân giải gốc | 2K (có upscale 4K) | 1K | 2K (với cờ —hd) |
| Độ chính xác render chữ | 95%+ đa ngôn ngữ | ~70% (chỉ Latin) | ~80% (chỉ Latin) |
| Tích hợp suy luận | Có — diễn giải chỉ dẫn nhiều lớp | Không | Không |
| Dải tỷ lệ khung hình | 3:1 đến 1:3 | 1:1, 16:9 | 1:1 đến 3:2 |
| Nhất quán nhân vật | Mức pixel giữa các ảnh liên tiếp | Hạn chế | Trung bình (cờ —cref) |
| Chỉnh sửa bằng ngôn ngữ tự nhiên | Có — chỉnh vùng bằng cách mô tả | Không | Không |
| Giá | Theo token qua API; các bậc gói ChatGPT | Giống vậy | Đăng ký $10–30/tháng |
Render chữ là tính năng được chú ý nhiều nhất, và có lý do chính đáng. Các model ảnh cũ coi chữ như kết cấu — yêu cầu một tiêu đề poster và bạn nhận nhiễu hình chữ. GPT Image 2 xử lý tiêu đề tiếng Anh nhiều dòng, ký tự tiếng Trung và bố cục đa ngôn ngữ với độ nhất quán thật; trong các bài thử của chúng tôi, khoảng 19 trên 20 lần tạo ra chữ đọc được hoàn toàn ngay lần đầu.
Tích hợp suy luận nghĩa là model làm nhiều hơn việc khớp mẫu lời bạn viết. Hãy bảo nó “tạo một infographic về các hoạt động cho thời tiết ngày mai ở San Francisco”, và nó sẽ lấy dự báo, chọn hoạt động phù hợp, rồi dựng bố cục quanh dữ liệu đó — một bước vượt cách Midjourney hoặc Stable Diffusion xử lý prompt.
Chỉnh sửa bằng ngôn ngữ tự nhiên cho phép bạn sửa ảnh bằng cách mô tả thay đổi thay vì che tay. “Đưa tách cà phê sang bên trái bàn” hoặc “đổi bầu trời thành hoàng hôn” đều áp dụng như các chỉnh sửa có mục tiêu mà không tạo lại cả cảnh.
Người dùng đang nói gì
Phản hồi từ lúc ra mắt phần lớn là tích cực, kèm một nhóm phàn nàn nhất quán. Các bài thử chân dung lan truyền trên X và Reddit trông sát ảnh studio, và các nhà thiết kế poster thử bố cục dài — tờ rơi, thực đơn, biển hiệu — báo rằng độ chính xác chữ cuối cùng cũng trụ được khi dùng thật. Một số nhà thiết kế nói họ có thể bỏ một lượt Photoshop cho tài sản marketing cơ bản vì cảm nhận bố cục của chính model đủ mạnh để quyết định bố cục mà không cần trợ giúp.
Lời khen mạnh nhất tập trung vào việc bám prompt: yêu cầu 15 yếu tố cụ thể trong một cảnh và GPT Image 2 thường đưa vào đủ, trong khi các model cũ bắt đầu bỏ chi tiết khi prompt dài ra.
Ở mặt tiêu cực, độ trung thực thương hiệu vẫn không ổn định. Một bài thử thực chiến của ZDNet được chia sẻ rộng rãi cho thấy model không tái tạo chính xác logo ZDNET, và người dùng khác báo cùng vấn đề với các dấu hiệu thương hiệu cụ thể. Model hiểu logo là gì về mặt khái niệm, nhưng không tái tạo đáng tin các hình vector chính xác hoặc bộ chữ độc quyền.
Các giới hạn đã biết
- Tái tạo logo thương hiệu không đáng tin cậy — hãy ghép logo chính xác trong Photoshop hoặc Figma sau khi tạo ảnh, thay vì yêu cầu mô hình vẽ chúng trực tiếp.
- Tốc độ tạo ảnh chậm hơn các mô hình nhẹ hơn như FLUX hay Nano Banana 2; trên ChatGPT Plus thường mất 30–60 giây, trong khi nơi khác dưới 10 giây.
- Giới hạn tốc độ gói miễn phí khá chặt — người dùng ChatGPT miễn phí chỉ được khoảng hai ảnh mỗi ngày. Người đăng ký Plus được tạo ảnh không giới hạn trên ChatGPT, nhưng chi phí API tăng theo khối lượng.
- Kiểm soát phong cách thô hơn Midjourney. Bạn không thể tinh chỉnh loại phim, loại ống kính hay hạt nhiễu với cùng độ chính xác, và thiên kiến thẩm mỹ của chính mô hình cần prompt có chủ đích mới ghi đè được.
- Chính sách nội dung nghiêm ngặt hơn các lựa chọn mã nguồn mở, nên một số prompt chạy tốt trên Stable Diffusion hoặc mô hình cục bộ sẽ bị từ chối ở đây.
Không điều nào trong số này loại trừ việc dùng cho sản xuất, nhưng đáng biết trước khi bạn xây một pipeline chỉ xoay quanh một mô hình.
Cách viết prompt GPT Image 2 thực sự hiệu quả
Thay đổi rõ nhất ở vòng thử nghiệm thứ hai: những prompt GPT Image 2 tốt nhất không chỉ mô tả một bức ảnh — chúng mô tả công việc bức ảnh phải làm. Prompt cho quảng cáo mạng xã hội nên đọc khác với ảnh cắt nền sản phẩm, infographic, màn hình UI, hay khung hình đầu tiên dành cho video.
Một mẫu đáng tin để cấu trúc brief:
Tạo [loại ảnh] cho [trường hợp sử dụng]. Chủ thể chính: [chủ thể cụ thể và chi tiết nhìn thấy]. Văn bản chính xác, nếu có: “[nội dung chữ phải xuất hiện]”. Bố cục: [khung hình, layout, khoảng trống âm, vị trí chủ thể]. Phong cách và ánh sáng: [ngôn ngữ hình ảnh, chất liệu, tâm trạng, hướng sáng]. Ràng buộc: [những gì không được đổi, không thêm chữ, không watermark]. Định dạng đầu ra: [tỷ lệ khung hình, nền trong suốt, khung sẵn sàng cho video].
Nêu công việc trước khi nói phong cách
Hãy mở đầu bằng loại đầu ra — poster, quảng cáo sản phẩm, màn hình ứng dụng, character sheet, sơ đồ, bản chỉnh sửa, hoặc khung hình đầu của video — để mô hình biết mình đang bị đánh giá theo tiêu chuẩn nào.
Yếu: Một loa tương lai ngầu, điện ảnh, chi tiết cao.
Tốt hơn: Tạo một quảng cáo sản phẩm cao cấp cho loa không dây đen mờ. Ảnh phải dùng được làm banner chiến dịch 16:9, sản phẩm nằm bên phải, một tiêu đề ngắn bên trái, khoảng trống âm gọn, và cạnh sản phẩm sắc nét.
Phiên bản thứ hai cho mô hình biết nó đang bị đánh giá về bố cục và khả năng sử dụng, không chỉ về thẩm mỹ.
Coi chữ như một tài sản đã khóa
Đặt mọi nội dung chữ bắt buộc trong dấu ngoặc kép và nói chính xác cách nó phải được hiển thị — đừng yêu cầu “một slogan” trừ khi bạn muốn mô hình tự bịa chữ.
Tiêu đề: “SOUND YOU CAN FEEL”. Hiển thị tiêu đề đúng nguyên văn. Không thêm chữ, không lặp chữ, không logo giả. Chữ sans-serif trắng đậm, bên trái bố cục, đọc được từ xa.
Với đoạn chữ dài hơn, hãy tách từng dòng rõ ràng trong prompt. Nếu một từ bị sai chính tả, hãy tạo lại với đoạn chữ ngắn hơn, cỡ chữ lớn hơn và chỉ dẫn chặt hơn là “chỉ đúng văn bản”.
Cho mô hình một máy ảnh và một bố cục
Nêu trực tiếp khoảng cách máy, góc máy, vị trí chủ thể, khoảng trống âm và tỷ lệ khung hình — GPT Image 2 tuân theo gợi ý bố cục khá tốt, nhưng chỉ khi chúng được viết rõ.
- Cận cảnh cho chất liệu sản phẩm, bàn tay, khuôn mặt, vật liệu, nhãn.
- Góc rộng cho môi trường, cảnh kể chuyện, poster thành phố, khung sẵn sàng cho video.
- Nhìn từ trên xuống cho đồ ăn, cảnh bàn làm việc, flat-lay, bộ bao bì.
- Một phần ba bên trái / một phần ba bên phải cho layout quảng cáo cân bằng chữ và sản phẩm.
- Lưới sạch cho mockup UI, character sheet, sơ đồ, infographic.
Viết lệnh chỉnh sửa trong ba câu
Những prompt chỉnh sửa mạnh nhất tách phần thay đổi khỏi những gì phải giữ nguyên và khỏi tính hiện thực vật lý gắn chúng lại:
Thay chiếc xe đang đỗ bằng một chiếc xe đạp cổ điển. Giữ nguyên chính xác ngôi nhà, hàng rào, lối xe, cảnh quan, hướng sáng, góc máy và thời điểm trong ngày. Khớp tỷ lệ xe đạp, bóng tiếp xúc và phối cảnh với cảnh hiện có.
Cấu trúc “thay đổi, giữ nguyên, khớp” đó luôn vượt trội so với một yêu cầu mơ hồ kiểu “làm cho cái này đẹp hơn”.
Thêm một gợi ý chuyển động nếu ảnh tĩnh sẽ thành video
Nếu một ảnh sau này có thể đưa vào pipeline image-to-video của PixVerse, hãy prompt sẵn chiều sâu và độ sẵn sàng cho chuyển động: tiền cảnh, trung cảnh, hậu cảnh, bóng chủ thể rõ, và một tín hiệu nhìn thấy được có thể chuyển động — bụi, vải, tóc, mưa, phản chiếu, hoặc đường đẩy máy.
Thay vì: Một phi hành gia trên sa mạc.
Hãy dùng: Một khung hình điện ảnh đầu tiên cho clip image-to-video: một phi hành gia đứng một mình bên mép miệng hố sa mạc phát sáng lúc bình minh, áo choàng và bụi sẵn sàng lay trong gió, bóng tiền cảnh mạnh, các lớp chiều sâu rõ, và ánh sáng đường chân trời ấm.
Cách chúng tôi thử nghiệm GPT Image 2
Qua cả hai vòng thử nghiệm, chúng tôi cho mô hình chạy chân dung, poster nhiều chữ, bố cục kiểu sản phẩm, character sheet, mockup UI và các cảnh kể chuyện thử nghiệm. Mục tiêu không phải một điểm benchmark — mà là liệu nhà thiết kế, marketer hay nhà sáng tạo có thể xuất bản đầu ra chỉ với chỉnh sửa nhẹ, thay vì dựng lại tài sản từ đầu.
| Hạng mục thử | Những gì chúng tôi kiểm tra |
|---|---|
| Chân dung và ảnh tĩnh điện ảnh | Kiểm soát ánh sáng, kết cấu da, phản chiếu, tâm trạng, tính nhất quán của cảnh |
| Bố cục poster và chữ | Chính tả tiêu đề, chữ nhiều dòng, phân cấp, khoảng trống âm, độ hoàn thiện giống thương hiệu |
| Bảng nhân vật và concept | Nhất quán nhiều góc nhìn, chi tiết trang phục, khớp bảng màu, độ chính xác của nhãn |
| Mockup UI và mạng xã hội | Tính hiện thực của layout, chữ nhỏ, khoảng cách icon, lưới feed, độ tin của ảnh chụp màn hình |
| Prompt thử nghiệm | Hài hước, suy luận kể chuyện, đặt vật thể, độ chính xác của chú thích nhỏ |
Quy luật giữ vững qua cả hai vòng: GPT Image 2 thưởng cho brief chính xác hơn là một chuỗi từ khóa. Khi prompt nêu rõ công việc và định nghĩa thành công — chữ chính xác, layout đã khóa, cấu trúc khung lặp lại được — mô hình có xu hướng giữ cấu trúc. Khi prompt chỉ xin một tâm trạng mơ hồ, kết quả vẫn có thể trông bóng bẩy, nhưng khó tái sử dụng nếu không chỉnh sửa.
Các trường hợp dùng GPT Image 2 kèm ví dụ prompt
Chúng tôi kiểm tra áp lực năm năng lực riêng biệt qua các tình huống này: kiểm soát ánh sáng, chữ chính xác, bố cục nhiều thành phần, nhất quán nhân vật và layout UI. Mỗi prompt bên dưới sẵn sàng để sao chép và điều chỉnh.
Chụp chân dung điện ảnh
Mục này kiểm tra mức nắm bắt ánh sáng, không khí và bố cục tiết chế của mô hình — những nền tảng tách một ảnh sẵn sàng cho portfolio khỏi một bản render AI chung chung.
Prompt:
Tạo một chân dung điện ảnh của một hình người đơn độc đứng trong môi trường gradient từ cam đậm sang đỏ. Ánh sáng bóng mạnh từ phía sau, tương phản bóng sâu, sàn bóng phản chiếu hình người. Bố cục đối xứng, thiết kế bối cảnh tối giản, không rối hậu cảnh. Tâm trạng trầm tư và mạnh mẽ, như một khung hình từ phim khoa học viễn tưởng. Tỷ lệ khung hình 16:9.
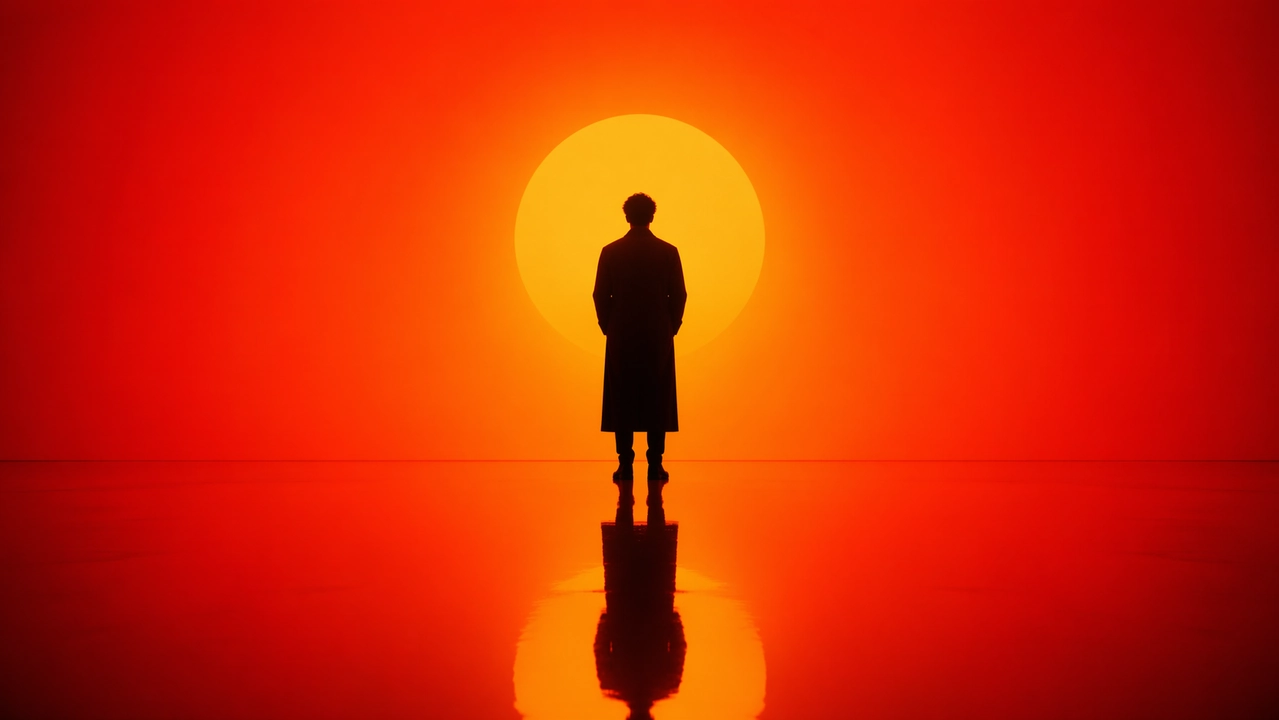
Cần nhìn gì: cạnh bóng sạch, không có quầng nhân tạo; phản chiếu sàn chính xác với phối cảnh đúng; gradient mượt (không bị vạch); và một tư thế có sức nặng thật, thay vì cứng hoặc như đang lơ lửng.
Thiết kế poster và minh họa thành phố
Đây là bài kiểm tra áp lực khó nhất cho chữ đọc được đi cùng bố cục dày, nhiều thành phần — hơn mười yếu tố hình ảnh riêng xếp dọc theo một đường cong chữ S, với chữ tiếng Anh phải sống sót nguyên vẹn sau khi render.
Prompt:
Một poster thành phố Xuân 2026 ấn tượng cho New York, thiết kế đương đại đậm và tâm trạng ăn mừng thanh lịch. Nền trắng ngà có kết cấu, khoảng trống âm rộng. Một người chèo kayak thu nhỏ bơi qua một dải nước phản chiếu hẹp ở góc dưới bên phải. Vệt nước quét lên theo một đường thư pháp động, dần biến thành sông Hudson rồi thành một toàn cảnh Manhattan vẽ tay như mơ. Bên trong bố cục hình dòng sông: Empire State Building, cầu Brooklyn, tán Central Park, One World Trade Center, mái brownstone, taxi vàng, phà cảng, và Tượng Nữ thần Tự do ở khoảng cách mềm. Sương sớm nhẹ, ánh xuân vàng, điểm nhấn tinh tế màu navy và vàng. Chữ thanh lịch ở góc dưới bên trái ghi “SPRING 2026” cùng slogan dọc “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Chữ phải sắc và được sắp đẹp. Không thêm chữ. Thiết kế đồ họa cao cấp, tỷ lệ khung hình 9:16.
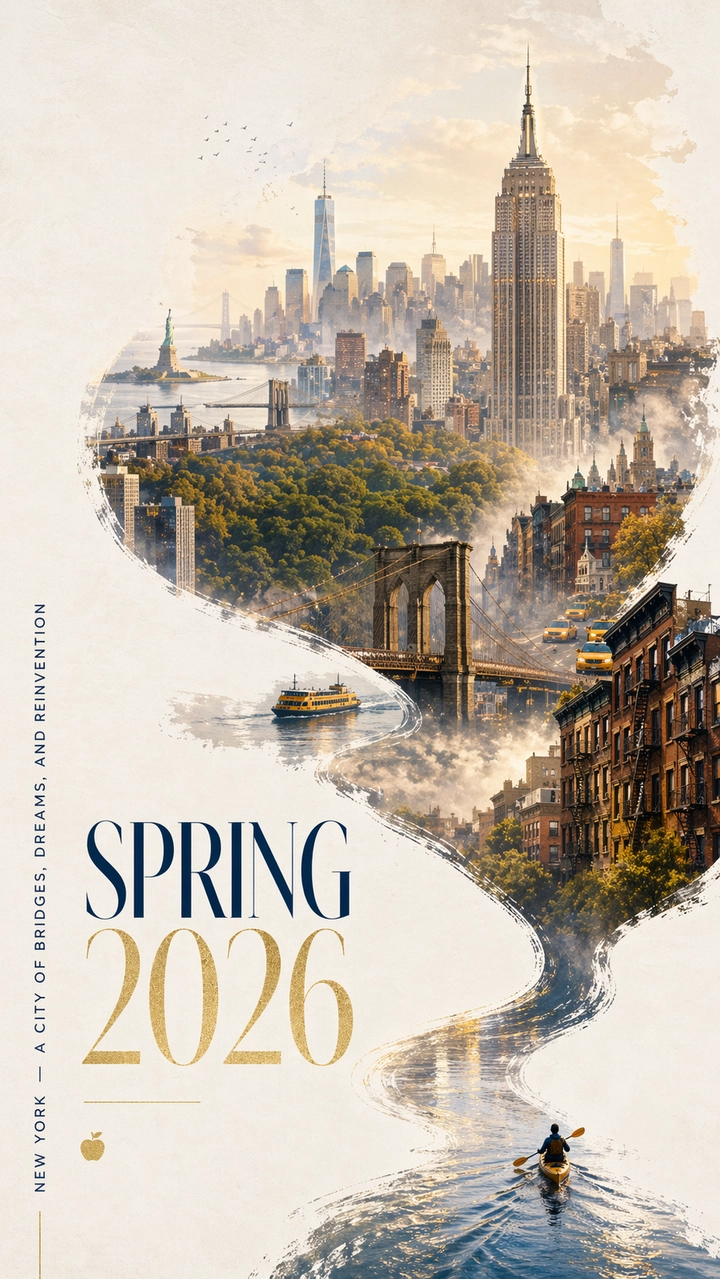
Cần nhìn gì: mọi chữ trong tiêu đề và slogan phải đọc được và đúng chính tả; đường cong chữ S phải chảy tự nhiên từ người chèo kayak đến đường chân trời; các tòa nhà biểu tượng phải nhận ra được chứ không phải tháp chung chung; và khoảng trống âm phải có chủ đích chứ không phải trống rỗng.
Thiết kế nhân vật và bảng tham chiếu
Nhà phát triển game và họa sĩ concept cần sự nhất quán nhiều góc nhìn từ một lần tạo duy nhất. Mục này kiểm tra mô hình có giữ vững thiết kế nhân vật qua góc trước, ngang và sau hay không.
Prompt:
Tạo một bảng tham chiếu nhân vật chuyên nghiệp cho nhân vật RPG giả tưởng gốc: một nữ pháp sư trẻ tóc bạc và mắt tím, khoác áo choàng tối trang trí với hoa văn rune phát sáng. Trên nền trắng sạch, gồm: turnaround ba góc trước, ngang và sau; các biến thể biểu cảm trung tính, mỉm cười, giận và ngạc nhiên; phân rã chi tiết trang phục và trang bị; một hàng mẫu bảng màu; và ghi chú xây dựng thế giới ngắn bằng chữ sạch. Layout lưới có tổ chức, phong cách concept art, độ phân giải cao. Tỷ lệ khung hình 16:9.
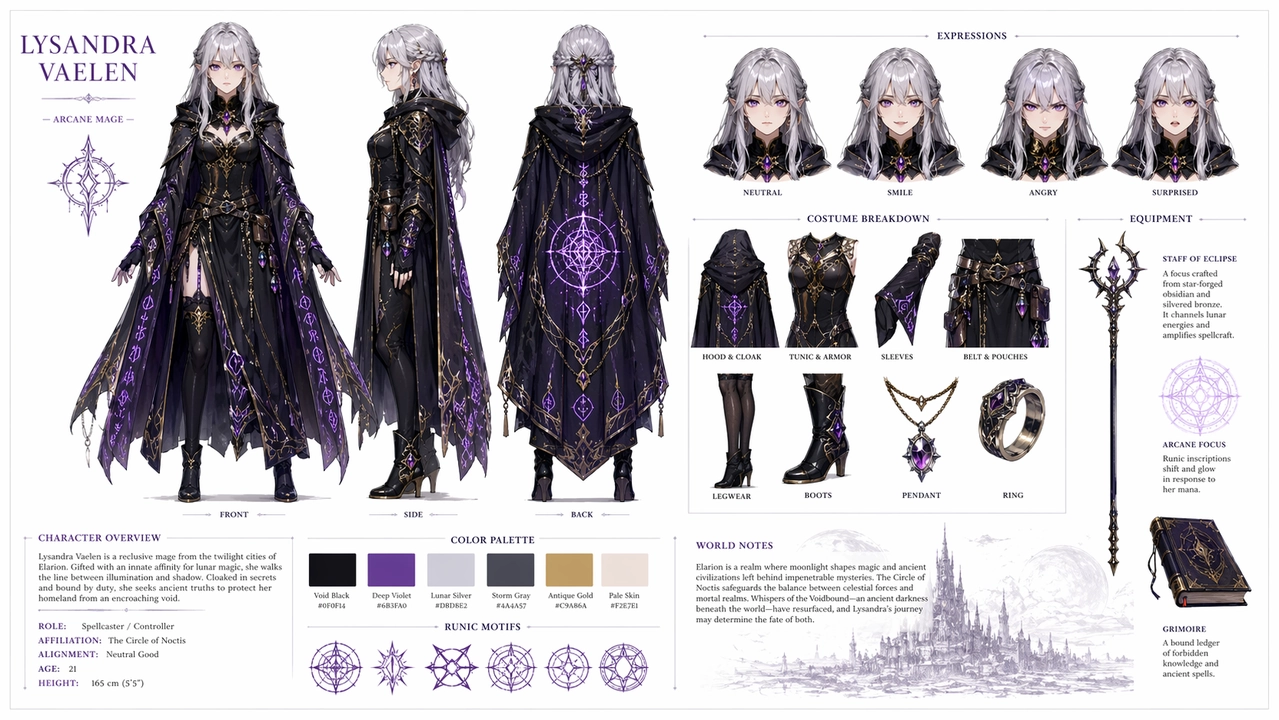
Cần nhìn gì: mặt, tóc và trang phục phải nhất quán ở cả ba góc; các biến thể biểu cảm chỉ đổi khuôn mặt, không đổi kiểu tóc hay quần áo; mẫu bảng màu phải khớp màu thực sự dùng trong tranh; và nhãn chữ phải đúng chính tả. Nếu góc ngang hoặc góc sau bị trôi, hãy tạo lại với ngôn ngữ “giữ nguyên” mạnh hơn, lặp lại các mỏ neo nhận dạng.
Mockup UI và mạng xã hội
Mục này đẩy ba thứ cùng lúc: layout UI chính xác đến từng pixel, kết xuất chữ đa ngôn ngữ, và hòa trộn ý tưởng sáng tạo — loại nội dung cũng thường hoạt động tốt trên các nền tảng mạng xã hội.
Prompt:
Một ảnh chụp màn hình iPhone siêu thực của trang hồ sơ Instagram hư cấu cho Leonardo da Vinci, tên người dùng @davinci_official, như thể ông là một influencer hiện đại năm 2026. Ảnh hồ sơ là chân dung tự họa Phục hưng cắt hình tròn. Tiểu sử ghi: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Lưới có 9 bài: Mona Lisa được dựng lại thành ảnh selfie gương, một phác thảo trực thăng với chú thích “just dropped my new drone design”, một nghiên cứu giải phẫu đăng như ảnh tiến độ phòng gym, Bữa ăn tối cuối cùng dựng thành ảnh nhóm tiệc tối, và các phép ghép lệch thời đại sáng tạo khác. Số người theo dõi: 12.4M. Story nổi bật gắn nhãn Sketches, Inventions và Florence Life. Đủ thanh trạng thái iOS với chữ nhà mạng “Renaissance 5G”, icon pin và giờ hiện tại. UI dark mode toàn bộ. Chất lượng ảnh chụp màn hình như ảnh thật, tỷ lệ khung hình 9:16.
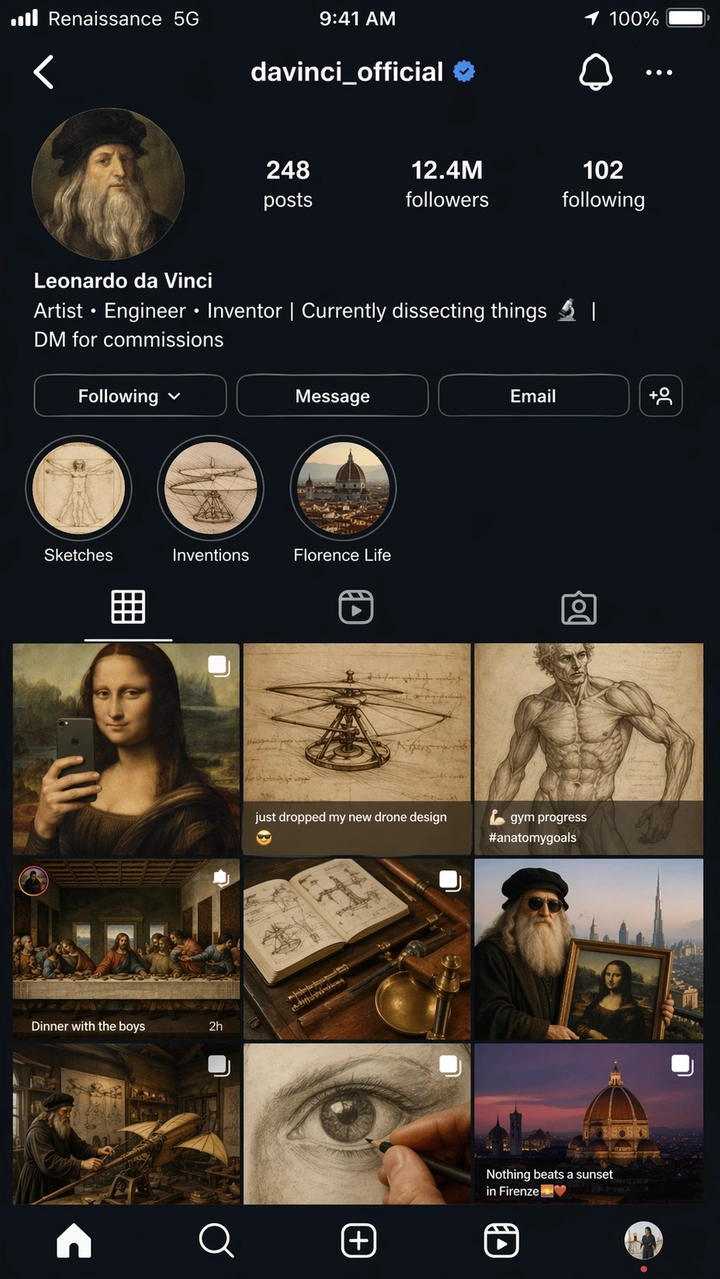
Cần nhìn gì: các thành phần UI Instagram — khoảng cách lưới, layout hồ sơ, vòng story, thanh tab — phải đọc như một ảnh chụp màn hình iOS thật, chứ không phải bản phỏng theo cách điệu. Mọi chữ phải đọc được, và nhãn nhà mạng “Renaissance 5G” là một bài kiểm tra độ chính xác có chủ đích. Hãy coi mọi đầu ra mockup UI là tài liệu tham chiếu concept chứ không phải UI sẵn sàng sản xuất; nhãn nhỏ và căn icon thường cần một lượt dọn.
Nghệ thuật sáng tạo và thử nghiệm
Những prompt ngắn có sẵn hài hước kể chuyện kiểm tra xem mô hình có tự lấp khoảng trống sáng tạo hay vẫn phụ thuộc vào chỉ dẫn thật chi tiết.
Prompt:
Bên trong một trưng bày bảo tàng mang tên “Ancient Technology: The Desktop Era”, một lập trình viên trong tủ kính đang trình diễn lập trình trực tiếp trên màn hình CRT trong khi học sinh kinh ngạc áp mặt vào kính. Biển thuyết minh ghi: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Một tủ trưng bày thứ hai gần đó cho thấy một cuốn sách vật lý gắn nhãn “Stack Overflow — Print Edition, Vol. 1 of 4,827”. Phong cách minh họa hoạt hình 2D, ánh sáng bảo tàng ấm, giọng điệu hài hước và hoài niệm. Tỷ lệ khung hình 16:9.
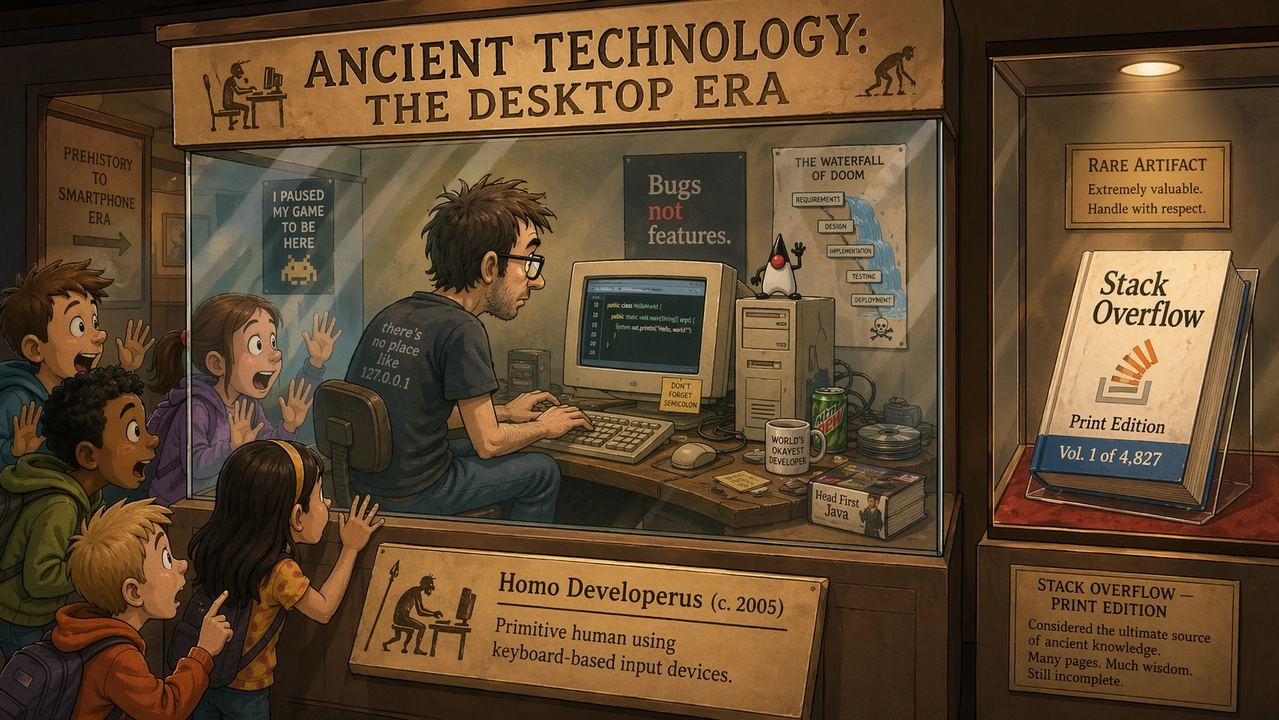
Cần nhìn gì: sự hài hước phải đạt nhờ chi tiết hình ảnh, không chỉ nhờ chữ chú thích. Biển thuyết minh và tên sách cần đọc được và đúng chính tả — một bài kiểm tra thực sự khó cho chữ nhiều dòng ở cỡ nhỏ — và phong cách hoạt hình phải liền mạch trên toàn cảnh, chứ không bị ảnh thật từng mảng.
Kết quả thử nghiệm theo trường hợp sử dụng
Kết quả mạnh nhất luôn đến từ những prompt có tiêu chuẩn sản xuất rõ — thứ có thể chấm bằng chính tả, layout, việc giữ nguyên vật thể, hoặc thứ tự khung. Prompt chỉ có tâm trạng mơ hồ cho kết quả biến thiên hơn.
| Trường hợp sử dụng | Những gì làm tốt | Những gì vẫn cần rà soát |
|---|---|---|
| Kết xuất chữ | Tiêu đề lớn, nhãn ngắn, tên poster và nhãn UI đơn giản giữ chính xác khi nội dung chữ được trích dẫn đúng. | Chữ pháp lý rất nhỏ, đoạn dày và font cách điệu vẫn có thể trôi — giữ chữ ngắn và kiểm tra từng ký tự. |
| Ảnh sản phẩm | Layout quảng cáo sạch, khoảng trống âm cho chiến dịch và bố cục ưu tiên sản phẩm render tốt. | Nhãn thật, logo và tuyên bố bị quản lý vẫn cần rà tay hoặc ghép từ tài sản đã duyệt. |
| Mockup UI | Màn hình di động, dashboard và phân cấp giống ứng dụng trông hợp lý khi prompt nêu đúng thành phần giao diện thật. | Coi đầu ra là mockup concept — nhãn nhỏ và căn icon thường cần dọn. |
| Nhất quán nhân vật | Character sheet, hàng biểu cảm và mẫu bảng màu hoạt động tốt như tài liệu tham chiếu sáng tạo. | Mặt và chi tiết trang phục có thể trôi giữa các góc; hãy lặp mỏ neo nhận dạng và tạo lại nếu cần. |
| Chỉnh sửa và ghép ảnh | Mẫu “thay đổi, giữ nguyên, khớp” vượt các yêu cầu chỉnh sửa rộng. | Ranh giới vùng chọn và đầu ra nền trong suốt vẫn cần QA. |
Những lỗi prompt GPT Image 2 thường gặp
- Xin chữ chính xác mà không cung cấp nội dung đúng. Nếu chữ quan trọng, hãy viết nguyên văn và nói nó thuộc về đâu.
- Nhồi một prompt bằng mọi chi tiết có thể. Bắt đầu từ cảnh cốt lõi, rồi tinh chỉnh từng biến một.
- Quên nêu các bất biến khi chỉnh sửa. Viết rõ những gì phải giữ nguyên: danh tính, hậu cảnh, tư thế, ánh sáng, hình dạng sản phẩm, chữ trên nhãn, góc máy.
- Dựa vào từ chất lượng trang trí cho công việc chức năng. “Đẹp” không làm nhãn đọc được — hãy dùng cách nói như “chữ nhãn sắc” hoặc “đọc được từ xa”.
- Bỏ qua tỷ lệ khung hình. Một ảnh vuông mạnh vẫn có thể thất bại khi làm quảng cáo dọc hoặc thumbnail video.
- Coi logo như chữ thường. GPT Image 2 có thể thiết kế concept logo, nhưng dấu hiệu thương hiệu chính xác nên được ghép từ tài sản đã duyệt, thay vì yêu cầu vẽ trực tiếp.
Ghi chú về API và giá GPT Image 2
Trang giá API của OpenAI liệt kê GPT Image 2 theo token, chứ không phải mức giá phẳng trên mỗi ảnh:
| Hạng mục | Giá niêm yết |
|---|---|
| Đầu vào ảnh | $8.00 / 1M token |
| Đầu vào ảnh đã cache | $2.00 / 1M token |
| Đầu ra ảnh | $30.00 / 1M token |
| Đầu vào văn bản | $5.00 / 1M token |
| Đầu vào văn bản đã cache | $1.25 / 1M token |
Chi phí thực trên mỗi ảnh phụ thuộc độ dài prompt, ảnh tham chiếu, kích thước đầu ra, bộ nhớ đệm và thiết lập chất lượng. Hạn mức gói ChatGPT là một đường riêng so với thanh toán API — gói Plus không chuyển thẳng thành credit API, nên hãy lập ngân sách hai khoản độc lập nếu bạn dùng cả hai.
Với quy trình khối lượng lớn, con số quan trọng là chi phí trên mỗi tài sản được chấp nhận sau các lần thử lại, không phải giá niêm yết của một lần thử. Một lần tạo rẻ hơn không thực sự rẻ hơn nếu cần ba lần tạo lại mới đúng chính tả hoặc layout.
| Quy trình | Lời khuyên prompt thực tế |
|---|---|
| Poster hoặc sơ đồ nhiều chữ | Dùng ít chữ hơn trên mỗi ảnh, trích dẫn nội dung chính xác, nêu rõ phân cấp. |
| Ảnh sản phẩm | Khóa hình dạng sản phẩm, nhãn, màu, chất liệu và góc máy; lặp danh sách giữ nguyên ở mỗi lượt chỉnh. |
| Mockup UI | Mô tả màn hình như một giao diện đã phát hành — điều hướng, thẻ, nút, trạng thái — không như concept art. |
| Chỉnh sửa nhiều ảnh tham chiếu | Gắn nhãn từng ảnh đầu vào theo vai trò: chủ thể, phong cách, hậu cảnh, trang phục, hoặc tham chiếu chất liệu. |
| Tạo theo lô | Theo dõi chi phí trên mỗi ảnh được chấp nhận, không phải chi phí trên mỗi lần thử. |
Nếu bạn muốn xem GPT Image 2 đứng thế nào so với một lựa chọn ưu tiên ảnh thật trên cùng những prompt giống nhau, bài so sánh GPT Image 2 và Nano Banana 2 của chúng tôi chạy sáu vòng đối đầu, kèm phân tích đầy đủ giá API và giá nền tảng.
Từ ảnh đến video: Hoàn tất quy trình sáng tạo trên PixVerse
Tạo một ảnh mạnh chỉ là một bước. Biến nó thành chuyển động mới là chỗ hầu hết quy trình đứt — bạn hoàn thành một chân dung hoặc poster sản phẩm trong GPT Image 2, rồi phải mở một công cụ khác, tải lại tệp, và hy vọng mô hình video không làm méo bức ảnh đã bố cục cẩn thận. Chính ma sát khi chuyển giao đó là điều PixVerse loại bỏ.
GPT Image 2 đã có trên PixVerse
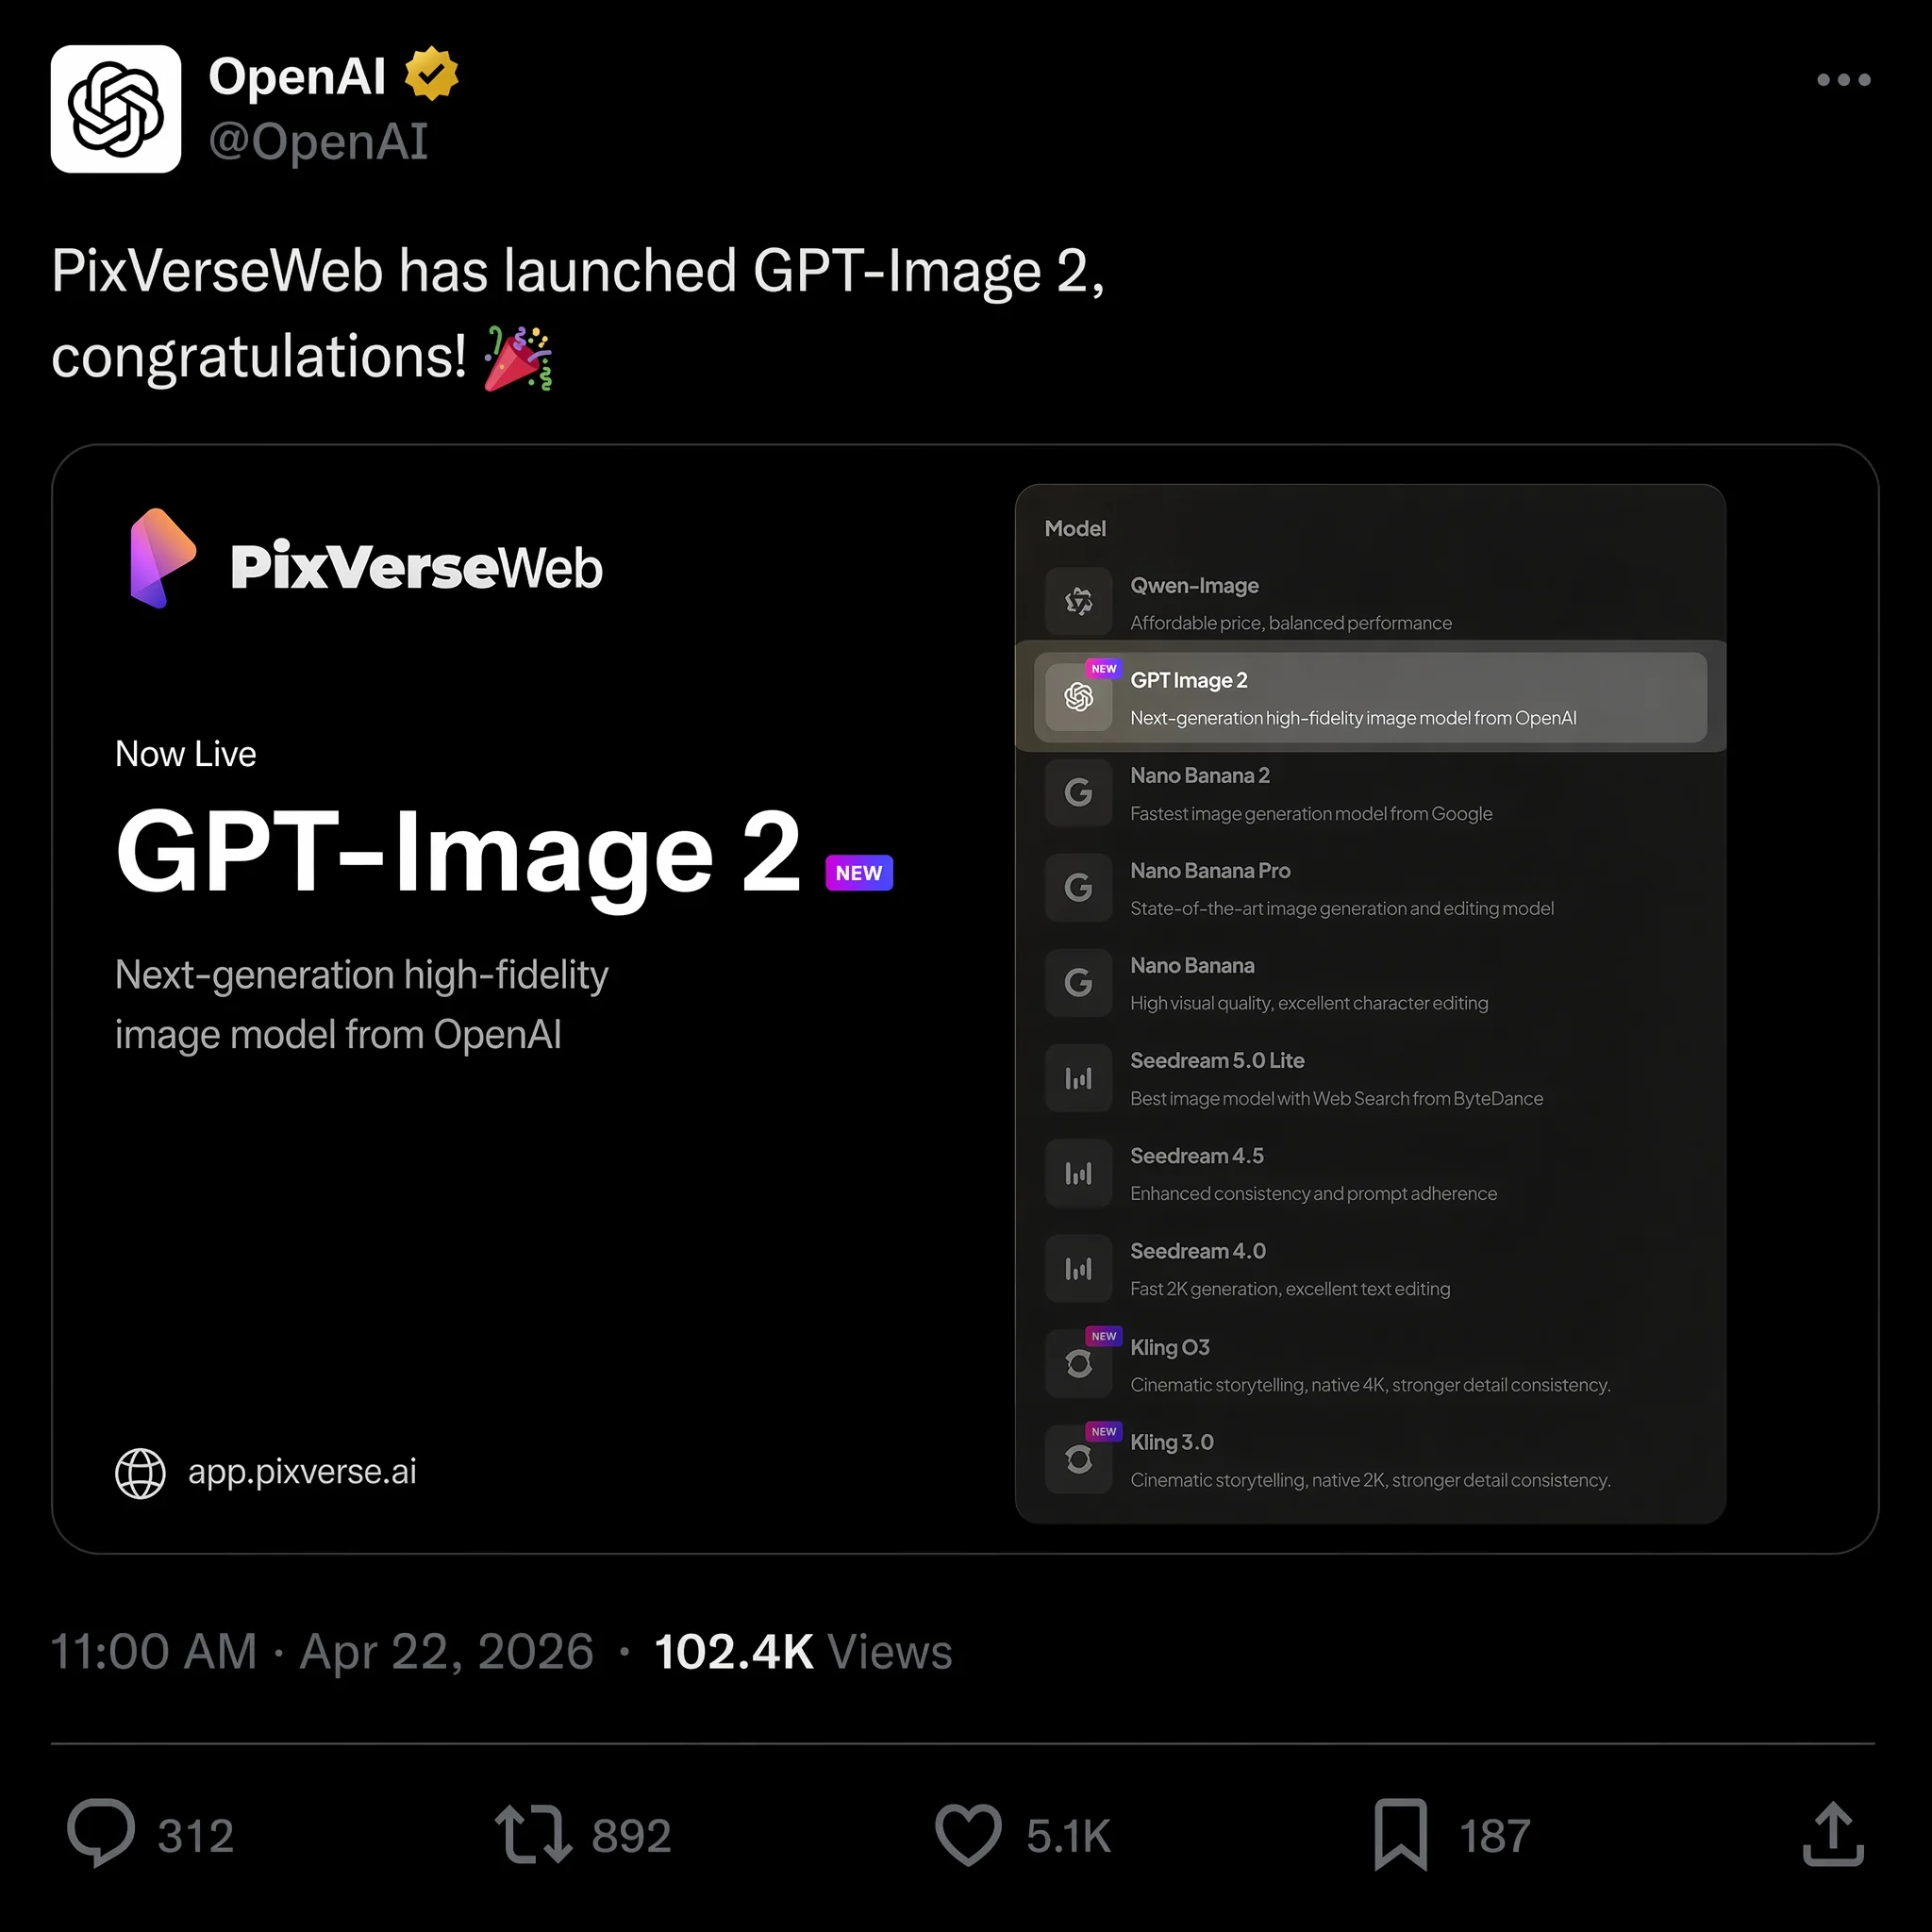
Ngày 22 tháng 4 năm 2026, PixVerse thêm GPT Image 2 như một tùy chọn text-to-image, đứng cùng Nano Banana 2, Seedream và HappyHorse 1.0 trong danh sách mô hình. Bạn có thể tạo ảnh bằng GPT Image 2 rồi chuyển thành video trong cùng một không gian làm việc, không cần tải xuống, tải lên lại hay chuyển tab.
Điều đó quan trọng vì một lý do cụ thể: khi ảnh đi thẳng vào pipeline image-to-video trên cùng nền tảng, mô hình video làm việc trực tiếp từ tệp nguồn đủ độ phân giải và siêu dữ liệu của nó. Không có mất chất lượng do nén hay chuyển định dạng dọc đường, nghĩa là chuyển động sạch hơn và ít lỗi hình hơn trong clip cuối.
Nếu một ảnh tĩnh được định để thành clip, hãy prompt độ sẵn sàng cho chuyển động ngay từ đầu — yêu cầu chiều sâu tiền cảnh, trung cảnh và hậu cảnh, một bóng chủ thể sạch, và một yếu tố vật lý có thể chuyển động hợp lý (bụi, hơi nước, vải, một nguồn sáng dịch chuyển). Hãy rà ảnh tĩnh như một tệp thiết kế đã xong trước khi làm chuyển động: kiểm tra chính tả, hình học sản phẩm và căn chỉnh UI trước, vì mô hình video sẽ không tự sửa một tiêu đề sai chính tả hay một nhãn bị méo. Sau đó viết một prompt chuyển động riêng, ngắn hơn, chỉ mô tả những gì nên chuyển động và những gì phải khóa, thay vì lặp lại toàn bộ brief của ảnh.
Vì sao nhà sáng tạo đang chuyển sang nền tảng tất cả trong một
Nếu trước tháng 3 năm 2026 bạn dùng Sora của OpenAI để tạo video, bạn đã biết rủi ro khi xây quy trình quanh một công cụ duy nhất. OpenAI đã tắt ứng dụng và API Sora vào ngày 24 tháng 3, viện dẫn chi phí không bền vững và việc xoay sang robotics, và hàng nghìn nhà sáng tạo mất pipeline video chỉ sau một đêm. Xem hướng dẫn các lựa chọn thay thế Sora của chúng tôi để có phân tích đầy đủ về chuyện đã xảy ra và những công cụ nào lấp chỗ trống.
PixVerse đi một hướng khác bằng cách cho bạn truy cập nhiều mô hình trên toàn bộ pipeline sáng tạo, thay vì khóa bạn vào một mô hình:
- Text-to-image với GPT Image 2, Nano Banana 2, Seedream và hơn thế — chọn mô hình hợp với công việc
- Image-to-video chuyển ảnh bạn tạo thành chuyển động với nhất quán nhân vật và điều khiển máy quay
- Text-to-video cho các clip tạo trực tiếp từ prompt viết, dùng PixVerse V6 hoặc mô hình C1 điện ảnh
- Tạo âm thanh gốc tự đồng bộ hiệu ứng và thoại với video của bạn
Lợi ích thực tế: bạn có thể đi từ một ý tưởng viết thành video hoàn chỉnh có âm thanh đồng bộ mà không rời một không gian làm việc, điều này bỏ hàng giờ quản lý tệp khỏi mỗi dự án. Nếu bạn muốn viết script tạo từ dòng lệnh, hướng dẫn PixVerse CLI trình bày cách tự động hóa cả tạo ảnh và tạo video.
PixVerse cũng cung cấp 30–60 credit miễn phí mỗi ngày cho người dùng mới, nên bạn có thể thử toàn bộ pipeline — từ tạo ảnh đến đầu ra video — trước khi cam kết một gói trả phí.
Câu hỏi thường gặp
GPT Image 2 có dùng miễn phí không?
Người dùng ChatGPT miễn phí có thể tạo khoảng hai ảnh mỗi ngày với GPT Image 2. Người đăng ký ChatGPT Plus ($20/tháng) được tạo không giới hạn với xử lý nhanh hơn. Quyền truy cập API được tính theo token trên đầu vào ảnh, đầu ra ảnh và đầu vào văn bản, nên chi phí tăng theo độ dài prompt và kích thước đầu ra, chứ không phải một mức phí phẳng trên mỗi ảnh.
GPT Image 2 hỗ trợ độ phân giải nào?
GPT Image 2 tạo ảnh ở độ phân giải gốc 2K, và có thể upscale 4K tùy chọn qua API. Tỷ lệ khung hình từ 3:1 đến 1:3, nên định dạng vuông, dọc và siêu rộng đều có sẵn trực tiếp.
GPT Image 2 có thể kết xuất chữ trong ảnh chính xác không?
Có — đây là một trong những điểm mạnh nhất của nó. Trong thử nghiệm của chúng tôi, độ chính xác chữ trên tiếng Anh, tiếng Trung, tiếng Nhật, tiếng Hàn và tiếng Ả Rập vượt 95% ngay lần tạo đầu. Tiêu đề nhiều dòng, tên poster và nhãn chữ UI đều được xử lý đáng tin, dù chữ rất nhỏ ở độ phân giải thấp vẫn đôi khi bị lệch.
GPT Image 2 so với Midjourney và Nano Banana 2 như thế nào?
Midjourney V8 có kiểm soát phong cách nghệ thuật mạnh hơn và một cộng đồng lâu đời hơn cho việc tinh chỉnh thẩm mỹ. Nano Banana 2 là lựa chọn mạnh hơn cho ảnh thật, ánh sáng điện ảnh và vòng lặp nhanh. GPT Image 2 nhỉnh hơn về kết xuất chữ, layout có cấu trúc và chỉnh sửa bằng ngôn ngữ tự nhiên. Với thiết kế poster và tài liệu marketing có chữ, GPT Image 2 hiện đang thắng; với khám phá nghệ thuật thuần túy hoặc các khung hero ảnh thật, hai mô hình kia đáng so trực tiếp — xem bài thử đối đầu với Nano Banana 2 của chúng tôi.
Đâu là lựa chọn thay thế Sora tốt nhất cho video sau khi đóng cửa?
Sau khi OpenAI tắt Sora vào tháng 3 năm 2026, các lựa chọn hàng đầu gồm PixVerse V6 cho video nhiều cảnh nhất quán nhân vật, Runway Gen-4 cho điều khiển máy quay điện ảnh, và Kling v3.0 cho các chuỗi hành động. PixVerse là nền tảng duy nhất kết hợp text-to-image, image-to-video và text-to-video với âm thanh gốc, tất cả đều dùng được bằng credit miễn phí hằng ngày. Xem đầy đủ hướng dẫn các lựa chọn thay thế Sora của chúng tôi để có bản so sánh chi tiết.
Tôi có thể biến đầu ra GPT Image 2 thành video không?
Có. Với GPT Image 2 có sẵn trong PixVerse, bạn có thể tạo ảnh ngay trong ứng dụng và chuyển thành video bằng pipeline image-to-video trong cùng không gian làm việc, không cần chuyển tệp. Bạn cũng có thể tải lên một tệp GPT Image 2 tạo ở nơi khác và chạy nó qua cùng pipeline.