รีวิว GPT Image 2: คู่มือพรอมป์ต์และกรณีใช้งานในปี 2026
OpenAI เปิดตัว GPT Image 2 เมื่อวันที่ 21 เมษายน 2026 — รุ่นถัดจาก GPT Image 1.5 และโมเดลที่ตอนนี้ขับเคลื่อนการสร้างภาพทั่ว ChatGPT เราทดสอบในช่วงสัปดาห์เปิดตัว แล้วกลับมาอีกครั้งปลายเดือนมิถุนายนด้วยชุดพรอมป์ต์ที่กว้างขึ้น คู่มือการเขียนพรอมป์ต์ของ OpenAI เอง และราคา API ที่เผยแพร่ เพื่อดูว่าโมเดลยืนระยะอย่างไรเมื่อกระแสแรกเริ่มสงบ
ประเด็นสำคัญ:
- GPT Image 2 สร้างภาพที่ความละเอียดเนทีฟ 2K พร้อมอัปสเกล 4K ที่เลือกได้ และความแม่นยำในการเรนเดอร์ข้อความอยู่เหนือ 95% ในสคริปต์ละติน จีน ญี่ปุ่น เกาหลี และอาหรับ
- ควรถือโมเดลนี้เป็นผู้ช่วยออกแบบมากกว่าเครื่องสร้างภาพถ่าย มันเก่งงานที่มีมาตรฐานความสำเร็จชัดเจน — ข้อความตรงตัว เลย์เอาต์ที่ล็อก โครงสร้างแผงที่ทำซ้ำได้ — และคาดเดาได้ยากขึ้นกับพรอมป์ต์ปลายเปิดแบบ “ทำให้สวย”
- การจำลองโลโก้แบรนด์ ข้อความกฎหมายตัวเล็ก และฟอนต์กรรมสิทธิ์ยังเป็นจุดอ่อนที่ต้องตรวจด้วยมือ
- API ของ OpenAI คิดค่า GPT Image 2 ตามโทเค็น ทั้งอินพุตภาพ อินพุตภาพที่แคช เอาต์พุตภาพ อินพุตข้อความ และอินพุตข้อความที่แคช — โมเดลราคาต่างจากระดับราคาต่อภาพที่คู่แข่งบางรายใช้
- PixVerse รวม GPT Image 2 ในไลน์อัป text-to-image คู่กับ Nano Banana 2 และ Seedream ดังนั้นภาพที่สร้างแล้วเข้าไปป์ไลน์ image-to-video ได้โดยไม่ต้องออกจากเวิร์กสเปซ
GPT Image 2 คืออะไร? ฟีเจอร์หลักและข้อจำกัด
GPT Image 2 คือโมเดลภาพรุ่นที่สองของ OpenAI ที่มาแทน GPT Image 1.5 ทั้งใน ChatGPT และ API มันแข่งขันกับ Midjourney, DALL-E 3 และ Stable Diffusion แต่ปักอัตลักษณ์ไว้ที่สองสิ่ง: ข้อความที่แม่นยำภายในภาพ และชั้นการให้เหตุผลที่ตีความเจตนาของพรอมป์ต์ ไม่ใช่แค่จับคู่คีย์เวิร์ด
ฟีเจอร์หลักโดยย่อ
| ฟีเจอร์ | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| ความละเอียดเนทีฟ | 2K (พร้อมอัปสเกล 4K) | 1K | 2K (พร้อมแฟล็ก —hd) |
| ความแม่นยำการเรนเดอร์ข้อความ | 95%+ หลายภาษา | ~70% (ละตินเท่านั้น) | ~80% (ละตินเท่านั้น) |
| การผสานการให้เหตุผล | มี — ตีความคำสั่งหลายชั้น | ไม่มี | ไม่มี |
| ช่วงอัตราส่วนภาพ | 3:1 ถึง 1:3 | 1:1, 16:9 | 1:1 ถึง 3:2 |
| ความสอดคล้องของตัวละคร | ระดับพิกเซลข้ามภาพต่อเนื่อง | จำกัด | ปานกลาง (แฟล็ก —cref) |
| การแก้ไขด้วยภาษาธรรมชาติ | มี — แก้บริเวณโดยการบรรยาย | ไม่มี | ไม่มี |
| ราคา | ตามโทเค็นผ่าน API ระดับแผน ChatGPT | เหมือนกัน | สมัครสมาชิก $10–30/เดือน |
การเรนเดอร์ข้อความ คือฟีเจอร์ที่ได้รับความสนใจมากที่สุด และมีเหตุผลดี โมเดลภาพรุ่นก่อนถือข้อความเป็นพื้นผิว — ขอพาดหัวโปสเตอร์แล้วได้เสียงรบกวนรูปตัวอักษร GPT Image 2 จัดการพาดหัวภาษาอังกฤษหลายบรรทัด อักขระจีน และเลย์เอาต์หลายภาษาด้วยความสม่ำเสมอจริง ในการทดสอบของเรา ราว 19 จาก 20 ภาพกลับมาอ่านออกทั้งหมดในครั้งแรก
การผสานการให้เหตุผล หมายความว่าโมเดลทำมากกว่าจับคู่รูปแบบคำของคุณ ขอให้ “สร้างอินโฟกราฟิกแสดงกิจกรรมสำหรับพยากรณ์อากาศวันพรุ่งนี้ในซานฟรานซิสโก” แล้วมันจะดึงพยากรณ์ เลือกกิจกรรมที่เกี่ยวข้อง และจัดเลย์เอาต์รอบข้อมูลนั้น — ก้าวหนึ่งเหนือวิธีที่ Midjourney หรือ Stable Diffusion ประมวลพรอมป์ต์
การแก้ไขด้วยภาษาธรรมชาติ ให้คุณปรับภาพโดยบรรยายการเปลี่ยนแปลง แทนการมาสก์ด้วยมือ “ย้ายถ้วยกาแฟไปด้านซ้ายของโต๊ะ” หรือ “เปลี่ยนท้องฟ้าเป็นพระอาทิตย์ตก” ทั้งคู่ใช้เป็นการแก้ไขเฉพาะจุดโดยไม่สร้างทั้งฉากใหม่
ผู้ใช้พูดว่าอย่างไร
เสียงตอบรับตั้งแต่เปิดตัวเป็นบวกเป็นส่วนใหญ่ พร้อมชุดข้อตำหนิที่สอดคล้องกัน การทดสอบภาพบุคคลที่แพร่บน X และ Reddit ดูใกล้ภาพถ่ายสตูดิโอ และนักออกแบบโปสเตอร์ที่ทดสอบเลย์เอาต์ยาว — ใบปลิว เมนู ป้าย — รายงานว่าความแม่นยำของข้อความในที่สุดก็ทนการใช้งานจริงได้ นักออกแบบหลายคนระบุว่าข้ามรอบ Photoshop สำหรับแอสเซ็ตการตลาดพื้นฐานได้ เพราะสัมผัสด้านการจัดองค์ประกอบของโมเดลแข็งพอที่จะตัดสินเลย์เอาต์ได้เอง
คำชมที่แรงที่สุดอยู่ที่การยึดตามพรอมป์ต์: ขอองค์ประกอบเฉพาะ 15 อย่างในฉาก แล้ว GPT Image 2 มักใส่ครบทั้งหมด ในขณะที่โมเดลเก่าเริ่มทิ้งรายละเอียดเมื่อพรอมป์ต์ยาวขึ้น
ด้านลบ ความเที่ยงตรงต่อแบรนด์ยังไม่สม่ำเสมอ การทดสอบลงมือใช้ของ ZDNet ที่ถูกแชร์อย่างกว้างขวางแสดงให้เห็นว่าโมเดลจำลองโลโก้ ZDNET ได้ไม่แม่น และผู้ใช้รายอื่นรายงานแบบเดียวกันกับเครื่องหมายแบรนด์เฉพาะ โมเดลเข้าใจเชิงแนวคิดว่าโลโก้ คือ อะไร แต่ไม่ได้จำลองรูปทรงเวกเตอร์ตรงตัวหรือแบบอักษรกรรมสิทธิ์ได้อย่างน่าเชื่อถือ
ข้อจำกัดที่ทราบ
- การจำลองโลโก้แบรนด์ ยังไม่น่าเชื่อถือ — ควรประกอบโลโก้ที่ตรงเป๊ะใน Photoshop หรือ Figma หลังสร้างภาพ แทนการสั่งในพรอมต์โดยตรง
- ความเร็วในการสร้าง ช้ากว่าโมเดลที่เบากว่าอย่าง FLUX หรือ Nano Banana 2 โดยทั่วไปใช้เวลา 30–60 วินาทีบน ChatGPT Plus เทียบกับไม่ถึง 10 วินาทีที่อื่น
- ขีดจำกัดอัตราของแพ็กเกจฟรี ค่อนข้างแน่น — ผู้ใช้ ChatGPT ฟรีได้ประมาณสองภาพต่อวัน ผู้สมัคร Plus ได้การสร้างบน ChatGPT ไม่จำกัด แต่ค่า API จะเพิ่มตามปริมาณการใช้งาน
- การควบคุมสไตล์ หยาบกว่า Midjourney คุณปรับฟิล์มสต็อก ประเภทเลนส์ หรือเกรนได้ไม่ละเอียดเท่า และความเอนเอียงด้านสุนทรียะของโมเดลเองต้องใช้พรอมต์อย่างตั้งใจจึงจะลบล้างได้
- นโยบายเนื้อหา เข้มงวดกว่าทางเลือกโอเพนซอร์ส ดังนั้นพรอมต์บางอย่างที่ใช้ได้ดีบน Stable Diffusion หรือโมเดลในเครื่อง จะถูกปฏิเสธที่นี่
ไม่มีข้อใดตัดการใช้ในงานจริงออกไป แต่ควรรู้ไว้ก่อนสร้างไปป์ไลน์ที่พึ่งพาโมเดลเดียวเพียงตัวเดียว
วิธีเขียนพรอมต์ GPT Image 2 ที่ใช้ได้จริง
สิ่งที่ชัดที่สุดจากการทดสอบรอบที่สอง: พรอมต์ GPT Image 2 ที่ดีที่สุดไม่ได้แค่อธิบายภาพ — แต่อธิบาย งาน ที่ภาพนั้นต้องทำ พรอมต์โฆษณาโซเชียลควรอ่านต่างจากคัตเอาต์สินค้า อินโฟกราฟิก หน้าจอ UI หรือเฟรมแรกที่ตั้งใจไว้สำหรับวิดีโอ
รูปแบบที่เชื่อถือได้สำหรับจัดโครงสร้างบรีฟ:
สร้าง [ประเภทของภาพ] สำหรับ [กรณีใช้งาน] ตัวแบบหลัก: [ตัวแบบเฉพาะและรายละเอียดที่มองเห็น] ข้อความที่ต้องตรงเป๊ะ (ถ้ามี): “[ข้อความที่ต้องปรากฏ]” องค์ประกอบภาพ: [การจัดเฟรม เลย์เอาต์ พื้นที่ว่าง ตำแหน่งตัวแบบ] สไตล์และแสง: [ภาษาภาพ สื่อ อารมณ์ ทิศทางแสง] ข้อจำกัด: [สิ่งที่ห้ามเปลี่ยน ห้ามมีคำเกิน ห้ามมีลายน้ำ] รูปแบบเอาต์พุต: [อัตราส่วนภาพ พื้นหลังโปร่งใส เฟรมพร้อมสำหรับวิดีโอ]
ระบุงานก่อนสไตล์
เริ่มด้วยประเภทเอาต์พุต — โปสเตอร์ โฆษณาสินค้า หน้าจอแอป ชีตตัวละคร ไดอะแกรม การแก้ไข หรือเฟรมแรกของวิดีโอ — เพื่อให้โมเดลรู้ว่ากำลังถูกตัดสินด้วยมาตรฐานใด
แบบอ่อน: ลำโพงล้ำยุคเท่ ๆ แบบภาพยนตร์ รายละเอียดสูง
แบบดีกว่า: สร้างโฆษณาสินค้าระดับพรีเมียมสำหรับลำโพงไร้สายสีดำด้าน ภาพต้องใช้เป็นแบนเนอร์แคมเปญ 16:9 ได้ โดยวางสินค้าทางขวา พาดหัวสั้น ๆ ทางซ้าย พื้นที่ว่างสะอาด และขอบสินค้าคมชัด
เวอร์ชันที่สองบอกโมเดลว่ากำลังถูกตัดสินจากเลย์เอาต์และความใช้งานได้ ไม่ใช่แค่ความสวย
ถือข้อความเป็นสินทรัพย์ที่ล็อกไว้
ใส่ข้อความที่จำเป็นในเครื่องหมายคำพูด และบอกให้ชัดว่าต้องเรนเดอร์อย่างไร — อย่าขอแค่ “สโลแกน” เว้นแต่คุณต้องการให้โมเดลคิดคำขึ้นมาเอง
พาดหัว: “SOUND YOU CAN FEEL” เรนเดอร์พาดหัวตามตัวอักษรทุกตัว ห้ามมีคำเกิน ห้ามข้อความซ้ำ ห้ามโลโก้ปลอม ตัวอักษรซานส์เซอริฟสีขาวตัวหนา ด้านซ้ายขององค์ประกอบ อ่านได้จากระยะไกล
สำหรับข้อความที่ยาวขึ้น ให้แบ่งแต่ละบรรทัดอย่างชัดเจนในพรอมต์ ถ้ามีคำสะกดผิดกลับมา ให้สร้างใหม่ด้วยข้อความที่สั้นกว่า ตัวอักษรใหญ่ขึ้น และคำสั่ง “exact text only” ที่เข้มงวดขึ้น
ให้โมเดลมีกล้องและเลย์เอาต์
ระบุระยะกล้อง มุม ตำแหน่งตัวแบบ พื้นที่ว่าง และอัตราส่วนภาพโดยตรง — GPT Image 2 ตามสัญญาณองค์ประกอบภาพได้ดี แต่เฉพาะเมื่อเขียนไว้ชัดเจน
- โคลสอัพ สำหรับพื้นผิวสินค้า มือ ใบหน้า วัสดุ ฉลาก
- ไวด์ช็อต สำหรับสภาพแวดล้อม ฉากเรื่องราว โปสเตอร์เมือง เฟรมพร้อมสำหรับวิดีโอ
- มุมมองจากด้านบน สำหรับอาหาร ฉากโต๊ะทำงาน แฟลตเลย์ ชุดบรรจุภัณฑ์
- หนึ่งในสามซ้าย / หนึ่งในสามขวา สำหรับเลย์เอาต์โฆษณาที่สมดุลระหว่างข้อความกับสินค้า
- กริดสะอาด สำหรับม็อกอัป UI ชีตตัวละคร ไดอะแกรม อินโฟกราฟิก
เขียนการแก้ไขเป็นสามประโยค
พรอมต์แก้ไขที่แข็งแรงที่สุดแยกสิ่งที่ต้องเปลี่ยนออกจากสิ่งที่ต้องคงเดิม และจากความสมจริงทางกายภาพที่ผูกทั้งสองเข้าด้วยกัน:
แทนที่รถที่จอดอยู่ด้วยจักรยานวินเทจ คงบ้าน รั้ว ทางรถเข้า การจัดภูมิทัศน์ ทิศทางแสง มุมกล้อง และช่วงเวลาของวันไว้ให้ตรงเดิมทุกประการ จับคู่สเกลจักรยาน เงาจุดสัมผัส และมุมมองให้เข้ากับฉากที่มีอยู่
โครงสร้าง “เปลี่ยน คงไว้ จับคู่” นั้นทำได้ดีกว่าคำขอคลุมเครืออย่าง “ทำให้ดูดีขึ้น” อย่างสม่ำเสมอ
เพิ่มสัญญาณการเคลื่อนไหวถ้าภาพนิ่งจะกลายเป็นวิดีโอ
ถ้าภาพอาจถูกป้อนเข้าไปป์ไลน์ภาพเป็นวิดีโอของ PixVerse ในภายหลัง ให้พรอมต์เรื่องความลึกและความพร้อมต่อการเคลื่อนไหวตั้งแต่ต้น: ฉากหน้า ฉากกลาง ฉากหลัง ซิลูเอตตัวแบบที่สะอาด และสัญญาณที่มองเห็นได้หนึ่งอย่างที่ขยับได้ — ฝุ่น ผ้า ผม ฝน เงาสะท้อน หรือเส้นทางพุชของกล้อง
แทนที่จะใช้: นักบินอวกาศในทะเลทราย
ใช้: เฟรมแรกแบบภาพยนตร์สำหรับคลิปภาพเป็นวิดีโอ: นักบินอวกาศคนเดียวยืนที่ขอบหลุมอุกกาบาตทะเลทรายเรืองแสงยามรุ่งอรุณ ผ้าคลุมและฝุ่นพร้อมขยับตามลม ซิลูเอตฉากหน้าที่ชัด ชั้นความลึกชัดเจน และแสงขอบฟ้าอบอุ่น
เราทดสอบ GPT Image 2 อย่างไร
ตลอดทั้งสองรอบการทดสอบ เราให้โมเดลทำงานกับภาพบุคคล โปสเตอร์ที่มีข้อความหนาแน่น องค์ประกอบแนวสินค้า ชีตตัวละคร ม็อกอัป UI และฉากเล่าเรื่องเชิงทดลอง เป้าหมายไม่ใช่คะแนนเบนช์มาร์ก — แต่คือนักออกแบบ นักการตลาด หรือครีเอเตอร์จะส่งงานออกไปได้ด้วยการแก้เล็กน้อย แทนการสร้างสินทรัพย์ใหม่ตั้งแต่ต้นหรือไม่
| พื้นที่ทดสอบ | สิ่งที่เราตรวจ |
|---|---|
| ภาพบุคคลและภาพนิ่งแบบภาพยนตร์ | การควบคุมแสง พื้นผิวผิวหนัง เงาสะท้อน อารมณ์ ความสอดคล้องของฉาก |
| เลย์เอาต์โปสเตอร์และตัวอักษร | การสะกดพาดหัว ข้อความหลายบรรทัด ลำดับชั้น พื้นที่ว่าง ความปราณีตคล้ายแบรนด์ |
| ชีตตัวละครและคอนเซปต์ | ความสอดคล้องหลายมุม รายละเอียดเครื่องแต่งกาย การจัดพาเลตต์ ความถูกต้องของป้ายกำกับ |
| ม็อกอัป UI และโซเชียล | ความสมจริงของเลย์เอาต์ ข้อความขนาดเล็ก ระยะไอคอน กริดฟีด ความน่าเชื่อของภาพหน้าจอ |
| พรอมต์เชิงทดลอง | อารมณ์ขัน การให้เหตุผลเชิงเรื่องราว การวางวัตถุ ความถูกต้องของคำบรรยายขนาดเล็ก |
รูปแบบนี้คงอยู่ทั้งสองรอบ: GPT Image 2 ให้ผลตอบแทนกับบรีฟที่แม่นยำมากกว่าห่วงโซ่คีย์เวิร์ด เมื่อพรอมต์ระบุงานและนิยามความสำเร็จ — ข้อความตรงเป๊ะ เลย์เอาต์ที่ล็อก โครงสร้างแผงที่ทำซ้ำได้ — โมเดลมักคงโครงสร้างไว้ เมื่อพรอมต์ขอแค่อารมณ์คลุมเครือ ผลลัพธ์อาจยังดูขัดเกลา แต่ใช้ซ้ำได้ยากหากไม่แก้ไข
กรณีใช้งาน GPT Image 2 พร้อมตัวอย่างพรอมต์
เราทดสอบความเครียดห้าความสามารถที่ต่างกันในสถานการณ์เหล่านี้: การควบคุมแสง ตัวอักษรที่ตรงเป๊ะ องค์ประกอบหลายชิ้น ความสอดคล้องของตัวละคร และเลย์เอาต์ UI พรอมต์แต่ละข้อด้านล่างพร้อมคัดลอกและปรับใช้
การถ่ายภาพบุคคลแบบภาพยนตร์
ส่วนนี้ตรวจความเข้าใจของโมเดลเรื่องแสง บรรยากาศ และองค์ประกอบที่รัดกุม — พื้นฐานที่แยกภาพพร้อมใส่พอร์ตโฟลิโอออกจากภาพเรนเดอร์ AI ทั่วไป
พรอมต์:
สร้างภาพบุคคลแบบภาพยนตร์ของบุคคลผู้โดดเดี่ยวที่ยืนในสภาพแวดล้อมไล่เฉดจากส้มเข้มไปแดง แสงซิลูเอตแรงจากด้านหลัง ความต่างของเงาลึก พื้นมันวาวสะท้อนเงาของบุคคล องค์ประกอบสมมาตร ฉากน้อยชิ้น ไม่มีสิ่งรกในพื้นหลัง อารมณ์ครุ่นคิดและทรงพลัง เหมือนภาพนิ่งจากภาพยนตร์ไซไฟ อัตราส่วนภาพ 16:9
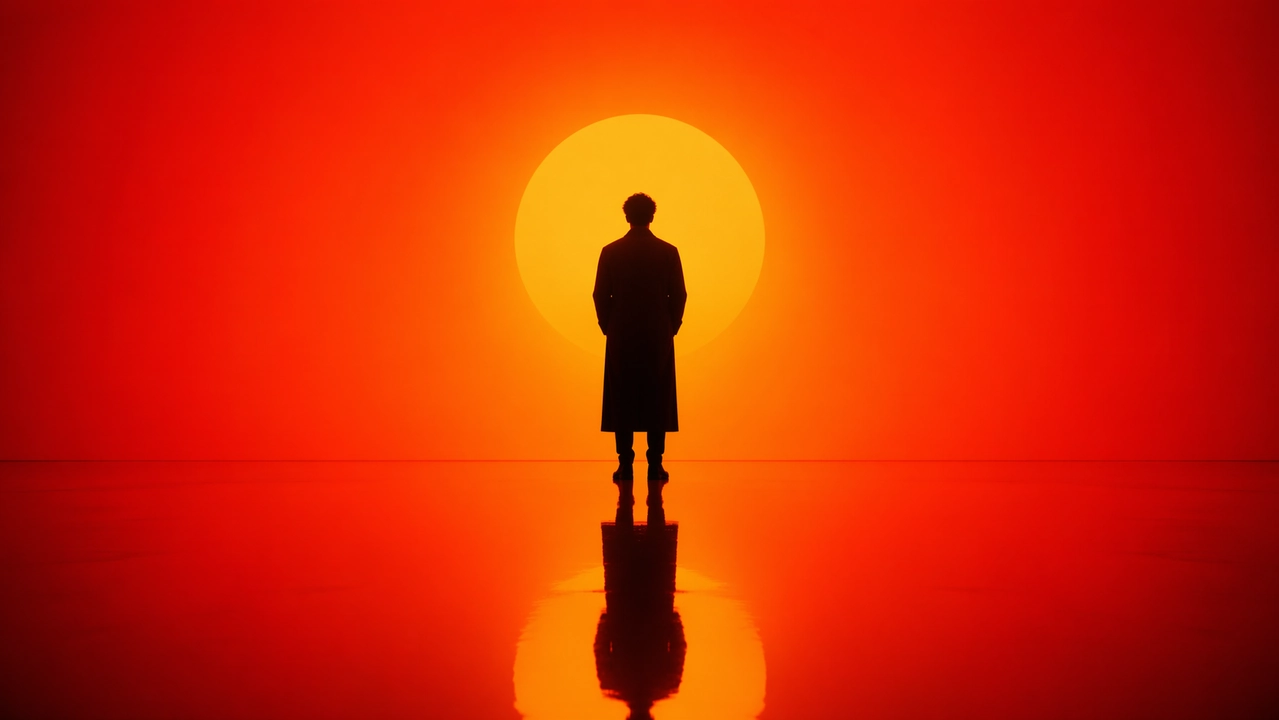
สิ่งที่ควรมองหา: ขอบซิลูเอตสะอาดไม่มีอาร์ติแฟกต์ฮาโล เงาสะท้อนบนพื้นถูกต้องตามมุมมอง ไล่เฉดเรียบ (ไม่เป็นแถบ) และท่าทางที่มีน้ำหนักจริง ไม่แข็งทื่อหรือลอย
การออกแบบโปสเตอร์เมืองและภาพประกอบ
การทดสอบความเครียดที่ยากที่สุดสำหรับตัวอักษรที่อ่านได้ควบคู่กับองค์ประกอบหนาแน่นหลายชิ้น — องค์ประกอบภาพที่แยกกันได้มากกว่าสิบชิ้นเรียงตามเส้นโค้งรูปตัว S พร้อมข้อความภาษาอังกฤษที่ต้องรอดจากการเรนเดอร์โดยไม่เสียหาย
พรอมต์:
โปสเตอร์เมืองนิวยอร์กฤดูใบไม้ผลิ 2026 ที่โดดเด่น ด้วยดีไซน์ร่วมสมัยตัวหนาและอารมณ์เฉลิมฉลองที่สง่างาม พื้นหลังเท็กซ์เจอร์ขาวนวลสะอาดพร้อมพื้นที่ว่างกว้างขวาง นักพายเรือคายัคขนาดจิ๋วพายข้ามแถบน้ำสะท้อนแคบ ๆ ที่มุมล่างขวา คลื่นน้ำกวาดขึ้นเป็นเส้นโค้งคัลลิกราฟีที่มีพลัง ค่อย ๆ กลายเป็นแม่น้ำฮัดสัน แล้วเป็นภาพพาโนรามามันฮัตตันแบบวาดมือในฝัน ภายในองค์ประกอบรูปแม่น้ำที่ไหล: ตึกเอ็มไพร์สเตต สะพานบรูคลิน เรือนยอดเซ็นทรัลพาร์ก วันเวิลด์เทรดเซ็นเตอร์ หลังคาบ้านบราวน์สโตน แท็กซี่เหลือง เรือเฟอร์รีท่าเรือ และเทพีเสรีภาพในระยะไกลนุ่มนวล หมอกยามเช้าบาง ๆ แสงฤดูใบไม้ผลิสีทอง สำเนียงสีกรมท่าและทองอย่างละมุน ตัวอักษรสง่างามที่มุมล่างซ้ายอ่านว่า “SPRING 2026” พร้อมสโลแกนแนวตั้ง “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION” ข้อความต้องคมและจัดองค์ประกอบอย่างสวยงาม ห้ามมีคำเกิน การออกแบบกราฟิกระดับพรีเมียม อัตราส่วนภาพ 9:16
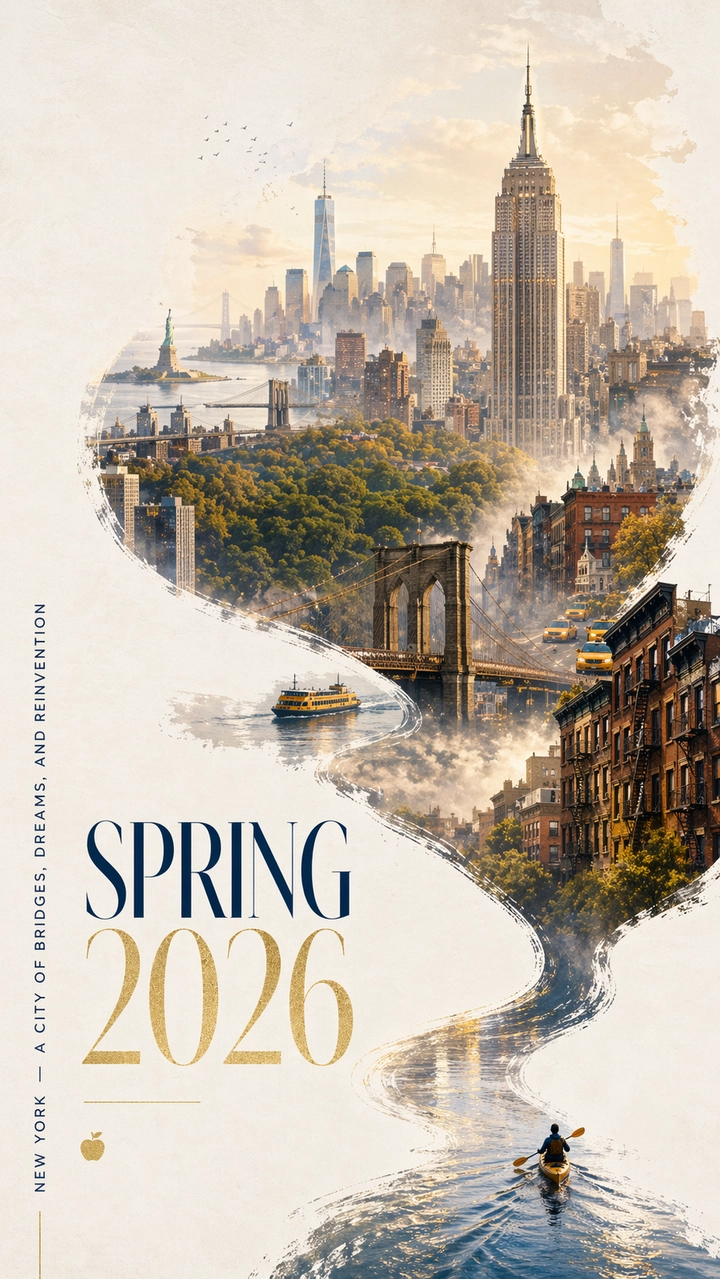
สิ่งที่ควรมองหา: ทุกตัวอักษรในชื่อและสโลแกนควรอ่านได้และสะกดถูกต้อง เส้นโค้งรูปตัว S ควรไหลอย่างเป็นธรรมชาติจากนักพายเรือคายัคไปยังเส้นขอบฟ้า อาคารแลนด์มาร์กควรอ่านออกว่าเป็นสถานที่ที่จำได้ ไม่ใช่ตึกทั่วไป และพื้นที่ว่างควรรู้สึกตั้งใจ ไม่ใช่ว่างเปล่า
การออกแบบตัวละครและชีตอ้างอิง
นักพัฒนาเกมและศิลปินคอนเซปต์ต้องการความสอดคล้องหลายมุมจากการสร้างครั้งเดียว ส่วนนี้ตรวจว่าโมเดลรักษาดีไซน์ตัวละครให้คงที่ในมุมหน้า ด้านข้าง และด้านหลังได้หรือไม่
พรอมต์:
สร้างชีตอ้างอิงตัวละครระดับมืออาชีพสำหรับตัวละคร RPG แฟนตาซีต้นฉบับ: นักเวทหญิงสาวผมสีเงิน ตาสีม่วง สวมผ้าคลุมสีเข้มประณีตที่มีลวดลายรูนเรืองแสง ใส่บนพื้นหลังสีขาวสะอาด: เทิร์นอะราวด์สามมุมแสดงด้านหน้า ด้านข้าง และด้านหลัง ความหลากหลายของสีหน้าแบบเฉย ยิ้ม โกรธ และประหลาดใจ รายละเอียดแยกชิ้นของเครื่องแต่งกายและอุปกรณ์ แถวสวอตช์พาเลตต์สี และบันทึกการสร้างโลกสั้น ๆ ด้วยตัวอักษรสะอาด เลย์เอาต์กริดที่เป็นระเบียบ สไตล์คอนเซปต์อาร์ต ความละเอียดสูง อัตราส่วนภาพ 16:9
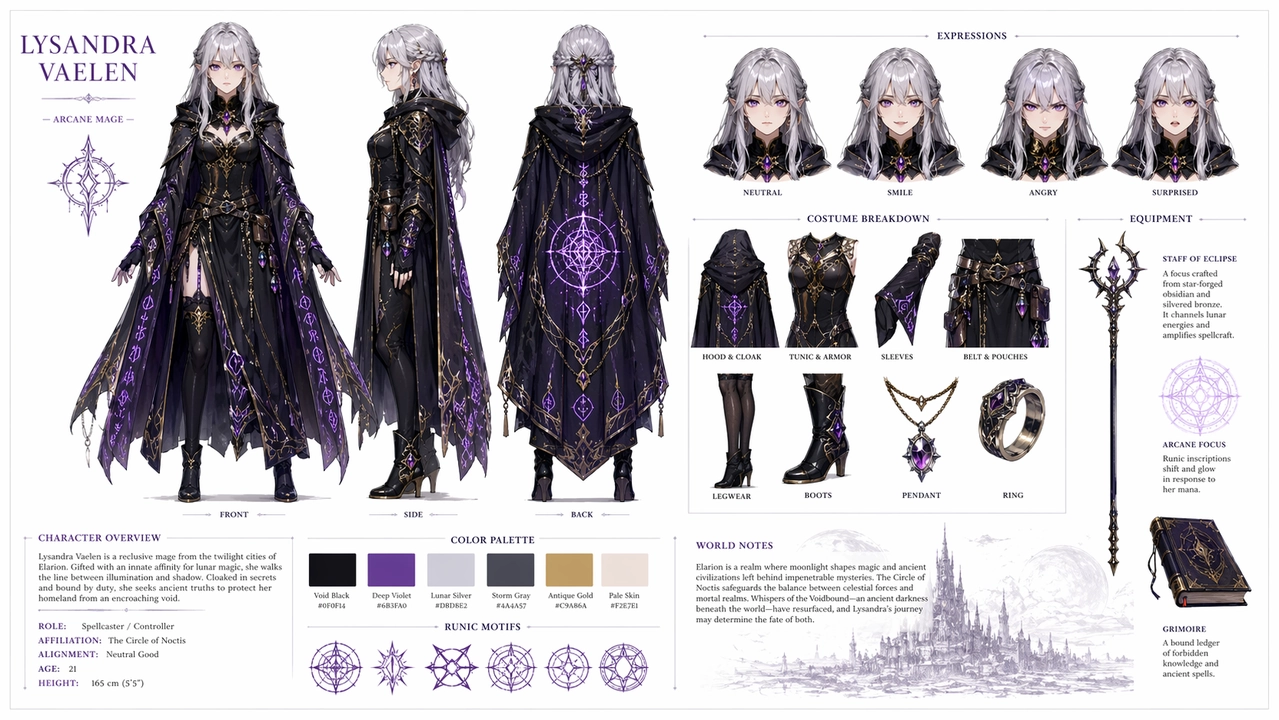
สิ่งที่ควรมองหา: ใบหน้า ผม และชุดควรคงสอดคล้องในทั้งสามมุม ความหลากหลายของสีหน้าควรเปลี่ยนเฉพาะใบหน้า ไม่ใช่ทรงผมหรือเสื้อผ้า สวอตช์พาเลตต์ควรตรงกับสีที่ใช้ในงานศิลป์จริง และป้ายข้อความควรสะกดถูกต้อง ถ้ามุมด้านข้างหรือด้านหลังเพี้ยน ให้สร้างใหม่ด้วยภาษา “preserve” ที่เข้มขึ้นโดยย้ำจุดยึดอัตลักษณ์
ม็อกอัป UI และโซเชียลมีเดีย
ส่วนนี้ดันสามสิ่งพร้อมกัน: เลย์เอาต์ UI ที่แม่นระดับพิกเซล การเรนเดอร์ข้อความหลายภาษา และการผสานคอนเซปต์เชิงสร้างสรรค์ — เนื้อหาประเภทที่มักทำผลงานได้ดีบนแพลตฟอร์มโซเชียลด้วย
พรอมต์:
ภาพหน้าจอ iPhone แบบไฮเปอร์เรียลลิสติกของหน้าโปรไฟล์ Instagram สมมติของ Leonardo da Vinci ชื่อผู้ใช้ @davinci_official ราวกับเขาเป็นอินฟลูเอนเซอร์ยุคใหม่ในปี 2026 รูปโปรไฟล์เป็นภาพเหมือนตนเองยุคเรเนสซองส์ในครอปวงกลม ไบโออ่านว่า: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions” กริดแสดง 9 โพสต์: โมนาลิซาถูกจัดเฟรมใหม่เป็นเซลฟี่หน้ากระจก สเก็ตช์เฮลิคอปเตอร์ที่มีคำบรรยาย “just dropped my new drone design” ภาพศึกษากายวิภาคที่โพสต์เป็นรูปความคืบหน้าในยิม The Last Supper ที่จัดฉากเป็นภาพหมู่ปาร์ตี้ดินเนอร์ และแมชอัปย้อนยุคสร้างสรรค์อื่น ๆ จำนวนผู้ติดตาม: 12.4M ไฮไลต์สตอรี่ติดป้าย Sketches, Inventions และ Florence Life แถบสถานะ iOS ครบถ้วนโดยข้อความผู้ให้บริการอ่านว่า “Renaissance 5G” ไอคอนแบตเตอรี่ และเวลาปัจจุบัน UI โหมดมืดตลอดทั้งภาพ คุณภาพภาพหน้าจอโฟโตเรียลลิสติก อัตราส่วนภาพ 9:16
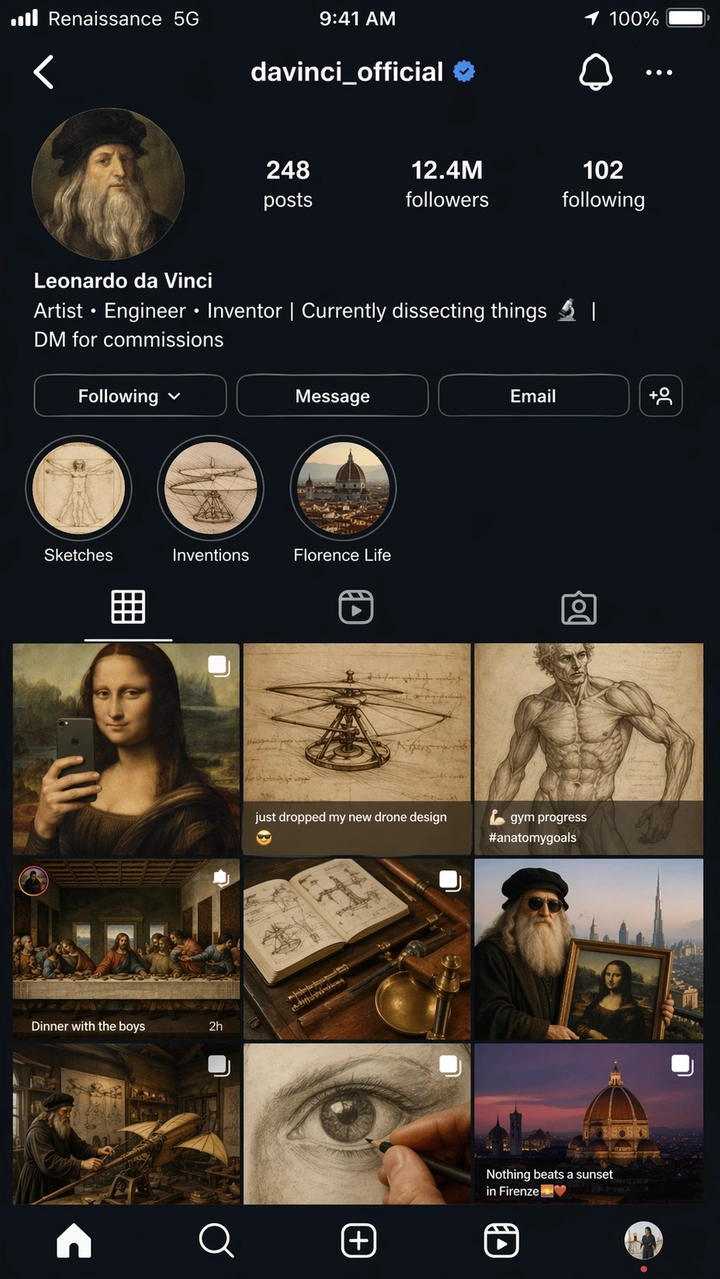
สิ่งที่ควรมองหา: องค์ประกอบ UI ของ Instagram — ระยะกริด เลย์เอาต์โปรไฟล์ วงกลมสตอรี่ แถบแท็บ — ควรอ่านออกว่าเป็นภาพหน้าจอ iOS จริง ไม่ใช่การประมาณแบบมีสไตล์ ข้อความทั้งหมดควรอ่านได้ และป้ายผู้ให้บริการ “Renaissance 5G” เป็นการตรวจความถูกต้องโดยตั้งใจ ถือเอาต์พุตม็อกอัป UI เป็นข้อมูลอ้างอิงคอนเซปต์ ไม่ใช่ UI พร้อมใช้งานจริง ป้ายขนาดเล็กและการจัดแนวไอคอนมักต้องผ่านรอบเก็บงาน
ศิลปะเชิงสร้างสรรค์และเชิงทดลอง
พรอมต์สั้นที่มีอารมณ์ขันเชิงเรื่องราวในตัว ทดสอบว่าโมเดลเติมช่องว่างเชิงสร้างสรรค์เองได้หรือไม่ แทนการพึ่งคำสั่งที่ละเอียดถี่ถ้วน
พรอมต์:
ภายในนิทรรศการพิพิธภัณฑ์ชื่อ “Ancient Technology: The Desktop Era” โปรแกรมเมอร์ในตู้กระจกกำลังสาธิตการเขียนโค้ดสดบนจอ CRT ขณะเด็กนักเรียนตะลึงกดหน้าแนบกระจก ป้ายนิทรรศการอ่านว่า: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” ตู้แสดงใกล้ ๆ อีกตู้หนึ่งโชว์หนังสือจริงที่ติดป้าย “Stack Overflow — Print Edition, Vol. 1 of 4,827” สไตล์ภาพประกอบการ์ตูน 2D แสงพิพิธภัณฑ์อบอุ่น โทนตลกและคิดถึงอดีต อัตราส่วนภาพ 16:9
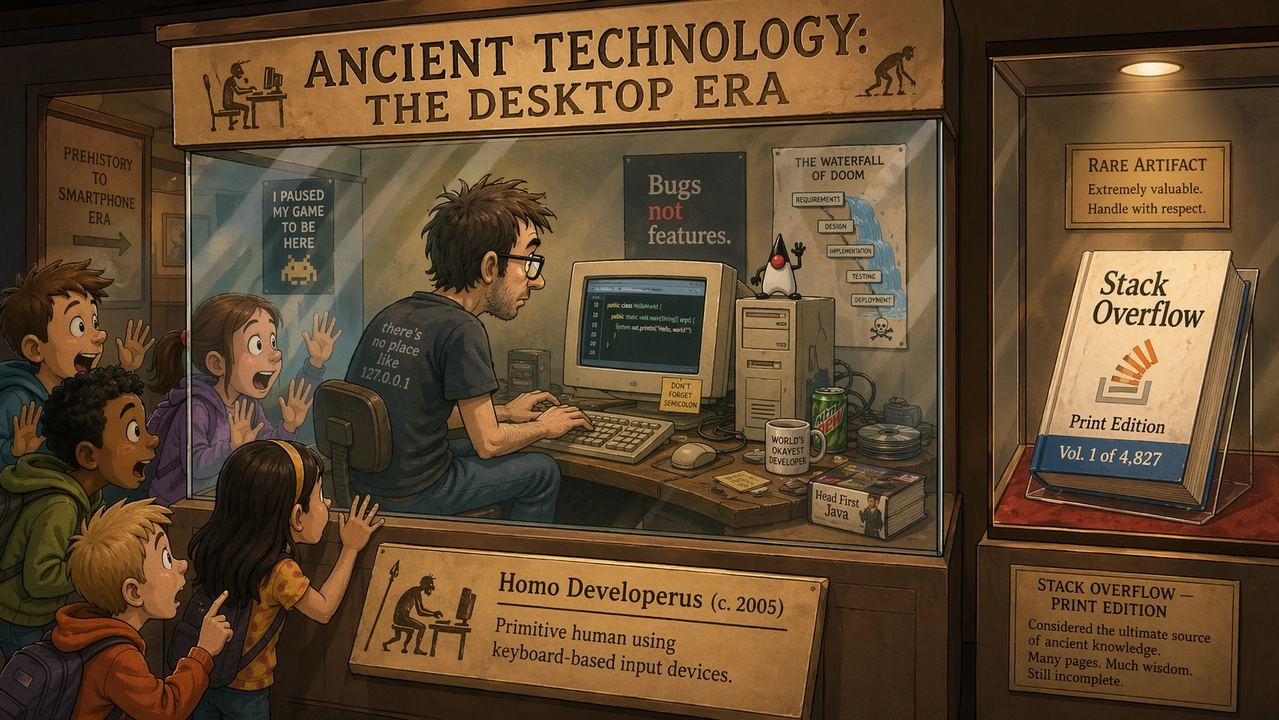
สิ่งที่ควรมองหา: อารมณ์ขันควรลงตัวผ่านรายละเอียดภาพ ไม่ใช่แค่ข้อความคำบรรยาย ป้ายและชื่อหนังสือต้องอ่านได้และสะกดถูกต้อง — การทดสอบที่ยากจริงสำหรับข้อความหลายบรรทัดขนาดเล็ก — และสไตล์การ์ตูนควรกลมกลืนทั้งฉาก ไม่กลายเป็นโฟโตเรียลลิสติกเป็นหย่อม ๆ
ผลการทดสอบตามกรณีใช้งาน
ผลที่แข็งแรงที่สุดมาอย่างสม่ำเสมอจากพรอมต์ที่มีมาตรฐานงานจริงที่ชัดเจน — สิ่งที่ตัดสินได้จากการสะกด เลย์เอาต์ การคงวัตถุ หรือลำดับแผง พรอมต์ที่ขอแค่อารมณ์คลุมเครือให้ผลที่แปรผันมากกว่า
| กรณีใช้งาน | สิ่งที่ใช้ได้ดี | สิ่งที่ยังต้องตรวจ |
|---|---|---|
| การเรนเดอร์ข้อความ | พาดหัวขนาดใหญ่ ป้ายสั้น ชื่อโปสเตอร์ และป้าย UI เรียบง่ายคงความถูกต้องเมื่ออ้างข้อความตรงเป๊ะ | ข้อความทางกฎหมายขนาดจิ๋ว ย่อหน้าหนาแน่น และฟอนต์มีสไตล์ยังอาจเพี้ยน — ให้ข้อความสั้นและตรวจทุกตัวอักษร |
| ภาพสินค้า | เลย์เอาต์โฆษณาสะอาด พื้นที่ว่างของแคมเปญ และองค์ประกอบที่สินค้ามาก่อนเรนเดอร์ได้ดี | ฉลากจริง โลโก้ และข้อความที่อยู่ภายใต้กฎระเบียบยังต้องตรวจด้วยมือหรือประกอบจากสินทรัพย์ที่อนุมัติแล้ว |
| ม็อกอัป UI | หน้าจอมือถือ แดชบอร์ด และลำดับชั้นคล้ายแอปดูน่าเชื่อเมื่อพรอมต์ระบุองค์ประกอบอินเทอร์เฟซจริง | ถือเอาต์พุตเป็นม็อกอัปคอนเซปต์ — ป้ายขนาดเล็กและการจัดแนวไอคอนมักต้องเก็บงาน |
| ความสอดคล้องของตัวละคร | ชีตตัวละคร แถวสีหน้า และสวอตช์พาเลตต์ใช้ได้ดีเป็นข้อมูลอ้างอิงเชิงสร้างสรรค์ | ใบหน้าและรายละเอียดเครื่องแต่งกายอาจเพี้ยนข้ามมุม ย้ำจุดยึดอัตลักษณ์และสร้างใหม่หากจำเป็น |
| การแก้ไขและการประกอบภาพ | รูปแบบ “เปลี่ยน คงไว้ จับคู่” ทำได้ดีกว่าคำขอแก้ไขกว้าง ๆ | ขอบเขตการเลือกและเอาต์พุตพื้นหลังโปร่งใสยังต้องผ่าน QA |
ข้อผิดพลาดทั่วไปในการพรอมต์ GPT Image 2
- ขอข้อความที่ถูกต้องโดยไม่ให้ข้อความตรงเป๊ะ ถ้าข้อความสำคัญ ให้เขียนตามตัวอักษรและบอกว่าอยู่ตรงไหน
- ยัดรายละเอียดที่เป็นไปได้ทั้งหมดลงพรอมต์เดียว เริ่มจากฉากหลัก แล้วปรับทีละตัวแปร
- ลืมระบุสิ่งที่ต้องคงเดิมระหว่างการแก้ไข เขียนให้ชัดว่าอะไรต้องไม่เปลี่ยน: อัตลักษณ์ พื้นหลัง ท่าทาง แสง รูปทรงสินค้า ข้อความบนฉลาก มุมกล้อง
- พึ่งคำคุณภาพตกแต่งสำหรับงานเชิงฟังก์ชัน “สวย” ไม่ทำให้ฉลากอ่านได้ — ใช้ภาษาอย่าง “ข้อความฉลากคมชัด” หรือ “อ่านได้จากระยะไกล” แทน
- ข้ามอัตราส่วนภาพ ภาพสี่เหลี่ยมจัตุรัสที่แข็งแรงยังอาจใช้ไม่ได้เป็นโฆษณาแนวตั้งหรือภาพขนาดย่อวิดีโอ
- ถือโลโก้เหมือนข้อความธรรมดา GPT Image 2 ออกแบบ คอนเซปต์ โลโก้ได้ แต่เครื่องหมายแบรนด์ที่ตรงเป๊ะควรประกอบจากสินทรัพย์ที่อนุมัติแล้ว ไม่ใช่สั่งในพรอมต์โดยตรง
บันทึก API และราคาของ GPT Image 2
หน้าราคา API ของ OpenAI ระบุ GPT Image 2 ตามโทเคน ไม่ใช่อัตราคงที่ต่อภาพ:
| รายการ | ราคาที่ระบุ |
|---|---|
| อินพุตภาพ | $8.00 / 1M tokens |
| อินพุตภาพที่แคช | $2.00 / 1M tokens |
| เอาต์พุตภาพ | $30.00 / 1M tokens |
| อินพุตข้อความ | $5.00 / 1M tokens |
| อินพุตข้อความที่แคช | $1.25 / 1M tokens |
ต้นทุนจริงต่อภาพขึ้นกับความยาวพรอมต์ ภาพอ้างอิง ขนาดเอาต์พุต การแคช และการตั้งค่าคุณภาพ โควตาแพ็กเกจ ChatGPT เป็นคนละเส้นทางกับการเรียกเก็บ API — การสมัคร Plus ไม่แปลงเป็นเครดิต API โดยตรง ดังนั้นควรงบทั้งสองอย่างแยกกันถ้าคุณใช้ทั้งคู่
สำหรับเวิร์กโฟลว์ปริมาณสูง ตัวเลขที่สำคัญคือต้นทุนต่อสินทรัพย์ที่ ยอมรับ หลังลองใหม่ ไม่ใช่ราคาป้ายของการพยายามครั้งเดียว การสร้างที่ถูกกว่าไม่ได้ถูกจริงถ้าต้องสร้างใหม่สามครั้งกว่าการสะกดหรือเลย์เอาต์จะถูกต้อง
| เวิร์กโฟลว์ | คำแนะนำการพรอมต์ที่ใช้ได้จริง |
|---|---|
| โปสเตอร์หรือไดอะแกรมที่มีข้อความมาก | ใช้คำน้อยลงต่อภาพ อ้างข้อความตรงเป๊ะ ระบุลำดับชั้นอย่างชัดเจน |
| ภาพถ่ายสินค้า | ล็อกรูปทรงสินค้า ฉลาก สี วัสดุ และมุมกล้อง ย้ำรายการที่ต้องคงไว้ทุกครั้งที่แก้ไข |
| ม็อกอัป UI | อธิบายหน้าจอเป็นอินเทอร์เฟซที่ปล่อยใช้งานแล้ว — การนำทาง การ์ด ปุ่ม สถานะ — ไม่ใช่คอนเซปต์อาร์ต |
| การแก้ไขหลายภาพอ้างอิง | ติดป้ายแต่ละภาพอินพุตตามบทบาท: ตัวแบบ สไตล์ พื้นหลัง ชุด หรือวัสดุอ้างอิง |
| การสร้างเป็นชุด | ติดตามต้นทุนต่อภาพที่ยอมรับ ไม่ใช่ต้นทุนต่อครั้งที่พยายาม |
ถ้าคุณอยากเห็นว่า GPT Image 2 เทียบกับทางเลือกที่เน้นโฟโตเรียลลิสม์เป็นอันดับแรกบนพรอมต์เดียวกันอย่างไร การเปรียบเทียบ GPT Image 2 กับ Nano Banana 2 ของเราทดสอบแบบตัวต่อตัวหกรอบ พร้อมรายละเอียดราคา API และแพลตฟอร์มครบ
จากภาพสู่วิดีโอ: ทำให้เวิร์กโฟลว์สร้างสรรค์ครบบน PixVerse
การสร้างภาพที่แข็งแรงเป็นเพียงขั้นหนึ่ง การเปลี่ยนเป็นภาพเคลื่อนไหวคือจุดที่เวิร์กโฟลว์ส่วนใหญ่สะดุด — คุณทำภาพบุคคลหรือโปสเตอร์สินค้าเสร็จใน GPT Image 2 แล้วต้องเปิดเครื่องมืออีกตัว อัปโหลดไฟล์ใหม่ และหวังว่าโมเดลวิดีโอจะไม่บิดเบือนภาพที่จัดองค์ประกอบอย่างระมัดระวัง แรงเสียดทานของการส่งต่องานนี้คือสิ่งที่ PixVerse ตัดออก
GPT Image 2 พร้อมใช้บน PixVerse แล้ว
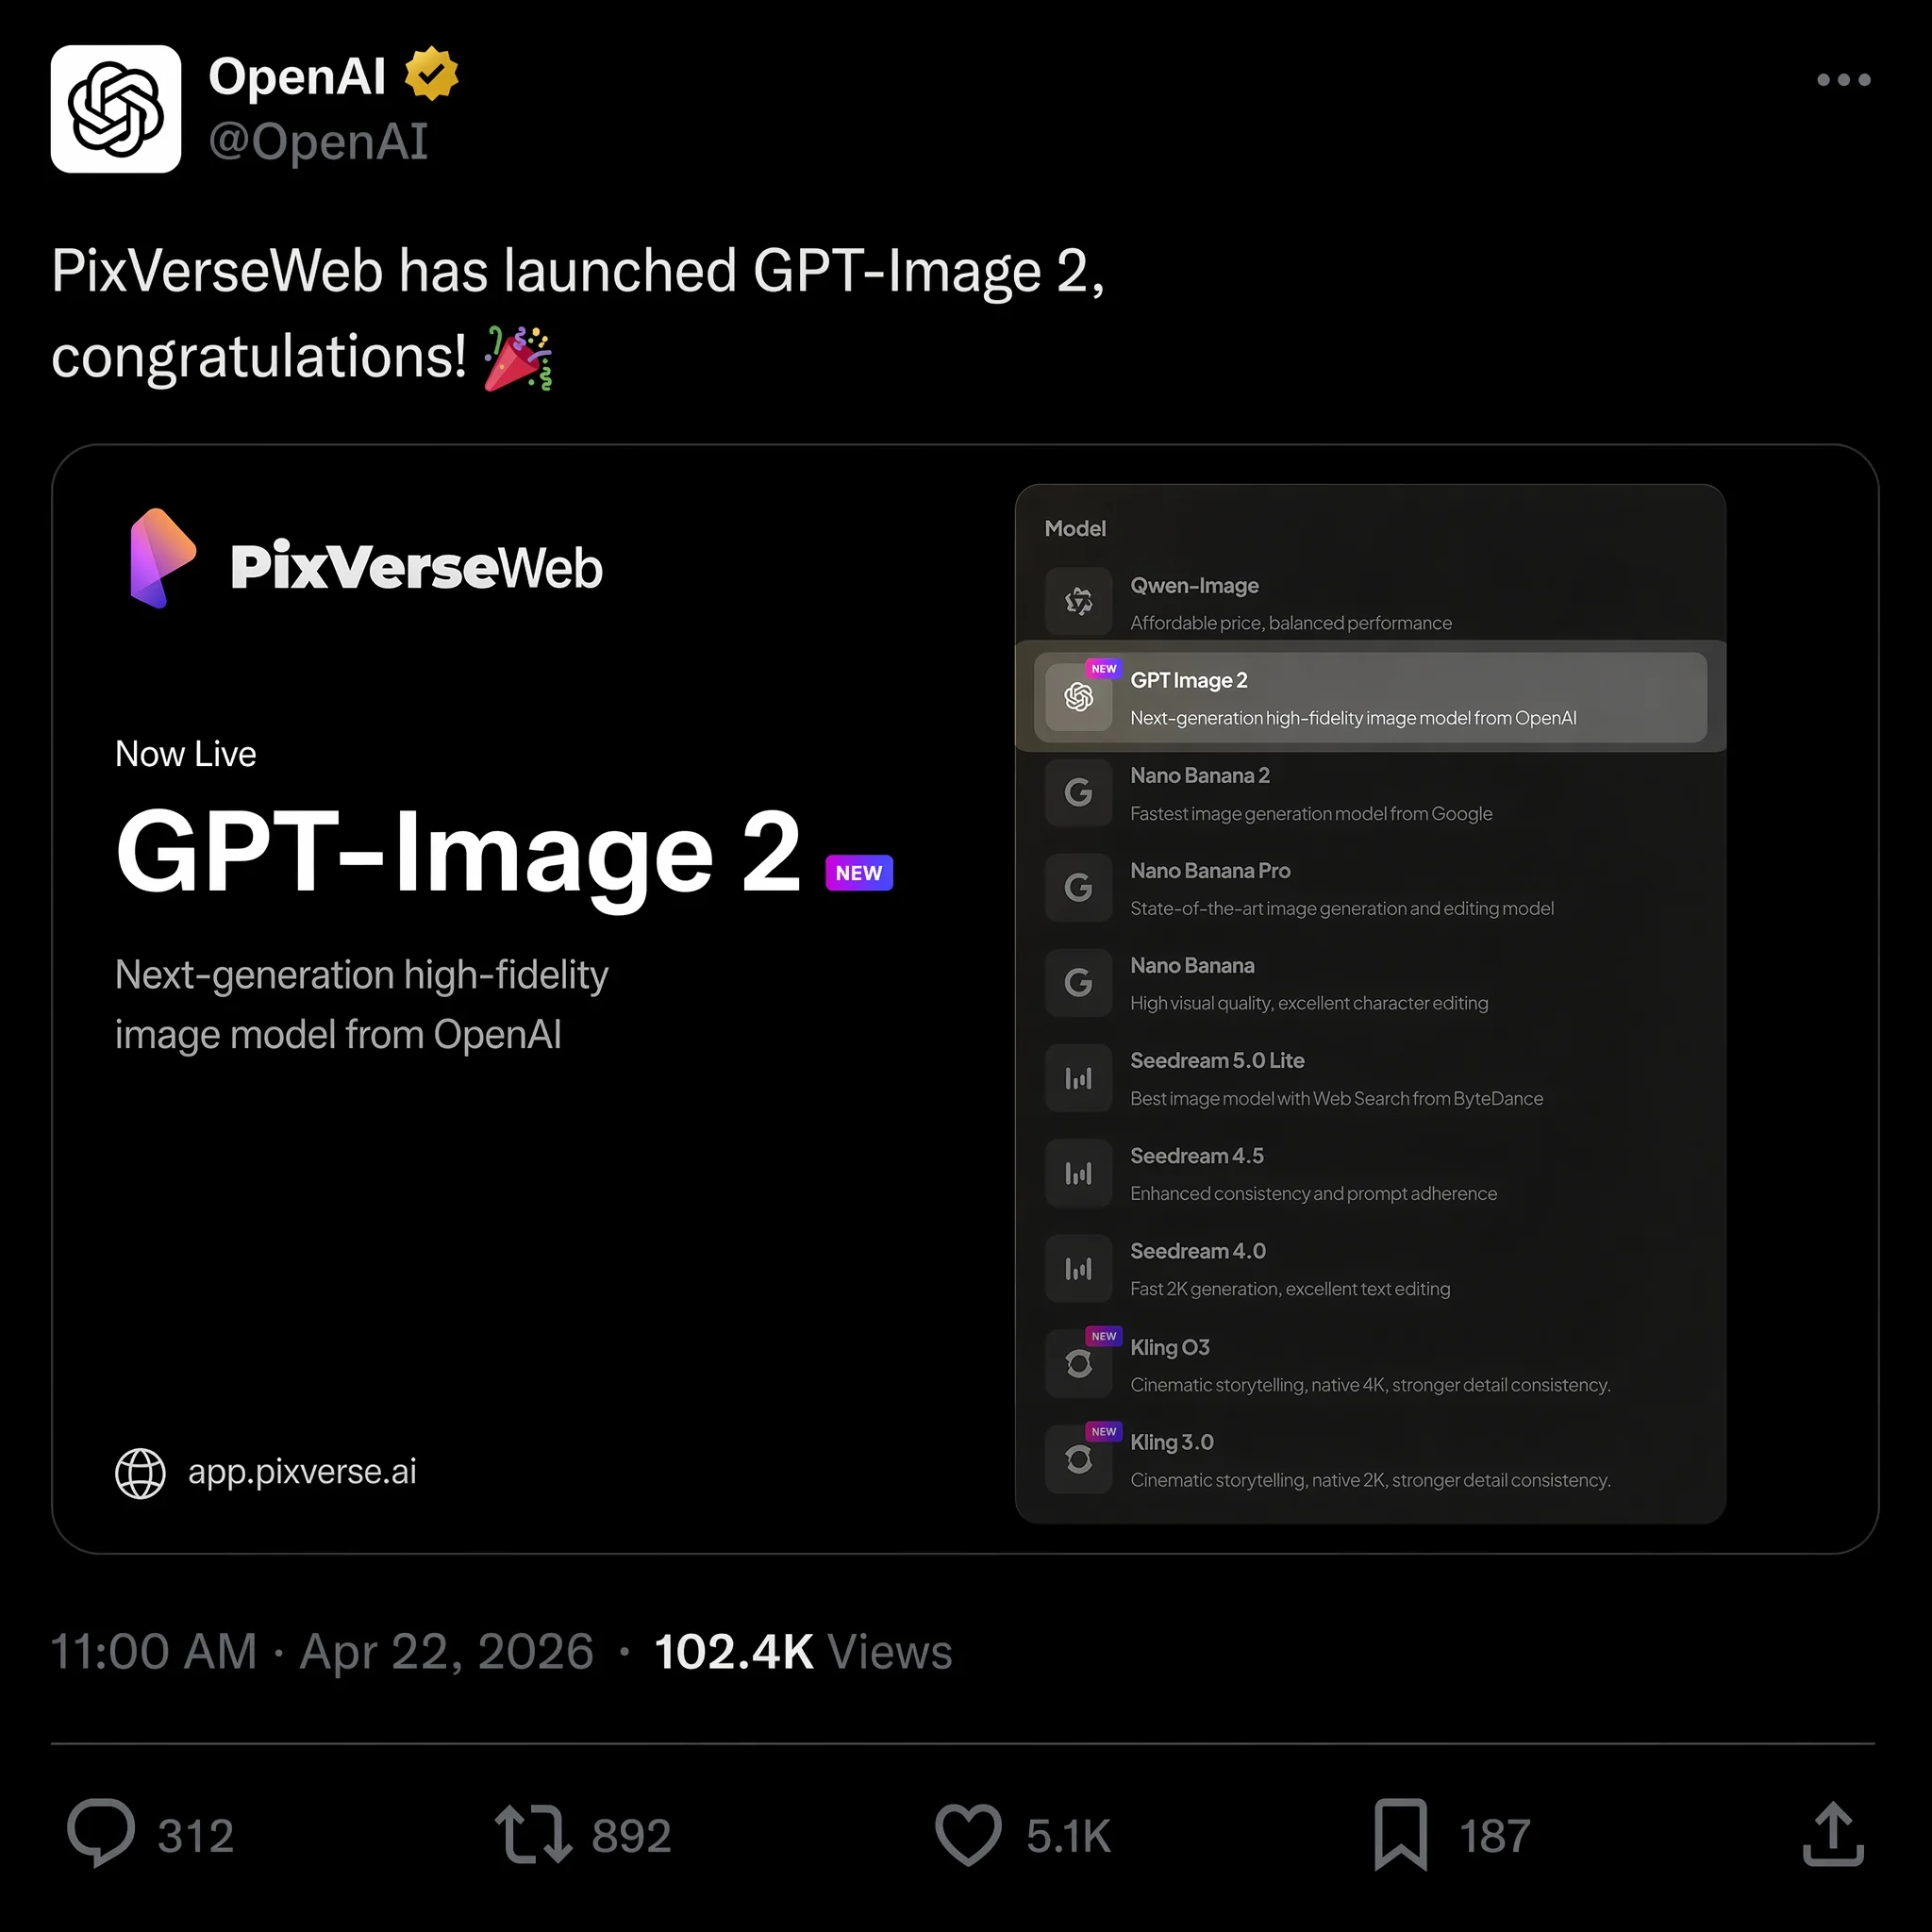
เมื่อวันที่ 22 เมษายน 2026 PixVerse เพิ่ม GPT Image 2 เป็นตัวเลือกข้อความเป็นภาพ ร่วมกับ Nano Banana 2, Seedream และ HappyHorse 1.0 ในรายชื่อโมเดล คุณสามารถสร้างภาพด้วย GPT Image 2 แล้วแปลงเป็นวิดีโอในเวิร์กสเปซเดียวกัน โดยไม่ต้องดาวน์โหลด อัปโหลดใหม่ หรือสลับแท็บ
เรื่องนี้สำคัญด้วยเหตุผลที่เป็นรูปธรรม: เมื่อภาพถูกป้อนตรงเข้าไปป์ไลน์ภาพเป็นวิดีโอบนแพลตฟอร์มเดียวกัน โมเดลวิดีโอทำงานจากไฟล์ต้นฉบับความละเอียดเต็มและเมตาดาต้าโดยตรง ไม่มีการสูญเสียคุณภาพจากการบีบอัดหรือการแปลงฟอร์แมตระหว่างทาง ซึ่งหมายถึงการเคลื่อนไหวที่สะอาดกว่าและอาร์ติแฟกต์น้อยลงในคลิปสุดท้าย
ถ้าภาพนิ่งตั้งใจให้กลายเป็นคลิป ให้พรอมต์เรื่องความพร้อมต่อการเคลื่อนไหวตั้งแต่ต้น — ขอความลึกของฉากหน้า ฉากกลาง และฉากหลัง ซิลูเอตตัวแบบที่สะอาด และองค์ประกอบทางกายภาพหนึ่งอย่างที่ขยับได้อย่างสมเหตุสมผล (ฝุ่น ไอน้ำ ผ้า แหล่งแสงที่เปลี่ยน) ตรวจภาพนิ่งเหมือนไฟล์ดีไซน์ที่เสร็จแล้วก่อนทำให้เคลื่อนไหว: ตรวจการสะกด เรขาคณิตของสินค้า และการจัดแนว UI ก่อน เพราะโมเดลวิดีโอจะไม่แก้พาดหัวที่สะกดผิดหรือฉลากที่บิดเบี้ยวเอง จากนั้นเขียนพรอมต์การเคลื่อนไหวแยกที่สั้นกว่า โดยอธิบายเฉพาะสิ่งที่ควรขยับและสิ่งที่ต้องล็อกไว้ แทนการทำซ้ำบรีฟภาพทั้งหมด
ทำไมครีเอเตอร์จึงย้ายไปแพลตฟอร์มแบบครบวงจร
ถ้าคุณใช้ Sora ของ OpenAI สำหรับสร้างวิดีโอก่อนมีนาคม 2026 คุณรู้ความเสี่ยงของการสร้างเวิร์กโฟลว์รอบเครื่องมือเดียวอยู่แล้ว OpenAI ปิดแอปและ API ของ Sora เมื่อวันที่ 24 มีนาคม โดยอ้างต้นทุนที่ยั่งยืนไม่ได้และการหันไปสู่หุ่นยนต์ และครีเอเตอร์หลายพันคนสูญเสียไปป์ไลน์วิดีโอข้ามคืน ดู คู่มือทางเลือกแทน Sora ของเราสำหรับรายละเอียดว่าเกิดอะไรขึ้น และเครื่องมือใดเติมช่องว่างนั้น
PixVerse ใช้แนวทางต่างออกไป โดยให้คุณเข้าถึงหลายโมเดลตลอดไปป์ไลน์สร้างสรรค์ทั้งหมด แทนการล็อกคุณไว้กับตัวเดียว:
- ข้อความเป็นภาพ ด้วย GPT Image 2, Nano Banana 2, Seedream และอื่น ๆ — เลือกโมเดลที่เหมาะกับงาน
- ภาพเป็นวิดีโอ ที่แปลงภาพที่คุณสร้างให้เป็นการเคลื่อนไหว พร้อม ความสอดคล้องของตัวละคร และการควบคุมกล้อง
- ข้อความเป็นวิดีโอ สำหรับคลิปที่สร้างตรงจากพรอมต์ที่เขียน โดยใช้ PixVerse V6 หรือ โมเดล C1 แบบภาพยนตร์
- การสร้างเสียงในตัว ที่ซิงก์เอฟเฟกต์เสียงและบทสนทนากับวิดีโอของคุณโดยอัตโนมัติ
ประโยชน์ที่ใช้ได้จริง: คุณไปจากคอนเซปต์ที่เขียนไว้สู่วิดีโอที่เสร็จพร้อมเสียงซิงก์ได้โดยไม่ต้องออกจากเวิร์กสเปซเดียว ซึ่งตัดเวลาจัดการไฟล์หลายชั่วโมงออกจากทุกโปรเจกต์ ถ้าคุณอยากสคริปต์การสร้างจากบรรทัดคำสั่ง คู่มือ PixVerse CLI ครอบคลุมการทำงานอัตโนมัติทั้งการสร้างภาพและวิดีโอ
PixVerse ยังให้เครดิตฟรีรายวัน 30–60 สำหรับผู้ใช้ใหม่ ดังนั้นคุณทดสอบไปป์ไลน์เต็มรูปแบบได้ — จากการสร้างภาพจนถึงเอาต์พุตวิดีโอ — ก่อนผูกมัดกับแพ็กเกจแบบเสียเงิน
คำถามที่พบบ่อย
GPT Image 2 ใช้ฟรีได้หรือไม่?
ผู้ใช้ ChatGPT ฟรีสร้างภาพด้วย GPT Image 2 ได้ประมาณสองภาพต่อวัน ผู้สมัคร ChatGPT Plus ($20/เดือน) ได้การสร้างไม่จำกัดพร้อมการประมวลผลที่เร็วกว่า การเข้าถึง API คิดตามโทเคนทั้งอินพุตภาพ เอาต์พุตภาพ และอินพุตข้อความ ดังนั้นต้นทุนเพิ่มตามความยาวพรอมต์และขนาดเอาต์พุต ไม่ใช่ค่าธรรมเนียมคงที่ต่อภาพ
GPT Image 2 รองรับความละเอียดเท่าใด?
GPT Image 2 สร้างภาพที่ความละเอียดเนทีฟ 2K พร้อมตัวเลือกอัปสเกล 4K ผ่าน API อัตราส่วนภาพมีตั้งแต่ 3:1 ถึง 1:3 ดังนั้นรูปแบบสี่เหลี่ยมจัตุรัส แนวตั้ง และอัลตราไวด์ใช้ได้โดยตรงทั้งหมด
GPT Image 2 เรนเดอร์ข้อความในภาพได้ถูกต้องหรือไม่?
ได้ — นี่คือหนึ่งในจุดแข็งที่สุด ในการทดสอบของเรา ความถูกต้องของข้อความภาษาอังกฤษ จีน ญี่ปุ่น เกาหลี และอาหรับเกิน 95% ในความพยายามสร้างครั้งแรก พาดหัวหลายบรรทัด ชื่อโปสเตอร์ และป้ายข้อความ UI จัดการได้อย่างน่าเชื่อถือ แม้ข้อความขนาดเล็กมากที่ความละเอียดต่ำยังอาจพลาดเป็นครั้งคราว
GPT Image 2 เทียบกับ Midjourney และ Nano Banana 2 อย่างไร?
Midjourney V8 มีการควบคุมสไตล์ศิลปะที่แข็งแรงกว่า และชุมชนที่ก่อตัวมานานกว่าสำหรับการขัดเกลาสุนทรียะ Nano Banana 2 เป็นตัวเลือกที่แข็งแรงกว่าสำหรับโฟโตเรียลลิสม์ แสงแบบภาพยนตร์ และการทำซ้ำที่เร็ว GPT Image 2 ได้เปรียบเรื่องการเรนเดอร์ข้อความ เลย์เอาต์ที่มีโครงสร้าง และการแก้ไขด้วยภาษาธรรมชาติ สำหรับการออกแบบโปสเตอร์และสื่อการตลาดที่มีข้อความ GPT Image 2 ชนะอยู่ในตอนนี้ สำหรับการสำรวจศิลปะล้วนหรือช็อตฮีโร่โฟโตเรียล อีกสองตัวคุ้มค่าที่จะเทียบโดยตรง — ดู การทดสอบตัวต่อตัวกับ Nano Banana 2 ของเรา
ทางเลือกที่ดีที่สุดแทน Sora สำหรับวิดีโอหลังการปิดบริการคืออะไร?
หลังจาก OpenAI ปิด Sora ในเดือนมีนาคม 2026 ทางเลือกอันดับต้น ๆ ได้แก่ PixVerse V6 สำหรับวิดีโอหลายช็อตที่ตัวละครสอดคล้องกัน Runway Gen-4 สำหรับการควบคุมกล้องแบบภาพยนตร์ และ Kling v3.0 สำหรับซีเควนซ์แอ็กชัน PixVerse เป็นแพลตฟอร์มเดียวที่รวมข้อความเป็นภาพ ภาพเป็นวิดีโอ และข้อความเป็นวิดีโอพร้อมเสียงในตัว ทั้งหมดเข้าถึงได้ด้วยเครดิตฟรีรายวัน ดู คู่มือทางเลือกแทน Sora ฉบับเต็มของเราสำหรับการเปรียบเทียบอย่างละเอียด
ฉันเปลี่ยนเอาต์พุต GPT Image 2 เป็นวิดีโอได้หรือไม่?
ได้ เมื่อมี GPT Image 2 ใน PixVerse คุณสร้างภาพในแอปแล้วแปลงเป็นวิดีโอด้วยไปป์ไลน์ภาพเป็นวิดีโอในเวิร์กสเปซเดียวกัน โดยไม่ต้องโอนไฟล์ คุณยังอัปโหลดไฟล์ GPT Image 2 ที่สร้างที่อื่นแล้วรันผ่านไปป์ไลน์เดียวกันได้