GPT Image 2 レビュー:2026年版プロンプトガイドと活用事例
OpenAIは2026年4月21日にGPT Image 2をリリースしました。GPT Image 1.5の後継モデルであり、現在ChatGPT全体の画像生成を支えているモデルです。私たちはローンチ週にこのモデルをテストし、6月下旬にはさらに幅広いプロンプト、OpenAI自身のプロンプトガイド、そして公開されているAPI価格を使って再検証を行い、初期の盛り上がりが落ち着いた後もモデルがどれだけ通用するかを確かめました。
主なポイント:
- GPT Image 2はネイティブ2K解像度で画像を生成し、オプションで4Kアップスケーリングにも対応しています。テキストレンダリングの精度は、ラテン文字、中国語、日本語、韓国語、アラビア語のスクリプト全体で95%以上です。
- このモデルは写真生成ツールというより、デザインアシスタントとして扱うのが最適です。正確なコピー、固定されたレイアウト、繰り返し可能なパネル構造といった明確な成功基準がある仕事で真価を発揮し、「美しく仕上げて」といった曖昧な指示では結果が読みにくくなります。
- ブランドロゴの再現、極小の法的表記、独自フォントは依然として弱点であり、手動での確認が必要です。
- OpenAIのAPIは、画像入力、キャッシュされた画像入力、画像出力、テキスト入力、キャッシュされたテキスト入力にわたってトークン単位でGPT Image 2を課金します。これは一部の競合が採用する画像単位の価格体系とは異なります。
- PixVerseはNano Banana 2やSeedreamと並んでGPT Image 2をテキストから画像へのモデルラインナップに組み込んでおり、生成した画像をワークスペースを離れることなくそのまま画像から動画へのパイプラインに投入できます。
GPT Image 2とは?主要機能と制限事項
GPT Image 2はOpenAIの第2世代画像モデルで、ChatGPTとAPI全体でGPT Image 1.5を置き換えます。Midjourney、DALL-E 3、Stable Diffusionと競合しますが、その独自性は2つの点にあります。画像内の正確なテキストと、プロンプトの意図をキーワードの単純な照合ではなく解釈する推論レイヤーです。
主要機能の概要
| 機能 | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| ネイティブ解像度 | 2K(4Kアップスケール対応) | 1K | 2K(—hdフラグ使用) |
| テキストレンダリング精度 | 95%以上(多言語対応) | 約70%(ラテン文字のみ) | 約80%(ラテン文字のみ) |
| 推論統合 | あり — 複層的な指示を解釈 | なし | なし |
| アスペクト比範囲 | 3:1〜1:3 | 1:1、16:9 | 1:1〜3:2 |
| キャラクター一貫性 | 連続画像間でピクセルレベルの一致 | 限定的 | 中程度(—crefフラグ) |
| 自然言語編集 | あり — 説明による領域単位の編集 | なし | なし |
| 価格 | APIはトークン課金制;ChatGPTはプラン階層制 | 同様 | $10〜30/月のサブスクリプション |
テキストレンダリングは最も注目される機能であり、それには理由があります。従来の画像モデルはテキストをテクスチャとして扱っていました——ポスターの見出しを依頼しても、文字のような形をしたノイズが返ってくるだけでした。GPT Image 2は、複数行の英語の見出し、漢字、さらには多言語が混在するレイアウトも本当に一貫した精度で処理します。私たちのテストでは、20回中およそ19回の生成が初回から完全に読み取れる結果でした。
推論統合とは、モデルが単に言い回しをパターンマッチングする以上のことを行うという意味です。「サンフランシスコの明日の天気に合わせた活動を示すインフォグラフィックを生成して」と依頼すると、モデルは予報を取得し、関連するアクティビティを選び、そのデータをもとにレイアウトを構築します。これはMidjourneyやStable Diffusionがプロンプトを処理する方法よりも一段進んだアプローチです。
自然言語編集では、手動でマスクを作成する代わりに、変更内容を説明するだけで画像を修正できます。「コーヒーカップをテーブルの左側に移動して」や「空を夕焼けに変えて」といった指示は、シーン全体を再生成することなく的確な編集として適用されます。
ユーザーの声
ローンチ以降のフィードバックは概ね好意的で、共通する不満もいくつか見られます。X(旧Twitter)やRedditで出回っているポートレートテストはスタジオ写真に近い仕上がりで、フライヤー、メニュー、看板といった長文レイアウトをテストしたポスターデザイナーからは、テキスト精度がようやく実用レベルに達したという報告が上がっています。複数のデザイナーは、モデル自身の構図センスがレイアウト判断を単独で行えるほど優れているため、基本的なマーケティング素材ではPhotoshopの工程を省略できたと述べています。
最も高く評価されているのはプロンプトへの忠実性です。シーンに15個の具体的な要素を指定しても、GPT Image 2はそのすべてを含める傾向があります。一方、旧モデルではプロンプトが長くなるにつれて細部が抜け落ち始めていました。
否定的な面では、ブランドの再現性は依然として不安定です。広く共有されたZDNetのハンズオンテストでは、モデルがZDNETのロゴを正確に再現できないことが示されており、他のユーザーも特定のブランドマークで同様の問題を報告しています。モデルはロゴが概念として何であるかは理解していますが、正確なベクター形状や独自の書体を確実に再現することはできません。
既知の制限事項
- ブランドロゴの再現は信頼性が低く、生成後にPhotoshopやFigmaで正確なロゴを合成する方が、直接プロンプトで指示するより確実です。
- 生成速度はFLUXやNano Banana 2といった軽量モデルに劣ります。ChatGPT Plusでは通常30〜60秒かかるのに対し、他のツールでは10秒未満です。
- 無料版のレート制限は厳しく、無料のChatGPTユーザーは1日あたりおよそ2枚の画像に制限されています。Plus加入者はChatGPTでの生成が無制限になりますが、APIコストは利用量に応じて増加します。
- スタイル制御はMidjourneyほど繊細ではありません。フィルムストックやレンズタイプ、粒状感を同じ精度で指定することはできず、モデル自身の美的傾向を上書きするには意図的なプロンプト工夫が必要です。
- コンテンツポリシーはオープンソースの代替ツールより厳格で、Stable Diffusionやローカルモデルでは問題なく通るプロンプトの一部がここでは拒否されます。
これらはいずれも本番利用を妨げるものではありませんが、1つのモデルだけを中心にパイプラインを構築する前に知っておく価値があります。
実際に機能するGPT Image 2プロンプトの書き方
2回目のテストで最もはっきりした変化は、優れたGPT Image 2プロンプトは単に絵を描写するのではなく、その絵が果たすべき「仕事」を描写しているという点です。ソーシャル広告用のプロンプトは、製品切り抜き、インフォグラフィック、UI画面、動画用のファーストフレームとはそれぞれ書き方が異なるべきです。
ブリーフを構成する際の信頼できるパターンは以下の通りです。
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
スタイルより先に「仕事」の種類を伝える
出力タイプ——ポスター、製品広告、アプリ画面、キャラクターシート、図解、編集、動画のファーストフレームなど——を最初に示すことで、モデルはどの基準で評価されるべきかを把握できます。
Weak: A cool futuristic speaker, cinematic, high detail.
Better: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
2つ目のバージョンは、モデルが単なる美しさではなくレイアウトと実用性で評価されていることを伝えています。
テキストは固定アセットのように扱う
必要なコピーは引用符で囲み、レンダリングのされ方を正確に指定します——「スローガンを入れて」だけでは、モデルが勝手に言葉を作り出してしまいます。
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
より長いコピーの場合は、プロンプト内で各行を明示的に分けてください。単語のスペルが間違って返ってきた場合は、コピーを短くし、文字を大きくし、より厳密な「exact text only」の指示を加えて再生成しましょう。
モデルにカメラとレイアウトを与える
カメラの距離、角度、被写体の配置、余白、アスペクト比を直接指定してください。GPT Image 2は構図の指示によく従いますが、それは明示的に書かれている場合に限られます。
- クローズアップ:製品の質感、手、顔、素材、ラベル向け。
- ワイドショット:環境、ストーリーシーン、シティポスター、動画用フレーム向け。
- トップダウン:フード、デスクシーン、フラットレイ、パッケージキット向け。
- 左3分の1/右3分の1:テキストと製品のバランスを取る広告レイアウト向け。
- クリーンなグリッド:UIモックアップ、キャラクターシート、図解、インフォグラフィック向け。
編集指示は3つの文で書く
最も効果的な編集プロンプトは、変更内容と、そのまま維持すべきもの、そして両者をつなぐ物理的なリアリズムを分けて記述しています。
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
この「変更・維持・整合」という構造は、曖昧な「もっと良くして」というリクエストよりも一貫して優れた結果を出します。
静止画が動画になる場合はモーションの手がかりを加える
画像がのちにPixVerseの画像から動画へのパイプラインに投入される可能性がある場合は、あらかじめ奥行きと動きへの準備をプロンプトに盛り込んでください。前景・中景・背景、被写体のクリアなシルエット、そして動きうる要素——ほこり、布、髪、雨、反射、あるいはカメラの移動経路——を1つ視覚的に含めます。
Instead of: An astronaut in a desert.
Use: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
GPT Image 2のテスト方法
2回のテストを通じて、ポートレート、テキストの多いポスター、製品風の構図、キャラクターシート、UIモックアップ、実験的なナラティブシーンにモデルを通しました。目的はベンチマークスコアを出すことではなく、デザイナー、マーケター、クリエイターが軽微な修正だけでアウトプットをそのまま使えるか、それともゼロから作り直す必要があるかを見極めることでした。
| テスト領域 | 確認した内容 |
|---|---|
| ポートレートとシネマティックスチル | ライティング制御、肌の質感、反射、雰囲気、シーンの一貫性 |
| ポスターとタイポグラフィレイアウト | 見出しのスペル、複数行テキスト、階層構造、余白、ブランドらしい完成度 |
| キャラクター・コンセプトシート | 複数視点の一貫性、衣装の細部、パレットの整合性、ラベルの正確さ |
| UI・ソーシャルモックアップ | レイアウトのリアリズム、小さなテキスト、アイコンの間隔、フィードグリッド、スクリーンショットとしての説得力 |
| 実験的プロンプト | ユーモア、ナラティブの推論、オブジェクトの配置、小さなキャプションの正確さ |
このパターンは両ラウンドを通じて一貫していました。GPT Image 2はキーワードの連なりよりも、正確なブリーフに報いる傾向があります。プロンプトが仕事の種類を明示し、成功の基準——正確なテキスト、固定されたレイアウト、繰り返し可能なパネル構造——を定義している場合、モデルは構造を維持しやすくなります。プロンプトが曖昧な雰囲気だけを求めている場合、結果自体は洗練されて見えても、編集なしで再利用するのは難しくなります。
GPT Image 2のユースケースとプロンプト例
ライティング制御、正確なテキストタイポグラフィ、複数要素の構図、キャラクターの一貫性、UIレイアウトという5つの異なる能力を、以下のシナリオでストレステストしました。以下の各プロンプトはそのままコピーして調整できます。
シネマティックポートレート写真
このテストは、ポートフォリオに掲載できる画像と一般的なAIレンダリングを分ける基本要素である、ライティング、雰囲気、抑制の効いた構図に対するモデルの理解力を確認します。
プロンプト:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
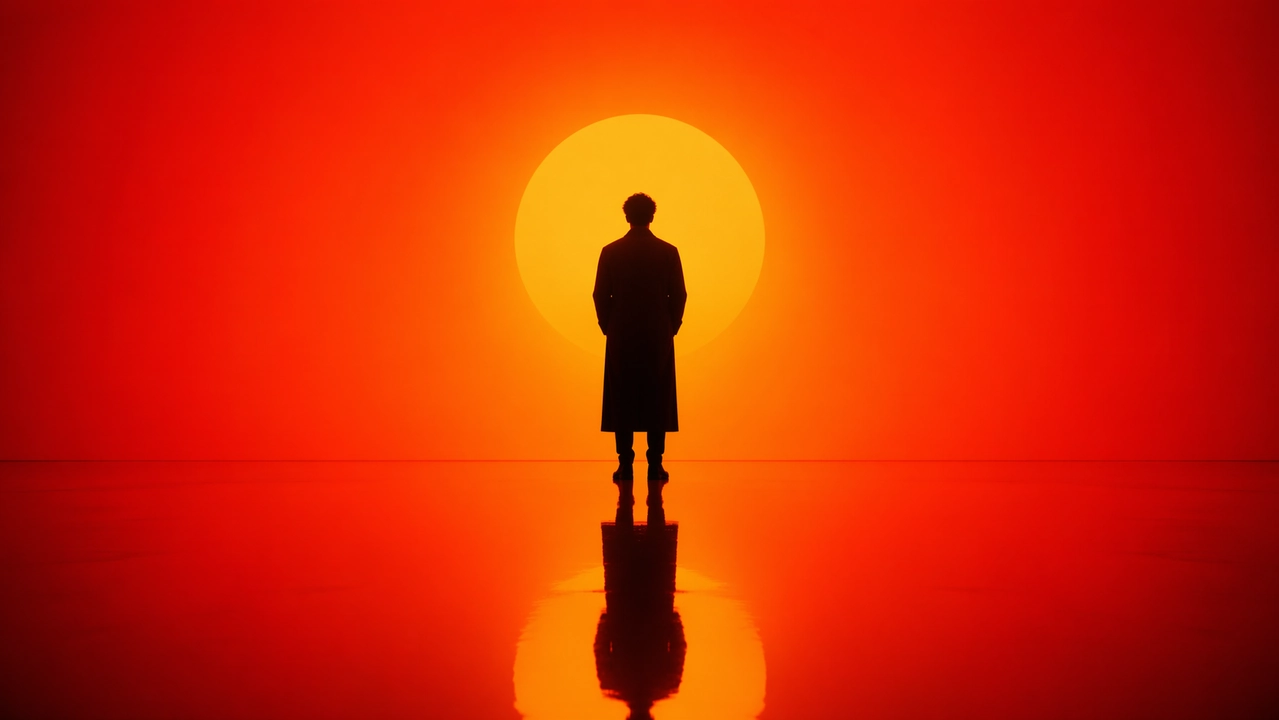
確認ポイント: ハロアーティファクトのないクリーンなシルエットの輪郭、正しいパースペクティブでの正確な床面反射、バンディングのない滑らかなグラデーション、そして硬直したり浮いたりして見えない、実際の重量感が伝わるポーズであること。
シティポスターとイラストデザイン
読み取り可能なタイポグラフィと、密度の高い複数要素の構図を組み合わせた最も過酷なストレステストです。S字カーブに沿って配置された10以上の視覚要素と、レンダリングを無傷で乗り切る必要がある英語テキストが求められます。
プロンプト:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
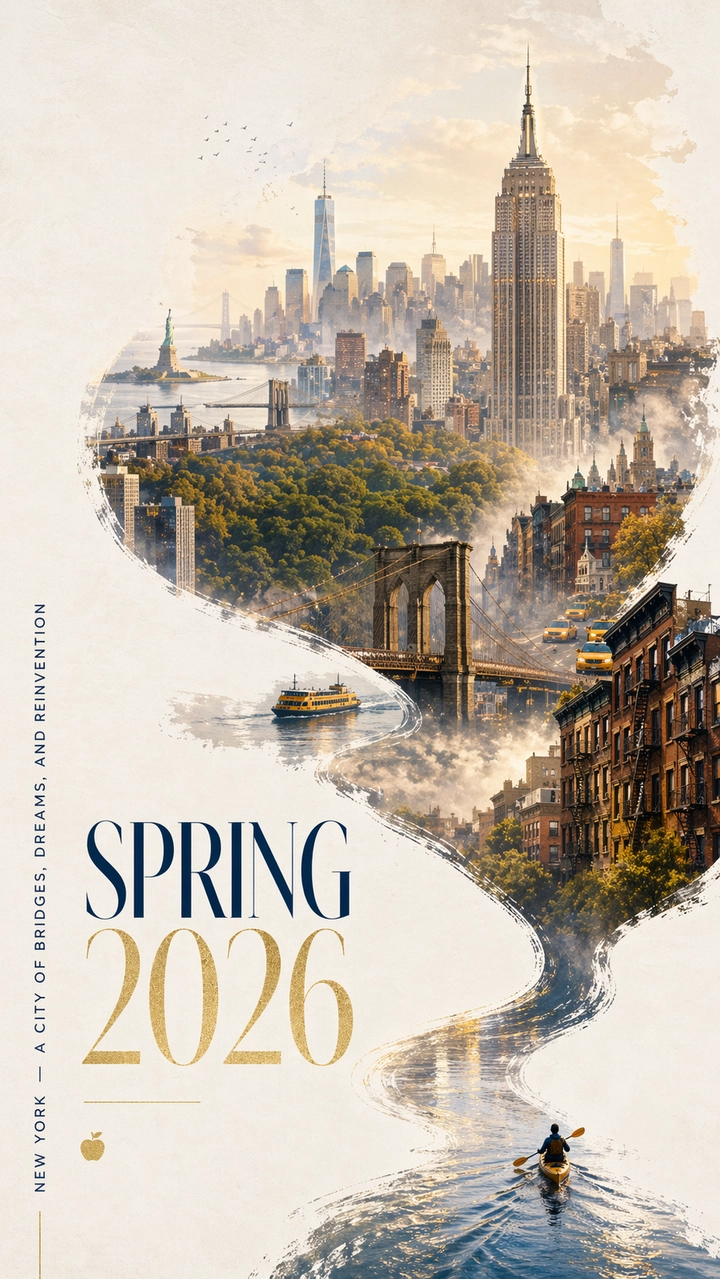
確認ポイント: タイトルとスローガンのすべての文字が読み取り可能で正しく綴られていること、S字カーブがカヤッカーからスカイラインへ自然に流れていること、ランドマークの建物が汎用的なタワーではなく認識可能に描かれていること、そして余白が空虚ではなく意図的に感じられること。
キャラクターデザインとリファレンスシート
ゲーム開発者やコンセプトアーティストは、1回の生成から複数視点の一貫性を必要とします。このテストは、モデルがフロント、サイド、バックの各ビューでキャラクターのデザインを安定して保持できるかどうかを確認します。
プロンプト:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
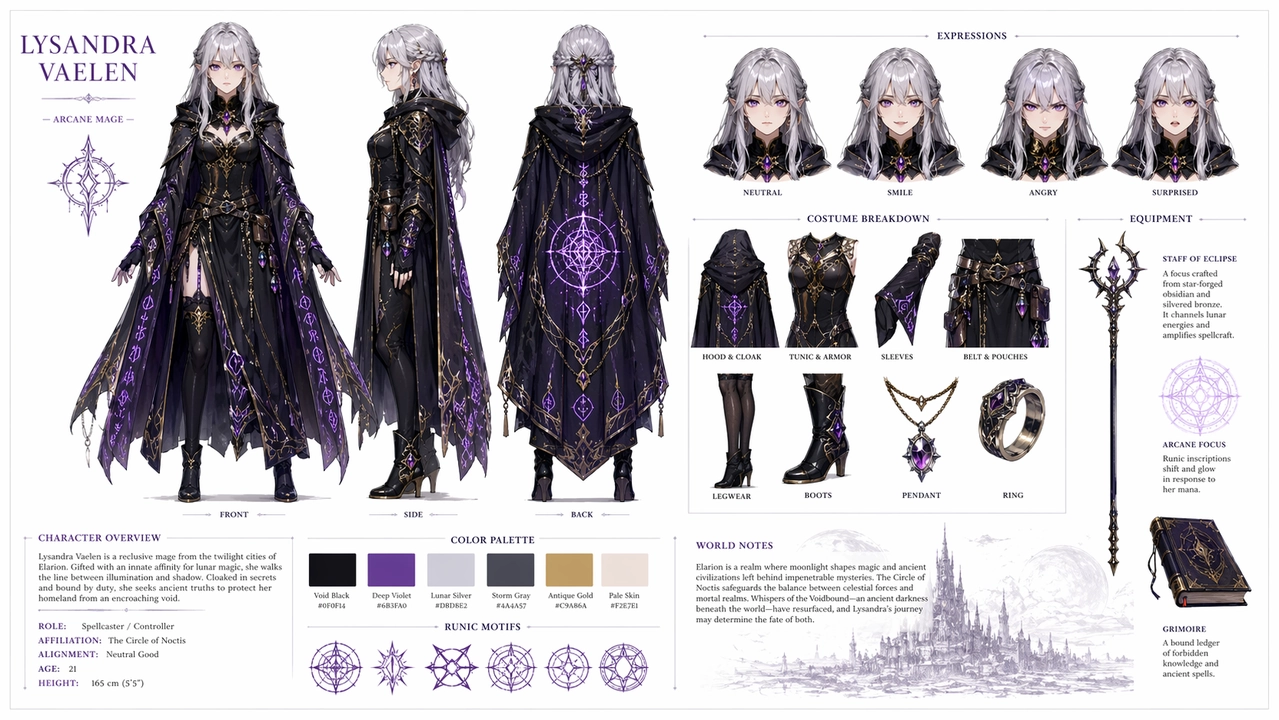
確認ポイント: 顔、髪、衣装は3つのビューすべてで一貫していること、表情バリエーションは顔だけが変化し、ヘアスタイルや服装は変わらないこと、カラーパレットのスウォッチが実際にアート内で使われている色と一致していること、テキストラベルのスペルが正確であること。サイドビューやバックビューがずれる場合は、アイデンティティの目印を繰り返す「preserve」表現を強めて再生成してください。
UIおよびソーシャルメディアモックアップ
このテストは、ピクセル精度のUIレイアウト、多言語テキストレンダリング、クリエイティブなコンセプトの融合という3つを同時に検証します。ソーシャルプラットフォームでも評価されやすいタイプのコンテンツです。
プロンプト:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
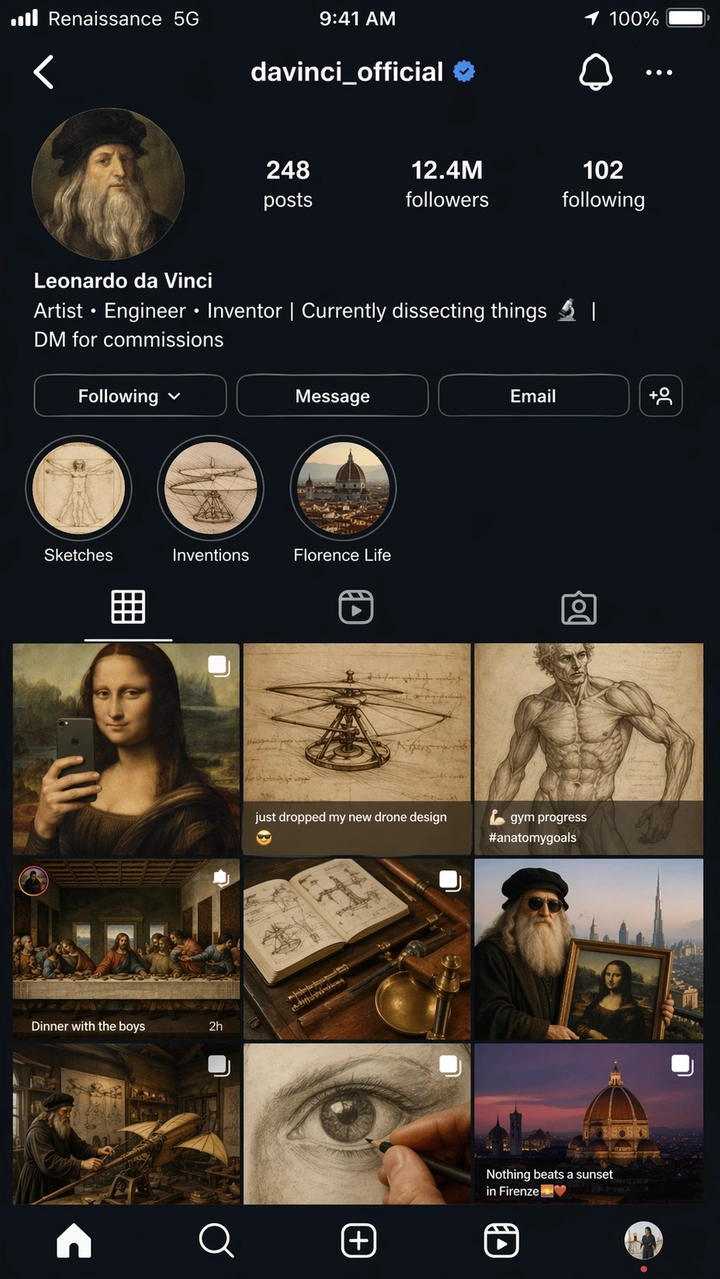
確認ポイント: Instagramの UI要素——グリッドの間隔、プロフィールレイアウト、ストーリーサークル、タブバー——が、スタイライズされた近似ではなく実際のiOSスクリーンショットのように見えること。すべてのテキストが読み取り可能であり、「Renaissance 5G」というキャリア表記は意図的な精度チェックです。UIモックアップの出力は、本番投入可能なUIではなくコンセプトリファレンスとして扱ってください。小さなラベルやアイコンの位置合わせは通常、仕上げの調整が必要です。
クリエイティブ・実験的アート
内蔵されたナラティブのユーモアを持つ短いプロンプトは、モデルが網羅的な指示に頼らずに自らクリエイティブなギャップを埋められるかどうかをテストします。
プロンプト:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
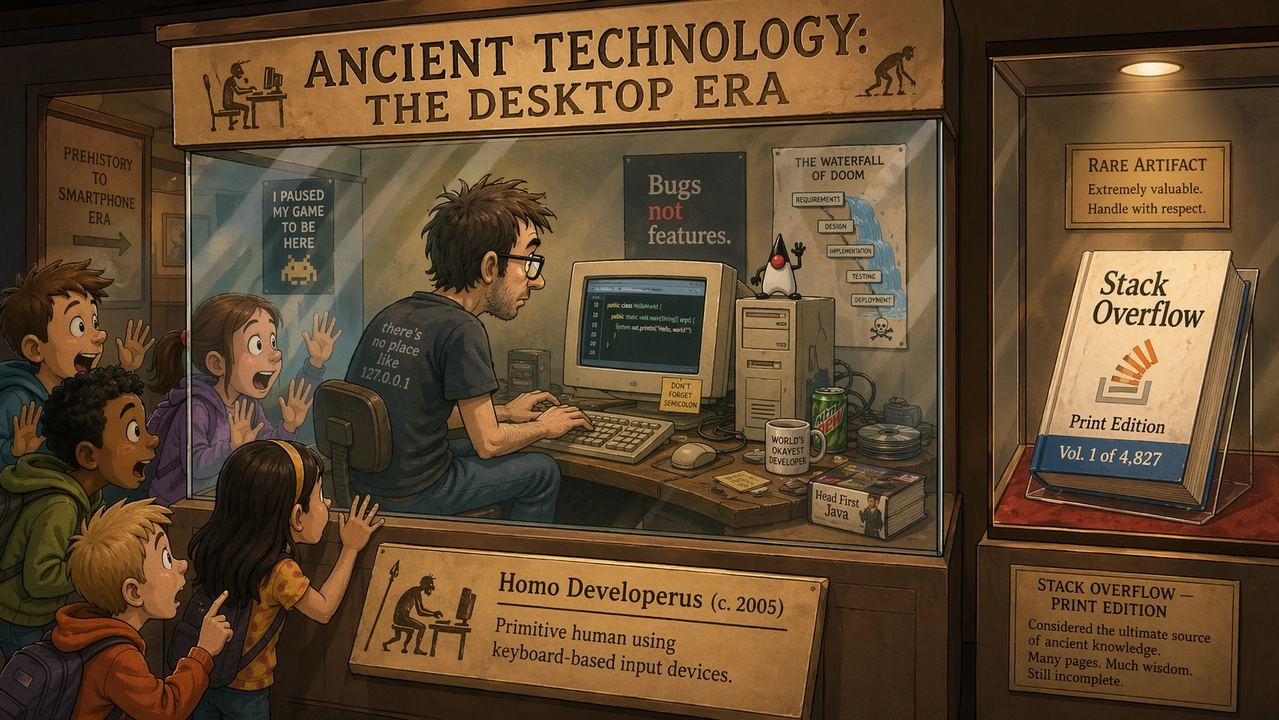
確認ポイント: ユーモアはキャプションのテキストだけでなく、視覚的なディテールを通じて伝わるべきです。プラカードと書籍のタイトルは読み取り可能で正しく綴られている必要があります——これは小さいサイズの複数行テキストにとって本当に難しいテストです。カートゥーンスタイルはシーン全体で統一感があるべきで、一部だけフォトリアリスティックになってはいけません。
ユースケース別テスト結果
最も強い結果は一貫して、スペル、レイアウト、オブジェクトの維持、パネルの順序といった明確な判断基準を持つプロンプトから得られました。雰囲気だけを求める曖昧なプロンプトは、結果のばらつきが大きくなりました。
| ユースケース | うまく機能した点 | まだ確認が必要な点 |
|---|---|---|
| テキストレンダリング | 大きな見出し、短いラベル、ポスタータイトル、シンプルなUIラベルは、正確なコピーを引用符で指定すれば正確に仕上がりました。 | 極小の法的表記、密度の高い段落、装飾的なフォントはまだずれることがあります。コピーは短く保ち、すべての文字を確認してください。 |
| 製品画像 | クリーンな広告レイアウト、キャンペーン用の余白、製品を主役にした構図はうまく仕上がりました。 | 実在のラベル、ロゴ、規制対象の表示は、承認済みアセットからの手動確認や合成が必要です。 |
| UIモックアップ | モバイル画面、ダッシュボード、アプリらしい階層構造は、プロンプトに実際のインターフェース要素を名指しした場合にもっともらしく見えました。 | 出力はコンセプトモックアップとして扱ってください。小さなラベルやアイコンの位置合わせは通常、仕上げが必要です。 |
| キャラクターの一貫性 | キャラクターシート、表情の並び、パレットスウォッチはクリエイティブリファレンスとしてよく機能しました。 | 顔や衣装の細部はビューによってずれることがあります。アイデンティティの目印を繰り返し、必要に応じて再生成してください。 |
| 編集と合成 | 「変更・維持・整合」のパターンは、広範な編集リクエストよりも優れた結果を出しました。 | 選択範囲の境界や透明背景の出力にはまだ品質確認が必要です。 |
GPT Image 2プロンプトでよくある間違い
- 正確なテキストを求めながら、正確なコピーを提示しないこと。 テキストが重要な場合は、それを一字一句書き出し、どこに配置すべきかを指定してください。
- 1つのプロンプトにあらゆる詳細を詰め込みすぎること。 まずコアとなるシーンから始め、一度に1つの変数だけを調整してください。
- 編集時に不変であるべき要素を明記し忘れること。 変更されてはいけないもの——アイデンティティ、背景、ポーズ、ライティング、製品の形状、ラベルのテキスト、カメラアングル——を明示してください。
- 機能的な仕事に装飾的な品質を表す言葉に頼ること。 「Beautiful」と書いてもラベルが読みやすくなるわけではありません。「sharp label text」や「readable from a distance」のような言葉を使ってください。
- アスペクト比を省略すること。 優れた正方形の画像でも、縦型広告や動画サムネイルとしては失敗することがあります。
- ロゴを通常のテキストのように扱うこと。 GPT Image 2はロゴのコンセプトをデザインできますが、正確なブランドマークは直接プロンプトで指示するのではなく、承認済みアセットから合成するべきです。
GPT Image 2 APIと価格に関する注意点
OpenAIのAPI価格ページでは、GPT Image 2は一律の画像単位料金ではなく、トークン単位で掲載されています。
| 項目 | 掲載価格 |
|---|---|
| 画像入力 | $8.00 / 100万トークン |
| キャッシュされた画像入力 | $2.00 / 100万トークン |
| 画像出力 | $30.00 / 100万トークン |
| テキスト入力 | $5.00 / 100万トークン |
| キャッシュされたテキスト入力 | $1.25 / 100万トークン |
実際の画像あたりのコストは、プロンプトの長さ、参照画像、出力サイズ、キャッシュ、品質設定によって異なります。ChatGPTのプランクォータはAPI課金とは別のトラックです。Plusのサブスクリプションがそのままapi クレジットに変換されるわけではないため、両方を利用する場合は個別に予算を組んでください。
大量のワークフローでは、重要な指標は1回の試行あたりの掲載価格ではなく、再生成を経て「採用された」アセットあたりのコストです。スペルやレイアウトを正しくするために3回の再生成が必要なら、単価が安い生成でも実際には安くありません。
| ワークフロー | 実践的なプロンプトのアドバイス |
|---|---|
| テキストの多いポスターや図解 | 1枚あたりの単語数を減らし、正確なコピーを引用符で指定し、階層構造を明示的に指定する。 |
| 製品写真 | 製品の形状、ラベル、色、素材、カメラアングルを固定し、編集のたびに「維持リスト」を繰り返す。 |
| UIモックアップ | 画面をコンセプトアートとしてではなく、出荷済みのインターフェース——ナビゲーション、カード、ボタン、状態——として説明する。 |
| 複数参照画像による編集 | 各入力画像に役割ラベルを付ける:被写体、スタイル、背景、衣装、素材のリファレンスなど。 |
| バッチ生成 | 試行あたりのコストではなく、採用された画像あたりのコストを追跡する。 |
同一のプロンプトでGPT Image 2がフォトリアリズム優先の代替モデルとどう比較されるか気になる方は、GPT Image 2 vs. Nano Banana 2の比較記事で、APIと各プラットフォームの価格を詳細に比較した6回のヘッドツーヘッドラウンドを紹介しています。
画像から動画へ:PixVerseでクリエイティブワークフローを完結させる
優れた画像を生成することは1つのステップに過ぎません。それを動きに変えるところで、多くのワークフローが行き詰まります。GPT Image 2でポートレートや製品ポスターを仕上げた後、別のツールを開いてファイルを再アップロードし、動画モデルが丁寧に構成した画像を歪めないことを祈る必要があります。この受け渡しの摩擦こそ、PixVerseがなくそうとしているものです。
GPT Image 2はPixVerseで利用可能
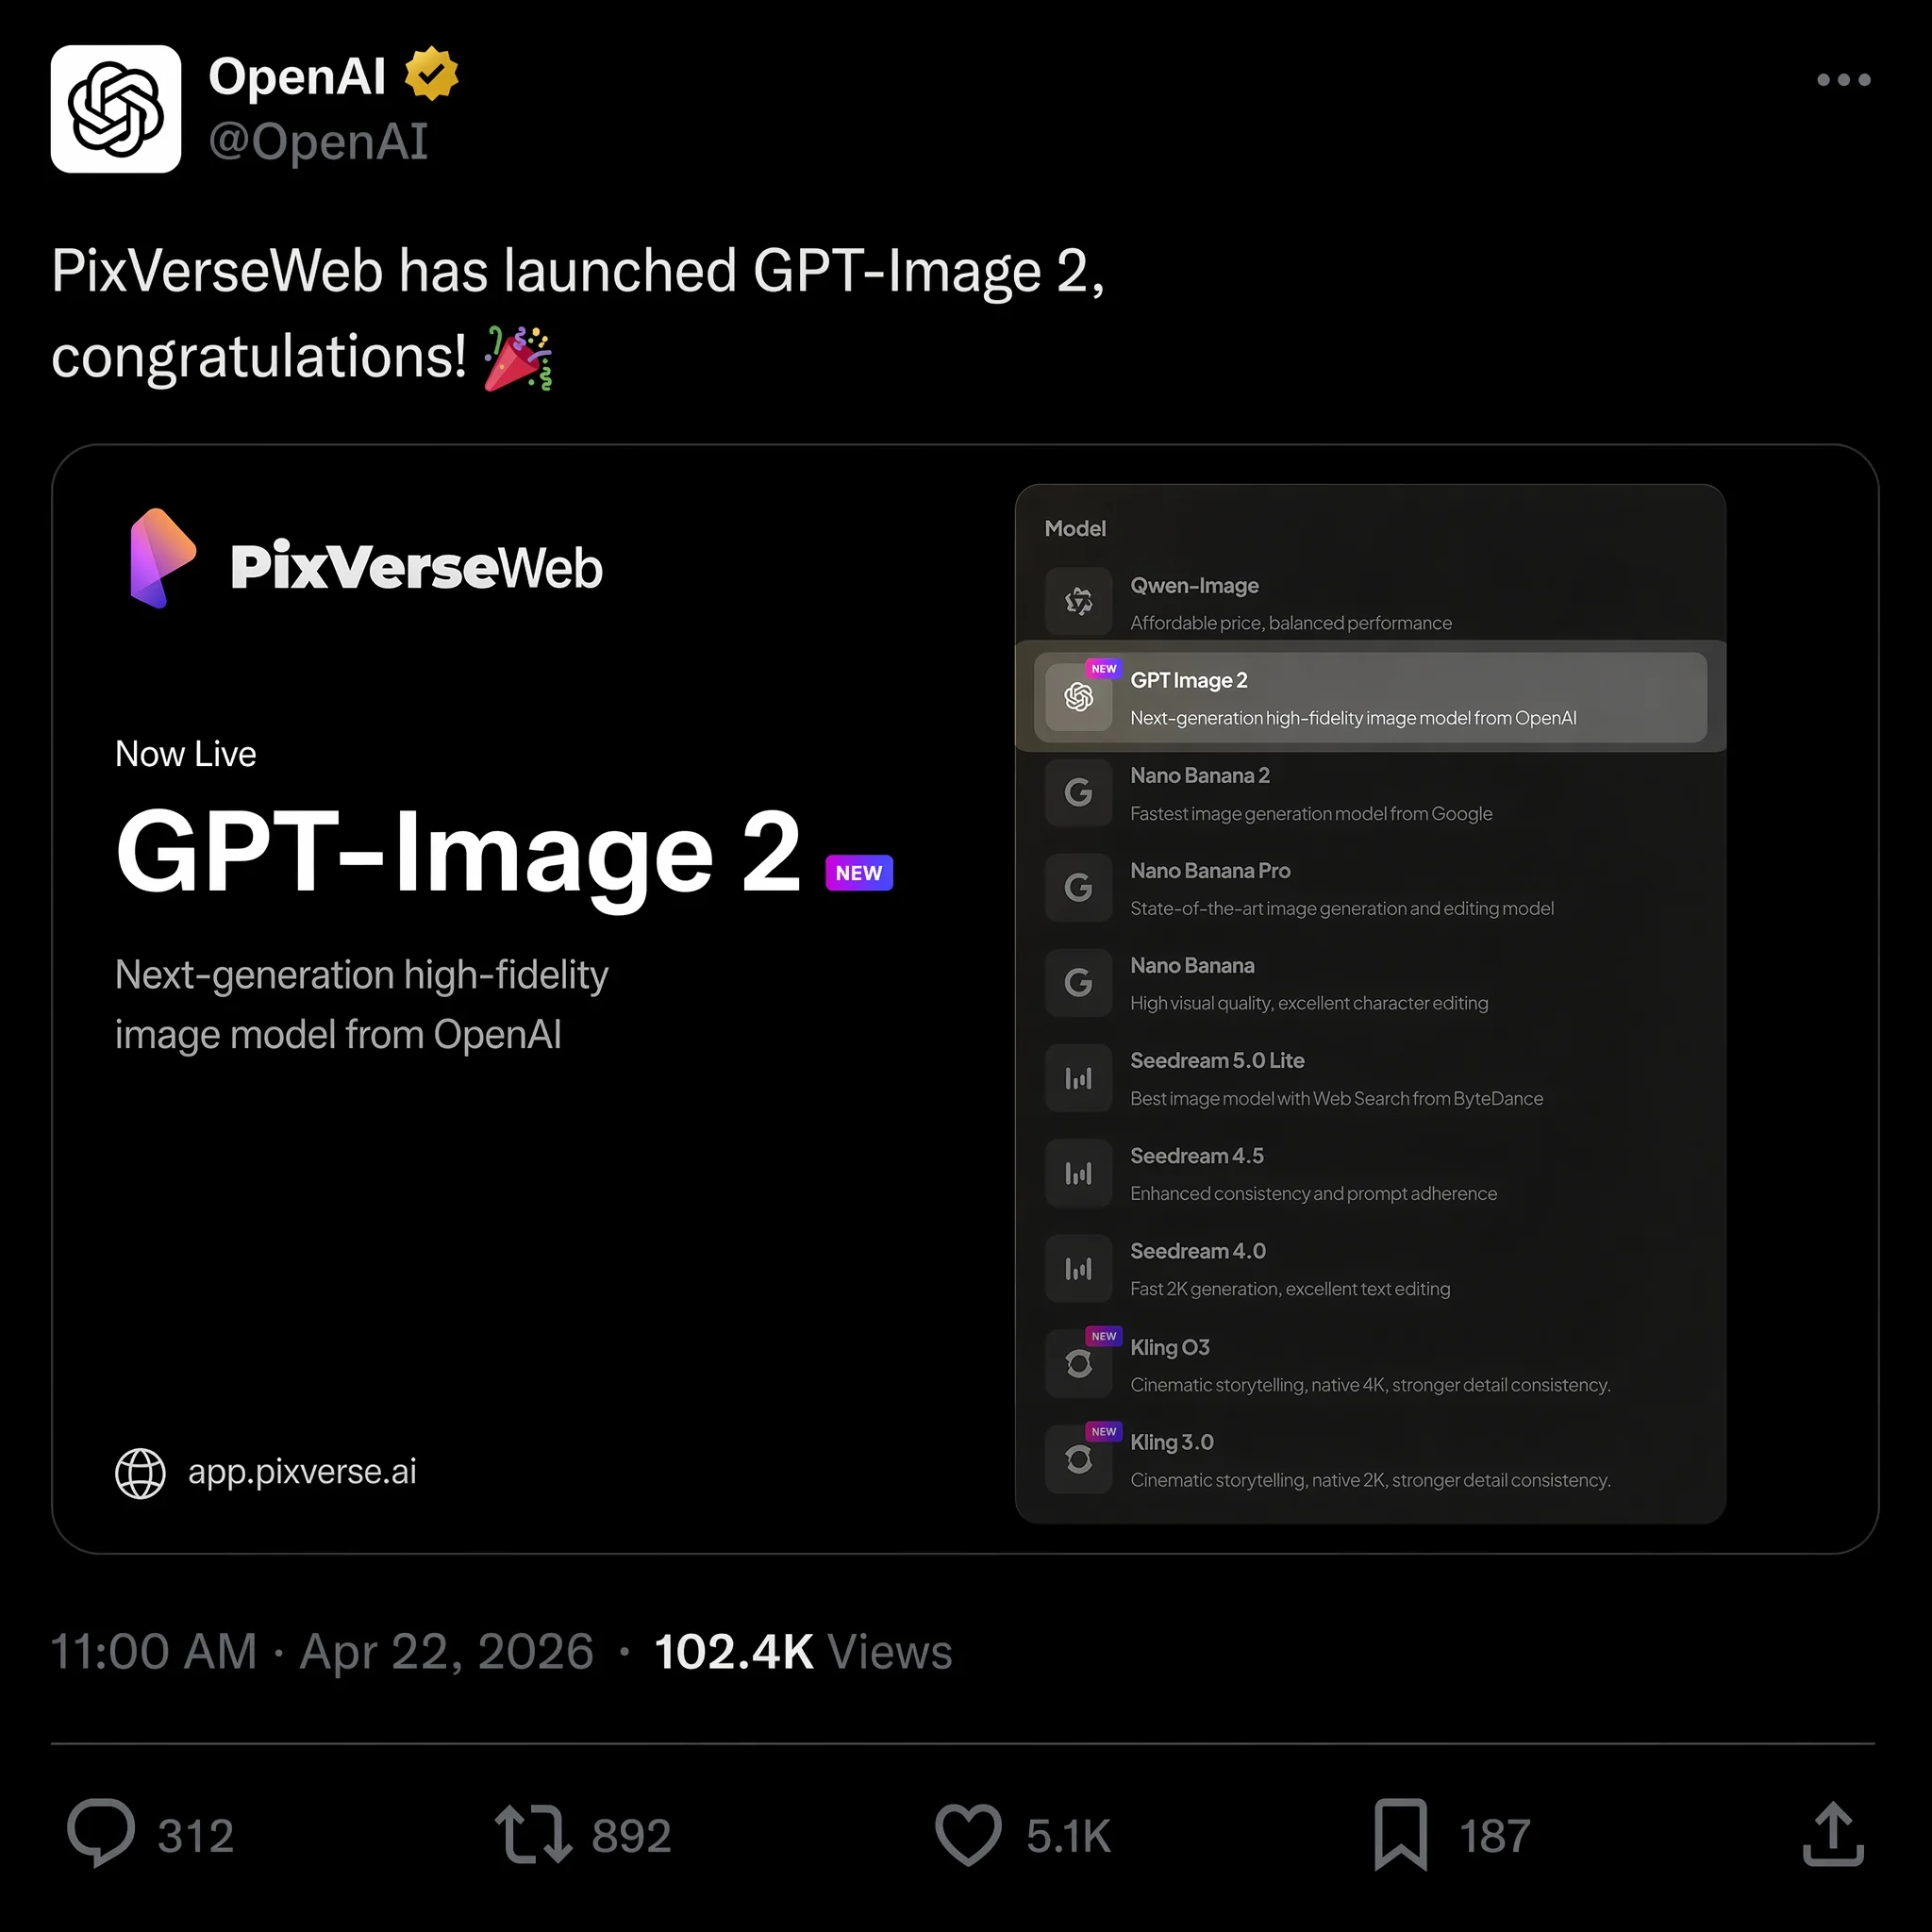
2026年4月22日、PixVerseはGPT Image 2をテキストから画像へのオプションとして追加し、Nano Banana 2、Seedream、HappyHorse 1.0とともにモデルラインナップに加わりました。同じワークスペース内でGPT Image 2を使って画像を生成し、動画に変換できます。ダウンロード、再アップロード、タブの切り替えは一切必要ありません。
これが重要なのには具体的な理由があります。画像が同じプラットフォーム上で画像から動画へのパイプラインに直接投入されると、動画モデルはフル解像度のソースファイルとそのメタデータを直接扱います。圧縮やフォーマット変換による品質の低下がなく、その結果、最終的なクリップではよりクリーンな動きと少ないアーティファクトが得られます。
静止画が動画になることを想定している場合は、最初からモーションへの準備をプロンプトに盛り込んでください。前景・中景・背景の奥行き、クリアな被写体のシルエット、そしてもっともらしく動きうる物理的要素(ほこり、湯気、布、揺れる光源など)を求めます。アニメーション化する前に、静止画を完成したデザインファイルとして確認してください。スペル、製品のジオメトリ、UIの位置合わせを先にチェックしましょう。動画モデルは、誤字のある見出しや歪んだラベルを自動的に修正してはくれません。そのうえで、画像全体のブリーフを繰り返すのではなく、何が動くべきで何を固定すべきかだけを記述した、別の短いモーションプロンプトを書いてください。
クリエイターがオールインワンプラットフォームに移行している理由
2026年3月以前にOpenAIのSoraを動画生成に使っていた方なら、1つのツールにワークフローを依存させるリスクをすでにご存知でしょう。OpenAIは3月24日にSoraのアプリとAPIを終了し、持続不可能なコストとロボティクスへの戦略転換を理由に挙げました。数千人のクリエイターが一夜にして動画パイプラインを失いました。詳しい経緯とそのギャップを埋めたツールについては、Sora代替ツールガイドをご覧ください。
PixVerseは異なるアプローチを取っています。1つのモデルに縛るのではなく、クリエイティブパイプライン全体にわたって複数のモデルへのアクセスを提供します。
- テキストから画像:GPT Image 2、Nano Banana 2、Seedreamなど — 用途に合ったモデルを選択可能
- 画像から動画:生成した画像をキャラクター一貫性とカメラコントロールを備えた動画に変換
- テキストから動画:PixVerse V6やシネマティックなC1モデルを使って、書き起こしたプロンプトから直接クリップを生成
- ネイティブ音声生成:効果音やセリフを動画に自動的に同期
実用的なメリットは、書き起こしたコンセプトから、同期された音声付きの完成動画まで、1つのワークスペースを離れることなく完結できる点です。これにより、プロジェクトごとに発生していた何時間ものファイル管理が不要になります。コマンドラインから生成をスクリプト化したい場合は、PixVerse CLIガイドで画像と動画の両方の生成を自動化する方法を解説しています。
PixVerseは新規ユーザーに毎日30〜60の無料クレジットも提供しているため、有料プランに登録する前に、画像生成から動画出力までのフルパイプラインをテストできます。
よくある質問
GPT Image 2は無料で使えますか?
無料のChatGPTユーザーは、GPT Image 2で1日あたりおよそ2枚の画像を生成できます。ChatGPT Plusの加入者($20/月)は、より高速な処理で無制限に生成できます。APIアクセスは画像入力、画像出力、テキスト入力にわたってトークンごとに課金されるため、コストは一律の画像単位料金ではなく、プロンプトの長さと出力サイズに応じて変動します。
GPT Image 2はどの解像度に対応していますか?
GPT Image 2はネイティブ2K解像度で画像を生成し、APIを通じてオプションで4Kにアップスケールできます。アスペクト比は3:1から1:3までの範囲に対応しているため、正方形、縦型、超ワイドフォーマットをすべて直接生成できます。
GPT Image 2は画像内のテキストを正確にレンダリングできますか?
はい——これはGPT Image 2の最も強力な機能の1つです。私たちのテストでは、英語、中国語、日本語、韓国語、アラビア語のテキスト精度が、初回の生成で95%を超えました。複数行の見出し、ポスタータイトル、UIテキストラベルはすべて安定して処理されますが、低解像度での非常に小さなテキストはまだ時折うまくいかないことがあります。
GPT Image 2はMidjourneyやNano Banana 2と比べてどうですか?
Midjourney V8は、より強力なアーティスティックスタイルの制御と、美的な洗練のためのより確立されたコミュニティを持っています。Nano Banana 2は、フォトリアリズム、シネマティックなライティング、高速な反復生成において優位性があります。GPT Image 2は、テキストレンダリング、構造化されたレイアウト、自然言語による編集で優位に立っています。テキストを含むポスターデザインやマーケティング素材では現在GPT Image 2が優勢ですが、純粋なアーティスティックな探求やフォトリアルなヒーローショットについては、他の2つを直接比較する価値があります——Nano Banana 2とのヘッドツーヘッドテストをご覧ください。
サービス終了後、動画生成におけるSoraの最良の代替ツールは何ですか?
2026年3月にOpenAIがSoraを終了した後、主な代替ツールとしては、キャラクターの一貫性を保ったマルチショット動画向けのPixVerse V6、シネマティックなカメラ制御向けのRunway Gen-4、アクションシーケンス向けのKling v3.0が挙げられます。PixVerseは、テキストから画像、画像から動画、テキストから動画をネイティブ音声とともに統合した唯一のプラットフォームであり、すべて毎日の無料クレジットで利用できます。詳細な比較はSora代替ツールガイドをご覧ください。
GPT Image 2の出力を動画に変換できますか?
はい。PixVerseでGPT Image 2が利用できるため、アプリ内で画像を生成し、同じワークスペース内の画像から動画へのパイプラインを使って動画に変換できます。ファイルの受け渡しは一切不要です。他の場所で作成したGPT Image 2のファイルをアップロードして、同じパイプラインに通すこともできます。