GPT Image 2 : test complet et guide de prompts en 2026
OpenAI a lancé GPT Image 2 le 21 avril 2026 — le successeur de GPT Image 1.5 et le modèle qui alimente désormais la génération d’images dans ChatGPT. Nous l’avons testé pendant la semaine de lancement, puis à nouveau fin juin avec un éventail plus large de prompts, le guide de prompting officiel d’OpenAI et sa grille tarifaire API publiée, pour voir comment le modèle tient la route une fois l’engouement initial retombé.
Points clés :
- GPT Image 2 génère des images en résolution native 2K avec un upscaling 4K optionnel, et la précision du rendu de texte dépasse 95 % sur les scripts latin, chinois, japonais, coréen et arabe.
- Le modèle se comporte davantage comme un assistant de design que comme un générateur de photos : il excelle sur les tâches ayant un critère de réussite clair — texte exact, mise en page fixe, structure de panneau répétable — et devient moins prévisible sur les prompts vagues du type « rends ça beau ».
- La reproduction de logos de marques, les mentions légales en petits caractères et les polices propriétaires restent des points faibles nécessitant une vérification manuelle.
- L’API d’OpenAI facture GPT Image 2 au jeton, selon l’entrée image, l’entrée image en cache, la sortie image, l’entrée texte et l’entrée texte en cache — un modèle tarifaire différent des paliers par image utilisés par certains concurrents.
- PixVerse intègre GPT Image 2 dans sa gamme texte-vers-image aux côtés de Nano Banana 2 et Seedream, ce qui permet d’envoyer une image générée directement dans un pipeline image-vers-vidéo sans quitter l’espace de travail.
Qu’est-ce que GPT Image 2 ? Fonctionnalités clés et limites
GPT Image 2 est le modèle d’image de deuxième génération d’OpenAI, qui remplace GPT Image 1.5 dans ChatGPT et via l’API. Il concurrence Midjourney, DALL-E 3 et Stable Diffusion, mais construit son identité autour de deux points : un texte précis à l’intérieur des images, et une couche de raisonnement qui interprète l’intention d’un prompt plutôt que de simplement associer ses mots-clés.
Fonctionnalités principales en un coup d’œil
| Fonctionnalité | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Résolution native | 2K (avec upscale 4K) | 1K | 2K (avec le flag —hd) |
| Précision du rendu de texte | 95 %+ multilingue | ~70 % (latin uniquement) | ~80 % (latin uniquement) |
| Intégration du raisonnement | Oui — interprète des instructions imbriquées | Non | Non |
| Plage de ratios | 3:1 à 1:3 | 1:1, 16:9 | 1:1 à 3:2 |
| Cohérence des personnages | Au pixel près sur des images séquentielles | Limitée | Modérée (flag —cref) |
| Édition en langage naturel | Oui — modifie des zones par description | Non | Non |
| Tarification | À l’usage via l’API ; paliers de plan ChatGPT | Identique | Abonnement 10–30 $/mois |
Le rendu de texte est la fonctionnalité qui attire le plus l’attention, et à juste titre. Les anciens modèles d’image traitaient le texte comme une texture — demandez un titre d’affiche et vous obteniez du bruit en forme de lettres. GPT Image 2 gère les titres anglais sur plusieurs lignes, les caractères chinois et les mises en page multilingues avec une réelle constance ; lors de nos tests, environ 19 générations sur 20 sont revenues parfaitement lisibles dès le premier essai.
L’intégration du raisonnement signifie que le modèle fait plus que simplement associer votre formulation. Demandez-lui de « générer une infographie montrant les activités adaptées à la météo de demain à San Francisco », et il ira chercher les prévisions, choisira des activités pertinentes et construira une mise en page autour de ces données — une étape au-delà de la façon dont Midjourney ou Stable Diffusion traitent un prompt.
L’édition en langage naturel permet de réviser une image en décrivant le changement plutôt qu’en la masquant manuellement. « Déplace la tasse de café vers la gauche de la table » ou « change le ciel en coucher de soleil » s’appliquent tous deux comme des modifications ciblées, sans régénérer toute la scène.
Ce que disent les utilisateurs
Les retours depuis le lancement sont globalement positifs, avec un ensemble constant de reproches. Les tests de portraits qui circulent sur X et Reddit se rapprochent de la photographie de studio, et les designers d’affiches qui testent des mises en page longues — flyers, menus, enseignes — rapportent que la précision du texte tient enfin la route en usage réel. Plusieurs designers ont noté qu’ils pouvaient éviter une passe sous Photoshop pour des visuels marketing basiques, car le sens de la composition du modèle est assez solide pour prendre les décisions de mise en page seul.
Les éloges les plus marqués concernent le respect du prompt : demandez 15 éléments précis dans une scène et GPT Image 2 a tendance à tous les inclure, là où les anciens modèles commençaient à en oublier au fur et à mesure que le prompt s’allongeait.
Côté négatif, la fidélité aux marques reste inconstante. Un test pratique largement partagé par ZDNet a montré le modèle échouer à reproduire fidèlement le logo ZDNET, et d’autres utilisateurs ont signalé la même chose avec des marques spécifiques. Le modèle comprend ce qu’est un logo conceptuellement, mais il ne reproduit pas de manière fiable les formes vectorielles exactes ou les polices propriétaires.
Limites connues
- La reproduction de logos de marques n’est pas fiable — incrustez les logos exacts dans Photoshop ou Figma après la génération plutôt que de les demander directement.
- La vitesse de génération est en retrait par rapport aux modèles plus légers comme FLUX ou Nano Banana 2, avec 30 à 60 secondes en général sur ChatGPT Plus, contre moins de 10 secondes ailleurs.
- Les limites du niveau gratuit sont strictes — environ deux images par jour pour les utilisateurs gratuits de ChatGPT. Les abonnés Plus obtiennent des générations illimitées sur ChatGPT, mais les coûts API évoluent avec le volume.
- Le contrôle stylistique est plus grossier que celui de Midjourney. Vous ne pouvez pas régler le type de pellicule, le type d’objectif ou le grain avec la même précision, et le biais esthétique propre au modèle demande un travail de prompt délibéré pour être contourné.
- La politique de contenu est plus stricte que les alternatives open source, donc certains prompts qui fonctionnent bien sur Stable Diffusion ou des modèles locaux seront refusés ici.
Aucun de ces points n’exclut un usage en production, mais ils méritent d’être connus avant de construire un pipeline reposant exclusivement sur un seul modèle.
Comment rédiger des prompts GPT Image 2 qui fonctionnent vraiment
Le constat le plus net de notre second round de tests : les meilleurs prompts GPT Image 2 ne se contentent pas de décrire une image — ils décrivent le travail que l’image doit accomplir. Un prompt de publicité sociale doit se lire différemment d’une découpe produit, d’une infographie, d’un écran d’interface ou d’une première image destinée à devenir une vidéo.
Un schéma fiable pour structurer le brief :
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Nommez le travail avant le style
Commencez par le type de sortie — affiche, publicité produit, écran d’application, fiche de personnage, diagramme, retouche ou première image de vidéo — pour que le modèle sache selon quel critère il est jugé.
Faible : A cool futuristic speaker, cinematic, high detail.
Meilleur : Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
La seconde version indique au modèle qu’il est jugé sur la mise en page et l’utilisabilité, pas seulement sur l’esthétique.
Traitez le texte comme un élément verrouillé
Placez tout texte requis entre guillemets et précisez exactement comment il doit s’afficher — ne demandez pas « un slogan » à moins de vouloir que le modèle invente les mots lui-même.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Pour un texte plus long, découpez chaque ligne explicitement dans le prompt. Si un mot revient mal orthographié, régénérez avec un texte plus court, une taille de police plus grande et une consigne « texte exact uniquement » plus stricte.
Donnez au modèle une caméra et une mise en page
Précisez directement la distance de caméra, l’angle, le placement du sujet, l’espace négatif et le ratio d’aspect — GPT Image 2 suit bien les indications de composition, mais uniquement lorsqu’elles sont explicites.
- Gros plan pour la texture d’un produit, les mains, les visages, les matériaux, les étiquettes.
- Plan large pour les environnements, les scènes narratives, les affiches de ville, les images prêtes pour la vidéo.
- Vue de dessus pour la nourriture, les scènes de bureau, les flat-lays, les kits d’emballage.
- Tiers gauche / tiers droit pour les mises en page publicitaires équilibrant texte et produit.
- Grille nette pour les maquettes UI, les fiches de personnages, les diagrammes, les infographies.
Rédigez les retouches en trois phrases
Les prompts de retouche les plus efficaces séparent le changement de ce qui doit rester intact, et du réalisme physique qui relie les deux :
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Cette structure « changer, préserver, ajuster » surpasse systématiquement une demande vague du type « rends ça plus beau ».
Ajoutez une indication de mouvement si l’image doit devenir une vidéo
Si une image est susceptible d’alimenter ensuite un pipeline image-vers-vidéo sur PixVerse, demandez dès le départ de la profondeur et une disposition prête pour le mouvement : premier plan, plan intermédiaire, arrière-plan, une silhouette de sujet nette, et un élément visible susceptible de bouger — poussière, tissu, cheveux, pluie, reflet ou un mouvement de caméra.
Au lieu de : An astronaut in a desert.
Utilisez : A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Comment nous avons testé GPT Image 2
Sur les deux rounds de tests, nous avons soumis le modèle à des portraits, des affiches riches en texte, des compositions de style produit, des fiches de personnages, des maquettes UI et des scènes narratives expérimentales. L’objectif n’était pas un score de benchmark — c’était de savoir si un designer, un marketeur ou un créateur pouvait livrer le résultat avec des retouches légères plutôt que de reconstruire l’asset depuis zéro.
| Zone de test | Ce que nous avons vérifié |
|---|---|
| Portraits et plans cinématiques | Contrôle de l’éclairage, texture de peau, reflets, ambiance, cohérence de scène |
| Mises en page d’affiches et typographie | Orthographe des titres, texte multi-lignes, hiérarchie, espace négatif, finition proche d’une marque |
| Fiches de personnages et de concept | Cohérence multi-vues, détail des costumes, cohérence de palette, exactitude des étiquettes |
| Maquettes UI et sociales | Réalisme de la mise en page, petit texte, espacement des icônes, grilles de fil d’actualité, crédibilité de capture d’écran |
| Prompts expérimentaux | Humour, raisonnement narratif, placement des objets, précision des petites légendes |
Le schéma s’est confirmé sur les deux rounds : GPT Image 2 récompense un brief précis plus qu’une chaîne de mots-clés. Quand un prompt nomme le travail et définit la réussite — texte exact, mise en page fixe, structure de panneau répétable — le modèle a tendance à préserver la structure. Quand un prompt ne demande qu’une ambiance vague, le résultat peut quand même paraître soigné, mais il est plus difficile à réutiliser sans retouches.
Cas d’utilisation de GPT Image 2 avec exemples de prompts
Nous avons soumis à rude épreuve cinq capacités distinctes à travers ces scénarios : contrôle de l’éclairage, typographie de texte exact, composition multi-éléments, cohérence des personnages et mise en page UI. Chaque prompt ci-dessous est prêt à être copié et adapté.
Portrait photographique cinématique
Ce test vérifie la compréhension qu’a le modèle de l’éclairage, de l’atmosphère et d’une composition sobre — les fondamentaux qui séparent une image digne d’un portfolio d’un rendu IA générique.
Prompt :
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
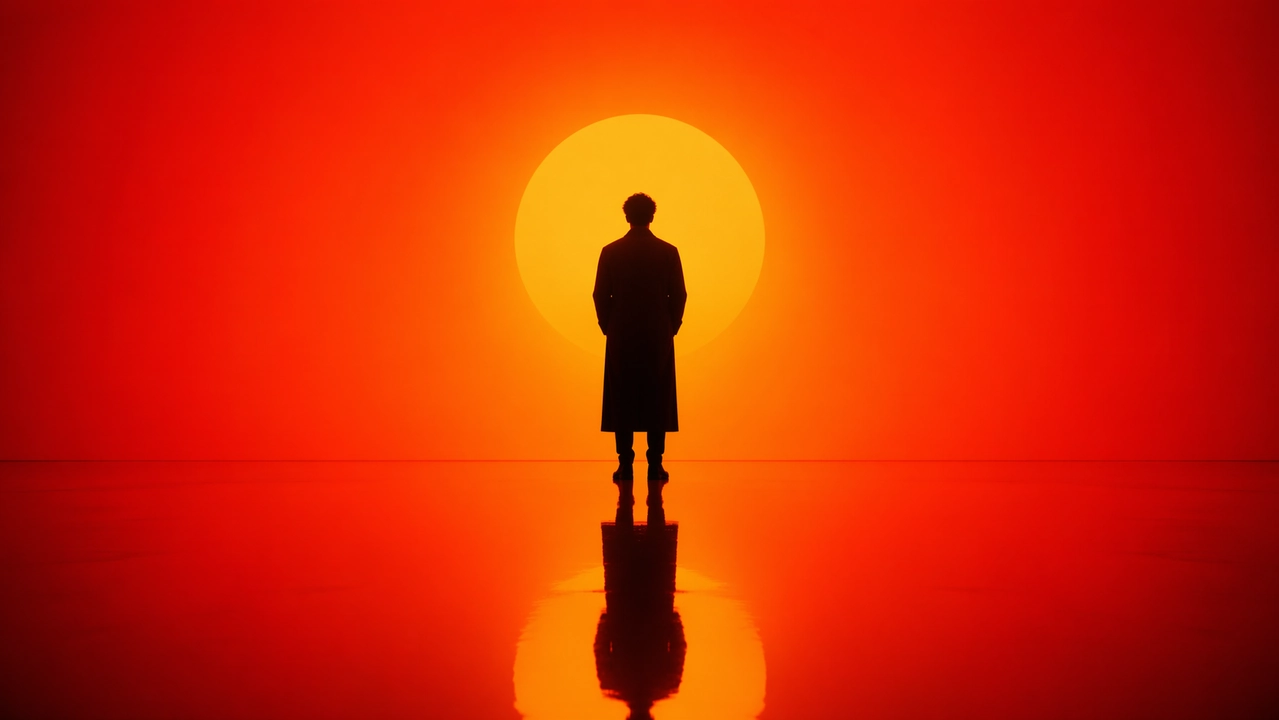
Ce qu’il faut observer : des contours de silhouette nets sans artefacts de halo, un reflet au sol précis avec une perspective correcte, un dégradé lisse (sans bandes visibles), et une pose qui porte un vrai poids plutôt que de paraître rigide ou flottante.
Affiche de ville et design d’illustration
Le test de résistance le plus exigeant pour une typographie lisible associée à une composition dense et multi-éléments — plus de dix éléments visuels distincts disposés le long d’une courbe en S, avec un texte anglais qui doit survivre intact au rendu.
Prompt :
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
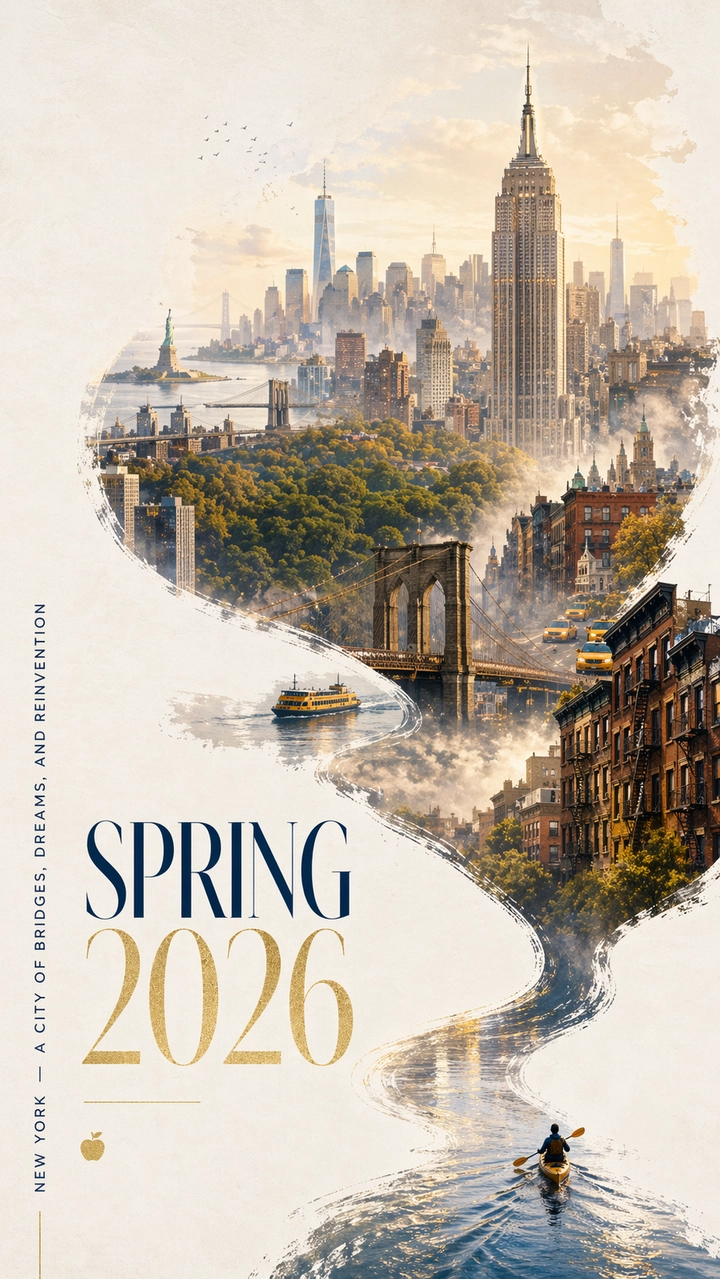
Ce qu’il faut observer : chaque lettre du titre et du slogan doit être lisible et correctement orthographiée, la courbe en S doit s’écouler naturellement du kayakiste vers la skyline, les bâtiments emblématiques doivent se lire comme reconnaissables plutôt que comme des tours génériques, et l’espace négatif doit paraître intentionnel plutôt que vide.
Design de personnage et fiche de référence
Les développeurs de jeux et les concept artists ont besoin d’une cohérence multi-vues à partir d’une seule génération. Ce test vérifie si le modèle peut maintenir stable le design d’un personnage entre les vues de face, de profil et de dos.
Prompt :
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
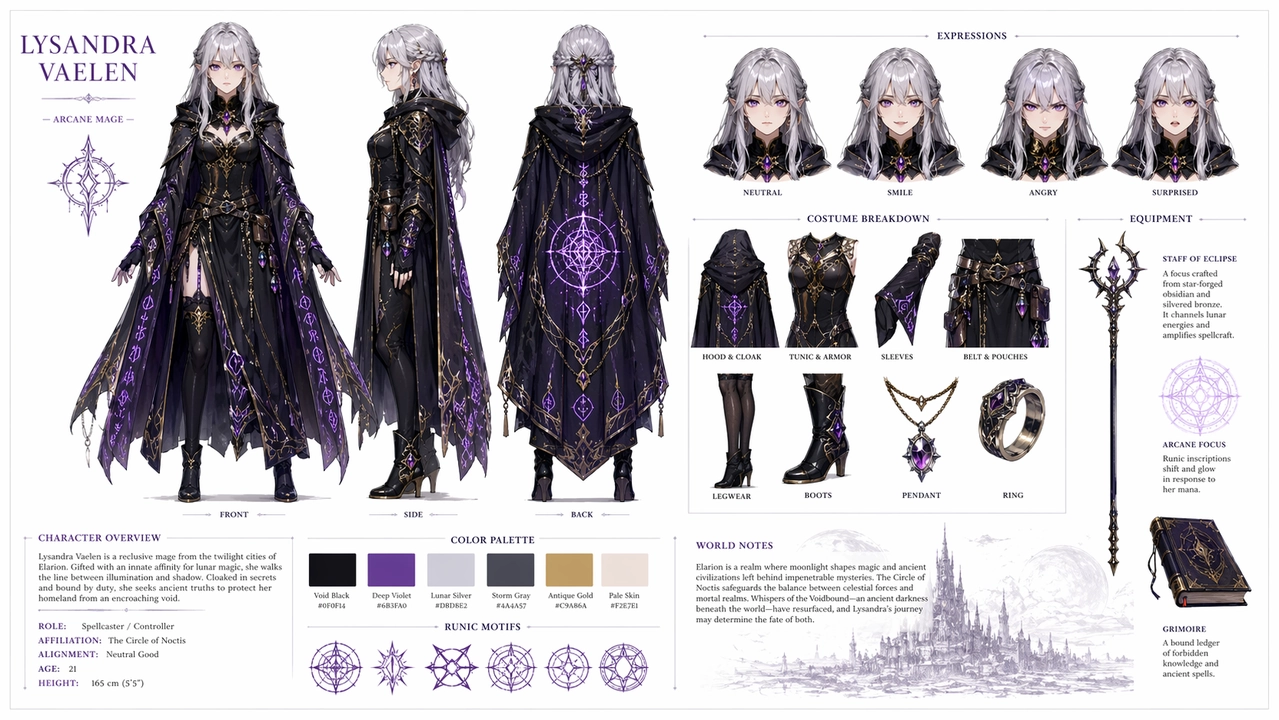
Ce qu’il faut observer : le visage, la coiffure et la tenue doivent rester cohérents sur les trois vues ; les variations d’expression ne doivent modifier que le visage, pas la coiffure ni les vêtements ; la palette de couleurs doit réellement correspondre aux couleurs utilisées dans l’illustration ; et les étiquettes textuelles doivent être correctement orthographiées. Si une vue de profil ou de dos dérive, régénérez avec un langage de « préservation » plus insistant en répétant les ancrages d’identité.
Maquette UI et réseaux sociaux
Ce test sollicite trois éléments à la fois : une mise en page UI au pixel près, un rendu de texte multilingue et une fusion de concepts créatifs — le genre de contenu qui tend aussi à bien performer sur les réseaux sociaux.
Prompt :
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
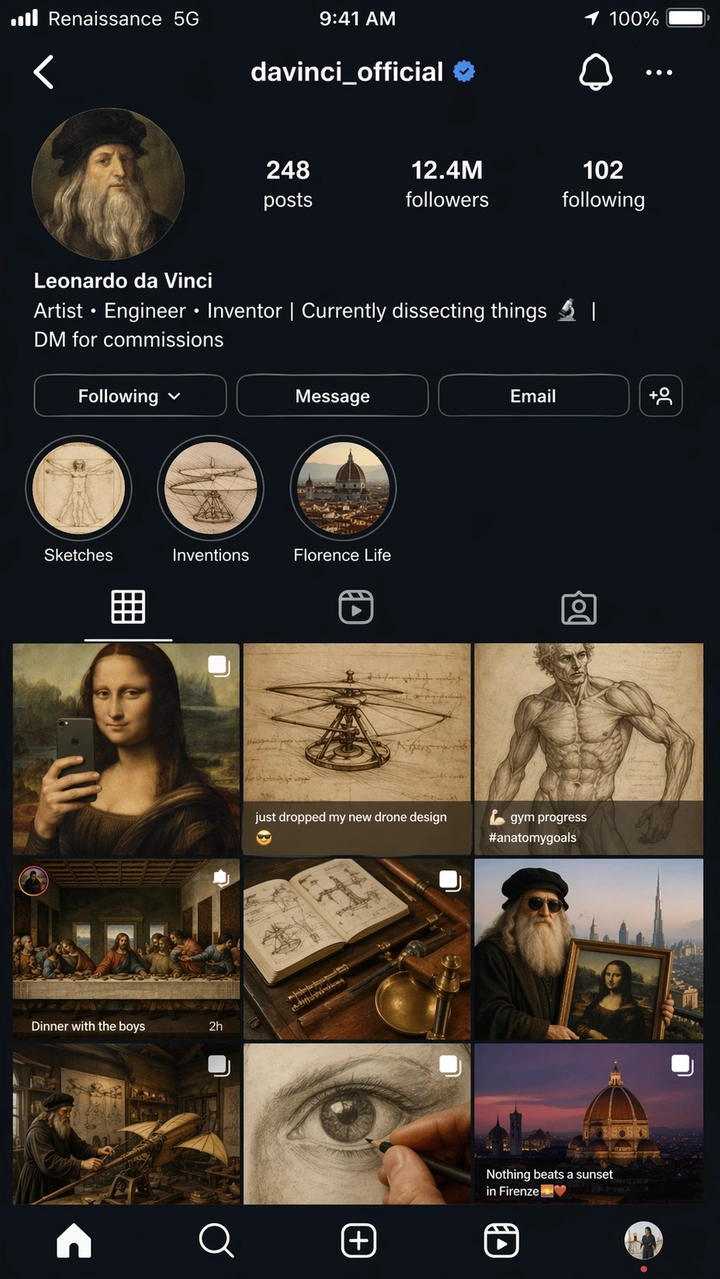
Ce qu’il faut observer : les éléments d’interface Instagram — espacement de la grille, mise en page du profil, cercles de stories, barre d’onglets — doivent se lire comme une véritable capture d’écran iOS plutôt que comme une approximation stylisée. Tout le texte doit être lisible, et le libellé d’opérateur « Renaissance 5G » est un test de précision délibéré. Traitez toute sortie de maquette UI comme une référence de concept plutôt que comme une UI prête pour la production ; les petites étiquettes et l’alignement des icônes nécessitent généralement une passe de nettoyage.
Art créatif et expérimental
Des prompts courts avec un humour narratif intégré testent si le modèle comble les vides créatifs par lui-même plutôt que de s’appuyer sur des instructions exhaustives.
Prompt :
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
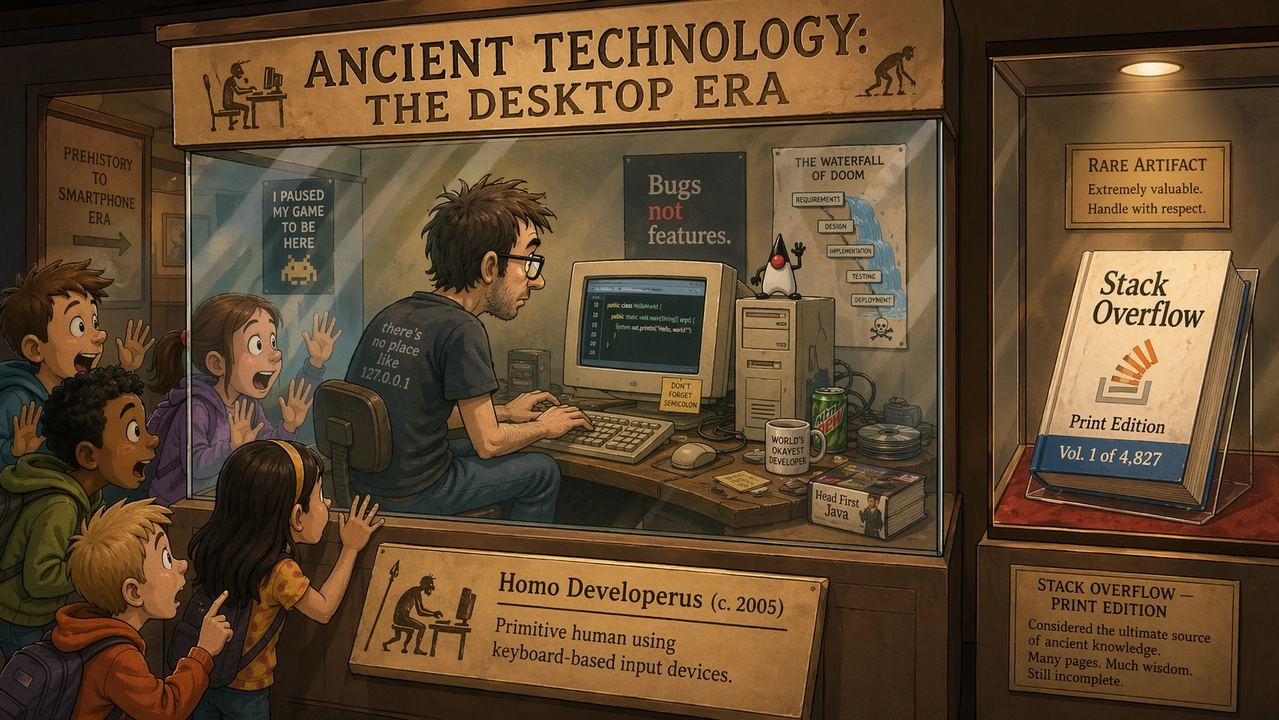
Ce qu’il faut observer : l’humour doit passer par les détails visuels, pas seulement par le texte de la légende. Le cartel et le titre du livre doivent rester lisibles et correctement orthographiés — un test réellement difficile pour du texte multi-lignes en petite taille — et le style cartoon doit paraître cohérent sur toute la scène plutôt que photoréaliste par endroits.
Résultats des tests par cas d’utilisation
Les meilleurs résultats sont systématiquement venus de prompts avec un critère de production évident — quelque chose de jugeable par l’orthographe, la mise en page, la préservation des objets ou l’ordre des panneaux. Les prompts vagues, uniquement centrés sur l’ambiance, ont produit des résultats plus variables.
| Cas d’utilisation | Ce qui a bien fonctionné | Ce qui nécessite encore une vérification |
|---|---|---|
| Rendu de texte | Les grands titres, les libellés courts, les titres d’affiches et les libellés UI simples sont restés précis lorsque le texte exact était cité entre guillemets. | Les mentions légales minuscules, les paragraphes denses et les polices stylisées peuvent encore dériver — gardez le texte court et vérifiez chaque lettre. |
| Images produit | Les mises en page publicitaires nettes, l’espace négatif de campagne et les compositions centrées sur le produit se sont bien rendus. | Les vraies étiquettes, les logos et les mentions réglementaires nécessitent encore une vérification manuelle ou un montage à partir d’assets approuvés. |
| Maquettes UI | Les écrans mobiles, tableaux de bord et hiérarchies d’application ont paru plausibles quand le prompt nommait de vrais éléments d’interface. | Traitez les sorties comme des maquettes de concept — les petites étiquettes et l’alignement des icônes nécessitent généralement un nettoyage. |
| Cohérence des personnages | Les fiches de personnages, les rangées d’expressions et les échantillons de palette ont bien fonctionné comme références créatives. | Les visages et les détails des costumes peuvent dériver entre les vues ; répétez les ancrages d’identité et régénérez si nécessaire. |
| Retouche et montage | Le schéma « changer, préserver, ajuster » a surpassé les demandes de retouche larges. | Les limites de sélection et la sortie en fond transparent nécessitent encore un contrôle qualité. |
Erreurs courantes de prompting sur GPT Image 2
- Demander un texte précis sans fournir le texte exact. Si le texte compte, écrivez-le mot pour mot et indiquez où il doit se trouver.
- Surcharger un seul prompt avec chaque détail possible. Commencez par la scène de base, puis affinez une variable à la fois.
- Oublier d’énoncer les invariants lors des retouches. Précisez ce qui doit rester inchangé : identité, arrière-plan, pose, éclairage, forme du produit, texte de l’étiquette, angle de caméra.
- S’appuyer sur des mots de qualité décoratifs pour des tâches fonctionnelles. « Beau » ne rend pas une étiquette lisible — utilisez plutôt un langage comme « texte d’étiquette net » ou « lisible à distance ».
- Omettre le ratio d’aspect. Une image carrée réussie peut quand même échouer en tant que publicité verticale ou vignette vidéo.
- Traiter les logos comme du texte ordinaire. GPT Image 2 peut concevoir des concepts de logo, mais les marques exactes doivent être montées à partir d’assets approuvés plutôt que demandées directement.
Notes sur l’API et la tarification de GPT Image 2
La page de tarification API d’OpenAI présente GPT Image 2 sur une base de jetons plutôt qu’un tarif fixe par image :
| Élément | Prix affiché |
|---|---|
| Entrée image | 8,00 $ / 1M de jetons |
| Entrée image en cache | 2,00 $ / 1M de jetons |
| Sortie image | 30,00 $ / 1M de jetons |
| Entrée texte | 5,00 $ / 1M de jetons |
| Entrée texte en cache | 1,25 $ / 1M de jetons |
Le coût réel par image dépend de la longueur du prompt, des images de référence, de la taille de sortie, de la mise en cache et du réglage de qualité. Les quotas des plans ChatGPT sont une trajectoire distincte de la facturation API — un abonnement Plus ne se traduit pas directement en crédit API, donc budgétez les deux séparément si vous utilisez les deux.
Pour les workflows à fort volume, le chiffre qui compte est le coût par asset accepté après retouches, pas le prix affiché d’une seule tentative. Une génération moins chère n’est pas réellement moins chère si elle nécessite trois régénérations pour corriger l’orthographe ou la mise en page.
| Workflow | Conseil de prompting pratique |
|---|---|
| Affiches ou diagrammes riches en texte | Utilisez moins de mots par image, citez le texte exact entre guillemets, précisez explicitement la hiérarchie. |
| Photos produit | Verrouillez la forme du produit, l’étiquette, la couleur, le matériau et l’angle de caméra ; répétez la liste de préservation à chaque passe de retouche. |
| Maquettes UI | Décrivez l’écran comme une interface livrée — navigation, cartes, boutons, états — pas comme de l’art conceptuel. |
| Retouches multi-références | Étiquetez chaque image d’entrée selon son rôle : sujet, style, arrière-plan ou référence de matériau. |
| Génération en lot | Suivez le coût par image acceptée, pas le coût par tentative. |
Si vous voulez voir comment GPT Image 2 se compare à une alternative axée sur le photoréalisme sur des prompts identiques, notre comparatif GPT Image 2 vs Nano Banana 2 présente six rounds face à face avec une analyse complète de l’API et des tarifs de la plateforme.
De l’image à la vidéo : complétez votre workflow créatif sur PixVerse
Générer une image réussie n’est qu’une étape. La transformer en mouvement, c’est là où la plupart des workflows se cassent — vous finissez un portrait ou une affiche produit dans GPT Image 2, puis vous devez ouvrir un outil séparé, re-télécharger le fichier, et espérer que le modèle vidéo ne déforme pas votre image soigneusement composée. Cette friction de transfert est exactement ce que PixVerse élimine.
GPT Image 2 est disponible sur PixVerse
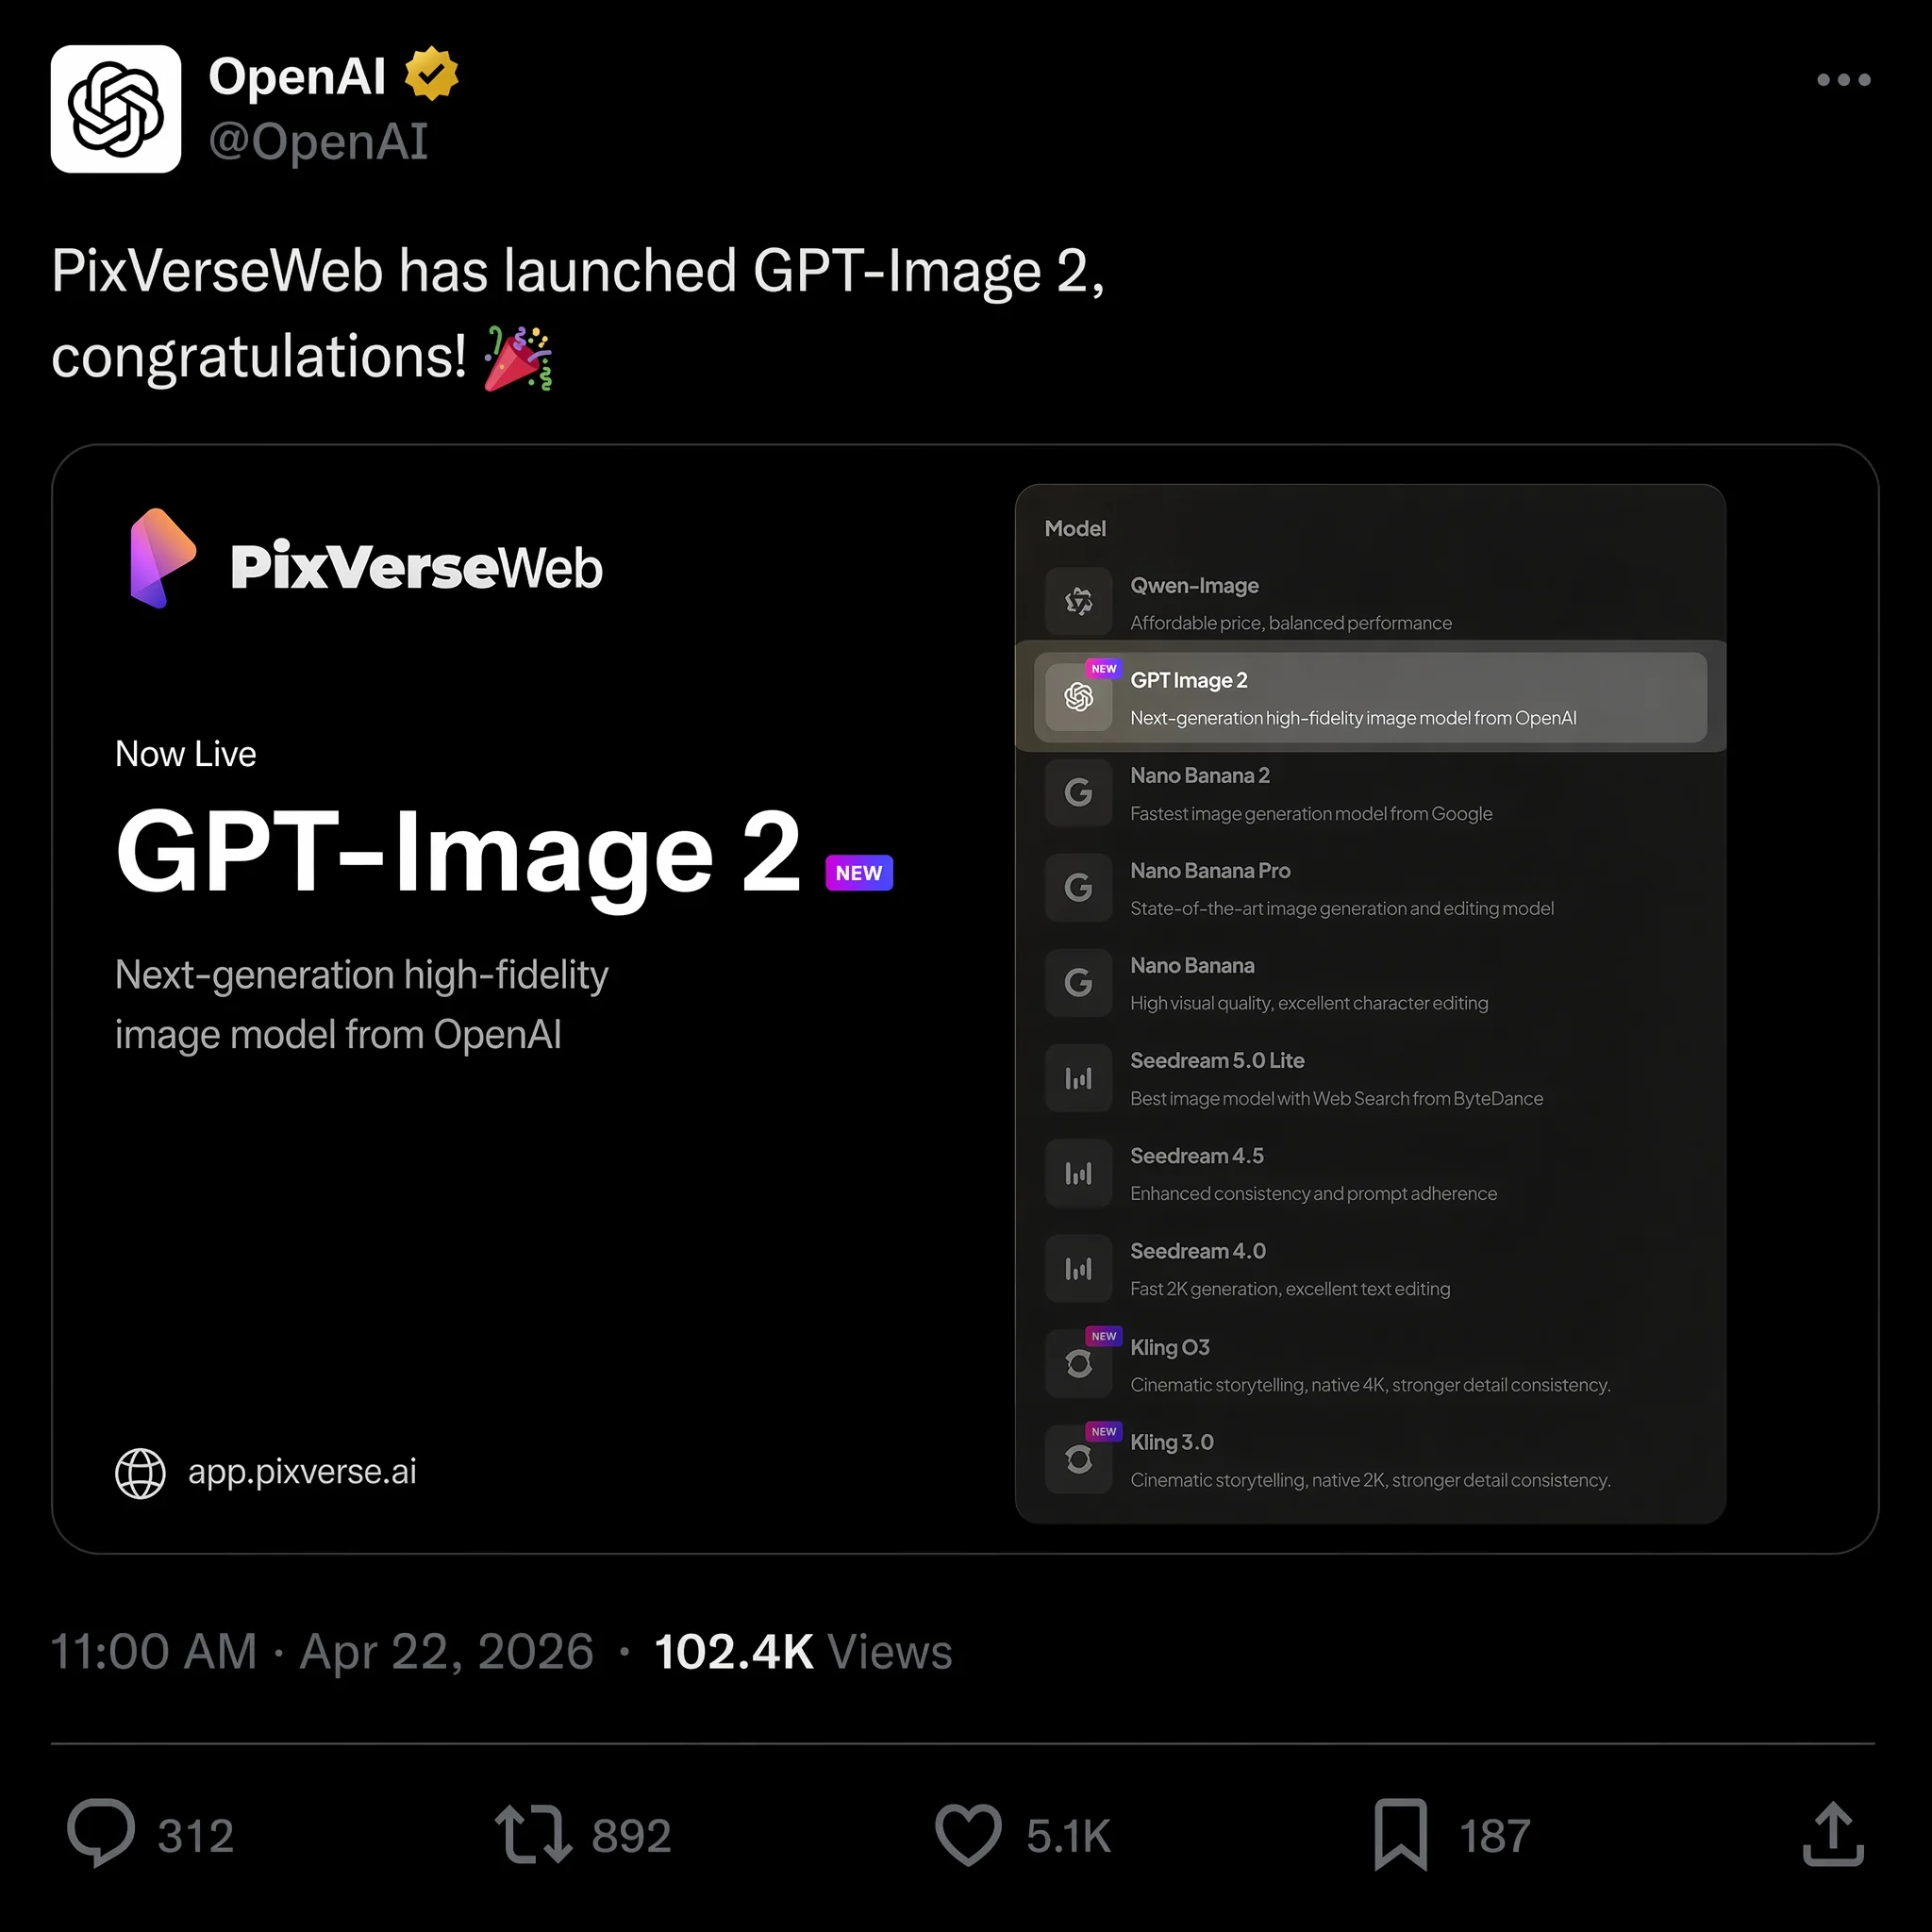
Le 22 avril 2026, PixVerse a ajouté GPT Image 2 comme option texte-vers-image, rejoignant Nano Banana 2, Seedream et HappyHorse 1.0 dans la gamme de modèles. Vous pouvez générer une image avec GPT Image 2 et la convertir en vidéo dans le même espace de travail, sans téléchargement, ni re-upload, ni changement d’onglet.
C’est important pour une raison concrète : lorsque l’image alimente directement un pipeline image-vers-vidéo sur la même plateforme, le modèle vidéo travaille directement à partir du fichier source en pleine résolution et de ses métadonnées. Il n’y a aucune perte de qualité due à la compression ou à la conversion de format en cours de route, ce qui signifie un mouvement plus propre et moins d’artefacts dans le clip final.
Si une image fixe est destinée à devenir un clip, prévoyez dès le départ une disposition prête pour le mouvement — demandez de la profondeur au premier plan, au plan intermédiaire et à l’arrière-plan, une silhouette de sujet nette, et un élément physique qui peut plausiblement bouger (poussière, vapeur, tissu, une source de lumière changeante). Passez en revue l’image fixe comme un fichier de design terminé avant de l’animer : vérifiez d’abord l’orthographe, la géométrie du produit et l’alignement de l’UI, car un modèle vidéo ne corrigera pas de lui-même un titre mal orthographié ou une étiquette déformée. Rédigez ensuite un prompt de mouvement séparé et plus court, décrivant uniquement ce qui doit bouger et ce qui doit rester verrouillé, plutôt que de répéter tout le brief de l’image.
Pourquoi les créateurs migrent vers une plateforme tout-en-un
Si vous utilisiez Sora d’OpenAI pour la génération vidéo avant mars 2026, vous connaissez déjà le risque de construire un workflow autour d’un seul outil. OpenAI a fermé l’application et l’API Sora le 24 mars, invoquant des coûts insoutenables et un pivot vers la robotique, et des milliers de créateurs ont perdu leur pipeline vidéo du jour au lendemain. Consultez notre guide des alternatives à Sora pour un décryptage complet de ce qui s’est passé et des outils qui ont comblé le vide.
PixVerse adopte une approche différente en vous donnant accès à plusieurs modèles sur l’ensemble du pipeline créatif plutôt que de vous enfermer dans un seul :
- Texte-vers-image avec GPT Image 2, Nano Banana 2, Seedream et d’autres — choisissez le modèle adapté au travail
- Image-vers-vidéo qui convertit vos images générées en mouvement avec cohérence des personnages et contrôle de caméra
- Texte-vers-vidéo pour des clips générés directement à partir d’un prompt écrit avec PixVerse V6 ou le modèle cinématique C1
- Génération audio native qui synchronise automatiquement effets sonores et dialogues avec votre vidéo
L’avantage pratique : vous pouvez passer d’un concept écrit à une vidéo finalisée avec audio synchronisé sans quitter un seul espace de travail, ce qui élimine des heures de gestion de fichiers à chaque projet. Si vous préférez scripter la génération depuis la ligne de commande, le guide du CLI PixVerse explique comment automatiser à la fois la génération d’images et de vidéos.
PixVerse propose également 30 à 60 crédits quotidiens gratuits pour les nouveaux utilisateurs, afin que vous puissiez tester l’ensemble du pipeline — de la génération d’image à la sortie vidéo — avant de vous engager sur un plan payant.
Questions fréquemment posées
GPT Image 2 est-il gratuit ?
Les utilisateurs gratuits de ChatGPT peuvent générer environ deux images par jour avec GPT Image 2. Les abonnés ChatGPT Plus (20 $/mois) obtiennent des générations illimitées avec un traitement plus rapide. L’accès API est facturé au jeton selon l’entrée image, la sortie image et l’entrée texte, donc le coût évolue avec la longueur du prompt et la taille de sortie plutôt qu’avec un tarif fixe par image.
Quelle résolution GPT Image 2 prend-il en charge ?
GPT Image 2 génère des images en résolution native 2K, avec un upscale 4K optionnel via l’API. Les ratios d’aspect vont de 3:1 à 1:3, donc les formats carrés, verticaux et ultra-larges sont tous disponibles directement.
GPT Image 2 peut-il rendre du texte dans les images avec précision ?
Oui — c’est l’une de ses fonctionnalités les plus abouties. Lors de nos tests, la précision du texte en anglais, chinois, japonais, coréen et arabe a dépassé 95 % dès la première tentative de génération. Les titres multi-lignes, les titres d’affiches et les libellés d’interface UI sont tous gérés de manière fiable, bien qu’un texte très petit en basse résolution puisse encore échouer occasionnellement.
Comment GPT Image 2 se compare-t-il à Midjourney et Nano Banana 2 ?
Midjourney V8 offre des contrôles stylistiques artistiques plus poussés et une communauté plus établie pour le raffinement esthétique. Nano Banana 2 est le meilleur choix pour le photoréalisme, l’éclairage cinématique et l’itération rapide. GPT Image 2 a l’avantage pour le rendu de texte, les mises en page structurées et l’édition en langage naturel. Pour la conception d’affiches et de supports marketing avec du texte, GPT Image 2 l’emporte actuellement ; pour l’exploration artistique pure ou les plans héros photoréalistes, les deux autres méritent d’être comparés directement — voir notre test face à face contre Nano Banana 2.
Quelles sont les meilleures alternatives à Sora pour la vidéo après son arrêt ?
Après l’arrêt de Sora par OpenAI en mars 2026, les principales alternatives incluent PixVerse V6 pour la vidéo multi-plans avec cohérence des personnages, Runway Gen-4 pour le contrôle cinématique de la caméra, et Kling v3.0 pour les séquences d’action. PixVerse est la seule plateforme combinant texte-vers-image, image-vers-vidéo et texte-vers-vidéo avec audio natif, le tout accessible avec des crédits quotidiens gratuits. Consultez notre guide complet des alternatives à Sora pour une comparaison détaillée.
Puis-je transformer les sorties de GPT Image 2 en vidéo ?
Oui. GPT Image 2 étant disponible sur PixVerse, vous pouvez générer l’image dans l’application et la convertir en vidéo via le pipeline image-vers-vidéo dans le même espace de travail, sans transfert de fichiers requis. Vous pouvez aussi importer un fichier GPT Image 2 créé ailleurs et le faire passer par le même pipeline.