Review ng GPT Image 2: Gabay sa Prompt at Mga Use Case sa 2026
Inilabas ng OpenAI ang GPT Image 2 noong Abril 21, 2026 — ang kahalili ng GPT Image 1.5 at ang modelong nagpapatakbo ngayon ng image generation sa buong ChatGPT. Sinubukan namin ito sa launch week at bumalik kami rito noong huling bahagi ng Hunyo gamit ang mas malawak na hanay ng mga prompt, ang sariling gabay sa prompting ng OpenAI, at ang inilathala nitong presyo ng API para makita kung paano tumatagal ang modelo kapag humupa na ang unang hype.
Mga Pangunahing Takeaway:
- Gumagawa ang GPT Image 2 ng mga larawan sa native na 2K resolution na may opsyonal na 4K upscaling, at ang katumpakan ng text rendering ay higit sa 95% sa mga script na Latin, Chinese, Japanese, Korean, at Arabic.
- Pinakamabuting ituring ang modelo bilang design assistant sa halip na photo generator: mahusay ito sa mga trabahong may malinaw na pamantayan ng tagumpay — eksaktong kopya, naka-lock na layout, nauulit na istruktura ng panel — at nagiging hindi gaanong predictable sa bukas na mga prompt na “gawing maganda.”
- Mahihinang punto pa rin ang reproduksyon ng brand logo, napakaliit na legal copy, at proprietary na font na kailangan pa ng manu-manong review.
- Sinisingil ng API ng OpenAI ang GPT Image 2 ayon sa token sa image input, cached image input, image output, text input, at cached text input — ibang modelo ng presyo kaysa sa per-image na mga tier na ginagamit ng ilang kakumpitensya.
- Kasama ang GPT Image 2 sa text-to-image lineup ng PixVerse kasabay ng Nano Banana 2 at Seedream, kaya ang isang nabuong larawan ay puwedeng dumiretso sa image-to-video pipeline nang hindi umaalis sa workspace.
Ano ang GPT Image 2? Mga Pangunahing Feature at Limitasyon
Ang GPT Image 2 ay second-generation na image model ng OpenAI, na pumapalit sa GPT Image 1.5 sa buong ChatGPT at sa API. Nakikipagkumpitensya ito sa Midjourney, DALL-E 3, at Stable Diffusion, ngunit itinataya nito ang pagkakakilanlan sa dalawang bagay: tumpak na text sa loob ng mga larawan, at isang reasoning layer na binibigyang-kahulugan ang layunin ng prompt sa halip na tumugma lang sa mga keyword nito.
Mga Core Feature sa Isang Sulyap
| Feature | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Native na resolution | 2K (may 4K upscale) | 1K | 2K (may —hd flag) |
| Katumpakan ng text rendering | 95%+ multilingual | ~70% (Latin lang) | ~80% (Latin lang) |
| Integrasyon ng reasoning | Oo — binibigyang-kahulugan ang magkapatong na tagubilin | Hindi | Hindi |
| Saklaw ng aspect ratio | 3:1 hanggang 1:3 | 1:1, 16:9 | 1:1 hanggang 3:2 |
| Pagkakapare-pareho ng character | Pixel-level sa magkakasunod na larawan | Limitado | Katamtaman (—cref flag) |
| Natural language na pag-edit | Oo — i-edit ang mga rehiyon sa pamamagitan ng paglalarawan | Hindi | Hindi |
| Presyo | Token-based sa pamamagitan ng API; mga tier ng plan ng ChatGPT | Pareho | $10–30/buwan na subscription |
Ang text rendering ang feature na pinakakukuha ng atensyon, at may magandang dahilan. Itinuring ng mas lumang image model ang text bilang texture — humingi ka ng headline ng poster at makakakuha ka ng ingay na hugis letra. Hinahawakan ng GPT Image 2 ang multi-line na English headline, Chinese character, at mixed-language na layout nang may tunay na pagkakapare-pareho; sa aming mga pagsubok, humigit-kumulang 19 sa 20 generation ang bumalik na ganap na nababasa sa unang subok.
Ang ibig sabihin ng integrasyon ng reasoning ay higit pa sa pagtutugma ng pattern sa iyong mga salita ang ginagawa ng modelo. Hilingin dito na “gumawa ng infographic na nagpapakita ng mga aktibidad para sa panahon bukas sa San Francisco,” at kukunin nito ang forecast, pipili ng mga kaugnay na aktibidad, at bubuo ng layout sa paligid ng datos na iyon — isang hakbang na lampas sa kung paano pinoproseso ng Midjourney o Stable Diffusion ang isang prompt.
Hinahayaan ka ng natural language na pag-edit na baguhin ang isang larawan sa pamamagitan ng paglalarawan ng pagbabago sa halip na manu-manong i-mask ito. Ang “Ilipat ang tasa ng kape sa kaliwang bahagi ng mesa” o “baguhin ang langit sa paglubog ng araw” ay parehong inilalapat bilang target na mga edit nang hindi nire-regenerate ang buong eksena.
Ano ang Sinasabi ng mga User
Karamihan ay positibo ang feedback mula nang ilunsad, na may pare-parehong hanay ng mga reklamo. Mukhang malapit sa studio photography ang mga portrait test na kumakalat sa X at Reddit, at iniulat ng mga poster designer na sumusubok ng long-form na layout — flyer, menu, signage — na sa wakas ay tumatagal ang katumpakan ng text sa tunay na paggamit. Napansin ng ilang designer na puwede nilang laktawan ang isang Photoshop pass para sa basic na marketing asset dahil sapat ang lakas ng sariling sentido ng komposisyon ng modelo para gumawa ng mga desisyon sa layout nang walang tulong.
Nakasentro ang pinakamalakas na papuri sa pagsunod sa prompt: humingi ka ng 15 partikular na elemento sa isang eksena at karaniwang isinasama ng GPT Image 2 ang lahat ng iyon, kung saan nagsisimulang mag-drop ng detalye ang mas lumang mga modelo habang humahaba ang mga prompt.
Sa negatibong panig, hindi pa rin pare-pareho ang brand fidelity. Ipinakita ng malawakang ibinahaging hands-on na pagsubok ng ZDNet na nabigo ang modelo na tumpak na i-reproduce ang logo ng ZDNET, at iniulat ng ibang user ang parehong bagay sa mga partikular na brand mark. Nauunawaan ng modelo kung ano ang isang logo sa konsepto, ngunit hindi nito mapagkakatiwalaang nire-reproduce ang eksaktong hugis ng vector o proprietary na typeface.
Mga Kilalang Limitasyon
- Hindi maaasahan ang paggaya sa brand logo — i-composite ang eksaktong logo sa Photoshop o Figma pagkatapos ng generation, sa halip na direktang i-prompt ang mga ito.
- Mas mabagal ang generation kaysa sa mas magaan na model tulad ng FLUX o Nano Banana 2; karaniwang 30–60 segundo sa ChatGPT Plus, kumpara sa wala pang 10 segundo sa iba.
- Masikip ang rate limit ng free tier — humigit-kumulang dalawang larawan kada araw para sa libreng user ng ChatGPT. Unlimited ang generation ng Plus subscribers sa ChatGPT, ngunit tumataas ang API cost kasabay ng volume.
- Mas magaspang ang style control kaysa sa Midjourney. Hindi mo kayang itakda ang film stock, uri ng lens, o grain nang parehong katumpakan, at kailangan ng sadyang prompt work para lampasan ang sariling aesthetic bias ng model.
- Mas mahigpit ang content policy kaysa sa open-source na alternatibo, kaya ang ilang prompt na gumagana sa Stable Diffusion o local models ay tatanggihan dito.
Wala sa mga ito ang nagsasabing hindi puwedeng gamitin sa production, ngunit mahalagang malaman ang mga ito bago ka magtayo ng pipeline na umaasa sa iisang model.
Paano Sumulat ng GPT Image 2 Prompts na Talagang Gumagana
Ang pinakamalinaw na pagbabago sa ikalawang round ng testing namin: ang pinakamahusay na GPT Image 2 prompts ay hindi lang naglalarawan ng larawan — inilalarawan nila ang trabaho na kailangang gawin ng larawan. Iba dapat ang mabasa ng social ad prompt kumpara sa product cutout, infographic, UI screen, o unang frame na para sa video.
Isang maaasahang pattern para sa pagbuo ng brief:
Gumawa ng [uri ng larawan] para sa [use case]. Pangunahing subject: [tiyak na subject at mga detalye na nakikita]. Eksaktong text, kung mayroon: “[copy na kailangang lumabas]”. Komposisyon: [framing, layout, negative space, puwesto ng subject]. Estilo at ilaw: [visual language, medium, mood, direksyon ng ilaw]. Mga limitasyon: [ano ang hindi dapat magbago, walang dagdag na salita, walang watermark]. Format ng output: [aspect ratio, transparent background, video-ready frame].
Pangalanan muna ang trabaho bago ang estilo
Magsimula sa uri ng output — poster, product ad, app screen, character sheet, diagram, edit, o unang frame ng video — para malaman ng model kung anong pamantayan ang gagamitin sa paghusga.
Mahina: Isang astig na futuristic speaker, cinematic, mataas ang detalye.
Mas mahusay: Gumawa ng premium product ad para sa matte black wireless speaker. Dapat gumana ang larawan bilang 16:9 campaign banner, ang produkto sa kanan, maikling headline sa kaliwa, malinis na negative space, at matatalas na gilid ng produkto.
Sinasabi ng ikalawang bersyon sa model na huhusgahan ito batay sa layout at usability, hindi lang sa aesthetics.
Ituring ang text na parang naka-lock na asset
Ilagay ang anumang kinakailangang copy sa loob ng quotation marks at sabihin nang eksakto kung paano ito dapat i-render — huwag humingi ng “isang slogan” maliban kung gusto mong mag-imbento ng mga salita ang model para sa iyo.
Headline: “SOUND YOU CAN FEEL”. I-render ang headline nang verbatim. Walang dagdag na salita, walang duplicate na text, walang pekeng logo. Bold na puting sans-serif type, kaliwang bahagi ng komposisyon, nababasa mula sa malayo.
Para sa mas mahabang copy, hatiin nang tahasan ang bawat linya sa prompt. Kung may salitang lumabas na mali ang baybay, mag-regenerate gamit ang mas maikling copy, mas malaking type, at mas mahigpit na tagubiling “exact text only”.
Bigyan ang model ng camera at layout
Sabihin nang diretso ang layo ng camera, anggulo, puwesto ng subject, negative space, at aspect ratio — sinusunod nang maayos ng GPT Image 2 ang mga cue sa komposisyon, ngunit kapag malinaw lang na nakasulat ang mga ito.
- Close-up para sa texture ng produkto, kamay, mukha, materyales, at label.
- Wide shot para sa kapaligiran, story scene, city poster, at video-ready frame.
- Top-down para sa pagkain, desk scene, flat-lay, at packaging kit.
- Left third / right third para sa ad layout na nagbabalanse ng text at produkto.
- Clean grid para sa UI mockup, character sheet, diagram, at infographic.
Isulat ang mga edit sa tatlong pangungusap
Ang pinakamalakas na edit prompt ay inihihiwalay ang pagbabago sa dapat manatiling hindi nagalaw, at sa physical realism na nag-uugnay sa mga ito:
Palitan ang naka-park na kotse ng vintage bicycle. Panatilihing eksakto ang bahay, bakod, driveway, landscaping, direksyon ng ilaw, anggulo ng camera, at oras ng araw. Itugma ang sukat ng bisikleta, contact shadow, at perspective sa kasalukuyang eksena.
Ang istrukturang “change, preserve, match” ay patuloy na mas mahusay kaysa sa malabong hiling na “gawing mas maganda ito”.
Magdagdag ng motion cue kung magiging video ang still
Kung maaaring pumasok ang larawan sa PixVerse image-to-video pipeline, mag-prompt na para sa depth at motion-readiness mula sa simula: foreground, midground, background, malinis na silhouette ng subject, at isang nakikitang cue na puwedeng gumalaw — alikabok, tela, buhok, ulan, repleksyon, o landas ng camera push.
Sa halip na: Isang astronaut sa disyerto.
Gamitin: Isang cinematic na unang frame para sa image-to-video clip: isang nag-iisang astronaut na nakatayo sa gilid ng kumikinang na crater sa disyerto sa madaling-araw, handang gumalaw sa hangin ang kapa at alikabok, malakas na foreground silhouette, malinaw na depth layer, at mainit na liwanag sa horizon.
Paano Namin Sinubukan ang GPT Image 2
Sa parehong round ng testing, pinatakbo namin ang model sa mga portrait, text-heavy poster, product-style na komposisyon, character sheet, UI mockup, at experimental na narrative scene. Hindi benchmark score ang layunin — kung kaya bang i-ship ng designer, marketer, o creator ang output sa pamamagitan ng magagaan na edit, sa halip na buuin muli ang asset mula sa simula.
| Test area | Ano ang sinuri namin |
|---|---|
| Mga portrait at cinematic still | Kontrol sa ilaw, texture ng balat, repleksyon, mood, pagkakapare-pareho ng eksena |
| Layout ng poster at typography | Baybay ng headline, multi-line na text, hierarchy, negative space, polish na parang brand |
| Character at concept sheet | Pagkakapare-pareho ng multi-view, detalye ng costume, pagkakahanay ng palette, katumpakan ng label |
| UI at social mockup | Realismo ng layout, maliit na text, spacing ng icon, feed grid, pagiging kapani-paniwala ng screenshot |
| Experimental na prompt | Humor, narrative reasoning, puwesto ng bagay, katumpakan ng maliit na caption |
Nanatili ang pattern sa parehong round: mas ginagantimpalaan ng GPT Image 2 ang tumpak na brief kaysa sa kadena ng keyword. Kapag pinangalanan ng prompt ang trabaho at tinukoy ang tagumpay — eksaktong text, naka-lock na layout, paulit-ulit na panel structure — madalas na pinapanatili ng model ang istruktura. Kapag mood lang ang malabong hinihingi ng prompt, maaari pa ring magmukhang pulido ang resulta, ngunit mas mahirap itong gamitin muli nang walang edit.
Mga Use Case ng GPT Image 2 na May Halimbawa ng Prompt
Sinubukan namin nang mabuti ang limang magkakaibang kakayahan sa mga sitwasyong ito: kontrol sa ilaw, exact-text typography, multi-element na komposisyon, pagkakapare-pareho ng character, at UI layout. Handa nang kopyahin at iangkop ang bawat prompt sa ibaba.
Cinematic Portrait Photography
Sinusuri nito ang pagkaunawa ng model sa ilaw, atmosphere, at pigil na komposisyon — ang mga batayan na naghihiwalay sa portfolio-ready na larawan mula sa generic na AI render.
Prompt:
Gumawa ng cinematic portrait ng isang nag-iisang pigura na nakatayo sa matinding orange-to-red gradient na kapaligiran. Malakas na silhouette lighting mula sa likod, malalim na contrast ng anino, reflective glossy na sahig na sumasalamin sa pigura. Simetrikal na komposisyon, minimal na set design, walang kalat sa background. Kontemplatibo at makapangyarihan ang mood, parang still mula sa science-fiction film. Aspect ratio 16:9.
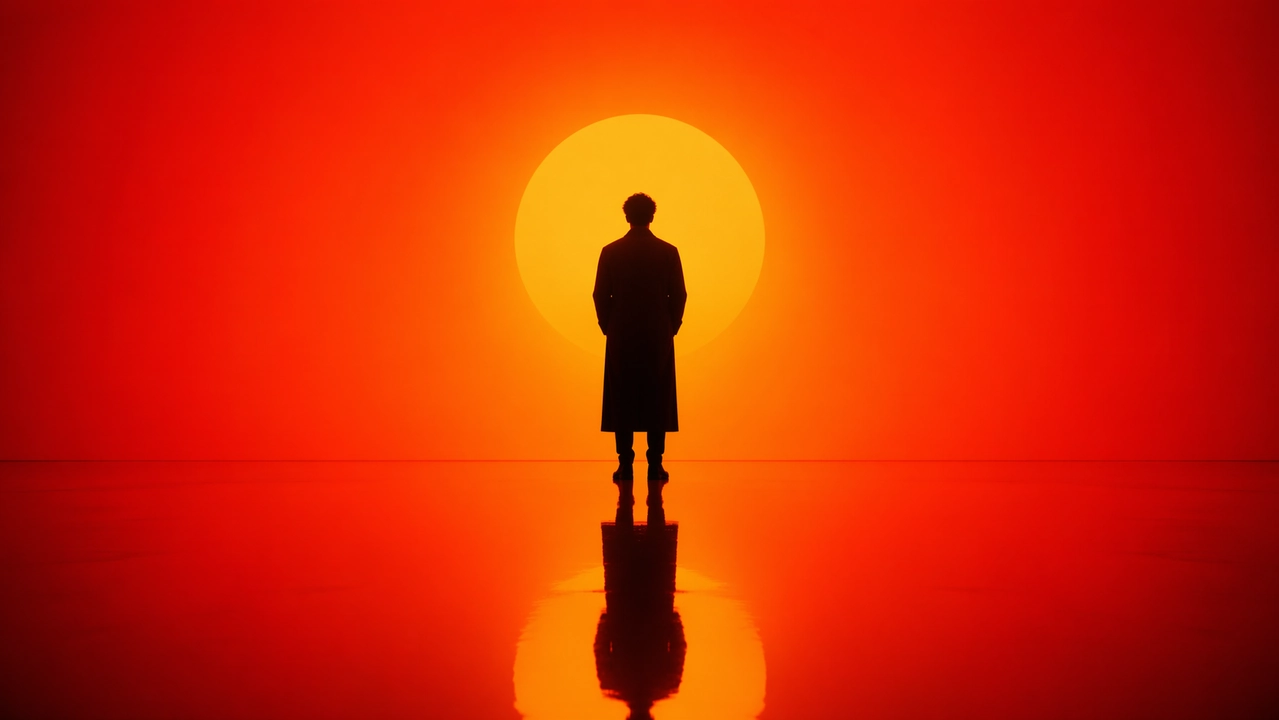
Ano ang hanapin: malinis na gilid ng silhouette na walang halo artifact, tumpak na repleksyon sa sahig na may tamang perspective, makinis (hindi banded) na gradient, at pose na may tunay na bigat sa halip na mukhang maninigas o lumulutang.
Disenyo ng City Poster at Ilustrasyon
Ang pinakamahirap na stress test para sa nababasang typography na ipinares sa siksik at multi-element na komposisyon — mahigit sampung magkakaibang visual element na nakaayos sa S-curve, na may English text na kailangang manatiling buo pagkatapos ng render.
Prompt:
Isang kapansin-pansing Spring 2026 city poster para sa New York na may bold na contemporary design at eleganteng celebratory mood. Malinis na off-white textured background na may maluwag na negative space. Isang miniature na kayaker ang nagsasagwan sa makitid na laso ng reflective na tubig sa ibabang-kanang sulok. Ang wake ay umaakyat sa dinamikong calligraphic curve, unti-unting nagiging Hudson River at pagkatapos ay isang dreamlike na hand-painted panorama ng Manhattan. Sa loob ng dumadaloy na komposisyong hugis-ilog: ang Empire State Building, Brooklyn Bridge, canopy ng Central Park, One World Trade Center, brownstone rooftop, yellow cab, harbor ferry, at ang Statue of Liberty sa malambot na distansya. Malambot na hamog sa umaga, gintong spring light, banayad na accent ng navy at gold. Eleganteng typography sa ibabang kaliwa ang nagsasabing “SPRING 2026” na may patayong slogan na “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Dapat matalas at maganda ang komposisyon ng text. Walang dagdag na salita. Premium graphic design, aspect ratio 9:16.
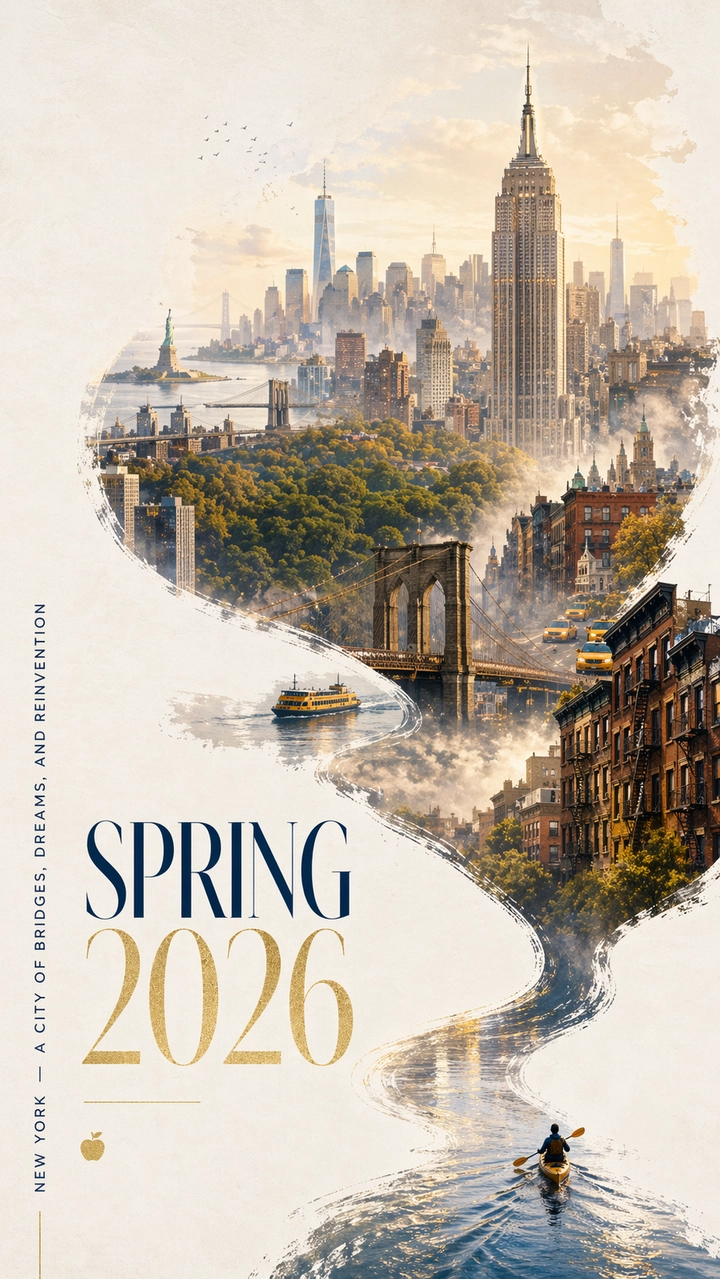
Ano ang hanapin: bawat titik sa title at slogan ay dapat nababasa at tama ang baybay, dapat natural ang daloy ng S-curve mula sa kayaker hanggang sa skyline, dapat makilala ang mga landmark na gusali sa halip na generic na tore, at dapat intensyonal ang negative space sa halip na mukhang bakante.
Character Design at Reference Sheet
Kailangan ng mga game developer at concept artist ang pagkakapare-pareho ng multi-view mula sa iisang generation. Sinusuri nito kung kayang panatilihin ng model ang disenyo ng character sa front, side, at back view.
Prompt:
Gumawa ng propesyonal na character reference sheet para sa orihinal na fantasy RPG character: isang batang babaeng mage na may pilak na buhok at violet na mata, nakasuot ng ornate na madilim na kapa na may kumikinang na rune pattern. Isama sa malinis na puting background: three-view turnaround na nagpapakita ng harap, gilid, at likod; variation ng facial expression na neutral, nakangiti, galit, at nagulat; detalyadong breakdown ng mga piraso ng costume at kagamitan; isang hilera ng color palette swatch; at maikling world-building note sa malinis na typography. Organisadong grid layout, concept art style, mataas na resolution. Aspect ratio 16:9.
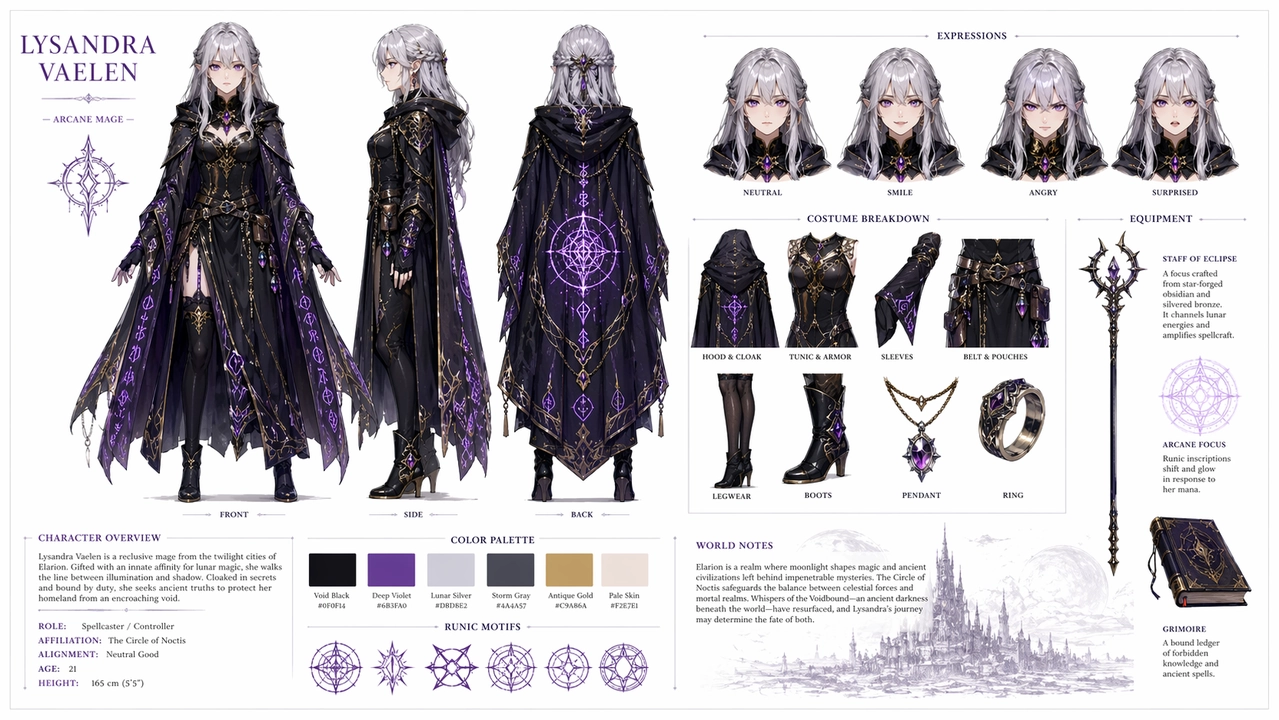
Ano ang hanapin: dapat manatiling pare-pareho ang mukha, buhok, at damit sa lahat ng tatlong view; ang variation ng expression ay dapat magbago lang sa mukha, hindi sa hairstyle o damit; ang palette swatch ay dapat tumugma sa mga kulay na ginamit sa art; at dapat tama ang baybay ng mga text label. Kung lumihis ang side o back view, mag-regenerate gamit ang mas malakas na wikang “preserve” na inuulit ang identity anchor.
UI at Social Media Mockup
Pinupush nito ang tatlong bagay nang sabay: pixel-accurate na UI layout, mixed-language na text rendering, at creative concept fusion — ang uri ng content na madalas ding mag-perform nang maayos sa social platform.
Prompt:
Isang hyper-realistic na iPhone screenshot ng kathang-isip na Instagram profile page para kay Leonardo da Vinci, username @davinci_official, na para bang modernong influencer siya noong 2026. Ang profile photo ay Renaissance self-portrait sa circle crop. Ganito ang bio: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Nagpapakita ang grid ng 9 post: ang Mona Lisa na muling naka-frame bilang mirror selfie, isang helicopter sketch na may caption na “just dropped my new drone design”, isang anatomy study na naka-post bilang gym progress photo, The Last Supper na itinanghal bilang group shot ng dinner party, at iba pang creative na anachronistic mashup. Follower count: 12.4M. Story highlight na may label na Sketches, Inventions, at Florence Life. Kumpletong iOS status bar na may carrier text na “Renaissance 5G”, battery icon, at kasalukuyang oras. Dark mode UI sa kabuuan. Photorealistic na kalidad ng screenshot, aspect ratio 9:16.
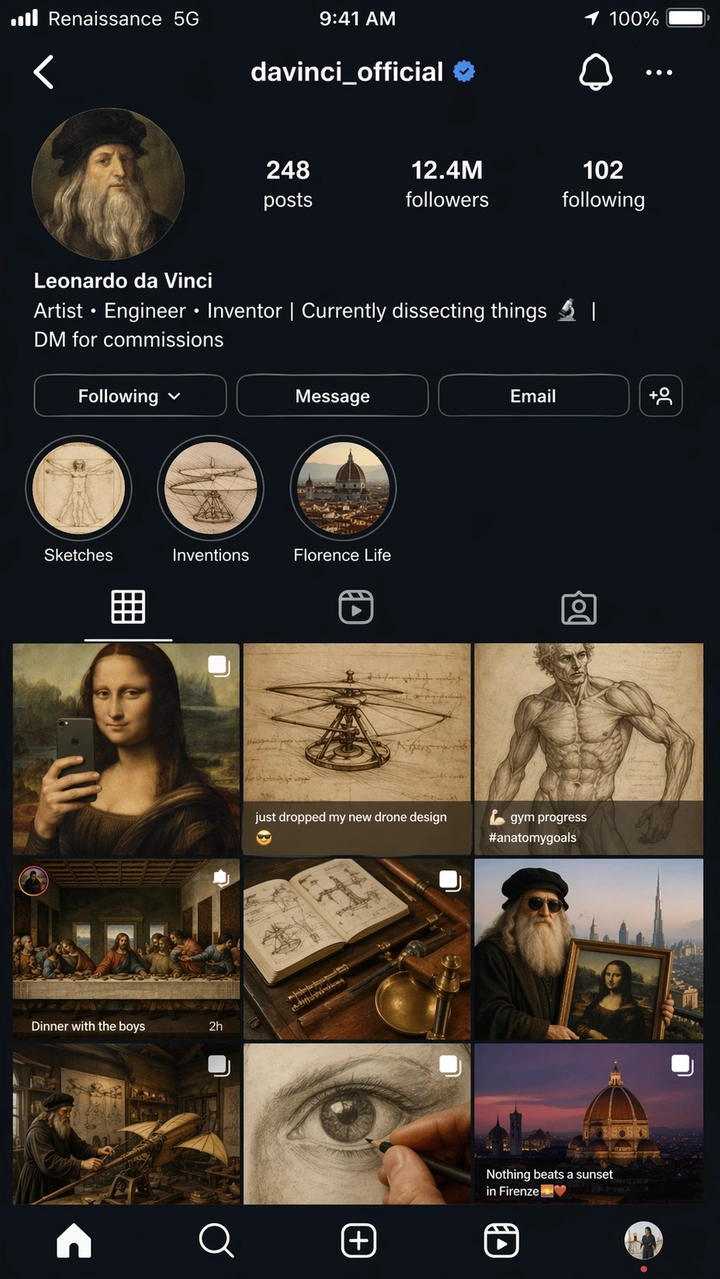
Ano ang hanapin: ang mga element ng Instagram UI — spacing ng grid, layout ng profile, story circle, tab bar — ay dapat mabasa bilang tunay na iOS screenshot, hindi bilang istiladong approximation. Dapat nababasa ang lahat ng text, at ang carrier label na “Renaissance 5G” ay sadyang pagsusuri ng katumpakan. Ituring ang anumang UI mockup output bilang concept reference, hindi bilang production-ready na UI; ang maliliit na label at pagkakahanay ng icon ay karaniwang nangangailangan ng cleanup pass.
Creative at Experimental na Sining
Ang maiikling prompt na may built-in na narrative humor ay sumusubok kung pupunan ng model ang mga creative gap nang mag-isa, sa halip na umasa sa kumpletong tagubilin.
Prompt:
Sa loob ng museum exhibit na pinamagatang “Ancient Technology: The Desktop Era”, isang programmer sa loob ng glass display case ang live na nagde-demo ng coding sa CRT monitor habang idinidiin ng namamanghang mga bata ang kanilang mukha sa salamin. Ganito ang sabi ng exhibit placard: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Isang pangalawang display case sa malapit ang nagpapakita ng pisikal na aklat na may label na “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, mainit na ilaw ng museo, nakakatawa at nostalgic na tono. Aspect ratio 16:9.
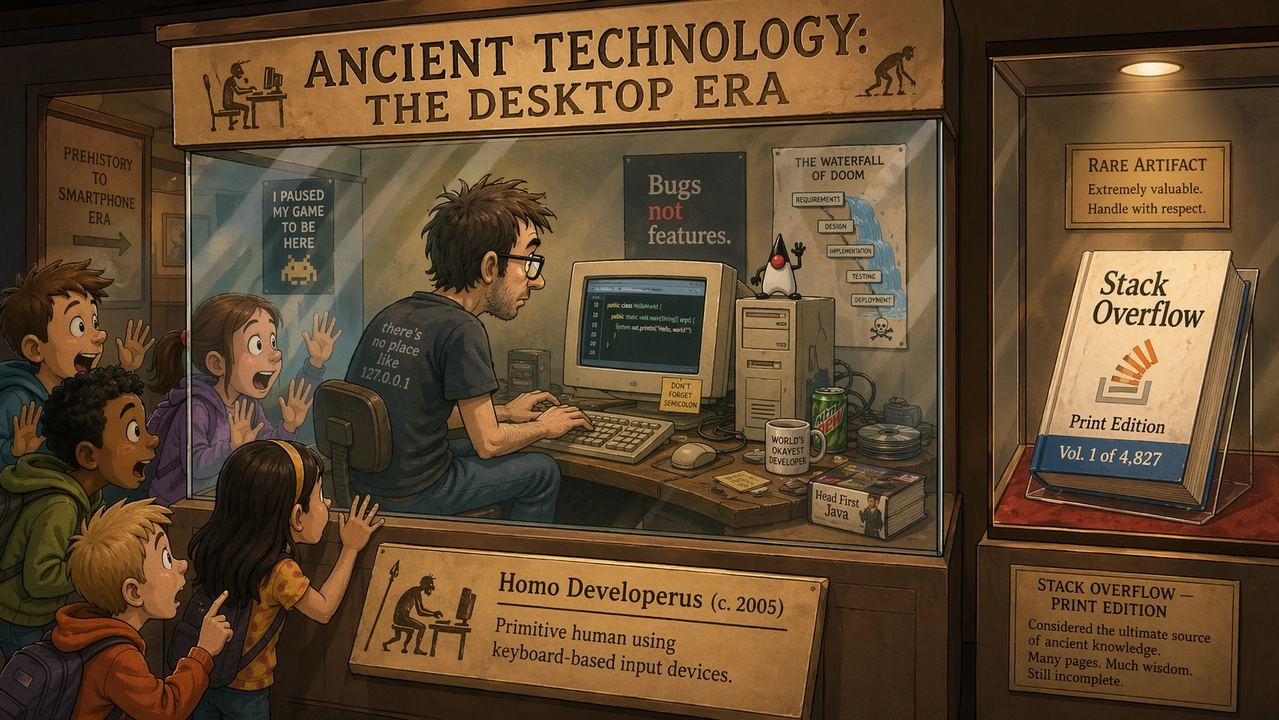
Ano ang hanapin: dapat tumama ang humor sa pamamagitan ng visual na detalye, hindi lang sa caption text. Kailangang manatiling nababasa at tama ang baybay ng placard at title ng aklat — isang tunay na mahirap na pagsubok para sa multi-line na text sa maliliit na sukat — at dapat magkakaugnay ang cartoon style sa buong eksena, hindi photorealistic sa ilang bahagi.
Mga Resulta ng Test ayon sa Use Case
Ang pinakamalakas na resulta ay palaging nanggagaling sa mga prompt na may halatang production standard — bagay na mahuhusgahan batay sa baybay, layout, pagpapanatili ng bagay, o pagkakasunod-sunod ng panel. Ang malabong prompt na mood lang ang hinihingi ay nagbunga ng mas pabago-bagong resulta.
| Use case | Ano ang gumana nang maayos | Ano ang kailangan pa ring suriin |
|---|---|---|
| Text rendering | Nanatiling tumpak ang malalaking headline, maikling label, title ng poster, at simpleng UI label kapag naka-quote ang eksaktong copy. | Ang napakaliit na legal copy, siksik na talata, at stylized na font ay maaari pa ring lumihis — panatilihing maikli ang copy at suriin ang bawat titik. |
| Mga larawan ng produkto | Maganda ang naging render ng malinis na ad layout, campaign negative space, at product-first na komposisyon. | Ang tunay na label, logo, at regulated claim ay kailangan pa ring manu-manong suriin o i-composite mula sa aprubadong asset. |
| UI mockup | Mukhang kapani-paniwala ang mobile screen, dashboard, at app-like na hierarchy kapag pinangalanan ng prompt ang tunay na interface element. | Ituring ang output bilang concept mockup — ang maliliit na label at pagkakahanay ng icon ay karaniwang nangangailangan ng cleanup. |
| Pagkakapare-pareho ng character | Maganda ang naging creative reference ang character sheet, expression row, at palette swatch. | Maaaring lumihis ang mukha at detalye ng costume sa iba’t ibang view; ulitin ang identity anchor at mag-regenerate kung kailangan. |
| Editing at compositing | Mas mahusay ang pattern na “change, preserve, match” kaysa sa malawak na edit request. | Kailangan pa ring i-QA ang selection boundary at transparent-background na output. |
Karaniwang Pagkakamali sa Pag-prompt ng GPT Image 2
- Paghingi ng tumpak na text nang hindi nagbibigay ng eksaktong copy. Kung mahalaga ang text, isulat ito nang verbatim at sabihin kung saan ito dapat ilagay.
- Pag-overload sa iisang prompt ng lahat ng posibleng detalye. Magsimula sa core scene, pagkatapos ay i-refine ang isang variable sa bawat pagkakataon.
- Pagkalimot na sabihin ang mga invariant habang nag-e-edit. Isulat nang malinaw kung ano ang dapat manatiling hindi nagbabago: identity, background, pose, ilaw, hugis ng produkto, label text, anggulo ng camera.
- Pag-asa sa dekoratibong quality word para sa functional na trabaho. Hindi ginagawang nababasa ng “Beautiful” ang isang label — gumamit ng wika tulad ng “sharp label text” o “readable from a distance”.
- Paglaktaw sa aspect ratio. Maaari pa ring bumagsak ang malakas na square image bilang vertical ad o video thumbnail.
- Pagturing sa logo na parang ordinaryong text. Kaya ng GPT Image 2 na magdisenyo ng logo concept, ngunit ang eksaktong brand mark ay dapat i-composite mula sa aprubadong asset, hindi direktang i-prompt.
Mga Tala sa API at Presyo ng GPT Image 2
Nakatala sa API pricing page ng OpenAI ang GPT Image 2 batay sa token, hindi sa flat na rate kada larawan:
| Item | Nakalistang presyo |
|---|---|
| Image input | $8.00 / 1M tokens |
| Cached image input | $2.00 / 1M tokens |
| Image output | $30.00 / 1M tokens |
| Text input | $5.00 / 1M tokens |
| Cached text input | $1.25 / 1M tokens |
Ang aktuwal na gastos kada larawan ay nakadepende sa haba ng prompt, reference image, laki ng output, caching, at quality setting. Hiwalay na track ang quota ng ChatGPT plan sa API billing — hindi direktang nagiging API credit ang Plus subscription, kaya i-budget nang hiwalay ang dalawa kung pareho mong ginagamit.
Para sa high-volume na workflow, ang bilang na mahalaga ay ang gastos kada tinanggap na asset pagkatapos ng retry, hindi ang list price ng iisang pagsubok. Hindi talaga mas mura ang mas murang generation kung kailangan ng tatlong regeneration para maitama ang baybay o layout.
| Workflow | Praktikal na payo sa pag-prompt |
|---|---|
| Text-heavy na poster o diagram | Gumamit ng mas kaunting salita kada larawan, i-quote ang eksaktong copy, at tahasang tukuyin ang hierarchy. |
| Mga larawan ng produkto | I-lock ang hugis ng produkto, label, kulay, materyal, at anggulo ng camera; ulitin ang preserve list sa bawat edit pass. |
| UI mockup | Ilarawan ang screen bilang shipped interface — navigation, card, button, state — hindi bilang concept art. |
| Multi-reference na edit | Lagyan ng label ang bawat input image ayon sa papel: subject, style, background, outfit, o material reference. |
| Batch generation | Subaybayan ang gastos kada tinanggap na larawan, hindi ang gastos kada pagsubok. |
Kung gusto mong makita kung paano ikukumpara ang GPT Image 2 sa photorealism-first na alternatibo gamit ang magkakaparehong prompt, ang aming paghahambing ng GPT Image 2 vs. Nano Banana 2 ay nagpapatakbo ng anim na head-to-head round na may buong breakdown ng API at platform pricing.
Mula sa Larawan patungong Video: Kumpletuhin ang Iyong Creative Workflow sa PixVerse
Isang hakbang lang ang paggawa ng malakas na larawan. Sa paggawa nitong gumalaw kadalasang nasisira ang workflow — natatapos mo ang portrait o product poster sa GPT Image 2, pagkatapos ay kailangan mong magbukas ng hiwalay na tool, i-upload muli ang file, at umasang hindi babaluktutin ng video model ang maingat mong komposisyon. Ang friction sa handoff na iyon ang eksaktong inaalis ng PixVerse.
Live na ang GPT Image 2 sa PixVerse
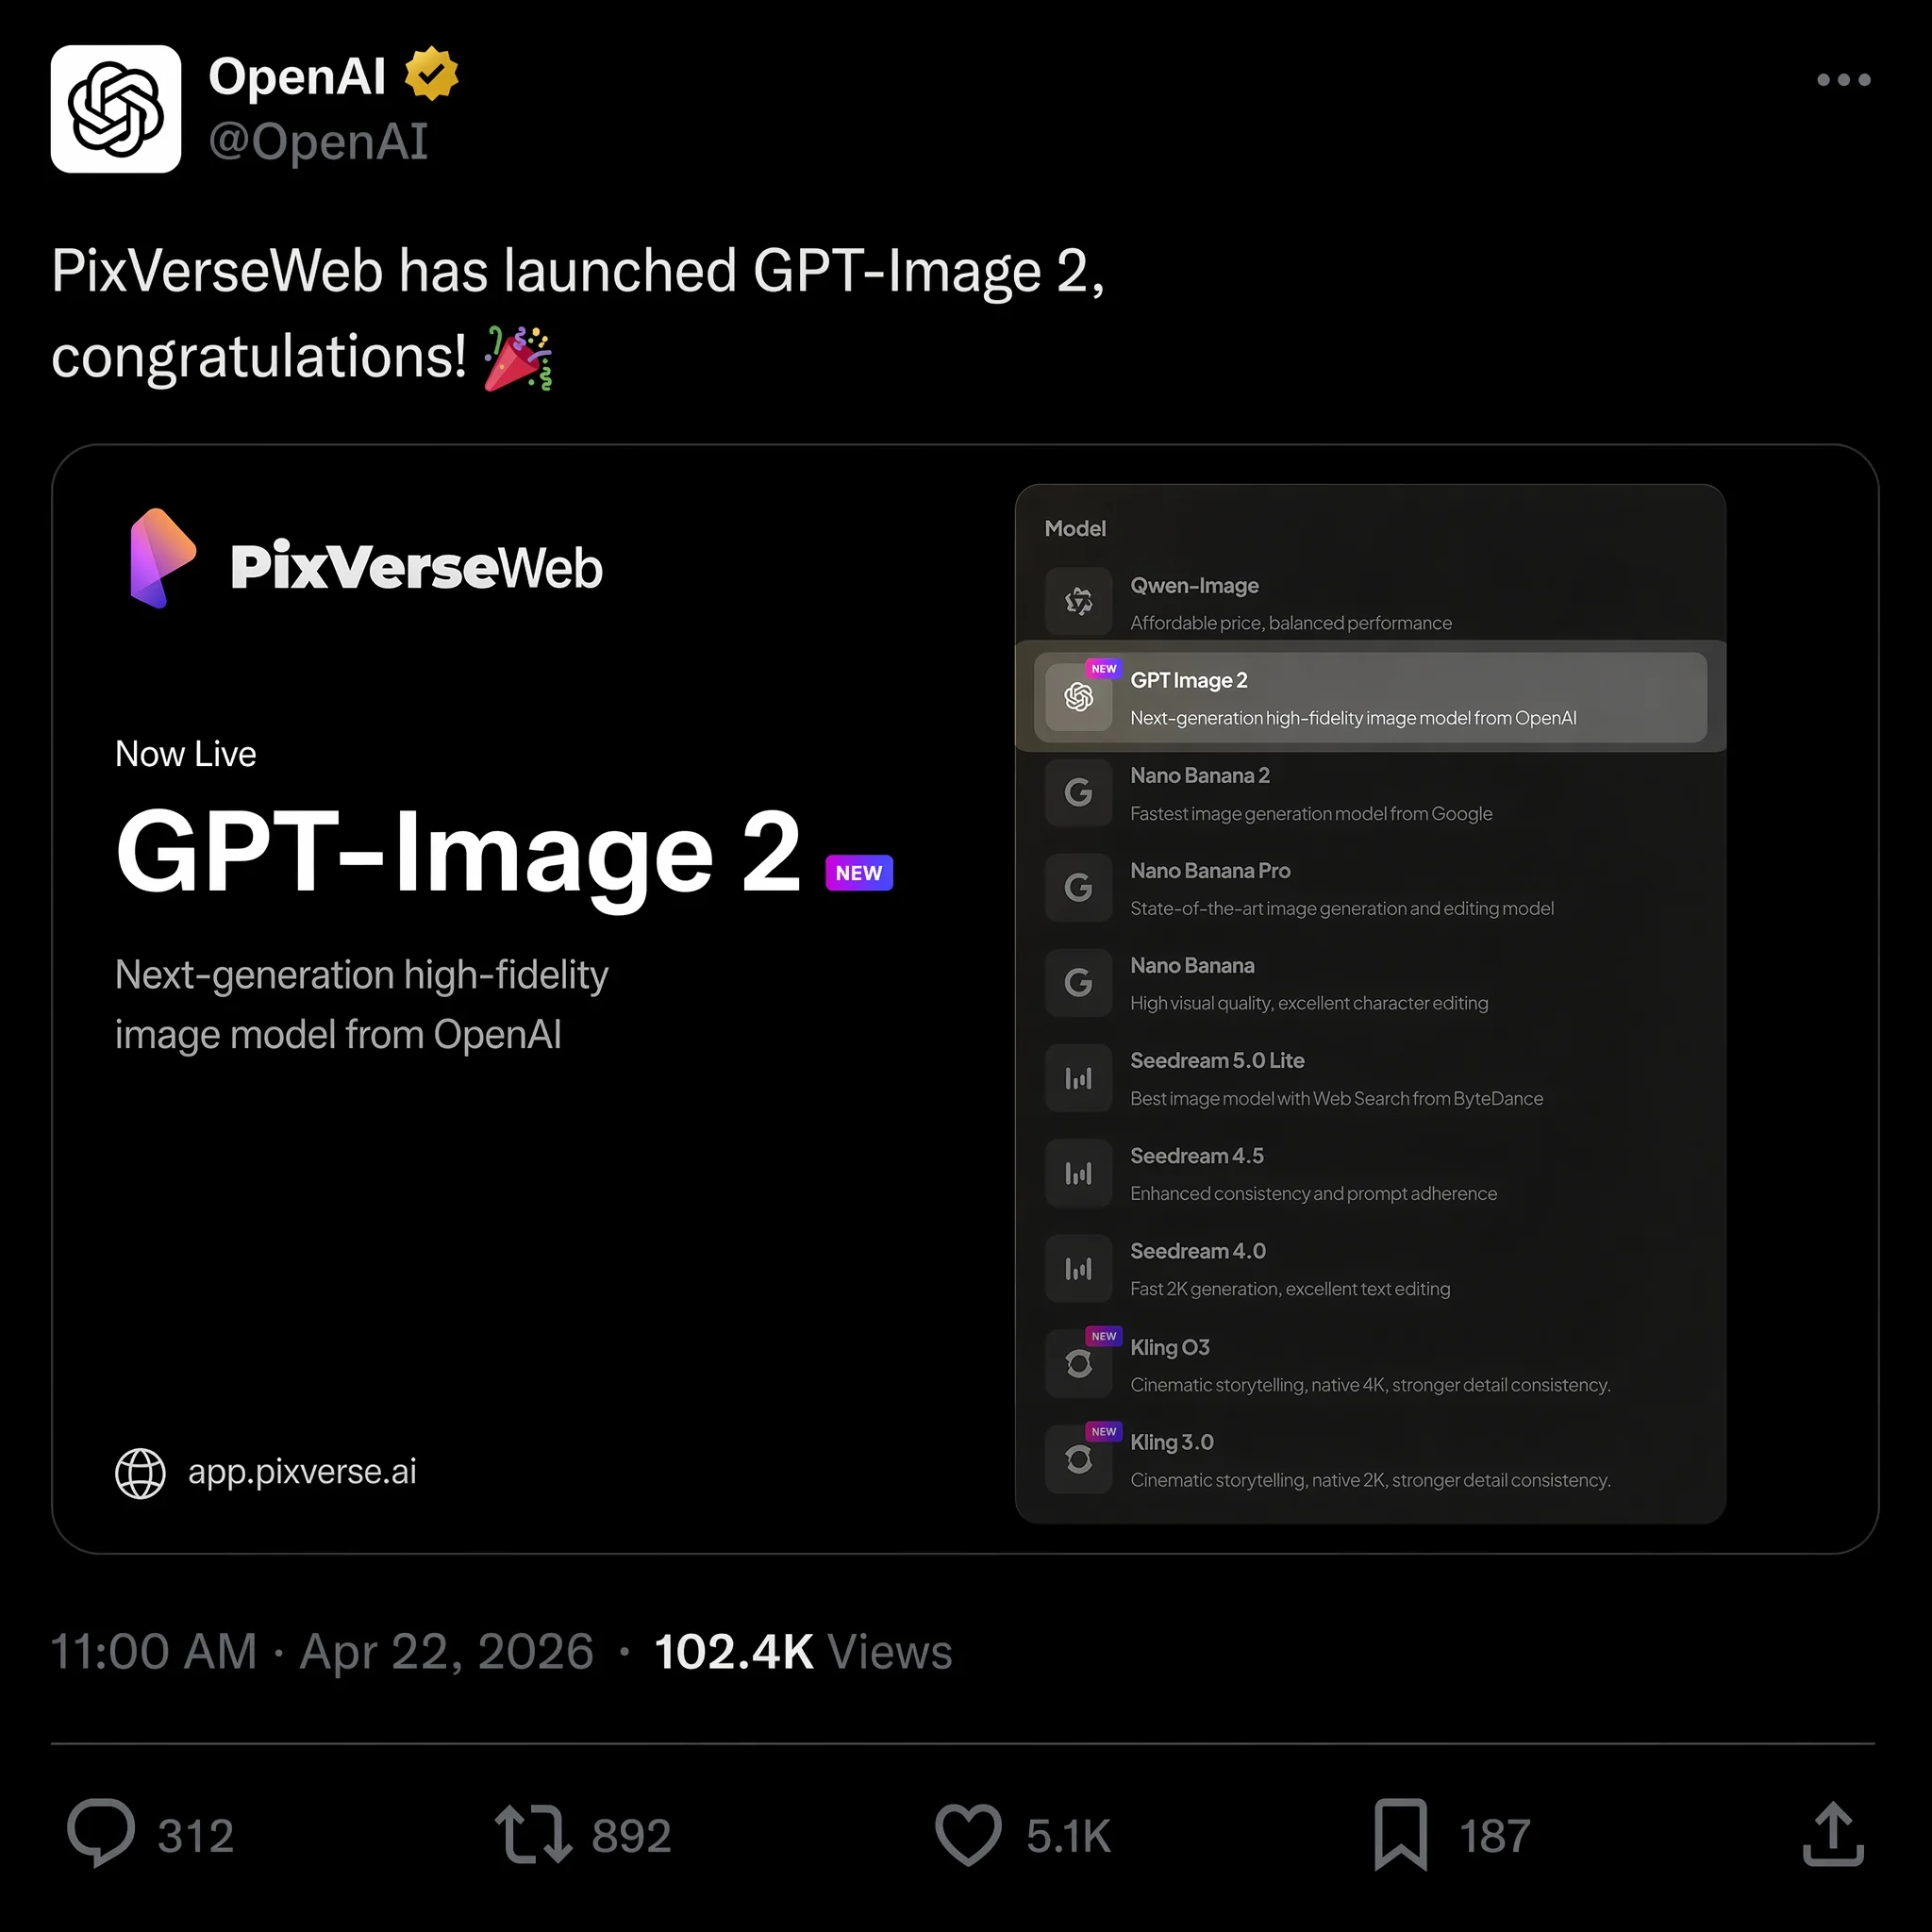
Noong Abril 22, 2026, idinagdag ng PixVerse ang GPT Image 2 bilang text-to-image na opsyon, kasama ang Nano Banana 2, Seedream, at HappyHorse 1.0 sa lineup ng model. Maaari kang gumawa ng larawan gamit ang GPT Image 2 at i-convert ito sa video sa iisang workspace, nang walang pag-download, muling pag-upload, o paglipat ng tab.
Mahalaga ito sa konkretong dahilan: kapag direktang pumapasok ang larawan sa image-to-video pipeline sa parehong platform, gumagana ang video model mula sa full-resolution source file at sa metadata nito nang direkta. Walang pagkawala ng kalidad mula sa compression o format conversion sa daan, kaya mas malinis ang galaw at mas kaunti ang artifact sa huling clip.
Kung ang still ay para maging clip, mag-prompt para sa motion-readiness mula sa simula — humingi ng depth ng foreground, midground, at background, malinis na silhouette ng subject, at isang pisikal na element na makatotohanang makakagalaw (alikabok, singaw, tela, nagbabagong pinagmumulan ng ilaw). Suriin ang still na parang tapos na design file bago ito i-animate: tingnan muna ang baybay, geometry ng produkto, at pagkakahanay ng UI, dahil hindi itatama ng video model ang maling baybay ng headline o baluktot na label nang mag-isa. Pagkatapos, sumulat ng hiwalay at mas maikling motion prompt na naglalarawan lang kung ano ang dapat gumalaw at kung ano ang dapat manatiling naka-lock, sa halip na ulitin ang buong image brief.
Bakit Lumilipat ang mga Creator sa All-in-One Platform
Kung ginagamit mo ang Sora ng OpenAI para sa video generation bago ang Marso 2026, alam mo na ang panganib ng pagtatayo ng workflow sa iisang tool. Isinara ng OpenAI ang Sora app at API noong Marso 24, dahil sa hindi sustainable na gastos at pivot patungo sa robotics, at libo-libong creator ang nawalan ng video pipeline nang magdamag. Tingnan ang aming gabay sa mga alternatibo sa Sora para sa buong breakdown ng nangyari at kung aling mga tool ang pumuno sa puwang.
Iba ang diskarte ng PixVerse: binibigyan ka nito ng access sa maraming model sa buong creative pipeline, sa halip na ikulong ka sa isa:
- Text-to-image gamit ang GPT Image 2, Nano Banana 2, Seedream, at iba pa — piliin ang model na akma sa trabaho
- Image-to-video na ginagawang galaw ang mga larawang ginawa mo, na may pagkakapare-pareho ng character at camera control
- Text-to-video para sa mga clip na direktang ginawa mula sa nakasulat na prompt gamit ang PixVerse V6 o ang cinematic na C1 model
- Native audio generation na awtomatikong sini-sync ang sound effect at dialogue sa iyong video
Ang praktikal na benepisyo: maaari kang pumunta mula sa nakasulat na konsepto patungo sa tapos na video na may synchronized audio nang hindi umaalis sa iisang workspace, na nag-aalis ng ilang oras ng file management sa bawat proyekto. Kung mas gusto mong i-script ang generation mula sa command line, saklaw ng gabay sa PixVerse CLI ang pag-automate ng parehong image at video generation.
Nag-aalok din ang PixVerse ng 30–60 libreng credit kada araw para sa mga bagong user, kaya masusubukan mo ang buong pipeline — mula sa image generation hanggang video output — bago mag-commit sa bayad na plan.
Mga Madalas Itanong
Libre bang gamitin ang GPT Image 2?
Ang mga libreng user ng ChatGPT ay maaaring gumawa ng humigit-kumulang dalawang larawan kada araw gamit ang GPT Image 2. Ang mga subscriber ng ChatGPT Plus ($20/buwan) ay may unlimited generation na may mas mabilis na processing. Ang API access ay sinisingil kada token sa image input, image output, at text input, kaya tumataas ang gastos kasabay ng haba ng prompt at laki ng output, hindi sa flat na bayad kada larawan.
Anong resolution ang sinusuportahan ng GPT Image 2?
Gumagawa ang GPT Image 2 ng mga larawan sa native na 2K resolution, na may opsyonal na 4K upscale sa pamamagitan ng API. Ang aspect ratio ay mula 3:1 hanggang 1:3, kaya available nang direkta ang square, vertical, at ultra-wide na format.
Kaya bang i-render nang tumpak ng GPT Image 2 ang text sa mga larawan?
Oo — isa ito sa pinakamalalakas nitong feature. Sa testing namin, lumampas sa 95% ang katumpakan ng text sa English, Chinese, Japanese, Korean, at Arabic sa unang generation attempt. Maaasahang hinahawakan ang multi-line na headline, title ng poster, at UI text label, bagama’t ang napakaliit na text sa mababang resolution ay maaari pa ring paminsan-minsang magkamali.
Paano ikukumpara ang GPT Image 2 sa Midjourney at Nano Banana 2?
Mas malakas ang artistic style control ng Midjourney V8 at mas matatag ang komunidad nito para sa aesthetic refinement. Ang Nano Banana 2 ang mas malakas na pagpipilian para sa photorealism, cinematic lighting, at mabilis na iteration. May edge ang GPT Image 2 sa text rendering, structured layout, at natural-language editing. Para sa poster design at marketing material na may text, kasalukuyang panalo ang GPT Image 2; para sa purong artistic exploration o photoreal hero shot, sulit na direktang ikumpara ang dalawa pa — tingnan ang aming head-to-head test laban sa Nano Banana 2.
Ano ang pinakamahusay na alternatibo sa Sora para sa video pagkatapos ng shutdown?
Pagkatapos isara ng OpenAI ang Sora noong Marso 2026, kabilang sa nangungunang alternatibo ang PixVerse V6 para sa character-consistent na multi-shot video, ang Runway Gen-4 para sa cinematic camera control, at ang Kling v3.0 para sa action sequence. Ang PixVerse lang ang platform na pinagsasama ang text-to-image, image-to-video, at text-to-video na may native audio, lahat ay accessible gamit ang libreng credit kada araw. Tingnan ang aming buong gabay sa mga alternatibo sa Sora para sa detalyadong paghahambing.
Maaari ko bang gawing video ang mga output ng GPT Image 2?
Oo. Dahil available ang GPT Image 2 sa PixVerse, maaari mong gawin ang larawan sa loob ng app at i-convert ito sa video gamit ang image-to-video pipeline sa parehong workspace, nang hindi kailangan ng file transfer. Maaari mo ring i-upload ang GPT Image 2 file na ginawa sa ibang lugar at ipasa ito sa parehong pipeline.