GPT Image 2: Análise e Guia de Prompts em 2026
A OpenAI lançou o GPT Image 2 em 21 de abril de 2026 — o sucessor do GPT Image 1.5 e o modelo que agora alimenta a geração de imagens em todo o ChatGPT. Testamos o modelo durante a semana de lançamento e voltamos a testá-lo no final de junho com um conjunto mais amplo de prompts, o guia oficial de prompts da OpenAI e os preços publicados da API, para ver como o modelo se sai depois que o burburinho inicial diminui.
Principais Conclusões:
- O GPT Image 2 gera imagens em resolução nativa 2K, com upscaling opcional para 4K, e a precisão na renderização de texto fica acima de 95% em escritas latina, chinesa, japonesa, coreana e árabe.
- O modelo é melhor tratado como um assistente de design do que como um gerador de fotos: ele se destaca em tarefas com um padrão de sucesso claro — texto exato, layout fixo, estrutura de painéis repetível — e fica menos previsível em prompts abertos do tipo “deixe bonito”.
- A reprodução de logotipos de marca, textos legais pequenos e fontes proprietárias continuam sendo pontos fracos que ainda exigem revisão manual.
- A API da OpenAI cobra o GPT Image 2 por token, considerando entrada de imagem, entrada de imagem em cache, saída de imagem, entrada de texto e entrada de texto em cache — um modelo de preços diferente das faixas por imagem usadas por alguns concorrentes.
- O PixVerse inclui o GPT Image 2 em sua linha de texto-para-imagem, ao lado do Nano Banana 2 e do Seedream, para que uma imagem gerada possa seguir diretamente para um pipeline de imagem-para-vídeo sem sair do workspace.
O Que É o GPT Image 2? Principais Recursos e Limitações
O GPT Image 2 é o modelo de imagem de segunda geração da OpenAI, substituindo o GPT Image 1.5 tanto no ChatGPT quanto na API. Ele compete com Midjourney, DALL-E 3 e Stable Diffusion, mas constrói sua identidade em torno de duas coisas: texto preciso dentro das imagens e uma camada de raciocínio que interpreta a intenção do prompt em vez de apenas combinar palavras-chave.
Principais Recursos em Resumo
| Recurso | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Resolução nativa | 2K (com upscale para 4K) | 1K | 2K (com flag —hd) |
| Precisão na renderização de texto | 95%+ multilíngue | ~70% (apenas latim) | ~80% (apenas latim) |
| Integração de raciocínio | Sim — interpreta instruções em camadas | Não | Não |
| Faixa de proporção | 3:1 a 1:3 | 1:1, 16:9 | 1:1 a 3:2 |
| Consistência de personagem | Nível de pixel entre imagens sequenciais | Limitada | Moderada (flag —cref) |
| Edição em linguagem natural | Sim — edita regiões descrevendo-as | Não | Não |
| Preços | Baseado em tokens via API; planos do ChatGPT | Mesmo | Assinatura de $10–30/mês |
A renderização de texto é o recurso que mais chama atenção, e com razão. Modelos de imagem mais antigos tratavam o texto como textura — pedir um título de pôster resultava em ruído com formato de letras. O GPT Image 2 lida com títulos em inglês de várias linhas, caracteres chineses e layouts multilíngues com consistência real; em nossos testes, cerca de 19 em 20 gerações voltaram totalmente legíveis na primeira tentativa.
Integração de raciocínio significa que o modelo faz mais do que apenas reconhecer padrões nas suas palavras. Peça para “gerar um infográfico mostrando atividades para o clima de amanhã em São Francisco”, e ele buscará a previsão, escolherá atividades relevantes e construirá um layout em torno desses dados — um passo além de como o Midjourney ou o Stable Diffusion processam um prompt.
Edição em linguagem natural permite revisar uma imagem descrevendo a mudança em vez de mascará-la manualmente. “Mova a xícara de café para o lado esquerdo da mesa” ou “mude o céu para um pôr do sol” aplicam-se como edições direcionadas, sem regenerar toda a cena.
O Que os Usuários Estão Dizendo
O feedback desde o lançamento tem sido, em geral, positivo, com um conjunto consistente de reclamações. Testes de retratos circulando no X e no Reddit parecem próximos de fotografia de estúdio, e designers de pôsteres testando layouts de formato longo — panfletos, cardápios, sinalização — relatam que a precisão do texto finalmente se sustenta em uso real. Vários designers observaram que puderam pular uma etapa no Photoshop para materiais básicos de marketing, porque o próprio senso de composição do modelo é forte o suficiente para tomar decisões de layout sem assistência.
O elogio mais forte gira em torno da aderência ao prompt: peça 15 elementos específicos em uma cena e o GPT Image 2 tende a incluir todos eles, enquanto modelos mais antigos começavam a descartar detalhes à medida que os prompts ficavam mais longos.
No lado negativo, a fidelidade de marca ainda é inconsistente. Um teste prático amplamente divulgado pela ZDNet mostrou o modelo falhando ao reproduzir o logotipo da ZDNET com precisão, e outros usuários relataram o mesmo com marcas específicas. O modelo entende o que um logotipo é conceitualmente, mas não reproduz com confiabilidade formas vetoriais exatas ou tipografias proprietárias.
Limitações Conhecidas
- Reprodução de logotipos de marca não é confiável — componha logotipos exatos no Photoshop ou Figma após a geração, em vez de solicitá-los diretamente no prompt.
- Velocidade de geração fica atrás de modelos mais leves, como FLUX ou Nano Banana 2, com 30–60 segundos típicos no ChatGPT Plus, contra menos de 10 segundos em outros lugares.
- Limites de uso no plano gratuito são apertados — aproximadamente duas imagens por dia para usuários gratuitos do ChatGPT. Assinantes do Plus têm gerações ilimitadas no ChatGPT, mas os custos de API escalam com o volume.
- Controle de estilo é mais grosseiro do que o do Midjourney. Não é possível ajustar tipo de filme, tipo de lente ou granulação com a mesma precisão, e o viés estético próprio do modelo exige trabalho deliberado no prompt para ser superado.
- Política de conteúdo é mais rígida do que alternativas de código aberto, então alguns prompts que funcionam bem no Stable Diffusion ou em modelos locais serão recusados aqui.
Nada disso descarta o uso em produção, mas vale a pena saber antes de construir um pipeline em torno de um único modelo.
Como Escrever Prompts para o GPT Image 2 Que Realmente Funcionam
A mudança mais clara em nossa segunda rodada de testes: os melhores prompts para o GPT Image 2 não apenas descrevem uma imagem — eles descrevem a tarefa que a imagem precisa cumprir. Um prompt de anúncio social deve ser escrito de forma diferente de um recorte de produto, um infográfico, uma tela de UI ou um primeiro quadro destinado a vídeo.
Um padrão confiável para estruturar o briefing:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
Nomeie a tarefa antes do estilo
Comece pelo tipo de saída — pôster, anúncio de produto, tela de aplicativo, ficha de personagem, diagrama, edição ou primeiro quadro de vídeo — para que o modelo saiba qual padrão está sendo usado para julgá-lo.
Fraco: A cool futuristic speaker, cinematic, high detail.
Melhor: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
A segunda versão diz ao modelo que ele está sendo julgado por layout e usabilidade, não apenas por estética.
Trate o texto como um ativo travado
Coloque qualquer texto obrigatório entre aspas e diga exatamente como ele deve ser renderizado — não peça por “um slogan”, a menos que queira que o modelo invente palavras por conta própria.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
Para textos mais longos, separe cada linha explicitamente no prompt. Se uma palavra voltar com erro de ortografia, regenere com texto mais curto, tipo maior e uma instrução mais rígida do tipo “apenas o texto exato”.
Dê ao modelo uma câmera e um layout
Especifique diretamente a distância da câmera, o ângulo, o posicionamento do assunto, o espaço negativo e a proporção de tela — o GPT Image 2 segue bem as indicações de composição, mas apenas quando elas são explicitadas.
- Close-up para textura de produto, mãos, rostos, materiais, rótulos.
- Plano aberto para ambientes, cenas narrativas, pôsteres de cidade, quadros prontos para vídeo.
- De cima para baixo para comida, cenas de mesa, flat-lays, kits de embalagem.
- Terço esquerdo / terço direito para layouts de anúncio que equilibram texto e produto.
- Grade limpa para mockups de UI, fichas de personagem, diagramas, infográficos.
Escreva edições em três frases
Os prompts de edição mais fortes separam a mudança do que deve permanecer intocado e do realismo físico que os conecta:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
Essa estrutura de “mudar, preservar, combinar” supera consistentemente um pedido vago de “deixe isso melhor”.
Adicione uma indicação de movimento se a imagem estática virar vídeo
Se uma imagem puder alimentar posteriormente um pipeline de imagem-para-vídeo do PixVerse, solicite profundidade e prontidão para movimento desde o início: primeiro plano, plano médio, fundo, uma silhueta de assunto limpa e um indício visível que possa se mover — poeira, tecido, cabelo, chuva, reflexo ou um trajeto de câmera em avanço.
Em vez de: An astronaut in a desert.
Use: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
Como Testamos o GPT Image 2
Nas duas rodadas de testes, submetemos o modelo a retratos, pôsteres com muito texto, composições estilo produto, fichas de personagem, mockups de UI e cenas narrativas experimentais. O objetivo não era uma pontuação de benchmark — era saber se um designer, profissional de marketing ou criador poderia entregar o resultado com pequenos ajustes, em vez de reconstruir o ativo do zero.
| Área de teste | O que verificamos |
|---|---|
| Retratos e still cinematográfico | Controle de iluminação, textura de pele, reflexos, atmosfera, consistência de cena |
| Layouts de pôster e tipografia | Ortografia do título, texto em várias linhas, hierarquia, espaço negativo, acabamento tipo marca |
| Fichas de personagem e conceito | Consistência multi-visão, detalhe de figurino, alinhamento de paleta, precisão de rótulos |
| Mockups de UI e redes sociais | Realismo de layout, texto pequeno, espaçamento de ícones, grades de feed, credibilidade de captura de tela |
| Prompts experimentais | Humor, raciocínio narrativo, posicionamento de objetos, precisão de legendas pequenas |
O padrão se manteve nas duas rodadas: o GPT Image 2 recompensa mais um briefing preciso do que uma cadeia de palavras-chave. Quando um prompt nomeia a tarefa e define sucesso — texto exato, layout fixo, estrutura de painéis repetível — o modelo tende a preservar a estrutura. Quando um prompt pede apenas uma atmosfera vaga, o resultado ainda pode parecer bem-acabado, mas é mais difícil de reutilizar sem edições.
Casos de Uso do GPT Image 2 com Exemplos de Prompt
Testamos ao limite cinco capacidades distintas nestes cenários: controle de iluminação, tipografia de texto exato, composição com múltiplos elementos, consistência de personagem e layout de UI. Cada prompt abaixo está pronto para copiar e adaptar.
Fotografia de Retrato Cinematográfico
Isto verifica a compreensão do modelo sobre iluminação, atmosfera e composição contida — os fundamentos que separam uma imagem pronta para portfólio de uma renderização genérica de IA.
Prompt:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
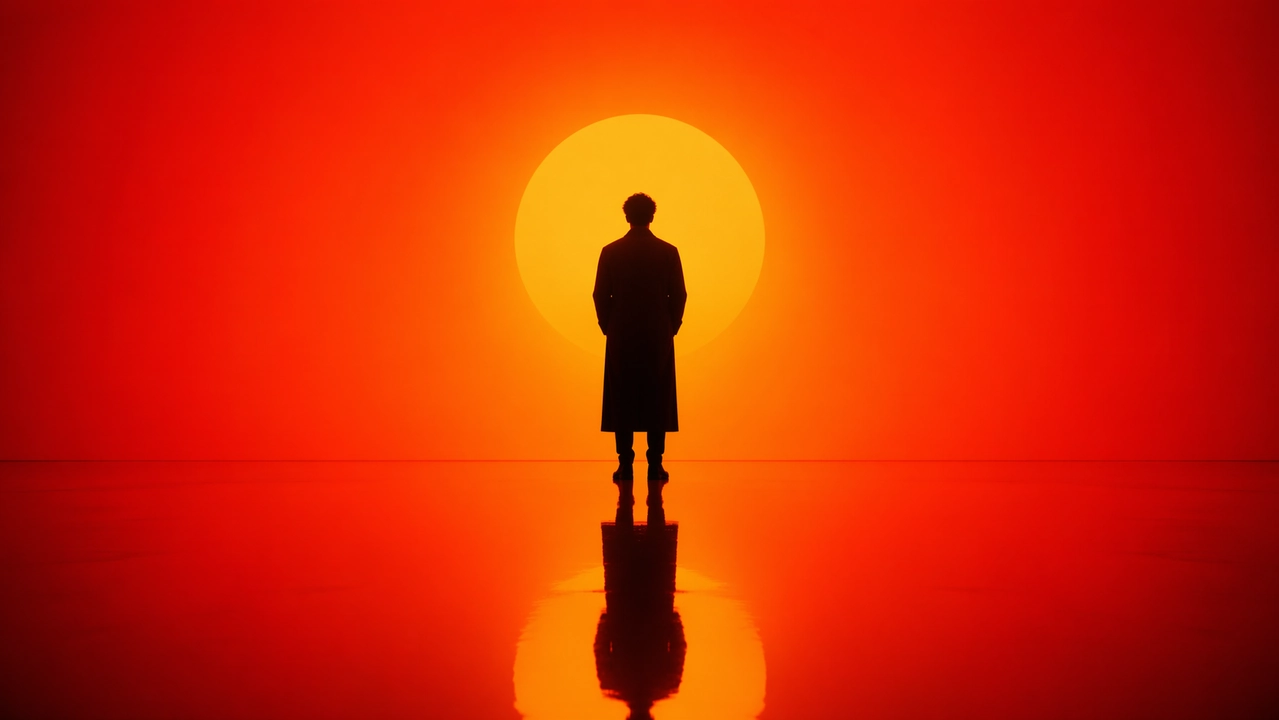
O que observar: bordas de silhueta limpas sem artefatos de halo, um reflexo de piso preciso com perspectiva correta, um gradiente suave (sem faixas) e uma pose que carrega peso real em vez de parecer rígida ou flutuante.
Design de Pôster e Ilustração de Cidade
O teste de estresse mais difícil para tipografia legível combinada com uma composição densa e multi-elementos — mais de dez elementos visuais distintos organizados ao longo de uma curva em S, com texto em inglês que precisa sobreviver intacto à renderização.
Prompt:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
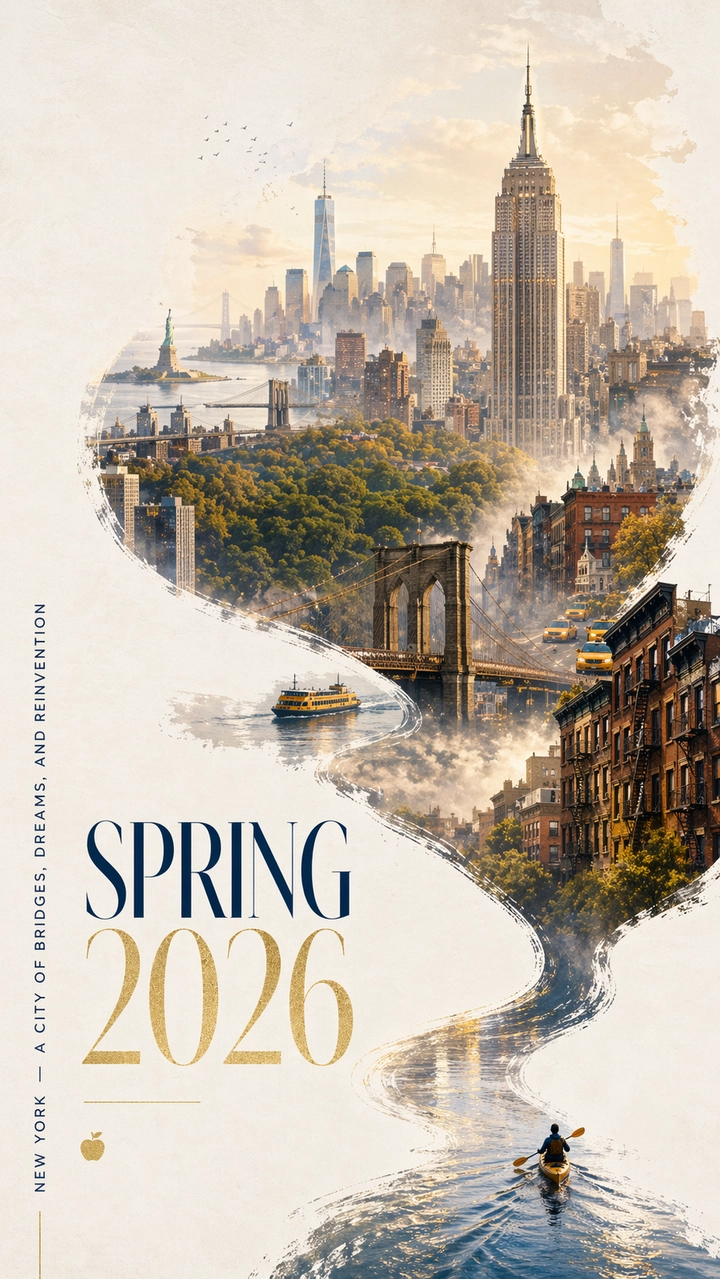
O que observar: cada letra do título e do slogan deve estar legível e corretamente grafada, a curva em S deve fluir naturalmente do caiaque ao horizonte, edifícios marcantes devem ser reconhecíveis em vez de torres genéricas, e o espaço negativo deve parecer intencional, e não vazio.
Design de Personagem e Ficha de Referência
Desenvolvedores de jogos e artistas conceituais precisam de consistência multi-visão em uma única geração. Isto verifica se o modelo consegue manter o design de um personagem estável entre as visões frontal, lateral e traseira.
Prompt:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
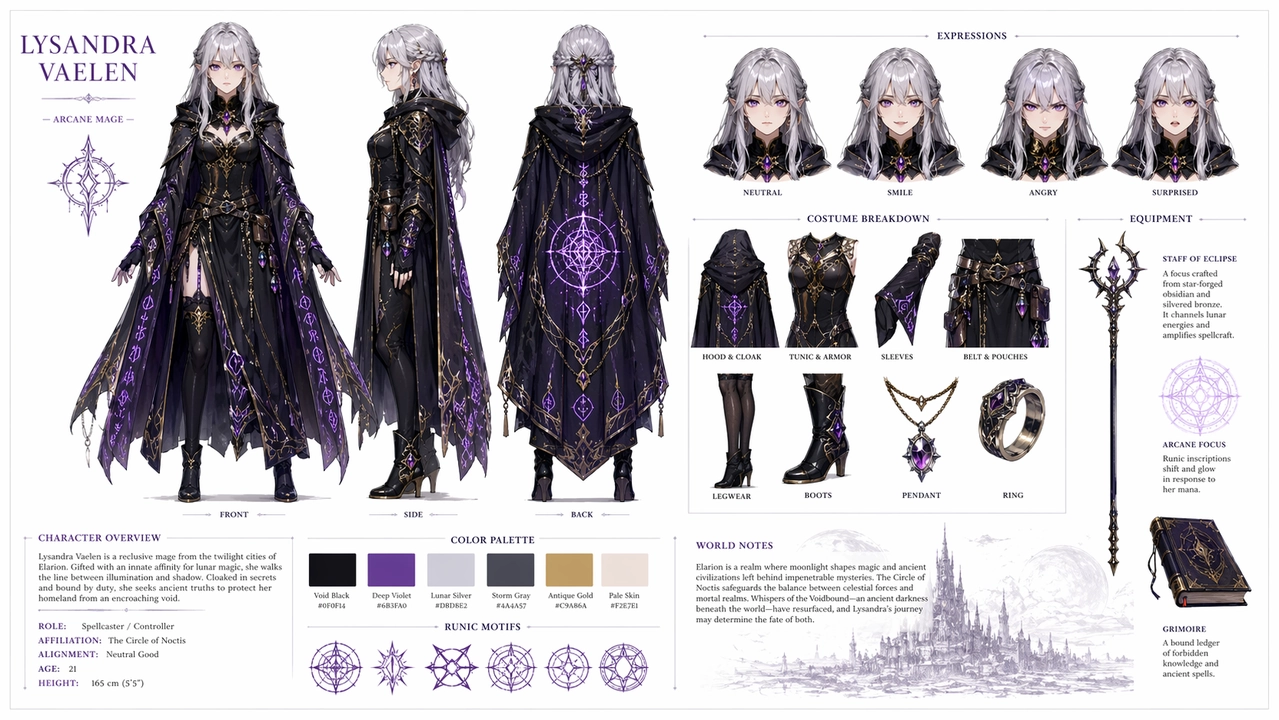
O que observar: rosto, cabelo e roupa devem permanecer consistentes nas três visões; as variações de expressão devem alterar apenas o rosto, não o penteado ou a roupa; a amostra de paleta deve realmente corresponder às cores usadas na arte; e os rótulos de texto devem estar corretamente grafados. Se uma visão lateral ou traseira apresentar desvio, regenere com linguagem de “preservação” mais forte, repetindo os pontos de ancoragem de identidade.
Mockup de UI e Redes Sociais
Isto exige três coisas ao mesmo tempo: layout de UI com precisão de pixel, renderização de texto multilíngue e fusão criativa de conceitos — o tipo de conteúdo que também costuma performar bem em plataformas sociais.
Prompt:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
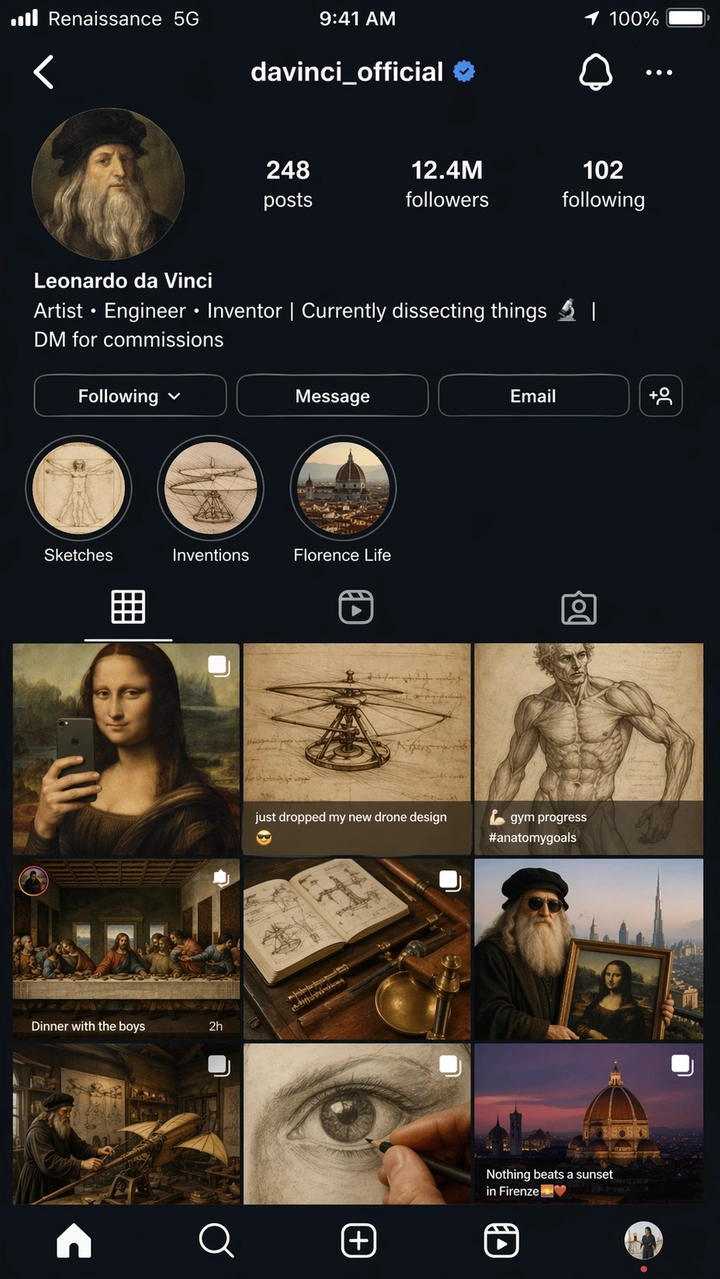
O que observar: os elementos de UI do Instagram — espaçamento da grade, layout do perfil, círculos de stories, barra de abas — devem parecer uma captura de tela real do iOS, e não uma aproximação estilizada. Todo o texto deve ser legível, e o rótulo de operadora “Renaissance 5G” é uma verificação deliberada de precisão. Trate qualquer resultado de mockup de UI como referência de conceito, e não como UI pronta para produção; rótulos pequenos e alinhamento de ícones geralmente precisam de uma etapa de acabamento.
Arte Criativa e Experimental
Prompts curtos com humor narrativo embutido testam se o modelo preenche lacunas criativas por conta própria, em vez de depender de instruções exaustivas.
Prompt:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
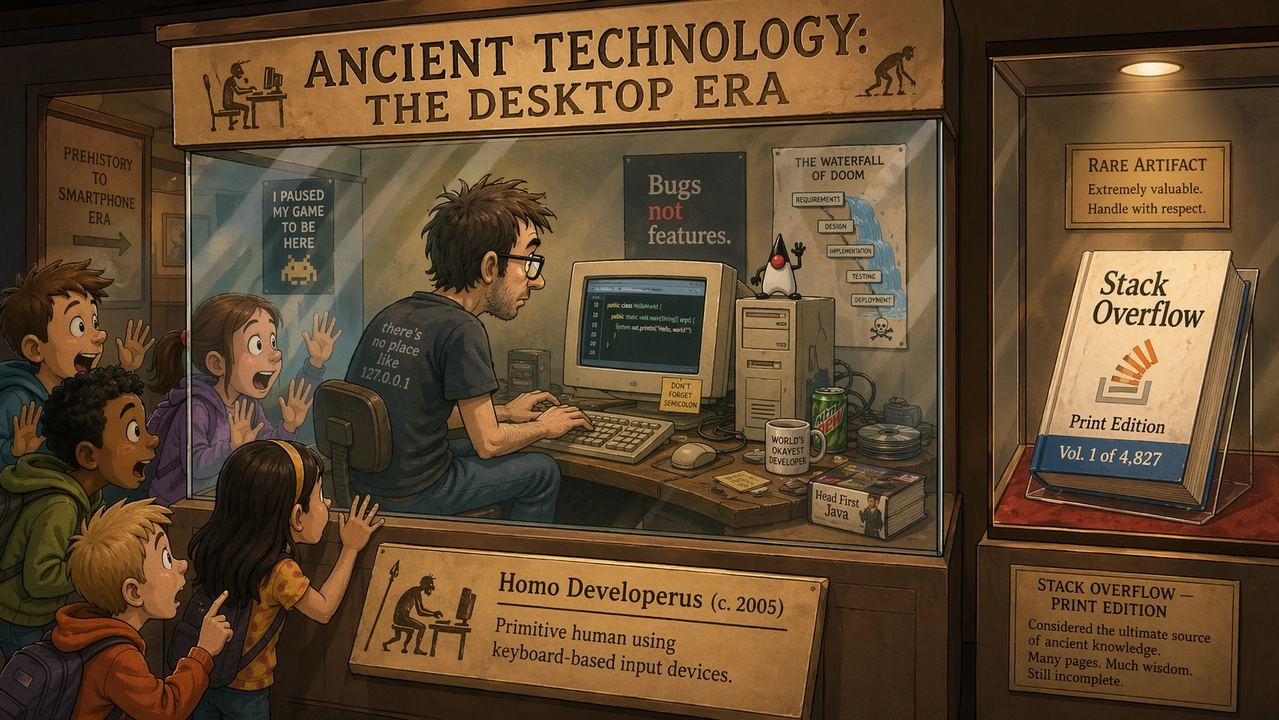
O que observar: o humor deve funcionar através dos detalhes visuais, não apenas do texto da legenda. A placa e o título do livro precisam permanecer legíveis e corretamente grafados — um teste genuinamente difícil para texto em várias linhas em tamanhos pequenos — e o estilo cartoon deve parecer coeso em toda a cena, em vez de fotorrealista em partes.
Resultados de Teste por Caso de Uso
Os resultados mais fortes vieram consistentemente de prompts com um padrão de produção óbvio — algo julgável por ortografia, layout, preservação de objetos ou ordem de painéis. Prompts vagos, focados apenas em atmosfera, produziram resultados mais variáveis.
| Caso de uso | O que funcionou bem | O que ainda precisa de revisão |
|---|---|---|
| Renderização de texto | Títulos grandes, rótulos curtos, títulos de pôster e rótulos simples de UI permaneceram precisos quando o texto exato foi citado. | Textos legais pequenos, parágrafos densos e fontes estilizadas ainda podem falhar — mantenha o texto curto e verifique cada letra. |
| Imagens de produto | Layouts de anúncio limpos, espaço negativo de campanha e composições focadas no produto renderizaram bem. | Rótulos reais, logotipos e alegações regulamentadas ainda precisam de revisão manual ou composição a partir de ativos aprovados. |
| Mockups de UI | Telas móveis, painéis e hierarquia de estilo de aplicativo pareceram plausíveis quando o prompt nomeou elementos reais de interface. | Trate os resultados como mockups de conceito — rótulos pequenos e alinhamento de ícones geralmente precisam de limpeza. |
| Consistência de personagem | Fichas de personagem, linhas de expressão e amostras de paleta funcionaram bem como referências criativas. | Rostos e detalhes de figurino podem apresentar desvio entre visões; repita os pontos de ancoragem de identidade e regenere se necessário. |
| Edição e composição | O padrão “mudar, preservar, combinar” superou pedidos de edição amplos. | Limites de seleção e saída com fundo transparente ainda precisam de controle de qualidade. |
Erros Comuns ao Criar Prompts para o GPT Image 2
- Pedir texto preciso sem fornecer o texto exato. Se o texto importa, escreva-o textualmente e diga onde ele deve aparecer.
- Sobrecarregar um único prompt com todos os detalhes possíveis. Comece com a cena principal e depois refine uma variável de cada vez.
- Esquecer de declarar invariantes durante edições. Especifique o que deve permanecer inalterado: identidade, fundo, pose, iluminação, forma do produto, texto do rótulo, ângulo de câmera.
- Depender de palavras decorativas de qualidade para tarefas funcionais. “Bonito” não torna um rótulo legível — use frases como “texto de rótulo nítido” ou “legível à distância”.
- Ignorar a proporção de tela. Uma imagem quadrada forte ainda pode falhar como anúncio vertical ou miniatura de vídeo.
- Tratar logotipos como texto comum. O GPT Image 2 pode projetar conceitos de logotipo, mas marcas exatas devem ser compostas a partir de ativos aprovados, em vez de solicitadas diretamente.
Notas sobre API e Preços do GPT Image 2
A página de preços da API da OpenAI lista o GPT Image 2 com base em tokens, em vez de uma taxa fixa por imagem:
| Item | Preço listado |
|---|---|
| Entrada de imagem | $8.00 / 1M tokens |
| Entrada de imagem em cache | $2.00 / 1M tokens |
| Saída de imagem | $30.00 / 1M tokens |
| Entrada de texto | $5.00 / 1M tokens |
| Entrada de texto em cache | $1.25 / 1M tokens |
O custo real por imagem depende do comprimento do prompt, das imagens de referência, do tamanho de saída, do cache e da configuração de qualidade. As cotas do plano do ChatGPT são uma trilha separada da cobrança da API — uma assinatura Plus não se converte diretamente em crédito de API, então orce os dois de forma independente se você usa ambos.
Para fluxos de trabalho de alto volume, o número que importa é o custo por ativo aceito após novas tentativas, não o preço de tabela de uma única tentativa. Uma geração mais barata não é de fato mais barata se precisar de três regenerações para acertar a ortografia ou o layout.
| Fluxo de trabalho | Conselho prático de prompt |
|---|---|
| Pôsteres ou diagramas com muito texto | Use menos palavras por imagem, cite o texto exato, especifique a hierarquia explicitamente. |
| Fotos de produto | Trave a forma do produto, o rótulo, a cor, o material e o ângulo de câmera; repita a lista de preservação em cada etapa de edição. |
| Mockups de UI | Descreva a tela como uma interface já lançada — navegação, cartões, botões, estados — e não como arte conceitual. |
| Edições com múltiplas referências | Rotule cada imagem de entrada por função: referência de assunto, estilo, fundo ou material. |
| Geração em lote | Acompanhe o custo por imagem aceita, não o custo por tentativa. |
Se você quiser ver como o GPT Image 2 se compara a uma alternativa focada em fotorrealismo com os mesmos prompts, nossa comparação entre GPT Image 2 e Nano Banana 2 traz seis rodadas diretas com detalhamento completo de preços de API e plataforma.
Da Imagem ao Vídeo: Complete Seu Fluxo Criativo no PixVerse
Gerar uma imagem forte é uma etapa. Transformá-la em movimento é onde a maioria dos fluxos de trabalho falha — você termina um retrato ou um pôster de produto no GPT Image 2, depois precisa abrir uma ferramenta separada, reenviar o arquivo e torcer para que o modelo de vídeo não distorça sua imagem cuidadosamente composta. Esse atrito de transferência é exatamente o que o PixVerse elimina.
O GPT Image 2 Já Está Disponível no PixVerse
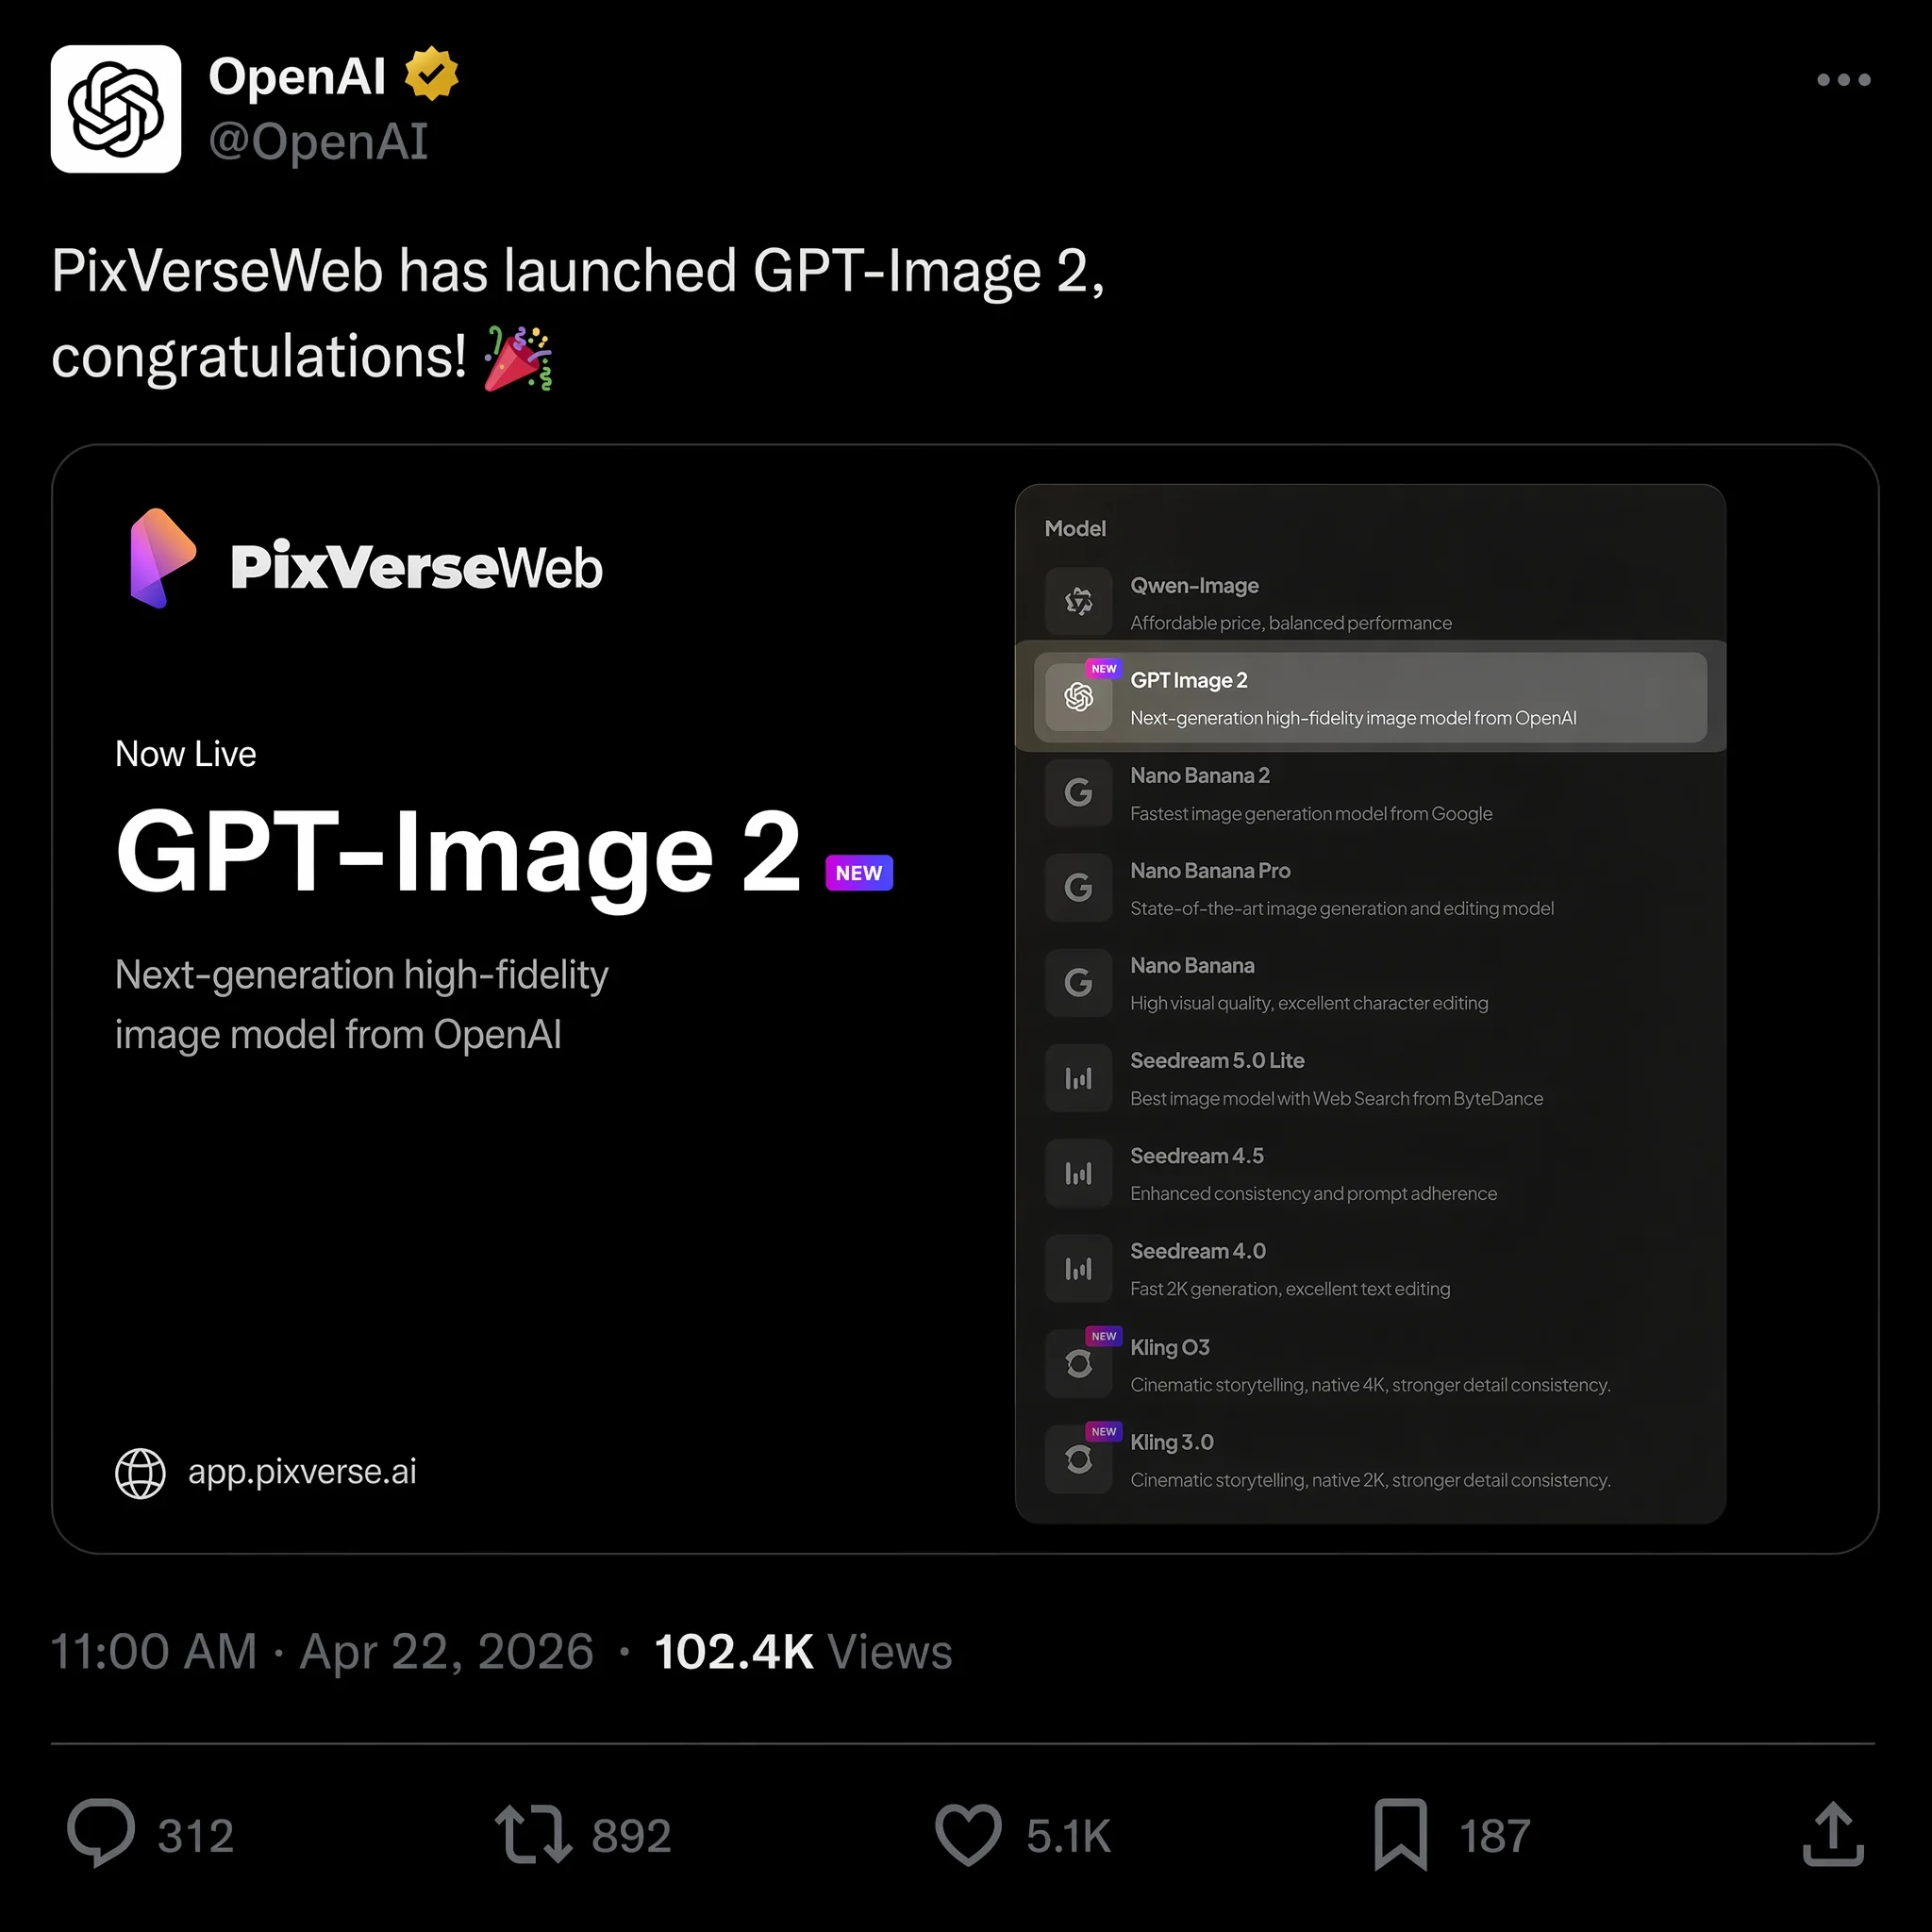
Em 22 de abril de 2026, o PixVerse adicionou o GPT Image 2 como opção de texto-para-imagem, unindo-se ao Nano Banana 2, ao Seedream e ao HappyHorse 1.0 na linha de modelos. Você pode gerar uma imagem com o GPT Image 2 e convertê-la em vídeo no mesmo workspace, sem baixar, reenviar ou trocar de aba.
Isso importa por um motivo concreto: quando a imagem alimenta diretamente um pipeline de imagem-para-vídeo na mesma plataforma, o modelo de vídeo trabalha diretamente a partir do arquivo-fonte em resolução completa e de seus metadados. Não há perda de qualidade por compressão ou conversão de formato ao longo do caminho, o que significa movimento mais limpo e menos artefatos no clipe final.
Se uma imagem estática está destinada a se tornar um clipe, solicite prontidão para movimento desde o início — peça profundidade em primeiro plano, plano médio e fundo, uma silhueta de assunto limpa e um elemento físico que possa plausivelmente se mover (poeira, vapor, tecido, uma fonte de luz mutável). Revise a imagem estática como um arquivo de design finalizado antes de animá-la: verifique primeiro a ortografia, a geometria do produto e o alinhamento de UI, já que um modelo de vídeo não corrigirá sozinho um título mal escrito ou um rótulo distorcido. Em seguida, escreva um prompt de movimento separado e mais curto, descrevendo apenas o que deve se mover e o que deve permanecer travado, em vez de repetir todo o briefing da imagem.
Por Que os Criadores Estão Migrando para uma Plataforma Tudo-em-Um
Se você usava o Sora, da OpenAI, para geração de vídeo antes de março de 2026, já conhece o risco de construir um fluxo de trabalho em torno de uma única ferramenta. A OpenAI encerrou o aplicativo e a API do Sora em 24 de março, citando custos insustentáveis e um pivô em direção à robótica, e milhares de criadores perderam seu pipeline de vídeo da noite para o dia. Veja nosso guia de alternativas ao Sora para um panorama completo do que aconteceu e quais ferramentas preencheram a lacuna.
O PixVerse adota uma abordagem diferente, dando acesso a múltiplos modelos em todo o pipeline criativo, em vez de prender você a um único:
- Texto-para-imagem com GPT Image 2, Nano Banana 2, Seedream e mais — escolha o modelo certo para a tarefa
- Imagem-para-vídeo que converte suas imagens geradas em movimento com consistência de personagem e controle de câmera
- Texto-para-vídeo para clipes gerados diretamente a partir de um prompt escrito, usando o PixVerse V6 ou o cinematográfico modelo C1
- Geração nativa de áudio que sincroniza efeitos sonoros e diálogos ao seu vídeo automaticamente
O benefício prático: você pode ir de um conceito escrito a um vídeo finalizado com áudio sincronizado sem sair de um único workspace, o que elimina horas de gerenciamento de arquivos de cada projeto. Se preferir programar a geração pela linha de comando, o guia da CLI do PixVerse cobre a automação tanto da geração de imagens quanto de vídeos.
O PixVerse também oferece de 30 a 60 créditos gratuitos diários para novos usuários, para que você possa testar todo o pipeline — da geração de imagem à saída de vídeo — antes de assumir um plano pago.
Perguntas Frequentes
O GPT Image 2 é gratuito?
Usuários gratuitos do ChatGPT podem gerar aproximadamente duas imagens por dia com o GPT Image 2. Assinantes do ChatGPT Plus ($20/mês) têm gerações ilimitadas com processamento mais rápido. O acesso via API é cobrado por token entre entrada de imagem, saída de imagem e entrada de texto, então o custo escala com o comprimento do prompt e o tamanho da saída, em vez de uma tarifa fixa por imagem.
Qual resolução o GPT Image 2 suporta?
O GPT Image 2 gera imagens em resolução nativa 2K, com upscale opcional para 4K através da API. As proporções variam de 3:1 a 1:3, então formatos quadrado, vertical e ultra-largo estão todos disponíveis diretamente.
O GPT Image 2 consegue renderizar texto em imagens com precisão?
Sim — esse é um de seus recursos mais fortes. Em nossos testes, a precisão do texto em inglês, chinês, japonês, coreano e árabe superou 95% na primeira tentativa de geração. Títulos com várias linhas, títulos de pôster e rótulos de texto de UI são tratados com confiabilidade, embora textos muito pequenos em resoluções baixas ainda possam falhar ocasionalmente.
Como o GPT Image 2 se compara ao Midjourney e ao Nano Banana 2?
O Midjourney V8 tem controles de estilo artístico mais fortes e uma comunidade mais estabelecida para refinamento estético. O Nano Banana 2 é a escolha mais forte para fotorrealismo, iluminação cinematográfica e iteração rápida. O GPT Image 2 leva vantagem em renderização de texto, layouts estruturados e edição em linguagem natural. Para design de pôster e materiais de marketing com texto, o GPT Image 2 atualmente vence; para exploração puramente artística ou fotos hero fotorrealistas, vale a pena comparar os outros dois diretamente — veja nosso teste direto contra o Nano Banana 2.
Quais são as melhores alternativas ao Sora para vídeo após o encerramento?
Depois que a OpenAI encerrou o Sora em março de 2026, as principais alternativas incluem o PixVerse V6 para vídeo multi-cena com personagem consistente, o Runway Gen-4 para controle de câmera cinematográfico e o Kling v3.0 para sequências de ação. O PixVerse é a única plataforma que combina texto-para-imagem, imagem-para-vídeo e texto-para-vídeo com áudio nativo, tudo acessível com créditos gratuitos diários. Veja nosso guia completo de alternativas ao Sora para uma comparação detalhada.
Posso transformar os resultados do GPT Image 2 em vídeo?
Sim. Com o GPT Image 2 disponível no PixVerse, você pode gerar a imagem no aplicativo e convertê-la em vídeo usando o pipeline de imagem-para-vídeo no mesmo workspace, sem necessidade de transferências de arquivo. Você também pode enviar um arquivo do GPT Image 2 criado em outro lugar e executá-lo pelo mesmo pipeline.