GPT Image 2 深度測評:2026 年提示詞指南與實戰案例
OpenAI 於 2026 年 4 月 21 日釋出了 GPT Image 2,作為 GPT Image 1.5 的繼任者,如今已成為 ChatGPT 內影像生成的核心模型。我們在釋出首周進行了測試,並在 6 月底用更豐富的提示詞集合、OpenAI 官方的提示詞指南以及公開的 API 定價再次回顧了它,看看這個模型在最初的熱度褪去後表現究竟如何。
核心要點:
- GPT Image 2 原生支援 2K 解析度輸出,可選 4K 放大,在拉丁文、中文、日文、韓文和阿拉伯文等多種文字下的文本渲染準確率超過 95%。
- 這個模型更適合被當作設計助手,而非單純的圖片生成器:它在有明確成功標準的任務上表現出色——精確的文案、固定的版式、可重複的分鏡結構——但在開放式的“讓它更美”這類提示詞上表現就沒那麼穩定。
- 品牌 Logo 還原、極小號法律條款文字和專有字型仍是薄弱環節,仍需人工複核。
- OpenAI 的 API 按 token 對 GPT Image 2 計費,涵蓋圖片輸入、快取圖片輸入、圖片輸出、文本輸入和快取文本輸入——這與部分競品採用的按圖計費模式不同。
- PixVerse 已將 GPT Image 2 納入其文生圖產品線,與 Nano Banana 2 和 Seedream 並列,生成的圖片可以直接進入圖片轉影片流程,無需離開工作區。
GPT Image 2 是什麼?核心功能與侷限
GPT Image 2 是 OpenAI 的第二代影像模型,在 ChatGPT 和 API 中全面取代了 GPT Image 1.5。它與 Midjourney、DALL-E 3 和 Stable Diffusion 展開競爭,但將自身定位押注在兩點上:圖片內文字的精準還原,以及能夠解讀提示詞意圖而非僅僅匹配關鍵詞的推理層。
核心功能一覽
| 功能 | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| 原生解析度 | 2K(支援 4K 放大) | 1K | 2K(需加 —hd 參數) |
| 文本渲染準確率 | 95%+(多語言) | 約 70%(僅拉丁文) | 約 80%(僅拉丁文) |
| 推理能力整合 | 支援——可解讀多層指令 | 不支援 | 不支援 |
| 寬高比範圍 | 3:1 至 1:3 | 1:1、16:9 | 1:1 至 3:2 |
| 角色一致性 | 連續圖片間達到畫素級 | 有限 | 中等(需 —cref 參數) |
| 自然語言編輯 | 支援——用文字描述區域進行編輯 | 不支援 | 不支援 |
| 定價 | API 按 token 計費;ChatGPT 按套餐分級 | 相同 | 每月 10-30 美元訂閱制 |
文本渲染是最受關注的功能,這也是有道理的。早期的影像模型把文字當作紋理來處理——你要求生成一句海報標題,得到的往往是字形狀的噪點。GPT Image 2 能夠以真正的一致性處理多行英文標題、中文字元和混合語言排版;在我們的測試中,大約每 20 次生成裡有 19 次能一次性得到完全可讀的結果。
推理能力整合意味著模型不只是對你的措辭做模式匹配。讓它“生成一張展示明天舊金山天氣對應活動的資訊圖”,它會去獲取天氣預報、挑選相關活動,並圍繞這些資料構建版式——這比 Midjourney 或 Stable Diffusion 處理提示詞的方式更進一步。
自然語言編輯讓你可以通過描述改動而非手動蒙版來修改圖片。“把咖啡杯移到桌子左側”或“把天空改成日落”,這兩種指令都能作為針對性的編輯生效,而無需重新生成整個場景。
使用者怎麼說
釋出以來的反饋總體積極,同時也伴隨著一組一致的抱怨。在 X 和 Reddit 上流傳的人像測試結果已經接近工作室級攝影水準,測試長文案排版(傳單、選單、招牌)的海報設計師們反饋,文字準確度終於能經得起真實使用的考驗。多位設計師提到,對於基礎行銷素材,他們可以跳過 Photoshop 精修步驟,因為模型自身對構圖的把握已經足夠獨立做出版式決策。
最受好評的是提示詞遵循度:要求場景中出現 15 個具體元素,GPT Image 2 往往能全部囊括,而老一代模型隨著提示詞變長,常常開始遺漏細節。
負面反饋方面,品牌還原度依然不穩定。一次被廣泛傳播的 ZDNet 實測顯示,模型未能準確還原 ZDNET 的 Logo,其他使用者也反饋了針對特定品牌標識的類似問題。模型在概念層面理解“什麼是 Logo”,但並不能可靠地還原精確的向量形狀或專有字型。
已知侷限
- 品牌 Logo 還原並不可靠——生成後建議在 Photoshop 或 Figma 中合成精確的 Logo,而不是直接用提示詞生成。
- 生成速度落後於 FLUX 或 Nano Banana 2 等更輕量的模型,在 ChatGPT Plus 上通常需要 30-60 秒,而其他平台不到 10 秒。
- 免費額度限制較緊,免費版 ChatGPT 使用者大約每天只能生成兩張圖。Plus 訂閱使用者在 ChatGPT 內可無限生成,但 API 費用會隨用量增長。
- 風格控制比 Midjourney 更粗粒度。你無法以同樣的精度調節膠片質感、鏡頭型別或顆粒感,模型自身的美學偏好也需要刻意的提示詞技巧才能覆蓋。
- 內容政策比開源替代方案更嚴格,一些在 Stable Diffusion 或本地模型上能順利執行的提示詞,在這裡會被拒絕。
這些侷限並不妨礙它投入生產使用,但在你把整條流程完全繫結到單一模型之前,值得提前瞭解。
如何寫出真正有效的 GPT Image 2 提示詞
我們第二輪測試中最明顯的轉變是:最好的 GPT Image 2 提示詞不只是描述一張圖片——它們描述的是這張圖片必須完成的任務。一條社媒廣告的提示詞,應該和產品切圖、資訊圖、UI 介面或者影片首幀的提示詞寫法不同。
一個可靠的任務簡述結構如下:
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
先說明任務型別,再談風格
先點明輸出型別——海報、產品廣告、App 介面、角色設定圖、圖表、編輯還是影片首幀——這樣模型才知道自己會被以什麼標準來評判。
較弱的寫法:A cool futuristic speaker, cinematic, high detail.
更好的寫法:Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
第二種寫法告訴模型,它是被以版式和實用性來評判的,而不僅僅是美感。
把文字當作鎖定的資產來對待
把所有必須出現的文案放進引號裡,並明確說明它應該以什麼方式呈現——除非你想讓模型自己編詞,否則不要籠統地要求“一句標語”。
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
對於更長的文案,在提示詞中把每一行文字明確拆開列出。如果某個單詞生成後出現拼寫錯誤,就用更短的文案、更大的字號,並加上更嚴格的“僅渲染指定文字”指令重新生成。
給模型一臺“相機”和一份版式
直接說明鏡頭距離、角度、主體位置、留白和寬高比——GPT Image 2 在構圖指令上遵循度很高,但前提是你把它們講清楚。
- 特寫適合產品質感、手部、面部、材質、標籤。
- 遠景適合環境場景、故事畫面、城市海報、適合轉影片的畫面。
- 俯拍適合美食、桌面場景、平鋪展示、包裝套裝。
- 左三分之一 / 右三分之一適合需要平衡文字和產品的廣告版式。
- 整齊網格適合 UI 效果圖、角色設定圖、圖表、資訊圖。
用三句話寫編輯類提示詞
最有效的編輯類提示詞會把“改動內容”、“必須保持不變的內容”以及把兩者銜接起來的物理真實感分開描述:
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
這種“改動、保留、匹配”的結構,效果始終優於籠統的“讓它看起來更好”這類要求。
如果靜態圖要轉成影片,加一條運動提示
如果一張圖片之後可能會用於 PixVerse 的圖片轉影片流程,請提前在提示詞里加入景深和運動就緒的要求:前景、中景、背景,一個乾淨的主體輪廓,以及一個可以合理運動的可見元素——灰塵、織物、頭髮、雨水、反光或一段鏡頭推進路徑。
不要這樣寫:An astronaut in a desert.
而要這樣寫:A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
我們如何測試 GPT Image 2
在兩輪測試中,我們讓模型分別處理人像、文字密集型海報、產品風格構圖、角色設定圖、UI 效果圖以及實驗性敘事場景。我們的目標不是跑一個基準分數,而是判斷設計師、行銷人員或創作者能否只需輕微修改就能直接交付這些產出,而不必從頭重做。
| 測試領域 | 我們檢查的內容 |
|---|---|
| 人像與電影感靜幀 | 光線控制、皮膚質感、反射、氛圍、場景一致性 |
| 海報與排版設計 | 標題拼寫、多行文字、層級關係、留白、類品牌級的精緻度 |
| 角色與概念設定圖 | 多視角一致性、服裝細節、色板統一性、標籤準確度 |
| UI 與社媒效果圖 | 版式真實感、小字號文字、圖示間距、資訊流網格、截圖可信度 |
| 實驗性提示詞 | 幽默感、敘事推理、物體擺放、小號說明文字的準確度 |
這一規律在兩輪測試中都成立:GPT Image 2 更青睞精確的任務簡述,而不是關鍵詞堆砌。當提示詞明確了任務並定義了成功標準——精確文字、固定版式、可重複的分鏡結構——模型往往能保持結構完整。如果提示詞只描述了一種模糊的氛圍,結果可能依然好看,但更難在不修改的情況下直接複用。
GPT Image 2 應用案例與提示詞示例
我們圍繞以下場景對五種不同能力進行了壓力測試:光線控制、精確文字排版、多元素構圖、角色一致性和 UI 排版。以下每一條提示詞都可以直接複製並按需調整。
電影感人像攝影
這一項考察模型對光線、氛圍和剋制構圖的把握——這正是區分作品集級圖片與普通 AI 生成圖的關鍵。
提示詞:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
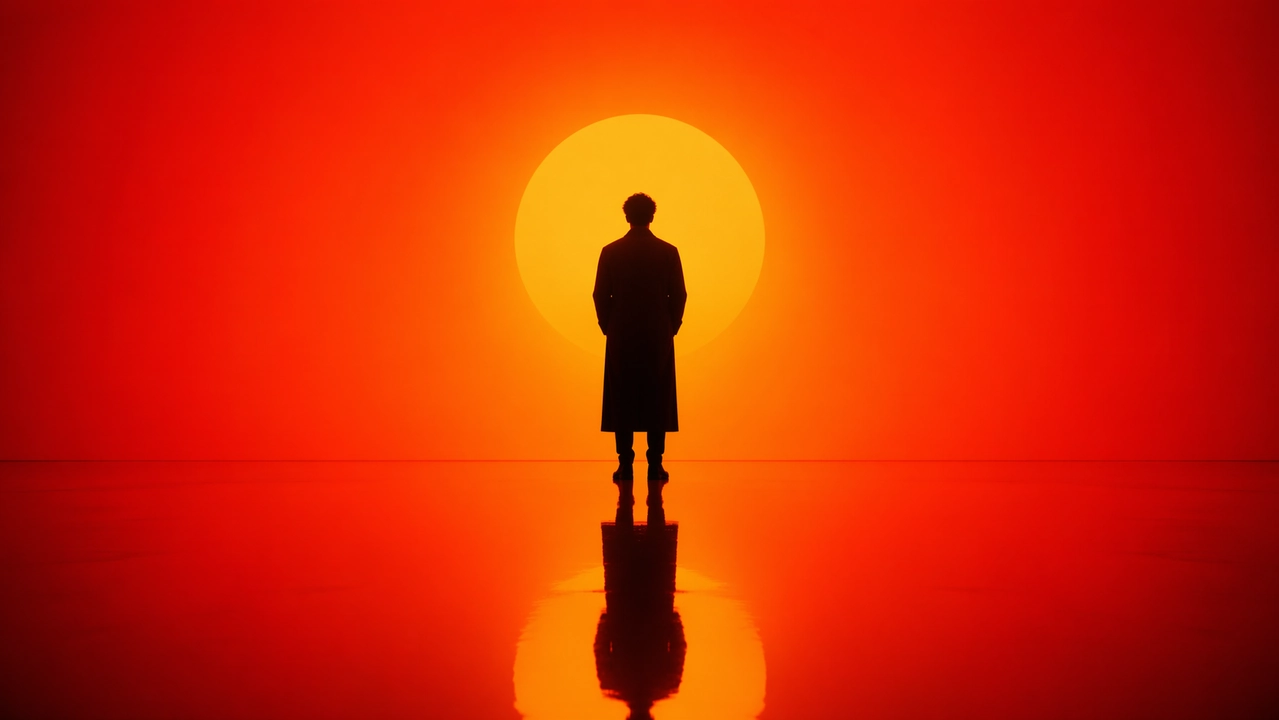
**需要關注的地方:**輪廓邊緣是否乾淨無光暈瑕疵,地面反射是否透視準確,漸變是否平滑(而非出現色帶斷層),以及姿態是否有真實的重量感,而不是顯得僵硬或懸浮。
城市海報與插畫設計
這是對清晰排版和密集多元素構圖的最嚴苛壓力測試——超過十個不同的視覺元素沿 S 形曲線排布,且英文文字必須在渲染後保持完整無誤。
提示詞:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
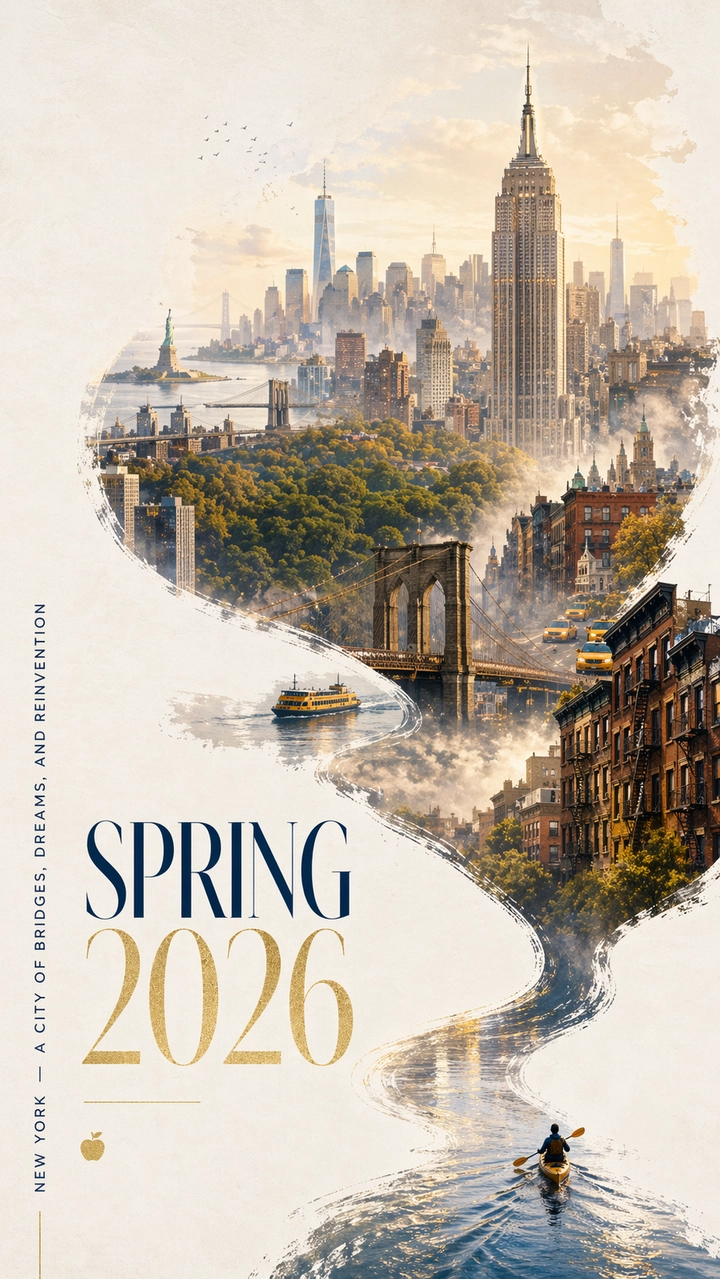
**需要關注的地方:**標題和標語中的每個字母是否清晰可讀且拼寫正確,S 形曲線是否從划艇自然過渡到天際線,地標建築是否能被識別出來而不是變成泛泛的高樓,以及留白是否給人刻意為之的感覺而非單純的空洞。
角色設計與設定圖
遊戲開發者和概念設計師需要在一次生成中獲得多視角的一致性。這一項考察模型能否在正面、側面和背面檢視之間穩定保持角色設計。
提示詞:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
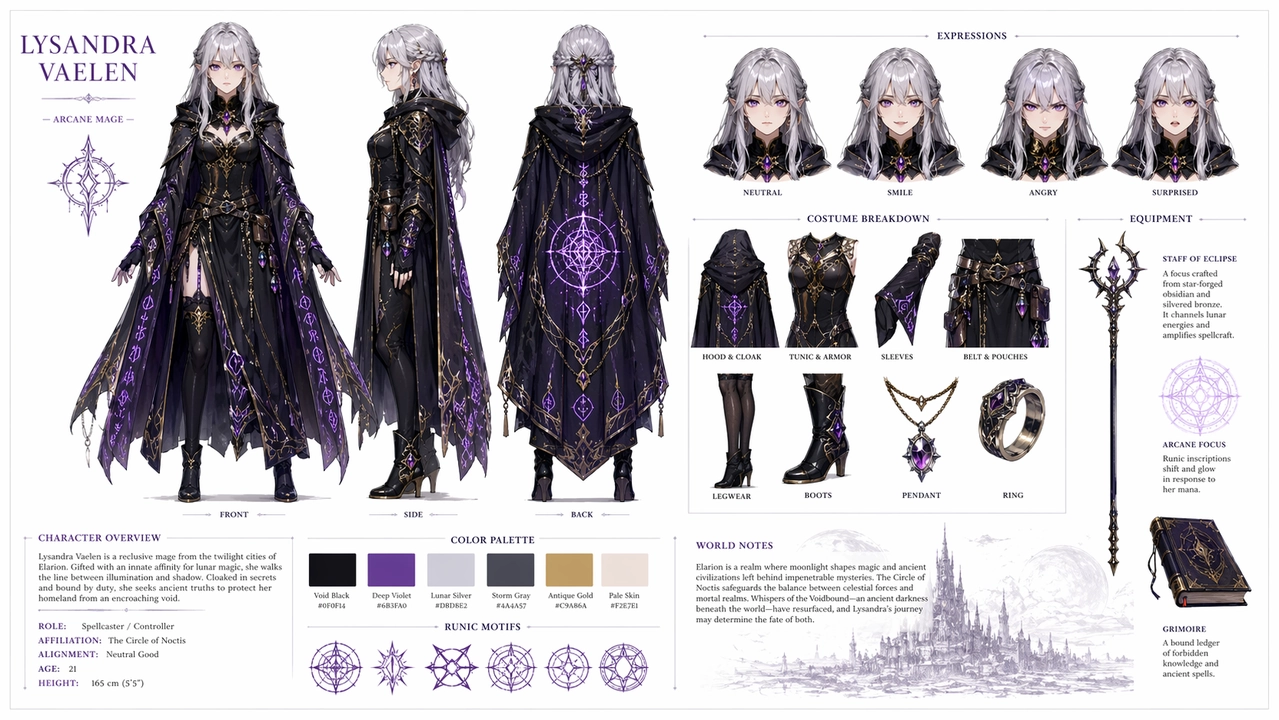
**需要關注的地方:**面部、髮型和服裝在三個視角中是否保持一致;表情變化是否只改變了面部,而沒有影響髮型或服裝;色板是否真正對應畫面中實際使用的顏色;以及文字標註是否拼寫正確。如果側面或背面檢視出現偏差,可以用更強的“保留”語句重複身份錨點後重新生成。
UI 與社媒效果圖
這一項同時考驗三種能力:畫素級精確的 UI 排版、混合語言文字渲染,以及創意概念的融合——這類內容往往也更容易在社群平台上獲得良好表現。
提示詞:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
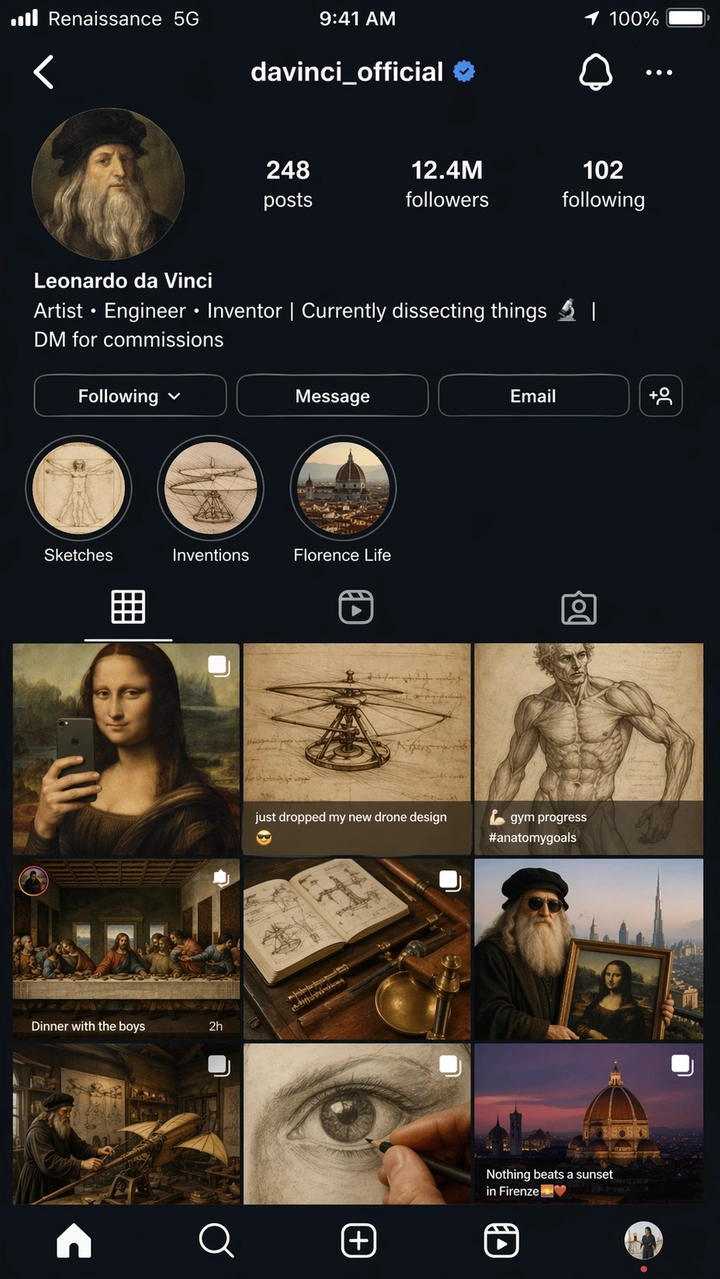
**需要關注的地方:**Instagram 的介面元素——網格間距、個人主頁排版、故事圓圈、底部標籤欄——是否讀起來像一張真實的 iOS 截圖,而不是風格化的近似效果。所有文字都應清晰可讀,其中“Renaissance 5G”運營商標籤是一個刻意設定的準確度檢驗點。應把任何 UI 效果圖輸出當作概念參考,而非可直接投產的介面;小號標籤和圖示對齊通常還需要一輪清理。
創意與實驗性藝術
帶有內在敘事幽默感的短提示詞,用來考察模型是否能自行填補創意空白,而不是完全依賴詳盡的指令。
提示詞:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
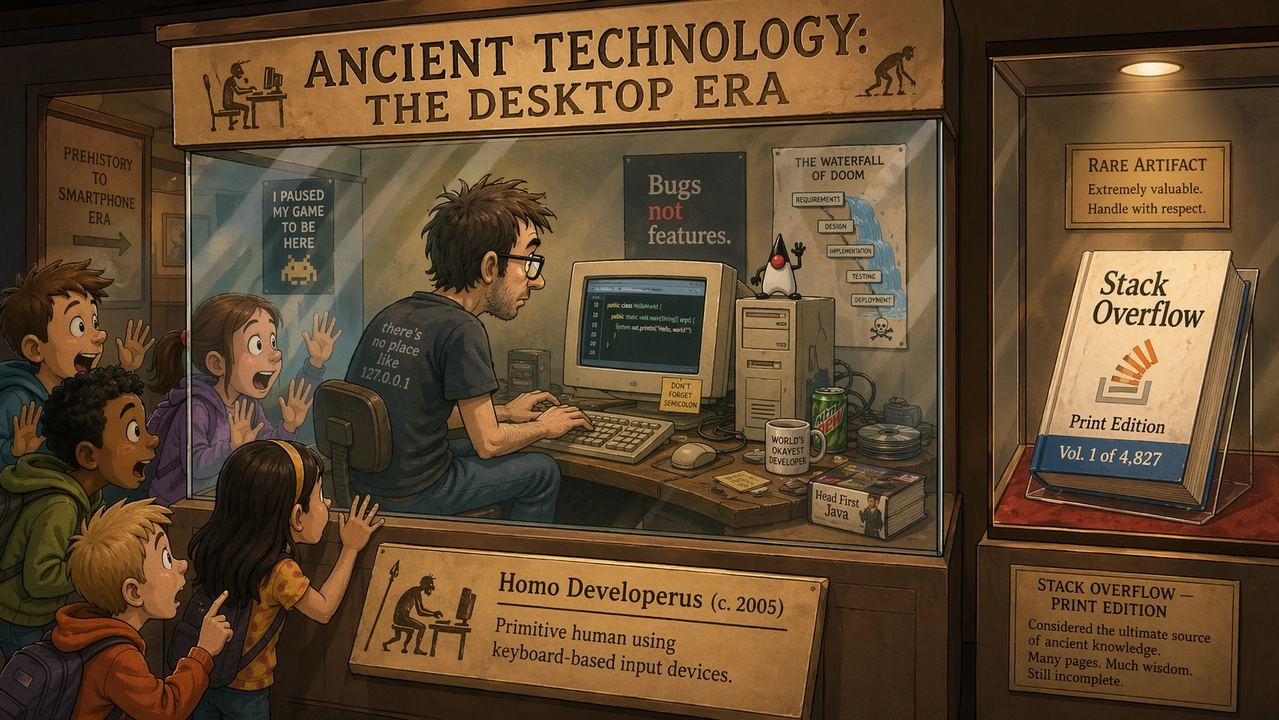
**需要關注的地方:**幽默感應通過視覺細節來傳達,而不僅僅依靠說明文字。展牌和書名必須保持清晰可讀且拼寫正確——這對小字號的多行文字來說是相當嚴苛的考驗——而且卡通風格應在整個場景中保持統一,而不是區域性出現寫實感的割裂。
各應用場景的測試結果
最出色的結果始終來自那些具有明確產出標準的提示詞——即可以通過拼寫、版式、物體保留度或分鏡順序來判定的標準。而只描述模糊氛圍的提示詞,結果的穩定性會差很多。
| 應用場景 | 表現良好的方面 | 仍需人工複核的方面 |
|---|---|---|
| 文本渲染 | 大標題、短標籤、海報標題以及簡單的 UI 標籤,在精確引用文案時都能保持準確。 | 極小號的法律條款文字、密集段落和風格化字型仍可能出現偏差——保持文案簡短並逐字檢查。 |
| 產品圖片 | 簡潔的廣告版式、留白充足的宣傳構圖以及以產品為核心的畫面表現良好。 | 真實的標籤、Logo 和受監管的宣傳語,仍需人工複核,或從經稽核的素材中合成。 |
| UI 效果圖 | 當提示詞點明真實介面元素時,手機介面、儀表盤和類 App 層級看起來相當可信。 | 應把輸出當作概念效果圖;小號標籤和圖示對齊通常仍需清理。 |
| 角色一致性 | 角色設定圖、表情變化和色板作為創意參考表現良好。 | 面部和服裝細節在不同視角間可能出現偏差;需重複身份錨點,必要時重新生成。 |
| 編輯與合成 | “改動、保留、匹配”結構的表現優於籠統的編輯請求。 | 選區邊界和透明背景輸出仍需質檢。 |
GPT Image 2 提示詞常見錯誤
- **要求精確文字卻不給出具體文案。**如果文字很重要,就把它逐字寫出來,並說明它應該出現在什麼位置。
- **在單條提示詞裡塞入所有可能的細節。**先從核心場景開始,再逐一調整變數進行最佳化。
- **在編輯時忘記宣告不變數。**明確說明必須保持不變的內容:身份特徵、背景、姿態、光線、產品形狀、標籤文字、鏡頭角度。
- 在功能性任務上依賴裝飾性的形容詞。“漂亮”並不能讓一個標籤變得可讀——應使用“清晰的標籤文字”或“遠距離可辨識”這類表述。
- **忽略寬高比。**一張出色的方形圖片,也可能無法作為豎版廣告或影片縮圖使用。
- **把 Logo 當作普通文書處理。**GPT Image 2 可以設計 Logo 概念,但精確的品牌標識應從經稽核的素材中合成,而不是直接用提示詞生成。
GPT Image 2 API 與定價說明
OpenAI 的 API 定價頁面對 GPT Image 2 採用按 token 計費,而非統一的按圖定價:
| 專案 | 標價 |
|---|---|
| 圖片輸入 | 8.00 美元 / 100 萬 token |
| 快取圖片輸入 | 2.00 美元 / 100 萬 token |
| 圖片輸出 | 30.00 美元 / 100 萬 token |
| 文本輸入 | 5.00 美元 / 100 萬 token |
| 快取文本輸入 | 1.25 美元 / 100 萬 token |
單張圖片的實際成本取決於提示詞長度、參考圖片、輸出尺寸、是否命中快取以及質量設定。ChatGPT 套餐配額與 API 計費是兩條獨立的軌道——Plus 訂閱並不能直接換算成 API 額度,如果兩者都在使用,建議分開做預算。
對於高頻次的工作流來說,真正重要的數字是經過重試後每張被採納素材的成本,而不是單次嘗試的標價。如果一次生成需要三次重新生成才能把拼寫或版式做對,那它其實並不便宜。
| 工作流 | 實用的提示詞建議 |
|---|---|
| 文字密集型海報或圖表 | 每張圖使用更少的文字,精確引用文案,明確指定層級關係。 |
| 產品照片 | 鎖定產品形狀、標籤、顏色、材質和鏡頭角度;在每一輪編輯中重複保留清單。 |
| UI 效果圖 | 把介面描述成一個已上線的產品介面——導航、卡片、按鈕、狀態——而不是概念藝術圖。 |
| 多參考圖編輯 | 為每張輸入圖片標註其角色:主體、風格、背景或材質參考。 |
| 批次生成 | 追蹤每張被採納圖片的成本,而不是每次嘗試的成本。 |
如果你想看看 GPT Image 2 在相同提示詞下與一個以寫實風格見長的對手相比表現如何,我們的《GPT Image 2 對比 Nano Banana 2》評測進行了六輪正面對比,並附有完整的 API 和平台定價明細。
從圖片到影片:在 PixVerse 完成你的完整創作流程
生成一張出色的圖片只是第一步。把它變成動態畫面,才是大多數工作流容易卡殼的地方——你在 GPT Image 2 中完成了一張人像或產品海報,接下來卻要開啟另一個工具,重新上傳檔案,還得祈禱影片模型不會把你精心構圖的畫面弄變形。PixVerse 正是要消除這種銜接上的摩擦。
GPT Image 2 已上線 PixVerse
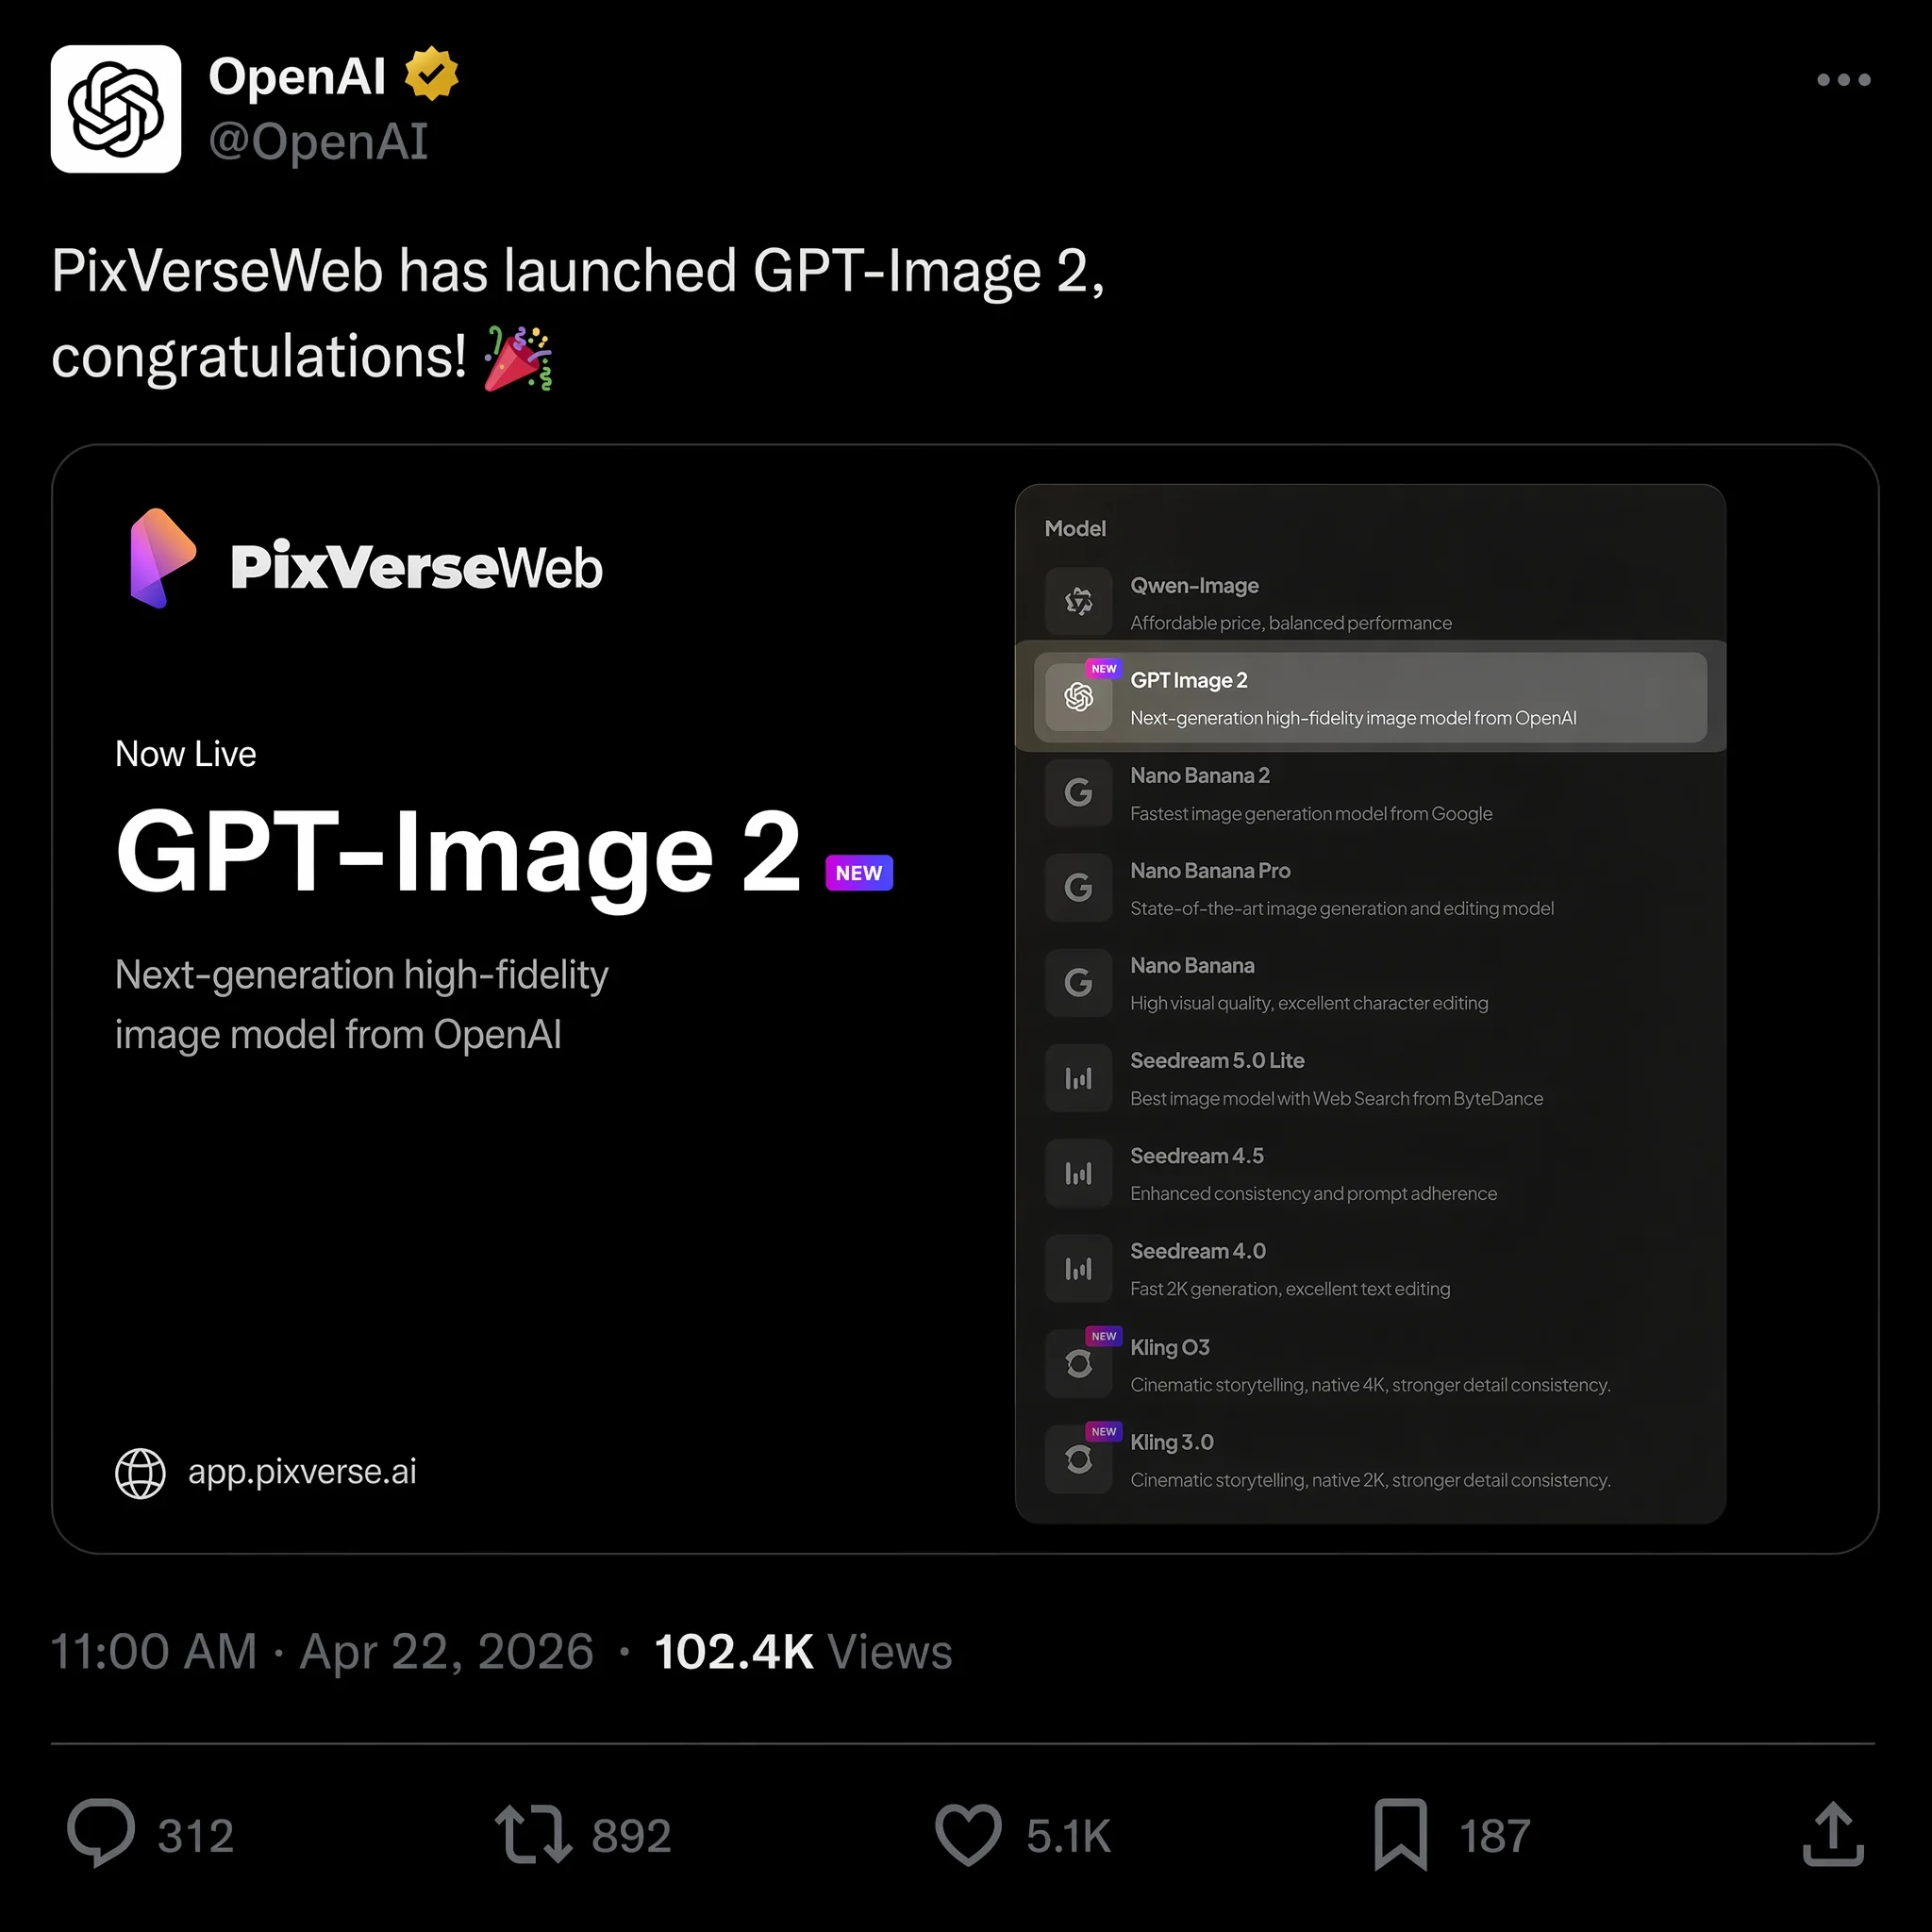
2026 年 4 月 22 日,PixVerse 將 GPT Image 2 加入文生圖選項,與 Nano Banana 2、Seedream 和 HappyHorse 1.0 共同組成模型陣容。你可以在同一個工作區內用 GPT Image 2 生成圖片並將其轉換為影片,全程無需下載、重新上傳或切換標籤頁。
這一點之所以重要有一個具體原因:當圖片直接進入同一平台上的圖片轉影片流程時,影片模型可以直接讀取全解析度的原始檔及其後設資料。整個過程不會因為壓縮或格式轉換而產生質量損失,這意味著最終成片的動態效果更乾淨,瑕疵更少。
如果一張靜態圖註定要變成一段影片片段,就從一開始在提示詞中加入運動就緒的要求——要求前景、中景、背景的景深層次,一個乾淨的主體輪廓,以及一個可以合理運動的物理元素(灰塵、蒸汽、織物、變化中的光源)。在為靜態圖新增動畫之前,先把它當作一份完成的設計檔案來審閱:先檢查拼寫、產品幾何形狀和 UI 對齊情況,因為影片模型不會自動修正拼錯的標題或變形的標籤。然後再單獨寫一條更短的運動提示詞,只描述應該運動的部分以及必須鎖定不變的部分,而不是把整份圖片簡述再重複一遍。
為什麼創作者正在轉向一體化平台
如果你在 2026 年 3 月之前一直用 OpenAI 的 Sora 做影片生成,你應該已經體會到把整套工作流押注在單一工具上的風險。OpenAI 在 3 月 24 日關閉了 Sora 應用和 API,理由是成本難以為繼,並計劃轉向機器人領域,數千名創作者的影片生產流程一夜之間中斷。完整的事件經過以及哪些工具填補了這一空缺,請參見我們的《Sora 替代方案指南》。
PixVerse 採取了不同的思路:讓你能在完整的創作流程中使用多個模型,而不是把你鎖定在單一工具裡:
- 文生圖支援 GPT Image 2、Nano Banana 2、Seedream 等多個模型——按任務需要挑選合適的模型
- 圖片轉影片將你生成的圖片轉換為動態畫面,具備角色一致性和運鏡控制能力
- 文字轉影片可直接根據文字提示生成片段,使用 PixVerse V6 或電影感更強的 C1 模型
- 原生音訊生成能自動為你的影片同步音效和對白
實際帶來的好處是:你可以從一個文字概念一路走到帶有同步音訊的成片,全程無需離開一個工作區,這為每個專案省下大量檔案管理的時間。如果你更喜歡通過命令列來編寫生成指令碼,PixVerse CLI 指南介紹瞭如何將圖片和影片生成都自動化。
PixVerse 還為新使用者提供每日 30-60 個免費額度,讓你可以在正式付費之前,先測試從圖片生成到影片輸出的完整流程。
常見問題
GPT Image 2 是免費使用的嗎?
免費版 ChatGPT 使用者大約每天可以用 GPT Image 2 生成兩張圖片。ChatGPT Plus 訂閱使用者(每月 20 美元)可無限生成,且處理速度更快。API 存取按 token 計費,涵蓋圖片輸入、圖片輸出和文本輸入,因此成本會隨提示詞長度和輸出尺寸變化,而不是固定的按圖收費。
GPT Image 2 支援什麼解析度?
GPT Image 2 原生支援 2K 解析度生成,通過 API 可選 4K 放大。寬高比範圍從 3:1 到 1:3,因此方形、豎版和超寬格式都可以直接生成。
GPT Image 2 能準確渲染圖片中的文字嗎?
可以——這是它最突出的能力之一。在我們的測試中,英文、中文、日文、韓文和阿拉伯文的文字準確率在首次生成時就超過了 95%。多行標題、海報標題和 UI 文字標籤都能被可靠處理,不過在低解析度下的極小號文字偶爾仍會出錯。
GPT Image 2 與 Midjourney、Nano Banana 2 相比如何?
Midjourney V8 擁有更強的藝術風格控制能力,以及更成熟的美學精修社群。Nano Banana 2 在寫實感、電影級光線和快速迭代方面更勝一籌。GPT Image 2 的優勢在於文字渲染、結構化排版和自然語言編輯。對於帶文字的海報設計和行銷素材,GPT Image 2 目前佔優;如果是純粹的藝術探索或寫實主視覺,另外兩款模型值得直接對比——參見我們的《對比 Nano Banana 2》正面測評。
Sora 關閉後,影片領域有哪些最佳替代方案?
OpenAI 在 2026 年 3 月關閉 Sora 之後,排在前列的替代方案包括:適合角色一致性多鏡頭影片的 PixVerse V6、擅長電影級運鏡控制的 Runway Gen-4,以及適合動作場面的 Kling v3.0。PixVerse 是唯一一個把文生圖、圖片轉影片和文字轉影片與原生音訊結合在一起的平台,並且每天都能獲得免費額度使用。完整對比詳見我們的《Sora 替代方案指南》。
我能把 GPT Image 2 生成的圖片轉換成影片嗎?
可以。由於 GPT Image 2 已在 PixVerse 上線,你可以在應用內生成圖片,並在同一工作區中通過圖片轉影片流程將其轉換為影片,無需任何檔案傳輸。你也可以上傳在其他地方生成的 GPT Image 2 檔案,並通過同一流程處理。