Ulasan GPT Image 2: Panduan Prompt dan Kasus Penggunaan di 2026
OpenAI merilis GPT Image 2 pada 21 April 2026 — penerus GPT Image 1.5 dan model yang kini menggerakkan pembuatan gambar di seluruh ChatGPT. Kami mengujinya selama pekan peluncuran dan kembali lagi pada akhir Juni dengan rangkaian prompt yang lebih luas, panduan prompting OpenAI sendiri, dan harga API yang dipublikasikan untuk melihat bagaimana model ini bertahan setelah hype awal mereda.
Poin Utama:
- GPT Image 2 membuat gambar pada resolusi 2K native dengan upscaling 4K opsional, dan akurasi rendering teks berada di atas 95% di skrip Latin, Tionghoa, Jepang, Korea, dan Arab.
- Model ini paling baik diperlakukan sebagai asisten desain, bukan generator foto: unggul pada pekerjaan dengan standar keberhasilan yang jelas — teks yang tepat, tata letak yang terkunci, struktur panel yang dapat diulang — dan menjadi kurang dapat diprediksi pada prompt terbuka “make it beautiful”.
- Reproduksi logo merek, teks hukum yang sangat kecil, dan font proprietary tetap menjadi titik lemah yang masih perlu tinjauan manual.
- API OpenAI menagih GPT Image 2 per token pada input gambar, input gambar cache, output gambar, input teks, dan input teks cache — model harga yang berbeda dari tingkatan per gambar yang dipakai sebagian pesaing.
- PixVerse menyertakan GPT Image 2 dalam jajaran text-to-image bersama Nano Banana 2 dan Seedream, sehingga gambar yang dihasilkan bisa langsung masuk ke pipeline image-to-video tanpa meninggalkan workspace.
Apa Itu GPT Image 2? Fitur Utama dan Keterbatasan
GPT Image 2 adalah model gambar generasi kedua OpenAI, menggantikan GPT Image 1.5 di ChatGPT dan API. Model ini bersaing dengan Midjourney, DALL-E 3, dan Stable Diffusion, tetapi menancapkan identitasnya pada dua hal: teks yang akurat di dalam gambar, dan lapisan penalaran yang menafsirkan maksud prompt, bukan hanya mencocokkan kata kuncinya.
Fitur Inti Sekilas
| Fitur | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| Resolusi native | 2K (dengan upscale 4K) | 1K | 2K (dengan flag —hd) |
| Akurasi rendering teks | 95%+ multibahasa | ~70% (hanya Latin) | ~80% (hanya Latin) |
| Integrasi penalaran | Ya — menafsirkan instruksi berlapis | Tidak | Tidak |
| Rentang rasio aspek | 3:1 hingga 1:3 | 1:1, 16:9 | 1:1 hingga 3:2 |
| Konsistensi karakter | Tingkat piksel di seluruh gambar berurutan | Terbatas | Sedang (flag —cref) |
| Pengeditan bahasa alami | Ya — edit area dengan mendeskripsikannya | Tidak | Tidak |
| Harga | Berbasis token via API; tingkatan paket ChatGPT | Sama | Langganan $10–30/bulan |
Rendering teks adalah fitur yang paling banyak mendapat perhatian, dan ada alasannya. Model gambar yang lebih lama memperlakukan teks sebagai tekstur — minta judul poster dan yang Anda dapatkan adalah noise berbentuk huruf. GPT Image 2 menangani judul bahasa Inggris multi-baris, karakter Tionghoa, dan tata letak multibahasa dengan konsistensi nyata; dalam pengujian kami, sekitar 19 dari 20 generasi kembali sepenuhnya terbaca pada percobaan pertama.
Integrasi penalaran berarti model melakukan lebih dari mencocokkan pola kata-kata Anda. Minta ia untuk “generate an infographic showing activities for tomorrow’s weather in San Francisco,” dan ia akan mengambil prakiraan, memilih aktivitas yang relevan, lalu membangun tata letak di sekitar data itu — selangkah lebih jauh dari cara Midjourney atau Stable Diffusion memproses prompt.
Pengeditan bahasa alami memungkinkan Anda merevisi gambar dengan mendeskripsikan perubahan, bukan menutupinya secara manual. “Move the coffee cup to the left side of the table” atau “change the sky to sunset” keduanya diterapkan sebagai edit tertarget tanpa membuat ulang seluruh adegan.
Apa Kata Pengguna
Masukan sejak peluncuran sebagian besar positif, dengan rangkaian keluhan yang konsisten. Uji potret yang beredar di X dan Reddit terlihat dekat dengan fotografi studio, dan desainer poster yang menguji tata letak panjang — flyer, menu, papan petunjuk — melaporkan bahwa akurasi teks akhirnya bertahan dalam penggunaan nyata. Beberapa desainer mencatat mereka bisa melewati satu lolosan Photoshop untuk aset pemasaran dasar karena rasa komposisi model sendiri cukup kuat untuk membuat keputusan tata letak tanpa bantuan.
Pujian terkuat berpusat pada kepatuhan prompt: minta 15 elemen spesifik dalam sebuah adegan dan GPT Image 2 cenderung menyertakan semuanya, sementara model yang lebih lama mulai menghilangkan detail saat prompt semakin panjang.
Di sisi negatif, fidelitas merek masih tidak konsisten. Uji langsung ZDNet yang tersebar luas menunjukkan model gagal mereproduksi logo ZDNET secara akurat, dan pengguna lain melaporkan hal yang sama dengan tanda merek tertentu. Model memahami apa itu logo secara konseptual, tetapi tidak andal mereproduksi bentuk vektor yang tepat atau rupa huruf proprietary.
Keterbatasan yang Diketahui
- Reproduksi logo merek tidak andal — gabungkan logo yang tepat di Photoshop atau Figma setelah pembuatan, alih-alih mem-prompt-nya secara langsung.
- Kecepatan pembuatan tertinggal dari model yang lebih ringan seperti FLUX atau Nano Banana 2, dengan 30–60 detik yang umum di ChatGPT Plus versus di bawah 10 detik di tempat lain.
- Batas laju tingkat gratis ketat — kira-kira dua gambar sehari untuk pengguna ChatGPT gratis. Pelanggan Plus mendapat pembuatan ChatGPT tanpa batas, tetapi biaya API naik seiring volume.
- Kontrol gaya lebih kasar daripada Midjourney. Anda tidak bisa mengatur stok film, jenis lensa, atau grain dengan presisi yang sama, dan bias estetika model sendiri membutuhkan kerja prompt yang sengaja untuk ditimpa.
- Kebijakan konten lebih ketat daripada alternatif sumber terbuka, jadi sebagian prompt yang berjalan baik di Stable Diffusion atau model lokal akan ditolak di sini.
Tidak satu pun dari ini menyingkirkan penggunaan produksi, tetapi layak diketahui sebelum Anda membangun pipeline di sekitar satu model secara eksklusif.
Cara Menulis Prompt GPT Image 2 yang Benar-Benar Berhasil
Pergeseran paling jelas pada putaran pengujian kedua kami: prompt GPT Image 2 terbaik tidak hanya mendeskripsikan gambar — mereka mendeskripsikan pekerjaan yang harus dilakukan gambar itu. Prompt iklan sosial harus terbaca berbeda dari potongan produk, infografis, layar UI, atau frame pertama yang ditujukan untuk video.
Pola yang andal untuk menyusun brief:
Buat [jenis gambar] untuk [kasus penggunaan]. Subjek utama: [subjek spesifik dan detail yang terlihat]. Teks persis, jika ada: “[teks yang harus muncul]”. Komposisi: [pembingkaian, tata letak, ruang negatif, penempatan subjek]. Gaya dan pencahayaan: [bahasa visual, medium, suasana, arah cahaya]. Batasan: [apa yang tidak boleh berubah, tanpa kata tambahan, tanpa watermark]. Format keluaran: [rasio aspek, latar belakang transparan, bingkai siap video].
Sebut pekerjaannya sebelum gayanya
Mulai dengan jenis output — poster, iklan produk, layar aplikasi, character sheet, diagram, edit, atau frame pertama video — agar model tahu standar apa yang dipakai untuk menilainya.
Lemah: A cool futuristic speaker, cinematic, high detail.
Lebih baik: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
Versi kedua memberi tahu model bahwa ia dinilai dari tata letak dan kegunaan, bukan hanya estetika.
Perlakukan teks seperti aset yang terkunci
Letakkan teks yang wajib ada di dalam tanda kutip dan sebutkan persis bagaimana teks itu harus dirender — jangan minta “a slogan” kecuali Anda ingin model menciptakan kata-kata untuk Anda.
Judul: “SOUND YOU CAN FEEL”. Render judul tersebut secara persis. Tanpa kata tambahan, tanpa teks duplikat, tanpa logo palsu. Huruf sans-serif putih tebal, di sisi kiri komposisi, terbaca dari kejauhan.
Untuk teks yang lebih panjang, pecah setiap baris secara eksplisit di prompt. Jika sebuah kata kembali salah eja, buat ulang dengan teks yang lebih pendek, ukuran huruf yang lebih besar, dan instruksi “exact text only” yang lebih ketat.
Beri model kamera dan tata letak
Nyatakan jarak kamera, sudut, penempatan subjek, ruang negatif, dan rasio aspek secara langsung — GPT Image 2 mengikuti petunjuk komposisi dengan baik, tetapi hanya jika semuanya dijabarkan.
- Close-up untuk tekstur produk, tangan, wajah, material, label.
- Wide shot untuk lingkungan, adegan cerita, poster kota, frame yang siap video.
- Top-down untuk makanan, adegan meja, flat-lay, kit kemasan.
- Left third / right third untuk tata letak iklan yang menyeimbangkan teks dan produk.
- Clean grid untuk mockup UI, character sheet, diagram, infografis.
Tulis edit dalam tiga kalimat
Prompt edit terkuat memisahkan perubahan dari apa yang harus tetap tidak tersentuh, dan dari realisme fisik yang mengikat keduanya:
Ganti mobil yang terparkir dengan sepeda vintage. Pertahankan rumah, pagar, jalan masuk, lanskap, arah pencahayaan, sudut kamera, dan waktu hari secara persis. Sesuaikan skala sepeda, bayangan kontak, dan perspektif dengan adegan yang sudah ada.
Struktur “ubah, pertahankan, sesuaikan” itu secara konsisten mengungguli permintaan samar seperti “buat ini terlihat lebih baik”.
Tambahkan isyarat gerak jika gambar diam akan menjadi video
Jika sebuah gambar nanti mungkin masuk ke pipeline image-to-video PixVerse, minta kedalaman dan kesiapan gerak sejak awal: latar depan, latar tengah, latar belakang, siluet subjek yang bersih, dan satu isyarat terlihat yang bisa bergerak — debu, kain, rambut, hujan, pantulan, atau jalur dorongan kamera.
Alih-alih: Seorang astronot di padang pasir.
Gunakan: Frame pertama sinematik untuk klip image-to-video: seorang astronot sendirian berdiri di tepi kawah gurun yang bersinar saat fajar, jubah dan debu siap bergerak tertiup angin, siluet latar depan yang kuat, lapisan kedalaman yang jelas, dan cahaya horizon yang hangat.
Cara Kami Menguji GPT Image 2
Di kedua putaran pengujian, kami menjalankan model pada potret, poster yang padat teks, komposisi bergaya produk, lembar karakter, mockup UI, dan adegan naratif eksperimental. Tujuannya bukan skor benchmark — melainkan apakah seorang desainer, pemasar, atau kreator bisa mengirim hasilnya dengan suntingan ringan alih-alih membangun ulang aset dari nol.
| Area uji | Yang kami periksa |
|---|---|
| Potret dan still sinematik | Kontrol pencahayaan, tekstur kulit, pantulan, suasana, konsistensi adegan |
| Tata letak poster dan tipografi | Ejaan judul, teks multi-baris, hierarki, ruang negatif, polesan yang terasa seperti merek |
| Lembar karakter dan konsep | Konsistensi multi-tampilan, detail kostum, keselarasan palet, akurasi label |
| Mockup UI dan media sosial | Realisme tata letak, teks kecil, jarak ikon, kisi feed, kelayakan tangkapan layar |
| Prompt eksperimental | Humor, penalaran naratif, penempatan objek, akurasi keterangan kecil |
Polanya bertahan di kedua putaran: GPT Image 2 lebih menghargai brief yang presisi daripada rantai kata kunci. Ketika prompt menyebut tugas dan mendefinisikan keberhasilan — teks yang persis, tata letak yang terkunci, struktur panel yang dapat diulang — model cenderung mempertahankan struktur. Ketika prompt hanya meminta suasana yang samar, hasilnya tetap bisa terlihat rapi, tetapi lebih sulit digunakan ulang tanpa suntingan.
Kasus Penggunaan GPT Image 2 dengan Contoh Prompt
Kami menguji tekanan lima kemampuan yang berbeda di skenario ini: kontrol pencahayaan, tipografi teks persis, komposisi multi-elemen, konsistensi karakter, dan tata letak UI. Setiap prompt di bawah siap disalin dan disesuaikan.
Fotografi Potret Sinematik
Ini menguji pemahaman model tentang pencahayaan, atmosfer, dan komposisi yang terkendali — dasar yang membedakan gambar siap portofolio dari render AI yang generik.
Prompt:
Hasilkan potret sinematik seorang sosok sendirian yang berdiri di lingkungan gradien oranye-ke-merah yang intens. Pencahayaan siluet kuat dari belakang, kontras bayangan yang dalam, lantai mengilap reflektif yang memantulkan sosok tersebut. Komposisi simetris, desain set minimal, tanpa kekacauan latar. Suasananya kontemplatif dan kuat, seperti still dari film fiksi ilmiah. Rasio aspek 16:9.
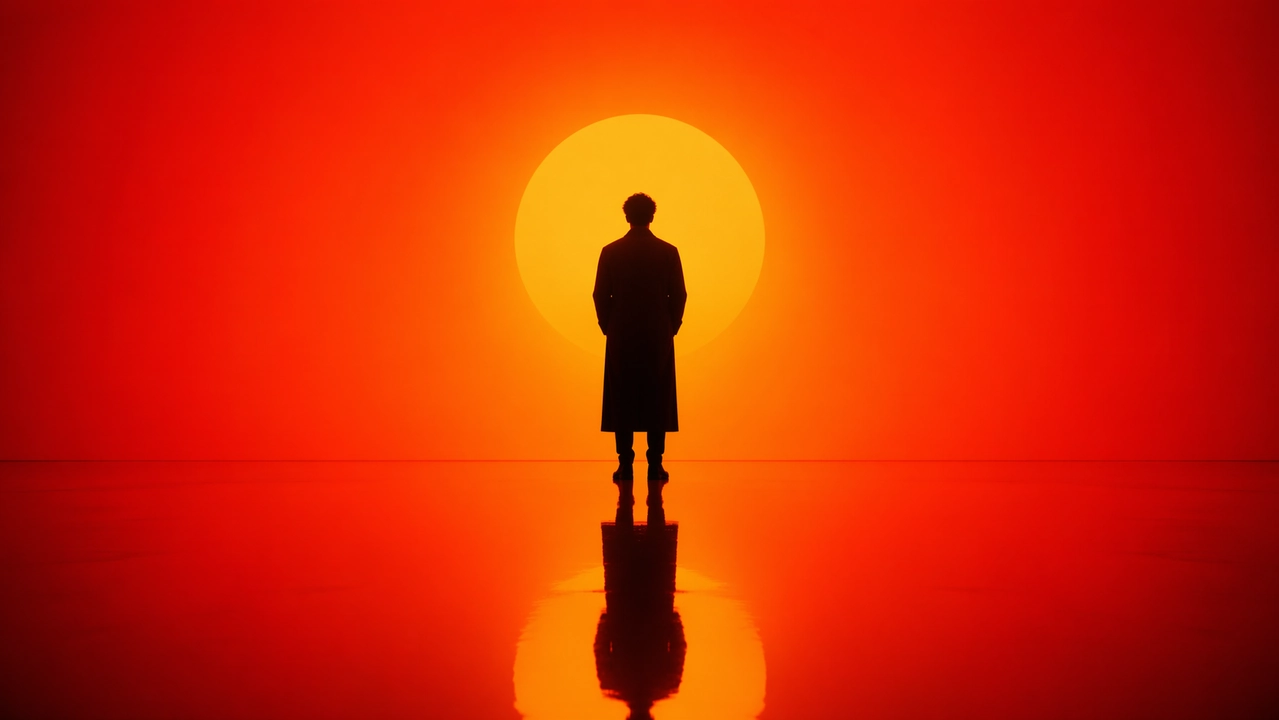
Yang perlu diperhatikan: tepi siluet yang bersih tanpa artefak halo, pantulan lantai yang akurat dengan perspektif yang benar, gradien yang halus (bukan berpita), dan pose yang membawa bobot nyata alih-alih terlihat kaku atau melayang.
Desain Poster Kota dan Ilustrasi
Uji tekanan tersulit untuk tipografi yang terbaca dipadukan dengan komposisi padat dan multi-elemen — lebih dari sepuluh elemen visual berbeda yang disusun sepanjang kurva S, dengan teks bahasa Inggris yang harus tetap utuh setelah render.
Prompt:
Poster kota New York Spring 2026 yang mencolok dengan desain kontemporer yang berani dan suasana perayaan yang elegan. Latar bertekstur off-white yang bersih dengan ruang negatif yang luas. Seorang pendayung kayak miniatur mendayung melintasi pita sempit air reflektif di sudut kanan bawah. Jejak air menyapu ke atas dalam kurva kaligrafi yang dinamis, berangsur berubah menjadi Sungai Hudson lalu menjadi panorama Manhattan yang dilukis tangan dan seperti mimpi. Di dalam komposisi berbentuk sungai yang mengalir: Empire State Building, Brooklyn Bridge, kanopi Central Park, One World Trade Center, atap brownstone, taksi kuning, feri pelabuhan, dan Patung Liberty di kejauhan yang lembut. Kabut pagi yang lembut, cahaya musim semi keemasan, aksen halus navy dan emas. Tipografi elegan di kiri bawah bertuliskan “SPRING 2026” dengan slogan vertikal “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Teks harus tajam dan tersusun indah. Tidak ada kata tambahan. Desain grafis premium, rasio aspek 9:16.
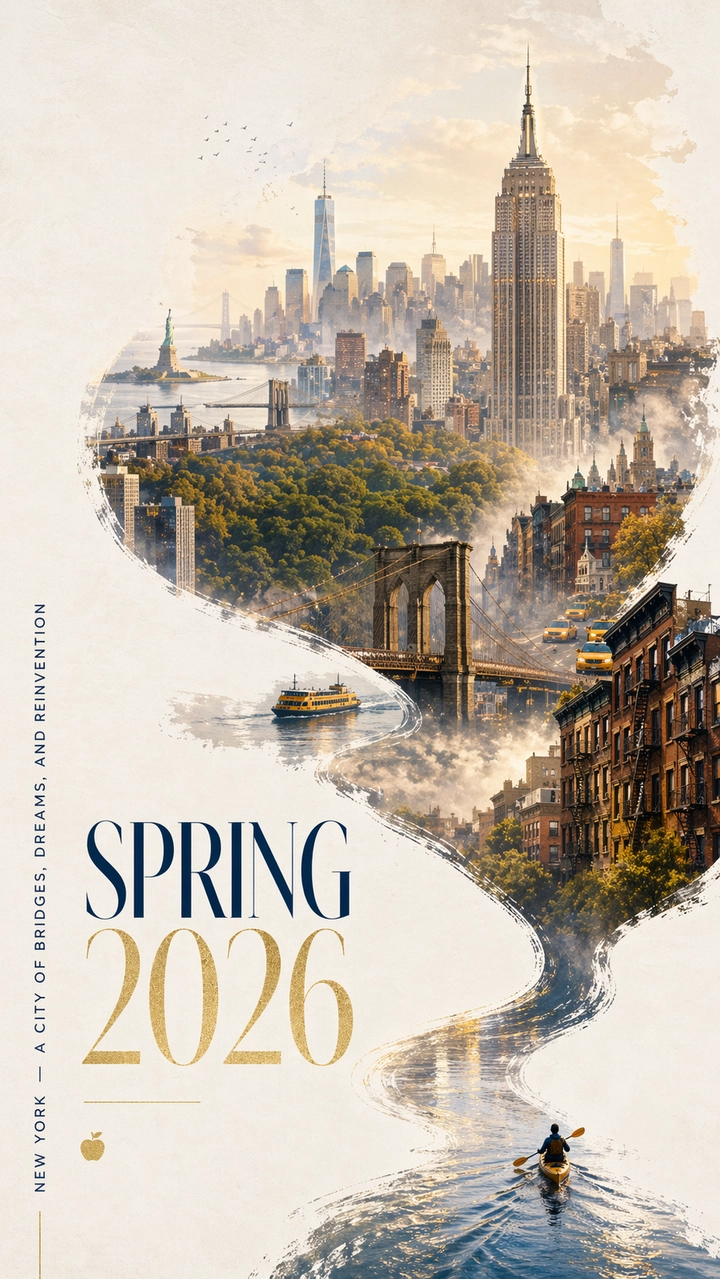
Yang perlu diperhatikan: setiap huruf pada judul dan slogan harus terbaca dan ejaannya benar, kurva S harus mengalir secara alami dari pendayung kayak ke cakrawala, bangunan ikonik harus terbaca sebagai landmark yang dikenali alih-alih menara generik, dan ruang negatif harus terasa disengaja alih-alih kosong.
Desain Karakter dan Lembar Referensi
Pengembang game dan seniman konsep membutuhkan konsistensi multi-tampilan dari satu generasi. Ini menguji apakah model dapat mempertahankan desain karakter secara stabil pada tampilan depan, samping, dan belakang.
Prompt:
Buat lembar referensi karakter profesional untuk karakter RPG fantasi orisinal: penyihir wanita muda dengan rambut perak dan mata violet, mengenakan jubah gelap berhias dengan pola rune yang bersinar. Sertakan pada latar putih bersih: turnaround tiga tampilan yang menunjukkan depan, samping, dan belakang; variasi ekspresi wajah yang menunjukkan netral, tersenyum, marah, dan terkejut; rincian terurai dari potongan kostum dan perlengkapan; satu baris swatch palet warna; dan catatan world-building singkat dalam tipografi yang bersih. Tata letak kisi yang terorganisasi, gaya concept art, resolusi tinggi. Rasio aspek 16:9.
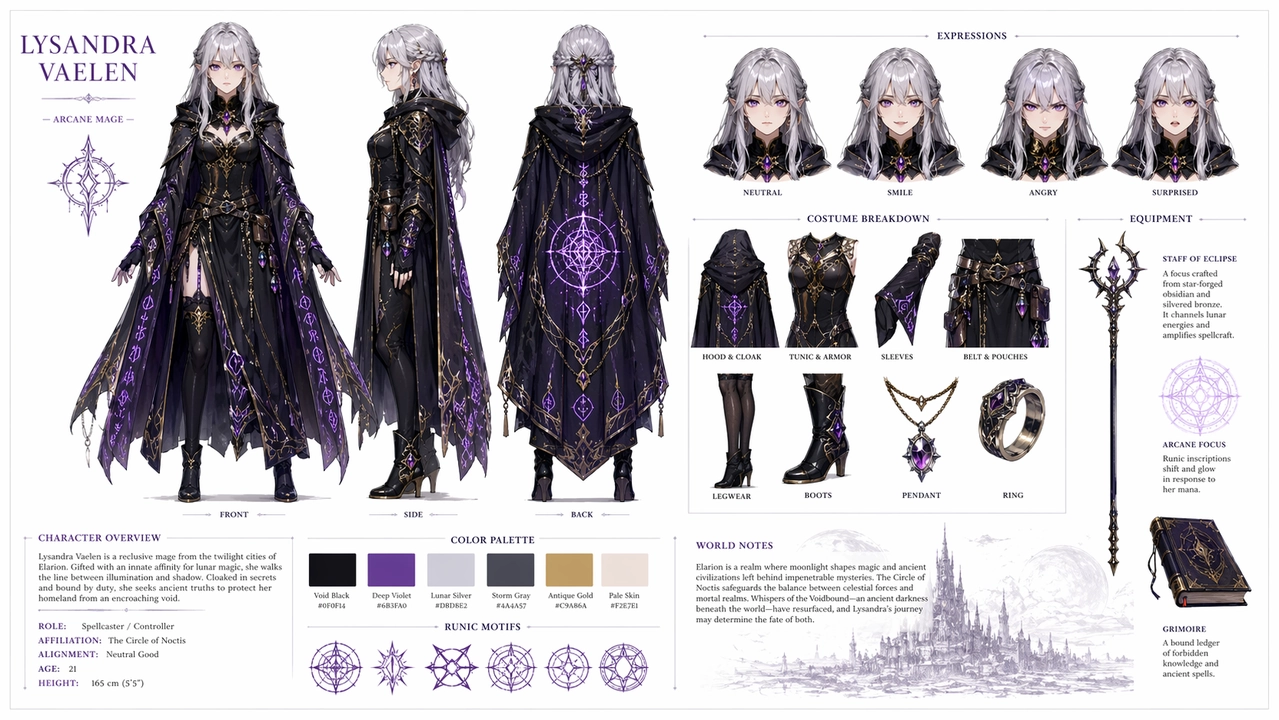
Yang perlu diperhatikan: wajah, rambut, dan pakaian harus tetap konsisten di ketiga tampilan; variasi ekspresi hanya boleh mengubah wajah, bukan gaya rambut atau pakaian; swatch palet harus benar-benar sesuai dengan warna yang dipakai dalam karya; dan label teks harus dieja dengan benar. Jika tampilan samping atau belakang bergeser, buat ulang dengan bahasa “pertahankan” yang lebih kuat dan ulangi jangkar identitas.
Mockup UI dan Media Sosial
Ini mendorong tiga hal sekaligus: tata letak UI yang akurat hingga piksel, rendering teks multibahasa, dan fusi konsep kreatif — jenis konten yang juga cenderung berkinerja baik di platform sosial.
Prompt:
Tangkapan layar iPhone yang hiper-realistis dari halaman profil Instagram fiktif untuk Leonardo da Vinci, username @davinci_official, seolah ia adalah influencer modern pada 2026. Foto profil adalah potret diri Renaisans dalam crop lingkaran. Bio berbunyi: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. Kisi menampilkan 9 postingan: Mona Lisa yang dibingkai ulang sebagai mirror selfie, sketsa helikopter dengan keterangan “just dropped my new drone design”, studi anatomi yang diposting sebagai foto progres gym, The Last Supper yang dipentaskan sebagai foto grup pesta makan malam, dan mashup anakronistik kreatif lainnya. Jumlah pengikut: 12.4M. Sorotan story berlabel Sketches, Inventions, dan Florence Life. Bilah status iOS lengkap dengan teks operator yang berbunyi “Renaissance 5G”, ikon baterai, dan waktu saat ini. UI mode gelap di seluruh layar. Kualitas tangkapan layar fotorealistis, rasio aspek 9:16.
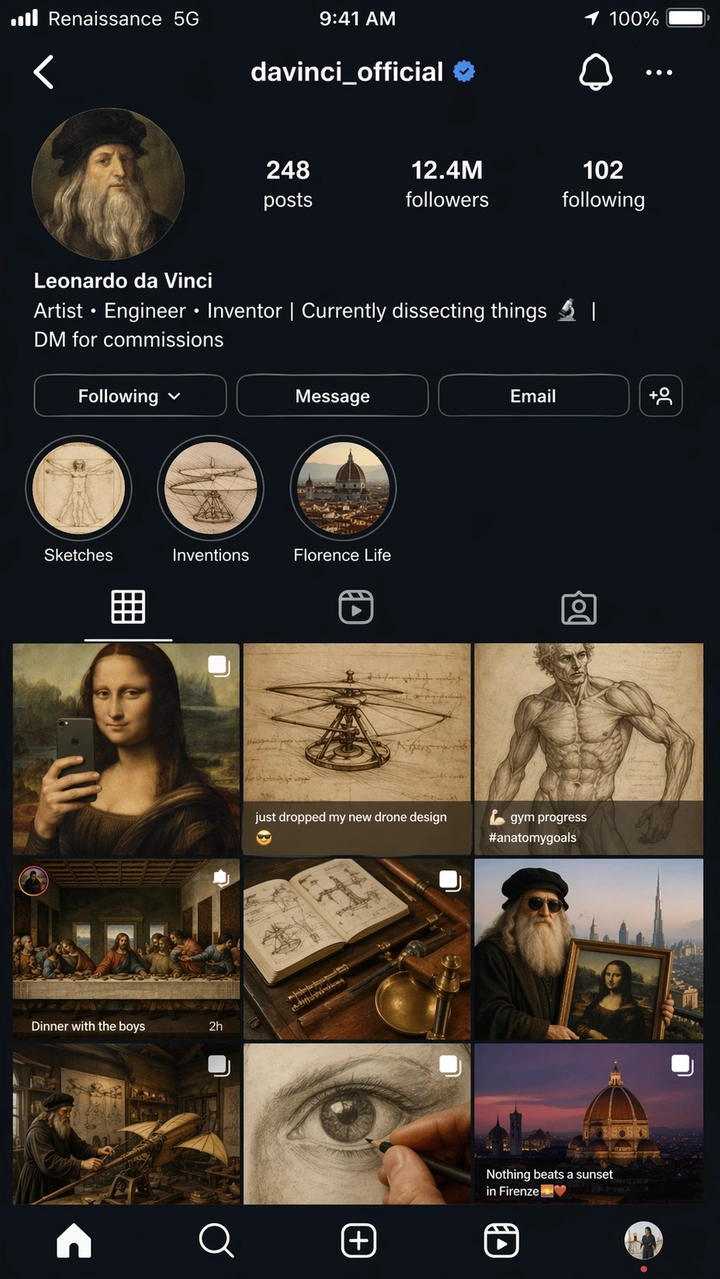
Yang perlu diperhatikan: elemen UI Instagram — jarak kisi, tata letak profil, lingkaran story, bilah tab — harus terbaca sebagai tangkapan layar iOS yang sesungguhnya alih-alih perkiraan yang distilisasi. Semua teks harus dapat dibaca, dan label operator “Renaissance 5G” adalah pemeriksaan akurasi yang disengaja. Perlakukan setiap output mockup UI sebagai referensi konsep alih-alih UI yang siap produksi; label kecil dan kesejajaran ikon biasanya membutuhkan satu putaran pembersihan.
Seni Kreatif dan Eksperimental
Prompt pendek dengan humor naratif bawaan menguji apakah model mengisi celah kreatif sendiri alih-alih mengandalkan instruksi yang lengkap.
Prompt:
Di dalam pameran museum berjudul “Ancient Technology: The Desktop Era”, seorang programmer di dalam kotak pajang kaca sedang mendemonstrasikan coding secara langsung di monitor CRT sementara anak-anak sekolah yang takjub menempelkan wajah ke kaca. Plakat pameran berbunyi: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” Kotak pajang kedua di dekatnya menunjukkan buku fisik berlabel “Stack Overflow — Print Edition, Vol. 1 of 4,827”. Gaya ilustrasi kartun 2D, pencahayaan museum yang hangat, nada humoris dan nostalgia. Rasio aspek 16:9.
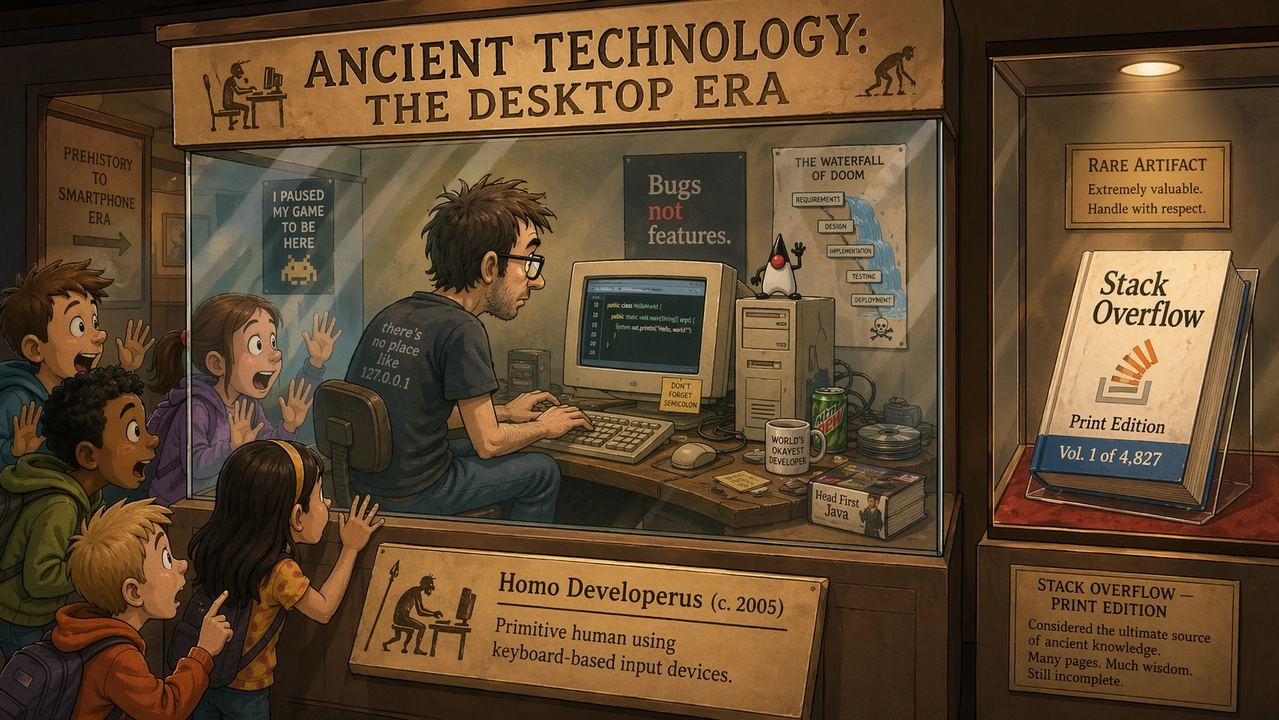
Yang perlu diperhatikan: humor harus terasa lewat detail visual, bukan hanya teks keterangan. Plakat dan judul buku harus tetap terbaca dan dieja dengan benar — ujian yang benar-benar sulit untuk teks multi-baris pada ukuran kecil — dan gaya kartun harus terasa utuh di seluruh adegan alih-alih fotorealistis di sebagian area.
Hasil Uji menurut Kasus Penggunaan
Hasil terkuat secara konsisten datang dari prompt dengan standar produksi yang jelas — sesuatu yang dapat dinilai dari ejaan, tata letak, pelestarian objek, atau urutan panel. Prompt yang hanya berisi suasana samar menghasilkan hasil yang lebih bervariasi.
| Kasus penggunaan | Yang berjalan baik | Yang masih perlu ditinjau |
|---|---|---|
| Rendering teks | Judul besar, label pendek, judul poster, dan label UI sederhana tetap akurat ketika salinan persis dikutip. | Salinan legal yang sangat kecil, paragraf padat, dan font bergaya masih bisa bergeser — jaga salinan tetap pendek dan periksa setiap huruf. |
| Gambar produk | Tata letak iklan yang bersih, ruang negatif kampanye, dan komposisi yang mengutamakan produk ter-render dengan baik. | Label nyata, logo, dan klaim yang diatur regulasi tetap perlu tinjauan manual atau komposit dari aset yang disetujui. |
| Mockup UI | Layar seluler, dasbor, dan hierarki mirip aplikasi terlihat masuk akal ketika prompt menyebut elemen antarmuka yang nyata. | Perlakukan output sebagai mockup konsep — label kecil dan kesejajaran ikon biasanya perlu dibersihkan. |
| Konsistensi karakter | Lembar karakter, baris ekspresi, dan swatch palet berfungsi baik sebagai referensi kreatif. | Wajah dan detail kostum dapat bergeser antar-tampilan; ulangi jangkar identitas dan buat ulang jika perlu. |
| Pengeditan dan komposit | Pola “ubah, pertahankan, sesuaikan” mengungguli permintaan edit yang luas. | Batas seleksi dan output latar transparan tetap perlu QA. |
Kesalahan Prompt GPT Image 2 yang Umum
- Meminta teks akurat tanpa menyediakan salinan persis. Jika teks penting, tuliskan secara verbatim dan sebutkan di mana teks itu berada.
- Membebani satu prompt dengan setiap detail yang mungkin. Mulai dari adegan inti, lalu sempurnakan satu variabel pada satu waktu.
- Lupa menyatakan invarian saat mengedit. Jelaskan apa yang harus tetap tidak berubah: identitas, latar, pose, pencahayaan, bentuk produk, teks label, sudut kamera.
- Mengandalkan kata kualitas dekoratif untuk pekerjaan fungsional. “Beautiful” tidak membuat label terbaca — gunakan bahasa seperti “teks label yang tajam” atau “terbaca dari kejauhan”.
- Melewatkan rasio aspek. Gambar persegi yang kuat tetap bisa gagal sebagai iklan vertikal atau thumbnail video.
- Memperlakukan logo seperti teks biasa. GPT Image 2 dapat merancang konsep logo, tetapi tanda merek yang persis sebaiknya dikomposit dari aset yang disetujui alih-alih diprompt secara langsung.
Catatan API dan Harga GPT Image 2
Halaman harga API OpenAI mencantumkan GPT Image 2 berdasarkan token, bukan tarif tetap per gambar:
| Item | Harga tercantum |
|---|---|
| Input gambar | $8.00 / 1M token |
| Input gambar dari cache | $2.00 / 1M token |
| Output gambar | $30.00 / 1M token |
| Input teks | $5.00 / 1M token |
| Input teks dari cache | $1.25 / 1M token |
Biaya aktual per gambar bergantung pada panjang prompt, gambar referensi, ukuran output, caching, dan pengaturan kualitas. Kuota paket ChatGPT adalah jalur terpisah dari penagihan API — langganan Plus tidak langsung menjadi kredit API, jadi anggarkan keduanya secara independen jika Anda memakai keduanya.
Untuk alur kerja volume tinggi, angka yang penting adalah biaya per aset yang diterima setelah percobaan ulang, bukan harga daftar satu percobaan. Generasi yang lebih murah tidak benar-benar lebih murah jika membutuhkan tiga regenerasi agar ejaan atau tata letak benar.
| Alur kerja | Saran prompting praktis |
|---|---|
| Poster atau diagram padat teks | Gunakan lebih sedikit kata per gambar, kutip salinan persis, tentukan hierarki secara eksplisit. |
| Foto produk | Kunci bentuk produk, label, warna, material, dan sudut kamera; ulangi daftar pertahankan pada setiap putaran edit. |
| Mockup UI | Jelaskan layar sebagai antarmuka yang sudah dirilis — navigasi, kartu, tombol, status — bukan sebagai concept art. |
| Edit multi-referensi | Beri label setiap gambar input menurut peran: subjek, gaya, latar, pakaian, atau referensi material. |
| Generasi batch | Lacak biaya per gambar yang diterima, bukan biaya per percobaan. |
Jika Anda ingin melihat bagaimana GPT Image 2 dibandingkan dengan alternatif yang mengutamakan fotorealisme pada prompt yang identik, perbandingan GPT Image 2 vs. Nano Banana 2 kami menjalankan enam ronde head-to-head dengan rincian harga API dan platform secara lengkap.
Dari Gambar ke Video: Lengkapi Alur Kerja Kreatif Anda di PixVerse
Menghasilkan gambar yang kuat adalah satu langkah. Mengubahnya menjadi gerak adalah tempat sebagian besar alur kerja rusak — Anda menyelesaikan potret atau poster produk di GPT Image 2, lalu harus membuka alat terpisah, mengunggah ulang file, dan berharap model video tidak merusak gambar yang sudah disusun dengan cermat. Gesekan serah terima itulah yang dihilangkan PixVerse.
GPT Image 2 Sudah Tayang di PixVerse
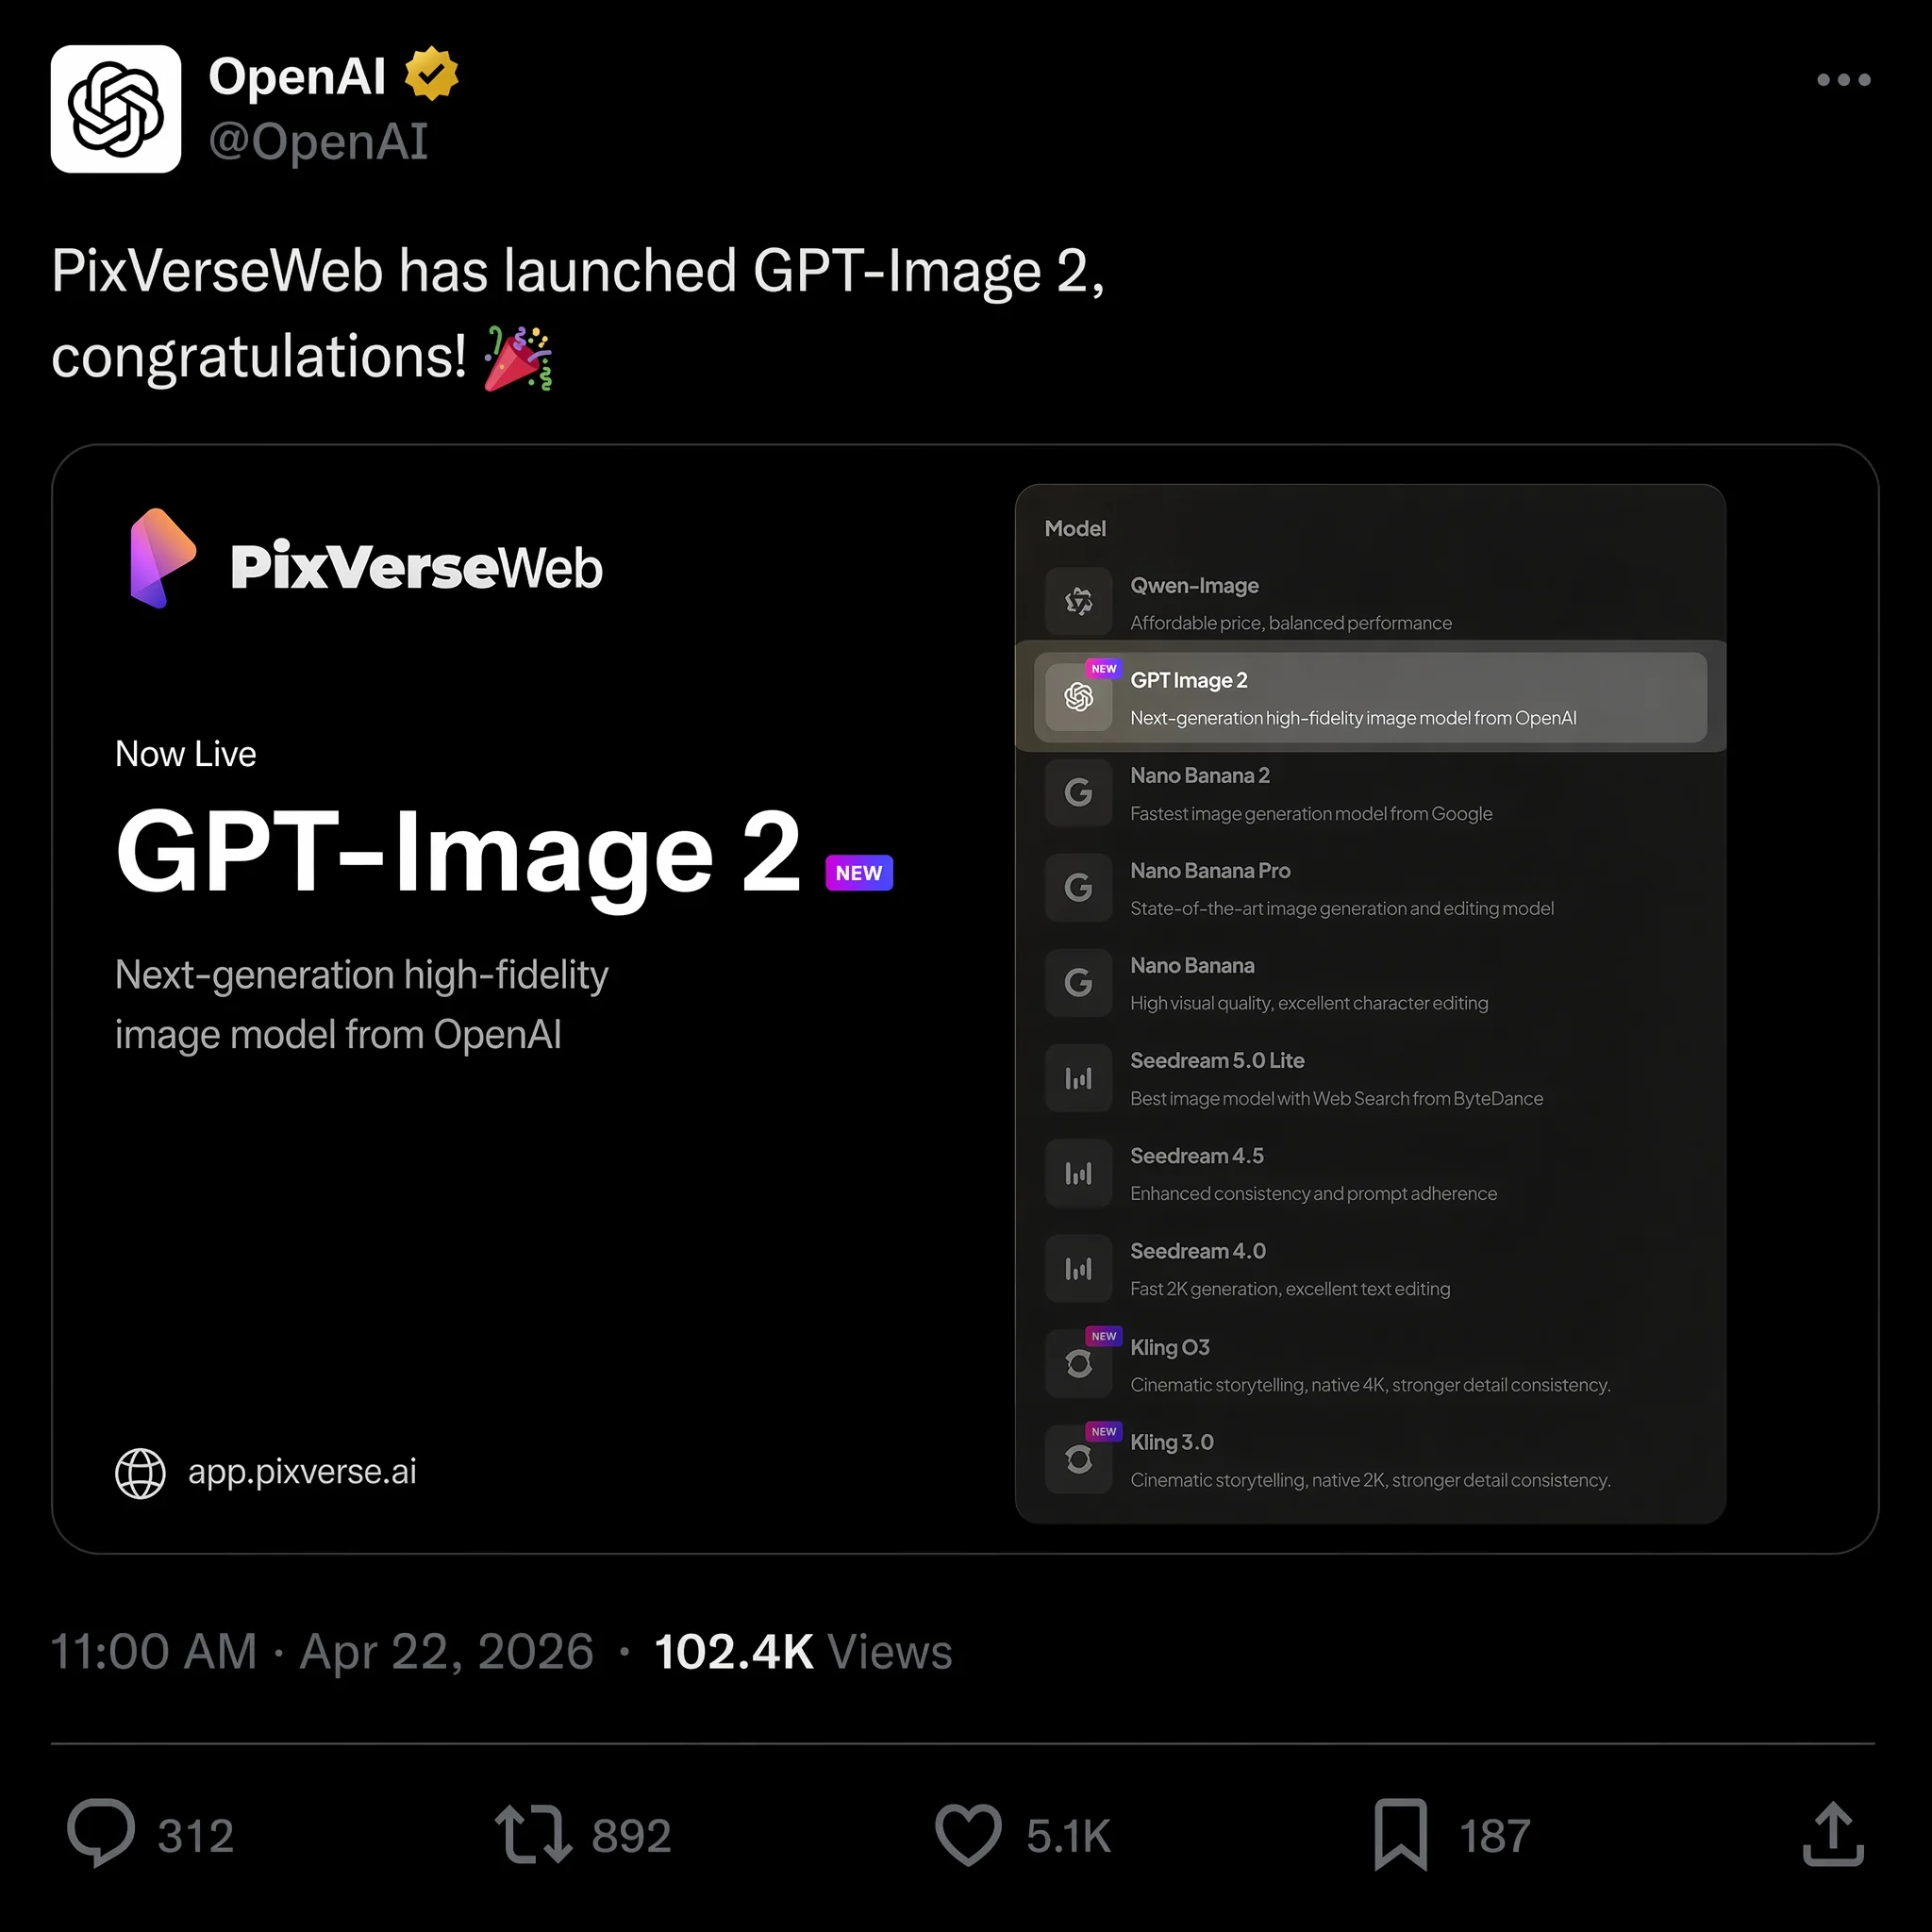
Pada 22 April 2026, PixVerse menambahkan GPT Image 2 sebagai opsi text-to-image, bergabung dengan Nano Banana 2, Seedream, dan HappyHorse 1.0 dalam jajaran model. Anda dapat menghasilkan gambar dengan GPT Image 2 dan mengubahnya menjadi video di workspace yang sama, tanpa mengunduh, mengunggah ulang, atau berpindah tab.
Itu penting karena alasan yang konkret: ketika gambar langsung masuk ke pipeline image-to-video di platform yang sama, model video bekerja dari file sumber resolusi penuh dan metadatanya secara langsung. Tidak ada kehilangan kualitas akibat kompresi atau konversi format di sepanjang jalan, yang berarti gerak lebih bersih dan lebih sedikit artefak pada klip akhir.
Jika gambar diam dimaksudkan menjadi klip, minta kesiapan gerak sejak awal — minta kedalaman latar depan, latar tengah, dan latar belakang, siluet subjek yang bersih, dan satu elemen fisik yang secara masuk akal dapat bergerak (debu, uap, kain, sumber cahaya yang bergeser). Tinjau gambar diam seperti file desain yang sudah selesai sebelum menganimasikannya: periksa ejaan, geometri produk, dan kesejajaran UI terlebih dahulu, karena model video tidak akan memperbaiki judul yang salah eja atau label yang melengkung dengan sendirinya. Lalu tulis prompt gerak terpisah yang lebih pendek, yang hanya menjelaskan apa yang harus bergerak dan apa yang harus tetap terkunci, alih-alih mengulang seluruh brief gambar.
Mengapa Kreator Beralih ke Platform All-in-One
Jika Anda memakai Sora dari OpenAI untuk pembuatan video sebelum Maret 2026, Anda sudah mengetahui risiko membangun alur kerja di sekitar satu alat. OpenAI menutup aplikasi dan API Sora pada 24 Maret, dengan alasan biaya yang tidak berkelanjutan dan pergeseran ke robotika, dan ribuan kreator kehilangan pipeline video mereka dalam semalam. Lihat panduan alternatif Sora kami untuk rincian lengkap tentang apa yang terjadi dan alat mana yang mengisi kekosongan itu.
PixVerse mengambil pendekatan berbeda dengan memberi Anda akses ke beberapa model di seluruh pipeline kreatif, alih-alih mengunci Anda pada satu model:
- Text-to-image dengan GPT Image 2, Nano Banana 2, Seedream, dan lainnya — pilih model yang sesuai pekerjaan
- Image-to-video yang mengubah gambar hasil generasi Anda menjadi gerak dengan konsistensi karakter dan kontrol kamera
- Text-to-video untuk klip yang dihasilkan langsung dari prompt tertulis menggunakan PixVerse V6 atau model C1 yang sinematik
- Pembuatan audio native yang menyelaraskan efek suara dan dialog dengan video Anda secara otomatis
Manfaat praktisnya: Anda dapat beralih dari konsep tertulis ke video jadi dengan audio yang tersinkron tanpa meninggalkan satu workspace, yang menghilangkan berjam-jam pengelolaan file dari setiap proyek. Jika Anda lebih suka menulis skrip pembuatan dari baris perintah, panduan PixVerse CLI membahas otomatisasi pembuatan gambar dan video.
PixVerse juga menawarkan 30–60 kredit gratis harian untuk pengguna baru, sehingga Anda dapat menguji pipeline lengkap — dari pembuatan gambar hingga output video — sebelum berkomitmen pada paket berbayar.
Pertanyaan yang Sering Diajukan
Apakah GPT Image 2 gratis digunakan?
Pengguna ChatGPT gratis dapat menghasilkan kira-kira dua gambar per hari dengan GPT Image 2. Pelanggan ChatGPT Plus ($20/bulan) mendapatkan generasi tanpa batas dengan pemrosesan yang lebih cepat. Akses API ditagih per token untuk input gambar, output gambar, dan input teks, sehingga biaya meningkat mengikuti panjang prompt dan ukuran output, bukan biaya tetap per gambar.
Resolusi apa yang didukung GPT Image 2?
GPT Image 2 menghasilkan gambar pada resolusi 2K native, dengan upscale 4K opsional melalui API. Rasio aspek berkisar dari 3:1 hingga 1:3, sehingga format persegi, vertikal, dan ultra-lebar semuanya tersedia secara langsung.
Dapatkah GPT Image 2 merender teks dalam gambar secara akurat?
Ya — ini adalah salah satu fitur terkuatnya. Dalam pengujian kami, akurasi teks untuk bahasa Inggris, Tionghoa, Jepang, Korea, dan Arab melampaui 95% pada percobaan generasi pertama. Judul multi-baris, judul poster, dan label teks UI semuanya ditangani dengan andal, meskipun teks yang sangat kecil pada resolusi rendah masih sesekali bisa meleset.
Bagaimana GPT Image 2 dibandingkan dengan Midjourney dan Nano Banana 2?
Midjourney V8 memiliki kontrol gaya artistik yang lebih kuat dan komunitas yang lebih mapan untuk penyempurnaan estetika. Nano Banana 2 adalah pilihan yang lebih kuat untuk fotorealisme, pencahayaan sinematik, dan iterasi cepat. GPT Image 2 unggul untuk rendering teks, tata letak terstruktur, dan pengeditan bahasa alami. Untuk desain poster dan materi pemasaran yang berisi teks, GPT Image 2 saat ini menang; untuk eksplorasi artistik murni atau hero shot fotoreal, dua model lainnya layak dibandingkan secara langsung — lihat uji head-to-head kami terhadap Nano Banana 2.
Apa alternatif terbaik untuk Sora untuk video setelah penutupan?
Setelah OpenAI menutup Sora pada Maret 2026, alternatif teratas meliputi PixVerse V6 untuk video multi-shot yang konsisten karakternya, Runway Gen-4 untuk kontrol kamera sinematik, dan Kling v3.0 untuk sekuens aksi. PixVerse adalah satu-satunya platform yang menggabungkan text-to-image, image-to-video, dan text-to-video dengan audio native, semuanya dapat diakses dengan kredit gratis harian. Lihat panduan alternatif Sora lengkap kami untuk perbandingan terperinci.
Dapatkah saya mengubah output GPT Image 2 menjadi video?
Ya. Dengan GPT Image 2 yang tersedia di PixVerse, Anda dapat menghasilkan gambar di dalam aplikasi dan mengubahnya menjadi video menggunakan pipeline image-to-video di workspace yang sama, tanpa perlu transfer file. Anda juga dapat mengunggah file GPT Image 2 yang dibuat di tempat lain dan menjalankannya melalui pipeline yang sama.