GPT Image 2 리뷰: 2026년 프롬프트 가이드와 활용 사례
OpenAI는 2026년 4월 21일 GPT Image 2를 출시했습니다. GPT Image 1.5의 후속작으로, 현재 ChatGPT 전반의 이미지 생성을 담당하는 모델입니다. 저희는 출시 주간에 이 모델을 테스트했고, 6월 말에 더 다양한 프롬프트와 OpenAI의 공식 프롬프트 가이드, 그리고 공개된 API 가격 정책을 가지고 다시 살펴보며 초기 화제가 가라앉은 이후에도 이 모델이 얼마나 견고한지 확인했습니다.
핵심 요약:
- GPT Image 2는 네이티브 2K 해상도로 이미지를 생성하며 선택적으로 4K 업스케일링이 가능하고, 라틴 문자, 중국어, 일본어, 한국어, 아랍어 문자 전반에 걸쳐 텍스트 렌더링 정확도가 95% 이상입니다.
- 이 모델은 사진 생성기보다는 디자인 어시스턴트로 다루는 것이 가장 적합합니다. 정확한 문구, 고정된 레이아웃, 반복 가능한 패널 구조처럼 명확한 성공 기준이 있는 작업에서 뛰어나며, “더 예쁘게 만들어줘” 식의 개방형 프롬프트에서는 예측 가능성이 떨어집니다.
- 브랜드 로고 재현, 아주 작은 법적 문구, 독점 폰트는 여전히 취약한 부분으로 수동 검토가 필요합니다.
- OpenAI의 API는 이미지 입력, 캐시된 이미지 입력, 이미지 출력, 텍스트 입력, 캐시된 텍스트 입력별로 토큰 단위 과금을 하며, 이는 일부 경쟁사가 사용하는 이미지당 요금제와는 다른 가격 모델입니다.
- PixVerse는 텍스트-이미지 라인업에 GPT Image 2를 Nano Banana 2, Seedream과 함께 포함하고 있어, 생성한 이미지를 워크스페이스를 벗어나지 않고 바로 이미지-영상 파이프라인으로 넘길 수 있습니다.
GPT Image 2란 무엇인가: 주요 기능과 한계
GPT Image 2는 OpenAI의 2세대 이미지 모델로, ChatGPT와 API 전반에서 GPT Image 1.5를 대체합니다. Midjourney, DALL-E 3, Stable Diffusion과 경쟁하지만, 두 가지 지점에 정체성을 걸고 있습니다. 이미지 안의 정확한 텍스트, 그리고 프롬프트의 키워드만 맞추는 것이 아니라 의도를 해석하는 추론 레이어입니다.
핵심 기능 한눈에 보기
| 기능 | GPT Image 2 | GPT Image 1.5 | Midjourney V8 |
|---|---|---|---|
| 네이티브 해상도 | 2K (4K 업스케일 가능) | 1K | 2K (—hd 플래그 사용 시) |
| 텍스트 렌더링 정확도 | 95%+ (다국어) | 약 70% (라틴 문자만) | 약 80% (라틴 문자만) |
| 추론 통합 | 있음 — 다층적 지시를 해석 | 없음 | 없음 |
| 화면 비율 범위 | 3:1 ~ 1:3 | 1:1, 16:9 | 1:1 ~ 3:2 |
| 캐릭터 일관성 | 연속 이미지 간 픽셀 수준 유지 | 제한적 | 보통 (—cref 플래그) |
| 자연어 편집 | 있음 — 영역을 설명해서 편집 | 없음 | 없음 |
| 가격 | API 토큰 기반; ChatGPT 요금제 등급 | 동일 | 월 10~30달러 구독 |
텍스트 렌더링은 가장 많은 주목을 받는 기능이며, 그럴 만한 이유가 있습니다. 이전 이미지 모델들은 텍스트를 텍스처처럼 다뤄서, 포스터 헤드라인을 요청하면 글자 모양의 노이즈가 나오곤 했습니다. GPT Image 2는 여러 줄의 영문 헤드라인, 한자, 다국어 혼합 레이아웃을 실제로 일관되게 처리합니다. 저희 테스트에서는 약 20회 생성 중 19회가 첫 시도에서 완전히 읽을 수 있는 결과로 나왔습니다.
추론 통합은 이 모델이 단순히 문구를 패턴 매칭하는 것 이상을 한다는 의미입니다. “내일 샌프란시스코 날씨에 맞는 활동을 보여주는 인포그래픽을 만들어줘”라고 요청하면, 모델이 예보를 가져와 관련 활동을 선택하고 그 데이터를 바탕으로 레이아웃을 구성합니다. 이는 Midjourney나 Stable Diffusion이 프롬프트를 처리하는 방식보다 한 단계 더 나아간 것입니다.
자연어 편집을 사용하면 이미지를 수동으로 마스킹하지 않고도 변경 내용을 설명하는 것만으로 수정할 수 있습니다. “커피잔을 테이블 왼쪽으로 옮겨줘”나 “하늘을 노을로 바꿔줘” 같은 요청 모두, 전체 장면을 다시 생성하지 않고도 정확히 해당 부분만 편집으로 적용됩니다.
사용자들의 반응
출시 이후 피드백은 대체로 긍정적이었고, 일관된 불만 사항도 함께 확인됐습니다. X와 레딧에 올라온 인물 사진 테스트는 스튜디오 촬영에 가까운 완성도를 보여주고 있으며, 전단지, 메뉴판, 간판 등 긴 형식의 레이아웃을 테스트한 포스터 디자이너들은 텍스트 정확도가 실제 사용에서도 마침내 버텨준다고 평가하고 있습니다. 여러 디자이너는 모델 자체의 구도 감각이 도움 없이도 레이아웃을 결정할 만큼 강력해서, 기본적인 마케팅 소재라면 포토샵 작업을 건너뛸 수 있었다고 언급했습니다.
가장 큰 호평은 프롬프트 준수도에 집중되어 있습니다. 한 장면에 15가지 구체적인 요소를 요청하면 GPT Image 2는 대체로 모두 포함하는 경향을 보이는데, 기존 모델들은 프롬프트가 길어질수록 세부 사항을 빠뜨리기 시작했습니다.
부정적인 측면에서는 브랜드 충실도가 여전히 불안정합니다. 널리 공유된 ZDNet의 실사용 테스트에서는 모델이 ZDNET 로고를 정확하게 재현하지 못하는 모습을 보였고, 다른 사용자들도 특정 브랜드 마크에서 같은 문제를 보고했습니다. 모델은 로고가 개념적으로 무엇인지는 이해하지만, 정확한 벡터 형태나 독점 서체를 안정적으로 재현하지는 못합니다.
알려진 한계
- 브랜드 로고 재현은 신뢰할 수 없습니다 — 로고를 직접 프롬프트로 요청하기보다는, 생성 후 포토샵이나 피그마에서 정확한 로고를 합성하는 방식을 사용하세요.
- 생성 속도는 FLUX나 Nano Banana 2 같은 더 가벼운 모델에 뒤처지며, ChatGPT Plus에서는 보통 30~60초가 걸리는 반면 다른 곳에서는 10초 미만입니다.
- 무료 등급 사용 제한이 빡빡합니다 — 무료 ChatGPT 사용자는 하루에 약 두 장의 이미지만 생성할 수 있습니다. Plus 구독자는 ChatGPT 생성이 무제한이지만, API 비용은 사용량에 비례해 늘어납니다.
- 스타일 제어는 Midjourney보다 거칩니다. 필름 종류, 렌즈 타입, 그레인을 같은 정밀도로 조절할 수 없고, 모델 자체의 미적 편향을 극복하려면 의도적인 프롬프트 작업이 필요합니다.
- 콘텐츠 정책은 오픈소스 대안보다 엄격해서, Stable Diffusion이나 로컬 모델에서는 문제없이 작동하는 일부 프롬프트가 여기서는 거부될 수 있습니다.
이 중 어느 것도 프로덕션 사용을 배제하지는 않지만, 하나의 모델만을 중심으로 파이프라인을 구축하기 전에 알아둘 가치가 있습니다.
실제로 통하는 GPT Image 2 프롬프트 작성법
두 번째 테스트 라운드에서 가장 뚜렷하게 드러난 변화는 이것입니다. 가장 좋은 GPT Image 2 프롬프트는 단순히 그림을 묘사하는 것이 아니라, 그 그림이 수행해야 할 역할을 묘사합니다. 소셜 광고 프롬프트는 제품 컷아웃, 인포그래픽, UI 화면, 또는 영상용 첫 프레임과는 다르게 작성되어야 합니다.
브리프를 구성하는 신뢰할 만한 패턴은 다음과 같습니다.
Create [type of image] for [use case]. Main subject: [specific subject and visible details]. Exact text, if any: “[copy that must appear]”. Composition: [framing, layout, negative space, subject placement]. Style and lighting: [visual language, medium, mood, light direction]. Constraints: [what must not change, no extra words, no watermark]. Output format: [aspect ratio, transparent background, video-ready frame].
스타일보다 먼저 역할을 명시하세요
포스터, 제품 광고, 앱 화면, 캐릭터 시트, 다이어그램, 편집, 영상 첫 프레임 등 출력 유형을 먼저 제시해서, 모델이 어떤 기준으로 평가받는지 알게 하세요.
약함: A cool futuristic speaker, cinematic, high detail.
더 나음: Create a premium product ad for a matte black wireless speaker. The image should work as a 16:9 campaign banner, with the product on the right, a short headline on the left, clean negative space, and sharp product edges.
두 번째 버전은 모델에게 이 작업이 미학뿐 아니라 레이아웃과 실용성으로 평가받는다는 것을 알려줍니다.
텍스트는 고정된 자산처럼 다루세요
필요한 문구는 반드시 따옴표 안에 넣고 정확히 어떻게 렌더링되어야 하는지 명시하세요 — 모델이 직접 문구를 지어내길 원하는 게 아니라면 그냥 “슬로건”이라고만 요청하지 마세요.
Headline: “SOUND YOU CAN FEEL”. Render the headline verbatim. No extra words, no duplicate text, no fake logo. Bold white sans-serif type, left side of the composition, readable from a distance.
더 긴 문구의 경우, 프롬프트 안에서 각 줄을 명시적으로 나누세요. 단어가 잘못 표기되어 돌아온다면, 더 짧은 문구, 더 큰 글씨, 더 엄격한 “정확한 텍스트만” 지시로 다시 생성하세요.
모델에게 카메라와 레이아웃을 부여하세요
카메라 거리, 각도, 피사체 배치, 여백, 화면 비율을 직접 명시하세요 — GPT Image 2는 구도 신호를 잘 따르지만, 오직 명확하게 서술되었을 때만 그렇습니다.
- 클로즈업은 제품 질감, 손, 얼굴, 소재, 라벨에 사용합니다.
- 와이드 샷은 환경, 스토리 장면, 도시 포스터, 영상용 프레임에 사용합니다.
- 탑다운은 음식, 책상 장면, 플랫레이, 패키징 세트에 사용합니다.
- 좌측 3분의 1 / 우측 3분의 1은 텍스트와 제품의 균형을 맞추는 광고 레이아웃에 사용합니다.
- 깔끔한 그리드는 UI 목업, 캐릭터 시트, 다이어그램, 인포그래픽에 사용합니다.
편집 프롬프트는 세 문장으로 작성하세요
가장 강력한 편집 프롬프트는 변경 사항을 유지되어야 할 것, 그리고 이 둘을 이어주는 물리적 사실성과 분리해서 작성합니다.
Replace the parked car with a vintage bicycle. Preserve the house, fence, driveway, landscaping, lighting direction, camera angle, and time of day exactly. Match the bicycle scale, contact shadow, and perspective to the existing scene.
이 “변경, 유지, 일치” 구조는 막연한 “더 낫게 만들어줘” 요청보다 꾸준히 더 나은 결과를 냅니다.
정지 이미지가 영상이 될 경우 움직임 신호를 추가하세요
이미지가 이후 PixVerse 이미지-영상 파이프라인에 투입될 수 있다면, 처음부터 깊이감과 움직임 준비 상태를 위한 프롬프트를 작성하세요. 전경, 중경, 배경, 깔끔한 피사체 실루엣, 그리고 움직일 수 있는 뚜렷한 요소 하나 — 먼지, 천, 머리카락, 비, 반사, 또는 카메라 이동 경로.
대신 쓰지 말 것: An astronaut in a desert.
이렇게 쓸 것: A cinematic first frame for an image-to-video clip: a lone astronaut standing at the edge of a glowing desert crater at dawn, cape and dust ready to move in the wind, strong foreground silhouette, clear depth layers, and warm horizon light.
GPT Image 2 테스트 방법
두 라운드에 걸친 테스트에서, 저희는 이 모델에 인물 사진, 텍스트가 많은 포스터, 제품 스타일 구도, 캐릭터 시트, UI 목업, 실험적인 서사 장면을 시켜봤습니다. 목표는 벤치마크 점수가 아니라, 디자이너나 마케터, 크리에이터가 처음부터 다시 만들지 않고 가벼운 수정만으로 결과물을 사용할 수 있는지였습니다.
| 테스트 영역 | 확인한 내용 |
|---|---|
| 인물 사진과 시네마틱 스틸컷 | 조명 제어, 피부 질감, 반사, 분위기, 장면 일관성 |
| 포스터 및 타이포그래피 레이아웃 | 헤드라인 철자, 여러 줄 텍스트, 위계, 여백, 브랜드급 완성도 |
| 캐릭터 및 콘셉트 시트 | 다중 시점 일관성, 의상 디테일, 팔레트 정합성, 라벨 정확도 |
| UI 및 소셜 목업 | 레이아웃 사실성, 작은 텍스트, 아이콘 간격, 피드 그리드, 스크린샷 신빙성 |
| 실험적 프롬프트 | 유머, 서사적 추론, 오브젝트 배치, 작은 캡션 정확도 |
이 패턴은 두 라운드 모두에서 유지되었습니다. GPT Image 2는 키워드 나열보다 정확한 브리프에 더 잘 보답합니다. 프롬프트가 역할을 명시하고 성공 기준을 정의할 때 — 정확한 텍스트, 고정된 레이아웃, 반복 가능한 패널 구조 — 모델은 구조를 유지하는 경향이 있습니다. 프롬프트가 막연한 분위기만 요청할 경우, 결과는 여전히 세련되어 보일 수 있지만 수정 없이 재사용하기는 더 어렵습니다.
프롬프트 예시로 보는 GPT Image 2 활용 사례
저희는 다음 시나리오에 걸쳐 다섯 가지 뚜렷한 역량을 집중적으로 테스트했습니다. 조명 제어, 정확한 텍스트 타이포그래피, 다중 요소 구도, 캐릭터 일관성, UI 레이아웃입니다. 아래 각 프롬프트는 바로 복사해서 조정할 수 있습니다.
시네마틱 인물 사진
이는 조명, 분위기, 절제된 구도에 대한 모델의 이해도를 확인합니다 — 포트폴리오급 이미지와 평범한 AI 렌더를 가르는 기본기입니다.
프롬프트:
Generate a cinematic portrait of a solitary figure standing in an intense orange-to-red gradient environment. Strong silhouette lighting from behind, deep shadow contrast, reflective glossy floor mirroring the figure. Symmetrical composition, minimal set design, no background clutter. The mood is contemplative and powerful, like a still from a science-fiction film. Aspect ratio 16:9.
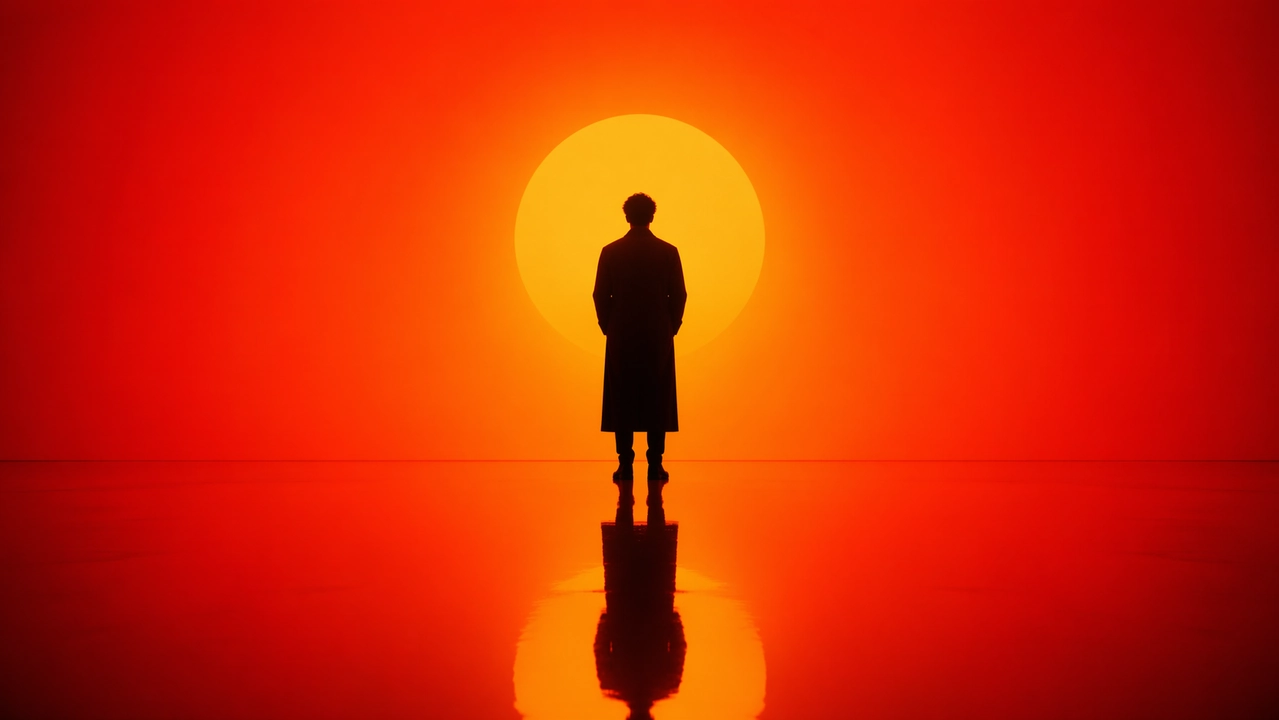
확인할 점: 후광 아티팩트 없는 깔끔한 실루엣 윤곽, 정확한 원근감의 바닥 반사, 부드럽고(밴딩 없이) 매끈한 그라디언트, 그리고 뻣뻣하거나 붕 떠 보이지 않고 실제 무게감이 느껴지는 포즈입니다.
도시 포스터 및 일러스트레이션 디자인
읽기 쉬운 타이포그래피와 밀도 높은 다중 요소 구도를 결합한 가장 어려운 스트레스 테스트입니다 — 10개 이상의 뚜렷한 시각 요소가 S자 곡선을 따라 배치되고, 영문 텍스트는 렌더링 과정에서 온전히 살아남아야 합니다.
프롬프트:
A striking Spring 2026 city poster for New York with a bold contemporary design and an elegant celebratory mood. Clean off-white textured background with generous negative space. A miniature kayaker paddles across a narrow ribbon of reflective water in the lower-right corner. The wake sweeps upward in a dynamic calligraphic curve, gradually transforming into the Hudson River and then into a dreamlike hand-painted panorama of Manhattan. Inside the flowing river-shaped composition: the Empire State Building, Brooklyn Bridge, Central Park canopy, One World Trade Center, brownstone rooftops, yellow cabs, harbor ferries, and the Statue of Liberty in soft distance. Soft morning fog, golden spring light, subtle accents in navy and gold. Elegant typography in the lower left reads “SPRING 2026” with a vertical slogan “NEW YORK — A CITY OF BRIDGES, DREAMS, AND REINVENTION”. Text must be sharp and beautifully composed. No extra words. Premium graphic design, aspect ratio 9:16.
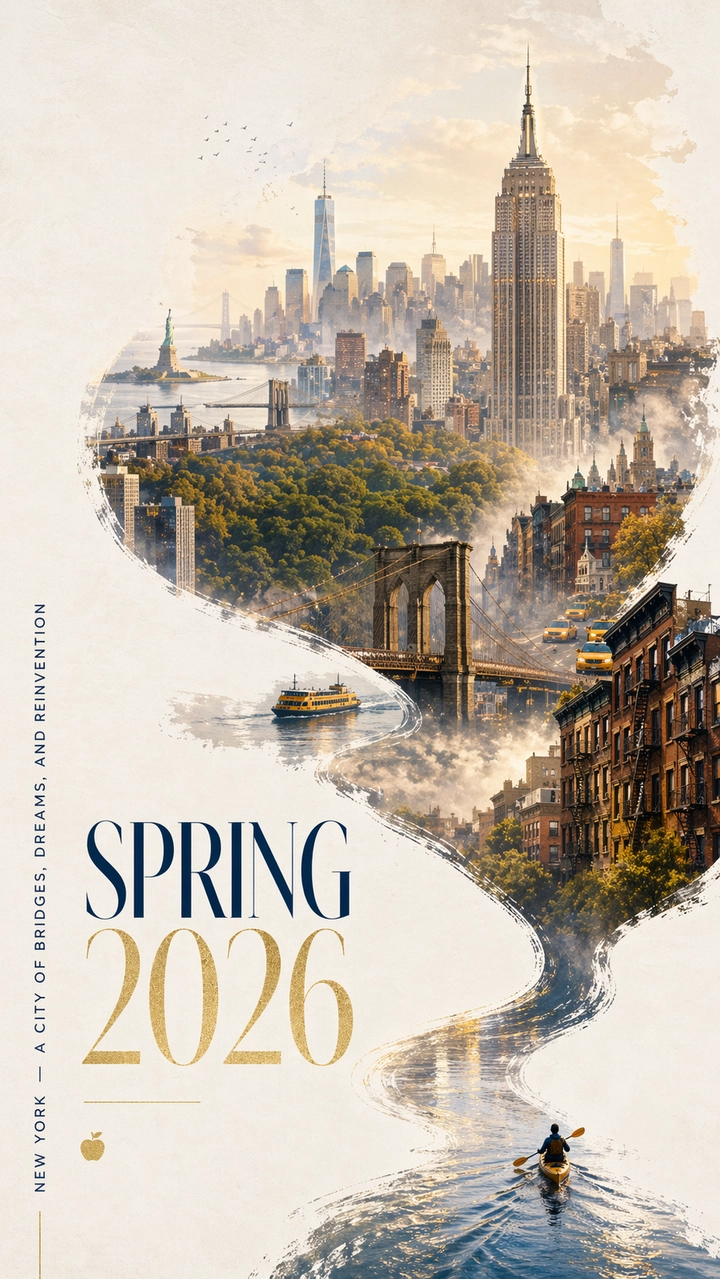
확인할 점: 제목과 슬로건의 모든 글자가 읽기 쉽고 철자가 정확해야 하며, S자 곡선이 카약 이용자에서 스카이라인까지 자연스럽게 흘러야 하고, 랜드마크 건물들이 일반적인 타워가 아니라 알아볼 수 있는 모습으로 표현되어야 하며, 여백이 비어 보이지 않고 의도적으로 느껴져야 합니다.
캐릭터 디자인 및 레퍼런스 시트
게임 개발자와 콘셉트 아티스트는 단 한 번의 생성으로 다중 시점 일관성을 필요로 합니다. 이는 모델이 정면, 측면, 후면에 걸쳐 캐릭터 디자인을 안정적으로 유지할 수 있는지 확인합니다.
프롬프트:
Create a professional character reference sheet for an original fantasy RPG character: a young female mage with silver hair and violet eyes, wearing an ornate dark cloak with glowing rune patterns. Include on a clean white background: a three-view turnaround showing front, side, and back; facial expression variations showing neutral, smiling, angry, and surprised; detailed breakdowns of costume and equipment pieces; a color palette swatch row; and brief world-building notes in clean typography. Organized grid layout, concept art style, high resolution. Aspect ratio 16:9.
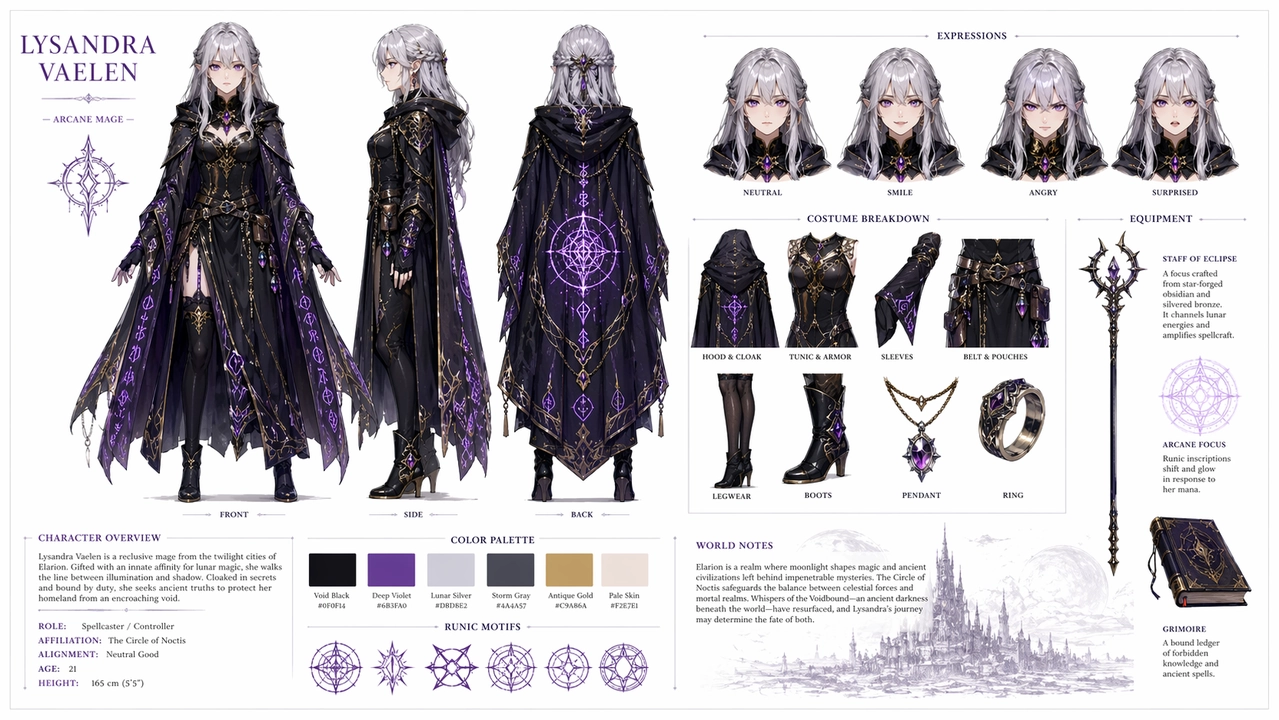
확인할 점: 얼굴, 머리카락, 의상이 세 시점 모두에서 일관되게 유지되어야 하고, 표정 변화는 헤어스타일이나 의상이 아니라 얼굴만 바뀌어야 하며, 팔레트 스와치는 실제로 그림에 사용된 색상과 일치해야 하고, 텍스트 라벨이 철자가 정확해야 합니다. 측면이나 후면 뷰가 어긋난다면, 정체성 기준점을 반복하는 더 강력한 “유지” 언어로 다시 생성하세요.
UI 및 소셜 미디어 목업
이는 세 가지를 동시에 시험합니다. 픽셀 단위로 정확한 UI 레이아웃, 다국어 텍스트 렌더링, 그리고 창의적인 콘셉트 융합 — 소셜 플랫폼에서도 좋은 성과를 내는 경향이 있는 종류의 콘텐츠입니다.
프롬프트:
A hyper-realistic iPhone screenshot of a fictional Instagram profile page for Leonardo da Vinci, username @davinci_official, as if he were a modern influencer in 2026. Profile photo is a Renaissance self-portrait in a circle crop. Bio reads: “Artist, Engineer, Inventor | Currently dissecting things | DM for commissions”. The grid shows 9 posts: the Mona Lisa reframed as a mirror selfie, a helicopter sketch captioned “just dropped my new drone design”, an anatomy study posted as a gym progress photo, The Last Supper staged as a dinner party group shot, and other creative anachronistic mashups. Follower count: 12.4M. Story highlights labeled Sketches, Inventions, and Florence Life. Complete iOS status bar with carrier text reading “Renaissance 5G”, battery icon, and current time. Dark mode UI throughout. Photorealistic screenshot quality, aspect ratio 9:16.
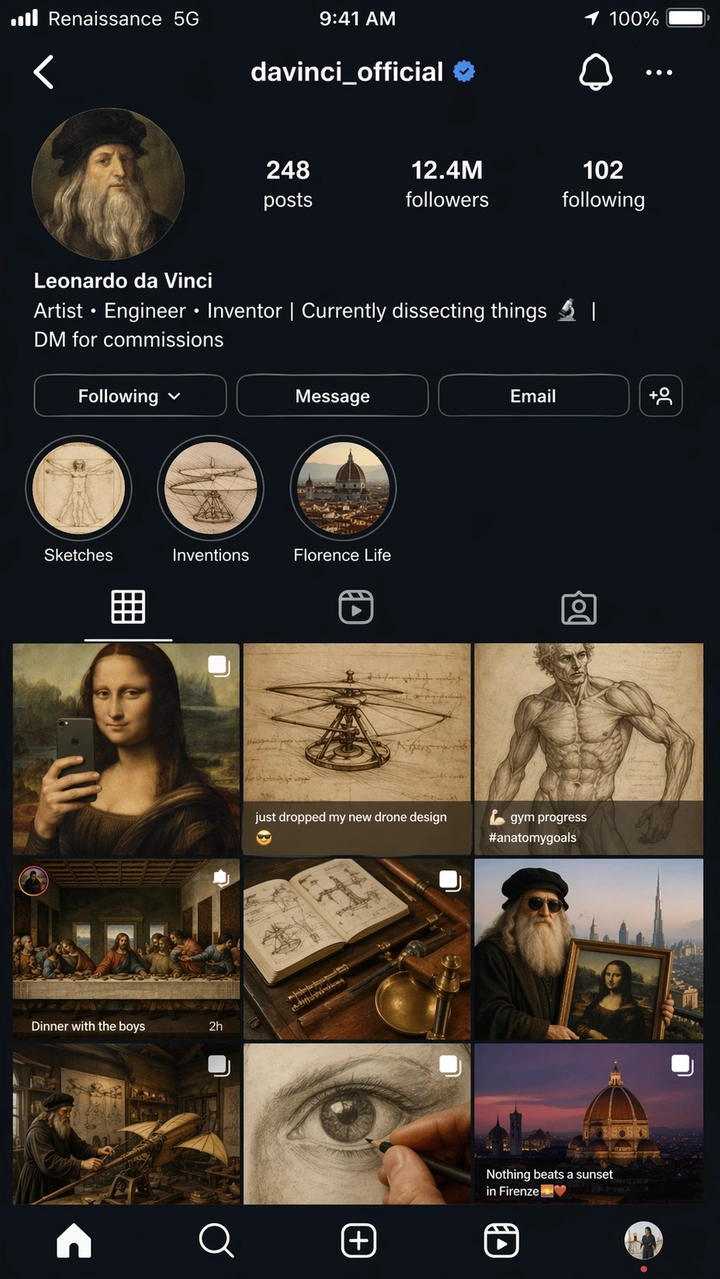
확인할 점: 인스타그램 UI 요소들 — 그리드 간격, 프로필 레이아웃, 스토리 원형, 탭 바 — 은 양식화된 근사치가 아니라 실제 iOS 스크린샷처럼 읽혀야 합니다. 모든 텍스트가 읽기 쉬워야 하며, “Renaissance 5G” 통신사 라벨은 의도적인 정확도 확인 지점입니다. UI 목업 결과물은 프로덕션 준비가 된 UI가 아니라 콘셉트 레퍼런스로 다뤄야 합니다. 작은 라벨과 아이콘 정렬은 보통 정리 작업이 필요합니다.
창의적이고 실험적인 아트
내재된 서사적 유머가 있는 짧은 프롬프트는 모델이 방대한 지시 없이도 스스로 창의적 공백을 채우는지 시험합니다.
프롬프트:
Inside a museum exhibit titled “Ancient Technology: The Desktop Era”, a programmer in a glass display case is live-demonstrating coding on a CRT monitor while amazed schoolchildren press their faces against the glass. The exhibit placard reads: “Homo Developerus (c. 2005) — Primitive human using keyboard-based input devices.” A second display case nearby shows a physical book labeled “Stack Overflow — Print Edition, Vol. 1 of 4,827”. 2D cartoon illustration style, warm museum lighting, humorous and nostalgic tone. Aspect ratio 16:9.
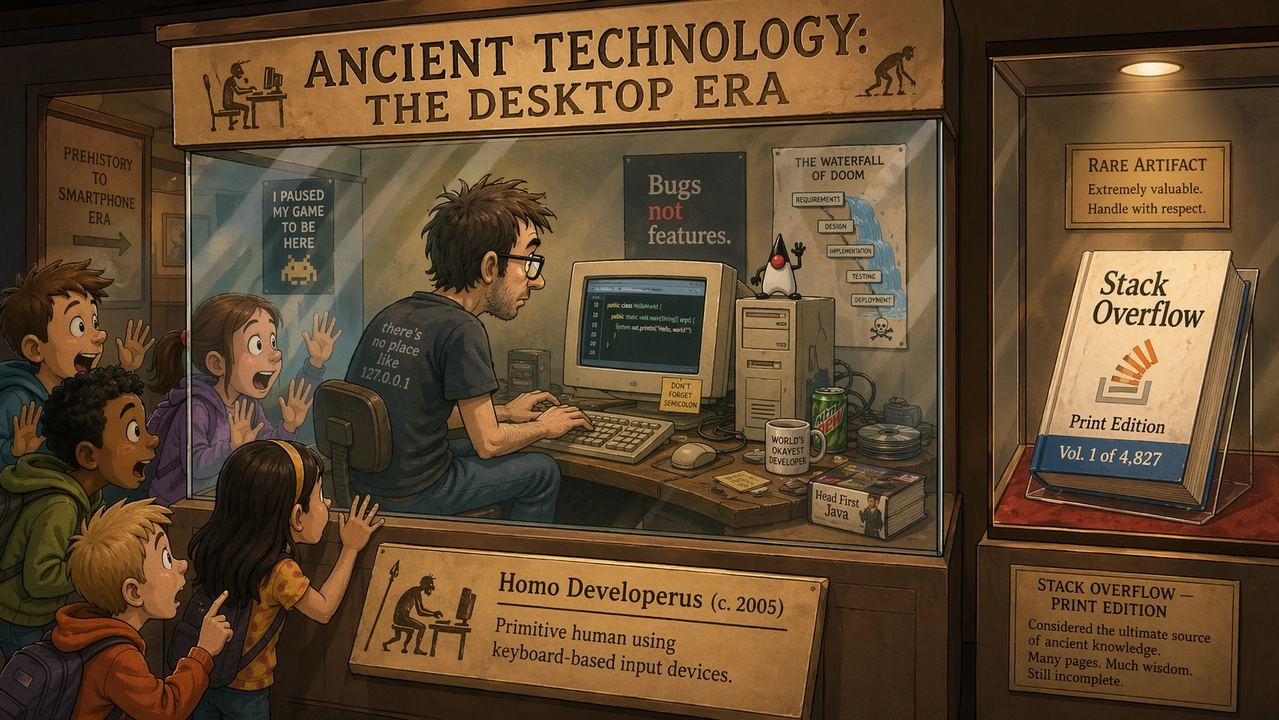
확인할 점: 유머는 캡션 텍스트만이 아니라 시각적 디테일을 통해서도 전달되어야 합니다. 명패와 책 제목은 읽기 쉽고 철자가 정확해야 하는데, 이는 작은 크기의 여러 줄 텍스트에 대한 정말로 어려운 테스트입니다. 그리고 카툰 스타일은 장면 곳곳이 부분적으로 사실적으로 보이지 않고 전체적으로 일관되게 느껴져야 합니다.
활용 사례별 테스트 결과
가장 강력한 결과는 철자, 레이아웃, 오브젝트 보존, 패널 순서처럼 판단 가능한 명확한 제작 기준이 있는 프롬프트에서 꾸준히 나왔습니다. 막연한 분위기만 요청한 프롬프트는 결과가 더 들쭉날쭉했습니다.
| 활용 사례 | 잘 작동한 부분 | 여전히 검토가 필요한 부분 |
|---|---|---|
| 텍스트 렌더링 | 정확한 문구를 따옴표로 명시했을 때 큰 헤드라인, 짧은 라벨, 포스터 제목, 단순한 UI 라벨은 정확하게 유지됐습니다. | 아주 작은 법적 문구, 밀도 높은 문단, 양식화된 폰트는 여전히 어긋날 수 있습니다 — 문구를 짧게 유지하고 글자마다 확인하세요. |
| 제품 이미지 | 깔끔한 광고 레이아웃, 캠페인용 여백, 제품 중심 구도는 잘 렌더링됐습니다. | 실제 라벨, 로고, 규제 관련 문구는 여전히 수동 검토나 승인된 자산으로부터의 합성이 필요합니다. |
| UI 목업 | 프롬프트가 실제 인터페이스 요소를 명시했을 때 모바일 화면, 대시보드, 앱과 같은 위계 구조가 그럴듯하게 보였습니다. | 결과물을 콘셉트 목업으로 다루세요 — 작은 라벨과 아이콘 정렬은 보통 정리 작업이 필요합니다. |
| 캐릭터 일관성 | 캐릭터 시트, 표정 행, 팔레트 스와치는 창의적 레퍼런스로 잘 작동했습니다. | 얼굴과 의상 디테일은 시점마다 어긋날 수 있습니다 — 정체성 기준점을 반복하고 필요하면 다시 생성하세요. |
| 편집 및 합성 | “변경, 유지, 일치” 패턴이 광범위한 편집 요청보다 더 나은 성과를 냈습니다. | 선택 영역 경계와 투명 배경 출력은 여전히 품질 검증이 필요합니다. |
GPT Image 2 프롬프트 작성 시 흔한 실수
- 정확한 문구를 제공하지 않고 정확한 텍스트를 요구하는 것. 텍스트가 중요하다면 그대로 적어주고 어디에 위치해야 하는지 말해주세요.
- 하나의 프롬프트에 가능한 모든 디테일을 과도하게 담는 것. 핵심 장면부터 시작한 다음, 한 번에 하나씩 변수를 다듬으세요.
- 편집 시 불변 요소를 명시하지 않는 것. 변하지 않아야 할 것을 명확히 하세요: 정체성, 배경, 포즈, 조명, 제품 형태, 라벨 텍스트, 카메라 각도.
- 기능적인 작업에 장식적인 품질 표현어에 의존하는 것. “아름다운”이라는 말이 라벨을 읽기 쉽게 만들어주지는 않습니다 — 대신 “선명한 라벨 텍스트”나 “멀리서도 읽을 수 있는” 같은 표현을 사용하세요.
- 화면 비율을 생략하는 것. 강력한 정사각형 이미지도 세로형 광고나 영상 썸네일로는 실패할 수 있습니다.
- 로고를 일반 텍스트처럼 다루는 것. GPT Image 2는 로고 콘셉트는 디자인할 수 있지만, 정확한 브랜드 마크는 직접 프롬프트로 요청하기보다 승인된 자산에서 합성해야 합니다.
GPT Image 2 API 및 가격 안내
OpenAI의 API 가격 페이지는 GPT Image 2를 정액제 이미지당 요금이 아니라 토큰 단위로 표기하고 있습니다.
| 항목 | 명시된 가격 |
|---|---|
| 이미지 입력 | 100만 토큰당 $8.00 |
| 캐시된 이미지 입력 | 100만 토큰당 $2.00 |
| 이미지 출력 | 100만 토큰당 $30.00 |
| 텍스트 입력 | 100만 토큰당 $5.00 |
| 캐시된 텍스트 입력 | 100만 토큰당 $1.25 |
이미지당 실제 비용은 프롬프트 길이, 레퍼런스 이미지, 출력 크기, 캐싱, 품질 설정에 따라 달라집니다. ChatGPT 요금제 할당량은 API 청구와는 별도의 트랙입니다 — Plus 구독이 API 크레딧으로 바로 전환되지 않으므로, 둘 다 사용한다면 예산을 각각 따로 잡으세요.
대량 워크플로우에서는 단일 시도의 정가가 아니라, 재시도를 거친 후 채택된 자산 하나당 비용이 중요한 숫자입니다. 철자나 레이아웃을 맞추기 위해 세 번의 재생성이 필요하다면, 더 저렴한 생성이라도 실제로는 더 저렴하지 않습니다.
| 워크플로우 | 실용적인 프롬프트 작성 조언 |
|---|---|
| 텍스트가 많은 포스터나 다이어그램 | 이미지당 단어 수를 줄이고, 정확한 문구를 인용하며, 위계를 명시적으로 지정하세요. |
| 제품 사진 | 제품 형태, 라벨, 색상, 소재, 카메라 각도를 고정하고, 모든 편집 단계마다 유지 목록을 반복하세요. |
| UI 목업 | 화면을 콘셉트 아트가 아니라 출시된 인터페이스로 — 내비게이션, 카드, 버튼, 상태를 — 묘사하세요. |
| 다중 레퍼런스 편집 | 각 입력 이미지를 역할별로 라벨링하세요: 피사체, 스타일, 배경, 의상, 또는 소재 레퍼런스. |
| 배치 생성 | 시도당 비용이 아니라 채택된 이미지당 비용을 추적하세요. |
동일한 프롬프트에서 GPT Image 2가 사실주의 우선 대안과 어떻게 비교되는지 보고 싶다면, 저희의 GPT Image 2 vs. Nano Banana 2 비교에서 여섯 차례의 정면 대결과 API 및 플랫폼 가격 상세 분석을 확인해 보세요.
이미지에서 영상으로: PixVerse에서 창작 워크플로우 완성하기
강력한 이미지를 생성하는 것은 한 단계일 뿐입니다. 대부분의 워크플로우가 무너지는 지점은 그것을 움직임으로 바꾸는 과정입니다 — GPT Image 2에서 인물 사진이나 제품 포스터를 완성한 다음, 별도의 도구를 열어 파일을 다시 업로드하고, 영상 모델이 공들여 구성한 이미지를 왜곡하지 않기만을 바라야 합니다. 그 인계 과정의 마찰이야말로 PixVerse가 없애는 부분입니다.
GPT Image 2, PixVerse에서 바로 사용 가능
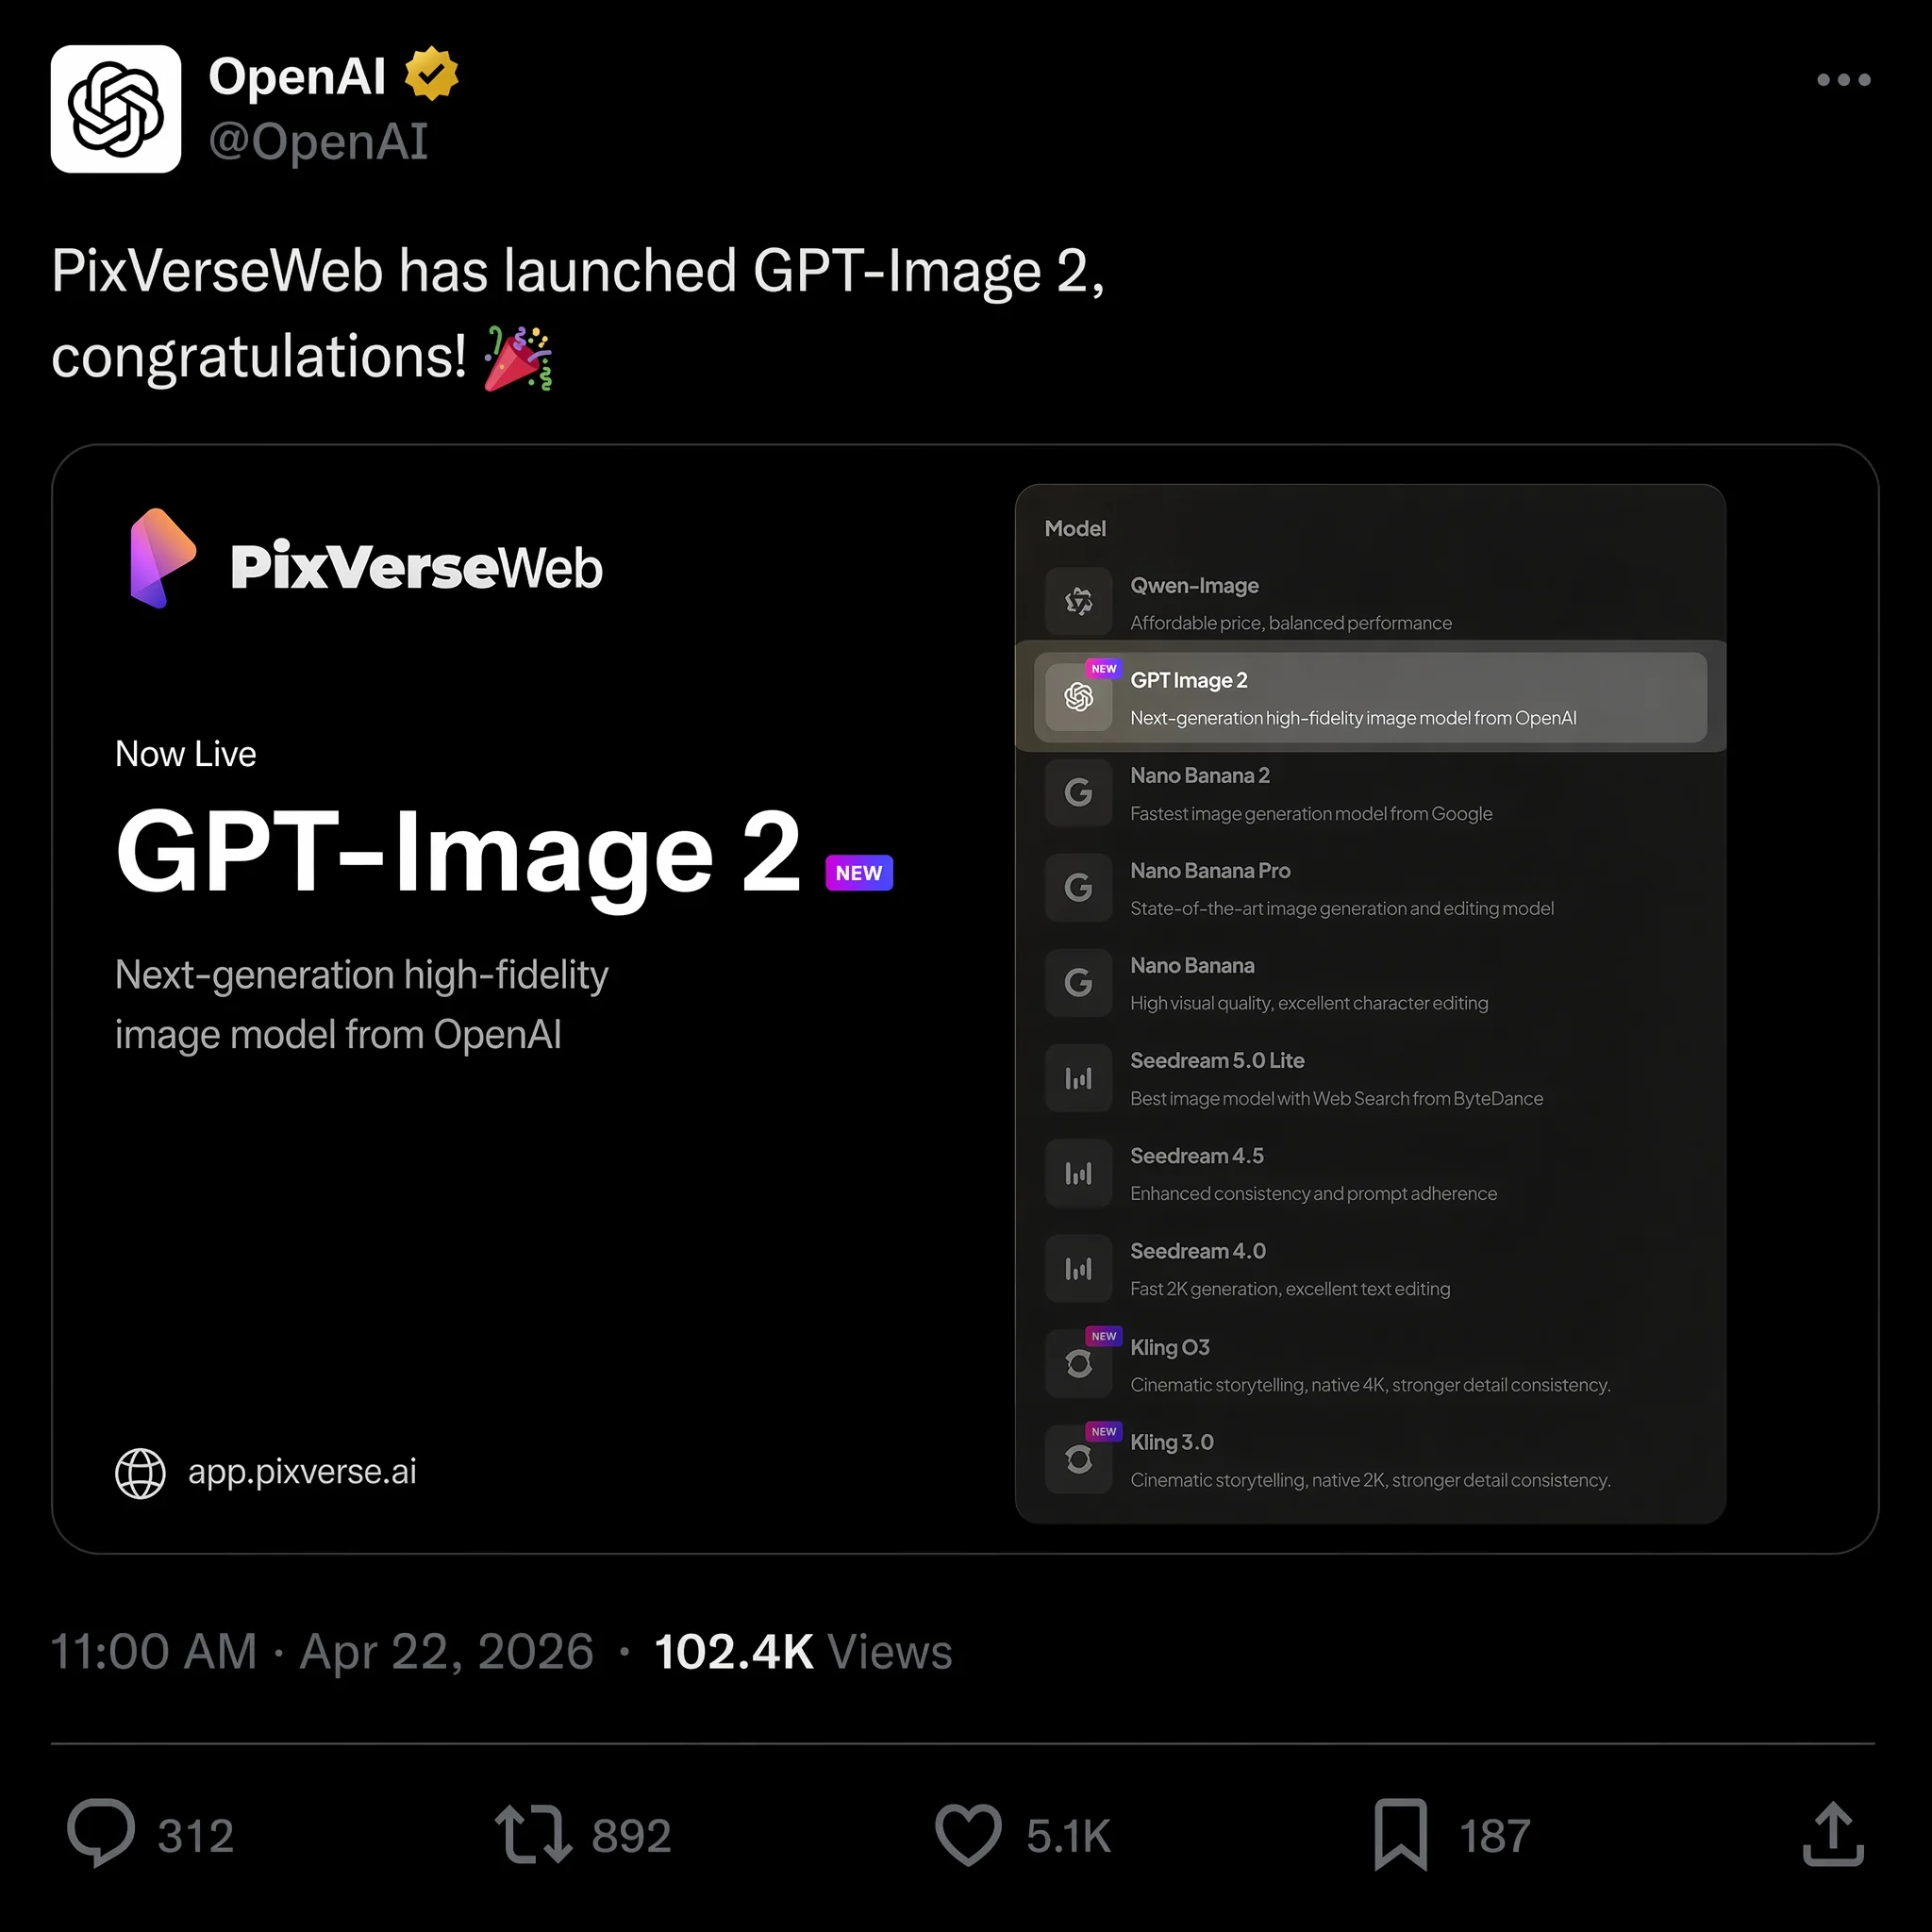
2026년 4월 22일, PixVerse는 텍스트-이미지 옵션으로 GPT Image 2를 추가하여, 모델 라인업에서 Nano Banana 2, Seedream, HappyHorse 1.0과 함께하게 됐습니다. 다운로드, 재업로드, 탭 전환 없이 같은 워크스페이스 안에서 GPT Image 2로 이미지를 생성하고 영상으로 변환할 수 있습니다.
이것이 중요한 구체적인 이유가 있습니다. 이미지가 같은 플랫폼의 이미지-영상 파이프라인으로 바로 이어질 때, 영상 모델은 전체 해상도의 소스 파일과 그 메타데이터를 직접 사용해 작업합니다. 그 과정에서 압축이나 포맷 변환으로 인한 품질 손실이 없으므로, 최종 클립에서 더 깔끔한 움직임과 더 적은 아티팩트로 이어집니다.
정지 이미지가 클립이 될 예정이라면, 처음부터 움직임 준비 상태를 위한 프롬프트를 작성하세요 — 전경, 중경, 배경의 깊이감, 깔끔한 피사체 실루엣, 그리고 그럴듯하게 움직일 수 있는 물리적 요소 하나(먼지, 증기, 천, 흔들리는 광원)를 요청하세요. 애니메이션 작업 전에 정지 이미지를 완성된 디자인 파일처럼 검토하세요 — 철자, 제품 형태, UI 정렬을 먼저 확인하세요. 영상 모델은 스스로 잘못 표기된 헤드라인이나 왜곡된 라벨을 고쳐주지 않기 때문입니다. 그런 다음 전체 이미지 브리프를 반복하는 대신, 무엇이 움직여야 하고 무엇이 고정되어야 하는지만 설명하는 별도의 더 짧은 모션 프롬프트를 작성하세요.
크리에이터들이 올인원 플랫폼으로 이동하는 이유
2026년 3월 이전에 영상 생성을 위해 OpenAI의 Sora를 사용하고 있었다면, 하나의 도구를 중심으로 워크플로우를 구축하는 위험을 이미 알고 있을 것입니다. OpenAI는 지속 불가능한 비용과 로보틱스로의 전환을 이유로 3월 24일 Sora 앱과 API를 종료했고, 수천 명의 크리에이터가 하룻밤 사이에 영상 파이프라인을 잃었습니다. 무슨 일이 있었고 어떤 도구들이 그 공백을 채웠는지 자세히 알아보려면 저희의 Sora 대안 가이드를 참고하세요.
PixVerse는 하나의 모델에 가두는 대신, 전체 창작 파이프라인에 걸쳐 여러 모델에 대한 접근을 제공하는 다른 접근 방식을 취합니다.
- 텍스트-이미지: GPT Image 2, Nano Banana 2, Seedream 등 — 작업에 맞는 모델을 선택하세요
- 이미지-영상: 생성한 이미지를 캐릭터 일관성과 카메라 제어를 갖춘 움직임으로 변환합니다
- 텍스트-영상: PixVerse V6나 시네마틱 C1 모델을 사용해 작성한 프롬프트만으로 직접 클립을 생성합니다
- 네이티브 오디오 생성: 효과음과 대사를 영상에 자동으로 동기화합니다
실질적인 이점은, 하나의 워크스페이스를 벗어나지 않고 문서화된 콘셉트에서 동기화된 오디오가 있는 완성된 영상까지 갈 수 있다는 것이며, 이는 프로젝트마다 몇 시간의 파일 관리를 없애줍니다. 커맨드라인에서 생성을 스크립트화하고 싶다면, PixVerse CLI 가이드에서 이미지와 영상 생성 자동화를 모두 다룹니다.
PixVerse는 또한 신규 사용자에게 하루 30~60 크레딧을 무료로 제공하므로, 유료 플랜에 가입하기 전에 이미지 생성부터 영상 출력까지 전체 파이프라인을 테스트해볼 수 있습니다.
자주 묻는 질문
GPT Image 2는 무료로 사용할 수 있나요?
무료 ChatGPT 사용자는 GPT Image 2로 하루에 약 두 장의 이미지를 생성할 수 있습니다. ChatGPT Plus 구독자(월 20달러)는 더 빠른 처리 속도와 함께 무제한 생성이 가능합니다. API 접근은 이미지 입력, 이미지 출력, 텍스트 입력에 걸쳐 토큰당 요금이 부과되므로, 비용은 정액제 이미지당 요금이 아니라 프롬프트 길이와 출력 크기에 따라 달라집니다.
GPT Image 2는 어떤 해상도를 지원하나요?
GPT Image 2는 네이티브 2K 해상도로 이미지를 생성하며, API를 통해 선택적으로 4K 업스케일이 가능합니다. 화면 비율은 3:1부터 1:3까지이므로, 정사각형, 세로형, 초광각 포맷을 모두 직접 사용할 수 있습니다.
GPT Image 2는 이미지 안의 텍스트를 정확하게 렌더링할 수 있나요?
네 — 가장 강력한 기능 중 하나입니다. 저희 테스트에서 영어, 중국어, 일본어, 한국어, 아랍어에 걸친 텍스트 정확도는 첫 생성 시도에서 95%를 넘었습니다. 여러 줄 헤드라인, 포스터 제목, UI 텍스트 라벨은 모두 안정적으로 처리되지만, 낮은 해상도의 아주 작은 텍스트는 여전히 가끔 실패할 수 있습니다.
GPT Image 2는 Midjourney 및 Nano Banana 2와 비교해서 어떤가요?
Midjourney V8은 더 강력한 예술적 스타일 제어와 미적 다듬기를 위한 더 확립된 커뮤니티를 갖고 있습니다. Nano Banana 2는 사실주의, 시네마틱 조명, 빠른 반복 작업에서 더 강력한 선택입니다. GPT Image 2는 텍스트 렌더링, 구조화된 레이아웃, 자연어 편집에서 우위를 갖고 있습니다. 텍스트가 포함된 포스터 디자인과 마케팅 소재라면 현재 GPT Image 2가 우세하고, 순수한 예술적 탐구나 포토리얼한 히어로 샷이라면 나머지 두 모델을 직접 비교해볼 가치가 있습니다 — 저희의 Nano Banana 2와의 정면 대결 테스트를 참고하세요.
종료 이후 영상용 Sora의 최고의 대안은 무엇인가요?
OpenAI가 2026년 3월 Sora를 종료한 이후, 최고의 대안으로는 캐릭터 일관성을 갖춘 멀티샷 영상을 위한 PixVerse V6, 시네마틱 카메라 제어를 위한 Runway Gen-4, 액션 시퀀스를 위한 Kling v3.0이 있습니다. PixVerse는 텍스트-이미지, 이미지-영상, 네이티브 오디오를 갖춘 텍스트-영상을 결합한 유일한 플랫폼이며, 모두 매일 무료 크레딧으로 이용할 수 있습니다. 자세한 비교는 저희의 전체 Sora 대안 가이드를 참고하세요.
GPT Image 2 결과물을 영상으로 만들 수 있나요?
네. PixVerse에서 GPT Image 2를 사용할 수 있으므로, 앱 안에서 이미지를 생성하고 같은 워크스페이스의 이미지-영상 파이프라인을 통해 파일 전송 없이 영상으로 변환할 수 있습니다. 다른 곳에서 만든 GPT Image 2 파일을 업로드해서 같은 파이프라인으로 처리할 수도 있습니다.