PixVerse-R1: 下一代实时世界模型
PixVerse-R1: 下一代实时世界模型
摘要
我们推出了 PixVerse-R1,这是一种基于原生多模态基础模型架构的下一代实时世界模型。该系统能够实现实时视频生成,视觉内容可对用户输入做出即时、流畅的响应。通过克服传统视频工作流固有的延迟和固定长度限制,PixVerse-R1 将视频生成转变为无限、连续且交互式的视觉流。这代表了视听媒体创作、体验和分享的一次重大进化,标志着向能够根据用户意图进行瞬时适应的智能化、交互式媒体的范式转移。
1. 引言
数字媒体领域正在从静态、预渲染的内容根本性地转向动态、交互式的体验。传统的制作流水线历来受高延迟和固定长度片段的约束,导致内容创作与实时消费之间存在隔阂。
为了解决这些局限性,我们引入了一种全新的世界模型架构,它统一了原生多模态基础模型、一致性自回归机制和瞬时响应引擎。这种统一的方法允许对时空补丁以及文本和音频数据进行联合处理,有效地拆解了传统的媒体处理孤岛。通过部署一个能够通过自回归机制和瞬时响应引擎进行无限流式传输的系统,生成的系统在长周期内保持物理一致性,且计算开销较低。
核心能力:凭借这种架构,我们的系统在性能上实现了突破,能够实时生成高达 1080P 的高分辨率视频。 这种能力增强了视觉保真度,并赋能了 AI 原生游戏和交互式电影,其中环境和叙事随着用户交互动态演变。从广义上讲,这使得生成系统能够作为持久的、交互式的世界运行,而非有限的媒体人工制品,预示着向连续、有状态且交互式的视听模拟方向发展。
2. 技术架构
2.1 Omni: 原生多模态基础模型
为了获得通用能力,我们通过设计一个完全端到端的原生多模态基础模型,超越了传统的生成流水线。
- 统一表示: Omni 模型将多种模态(文本、图像、视频、音频)统一为连续的令牌流,使其能够在单一框架内接受任意多模态输入。
- 端到端训练: 整个架构在异构任务上进行训练,无需中间接口,防止了误差传播并确保了强大的可扩展性。
- 原生分辨率: 我们在此框架内利用原生分辨率训练,以避免通常与裁剪或缩放相关的伪影。
此外,该模型通过从海量的现实世界视频数据语料库中学习,内化了现实世界的内在物理规律和动态。这种基础性的理解使系统能够实时合成一个一致、响应式的“平行世界”。
Omni 模型可以有效地扩展,它不仅作为一个生成引擎,而且是构建通用物理世界模拟器的开拓性一步。通过将模拟任务视为单一的、端到端的生成范式,我们促进了对实时、长周期 AI 生成世界的探索。
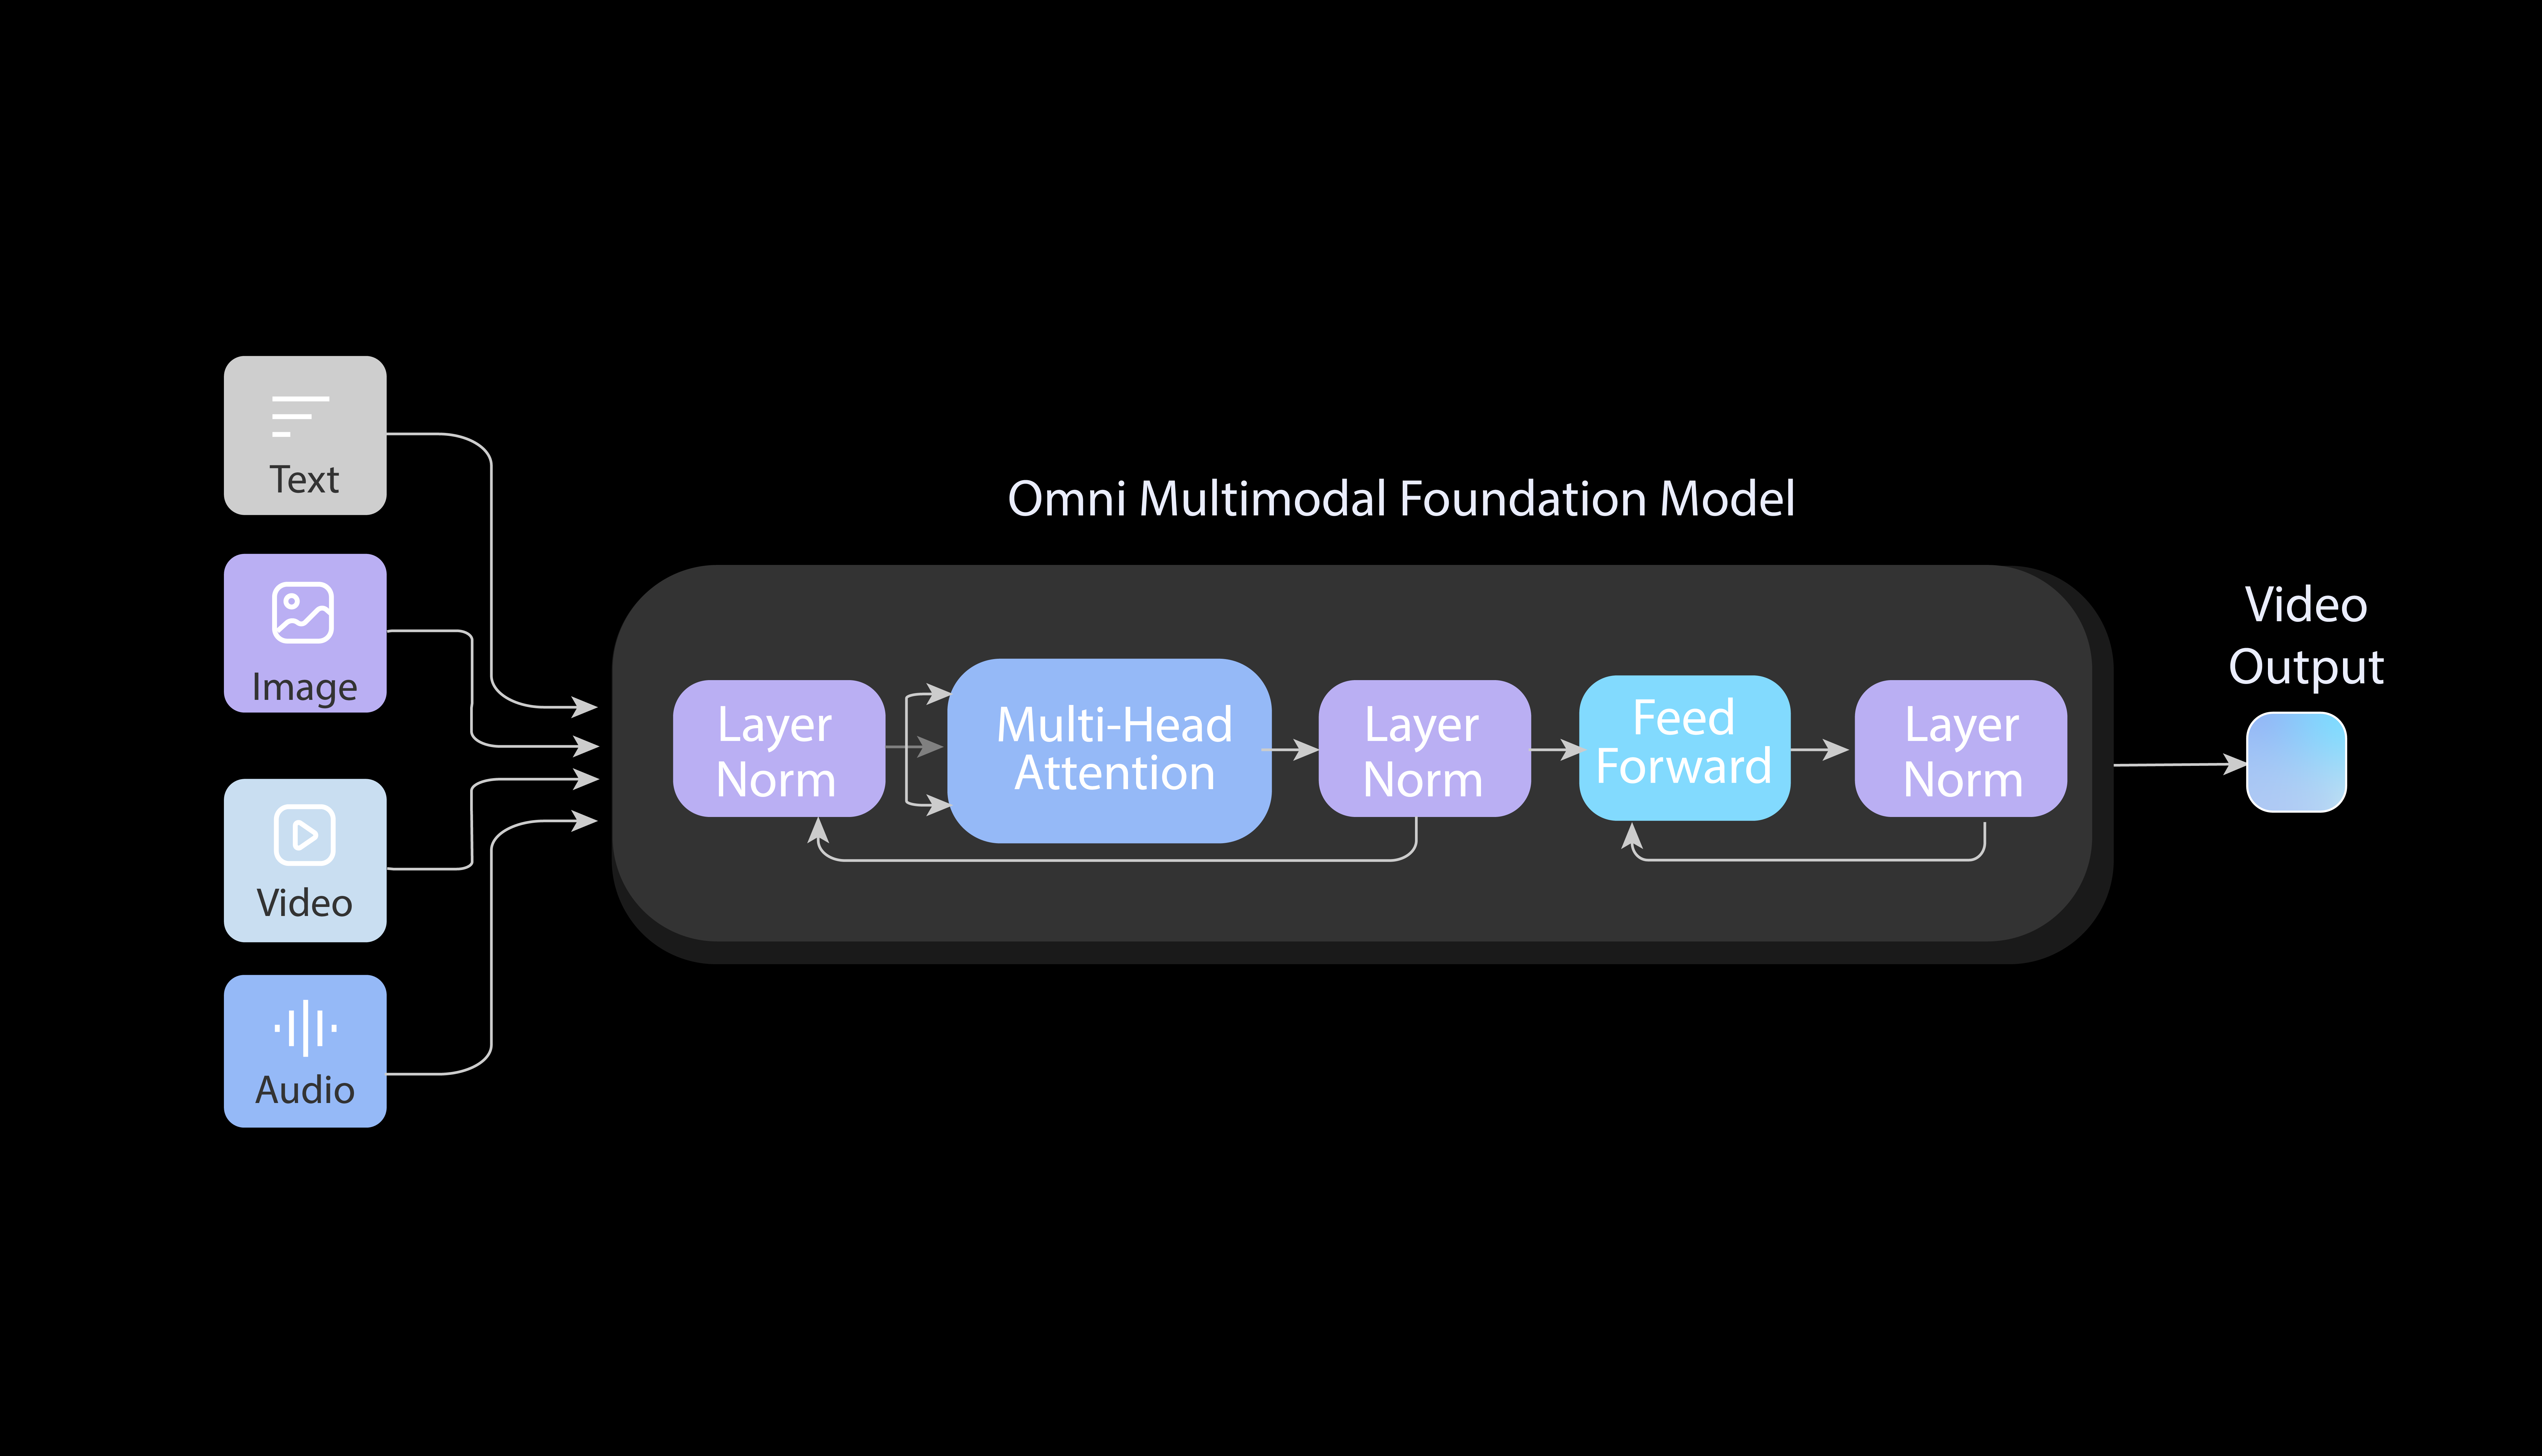
图 1. 我们的 Omni 原生多模态基础模型的端到端架构,统一的设计使我们的 Omni 模型能够同时接受任意多模态输入并生成音频和视频。
2.2 Memory: 通过自回归机制实现一致的无限流
与受限于有限片段的标准扩散方法不同,PixVerse-R1 集成了自回归建模以实现无限、连续的视觉流,并引入了记忆增强的注意力机制,以确保生成的系统在长周期内保持物理一致性。
- 无限流: 通过将视频合成公式化为一个自回归过程,模型顺序预测后续帧,以实现连续、无界的视觉流。
- 时间一致性: 记忆增强的注意力机制将当前帧的生成基于前序上下文的潜在表示,确保系统在长周期内保持物理一致性。
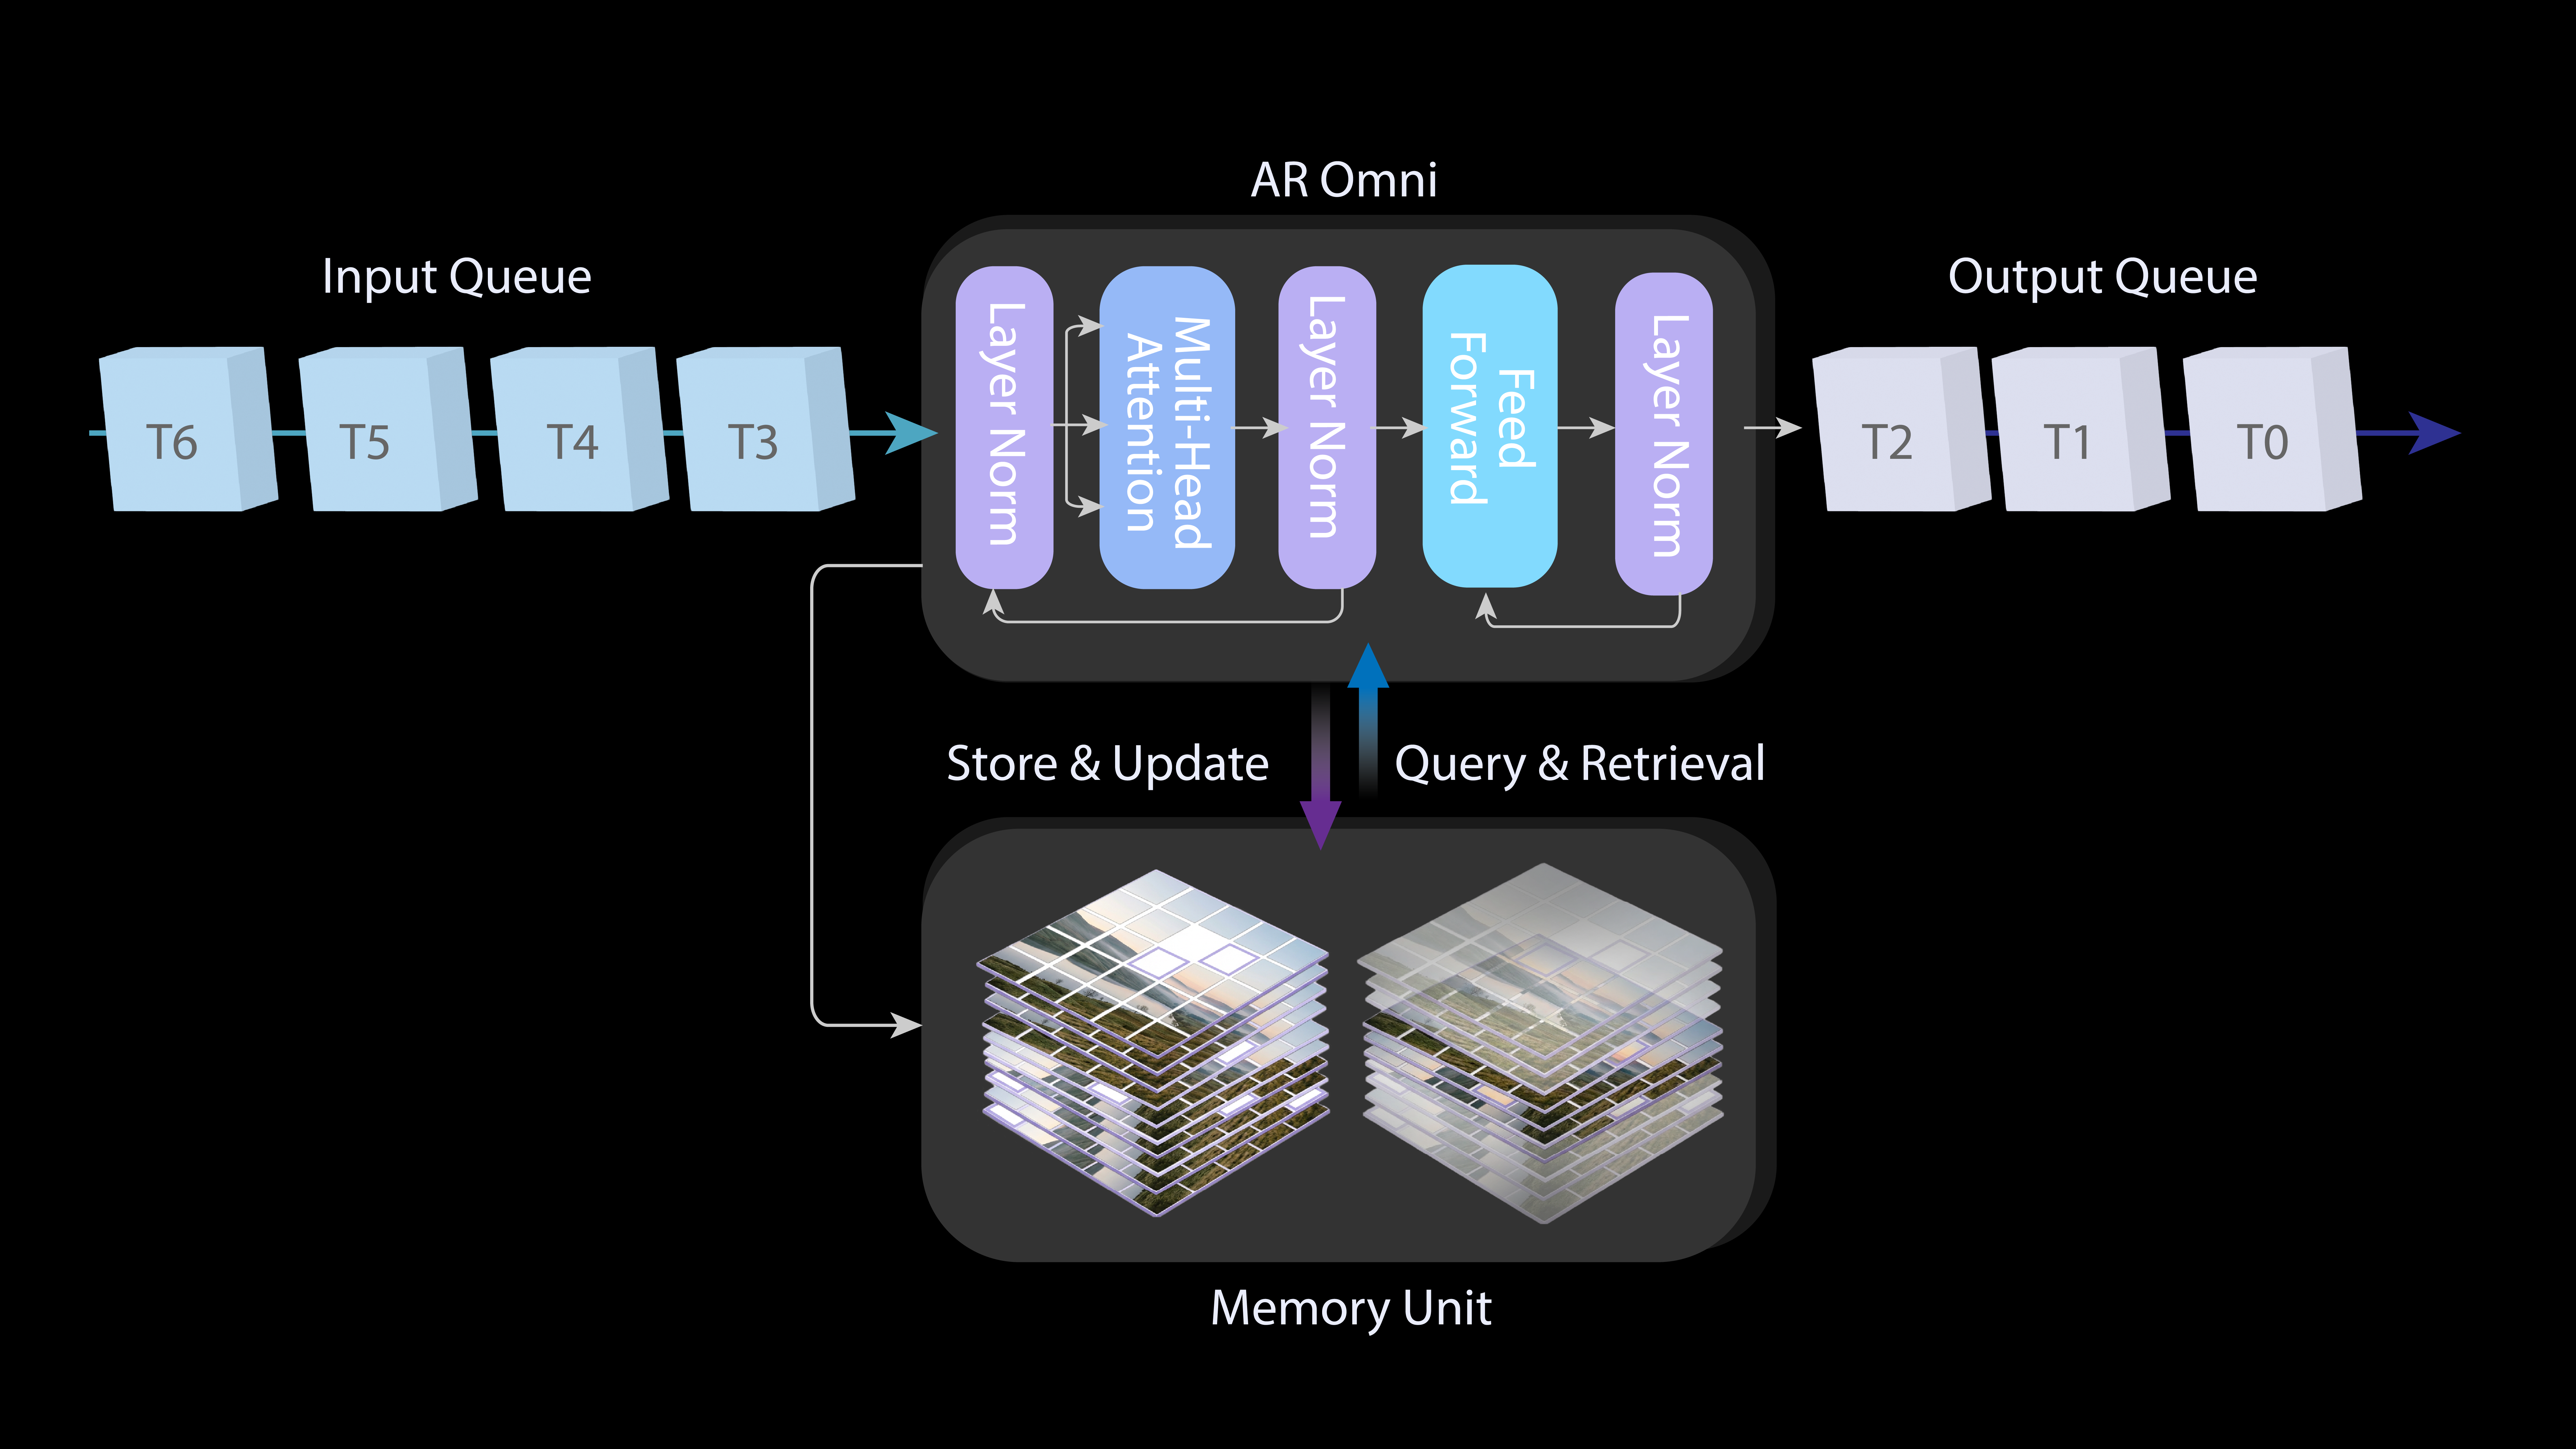
图 2. 集成自回归建模与 Omni 基础模型。
2.3 实时 1080P: 瞬时响应引擎
虽然迭代去噪通常能确保高质量,但其计算密度往往阻碍了实时性能。为了解决这个问题并实现高分辨率(高达 1080P)的实时生成,我们将流水线重新构建为瞬时响应引擎 (IRE)。
IRE 通过以下技术进步优化了采样过程:
- 时间轨迹折叠: 通过实施直接传输映射作为结构先验,网络直接预测干净的数据分布。这将采样步骤从几十步减少到仅 1-4 步,创造了超低延迟所必需的精简路径。
- 引导校正: 我们通过将条件梯度合并到学生模型中,绕过了 Classifier-Free Guidance 的采样开销。
- 自适应稀疏注意力: 这减轻了长程依赖的冗余,产生了一个浓缩的计算图,进一步促进了实时 1080P 生成的实现。
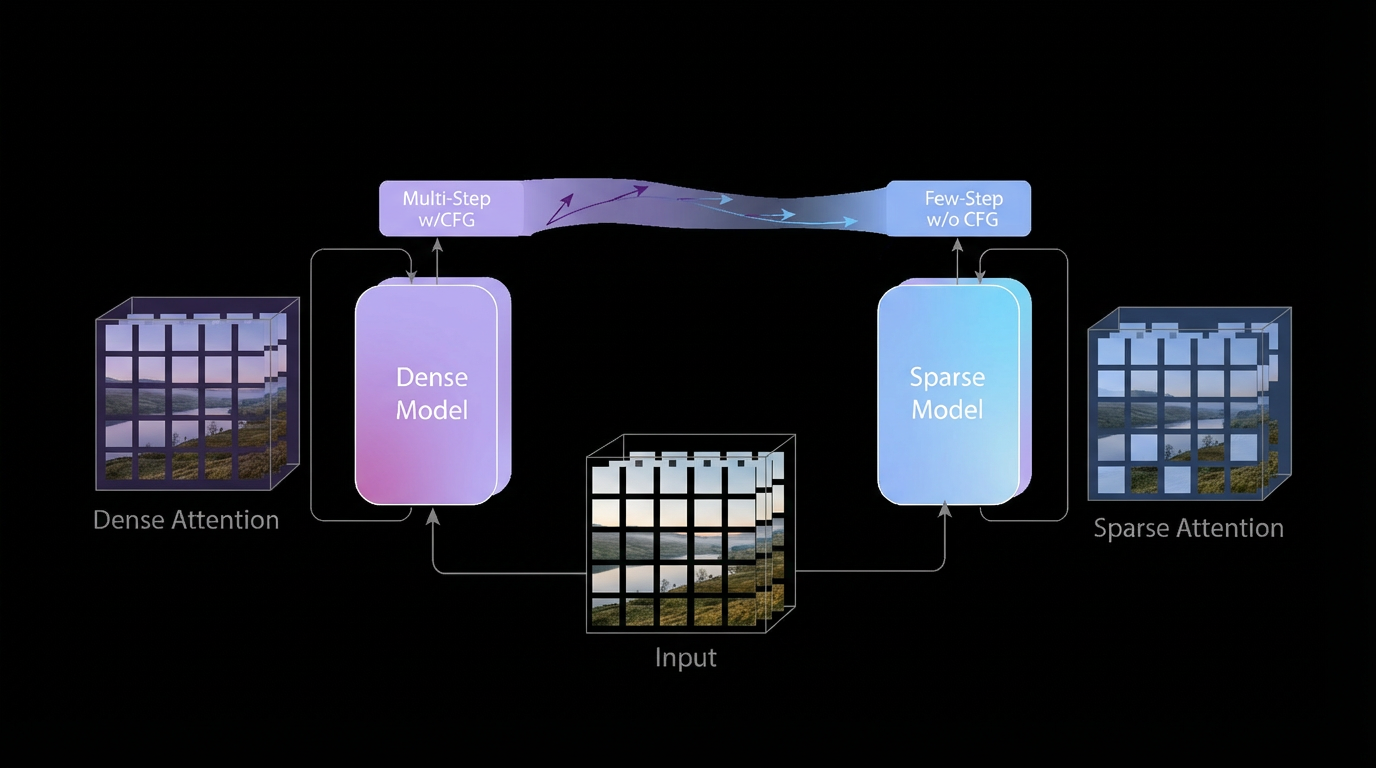
图 3. 瞬时响应引擎由三个模块组成:时间轨迹折叠、引导校正和自适应稀疏注意力学习。
3. 应用与社会影响
PixVerse-R1 引入了一种新的生成介质:实时、连续且有状态的视听系统。 与预渲染视频不同,这种介质作为一个持久的过程运行,对用户意图做出即时响应,生成与交互紧密耦合。 这种新介质赋能了一大类交互式系统,包括但不限于:
-
交互式媒体
- AI 原生游戏和交互式电影体验
- 实时 VR/XR 和沉浸式模拟
-
创意与教育系统
- 自适应媒体艺术和交互式装置
- 实时学习和培训环境
-
模拟与规划
- 实验性研究和情景探索
- 工业、农业和生态模拟
除了具体应用外,PixVerse-R1 作为一个连续的视听世界模拟器运行,缩短了人类意图与系统响应之间的距离,并赋能在持久数字环境中的新形式人机协同创作。
4. 结论
PixVerse-R1 引入了一个实时的生成框架,通过在多模态处理和瞬时响应方面的架构创新,克服了传统视频工作流的固有局限。通过实现一致的实时生成,该模型标志着视听媒体创作和体验的一次重大进化。向实时延迟的转变实现了从静态内容消费到动态环境交互的过渡,为从 AI 原生游戏到复杂工业模拟的应用提供了可扩展的计算基石。通过弥合用户意图与瞬时视觉反馈之间的鸿沟,该系统为交互式世界建模和人机协同环境建立了新的前沿。
5. 局限性
虽然 PixVerse-R1 提供了显著的建模优势,但在时间准确性和物理保真度方面仍存在两个主要约束:
- 时间误差累积: 在超长序列中,微小的预测误差可能会累积,从而可能损害模拟的结构完整性。
- 物理与计算的权衡: 为了成功实现实时生成,在生成复杂度方面做出了一些牺牲。因此,与非实时模型相比,在某些物理定律的精确渲染上可能会有一定程度的损失。