PixVerse-R1: realtime wereldmodel van de volgende generatie
PixVerse-R1: realtime wereldmodel van de volgende generatie
Samenvatting
We presenteren PixVerse-R1, een realtime wereldmodel van de volgende generatie, gebouwd op een native multimodaal foundation model. Dit systeem maakt realtime videogeneratie mogelijk waarbij visuele content direct en vloeiend reageert op gebruikersinvoer. Door de intrinsieke latentie en de beperkingen van vaste lengte in traditionele videoworkflows te overwinnen, verandert PixVerse-R1 videogeneratie in een oneindige, continue en interactieve visuele stroom. Dit is een aanzienlijke evolutie in het creëren, ervaren en delen van audiovisuele media, en markeert een paradigmaverschuiving naar intelligente, interactieve media die zich onmiddellijk kunnen aanpassen op basis van de intentie van de gebruiker.
Klaar om R1 te ervaren? Bekijk onze lanceringaankondiging van PixVerse R1 voor praktische informatie en hoe je een uitnodigingscode krijgt om toegang te krijgen tot R1.
1. Inleiding
Het landschap van digitale media verschuift fundamenteel van statische, vooraf gerenderde content naar dynamische, interactieve ervaringen. Conventionele productiepijplijnen zijn historisch beperkt door hoge latentie en clips van vaste lengte, waardoor een tweedeling ontstaat tussen contentcreatie en realtimeconsumptie.
Om deze beperkingen aan te pakken introduceren we een nieuwe wereldmodelarchitectuur die een native multimodaal foundation model, een consistentie-autoregressief mechanisme en een engine voor onmiddellijke respons verenigt. Deze uniforme aanpak maakt gezamenlijke verwerking van spatiotemporele patches mogelijk naast tekst- en audiodata, en breekt zo de traditionele silo’s van mediaverwerking af. Door een systeem in te zetten dat oneindig kan streamen via een autoregressief mechanisme en een engine voor onmiddellijke respons, blijft de gegenereerde wereld over lange horizonten fysiek consistent, met lage computationele overhead.
Kerncapaciteit: door deze architectuur te benutten bereikt ons systeem een doorbraak in prestaties en genereert het video in hoge resolutie tot 1080P in realtime. Deze capaciteit verhoogt de visuele getrouwheid en maakt AI-native gaming en interactieve cinema mogelijk, waarbij omgevingen en verhalen dynamisch evolueren in reactie op gebruikersinteractie. Breder stelt dit generatieve systemen in staat te functioneren als persistente, interactieve werelden in plaats van eindige media-artefacten, wat wijst op een traject naar continue, stateful en interactieve audiovisuele simulaties.
2. Technische architectuur
2.1 Omni: native multimodaal foundation model
Om algemene capaciteiten te bereiken zijn we traditionele generatiepijplijnen ontstegen door een volledig end-to-end Native Multimodal Foundation Model te ontwerpen.
- Uniforme representatie: het Omni-model verenigt diverse modaliteiten (tekst, beeld, video, audio) tot een continue stroom tokens, zodat het willekeurige multimodale invoer binnen één kader kan accepteren.
- End-to-endtraining: de volledige architectuur wordt getraind over heterogene taken zonder tussenliggende interfaces, wat foutpropagatie voorkomt en robuuste schaalbaarheid waarborgt.
- Native resolutie: we gebruiken training op native resolutie binnen dit kader om artefacten te vermijden die doorgaans samenhangen met bijsnijden of schalen.
Bovendien internaliseert het model de intrinsieke natuurkundige wetten en dynamiek van de echte wereld door te leren van een omvangrijk corpus van videodata uit de echte wereld. Dit fundamentele begrip stelt het systeem in staat in realtime een consistente, responsieve “parallelle wereld” te synthetiseren.
Het Omni-model schaalt effectief en functioneert niet louter als een generatieve engine, maar als een baanbrekende stap naar het bouwen van algemene simulatoren van de fysieke wereld. Door de simulatietaak te behandelen als één enkel, end-to-end generatieparadigma, faciliteren we de verkenning van realtime, door AI gegenereerde werelden met een lange horizon.

Figuur 1. De end-to-endarchitectuur van ons Omni Native Multimodal Foundation Model; het uniforme ontwerp stelt ons Omni-model in staat willekeurige multimodale invoer te accepteren en tegelijk audio en video te genereren.
2.2 Geheugen: consistente oneindige streaming via een autoregressief mechanisme
In tegenstelling tot standaard diffusiemethoden die beperkt zijn tot eindige clips, integreert PixVerse-R1 autoregressieve modellering om oneindige, continue visuele streaming mogelijk te maken, en een geheugenversterkt aandachtsmechanisme zodat de gegenereerde wereld over lange horizonten fysiek consistent blijft.
- Oneindige streaming: door videosynthese te formuleren als een autoregressief proces voorspelt het model opeenvolgende frames sequentieel, om continue, onbegrensde visuele streaming te bereiken.
- Temporele consistentie: een geheugenversterkt aandachtsmechanisme conditioneert de generatie van het huidige frame op de latente representaties van de voorafgaande context, zodat de wereld over lange horizonten fysiek consistent blijft.
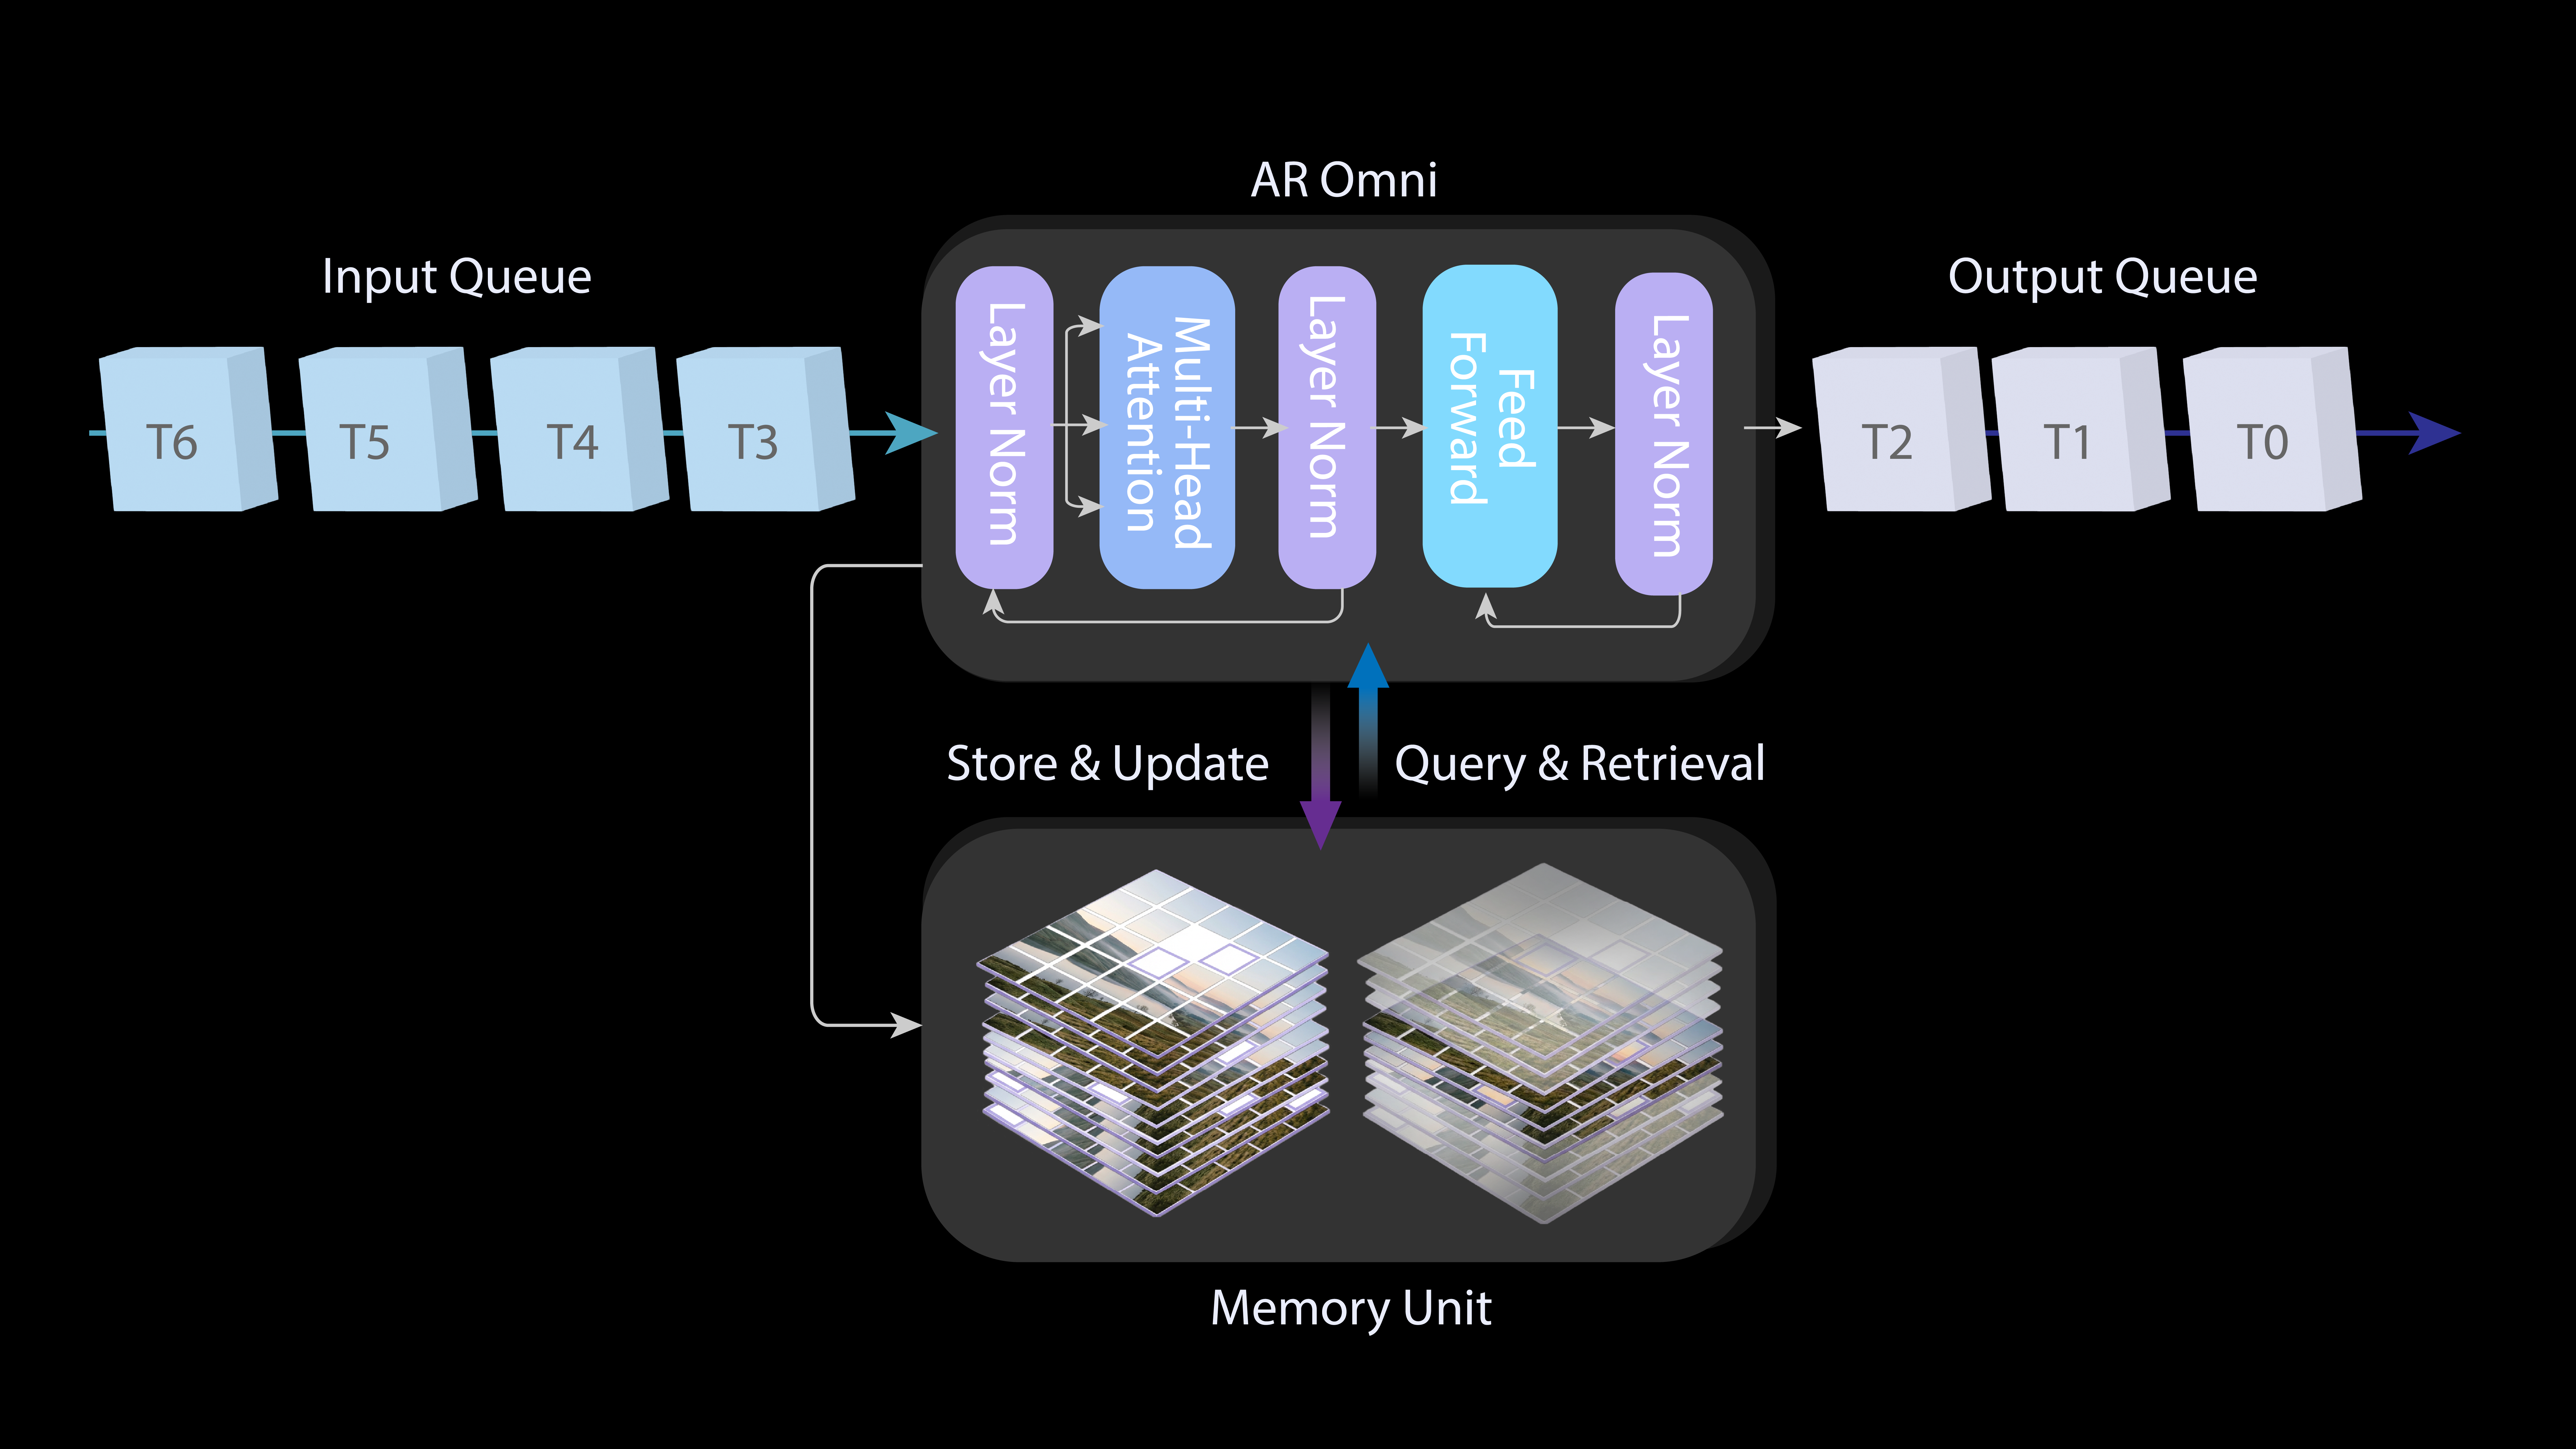
Figuur 2. De geïntegreerde autoregressieve modellering met het Omni foundation model.
2.3 Realtime 1080P: Instantaneous Response Engine
Hoewel iteratieve denoising doorgaans hoge kwaliteit waarborgt, belemmert de computationele dichtheid ervan vaak realtimeprestaties. Om dit op te lossen en realtimegeneratie bij hoge resoluties (tot 1080P) te bereiken, hebben we de pijplijn opnieuw ontworpen tot een Instantaneous Response Engine.
De IRE optimaliseert het samplingproces via de volgende verbeteringen:
- Temporele trajectvouwing: door Direct Transport Mapping te implementeren als structurele prior voorspelt het netwerk de schone dataverdeling rechtstreeks. Dit reduceert de samplingstappen van tientallen tot slechts 1–4 en creëert een gestroomlijnd pad dat essentieel is voor ultralage latentie.
- Guidance-rectificatie: we omzeilen de samplingoverhead van Classifier-Free Guidance door conditionele gradiënten samen te voegen in het studentmodel.
- Adaptieve spaarse aandacht: dit vermindert redundantie in afhankelijkheden over lange afstand en levert een verdichte computationele graaf op die de realisatie van realtime 1080P-generatie verder ondersteunt.
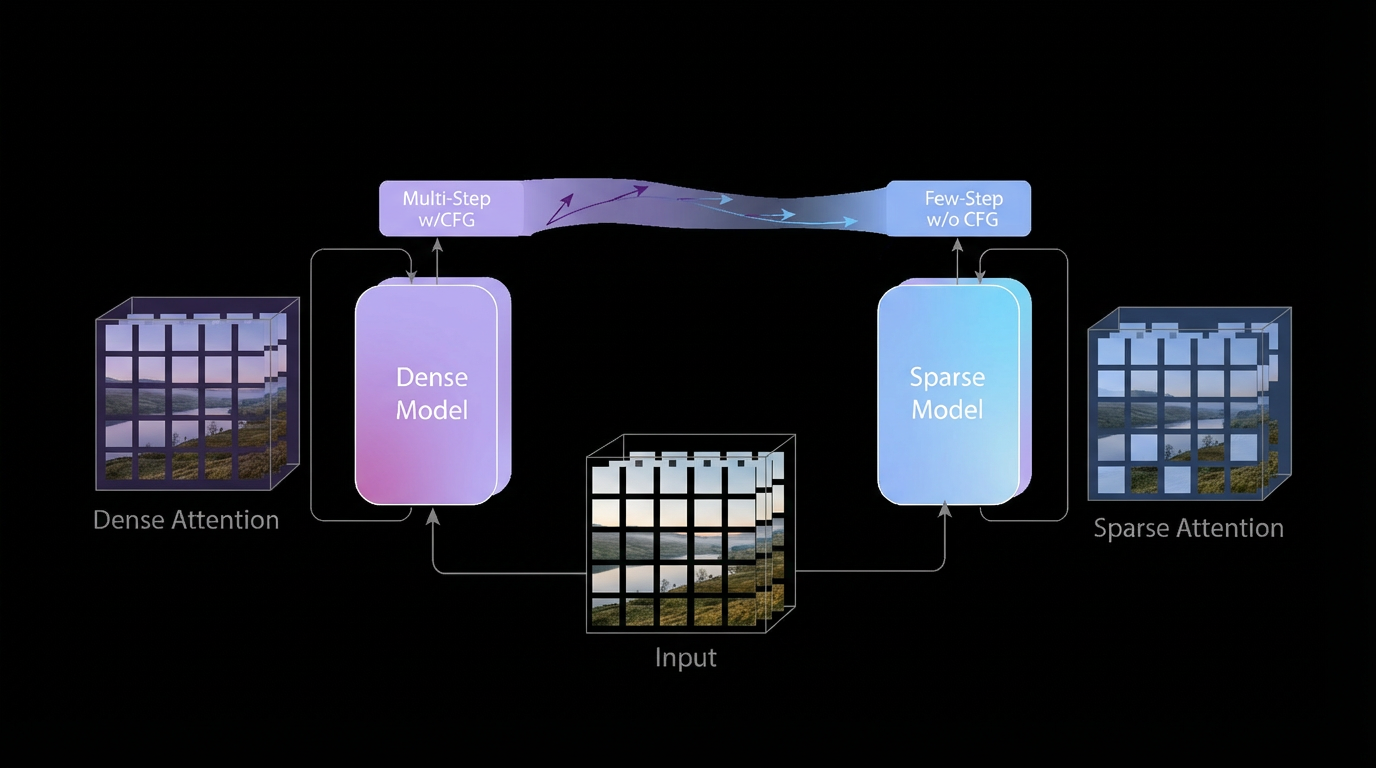
Figuur 3. De engine voor onmiddellijke respons bestaat uit drie modules: temporele trajectvouwing, guidance-rectificatie en het leren van adaptieve spaarse aandacht.
3. Toepassingen en maatschappelijke impact
PixVerse-R1 introduceert een nieuw generatief medium: realtime, continue en stateful audiovisuele systemen. Anders dan vooraf gerenderde video werkt dit medium als een persistent proces dat onmiddellijk reageert op de intentie van de gebruiker, waarbij generatie en interactie nauw gekoppeld zijn. Dit nieuwe medium maakt een brede klasse interactieve systemen mogelijk, waaronder maar niet beperkt tot:
-
Interactieve media
- AI-native games en interactieve cinematische ervaringen
- Realtime VR/XR en meeslepende simulaties
-
Creatieve en educatieve systemen
- Adaptieve mediakunst en interactieve installaties
- Realtime leer- en trainingsomgevingen
-
Simulatie en planning
- Experimenteel onderzoek en scenarioverkenning
- Industriële, agrarische en ecologische simulaties
Naast specifieke toepassingen functioneert PixVerse-R1 als een continue audiovisuele wereldsimulator, die de afstand tussen menselijke intentie en systeemrespons verkleint en nieuwe vormen van mens–AI-cocreatie mogelijk maakt binnen persistente digitale omgevingen.
4. Conclusie
PixVerse-R1 introduceert een realtime generatief kader dat de inherente beperkingen van traditionele videoworkflows overwint via architecturale innovaties in multimodale verwerking en onmiddellijke respons. Door consistente realtimegeneratie mogelijk te maken, markeert dit model een aanzienlijke evolutie in het creëren en ervaren van audiovisuele media. De verschuiving naar realtime latentie maakt een overgang mogelijk van statische contentconsumptie naar dynamische interactie met de omgeving, en biedt een schaalbaar computationeel substraat voor toepassingen variërend van AI-native gaming tot complexe industriële simulaties. Door de kloof tussen gebruikersintentie en onmiddellijke visuele feedback te overbruggen, vestigt het systeem een nieuwe grens voor interactieve wereldmodellering en collaboratieve mens-AI-omgevingen.
5. Beperkingen
Hoewel PixVerse-R1 aanzienlijke modelleringsvoordelen biedt, blijven twee primaire beperkingen bestaan met betrekking tot temporele nauwkeurigheid en fysieke getrouwheid:
- Temporele foutaccumulatie: over langere sequenties kunnen kleine voorspellingsfouten zich opstapelen en mogelijk de structurele integriteit van de simulatie aantasten.
- Afweging tussen fysica en rekenwerk: om realtimegeneratie succesvol te bereiken, zijn specifieke offers gebracht ten aanzien van de complexiteit van de generatie. Daardoor kan er een zekere mate van verlies optreden in de precieze weergave van sommige natuurkundige wetten vergeleken met niet-realtimemodellen.