PixVerse-R1: World Model Waktu Nyata Generasi Berikutnya
PixVerse-R1: World Model Waktu Nyata Generasi Berikutnya
Abstrak
Kami mempersembahkan PixVerse-R1, world model waktu nyata generasi berikutnya yang diarsitektur di atas foundation model multimodal native. Sistem ini memungkinkan generasi video waktu nyata di mana konten visual merespons masukan pengguna secara instan dan lancar. Dengan mengatasi latensi intrinsik dan kendala panjang tetap dari alur kerja video tradisional, PixVerse-R1 mengubah generasi video menjadi aliran visual yang tak terbatas, berkelanjutan, dan interaktif. Ini merupakan evolusi signifikan dalam penciptaan, pengalaman, dan berbagi media audiovisual, menandai pergeseran paradigma menuju media cerdas dan interaktif yang mampu beradaptasi secara instan berdasarkan niat pengguna.
Siap merasakan R1? Lihat pengumuman peluncuran PixVerse R1 kami untuk informasi praktis dan cara mendapatkan kode undangan untuk mengakses R1.
1. Pendahuluan
Lanskap media digital sedang bergeser secara fundamental dari konten statis yang telah di-render sebelumnya menuju pengalaman yang dinamis dan interaktif. Alur produksi konvensional secara historis terkendala oleh latensi tinggi dan klip berpanjang tetap, menciptakan dikotomi antara penciptaan konten dan konsumsi waktu nyata.
Untuk mengatasi keterbatasan ini, kami memperkenalkan arsitektur world model baru yang menyatukan foundation model multimodal native, mekanisme autoregresif konsistensi, dan instantaneous response engine. Pendekatan terpadu ini memungkinkan pemrosesan bersama patch spatiotemporal bersama data teks dan audio, secara efektif membongkar silo pemrosesan media tradisional. Dengan menerapkan sistem yang mampu melakukan streaming tak terbatas melalui mekanisme autoregresif dan instantaneous response engine, dunia yang dihasilkan tetap konsisten secara fisik pada horizon yang panjang dengan overhead komputasi yang rendah.
Kapabilitas Utama: Dengan memanfaatkan arsitektur ini, sistem kami mencapai terobosan kinerja, menghasilkan video resolusi tinggi hingga 1080P secara waktu nyata. Kapabilitas ini meningkatkan fidelitas visual dan memungkinkan game native AI serta sinema interaktif, di mana lingkungan dan narasi berkembang secara dinamis sebagai respons terhadap interaksi pengguna. Secara luas, ini memungkinkan sistem generatif berfungsi sebagai dunia yang persisten dan interaktif, bukan artefak media yang terbatas, yang menunjukkan lintasan menuju simulasi audiovisual yang berkelanjutan, berstatus, dan interaktif.
2. Arsitektur Teknis
2.1 Omni: Foundation Model Multimodal Native
Untuk mencapai kapabilitas umum, kami melampaui alur generasi tradisional dengan merancang Native Multimodal Foundation Model yang sepenuhnya end-to-end.
- Representasi Terpadu: Model Omni menyatukan beragam modalitas (teks, gambar, video, audio) menjadi aliran token yang berkelanjutan, sehingga dapat menerima masukan multimodal yang arbitrer dalam satu kerangka.
- Pelatihan End-to-End: Seluruh arsitektur dilatih di berbagai tugas heterogen tanpa antarmuka perantara, mencegah perambatan kesalahan dan memastikan skalabilitas yang kuat.
- Resolusi Native: Kami menggunakan pelatihan resolusi native dalam kerangka ini untuk menghindari artefak yang biasanya terkait dengan pemotongan atau pengubahan ukuran.
Selain itu, model menginternalisasi hukum fisika intrinsik dan dinamika dunia nyata dengan belajar dari korpus besar data video dunia nyata. Pemahaman mendasar ini memberdayakan sistem untuk menyintesis “dunia paralel” yang konsisten dan responsif secara waktu nyata.
Model Omni berskala secara efektif, berfungsi bukan sekadar sebagai mesin generatif, melainkan sebagai langkah perintis menuju pembangunan simulator serbaguna dari dunia fisik. Dengan memperlakukan tugas simulasi sebagai paradigma generasi tunggal yang end-to-end, kami memfasilitasi eksplorasi dunia yang dihasilkan AI secara waktu nyata dan berhorizon panjang.

Gambar 1. Arsitektur end-to-end Omni Native Multimodal Foundation Model kami; desain terpadu memungkinkan model Omni menerima masukan multimodal yang arbitrer dan menghasilkan audio serta video secara bersamaan.
2.2 Memori: Streaming Tak Terbatas yang Konsisten melalui Mekanisme Autoregresif
Tidak seperti metode difusi standar yang terbatas pada klip terbatas, PixVerse-R1 mengintegrasikan pemodelan autoregresif untuk memungkinkan streaming visual yang tak terbatas dan berkelanjutan, serta menggabungkan mekanisme attention yang diperkaya memori untuk memastikan dunia yang dihasilkan tetap konsisten secara fisik pada horizon yang panjang.
- Streaming Tak Terbatas: Dengan merumuskan sintesis video sebagai proses autoregresif, model secara berurutan memprediksi bingkai berikutnya untuk mencapai streaming visual yang berkelanjutan dan tak terbatas.
- Konsistensi Temporal: Mekanisme attention yang diperkaya memori mengondisikan generasi bingkai saat ini pada representasi laten dari konteks sebelumnya, memastikan dunia tetap konsisten secara fisik pada horizon yang panjang.
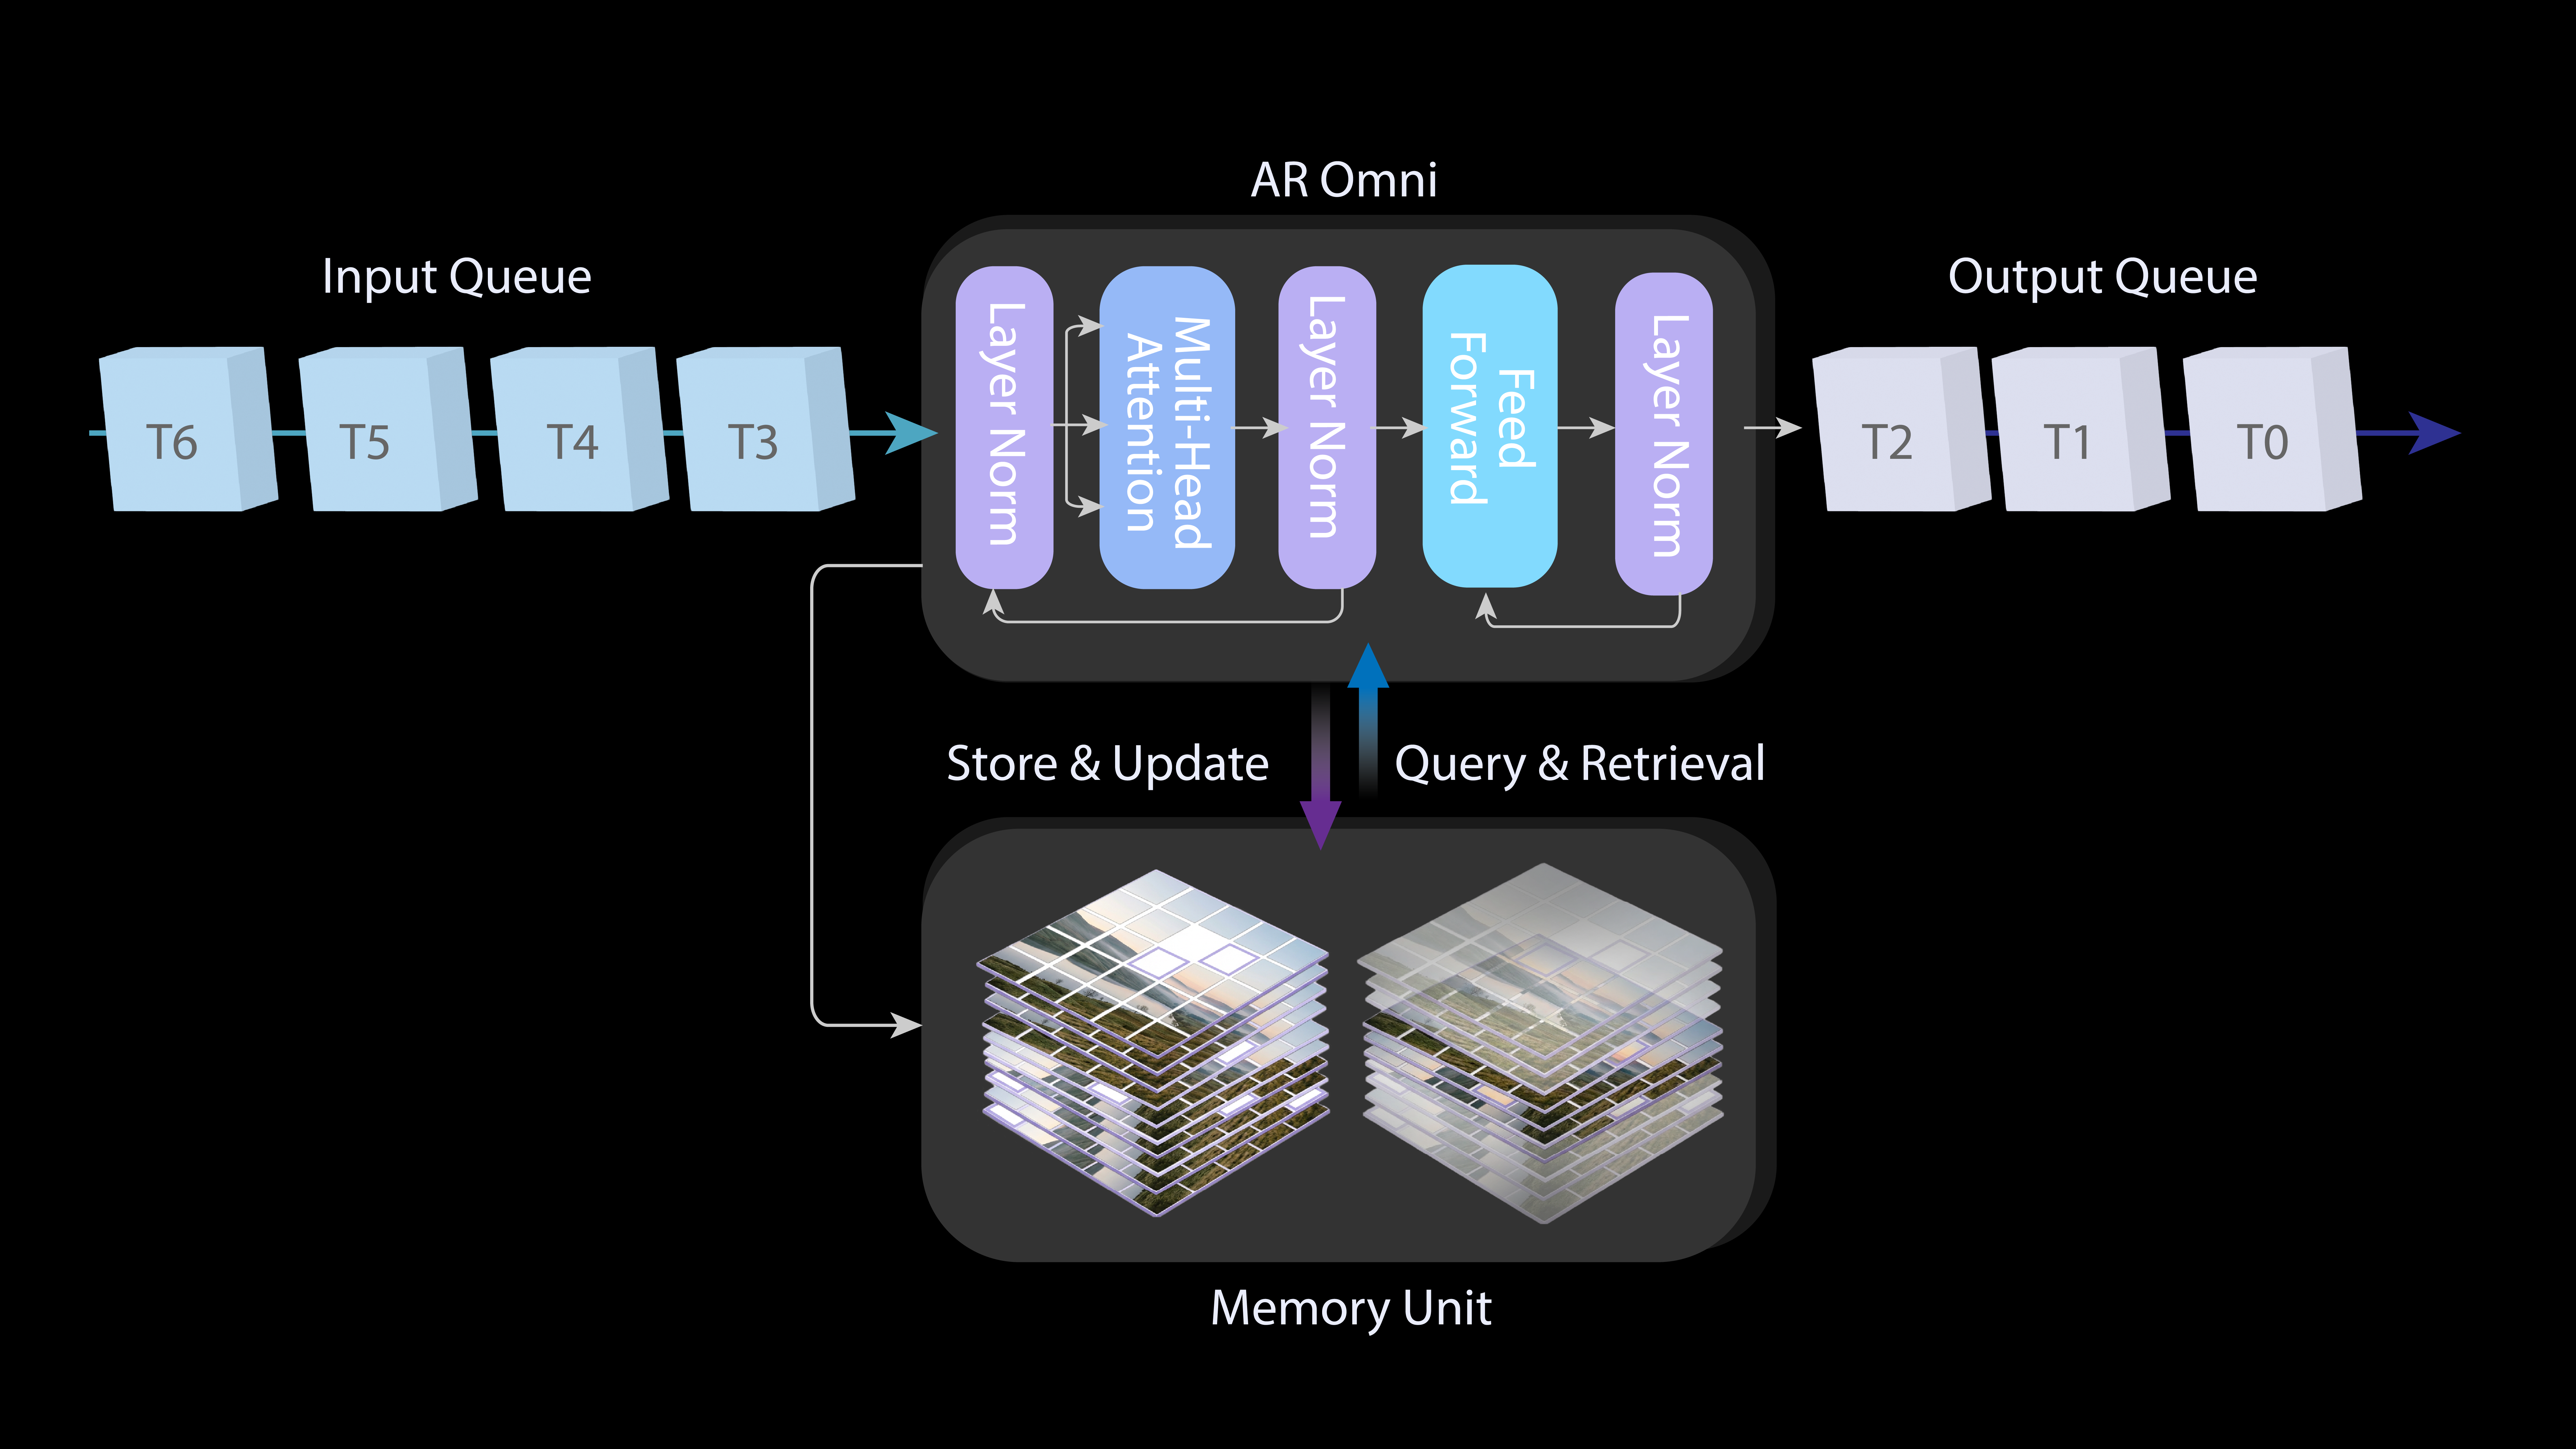
Gambar 2. Pemodelan autoregresif terintegrasi dengan foundation model Omni.
2.3 1080P Waktu Nyata: Instantaneous Response Engine
Meskipun denoising iteratif biasanya memastikan kualitas tinggi, kepadatan komputasinya sering menghambat kinerja waktu nyata. Untuk menyelesaikan ini dan mencapai generasi waktu nyata pada resolusi tinggi (hingga 1080P), kami merancang ulang alur menjadi Instantaneous Response Engine.
IRE mengoptimalkan proses sampling melalui kemajuan berikut:
- Temporal Trajectory Folding: Dengan menerapkan Direct Transport Mapping sebagai prior struktural, jaringan memprediksi distribusi data bersih secara langsung. Ini mengurangi langkah sampling dari puluhan menjadi hanya 1–4, menciptakan jalur yang lebih ringkas yang esensial untuk latensi ultra-rendah.
- Guidance Rectification: Kami melewati overhead sampling Classifier-Free Guidance dengan menggabungkan gradien kondisional ke dalam model student.
- Adaptive Sparse Attention: Ini meredam redundansi dependensi jarak jauh, menghasilkan graf komputasi yang lebih ringkas yang semakin memfasilitasi realisasi generasi 1080P waktu nyata.
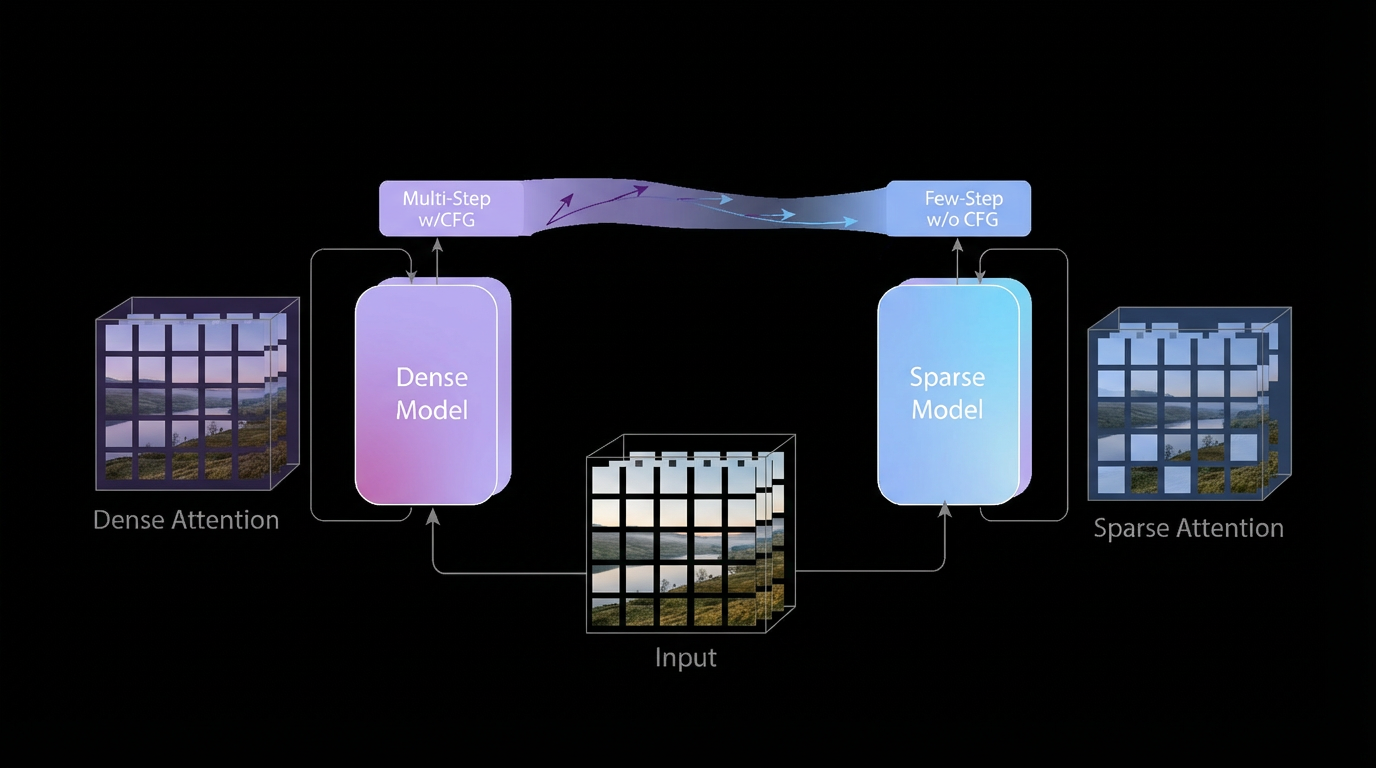
Gambar 3. Instantaneous response engine terdiri dari tiga modul: temporal trajectory folding, guidance rectification, dan pembelajaran adaptive sparse attention.
3. Aplikasi dan Dampak Sosial
PixVerse-R1 memperkenalkan medium generatif baru: sistem audiovisual waktu nyata, berkelanjutan, dan berstatus. Tidak seperti video yang telah di-render sebelumnya, medium ini beroperasi sebagai proses persisten yang merespons niat pengguna secara instan, di mana generasi dan interaksi terikat erat. Medium baru ini memungkinkan kelas luas sistem interaktif, termasuk tetapi tidak terbatas pada:
-
Media Interaktif
- Game native AI dan pengalaman sinematik interaktif
- VR/XR waktu nyata dan simulasi imersif
-
Sistem Kreatif dan Edukatif
- Seni media adaptif dan instalasi interaktif
- Lingkungan pembelajaran dan pelatihan waktu nyata
-
Simulasi dan Perencanaan
- Riset eksperimental dan eksplorasi skenario
- Simulasi industri, pertanian, dan ekologi
Di luar aplikasi spesifik, PixVerse-R1 berfungsi sebagai simulator dunia audiovisual yang berkelanjutan, memperkecil jarak antara niat manusia dan respons sistem, serta memungkinkan bentuk baru kreasi bersama manusia–AI di dalam lingkungan digital yang persisten.
4. Kesimpulan
PixVerse-R1 memperkenalkan kerangka generatif waktu nyata yang mengatasi keterbatasan inheren alur kerja video tradisional melalui inovasi arsitektur dalam pemrosesan multimodal dan respons instan. Dengan memungkinkan generasi yang konsisten dan waktu nyata, model ini menandai evolusi signifikan dalam penciptaan dan pengalaman media audiovisual. Pergeseran menuju latensi waktu nyata memungkinkan transisi dari konsumsi konten statis ke interaksi lingkungan yang dinamis, menyediakan substrat komputasi yang dapat diskalakan untuk aplikasi mulai dari game native AI hingga simulasi industri yang kompleks. Dengan menjembatani kesenjangan antara niat pengguna dan umpan balik visual instan, sistem ini menetapkan batas baru bagi pemodelan dunia interaktif dan lingkungan kolaboratif manusia-AI.
5. Keterbatasan
Meskipun PixVerse-R1 menawarkan keunggulan pemodelan yang signifikan, dua kendala utama tetap ada terkait akurasi temporal dan fidelitas fisik:
- Akumulasi Kesalahan Temporal: Pada urutan yang panjang, kesalahan prediksi kecil dapat terakumulasi, yang berpotensi mengganggu integritas struktural simulasi.
- Kompromi Fisika vs. Komputasi: Untuk berhasil mencapai generasi waktu nyata, pengorbanan tertentu dilakukan terkait kompleksitas generasi. Akibatnya, mungkin ada tingkat kehilangan tertentu dalam rendering yang presisi dari sebagian hukum fisika dibandingkan dengan model non-waktu nyata.