PixVerse-R1: Modelo de mundo em tempo real de última geração
PixVerse-R1: Modelo de mundo em tempo real de última geração
Resumo
Apresentamos o PixVerse-R1, um modelo de mundo em tempo real de última geração arquitetado sobre um modelo de base multimodal nativo. Este sistema permite a geração de vídeo em tempo real, onde o conteúdo visual responde instantânea e fluidamente à entrada do usuário. Ao superar a latência intrínseca e as restrições de comprimento fixo dos fluxos de trabalho de vídeo tradicionais, o PixVerse-R1 transforma a geração de vídeo em um fluxo visual infinito, contínuo e interativo. Isso representa uma evolução significativa na criação, experiência e compartilhamento de mídia audiovisual, marcando uma mudança de paradigma em direção a mídias inteligentes e interativas, capazes de adaptação instantânea baseada na intenção do usuário.
1. Introdução
O cenário da mídia digital está mudando fundamentalmente de conteúdo estático e pré-renderizado para experiências dinâmicas e interativas. Os pipelines de produção convencionais têm sido historicamente limitados por alta latência e clipes de comprimento fixo, criando uma dicotomia entre a criação de conteúdo e o consumo em tempo real.
Para abordar essas limitações, introduzimos uma nova arquitetura de modelo de mundo que unifica um modelo de base multimodal nativo, um mecanismo autorregressivo de consistência e um motor de resposta instantânea. Essa abordagem unificada permite o processamento conjunto de patches espaço-temporais juntamente com dados de texto e áudio, desmantelando efetivamente os silos tradicionais de processamento de mídia. Ao implantar um sistema capaz de streaming infinito por meio de um mecanismo autorregressivo e um motor de resposta instantânea, o mundo gerado permanece fisicamente consistente em longos horizontes com baixa sobrecarga computacional.
Capacidade principal: Aproveitando esta arquitetura, nosso sistema alcança um avanço no desempenho, gerando vídeo de alta resolução de até 1080P em tempo real. Essa capacidade aumenta a fidelidade visual e permite jogos nativos de IA e cinema interativo, onde ambientes e narrativas evoluem dinamicamente em resposta à interação do usuário. De forma ampla, isso permite que os sistemas generativos funcionem como mundos persistentes e interativos, em vez de artefatos de mídia finitos, indicando uma trajetória em direção a simulações audiovisuais contínuas, com estado e interativas.
2. Arquitetura Técnica
2.1 Omni: Modelo de Base Multimodal Nativo
Para alcançar capacidades gerais, transcendemos os pipelines de geração tradicionais projetando um modelo de base multimodal nativo totalmente de ponta a ponta.
- Representação unificada: O modelo Omni unifica diversas modalidades (texto, imagem, vídeo, áudio) em um fluxo contínuo de tokens, permitindo aceitar entradas multimodais arbitrárias em uma única estrutura.
- Treinamento de ponta a ponta: Toda a arquitetura é treinada em tarefas heterogêneas sem interfaces intermediárias, evitando a propagação de erros e garantindo uma escalabilidade robusta.
- Resolução nativa: Utilizamos o treinamento em resolução nativa nesta estrutura para evitar artefatos tipicamente associados ao corte ou redimensionamento.
Além disso, le modelo internaliza as leis físicas e a dinâmica intrínsecas do mundo real ao aprender com um enorme corpus de dados de vídeo do mundo real. Essa compreensão fundamental permite que o sistema sintetize um “mundo paralelo” consistente e responsivo em tempo real.
O modelo Omni escala de forma eficaz, funcionando não apenas como um motor generativo, mas como um passo pioneiro na construção de simuladores de propósito geral do mundo físico. Ao tratar a tarefa de simulação como um paradigma de geração único e de ponta a ponta, facilitamos la exploração de mundos gerados por IA em tempo real e de longo horizonte.
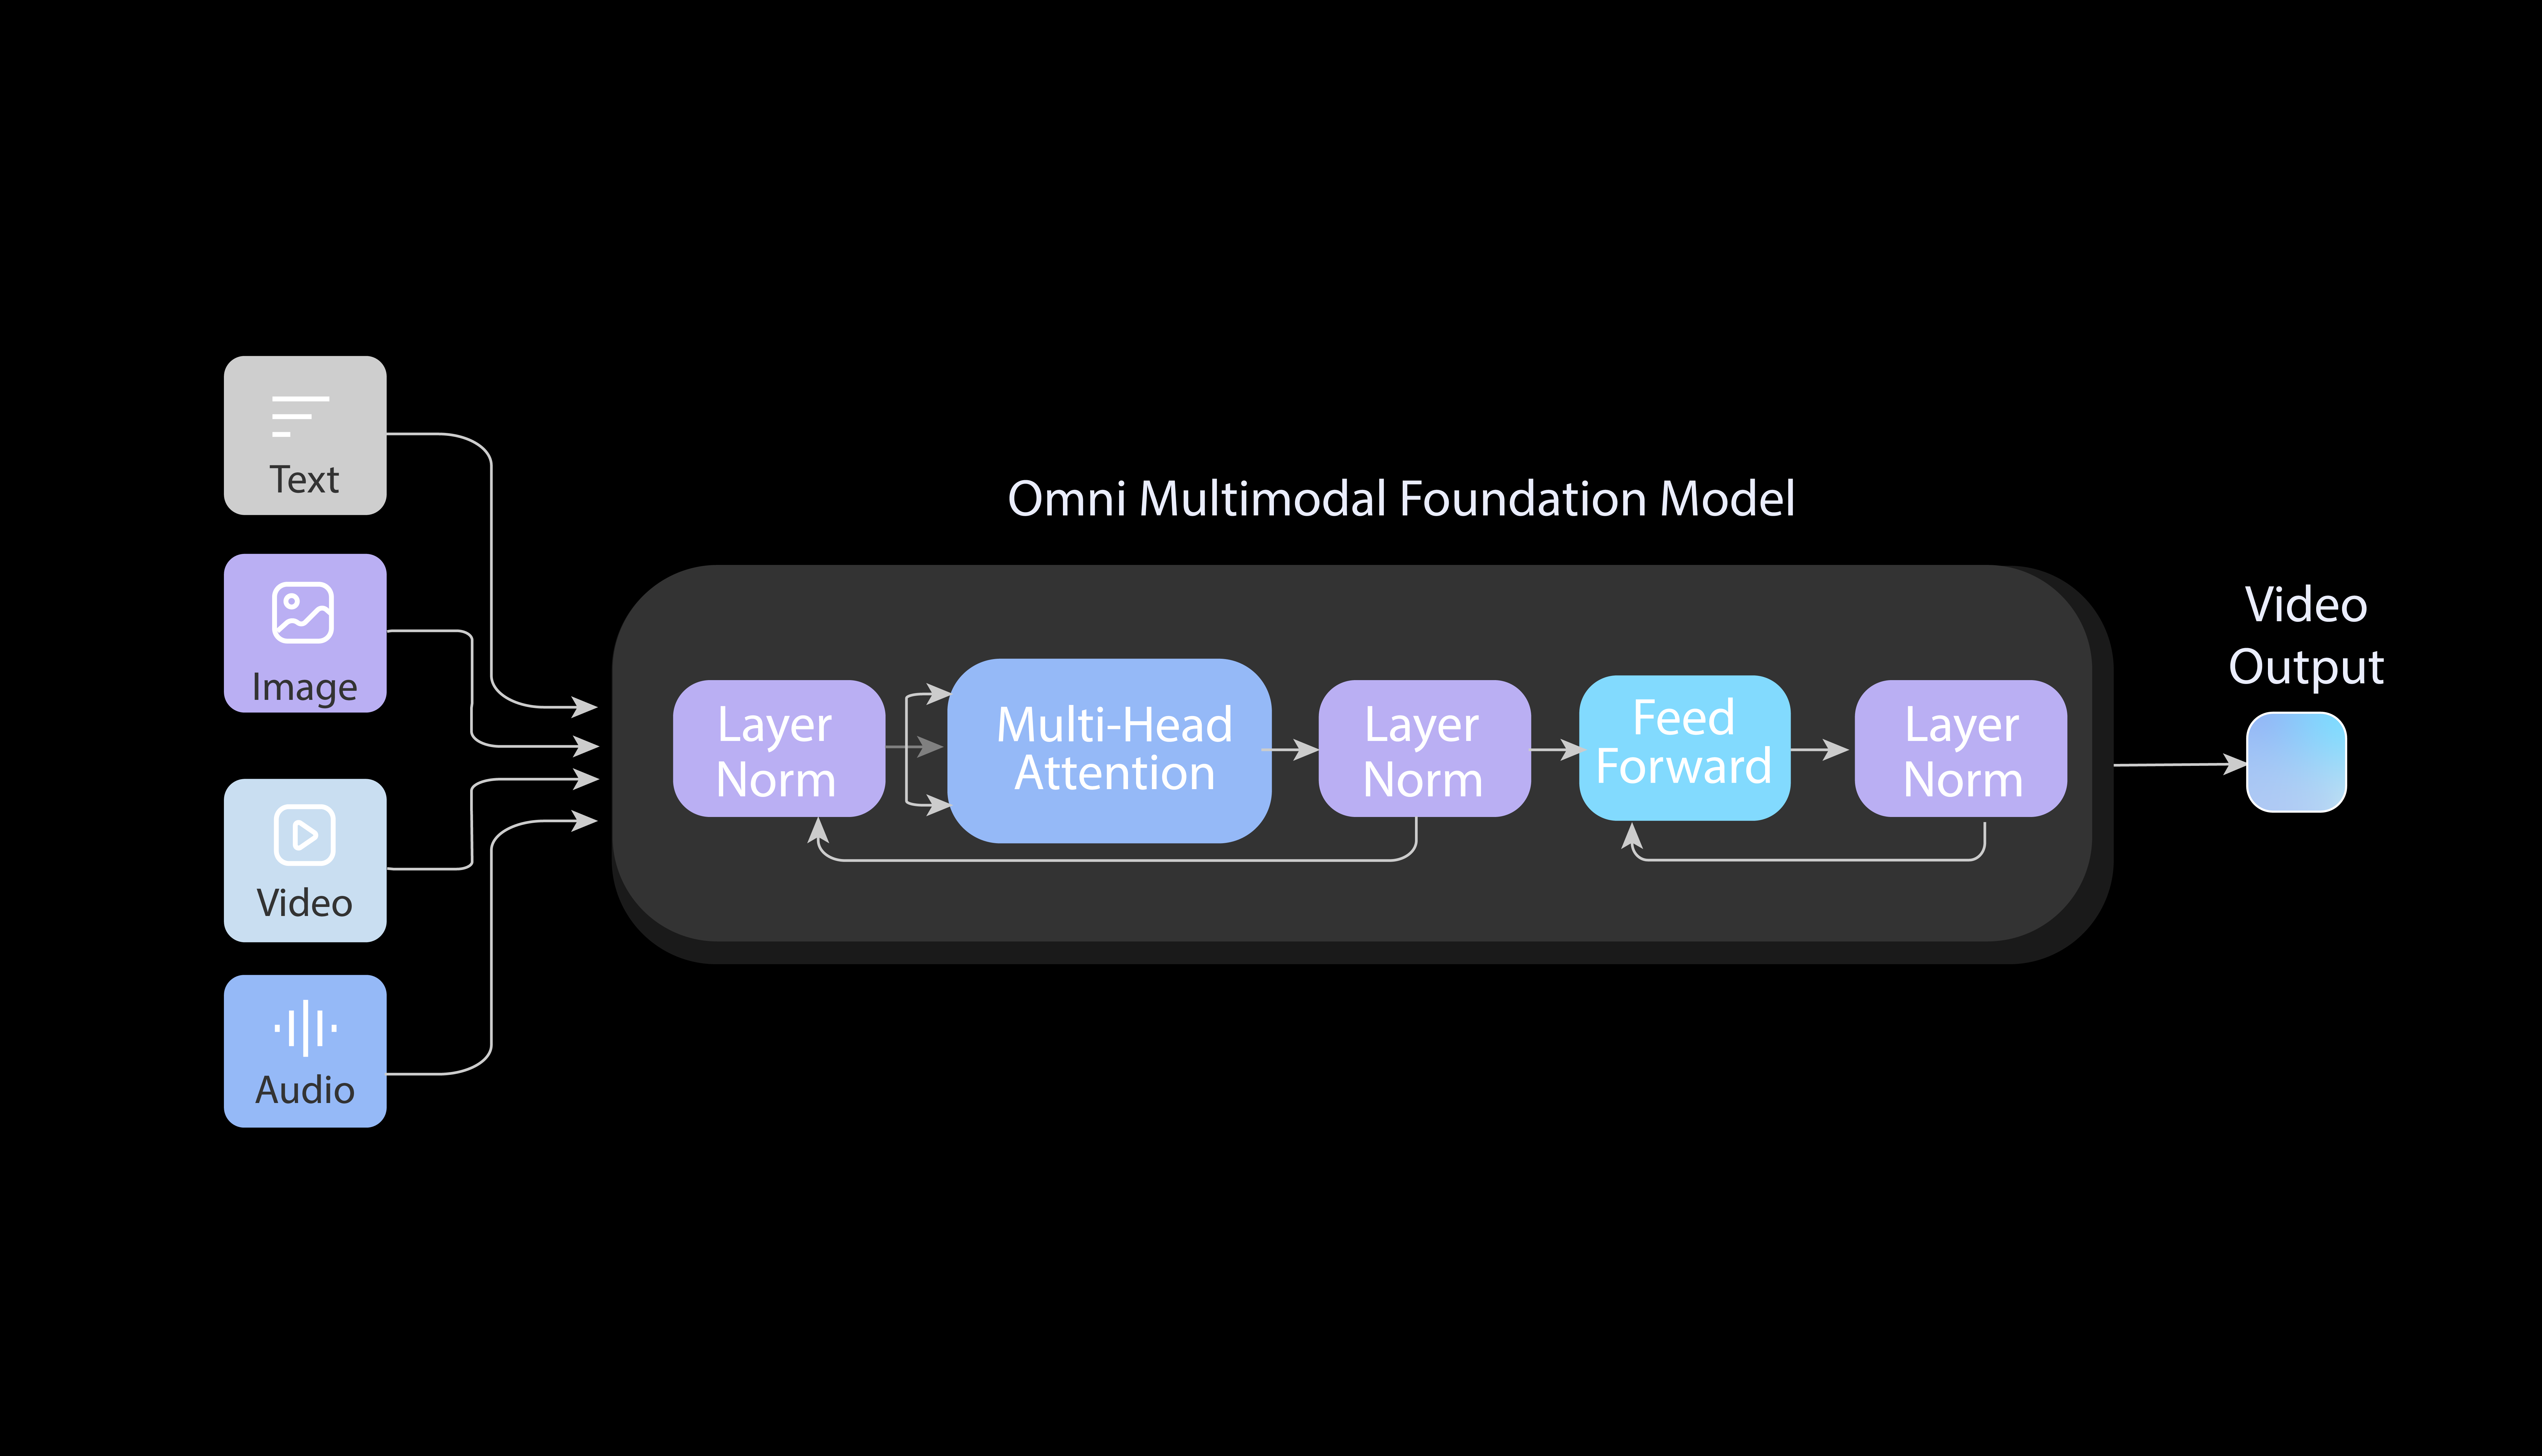
Figura 1. A arquitetura de ponta a ponta do nosso Modelo de Base Multimodal Nativo Omni; o design unificado permite que nosso modelo Omni aceite entradas multimodales arbitrárias e gere áudio e vídeo ao mesmo tempo.
2.2 Memory: Streaming infinito consistente via mecanismo autorregressivo
Diferente dos métodos de difusão padrão restritos a clipes finitos, o PixVerse-R1 integra modelagem autorregressiva para permitir streaming visual infinito e contínuo, e incorpora um mecanismo de atenção aumentado por memória para garantir que o mundo gerado permaneça fisicamente consistente em longos horizontes.
- Streaming infinito: Ao formular a síntese de vídeo como um processo autorregressivo, o modelo prevê sequencialmente os quadros subsequentes para obter um streaming visual contínuo e ilimitado.
- Consistência temporal: Um mecanismo de atenção aumentado por memória condiciona a geração do quadro atual nas representações latentes do contexto anterior, garantindo que o mundo permaneça fisicamente consistente em longos horizontes.
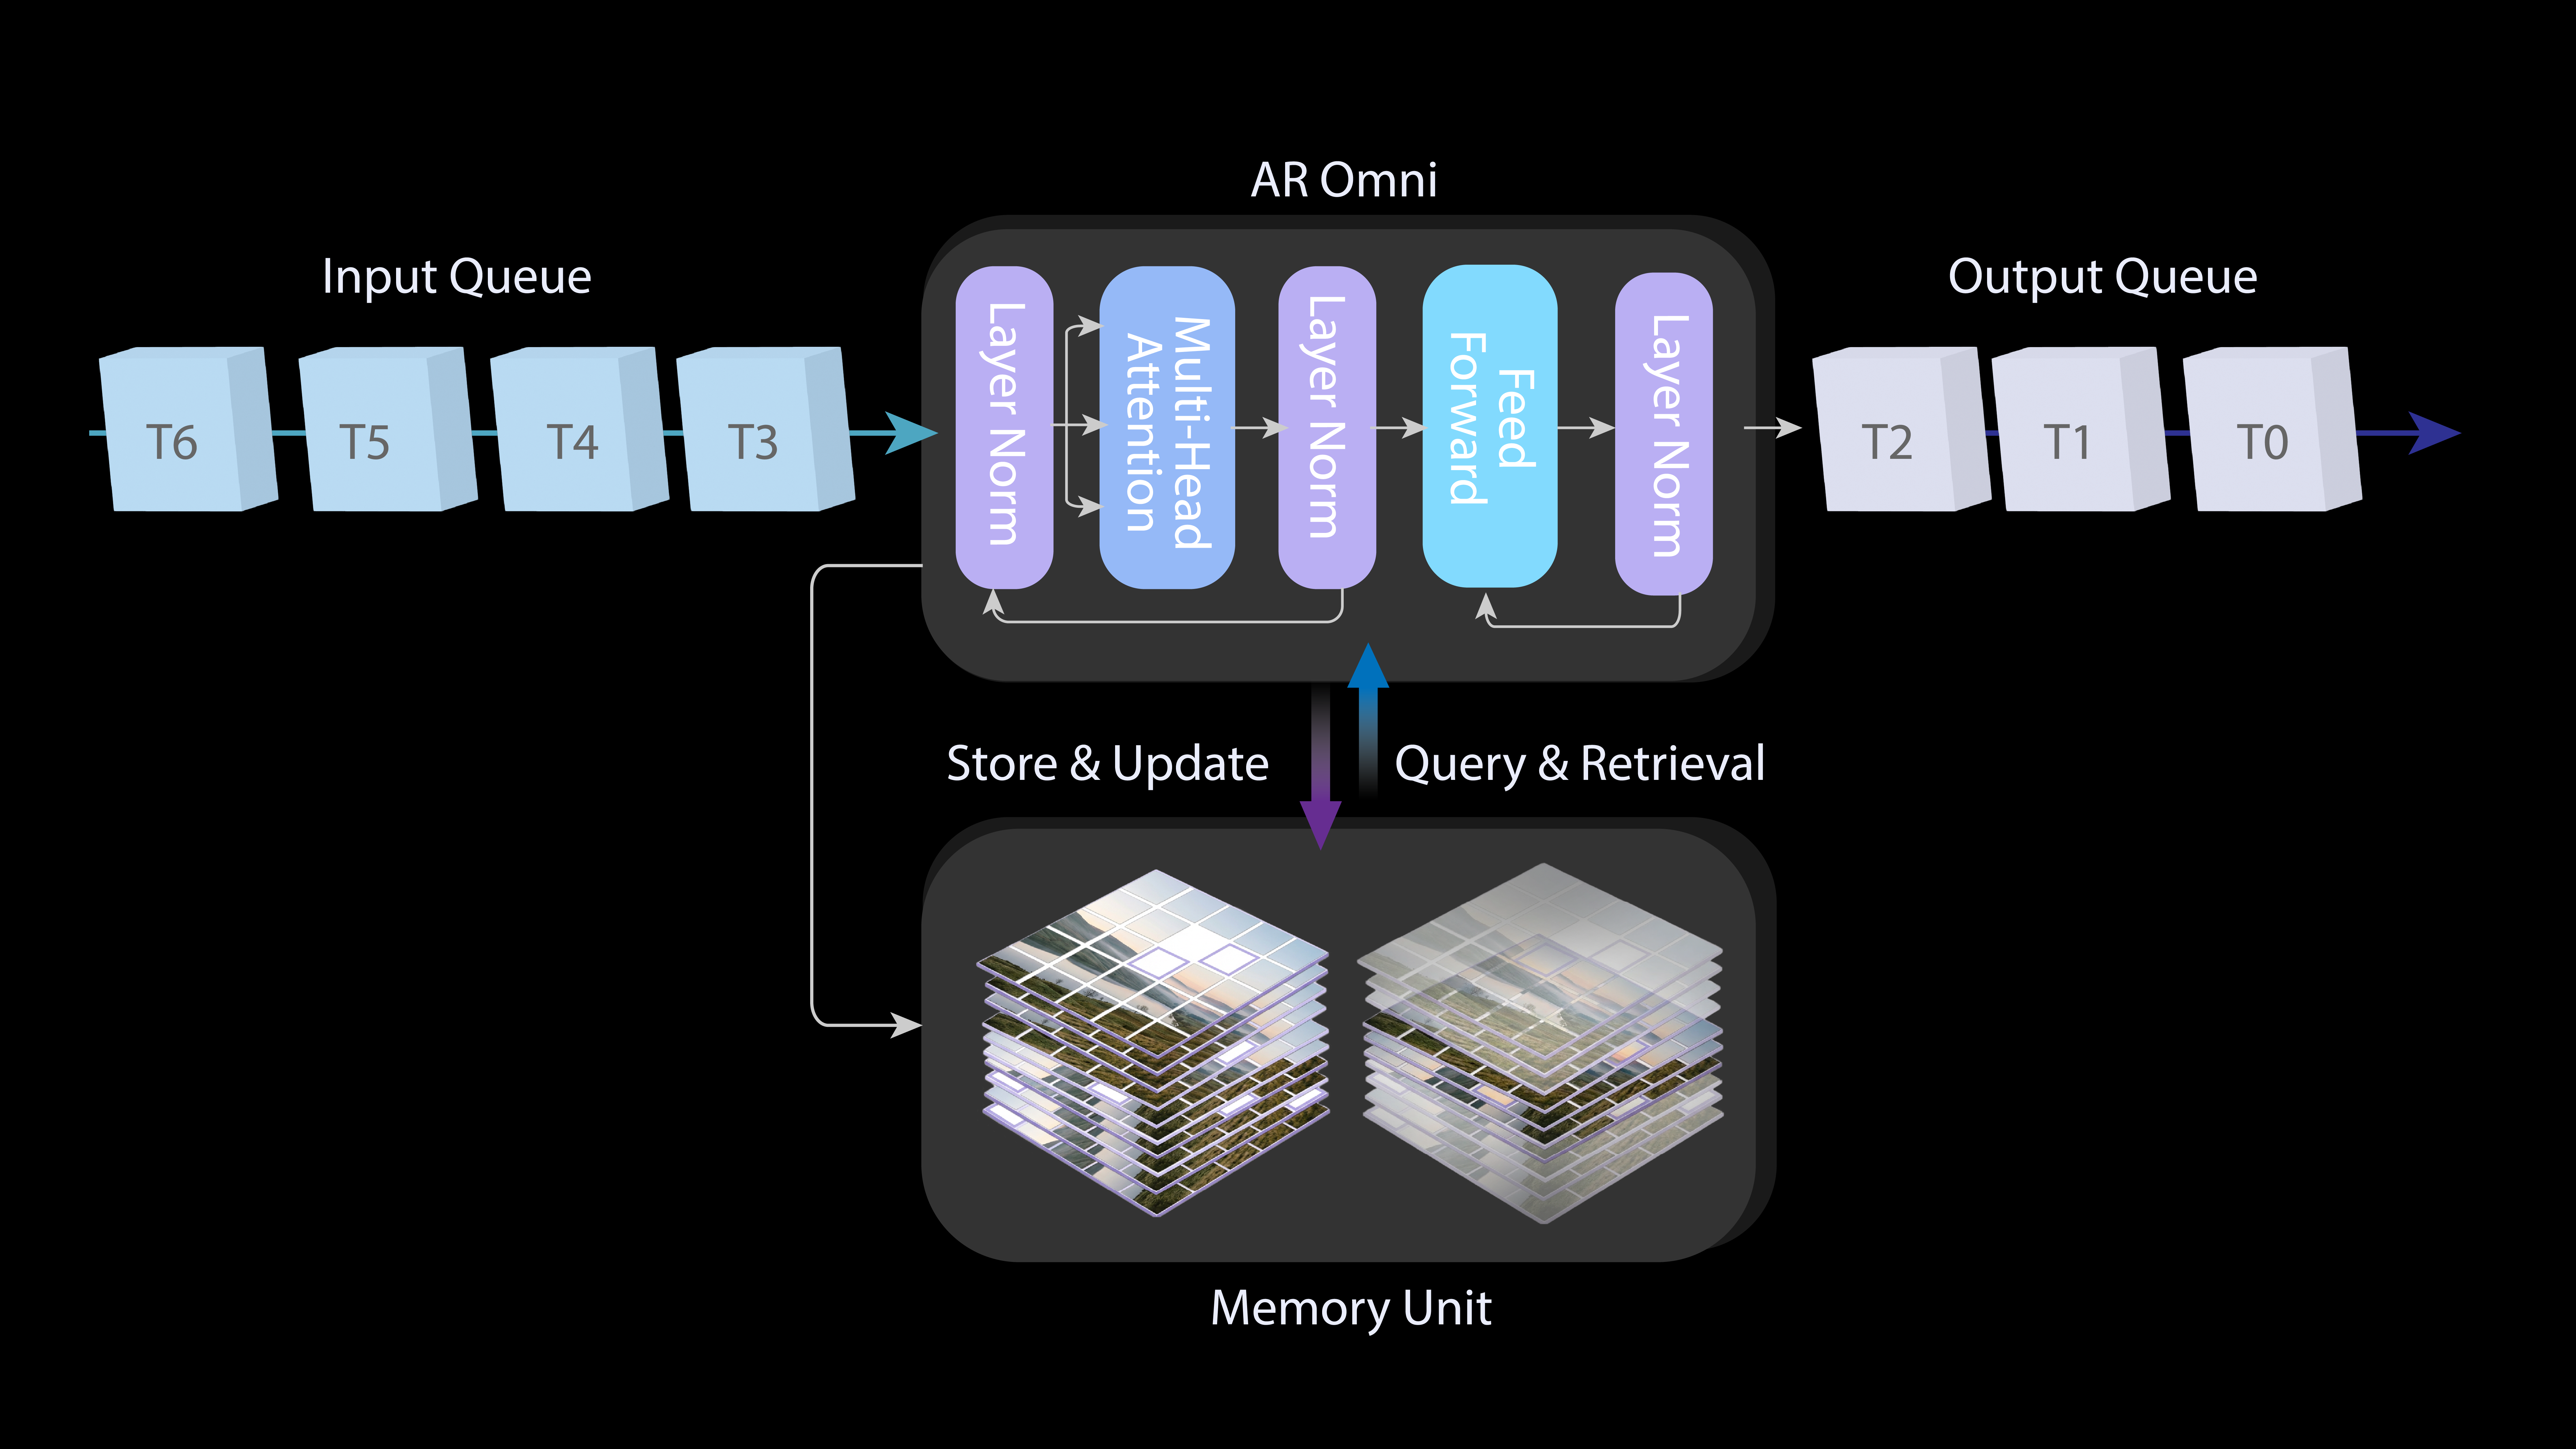
Figura 2. A modelagem autorregressiva integrada com o modelo de base Omni.
2.3 1080P em tempo real: Motor de resposta instantânea
Embora a remoção de ruído iterativa geralmente garanta alta qualidade, sua densidade computacional muitas vezes impede o desempenho em tempo real. Para resolver isso e alcançar a geração em tempo real em altas resoluções (até 1080P), reestruturamos o pipeline em um Motor de Resposta Instantânea (IRE).
O IRE otimiza o processo de amostragem por meio dos seguintes avanços:
- Temporal Trajectory Folding: Ao implementar o Mapeamento de Transporte Direto como um prior estrutural, a rede prevê a distribuição de dados limpos diretamente. Isso reduz as etapas de amostragem de dezenas para meras 1 a 4, criando um caminho simplificado essencial para latência ultrabaixa.
- Retificação de orientação: Ignoramos a sobrecarga de amostragem da Orientação Sem Classificador (Classifier-Free Guidance), fundindo gradientes condicionais no modelo de estudante.
- Atenção esparsa adaptativa: Isso mitiga a redundância de dependência de longo alcance, resultando em um gráfico computacional condensado que facilita ainda mais a realização da geração 1080P em tempo real.
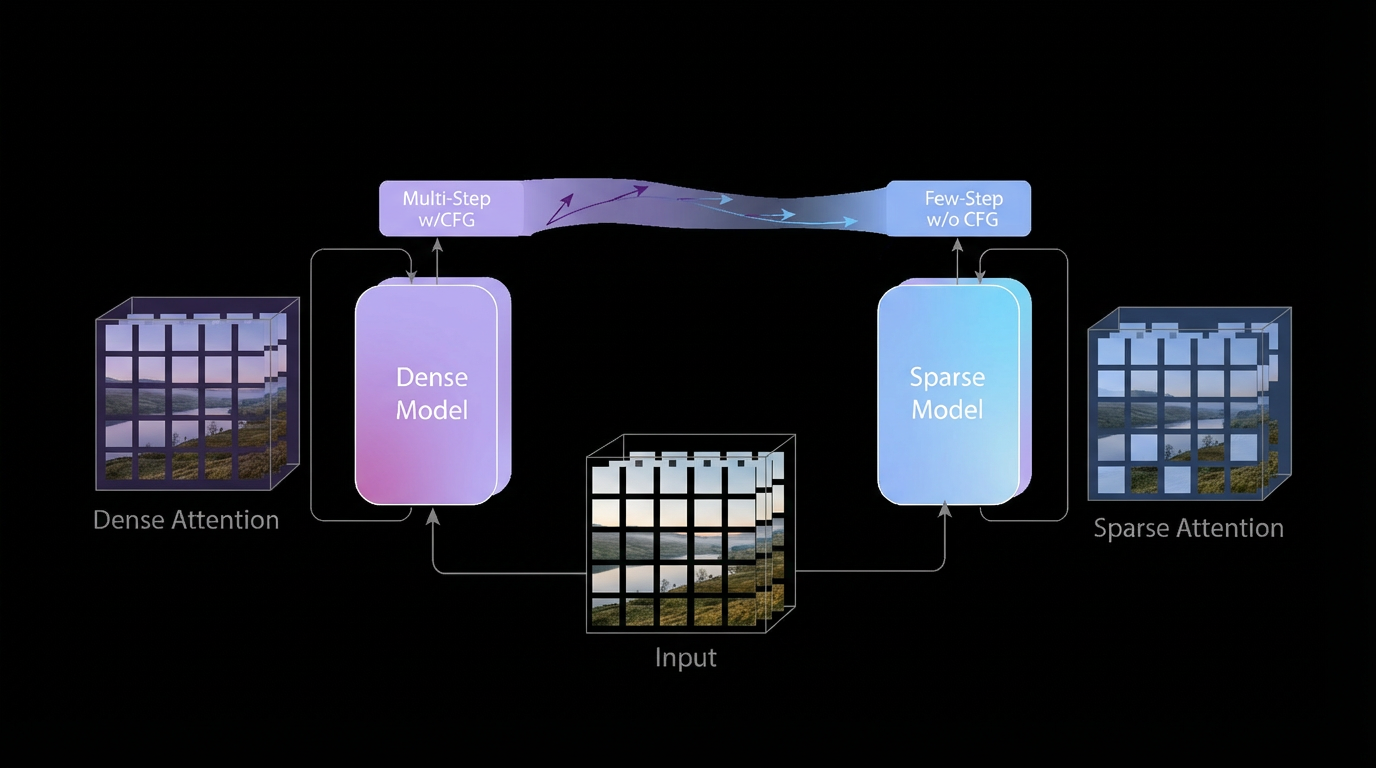
Figura 3. O motor de resposta instantânea consiste em três módulos: temporal trajectory folding, retificação de orientação e aprendizado de atenção esparsa adaptativa.
3. Aplicações e impacto social
O PixVerse-R1 apresenta um novo meio generativo: sistemas audiovisuais em tempo real, contínuos e com estado. Diferente do vídeo pré-renderizado, este meio opera como um processo persistente que responde instantaneamente à intenção do usuário, onde a geração e a interação estão estreitamente acopladas. Este novo meio possibilita uma ampla classe de sistemas interativos, incluindo, entre outros:
-
Mídia interativa
- Jogos nativos de IA e experiências cinematográficas interativas
- VR/XR em tempo real e simulações imersivas
-
Sistemas criativos e educacionais
- Arte de mídia adaptativa e instalações interativas
- Ambientes de aprendizado e treinamento em tempo real
-
Simulação e planejamento
- Pesquisa experimental e exploração de cenários
- Simulações industriais, agrícolas e ecológicas
Além de aplicações específicas, o PixVerse-R1 funciona como um simulador de mundo audiovisual contínuo, reduzindo a distância entre a intenção humana e a resposta do sistema, e permitindo novas formas de cocriação humano-IA dentro de ambientes digitais persistentes.
4. Conclusão
O PixVerse-R1 apresenta uma estrutura generativa em tempo real que supera as limitações inerentes aos fluxos de trabalho de vídeo tradicionais por meio de inovações arquitetônicas no processamento multimodal e na resposta instantânea. Ao permitir a geração consistente em tempo real, este modelo marca uma evolução significativa na criação e experiência de mídia audiovisual. A mudança para a latência em tempo real permite uma transição do consumo de conteúdo estático para a interação com o ambiente dinâmico, fornecendo um substrato computacional escalável para aplicações que variam de jogos nativos de IA a simulações industriais complexas. Ao preencher a lacuna entre a intenção do usuário e o feedback visual instantâneo, le sistema estabelece uma nova fronteira para modelagem de mundo interativo e ambientes de colaboração humano-IA.
5. Limitações
Embora o PixVerse-R1 ofereça vantagens significativas de modelagem, duas restrições principais persistem em relação à precisão temporal e fidelidade física:
- Acúmulo de erro temporal: Em sequências estendidas, erros de previsão menores podem se acumular, potencialmente comprometendo a integridade estrutural da simulação.
- Trade-off entre física e computação: Para alcançar com sucesso a geração em tempo real, sacrifícios específicos foram feitos em relação à complexidade da geração. Consequentemente, pode haver um certo grau de perda na renderização precisa de algumas leis físicas em comparação com modelos que não são em tempo real.