PixVerse-R1: نموذج عالم من الجيل التالي في الوقت الفعلي
PixVerse-R1: نموذج عالم من الجيل التالي في الوقت الفعلي
الملخص
نقدّم PixVerse-R1، وهو نموذج عالم من الجيل التالي في الوقت الفعلي مُعمَّر فوق نموذج أساس متعدد الوسائط أصلي. يتيح هذا النظام توليد فيديو في الوقت الفعلي يستجيب فيه المحتوى البصري فورًا وبسلاسة لمدخلات المستخدم. ومن خلال تجاوز قيود زمن الاستجابة الجوهرية وقيود الطول الثابت في مسارات عمل الفيديو التقليدية، يحوّل PixVerse-R1 توليد الفيديو إلى تيار بصري لا نهائي ومتصل وتفاعلي. ويمثّل ذلك تطورًا مهمًا في إنشاء الوسائط السمعية البصرية وتجربتها ومشاركتها، ويؤشر إلى تحول نموذجي نحو وسائط ذكية وتفاعلية قادرة على التكيف الفوري بناءً على نية المستخدم.
هل أنت مستعد لتجربة R1؟ اطّلع على إعلان إطلاق PixVerse R1 للمعلومات العملية وكيفية الحصول على رمز دعوة للوصول إلى R1.
1. المقدمة
يتحول مشهد الوسائط الرقمية تحولًا جوهريًا من المحتوى الثابت المُعد مسبقًا نحو التجارب الديناميكية والتفاعلية. وقد كانت خطوط الإنتاج التقليدية مقيّدة تاريخيًا بزمن استجابة مرتفع ومقاطع ذات طول ثابت، ما أوجد انقسامًا بين إنشاء المحتوى والاستهلاك في الوقت الفعلي.
ولمعالجة هذه القيود، نقدّم معمارية جديدة لنموذج العالم توحّد نموذج أساس متعدد الوسائط أصليًا، وآلية انحدار ذاتي للاتساق، ومحرك استجابة فورية. يتيح هذا النهج الموحّد المعالجة المشتركة للرقع الزمكانية إلى جانب بيانات النص والصوت، ما يفكك فعليًا صوامع معالجة الوسائط التقليدية. ومن خلال نشر نظام قادر على البث اللانهائي عبر آلية انحدار ذاتي ومحرك استجابة فورية، يظل العالم المولَّد متسقًا فيزيائيًا عبر الآفاق الطويلة مع عبء حوسبي منخفض.
القدرة الأساسية: بالاستفادة من هذه المعمارية، يحقق نظامنا اختراقًا في الأداء، إذ يولّد فيديو عالي الدقة يصل إلى 1080P في الوقت الفعلي. تعزز هذه القدرة الدقة البصرية وتمكّن الألعاب الأصيلة للذكاء الاصطناعي والسينما التفاعلية، حيث تتطور البيئات والسرديات ديناميكيًا استجابة لتفاعل المستخدم. وعلى نطاق أوسع، يتيح ذلك للأنظمة التوليدية أن تعمل كعوالم مستمرة وتفاعلية بدل أن تكون قطعًا وسائطية محدودة، ما يشير إلى مسار نحو محاكاة سمعية بصرية متصلة وذات حالة وتفاعلية.
2. البنية التقنية
2.1 Omni: نموذج الأساس متعدد الوسائط الأصلي
ولبلوغ قدرات عامة، تجاوزنا خطوط التوليد التقليدية بتصميم نموذج أساس متعدد الوسائط أصلي من طرف إلى طرف بالكامل.
- تمثيل موحّد: يوحّد نموذج Omni وسائط متنوعة (النص والصورة والفيديو والصوت) في تيار متصل من الرموز، ما يتيح له قبول مدخلات متعددة الوسائط اعتباطية ضمن إطار واحد.
- تدريب من طرف إلى طرف: تُدرَّب المعمارية بأكملها عبر مهام غير متجانسة من دون واجهات وسيطة، ما يمنع انتشار الأخطاء ويضمن قابلية توسع متينة.
- الدقة الأصلية: نستخدم التدريب بالدقة الأصلية داخل هذا الإطار لتجنب العيوب المرتبطة عادة بالقص أو إعادة التحجيم.
وعلاوة على ذلك، يستبطن النموذج القوانين الفيزيائية الجوهرية وديناميكيات العالم الحقيقي بالتعلم من متن ضخم من بيانات الفيديو الواقعية. ويمكّن هذا الفهم التأسيسي النظام من تركيب «عالم موازٍ» متسق ومتجاوب في الوقت الفعلي.
يتوسع نموذج Omni بفعالية، فلا يعمل مجرد محرك توليدي، بل كخطوة رائدة نحو بناء محاكيات عامة الغرض للعالم الفيزيائي. وبمعاملة مهمة المحاكاة كنموذج توليد واحد من طرف إلى طرف، نيسّر استكشاف عوالم مولَّدة بالذكاء الاصطناعي في الوقت الفعلي وذات أفق طويل.

الشكل 1. المعمارية من طرف إلى طرف لنموذج الأساس متعدد الوسائط الأصلي Omni لدينا؛ يتيح التصميم الموحّد لنموذج Omni قبول مدخلات متعددة الوسائط اعتباطية وتوليد الصوت والفيديو في الوقت نفسه.
2.2 الذاكرة: بث لا نهائي متسق عبر آلية الانحدار الذاتي
وعلى خلاف أساليب الانتشار القياسية المقيدة بمقاطع محدودة، يدمج PixVerse-R1 النمذجة بالانحدار الذاتي لتمكين بث بصري لا نهائي ومتصل، ويضم آلية انتباه معزَّزة بالذاكرة لضمان بقاء العالم المولَّد متسقًا فيزيائيًا عبر الآفاق الطويلة.
- البث اللانهائي: بصياغة تركيب الفيديو كعملية انحدار ذاتي، يتنبأ النموذج بالإطارات اللاحقة على التوالي لتحقيق بث بصري متصل وغير محدود.
- الاتساق الزمني: تشرط آلية انتباه معزَّزة بالذاكرة توليد الإطار الحالي على التمثيلات الكامنة للسياق السابق، ما يضمن بقاء العالم متسقًا فيزيائيًا عبر الآفاق الطويلة.
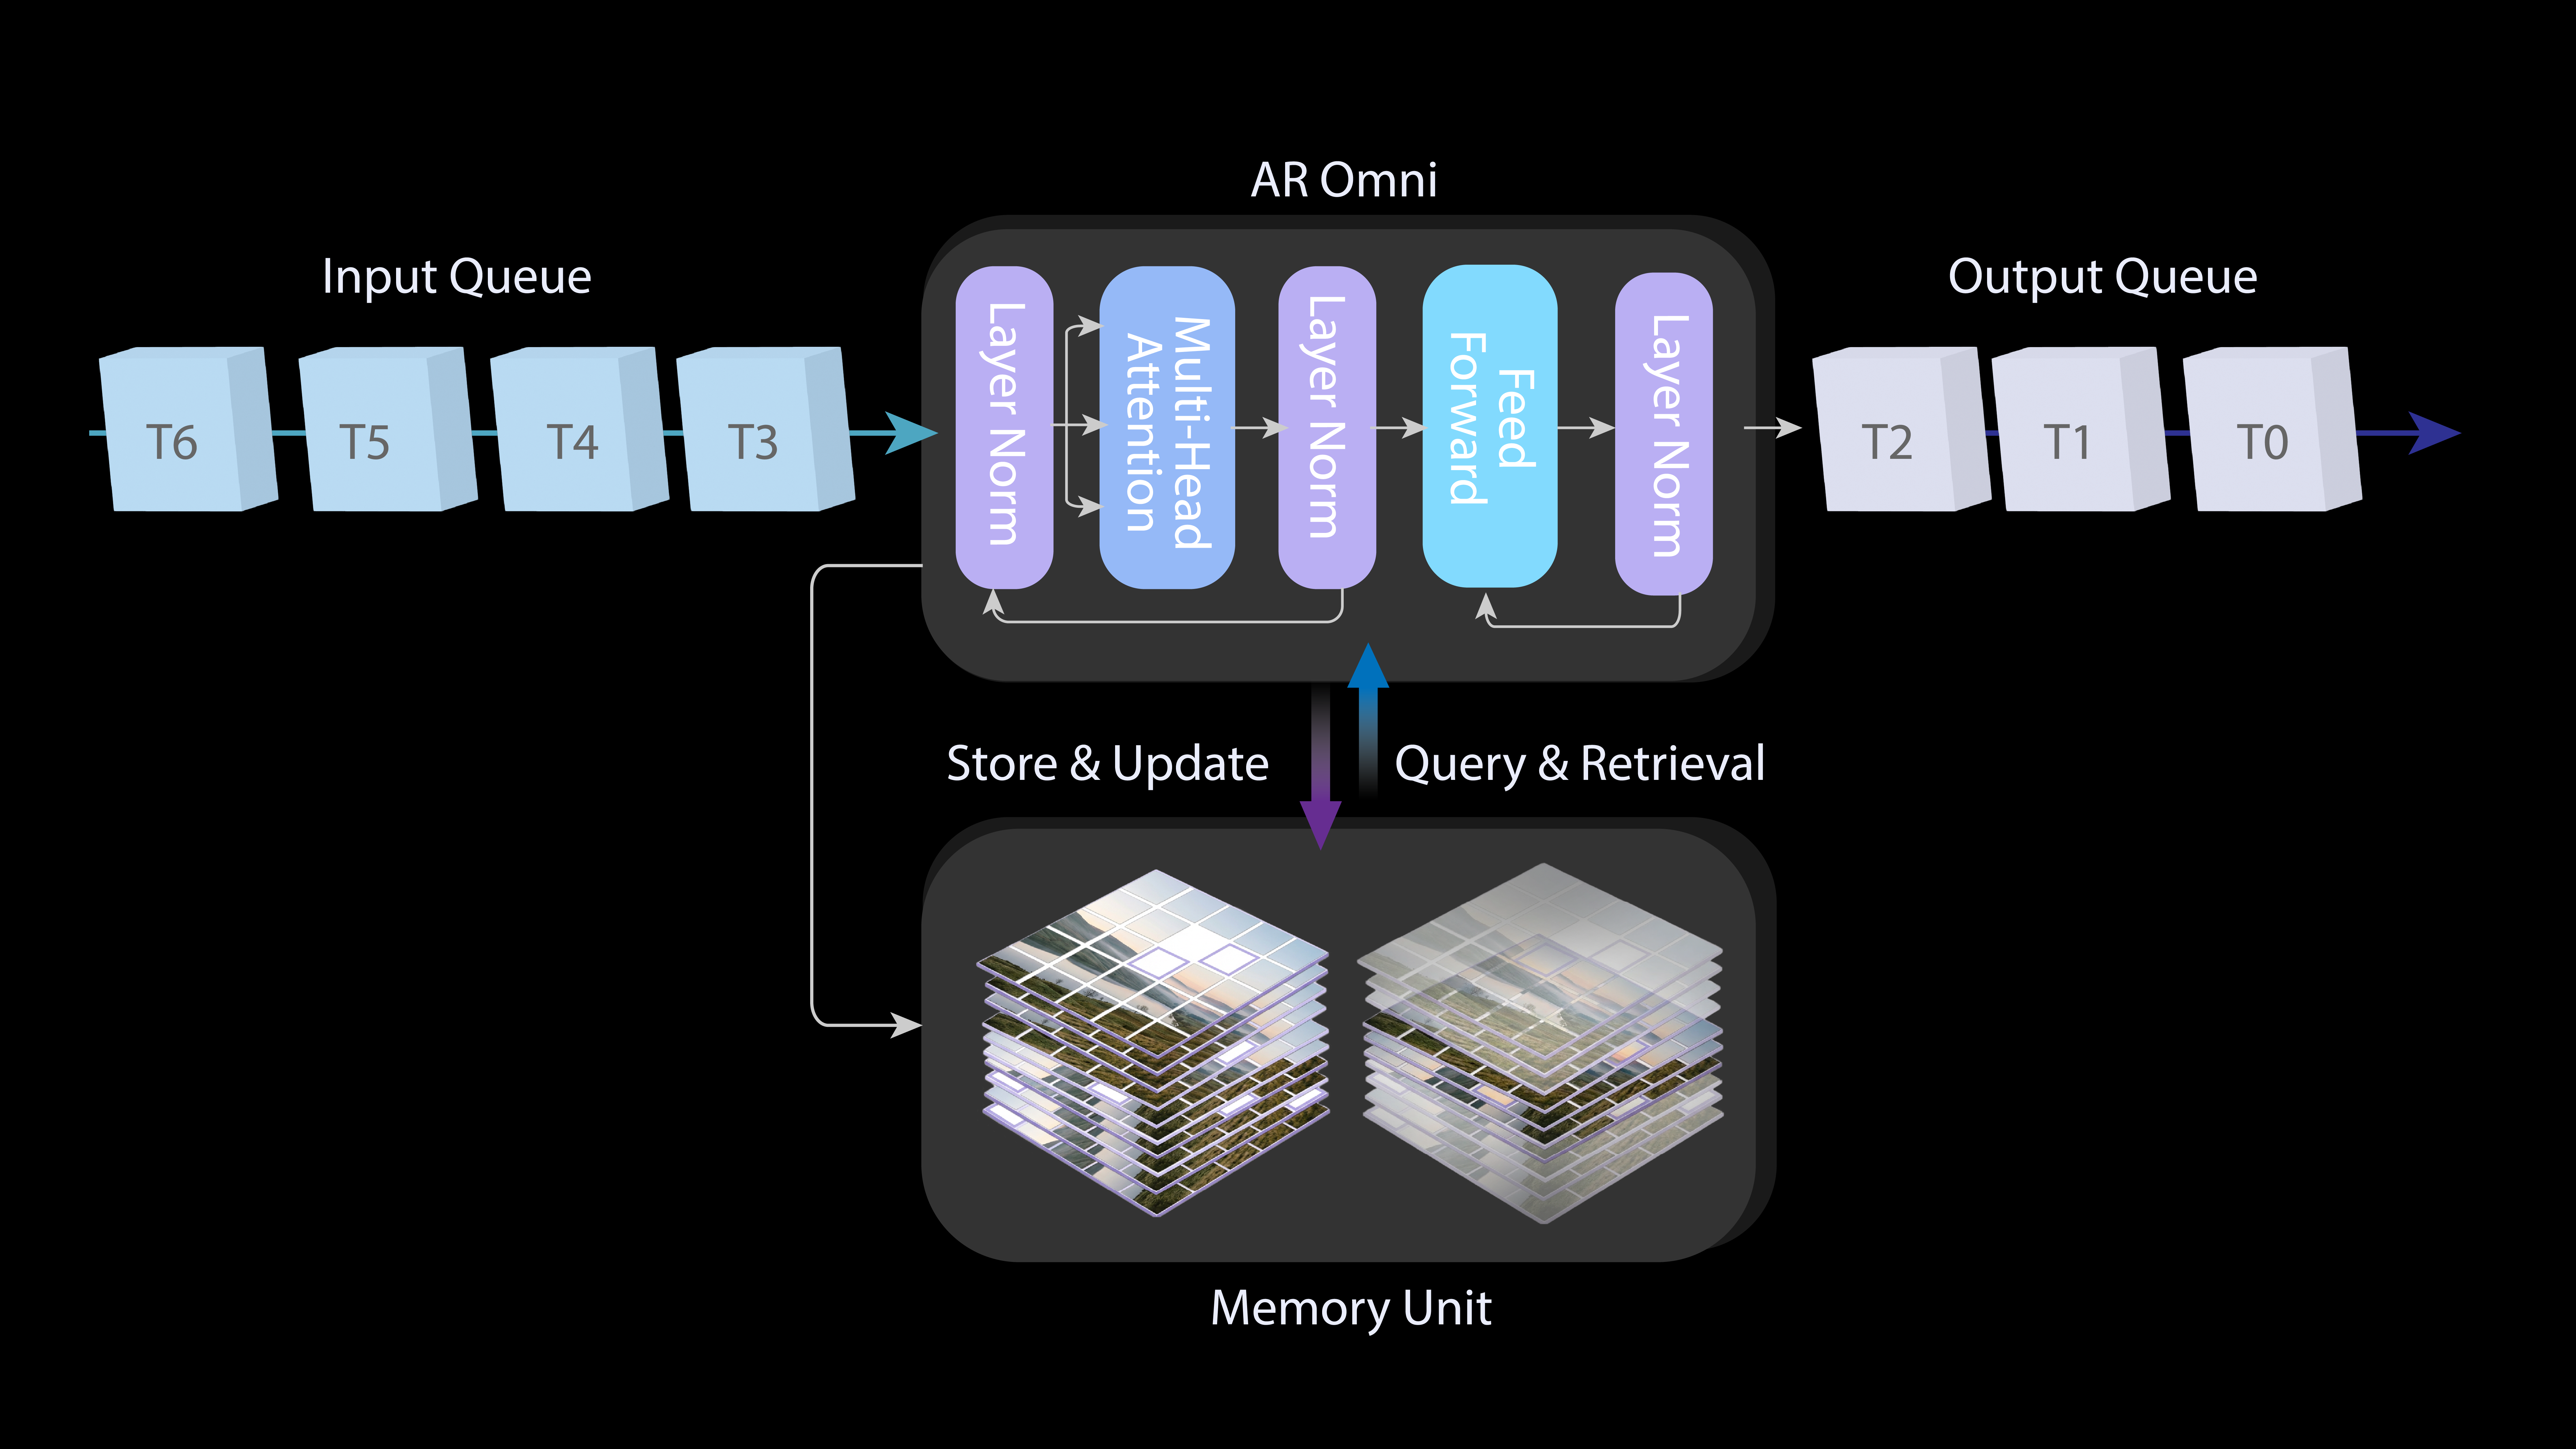
الشكل 2. النمذجة المتكاملة بالانحدار الذاتي مع نموذج الأساس Omni.
2.3 دقة 1080P في الوقت الفعلي: محرك الاستجابة الفورية
في حين يضمن إزالة الضوضاء التكرارية عادة جودة عالية، فإن كثافته الحوسبية كثيرًا ما تعيق الأداء في الوقت الفعلي. ولحل ذلك وتحقيق التوليد في الوقت الفعلي بدقات عالية (تصل إلى 1080P)، أعدنا معمارية خط المعالجة إلى محرك استجابة فورية.
يحسّن محرك الاستجابة الفورية (IRE) عملية أخذ العينات عبر التطورات التالية:
- طي المسار الزمني: بتنفيذ تعيين النقل المباشر كمسبق بنيوي، تتنبأ الشبكة بتوزيع البيانات النظيفة مباشرة. ويخفض ذلك خطوات أخذ العينات من عشرات إلى 1–4 فحسب، ما يخلق مسارًا مبسّطًا ضروريًا لزمن استجابة بالغ الانخفاض.
- تصحيح التوجيه: نتجاوز عبء أخذ العينات في التوجيه الخالي من المصنّف بدمج التدرجات الشرطية في نموذج الطالب.
- الانتباه المتناثر التكيفي: يخفف ذلك تكرار الاعتماد طويل المدى، فينتج رسمًا بيانيًا حوسبيًا مكثفًا ييسّر أكثر تحقيق توليد 1080P في الوقت الفعلي.
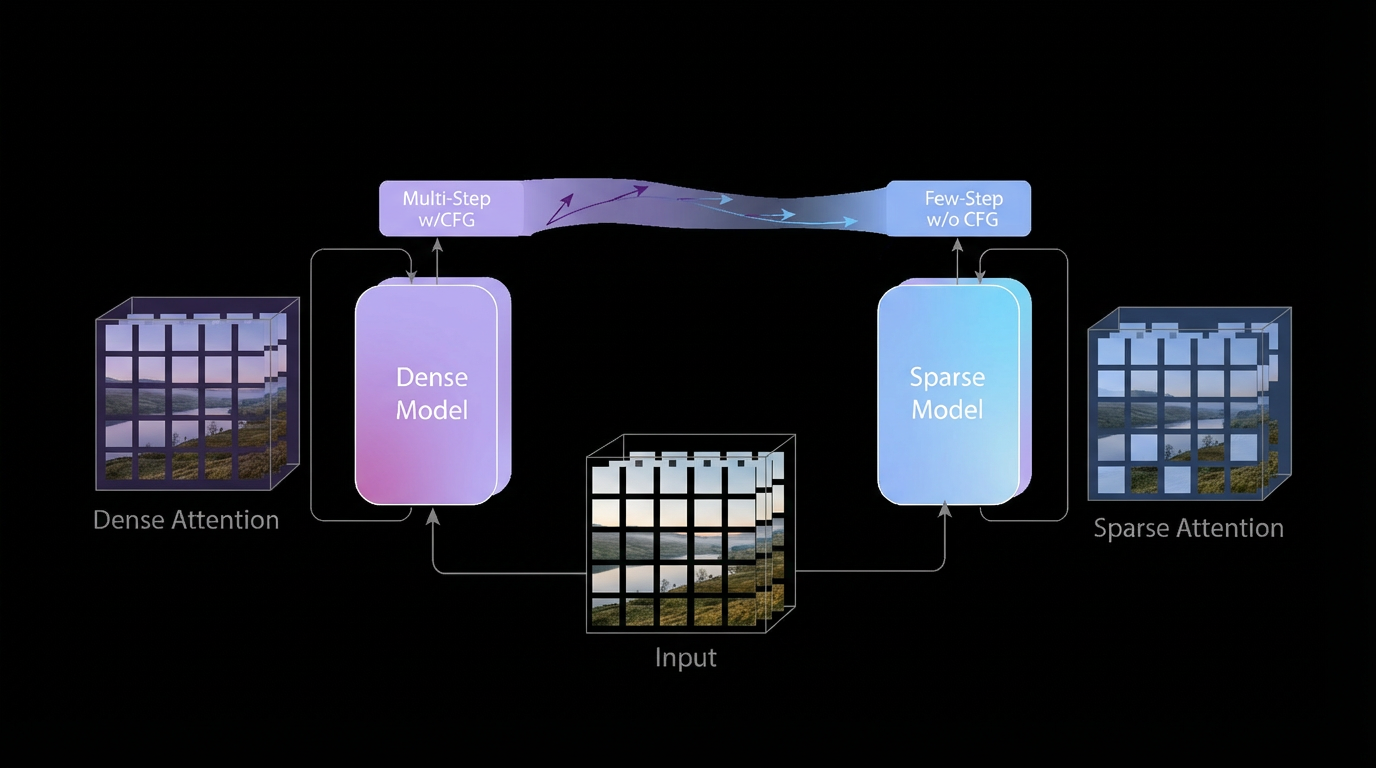
الشكل 3. يتألف محرك الاستجابة الفورية من ثلاث وحدات: طي المسار الزمني، وتصحيح التوجيه، وتعلم الانتباه المتناثر التكيفي.
3. التطبيقات والأثر الاجتماعي
يقدّم PixVerse-R1 وسيطًا توليديًا جديدًا: أنظمة سمعية بصرية في الوقت الفعلي ومتصلة وذات حالة. وعلى خلاف الفيديو المُعد مسبقًا، يعمل هذا الوسيط كعملية مستمرة تستجيب فورًا لنية المستخدم، حيث يكون التوليد والتفاعل مترابطين بإحكام. ويمكّن هذا الوسيط الجديد طائفة واسعة من الأنظمة التفاعلية، بما في ذلك على سبيل المثال لا الحصر:
-
الوسائط التفاعلية
- ألعاب أصيلة للذكاء الاصطناعي وتجارب سينمائية تفاعلية
- الواقع الافتراضي/الواقع الممتد في الوقت الفعلي والمحاكاة الغامرة
-
الأنظمة الإبداعية والتعليمية
- فن الوسائط التكيفي والتركيبات التفاعلية
- بيئات التعلم والتدريب في الوقت الفعلي
-
المحاكاة والتخطيط
- البحث التجريبي واستكشاف السيناريوهات
- المحاكاة الصناعية والزراعية والبيئية
وإلى جانب التطبيقات المحددة، يعمل PixVerse-R1 كمحاكٍ مستمر لعالم سمعي بصري، فيقلل المسافة بين نية الإنسان واستجابة النظام، ويمكّن أشكالًا جديدة من الإبداع المشترك بين الإنسان والذكاء الاصطناعي داخل بيئات رقمية مستمرة.
4. الخاتمة
يقدّم PixVerse-R1 إطارًا توليديًا في الوقت الفعلي يتغلب على القيود المتأصلة في مسارات عمل الفيديو التقليدية عبر ابتكارات معمارية في المعالجة متعددة الوسائط والاستجابة الفورية. وبتمكين التوليد المتسق في الوقت الفعلي، يؤشر هذا النموذج إلى تطور مهم في إنشاء الوسائط السمعية البصرية وتجربتها. ويتيح التحول نحو زمن الاستجابة في الوقت الفعلي الانتقال من استهلاك المحتوى الثابت إلى التفاعل مع بيئة ديناميكية، ويوفر ركيزة حوسبية قابلة للتوسع لتطبيقات تمتد من الألعاب الأصيلة للذكاء الاصطناعي إلى المحاكاة الصناعية المعقدة. وبسد الفجوة بين نية المستخدم والتغذية الراجعة البصرية الفورية، يؤسس النظام أفقًا جديدًا لنمذجة العوالم التفاعلية والبيئات التعاونية بين الإنسان والذكاء الاصطناعي.
5. القيود
وفي حين يقدّم PixVerse-R1 مزايا نمذجة مهمة، يظل هناك قيدان أساسيان يتعلقان بالدقة الزمنية والدقة الفيزيائية:
- تراكم الخطأ الزمني: عبر التسلسلات الممتدة، قد تتراكم أخطاء تنبؤ طفيفة، ما قد يهدد السلامة البنيوية للمحاكاة.
- مقايضة الفيزياء مقابل الحوسبة: لتحقيق التوليد في الوقت الفعلي بنجاح، قُدّمت تضحيات محددة فيما يتعلق بتعقيد التوليد. ونتيجة لذلك، قد يكون هناك قدر معيّن من الفقد في التصيير الدقيق لبعض القوانين الفيزيائية مقارنة بالنماذج غير العاملة في الوقت الفعلي.