PixVerse-R1: Next-Generation na Real-Time World Model
PixVerse-R1: Next-Generation na Real-Time World Model
Abstrak
Ipinapakita namin ang PixVerse-R1, isang next-generation na real-time world model na naka-arkitektura sa isang native multimodal foundation model. Ang sistemang ito ay nagbibigay-daan sa real-time na pagbuo ng video kung saan ang visual content ay agad at maayos na tumutugon sa input ng user. Sa pagdaig sa likas na latency at mga fixed-length na hadlang ng tradisyonal na video workflow, ginagawang ng PixVerse-R1 ang pagbuo ng video bilang isang walang hanggan, tuloy-tuloy, at interactive na visual stream. Ito ay kumakatawan sa isang makabuluhang ebolusyon sa paglikha, karanasan, at pagbabahagi ng audiovisual media, na nagmamarka ng paradigm shift tungo sa matalino at interactive na media na kayang agad na umangkop batay sa intensyon ng user.
Handa nang maranasan ang R1? Tingnan ang aming anunsyo ng paglunsad ng PixVerse R1 para sa praktikal na impormasyon at kung paano kumuha ng invite code para ma-access ang R1.
1. Panimula
Ang landscape ng digital media ay pundamental na lumilipat mula sa static at pre-rendered na content tungo sa dynamic at interactive na mga karanasan. Ang mga conventional production pipeline ay matagal nang napipigilan ng mataas na latency at fixed-length na mga clip, na lumilikha ng dichotomy sa pagitan ng paglikha ng content at real-time na pagkonsumo.
Upang tugunan ang mga limitasyong ito, ipinakikilala namin ang isang nobelang arkitektura ng world model na pinag-iisa ang isang native multimodal foundation model, isang consistency autoregressive mechanism, at isang instantaneous response engine. Ang pinag-isang approach na ito ay nagbibigay-daan sa magkasamang pagpoproseso ng spatiotemporal patches kasabay ng text at audio data, na epektibong binubuwag ang tradisyonal na mga silo ng media processing. Sa pag-deploy ng isang sistemang kayang mag-infinite streaming sa pamamagitan ng autoregressive mechanism at instantaneous response engine, ang nabuong mundo ay nananatiling physically consistent sa mahahabang horizon na may mababang computational overhead.
Pangunahing Kakayahan: Gamit ang arkitekturang ito, nakakamit ng aming sistema ang isang breakthrough sa performance, na bumubuo ng high-resolution na video hanggang 1080P nang real-time. Pinapahusay ng kakayahang ito ang visual fidelity at nagbibigay-daan sa AI-native gaming at interactive cinema, kung saan ang mga kapaligiran at naratibo ay dynamic na umuunlad bilang tugon sa interaction ng user. Sa mas malawak na saklaw, pinapayagan nito ang mga generative system na gumana bilang persistent at interactive na mga mundo sa halip na finite na media artifact, na nagpapahiwatig ng isang trajectory tungo sa tuloy-tuloy, stateful, at interactive na audiovisual simulation.
2. Teknikal na Arkitektura
2.1 Omni: Native Multimodal Foundation Model
Upang makamit ang pangkalahatang kakayahan, nilampasan namin ang tradisyonal na generation pipeline sa pamamagitan ng pagdidisenyo ng isang ganap na end-to-end na Native Multimodal Foundation Model.
- Pinag-isang Representasyon: Pinag-iisa ng Omni-model ang magkakaibang modality (text, image, video, audio) sa isang tuloy-tuloy na stream ng mga token, na nagbibigay-daan dito na tumanggap ng arbitrary na multimodal input sa loob ng isang framework.
- End-to-End na Pagsasanay: Ang buong arkitektura ay sinasanay sa magkakaibang gawain nang walang intermediate interface, na pumipigil sa pagkalat ng error at nagtitiyak ng matibay na scalability.
- Native Resolution: Gumagamit kami ng native resolution training sa loob ng framework na ito upang maiwasan ang mga artifact na karaniwang kaugnay ng cropping o resizing.
Higit pa rito, ini-internalize ng modelo ang likas na pisikal na batas at dynamics ng tunay na mundo sa pamamagitan ng pag-aaral mula sa napakalaking corpus ng real-world na video data. Ang pundasyong pag-unawang ito ay nagbibigay-kapangyarihan sa sistema na mag-synthesize ng isang consistent at tumutugon na “parallel world” nang real-time.
Ang Omni-model ay epektibong nagsa-scale, na gumagana hindi lamang bilang isang generative engine, kundi bilang isang pangungunang hakbang tungo sa pagbuo ng general-purpose na simulator ng pisikal na mundo. Sa pagtrato sa simulation task bilang isang iisang end-to-end na generation paradigm, pinapadali namin ang paggalugad ng real-time at long-horizon na AI-generated na mga mundo.

Figure 1. Ang end-to-end na arkitektura ng aming Omni Native Multimodal Foundation Model; ang pinag-isang disenyo ay nagbibigay-daan sa aming Omni-model na tumanggap ng arbitrary na multimodal input at bumuo ng audio at video nang sabay.
2.2 Memory: Consistent na Infinite Streaming sa pamamagitan ng Autoregressive Mechanism
Hindi tulad ng standard diffusion method na limitado sa finite na mga clip, isinasama ng PixVerse-R1 ang autoregressive modeling upang paganahin ang infinite at tuloy-tuloy na visual streaming, at isinasama ang isang memory-augmented attention mechanism upang matiyak na ang nabuong mundo ay nananatiling physically consistent sa mahahabang horizon.
- Infinite Streaming: Sa pagbuo ng video synthesis bilang isang autoregressive na proseso, sunud-sunod na hinuhulaan ng modelo ang mga kasunod na frame upang makamit ang tuloy-tuloy at walang hangganang visual streaming.
- Temporal Consistency: Ang isang memory-augmented attention mechanism ay kinokondisyon ang pagbuo ng kasalukuyang frame sa latent representations ng naunang context, na tinitiyak na ang mundo ay nananatiling physically consistent sa mahahabang horizon.
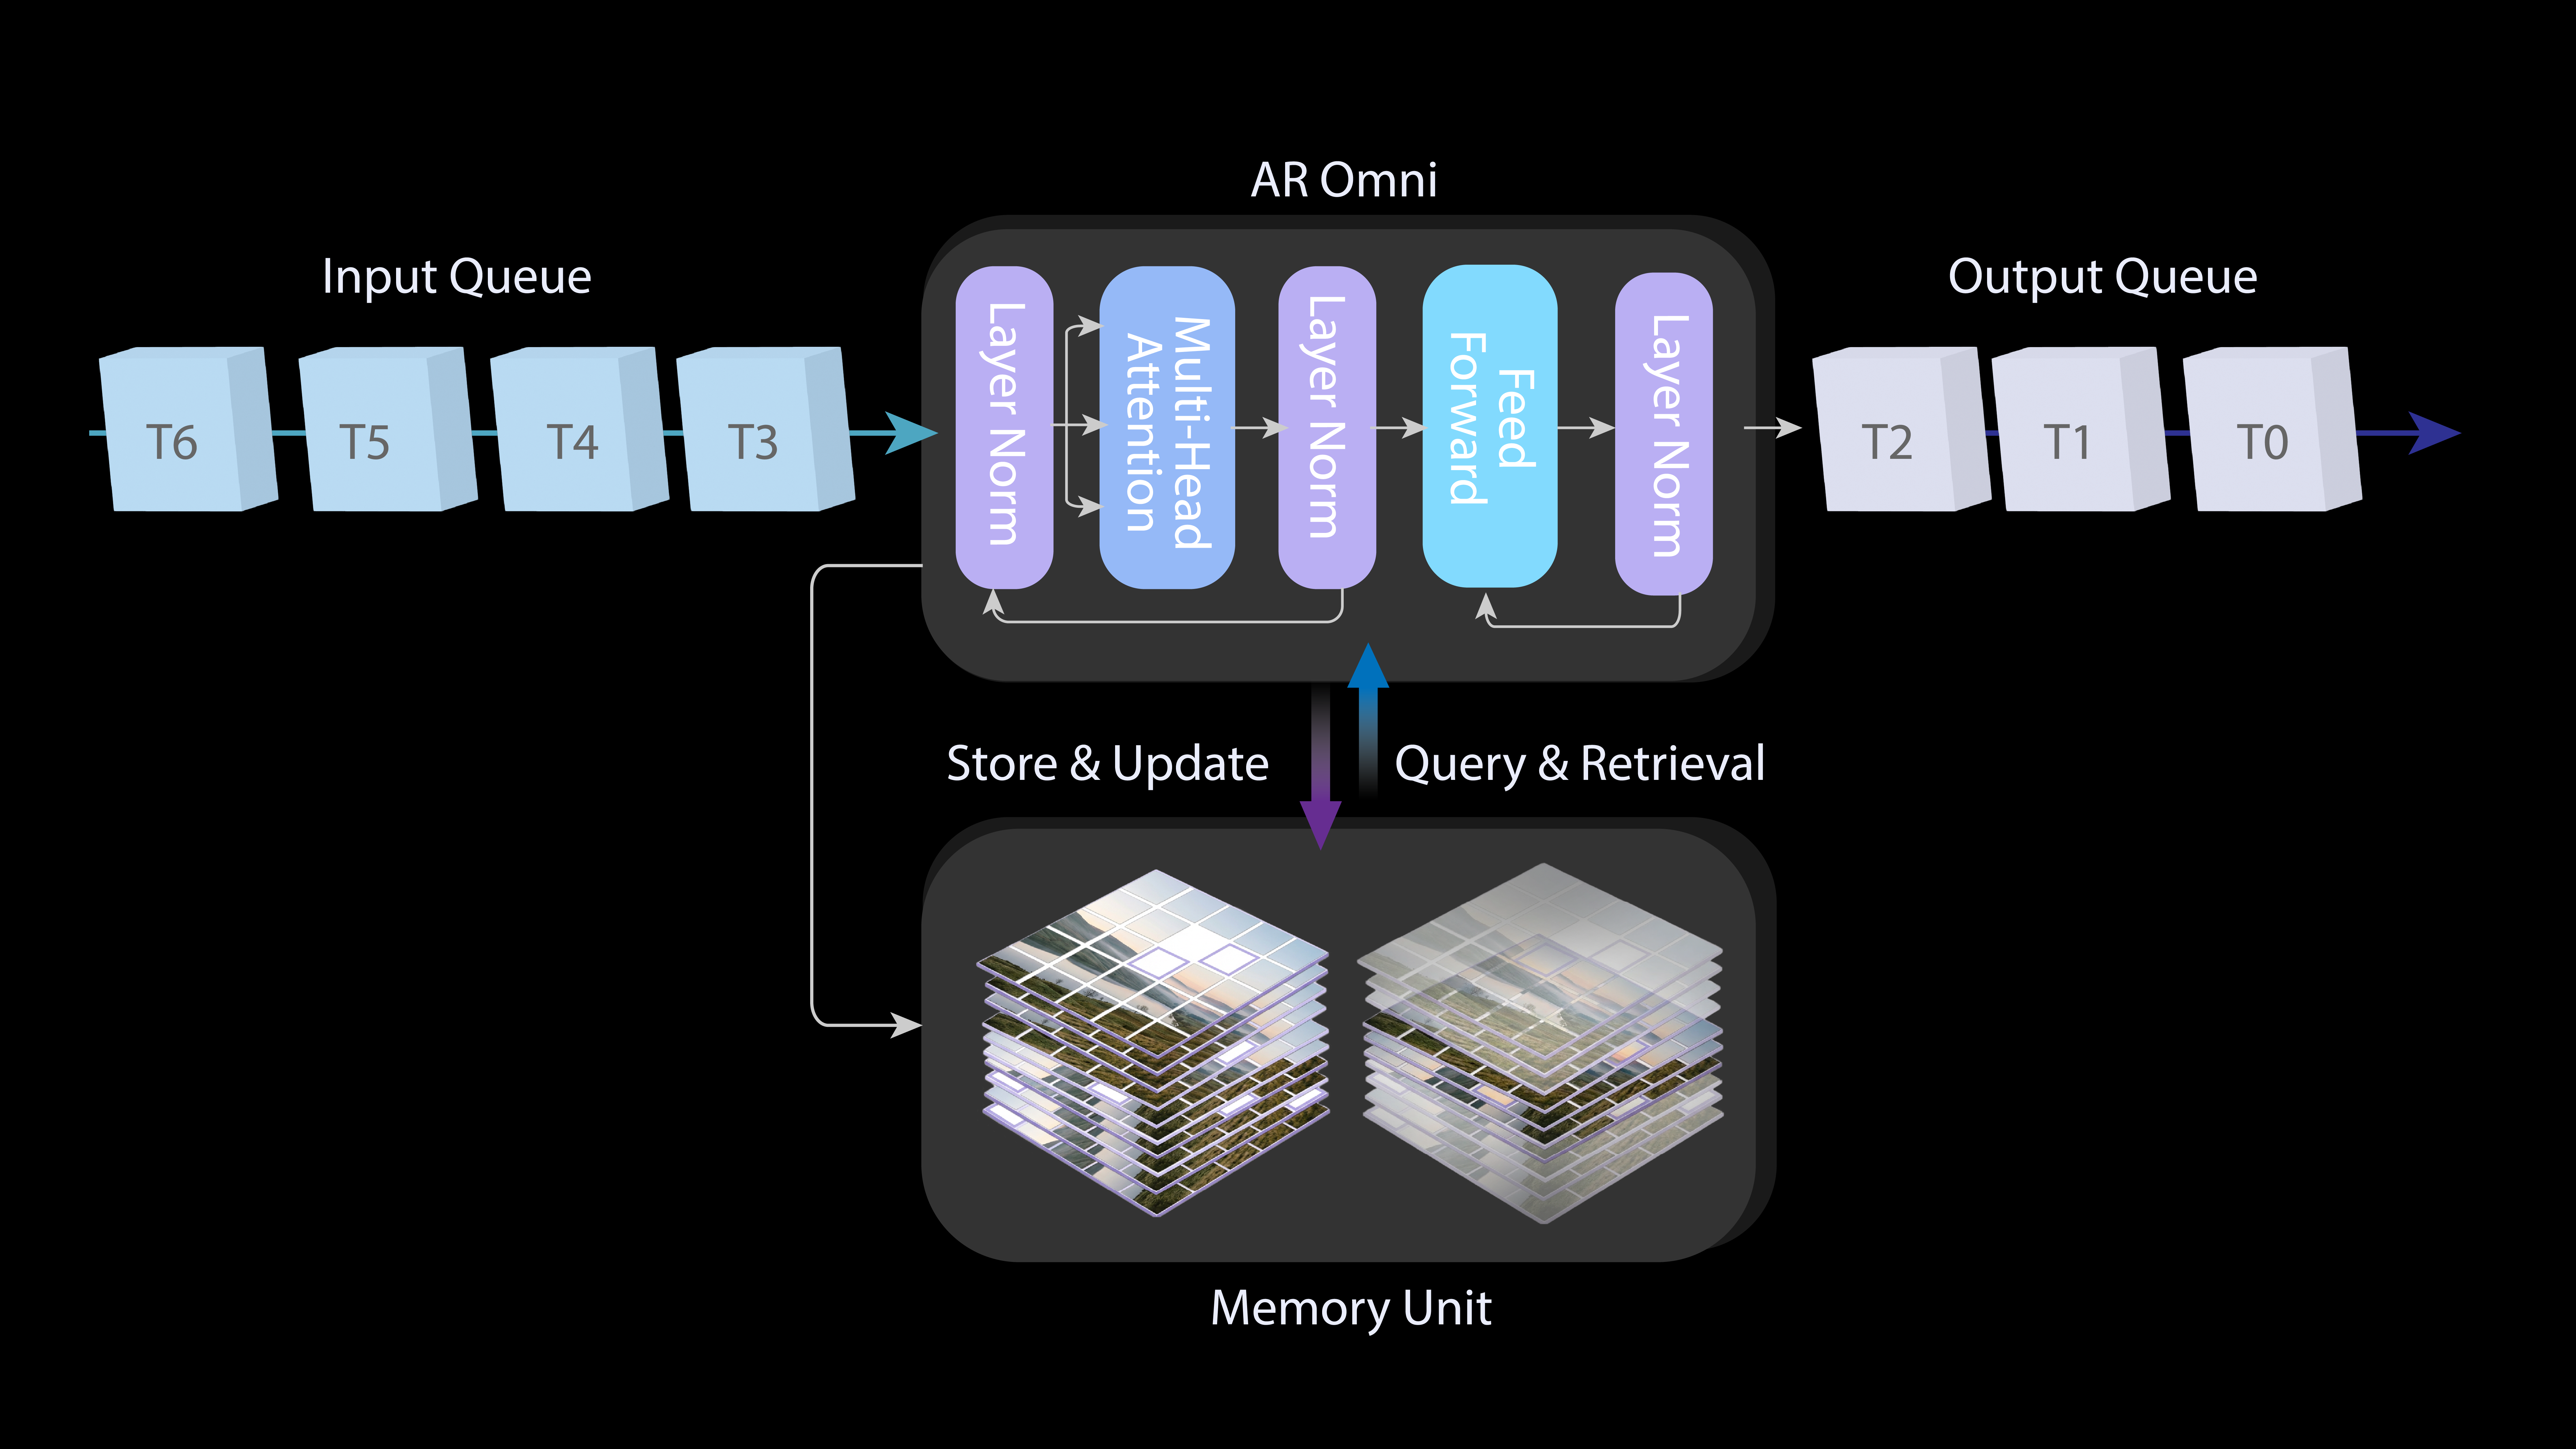
Figure 2. Ang pinagsamang autoregressive modeling kasama ang Omni foundation model.
2.3 Real-time na 1080P: Instantaneous Response Engine
Bagama’t karaniwang tinitiyak ng iterative denoising ang mataas na kalidad, ang computational density nito ay madalas na humahadlang sa real-time na performance. Upang lutasin ito at makamit ang real-time na pagbuo sa mataas na resolution (hanggang 1080P), muling inarkitektura namin ang pipeline bilang isang Instantaneous Response Engine.
Ino-optimize ng IRE ang sampling process sa pamamagitan ng mga sumusunod na pagsulong:
- Temporal Trajectory Folding: Sa pagpapatupad ng Direct Transport Mapping bilang isang structural prior, direktang hinuhulaan ng network ang malinis na data distribution. Binabawasan nito ang mga sampling step mula sa dose-dosenang tungo sa 1–4 lamang, na lumilikha ng isang streamlined na pathway na mahalaga para sa ultra-low latency.
- Guidance Rectification: Nilalampasan namin ang sampling overhead ng Classifier-Free Guidance sa pamamagitan ng pagsasama ng conditional gradients sa student model.
- Adaptive Sparse Attention: Pinapagaan nito ang redundancy ng long-range dependency, na nagbubunga ng isang condensed computational graph na higit pang nagpapadali sa pagsasakatuparan ng real-time na 1080P generation.
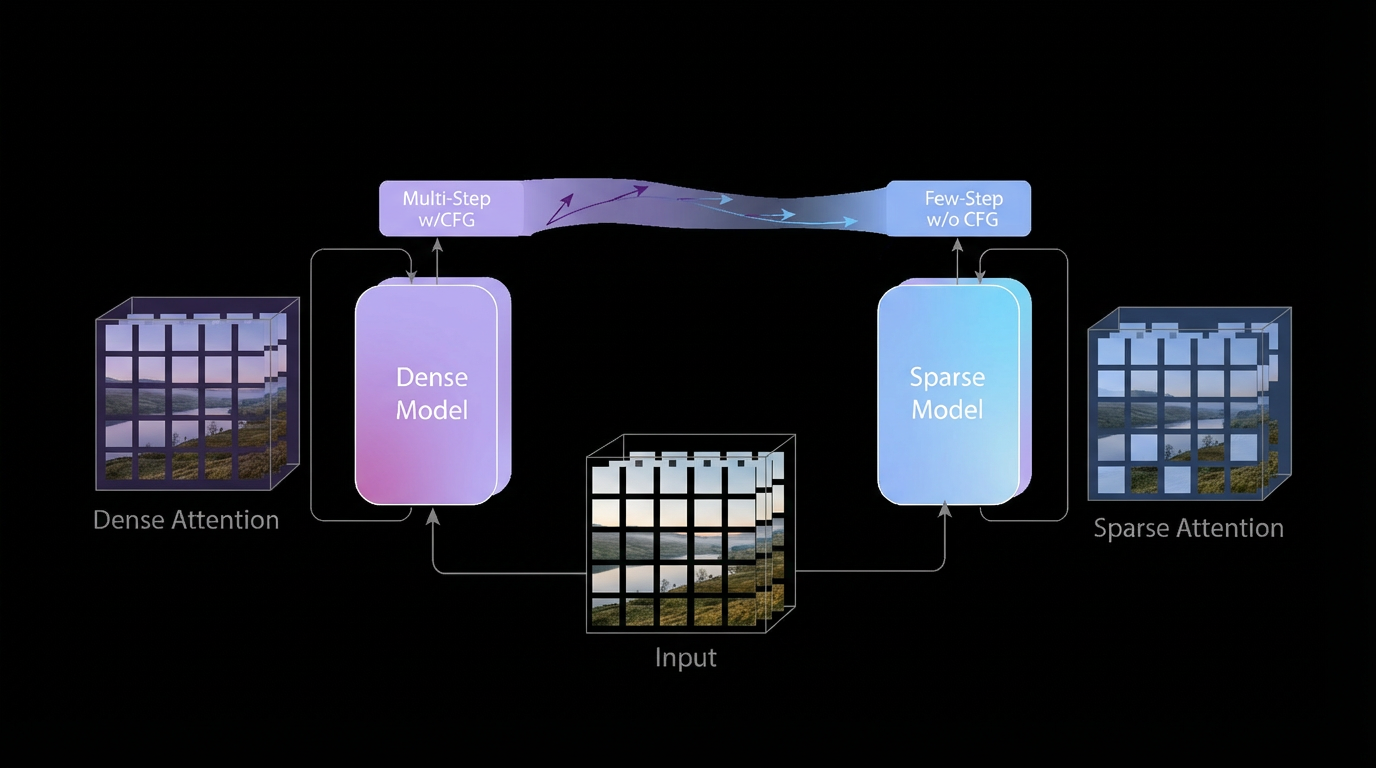
Figure 3. Ang instantaneous response engine ay binubuo ng tatlong module: temporal trajectory folding, guidance rectification, at adaptive sparse attention learning.
3. Mga Aplikasyon at Epektong Panlipunan
Ipinakikilala ng PixVerse-R1 ang isang bagong generative medium: real-time, tuloy-tuloy, at stateful na audiovisual system. Hindi tulad ng pre-rendered na video, ang medium na ito ay gumagana bilang isang persistent na prosesong agad na tumutugon sa intensyon ng user, kung saan ang pagbuo at interaction ay mahigpit na magkaugnay. Ang bagong medium na ito ay nagbibigay-daan sa isang malawak na klase ng interactive na sistema, kabilang ngunit hindi limitado sa:
-
Interactive Media
- Mga AI-native na laro at interactive na cinematic experience
- Real-time na VR/XR at immersive na simulation
-
Malikhain at Pang-edukasyong Sistema
- Adaptive media art at interactive na installation
- Real-time na pag-aaral at mga kapaligiran sa pagsasanay
-
Simulation at Pagpaplano
- Eksperimental na pananaliksik at paggalugad ng senaryo
- Industrial, agricultural, at ecological na simulation
Higit pa sa mga partikular na aplikasyon, ang PixVerse-R1 ay gumagana bilang isang tuloy-tuloy na audiovisual world simulator, na nagpapaliit sa distansya sa pagitan ng intensyon ng tao at tugon ng sistema, at nagbibigay-daan sa mga bagong anyo ng human–AI co-creation sa loob ng persistent na digital na kapaligiran.
4. Konklusyon
Ipinakikilala ng PixVerse-R1 ang isang real-time na generative framework na dumadaig sa likas na limitasyon ng tradisyonal na video workflow sa pamamagitan ng mga inobasyon sa arkitektura sa multimodal processing at instantaneous response. Sa pagbibigay-daan sa consistent at real-time na pagbuo, ang modelong ito ay nagmamarka ng makabuluhang ebolusyon sa paglikha at karanasan ng audiovisual media. Ang paglipat tungo sa real-time latency ay nagbibigay-daan sa transisyon mula sa static na pagkonsumo ng content tungo sa dynamic na interaction sa kapaligiran, na nagbibigay ng scalable na computational substrate para sa mga aplikasyon mula sa AI-native gaming hanggang sa kumplikadong industrial simulation. Sa pagtulay sa agwat sa pagitan ng intensyon ng user at instantaneous na visual feedback, itinatatag ng sistema ang isang bagong hangganan para sa interactive world modeling at human-AI collaborative na mga kapaligiran.
5. Mga Limitasyon
Bagama’t nag-aalok ang PixVerse-R1 ng makabuluhang kalamangan sa modeling, dalawang pangunahing hadlang ang nananatili hinggil sa temporal accuracy at physical fidelity:
- Temporal Error Accumulation: Sa mahahabang sequence, maaaring mag-ipon ang maliliit na prediction error, na posibleng makompromiso ang structural integrity ng simulation.
- Trade-off ng Physics laban sa Computation: Upang matagumpay na makamit ang real-time na pagbuo, may mga partikular na sakripisyong ginawa hinggil sa generation complexity. Dahil dito, maaaring may tiyak na antas ng pagkawala sa tumpak na pag-render ng ilang pisikal na batas kumpara sa mga non-real-time na modelo.