PixVerse-R1: 下一代即時世界模型
PixVerse-R1: 下一代即時世界模型
摘要
我們推出了 PixVerse-R1,這是一種基於原生多模態基礎模型架構的下一代即時世界模型。該系統能夠實現即時影片生成,視覺內容可對使用者輸入做出即時、流暢的響應。通過克服傳統影片工作流固有的延遲和固定長度限制,PixVerse-R1 將影片生成轉變為無限、連續且互動式的視覺流。這代表了視聽媒體創作、體驗和分享的一次重大進化,標誌著向能夠根據使用者意圖進行瞬時適應的智慧化、互動式媒體的範式轉移。
1. 引言
數字媒體領域正在從靜態、預渲染的內容根本性地轉向動態、互動式的體驗。傳統的製作流水線歷來受高延遲和固定長度片段的約束,導致內容創作與即時消費之間存在隔閡。
為了解決這些侷限性,我們引入了一種全新的世界模型架構,它統一了原生多模態基礎模型、一致性自迴歸機制和瞬時響應引擎。這種統一的方法允許對時空補丁以及文本和音訊資料進行聯合處理,有效地拆解了傳統的媒體處理孤島。通過部署一個能夠通過自迴歸機制和瞬時響應引擎進行無限流式傳輸的系統,生成的系統在長週期內保持物理一致性,且計算開銷較低。
核心能力:憑藉這種架構,我們的系統在效能上實現了突破,能夠即時生成高達 1080P 的高解析度影片。 這種能力增強了視覺保真度,並賦能了 AI 原生遊戲和互動式電影,其中環境和敘事隨著使用者互動動態演變。從廣義上講,這使得生成系統能夠作為持久的、互動式的世界執行,而非有限的媒體人工製品,預示著向連續、有狀態且互動式的視聽模擬方向發展。
2. 技術架構
2.1 Omni: 原生多模態基礎模型
為了獲得通用能力,我們通過設計一個完全端到端的原生多模態基礎模型,超越了傳統的生成流水線。
- 統一表示: Omni 模型將多種模態(文本、影像、影片、音訊)統一為連續的令牌流,使其能夠在單一框架內接受任意多模態輸入。
- 端到端訓練: 整個架構在異構任務上進行訓練,無需中間介面,防止了誤差傳播並確保了強大的可擴充性。
- 原生解析度: 我們在此框架內利用原生解析度訓練,以避免通常與裁剪或縮放相關的偽影。
此外,該模型通過從海量的現實世界影片資料語料庫中學習,內化了現實世界的內在物理規律和動態。這種基礎性的理解使系統能夠即時合成一個一致、響應式的“平行世界”。
Omni 模型可以有效地擴充,它不僅作為一個生成引擎,而且是構建通用物理世界模擬器的開拓性一步。通過將模擬任務視為單一的、端到端的生成範式,我們促進了對即時、長週期 AI 生成世界的探索。

圖 1. 我們的 Omni 原生多模態基礎模型的端到端架構,統一的設計使我們的 Omni 模型能夠同時接受任意多模態輸入並生成音訊和影片。
2.2 Memory: 通過自迴歸機制實現一致的無限流
與受限於有限片段的標準擴散方法不同,PixVerse-R1 集成了自迴歸建模以實現無限、連續的視覺流,並引入了記憶增強的注意力機制,以確保生成的系統在長週期內保持物理一致性。
- 無限流: 通過將影片合成公式化為一個自迴歸過程,模型順序預測後續幀,以實現連續、無界的視覺流。
- 時間一致性: 記憶增強的注意力機制將當前幀的生成基於前序上下文的潛在表示,確保系統在長週期內保持物理一致性。
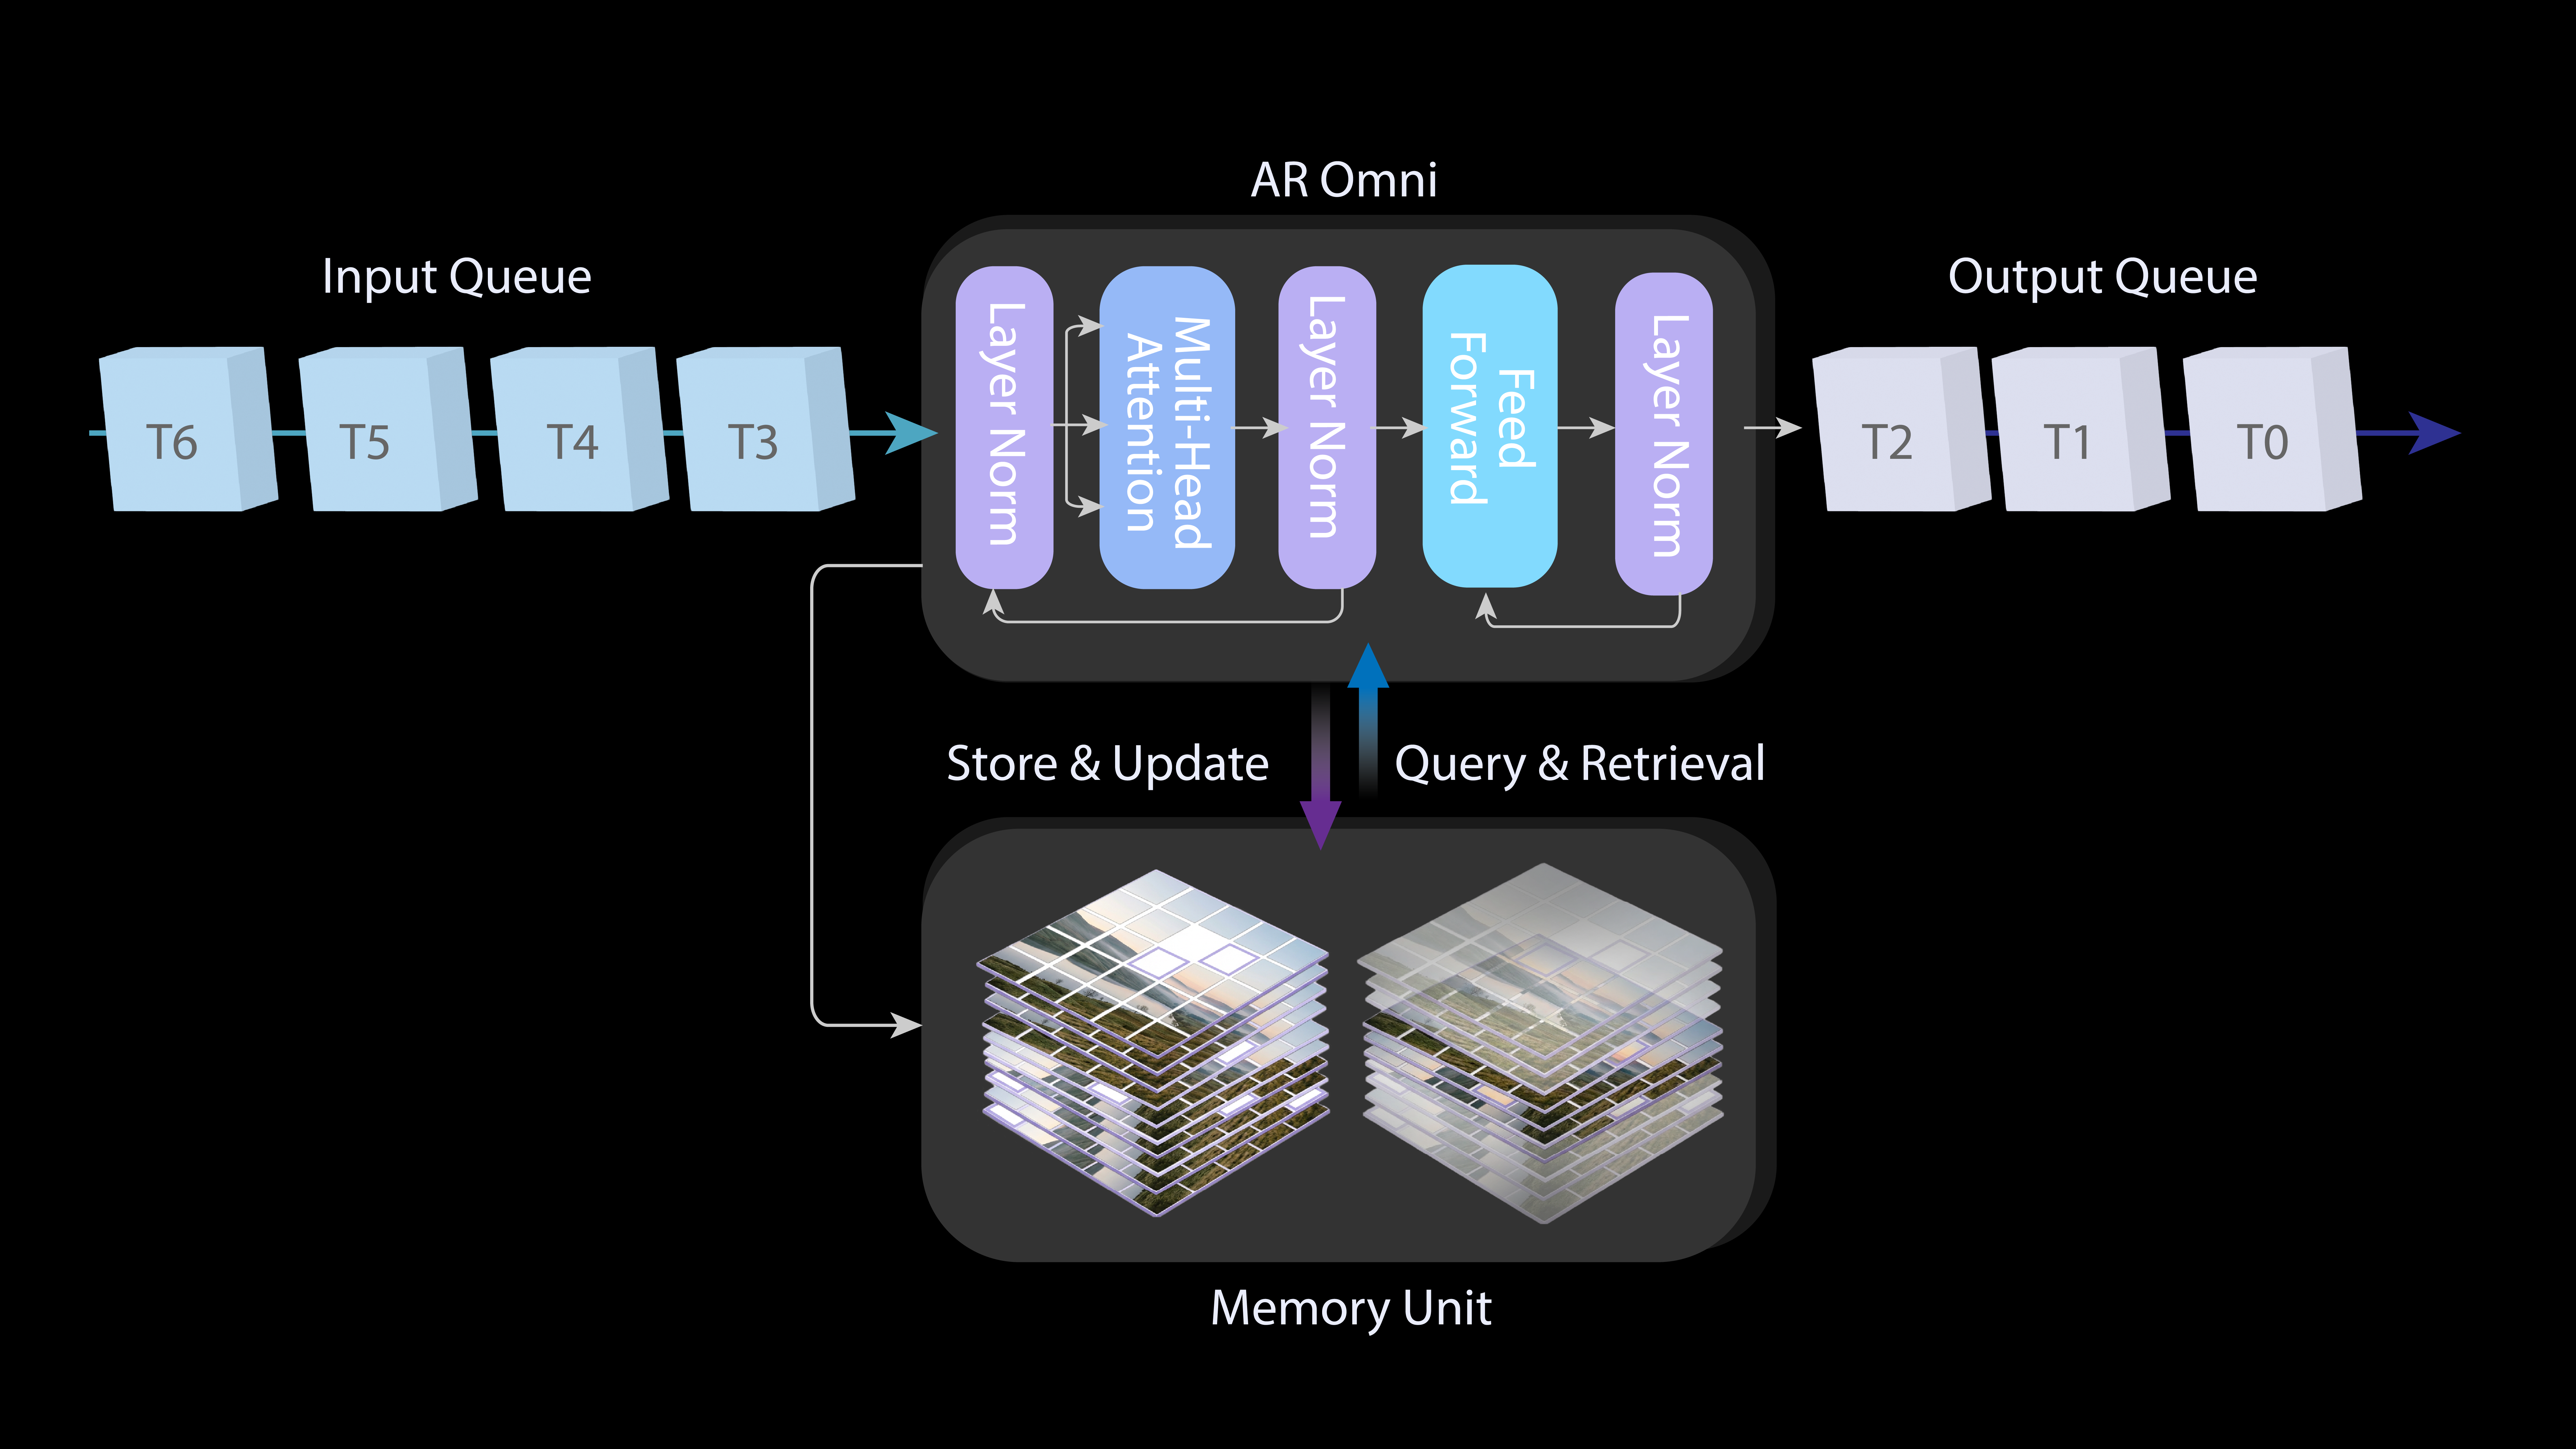
圖 2. 整合自迴歸建模與 Omni 基礎模型。
2.3 即時 1080P: 瞬時響應引擎
雖然迭代去噪通常能確保高質量,但其計算密度往往阻礙了即時效能。為了解決這個問題並實現高解析度(高達 1080P)的即時生成,我們將流水線重新構建為瞬時響應引擎 (IRE)。
IRE 通過以下技術進步優化了取樣過程:
- 時間軌跡摺疊: 通過實施直接傳輸對映作為結構先驗,網路直接預測乾淨的資料分佈。這將取樣步驟從幾十步減少到僅 1-4 步,創造了超低延遲所必需的精簡路徑。
- 引導校正: 我們通過將條件梯度合併到學生模型中,繞過了 Classifier-Free Guidance 的取樣開銷。
- 自適應稀疏注意力: 這減輕了長程依賴的冗餘,產生了一個濃縮的計算圖,進一步促進了即時 1080P 生成的實現。
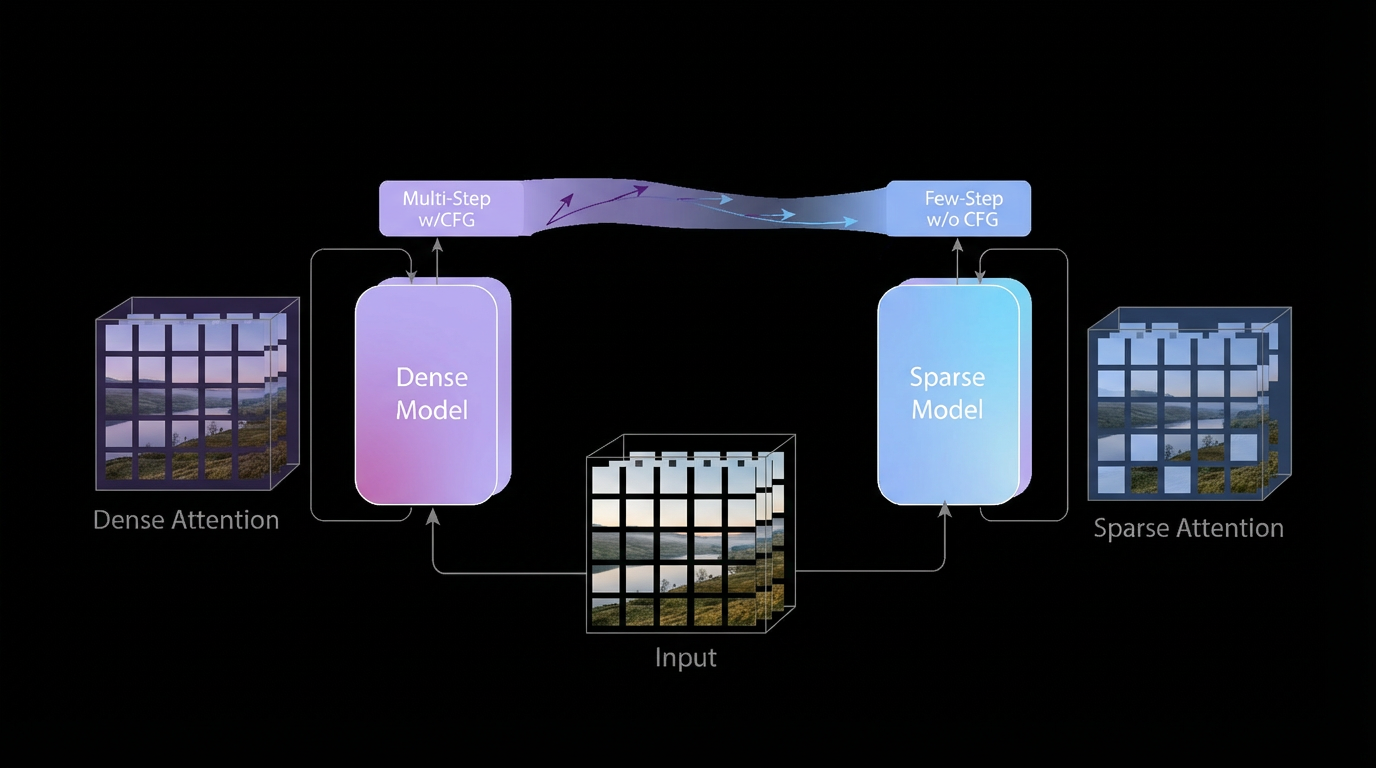
圖 3. 瞬時響應引擎由三個模組組成:時間軌跡摺疊、引導校正和自適應稀疏注意力學習。
3. 應用與社會影響
PixVerse-R1 引入了一種新的生成介質:即時、連續且有狀態的視聽系統。 與預渲染影片不同,這種介質作為一個持久的過程執行,對使用者意圖做出即時響應,生成與互動緊密耦合。 這種新介質賦能了一大類互動式系統,包括但不限於:
-
互動式媒體
- AI 原生遊戲和互動式電影體驗
- 即時 VR/XR 和沉浸式模擬
-
創意與教育系統
- 自適應媒體藝術和互動式裝置
- 即時學習和培訓環境
-
模擬與規劃
- 實驗性研究和情景探索
- 工業、農業和生態模擬
除了具體應用外,PixVerse-R1 作為一個連續的視聽世界模擬器執行,縮短了人類意圖與系統響應之間的距離,並賦能在持久數字環境中的新形式人機協同創作。
4. 結論
PixVerse-R1 引入了一個即時的生成框架,通過在多模態處理和瞬時響應方面的架構創新,克服了傳統影片工作流的固有侷限。通過實現一致的即時生成,該模型標誌著視聽媒體創作和體驗的一次重大進化。向即時延遲的轉變實現了從靜態內容消費到動態環境互動的過渡,為從 AI 原生遊戲到複雜工業模擬的應用提供了可擴充的計算基石。通過彌合用戶意圖與瞬時視覺反饋之間的鴻溝,該系統為互動式世界建模和人機協同環境建立了新的前沿。
5. 侷限性
雖然 PixVerse-R1 提供了顯著的建模優勢,但在時間準確性和物理保真度方面仍存在兩個主要約束:
- 時間誤差累積: 在超長序列中,微小的預測誤差可能會累積,從而可能損害模擬的結構完整性。
- 物理與計算的權衡: 為了成功實現即時生成,在生成複雜度方面做出了一些犧牲。因此,與非即時模型相比,在某些物理定律的精確渲染上可能會有一定程度的損失。