PixVerse-R1: Model świata czasu rzeczywistego nowej generacji
PixVerse-R1: Model świata czasu rzeczywistego nowej generacji
Streszczenie
Przedstawiamy PixVerse-R1, model świata czasu rzeczywistego nowej generacji, zbudowany na natywnym multimodalnym modelu bazowym. System ten umożliwia generowanie wideo w czasie rzeczywistym, w którym treść wizualna reaguje natychmiastowo i płynnie na dane wejściowe użytkownika. Pokonując wewnętrzne opóźnienia i ograniczenia stałej długości tradycyjnych procesów wideo, PixVerse-R1 przekształca generowanie wideo w nieskończony, ciągły i interaktywny strumień wizualny. Stanowi to znaczącą ewolucję w tworzeniu, doświadczaniu i udostępnianiu mediów audiowizualnych, wyznaczając zmianę paradygmatu w kierunku inteligentnych, interaktywnych mediów zdolnych do błyskawicznej adaptacji w oparciu o intencje użytkownika.
1. Wstęp
Krajobraz mediów cyfrowych zasadniczo przesuwa się od statycznych, wstępnie renderowanych treści w stronę dynamicznych, interaktywnych doświadczeń. Konwencjonalne procesy produkcyjne były historycznie ograniczone przez wysokie opóźnienia i klipy o stałej długości, co tworzyło dychotomię między tworzeniem treści a konsumpcją w czasie rzeczywistym.
Aby zaradzić tym ograniczeniom, wprowadzamy nowatorską architekturę modelu świata, która jednoczy natywny multimodalny model bazowy, mechanizm autoregresyjny spójności i silnik natychmiastowej odpowiedzi. To zunifikowane podejście pozwala na wspólne przetwarzanie fragmentów czasoprzestrzennych wraz z danymi tekstowymi i audio, skutecznie demontując tradycyjne bariery w przetwarzaniu mediów. Dzięki wdrożeniu systemu zdolnego do nieskończonego przesyłania strumieniowego za pośrednictwem mechanizmu autoregresyjnego i silnika natychmiastowej odpowiedzi, generowany świat pozostaje fizycznie spójny w długich horyzontach przy niskim obciążeniu obliczeniowym.
Kluczowa funkcja: Wykorzystując tę architekturę, nasz system osiąga przełom w wydajności, generując wideo o wysokiej rozdzielczości do 1080P w czasie rzeczywistym. Ta funkcja zwiększa wierność wizualną i umożliwia tworzenie gier natywnych dla AI oraz kina interaktywnego, w których środowiska i narracje ewoluują dynamicznie w odpowiedzi na interakcję użytkownika. Szerzej pozwala to systemom generatywnym funkcjonować jako trwałe, interaktywne światy, a nie skończone artefakty medialne, wskazując trajektorię w kierunku ciągłych i interaktywnych symulacji audiowizualnych.
2. Architektura techniczna
2.1 Omni: Natywny multimodalny model bazowy
Aby osiągnąć ogólne możliwości, wyszliśmy poza tradycyjne procesy generowania, projektując w pełni kompleksowy (end-to-end) natywny multimodalny model bazowy.
- Zunifikowana reprezentacja: Model Omni jednoczy różne modalności (tekst, obraz, wideo, audio) w ciągły strumień tokenów, co pozwala mu na przyjmowanie dowolnych danych multimodalnych w ramach jednej struktury.
- Trening kompleksowy: Cała architektura jest trenowana na heterogenicznych zadaniach bez interfejsów pośrednich, co zapobiega propagacji błędów i zapewnia solidną skalowalność.
- Natywna rozdzielczość: W ramach tej struktury wykorzystujemy trening w natywnej rozdzielczości, aby uniknąć artefaktów typowo związanych z przycinaniem lub zmianą rozmiaru.
Co więcej, model internalizuje wewnętrzne prawa fizyki i dynamikę świata rzeczywistego, ucząc się na ogromnym korpusie rzeczywistych danych wideo. To fundamentalne zrozumienie pozwala systemowi syntetyzować spójny, responsywny „świat równoległy” w czasie rzeczywistym.
Model Omni skaluje się efektywnie, funkcjonując nie tylko jako silnik generatywny, ale jako pionierski krok w kierunku budowania symulatorów świata fizycznego ogólnego przeznaczenia. Traktując zadanie symulacji jako pojedynczy, kompleksowy paradygmat generowania, ułatwiamy eksplorację długofalowych światów generowanych przez AI w czasie rzeczywistym.
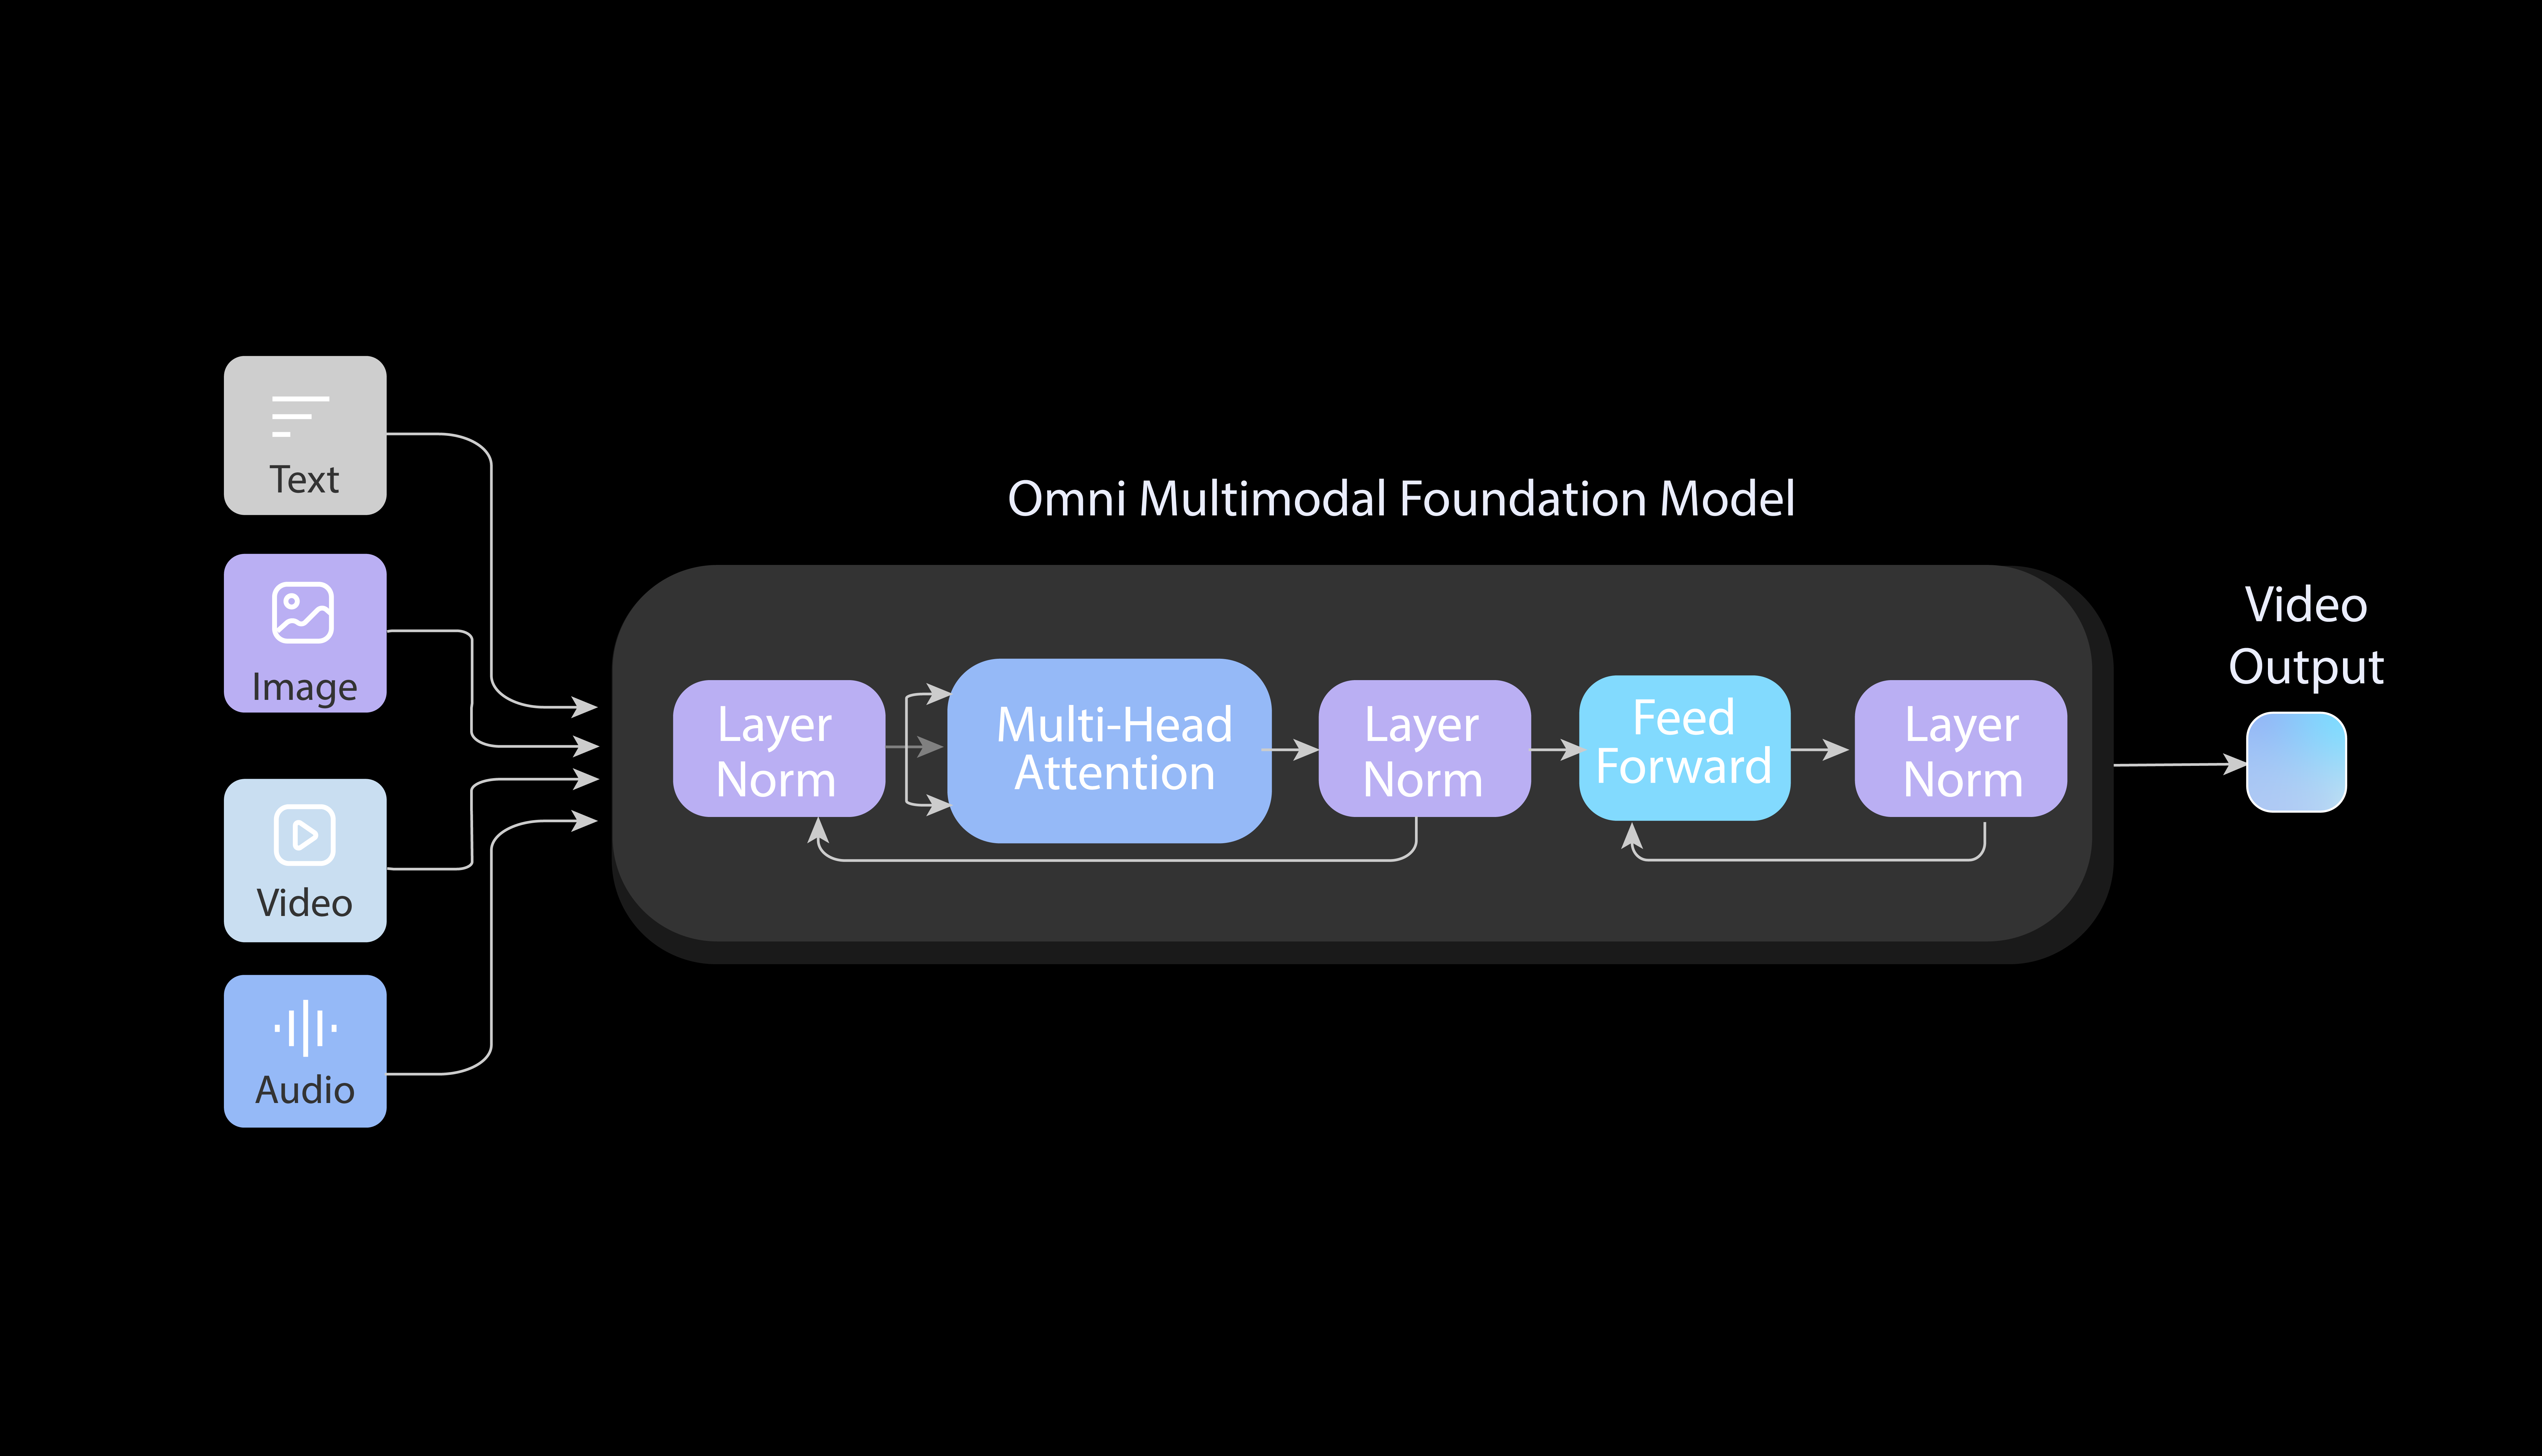
Rysunek 1. Kompleksowa architektura naszego natywnego multimodalnego modelu bazowego Omni; zunifikowany projekt pozwala modelowi Omni na przyjmowanie dowolnych danych multimodalnych i jednoczesne generowanie dźwięku i obrazu.
2.2 Memory: Spójne nieskończone przesyłanie strumieniowe przez mechanizm autoregresyjny
W przeciwieństwie do standardowych metod dyfuzyjnych ograniczonych do skończonych klipów, PixVerse-R1 integruje modelowanie autoregresyjne, aby umożliwić nieskończone, ciągły przesyłanie strumieniowe obrazu, oraz zawiera mechanizm uwagi wspomagany pamięcią, aby zapewnić fizyczną spójność generowanego świata w długich horyzontach.
- Nieskończone przesyłanie strumieniowe: Formułując syntezę wideo jako proces autoregresyjny, model sekwencyjnie przewiduje kolejne klatki, aby osiągnąć ciągły, nieograniczony strumień wizualny.
- Spójność czasowa: Mechanizm uwagi wspomagany pamięcią warunkuje generowanie bieżącej klatki na podstawie ukrytych reprezentacji poprzedniego kontekstu, gwarantując, że świat pozostaje fizycznie spójny w długich horyzontach.
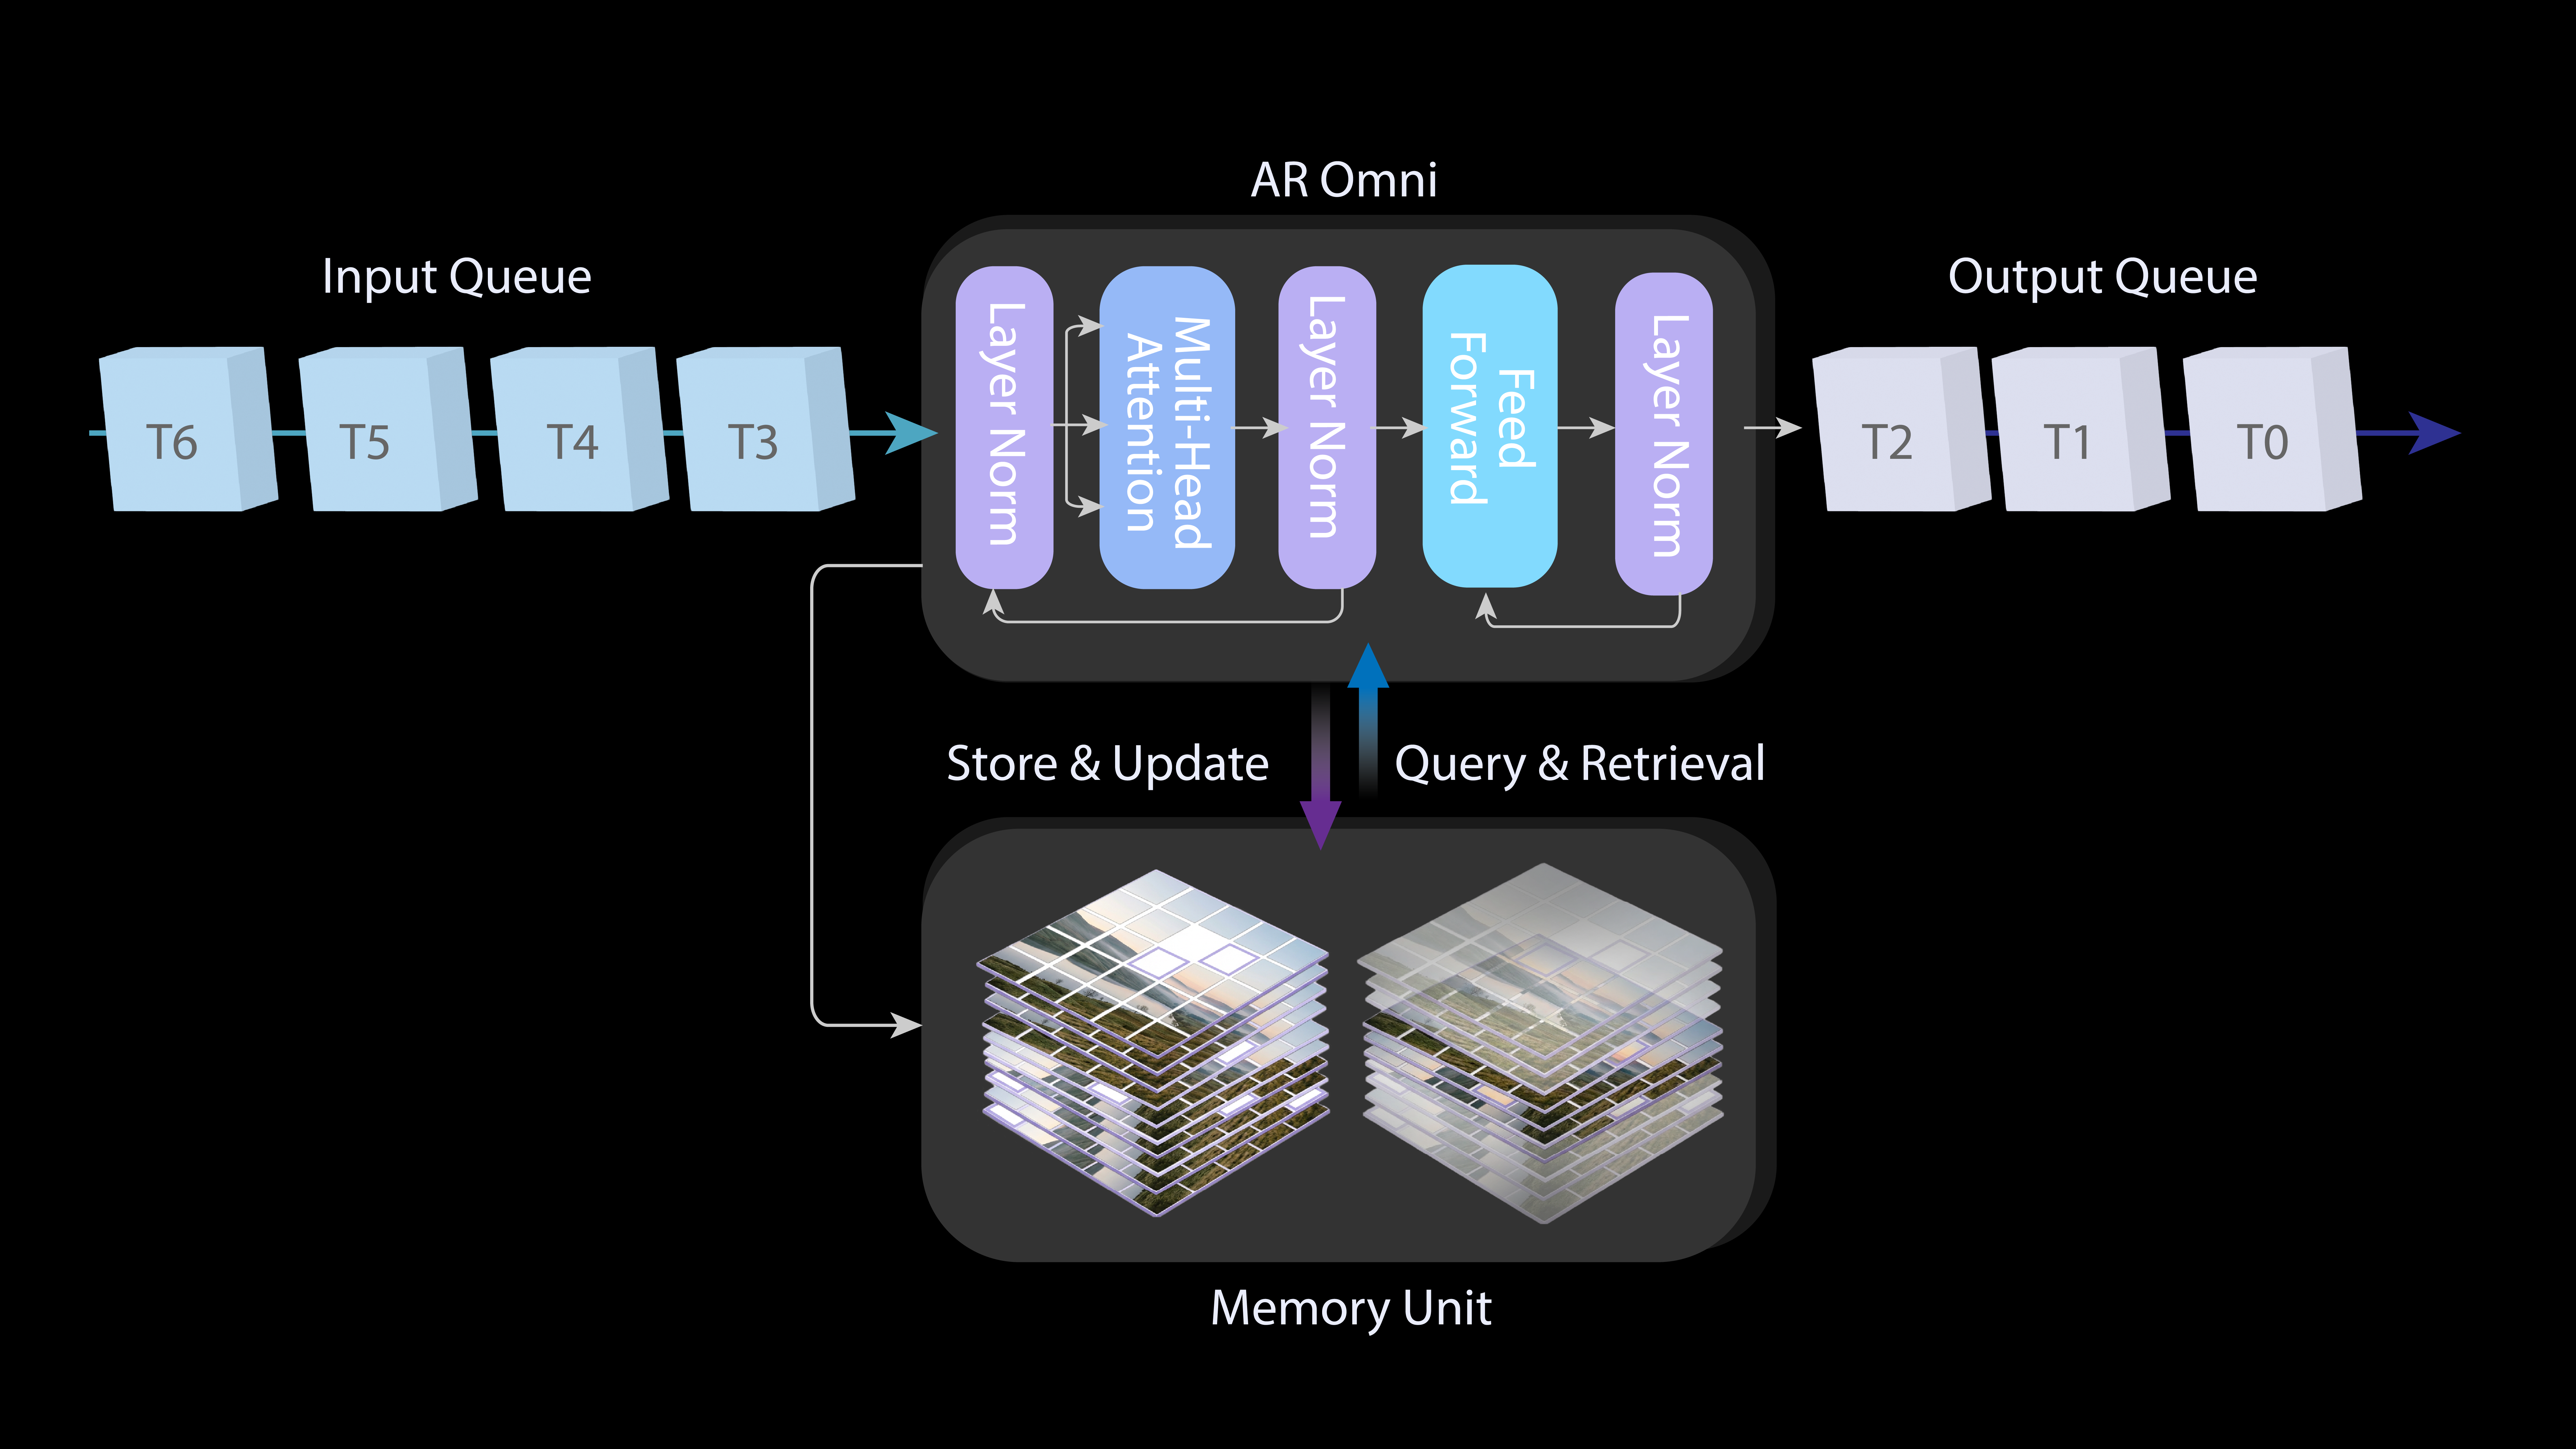
Rysunek 2. Zintegrowane modelowanie autoregresyjne z modelem bazowym Omni.
2.3 1080P w czasie rzeczywistym: Silnik natychmiastowej odpowiedzi
Chociaż iteracyjne odszumianie zazwyczaj zapewnia wysoką jakość, jego gęstość obliczeniowa często utrudnia wydajność w czasie rzeczywistym. Aby to rozwiązać i osiągnąć generowanie w czasie rzeczywistym w wysokich rozdzielczościach (do 1080P), przebudowaliśmy proces w silnik natychmiastowej odpowiedzi (IRE).
IRE optymalizuje proces próbkowania dzięki następującym udoskonaleniom:
- Składanie trajektorii czasowej: Wdrażając Direct Transport Mapping jako priorytet strukturalny, sieć bezpośrednio przewiduje czysty rozkład danych. Skraca to etapy próbkowania z dziesiątek do zaledwie 1–4, tworząc usprawnioną ścieżkę niezbędną dla ultraniskich opóźnień.
- Rektyfikacja wskazówek: Omijamy narzut próbkowania Classifier-Free Guidance poprzez włączenie gradientów warunkowych do modelu ucznia.
- Adaptacyjna rzadka uwaga: Łagodzi to nadmiarowość zależności dalekiego zasięgu, dając skondensowany graf obliczeniowy, który dodatkowo ułatwia realizację generowania 1080P w czasie rzeczywistym.
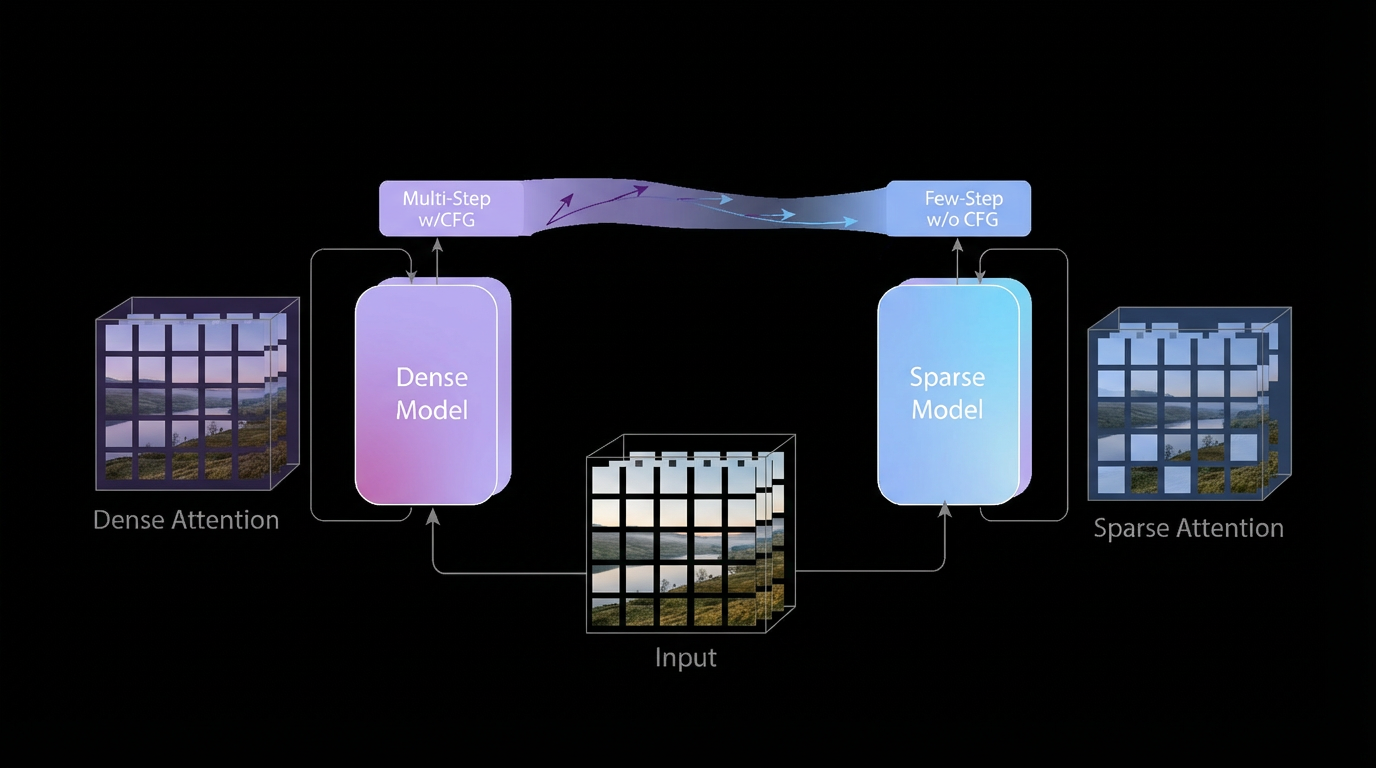
Rysunek 3. Silnik natychmiastowej odpowiedzi składa się z trzech modułów: składania trajektorii czasowej, rektyfikacji wskazówek i adaptacyjnego rzadkiego uczenia się uwagi.
3. Zastosowania i wpływ społeczny
PixVerse-R1 wprowadza nowe medium generatywne: systemy audiowizualne czasu rzeczywistego, ciągłe i stanowe. W przeciwieństwie do wstępnie renderowanego wideo, to medium działa jako trwały proces, który natychmiast reaguje na intencje użytkownika, gdzie generowanie i interakcja są ściśle powiązane. To nowe medium umożliwia tworzenie szerokiej klasy systemów interaktywnych, w tym między innymi:
-
Media interaktywne
- Gry natywne dla AI i interaktywne doświadczenia kinowe
- VR/XR w czasie rzeczywistym i immersyjne symulacje
-
Systemy kreatywne i edukacyjne
- Adaptacyjna sztuka mediów i instalacje interaktywne
- Środowiska uczenia się i szkolenia w czasie rzeczywistym
-
Symulacja i planowanie
- Badania eksperymentalne i eksploracja scenariuszy
- Symulacje przemysłowe, rolnicze i ekologiczne
Poza konkretnymi zastosowaniami PixVerse-R1 funkcjonuje jako ciągły symulator świata audiowizualnego, zmniejszając dystans między intencją ludzką a odpowiedzią systemu i umożliwiając nowe formy współtworzenia ludzi i AI w trwałych środowiskach cyfrowych.
4. Wnioski
PixVerse-R1 wprowadza platformę generatywną czasu rzeczywistego, która pokonuje nieodłączne ograniczenia tradycyjnych procesów wideo dzięki innowacjom architektonicznym w przetwarzaniu multimodalnym i natychmiastowej odpowiedzi. Umożliwiając spójne generowanie w czasie rzeczywistym, model ten stanowi znaczącą ewolucję w tworzeniu i doświadczaniu mediów audiowizualnych. Przejście na opóźnienia w czasie rzeczywistym pozwala na przejście od konsumpcji statycznych treści do interakcji z dynamicznym środowiskiem, zapewniając skalowalne podłoże obliczeniowe dla aplikacji od gier natywnych dla AI po złożone symulacje przemysłowe. Wypełniając lukę między intencją użytkownika a natychmiastową informacją zwrotną wizualną, system wyznacza nową granicę dla interaktywnego modelowania świata i środowisk współpracy człowiek-AI.
5. Ograniczenia
Chociaż PixVerse-R1 oferuje znaczące zalety modelowania, dwa podstawowe ograniczenia utrzymują się w odniesieniu do dokładności czasowej i wierności fizycznej:
- Akumulacja błędów czasowych: W dłuższych sekwencjach drobne błędy przewidywania mogą się kumulować, co może zagrozić integralności strukturalnej symulacji.
- Kompromis między fizyką a obliczeniami: Aby pomyślnie osiągnąć generowanie w czasie rzeczywistym, poczyniono określone poświęcenia w zakresie złożoności generowania. W konsekwencji może wystąpić pewien stopień utraty precyzji renderowania niektórych praw fizyki w porównaniu z modelami działającymi poza czasem rzeczywistym.