PixVerse-R1: Modelo de mundo en tiempo real de próxima generación
PixVerse-R1: Modelo de mundo en tiempo real de próxima generación
Resumen
Presentamos PixVerse-R1, un modelo de mundo en tiempo real de próxima generación diseñado sobre un modelo base multimodal nativo. Este sistema permite la generación de video en tiempo real donde el contenido visual responde de forma instantánea y fluida a la entrada del usuario. Al superar la latencia intrínseca y las limitaciones de longitud fija de los flujos de trabajo de video tradicionales, PixVerse-R1 transforma la generación de video en un flujo visual infinito, continuo e interactivo. Esto representa una evolución significativa en la creación, experiencia y uso compartido de medios audiovisuales, marcando un cambio de paradigma hacia medios inteligentes e interactivos capaces de una adaptación instantánea basada en la intención del usuario.
1. Introducción
El panorama de los medios digitales está cambiando fundamentalmente de contenido estático y pre-renderizado hacia experiencias dinámicas e interactivas. Los procesos de producción convencionales han estado históricamente limitados por una alta latencia y clips de longitud fija, creando una dicotomía entre la creación de contenido y el consumo en tiempo real.
Para abordar estas limitaciones, presentamos una arquitectura de modelo de mundo novedosa que unifica un modelo base multimodal nativo, un mecanismo autorregresivo de consistencia y un motor de respuesta instantánea. Este enfoque unificado permite el procesamiento conjunto de parches espaciotemporales junto con datos de texto y audio, desmantelando eficazmente los silos tradicionales del procesamiento de medios. Al desplegar un sistema capaz de transmisión infinita a través de un mecanismo autorregresivo y un motor de respuesta instantánea, el mundo generado permanece físicamente consistente en horizontes largos con una baja sobrecarga computacional.
Capacidad clave: Aprovechando esta arquitectura, nuestro sistema logra un avance en el rendimiento, generando video de alta resolución de hasta 1080P en tiempo real. Esta capacidad mejora la fidelidad visual y permite juegos nativos de IA y cine interactivo, donde los entornos y las narrativas evolucionan dinámicamente en respuesta a la interacción del usuario. En términos generales, esto permite que los sistemas generativos funcionen como mundos persistentes e interactivos en lugar de artefactos de medios finitos, lo que indica una trayectoria hacia simulaciones audiovisuales continuas, con estado e interactivas.
2. Arquitectura Técnica
2.1 Omni: Modelo Base Multimodal Nativo
Para lograr capacidades generales, trascendimos los procesos de generación tradicionales diseñando un modelo base multimodal nativo totalmente de extremo a extremo.
- Representación unificada: El modelo Omni unifica diversas modalidades (texto, imagen, video, audio) en un flujo continuo de tokens, lo que le permite aceptar entradas multimodales arbitrarias dentro de un solo marco.
- Entrenamiento de extremo a extremo: Toda la arquitectura se entrena en tareas heterogéneas sin interfaces intermedias, lo que evita la propagación de errores y garantiza una escalabilidad robusta.
- Resolución nativa: Utilizamos el entrenamiento con resolución nativa dentro de este marco para evitar artefactos típicamente asociados con el recorte o el cambio de tamaño.
Además, el modelo interioriza las leyes físicas y la dinámica intrínsecas del mundo real al aprender de un corpus masivo de datos de video del mundo real. Esta comprensión fundamental permite al sistema sintetizar un “mundo paralelo” consistente y receptivo en tiempo real.
El modelo Omni escala de manera efectiva, funcionando no solo como un motor generativo, sino como un paso pionero hacia la construcción de simuladores de propósito general del mundo físico. Al tratar la tarea de simulación como un paradigma de generación único de extremo a extremo, facilitamos la exploración de mundos generados por IA en tiempo real y a largo plazo.
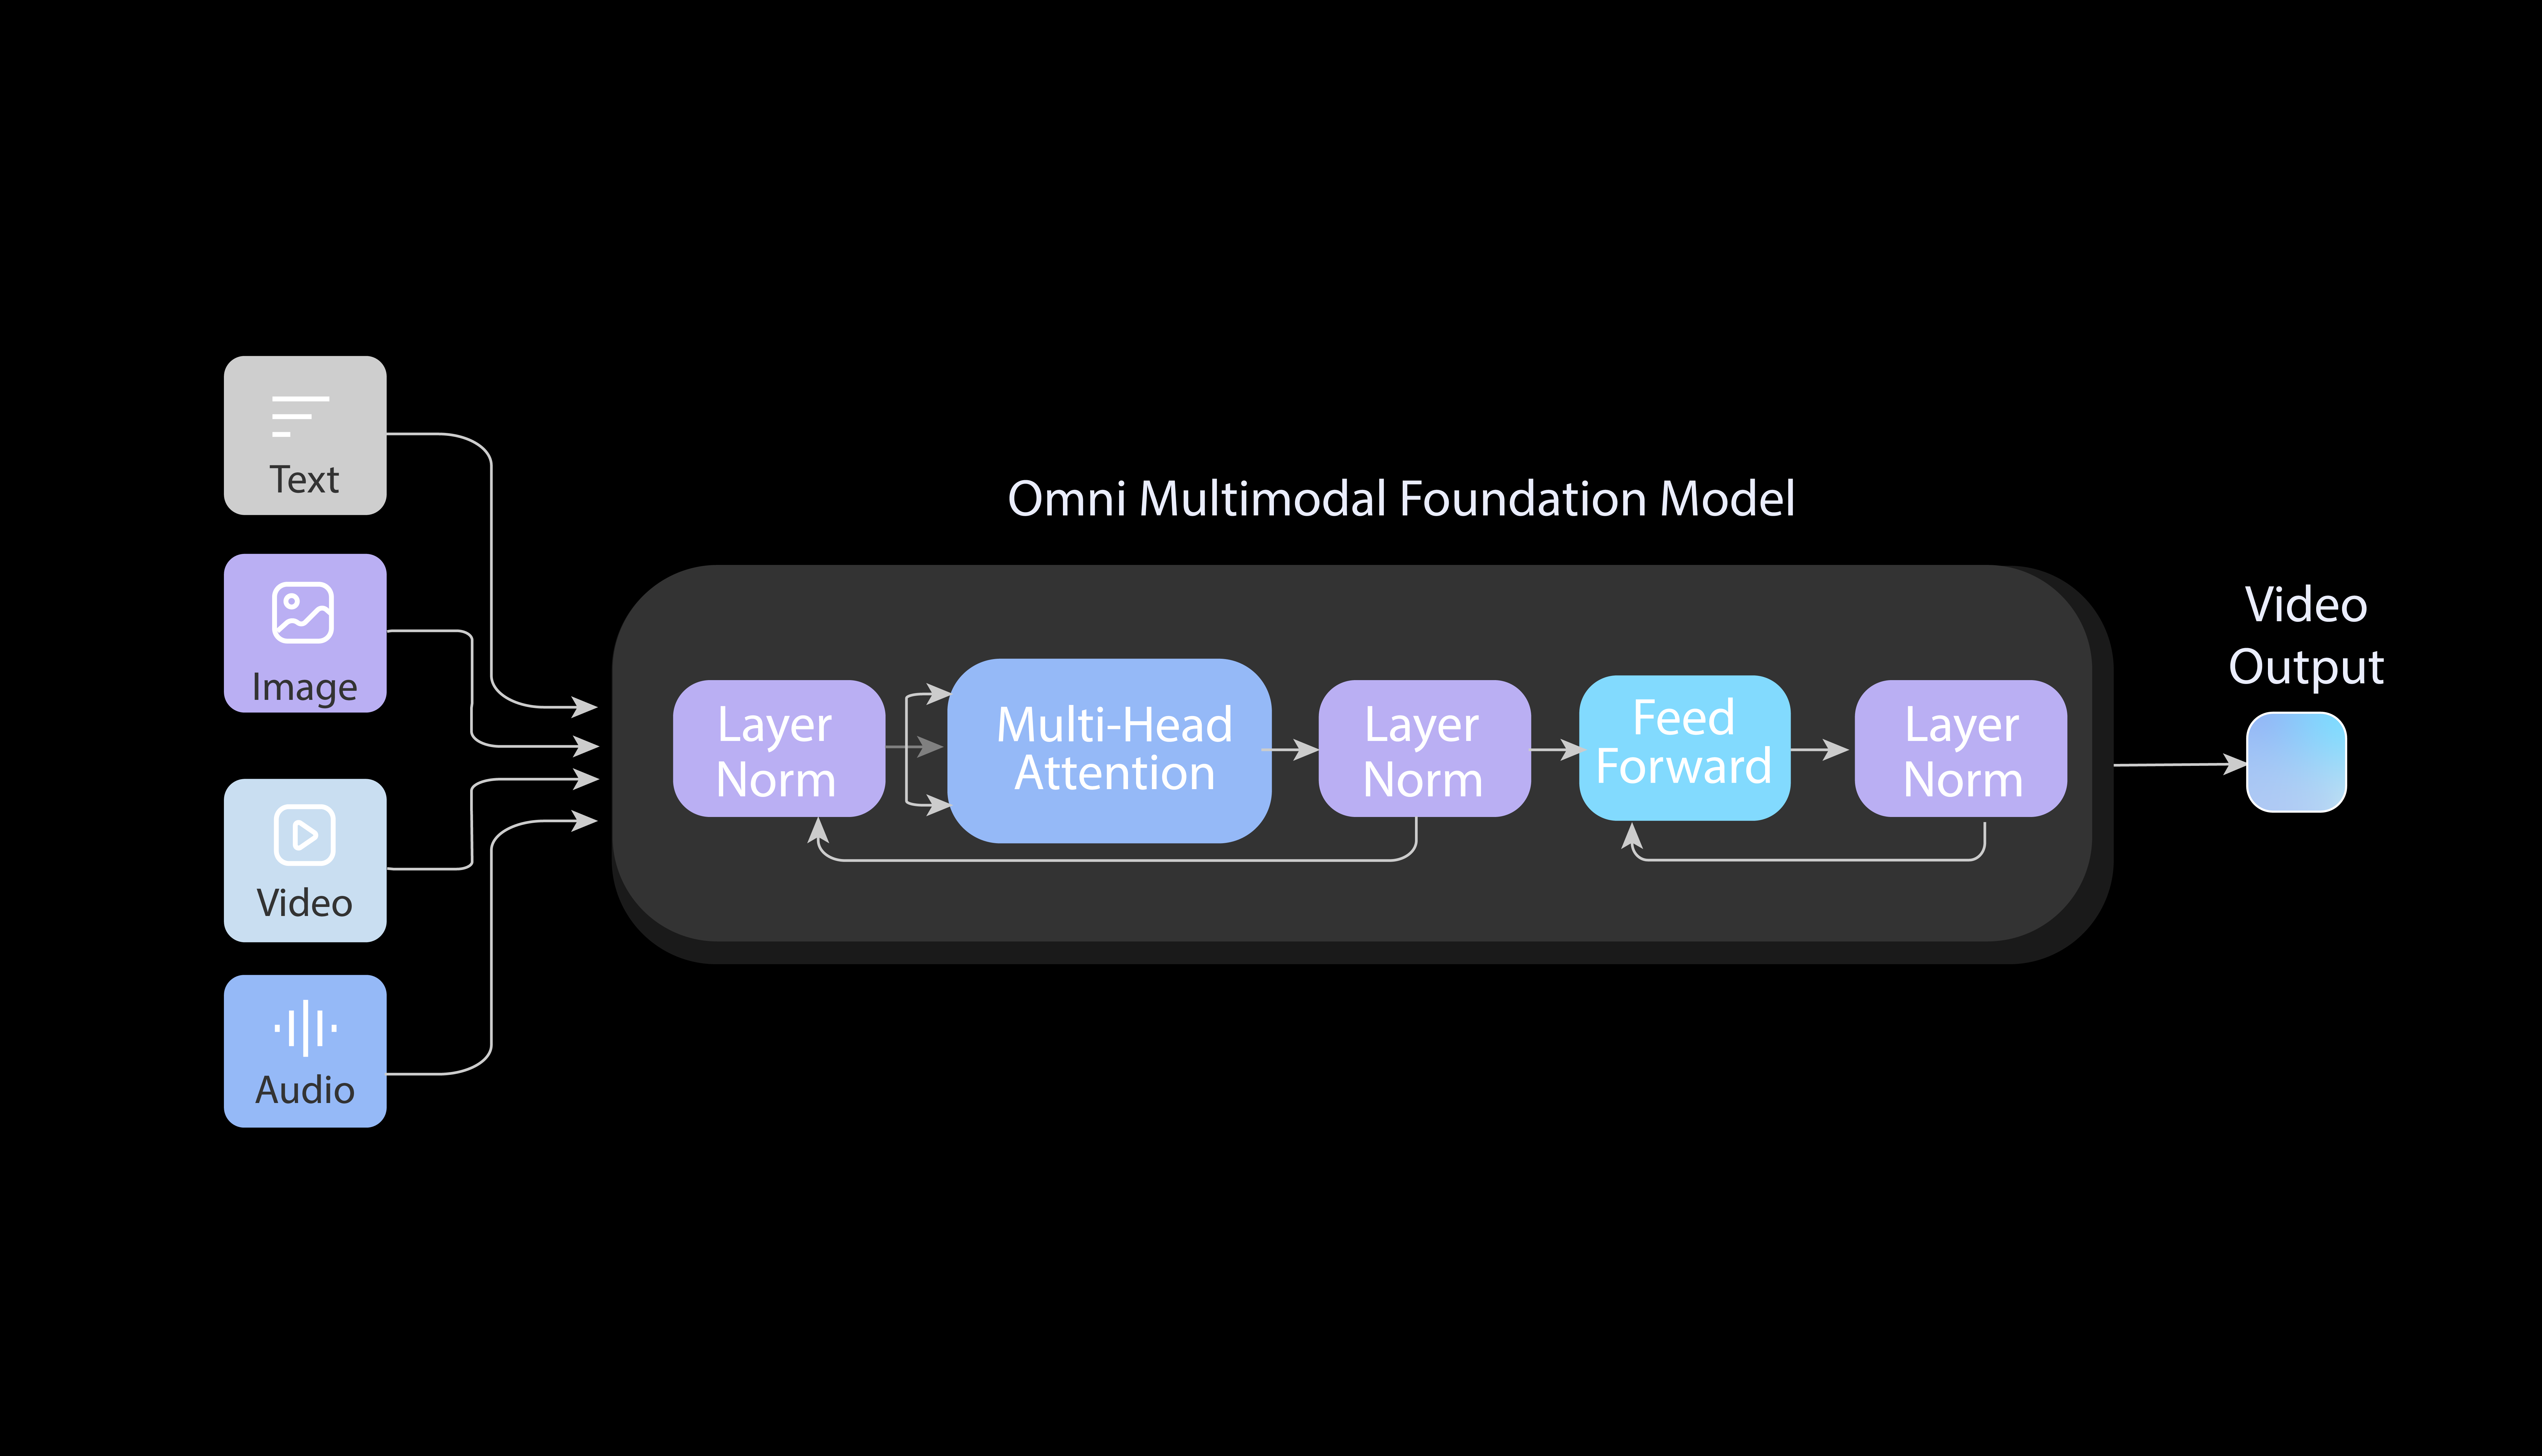
Figura 1. La arquitectura de extremo a extremo de nuestro modelo base multimodal nativo Omni; el diseño unificado permite que nuestro modelo Omni acepte entradas multimodales arbitrarias y genere audio y video al mismo tiempo.
2.2 Memory: Transmisión infinita consistente mediante mecanismo autorregresivo
A diferencia de los métodos de difusión estándar restringidos a clips finitos, PixVerse-R1 integra el modelado autorregresivo para permitir una transmisión visual infinita y continua, e incorpora un mecanismo de atención aumentado por memoria para garantizar que el mundo generado permanezca físicamente consistente en horizontes largos.
- Transmisión infinita: Al formular la síntesis de video como un proceso autorregresivo, el modelo predice secuencialmente los fotogramas posteriores para lograr una transmisión visual continua y sin límites.
- Consistencia temporal: Un mecanismo de atención aumentado por memoria condiciona la generación del fotograma actual a las representaciones latentes del contexto precedente, asegurando que el mundo permanezca físicamente consistente en horizontes largos.
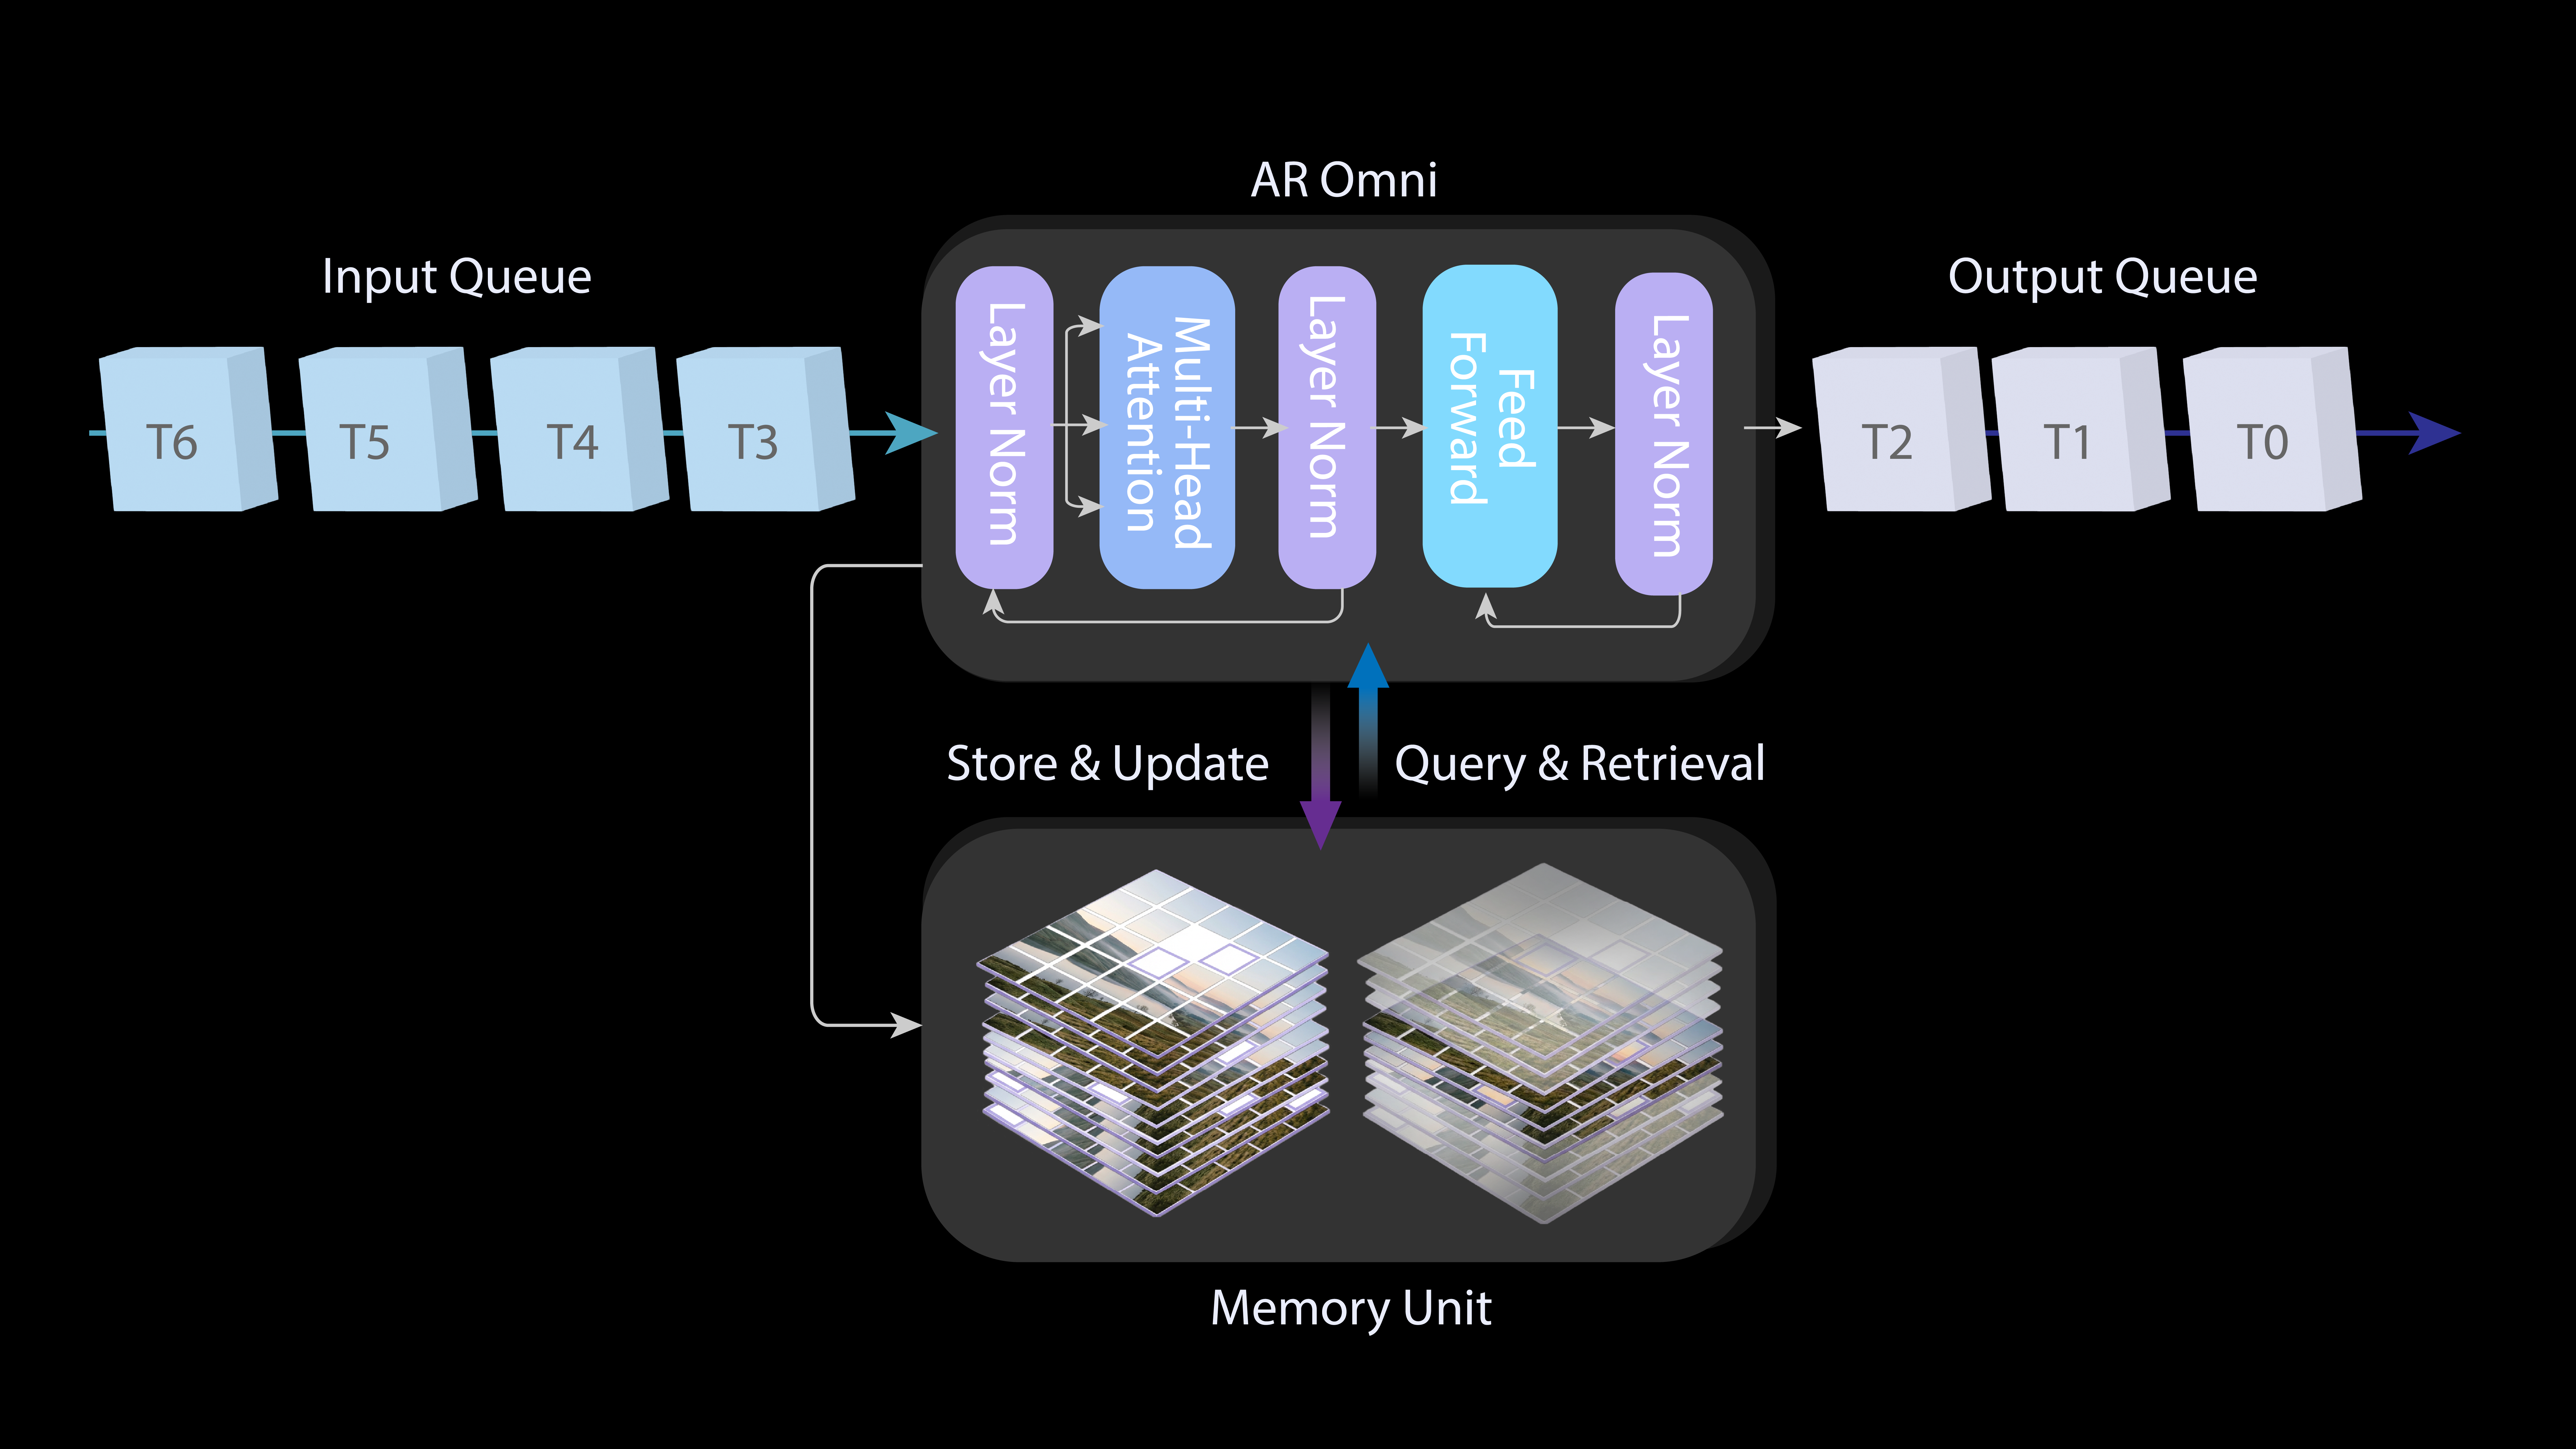
Figura 2. El modelado autorregresivo integrado con el modelo base Omni.
2.3 1080P en tiempo real: Motor de respuesta instantánea
Si bien la eliminación de ruido iterativa suele garantizar una alta calidad, su densidad computacional a menudo impide el rendimiento en tiempo real. Para resolver esto y lograr la generación en tiempo real a altas resoluciones (hasta 1080P), rediseñamos el proceso en un motor de respuesta instantánea (IRE).
El IRE optimiza el proceso de muestreo a través de los siguientes avances:
- Plegado de trayectoria temporal: Al implementar el mapeo de transporte directo como una prioridad estructural, la red predice la distribución de datos limpios directamente. Esto reduce los pasos de muestreo de docenas a solo 1 a 4, creando una vía simplificada esencial para una latencia ultra baja.
- Rectificación de guía: Omitimos la sobrecarga de muestreo de la guía sin clasificador (Classifier-Free Guidance) al fusionar gradientes condicionales en el modelo de estudiante.
- Atención dispersa adaptable: Esto mitiga la redundancia de la dependencia de largo alcance, produciendo un gráfico computacional condensado que facilita aún más la realización de la generación 1080P en tiempo real.
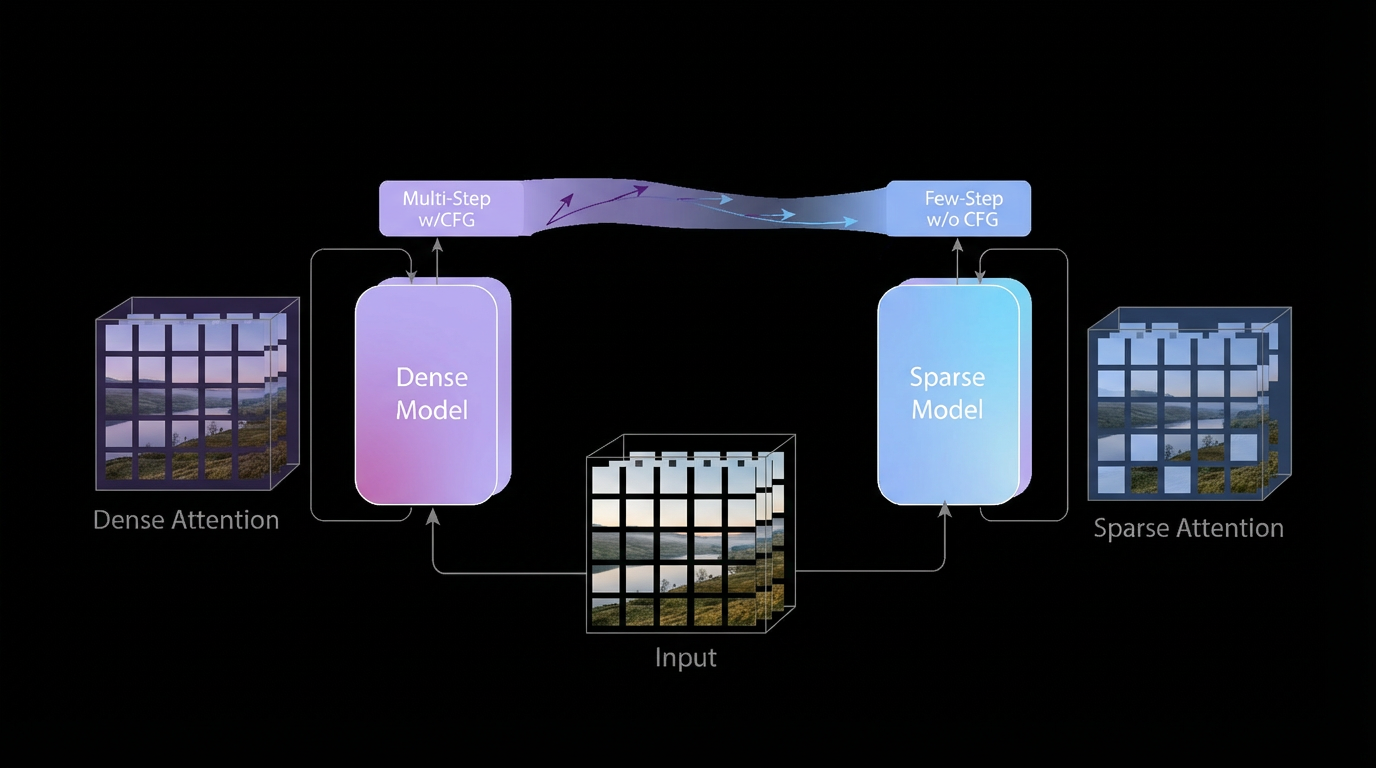
Figura 3. El motor de respuesta instantánea consta de tres módulos: plegado de trayectoria temporal, rectificación de guía y aprendizaje de atención dispersa adaptable.
3. Aplicaciones e impacto social
PixVerse-R1 introduce un nuevo medio generativo: sistemas audiovisuales en tiempo real, continuos y con estado. A diferencia del video pre-renderizado, este medio funciona como un proceso persistente que responde instantáneamente a la intención del usuario, donde la generación y la interacción están estrechamente vinculadas. Este nuevo medio habilita una amplia clase de sistemas interactivos, que incluyen pero no se limitan a:
-
Medios interactivos
- Juegos nativos de IA y experiencias cinematográficas interactivas
- VR/XR en tiempo real y simulaciones inmersivas
-
Sistemas creativos y educativos
- Arte mediático adaptable e instalaciones interactivas
- Entornos de aprendizaje y formación en tiempo real
-
Simulación y planificación
- Investigación experimental y exploración de escenarios
- Simulaciones industriales, agrícolas y ecológicas
Más allá de las aplicaciones específicas, PixVerse-R1 funciona como un simulador continuo de mundos audiovisuales, reduciendo la distancia entre la intención humana y la respuesta del sistema, y permitiendo nuevas formas de cocreación humano-IA dentro de entornos digitales persistentes.
4. Conclusión
PixVerse-R1 presenta un marco generativo en tiempo real que supera las limitaciones inherentes de los flujos de trabajo de video tradicionales mediante innovaciones arquitectónicas en el procesamiento multimodal y la respuesta instantánea. Al permitir una generación consistente en tiempo real, este modelo marca una evolución significativa en la creación y experiencia de medios audiovisuales. El cambio hacia la latencia en tiempo real permite una transición del consumo de contenido estático a la interacción con el entorno dinámico, proporcionando un sustrato computacional escalable para aplicaciones que van desde juegos nativos de IA hasta simulaciones industriales complejas. Al cerrar la brecha entre la intención del usuario y la retroalimentación visual instantánea, le sistema establece una nueva frontera para el modelado de mundos interactivos y los entornos de colaboración humano-IA.
5. Limitaciones
Si bien PixVerse-R1 ofrece ventajas de modelado significativas, persisten dos limitaciones principales con respecto a la precisión temporal y la fidelidad física:
- Acumulación de errores temporales: En secuencias extendidas, los errores menores de predicción pueden acumularse, comprometiendo potencialmente la integridad estructural de la simulación.
- Compromiso entre física y computación: Para lograr con éxito la generación en tiempo real, se hicieron sacrificios específicos con respecto a la complejidad de la generación. En consecuencia, puede haber cierto grado de pérdida en la representación precisa de algunas leyes físicas en comparación con los modelos que no son en tiempo real.