PixVerse-R1: 차세대 실시간 월드 모델
PixVerse-R1: 차세대 실시간 월드 모델
요약
네이티브 멀티모달 파운데이션 모델을 기반으로 설계된 차세대 실시간 월드 모델인 PixVerse-R1을 소개합니다. 이 시스템은 시각적 콘텐츠가 사용자 입력에 즉각적이고 유동적으로 반응하는 실시간 비디오 생성을 가능하게 합니다. 기존 비디오 워크플로우의 고유한 지연 시간과 고정 길이 제약을 극복함으로써, PixVerse-R1은 비디오 생성을 무한하고 연속적이며 상호작용 가능한 시각적 스트림으로 변화시킵니다. 이는 시청각 미디어의 생성, 경험 및 공유에 있어 중요한 진화를 나타내며, 사용자 의도에 따라 즉각적인 적응이 가능한 지능형 상호작용 미디어로의 패러다임 전환을 의미합니다.
1. 서론
디지털 미디어 환경은 정적이고 사전 렌더링된 콘텐츠에서 동적이고 상호작용적인 경험으로 근본적으로 변화하고 있습니다. 전통적인 제작 파이프라인은 역사적으로 높은 지연 시간과 고정된 길이의 클립에 제약을 받아왔으며, 이는 콘텐츠 제작과 실시간 소비 사이의 이분법을 만들어냈습니다.
이러한 한계를 해결하기 위해, 네이티브 멀티모달 파운데이션 모델, 일관성 자기회귀 메커니즘, 그리고 즉각적 응답 엔진을 통합한 새로운 월드 모델 아키텍처를 도입합니다. 이 통합된 접근 방식은 텍스트 및 오디오 데이터와 함께 시공간 패치를 공동으로 처리할 수 있게 하여 기존 미디어 처리의 사일로(silos)를 효과적으로 해체합니다. 자기회귀 메커니즘과 즉각적 응답 엔진을 통해 무한 스트리밍이 가능한 시스템을 구축함으로써, 생성된 세계는 낮은 계산 비용으로 오랜 시간 동안 물리적 일관성을 유지합니다.
핵심 역량: 이 아키텍처를 활용하여 우리 시스템은 성능의 획기적인 발전을 이루었으며, 실시간으로 최대 1080P의 고해상도 비디오를 생성합니다. 이 능력은 시각적 충실도를 높이고 AI 네이티브 게임 및 인터랙티브 시네마를 가능하게 하며, 여기서 환경과 서사는 사용자 상호작용에 따라 동적으로 진화합니다. 광범위하게 말하면, 이는 생성 시스템이 유한한 미디어 결과물이 아닌 지속적이고 상호작용적인 세계로 기능하게 하여, 연속적이고 상태가 유지되며 상호작용적인 시청각 시뮬레이션으로의 궤적을 제시합니다.
2. 기술 아키텍처
2.1 Omni: 네이티브 멀티모달 파운데이션 모델
일반적인 능력을 달성하기 위해, 우리는 완전히 엔드 투 엔드(end-to-end)인 네이티브 멀티모달 파운데이션 모델을 설계함으로써 전통적인 생성 파이프라인을 초월했습니다.
- 통합된 표현: Omni 모델은 다양한 모달리티(텍스트, 이미지, 비디오, 오디오)를 연속적인 토큰 스트림으로 통합하여 단일 프레임워크 내에서 임의의 멀티모달 입력을 수용할 수 있도록 합니다.
- 엔드 투 엔드 학습: 전체 아키텍처는 중간 인터페이스 없이 이종 작업 전반에 걸쳐 학습되어 오류 전파를 방지하고 강력한 확장성을 보장합니다.
- 네이티브 해상도: 크롭(cropping)이나 리사이징(resizing)과 관련된 아티팩트를 피하기 위해 이 프레임워크 내에서 네이티브 해상도 학습을 활용합니다.
또한, 모델은 대규모 실제 세계 비디오 데이터 코퍼스로부터 학습함으로써 실제 세계의 고유한 물리 법칙과 역학을 내면화합니다. 이러한 기초적인 이해는 시스템이 실시간으로 일관되고 반응적인 “평행 세계”를 합성할 수 있게 합니다.
Omni 모델은 효과적으로 확장되어 단순한 생성 엔진이 아니라 물리 세계의 범용 시뮬레이터를 구축하기 위한 선구적인 단계로 기능합니다. 시뮬레이션 작업을 단일 엔드 투 엔드 생성 패러다임으로 취급함으로써, 실시간 장기 AI 생성 세계의 탐색을 촉진합니다.
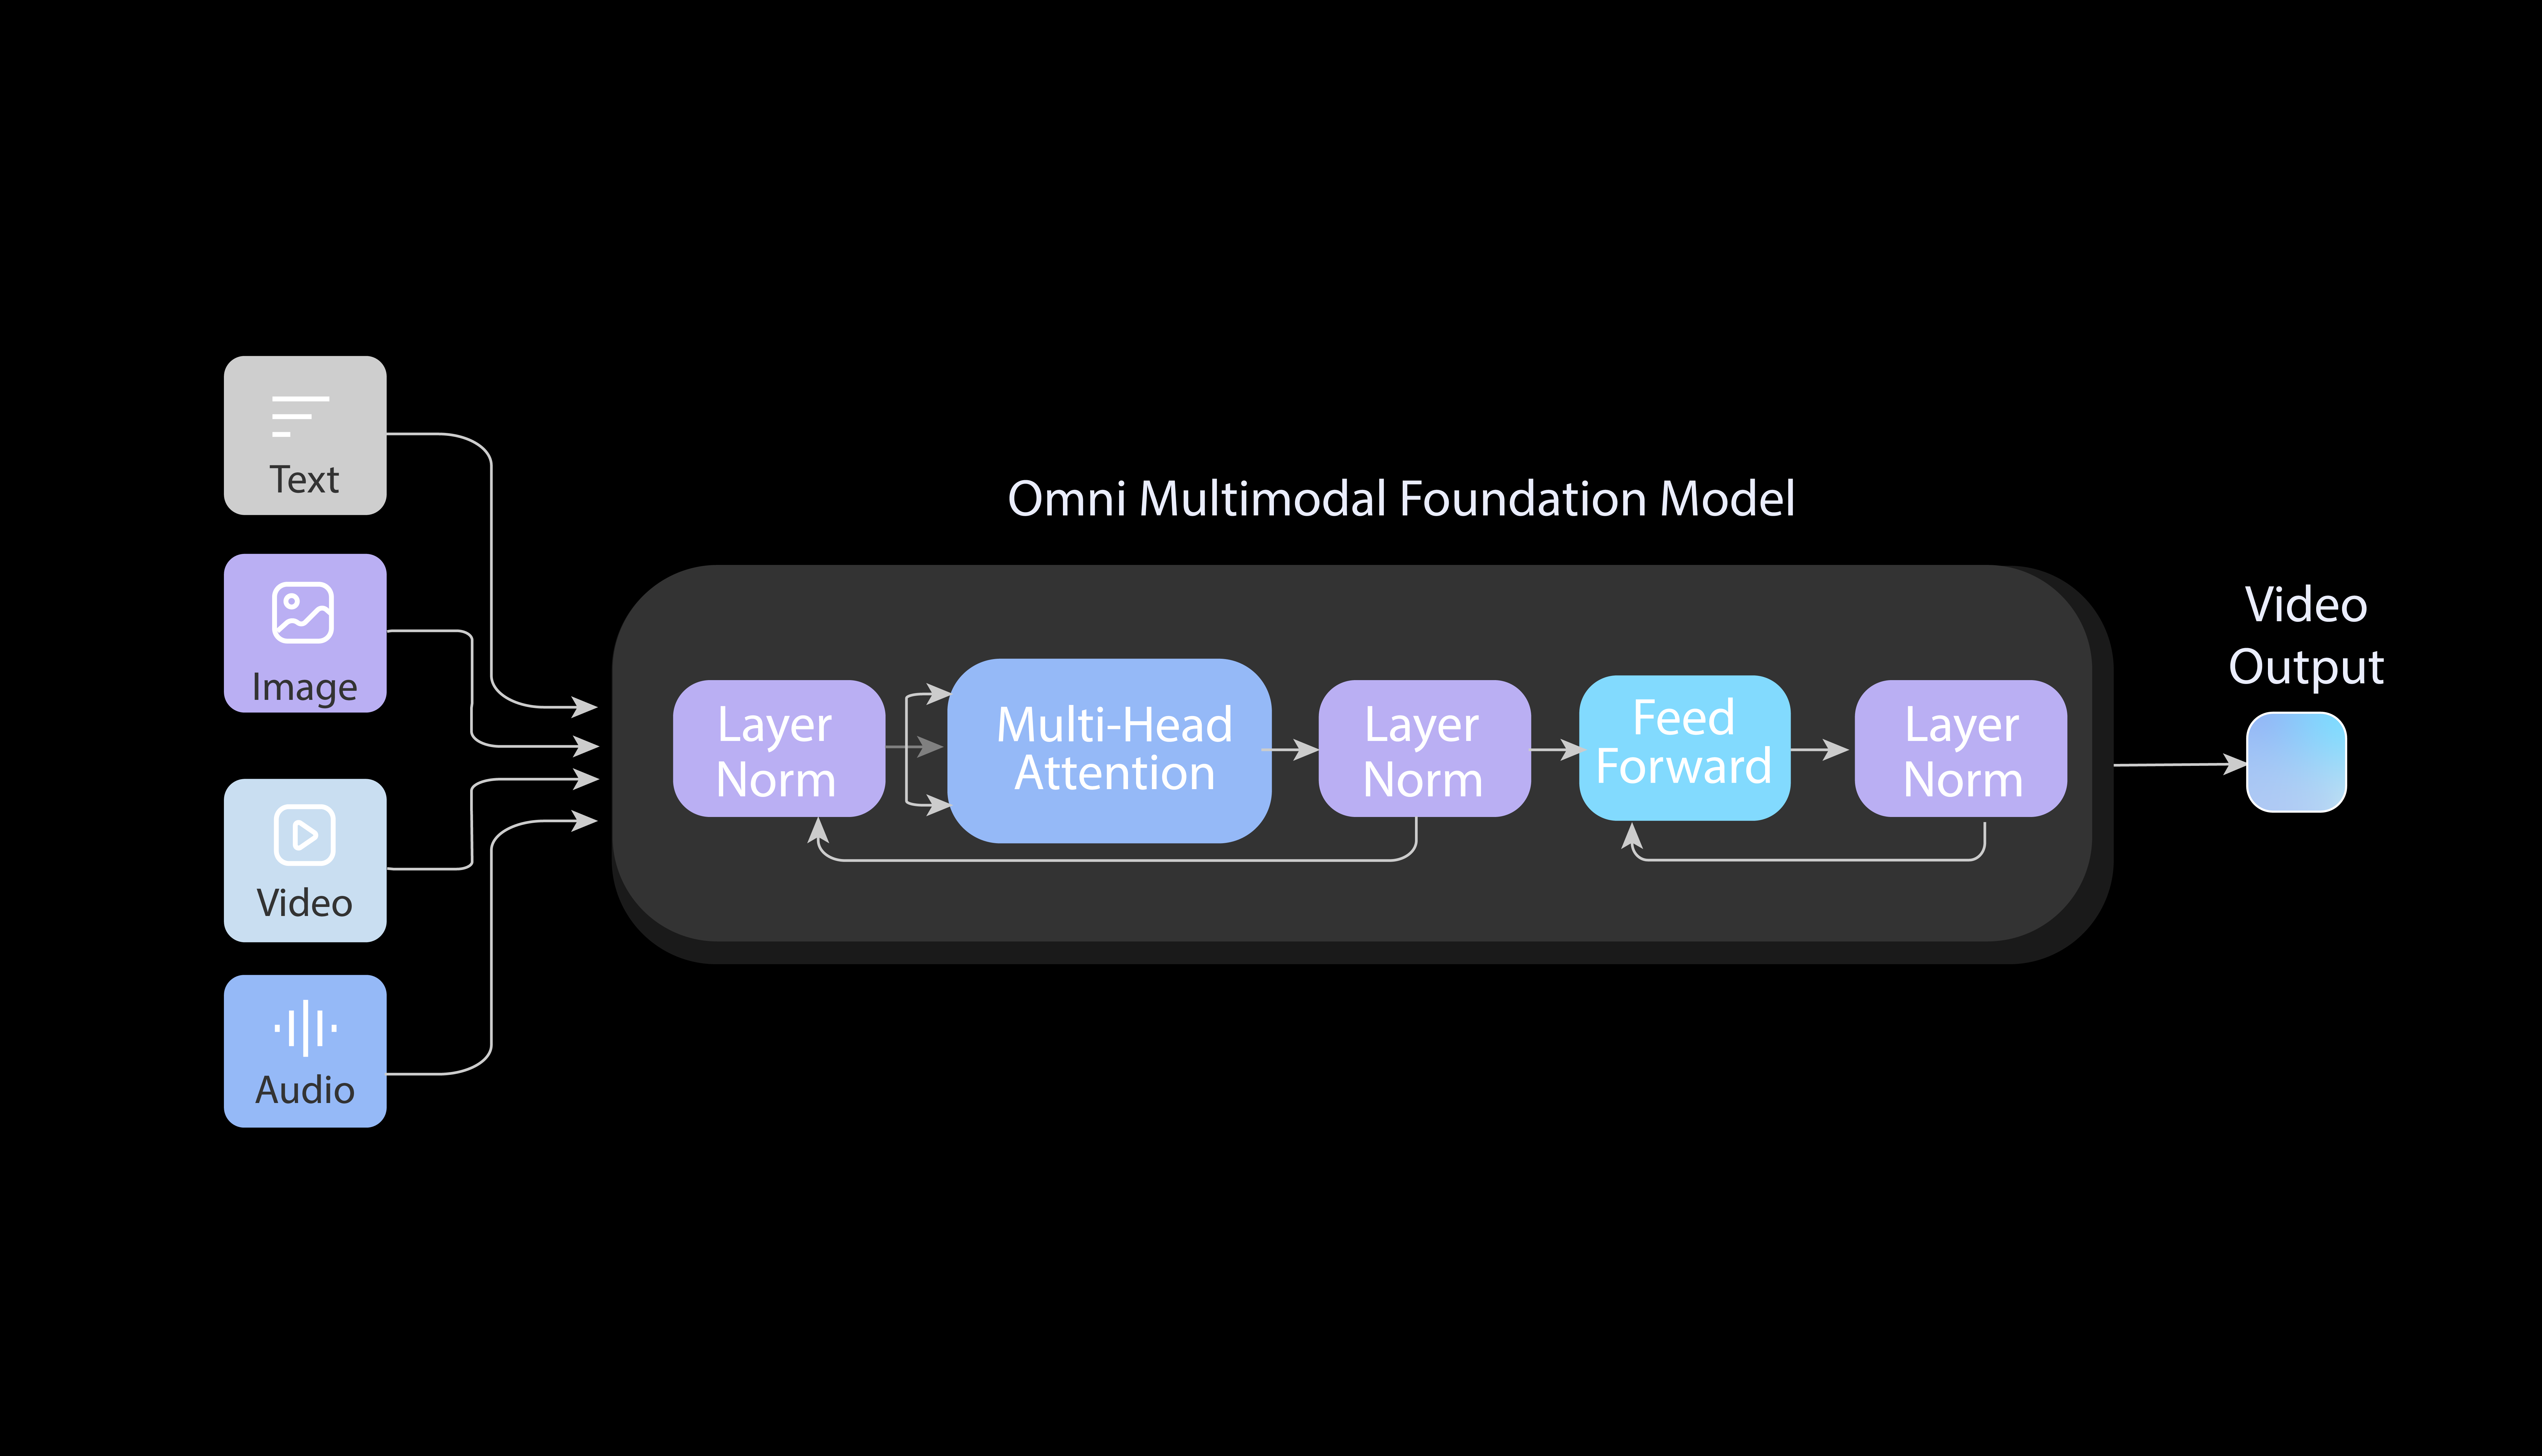
그림 1. Omni 네이티브 멀티모달 파운데이션 모델의 엔드 투 엔드 아키텍처. 통합된 설계 덕분에 Omni 모델은 임의의 멀티모달 입력을 수용하고 오디오와 비디오를 동시에 생성할 수 있습니다.
2.2 Memory: 자기회귀 메커니즘을 통한 일관된 무한 스트리밍
유한한 클립으로 제한되는 표준 확산 방식과 달리, PixVerse-R1은 자기회귀 모델링을 통합하여 무한하고 연속적인 시각적 스트리밍을 가능하게 하고, 메모리 증강 어텐션(memory-augmented attention) 메커니즘을 통합하여 생성된 세계가 오랜 시간 동안 물리적 일관성을 유지하도록 합니다.
- 무한 스트리밍: 비디오 합성을 자기회귀 프로세스로 공식화함으로써, 모델은 후속 프레임을 순차적으로 예측하여 연속적이고 무한한 시각적 스트리밍을 달성합니다.
- 시간적 일관성: 메모리 증강 어텐션 메커니즘은 이전 맥락의 잠재 표현을 기반으로 현재 프레임의 생성을 조건화하여 세계가 오랜 시간 동안 물리적으로 일관되게 유지되도록 합니다.
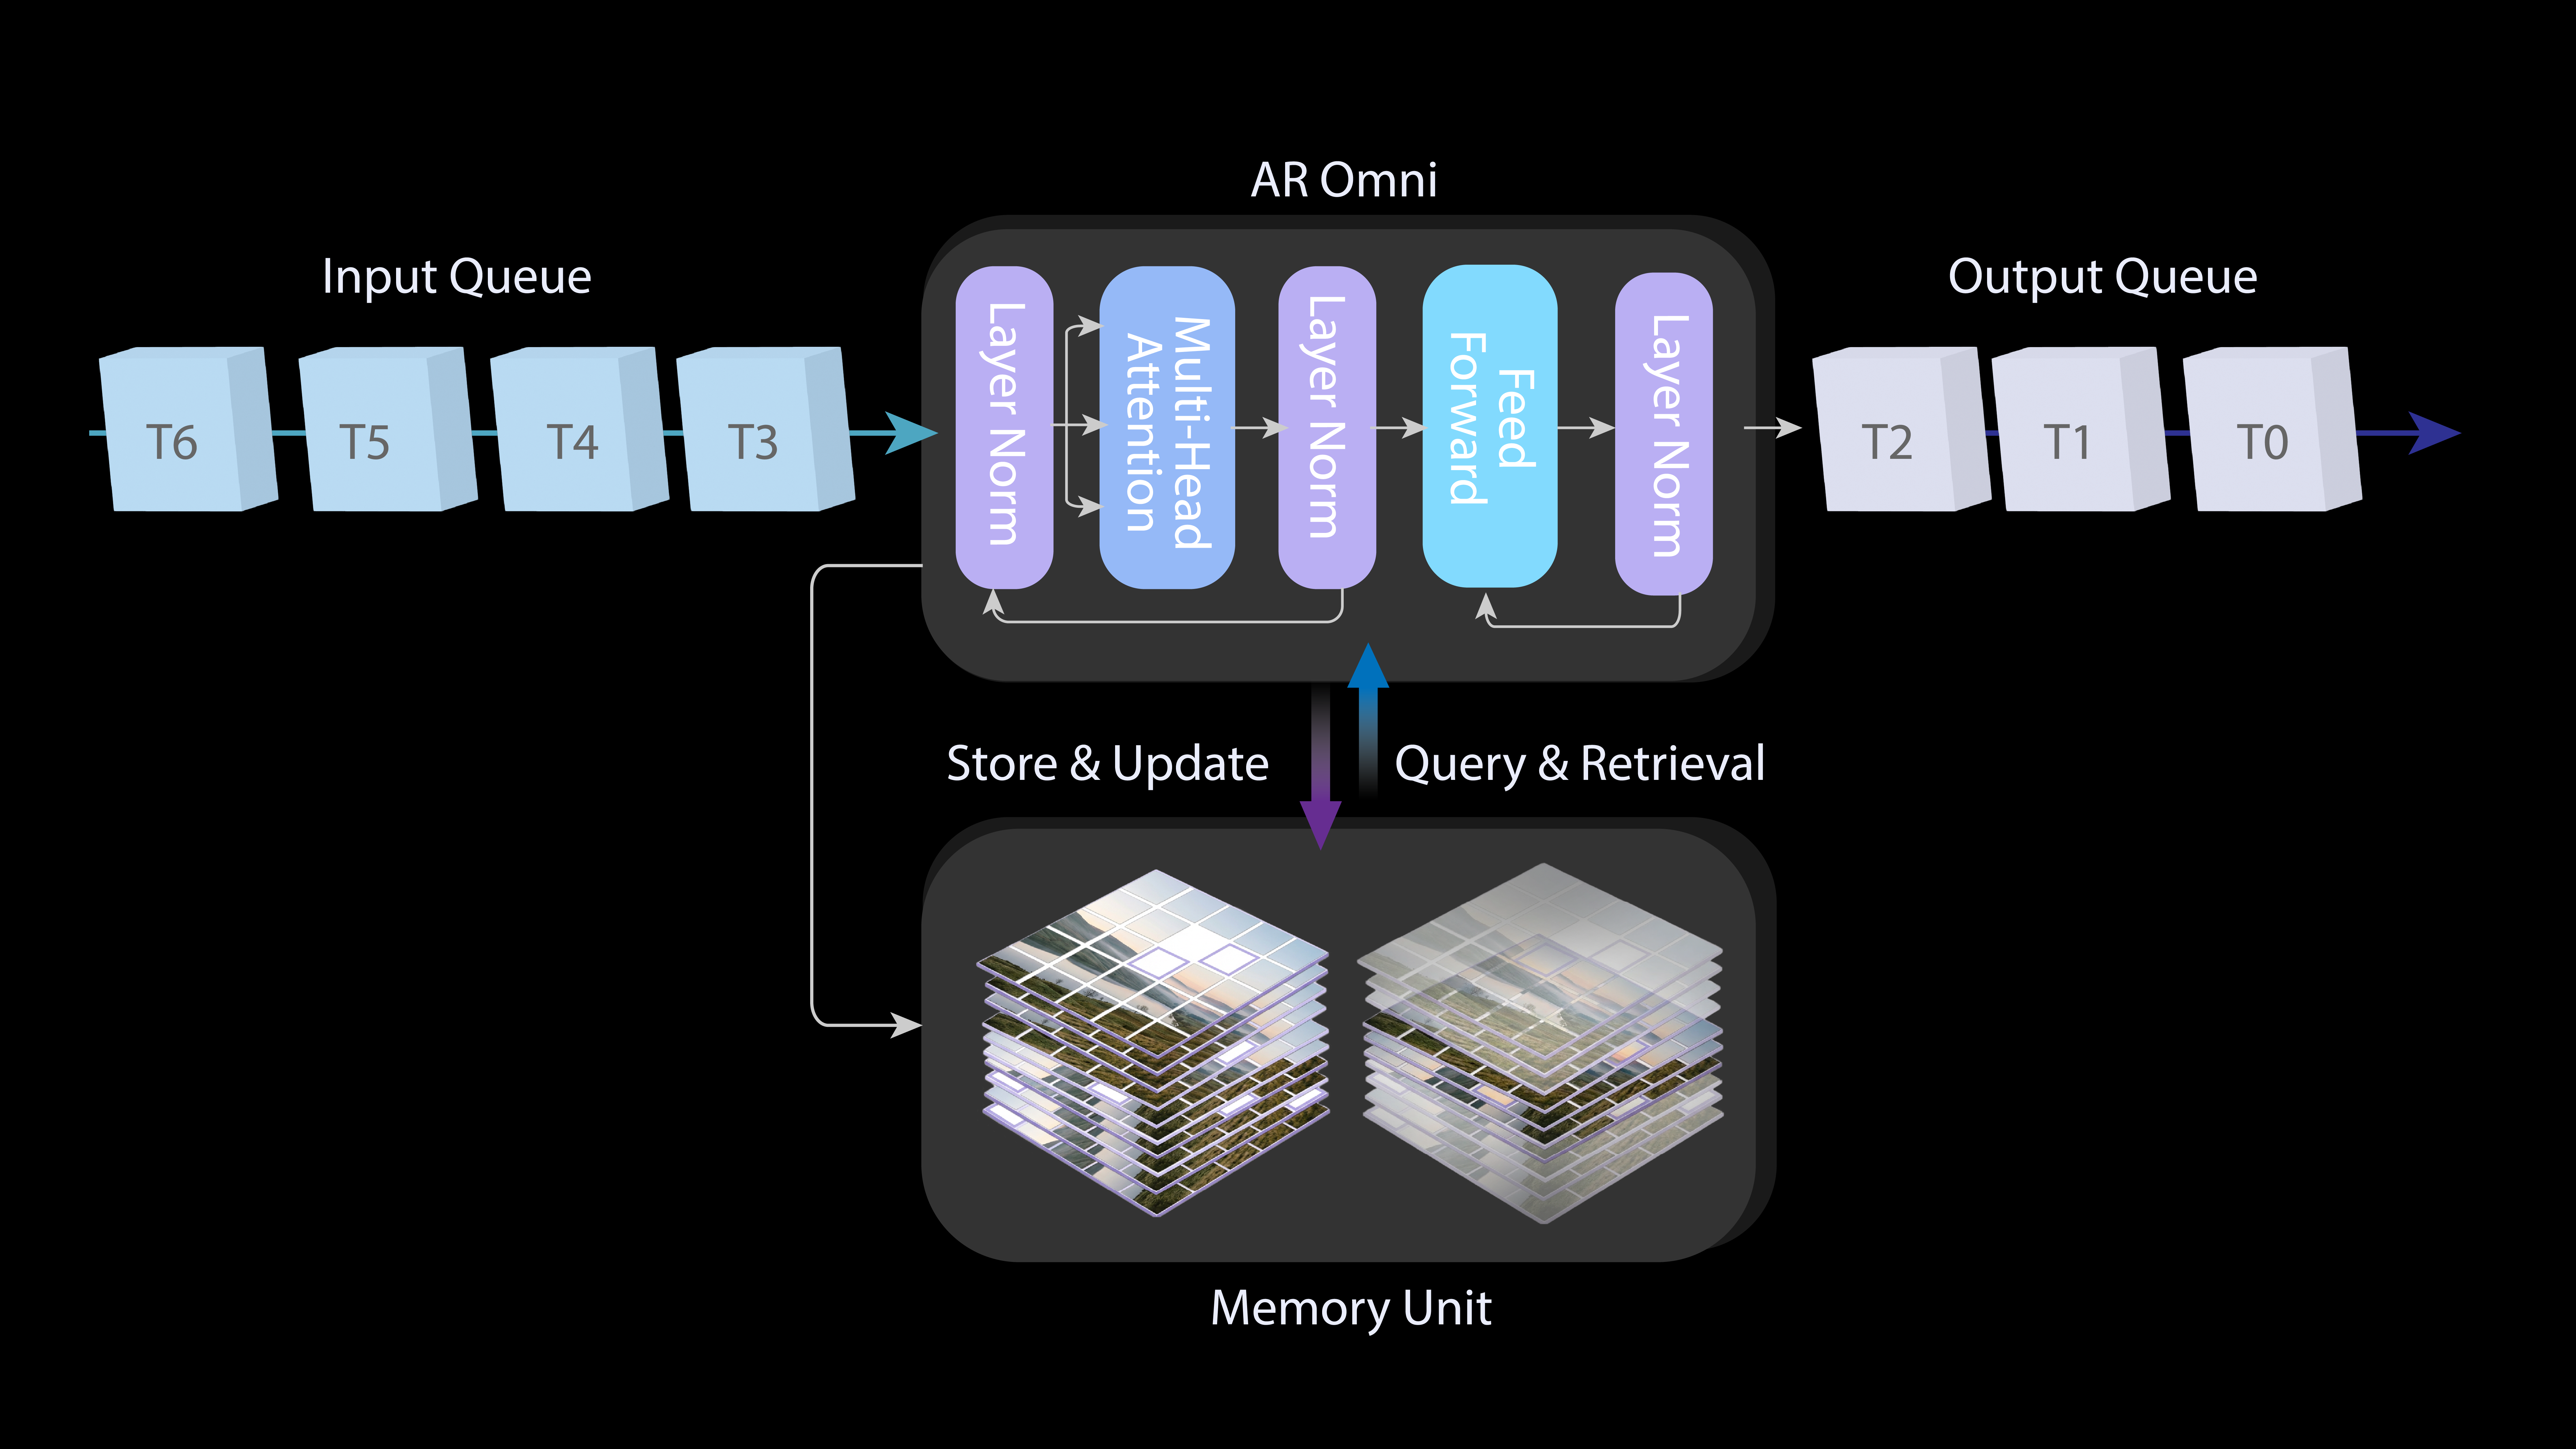
그림 2. Omni 파운데이션 모델과 통합된 자기회귀 모델링.
2.3 실시간 1080P: 즉각적 응답 엔진
반복적인 디노이징(denoising)은 일반적으로 높은 품질을 보장하지만, 그 계산 밀도는 종종 실시간 성능을 저해합니다. 이를 해결하고 고해상도(최대 1080P)에서 실시간 생성을 달성하기 위해 파이프라인을 즉각적 응답 엔진(IRE)으로 재구성했습니다.
IRE는 다음과 같은 발전을 통해 샘플링 프로세스를 최적화합니다.
- 시간적 궤적 폴딩(Temporal Trajectory Folding): 직접 운송 매핑(Direct Transport Mapping)을 구조적 사전 지식으로 구현함으로써 네트워크는 깨끗한 데이터 분포를 직접 예측합니다. 이는 샘플링 단계를 수십 단계에서 단 1~4단계로 줄여 초저지연에 필수적인 간소화된 경로를 생성합니다.
- 가이던스 정류(Guidance Rectification): 조건부 그래디언트를 학생 모델에 병합함으로써 Classifier-Free Guidance의 샘플링 오버헤드를 우회합니다.
- 적응형 희소 어텐션(Adaptive Sparse Attention): 이는 장거리 의존성 중복을 완화하여 응축된 계산 그래프를 생성하고, 실시간 1080P 생성의 실현을 더욱 촉진합니다.
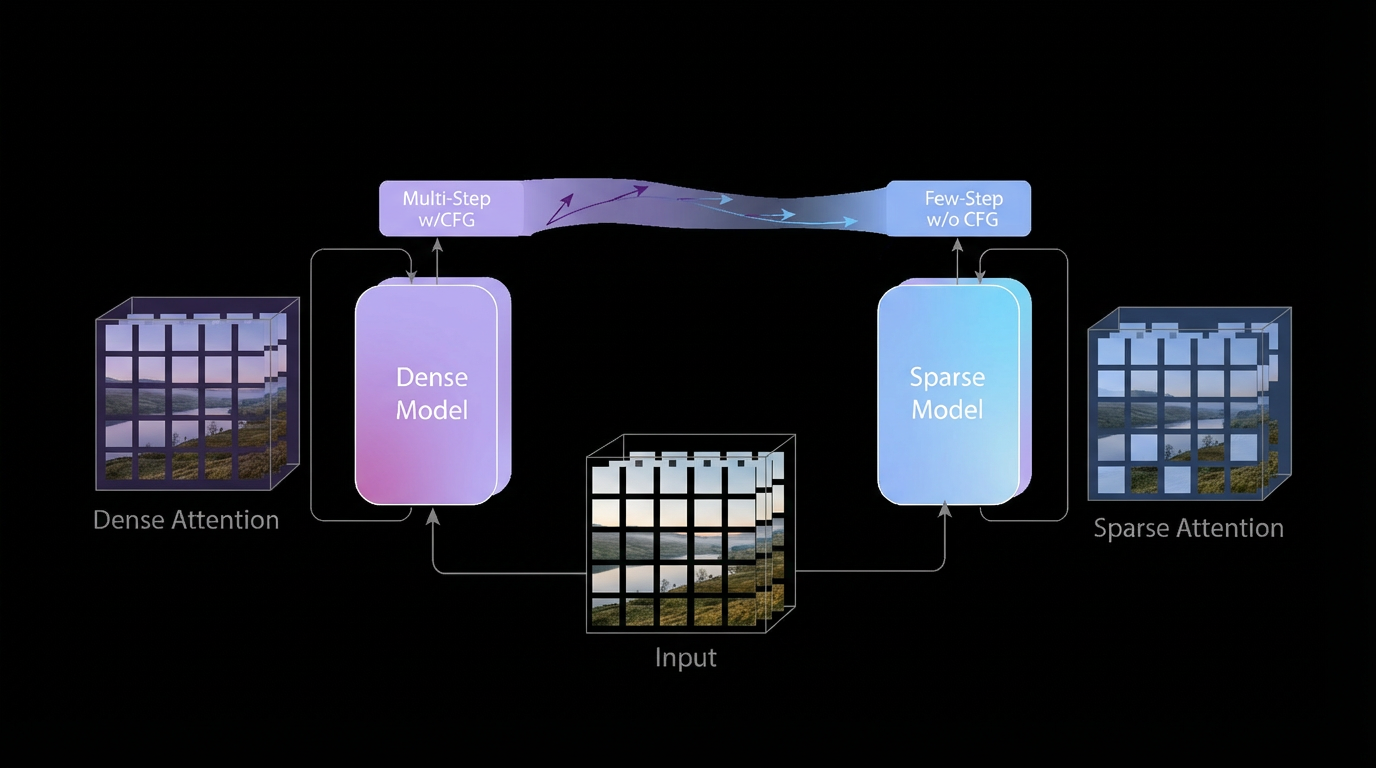
그림 3. 즉각적 응답 엔진은 시간적 궤적 폴딩, 가이던스 정류, 적응형 희소 어텐션 학습의 세 가지 모듈로 구성됩니다.
3. 애플리케이션 및 사회적 영향
PixVerse-R1은 실시간, 연속적, 상태 유지 시청각 시스템이라는 새로운 생성 미디어를 도입합니다. 사전 렌더링된 비디오와 달리, 이 미디어는 사용자 의도에 즉각적으로 반응하는 지속적인 프로세스로 작동하며 생성과 상호작용이 긴밀하게 결합되어 있습니다. 이 새로운 미디어는 다음을 포함하되 이에 국한되지 않는 광범위한 상호작용 시스템을 가능하게 합니다.
-
대화형 미디어
- AI 네이티브 게임 및 인터랙티브 시네마 경험
- 실시간 VR/XR 및 몰입형 시뮬레이션
-
창의 및 교육 시스템
- 적응형 미디어 아트 및 인터랙티브 설치물
- 실시간 학습 및 교육 환경
-
시뮬레이션 및 계획
- 실험적 연구 및 시나리오 탐색
- 산업, 농업 및 생태 시뮬레이션
특정 애플리케이션을 넘어, PixVerse-R1은 연속적인 시청각 월드 시뮬레이터로 기능하여 인간의 의도와 시스템 응답 사이의 거리를 좁히고 지속적인 디지털 환경 내에서 새로운 형태의 인간-AI 공동 창작을 가능하게 합니다.
4. 결론
PixVerse-R1은 멀티모달 처리 및 즉각적 응답에서의 아키텍처 혁신을 통해 기존 비디오 워크플로우의 고유한 한계를 복하는 실시간 생성 프레임워크를 도입합니다. 일관된 실시간 생성을 가능하게 함으로써, 이 모델은 시청각 미디어의 생성 및 경험에 있어 중요한 진화를 나타냅니다. 실시간 지연 시간으로의 전환은 정적인 콘텐츠 소비에서 동적인 환경 상호작용으로의 전환을 가능하게 하며, AI 네이티브 게임에서 복잡한 산업 시뮬레이션에 이르는 애플리케이션을 위한 확장 가능한 계산 기반을 제공합니다. 사용자 의도와 즉각적인 시각적 피드백 사이의 간극을 메움으로써, 이 시스템은 인터랙티브 월드 모델링 및 인간-AI 협업 환경을 위한 새로운 지평을 열었습니다.
5. 한계점
PixVerse-R1은 상당한 모델링 이점을 제공하지만, 시간적 정확성과 물리적 충실도와 관련하여 두 가지 주요 제약이 남아 있습니다.
- 시간적 오차 누적: 긴 시퀀스에 걸쳐 미세한 예측 오차가 누적되어 시뮬레이션의 구조적 무결성이 손상될 가능성이 있습니다.
- 물리 법칙 대 계산의 절충: 실시간 생성을 성공적으로 달성하기 위해 생성 복잡성과 관련하여 특정 희생이 따랐습니다. 결과적으로 비실시간 모델에 비해 일부 물리 법칙의 정밀한 렌더링에서 어느 정도 손실이 발생할 수 있습니다.