PixVerse-R1:次世代リアルタイム・ワールドモデル
PixVerse-R1:次世代リアルタイム・ワールドモデル
概要
ネイティブなマルチモーダル基盤モデル上に構築された次世代のリアルタイム・ワールドモデル、PixVerse-R1を発表します。このシステムは、ユーザーの入力に即座に、かつ流動的に反応するリアルタイムのビデオ生成を可能にします。従来のビデオワークフローにおける固有の遅延や固定長の制約を克服することで、PixVerse-R1はビデオ生成を無限で連続的、かつインタラクティブなビジュアルストリームへと変貌させます。これは、オーディオビジュアルメディアの創造、体験、共有における重要な進化であり、ユーザーの意図に基づいた瞬時の適応が可能な、知的でインタラクティブなメディアへのパラダイムシフトを意味します。
1. はじめに
デジタルメディアの状況は、静的で事前レンダリングされたコンテンツから、動的でインタラクティブな体験へと根本的にシフトしています。従来の制作パイプラインは、歴史的に高い遅延と固定長のクリップに制約されており、コンテンツ制作とリアルタイム消費の間に二分法を生み出してきました。
これらの制限に対処するために、ネイティブなマルチモーダル基盤モデル、一貫性自己回帰メカニズム、および瞬時応答エンジンを統合した新しいワールドモデルアーキテクチャを導入します。この統一されたアプローチにより、テキストやオーディオデータとともに時空間パッチの共同処理が可能になり、従来のメディア処理のサイロ化を効果的に解消します。自己回帰メカニズムと瞬時応答エンジンを介して無限のストリーミングが可能なシステムを導入することで、生成された世界は低い計算オーバーヘッドで、長期にわたって物理的な一貫性を維持します。
主要な能力:このアーキテクチャを活用することで、当社のシステムはパフォーマンスの飛躍的進歩を遂げ、最大1080Pの高解像度ビデオをリアルタイムで生成します。 この能力は視覚的な忠実度を高め、AIネイティブのゲームやインタラクティブなシネマを可能にします。そこでは、環境や物語がユーザーのインタラクションに応じて動的に進化します。広義には、これにより生成システムは有限のメディアアーティファクトではなく、持続的でインタラクティブな世界として機能することが可能になり、連続的でステートフル、かつインタラクティブなオーディオビジュアルシミュレーションへの軌道を示しています。
2. 技術アーキテクチャ
2.1 Omni:ネイティブ・マルチモーダル基盤モデル
一般的な能力を獲得するために、完全にエンドツーエンドのネイティブ・マルチモーダル基盤モデルを設計することで、従来の生成パイプラインを超越しました。
- 統一された表現: Omniモデルは、多様なモダリティ(テキスト、画像、ビデオ、オーディオ)をトークンの連続したストリームに統合し、単一のフレームワーク内で任意のマルチモーダル入力を受け入れることができます。
- エンドツーエンドのトレーニング: アーキテクチャ全体が中間インターフェースなしで異種タスクにわたってトレーニングされており、エラーの伝播を防ぎ、堅牢なスケーラビリティを確保しています。
- ネイティブ解像度: クロッピングやリサイズに伴うアーティファクトを避けるために、このフレームワーク内でネイティブ解像度のトレーニングを利用しています。
さらに、モデルは大規模な現実世界のビデオデータコーパスから学習することで、現実世界の固有の物理法則とダイナミクスを内面化しています。この基礎的な理解により、システムは一貫性のあるレスポンシブな「並行世界」をリアルタイムで合成することができます。
Omniモデルは効果的に拡張され、単なる生成エンジンとしてではなく、物理世界の汎用シミュレーターを構築するための先駆的な一歩として機能します。シミュレーションタスクを単一のエンドツーエンドの生成パラダイムとして扱うことで、リアルタイムで長期的なAI生成世界の探索を促進します。
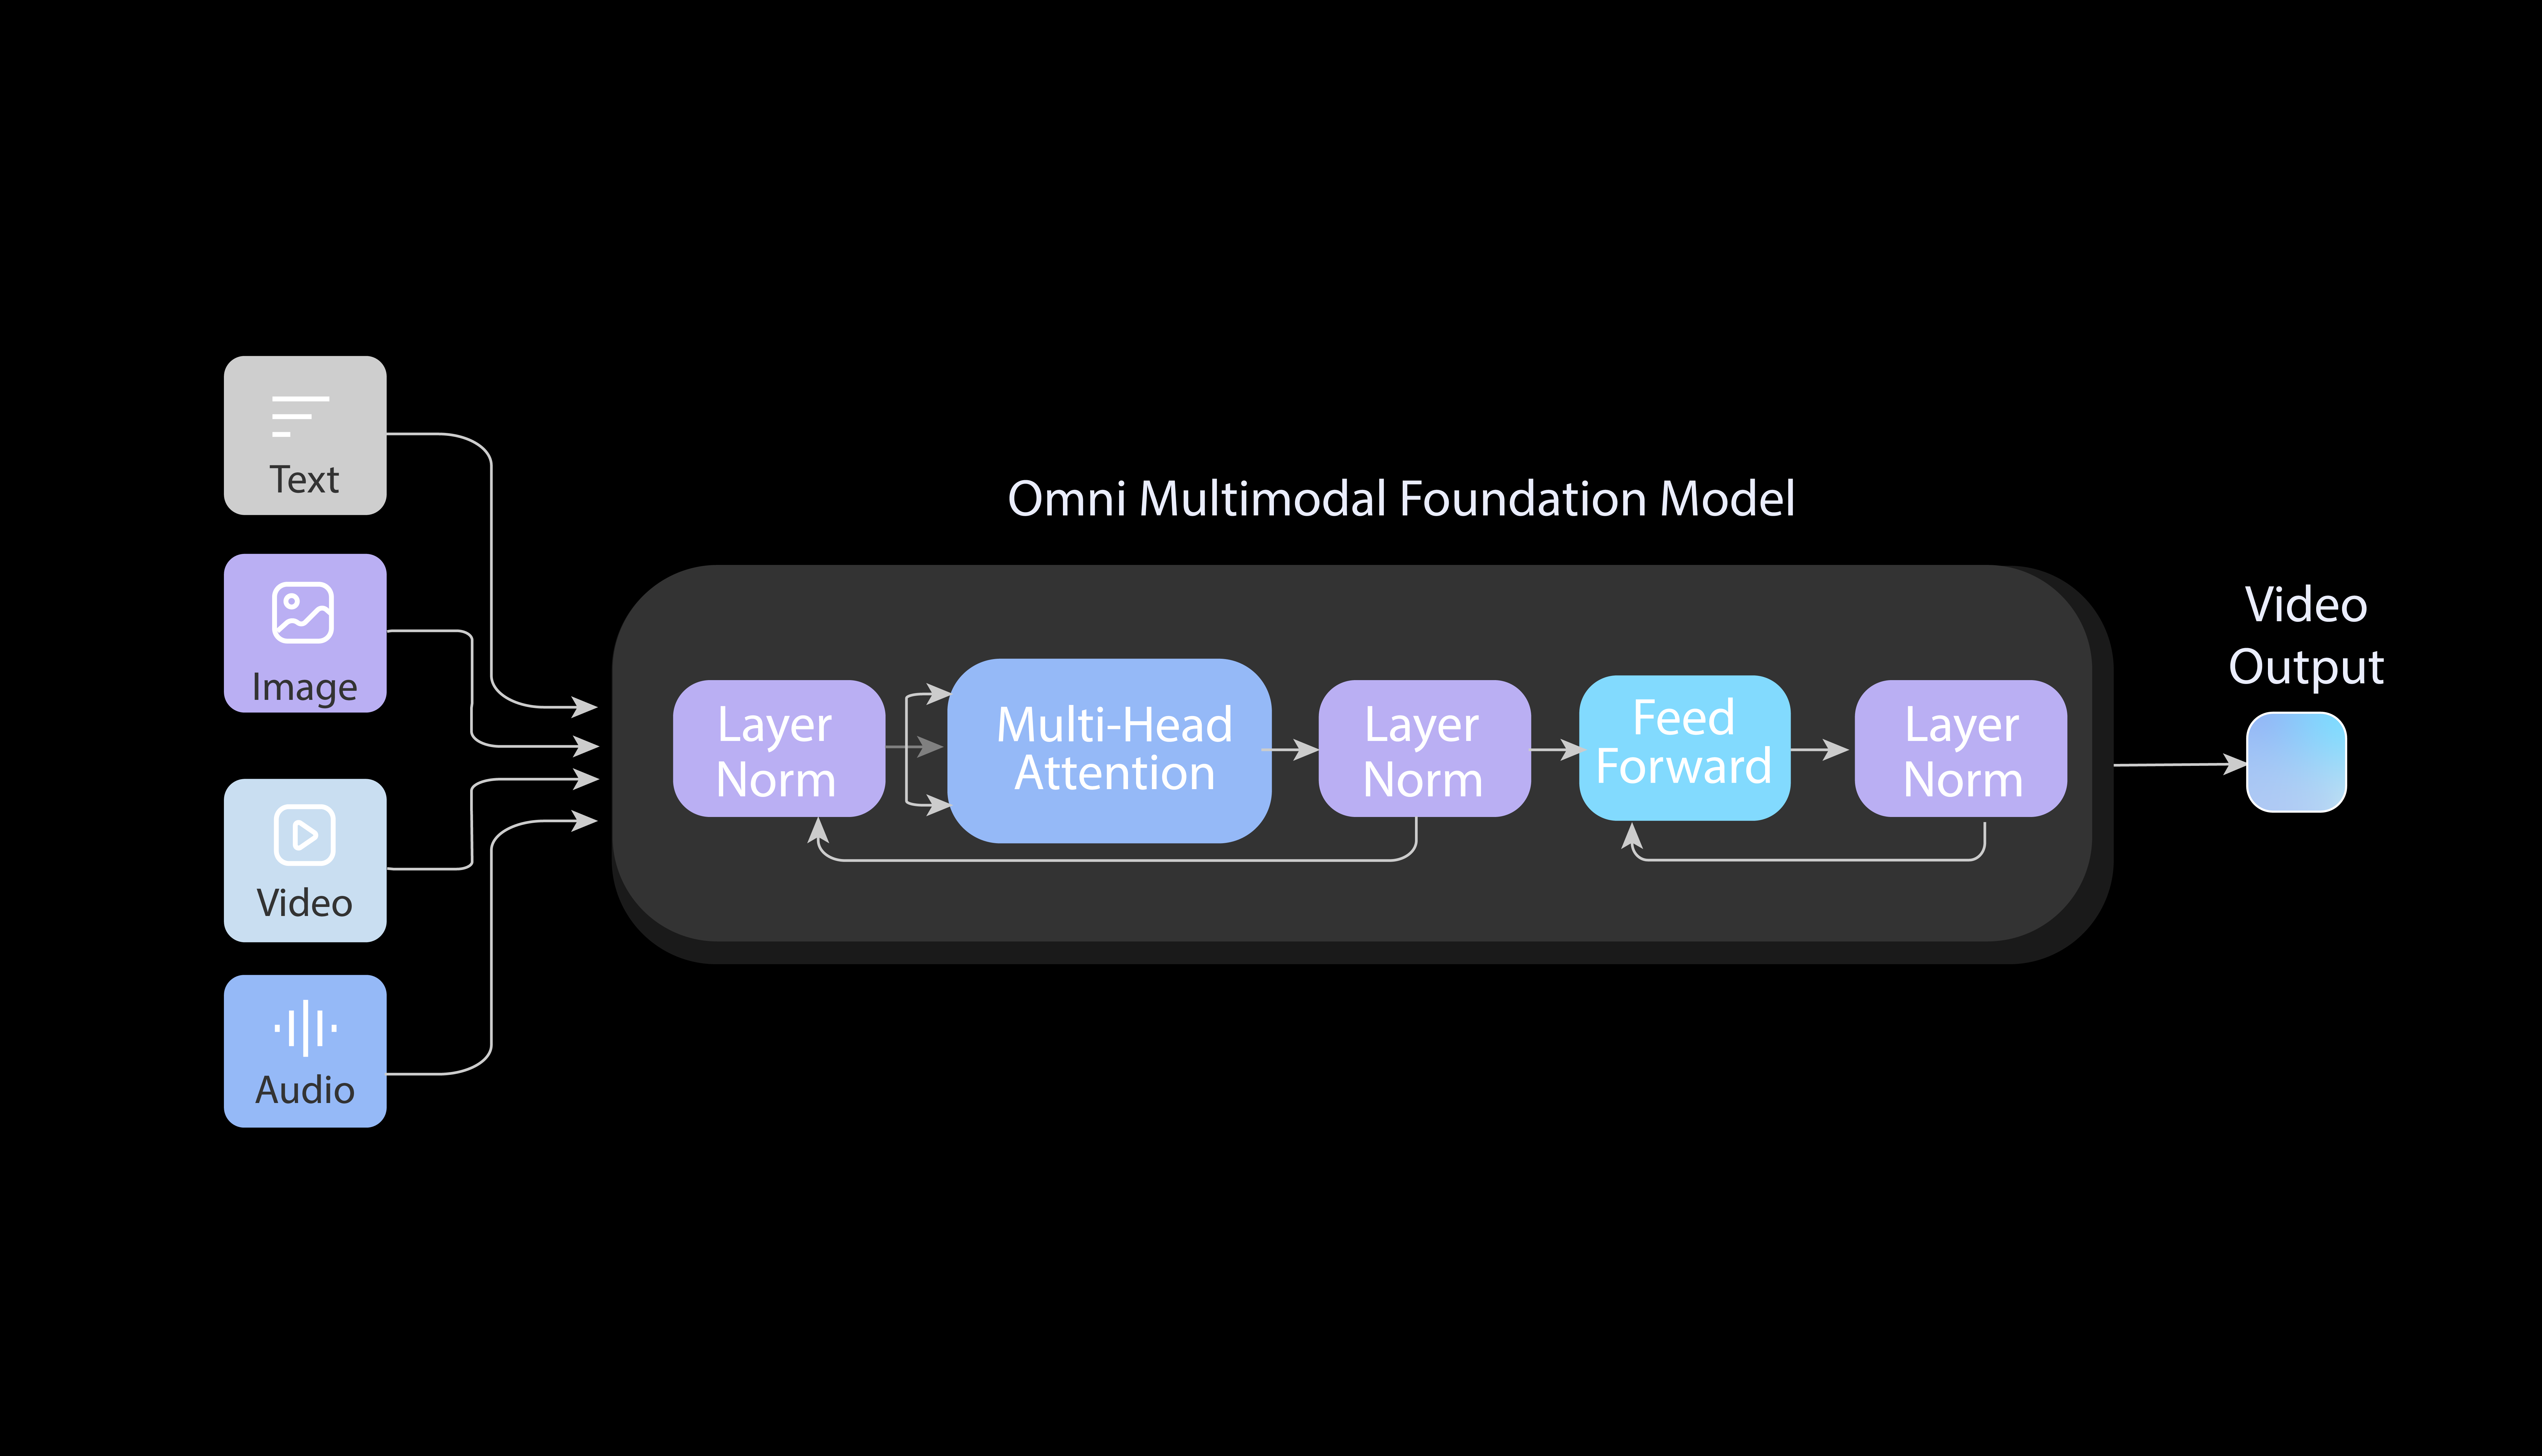
図1. Omniネイティブ・マルチモーダル基盤モデルのエンドツーエンドアーキテクチャ。統一された設計により、Omniモデルは任意のマルチモーダル入力を受け入れ、オーディオとビデオを同時に生成することができます。
2.2 Memory:自己回帰メカニズムによる一貫した無限ストリーミング
有限のクリップに制限された標準的な拡散手法とは異なり、PixVerse-R1は自己回帰モデリングを統合して無限で連続的なビジュアルストリーミングを可能にし、メモリ拡張アテンションメカニズムを組み込んで、生成された世界が長期にわたって物理的な一貫性を維持するようにします。
- 無限ストリーミング: ビデオ合成を自己回帰プロセスとして定式化することで、モデルは後続のフレームを順次予測し、連続的で制限のないビジュアルストリーミングを実現します。
- 時間的一貫性: メモリ拡張アテンションメカニズムは、先行するコンテキストの潜在的な表現に基づいて現在のフレームの生成を条件付け、世界が長期にわたって物理的に一貫性を保つようにします。
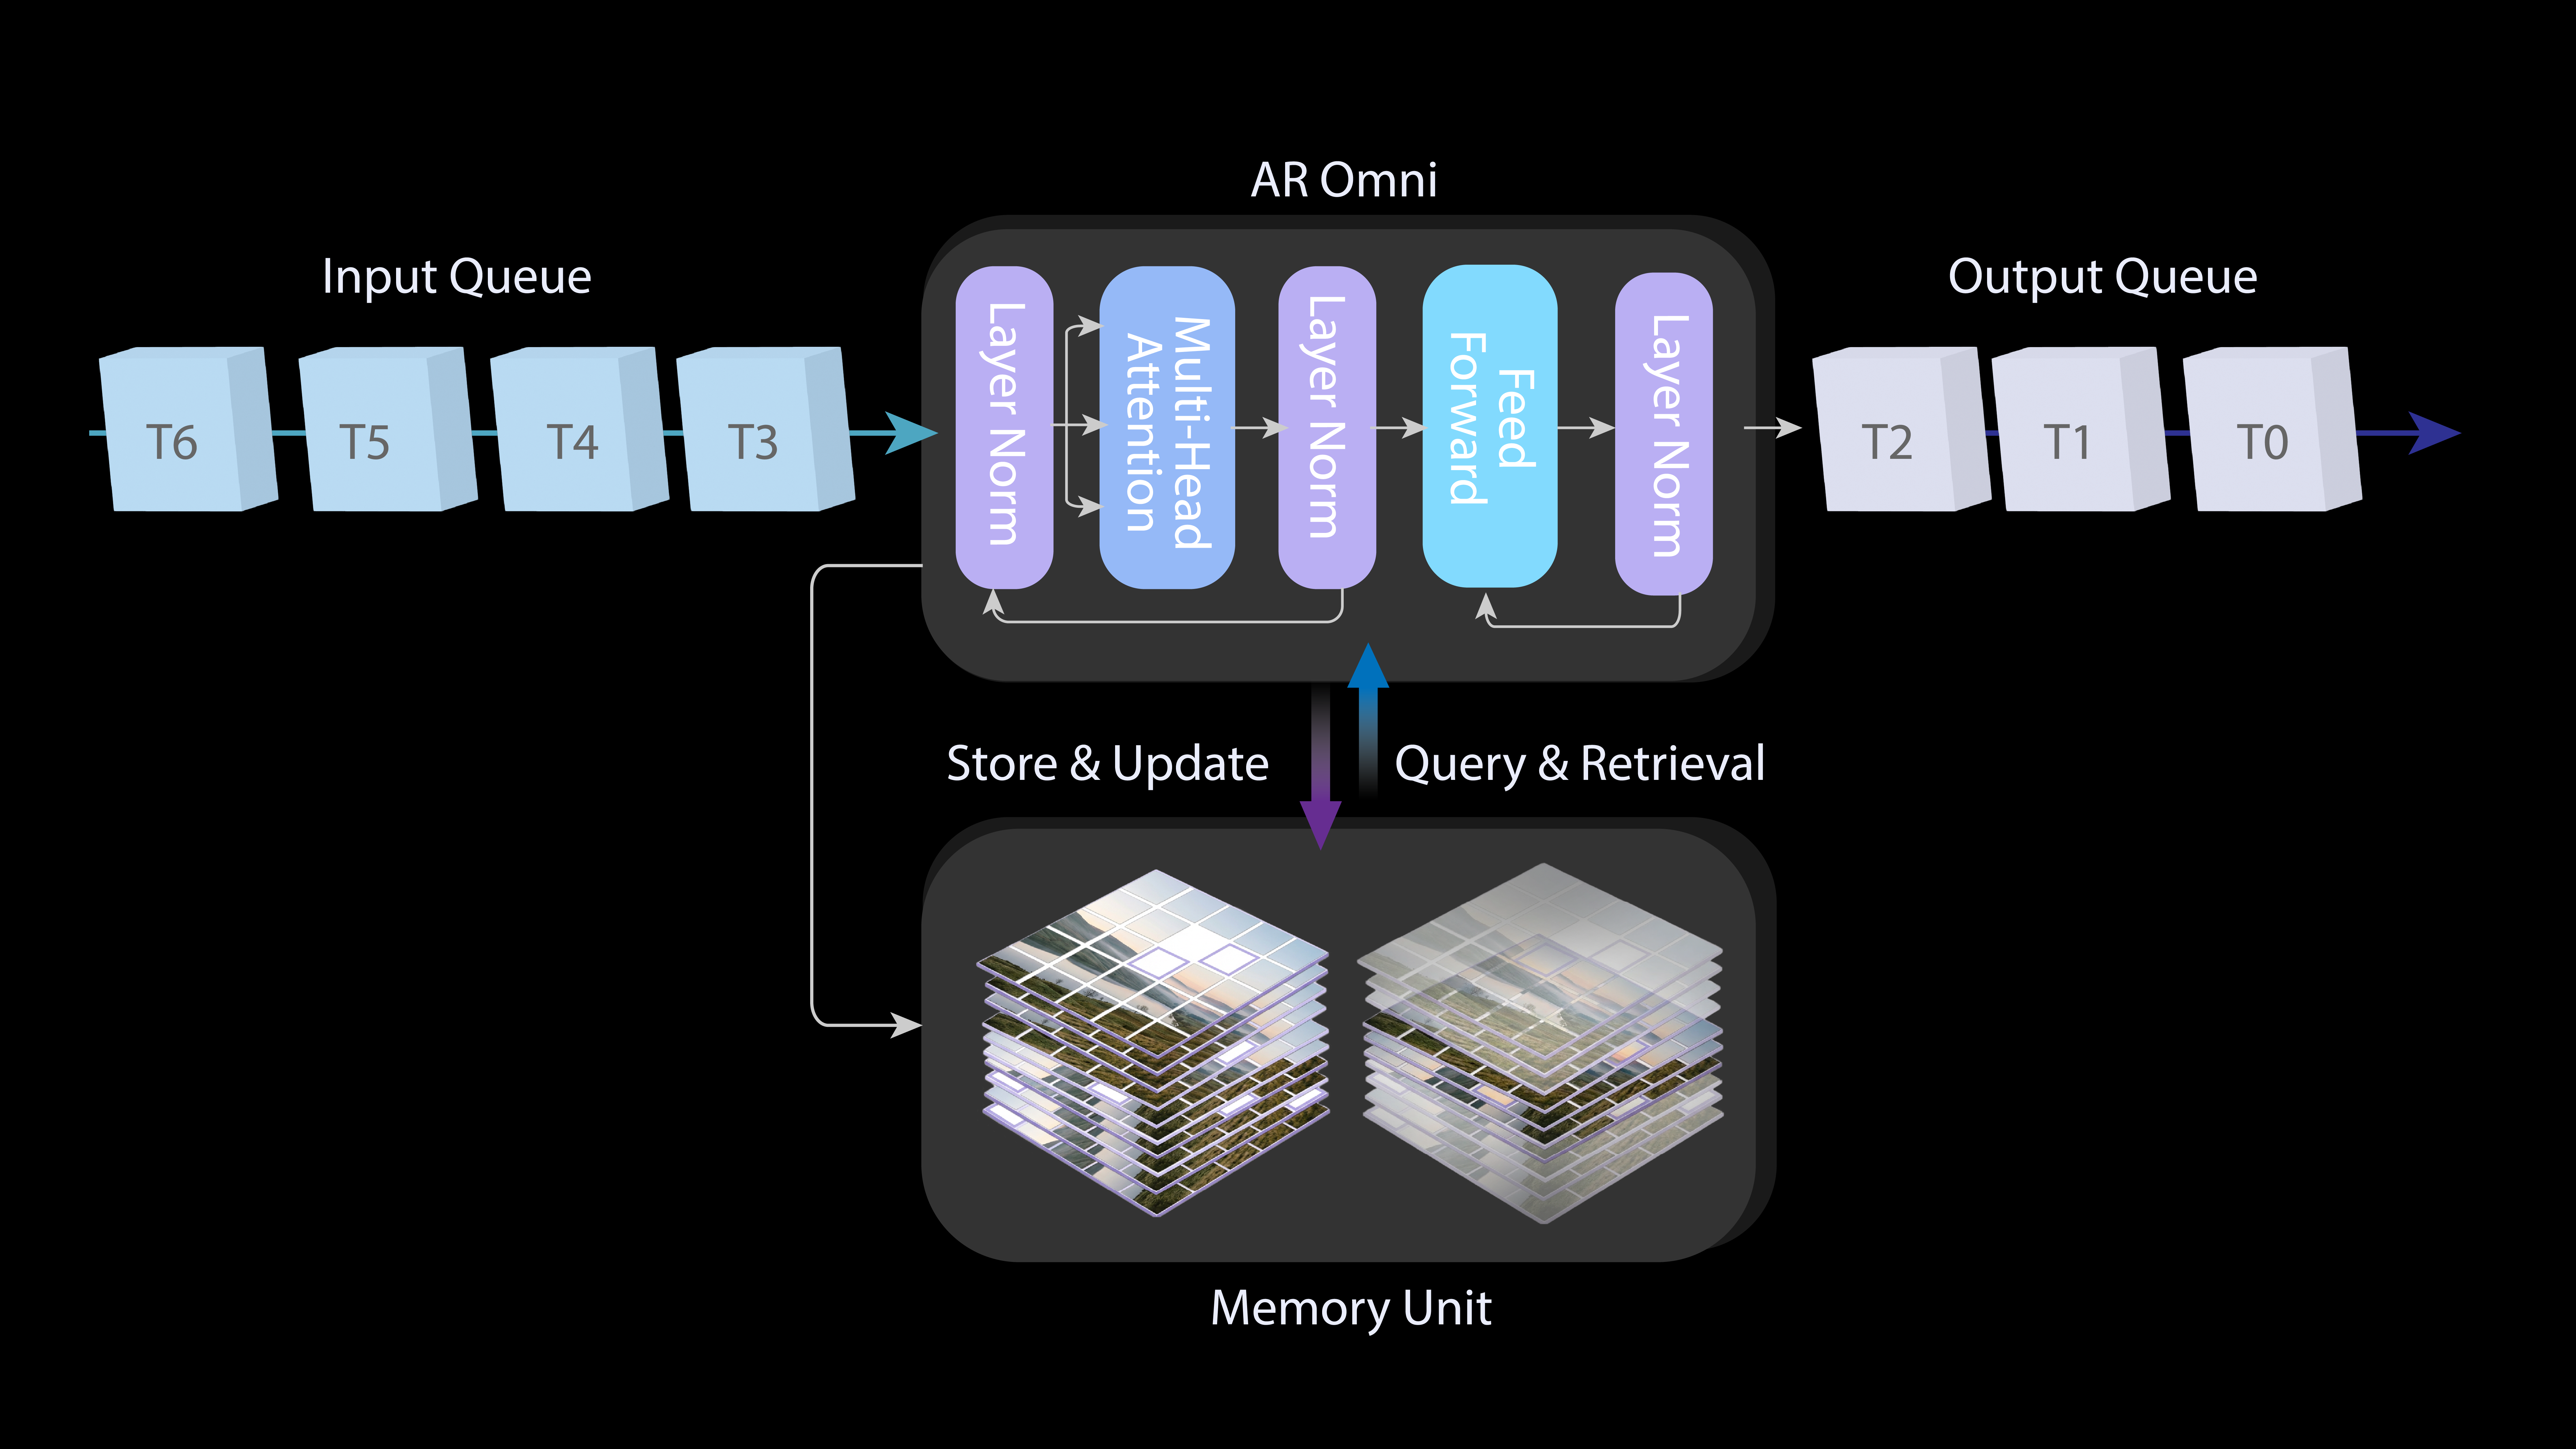
図2. Omni基盤モデルと統合された自己回帰モデリング。
2.3 リアルタイム 1080P:瞬時応答エンジン
反復的なデノイジングは通常、高品質を保証しますが、その計算密度はリアルタイムのパフォーマンスを妨げることがよくあります。これを解決し、高解像度(最大1080P)でのリアルタイム生成を達成するために、パイプラインを瞬時応答エンジン(IRE)に再構築しました。
IREは、以下の進歩を通じてサンプリングプロセスを最適化します。
- 時間的軌道フォーリング: 構造的なプライアとして直接輸送マッピング(Direct Transport Mapping)を実装することで、ネットワークはクリーンなデータ分布を直接予測します。これにより、サンプリングステップが数十からわずか1〜4に短縮され、超低遅延に不可欠な合理化された経路が作成されます。
- ガイダンス整流: 条件付き勾配をスチューデントモデルにマージすることで、Classifier-Free Guidanceのサンプリングオーバーヘッドを回避します。
- 適応型スパースアテンション: これにより長距離の依存関係の冗長性が緩和され、リアルタイム1080P生成の実現をさらに促進する凝縮された計算グラフが得られます。
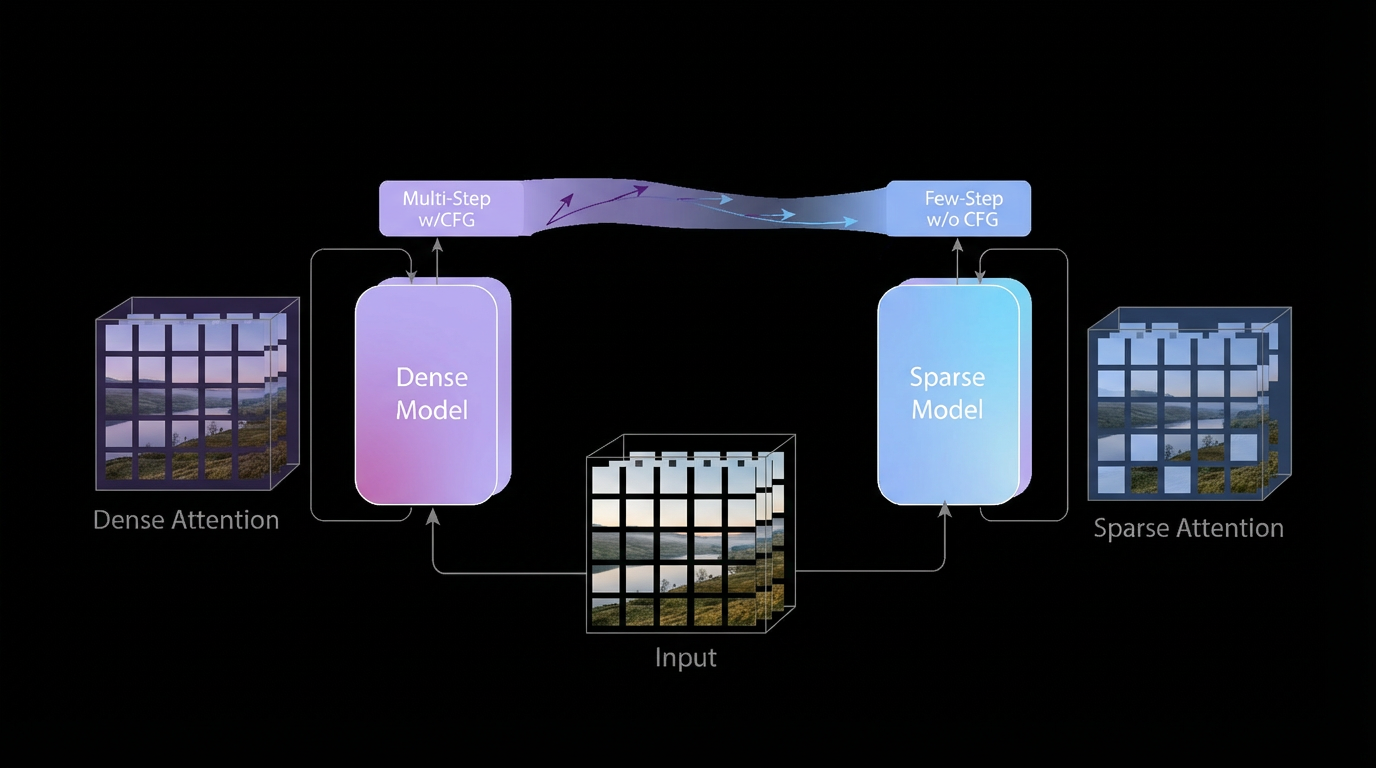
図3. 瞬時応答エンジンは、時間的軌道フォーリング、ガイダンス整流、および適応型スパースアテンション学習の3つのモジュールで構成されています。
3. アプリケーションと社会的影響
PixVerse-R1は、新しい生成メディアであるリアルタイムで連続的、かつステートフルなオーディオビジュアルシステムを導入します。 事前レンダリングされたビデオとは異なり、このメディアはユーザーの意図に即座に反応する持続的なプロセスとして機能し、生成とインタラクションが密接に結合しています。 この新しいメディアは、以下を含む(がこれらに限定されない)幅広いインタラクティブシステムを可能にします。
-
インタラクティブメディア
- AIネイティブのゲームとインタラクティブな映画体験
- リアルタイムVR/XRと没入型シミュレーション
-
クリエイティブおよび教育システム
- 適応型メディアアートとインタラクティブなインスタレーション
- リアルタイムの学習およびトレーニング環境
-
シミュレーションとプランニング
- 実験的研究と探索的なシナリオ作成
- 工業、農業、生態学的シミュレーション
特定のアプリケーションを超えて、PixVerse-R1は連続的なオーディオビジュアル・ワールドシミュレーターとして機能し、人間の意図とシステム応答の間の距離を縮め、持続的なデジタル環境内での新しい形の人とAIの共創を可能にします。
4. 結論
PixVerse-R1は、マルチモーダル処理と瞬時応答におけるアーキテクチャの革新を通じて、従来のビデオワークフローの固有の制限を克服するリアルタイム生成フレームワークを導入します。一貫したリアルタイム生成を可能にすることで、このモデルはオーディオビジュアルメディアの創造と体験における重要な進化を示しています。リアルタイムの遅延への移行により、静的なコンテンツ消費から動的な環境インタラクションへの転換が可能になり、AIネイティブのゲームから複雑な工業用シミュレーションに至るまでのアプリケーションにスケーラブルな計算基盤を提供します。ユーザーの意図と瞬時の視覚的フィードバックの間のギャップを埋めることで、システムはインタラクティブなワールドモデリングと人間とAIのコラボレーション環境のための新しいフロンティアを確立します。
5. 制限事項
PixVerse-R1は大きなモデリング上の利点を提供しますが、時間的精度と物理的忠実度に関して2つの主要な制約が残っています。
- 時間的誤差の累積: 長いシーケンスにわたって、わずかな予測誤差が蓄積され、シミュレーションの構造的な整合性が損なわれる可能性があります。
- 物理学対計算のトレードオフ: リアルタイム生成を正常に達成するために、生成の複雑さに関して特定の犠牲が払われました。その結果、非リアルタイムモデルと比較して、一部の物理法則の正確なレンダリングにおいてある程度の損失が生じる可能性があります。