PixVerse-R1 : Modèle de monde en temps réel de nouvelle génération
PixVerse-R1 : Modèle de monde en temps réel de nouvelle génération
Résumé
Nous présentons PixVerse-R1, un modèle de monde en temps réel de nouvelle génération architecturé sur un modèle de fondation multimodal natif. Ce système permet la génération de vidéo en temps réel où le contenu visuel répond instantanément et de manière fluide aux entrées de l’utilisateur. En surmontant la latence intrinsèque et les contraintes de longueur fixe des flux de travail vidéo traditionnels, PixVerse-R1 transforme la génération vidéo en un flux visuel infini, continu et interactif. Cela représente une évolution significative dans la création, l’expérience et le partage de médias audiovisuels, marquant un changement de paradigme vers des médias intelligents et interactifs capables d’une adaptation instantanée basée sur l’intention de l’utilisateur.
1. Introduction
Le paysage des médias numériques évolue fondamentalement, passant d’un contenu statique pré-rendu à des expériences dynamiques et interactives. Les pipelines de production conventionnels ont historiquement été contraints par une latence élevée et des clips de longueur fixe, créant une dichotomie entre la création de contenu et la consommation en temps réel.
Pour répondre à ces limitations, nous introduisons une nouvelle architecture de modèle de monde qui unifie un modèle de fondation multimodal natif, un mécanisme autorégressif de cohérence et un moteur de réponse instantanée. Cette approche unifiée permet le traitement conjoint de patchs spatiotemporels ainsi que de données textuelles et audio, démantelant efficacement les silos traditionnels du traitement des médias. En déployant un système capable de streaming infini via un mécanisme autorégressif et un moteur de réponse instantanée, le monde généré reste physiquement cohérent sur de longs horizons avec une faible surcharge de calcul.
Capacité clé : En tirant parti de cette architecture, notre système réalise une percée en termes de performances, générant des vidéos haute résolution jusqu’à 1080P en temps réel. Cette capacité améliore la fidélité visuelle et permet le jeu vidéo natif IA et le cinéma interactif, où les environnements et les récits évoluent dynamiquement en réponse à l’interaction de l’utilisateur. Plus largement, cela permet aux systèmes génératifs de fonctionner comme des mondes persistants et interactifs plutôt que comme des artefacts médiatiques finis, indiquant une trajectoire vers des simulations audiovisuelles continues, avec état et interactives.
2. Architecture Technique
2.1 Omni : Modèle de fondation multimodal natif
Pour atteindre des capacités générales, nous avons transcendé les pipelines de génération traditionnels en concevant un modèle de fondation multimodal natif entièrement de bout en bout.
- Représentation unifiée : Le modèle Omni unifie diverses modalités (texte, image, vidéo, audio) en un flux continu de jetons, lui permettant d’accepter des entrées multimodales arbitraires au sein d’un cadre unique.
- Entraînement de bout en bout : L’ensemble de l’architecture est entraîné sur des tâches hétérogènes sans interfaces intermédiaires, empêchant la propagation des erreurs et assurant une évolutivité robuste.
- Résolution native : Nous utilisons un entraînement en résolution native au sein de ce cadre pour éviter les artefacts typiquement associés au recadrage ou au redimensionnement.
De plus, le modèle internalise les lois physiques et la dynamique intrinsèques du monde réel en apprenant à partir d’un corpus massif de données vidéo du monde réel. Cette compréhension fondamentale permet au système de synthétiser un “monde parallèle” cohérent et réactif en temps réel.
Le modèle Omni évolue efficacement, fonctionnant non seulement comme un moteur génératif, mais comme une étape pionnière vers la construction de simulateurs polyvalents du monde physique. En traitant la tâche de simulation comme un paradigme de génération unique de bout en bout, nous facilitons l’exploration de mondes générés par l’IA en temps réel et sur de longs horizons.
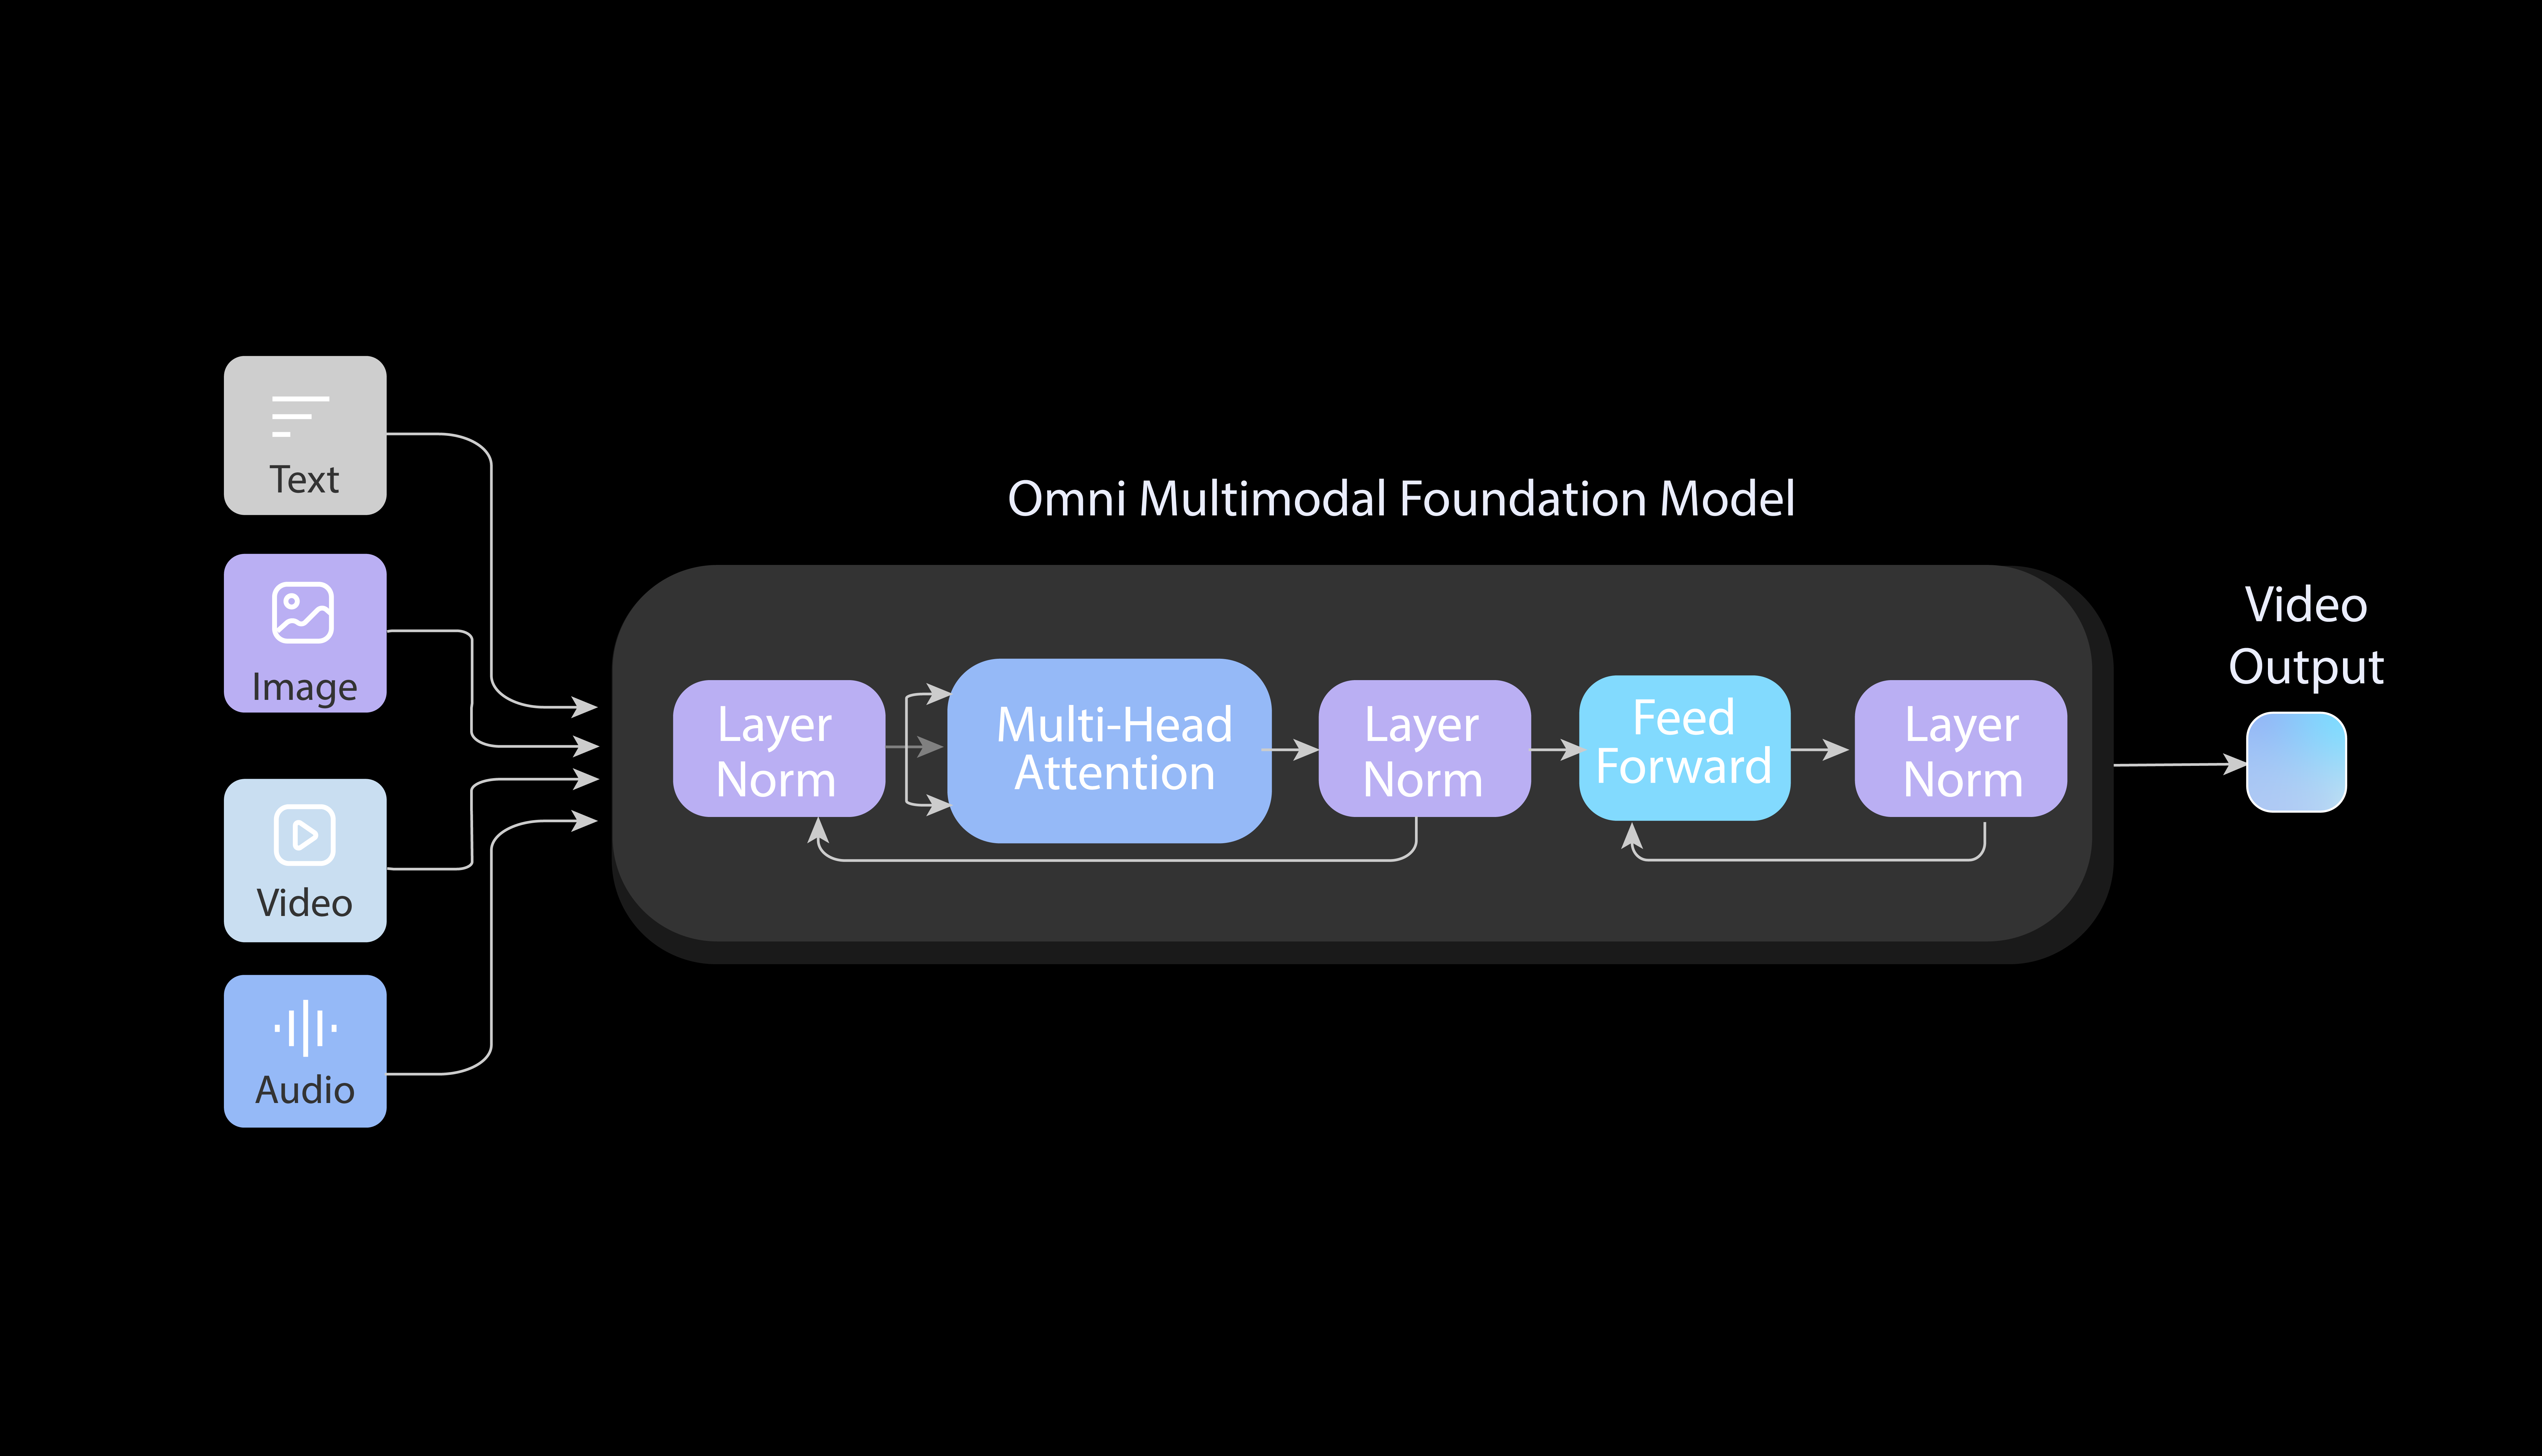
Figure 1. L’architecture de bout en bout de notre modèle de fondation multimodal natif Omni ; la conception unifiée permet à notre modèle Omni d’accepter des entrées multimodales arbitraires et de générer de l’audio et de la vidéo en même temps.
2.2 Memory : Streaming infini cohérent via un mécanisme autorégressif
Contrairement aux méthodes de diffusion standard limitées à des clips finis, PixVerse-R1 intègre une modélisation autorégressive pour permettre un streaming visuel infini et continu, et incorpore un mécanisme d’attention augmenté par la mémoire pour garantir que le monde généré reste physiquement cohérent sur de longs horizons.
- Streaming infini : En formulant la synthèse vidéo comme un processus autorégressif, le modèle prédit séquentiellement les images suivantes pour obtenir un flux visuel continu et illimité.
- Cohérence temporelle : Un mécanisme d’attention augmenté par la mémoire conditionne la génération de l’image actuelle sur les représentations latentes du contexte précédent, garantissant que le monde reste physiquement cohérent sur de longs horizons.
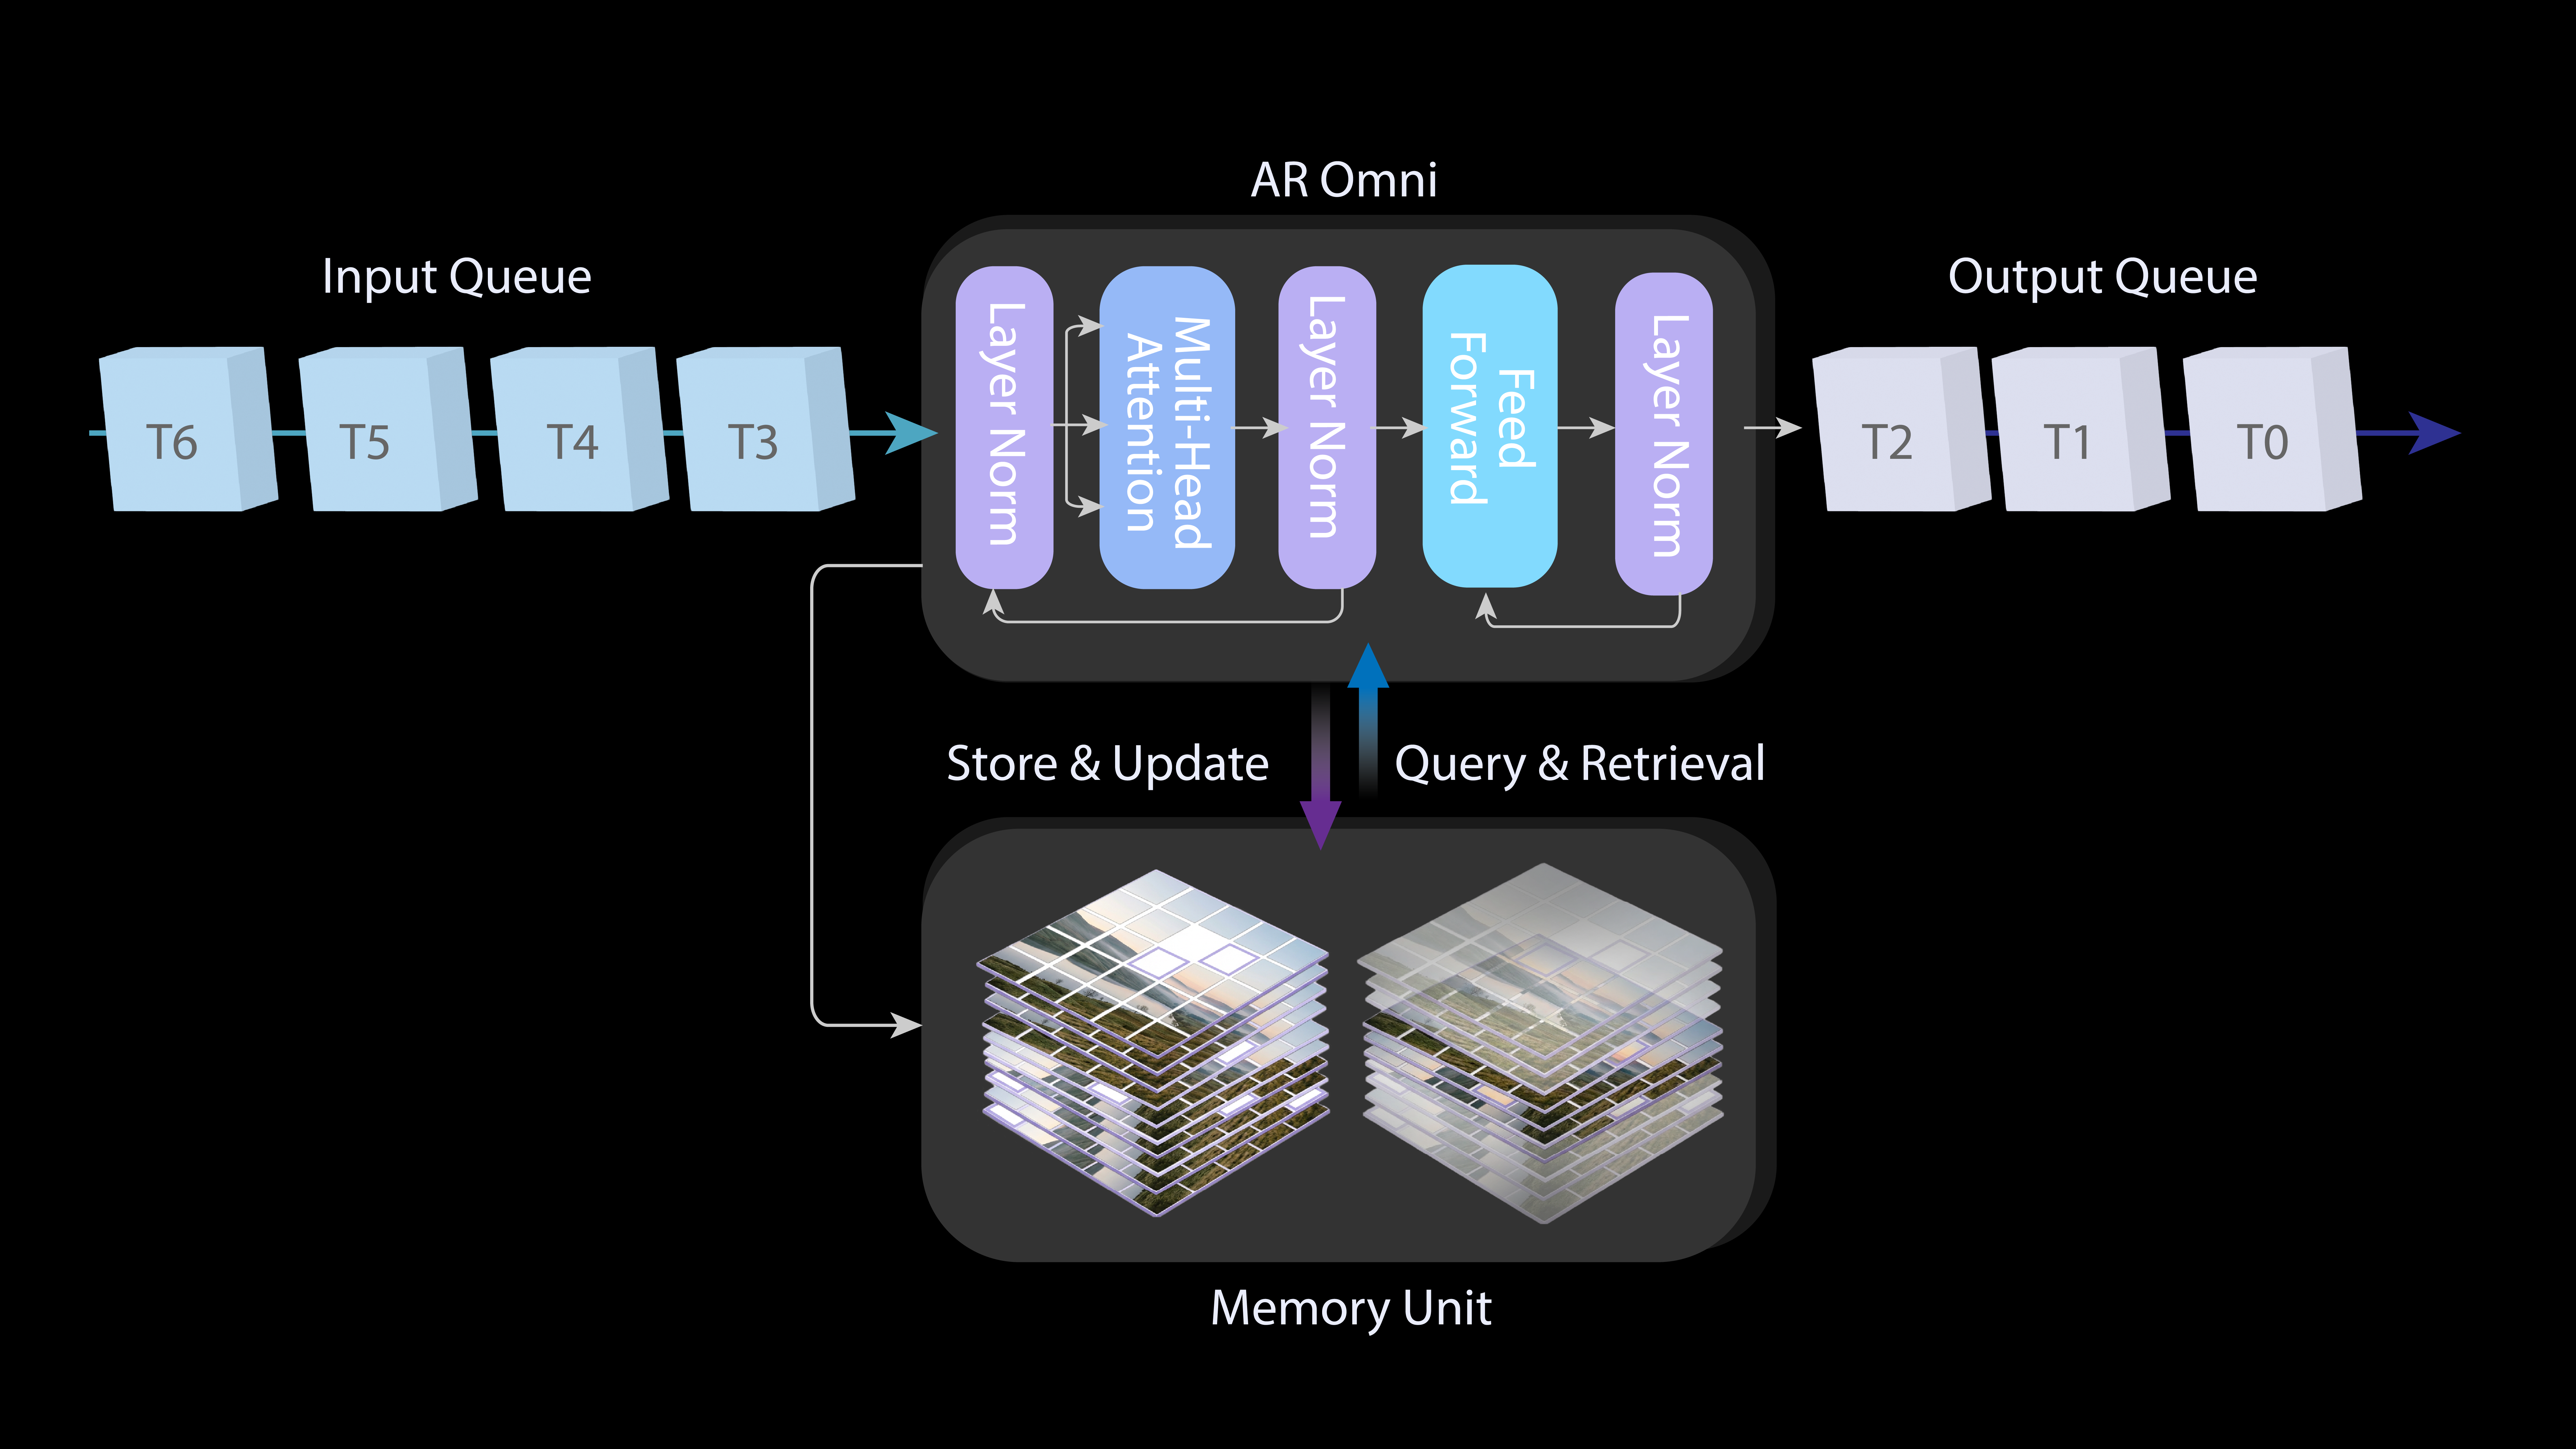
Figure 2. La modélisation autorégressive intégrée au modèle de fondation Omni.
2.3 1080P en temps réel : Moteur de réponse instantanée
Bien que le débruitage itératif assure généralement une haute qualité, sa densité de calcul entrave souvent les performances en temps réel. Pour résoudre ce problème et parvenir à une génération en temps réel à des résolutions élevées (jusqu’à 1080P), nous avons ré-architecturé le pipeline en un moteur de réponse instantanée (IRE).
L’IRE optimise le processus d’échantillonnage grâce aux avancées suivantes :
- Pliage de trajectoire temporelle : En implémentant le Direct Transport Mapping comme a priori structurel, le réseau prédit directement la distribution des données propres. Cela réduit les étapes d’échantillonnage de plusieurs dizaines à seulement 1 à 4, créant une voie simplifiée essentielle pour une latence ultra-faible.
- Rectification de guidage : Nous contournons la surcharge d’échantillonnage du Classifier-Free Guidance en fusionnant les gradients conditionnels dans le modèle étudiant.
- Attention éparse adaptative : Cela atténue la redondance des dépendances à longue portée, produisant un graphe de calcul condensé qui facilite davantage la réalisation d’une génération 1080P en temps réel.
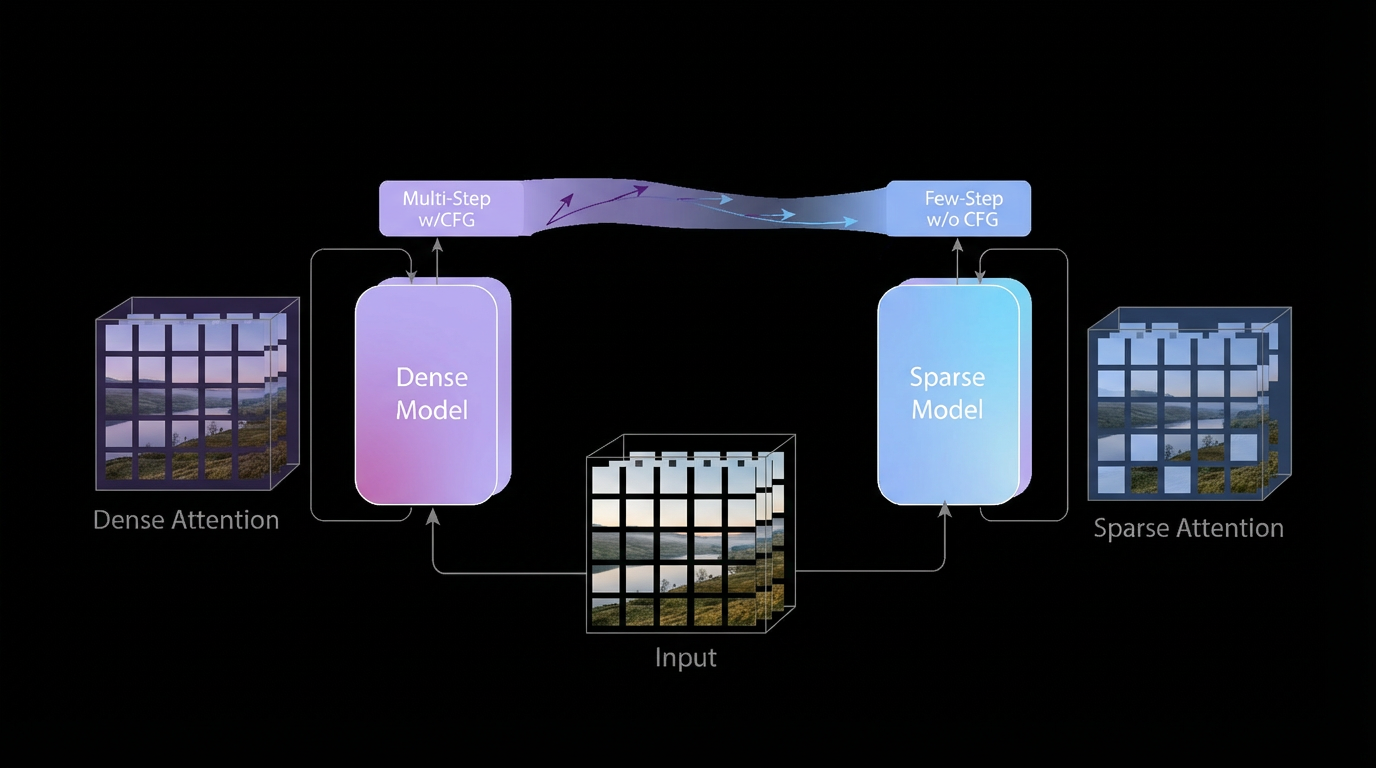
Figure 3. Le moteur de réponse instantanée se compose de trois modules : pliage de trajectoire temporelle, rectification de guidage et apprentissage par attention éparse adaptative.
3. Applications et impact social
PixVerse-R1 introduit un nouveau support génératif : des systèmes audiovisuels en temps réel, continus et avec état. Contrairement à la vidéo pré-rendue, ce support fonctionne comme un processus persistant qui répond instantanément à l’intention de l’utilisateur, où la génération et l’interaction sont étroitement couplées. Ce nouveau support permet une large classe de systèmes interactifs, incluant mais sans s’y limiter :
-
Médias interactifs
- Jeux natifs IA et expériences cinématographiques interactives
- VR/XR en temps réel et simulations immersives
-
Systèmes créatifs et éducatifs
- Art médiatique adaptatif et installations interactives
- Environnements d’apprentissage et de formation en temps réel
-
Simulation et planification
- Recherche expérimentale et exploration de scénarios
- Simulations industrielles, agricoles et écologiques
Au-delà des applications spécifiques, PixVerse-R1 fonctionne comme un simulateur de monde audiovisuel continu, réduisant la distance entre l’intention humaine et la réponse du système, et permettant de nouvelles formes de co-création humain-IA au sein d’environnements numériques persistants.
4. Conclusion
PixVerse-R1 introduit un cadre génératif en temps réel qui surmonte les limitations inhérentes aux flux de travail vidéo traditionnels grâce à des innovations architecturales dans le traitement multimodal et la réponse instantanée. En permettant une génération cohérente en temps réel, ce modèle marque une évolution significative dans la création et l’expérience de médias audiovisuels. Le passage à une latence en temps réel permet une transition de la consommation de contenu statique à l’interaction avec un environnement dynamique, fournissant un substrat informatique évolutif pour des applications allant du jeu IA natif aux simulations industrielles complexes. En comblant le fossé entre l’intention de l’utilisateur et le retour visuel instantané, le système établit une nouvelle frontière pour la modélisation de mondes interactifs et les environnements de collaboration humain-IA.
5. Limitations
Bien que PixVerse-R1 offre des avantages de modélisation significatifs, deux contraintes primaires persistent concernant la précision temporelle et la fidélité physique :
- Accumulation d’erreurs temporelles : Sur des séquences étendues, des erreurs de prédiction mineures peuvent s’accumuler, compromettant potentiellement l’intégrité structurelle de la simulation.
- Compromis Physique vs Calcul : Pour réussir la génération en temps réel, des sacrifices spécifiques ont été faits concernant la complexité de la génération. Par conséquent, il peut y avoir un certain degré de perte dans le rendu précis de certaines lois physiques par rapport aux modèles non temps réel.