如何用 AI 保持角色一致:PixVerse V6 指南
一致角色 AI(Consistent character AI)指的是在多次獨立的影片生成中,儘量保持面部特徵、體態與服裝選擇一致的工作流。由於 AI 影片模型不會「記住」上一段成片,每一次生成都相當於從零開始,因此學習如何用 AI 建立一致角色,關鍵不在於一句萬能提示詞,而在於可複用的錨點。在怪模型之前,為控制角色漂移,你需要用三類約束穩住生成:詳盡的書面角色表、清晰的參考圖,以及每次嚴格相同順序的關鍵詞。
本指南將涵蓋的內容:
下文將拆解維持角色穩定性所需的具體流程,主要包括:
- 常見陷阱: 生成過程中容易失效的原因,以及如何糾正漂移。
- 提示詞最佳實踐: 我日常依賴的提示詞習慣與外貌細節記錄方式。
- PixVerse V6 的優勢: 以「實測」方式對照行業常見痛點與 PixVerse V6 的應對方式。
- PixVerse 分步操作: 在平台上鎖定角色身份的可執行步驟。
- 提示詞示例與成片觀察: 真實提示詞搭配簡短的輸出說明。
- 資源與模式: 關於積分與選擇合適生成模式的思路。
理解 AI 角色一致性:角色漂移為何發生
真實的「一致」是什麼
在 AI 影片裡,一致性指觀眾能立刻認出鏡頭 A 與鏡頭 B 是同一人。髮色、下頜線、年齡感與服裝等核心身份標記必須始終落在可辨認的範圍內。輕微漂移會讓觀眾覺得突然換角;嚴重漂移則徹底破壞敘事沉浸。
為什麼擴散模型通不過一致性考驗
文字轉影片擴散模型在每一幀都會從零重建主體。若在不同提示之間換掉形容詞,或在專案中途更換模型,就等於把陌生人請進畫面。只靠文字是最弱的錨點。要鎖定身份,必須依靠參考靜幀與精心重複的文字塊共同形成的更強引力。
生成前的藍圖
在點選生成前,先建立基線:用一段緊湊文字寫清面部與髮型,一行寫預設服裝,一行寫體型(如需要)。儲存在獨立筆記檔案中。這份主文件就是你用 AI 建立一致角色的基礎藍圖。機位、光線與環境可以隨場景變化,但這段身份描述除非你刻意寫換裝,否則不應改動。
穩定 AI 角色的提示詞框架
在開啟生成介面之前,你就需要嚴格的提示詞紀律。專業流程依賴四條不可妥協的習慣,以減少幻覺並保持控制:
- 身份優先於動作(固定順序): 先寫透角色描述,再搭建場景。提示詞務必以主體身份起筆,其次是動作、環境,最後是風格或技術參數(如機位與光線)。
- 鎖定用詞: 一致性要求措辭完全一致。若你把頭髮定為「及肩深棕」,下一段就不要隨口改成「深褐發」。模型會把它們當成不同的視覺 token。
- 善用負面提示: 只要介面支援,就明確列出不要出現的內容:錯誤的年齡段、角色不戴眼鏡卻出現眼鏡、用「畫面中不要出現兩張臉」等短語保持畫面乾淨。
- 建立並複製範本: 不要憑記憶重寫提示。把最穩定、最成功的提示存成母版文本。每次新建任務都複製它,核心身份塊完全不動,只改與場景相關的動作行。
實測手記:標準工作流為何在角色一致性上失效
我們測試了多款主流文字轉影片棧,看它們能否在多鏡頭中維持同一位主角。儘管我們在提示詞工程上已盡力,仍反覆撞上同樣的技術牆。
下表歸納了我們遇到的四個主要摩擦點:
| 痛點 | 畫面結果 |
|---|---|
| 時長上限 | 被迫拼接短片段,每到接縫身份都會「扭曲」。 |
| 純文字限制 | 沒有視覺錨點時,面部幾何(眼距、鼻型等)持續漂移。 |
| 連貫性斷裂 | 從全景切到特寫,像換了演員卻只換了相似衣服。 |
| 工作流摩擦 | 提示詞字數過低且音畫割裂,複雜敘事幾乎難以實現。 |
轉折點:我們為何轉向 PixVerse
我們意識到需要的不是「更好的提示詞」,而是更聰明的影片引擎。我們開發 PixVerse V6,正是因為在各地測試中一再撞上這些瓶頸。我們構建了一條從第一幀起就把身份寫進生成流程的工作流,而不是在每一鏡裡跟模型搏鬥才能把臉穩住。
我們把同一測試專案遷到 PixVerse V6。下文對照上文各條問題,說明產品能力如何對應。細節與我們對外的 V6 評測及內部產品說明一致。
- 短片段與接縫 → 單次生成可更長(最長約 15 秒)、最高約 1080p,並支援 16:9 至 9:16 等常見畫幅。被迫剪輯更少,調色與臉型在檔案之間「重置」的機會也更少。
- 純文字導致的身份漂移 → 文字轉影片與圖片轉影片在同一流程裡。同一段身份描述加上清晰的肖像作起始幀,比純文字更容易把臉鎖在合理範圍。
- 孤立鏡頭與弱跨鏡邏輯 → 內建多鏡頭讓你在需要多機位時,可在同一次任務裡描述多段節拍或角度,世界與服裝不會像硬拼多段匯出那樣反覆重置。
- 提示詞太擠 → 較長的提示預算讓「角色段」和「場景段」能寫在同一處,減少在備忘錄與介面之間來回搬運。
- 音畫分離 → 原生音訊與畫面同一次渲染,環境聲與表演可以在同一輪裡描述,不必再去別的工具裡對同步。
- 表情驅動的敘事 → 模型在布料、重量與面部動作上更可信,當故事靠特寫表演而不是隻有大全景時,這一點很重要。
- 迭代成本 → Web 端支援預覽類與錯峰類模式,在願意花積分做全長渲染之前,可以用更省積分的方式多試幾版。
因此下文操作步驟以 PixVerse V6 為主,但前幾節的通用習慣在任何工具裡都適用。
如何用 PixVerse V6 生成角色一致的影片
- 登入 PixVerse 帳號。
- 在創作面板進入 影片 分割槽。
- 在模型列表中選擇 PixVerse V6。
- 設定參數:時長、畫幅、解析度,以及是否開啟音訊。若介面有運動強度等選項,首版太猛時可以調低再生成。
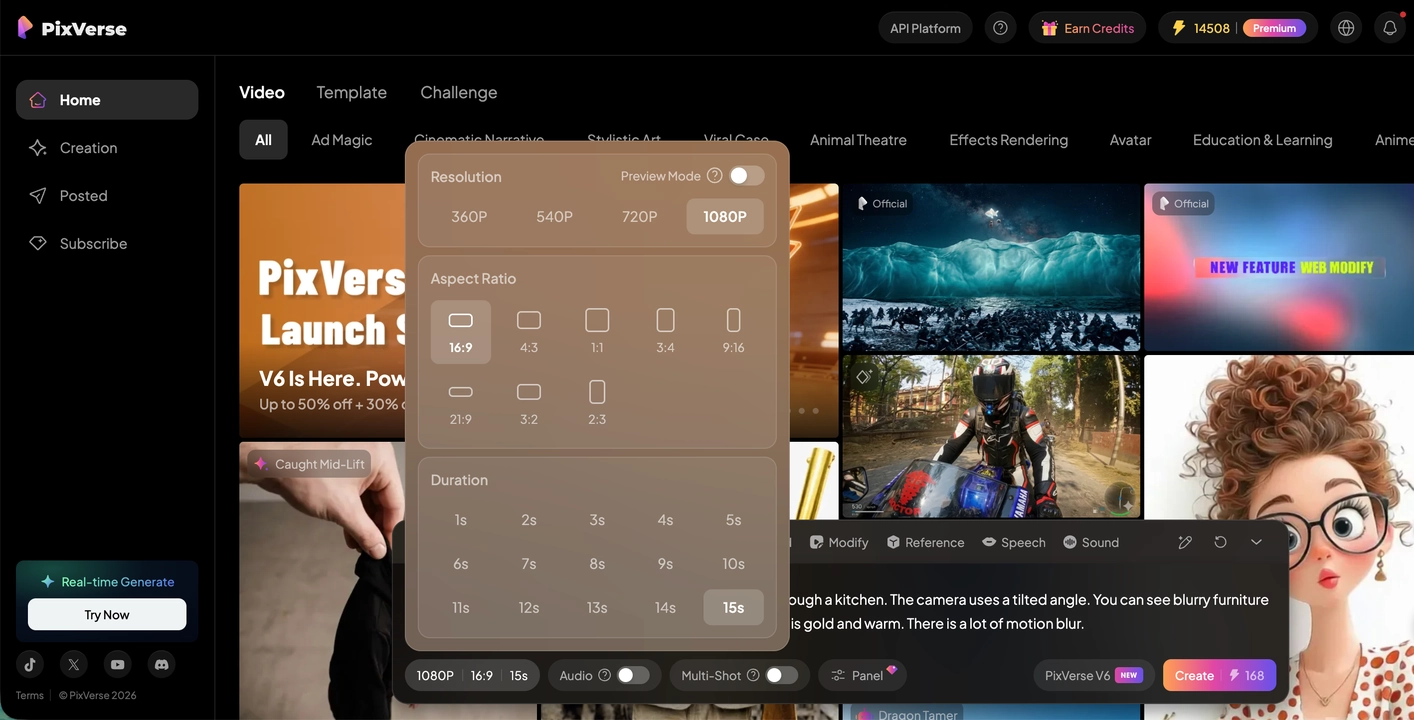
- 輸入提示 —— 描述角色與場景。若已有滿意的肖像,可作為圖片轉影片的起始幀上傳。若產品提供多鏡頭或分鏡欄位,可在同一次任務裡寫多個角度;重複相同的核心外貌描述通常有助於對齊。
- 點選生成 並檢查成片。
若純文字仍讓臉漂移,一張清晰的參考靜幀往往比堆形容詞更有效。
可執行的 AI 角色一致性提示詞(含影片成片)
以下中文提示與內部 V6 測試一致。每個場景均附有樣片匯出。
窗邊的情緒特寫
Prompt:
一位年輕女子站在窗邊,透過玻璃望向窗外的世界。她的眼睛微微泛紅。鏡頭緩緩推近。她的呼吸略急促。她咬著嘴唇。她的眼裡閃著淚光。她的身體因情緒而微微顫抖。
我們的觀察:同一主靜幀帶隊圖片轉影片時,身份更穩;眼寬與下頜在兩次重跑之間仍在合理範圍。不用靜幀、純文字重跑時,下頜更「軟」、雙眼皮褶皺不同。運動較緩,一致角色質量主要受參考紀律限制,而不是運動模糊。
持扇的悲傷表情
Prompt:
女孩緊鎖眉頭,十分悲傷。淚水從雙眼緩緩滑落。她用摺扇遮住下半張臉,只露出雙眼。
我們的觀察:半臉遮擋是壓力測試。摺扇位置在多次嘗試間一致時,眼周身份更穩。只改提示裡扇子的顏色時,臉頰明暗會有輕微變化。經驗:若配飾是識別錨點,各段提示裡配飾措辭要保持一致。
舞蹈並以面部收尾
Prompt:
低角度鏡頭向上仰拍,一位身著傳統中式服裝的女子正在表演古典舞。鏡頭移近,特寫她的臉。她對著鏡頭微笑並眨眼。
我們的觀察:大肢體動作再加面部收尾時,多鏡頭更有用:一次生成能在特寫前儘量穩住服裝與頭髮。我們仍會對比眨眼前後的眉形。有一次生成出現輕微不對稱;社交短片可接受,不適合當主視覺海報。
一致角色 AI 生成器:PixVerse 在工具棧中的位置
實踐裡 PixVerse 可以當作一致角色向的 AI 生成棧,因為影像、影片與參考驅動模型共用同一帳號。V6 負責敘事短片路徑;同平台上的其他模型承擔不同工種。並不是用一個勾選項就能選出所謂「全球最強一致角色 AI」,而是按交付物選模式:先靜幀,再 V6 做動態,需要比單張 JPG 更多錨點時再走重參考的影片模型。
常見問題
什麼是一致角色 AI?
指在多次生成之間保持視覺身份穩定的流程,通常是一段文字說明加參考素材。
預算有限時如何用 AI 做出一致角色?
先用每日積分驗證參考圖與固定措辭,再提高時長或解析度。
PixVerse V6 是否適合所有專案裡「最佳」的一致角色方案?
對有原生多鏡頭與音訊的短影片,它是很強的預設選項。只做靜態的專案可以留在影像工具裡。按交付物選工具。
每日積分、免費額度與定價如何影響一致角色工作流?
新帳號通常會獲得可在影片創作中使用的每日積分。請先用它們演練參考靜幀與固定提示詞塊,再提高時長或解析度。零成本、無上限的頂規格並不現實。在向客戶承諾交期前,請在應用內檢視即時定價與單次生成積分消耗(例如「建立」旁顯示的費用)。
結論
真正的角色一致性不是靠一句「魔法提示詞」,而是一套可工程化的流程。在 PixVerse,我們將圖片轉影片管線視為從全景到極特寫鎖定身份不可退讓的基礎。請不要再把提示詞當成彩票,而應把它當作僵硬的結構藍圖。在預覽模式裡驗證鏡頭、在動主角色表之前先排查鏡頭邏輯,就能去掉猜測。我們認為角色一致性不該靠運氣——它應當是可以預測、可以規模化的體系。