Cách tạo nhân vật nhất quán bằng AI: Hướng dẫn PixVerse V6
Consistent character AI là quy trình giữ nguyên đặc điểm khuôn mặt, dáng người và lựa chọn trang phục qua nhiều lần tạo video riêng biệt. Vì mô hình video AI không nhớ các clip trước và coi mỗi lần tạo là một khởi đầu mới, việc học cách tạo nhân vật nhất quán bằng AI dựa vào các điểm neo chiến lược chứ không phải một “prompt thần kỳ” duy nhất. Để ngăn nhân vật lệch trước khi đổ lỗi cho mô hình, bạn phải neo các lần tạo bằng ba yếu tố cốt lõi: bảng mô tả nhân vật viết chi tiết, ảnh tham chiếu chính xác, và thứ tự từ khóa được cố định nghiêm ngặt.
Bạn sẽ học gì trong hướng dẫn này:
Trong phần phân tích này, chúng tôi khám phá các quy trình cần để giữ nhân vật ổn định. Đây là những gì chúng tôi đề cập:
- Lỗi thường gặp: Những gì thường hỏng khi tạo và cách sửa hiện tượng lệch.
- Thực hành prompt tốt: Thói quen viết prompt và kỹ thuật ghi chi tiết ngoại hình mà tôi dùng mỗi ngày.
- Lợi thế của PixVerse V6: Một bài thử kiểu thực địa so sánh các điểm đau phổ biến trong ngành với cách PixVerse V6 giải quyết chúng.
- Quy trình PixVerse từng bước: Các bước cụ thể để khóa danh tính nhân vật trên nền tảng.
- Ví dụ prompt và phân tích: Prompt thực tế kèm ghi chú ngắn về kết quả.
- Quản lý tài nguyên: Cách nghĩ về credit và chọn đúng chế độ tạo.
Hiểu tính nhất quán nhân vật AI: Vì sao nhân vật bị lệch
Thực tế của sự nhất quán thật Trong tạo video AI, nhất quán nghĩa là khán giả nhận ra ngay cùng một chủ thể khi chuyển từ cảnh A sang cảnh B. Các dấu hiệu nhận dạng cốt lõi—màu tóc, đường hàm, độ tuổi biểu kiến và trang phục—phải nằm chặt trong một phạm vi có thể nhận ra. Một lệch hình nhỏ khiến người xem cảm giác như vừa thay diễn viên; một lệch lớn thì phá hoàn toàn sự đắm chìm vào câu chuyện.
Vì sao mô hình diffusion trượt bài kiểm tra nhất quán Các mô hình diffusion text-to-video dựng lại chủ thể của bạn từ đầu ở từng khung hình. Nếu bạn đổi tính từ giữa các prompt hoặc đổi mô hình giữa dự án, về cơ bản bạn đang mời một người lạ vào cảnh. Chỉ dựa vào chữ là điểm neo yếu nhất. Để khóa danh tính, bạn phải dựa vào lực hút mạnh hơn của ảnh tĩnh tham chiếu kết hợp với các khối chữ được lặp lại tỉ mỉ.
Bản thiết kế trước khi tạo Trước khi nhấn generate, bạn phải lập một đường cơ sở. Ghi một đoạn ngắn chặt về đặc điểm khuôn mặt và tóc, một dòng cụ thể cho trang phục mặc định, và một dòng cho vóc dáng. Lưu vào một file ghi chú riêng. Tài liệu chủ này là bản thiết kế nền để tạo nhân vật nhất quán bằng AI. Góc máy, ánh sáng và bối cảnh sẽ đổi theo cảnh, nhưng khối danh tính này không đổi trừ khi bạn cố ý viết kịch bản thay trang phục.
Khung prompt cho nhân vật AI ổn định
Trước cả khi mở giao diện tạo, bạn cần kỷ luật prompt nghiêm ngặt. Quy trình chuyên nghiệp dựa trên bốn thói quen không thương lượng để ngăn ảo giác và giữ quyền kiểm soát:
- Ưu tiên danh tính hơn hành động (thứ tự cố định): Nắm mô tả nhân vật trước, rồi mới dựng cảnh. Luôn mở prompt bằng danh tính chủ thể, tiếp theo là hành động, môi trường, và cuối cùng là thông số phong cách hoặc kỹ thuật (như góc máy và ánh sáng).
- Khóa từ vựng: Nhất quán đòi hỏi cách diễn đạt giống hệt. Nếu bạn xác lập tóc nhân vật là “shoulder-length dark brown”, đừng tùy tiện đổi thành “brunette” ở clip sau. AI coi đây là các token hình ảnh khác nhau.
- Khai thác negative prompt: Bất cứ khi nào giao diện cho phép, hãy liệt kê rõ những gì không được xuất hiện. Cấm sai nhóm tuổi, cấm “glasses” nếu nhân vật không đeo kính, và thêm các cụm như “duplicate faces” để khung hình sạch.
- Xây và nhân bản template: Đừng viết prompt từ trí nhớ. Lưu prompt ổn định, thành công nhất thành template văn bản chủ. Nhân bản nó cho mỗi lần tạo mới, để nguyên hoàn toàn khối danh tính cốt lõi, và chỉ sửa ở các dòng hành động riêng của cảnh.
Vì sao quy trình chuẩn thất bại ở tính nhất quán nhân vật
Chúng tôi đưa vài stack text-to-video hàng đầu vào thử để xem chúng có giữ được một nhân vật chính qua nhiều cảnh không. Dù đã cố hết sức với prompt engineering, chúng tôi vẫn liên tục đụng cùng những bức tường kỹ thuật đó.
Bảng sau tóm tắt bốn điểm ma sát chính mà chúng tôi gặp:
| Điểm đau | Kết quả hình ảnh |
|---|---|
| Giới hạn thời lượng | Danh tính méo ở mỗi đường nối vì chúng tôi buộc phải ghép các clip ngắn. |
| Giới hạn chỉ dùng chữ | Hình học khuôn mặt (khoảng cách mắt, hình mũi) liên tục đổi khi không có neo hình ảnh. |
| Liên tục bị gãy | Cắt từ toàn cảnh sang cận cảnh giống như vừa thay diễn viên trong bộ đồ tương tự. |
| Ma sát quy trình | Giới hạn prompt thấp và âm thanh tách rời khiến kể chuyện phức tạp gần như không thể. |
Bước ngoặt: Vì sao chúng tôi chuyển sang PixVerse
Chúng tôi nhận ra mình không cần “prompt tốt hơn”—mà cần một engine video thông minh hơn. Chúng tôi phát triển PixVerse V6 vì liên tục gặp đúng những nút thắt đó ở mọi nơi thử nghiệm. Chúng tôi xây một quy trình trong đó danh tính được gắn vào quá trình tạo ngay từ khung hình đầu, thay vì thứ phải vật lộn lấy ra khỏi mô hình từng cảnh một để giữ khuôn mặt nhất quán.
Chúng tôi chuyển cùng dự án thử sang PixVerse V6. Dưới đây chúng tôi ánh xạ khả năng sản phẩm với từng vấn đề ở trên. Chi tiết khớp với những gì chúng tôi công bố trong bài đánh giá V6 và ghi chú sản phẩm nội bộ.
- Clip ngắn và đường nối ghép → Một lần tạo có thể chạy dài hơn (tới khoảng mười lăm giây) ở tối đa 1080p, với các tỷ lệ khung phổ biến từ 16:9 đến 9:16. Ít lần cắt cưỡng bức hơn nghĩa là ít chỗ để màu và hình học khuôn mặt bị reset giữa các file.
- Lệch danh tính khi chỉ dùng chữ → Text-to-video và image-to-video nằm trong cùng một luồng. Cùng đoạn mô tả danh tính cộng một chân dung rõ làm khung bắt đầu cho chúng tôi một khuôn mặt giữ được trong phạm vi qua các job tốt hơn chỉ dùng chữ.
- Các take tách rời và logic xuyên cảnh yếu → Multi-shot tích hợp cho phép mô tả vài nhịp hoặc góc trong một job khi cảnh cần nhiều hơn một góc, nên thế giới và trang phục không bị reset như khi bạn dán các bản xuất riêng.
- Prompt chật → Ngân sách prompt lớn nghĩa là khối nhân vật và khối cảnh có thể nằm trong một trường, ít phải chuyển qua lại giữa app ghi chú và giao diện.
- Âm thanh tách khỏi hình → Âm thanh gốc đi cùng trong cùng một lần render, nên không khí và diễn xuất có thể được mô tả trong một lượt thay vì đuổi đồng bộ ở công cụ khác.
- Câu chuyện dẫn bằng biểu cảm → Mô hình được tinh chỉnh cho chuyển động đáng tin trên vải, trọng lượng và khuôn mặt, điều quan trọng khi câu chuyện được mang bởi diễn xuất cận, không chỉ bởi một cảnh thiết lập rộng.
- Chi phí lặp → Web hỗ trợ xem trước và các chế độ kiểu giờ thấp điểm khi chúng tôi muốn các lượt rẻ hơn trước khi dùng credit cho một bản render đủ độ dài.
Trải nghiệm đó là lý do các bước dưới đây được viết quanh PixVerse V6, dù các thói quen ở các phần trước áp dụng ở mọi nơi.
Cách tạo video nhân vật nhất quán với PixVerse V6
- Đăng nhập vào tài khoản PixVerse của bạn.
- Vào mục Video trong bảng tạo.
- Chọn PixVerse V6 từ danh sách mô hình.
- Đặt thông số: thời lượng, tỷ lệ khung, độ phân giải, và bạn có muốn bật âm thanh không. Chỉnh cường độ chuyển động hoặc các điều khiển tương tự nếu giao diện có và take đầu cảm giác quá mạnh.
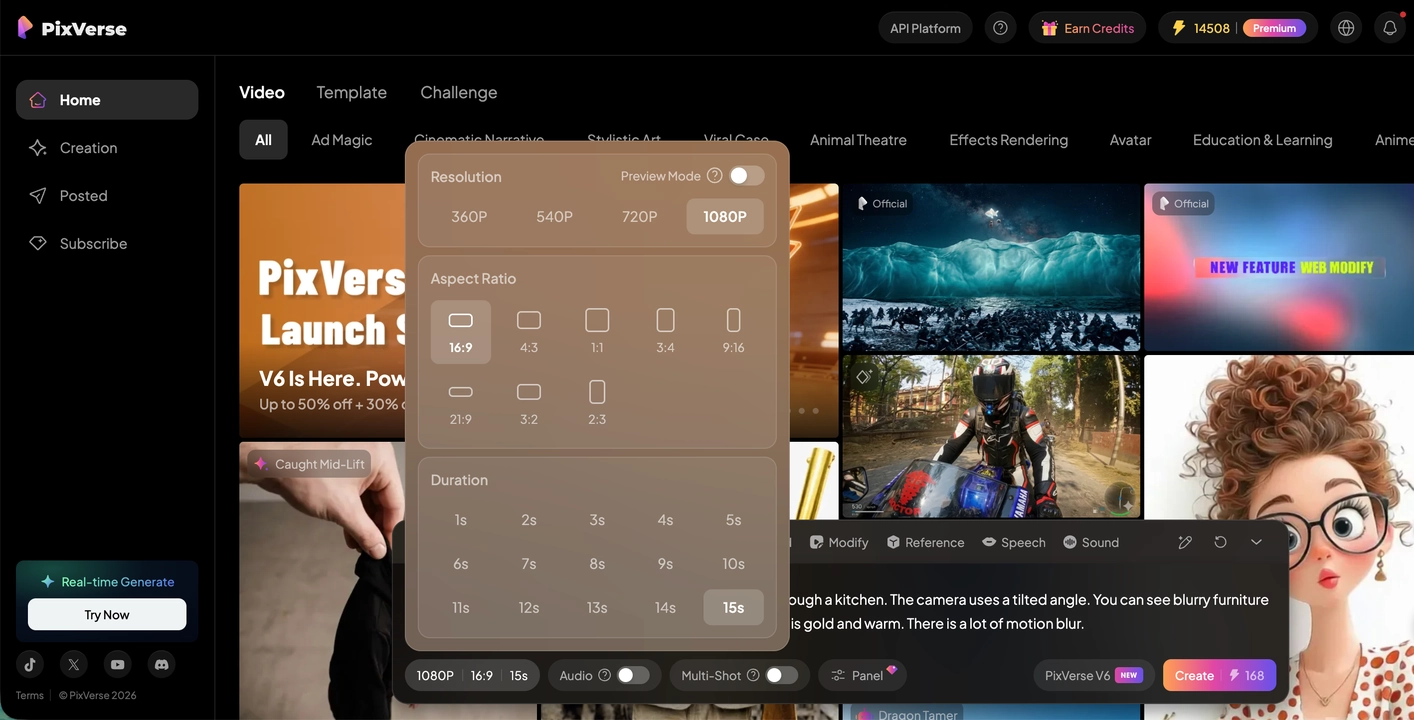
- Nhập prompt — mô tả nhân vật và cảnh. Nếu bạn đã có một chân dung ưng ý, hãy tải lên làm khung bắt đầu cho image-to-video. Nếu sản phẩm có multi-shot hoặc các trường theo từng cảnh, bạn có thể mô tả nhiều hơn một góc trong một job; lặp lại các dòng ngoại hình cốt lõi thường giúp mô hình giữ được sự thẳng hàng.
- Nhấn Generate và xem kết quả.
Nếu các lần chỉ dùng chữ vẫn lệch khuôn mặt, một ảnh tĩnh tham chiếu rõ thường ổn định danh tính hơn là chỉnh tính từ.
Prompt có thể hành động cho tính nhất quán nhân vật AI
Các prompt dưới đây bằng tiếng Anh; PixVerse V6 cũng nhận prompt ngôn ngữ tự nhiên bằng các ngôn ngữ khác—các bản địa hóa của bài này hiển thị cùng ba tình huống đã được dịch. Các ví dụ khớp các lần chạy V6 nội bộ dùng cho thử diễn xuất khuôn mặt và vũ đạo. Bản xuất video mẫu được kèm cho từng tình huống dưới đây.
Cận cảnh cảm xúc bên cửa sổ
Prompt:
Một phụ nữ trẻ đứng bên cửa sổ, nhìn qua lớp kính ra thế giới bên ngoài. Đôi mắt cô hơi đỏ. Máy quay từ từ đẩy vào. Hơi thở của cô hơi nhanh. Cô cắn môi. Đôi mắt cô long lanh nước mắt. Cơ thể cô run lên vì cảm xúc.
Những gì chúng tôi thấy: Danh tính giữ ổn định khi cùng một ảnh chủ dẫn image-to-video. Tỷ lệ mắt và hàm nằm trong phạm vi đáng tin qua hai lần chạy lại. Không có ảnh tĩnh, một lần chạy lại chỉ bằng chữ cho hàm mềm hơn và nếp mí mắt khác. Chuyển động điềm, nên chất lượng consistent character ai bị giới hạn bởi kỷ luật tham chiếu, không phải bởi nhòe chuyển động.
Biểu cảm buồn với chiếc quạt
Prompt:
Một cô gái nhíu mày, buồn sâu sắc. Nước mắt từ từ lăn từ cả hai mắt. Cô che nửa dưới khuôn mặt bằng một chiếc quạt xếp, chỉ để lộ đôi mắt.
Những gì chúng tôi thấy: Che một phần khuôn mặt là bài kiểm tra áp lực. Mô hình giữ danh tính vùng mắt khi vị trí quạt khớp giữa các lần thử. Khi chúng tôi chỉ đổi màu quạt trong prompt, bóng má lệch nhẹ. Bài học: giữ nguyên cách diễn đạt phụ kiện qua các clip nếu phụ kiện là tín hiệu nhận diện.
Vũ đạo kết bằng khuôn mặt
Prompt:
Máy quay góc thấp nghiêng lên khi một người phụ nữ mặc trang phục truyền thống Trung Quốc biểu diễn múa cổ điển. Máy quay chuyển vào cận cảnh khuôn mặt cô. Cô mỉm cười và nháy mắt vào ống kính.
Những gì chúng tôi thấy: Chuyển động cơ thể lớn cộng phần kết bằng khuôn mặt là chỗ multi-shot giúp ích: một lần tạo có thể giữ trang phục và tóc qua các nhịp trước cảnh cận. Chúng tôi vẫn so hình lông mày trước và sau cái nháy mắt. Một lần chạy xuất hiện bất đối xứng nhẹ; chấp nhận được cho mạng xã hội, không dành cho poster chủ lực.
FAQ
Consistent character AI là gì?
Bất kỳ pipeline nào giữ danh tính hình ảnh ổn định qua các lần tạo, thường bằng một khối chữ cộng ảnh tham chiếu.
Làm sao tạo nhân vật nhất quán bằng AI khi không có ngân sách lớn?
Dùng credit hằng ngày để xác nhận ảnh tham chiếu cộng văn bản cố định trước khi bạn tăng thời lượng hoặc độ phân giải.
PixVerse V6 có phải AI tốt nhất cho nhân vật nhất quán với mọi dự án không?
Đây là lựa chọn mặc định mạnh cho video ngắn có multi-shot và âm thanh. Các pipeline chỉ tĩnh có thể ở lại công cụ ảnh. Hãy khớp công cụ với sản phẩm bàn giao.
Credit hằng ngày, truy cập miễn phí và giá khớp thế nào vào quy trình nhân vật nhất quán?
Tài khoản mới thường nhận credit hằng ngày để dùng trong trình tạo video. Hãy dùng chúng để tập ảnh tĩnh tham chiếu và các khối prompt cố định trước khi tăng thời lượng hoặc độ phân giải. Đầu ra hạng cao nhất không giới hạn với chi phí bằng không là không thực tế. Kiểm tra giá và chi phí credit trực tiếp trong ứng dụng—hiển thị cạnh các thao tác như Create—trước khi hứa ngày bàn giao với khách hàng.
Kết luận
Tính nhất quán nhân vật thật không phải kết quả của một prompt thần kỳ; đó là một quy trình được thiết kế. Tại PixVerse, chúng tôi coi pipeline Image-to-Video là nền tảng không thương lượng để khóa danh tính từ cảnh rộng đến cực cận. Đừng coi prompt như vé số và hãy bắt đầu dùng chúng như bản thiết kế cấu trúc cứng. Bằng cách xác nhận các cảnh ở chế độ xem trước và xử lý logic máy quay trước khi từng đụng vào bảng nhân vật chủ, bạn loại hoàn toàn việc đoán mò. Chúng tôi tin tính nhất quán nhân vật không nên là một canh bạc—nó phải là một hệ thống có thể dự đoán và mở rộng.