Seedance 2.0 评测:功能、提示词与 2026 年替代方案
Seedance 2.0 于 2026 年 2 月初发布,48 小时内就席卷了 X 和 Reddit。创作者们发布的片段看起来像是出自专业制作工作室,而不是 AI 模型的产物。跑分同样支持了这波热度:文生视频 ELO 1,269 分,图生视频 1,351 分,发布时便领先于可灵 3.0、Veo 3 和 Runway Gen-4.5。
两个月后,热度已经平息。我们花了数周时间在不同场景下测试 Seedance 2.0——电影场景、产品广告、人像、奇幻序列——并阅读了数百篇社区帖子,试图区分哪些是真正好用的功能,哪些只是演示视频里好看而已。这篇评测将覆盖该模型的优势、不足、真实用户的评价、与前代及竞品的对比,以及六个可以立即测试的提示词用例。
核心要点:
- Seedance 2.0 最多支持 12 个混合输入(文本、图像、视频、音频),可生成 4-15 秒、最高 2K 分辨率、带原生音频的视频片段。
- 相较 Seedance 1.0,镜头运动、角色一致性和手部/肢体渲染都有明显提升。
- 中国大陆以外地区的访问仍是痛点。激进的内容审核和对普通用户而言较陡峭的学习曲线是常见的抱怨。
- Seedance 2.0 现已登陆 PixVerse,你可以在同一个平台上与 PixVerse V6、可灵、Veo 等模型一起体验,无需切换平台。
- 字节跳动的下一代模型 Seedance 2.5 已经出现在合作平台上,号称支持 30 秒长片段和 50 个参考输入——查看我们的 Seedance 2.5 详解,了解哪些信息已被验证、哪些还未证实。
什么是 Seedance 2.0?
Seedance 2.0 是字节跳动打造的多模态 AI 视频模型,于 2026 年 2 月 7 日发布,是一次从零开始的重建,而非对 Seedance 1.0 的小幅升级。
上一代版本通过独立的管线分别处理文本和图像。Seedance 2.0 用统一的多模态扩散 Transformer 取而代之,将文本、图像、音频和视频编码进同一个共享表示空间。这在实际使用中意味着,模型可以接收一段文本提示、一张角色参考照片、一段展示你想要的镜头运动的视频片段,以及一段音轨——然后将所有这些融合进单次生成的输出中。
该模型每次生成最多支持 12 个参考素材:9 张图像、3 段视频和 3 个音频文件。你可以用 @ 语法在提示词中标记它们(@image1、@video1 等),精确告诉模型每个参考应该应用在哪里。
输出规格:4-15 秒视频,最高 2K 分辨率,原生立体声音频与画面同步生成。
Seedance 2.0 的亮点:它擅长什么
多模态输入与 @引用系统
引用系统是最大的亮点功能。你不必把一切都用文字描述出来、指望模型正确理解,而是可以直接展示你想要的东西。上传一张人脸照片并在提示词中标记为 @image1,添加一段展示你想要的镜头轨迹的视频片段,再加入一段背景音乐音轨。模型会读取每个引用,并将其应用到你指定的位置。
这在多次生成之间保持角色一致性方面表现尤为出色。上传同一张人脸参考图,角色的外观就能保持一致——这在大多数竞品模型上仍然需要额外的变通方法。
电影级镜头表现
在我们测试过的模型中,Seedance 2.0 处理镜头运动的方式更加自然。跟踪镜头、推近镜头和缓慢环绕运镜显得流畅且有意图,而不是随机的。一位 Reddit 用户报告说,他重现了美剧《人生切割术》(Severance)中的镜头运动,效果“惊人地准确”。
模型对提示词中具体的镜头语言反应很好:“从中景缓慢推近至特写”或“低角度跟踪镜头”都能产生可预测的结果。像“电影感”这样模糊的指令给你的控制力较弱,但输出仍会默认为相对合理的效果。
如何在 Seedance 2.0 中控制镜头运动:
- 在提示词中使用精确的电影摄影术语。 不要写“移动的镜头”,而要写“从全景缓慢推近至中近景”或“低角度跟踪镜头,从左向右移动”。模型能识别标准的电影术语。
- 上传 @video 参考,展示你想要的运镜方式。 录制一段粗略的片段(即使是用手机拍的)展示运镜轨迹,标记为
@video1,并在提示词中描述:“镜头跟随 @video1 中展示的轨迹。” - 对复杂序列使用时间轴标注。 写成
0-4秒:静态全景建立镜头→4-8秒:缓慢推近至中景→8-12秒:环绕主体运镜。模型会将每个片段作为一个连贯片段的一部分生成。
与 Runway Gen-4.5 的 Motion Brush(允许区域级运动绘制)不同,Seedance 2.0 不提供逐帧的运动控制。镜头行为完全通过提示词语言和视频参考来控制——精细度较低,但迭代速度更快。
原生音视频同步
Seedance 2.0 通过联合扩散同时生成音频和视频,包括:
- 支持 7 种以上语言的对白唇形同步
- 与画面动作时间对齐的音效
- 与画面氛围相匹配的环境音景和背景音乐
在我们的测试中,唇形同步质量很出色——明显优于后期配音工具。它并不完美,但在大多数情况下省去了单独制作音频管线的需要。
时序一致性与物理真实感
角色和物体在多帧之间保持形状一致,几乎没有闪烁。手部渲染——历来是 AI 视频的薄弱环节——相较 1.0 有大幅改善。手指数量更常保持正确,肢体运动看起来有重量感而非漂浮感。
布料垂坠、水的表现和碰撞物理都显得更加扎实。这对任何超越抽象视觉效果的内容都很重要。如果你在制作产品广告或角色驱动的叙事内容,可信的物理效果决定了“令人印象深刻的 AI 演示”和“可用素材”之间的差别。
多镜头叙事
你可以将提示词构建为时间轴——0-4秒:全景建立镜头、4-8秒:中景跟踪镜头等——模型会将每个片段生成为一个连贯的序列。角色保持一致,镜头之间的转场流畅而不生硬。
这是一次真正的工作流转变。早期模型需要你单独生成每个镜头,再在后期拼接。Seedance 2.0 原生处理镜头序列。
视频内编辑
你可以在不重新生成整段视频的情况下,替换现有视频中的角色或物体。需要更换角色的服装?替换背景?模型会修改目标元素,同时保持其他部分不变。这在大多数竞品模型上都不可用,能节省大量迭代时间。
Seedance 2.0 一览
| 规格 | 详情 |
|---|---|
| 开发商 | 字节跳动 |
| 发布日期 | 2026 年 2 月 7 日 |
| 架构 | 统一多模态扩散 Transformer |
| 输入 | 文本 + 最多 9 张图像 + 3 段视频 + 3 个音频文件 |
| 最高分辨率 | 2K |
| 时长 | 4-15 秒 |
| 原生音频 | 是(对白、音效、环境音、音乐) |
| 唇形同步语言 | 7 种以上 |
| 视频内编辑 | 是(角色/物体替换) |
Seedance 2.0 的不足之处
没有模型能没有权衡地发布。以下是真正重要的几点。
区域访问受限。 Seedance 2.0 主要通过字节跳动的中国生态系统(即梦 App)发布。国际用户面临验证延迟、区域锁定和支付摩擦。最简单的解决方法是通过 PixVerse 访问,这完全消除了地域限制。
内容审核较为激进。 多位用户反映,提示词因为一些无害内容而被标记。涉及人脸的生成尤其容易触发过滤器。一条 Reddit 评论总结道:“审查简直毁了 Seedance 2.0。”对于需要稳定输出的商业创意工作来说,这是一个实实在在的瓶颈。
学习曲线较陡。 如果你只想输入一句话就得到一段视频,Seedance 2.0 并不是最容易上手的起点。@引用系统、时间轴提示词和多模态输入都很强大——但需要时间来学习。评测者普遍对专业用户给出较高评分(8.5/10),而对普通用户评分较低(5/10)。
API 仍处于测试阶段。 需要稳定程序化访问的企业团队应该为破坏性更新和速率限制的意外情况做好准备。
视频内文字渲染不稳定。 如果你的场景包含屏幕文字——招牌、片头字幕、产品标签——预计结果会不稳定。这是 2026 年大多数视频模型共有的弱点,但值得注意。
不支持 LoRA。 你无法在自定义数据集上微调模型。如果你需要基础模型未覆盖的特定视觉风格或品牌外观,只能依靠提示词工程和参考图像。
每段片段最长 15 秒。 对社交内容和广告来说足够长,但对叙事作品来说偏短。多镜头提示词有所帮助,但每次生成的总时长仍上限为 15 秒。
商业授权条款不明确。 字节跳动尚未公布 Seedance 2.0 输出内容的明确商业使用权。即梦的服务条款授予了平台生成内容的使用权,但关于再分发、衍生作品和商业广告责任的具体细节并未明确说明。如果你通过 PixVerse 生成,则适用 PixVerse 的商业许可。对于高风险的商业工作——产品广告、客户交付物、广播内容——发布前请务必确认权利归属。
如何修复 Seedance 2.0 的常见错误
如果你遇到了问题,你并不孤单。以下是根据社区反馈和我们自身测试整理的最常见问题及其修复方法。
| 问题 | 可能原因 | 解决方法 |
|---|---|---|
| 提示词被标记/拒绝审核 | 与人脸相关的关键词或模糊措辞触发了内容过滤器 | 移除明确的面部描述。使用 @image 引用而非在文本中描述面部。避免将“写实肖像”这类词汇与具名人物结合使用。 |
| 黑屏或生成失败 | 提示词对所选时长/分辨率过于复杂 | 每 4-5 秒缩减为一个动作。将分辨率从 2K 降至 720p。将多镜头提示词拆分为更短的片段。 |
| 角色面部在镜头间变化 | 缺乏一致的参考锚点 | 在每次生成中都上传同一张人脸照片作为 @image1。在提示词中明确引用:“@image1 中的人物走向镜头。” |
| 音频与画面不同步 | 复杂唇形同步场景下的联合扩散不匹配 | 关闭音频重新生成,然后单独添加音频。或者简化对白,使用更短的短语。 |
| “区域不支持”或支付错误 | 即梦要求中国大陆身份验证 | 改为通过 PixVerse 访问 Seedance 2.0——无区域锁定,无需中国大陆手机号。 |
| 手部/手指扭曲变形 | 复杂的手部交互缺乏参考引导 | 添加展示你想要的手部姿势的参考图像。避免要求同时进行多次手部交互的提示词。 |
| 输出看起来“AI 感”很重或塑料感强 | 过度依赖风格关键词而缺乏物理细节支撑 | 添加物理细节:具体材质、真实光照条件、镜头类型。使用“Arri Alexa 拍摄,35mm”而非泛泛的“电影感”。 |
如果同样的提示词结构连续失败 3 次以上,问题很可能出在提示词复杂度而非平台故障上。先简化,生成,再逐步叠加复杂度。
Seedance 2.0 的价格是多少?
Seedance 2.0 在即梦上免费使用,但每日生成次数有限;在 PixVerse 上,每段 5 秒的 720p 标准模式片段需要 150 积分。以下是两种访问方式的完整定价明细。
在即梦(字节跳动原生平台)上:
| 套餐 | 月费 | 每日生成次数 | 说明 |
|---|---|---|---|
| 免费版 | $0 | 约 5-10 段/天 | 仅限中国大陆使用,需要中国大陆手机号 |
| 基础版 | 约 $9.99 | 50+ 段/天 | 更高分辨率访问权限 |
| 专业版 | 约 $29.99 | 200+ 段/天 | 优先队列 |
| 高级版 | 约 $49.99 | 无限制 | 全部功能,生成速度最快 |
在 PixVerse(全球访问,无区域锁定)上:
| 档位 | 480p | 720p | 1080p |
|---|---|---|---|
| 标准版 | 15 积分/秒 | 30 积分/秒 | 可用 |
| 快速版 | 10 积分/秒 | 20 积分/秒 | 不适用 |
一段 5 秒 720p 标准模式片段需要 150 积分。快速模式生成同样的片段只需 100 积分。Pro($9.99/月)、Premium($24.99/月)和 Ultra($49.99/月)会员均可使用 Seedance 2.0。Ultra 会员在所有生成上可享受 40% 的积分折扣。
每段 5 秒 720p 片段的成本对比:
| 模型 | 平台 | 大致成本 |
|---|---|---|
| Seedance 2.0 标准版 | PixVerse | 约 $0.75(150 积分) |
| Seedance 2.0 快速版 | PixVerse | 约 $0.50(100 积分) |
| PixVerse V6 | PixVerse | 约 $0.35(70 积分) |
| 可灵 3.0 | 可灵 | 包含在 $10/月 套餐内 |
| Hailuo AI | MiniMax | 包含在 $9.99/月 套餐内 |
| Sora 2 | OpenAI | 约 $0.50-$2.50 |
按每秒约 $0.15(720p 标准模式)计算,Seedance 2.0 的单片成本约为 PixVerse V6 的两倍,但包含多模态输入——对于那些原本需要多次参考匹配尝试或大量后期制作的项目而言,这反而是最具性价比的选择。
社区怎么说
创作者与专业人士反馈
专业创作者——电影制作人、音乐视频制作人、广告代理商——是最热情的用户群体。多模态引用系统和时间轴提示词,与他们已有的制作思维方式相契合:以镜头、参考和序列而非文字描述来思考。
一篇评测将 Seedance 2.0 对需要精细控制的创意专业人士评为 8.5/10。一位早期测试者在 X 上写道:“我的联合创始人花了一整天想实现这个效果,Seedance 2.0 只用 5 分钟就做到了。”
这款模型被描述为“像导演一样思考”——它对镜头级别的指导做出反应,而不只是生成大致符合你提示词的内容。对于已经在采用前期制作工作流的团队来说,这是一次有意义的转变。
社交媒体与论坛反响
Reddit 社区(r/SeedanceAI_Lab、r/Seedance_v2)活跃且不断壮大。最广泛传播的输出往往是那些看起来更接近真人实拍而非典型 AI 视频的电影感片段。
社交媒体上的普遍抱怨与我们自己的发现一致:境外访问困难、审核误判,以及学习提示词系统所需的时间投入。多个帖子将其比作“拥有一台强大的相机,但需要先学会手动模式才能拍出好照片”。
版权争议
发布后几天内,迪士尼就向字节跳动发出了停止令,指控 Seedance 2.0 从其训练数据中生成迪士尼角色。美国电影协会(MPA)和 SAG-AFTRA 工会都发表了公开声明。AI 生成的名人形象病毒式传播的视频火上浇油。
这是整个 AI 视频领域都存在的法律问题,并非 Seedance 2.0 独有。但如果你打算将该模型用于涉及知名角色或肖像的商业工作,这一点值得持续关注。
Seedance 2.0 与 Seedance 1.0:有哪些变化
从 1.0 到 2.0 是一次完整的架构重建。以下是它们的对比:
| 功能 | Seedance 1.0 | Seedance 2.0 |
|---|---|---|
| 架构 | 独立的文本和图像管线 | 统一多模态扩散 Transformer |
| 文本输入 | 支持 | 支持 |
| 图像输入 | 单张可选图像 | 最多 9 张图像,支持 @标签控制 |
| 视频输入 | 不支持 | 最多 3 段参考视频 |
| 音频输入 | 不支持 | 最多 3 个音频文件 |
| 原生音频输出 | 不支持 | 支持(对白、音效、环境音、音乐) |
| 最高分辨率 | 1080p | 2K |
| 时长 | 5-10 秒 | 4-15 秒 |
| 多镜头 | 基础功能 | 具备跨镜头一致性的时间轴分镜 |
| 手部/肢体质量 | 常见瑕疵 | 明显改善 |
| 视频内编辑 | 不支持 | 支持(角色/物体替换) |
| 可用输出率 | 约 60% | 首次尝试即达 90% 以上 |
日常使用中最重要的两项升级是原生音频(1.0 完全没有)和多模态引用系统(1.0 仅支持一张可选图像)。如果你试过 1.0 后就没再用,那么 2.0 是一个完全不同的工具。
Seedance 2.5 又是什么情况?
字节跳动并没有止步不前。一个更新的版本——被称为 Seedance 2.5——已经出现在剪映/Dreamina 的公开页面上,号称支持 30 秒的标准片段长度(相比 2.0 的 15 秒上限大幅提升)、180 秒的测试版长视频模式、最多 50 个多模态参考输入,以及一套全新的参考到视频(R2V)系统,可通过绿幕或白模素材控制角色运动。这些信息目前都尚未经过独立验证——它们来自平台宣传文案,而非实验室测试——所以请将这些规格视为方向性信息,而非确凿定论。如果这些数字属实,2.5 相对 2.0 的提升幅度可能会超过 2.0 相对 1.0 的提升。我们在 Seedance 2.5 详解文章中详细拆解了哪些信息已被证实、哪些仍待验证。在 2.5 广泛上线并经过验证之前,本文的所有内容仍然适用于目前已可使用的 2.0 模型。
Seedance 2.0 使用案例:六个实测提示词
我们在六个涵盖最常见创意需求的场景中测试了 Seedance 2.0。以下每个提示词都可以直接复制测试。针对每一个案例,我们都会描述实际得到的结果、耗时以及哪些部分有效、哪些无效。
除非另有说明,所有测试均在 PixVerse 上使用 Seedance 2.0 标准模式,720p,5-8 秒,16:9 画幅比例。
电影感场景
这个提示词测试了在黑暗、高对比度条件下的镜头表现、氛围营造和角色渲染——这类场景往往能很快暴露运动瑕疵。
提示词:
A retired detective in a long dark coat walks through a rain-soaked alley at night. Neon signs reflect red and blue on the wet cobblestones. He pauses, lights a cigarette, and glances over his shoulder. Slow push-in from wide shot to medium close-up. Film noir style, anamorphic lens flare, teal-orange color grading, film grain.
实测结果: 镜头推近平稳流畅——没有抖动或突兀跳跃。湿漉漉的鹅卵石路面上的雨水反光十分逼真,霓虹灯的色彩以应有的方式渗透进湿润的表面。侦探的大衣随着行走自然摆动,点烟的动作也没有出现任何手部畸变。环境音效包含了雨声和远处的城市噪音,与场景十分契合。在标准模式下生成大约耗时 70 秒。总体而言,这样的输出可以直接放进氛围片或短片提案中,几乎不需要额外的后期处理。
产品广告
产品镜头是对物理模拟的一次实际考验:光线是否正确打在表面上,旋转是否有机械般的流畅感,材质看起来是否符合预期。
提示词:
A luxury perfume bottle rotates slowly on a black marble surface. Golden liquid catches the light as it turns. Soft particles of gold dust float in the air around it. Macro close-up, slow 360-degree orbit camera. Studio lighting with warm rim light, high-end commercial photography style.
实测结果: 瓶内玻璃的折射效果和液体表现出乎意料地准确。金色微粒以自然的速度飘动,大理石表面呈现出可见的纹理颗粒感。环绕镜头在完整旋转过程中十分流畅。光线以正确的角度打在玻璃上,产生了如同真实影棚布光才有的焦散高光效果。总生成时间:约 65 秒。作为产品概念视频的初稿,这比搭建 3D 渲染场景节省了数小时的时间。
音乐视频
音乐视频要求富有表现力的动作、戏剧性的光影变化,以及在动态运动中保持角色形象的能力。这正是时序一致性受到严峻考验的地方。
提示词:
A female singer in a flowing red silk dress performs on a rooftop at sunset. City skyline stretches behind her. Wind blows her hair and dress dramatically. She sings with emotional intensity, arms spread wide. Dynamic tracking shot circling around her. Golden hour backlighting, lens flare, vibrant warm tones.
实测结果: 裙摆的物理效果是最大的亮点——红色丝绸在风中和光线下的表现看起来是真实的物理效果,而非程序化模拟。围绕歌手的环绕跟踪镜头流畅自然,她的面部在整个旋转过程中保持一致。发丝的动态自然,并与裙摆的风向相匹配,这是许多模型都会出错的细节。原生音频生成了与她动作节奏相匹配的环境音乐轨道。生成耗时:约 75 秒。如果你正在为音乐项目制作氛围板或概念视频,单次生成就能达到 80% 的完成度。
动态人物肖像
对大多数视频模型来说,细微的动作比戏剧性的动作更难处理。诸如转头、双手端详物体这样的小动作,会暴露出快节奏场景所能掩盖的时序不稳定问题。
提示词:
An elderly Japanese craftsman in a traditional wooden workshop, morning light streaming through paper screens. He slowly lifts a hand-forged ceramic tea bowl, examining it with quiet pride. His weathered hands rotate the bowl gently. Close-up of his hands, then slow tilt up to reveal his face. Wabi-sabi aesthetic, warm natural light, documentary portrait quality.
实测结果: 这是我们测试中最出色的结果之一。手部——通常是 AI 视频中最薄弱的环节——在整段片段中保持稳定,手指数量正确,关节运动自然。从手部到面部的镜头俯仰运动流畅,焦点转换的感觉如同真实的镜头拉焦。透过纸屏的晨光投下了柔和均匀的阴影。模型还自行添加了细微的工坊环境音:远处的鸟鸣、陶器轻微的碰撞声。饱经风霜的双手的皮肤质感看起来真实,没有过度锐化。生成耗时:约 80 秒。对于纪录片风格的内容或品牌叙事而言,正需要这种程度的细腻表现。
自然与风景
航拍和风景镜头考验大尺度的连贯性:模型能否在运镜的数秒之内维持一个一致的环境?
提示词:
Aerial drone shot gliding over a misty mountain valley at sunrise. Layers of fog roll between emerald green peaks. A winding river reflects the golden morning light below. Eagles soar through the frame at eye level. Smooth forward tracking with slight descent. Epic landscape, volumetric fog, golden hour lighting.
实测结果: 雾层以不同速度独立飘动,让场景呈现出真正的纵深感,而不是一幅平面的哑光背景画。河流的倒影随着镜头前移正确更新——这个细节需要模型具备空间感知能力。整体的色彩搭配——温暖的金色映衬着冷调的蓝绿色山峦——处理得很好,体积雾也呈现出立体感。音频包含了与环境相匹配的风声和远处的鸟鸣。这也是我们这批测试中生成速度最快的一次:约 55 秒。这样的输出已经接近专业无人机航拍的效果,还省去了差旅预算。
动漫与奇幻
风格化内容是与写实主义完全不同的挑战。模型需要在生成可信动作的同时,保持一致的艺术风格(赛璐璐渲染、速度线、平面色彩)。
提示词:
An anime warrior princess stands atop a cliff overlooking a burning medieval city at night. Her long silver hair and crimson cape billow in the wind. She draws a glowing blue katana, electricity crackling along the blade. Cherry blossom petals swirl around her. Dynamic low-angle shot with slow push-in. Cel-shading style, vibrant neon accents, dramatic speed lines.
实测结果: 赛璐璐渲染在整段片段中保持一致——没有出现动漫风格与写实风格混杂的常见问题。拔刀动作流畅,刀刃上的电流特效看起来就像出自真正的动漫,而不是通用的发光叠加效果。樱花花瓣独立飘动,部分花瓣还捕捉到了下方燃烧城市的火光反射。音效为拔刀动作配上了恰到好处的戏剧性挥刀声,与动作完全同步。生成耗时:约 70 秒。风格一致性是 AI 生成动漫内容中最难做好的部分,而 Seedance 2.0 在这方面的表现优于我们测试过的大多数模型。
Seedance 2.0 替代方案:2026 年顶级 AI 视频生成器对比
Seedance 2.0 是一款出色的模型,但并非唯一的选择——根据你的具体需求,它可能并非最佳之选。下面我们将 Seedance 2.0 与 PixVerse V6、Runway Gen-4.5、Pika 2.2、Luma Ray3 以及另外五款领先模型在分辨率、定价、音频和工作流适配性方面进行对比。
PixVerse V6——以及 PixVerse 上的 Seedance 2.0
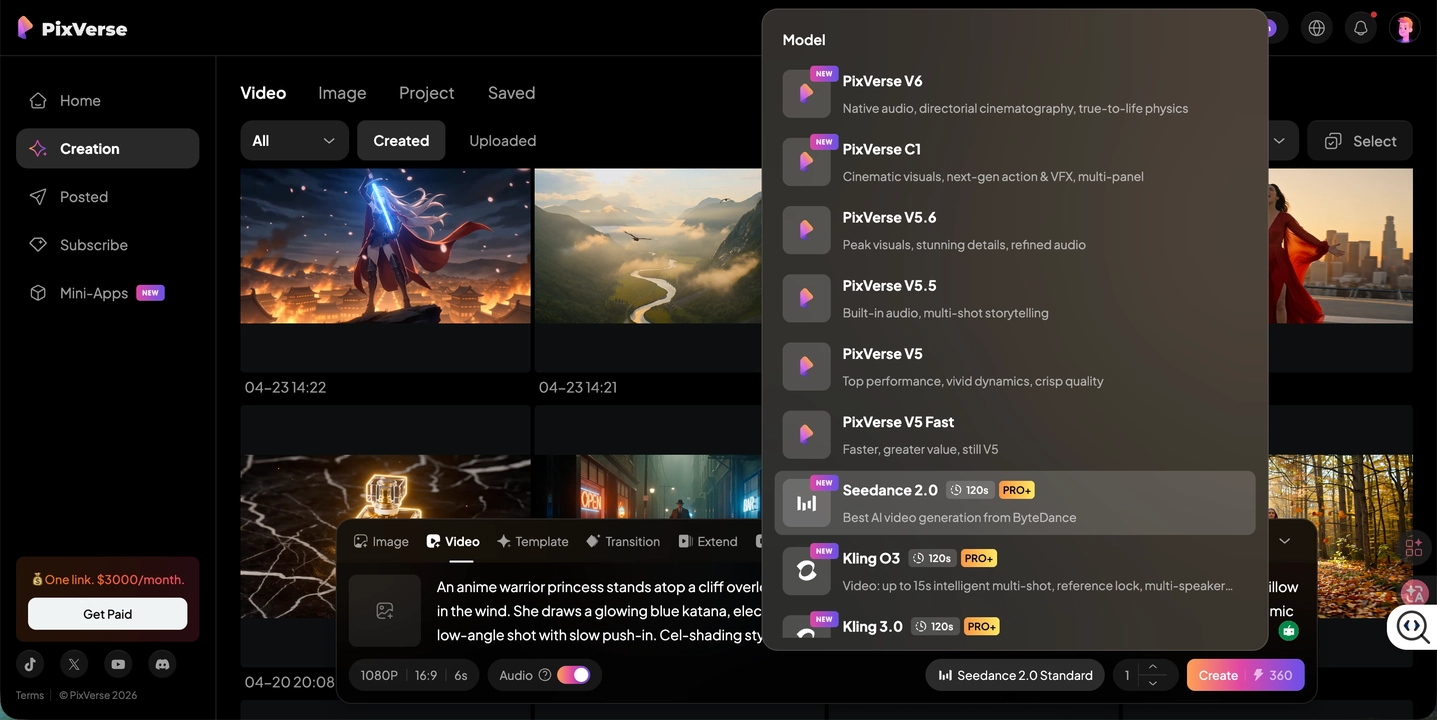
在逐一对比各个模型之前,有必要先解决一个实际问题:每个模型都活在自己的平台上,拥有各自独立的账户、定价和工作流程。如果你想将 Seedance 2.0 与可灵 3.0 用于同一个产品广告项目做对比,通常需要两个账户和两套积分。
PixVerse 解决了这个问题。Seedance 2.0 于 2026 年 4 月 13 日登陆 PixVerse,与可灵 O3、Veo 3.1、Sora 2 等模型汇聚在同一平台。一个账户,一份积分余额,即可并排对比。
PixVerse 上的 Seedance 2.0 提供两档模式:
| 档位 | 480p | 720p | 1080p |
|---|---|---|---|
| 标准版 | 15 积分/秒 | 30 积分/秒 | 可用 |
| 快速版 | 10 积分/秒 | 20 积分/秒 | 不适用 |
一段 5 秒 720p 标准模式片段需要 150 积分。快速模式生成同样的片段只需 100 积分。Pro、Premium 和 Ultra 会员均可使用 Seedance 2.0。Ultra 会员在所有生成上可享受 40% 的积分折扣。
除了托管第三方模型,PixVerse V6 本身也是一个强大的替代方案。 它采取了不同的路径——Seedance 2.0 擅长多参考精确控制,而 PixVerse V6 则专注于镜头控制和多镜头制作。
| 功能 | PixVerse V6 | Seedance 2.0 |
|---|---|---|
| 最长时长 | 15 秒 | 15 秒 |
| 镜头控制 | 20 多种参数化控制(推轨、升降、环绕、跟踪) | 基于提示词的描述 |
| 原生音频 | 支持 | 支持(7 种以上语言唇形同步) |
| 输入类型 | 文本 + 图像;多镜头引擎 | 文本 + 9 张图像 + 3 段视频 + 3 个音频 |
| 视频内编辑 | 不支持 | 支持 |
| 多镜头 | 单提示词生成完整短片,含原生音频 | 时间轴分镜 |
| 访问方式 | 网页、移动端、API、CLI | 即梦(中国大陆)或 PixVerse |
| 成本(1080p,每秒) | 14 积分(约 $0.07) | 标准版 30 积分(约 $0.15) |
何时选择 V6: 当你需要精确的镜头运动、面向开发者工作流的 CLI 集成(兼容 Claude Code、Codex、Cursor),或不受限制的全球访问。
何时选择 Seedance 2.0: 当你需要多参考输入控制、更高分辨率输出,或视频内编辑功能。
两者都可以在 PixVerse 上使用,因此你无需只选择其中一个。
Sora 2(OpenAI)
Sora 2 在叙事讲述和物理模拟方面表现最强。提示词遵循度很高,在对白驱动场景、细腻角色互动等情感场景的处理上优于大多数竞品。它需要 ChatGPT Plus($20/月)或 Pro($200/月)订阅。API 定价根据分辨率不同,每秒约为 $0.10-$0.50。最高输出:1080p,最长 20 秒。
Veo 3(Google)
Veo 3 是分辨率冠军:原生 4K 输出,支持 60fps 选项和空间音频。它能顺畅融入 Google Cloud 工作流,对于已经身处该生态系统的企业团队很有吸引力。代价是时长——片段上限为 8 秒,限制了其在叙事内容中的实用性。Lite 档位起价为 $0.05/秒。
可灵 3.0(快手)
可灵 3.0 提供每段片段中最佳的性价比。原生 4K 60fps、多语言唇形同步,以及能在单个 15 秒生成中处理最多六个镜头切换的多镜头 AI 导演功能。元素绑定(Element Binding)在多个镜头之间保持角色和物体的一致性。套餐起价为 $10/月。免费档位存在,但仅限于可灵 2.0。
Runway Gen-4.5
Runway 拥有最成熟的编辑工具集。Motion Brush 让你能对视频特定区域的运动进行帧级别的控制。如果你已经在使用 After Effects 或 DaVinci Resolve 这样的后期制作流程,Runway 能很自然地融入其中。缺点是:最高 720p 分辨率和 10 秒片段上限。API 定价约为每秒 $0.12。
Hailuo AI(MiniMax)
Hailuo 是速度选项。生成时间为每段 30-90 秒——是本次对比中最快的。它在 WorldModelBench 物理模拟排名中位列第一,并且在动漫和风格化内容方面表现出色。最高分辨率为 1080p,但片段上限为 10 秒。套餐起价为 $9.99/月。
Pika 2.2(Pika Labs)
Pika 2.2 专注于创意编辑而非原始生成。其 Scene-to-Scene 功能可以将现有素材转换为全新的视觉风格,而 Lip Sync 功能无需完整视频重新生成即可处理对白叠加。Pikaffects 系统可应用风格化转换效果(挤压、融化、爆炸),在社交媒体内容中很受欢迎。标准套餐每月 $8,是最实惠的选项之一。最高分辨率为 1080p,片段最长 10 秒。缺点:Pika 的原始生成质量和物理模拟在跑分上落后于 Seedance 2.0、可灵和 Veo。
Luma Ray3(Dream Machine)
Ray3 面向专业后期制作。原生 1080p 支持 HDR、16 位 EXR 帧输出以适配调色流程,还有一个 Draft Mode 可以 5 倍速度、5 倍更低成本进行快速原型制作。Modify Video 功能可将时长延长至 18 秒。套餐起价为 $9.99/月。
快速三方对比
想要一个直接的正面对比?以下是各顶级模型按主要优势的划分:
- 多参考精确控制 + 电影级叙事: Seedance 2.0
- 帧级运动控制 + 后期制作集成: Runway Gen-4.5
- HDR/EXR 工作流 + 快速原型制作: Luma Ray3
- 创意特效 + 预算有限的社交内容: Pika 2.2
- 参数化镜头控制 + CLI/开发者访问: PixVerse V6
完整对比表
| 模型 | 最长时长 | 原生音频 | 起始价格 | 最适合场景 |
|---|---|---|---|---|
| Seedance 2.0 | 15秒 | 支持 | PixVerse 上约 150 积分/段 | 多参考控制,电影级叙事 |
| PixVerse V6 | 15秒 | 支持 | 约 70 积分/段 | 镜头控制,多镜头短片,CLI 工作流 |
| Sora 2 | 20秒 | 不支持 | $0.10/秒 | 叙事讲述,物理模拟 |
| Veo 3 | 8秒 | 支持(空间音频) | $0.05/秒 | 4K 写实,企业场景 |
| 可灵 3.0 | 15秒 | 支持 | $10/月 | 性价比,长片段,多镜头 |
| Runway Gen-4.5 | 10秒 | 不支持 | 约 $0.12/秒 | Motion Brush,电影制作工具 |
| Pika 2.2 | 10秒 | 不支持 | $8/月 | 创意特效,社交内容,预算有限 |
| Hailuo AI | 10秒 | 不支持 | $9.99/月 | 速度,预算,物理模拟 |
| Luma Ray3 | 约 10.5秒 | 不支持 | $9.99/月 | HDR 工作流,后期制作 |
常见问题
什么是 Seedance 2.0?
Seedance 2.0 是字节跳动推出的多模态 AI 视频模型,于 2026 年 2 月发布。它可以生成 4-15 秒、最高 2K 分辨率、带原生音频的视频片段。该模型接受文本、图像、视频和音频组合输入——每次生成最多支持 12 个参考素材。
Seedance 2.0 免费吗?
Seedance 2.0 在其原生平台上提供免费和付费两档(最高 $49.99/月)。在 PixVerse 上,Pro、Premium 和 Ultra 会员可以使用它,按积分计费——一段 5 秒 720p 标准模式片段需要 150 积分。Ultra 会员在所有 Seedance 2.0 生成上均可享受 40% 折扣。
Seedance 2.0 与 Seedance 1.0 相比如何?
这是一次彻底的重建,而非小幅更新。主要升级包括:原生音频生成(1.0 完全没有)、支持最多 12 个素材的多模态输入(1.0 仅支持文本加一张可选图像)、更高分辨率(2K 对比 1080p)、更好的手部/肢体渲染,以及首次尝试即可达到 90% 以上的可用输出率。
我可以在中国大陆以外使用 Seedance 2.0 吗?
通过即梦 App 直接访问需要中国大陆手机号和支付方式,这给国际用户带来了阻碍。更简便的方式是通过 PixVerse 使用 Seedance 2.0——没有区域限制,无需单独注册账户。
Seedance 2.0 的最佳提示词结构是什么?
从以下结构开始:[主体] + [动作] + [场景] + [风格] + [镜头] + [光线]。镜头指令要具体(“从中景缓慢推近至特写”),当你有可视素材来引导输出时,使用 @image1 / @video1 引用语法。对于多镜头序列,使用时间轴标注:0-4秒:全景、4-8秒:跟踪镜头等。
Seedance 2.0 与 PixVerse V6——我该用哪个?
这取决于具体项目。PixVerse V6 提供 20 多种参数化镜头控制、面向开发者工作流的 CLI 访问,以及简单直接的全球可用性。Seedance 2.0 提供更丰富的多模态输入(12 个素材)、更高分辨率(2K)和视频内编辑功能。两款模型都在 PixVerse 上,你可以并排测试对比。
Seedance 2.0 会生成音频吗?
会。它会在生成视频的同一次过程中生成对白(支持 7 种以上语言唇形同步)、音效和环境音频。无需单独的音频制作步骤。音频默认开启,如果你只需要画面轨道,也可以关闭。
Seedance 2.0 的主要局限性是什么?
区域访问壁垒(主要与中国大陆平台相关)、激进的内容审核、测试阶段的 API、不支持 LoRA 或微调、视频内文字渲染不稳定、商业授权条款不明确、较陡的学习曲线,以及 15 秒的最长片段限制。具体到社交媒体内容创作者:15 秒上限适用于 Reels、TikTok 和 Shorts,但学习曲线和审核标记可能会拖慢那些更看重速度而非单片精度的高产量工作流。
对专业动画师来说,Seedance 2.0 值得升级吗?
对于需要参考驱动生成的 2D/3D 动画师来说——值得。@引用系统与动画师已有的工作方式相契合:姿势表、转身图和风格帧成为直接输入,而不是需要用文字描述的东西。首次尝试即可达到 90% 以上的可用输出率,大幅减少了迭代循环。不过,如果你的工作流依赖 LoRA 微调来实现自定义角色模型,Seedance 2.0 并不支持这一点。对于动漫专项工作,Hailuo AI 和 PixVerse V6 也能以更低的单片成本产出出色结果。最终决定取决于多参考输入控制是否值得为你的具体流程支付更高的积分成本。
我可以在生产环境工作流中使用 Seedance 2.0 API 吗?
截至 2026 年 4 月,该 API 仍处于公开测试阶段。它支持文生视频和图生视频端点,具备基础的参数控制。然而,速率限制、版本间的破坏性变更以及不完整的文档,使其目前尚不适合用于生产关键的自动化管线。对于当下的程序化视频生成需求,PixVerse 的 API 和 CLI 提供了稳定的访问方式,可与其他模型一起调用 Seedance 2.0——具备一致的接口、有文档记录的速率限制,以及面向开发者工作流的 Claude Code / Cursor 集成。
最终结论
Seedance 2.0 是 AI 视频生成领域一次真正的进步——尤其对那些愿意投入时间学习其多模态提示词系统的创作者而言。基于引用的工作流、原生音频以及基于时间轴的多镜头生成,让它更接近一款生产工具,而非一个新奇玩具。
谁应该使用 Seedance 2.0:
- 专业电影制作人和动画师: 在多参考、多镜头叙事方面表现最佳。如果你已经习惯以镜头列表和参考板的方式思考,这条学习曲线是值得的。
- 社交媒体内容创作者: 适用于高质量的核心内容和活动视频。对于日常高频发布来说有些大材小用——追求速度优先的工作流可以考虑 PixVerse V6 或 Hailuo AI。
- 企业和依赖 API 的团队: 等待 API 退出测试阶段,或使用 PixVerse 的 API 层来获得对 Seedance 2.0 的稳定程序化访问。
- 普通用户和新手: 从 PixVerse V6 或 Hailuo AI 开始——更简单的提示词系统、更快的结果、更低的单片成本。
它并不适合所有人。如果你只想用一句话提示词快速生成一段片段,像 Hailuo AI 或 PixVerse V6 这样的模型能以更少的摩擦更快地实现。如果你需要 4K 输出,Veo 3 或可灵 3.0 是更好的选择。如果镜头控制是你的首要考量,PixVerse V6 目前提供的参数化选项比 Seedance 2.0 基于提示词的方式更精确。
现在尝试 Seedance 2.0 最有力的理由是,你不必只选择一个模型。在 PixVerse 上,你可以将同一个创意概念用 Seedance 2.0、V6、可灵和 Veo 分别跑一遍,再将结果与我们 AI 视频生成器 榜单中的每一款旗舰模型对比——比较结果,为每个镜头选用最合适的那一个。这种灵活性,比任何单一模型的跑分都更重要。